


Google TPU 世代技术全景:从 bfloat16、光交换到 Ironwood,以及 TorchTPU 的 PyTorch 原生后端
为什么要按代拆开看 TPU
TPU v1 的故事已经在站内两篇文章里讲透了:一颗只为 8 位整数推理设计的 ASIC,256×256 的脉动阵列,92 TOPS 峰值,2015 年就在 Google 数据中心里跑起了搜索排序和语音识别。可参考 TPU v1 完全拆解(一):为推理而生的领域专用架构与指令集 与 TPU v1 完全拆解(二):脉动阵列、weight-stationary 数据流与 Roofline 性能归因。
但 v1 有一个致命的边界:它只能做推理,不能训练。权重必须提前量化好、按层排布好,芯片里没有足够的浮点能力和通用性去跑反向传播。从 v2 开始,TPU 变成了一整个家族:v2 和 v3 把芯片做成可训练的超级计算机节点,v4 用光交换把拓扑变成可重构资源,v5 分叉出面向推理成本的 v5e 和面向绝对性能的 v5p,v6e Trillium 把能效和 HBM 带宽抬上去,v7 Ironwood 第一次明确地”为推理而生”,v8 则直接拆成训练用的 8t 和推理用的 8i 两颗芯片。
这条路线看似每隔一两年就换一次数字,实际的演进主线只有五条:
- 矩阵乘单元的规模:从 v1 的 256×256 单阵列,到 v4 每芯片 8 个 128×128 MXU,再到后期世代通过更宽的 MXU 和更高频率堆算力。
- HBM 的容量与带宽:解码阶段的瓶颈从来不是算力,而是每生成一个 token 要把全部权重和 KV 缓存读一遍。v7 把容量拉到 192 GB、带宽拉到 7.37 TB/s,v8i 进一步到 288 GB 加 384 MB 片上 SRAM,都是冲着这个瓶颈去的。
- 片间互联拓扑:从 v2/v3 的 2D torus,到 v4 的 3D torus 加光交换,再到 v8i 的 Boardfly。拓扑决定了张量并行、专家并行、全归约能跑多快。
- 稀疏与嵌入支持:SparseCore 从 v2 就存在,到 v4 变成每芯片 4 个、占 5% 面积却把嵌入类负载加速 5 到 7 倍。
- 数值格式:bfloat16 让训练可行,FP8 原生支持让推理的算力口径翻倍,FP4 已经在 v8 的路线图上。
把这些线索串起来,就能理解每一代为什么长成那个样子,而不是简单记一串 TOPS 数字。
一颗 TPU 里到底有什么
在逐代展开之前,先把 TPU 的芯片内部结构拆开。不同世代的规格在变,但组件划分基本稳定。
TensorCore、MXU 与 VPU
TPU 芯片里最核心的单元叫 TensorCore(张量核心),v2 到 v7 的芯片通常集成两个。一个 TensorCore 包含:
- 一组 MXU(Matrix Multiply Unit,矩阵乘单元)。v4 的一个 TensorCore 有 4 个 128×128 的 MXU,两个 TensorCore 合计 8 个;每个 MXU 内部是 16384 个乘加单元,按脉动阵列组织。
- 一个 VPU(Vector Processing Unit,向量处理单元),v4 上是 128 条 lane、每条 lane 16 个 ALU,合计 2048 个 ALU,配 16 MiB 的 VMEM。
- 一个标量单元,负责地址计算和控制流。
两个 TensorCore 共享一块 CMEM(Common Memory,公共内存),v4 上是 128 MiB。这块片上暂存不是缓存,没有硬件一致性协议,完全由编译器显式管理。它存在的理由很直接:小权重、小 batch 的负载从 HBM 读太慢,把热数据钉在 CMEM 里能把这类负载拉快数倍。论文里 RNN1 在 v4 上比 v3 快 3.3 倍,很大一部分就来自 CMEM 的带宽。
MXU 的峰值算力可以精确算出来:
其中 是乘加单元总数, 是时钟频率,系数 2 是因为一次乘加包含一次乘法和一次加法。以 v4 为例,,时钟约 1.05 GHz,代入得 TFLOPS,正好对上官方公布的 275 TFLOPS BF16 峰值。这个公式也解释了为什么后续世代提升算力只有三条路:加 MXU 数量、加宽 MXU、提高频率。
TPU 是一台”带超宽向量寄存器的顺序机器”
GPU 的编程模型是大量 SIMT 线程,靠 warp 切换隐藏延迟;TPU 不是。JAX 的 Pallas 文档对 TPU 的描述非常准确:TPU 本质上是一台顺序执行的机器,带一个非常宽的向量寄存器,更像 CPU 而不是 GPU。区别在于,它允许软件把某些操作调度到后台异步执行,包括 HBM 访存、矩阵乘、矩阵转置与 permute。
这个模型带来两个工程后果。
第一,性能可预测。TensorCore 同一时刻只执行一条指令流,没有乱序、没有多线程抢占,只要程序结构固定,执行时间就基本固定。这对推理服务的尾延迟是好事,但对需要靠大量并发隐藏延迟的负载不友好。
第二,并行度来自数据分块而不是线程。Pallas 在 TPU 上写 kernel 时,grid 默认按字典序串行迭代,而不是像 CUDA 那样把每个 block 分给一个 SM。相邻迭代如果复用同一块输入切片,HBM 传输会被自动跳过;多次迭代写同一块输出切片也不会竞争,只要这些迭代是连续的。这些性质在 GPU 上要靠同步和原子操作保证,在 TPU 上是硬件执行模型自带的。
SparseCore:专门处理嵌入与不规则访存
SparseCore(SC)是 TPU 从 v2 起就有、但很少被单独拿出来讲的单元。它负责稠密矩阵乘不擅长的部分:嵌入查表、gather/scatter、排序、去重、直方图、ragged 张量,以及把集合通信从 TensorCore 上卸下来。
v4 的每个 SparseCore 有 16 个计算 tile,每个 tile 绑定一条 HBM 通道,配 2.5 MiB 的 Sparse Vector Memory(spmem),内部有一个 8 宽 SIMD 的 scVPU 和取数、写回单元。五个 Cross-Channel Unit 负责跨 tile 的嵌入操作。它们执行的是类似 v1 的 CISC 指令,操作数长度可变,单条指令的运行时间依赖数据。
这个设计的动机来自推荐模型。DLRM 的嵌入表可以从几十 MiB 到几百 GiB,总量能到几 TiB,必须跨芯片分片。查表本身是低算术强度的随机访存,放在 TensorCore 上会浪费宽 VPU 和 MXU;放在主机 CPU 上又会被 CPU DRAM 带宽卡死。SparseCore 用 5% 的芯片面积和 5% 的功耗,把这些负载加速了 5 到 7 倍。v4 里所有 SparseCore 通过 HBM 和 ICI 组成一个 128 TiB 的扁平全局地址空间,嵌入表可以像一块内存那样被寻址。
HBM 与 ICI
每颗 TPU 封装里除了 ASIC 还有 HBM 堆栈。v4 是 32 GB HBM2、1.2 TB/s;v7 是 192 GB HBM、7.37 TB/s;v8i 是 288 GB、8.6 TB/s。HBM 的容量决定能装下多大的模型和多少 KV 缓存,带宽决定解码时每个 token 能多快把权重读完。
片间互联叫 ICI(Inter-Chip Interconnect)。它把同一 slice 里的芯片连成环面拓扑,不经过主机网络。v7 的 ICI 双向带宽是 1.2 TB/s,v8t 和 v8i 到了 19.2 TBps。ICI 之外还有 DCN(Data Center Network),负责跨 slice 通信,带宽低一个数量级,v8t 上是 400 GBps。任何并行策略的设计,第一步都是把通信最重的维度放到最快的 ICI 维度上。
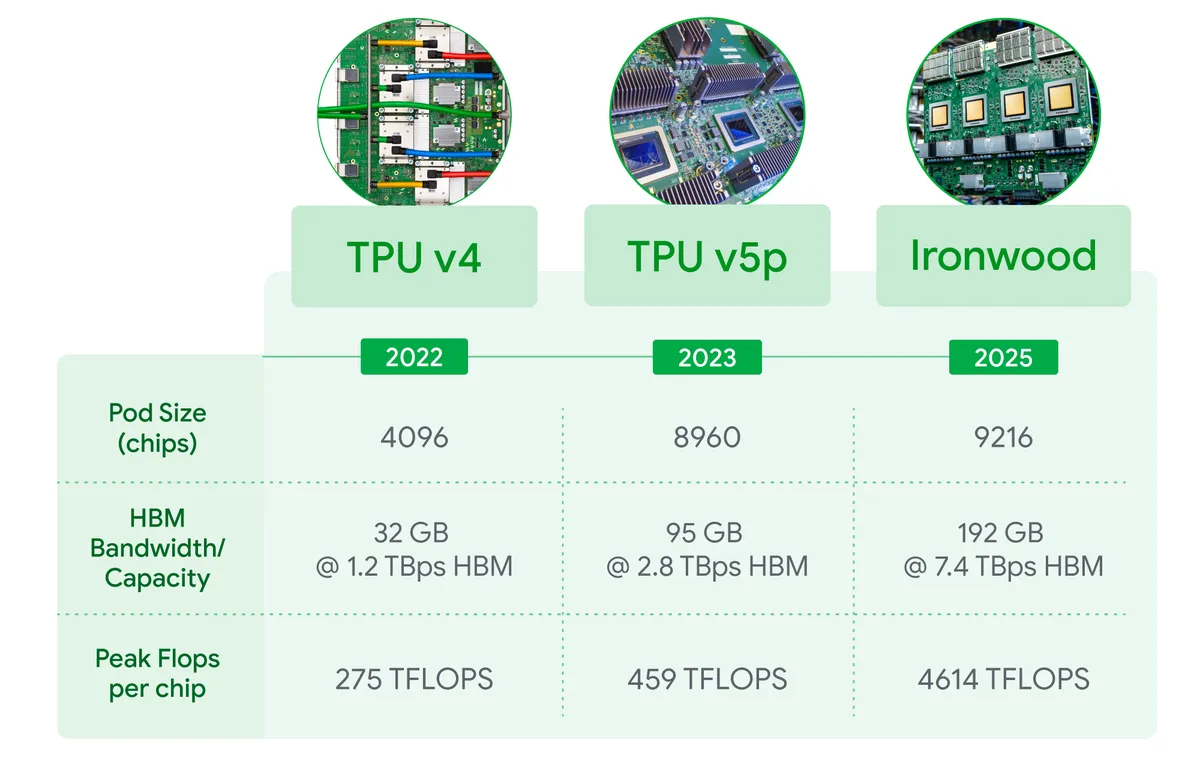
上图是 Google 在 Ironwood 发布时给出的 3D torus 版本 Cloud TPU 规格对比,覆盖 TPU v4、TPU v5p 和 Ironwood 三代。可以看到 v4 到 Ironwood 的单芯片峰值从 275 TFLOPS(BF16 口径)涨到 4614 TFLOPS(FP8 原生),HBM 从 32 GB 涨到 192 GB,带宽从 1.2 TBps 涨到 7.4 TBps,而 pod 规模基本停在 4096 到 9216 芯片之间。算力和带宽涨了一个数量级,规模只涨了两倍多,说明这一阶段的重点不是继续堆芯片数,而是让每颗芯片更”抗内存墙”。
v2 与 v3:让 TPU 学会训练
从整数推理到浮点训练
v1 用 INT8 是因为推理只需要前向,量化误差可以用校准弥补。训练不行:梯度更新的动态范围跨越多个数量级,INT8 的表示范围根本不够,FP32 又太贵。Google 在 v2 上给出的答案是 bfloat16(BF16)。
BF16 的位布局是 1 位符号、8 位指数、7 位尾数,总共 16 位。它和 FP32 的指数位一样宽,所以表示范围与 FP32 相同,只是尾数从 23 位缩到 7 位,相对精度约为 。这个取舍非常聪明:深度学习的数值问题主要出在范围而不是精度,梯度下溢到 0 或者上溢到 inf 是灾难,尾数少几位只是噪声大一点。
更关键的是 MXU 里的乘加结构。两个 BF16 相乘,乘积的尾数最多 16 位,FP32 的 24 位尾数可以精确容纳,所以单次 BF16 乘法的结果在 FP32 里是无损的;累加也在 FP32 里做,只有累加过程本身有舍入。这解释了为什么 BF16 训练能收敛:误差不会在每一次乘法上累积成系统性偏差。
v2 与 v3 的硬件轮廓
v2 于 2017 年发布,是 Google 第一代对外销售的 Cloud TPU。每颗芯片两个 MXU,BF16 峰值约 45 TFLOPS,16 GB HBM、600 GB/s,四颗芯片一块板,64 颗芯片组成一个 pod。v3 在 2018 年把规模拉到 1024 颗芯片一个 pod,单芯片 123 TFLOPS、32 GB HBM、900 GB/s,并第一次大规模采用液冷。
v2 和 v3 的拓扑都是 2D torus。2D 环面的优点是布线简单、每颗芯片只需要连四个方向;缺点是二分带宽随芯片数 只按 增长。当 pod 从 64 颗扩到 1024 颗时,环回链路要跨越整个机架行,电信号传不了那么远,只能换成光模块。v4 论文里明确写了这个痛点:1024 颗芯片的 v3 pod 已经有一批环回链路必须是光口,光链路比电链路贵十倍以上;如果继续按 2D torus 扩到 4096 颗,光口数量会失控。
这一段历史解释了 v4 为什么必须换拓扑,也解释了 TPU 的互联设计为什么从一开始就和并行策略绑在一起。数据并行做全归约、张量并行做 all-reduce 和 all-gather、流水并行做点对点传递,三种通信模式对拓扑的要求不同。2D torus 在 1024 颗芯片时还能用,再大就必须换一种能把二分带宽提上去的结构。
XLA:把整张计算图当成一个编译单元
TPU 的软件栈从 v2 起就是 XLA(Accelerated Linear Algebra)。它不是普通的算子库,而是一个把整张计算图编译成 TPU 指令的编译器:前端把模型降成 HLO,编译器做算子融合、内存规划、布局选择和集合通信插入,最后生成 TPU 可执行文件。
这个设计和 GPU 的”kernel 逐个启动”模式差别很大。GPU 上一个 Transformer 层是几十个 kernel,每个 kernel 都有自己的启动开销和访存往返;XLA 会把整个前向图当成一个程序,能融合的融合,能常驻的常驻,集合通信也能被调度到和计算重叠的位置。代价是形状必须编译期已知。这个约束一直延续到今天,也是 TorchTPU 要解决的核心问题之一,后文会详细展开。
v4:用光交换把拓扑变成可重构资源
v4 是 TPU 家族里架构味道最浓的一代,2023 年发表于 ISCA 的论文 TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings 把它完整讲了一遍。这一代要解决的问题很明确:v3 已经做到 1024 颗芯片一个 pod,再往上扩到 4096 颗时,2D torus 的环回链路和二分带宽都撑不住。
3D torus 与 4×4×4 立方体
v4 把拓扑改成 3D torus。基本构建块是 4×4×4 的立方体,共 64 颗芯片,装在一个机架里;64 个这样的立方体再由光交换连成 4096 颗芯片的超级计算机。
维度从 2 变成 3 之后,二分带宽随芯片数的增长速度从 变成 。这个变化在千颗量级上非常明显:同样 1024 颗芯片,3D torus 的二分带宽是 2D torus 的 2 到 4 倍。论文里用嵌入查表举例,因为嵌入的 all-to-all 传输正好吃二分带宽,v4 的嵌入性能因此比 v3 快 1.1 到 2.0 倍。
但 3D torus 有一个物理问题:立方体内部的连接可以走电缆,立方体之间的连接距离远,必须走光纤。如果每一根跨立方体的链路都固定成一根光纤,成本和布线复杂度都无法接受。v4 的答案是 OCS(Optical Circuit Switch,光路交换)。
Palomar OCS 是怎么工作的
Google 的 Palomar OCS 基于 3D MEMS 反射镜:光纤阵列发出的光经过一组可转动的微镜,被反射到目标光纤。微镜的角度由控制电路设定,切换时间是毫秒级。它还用环行器(circulator)让同一根光纤双向传输,端口数和线缆数减半。
关键在于,OCS 交换的是光路而不是数据包。一旦微镜角度设定好,光就从输入端口直达输出端口,中间不需要光电转换、不需要排队、不需要协议处理。整条光路的功耗和延迟都极低。论文给出的数字是:OCS 和配套光器件占整机成本的不到 5%、功耗的不到 3%。
48 个 OCS 把 64 个立方体连成完整的 4096 芯片系统。每个立方体的 48 对输入输出光纤接到 48 个不同的 OCS 上,任意两个立方体之间都能通过其中一个 OCS 建立连接。这台机器因此可以按 job 的需要改变拓扑,而不需要重新插拔任何一根线。
OCS 带来的五个好处
论文把 OCS 的价值总结成五条,每一条都对应一个真实的运维问题。
可用性:4096 颗芯片的系统里,主机故障是常态。每个主机挂 4 颗 TPU,4096 颗芯片对应 1024 台主机。如果拓扑是固定的,一台主机坏掉就可能让整个立方体不可用;有了 OCS,调度器可以把坏掉的芯片或链路绕过去,把剩下的芯片重新连成一个可用的 slice。论文的实测是,在 99.0% 的主机可用率下,OCS 连接的机器仍然能给出合理的 goodput,而固定拓扑的机器必须等到 99.9% 才能跑满。
部署速度:v3 的 1024 芯片 pod 必须等所有芯片和线缆装完、测完才能上线;v4 的每个机架是独立的,64 颗芯片装好就能投产,OCS 后续再把机架连起来。这缩短了从到货到产生收入的周期。
拓扑定制:用户可以根据并行策略选形状。流水并行喜欢”雪茄形”,比如 4×4×32;嵌入密集的负载喜欢接近立方体的 8×8×8,因为二分带宽最大。论文里报告,仅调整 slice 形状和并行超参就能带来 1.2 到 2.3 倍的性能差异。
扭曲环面:对于 或 的 slice,OCS 可以把环面的连接方式从规则环面改成 twisted torus(扭曲环面)。规则环面里,相邻维度的链路会在某些 all-to-all 模式下形成热点;扭曲之后,流量分布更均匀。论文实测同样大小的 4×4×8 和 4×8×8 slice,扭曲环面的 all-to-all 吞吐明显高于规则环面。这个改动不需要重新布线,只改路由表。
模块化与安全:不同租户的 slice 可以在物理上隔离,光路不交叉,避免侧信道和相互干扰。
SparseCore 在 v4 上的升级
v4 把每芯片的 SparseCore 数量从 v3 的 2 个增加到 4 个,并把它们组织成一个跨芯片的扁平地址空间。4096 颗芯片的 HBM 加起来是 128 TiB,SparseCore 可以在这个空间里做细粒度的 gather/scatter,不需要主机参与。
这里的工程取舍值得说清楚。嵌入查表的算术强度极低,一次查表就是读一行向量,几乎不做乘加;但它对延迟和随机访存很敏感。如果放在 TensorCore 上,宽 VPU 和 MXU 会大量空转;如果放在 CPU 上,4:1 的 TPU 与主机比例会让 CPU DRAM 带宽成为 Amdahl 瓶颈。SparseCore 用独立的数据流架构专门吃这类负载,代价是 5% 的芯片面积和 5% 的功耗,收益是 5 到 7 倍的端到端加速。这笔账在推荐系统上非常划算。
v4 相对 v3 的整体提升是 2.1 倍性能、2.7 倍每瓦性能。论文特别说明,其中约 40% 的每瓦提升来自 7nm 工艺,其余来自设计改进:平衡流水线、时钟门控、更大的 CMEM、更多的 SparseCore。
v5e 与 v5p:一颗芯片拆成两个方向
v5 这一代最有意思的地方不是某一项新技术,而是产品线的分叉。
TPU v5e 面向推理和成本敏感的训练。它的单芯片 BF16 峰值是 197 TFLOPS,16 GB HBM、819 GB/s,pod 规模最大 256 颗芯片。相比 v4,它的 HBM 容量和带宽都退了一步,换的是更低的单芯片成本和更低的功耗。对推理来说,这个取舍常常是对的:很多推理负载的模型能放进 16 GB,真正的瓶颈是每 token 的访存次数,而不是 pod 能扩到多大。
TPU v5p 面向最大规模的训练。单芯片 459 TFLOPS BF16,95 GB HBM、2.8 TB/s,pod 最多 8960 颗芯片,3D torus 拓扑。它的 HBM 容量是 v5e 的将近 6 倍,pod 规模是 35 倍,价格也高得多。
两者都支持 FP8,但 v5p 的 FP8 峰值是”模拟”出来的,Ironwood 才是原生支持。这个细节在对比算力时非常容易踩坑:不同世代的 TFLOPS 数字如果口径不同,直接比较会得出错误结论。Google 在 Ironwood 的规格图里专门标注了 “FP8 peak TFlops emulated for v4 and v5p, but natively supported for Ironwood”。
分叉的背后是一个朴素的经济学判断:推理和训练对硬件的需求已经分开了。训练要的是大内存、大 pod、高带宽互联,因为要装下优化器状态、激活和梯度,还要在几千颗芯片之间做全归约;推理要的是低延迟、低成本、足够的 HBM 带宽,因为 decode 阶段每生成一个 token 都要把权重读一遍,而 batch 往往填不满。用同一颗芯片同时服务两类负载,必然有一边要为另一边付溢价。
v6e Trillium:把能效和带宽补上
Trillium 是第六代 TPU,2024 年发布。Google 公布的相对数字是:单芯片峰值算力是 v5e 的 4.7 倍,能效提升 67%。按 v5e 的 197 TFLOPS 推算,Trillium 的峰值大约在 926 TFLOPS 量级;Google 没有公布这一代的口径细节,这个数字只适合做量级参照。
从 Ironwood 发布时给出的反向倍数可以还原出 Trillium 的另外几个关键规格:Ironwood 的 192 GB HBM 是 Trillium 的 6 倍,所以 Trillium 是 32 GB;7.37 TB/s 是 Trillium 的 4.5 倍,所以 Trillium 约 1.64 TB/s;1.2 TB/s 的 ICI 是 Trillium 的 1.5 倍,所以 Trillium 约 800 Gbps。
把这组数字和 v5e 放在一起看,Trillium 的定位就清楚了:它没有把 pod 规模做得更大,而是把单芯片的算力、HBM 容量、HBM 带宽、ICI 带宽同时抬了一档。对推理服务来说,这是一组更实用的提升。decode 阶段的算术强度很低,HBM 带宽几乎线性决定吞吐;多卡张量并行时,ICI 带宽决定 all-reduce 的开销;32 GB 的容量则决定了能装下多大的模型和多长的上下文。
Trillium 也是 TorchTPU 最早验证的硬件世代之一。TorchTPU 的模型覆盖测试从 v5e 开始,训练和微调的案例则同时跑了 v6e 和 v7x。
v7 Ironwood:第一颗明确为推理设计的 TPU
2025 年 4 月,Google 发布第七代 TPU Ironwood,定位是”第一颗为推理时代设计的 TPU”。这句话不是营销话术,规格上的取舍非常明确。
单芯片 4614 TFLOPS FP8 峰值。注意单位是 FP8 而不是 BF16,而且这一代是原生 FP8,不是模拟。192 GB HBM,带宽 7.37 TB/s,是 Trillium 的 4.5 倍。ICI 双向 1.2 TB/s,是 Trillium 的 1.5 倍。一个 pod 最多 9216 颗液冷芯片,合计 42.5 Exaflops,功耗接近 10 MW。Google 同时提供 256 颗芯片的小配置,给不需要超大 pod 的推理负载。
为什么推理需要这么大的 HBM
很多人会直觉地认为推理比训练便宜,因为推理不做反向传播。单看单次前向的 FLOPs,这个判断没错;但推理的总成本由访存决定。
考虑一个 70B 参数的模型,BF16 权重占 140 GB。decode 阶段每生成一个 token,要把这 140 GB 权重完整读一遍。如果 HBM 带宽是 7.37 TB/s,理论最短时间约 19 ms,折算下来单请求不到 53 token/s。这就是所谓的内存墙:算力再高,权重读不完也没用。
KV 缓存进一步放大压力。一个 80 层、8 个 KV head、head_dim 128 的模型,在 32k 上下文下单条请求的 KV 缓存大小是:
其中 是层数, 是 KV head 数, 是每个 head 的维度, 是序列长度, 是每个元素的字节数。代入 、、、、,得到约 10.7 GB。也就是说,单条 32k 上下文的请求就要吃掉 10.7 GB HBM,192 GB 的 Ironwood 最多同时驻留十几条这样的请求。如果想提高并发,要么用量化把 KV 压到 FP8(直接减半),要么用分页和前缀复用来提高实际利用率。
这两个公式合起来解释了 Ironwood 的规格为什么是现在这样:HBM 容量决定并发上限,HBM 带宽决定单 token 延迟,FP8 决定同样的容量能装下多少。4614 TFLOPS 的 FP8 算力当然也重要,但它更多是给 prefill 和 MoE 的专家矩阵乘用的;decode 阶段能不能跑快,主要看 7.37 TB/s。
FP8 与推理算力口径
FP8 有两种常见格式:E4M3(4 位指数、3 位尾数)和 E5M2(5 位指数、2 位尾数)。E4M3 的精度更高,适合前向的权重和激活;E5M2 的范围更大,适合梯度。Ironwood 原生支持 FP8,意味着 MXU 可以直接以 FP8 为输入做矩阵乘,并用更高的吞吐累加,而不是把 FP8 反量化成 BF16 再算。
这也是算力数字容易误导的地方。v4 的 275 TFLOPS 是 BF16,v5p 的 459 TFLOPS 是 BF16,Ironwood 的 4614 TFLOPS 是 FP8。三者不能直接相除得出”快 16 倍”的结论。合理的比较方式是在同一精度、同一 batch、同一模型下看端到端吞吐和每 token 成本,而不是看峰值。
SparseCore 与推荐负载
Ironwood 增强了 SparseCore。每芯片 2 个 SparseCore(4 个物理核心),每个 16 个 subcore,SIMD 宽度在 F32 下是 16、BF16 下是 32。这个宽度比 v4 的 8 宽了一倍,意味着同样的嵌入查表和排序操作,单条指令能处理更多元素。
Google 在发布里特别提到,增强后的 SparseCore 不只服务推荐系统,也能覆盖金融和科学计算里的稀疏负载。这个说法背后的技术事实是:SparseCore 的指令集本来就是为不规则访存和变长数据设计的,只要负载的算术强度低、访存随机,它就有优势。
v8:8t 与 8i 的分叉,以及 Boardfly
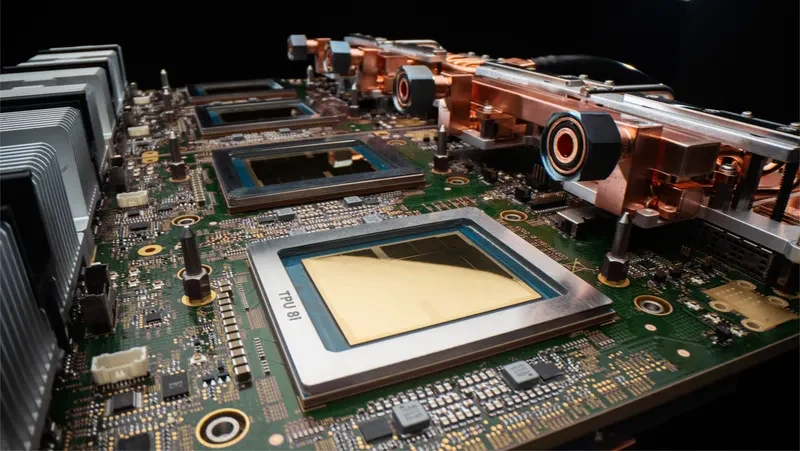
上图是 Google 第八代 TPU 发布时给出的两颗芯片示意。把 8t 和 8i 并排放在一起,能直观看到产品线已经按训练和推理彻底分开:8t 追求更大的算力和 scale-up 带宽,8i 追求更大的内存带宽和更低的延迟。Ironwood 是这条分叉路线上的第一步,它先把”推理专用”作为一个明确的产品定位立住,第八代再把训练和推理拆成两颗独立的芯片。
2026 年 4 月,Google 发布第八代 TPU,直接拆成两颗芯片:TPU 8t 面向训练,TPU 8i 面向推理与智能体负载。这是 TPU 历史上第一次在同一代里为训练和推理设计两套独立架构。
TPU 8t:把 superpod 做到 9600 颗芯片
8t 的单 superpod 最多 9600 颗芯片,共享 2 PB 高带宽内存,片间带宽是上一代的两倍。配套的是新的 Virgo Network 和 Google 的 Pathways 软件栈,官方说法是可以在单个逻辑集群里做到接近线性扩展到一百万颗芯片。
可靠性被放到了和性能同等的位置。8t 的目标是 97% 以上的 goodput(有效计算时间占比),手段包括:几万颗芯片的实时遥测、ICI 链路故障的自动检测和绕行、以及用 OCS 在硬件故障时自动重构拓扑,不需要人工介入。这个思路和 v4 的 OCS 一脉相承:把拓扑当成软件可以调整的资源,而不是一次布好的死结构。
8t 还集成了 10 倍速的存储访问和 TPUDirect,让数据可以直接进 TPU,绕过主机内存的拷贝。对训练来说,这两项解决的是数据管道的喂料问题:算力再大,存储读不上来,MXU 也只能空转。
TPU 8i:为智能体负载重做内存层次
8i 的规格是 288 GB HBM 加 384 MB 片上 SRAM,SRAM 是上一代的 3 倍。Google 的说法是要把模型的活跃工作集完全留在片上。这个设计的动机来自智能体负载的特征:多轮对话、长上下文、高前缀复用、子智能体突发。这类负载的 KV 缓存访问模式很不规则,而且对首 token 延迟和交互流畅度极其敏感。
拓扑上,8i 用了新的 Boardfly 架构,把最大网络直径减少了 50% 以上。网络直径直接决定最坏情况下的通信跳数,对延迟敏感的推理比对大吞吐训练更在意这个指标。8i 的 ICI 带宽是 19.2 TBps,DCN 是 400 GBps,前者负责 slice 内的张量并行和专家并行,后者负责跨 slice 的请求调度和 KV 传输。
Boardfly 的具体拓扑细节 Google 没有完整公开,但从 TorchTPU 的文档可以确认两件事:8i 的 slice 内部不再是 3D torus,而是 Boardfly;PyTorch 侧看到的设备模型仍然是”一颗芯片两个 TensorCore,对应两个 device”。后一点在分布式初始化时会带来很实际的麻烦,后文讲 TorchTPU 的 one-process-per-device 时还会遇到。
一张表看清七代
下表把前面提到的规格汇总。不同来源的数字口径不完全一致,表中标注了精度和来源,避免把 BF16 和 FP8 混在一起比较。
| 世代 | 年份 | 单芯片峰值 | HBM 容量 / 带宽 | pod 规模 | 拓扑 | 主要定位 |
|---|---|---|---|---|---|---|
| TPU v2 | 2017 | 45 TFLOPS BF16 | 16 GB / 600 GB/s | 64 | 2D torus | 第一代可训练 TPU |
| TPU v3 | 2018 | 123 TFLOPS BF16 | 32 GB / 900 GB/s | 1024 | 2D torus | 大规模训练,液冷 |
| TPU v4 | 2020 部署 / 2023 论文 | 275 TFLOPS BF16 | 32 GB / 1.2 TB/s | 4096 | 3D torus + OCS | 光重构拓扑,SparseCore |
| TPU v5e | 2023 | 197 TFLOPS BF16 | 16 GB / 819 GB/s | 256 | 3D torus | 推理与成本优化 |
| TPU v5p | 2023 | 459 TFLOPS BF16 | 95 GB / 2.8 TB/s | 8960 | 3D torus | 最大规模训练 |
| TPU v6e Trillium | 2024 | 约 926 TFLOPS BF16 | 32 GB / 约 1.6 TB/s | 256 | 3D torus | 能效与带宽提升 |
| TPU v7 Ironwood | 2025 | 4614 TFLOPS FP8 | 192 GB / 7.37 TB/s | 9216 | 3D torus | 第一代推理专用 |
| TPU v8t | 2026 | 未公开绝对值 | 共享 2 PB / superpod | 9600 | Virgo + OCS | 训练 superpod |
| TPU v8i | 2026 | 未公开绝对值 | 288 GB / 8.6 TB/s | 未公开 | Boardfly | 智能体推理 |
编程模型:StableHLO、Mosaic 与 Pallas
理解了硬件,还要理解软件怎么驱动它。TPU 的编程栈有三个层次,理解这三层是读懂 TorchTPU 的前提。
最上层是 StableHLO。它是机器学习算子的高层中间表示(IR),采用 SSA(静态单赋值)形式,所有张量值一旦构造就不可变,写操作会生成新值。StableHLO 可以理解为 TPU 世界的”可移植汇编前端”:JAX、PyTorch、TensorFlow 都能把计算图降到这里。
下层是 Mosaic。它是更接近硬件的低级 IR,用来写自定义 kernel,控制 tile 大小、内存空间和流水线。TorchTPU 的文档直接把 StableHLO 和 Mosaic 类比成 GPU 上的 PTX:前者是高层入口,后者是底层入口。真正的 TPU 指令集是私有的,不对外公开。
两层之下是 PjRT 运行时。一个 C++ 程序通过 PjRT Client 访问本地 TPU:把 MLIR 编译成 TPU 可执行文件、启动执行、在主机和 TPU 之间拷贝数据。TPU 的执行是异步的,CPU 通过等待 PjRTBuffer 来取结果。
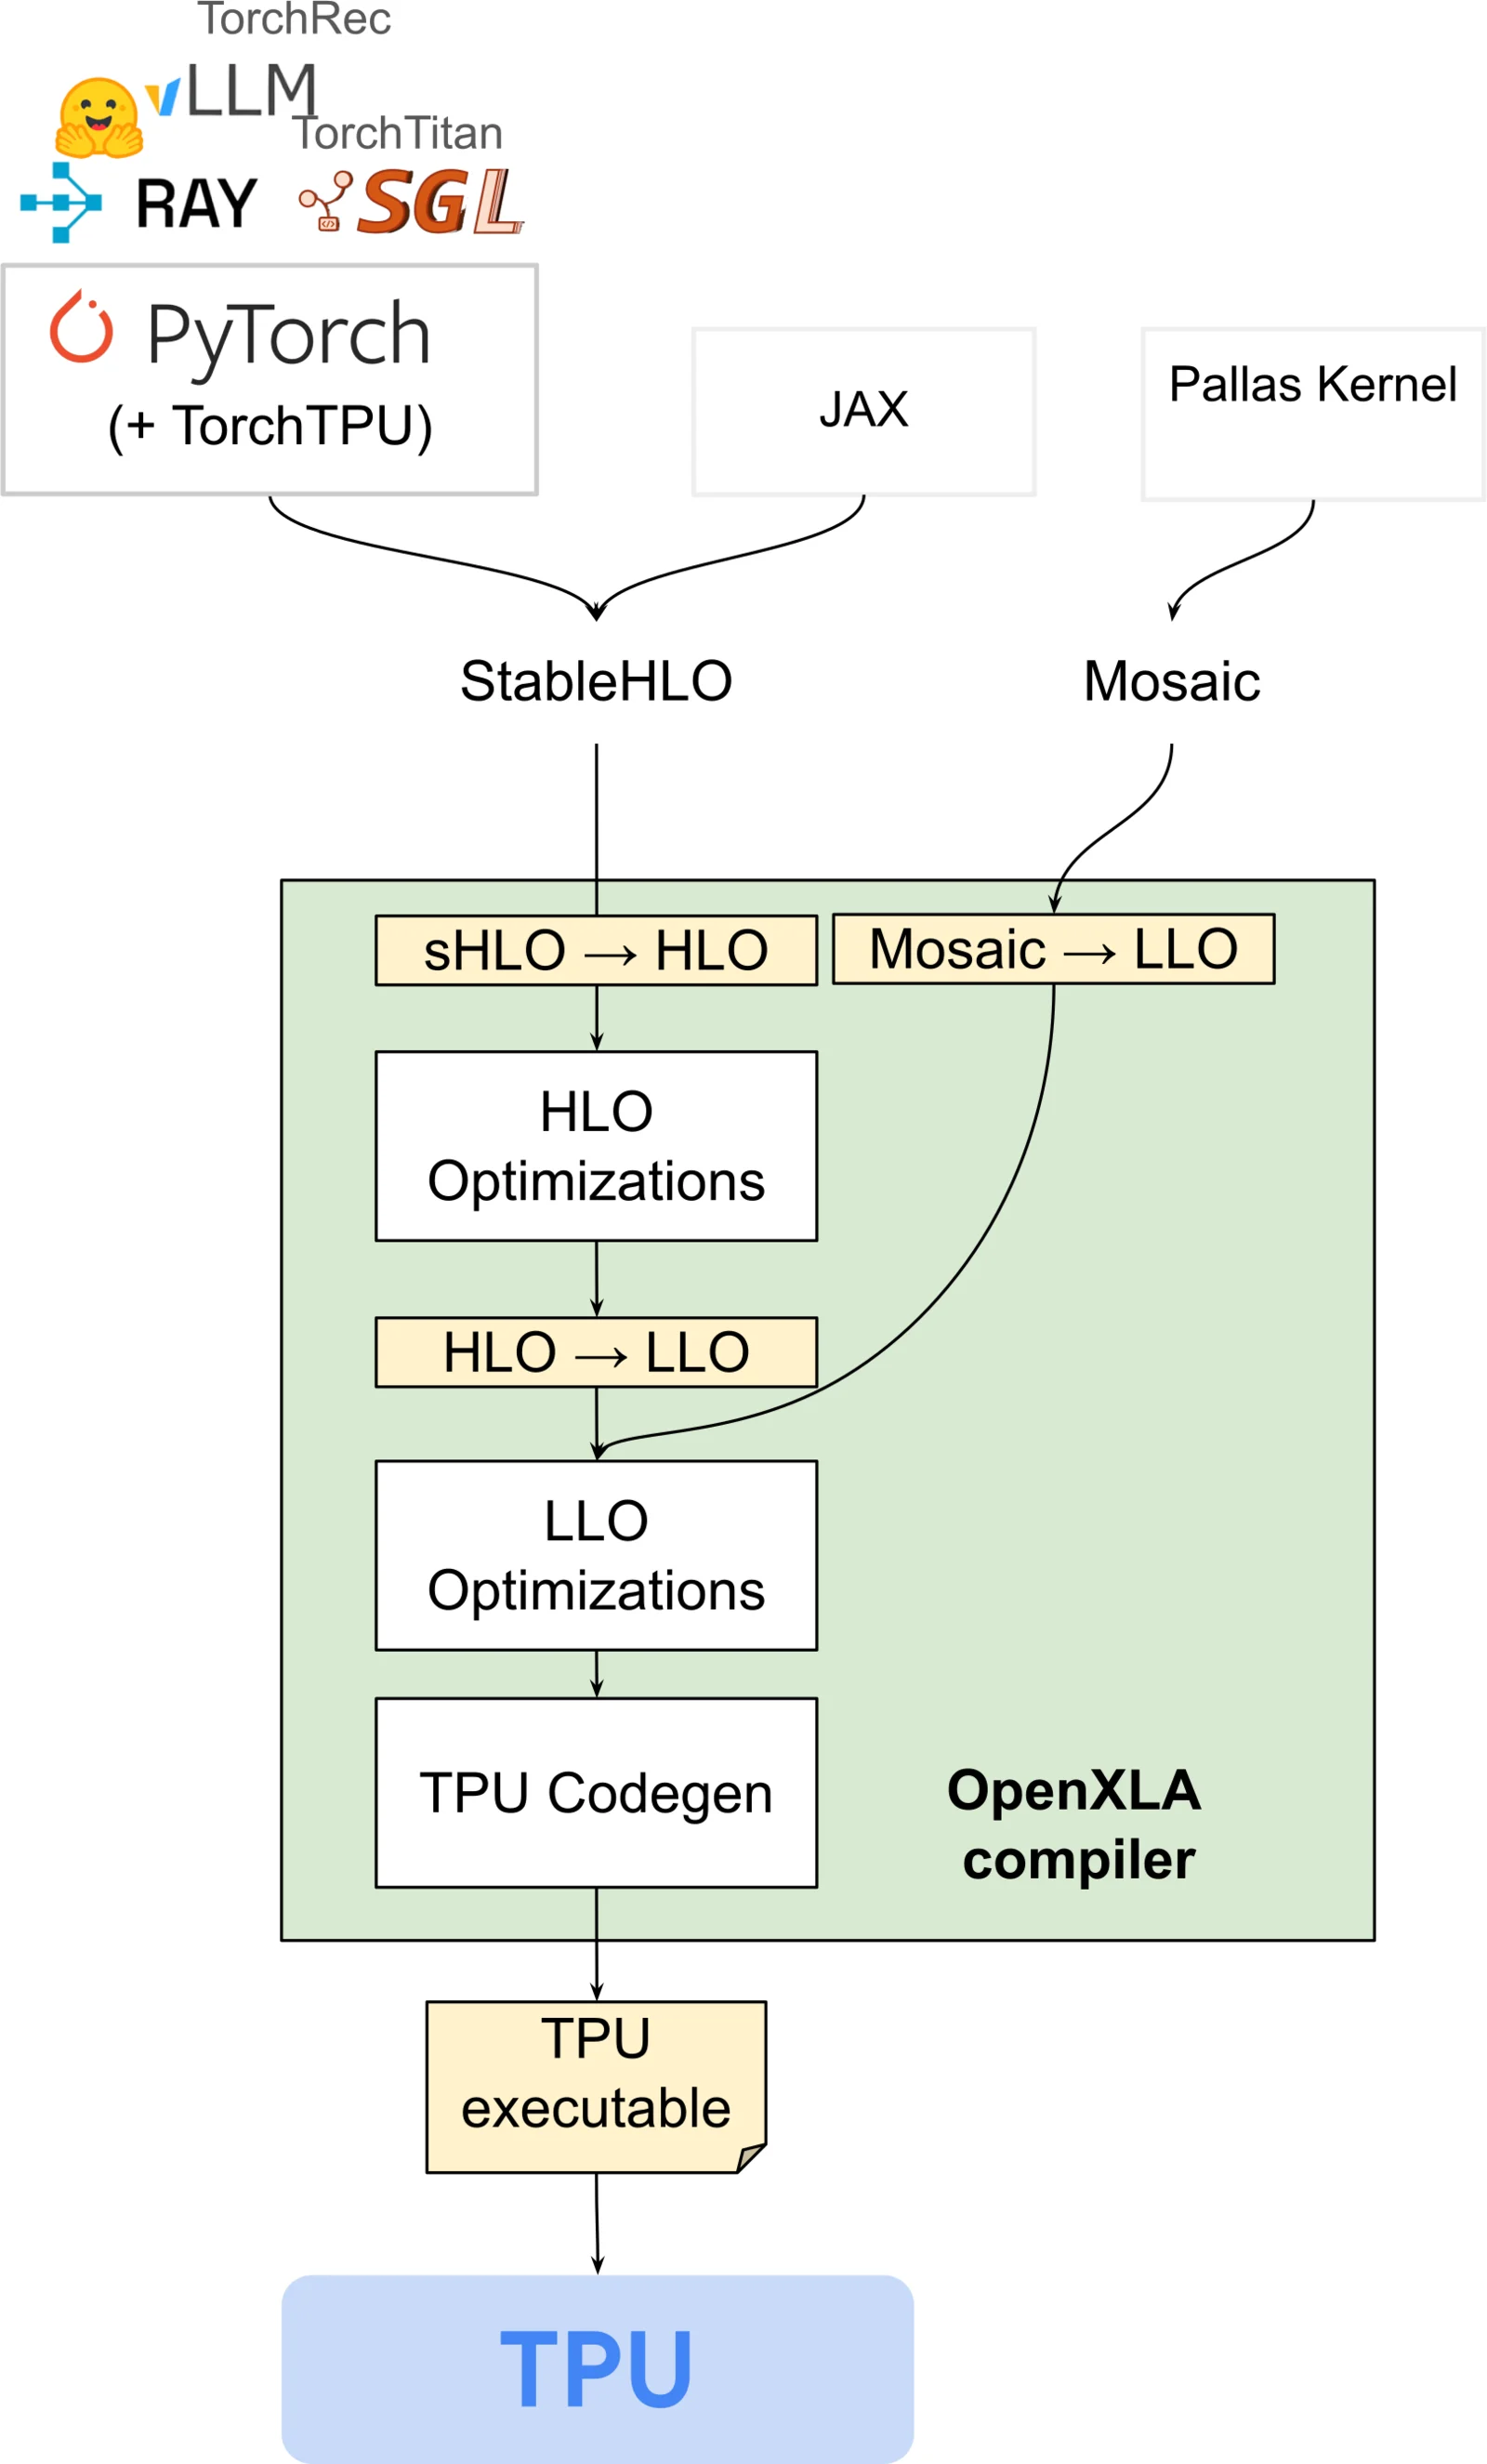
上图来自 TorchTPU 论文,画的是 PyTorch 如何落到 XLA 栈上。左侧是 PyTorch 生态的入口:TorchTitan、TorchRec、Ray、vLLM 等框架;中间是 TorchTPU 提供的 Pallas kernel 接口;再往下分成两条路径:JAX 与 PyTorch 都先降到 StableHLO,自定义 kernel 则走 Mosaic。两类 IR 进入 OpenXLA 编译器,经过 HLO 优化、LLO 优化和 TPU codegen,最终生成 TPU 可执行文件。这张图解释了 TorchTPU 的定位:它不是另起一套运行时,而是把 PyTorch 的计算图接到已有的 XLA 编译链上,从而复用 Google 十几年积累的布局选择、融合和集合通信调度能力。
TPU 编程模型的四个硬约束
形状编译期已知。XLA 传统上要求张量形状在编译时完全确定,这样才能做静态布局和融合。PyTorch 的动态形状(比如变长序列)在 TPU 上会触发重编译,代价很高。
TensorCore 是单线程的。一颗芯片上的 TensorCore 同一时刻只能执行一条指令流,想并行只能靠多个 TensorCore、SparseCore 和 DMA 引擎。这和 GPU 上”多开几个 kernel 就能填满 SM”的直觉相反。
集合通信是 HLO 算子。TPU 没有 NCCL 那样的独立通信库,all-reduce、all-gather、all-to-all 都表达成 StableHLO 算子,由 XLA 编译器决定插入位置和重叠方式。好处是编译器能看到通信和计算的全貌,坏处是通信的语义必须和计算图一起编译。
稀疏操作可以卸载到 SparseCore。XLA 可以自动把 gather/scatter 和集合通信放到 SparseCore 上,也可以通过 MLIR 注解手动指定。SparseCore 能执行完整的 StableHLO 算子集,只是在稠密数学上不如 TensorCore,在稀疏数学上更快。
Pallas:在 TPU 上写 kernel 的正确姿势
Pallas 是 JAX 提供的内核语言,用来在 TPU 上写自定义 kernel。它的编程模型和 CUDA 差别很大:
- 输入输出默认在 HBM,kernel body 里操作的是通过
BlockSpec切出来的块。 - 块形状有硬约束:最后两维必须分别能被 8 和 128 整除,或者等于整体数组的对应维度。这个约束来自 MXU 的 8×128 数据通路。
- 用
pltpu.emit_pipeline可以把数据预取到 VMEM,让 DMA 和计算重叠。 - grid 默认按字典序串行执行,相邻迭代复用输入切片时 HBM 传输会被跳过。
这些约束直接塑造了 TPU 上的 kernel 写法。比如一个矩阵乘 kernel 通常用三维 grid:前两维切左右操作数,最后一维切归约维度;归约维度必须放在最后,因为输出窗口不随它变化,可以把输出引用当成累加器。这种”把归约放在最内层、让输出常驻”的模式,和 GPU 上按 tile 并行、每块独立算部分和的写法在思路上是相通的,但调度方式完全不同。
TorchTPU:为什么需要一个新的 PyTorch 后端
PyTorch/XLA 的问题
Google 在 2020 年就做过 PyTorch 上 TPU 的集成,叫 PyTorch/XLA。它基于 Lazy Tensor:PyTorch 的算子先被记录成一张待编译的图,攒到一定规模再交给 XLA 编译执行。
这套方案能跑,但工程上有四个硬伤:
- 需要在源码里显式标出可编译区域,侵入性强。
- 编译延迟严重,形状一变就重编译,交互式开发体验很差。
- 不支持 PyTorch 原生的 eager 执行,调试困难。
- 对新出现的分布式原语跟进慢,PyTorch 生态里的 FSDP、DTensor、TP 等特性经常滞后。
后来的 TorchAX 走的是另一条路:把 PyTorch 程序翻译成 JAX 程序,再借 JAX 的 TPU 后端执行。这相当于把 PyTorch 塞进 JAX 的工作方式里,仍然不是”PyTorch 原生”。
TorchTPU 的设计原则
TorchTPU 于 2025 年中在 Google 内部启动,与 Meta 的 PyTorch 团队合作,2026 年 10 月在 PyTorch Conference 上开源。它的目标写在论文和博客里,可以归纳成三组原则。
PyTorch 公民身份:运行时不把 JAX 作为依赖(Pallas 和 Tokamax kernel 仍以 JAX 编写,但只在需要自定义 kernel 时引入);eager 模式要扎实;torch.compile 走 TorchDynamo 而不是 Lazy Tensor;在 PyTorch 栈的最底层(Process Group API)提供 TPU 集合通信,从而支持 DDP、FSDP、DTensor 等分布式惯用法;无缝接入 PyTorch 生态。
以用户为中心:把模型迁到 TPU 应该只需要把 model.to("cuda") 改成 model.to("tpu")。当然,这样改完不一定能拿到峰值性能,因为模型的形状、切分和算子可能偏向 GPU 架构,但至少要能开箱跑起来。错误信息要可操作,工具要复用 PyTorch 社区已有的东西,比如 torch.profiler、DTensor、Ray。
推进技术水平:要能和 GPU 上的 PyTorch 在大规模负载上竞争;为 eager 执行引入 JIT 编译路径,缩小逐算子执行和编译执行之间的差距;引入 bounded dynamism,避免形状变化触发 XLA 重编译,并探索可预编译的动态 TPU kernel。
这组原则里最关键的一条是”运行时不把 JAX 当作依赖”。它意味着 TorchTPU 不是 JAX 的包装层,而是一个独立的 PyTorch 后端,直接和 XLA、PjRT 打交道。这也解释了为什么它要自己实现编译缓存、视图语义、流和分布式,而不能简单复用 JAX 的现成机制。
截至论文写作时,TorchTPU 支持约 450 个 Aten 算子,覆盖主流深度学习架构所需的前向和反向核心算子;验证了 Hugging Face Transformers v5、Diffusers、Kernels 的开箱执行;接入了 vLLM、SGLang、TorchTitan、Ray、TorchRec。
Eager 执行:DeferAndFuse 与物化点
三种 eager 模式
TorchTPU 在 PyTorch 的 dispatcher 里注册了一个新的 C++ 后端,设备类型是 PrivateUse1。张量存储用 c10::StorageImpl 加 c10::UniqueVoidPtr 实现,指向 TPU 侧的对象。这样 PyTorch 的所有上层机制,包括 autograd、view、分布式,都能照常工作。
eager 执行有三种模式,用环境变量或上下文管理器切换:
- Strict(默认):一次派发一个 Aten 算子,算子在 TPU 上异步执行,CPU 不等结果。这等价于 GPU 上的普通 eager 执行。
- Debug:设置
TORCH_TPU_LAUNCH_BLOCKING=1,一次派发一个算子,但 TPU 执行与 CPU 同步。慢,用于调试,相当于 CUDA 的CUDA_LAUNCH_BLOCKING,还额外开启边界检查。 - DeferAndFuse:设置
TORCH_TPU_DEFER_AND_FUSE=1,把多个 Aten 算子延迟并融合成更大的块。这是 TorchTPU 引入的 eager 与编译混合模式,官方说法是比 Strict eager 快 50% 以上,同时因为融合减少了临时张量,峰值 HBM 占用更低。
DeferAndFuse 是整套设计里最有意思的部分。它的工作流程是:
- dispatcher 收到一个算子调用,比如
aten::mul.out,TorchTPU 不立即执行,而是创建一个 Deferred Op。这个对象里包含一个 StableHLO builder,调用它能生成实现该算子语义的 StableHLO 函数;还包含静态参数(比如 batch norm 的 training 标志和 momentum),用于计算缓存键。 - 返回一个新的
at::Tensor,它的StorageImpl通过间接层指向这个 Deferred Op,而不是指向真实的 HBM 缓冲。 - 后续算子继续以同样方式追加,形成一段延迟区域。
- 当遇到物化点,比如
.to("cpu")、.item(),或者重复算子启发式判定需要提前物化时,TorchTPU 分析从延迟区域到目标张量的依赖子图,做活跃性分析,决定哪些算子需要物化。有副作用的算子(比如集合通信)必须保留,且顺序不能变。 - 为待物化的子图计算编译缓存键,查缓存;命中就直接派发可执行文件,未命中就用线程池异步编译。
- 等 TPU 结果就绪,把数据从 HBM 拷回 CPU 对应的存储。
这个设计的巧妙之处在于,它把”什么时候编译”的决定权从用户手里拿走,交给运行时。用户写的仍然是普通 PyTorch 代码,TorchTPU 在背后把一段算子序列攒成一张图,编译一次,后续重复执行直接命中缓存。对于 Transformer 这种结构重复的负载,几轮迭代之后缓存就热了,CPU 侧的 tracing 和派发会跑在 TPU 执行前面,形成流水。
编译缓存的三层结构
XLA 编译很贵,缓存是性能的生命线。TorchTPU 的编译缓存分三层:
- Tier-1:进程内内存缓存,同一进程内共享,最快,始终开启。
- Tier-2:机器内共享内存,跨进程共享,多设备训练和推理时有用,分布式程序默认开启,单设备默认关闭。
- Tier-3:持久化缓存,后端是远程文件系统(比如 Google Cloud Storage),跨主机、跨程序、跨重启复用,默认关闭,需要显式指定共享存储路径。
缓存键不是 StableHLO 图本身,而是三个 64 位整数组成的 192 位元组:
- shapeless key:捕捉计算图的结构,不含张量尺寸。
- dimensions key:捕捉张量的具体尺寸。
- compile options key:捕捉传给 XLA 编译器的选项,以及 TorchTPU、libtpu、PjRt 运行时的版本。
前两个合称 graph key。为什么要拆成 shapeless 和 dimensions 两部分?因为很多模型的结构完全一样,只是 batch 或序列长度不同。分开之后,结构相同的图可以复用同一份编译产物描述,尺寸变化只需要重算 dimensions key,缓存命中率更高。192 位的键空间也足够大,官方认为实际中不会碰撞。
视图语义与空张量
PyTorch 的张量是”指向一段线性字节数组的指针 + stride 元数据”,多个张量可以共享同一段存储,原地写会互相可见。StableHLO 是纯函数式的,所有值不可变,物理布局由编译器决定,不支持直接操作 stride。
这个语义鸿沟必须填平,否则大量 PyTorch 代码在 TPU 上会直接不工作。TorchTPU 的做法是 view decomposition(视图分解)加 view inversion(视图反演),再配合延迟算子:把复杂的视图操作拆成一组基本变换,在物化时反向应用,保证写入落到正确的逻辑位置。这样连”拼接参数数组用于分布式训练”这种在 GPU 上很常见的模式,也能在 TPU 上原生支持。
空张量是另一个例子。StableHLO 的 SSA 语义意味着 torch.empty() 不能在 TPU 上分配一块未初始化内存。TorchTPU 的处理是:返回的 at::Tensor 关联一个”填充 NaN”的 Deferred Op。如果这个张量后续从未被读取,NaN 就永远不会被物化,等于零成本。这个细节看起来小,但它决定了 torch.empty() 在 TPU 上不会变成一个昂贵的真实分配。
流与 SparseCore
PyTorch 在 GPU 上用 stream 表达并发:计算、集合通信、主机与设备的数据传输可以同时进行。TPU 上不能简单照搬,因为 TensorCore 是单线程的,同一时刻只能跑一个计算。
TorchTPU 仍然实现了 PyTorch 的 Stream API,但语义做了调整:
- 数据传输可以走 DMA 引擎,和 TensorCore 上的计算并行。
- 可以把一个 stream 手动绑定到 SparseCore。这样一个流上的算子会在 SparseCore 上执行,和 TensorCore 上的主计算并行。
- SparseCore 能执行完整的 StableHLO 算子集,只是在稀疏数学上更快、在稠密数学上更慢。
这条设计对推理很有价值。MoE 的 all-to-all、嵌入查表、top-k 这类操作可以放到 SparseCore 上,和 MXU 上的专家矩阵乘重叠,等于凭空多出一条并行的计算通道。后文讲 vLLM-TorchTPU 的 MoE 优化时会看到,这条通道是整套方案能跑起来的关键。
编译模式与 bounded dynamism
torch.compile 走 Dynamo,而不是 Lazy Tensor
TorchTPU 的编译入口和其他后端保持一致:
compiled_model = torch.compile(model, backend="tpu")Dynamo 把模型 trace 成 torch.fx.GraphModule,连同示例输入一起交给 TorchTPU 的 Dynamo 后端。后端在 eager 模式下把整张图 trace 一遍,所有算子都处于延迟状态、不真正执行,从而为整个 FX 图生成一个完整的 StableHLO 程序,编译成 TPU 可执行文件,最后返回一个包装该可执行文件的 Python 可调用对象。
论文里讨论了另一条路:给 TorchInductor 写一个 TPU 后端,把 Inductor IR 降到 Pallas 或 Mosaic。他们最终没有走这条路,理由有三条:复用 eager 模式已经建好的编译基础设施成本最低;XLA/TPU 编译器经过 Google 多年打磨,稳定性和性能更有保障;Inductor 的成功很大程度绑定在 Triton 上,而 Triton 不容易移植到 TPU 架构。
这个选择很务实。它意味着 TorchTPU 的编译路径本质上是”把 FX 图降成 StableHLO,交给 XLA 编译”,而不是自己造一套 kernel 生成器。代价是 TorchTPU 必须接受 XLA 的静态形状假设,于是就有了 bounded dynamism。
bounded dynamism 要解决什么问题
XLA 传统上要求静态形状,因为只有形状固定,才能做最优的硬件布局和融合。实际负载里 batch 大小和序列长度经常变化,过去常见的做法是手动 pad 到固定长度、算完再 slice 回来。
手动 pad 有四个问题:代码侵入性强;不同算子需要不同的填充值,torch.sum 要填 0,torch.mul 要填 1;即使主函数被 pad 成静态形状,pad 和 slice 本身仍然接收变长输入,单独编译这些算子照样会重编译;完全不 pad 的话,每遇到一个新形状就整图重编译,性能直接崩掉。
bounded dynamism(有界动态形状)的思路是:在编译期给出每个动态维度的上界,运行时允许实际尺寸在上界内变化,图只编译一次。
编译流程分四步,下图是论文给出的完整数据流:
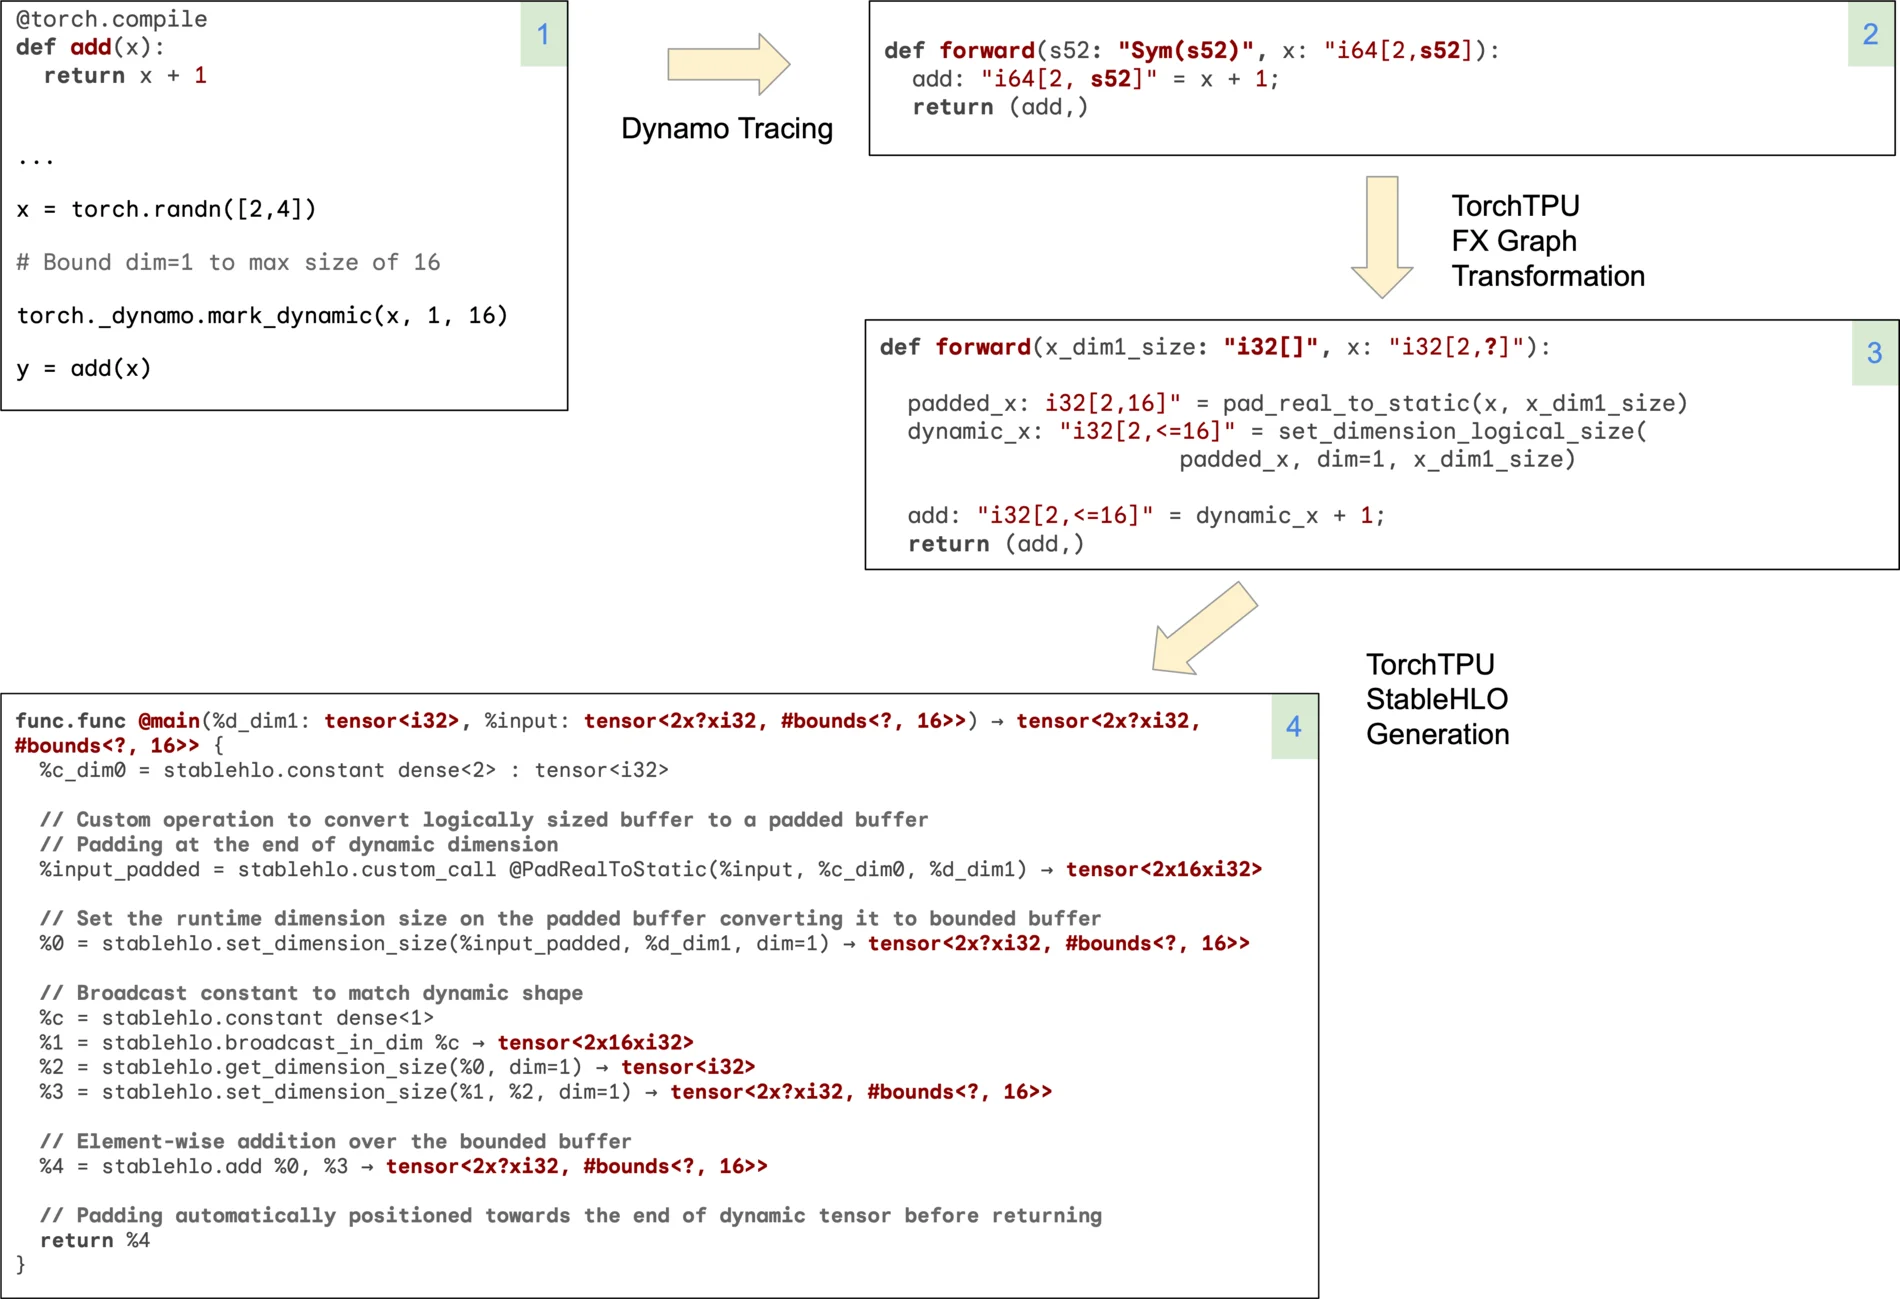
第一步,用户用 torch._dynamo.mark_dynamic 标出动态维度并给出上界,比如 mark_dynamic(x, 1, 16) 表示第二维最大 16。
第二步,Dynamo 符号化 trace,动态维度在 FX 图里表示成符号整数 SymInt,例如 s52。
第三步,TorchTPU 的动态编译后端拦截 FX 图,做三件事:把 SymInt 参数替换成一个标量张量占位符,比如 x_dim1_size: i32[],用来在运行时承载真实尺寸;插入 _pad_real_to_static,把输入张量从 i32[2, ?] 填到上界缓冲 i32[2,16];插入 _set_dimension_logical_size,把填充后的静态缓冲和真实尺寸关联起来,得到一个有界动态张量 i32[2,<=16]。
第四步,降成 StableHLO。因为填充逻辑已经编进模块内部,这个模块可以接受上界以内的任意动态输入,不需要重新编译。
运行时的处理同样精巧。XLA 的 PadRealToStatic 把填充放在动态维度的末尾,生成静态有界缓冲;计算在整个有界缓冲上统一执行,XLA 的 DynamicPadder pass 会把填充区域的值重置成代数单位元,保证不影响结果;中间缓冲保留逻辑尺寸信息,输出张量的填充同样在末尾,返回给 PyTorch 时只需更新元数据里的尺寸,不需要真的做切片。
这套机制的意义不只是省编译时间。它让 TorchTPU 能支持 SymInt,从而支持 torch.compile 的动态形状路径;它也避免了手动 pad 带来的语义错误,因为填充值和重置逻辑由编译器统一处理,而不是散落在用户代码里。
需要说明的是,截至论文写作时,在 TPU 机器上调用 torch.compile 会自动设置 dynamic=False,因为 bounded dynamism 还没有默认开启。这是 TorchTPU 当前的一个明确限制,也是路线图里的优先项。
精度、kernel 与分布式
三档精度模式
TPU 的 MXU 原生做 BF16 输入、FP32 累加;VPU 做完整的 IEEE-754 FP32 标量运算。TorchTPU 把 PyTorch 的精度 API 映射到这套硬件能力上,提供三档:
| 模式 | 乘法输入 | 累加 | 相对开销 | 适用场景 |
|---|---|---|---|---|
| medium(默认) | BF16 | FP32 | 1x | 绝大多数深度学习负载 |
| high | BF16 高低分量拆分,3 次交叉项 | FP32 | 约 3x MXU 计算 | 出现精度相关收敛问题时 |
| highest | 全交叉项,6 次 pass | FP32 | 约 6x MXU 计算 | 需要接近 IEEE FP32 精度时 |
medium 是默认值。它的逻辑是:单次 BF16 乘法配合 FP32 累加,对几乎所有的深度学习负载都够用;强行用更高精度,MXU 的算力会被多趟分解吃掉。
high 和 highest 的实现方式是算法分解,不是硬件支持。high 把每个输入拆成高位和低位两部分,计算三个交叉项,用 3 倍的计算量换回接近 FP32 的精度;highest 计算全部交叉项,用 6 倍计算量逼近完整 FP32。这是 TPU 和 GPU 的一个本质差别:GPU 有独立的 FP32/TF32 单元,高精度模式只是降速一到两倍;TPU 没有独立的 FP32 矩阵单元,只能靠多趟 BF16 计算模拟,代价是三到六倍。
TorchTPU 还提供了线程局部的 torch.tpu.precision 上下文管理器,可以只对数值敏感的那几层开高精度,而不是全局降速。这个设计很实用:大部分层用 medium,LayerNorm、softmax 或者输出头附近用 high,整体开销可控。
三种写 kernel 的方式
TorchTPU 把 kernel 分成两类:PyTorch 框架自带的(比如 F.scaled_dot_product_attention)和用户自定义的。对后者,它提供了三条路径:
Pallas + jax_op:用 Pallas 写 TPU kernel,再用 torch.tpu.pallas.jax_op 包装成 PyTorch 函数。包装后的函数可以直接在 TPU 张量上调用,eager 和 torch.compile 都支持。这是生产可用的路径。
Tokamax:Google 维护的高性能 TPU kernel 库,提供分组矩阵乘、token gather/scatter、paged attention、Gated DeltaNet、Kimi Delta Attention、MLA、TopK 等实现。kernel 本身用 JAX/Pallas 写,但通过 torch.tpu.pallas.jax_op 暴露成原生 PyTorch API,并配套自动调优、基于 XProf 的低开销 benchmark 和回归测试。
Helion:实验性路径。用户用 Helion DSL 写 kernel,指定 backend="pallas",同一份 PyTorch 风格的 DSL 可以面向多种加速器。这是把 GPU kernel 迁到 TPU 的一条折中路线。
这三条路径覆盖了不同的工程阶段:想快速验证,用 Tokamax 的现成 kernel;想深度优化,用 Pallas 手写;想复用 GPU 侧的 kernel 代码,试 Helion。
分布式:把集合通信做进 Process Group
TorchTPU 没有另造一套分布式 API,而是在 PyTorch 的 Process Group 层实现 TPU 后端:继承 c10d::Backend,注册成 tpu_dist。这样 eager 和编译模式下的集合通信都能被拦截,DTensor、FSDPv2、SimpleFSDP、FairScale 这些框架可以照常工作。
实现上有几个 TPU 特有的坑,每一个都值得单独说。
初始化顺序不同。GPU 上一个 torchrun 启动的进程能看到主机上所有设备,可以先 model.to(f"cuda:{local_rank}") 再 init_process_group。TPU 上一个进程只能看到一个设备,也不知道主机上挂了几颗芯片。所以初始化之前,进程必须知道三件事:要跑分布式、world size 是多少、TPU 类型是什么,因为类型决定拓扑。TorchTPU 用两个环境变量承载这些信息:TORCH_TPU_TOPOLOGY 给出 slice 的物理网格形状,比如 2,2,1;TORCH_TPU_SLICEBUILDER_ADDRESSES 给出每台设备的地址和端口,用来构造 ICI 网络。
默认进程组的知识。torch.distributed.all_reduce 只接收当前子组;而 stablehlo.all_reduce 需要知道所有子组的划分,即使当前进程不在某些子组里。这就是为什么 TorchTPU 必须把整个默认进程组的信息传进编译后的模块。
MPMD 与集合通信不一致。TPU 栈历史上是为 SPMD 设计的:用户写一份单机程序,Shardy 负责在几千颗芯片上切分,XLA 负责在正确的位置插入集合通信。PyTorch 生态不是纯 SPMD:用户可能写 if rank == 0,DTensor 在维度不能整除时也会产生不均匀切分。不同 rank 生成不同的 StableHLO 模块时,sync flag ID 和缓冲偏移可能对不上,导致死锁或内存损坏。
TorchTPU 的默认对策是 Skinny Collectives:把每个集合通信算子单独编译成一个”瘦”StableHLO 模块,保证各 rank 的缓冲和同步 ID 一致。这能保证正确性,但代价是 XLA 无法把通信和计算重叠,端到端性能损失 30% 到 40%。正在做的优化是把这些瘦模块放到绑定 SparseCore 的独立 stream 上,让它们和 TensorCore 上的数学重叠,官方预期能收回大部分损失。
如果用户确定某段代码是 SPMD 的,可以用 @spmd_safe 装饰器标出来。在 torch.compile 下,这会让 TorchTPU 不在集合通信周围插入 graph break,从而生成一个包含通信的大模块,让 XLA 自由移动集合通信、最大化重叠。另有一条更保守的路径是编译握手(handshake):编译前在所有副本之间做一轮共识,确认 FX 图完全一致,再放开 graph break。
拓扑感知的 mesh。TorchTPU 提供 torch.tpu.topology_aware_mesh,根据物理 ICI 拓扑计算最优的 rank 排布。原则是把通信最重的并行维度放到最快、最连续的 ICI 维度上:张量并行每层都要 all-reduce 和 reduce-scatter,应该放在同一 tray 内一跳可达的芯片上;上下文并行和专家并行的 all-to-all 放在 slice 内的局部轴;FSDP 的 all-gather 和 reduce-scatter 也放在局部轴;纯数据并行只在每一步同步梯度,可以放到跨 slice 的 DCN 上。
这个映射不是可选的优化,而是性能的必要条件。TPU 的 ICI 和 DCN 带宽差一个数量级,把张量并行放到 DCN 上,训练会直接慢到不可用。
分布式 Pallas kernel。TorchTPU 支持在 Pallas kernel 里直接用 pltpu.make_async_remote_copy 做芯片间 RDMA,不经过主机 CPU。这可以写 Ring Attention、自定义 all-to-all、流水并行的阶段传递、halo exchange 这类点对点通信 kernel,并像普通 PyTorch 函数一样调用。
这里有一个曾经踩过的坑:Pallas 的底层通信按硬件 device ID 路由,而不是 PyTorch rank。当硬件 ID 和 rank 顺序不一致时,环形通信会发到错误的物理设备,隔离子组还会因为分区数不匹配而失败。TorchTPU 后来加了映射层来对齐这两套编号。
推理栈上的实战:vLLM-TorchTPU 的三项硬优化
TorchTPU 不只是让 PyTorch 模型能跑,它还要让推理框架在 TPU 上跑到有竞争力的水平。论文里的 InferenceX 案例给出了三个很有代表性的优化,每一个都体现了 TPU 的硬件特性。
MoE 层写成一个 SPMD 程序
在 DP8 + EP 的配置下,vLLM 原本的 MoE 层流程是:每个 rank 把 token gather 到所有 rank,路由,permute,跑两次分组矩阵乘,combine,再 reduce-scatter 回去。在 prefill 为主的步骤、并发 256 时,这个 reduce-scatter 每层要 1190 微秒,占全部设备时间的 22%,而且这段时间没有其他计算在跑。
TorchTPU 的做法是把整个 MoE 层写成一个跨 8 个 TensorCore 的 SPMD 程序:每个 TensorCore 把自己的行量化成 FP8,在 SparseCore 上异步 all-gather;同时用 Pallas top-k 选出自己 token 的专家,通过第二次很小的 all-gather 交换专家索引和行缩放因子;然后用一个 Pallas kernel,按索引取出路由到本地的行,跑每个本地专家的两次矩阵乘;结果按 FP8 加逐行 scale,用 make_async_remote_copy 直接推到拥有该 token 的 TensorCore,推送和后续专家的矩阵乘重叠;最后每个 TensorCore 按路由分数加权求和收到的行。
这一套替换掉了原来的一串操作:路由行的 argsort、SparseCore 上的 permute 和 combine、两次分组矩阵乘、combine 的 reduce-scatter。它之所以成立,前提是 TPU 允许把通信 kernel 和计算 kernel 放在不同单元上并行执行,这正是 SparseCore 和异步 DMA 的价值。
sequence-on-lane:为 32 位字宽重排 KV 缓存
TPU 的向量单元按 32 位字操作,KV 缓存如果按标准布局排,一个 32 位字里会塞进多个 head 的 K 和 V。在 8 路张量并行下,每个核心只持有模型两个 KV head 中的一个,于是每个字有一半是填充:每 token 每核心 1024 字节缓存,实际只有 512 字节数据。
sequence-on-lane 把一页的 token 排在 128 条 lane 上,把 head 维度放在 sublane 上。这样一个字里是同一个 token 的四个 FP8 值,没有浪费。效果是 KV 内存减半,decode 每步读取的 KV 字节也减半。
这个优化非常能说明”硬件决定了数据布局”这件事。同一个 KV 缓存,在 GPU 上按 head 维度连续排是自然的,因为访存按 128 字节事务合并;在 TPU 上按 lane 排才是自然的,因为向量单元按 32 位字和 lane 组织。布局错了,一半带宽就浪费在填充上。
Gated DeltaNet:把递推改写成矩阵乘
Qwen3.5 的 60 层里有 45 层用 Gated DeltaNet,它每个 head 维护一个固定的 128×128 状态,而不是不断增长的 KV 缓存。decode 每步都要读写所有序列的状态;在并发 64 时,把 kernel 里的算术全部去掉只能快 6%,说明它完全是访存受限的。prefill 则是逐 token 的顺序递推,矩阵单元大量空转。
TorchTPU 用一个 Pallas kernel 把卷积和递推融合,decode 时批量处理多个序列,prefill 时按 64 token 分块,尽量改写成矩阵乘。状态和 KV 缓存放在同一个分页池里,kernel 直接从池页流式读取,通过改变寻址方式原地读取递推状态,而不是先转换再读。结果是共享池没有带来吞吐损失,测试里每种配置都不低于独立缓存。
这三个案例的共同点是:它们都不是”把 GPU 代码原样搬过来”,而是针对 TPU 的执行模型重新设计数据流。MoE 利用了 SparseCore 与 TensorCore 的并行,KV 布局利用了 32 位字和 lane 结构,Gated DeltaNet 利用了 MXU 擅长矩阵乘、不擅长顺序递推的特点。
这套架构的边界
把 TPU 和 TorchTPU 放到一起看,边界同样清楚。
静态形状的遗产还在。bounded dynamism 解决了大部分变长问题,但它需要用户显式给上界;torch.compile 目前还默认 dynamic=False;超出上界的形状仍然会重编译。对推理服务来说,这意味着要么把序列长度分桶,要么接受一定比例的重新编译。
一颗芯片只能被一个用户态进程访问。这是 TPU 的硬件约束,TorchTPU 因此采用 one-process-per-device。好处是和 GPU 的 PyTorch 用法一致,坏处是 RL 训练里常见的”训练和采样共置”没法开箱支持,官方还在研究绕过办法。
MPMD 代码是脆弱的。Skinny Collectives 能保证正确性但损失 30% 到 40% 性能;@spmd_safe 能恢复性能,但要求用户真的确认代码是 SPMD 的,标错了会出难查的死锁;编译握手是更安全的路径,但还在 RFC 阶段。
算子覆盖还在补齐。约 450 个 Aten 算子覆盖了主流架构,但 FlexAttention 还不支持,TorchTitan 的案例里需要把它换成普通的 F.scaled_dot_product_attention。新模型结构出现时,TPU 侧的 kernel 支持通常晚于 GPU。
性能上限依赖手写 kernel。纯 PyTorch 代码在 TPU 上能跑,也能拿到不错的 MFU,但要接近峰值,还是得用 Pallas 或 Tokamax 的专用 kernel。论文的态度很明确:开箱即用是及格线,峰值性能要靠设备特定的优化。
这些边界并不否定 TPU 的价值,它们只是说明 TPU 仍然是一台需要专门优化的机器。它的优势在于:当负载匹配它的执行模型时,同样的功耗和成本能给出更高的吞吐;当负载不匹配时,迁移的代价会体现得非常明显。
小结
把七代 TPU 和 TorchTPU 放在一条线上,可以得到几个稳定的结论。
TPU 的演进不是简单地堆算力,而是在五个维度上反复做取舍:MXU 的规模决定峰值,HBM 的容量和带宽决定 decode 的上限,ICI 拓扑决定并行策略能跑多快,SparseCore 决定稀疏负载划不划算,数值格式决定同样的硅面积能换多少有效算力。v4 用 OCS 把拓扑变成可重构资源,v5 把训练和推理分叉,v7 明确为推理设计,v8 干脆拆成两颗芯片,每一步都是这五个维度上的重新平衡。
TPU 的编程模型和 GPU 有本质差别。它是顺序执行加超宽向量寄存器,靠 DMA、MXU、SparseCore 的异步并行而不是线程级并发;它要求静态形状,靠 XLA 做全局的融合、布局和通信调度;它的集合通信是 HLO 算子,不是独立库。理解这三点,才能理解为什么 TPU 上的 kernel 写法、数据布局和并行策略都和 GPU 不同。
TorchTPU 的意义在于,它没有试图把 TPU 伪装成 GPU,而是把 PyTorch 的语义正确地映射到 TPU 的硬件事实上:用 PrivateUse1 后端接管 eager,用 DeferAndFuse 在 eager 和编译之间找平衡,用三层编译缓存摊薄 XLA 的编译成本,用 bounded dynamism 处理动态形状,用 Process Group 层的集合通信支持 PyTorch 的分布式生态,用 SparseCore 和 Pallas kernel 打开硬件特定的优化空间。
对做推理系统的人来说,最值得记住的可能是那两个公式:峰值算力看 MXU 数量和频率,decode 吞吐看 HBM 带宽和 KV 缓存大小。所有架构选择,最终都要回到这两个约束上。
参考资料
- TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings
- TorchTPU - A Hybrid Eager/Compiled Architecture for Native PyTorch Execution on TPU
- Introducing TorchTPU
- Ironwood: The first Google TPU for the age of inference
- Our eighth-generation TPUs: Two chips for the agentic era
- Ask a Techspert: What’s the difference between a CPU, GPU and TPU?
- Writing TPU kernels with Pallas
- SparseCore Kernel Writing
- In-Datacenter Performance Analysis of a Tensor Processing Unit
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



