


TPU v1 完全拆解(一):为推理而生的领域专用架构与指令集
背景与问题定义
2015 年数据中心里的推理困境
2015 年,Google 的数据中心面临一个之前几篇文章里都没出现过的问题:神经网络推理(inference)的算力需求涨得太快了。训练可以慢慢等,但推理是用户可见的——你对着手机说一句”OK Google”,语音识别模型必须在几百毫秒内给出回答;你搜索一个词,排名模型必须在查询返回前把所有候选结果的分数算完。当时的应用对响应时间有硬性要求,尤其是 99 百分位(99th-percentile)延迟,比如语音识别要求 7 ms 以内。
问题的另一面是用量。Google 内部用 CPU 跑神经网络推理,每过几个月推理需求的算力就要翻一倍,到 2015 年,纯用 CPU 已经贵得离谱、电费高得离谱。Google 当时估算:如果继续用 CPU 扛推理负载,需要的服务器数量会让成本完全失控。唯一出路是造更快的硬件。
论文的作者团队(Norman Jouppi、Cliff Young、David Patterson 等)从架构师的视角提出了一个当时颇具争议的判断:通用处理器(CPU/GPU)的”通用”是有代价的。CPU 为了通用性,把大量晶体管花在缓存、分支预测、乱序执行、多线程这些”提升平均吞吐”的机制上;但这些机制对 99 百分位延迟几乎毫无帮助——延迟指标只看最慢的那 1% 请求,而乱序执行和缓存命中的收益是统计性的、时好时坏的。推理应用要的是可预测的低延迟,不是平均意义上的高吞吐。
这篇论文就是后来载入计算机体系结构史册的 In-Datacenter Performance Analysis of a Tensor Processing Unit,由 Google 团队发表于 2017 年 ISCA(第 44 届国际计算机体系结构研讨会),描述的是一颗 2015 年就已部署进 Google 数据中心的专用芯片——第一代 Tensor Processing Unit(TPU v1)。它是 ASIC 推理加速器的开山之作,之后的 Groq、Cerebras 以及各种 NPU 芯片都能在这颗芯片上找到思想源头。
为什么是 ASIC,而不是 GPU 或 FPGA
在设计 TPU 之前,团队其实先认真评估过两条”老路”:GPU 和 FPGA。这个取舍值得先讲清楚,因为”为什么选 ASIC”恰恰是整篇论文论证的核心。
- GPU 的问题:当时数据中心里的 GPU(NVIDIA K80)确实有很高的峰值算力,但它是为训练设计的。训练不在乎单次延迟,用大批量(batch)把吞吐拉满就行;而推理应用受延迟约束,只能用小批量。小批量意味着 GPU 的成千上万个线程并行度喂不满,显存带宽也利用不起来。论文里的实测数据很扎心:受 7 ms 延迟约束,K80 只能发挥出峰值吞吐的 37%,和 Haswell CPU(42%)差不多。也就是说,GPU 在推理场景下被延迟约束”阉割”了。
- FPGA 的问题:FPGA 灵活性高、开发周期短,但同样工艺下性能和能效都远不如 ASIC——FPGA 的查找表(LUT)和可编程互联要浪费大量晶体管。Google 有每年数以十万计的服务器规模,每多花 1 瓦电都是真金白银,这个量级下 FPGA 的能效劣势无法接受。
- ASIC 的答案:推理负载有一个 GPU/CPU 都利用不上的特点——权重(weights)是静态的。推理时不更新权重,权重从训练好的模型里一次性读进来,可以反复复用。如果专门为”读权重、做矩阵乘、写回结果”这个固定模式设计硬件,就可以砍掉所有与通用性相关的开销。
还有一个技术前提让 ASIC 这条路真正成立:量化(quantization)。推理可以用 8 位整数代替 32 位浮点。论文引用了一个关键数据:8 位整数乘法比 IEEE 754 16 位浮点乘法省 6 倍能量、省 6 倍面积;整数加法更是省 13 倍能量、38 倍面积。8 位乘法的功耗只有 32 位浮点的零头,这让”堆几千个乘法器”成为可能——ASIC 的设计自由度一下子打开了。
一句话总结设计动机:推理负载 = 静态权重 + 低精度整数 + 严格延迟约束,这三者共同指向一颗专用 ASIC,而不是通用处理器。
15 个月的极限开发周期
TPU 项目还有一个对理解后续所有设计决策都至关重要的背景:开发周期只有 15 个月。从设计启动到量产部署,Google 要求这颗芯片在一年多一点的时间里完成架构设计、RTL 编写、流片、验证、驱动开发和部署。这个时间约束解释了为什么 TPU 里到处是”够用就行”的取舍:
- 不支持稀疏矩阵(论文明确说 sparsity 是为了按时交付砍掉的,留给下一代);
- 没有复杂的电源管理,能效比例(energy proportionality)很差;
- 内存用现成的 DDR3 而不是当时 GPU 用的 GDDR5;
- 时钟频率只做到 700 MHz(28nm 工艺下这是保守的)。
这些”妥协”反而让 TPU 成了一台极简的推理机器——把所有资源都花在矩阵乘上。这正是领域专用架构(domain-specific architecture)的精髓:不是在所有场景下最优,而是在目标场景下做到极致。
核心思想
一句话概括
TPU v1 是一颗只做一件事的芯片:把 8 位整数矩阵乘跑到极限,其余一切都为它服务。
具体来说,TPU 的芯片上放了一个 256×256 的脉动乘法器阵列(systolic array),也就是 65,536 个 8 位乘加单元(MAC),峰值算力 92 TOPS(每秒 92 万亿次 8 位整数运算)。围绕这个阵列的,是三个”仓库”:24 MiB 的统一缓冲区(Unified Buffer,存中间结果)、4 MiB 的累加器(Accumulators,存部分和)、8 GiB 的外部权重内存(Weight Memory,DDR3,存所有模型的权重)。芯片上几乎没有任何通用处理器该有的东西——没有缓存、没有分支预测、没有乱序执行、没有多线程。控制逻辑只占芯片面积的 2%。
把三个数字放在一起感受一下:92 TOPS 峰值算力、28 MiB 片上存储、40 瓦实测功耗。作为对比,同期的 NVIDIA K80 GPU(双芯卡)单芯实测只有 2.8 TOPS,TDP 150 W;Haswell CPU 是 2.6 TOPS、145 W。也就是说 TPU 用不到 GPU 三分之一的功耗,提供了超过 30 倍的峰值算力。
为什么”确定性执行模型”是推理的王道
TPU 的一个容易被忽略但极其重要的设计哲学,是确定性执行(deterministic execution)。CPU 和 GPU 为了榨取平均吞吐,引入了大量”时间上不确定”的机制:缓存命中与否不确定、线程调度顺序不确定、访存延迟不确定。这些机制的平均收益很好,但单次执行的延迟是抖动的——有时快有时慢。
而推理服务的 SLA 盯的是 99 百分位延迟,即”最慢的 1% 请求不能超过 X 毫秒”。对 GPU 来说,为了满足 99 百分位约束,你只能保守地留出大量余量,结果就是利用率很低(前面提到 K80 只能用到 37%)。TPU 没有这些机制,指令的执行是流水线式的、可预测的:每个矩阵乘指令占用多少个周期是确定的,每次运行都一样。这种确定性让系统设计者可以放心地把利用率推到接近峰值。
论文里有个很妙的类比:TPU 与其说是 GPU,不如说更像浮点协处理器(FPU)——主机 CPU 通过指令驱动它,它没有自主调度,主机让它算啥它就算啥。这种”协处理器”模型让整机系统的延迟行为完全可预测。
硬件架构详解
整体框图:一条 256 字节宽的流水线
论文的 Figure 1 给出了 TPU 的整体框图,这是理解整颗芯片的第一张地图:
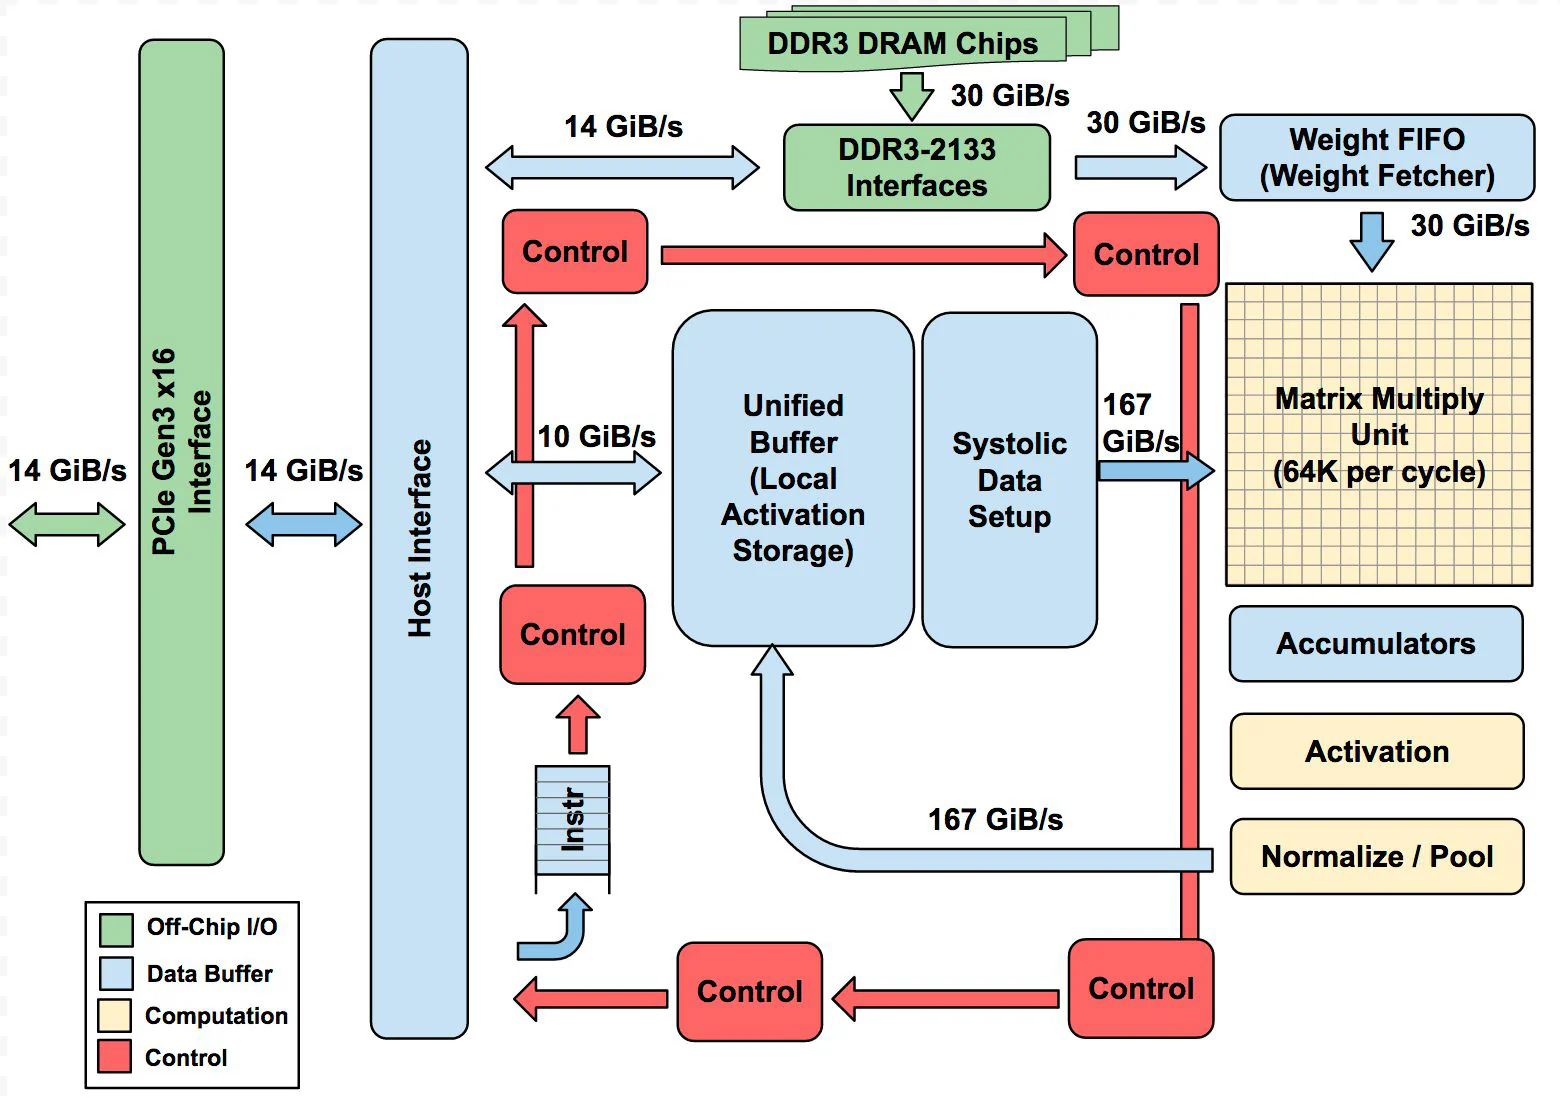
图里的数据流是这样的(从右往左看):
- 主机 CPU 通过 PCIe Gen3 x16 总线把 TPU 指令发送到片上的指令缓冲区(Instruction Buffer)。PCIe Gen3 x16 的理论带宽约 16 GB/s,这是整颗芯片与外界唯一的接口。
- 指令告诉 DMA 控制器把激活值(activations)从主机内存搬进 Unified Buffer(UB),把权重从外部 Weight Memory 搬进 Weight FIFO。
- Matrix Multiply Unit(MXU) 从 UB 读激活、从 Weight FIFO 读权重,执行矩阵乘,结果写进 Accumulators。
- Activation Unit 对累加器里的结果做非线性激活(ReLU、Sigmoid 等)和池化,写回 UB。
- 最终结果通过 DMA 写回主机内存。
芯片内部各个模块之间用 256 字节宽的总线连接——每次数据传输一拍搬 256 字节,这正好对应 MXU 每拍处理 256 个元素的节奏。
关键点:整条流水线里没有”通用”的部分。每个模块都是为矩阵乘这一个计算模式服务的,模块之间是固定的、无调度的数据流。
Matrix Multiply Unit:芯片的心脏
MXU 是 TPU 的灵魂,值得单独展开(下一篇会做源码级和时序级的深挖,这里先讲清架构层面的设计)。
- 规模:256×256 个 MAC,共 65,536 个 8 位乘加单元,全部做有符号或无符号 8 位整数乘加。
- 峰值算力:700 MHz 下,每拍完成 256×256=65,536 次乘加,峰值就是 92 TOPS(TOPS = 每秒万亿次 8 位整数运算)。
- 输入输出:每拍读入 256 个激活值、256 个权重,产生 256 个部分和(partial sum),写进下方 4 MiB 的累加器。4 MiB 累加器 = 4096 组 × 256 元素 × 32 位。
- 精度组合:8 位权重 × 8 位激活是全速;8 位 × 16 位或 16 位 × 8 位是半速;16 位 × 16 位是四分之一速。TPU 的乘加结果以 16 位(乘积)在阵列内部流动,累加用 32 位,防止误差累积。
- 权重缓存:MXU 内部能放 64 KiB 的权重块(tile),外加一份做双缓冲(double buffering)——一个块在计算时,另一个块在从 Weight FIFO 加载,用 256 拍的时间掩盖加载延迟。
- 通用性:MXU 既能做矩阵乘也能做卷积(通过把卷积展开成矩阵乘的 im2col 方式),并且是面向稠密矩阵设计的——稀疏支持被砍掉了。
为什么累加器是 4096 组?论文给出了推导:TPU 的 Roofline 模型显示,达到峰值性能需要约 1350 次运算/字节的操作强度,对应约 2048 组累加器;再翻倍到 4096,是为了让编译器能用双缓冲在跑峰值时仍然有空间。每个数字都是算出来的,不是拍脑袋定的——这是这篇论文最值得学习的地方。
Unified Buffer:24 MiB 的中间结果仓库
UB 是 MXU 的输入源和输出归宿,也是全芯片最大的存储单元,占了约三分之一的芯片面积。论文的 Figure 2 展示了芯片的物理布局(floor plan):
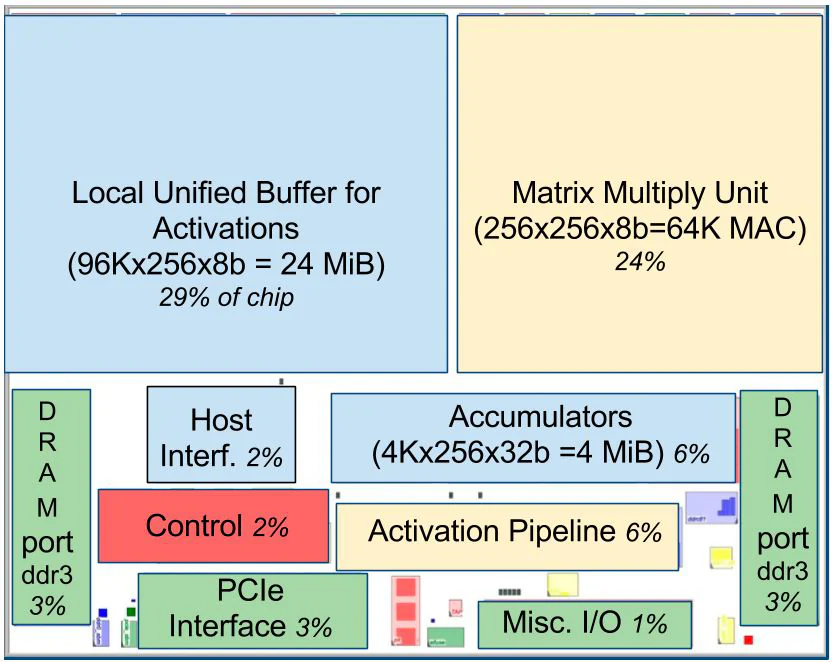
版图数据非常有信息量:
- 数据缓冲区(UB + 累加器等):37% 的 die 面积;
- 计算部分(MXU):30%;
- I/O(DDR3 控制器、PCIe 等):10%;
- 控制逻辑:只有 2%。
对比一下:CPU 里控制逻辑(分支预测、乱序窗口、调度器)轻松占到 20% 以上。2% 的控制占比意味着几乎 98% 的晶体管都在干”搬运数据和算乘法”这两件正事——这就是领域专用架构的面积效率。
24 MiB 这个数字怎么来的?两个理由:一是匹配 MXU 在 die 上的物理尺寸(布局布线能对齐);二是简化编译器——UB 大到能把整个模型的中间结果装下,编译器就不需要做复杂的缓存调度。当时选 24 MiB 是为了让 MLP 以 2048 的批量跑完整模型。
Weight Memory 与 Weight FIFO
权重存储在板载 8 GiB DDR3 里,论文称之为 Weight Memory。为什么权重单独放一块外部内存?因为推理时权重是只读的,8 GiB 足够同时放很多个模型(当时每个模型 5M–1 亿个权重,8 GiB 能装几十上百个模型),切换模型就是切换内存里的权重区域,不用重传。
权重从 DDR3 到 MXU 的路径上有一个 Weight FIFO,深度为 4 个权重块(4 × 64 KiB)。FIFO 的作用是把”从内存搬权重”和”矩阵乘计算”解耦:计算一个块的同时,后台把后面三个块预取进 FIFO。注意 TPU 的权重路径是单向的(只读),不需要写回,这也是推理专用的一个重要简化。
物理形态:插进服务器就能用
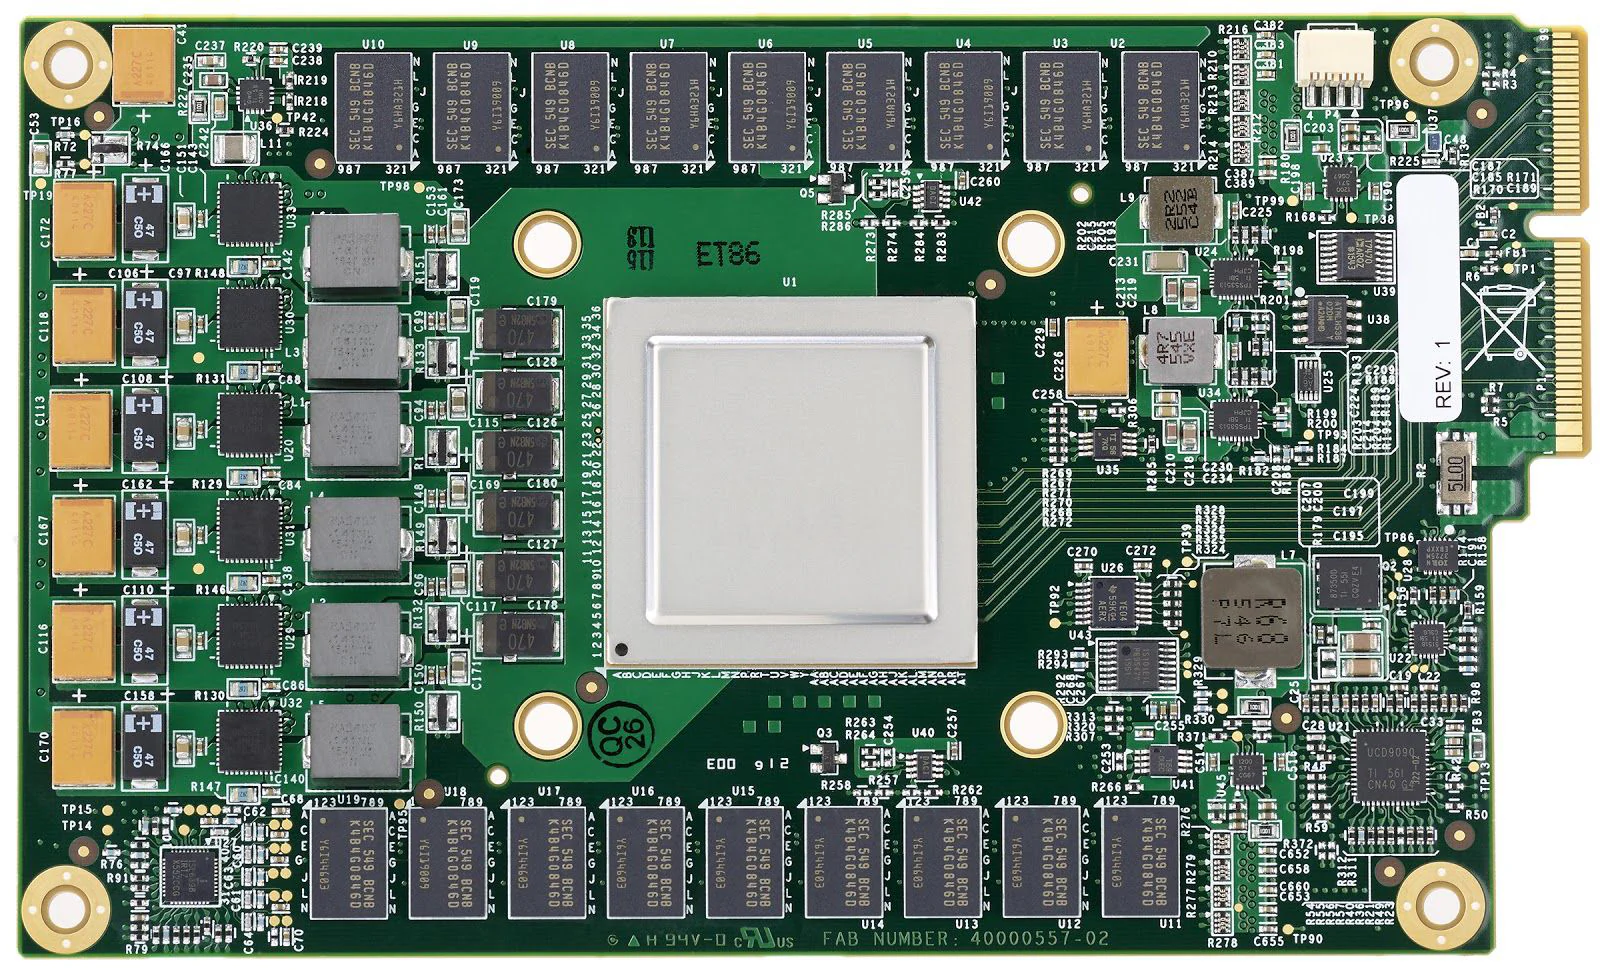
TPU 做成了一块标准的 PCIe 板卡,外形和 SATA 硬盘一样,可以插进现有服务器——这是 Google 部署策略的关键:不改造服务器,只插卡。每台服务器插 4 块 TPU,与主机 CPU 通过 PCIe Gen3 x16 通信。板载 8 GiB DDR3 就是权重内存。整卡 TDP 75 W,实测忙时功耗 40 W。
部署形态总结:
| 指标 | TPU v1 | NVIDIA K80(单芯) | Intel Haswell E5-2699 v3 |
|---|---|---|---|
| 工艺 | 28 nm | 28 nm | 22 nm |
| 时钟 | 700 MHz | 560 MHz(Boost 关闭) | 2.3 GHz |
| 峰值算力 | 92 TOPS(8-bit INT) | 2.8 TOPS(8-bit) | 2.6 TOPS(FP) |
| 片上存储 | 28 MiB | 8 MiB | 51 MiB(缓存层次) |
| TDP | 75 W | 150 W/芯 | 145 W |
| 实测忙时功耗 | 40 W | 98 W | 145 W |
| 外部内存 | 8 GiB DDR3(权重) | 12 GiB GDDR5×8 | 256 GiB DDR4 |
注意 K80 的 2.8 TOPS 是”关闭 Boost、单芯、带 SECDED”条件下的实测值,不是纸面峰值——论文为了避免”为赢跑分而配置”刻意选了保守但真实可部署的配置。
指令集设计:CISC 风格的领域专用 ISA
为什么用 CISC 而不是 RISC
TPU 的指令集设计是全文最反直觉、也最有教学价值的部分。TPU 用的是 CISC(复杂指令集),而不是 RISC(精简指令集)。为什么?
逻辑是这样的:指令是从主机 CPU 通过 PCIe 总线传给 TPU 的,PCIe 的单次传输延迟在微秒量级。如果像 GPU 那样用几千条细粒度指令,光传输指令就要占掉大量 PCIe 带宽和延迟。所以 TPU 的设计目标之一是用尽量少的指令完成尽量多的工作,每条指令都是”一句话把一整层网络算完”的粗粒度指令。
TPU 指令集总共只有大约 12 条指令,平均每条指令要执行 10–20 个时钟周期(CPI 10–20),最长的矩阵乘指令能执行几千个周期。这种”指令少而重”的风格正是 CISC 的传统——和 1970 年代的 IBM 大型机一脉相承。
五条核心指令
论文列出了五条关键指令,它们拼出了 TPU 的完整执行模型:
- Read_Host_Memory:把数据从 CPU 主机内存读到 Unified Buffer。
- Read_Weights:把权重从 Weight Memory 读到 Weight FIFO,作为 MXU 的输入。
- MatrixMultiply/Convolve:让 MXU 执行矩阵乘或卷积——从 UB 读入一个 的激活矩阵,乘以 256×256 的常量权重矩阵,输出 的部分和,耗时 个流水线周期。这条指令是整个 TPU 存在的原因。
- Activate:对累加器里的结果做非线性激活(ReLU、Sigmoid 等),输出到 UB;还能做卷积需要的池化操作。
- Write_Host_Memory:把结果从 UB 写回主机内存。
其余指令是辅助性的:主机内存读写变体、配置、两种同步指令、中断主机、调试标签、nop、halt。
以矩阵乘指令为例,看它的 12 字节编码:3 字节 UB 地址(激活在哪)、2 字节累加器地址(结果写哪)、4 字节长度( 是多少,卷积时是两维)、其余是操作码和标志位。一条指令 = 一整层网络的计算,这就是”领域专用 ISA”的含义——指令集直接对齐神经网络的算子,而不是对齐通用的寄存器传输。
四级流水线与解耦访存
TPU 的微架构哲学是一句话:让矩阵单元永远忙。为此它用了一个 4 级流水线,每条 CISC 指令在独立的流水级中执行,通过让其他指令与 MatrixMultiply 重叠执行来隐藏它们的开销。
关键技巧是 Read_Weights 指令的解耦访问/执行(decoupled access/execute):这条指令在发出地址后就算”完成”了,不需要等权重真正从内存搬进 FIFO。如果 MXU 需要的权重还没准备好,它会自动停顿(stall)等待。这样编译器可以把 Read_Weights 提前发出去,让权重搬运和前面的矩阵乘并行进行——这是经典 CPU 里”预取”思想的专用化版本。
由于指令可以占用流水站几千个周期,TPU 没有传统 RISC 那种”每级一拍”的干净流水图。论文特别提到一个有趣的场景:层与层之间需要显式同步。当一层的激活必须全部算完、下一层的矩阵乘才能开始时,矩阵单元会等待一个显式的同步指令,然后才安全地读 UB——这相当于软件控制的屏障(barrier)。
软件栈:TensorFlow 编译到 TPU 指令
再好的硬件,没有软件栈也是废铁。TPU 的软件设计目标是与 CPU/GPU 生态兼容,让应用能快速移植:
- 跑在 TPU 上的模型用 TensorFlow 编写(论文里的 6 个生产模型都只有 100–1500 行代码),编译成一套能在 GPU 和 TPU 上通用的 API。
- 软件栈分两层:内核驱动(Kernel Driver) 只负责内存管理和中断,保持长期稳定;用户态驱动(User Space Driver) 频繁更新,负责把 API 调用翻译成 TPU 指令、把数据重排成 TPU 需要的格式。
- 用户态驱动在第一次运行模型时做编译,缓存程序镜像并把权重写入 Weight Memory;第二次开始全速运行。这就是”JIT 编译 + 缓存”的模式,和现代推理框架(vLLM、TensorRT)的编译缓存思路完全一致。
TPU 的终极目标是让整个推理模型完全在 TPU 上跑完,最大化”TPU 计算时间 / I/O 时间”的比值——主机 CPU 只在开始和结束时碰数据。每层计算一个接一个流水执行,矩阵乘单元把非关键路径的操作全部掩盖掉。
为什么这套设计能赢:延迟约束下的利用率
这一节先把论文的结论性数据放出来(详细的分析和 Roofline 模型下一篇展开)。
论文拿 TPU 与同期的 Haswell CPU 和 K80 GPU 在同一个数据中心、同一批生产负载(6 个模型:2 个 MLP、2 个 LSTM、2 个 CNN,覆盖了当时数据中心 95% 的推理需求)上做了对比,核心结论:
- K80 GPU 在推理场景下只是比 Haswell CPU 快一点点(几何平均 1.1 倍,加权平均 1.9 倍)——GPU 的延迟抖动和利用率损失抵消了它的算力优势;
- TPU 比 CPU 快 14.5 倍(几何平均)/ 29.2 倍(加权平均),比 GPU 快 13.2 倍 / 15.3 倍;
- 以 MLP0 为例,7 ms 延迟约束下:CPU 只能发挥 42% 的峰值吞吐(batch=16),GPU 只能发挥 37%(batch=16),而 TPU 能发挥 80%(batch=200)——大批量 + 确定性的执行模型让 TPU 可以贴着延迟上限跑。
为什么 TPU 能撑住 batch=200 而 GPU 不行?因为 TPU 单条指令就是一层网络,200 个样本的矩阵乘一条指令算完,执行时间是确定的;GPU 要调度几十万个线程,延迟不可控,只能用保守的小批量。
局限与设计取舍
TPU v1 是”15 个月造出来的极简机器”,论文自己也坦诚地列出了它的短板:
- 不支持稀疏:稀疏矩阵支持因为时间紧被砍掉,论文表示这是下一代的高优先级。这对后来的硬件影响深远——现在所有加速器都在啃稀疏。
- 能效比例差:10% 负载时功耗是满负载的 88%,几乎没有电源门控——还是时间紧的锅。
- 内存带宽低:DDR3 只有约 34 GB/s,是 K80 GDDR5 带宽的约五分之一。论文用性能模型估算:如果只把内存换成 GDDR5,TPU 性能能翻 2.6–3.9 倍——这直接启发了 TPU 后续版本的带宽设计。
- MLP/LSTM 利用率低:受权重带宽限制,MXU 平均只有 28% 的周期在干活(CNN 能到 78%)。但即便如此,绝对性能依然碾压同期 CPU/GPU。
这些局限恰好说明了一个重要事实:TPU v1 的胜利不是”完美设计”的胜利,而是”针对目标场景做极端取舍”的胜利。
小结
TPU v1 回答了”推理加速器应该长什么样”这个问题,答案可以浓缩成三条:
- 推理的本质是”静态权重 × 低精度整数”的矩阵乘——所以芯片应该围绕一个大矩阵乘单元来设计,而不是围绕通用执行引擎;
- 延迟约束比峰值算力更重要——所以要用确定性的执行模型换掉 CPU/GPU 那些提升平均吞吐的复杂机制,省下来的晶体管和功耗全部投给算力;
- 领域专用 ISA 是可行的——CISC 风格的粗粒度指令让”一条指令一层网络”成为可能,PCIe 的传输开销被压缩到最小。
它用 15 个月、40 瓦、28 MiB 片上存储,做到了同期 GPU 13–15 倍的推理性能、25–29 倍的能效(性能/瓦)。更重要的是,它验证了”领域专用架构”这条路——此后几年,Google 用它换来的利润和信心投向了 TPU v2/v3,整个行业也掀起了一轮 NPU/加速器军备竞赛。
下一篇将拆解 TPU v1 性能神话的技术内核:脉动阵列(systolic array)的时序原理、weight-stationary 数据流、Roofline 分析,以及”MXU 为什么能 92 TOPS 而实际只用 28%“的完整性能归因。
参考资料
- In-Datacenter Performance Analysis of a Tensor Processing Unit(ISCA 2017 论文原文)
- Google Cloud Blog:Quantifying the performance of the TPU, our first machine learning chip(官方解读)
- Google Cloud Blog:An in-depth look at Google’s first Tensor Processing Unit(TPU 架构详解)
- IEEE Micro:In-Datacenter Performance Analysis of a Tensor Processing Unit(含芯片实拍图的扩展版)
- Roofline: An Insightful Visual Performance Model for Multicore Architectures(Roofline 模型原始论文,TPU 性能分析的数学基础)
- HPCwire:Google Pulls Back the Covers on Its First Machine Learning Chip(技术社区解读)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



