


BitDecoding-FP4 完全拆解:让注意力直接在 FP4 Tensor Core 上解码——三重量化误差与三条 kernel 改造
背景:为什么 KV Cache 一定要走到 4 位
长上下文推理的瓶颈早已不是模型权重,而是 KV Cache。权重是静态的,一次装载之后在整个服务期里反复复用;KV Cache 则是动态的,它随序列长度和并发数线性增长,并且每解码一个 token 都要被完整读一遍。在 128K 上下文、几十条并发请求的条件下,一次 decode step 的显存带宽几乎全部花在把 KV 从 HBM 搬进 SM 上,权重读取只占很小的一部分。
把 KV 量化到低精度,是同时压缩容量与带宽最直接的办法。FP8 KV Cache 已经在 vLLM 这类框架里成为标配,而 4 位量化又能在此基础上再翻一倍。更关键的是,NVIDIA Blackwell 一代的第五代 Tensor Core 原生支持微缩放(Microscaling,MX)格式:NVFP4 与 MXFP4 的 E2M1 元素和块缩放可以直接作为 MMA 操作数喂进去,不需要先把它们反量化回 BF16 或 FP8 再算。按照 NVIDIA 的说法,这些格式的矩阵乘吞吐可以达到 FP8 的两倍左右。
这就带来一个看起来”一步到位”的诱惑:KV Cache 用 NVFP4 存,注意力矩阵乘直接用 FP4 Tensor Core 算,既省了容量,又省了反量化开销。BitDecoding-FP4(arXiv 2611.09825,2026 年 11 月,爱丁堡大学与腾讯混元联合发布)研究的正是这条路线上被忽略的差距:把 KV 存成 FP4 很容易,让注意力在 FP4 上算得既准又快,完全是另一回事。
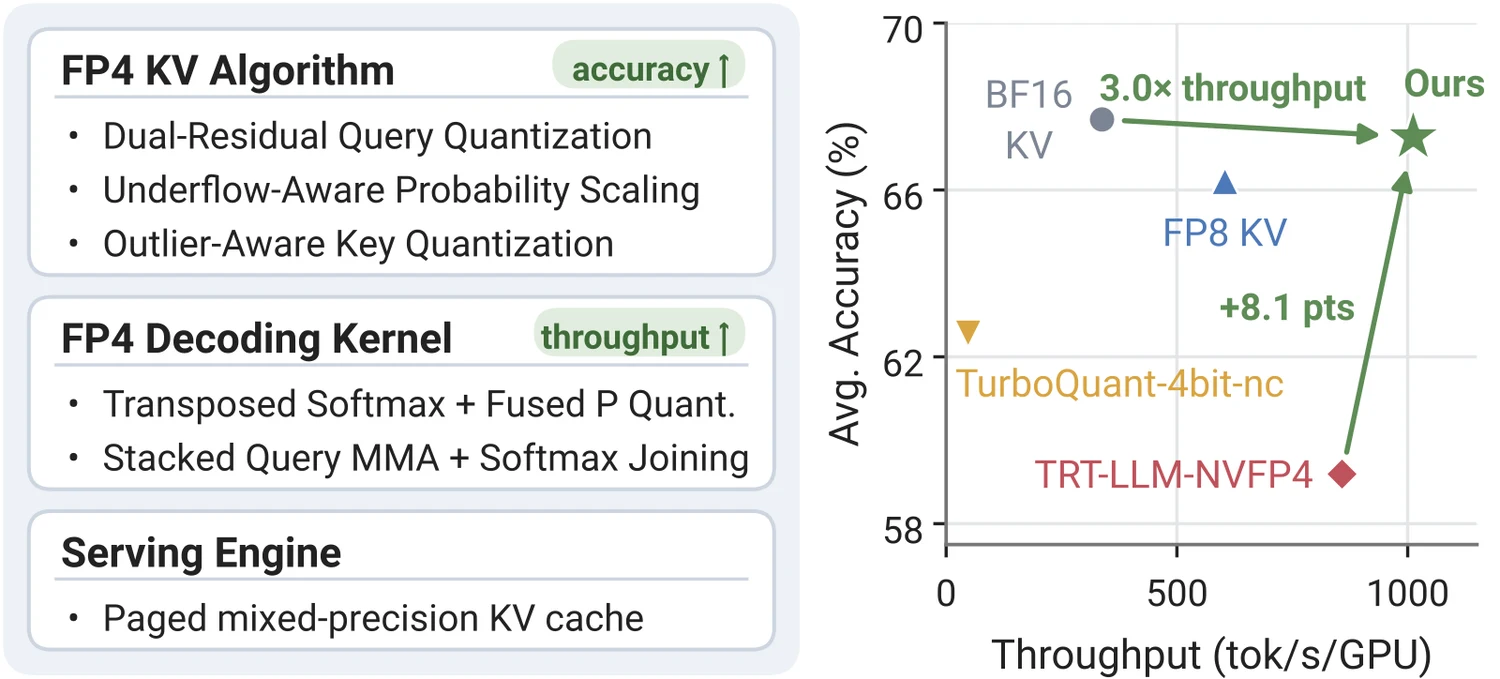
上图左侧是这篇文章的主线:算法层针对查询、概率、Key 三类操作数各做一个修正,系统层针对 softmax、查询残差、分页元数据各做一项 kernel 改造。右侧把结果放在精度-吞吐平面上,BF16 KV、FP8 KV、TRT-LLM-NVFP4、TurboQuant-4bit 分别落在不同位置,BitDecoding-FP4 同时贴着 BF16 KV 的精度和向量量化方法的吞吐上限。这张图想表达的结论很直接:精度和速度不必二选一。
后续章节沿着这条主线展开:先补足微缩放 FP4 与”原生 FP4 注意力”的定义,再解释三类量化误差各自的来源与修正,然后拆系统侧的三个 kernel 设计,最后核对实验、局限与它对推理框架的启发。
背景:微缩放 FP4 是什么,原生 FP4 注意力又是什么
在讲误差之前,需要先把两个术语讲清楚,后面的所有推导都建立在它们之上。
微缩放格式:块内共享一个标量
微缩放(Microscaling)格式的思路来自 OCP 的 MX 规范:把一个张量沿某个维度切成连续的小块 ,每块大小 个元素,只存一份标量缩放 ,块内每个元素存成低位格式 。对 4 位浮点(FP4)而言,元素取自 E2M1 网格——1 位符号、2 位指数、1 位尾数:
一共 16 个可取值,最大绝对值是 6。块量化器把 映射为一对标量:
这里 是块内最大绝对值, 是向网格最近点的舍入。除 6 的目的很直白:让块内最大的那个元素正好落在网格顶端。反量化就是 , 表示把 广播回块内每个元素。我们把”量化再反量化”的往返记为 。
两种主流变体的差别只在块大小与缩放精度:
| 格式 | 块大小 | 缩放类型 | 特征 |
|---|---|---|---|
| NVFP4 | 16 | E4M3(4 位指数、3 位尾数,可表示 ~ 到 448) | 缩放本身是浮点,有约 8% 的相对精度 |
| MXFP4 | 32 | E8M0(只有 8 位指数,2 的整数次幂) | 缩放免费(纯指数),但只能是 2 的幂 |
E2M1 的网格在零附近最密,在 3 到 6 之间稀疏,这跟权重、激活这类近似钟形的分布贴合得比均匀的 INT4 更好——这也是 FP4 能在 4 位下保持精度的前提。
原生 FP4 注意力:四个操作数全是 FP4
普通解码注意力的计算是
其中 是当前 token 的查询, 是缓存里的 个 token 的 Key 和 Value, 是第 个 token 的行, 把自然指数换成以 2 为底,便于后续用 exp2 在 GPU 上实现。
所谓”原生 FP4 注意力”,是要求矩阵乘 与 都在 FP4 Tensor Core 上完成,即四个操作数 全部是微缩放 FP4,硬件直接消费 E2M1 元素和块缩放,形如 。相比之下,绝大多数低位 KV Cache kernel(QServe、SAW、BitDecoding 原版等)的做法是先把 KV 反量化成 BF16 或 FP8,再用常规 Tensor Core 算——这样查询和概率可以留在 16 位,精度容易保住,但每次注意力 GEMM 之前都要多付一轮反量化。
先看反量化的代价。论文用 FlashInfer 的 XQA-NVFP4 解码 kernel 做了测量:在 128K 上下文下,把一个 NVFP4 KV 反量化成 BF16 的步骤占解码 kernel 时间的 7–21%,具体比例见下图。
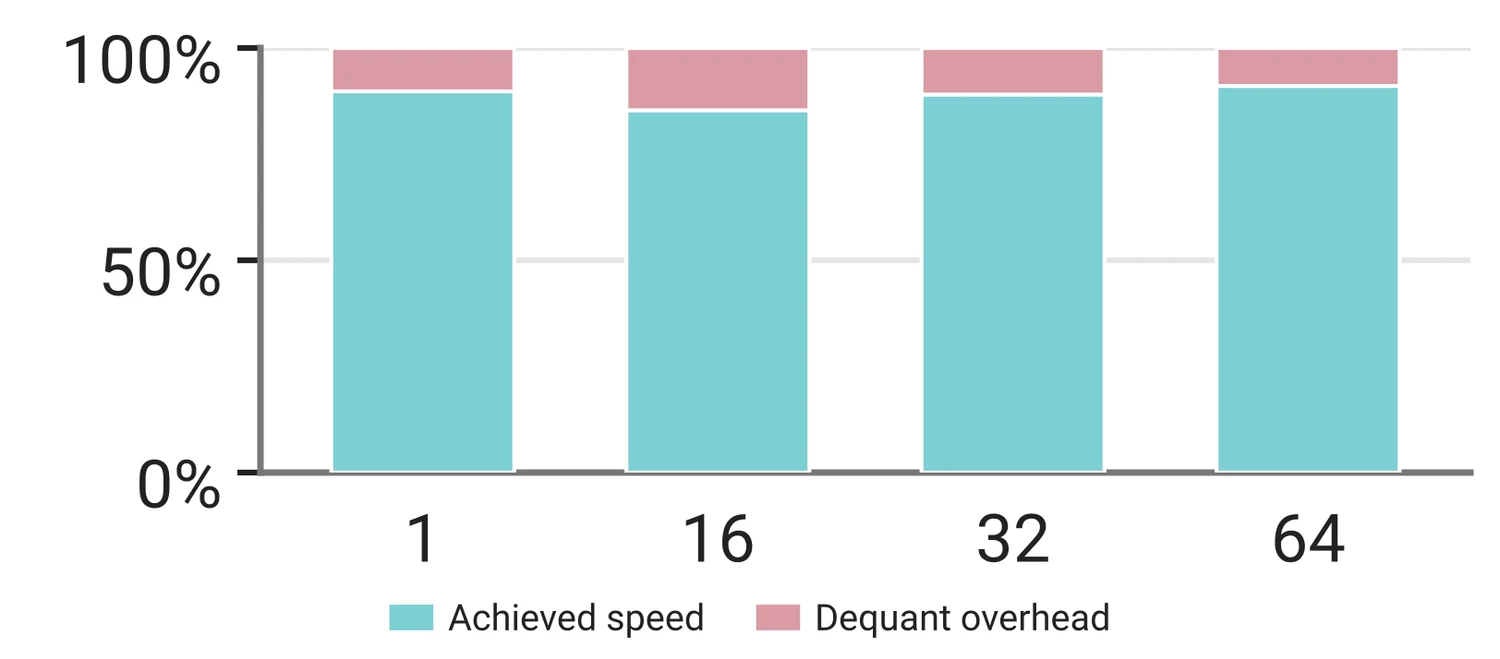
上方的图例给出几个 batch 取值(含 N=1),柱状图是 Qwen3-4B 在 128K 上下文下的结果,反量化占解码 kernel 时间的比例在 7% 到 21% 之间浮动。这个数字说明了两件事:一是反量化不是可以忽略的零头,二是只要还走”先反量化再算”的路线,这部分开销就永远存在。而 Blackwell 的 tcgen05 Tensor Core 原生支持块缩放 NVFP4/MXFP4 相乘,直接把这块开销删掉。站内 GPU GEMM 优化完全拆解(四):tcgen05 与 Blackwell 拆过这套指令的机制,可以参考。
差距到底在哪里
论文指出的”缺口”是双向的:
- 系统效率优先的一侧:TRT-LLM-NVFP4 直接把式 (1) 的朴素量化套到 KV Cache 上,长上下文精度掉得很厉害;论文测到它在 Qwen3-4B 上平均比 BF16 KV 少 8.5 个百分点,RULER 从 96.28 掉到 80.04。
- 算法精度优先的一侧:TurboQuant 这类 4 位算法用向量码本逼近分布,精度不错,但每次解码都要在线查表并在 GPU 上重建向量;论文测到它的逐输出 token 延迟(TPOT)是 BF16 KV 的 12 倍以上(256K 上下文下 94.46 ms 对 7.74 ms)。
- 中间地带:SageAttention3 这类原生 FP4 注意力方法做的是预填充、非因果或扩散模型场景,它们在每次调用内对 BF16 的 Q/K/V 现做现量化,而不是从一个低精度缓存里读取——“从 FP4 缓存解码”的误差特征和它并不一样。
此外,BitDecoding 原版(2025 年的工作,站外)已经解决了低比特 KV 缓存与 Tensor Core 友好的布局、混合精度缓冲问题,但它的两个 GEMM 仍然是反量化后进行,查询和概率没有进入 FP4。BitDecoding-FP4 明确声明自己是在 BitDecoding 的基础上,补上”准确的 FP4 量化算法 + 针对 Blackwell 的原生 FP4 kernel”这两块。
三个误差源:为什么”直接上 FP4”一定掉精度
如果只是把式 (1) 分别套到 、、 和 softmax 概率 上,然后送进 FP4 Tensor Core,精度会明显崩。论文把原因拆成三个互不相同的误差源,这也是全文算法部分的组织方式。
误差源一:查询量化不是二阶小量
记量化后的张量为 ,量化误差为 。注意力 logit 的误差可以精确写成(忽略常数 ):
推导只用到 再展开,没有近似。两项分别由 Key 的量化误差和查询的量化误差贡献。长期以来低比特 KV 的文献几乎都把注意力放在 Key 的通道离群值上,很自然地假设查询那点误差影响不大——毕竟查询只有一行,而 Key 有成千上万行。
论文用实验否定了这个假设。它把 logit 误差按上式拆成 Key 项和查询项,比较不同查询格式下的均方误差:
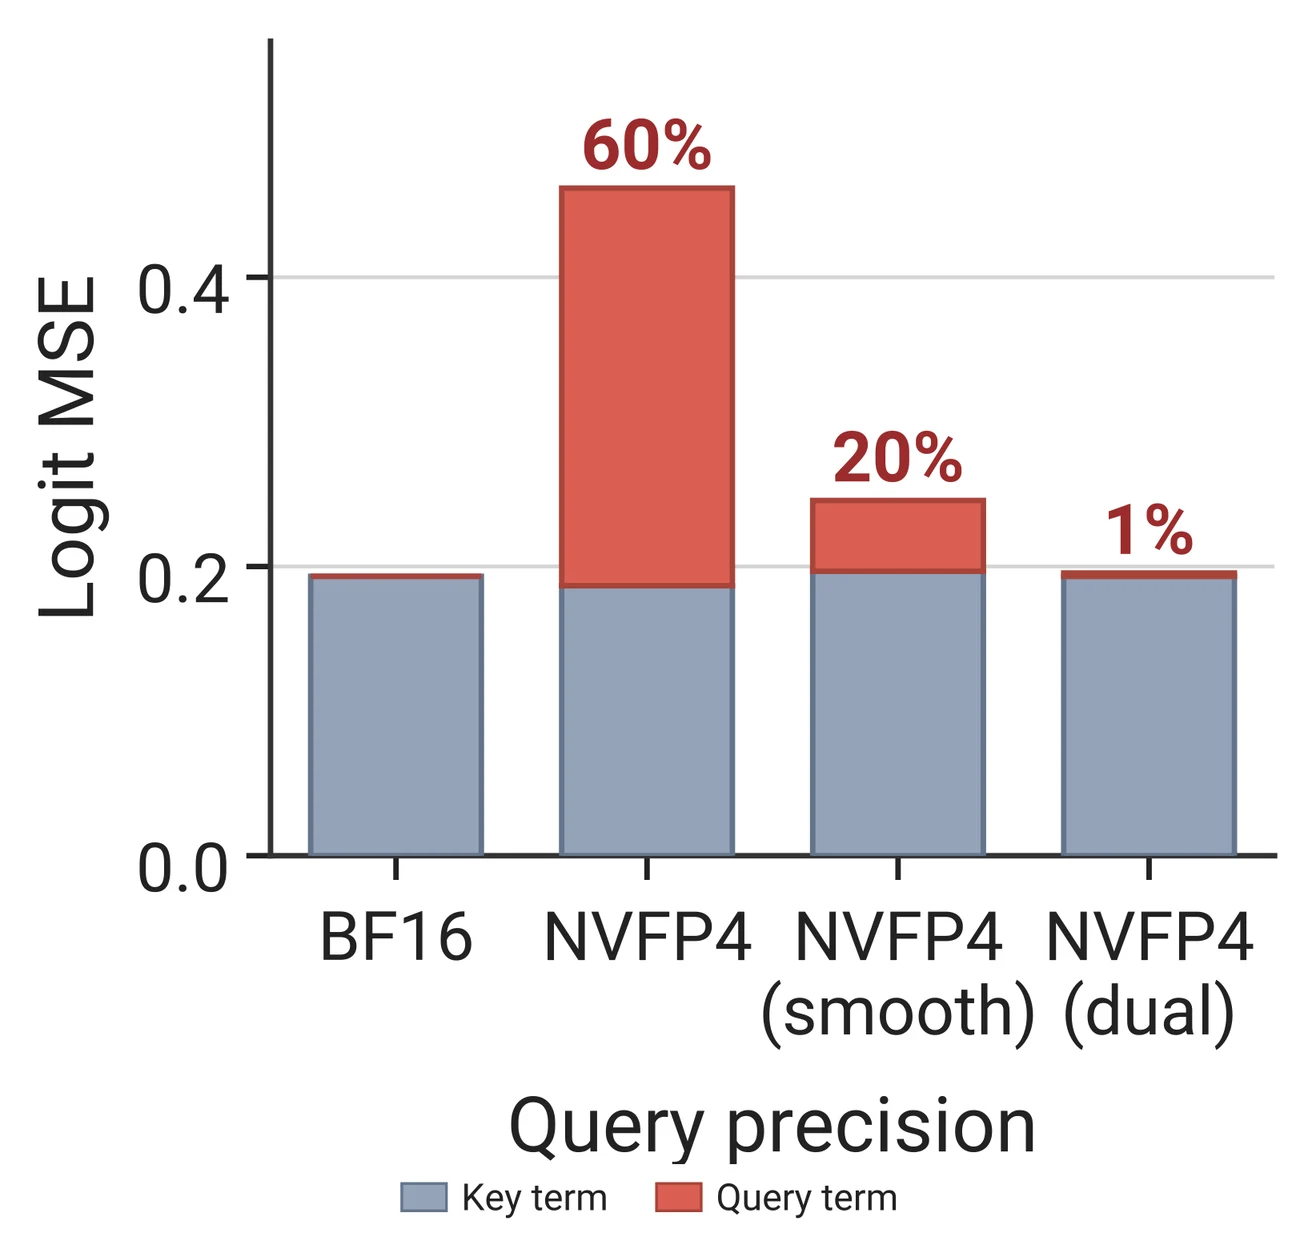
图 (a) 是 NVFP4 Key 的结果,图 (b) 是 MXFP4 Key 的结果,横轴是不同查询格式,纵轴是 logit 均方误差,每组柱子里的两段分别是查询项与 Key 项。NVFP4 Key 配 NVFP4 查询时,查询项占了总误差的 60%——比 Key 本身还大。原因不复杂:查询是一行向量,被广播到成千上万个 token 上,它的舍入噪声不会被平均掉,反而被 softmax 放大成注意力的整体偏移;而 Key 的误差在点积里逐 token 独立,部分相互抵消。
误差源二:概率在 E4M3 缩放下整体下溢
在线 softmax 的每一步算的是
其中 是到目前为止见过的最大 logit。解码到长上下文时,绝大多数 token 的 logit 都明显低于 ,所以每个概率块的块内最大值满足 。按式 (1),这个块的缩放是 。E4M3 能表示的最小次正规数约为 ,比它再小一半()就会舍入到零。于是当
时,,整个块的概率全被量化成 0。论文在长推理轨迹上观察到:接近 90% 的概率块满足这个条件,也就是说这些 token 在后续的 里根本不会被考虑。对需要”从长上下文里精确检索某个片段”的任务,这几乎是致命的。
误差源三:Key 的通道离群值撞上 token-wise 布局
Key 张量在少数固定通道上有持续的大幅离群值,这是低比特 KV 量化里的老问题。以往的解法是按通道量化:沿序列维把同一通道的所有 token 放在一个块里,离群通道自然被隔离到自己的缩放里。
但原生 FP4 Tensor Core 的计算方式决定了不能这么做。每个 logit 是单个 token 的 个通道上的点积,硬件对这条点积的每 16 个(NVFP4)或 32 个(MXFP4)通道切片共享一个缩放。因此缓存的 Key 必须按 token、沿通道维分块量化。在这种布局下,一个离群通道会把所在块的 拉高,缩放随之变大,同块其余通道全被压扁到 E2M1 网格的低分辨率区域,量化误差急剧上升。
三个误差源分别对应三个算法修正:双残差查询量化、防下溢概率缩放、离群感知 Key 量化。下一节逐个拆。
算法修正一:双残差查询量化
针对查询误差,最直接的想法是给查询更高的位宽,比如让查询留在 FP8 或 BF16,只让 KV 走 FP4。但原生 FP4 注意力的前提是两个矩阵乘都在 FP4 Tensor Core 上完成;如果查询是 FP8,第一个 GEMM 就退化成混合精度,硬件要么走较慢的路径,要么仍需要类型转换。论文选择的方向是:查询仍然用 FP4,但用两个 FP4 张量来表示它。
表示形式
设普通量化结果为 ,把”第一次量化剩下的部分”再量化一次:
其中 与 是两组独立的块缩放和 4 位元素:第二组按式 (1) 从残差 计算,拥有自己的缩放。于是查询的最终误差不再是第一次量化的 ,而是残差自身的舍入误差:
这就是名称里”双残差”的含义——第二项量化的是第一项的残差。
为什么这样能 work
微缩放格式的精度瓶颈在块缩放:一个块只有一个指数,块内元素的动态范围被压缩。两次量化相当于给同一段数值配了两套指数:第一套覆盖原始量级,第二套专门覆盖舍入后剩下的那点小残差。在数值计算里,这正是双单精度(double-single)或补偿求和的思路——用两个低精度数拼出更高有效精度,而不是换一个更宽的格式。
代价也很清楚:查询变成两个 FP4 张量,第一个 GEMM 需要形成两个块缩放乘积再相加:
这多出来的一个 GEMM 不能直接忽略,系统侧必须专门处理——后文「查询堆叠 MMA 与 softmax 内合并」一节正是为此设计的。
效果
论文的测量是:NVFP4 Key 下,查询项在 logit 误差中的占比从 60% 降到 1%。作为对比,SageAttention3 风格的查询平滑(smoothing Q)在 GQA 头平均口径下仍留下 20% 的误差,在早期 token 平均口径下留下 42%;MXFP4 Key 下,双残差查询同样只留 1%,而硬件可以直接接受、精度更高的 MXFP8 查询仍留下 5%。换句话说,两个 FP4 张量在注意力这个具体场景里,比一个位宽翻倍的查询更有效——因为它把误差对准了残差,而不是均匀地提高所有位的精度。
算法修正二:防下溢的概率缩放
概率下溢是三个误差源里最隐蔽的一个,因为它在短上下文评测里几乎不出现,一到长上下文检索就集中爆发。
先看清 E4M3 缩放的”地板”
NVFP4 的块缩放是 E4M3:4 位指数、3 位尾数,最小正规数约 ,再往下是次正规数,最小到 。当块缩放 小于 时,E4M3 只能把它舍入成 0。这时无论块内概率原本是多少,乘上缩放都归零。
论文在长推理轨迹上统计:约 90% 的概率块最大值低于 ,缩放被舍成 0。softmax 的分母仍然把这些 token 算进去,分子却是 0——它们既不被注意,也不贡献输出,相当于在检索时被静默删除。这种失效模式与”量化噪声变大”不同,是整块信息直接消失,所以对 RULER、MRCR 这类检索任务伤害极大。
两个手段:常数抬升与双阈值缩放
第一个手段是把概率整体乘一个常数 。朴素实现是给每个概率乘一个 FP32 因子,但这样每块都要多一次乘法。论文把它折进在线 softmax 的指数里:
因为 是常数,这一步只是把 exp2 的指数加 3,不产生额外指令。又因为 softmax 最终要除以概率和 ,这个常数在归一化时自动约掉,不影响结果。
第二个手段是让部分块的缩放对齐到 而不是 。这样块内最大值映射到 E2M1 的 2,而不是 6;缩放本身被抬高 3 倍,离 E4M3 的零和次正规区更远。代价是块内量化步长变成 3 倍,但只对”最大值本来就很小”的块启用,这些块的绝对误差本来就在可接受范围内,而且 E2M1 在 2 附近的网格更密,误差分布反而更均匀——这正是 Four Over Six 那篇工作观察到的现象。
选择规则写成:
其中 是一个离线校准的阈值。阈值的作用是决定”什么时候值得牺牲 3 倍步长来换取远离下溢”。论文通过在 BF16 logits 上重放在线 softmax、最小化所有概率块的总平方量化误差来选它,候选值限定在 E4M3 网格上;生产配置选中的是 code 10()。校准结果显示这个选择很稳定:五类校准数据(UUID 检索、标记检索、代码与数学填充、Key 平滑文本、模型自己的推理轨迹)都选中 code 10,随机子集也几乎都选中它,只有推理轨迹需要 32 条样本才能稳定。
效果与边界
两个手段叠加后,概率缩放的可用下限从 推到 :前者是标准规则下溢的块最大值门槛,后者是新规则的门槛,比值恰好是 ,也就是论文说的”下溢地板降低 24 倍”。这解释了为什么长上下文检索的精度能被拉回来:原本被清零的那 90% 块,现在大部分能拿到非零缩放。
这个修正只对 NVFP4 需要。MXFP4 的缩放是 E8M0,只有指数、没有尾数,取值范围覆盖极大与极小,不存在”缩放被舍成 0”的问题;因此消融实验里 MXFP4 配置直接省略了概率缩放,这也从反面印证了误差源的分析。
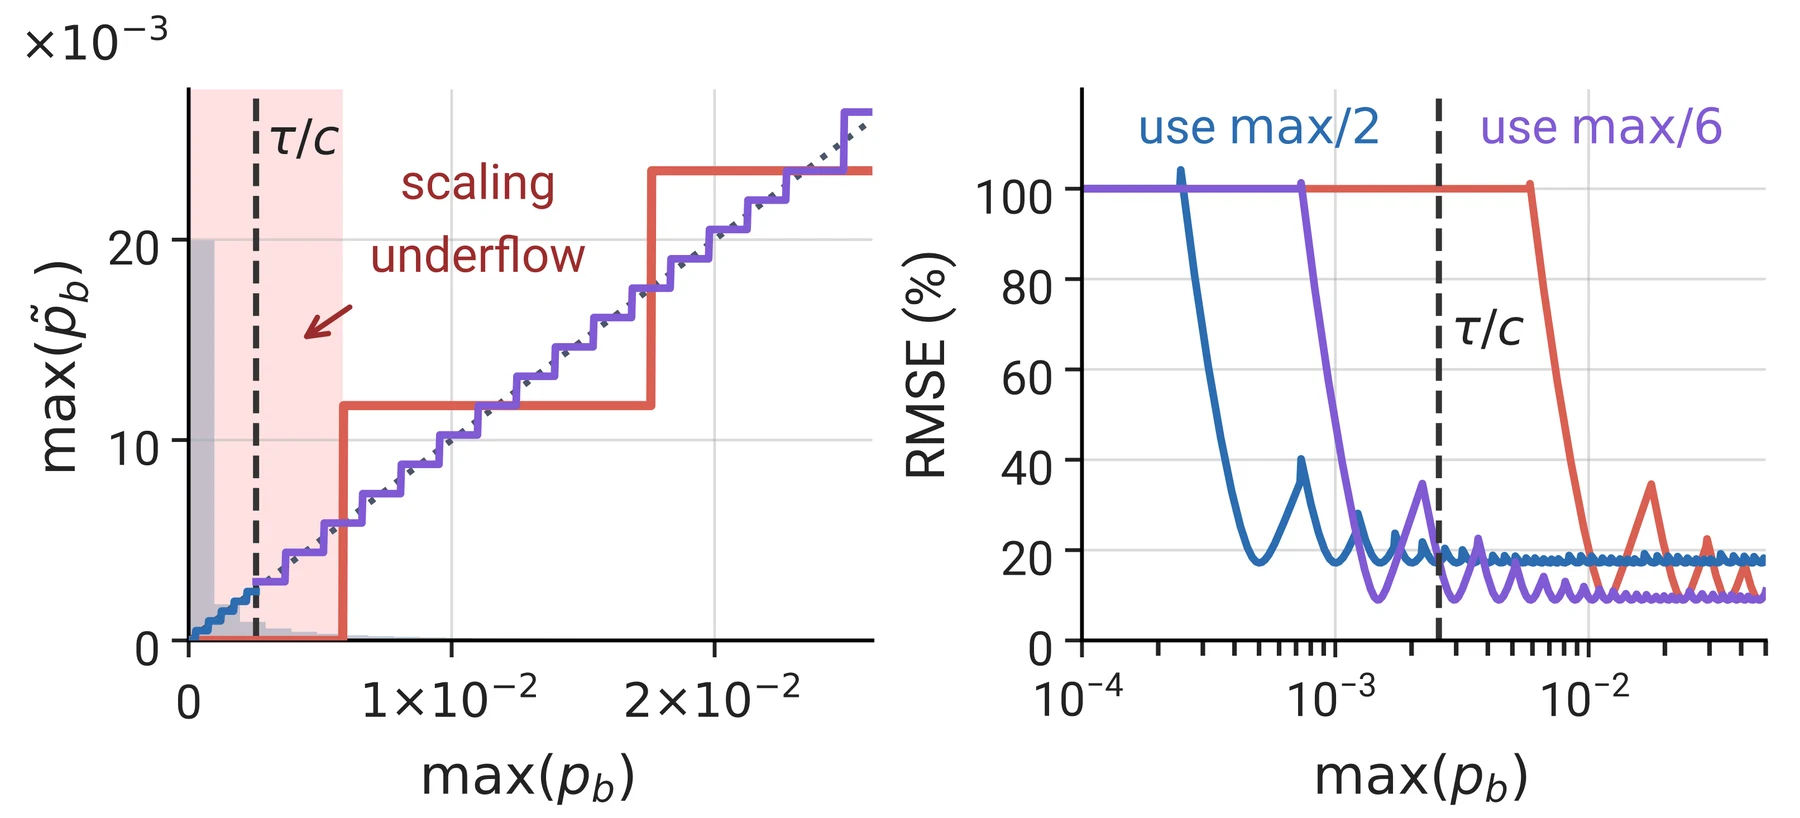
左图是 E4M3 缩放阶梯上的下溢情况,横轴是块内最大概率 ,纵轴是下溢比例;图中的阶梯就是 E4M3 能表示的缩放值序列,曲线从 量级开始明显抬升,到 量级几乎全部下溢,标注的 max/2、max/6 与 τ/c 分别对应不同的缩放规则。右图是量化误差随块最大概率的变化,几条曲线对应不同缩放策略;可以看到在很小的概率区间,固定 max/6 的误差陡增,而带阈值切换的规则把误差压在更低的水平。两张图合起来说明:下溢不是罕见边角,而是长上下文解码的常态,必须用专门的缩放规则处理。
算法修正三:离群感知的 Key 量化
Key 的问题不是”有离群值”——这在低位 KV 里人人皆知——而是 Tensor Core 的块布局把离群值的影响放大了。
token-wise 布局的硬约束
原生 FP4 Tensor Core 算 logit 时,把单个 token 的通道维切成 16 或 32 个一组,每组共享一个缩放。这意味着量化的分块轴必须是”token 内的通道”,而不能是”跨 token 的同一通道”。前者让离群通道与普通通道挤在同一个块里,后者才能把离群通道单独隔离。
约束无法绕开,只能在 token-wise 布局下削弱离群值本身。论文用了三层处理:去静态偏置、旋转打散、逐块选缩放。
第一层:静态 Key 平滑
Key 的通道离群值有一部分是静态的:某些通道在所有 token 上都偏大,形成一个固定的通道偏置。softmax 对 logits 的整体平移不变,所以对每个头减去一个常数向量 不改变注意力结果:
第二项对固定查询是常数,softmax 之后完全抵消。因此平滑不引入任何计算误差,也不需要额外 kernel。
关键在 怎么来。预填充注意力可以在每次调用里对当前序列动态求通道均值,解码不行——解码每一步只看到一个 token,没有”整条序列”可求。论文改为离线校准一个静态的逐头均值:用 8 条日常话题的种子提示(解释哈希表、光合作用、写短故事之类),让模型贪心续写 256 token,共约 2K token;把 8 段文本拼起来铺满整个上下文窗口(128K 窗口用 131071 token),做一次预填充,累加每一层、每个 KV 头在 RoPE 之后的 Key,取均值。整个过程在单张 B300 上耗时 13 秒。
几个设计选择值得注意:
- 用模型自己生成的文本,而不是外部语料,是因为校准目标是对齐服务时的 Key 分布;
- 把文本平铺到整个窗口,是因为 RoPE 让 Key 的均值依赖位置,只在一小段上统计会得到有偏的均值;
- 8 条提示、2K 生成 token 已经足够。论文对比了更多校准数据:10 条检索提示(1.3M token)让 MRCR 的 teacher-forced KL 上升 21%,40 条混合提示(5.2M token)上升 16%。更多数据反而更差,因为检索文本的通道统计与服务时的自然生成分布不匹配——校准要的是”同分布”,不是”大规模”。
第二层:Hadamard 旋转
平滑只能去掉静态偏置,动态的、随 token 变化的尖峰仍在。论文对查询和平滑后的 Key 同时做一个归一化 Walsh–Hadamard 旋转:
其中 满足 。正交性保证内积不变:
旋转的作用是把集中在少数通道上的尖峰能量均匀分散到所有 个坐标上。块内最大值因此下降,缩放不再被单个通道绑架,同块其他通道保住了分辨率。选 Walsh–Hadamard 而不是学习出来的旋转矩阵,理由很实际:它没有参数、可以用蝶形运算以 完成、能量严格守恒,并且最大相干性低,适合在 kernel 里就地做。站内 QuaRot 完全拆解 讨论过同一类旋转在 W4A4 里的用法,机制相通。
第三层:逐块缩放搜索
即使经过平滑和旋转,每个块的分布仍不同,固定用 不一定最优。论文对每个块在两个候选缩放里选重构误差更小的那个:
- NVFP4 的候选集是 E4M3 网格上的两个缩放最大值:标准的 与 Four Over Six 的 。后者把块内最大值映射到 4 而不是 6,牺牲一点步长,换取近最大值元素更细的网格覆盖——E2M1 在 2 到 4 之间的点比 4 到 6 之间密。
- MXFP4 的候选集是两个相邻的 2 的幂。标准 OCP 规则取 ,使 ;当这个比值落在 时,块最大值会被 E2M1 的上限 6 截断。取下一个幂 会把比值压到 ,避免截断,代价是整块步长翻倍。两者逐块比较,保证块 MSE 不高于任何单一固定规则。
这一层是纯离线/缓存写入时的计算:Key 在写入 KV Cache 前量化一次,搜索两个候选的代价可以忽略;解码时只读结果,没有运行时开销。
三层各自贡献多少
因为完整配方已经贴近 BF16 KV,端到端 benchmark 的分辨率不够,论文改用 teacher-forced KL 做逐项消融(KL 越低越好,数值单位是 nats):
| 配置(Qwen3-4B-Thinking) | MRCR KL | AIME24 KL |
|---|---|---|
| NVFP4 完整配方 | 3.83 | 4.70 |
| 去掉 Key 平滑 | 11.79(+208%) | 8.11(+72%) |
| 去掉 Hadamard 旋转 | 6.68(+74%) | 6.84(+45%) |
| 去掉块缩放搜索 | 4.70(+23%) | 5.58(+19%) |
| MXFP4 完整配方 | 10.27 | 11.75 |
| MXFP4 去掉 Key 平滑 | 50.73(+394%) | 37.76(+221%) |
| MXFP4 去掉 Hadamard 旋转 | 30.23(+194%) | 35.93(+206%) |
| MXFP4 去掉块缩放搜索 | 12.97(+26%) | 17.19(+46%) |
三层缺一不可,其中 Key 平滑的贡献最大:NVFP4 下去掉它让 MRCR 的 KL 变成三倍,MXFP4 下变成近五倍。这也说明在 token-wise 布局下,静态通道偏置是最主要矛盾;旋转处理的是残余动态尖峰;缩放搜索是最后一层微调。
系统改造一:转置 softmax 与融合的概率量化
算法修正解决了”准不准”,但把它们放进 kernel 之后,新的瓶颈出现了:softmax。论文的观察是,FP4 把每个 token 的字节数压到 1/4 之后,解码注意力的算术强度上升,Tensor Core 不再是限制;真正的天花板变成了跑在 CUDA core 上的 softmax 归约与概率量化。如果不改 softmax 的线程布局,FP4 Tensor Core 大部分时间在等。
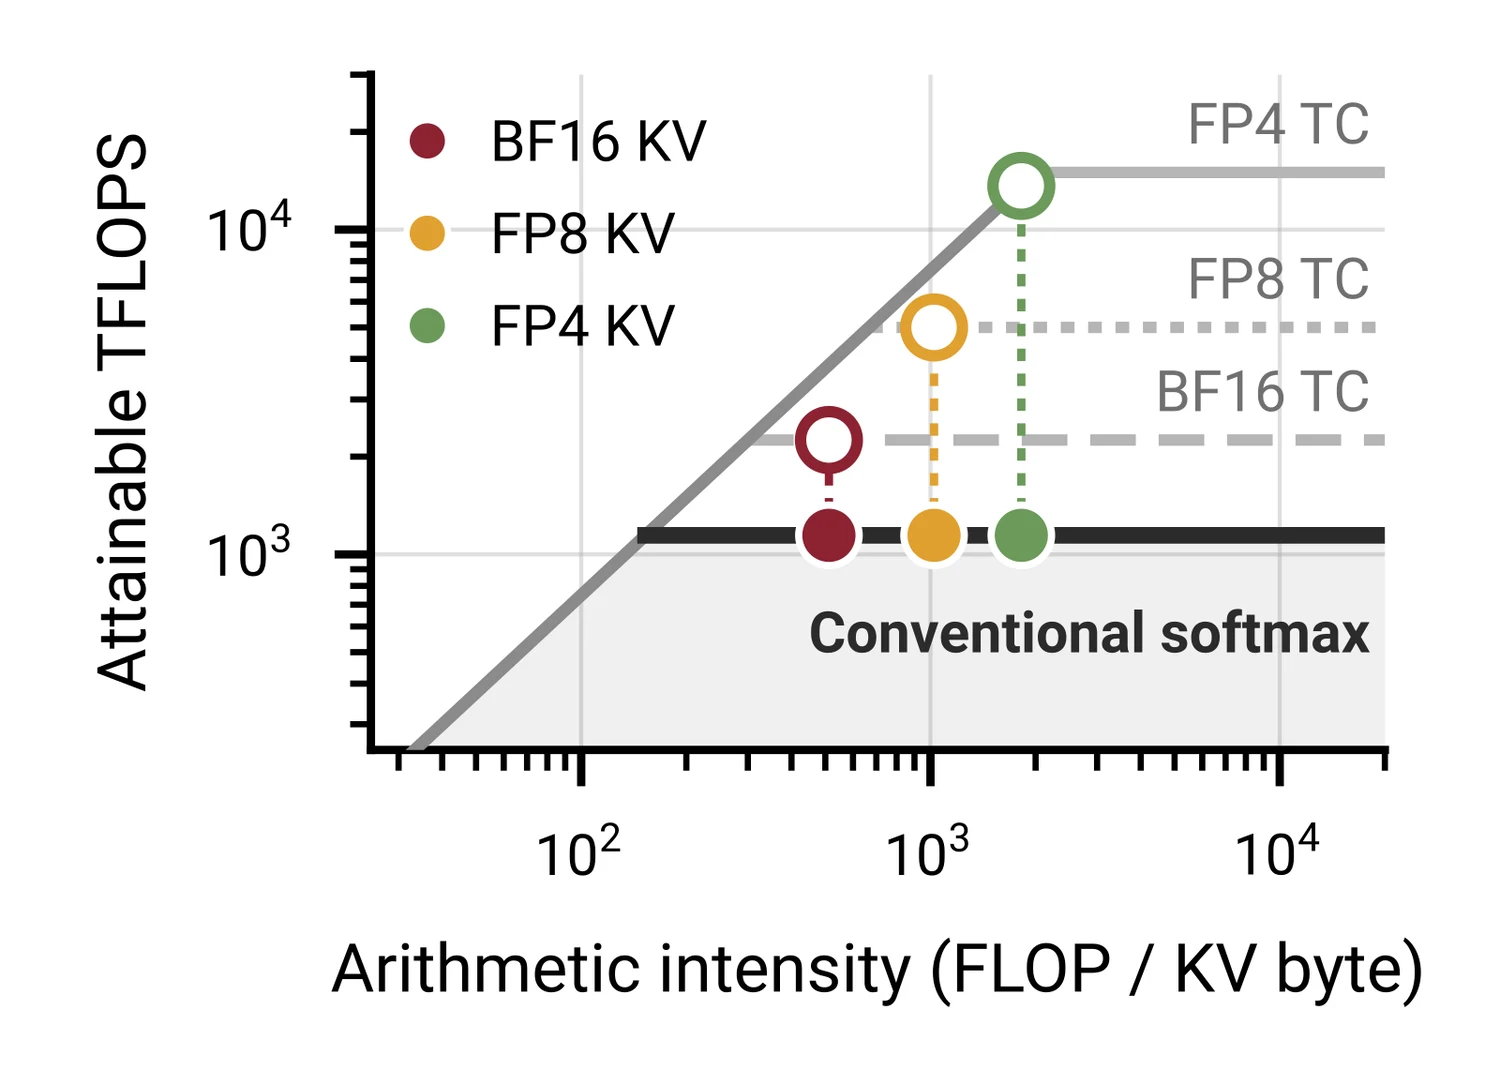
这张 roofline 图的横轴是算术强度(每字节的浮点运算数),纵轴是吞吐。斜线是显存带宽屋顶,横线是不同计算单元的上限:最上方是 FP4 Tensor Core,往下依次是 FP8、BF16 Tensor Core,再往下是 softmax 所在的 CUDA core 屋顶。BF16 KV 的解码工作点落在带宽屋顶上;换成 FP4 后,每字节承载的计算翻了几倍,工作点向右移动,本应接近 Tensor Core 的横线,但 softmax 的横线更低,于是实际吞吐被它压住。这就是”精度换了、速度没换”的机制性原因。
传统布局为什么在解码时浪费线程
FlashAttention 风格的 kernel 里,score tile 的形状是 , 是共享同一个 KV 头的查询头数(GQA 的组大小), 是 Key 的分块长度。softmax 线程沿 tile 的行划分,一行对应一个查询头。解码时 通常只有 4 或 8,而 MMA tile 的高度 是 64 或 128——大部分线程坐在补零的行上空转。
更糟的是每个活跃线程的处理方式:它要沿着自己那一行的 个 Key 串行扫三遍——第一遍求行最大值,第二遍算 并累加和,第三遍再扫一遍求每个概率块的块内最大值、把概率量化成 FP4。Key 越长,这三趟串行越贵;而这三趟全是 CUDA core 标量工作,Tensor Core 只能等。
把矩阵转置过来
论文把两个矩阵乘的操作数对调,计算转置后的 score tile 与概率 tile:
并把 Key 分块长度取成 。这样 tile 的行变成了 Key,无论 是多少,所有 行都被有效 Key 填满,每个线程手里都握着有效 key 的分数,没有空转行。
softmax 的归约方向也随之改变:原来每个线程沿自己的行扫描所有 Key,现在归约发生在线程之间——同一列(同一个查询头)的分数分布在不同 lane 上,用 warp 级蝶形 shuffle(shfl.sync.bfly)做树形归约, 步完成,最后只需一次跨 warp 的共享内存归约。每个线程的串行工作量从 步降到几步蝶形。
这个改动还顺带解决了概率量化的融合问题。微缩放块在转置布局下对应连续的 Key,也就是连续的 tile 行,恰好落在同一组 lane 上;而块内最大值 与 logit 的块内最大值一一对应(exp2 单调),所以第一步求行最大值时产生的中间结果就是块缩放需要的 ,不需要再扫一遍 。防下溢规则的阈值判断只是对块最大值的一个谓词, 折进 exp2 的指数参数;每个线程最后在寄存器里完成缩放和 E2M1 舍入,直接得到 MMA 需要的 布局。
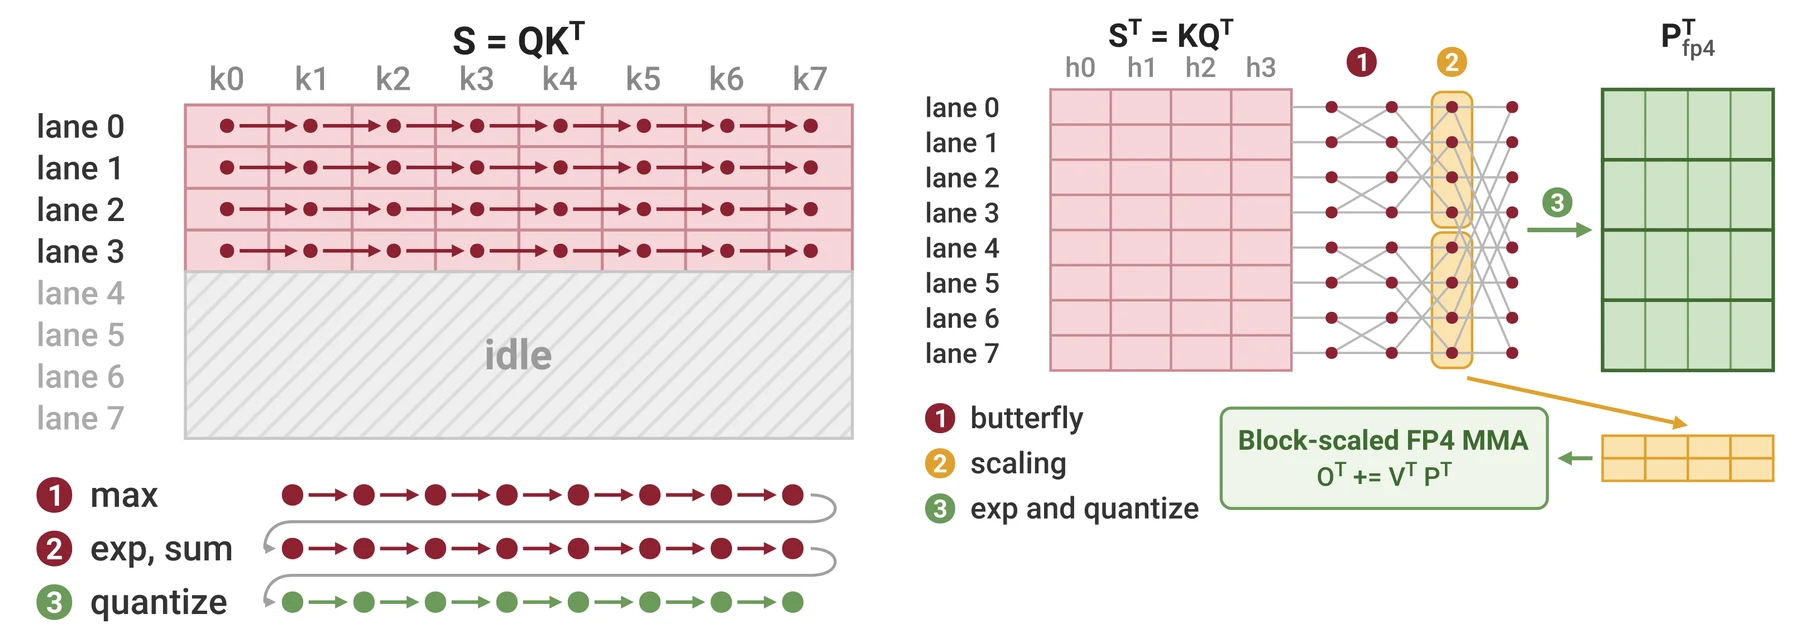
左图是传统布局:8 个 lane 对应 8 个查询头行,tile 高度远大于 ,右侧大量行标着 idle,活跃 lane 需要沿 Key 方向串行做 max、exp+sum、quantize 三趟。右图是转置布局:lane 对应 Key,fp4 块沿 Key 连续排列,max 与 block max 由蝶形归约同时得到,exp、缩放和量化在同一次寄存器操作里完成。图下方标注的 butterfly、scaling、max 等步骤对应两种布局的实际指令序列,可以直接看出串行链被拆成了并行树。
这一项改造单独就把纯 kernel 延迟压到原来的约一半(论文消融里是 1.91 倍加速),也把之前被 softmax 掩盖的另一个问题暴露出来:双残差查询需要第二个 GEMM,单独发一次 MMA 会带来 10.3% 的开销——这正是下一节要处理的。
系统改造二:查询堆叠 MMA 与 softmax 内合并
双残差查询在数学上很干净,在 kernel 里却有一个麻烦:两个 FP4 查询张量的块缩放相差很大。 的缩放是从很小的残差算出来的,和 的缩放不在一个量级。微缩放 MMA 的每个操作数块共享一个缩放,不能把两个查询拼成一个 FP4 张量共用一套缩放——那样 会被 的缩放压成零。所以只能形成两个块缩放乘积,在 FP32 里相加:
最直接的实现是每个 Key tile 发两次 MMA,累加到同一份 FP32 分数上。但在转置布局里, 个查询头构成 MMA 的列维;当 小于 MMA 的最小列宽时,查询操作数本来就要补零。第二次 MMA 有一大部分算力重复花在这些补零列上,纯属浪费。
把残差塞进补零行
微缩放 MMA 的缩放是按操作数的行附加的,不同行可以携带互不相关的缩放。论文利用这一点,把 的有效行放进 tile 的补零行里:
- KV 循环开始前,TMA 把两个查询 tile 都搬进共享内存。一个 load warp 把 的 个有效行及其块缩放复制到 tile 的第 到 行,以及对应的缩放 tile;随后 fence 共享内存,通过 mbarrier 通知 MMA warp。查询在整个 KV 循环里不变,所以这个复制每个 tile 只做一次。
- 每个 Key tile 只发一次 FP4 MMA,列数是 ,两个乘积被写进 的相邻列区:前 列是 的结果,后 列是 的结果。
- 两个乘积的 FP32 加法被挪进 softmax:每个 softmax 线程本来就持有有效 key 的分数,它多读 个分数,把第 列加到第 列上即可。因为这一步发生在 mask 和行最大值之前,在线 softmax 看到的已经是完整的 ,running max、重缩放和归一化逻辑完全不用改。
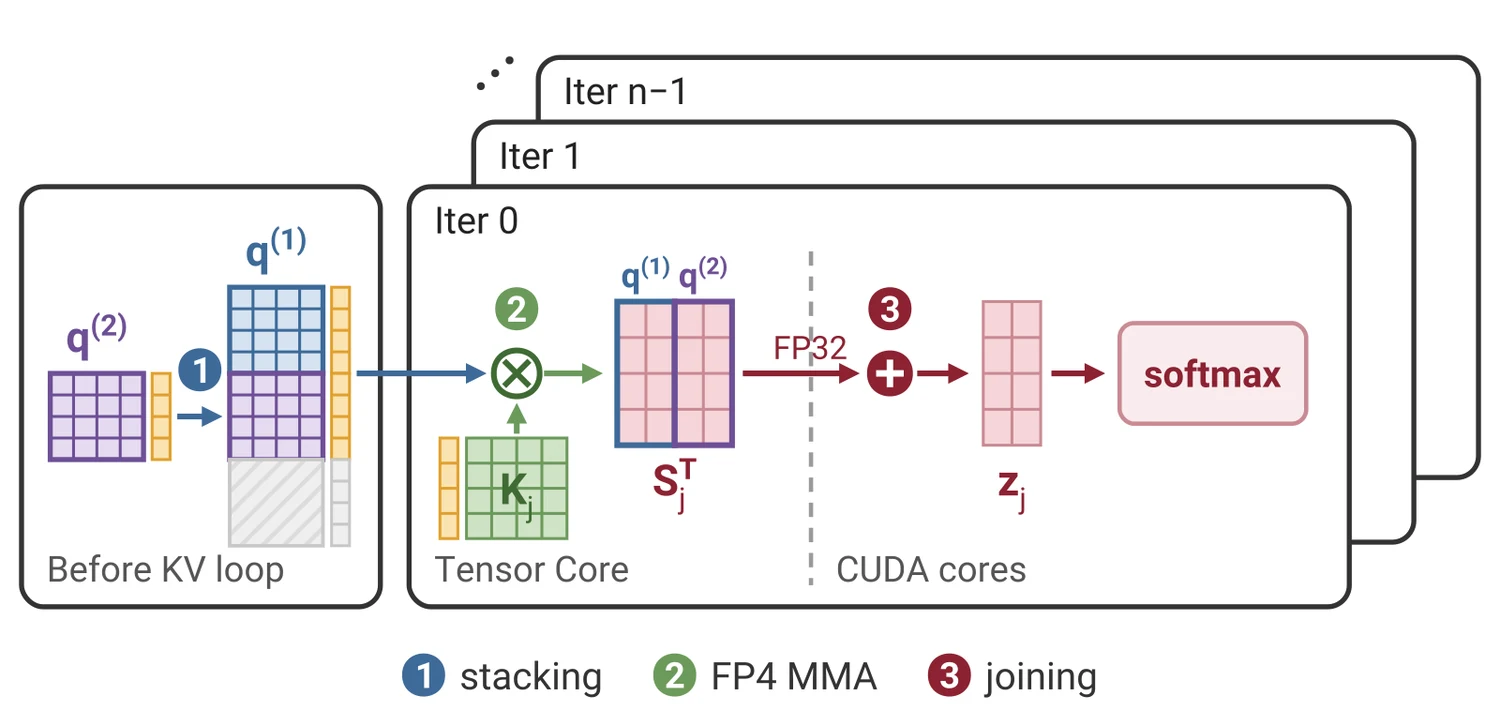
图上标出了三个阶段:左侧 “Before KV loop” 是堆叠动作, 与 的 tile 并排,虚线框表示补零行;中间 “Tensor Core” 是一次 FP4 MMA,输出 的两半;右侧 “CUDA cores” 是 softmax 线程在寄存器里做 + 合并,再进入 exp、缩放与量化。这个设计把”多一个查询项”的代价从一次额外 MMA 降成一次 load warp 的复制加 softmax 里的一个加法。
效果在消融里很明确:转置 softmax 之后,单独发残差 MMA 会让完整配方的开销达到 10.3%;堆叠之后整套算法修正的运行时开销被压在 4% 以内,并且仍然快过 TRT-LLM-NVFP4。换句话说,论文的”无损精度”不是靠牺牲速度换来的,算法与 kernel 是互相让路的。
系统改造三:混合精度在线服务与分页元数据
前两节都在单个 kernel 内部。真正的服务还要面对分页 KV Cache、变长序列、批内请求进出,以及两个不能量化的特殊区域。
哪些 token 不能放进 FP4
论文沿用 BitDecoding 的混合精度缓冲,保留两类 BF16 token:
- 注意力汇点(attention sink):序列最前面的 16 个 token。已有工作(StreamingLLM)表明这些 token 承担了 softmax 的稳定器角色,量化误差会通过它们影响全局。
- 最近 token:还不满一个 128-token 页的尾部 token。它们刚被写入、马上要被后续查询读到,留在 BF16 既省一次量化,也避免”写入即量化”的往返误差。
这两类 token 与 FP4 页在同一次 Tensor Core 流水线里处理,不是单独发一个 kernel。
长上下文切分:别让汇点变成拖尾
长上下文解码沿用 Flash-Decoding 的做法,把一个请求的 FP4 页切给多个 CTA 并行,各自算部分注意力,最后按 log-sum-exp 加权合并。这里有个容易忽略的负载均衡问题:如果把 BF16 汇点和最近 token 挂在某一个 FP4 分片上,那个 CTA 就会变成拖尾,其他 CTA 早早算完等它。
论文的做法是把汇点和最近 token 合并进一个额外的 CTA,与 FP4 分片并列。这些 token 数量少(16 个汇点 + 最多 127 个最近 token),单独一个 CTA 很快算完,同时占用了原本闲置的 SM;所有部分输出再做 LSE 加权合并。
分页缓存里的元数据
vLLM 按固定大小的 block 按需分配 KV Cache,每个请求有一张 block table 把逻辑页映射到物理块。BitDecoding-FP4 把一个 FP4 页和它的块缩放放在同一个 cache block 里;BF16 汇点与最近 token 则放在分页缓存之外的独立缓冲,每个运行中的请求占一个槽(slot)。
问题在于:vLLM 引擎不知道这些槽的存在,也不会把请求身份传给注意力 kernel。如果每次 decode 都要回主机查”这一行 batch 对应哪个槽”,就会引入同步,破坏 CUDA Graph 的捕获与回放。论文用一个设备端的轻量控制 kernel 解决:
- 控制 kernel 用”持有该请求第一页的 cache block”来识别 batch 行 ——这个块在请求生命周期内不变,可以作为稳定的身份。它把该标识与槽表比对,槽表记录每个槽的拥有者和最后一次被看到的 step。图 7 里行 匹配到槽 ;新请求 拿走最近最少使用且无人认领的槽 ; 仍属于它的请求,只是这一步没被批进来。
- 根据序列长度,控制 kernel 把每行拆成 FP4 部分与最近 token 部分(图中 384 与 128),再加上 16 个汇点;汇点在第一页里的 FP4 副本被 mask 掉,避免重复计算。
- decode kernel 通过 block table 读 FP4 页,通过每行的槽读 BF16 token。当最近 token 填满一页(图中的 ),在最后一层写完那个填满页的 token 之后,把这一页量化进早已为它预留的 cache block。
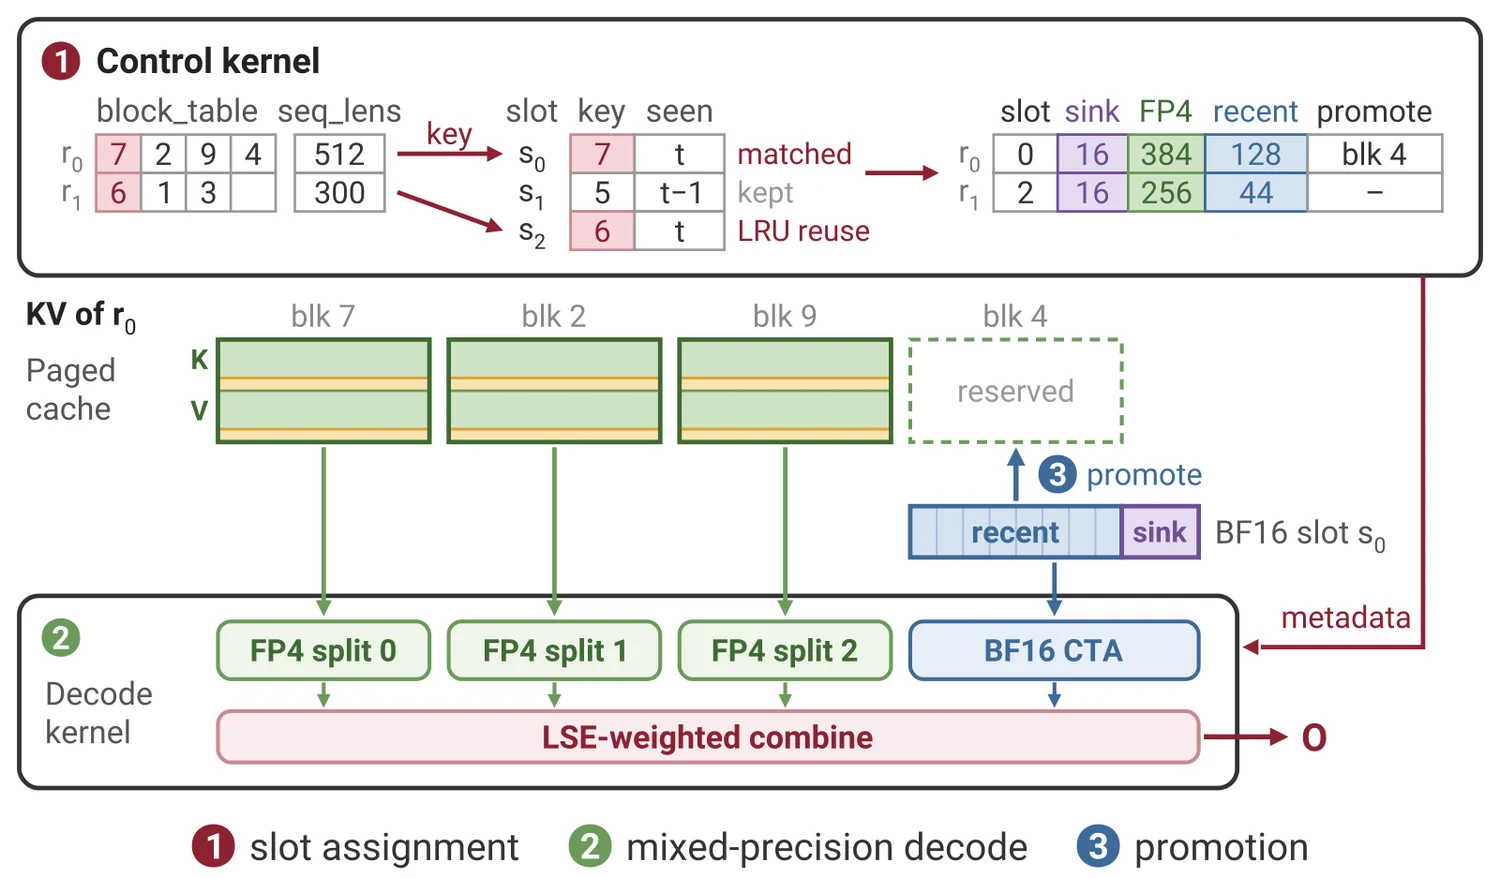
图分三层:上方是控制 kernel 的槽表(slot、key、seen 三列)与”匹配/保留/LRU 复用”三种判定;中间是分页缓存,标着 blk 7、blk 2、blk 9 与新请求的 reserved 块;下方是 decode kernel 的 LSE 加权合并。三个编号圆圈对应论文描述的三步:槽分配、混合精度解码、页满晋升(promote)。整个元数据流不离开设备,因此解码不需要主机同步,也能被 CUDA Graph 完整捕获。
代价被压得很低:batch 1、4K 上下文下,Kitty 风格的 BF16 汇点管理每步要加 1.5 ms,而这个控制 kernel 把解码开销控制在 95 μs(比 Kitty 低 15.8 倍,比 TRT-LLM-NVFP4 与 SAW-INT4 低 3 倍);预填充侧开销 1.46 ms,与 SAW-INT4 持平,比 TRT-LLM-NVFP4 低 2.6 倍。
精度:接近无损,并且跨过 FP8
实验配置需要先交代清楚:四款模型覆盖了稠密模型与 MoE 模型、GQA 与 MLA 两类注意力——Qwen3-4B-Thinking-2507、Qwen3-30B-A3B-Thinking-2507(稠密与 MoE,GQA)、GLM-4.7-FP8(355B,GQA)、Hy4-preview(770B,稀疏 MLA)。长上下文任务用 LongBench Pro、MRCR、RULER-NIAH,长推理任务用 AIME 2024/2025、LiveCodeBench v6、GPQA-Diamond。硬件是 NVIDIA B300(SM103,288GB)与 RTX PRO 5000(SM120,72GB),kernel 基准在两块卡上都跑。
主结果表
Qwen3-4B-Thinking 在 256K 上下文下的对比(数值为百分比,TPOT 单位为 ms):
| 方法 | LB-Pro | MRCR | RULER | AIME24 | AIME25 | LCB v6 | GPQA | 平均 | TPOT | 相对加速 |
|---|---|---|---|---|---|---|---|---|---|---|
| BF16 KV | 53.27 | 38.82 | 96.28 | 83.44 | 81.15 | 53.86 | 66.98 | 67.69 | 7.74 | 1.00× |
| FP8 KV | 52.60 | 37.67 | 94.42 | 82.29 | 78.75 | 50.86 | 66.86 | 66.21 | 5.43 | 1.43× |
| TurboQuant-4bit-nc | 49.78 | 32.91 | 93.15 | 77.40 | 72.29 | 47.43 | 64.96 | 62.56 | 94.46 | 0.08× |
| SAW-INT4 | 49.92 | 31.57 | 91.19 | 79.69 | 75.63 | 52.86 | 64.02 | 63.55 | — | — |
| TRT-LLM-NVFP4 | 44.89 | 28.84 | 80.04 | 76.56 | 72.29 | 48.71 | 63.01 | 59.19 | 4.63 | 1.67× |
| BitDecoding-MXFP4 | 52.96 | 35.61 | 94.46 | 81.56 | 80.42 | 55.14 | 66.73 | 66.70 | 4.34 | 1.78× |
| BitDecoding-NVFP4 | 52.34 | 36.68 | 95.68 | 82.50 | 80.62 | 56.14 | 66.92 | 67.27 | 4.28 | 1.81× |
几个点值得拆开看:
- 平均只差 0.42 个百分点(67.27 对 67.69),论文口径是”0.5 以内”。逐项看,差距主要集中在 MRCR(2.14 点)与 LB-Pro(0.93 点),这两项都是长上下文检索;AIME25 甚至反超 BF16(80.62 对 81.15 只差 0.53,LCB v6 反而高 2.28 点,这两项更多受采样噪声影响)。
- 4 位精度超过 8 位:平均 67.27 对 FP8 的 66.21,MXFP4 变体 66.70 也比 FP8 高。这乍看反直觉,其实是两类误差性质不同:FP8 是 E4M3 统一格式,概率下溢与 Key 离群值都没有专门处理;FP4 虽然元素位更少,但有 16/32 元素的细颗粒度缩放和三项算法修正,误差结构被重新塑造了。
- TRT-LLM-NVFP4 的崩点很集中:RULER 从 96.28 掉到 80.04,MRCR 从 38.82 掉到 28.84,都是检索类的长上下文任务。这与”概率块被整体清零”的分析吻合——检索任务恰恰依赖那些 logit 较低的远端 token。
- TurboQuant 的延迟是另一回事:TPOT 94.46 ms,比 BF16 慢 12 倍。它的精度(62.56)也不如 BitDecoding-FP4,说明向量码本的在线查表在这个具体场景里既没换来精度也没换来速度。
Qwen3-30B-A3B 趋势类似:BF16 平均 73.15,BitDecoding-NVFP4 为 72.74(差 0.41),MXFP4 为 72.60(差 0.55),TRT-LLM-NVFP4 为 67.25(差了近 6 点);TPOT 从 6.66 ms 降到 4.34 ms,1.53 倍加速。
大模型与 MLA
Qwen3 系列只是 GQA 加稠密/MoE 的组合。论文进一步在 GLM-4.7(355B,GQA)与 Hy4-preview(770B,MLA)上验证:
| 模型 / 上下文 | 方法 | LB-Pro | MRCR | AIME25 | KV 占用 |
|---|---|---|---|---|---|
| GLM-4.7,200K | BF16 KV | 67.40 | 61.85 | 93.23 | 71.88 GiB |
| FP8 KV | 65.87 | 61.27 | 92.40 | 35.94 GiB | |
| TRT-LLM-NVFP4 | 62.28 | 56.29 | 91.88 | 20.21 GiB | |
| BitDecoding-NVFP4 | 66.74 | 60.83 | 93.75 | 20.27 GiB | |
| Hy4-preview,1M | BF16 KV | 60.29 | 67.96 | 98.65 | 90.46 GiB |
| FP8 KV | 59.71 | 67.83 | 98.96 | 52.68 GiB | |
| BitDecoding-NVFP4 | 60.32 | 67.84 | 98.75 | 34.41 GiB |
GLM-4.7 上,BitDecoding-NVFP4 与 BF16 平均差 0.4 点,KV 从 71.88 GiB 压到 20.27 GiB(3.5 倍);TRT-LLM-NVFP4 虽然占用相近,但检索任务掉了 5 点以上。Hy4-preview 上,三项任务与 BF16 的最大差距只有 0.12 点,1M token 的 KV 从 90.46 GiB 降到 34.41 GiB,比 BF16 小 2.6 倍、比 FP8 小 1.5 倍。
MLA 为什么没有速度加速
论文明确说明 Hy4-preview 没有给延迟加速数据,原因是它用的是稀疏 MLA,每步只看固定 2048 token 的活跃窗口。活跃窗口内注意力计算量本来就小,低比特 KV 量化的主要收益变成容量——1M 上下文能不能放得下——而不是带宽。这是模型架构决定的收益分配,不能当作”FP4 解码没用”。
MLA 的 FP4 实现也不是照搬 GQA。按论文附录,MLA 的 latent 缓存 同时服务于分数乘积和上下文乘积,两个乘积的归约轴不同:分数 GEMM 要求块沿通道维对齐,上下文归约如果也在 FP4 上做,就得在运行时沿 token 维重新量化同一份 latent。论文的选择是:分数路径走 FP4(对旋转后的吸收查询做双残差、对 latent 做离群感知量化),上下文路径则在运行时把当前 latent 块反量化,在 FP16 里累加加权 latent,并且省略概率量化。此外,因为 latent 在 value 路径里也要用,做 value 上投影前还要把 Hadamard 旋转逆回去、恢复 latent 均值(实际上这两步可以离线折进投影矩阵)。位置编码相关的查询与缓存则保持 BF16。
这一段的工程含义是:同一个 FP4 算法在 GQA 与 MLA 上的收益结构不同,MLA 的注意力几何让一部分乘法的 FP4 化得不偿失,与其强行统一起见,不如在关键的容量维度上拿收益。
性能:kernel 与端到端
解码 kernel
128K 上下文、batch 1 到 64 的范围内比较解码 kernel 相对 BF16 KV 的加速:
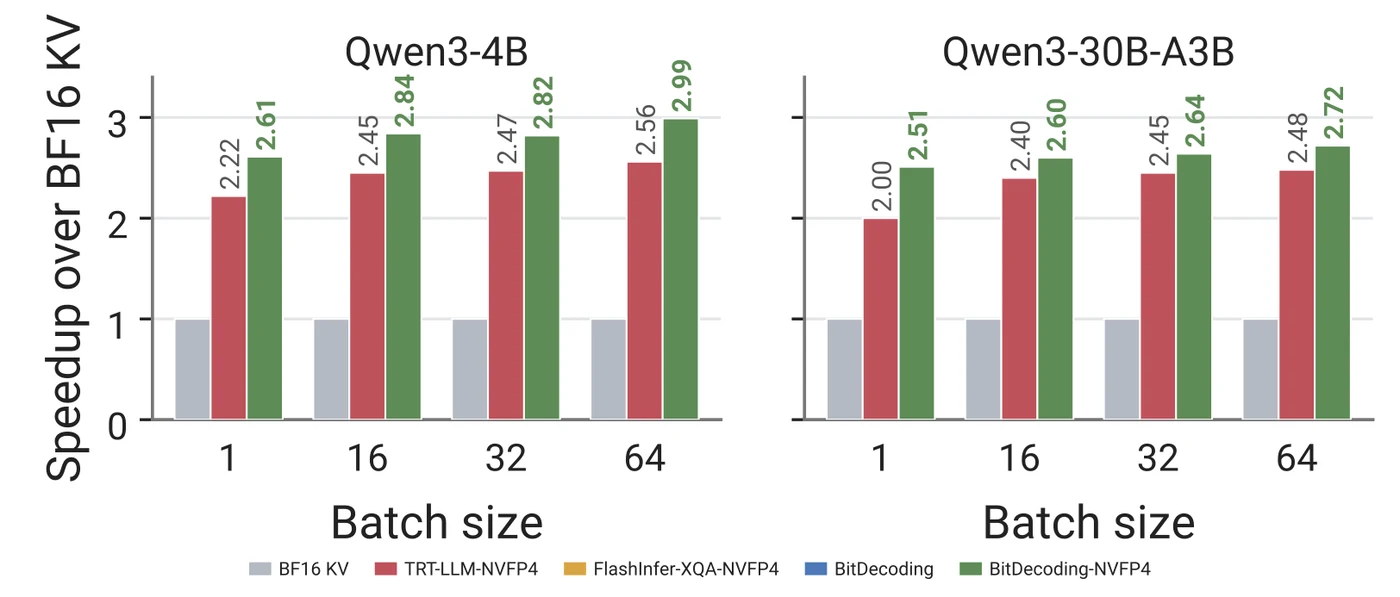
B300(SM103)上,Qwen3-4B 最高 2.99 倍,Qwen3-30B-A3B 最高 2.72 倍,且在所有 batch 上都超过 TRT-LLM-NVFP4——注意它跑的是完整精度配方,不是简化版。RTX PRO 5000(SM120)上分别是 4.01 倍和 3.96 倍,同时超过 FlashInfer-XQA-NVFP4 和反量化路线的 BitDecoding,因为它把两个 GEMM 都放到了 FP4 Tensor Core 上。SM120 加速更高与卡本身的特性有关:RTX PRO 5000 的显存带宽/算力比例不同于 B300,解码更受带宽约束,FP4 削减字节数的收益在它上面更明显。
端到端服务
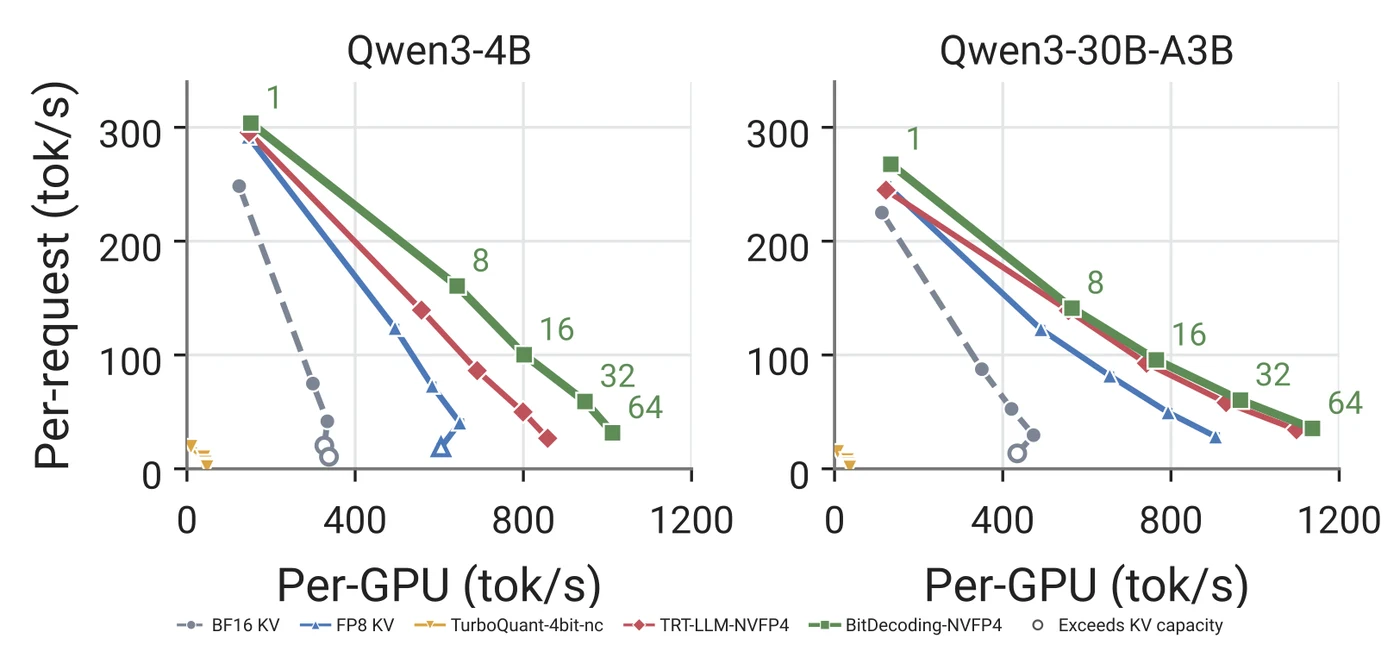
图是 128K 输入 / 2K 输出、TP=2 的端到端吞吐,横轴是并发请求数 1、8、16、32、64。BF16 与 FP8 KV 在并发上升后很快耗尽 KV 容量,多出来的请求被排队或抢占,吞吐曲线提前压平;BitDecoding-NVFP4 在 64 并发下仍能把所有请求放进显存,峰值单卡吞吐比 BF16 KV 高 2.4 到 3.0 倍,与 TRT-LLM-NVFP4 持平或更高。64K 输入、TP=1 的配置趋势相同。
这里真正起作用的不是 kernel 的 3 倍加速,而是容量:同样的显存装下 4 倍数量的长上下文请求,批大小上去之后 GPU 才真正吃满。这是 KV 量化在服务层面最容易被低估的收益。
RL rollout 里的表现
论文还用 DAPO 风格的 RL 后训练验证了 KV 量化在训练期 rollout 生成中的表现——这里只作为背景提一句:模型用 BF16 权重,只用不同的 KV Cache 方法生成 rollout,评估 mean@4 精度。
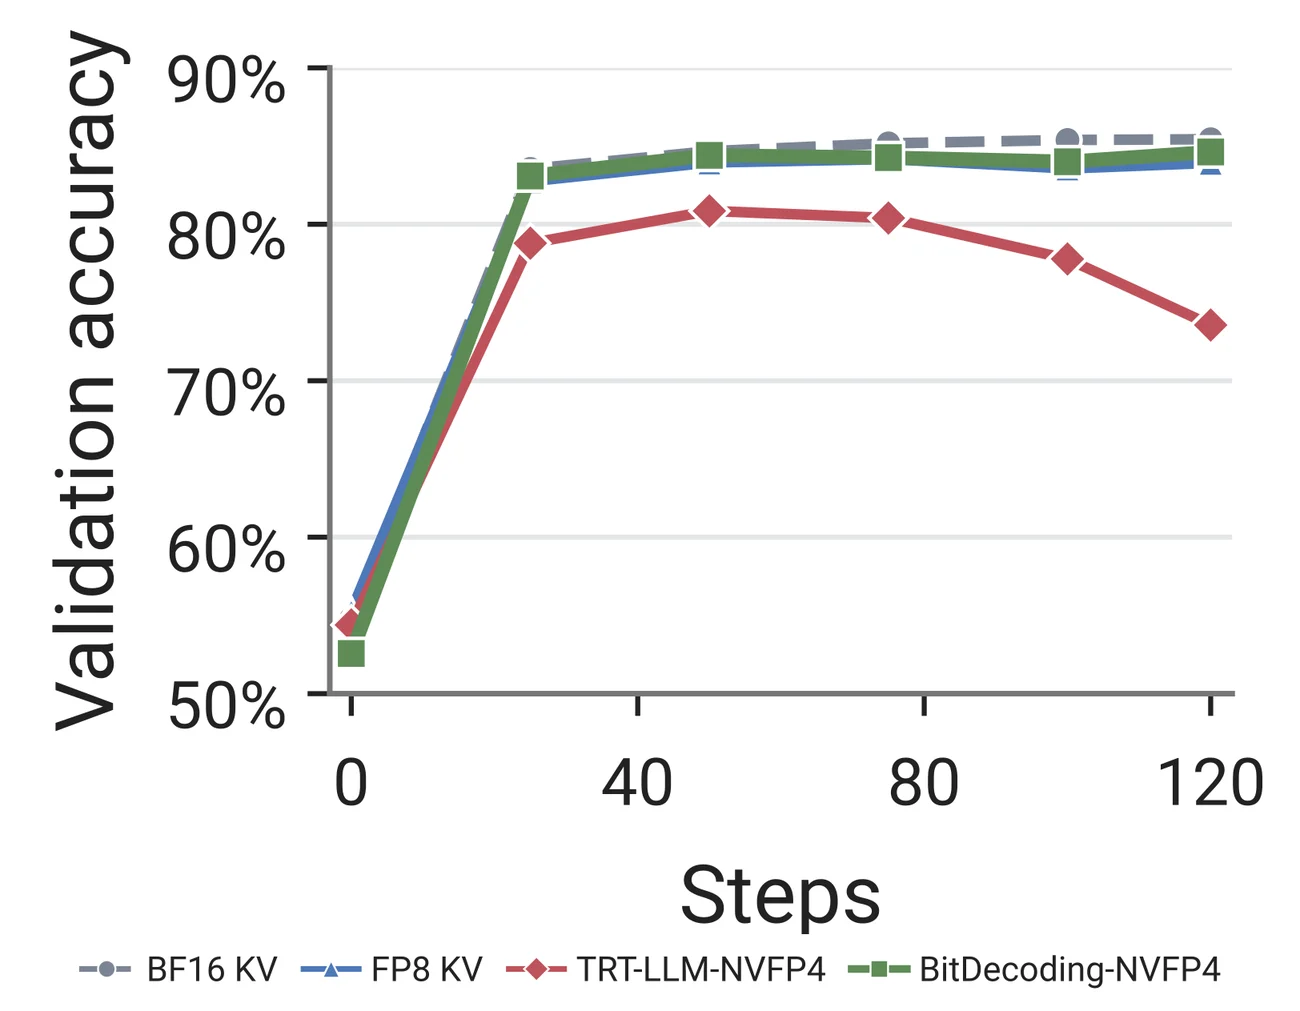
左半是精度曲线的总体走势,右半是对应图例。TRT-LLM-NVFP4 在长推理轨迹下明显低于 BF16,曲线中段就开始掉;BitDecoding-NVFP4 全程贴着 BF16 KV。这与前面”接近 90% 概率块被清零”的分析一致:rollout 越长,下溢越严重,朴素 FP4 的 rollout 质量越差,而 RL 对 rollout 分布的偏移极其敏感。DeepSeek-V4.1-Flash 采用朴素 NVFP4 KV 并在局部滑窗注意力上保留 FP8,论文把这一选择作为”未处理 FP4 误差源”的例子来对照。
消融
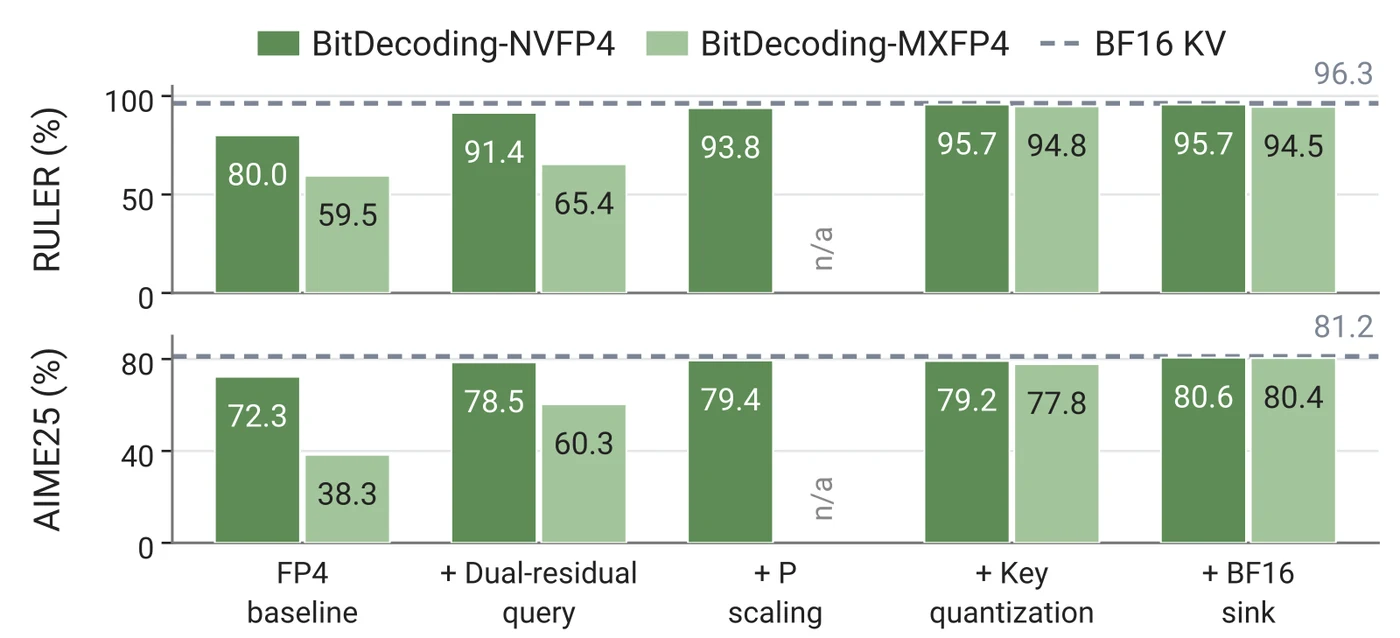
精度消融按 NVFP4/MXFP4 两组展开:MXFP4 的增益主要由双残差查询与离群感知 Key 量化贡献(它的 E8M0 缩放不会下溢,所以不做概率缩放);NVFP4 里,双残差查询把大部分差距收回,防下溢概率缩放把 RULER 检索恢复回来,离群感知 Key 量化补上剩余部分。三条修正分别对准三个误差源,消融的顺序也基本按误差贡献大小排列。
kernel 侧消融则给出了一条清晰的因果链:传统行 softmax 下,softmax 与概率量化把执行卡住,Qwen3-30B-A3B 上比 TRT-LLM-NVFP4 慢 2.1 倍;换成转置 softmax 后纯 kernel 延迟几乎减半(1.91 倍);这时单独发残差查询 MMA 的 10.3% 开销浮现出来;堆叠查询 MMA 把这一项折进一次窄 MMA,整套配方开销压到 4% 以内。每一步都在解决上一步暴露出来的问题,而不是预先堆设计。
方法背后的方法论:teacher-forced KL
论文附录里有一项很值得借鉴的评估方法:teacher-forced KL。端到端 benchmark 既慢又吵——量化后的模型一旦在不同位置采样出不同 token,后续轨迹就分叉,逐样本得分差异大部分来自采样而不是量化。当配置之间的差距已经缩到零点几个百分点时,端到端分数根本分不开它们。
做法是两遍前向:
- 用 BF16 KV 按评测采样器生成参考轨迹 ,同时记录每一步的 next-token 分布 。
- 每个 FP4 配置解码同样的提示,但被强制沿 走——第 步从自己的量化 KV 算出 ,然后发出 而不是采样。vLLM 的 logits processor 负责强制,因此配置走的是未经修改的服务路径,包括缓存写入与 FP4 解码 kernel。
逐步散度是
其中 是 BF16 在第 步概率最高的 128 个 token——平均覆盖 99.996% 的概率质量,把长尾截掉不影响结论。对所有轨迹平均后,用配对 检验比较两个配置的逐轨迹差异,抵消提示难度带来的大方差。
这个指标与端到端精度高度一致(Qwen3-4B 上 KL 单位 nats):
| 配置 | KL | top-1 不一致率 | MRCR |
|---|---|---|---|
| BF16 KV | 0.29 | 0.32% | 38.82 |
| BitDecoding-NVFP4 | 3.83 | 1.00% | 36.68 |
| BitDecoding-MXFP4 | 10.27 | 1.56% | 35.61 |
| TRT-LLM-NVFP4 | 39.62 | 3.59% | 28.84 |
KL、top-1 不一致率与 MRCR 三者排序完全一致;BitDecoding-NVFP4 把 TRT-LLM-NVFP4 的 KL 降到十分之一,收回了 MRCR 上 10 个点差距中的 7.8 点。
对于正在调量化参数的人,这个方法的价值在于:每改一个阈值、每去掉一个变换,都可以在几分钟内得到一个可比的数值,而不是等一整轮 benchmark。前面那几张消融表(Key 平滑、旋转、缩放搜索)就是用它做出来的。
与同领域工作的位置
理解这篇工作的位置,有助于判断它解决了什么、没解决什么。
- 与 BitDecoding 原版:原版解决的是”低比特 KV 缓存怎么以 Tensor Core 友好的方式组织”——把缓存布局与 MMA 的操作数布局对齐、把昂贵的反量化分散到 Tensor Core 的边缘。它的两个 GEMM 仍是反量化后算的。BitDecoding-FP4 在此基础上把查询和概率也压进 FP4,并做算法修正,收益叠加。
- 与 TRT-LLM 的 NVFP4 KV:TRT-LLM 是把 NVFP4 存进分页缓存的工程化实现,kernel 成熟,但量化本身是朴素的。差距集中在概率下溢与查询误差,所以长上下文检索类任务崩得明显。
- 与 TurboQuant:向量量化(vector quantization)把 4 个或更多维度联合编码进码本,理论失真率低,但解码时要在 GPU 上查表并按 codebook 重建,每一步都是标量或小矩阵操作。这正是”算法精度换系统吞吐”的典型:精度还行、速度崩了。
- 与 SageAttention3 / MXAttention / Attn-QAT:这些原生 FP4 注意力工作面向预填充、非因果、扩散或训练,操作数在每次调用内从 BF16 现做现量化;缓存解码的误差主要是”缓存里的值已经错了,还被反复读”,与”一次调用里的舍入误差”性质不同。SageAttention3 的两级 缩放与 BitDecoding-FP4 的防下溢缩放形式相近,但它的目标场景决定了两级缩放需要额外的逐 tile 重缩放,而这里把缩放折进了在线 softmax 的指数。
- 与旋转类方法(QuaRot、SpinQuant、OScaR):他们都用旋转抑制离群值,区别在于旋转矩阵(Hadamard 固定 vs 学习)、作用对象(权重+激活 vs 仅缓存)以及是否配合 token-wise 缩放。BitDecoding-FP4 只对缓存路径做旋转,代价小,但需要在写入前完成,并与 Key 平滑联合调参。
一句话概括这篇工作的定位:它把”FP4 KV 缓存”从”能存”推进到”能算且算得准”,并用 kernel 层面的重构让算法修正不拖慢速度。它没有发明新的数值格式,也没有改变注意力的数学结构——软硬件协同的意义正在于此。
局限与仍未解决的问题
按论文公开的信息,有几处边界需要读者心里有数:
- 硬件门槛高。实验与实现都依赖 SM100/SM103/SM120(B200/B300、RTX PRO 5000 一类 Blackwell 卡),CUDA 13.0 以上。较老的 Hopper、Ada 架构没有原生块缩放 FP4 Tensor Core,这套方法无法直接迁移,“FP4 算”在这些卡上会退化回”反量化后算”。
- MLA 的收益不对称。如前面所述,MLA 的上下文路径仍需要运行时反量化并在 FP16 累加,且稀疏 MLA 的活跃窗口让注意力计算量本身很小,收益主要体现在容量上。对 1M 上下文这类容量瓶颈场景没问题,对短上下文的 MLA 服务,收益需要重新评估。
- 校准依赖。Key 的静态均值 与概率阈值 都是一次性离线校准,随模型 checkpoint、上下文窗口变化需要重新校准。论文报告了 秒的单卡校准成本与跨校准集的稳定性,但对于频繁更换模型或窗口配置的部署,这是一项运维工作。另外, 是对 RoPE 之后的 Key 求的,依赖位置分布,窗口长度变化时校准文本需要重新平铺到新长度。
- 注意力汇点与最近 token 仍需 BF16。16 个汇点加最多 127 个最近 token 的 BF16 缓冲让实现更复杂:多一个缓存区域、一个设备端控制 kernel、一条页满晋升路径。这部分逻辑需要跟 vLLM 的调度与 CUDA Graph 配合,换框架就得重做一次。论文把它做成 vLLM 的 out-of-tree
CUSTOM后端,说明它在别的框架里并非零成本移植。 - 精度仍不是严格无损。MRCR 上 2.14 个百分点的差距是真实的,长上下文精确检索仍是最薄弱环节。论文的改进方向是把误差压到”端到端 benchmark 分辨不出来”的程度,而不是数学意义上的零误差。
这些并不削弱核心结论,但它们决定了”什么时候该用它”:长上下文、大并发、Blackwell 一代卡上的 GQA 服务是它最舒服的区间;MLA 稀疏注意力或老硬件,则要按收益结构另算。
对推理系统的启发
抛开这篇论文的具体配方,它给推理系统设计留下几条可以迁移的经验。
第一,量化方法的战场已经从线性层转移到注意力。权重、激活的 FP4 量化已有成熟配方(自适应块缩放、旋转、四六选择),但 KV 缓存与注意力概率从未有过相同的待遇。概率 的分布与权重完全不同(大量极小值、最大值依赖当前上下文),需要专门的缩放规则;这类”操作数分布驱动的量化设计”值得在 KV 量化里系统化。
第二,算法修正要按”kernel 能承受的代价”设计。双残差查询在数学上是多一次 GEMM,堆叠 MMA 把它变成一次 load 与 softmax 里的一次加法;防下溢缩放原本是每块乘常数,折进指数后变成免费。同样的算法思路,如果实现方式没跟 kernel 合作,就会像第一版那样吃掉 10% 的性能。站内 vLLM 源码完全拆解(三十七):MLA 注意力后端 也展示了注意力后端如何在多种 kernel 之间取舍,思路相通。
第三,端到端收益往往来自容量而非算力。kernel 3 倍加速听起来很响亮,但服务吞吐 2.4 到 3.0 倍的提升,很大一部分是”同样的显存装下更多并发请求”带来的批大小效应。做 KV 量化时,评估口径必须包含”在给定显存下能跑多少并发、多少长度”,只看单请求 TPOT 会低估容量收益、高估算力收益。
第四,元数据必须留在设备上。分页缓存之上再叠加混合精度缓冲、槽位分配,很容易引入主机同步,打断 CUDA Graph。用一个轻量控制 kernel 在设备端完成身份识别与槽分配,是这类”在引擎不知情的前提下扩展缓存”的必要手法。站内 CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图 讨论了同类约束。
小结
BitDecoding-FP4 的问题定义很朴素:Blackwell 的 Tensor Core 已经原生支持 FP4 矩阵乘,KV Cache 也已经能存成 FP4,为什么直接把两者拼起来既不准也不快?论文的答案分成两半。
算法侧,误差来自三个地方:查询量化在长上下文里被广播放大、softmax 概率在 E4M3 缩放下整块清零、Key 的通道离群值因 Tensor Core 的 token-wise 块布局被同块压扁。对应的三个修正是双残差查询、防下溢概率缩放、离群感知 Key 量化,消融显示三者缺一不可。
系统侧,瓶颈从 Tensor Core 转移到 softmax 与概率量化。转置 softmax 让归约跨 Key 并行并把概率量化融进蝶形归约;查询堆叠 MMA 把残差的第二次 GEMM 折进一次窄 MMA;设备端控制 kernel 让混合精度的分页缓存不需要主机同步。
结果层面,它在 Qwen3-4B/30B-A3B、GLM-4.7、Hy4-preview 上把平均精度维持在 BF16 KV 的 0.5 以内(MXFP4 为 1 以内),并超过 FP8 KV;在 B300 上给到 2.4 到 3.0 倍的服务吞吐。它说明了一个更一般的判断:低比特 KV 的下一段进步,不在于把格式再压低一位,而在于让量化的每一步都跟目标硬件的块布局与 kernel 结构对齐。
参考资料
- BitDecoding-FP4: Native FP4 KV Cache Decoding via Algorithm-System Co-Design
- BitDecoding-FP4 官方代码仓库(OpenBitSys)
- OCP Microscaling Formats (MX) Specification v1.0
- Four Over Six: More Accurate NVFP4 Quantization with Adaptive Block Scaling
- BitDecoding: Unlocking Tensor Cores for Long-Context LLMs with Low-Bit KV Cache
- TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate
- SageAttention3: Microscaling FP4 Attention for Inference
- Attn-QAT: 4-Bit Attention With Quantization-Aware Training
- FlashAttention-4: Algorithm and Kernel Pipelining Co-Design for Asymmetric Hardware Scaling
- Efficient Memory Management for Large Language Model Serving with PagedAttention
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



