


线性注意力完全拆解:把 softmax 注意力改写成 RNN,快在哪里、又丢掉了什么
背景:二次方注意力与线性增长的 KV Cache
标准 Transformer 的注意力层要做两件事:先用 query 和所有 key 算出 的分数矩阵,再用它加权求和 value。序列长度翻倍,分数矩阵的元素数翻四倍;同时,自回归推理必须把每个历史 token 的 key 和 value 留在显存里,KV Cache 随上下文线性增长。两条曲线叠在一起,长上下文就成了显存带宽和容量的双重瓶颈。
具体到数字:一个 32 层、32 个注意力头、每头维度 128 的 7B 级模型,在 FP16 下保存 128K token 的完整 KV Cache 需要
这已经超过一张 80GB 显卡的可用容量。改用 8 个 KV 头的 GQA 后降到约 17.2 GB,仍然意味着单条请求就占掉五分之一的显存。解码阶段每生成一个 token,都要把这 17.2 GB 从头读一遍;GPU 的算力远没有被喂饱,时间花在搬运上。可参考 GQA 完全拆解 与 PagedAttention 完全拆解 了解工业界如何通过共享 KV 头和分页管理来缓解这个问题,但它们都只是在常数因子上做文章,没有改变「缓存随长度增长」这一事实。
线性注意力(Linear Attention)走的是另一条路:不再保留每个 token 的 K、V,而是把整个历史压缩进一个固定大小的矩阵状态。这个想法最早由 Katharopoulos 等人在 2020 年的 ICML 论文 Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention 中系统提出,论文标题就是结论:把 softmax 注意力改写成核函数形式之后,Transformer 在推理时等价于一个循环神经网络。
需要先厘清一个常见误解:线性注意力不是「把 softmax 去掉」这么简单,也不是对 softmax 注意力的无损近似。它换掉了注意力权重的定义方式,因此换来的是一类不同的模型,而不是同一个模型的加速版。下面的推导会把这个替换过程、等价的循环形式,以及由此产生的收益和损失逐项拆开。
从 softmax 注意力到核函数
先写出单头、单 query 位置的 softmax 注意力。给定 query 、历史 key 、value ,输出为
分子里的 是一个标量相似度,分母是所有相似度之和,用来把权重归一化成概率。把它写成矩阵形式,就是 ,其中 softmax 按行归一化,因果掩码把上三角位置置为 。
关键观察是:指数函数可以看成一个核函数。定义
注意力权重就是核函数在 query-key 对上的取值再归一化。核方法里有一个标准技巧:如果能找到特征映射 ,使得
那么两个向量的相似度就可以先在低维(或至少固定维)特征空间里各自映射,再做点积。Performer 的 FAVOR+ 就是用随机特征来逼近 softmax 核,论文 Rethinking Attention with Performers 给出了无偏估计和方差控制;Random Feature Attention 则在同一个思路上加入了门控,见 Random Feature Attention。
线性注意力做了一个更直接的替换:不要求 精确逼近指数核,只要它把 query 和 key 映射成非负向量,就用点积代替指数相似度:
这样一来,注意力权重变成
最常用的特征映射是 ,逐元素计算。加 1 是为了保证特征非负,从而让「权重」保持非负;ELU 在负半轴饱和到 ,加上 1 之后落在 ,在正半轴则近似恒等。也有工作用 ReLU、余弦映射或泰勒展开的特征映射,不同选择对应不同的归纳偏置。
这里已经出现了与 softmax 注意力的第一个实质差别:softmax 的权重是先算完整分数再做全局归一化,天然形成「赢家通吃」的尖锐分布;线性注意力的权重来自两个非负向量的点积,分布通常更平滑,且没有一个显式的指数放大机制。这个差别会在表达能力一节展开。
另一个容易被忽略的点是 的选择。特征维度越大,点积能承载的键值区分度越高,但状态矩阵也越大,推理时的固定开销越高。Based 论文把这一点做成了可调旋钮:增大线性注意力的特征维度,等价于增大循环状态,从而提高召回能力、降低吞吐,形成一条可以选择的帕累托前沿。后文会给出量化结果。
去掉 softmax:结合律如何把 变成
把线性注意力的分子重新整理。记 作用后的 query 和 key 分别为 、,分子为
注意括号里是一个标量,外面乘了一个向量。矩阵乘法满足结合律,所以可以把求和顺序改写成
右边括号里是 个 外积的和,记作矩阵状态
分子变成 ,只需一次矩阵-向量乘法。分母同理,记 ,分母为 。完整的输出为
成本对比一目了然:
| 形式 | 计算对象 | 时间 | 训练显存(朴素实现,单层序列维) |
|---|---|---|---|
| 二次方注意力 | 分数矩阵 | (FlashAttention 用重算降到 ) | |
| 线性注意力(并行形式) | 逐位置外积再前缀和 |
当 时,二次项被彻底消掉。论文在很长的序列上报告了相对基线最高约 4000 倍的自回归推理加速;这个数字对比的是未做 KV Cache 的朴素实现,实际工程中对比的是 FlashAttention 加 KV Cache 的成熟实现,倍数会小很多。
两种写法回答的是两个问题
上面的推导回答的是「怎么算」。接下来要回答的是「算完之后,状态怎么保存、什么时候更新」。这引出线性注意力的两种等价实现:
- 并行形式(parallel form):按上面的推导,一次处理整段序列,构造所有 的外积并做前缀和。这对应训练时的矩阵运算,能铺满 GPU,但显存占用与序列长度成正比。
- 循环形式(recurrent form):只维护单个状态 ,每读入一个 token 就做一次增量更新。这对应推理,显存与序列长度无关。
两种形式在数学上给出完全相同的结果,区别只在于执行方式和并行度。这是线性注意力最核心的结构性优势:同一套参数,训练时可以像 Transformer 一样并行,推理时可以像 RNN 一样只花常数内存。RetNet 论文把这种「同时具有训练并行、推理低成本」的性质作为卖点,并进一步给出三种形式(并行、循环、分块循环),见 Retentive Network。
训练并行、推理循环:同一个公式的两种执行方式
循环形式的推导
从 的定义出发,相邻两步的差是
这就是线性注意力的状态更新方程,每步只增加一个 rank-1 矩阵。结合输出公式,一个完整的线性注意力层前向是
# 线性注意力的循环形式:逐 token 更新 2D 状态# q_t, k_t, v_t 形状分别为 (d,), (d,), (d_v,)# phi 为特征映射,如 elu(x)+1
S = zeros((d_phi, d_v)) # 矩阵状态z = zeros((d_phi,)) # 归一化状态for t in range(T): qp = phi(q[t]) # (d_phi,) kp = phi(k[t]) # (d_phi,) S = S + outer(kp, v[t]) z = z + kp o[t] = (S @ qp) / (qp @ z)与 Transformer 解码时每步读取全部历史 KV 不同,这里每步只访问固定大小的 和 。把 和 合起来看,它们就是线性注意力模型在推理时需要保存的全部「记忆」,可以称为循环状态(recurrent state)。
这个循环状态与 KV Cache 的容量换算
设模型有 个查询头、 为值维度、 为特征维度。如果每个头独立维护状态,每层、每头的状态大小是 ,整个模型的状态为
全注意力在同样长度 下的 KV Cache 为 (若使用 GQA, 为 KV 头数)。令两者相等,可以得到「线性注意力的状态相当于缓存了多少个 token」的等效长度:
以 、(4:1 的 GQA)、、、 为例,。也就是说,这样一个线性注意力层的状态,在显存上只相当于多缓存了 256 个 token。若改成 ,等效长度是 1024; 则是 2048。
这个换算解释了为什么线性注意力在长上下文上收益极大,也解释了为什么它在短序列上不一定快:状态虽小,但每步都要做一次 的矩阵-向量乘,加上门控、卷积等固定开销,当 只有几百时,这些开销可能超过一次规整的 矩阵乘法。Kimi Linear 的实测也印证了这一点:4K 到 16K 区间与 MLA 延迟接近,128K 以上差距才持续拉开(见本站 Kimi Delta Attention 完全拆解)。
一个容易混淆的等价关系
线性注意力和「去掉 softmax 的注意力」在使用同样特征映射时是同一个东西,但和「把注意力后的线性层去掉」毫无关系。另一个常见的困惑是状态矩阵 的秩:它是 个 rank-1 外积之和,秩最多为 。这意味着它能记住的独立键值关联不超过 个。一旦历史中不同键值对的数量超过这个上限,状态就必然发生覆盖式遗忘。这就是线性注意力「有限记忆容量」的矩阵形式表述,也是后续所有改进(门控、Delta Rule、混合架构)试图缓解的根源。
更早的理论视角来自 Schlag 等人的 Linear Transformers Are Secretly Fast Weight Programmers:线性注意力的状态更新与 1990 年代的 fast weight 机制在形式上完全一致,二者都是用外积把输入编程进一个快速变化的权重矩阵。这个视角带来的启示是:既然是「编程」,就可以换成更聪明的写入规则,比如只在预测有误差时才修正。后面讲 DeltaNet 时,这正是它的出发点。
因果掩码与分块形式
因果掩码如何进入状态
上面推导的状态更新 本身就隐式实现了因果掩码:时刻 的输出只用到前 步累积的状态,自然看不到未来 token。这正是循环形式相对二次方注意力的另一个便利之处:因果性由执行顺序保证,不需要构造掩码矩阵。
但在并行形式(训练)中,因果性需要额外处理。朴素做法是把所有两两相似度排成一个 矩阵再掩码,这又回到了二次方复杂度。正确的做法不是构造掩码矩阵,而是直接对状态做前缀和。对每个位置 ,定义
则输出就是 。训练时沿序列维对 和 各做一次 cumulative sum(cumsum),就能一次性得到所有位置的 与 ,全程不出现 矩阵。因果性由「前缀和只累计到当前位置」保证,这与循环形式中「按顺序更新状态」是同一件事,只是在时间轴上换成了并行前缀和。
代价是中间张量:所有 拼起来的大小是 ,显存仍与序列长度成正比;同时 cumsum 是典型的带宽受限操作,在长序列上未必比矩阵乘快。这两点正是下面分块形式要解决的。
块内并行、块间递推
上面这种全局前缀和实现虽然去掉了 ,但需要全程保留 个中间向量,显存仍与 成正比。工业实现普遍采用更实用的折中:分块(chunk)。
- 把序列切成若干个长度为 的块;
- 块内用并行的二次方计算( 很小,可以整块放进共享内存或寄存器);
- 块间只传递一个状态矩阵,按循环方式递推。
设块 的起始状态为 ,块内输出为
块内部分沿用二次方注意力,块间部分用 这项把历史信息注入。更新则写作
这就是 RetNet 的「chunkwise recurrent」表示(见其论文第 2.1 节公式 (7)),也是 Mamba-2 的 SSD 框架与 GLA 的 FLASHLINEARATTENTION 算法共同采用的结构。它同时具备了三种性质:
- 块内二次方,但常数很小: 一般取 64 到 256,块内矩阵乘可以直接用 Tensor Core;
- 块间线性递推:状态只在块边界更新,块内各块之间天然并行;
- 训练显存与长度线性相关:只需要保存每个块的输入和块状态,不需要 中间量。
GLA 论文的 Figure 3 用一张注意力式的示意图说明了这种计算方式:块内依赖用实线直接计算,块间依赖(灰色部分)通过状态传递,不在块内直接算出。Mamba-2 论文把同一套分块结构纳入 SSD 框架,并用 Triton 实现了硬件感知版本。
# 线性注意力的分块(chunkwise)前向# 为了简洁,省略特征映射 phi、门控与衰减;假设块长 C 整除 TS = zeros((d_phi, d_v)) # 跨块状态for i in range(T // C): Qc = Q[i*C:(i+1)*C] # (C, d_phi) Kc = K[i*C:(i+1)*C] # (C, d_phi) Vc = V[i*C:(i+1)*C] # (C, d_v)
# 块内:带因果掩码的二次方注意力 intra = (Qc @ Kc.T * causal_mask(C)) @ Vc
# 块间:用上一块的累计状态 inter = Qc @ S
O[i*C:(i+1)*C] = intra + inter
# 状态更新:只做一次外积累加 S = S + Kc.T @ Vc Z = Z + Kc.sum(dim=0) # 归一化状态同理RetNet 的两种视图
RetNet 的 Figure 3 把并行表示与循环表示并排放置,直观展示了同一套 retention 参数如何对应两种执行路径:左图是并行表示,输入 依次经过 、、 投影,输出 一次性得到;右图是循环表示,每一步接收 ,更新状态 ,再输出 。公式上,循环表示对应
其中 是一个固定衰减因子。论文还给出了第三种「chunkwise recurrent」表示,与前两节的分块形式相同。
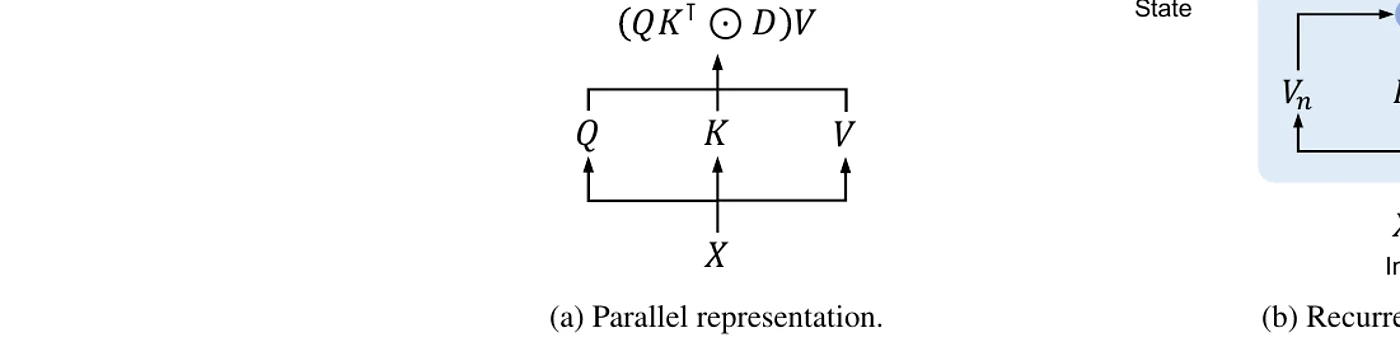
上图出自 RetNet 论文 Figure 3。左半部分(a)是并行表示:输入经过线性投影得到 ,以 的形式一次算出全部输出;右半部分(b)是循环表示:每一步用 递推状态,再乘上当前 query 得到输出。 里的 是衰减矩阵,(),它让过去的 token 随着距离衰减,起到类似位置编码的作用。注意:RetNet 的衰减因子 是每个头固定的标量,不随输入内容变化,这一点与后续的门控线性注意力不同。
线性注意力丢掉了什么
线性注意力的收益来自两处「压缩」:把 的注意力矩阵压成 的状态,把随长度增长的 KV Cache 压成常数。压缩必然有代价。下面从四个层面拆开:注意力矩阵的秩、状态容量、位置信息、以及可计算性。
注意力矩阵被压成了低秩矩阵
在标准注意力里,注意力矩阵 是一个 的行随机矩阵。只要 query/key 维度足够、logits 足够尖锐,它可以逼近任意一个置换矩阵——这正是「精确检索」的数学形式:第 行只在某个历史位置 上取接近 1 的权重,其余接近 0。
线性注意力的注意力矩阵是
其中 、。无论 多大, 的秩都不超过 。换句话说,这个 矩阵的所有行都落在一个 维子空间里,第 行的注意力分布是 个「基模式」的线性组合。它能表达平滑的、多峰但相关的权重,却无法为每个 query 独立地指定一个尖锐的 one-hot 位置。
这不是实现细节,而是模型类的硬约束:低秩矩阵无法逼近满秩矩阵。当任务要求在长上下文中精确定位某一个 token(例如从一段代码里复制一个变量名、从对话里找回一个日期),softmax 注意力可以用尖锐的分数完成,线性注意力只能把信息混合进状态,再由状态近似地读出来。混合得越多,读出的精度越差。
状态容量决定了「能记住多少」
状态 只有 个浮点数。它要同时保存所有历史键值对的关联,必然存在容量上限。前面已经算过: 是 个 rank-1 外积之和,最多只能表示 个线性无关的键方向;超过之后,新写入会覆盖旧关联。
Zoology 论文系统地量化了这个后果。作者预训练了 17 个注意力与门控卷积模型,发现当时最好的门控卷积架构在 Pile 上的困惑度仍比注意力高最多 2.1 个点,而其中 82% 的差距可以用「关联召回」(associative recall)解释:上下文里先出现一个 bigram,后面再出现它的前半段,模型能否补出后半段。更极端的结果是,一个 70M 参数的注意力模型在关联召回上超过了一个 1.4B 参数的门控卷积模型。
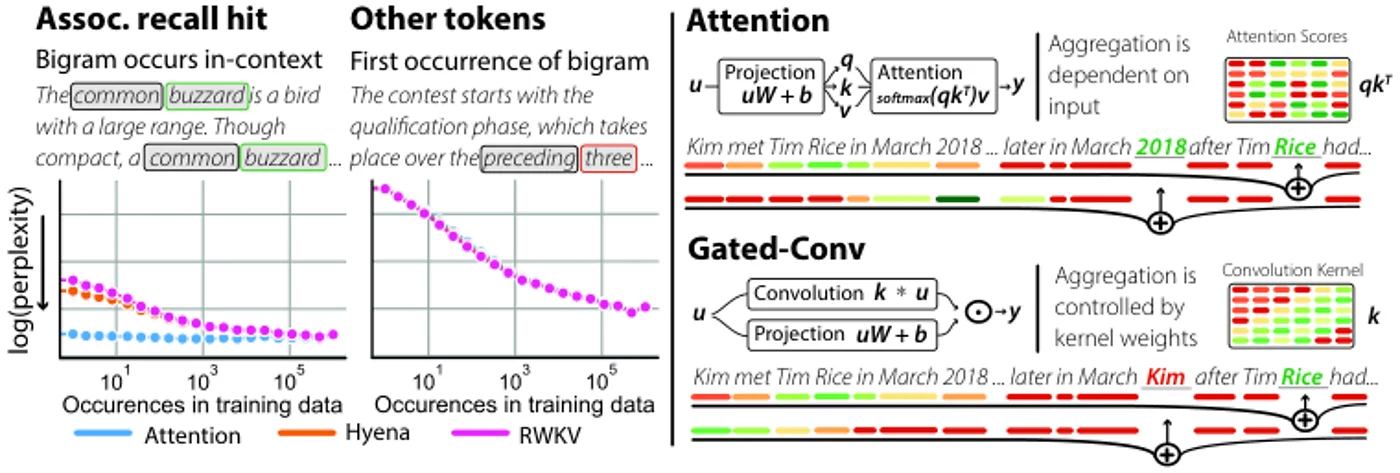
上图是 Zoology 论文的 Figure 1:横轴是 bigram 在训练数据中出现的频率,纵轴是验证集困惑度,曲线按「预测的 token 是否是上下文里出现过的 bigram」分层。注意力模型(Attention)在低频 bigram 上的困惑度明显低于 Hyena、RWKV 等固定状态模型;差距集中在「需要从上下文里回忆曾经见过的组合」这一类 token 上,而不是所有 token。这说明固定状态模型的短板不是语言建模的整体能力,而是精确的上下文检索。
Zoology 还做了一个控制变量实验:在 MQAR(multi-query associative recall)合成任务上,固定状态模型可以通过增大模型维度提升准确率,但在序列变长时,同样维度下的准确率下降得比注意力快。
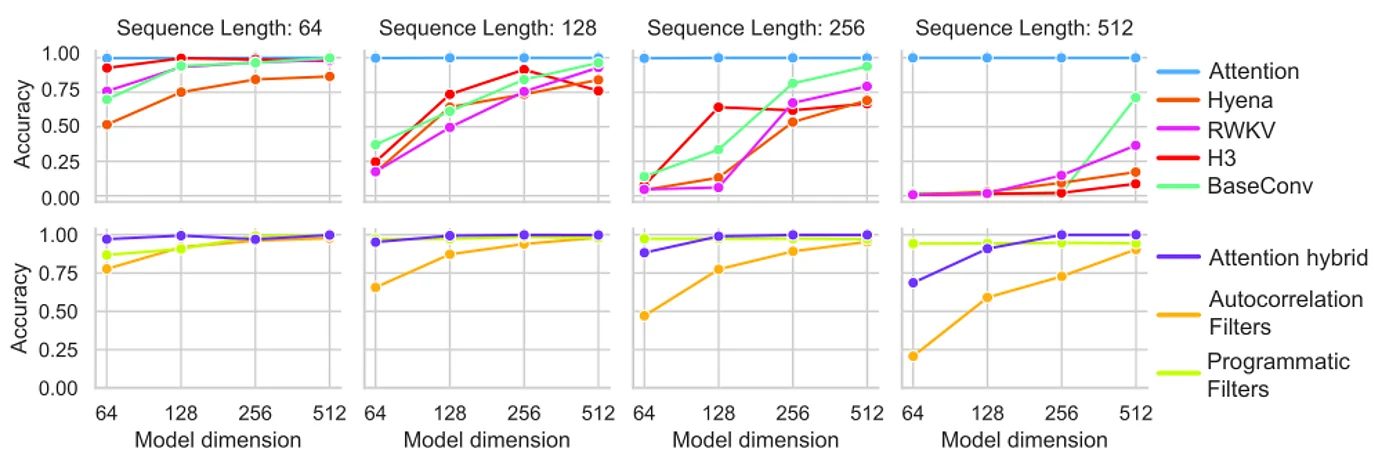
这张 Figure 2 展示的是 MQAR 任务:序列里埋入若干键值对,末尾给出若干个 key,要求模型输出对应的 value。四个子图的序列长度从 64 增加到 512,横轴是模型维度。注意力(Attention)在四个长度上都随维度提升迅速逼近满分;Hyena、RWKV、H3 等固定状态模型在短序列上还能跟上,序列变长后准确率明显落后。注意这里的横轴是模型维度而不是状态大小:即便把参数堆得更大,固定状态模型的有效记忆仍受状态维度限制。
位置信息不是默认存在的
把 取成恒等映射,线性注意力的输出只依赖所有历史 的集合,与它们的顺序无关。原因是状态更新只做累加,交换任意两个 token 的写入顺序,最终的 完全相同。这意味着纯线性注意力是一个「词袋」模型,必须额外注入位置信息,否则连「A 在 B 之前」这种关系都学不到。
三种常见做法:
- 衰减:RetNet 的 让越久远的 token 权重越小,顺序因此变得可区分;
- 门控:GLA 的 按输入内容决定每个通道的遗忘速度,相当于让位置衰减变成数据相关;
- 短卷积:Mamba 在状态更新前加一层因果 depthwise 卷积,把局部顺序编码进输入。
这三种机制的共同点是:都在状态更新路径上引入「非对称」——写入顺序会影响最终状态。代价是状态更新不再是简单的加法,kernel 实现要额外处理衰减、门控和卷积。
精确复制与状态追踪的能力上限
固定状态带来的限制有更硬的理论版本。「Repeat After Me」论文证明:两层 Transformer 可以复制指数级长度的字符串,而任何固定大小隐状态的模型(论文称为 generalized state space model)都无法做到,因为要原样输出 个 token,隐状态至少要能区分 种可能的输入前缀。实验上,预训练的 Transformer 在复制和从上下文检索信息上也显著优于 SSM。
另一个方向是状态追踪(state tracking)。「The Illusion of State in State-Space Models」证明 SSM 的表达能力同样被限制在 内,无法完成置换复合(permutation composition)这类简单的顺序状态追踪任务;换句话说,SSM 虽然结构上像 RNN,但并没有获得 RNN 的串行计算能力。线性注意力与 SSM 在数学上高度重叠(下一节会讲二者的对应关系),这类结论对理解线性注意力的能力边界有直接参考价值。
需要说明的是,这些结论针对的是「固定大小状态 + 有限精度」的模型类,不等于说每一个线性注意力模型都必然失败;状态越大、特征映射越丰富,能表达的函数越多。它们说明的是:在同等参数量下,线性注意力与 softmax 注意力不在同一个表达能力等级上,差距集中在需要精确记忆和串行状态追踪的任务。
数值稳定性与训练难度
softmax 的分母天然把输出约束在 value 的凸组合内,数值范围可控。线性注意力的分母 可能很小甚至接近零,尤其在特征非负但分布稀疏时;工程实现通常加一个 或改用 。此外,状态 随 累加,若不衰减,范数会持续增长,反向传播时容易出现梯度爆炸。门控与衰减不仅是表达能力的改进,也是数值稳定的必需品。
最后是一句来自实践的结论:GLA 论文的摘要直接写道「linear attention generally underperforms ordinary softmax attention」。这不是某个实现没调好,而是上面这些结构性限制的综合结果。后续所有有竞争力的线性注意力模型,要么加门控和 Delta 修正提升状态利用率,要么与少量全注意力层混合,没有一个是「朴素线性注意力直接替换 softmax」就能打赢的。
主要变体与技术谱系
线性注意力的思想在 2020 年提出后,经过几轮演进,逐步从「朴素累加」走向「可学习的写入与遗忘」。按状态更新规则可以把谱系大致分成五代,每一代都是在修正上一代的一个具体缺陷。
第一代:朴素线性注意力(Linear Transformer,2020)
状态更新是纯加法 ,特征映射 。优点是推导最简单、kernel 最好写;缺点是没有任何遗忘机制,状态范数单调增长,且旧关联会被新关联无差别覆盖。论文标题 «Transformers are RNNs» 给出了一个重要的定性结论:线性注意力在推理时就是一个以矩阵为隐状态的循环网络,可以直接用 RNN 的视角分析它。
第二代:加衰减(RetNet,2023)
RetNet 引入固定的逐位置衰减 ,形成 。这解决了状态范数无界增长的问题,也顺便注入了位置信息。RetNet 的另一贡献是把「并行、循环、chunkwise」三种表示统一在一篇论文里,明确提出「训练并行 + 推理 」这一组合是线性注意力相对 Transformer 的核心卖点。缺点是 是每个头固定的超参数,不随输入变化,模型无法学会「这个 token 该记住、那个 token 可以忘」。
第三代:数据相关门控(GLA、Mamba、RWKV 系列)
GLA 把标量衰减改成逐通道的输入相关门控:
每个特征通道有独立的遗忘速度,模型可以通过输入内容决定哪些记忆方向需要保留、哪些要清空。GLA 论文的消融实验给出了清晰的递进关系(Table 4,340M 参数、7B token 训练,指标为训练困惑度):
| 变体 | 训练困惑度 |
|---|---|
| GLA Transformer(4 头) | 14.77 |
| 无门控(即朴素线性注意力) | 23.21 |
| 数据无关标量衰减(即 RetNet) | 16.55 |
| 数据相关标量门控 | 15.56 |
从 23.21 到 16.55 是「有没有衰减」的差距,从 16.55 到 15.56 是「衰减是否随输入变化」的差距,从 15.56 到 14.77 是「标量衰减 vs 逐通道门控」的差距。每一步改进都在缩小与 Transformer 的距离,但即便到 GLA,也没有追平 softmax 注意力。
Mamba 与 GLA 年代相近、思想相通。Mamba 的核心创新是让 SSM 的参数随输入变化(选择性),并用一个硬件感知的并行扫描算法(selective scan)替代了此前 SSM 依赖的卷积形式。Mamba-2 进一步提出状态空间对偶(SSD),把 Mamba-2 的核心层写成带标量衰减的线性注意力特例:矩阵值状态、对角转移、标量或逐通道门控。这个对偶关系的价值在于,它让 SSM 和线性注意力可以用同一套分块矩阵算法实现,也解释了为什么两者在实验中的优劣往往同向变化。
第四代:Delta Rule(DeltaNet、Gated DeltaNet)
前三代的写入规则都是「加法」:新的键值关联直接累加到状态上。问题在于,如果新键 与某个旧键方向相近,加法会同时保留旧值和新的值,读出时得到的是两个值的混合。DeltaNet 把写入改成「先读出当前预测,再按误差修正」:
当 已归一化时, 是一个 Householder 矩阵,作用是把状态在 方向上「投影扣除」出当前预测 ,再用 与预测的差作为修正量写回。直观理解:状态是一张从键到值的映射表,Delta Rule 相当于对表里已有的同名条目做「更新」而不是「追加一条新条目」,因此不会出现同名键的混乱。
DeltaNet 的瓶颈在于训练。Householder 矩阵的连乘不能简单地用前缀和分解,最初的实现只能逐步递推,无法在序列维并行。「Parallelizing Linear Transformers with the Delta Rule over Sequence Length」给出了利用「矩阵初等变换」结构的 WY 表示,把一段内的多个 Householder 矩阵连乘压缩成一个低秩更新,从而支持 chunk 并行训练。有了这个算法,DeltaNet 才能扩大到 1.3B 参数、100B token 的规模,并超过 Mamba 与 GLA。
Gated DeltaNet 在 Delta 修正之上再加一个标量门 (\alpha_t),把「快速遗忘」和「精确修正」这两类需求分开处理:门控负责大范围擦除,Delta Rule 负责局部改写。论文报告它在语言建模、常识推理、上下文检索、长度外推上都优于 Mamba2 与 DeltaNet。KDA 再进一步把 GDN 的标量门细化为逐通道门,即本站 Kimi Delta Attention 完全拆解 所讲的内容。
第五代:与全注意力混合
即便经过四代改进,纯线性注意力模型在标准评测上仍然难以全面超过强 MLA/GQA 基线。「混合」成为当前主流方案:
- RetNet 之后:H3、Hyena 等模型是门控卷积与注意力的混合,但线性层仍以卷积为主;
- Kimi Linear:按 3:1 的比例交错 KDA 层与 MLA 层,得到 48B 总参数、3B 激活参数的模型。论文声称在公平比较下首次在短上下文、长上下文与 RL 扩展三种场景中都超过了全注意力 MLA,并将 1M 上下文的 decode 延迟降到 MLA 的约六分之一;
- Based:线性注意力层与 64 到 128 token 的滑窗 softmax 注意力交替,把状态大小的选择和检索能力解耦。
混合架构的直觉是:线性层负责廉价的大范围信息压缩,全注意力层负责昂贵的精确检索。需要知道「某个值具体是多少」时,交给全注意力;只需要「某件事大概发生过」时,交给线性层。代价是混合层仍然需要保留 KV Cache,只是用量减少了。
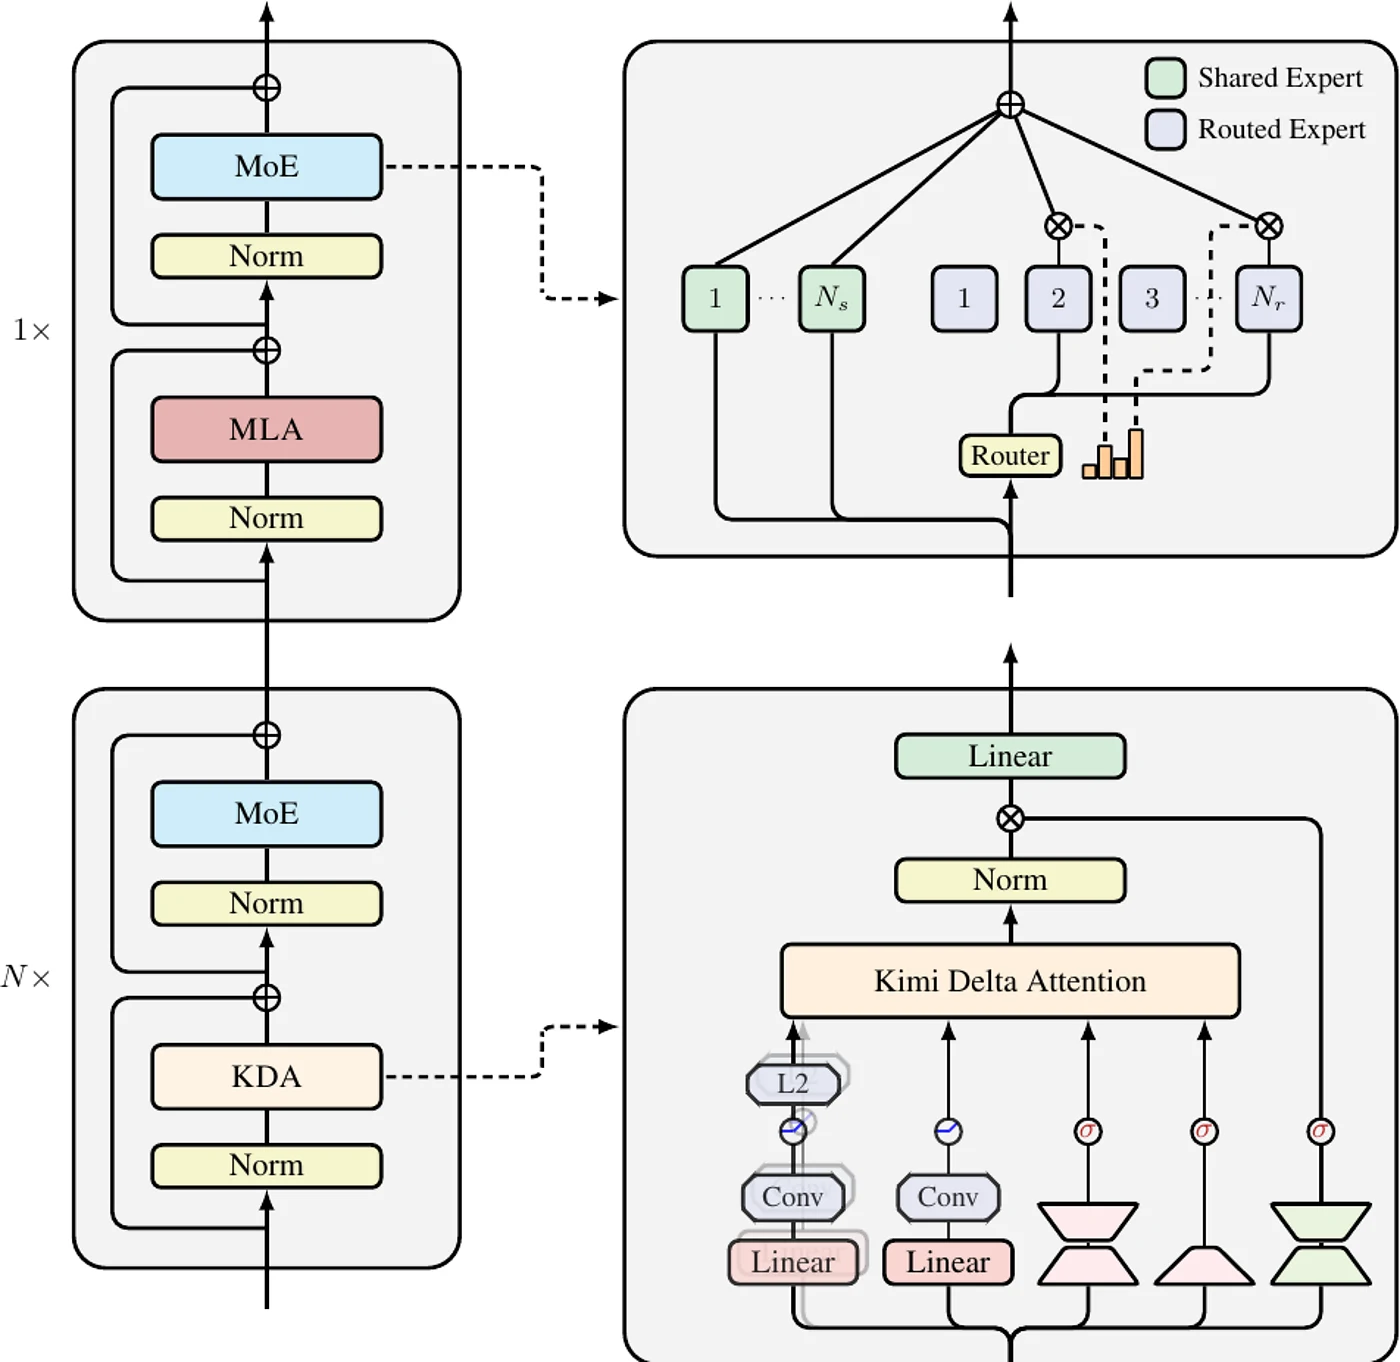
Kimi Linear 论文的 Figure 3 把混合方式画得很清楚:每个 block 由一个 token mixing 层和一个 MoE channel mixing 层组成,token mixing 部分按 交错 KDA 与 MLA,论文实现取 ,即三个 KDA 层后接一个 MLA 层。右侧拆开了一个 KDA block 的内部结构:输入先经过归一化与投影,进入 KDA 的循环状态更新,再经过 gate 与输出投影;MLA block 则保留完整的 KV Cache。按 3:1 的比例,约四分之三的层不再随长度增长缓存,只有四分之一的层需要维护 KV。这也是为什么论文报告 KV Cache 用量显著下降,但模型仍保留精确的全局检索通道。
与 SSM 谱系的关系
从数学结构看,线性注意力与结构化状态空间模型(S4、Mamba)共享同一个骨架:一个 的矩阵状态,按输入依赖的转移矩阵更新。二者的区别主要在转移矩阵的形式:
- 标准线性注意力:转移矩阵是单位阵(无衰减);
- RetNet:转移矩阵是标量 ;
- GLA:转移矩阵是对角矩阵 ;
- Mamba 的 S6:转移矩阵是对角矩阵,且对角线参数随输入变化(选择机制);
- KDA:转移矩阵是对角矩阵减 rank-1(DPLR 形式),兼顾表达能力与 chunk 效率。
Mamba-2 的论文把这条谱系整理为「结构化半可分离矩阵」的分解问题:对角转移、标量衰减、Delta 修正都可以对应到半可分离矩阵的不同约束形式,所有形式都能用同一类分块矩阵乘实现。理解这个谱系之后,再看到一个新模型声称「融合了线性注意力与 SSM」,就能立刻判断它在状态更新规则上处于哪个位置。SSM 推理侧的细节可参考本站 Mamba 状态空间模型推理完全拆解。
与标准 Transformer 的逐项对比
这一节把两边的账摆在同一张桌上。为了让数字具体,先固定一个参照配置: 的上下文、 的头维度、、线性注意力取 、32 个查询头、GQA 下 8 个 KV 头、FP16。
复杂度账
| 指标 | softmax 注意力(FlashAttention + KV Cache) | 线性注意力(chunkwise) |
|---|---|---|
| 训练时间 | ||
| 解码每 token 读取 | (读全部 KV) | (读状态) |
| 每请求推理显存 | (与 无关) | |
| 注意力矩阵秩 | 最大 | 最大 |
| 精确 one-hot 检索 | 支持 | 不支持 |
| 因果掩码 | 显式矩阵 | 循环形式天然因果 |
有一项常被忽略:softmax 注意力的 decode 是显存带宽受限的。每生成一个 token,要把整份 KV Cache 从 HBM 读进 SM 一次,而实际的浮点运算量很小(每个头只有 次点积与加权求和)。这意味着解码吞吐的上限由显存带宽除以每步读取字节数决定,与 GPU 的计算峰值无关。线性注意力把读取量从 降到 ,这个上限随之变成常数。
但线性注意力有另一个带宽问题:状态矩阵每步都要读出、更新、写回显存,单次读写量是 个 FP16 元素。当多个请求的线性层并行处理时,每个请求都要做一次状态读写;状态虽然小,但解码阶段本身的算力利用率也低,这些读写同样会构成瓶颈。工程上的典型做法是把多个请求的线性层合并成一个 batched GEMV(状态堆叠成批量矩阵),并把状态放在 L2 或 shared memory 级别复用。
内存账
按前面的公式:
假设 、、、:
- softmax 注意力在 32K 上下文的 KV Cache:;
- 线性注意力全部层的状态:。
相差约 128 倍。当序列增长到 1M,softmax 的 KV Cache 增长到约 137 GB,线性注意力的状态仍然是 33.6 MB。这就是为什么长上下文服务中,线性层可以大幅提高并发量:每条请求的显存占用几乎不随上下文增长,调度器可以把更多请求塞进同一个批次。
质量账
质量对比不能只看个别实验,而要看整体趋势:
- 朴素线性注意力在 GLA 论文的 340M 规模对照中,训练困惑度 23.21,而 GLA 是 14.77,Transformer++ 基线则更低;
- Zoology 的结论:固定状态模型在关联召回上与注意力差距最大,这部分解释约 82% 的整体差距;
- Based 的实验给出了另一侧的数据:线性注意力在不增加状态的情况下,召回能力显著弱于注意力;但把状态增大、并叠加一个很小的滑窗 softmax,召回可以接近注意力,同时吞吐仍明显优于全注意力;
- Kimi Linear 是到目前为止最接近「全面超过」的混合架构,但它本身也保留了 MLA 层,而且论文用的是逐层交错的混合模型,不是纯线性模型。
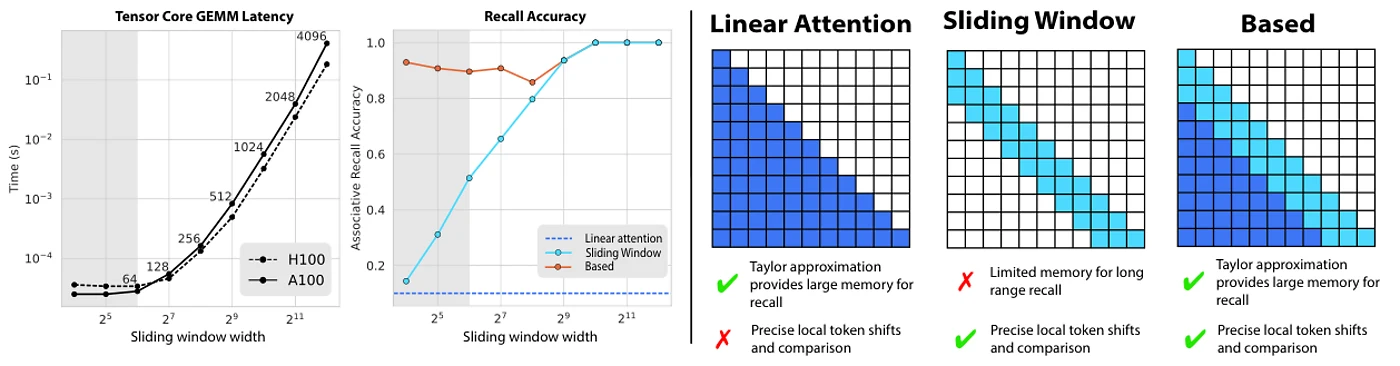
Based 的这张图把两类成本放在一张图上:左侧展示在 GPU 上执行不同窗口大小的滑窗注意力与线性注意力 GEMM 的耗时,右侧展示不同窗口宽度下模型在 MQAR 任务上的召回准确率。小窗口(64、128)的滑窗注意力耗时与一次小型 GEMM 处于同一量级,但能显著补上线性注意力缺失的「近处精确拷贝」能力;窗口超过一定宽度后,耗时开始明显上升。这意味着:近处的精确检索可以用很便宜的滑窗补齐,远处的检索才是线性注意力真正的短板。这个观察直接催生了后续几乎所有混合架构的设计。
何时线性注意力会输
即便是混合模型,在以下场景中线性注意力的优势也会缩水甚至消失:
- 短上下文: 只有几百时,状态读写和门控、卷积的固定开销占主导。Kimi Linear 的实测显示 4K 到 16K 区间与 MLA 延迟接近。
- 高并发、小 batch 的解码:状态虽小,但每个请求都要做一次矩阵状态读写;如果 batch 很小,显存带宽利用率可能反而不如全注意力的大矩阵乘。
- prefill 长度较短:分块算法的块边界处理、初始状态清零等开销,在短 prefill 下摊不开。
- 需要精确输出长文本:复制、摘要转写、代码补全等任务对精确检索的要求最高,纯线性层的召回能力不足,必须依赖混合层。
反过来,线性注意力的优势在以下条件下最明显:
- 超长上下文: 从 128K 到 1M,KV Cache 与 decode 带宽成为最主要瓶颈;
- 大量并发长请求:显存被 KV Cache 占满导致无法提高 batch size 时,线性层相当于把并发上限抬高一到两个数量级;
- 流式长生成:每 token 成本恒定,不会因为上下文越滚越长而越来越慢;
- 对质量要求不那么苛刻的场景:长文档摘要、检索增强生成中的候选筛选,能用略低的召回换取大得多的吞吐。
工程实现与部署现实
Kernel:分块算法如何落到 GPU
前几节已经把数学结构讲清楚了。真正决定线性注意力能否在推理系统里用起来的是 kernel:同样的分块公式,写得好与写得差,速度可以差好几倍。开源的参考实现是 fla-org/flash-linear-attention,它用 Triton 实现了 GLA、DeltaNet、Gated DeltaNet、KDA 等一大批算子,并已在 vLLM、SGLang 的部分混合模型推理路径中被引用。
GLA 的 chunkwise kernel 在结构上分成三个主要部分:
- 跨块状态前缀和(
chunk_fwd_h):按块扫描,每块计算 并累加到状态上,产出每块的起始状态 。这一步的核心是一个沿序列方向的串行扫描,但每个块内部是一次矩阵乘。为了给这个串行扫描留出更多并行度,FLA 的chunk_fwd_h支持二级分块(secondary chunking):以较大的 为单位分配 program,每个 program 内顺序处理若干 大小的子块,把「长链串行」切成若干段并行的短链,再由一个轻量的合并步骤串起来。 - 块内注意力矩阵(
chunk_gla_fwd_A/fwd_intra_gk):用门控把 与 按块内位置缩放,再计算块内带因果掩码的 。门控是逐 token 的累积值(cumulative sum),因此 kernel 里先做chunk_local_cumsum,得到每个位置相对块起点的对数衰减,再在矩阵乘时用exp2把衰减乘进去。这样在块内仍然可以使用 Tensor Core 的密集矩阵乘,而不是逐元素循环。 - 输出合成(
chunk_gla_fwd_o): 两项分别计算,后者直接读上一块的边界状态。
从源码能看到的一个一致性:这些 kernel 在计算中用 exp2(即 )而不是 exp;这是有意的——GPU 的 exp2 指令比 exp 快,且门控值先乘以 (代码中的 RCP_LN2)再做 exp2,数学上等价于求自然指数。
推理框架中的接入方式
线性注意力层接入推理框架时面临几个与全注意力不同的工程问题:
状态分配与回收。 全注意力请求的 KV Cache 需要按 token 动态增长与分页,而线性注意力请求的状态大小固定,分配模式更接近「每请求一块固定大小的 workspace」。多请求批处理时,需要把每个请求的状态拼成一个 batch 维度张量;请求结束后释放即可。这简化了分页管理,但也意味着状态池必须按最大并发数预留,不能按实际 token 数弹性调整。
前缀缓存。 全注意力的前缀缓存(如 RadixAttention)靠前缀树按 token 匹配复用 KV。线性注意力的状态是整段前缀的函数,可以在块边界上保存中间状态快照,实现「前缀状态缓存」:命中相同前缀时直接加载对应的状态矩阵,跳过全部重算。Kimi Linear 论文在讨论 decode 加速时也提到了这一点:混合架构里 MLA 层仍然可以复用 KV 前缀缓存,线性层可以复用状态快照。两者的缓存粒度不同,需要推理框架分别管理。
投机解码。 线性层的状态更新是顺序执行的,验证多个草稿 token 时,不能像全注意力那样用一次「多 query 对全 KV」的矩阵乘完成验证;需要沿草稿序列逐位推进状态,并在拒绝时回滚。常见做法是在验证阶段把草稿链的状态先算出来,若被拒绝到第 个 token,就从保存的中间状态恢复,只重算接受部分的更新。这使得混合模型的投机解码实现比全注意力模型复杂。
张量并行与数据并行。 混合模型里线性层与 MLA 层的 KV/状态分布方式不同:MLA 层可以按头切分并跨卡维护 KV,而线性层的矩阵状态在头维度上切分是自然的,跨块前缀扫描需要在每张卡上各自完整地执行一遍(或做一次跨越序列的通信)。Kimi Linear 论文指出其 KDA 层在张量并行下几乎无额外通信,这是混合架构在系统层面的一个重要优势。
编译与图捕获。 线性层的状态更新依赖相邻块之间的依赖关系,decode 阶段每步的状态读写是一个固定形状的小矩阵乘,可以稳定地放进 CUDA Graph;但 prefill 阶段的分块数随输入长度变化,需要按块数分桶。这一点与全注意力解码图的桶划分思路一致,可参考本站 CUDA Graph 的桶与垫。
部署时的数字示例
以一个 48B 总参数、3B 激活参数的 Kimi Linear 为例(这些数字来自论文对配置的描述):
- 按 3:1 交错,约四分之三的 token mixing 层是 KDA;
- 1M 上下文的 decode 阶段,论文报告 Kimi Linear 比全注意力快约 6 倍,512K 时 prefill 快约 2.3 倍、1M 时约 2.9 倍;
- 这些倍数并非来自 kernel 本身更快,而是来自 decode 阶段需要读取的数据量大幅减少。
需要注意的是,这些数据是论文在特定配置下的测量,真实部署时的加速比强烈依赖于 batch size、上下文长度分布、硬件与 kernel 版本。把一个纯线性注意力模型放到短上下文、大 batch 的对话场景里,很可能看不到任何优势。
一个实际的选择框架
如果要为一个新模型或新服务选择注意力结构,可以用下面几个问题做快速判断:
- 平均上下文长度是多少? 如果绝大多数请求都在 8K 以内,线性层基本没有优势,全注意力更成熟。
- 能不能承担质量损失? 若下游任务依赖精确的上下文检索(代码、长文档问答、表格检索),纯线性不够,需要混合。
- 并发量与显存是否紧张? 如果长上下文服务被 KV Cache 的显存占用卡死,那么线性层是提高并发上限最直接的手段。
- 能否更换模型权重? 线性注意力需要重新预训练,不能直接替换已部署模型的注意力层。混合架构同样需要从头训练,因此只能用于新模型。
- 推理框架是否支持? 混合模型的算子需要推理框架实现对应的 backend;目前的混合模型算子在各个推理框架中的覆盖范围与版本支持差异较大,选型时需要逐一确认目标框架是否已实现对应的 backend。
小结
线性注意力的核心是一个矩阵恒等式:把注意力权重写成两个特征映射的内积,再利用结合律把「先算 的分数再加权」改成「先把键值关联累积进一个 的状态,再用 query 读出」。这一个改写同时带来三件事:
- 训练仍可并行:并行形式与二次方注意力在数学上等价,矩阵运算铺满 GPU;
- 推理变成循环网络:状态固定大小,每 token 成本与上下文长度无关;
- 注意力矩阵降秩: 的行空间被压进 维,精确的 one-hot 检索不再可能。
第二件事是它的主要卖点,第三件事是它的主要代价。所有后续改进——RetNet 的固定衰减、GLA 的逐通道门控、DeltaNet 的误差修正、Gated DeltaNet 的门控加修正、KDA 的逐通道细化、Kimi Linear/Based 的混合架构——本质上都是在「有限的固定状态」里挤出更多有效记忆,同时把最需要精确检索的场景交还给少量的全注意力层。
判断一个「线性注意力与 Transformer」的对比是否可信,可以看三件事:上下文长度是否足够长,是否如实报告了质量差距,以及是否用的是混合架构而非纯线性层。这三件事决定了结论是否适用于具体场景。
参考资料
- Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention
- Linear Transformers Are Secretly Fast Weight Programmers
- Random Feature Attention
- Rethinking Attention with Performers
- Retentive Network: A Successor to Transformer for Large Language Models
- Gated Linear Attention Transformers with Hardware-Efficient Training
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces
- Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
- Parallelizing Linear Transformers with the Delta Rule over Sequence Length
- Gated Delta Networks: Improving Mamba2 with Delta Rule
- Kimi Linear: An Expressive, Efficient Attention Architecture
- Zoology: Measuring and Improving Recall in Efficient Language Models
- Simple linear attention language models balance the recall-throughput tradeoff
- Repeat After Me: Transformers are Better than State Space Models at Copying
- The Illusion of State in State-Space Models
- fla-org/flash-linear-attention
- Linear Attention Sequence Parallelism
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



