


HBF 推理系统完全解析:HBFlex、HBFWeave 与 SparseHBF 如何把细粒度 KV 放进粗粒度闪存
当 KV Cache 的容量需求越过单卡 HBM 的上限,推理系统面对的第一个问题不是「有没有更大的内存」,而是「更大的内存能不能被有效地读」。高带宽闪存(High-Bandwidth Flash,HBF)把 NAND 裸片按 HBM 的堆叠方式封装起来,用容量换带宽密度,看上去正好补上 HBM 与 SSD 之间的空缺。可一旦把 PagedAttention 管理的细粒度 KV 页放进去,问题立刻变得具体:闪存的读写单位是 page,擦除单位是 block,带宽又依赖多个 plane 并行读出;而推理框架分配 KV 页时只看逻辑块表,不看物理 plane。逻辑上的「一页」和物理上的「一个 plane 的一次读出」之间,隔着一整套需要重新设计的运行时。
本文围绕同一主题下的三套系统展开:HBFlex、HBFWeave 与 SparseHBF。它们分别回答三个层次的问题。HBFlex 讨论全 HBF 封装里,KV 的放置、写入窗口和生命周期回收如何与闪存并行度对齐;HBFWeave 讨论在「DRAM 做缓存、HBF 做容量」的混合堆栈里,稀疏注意力留下的那部分 KV 访问如何被缓存、调度和写入;SparseHBF 则把问题收窄到原生稀疏注意力(Native Sparse Attention,NSA)模型,分析索引器 K、主 KV 与写停顿在 HBF 上的真实瓶颈。三套系统共享同一个底层矛盾:推理框架的细粒度状态管理与闪存的粗粒度并行执行之间存在结构性错配。
文中的数据与图来自这组研究报告及其 manuscript;HBF 的器件背景、标准进展和公开论文则来自文末列出的公开资料。HBF 目前仍处在标准落地与样品阶段,报告中的带宽、延迟和容量是设计空间里的参数,不是已经量产的实测值;涉及代理模型与解析回放的实验,文中会明确标注口径。
为什么推理系统开始盯上 HBF
容量墙不是「显存不够大」这么简单
LLM 推理的驻留数据可以粗分为三类:模型权重、KV Cache、以及运行时的工作区与激活。权重是静态的,一次装载后长期复用;KV Cache 是动态的,随请求数、上下文长度和解码步数持续增长;工作区则是短生命周期的临时缓冲。HBM 的问题是三者共享同一份容量预算,而 KV 的增长速度远高于权重。
对一条长为 、层数为 、KV 头数为 、头维度为 的序列,若 KV 以 字节存储,单请求 KV 大小为:
系数 2 来自 key 和 value 两份张量。以 、、、(FP8)估算,每个 token 约 KB;128K 上下文就是约 7.9 GB,1M 上下文就是约 61 GB。再乘上并发批大小,KV 很快超过单卡 HBM 的 80 GB 或 141 GB。多卡可以扩容,但张量并行和专家并行会引入额外的通信与同步;把 KV 拆到更多卡上,换来的容量往往被集合通信吃掉。
这正是 KV Cache Offloading 完全拆解 讨论过的那条路:把冷 KV 放到 CPU、SSD 或远端内存。但 SSD 的随机读延迟在百微秒量级,带宽也受限于 PCIe 与控制器队列;当解码阶段每个 token 都要读历史 KV 时,SSD 只能服务命中率极高的前缀缓存,难以承担主 KV 的随机访问。HBF 的定位,就是在 HBM 与 SSD 之间插入一层「容量接近闪存、带宽接近 HBM」的介质。
HBF 到底是什么
HBF 的概念由 SanDisk 在 2025 年提出,随后与 SK hynix 在 OCP 框架下推动标准化。它的物理形态与 HBM 同构:多片 NAND 裸片通过 TSV 垂直堆叠,底部是 base die,base die 负责 TSV 连接、控制器与共享 SRAM。不同之处在于存储单元从 DRAM 电容换成了 NAND 浮栅/电荷陷阱,容量密度大幅提升,代价是写入需要 program、擦除需要 erase,且读写延迟高出几个数量级。
公开报道显示,2026 年 8 月发布的首版 HBF 标准覆盖两种堆叠配置、单堆栈容量最高 512 GB,带宽分为多个档位,并用 UCIe 与 GPU/CPU 互连;首批 HBF 推理设备预计 2027 年初出样。报告中引用的第三代 OCP HBF stack 目标为 3 TB/s/stack,而 HBFlex 评测采用的是 488 GB/s/stack 这一代配置,两者不能直接混用。HBF 不是「更便宜的 HBM」,而是一个新的容量层:它用 NAND 的密度换容量,用多 plane 并行换带宽,用 base die 的 SRAM 缓冲换延迟隐藏。
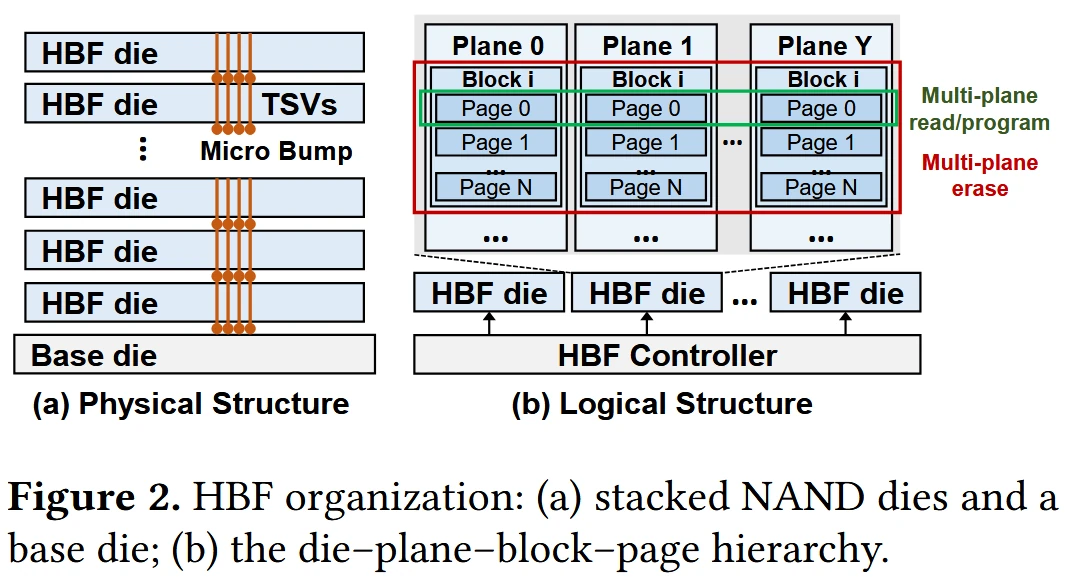
图中左侧是物理结构:多片 NAND die 通过 TSV 与 micro bump 连到 base die,base die 内含 HBF controller 与 SRAM buffer;右侧是逻辑层次:stack → die → plane → block → page。读写的最小单位是 page(通常 4 KB),擦除的最小单位是 block(通常包含数百到上千个 page)。真正决定 HBF 带宽的不是单页延迟,而是同一轮里能同时从多少个 plane 各读出一页。
设一个 stack 有 片 die、每片 die 有 个 plane,每个 plane 一次只能服务一个 page 读,单页读出时间为 ,页大小为 ,则这个 stack 的峰值读带宽近似为:
代入 、、 KB、 μs,得到 GB/s。报告中的 HBFlex 评测配置给出 488 GB/s 的读带宽,差额来自控制器、队列和刷新等开销。这个数字很重要:它说明 HBF 的高带宽不是「单页读得快」,而是「同时读的 plane 多」。一旦请求只落在少数 plane 上,实际带宽会按比例塌下去。
写入侧更悬殊。NAND program 的延迟约 75 μs,按同样的并行度估算,program 带宽只有约 27 GB/s,读带宽是它的 18 倍左右。读和写在同一个 plane 上不能同时进行,写入还会占用控制器队列。HBF 的读写不对称,比 HBM 的读写不对称严重得多,这直接决定了后文三套系统为什么都把「写回窗口」和「写放大」当成一等公民。
四种集成方式,四种取舍
HBF 进入封装的方式不止一种。报告把常见形态归为四类:全 HBF(Full HBF)、级联 HBM 与 HBF(Cascade HBM & HBF)、HBM 与 HBF 共置(Co-located HBM & HBF)、以及 HBM 与 HBF 混合堆栈(Integrated HBM & HBF Stack)。
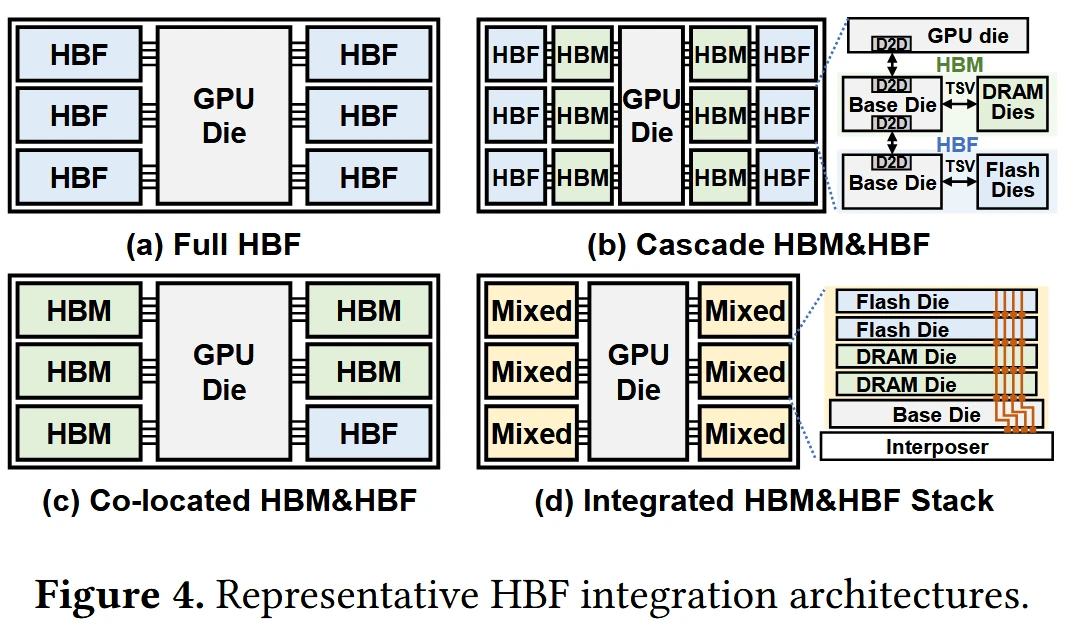
四类形态的核心差别在于「HBM 与 HBF 谁服务谁」。全 HBF 把封装面积全部给 HBF,容量和聚合带宽最大,但运行时必须直接管理 KV 的读、写、回收,没有 HBM 做缓冲;级联形态让 GPU 先连 HBM base die,再由 HBM base die 连 HBF,HBM 充当 HBF 的延迟隐藏层;共置形态把 HBM 与 HBF 并排放在中介层上,二者共享封装但独立寻址;混合堆栈则把 DRAM die 与 flash die 堆在同一个 stack 里,用 TSV 连接,容量与带宽按 DRAM
这份分类解释了一个容易被忽略的取舍:在同一份封装预算下,集成 HBM 会挤占 HBF 的容量和 plane 数。HBM 提供低延迟和缓存能力,但它占用的面积本可以放更多 NAND die。HBFlex 选择全 HBF,是为了把容量和聚合带宽推到最大,再用 base die 的 SRAM 和运行时调度补上延迟与写缓冲;HBFWeave 选择混合堆栈,是因为稀疏注意力只需要读一小部分 KV,DRAM 缓存能把「稀疏访问的集中性」变成命中率;SparseHBF 则进一步指出,不同部署位置(prefill 还是 decode)对容量和带宽的需求并不一样。
HBF 与 HBM 的关系,之前在 H³ 完全拆解 和 HotChip/FMS 内存墙(二) 里已经从混合架构与标准两个角度讲过。本文不再重复 HBF 的器件细节,而是把镜头推到更下一层:当 KV 真的放进 HBF,推理框架的页管理、内核调度和闪存控制器要如何共同改写。
粒度错配:PagedAttention 的细页与 HBF 的 plane 轮次
PagedAttention 为 HBM 设计,却把问题带进了闪存
PagedAttention 的核心思想在 PagedAttention 完全拆解 中已经拆过:把逻辑上连续的 KV 序列切成固定大小的 logical page,用块表把每个逻辑页映射到任意物理页,从而消除连续分配带来的内部碎片和外部碎片。对 HBM 来说,这个设计几乎是无代价的:物理页分散在 DRAM 的任意 bank,bank 级并行本来就能吸收随机性,页表多一次间接寻址也只增加几个周期的延迟。
对 HBF 来说,同一个设计会暴露两个物理事实。第一,HBF 的 page 是读写单位,但带宽来自多个 plane 的并行读出;一次读操作轮次由「所有 plane 中需求 page 数的最大值」决定,而不是由总 page 数决定。第二,PagedAttention 的块表只保证逻辑页有位置,不保证物理页在 plane 上均匀分布。于是逻辑上均匀的 KV 访问,映射到物理上可能变成少数 plane 的热点。
设一次注意力 kernel 需要读 个 page,其中落在 plane 上的 page 数为 ,plane 总数为 。忽略流水线重叠,读操作轮次为:
理想情况下每个 plane 的负载相同,轮次为 。定义不均衡比:
当 时,所有 plane 同时读完,带宽打满;当 时,一半 plane 空闲,实际带宽只剩峰值的一半。HBF 的系统设计,很大程度上就是在各种访问模式下把 压回 1 附近。
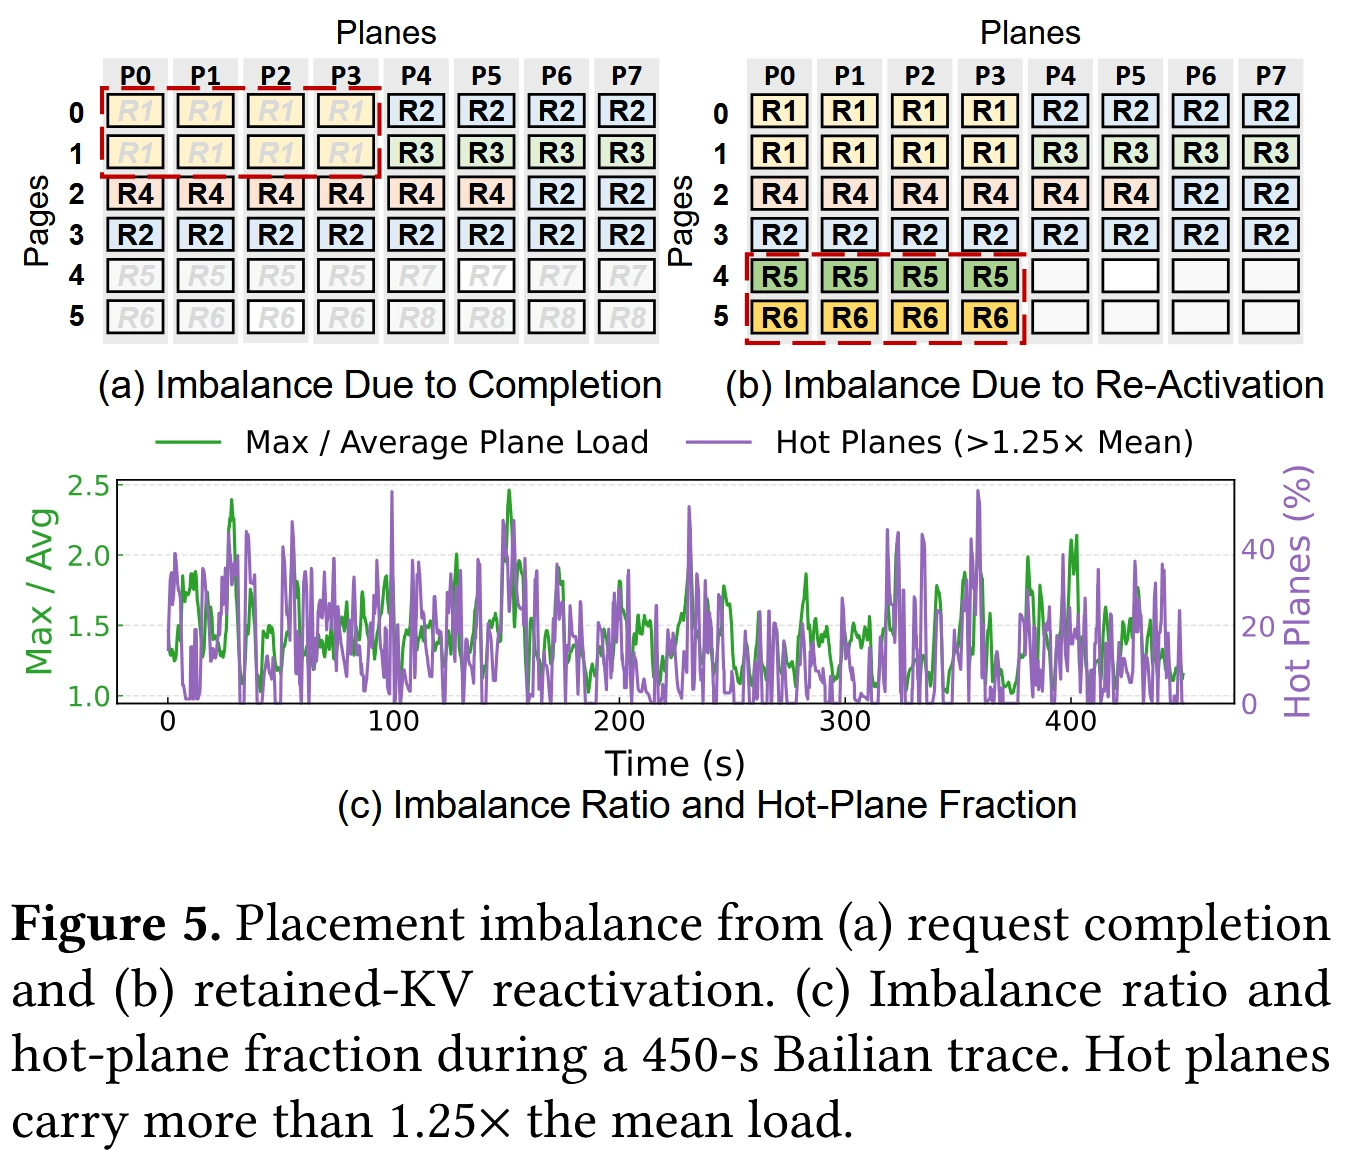
图 (a) 是「请求完成」造成的失衡:R2 的 KV 被释放后,原本承载它的 plane 负载下降;(b) 是「保留 KV 重新激活」造成的失衡:同一段 KV 被再次读时,那些 plane 又热起来。(c) 是 450 秒 trace 上的不均衡比(实线,取最大值/平均值)与热 plane 比例(另一次序列),曲线上下起伏说明负载不是静态倾斜,而是随时间迁移——这正是「静态条带化」不够、还需要运行时调度与轮次均衡的原因。
CTA 调度把细页进一步打散
PagedAttention 之上,推理框架通常把 attention 计算拆给多个 CTA(cooperative thread array),每个 CTA 负责一段 query 和一段 KV chunk。chunked CTA 调度让不同 CTA 并发处理不同请求、不同层、不同 KV 段。对 HBM 来说,这种并发是好事:更多 CTA 意味着更多 outstanding request,bank 级并行更充分。对 HBF 来说,CTA 的 read 请求会映射成物理上的细粒度、散乱读:一个 CTA 读 4 个 page,另一个 CTA 读 4 个 page,它们可能落在同一个 plane,也可能落在不同 plane。控制器看到的是「很多个小请求」,而不是「一批可以按 plane 对齐的大请求」。
这解释了为什么 HBF 系统不能只做「块表换物理地址」:调度器必须知道物理页的 plane 归属,才能把 CTA 的读请求排成均匀的轮次。HBFlex 的 Placement-Aware Read Scheduler、HBFWeave 的 ready-plane miss service、SparseHBF 的 request affiliation hint,本质上都是在不同层次上把「逻辑页号」翻译成「plane 负载」,再据此重排请求。
三个挑战,三套系统各自加重了哪一个
把三套系统放在同一张问题地图上,可以看到它们并不是三个孤立方案,而是同一组约束在不同架构选择下的不同投影。
| 约束 | HBFlex(全 HBF) | HBFWeave(DRAM+HBF) | SparseHBF(NSA on HBF) |
|---|---|---|---|
| 读不均衡 | 请求完成/重新激活导致 plane 负载漂移;CTA 细页调度加剧 | 稀疏访问集中,缓存未命中后残余请求挤在少数 plane | top-k 选中的 page 天然不均匀;indexer K 物理地址碎片化 |
| 写读干扰 | decode KV 持续写入,75 μs program 阻塞 4 μs read | KV/index 写入与 cache fill 竞争控制器队列 | prefill 与 generated KV 持续写入,PD 分离放大写流量 |
| 擦除放大 | 不同请求 KV 寿命不同却共享 erase block | 混合寿命请求在 GC 时留下有效页 | 主 KV 与索引器 K 的更新节奏不同,回收粒度错位 |
HBFlex 面对的是「全 HBF 没有 HBM 兜底」的极端形态:所有 KV 读写和回收都落在闪存上,任何一次写阻塞或 GC 都会直接进入端到端延迟。HBFWeave 面对的是「DRAM 太小、HBF 太大」的混合形态:缓存能吸收大部分稀疏访问,但剩下的 miss 仍然要跨 plane 排队,且写入要按请求生命周期分组。SparseHBF 面对的是「模型算法已经把 KV 访问变稀疏」的形态:容量问题被 HBF 解决,但索引器 K 的 dense 读取和主 KV 的 top-k 读取把不均衡推到了新的位置。
三套系统共享的底层洞察是:HBF 的容量不是免费拿到的,它要求软件把 KV 的生命周期、物理放置和访问顺序一起重新设计。下面逐套拆解。
HBFlex:全 HBF 封装下,KV 的放置、写入与回收
HBFlex 的设计前提是「封装面积全部留给闪存」。报告给出的架构是:GPU compute die 通过 D2D 连到 HBF base die,base die 协调 TSV 相连的 NAND core die,并在 base die 内放一块 40 MB 的共享 SRAM(3 nm 工艺;报告标注的面积数据为 8.06/121 mm²)。这块 SRAM 同时承担四个角色:HBF read 预取缓冲、decode 阶段生成 KV 的写入缓冲、过载 plane 的 offload 缓存、以及 GC 迁移时的搬运缓存。
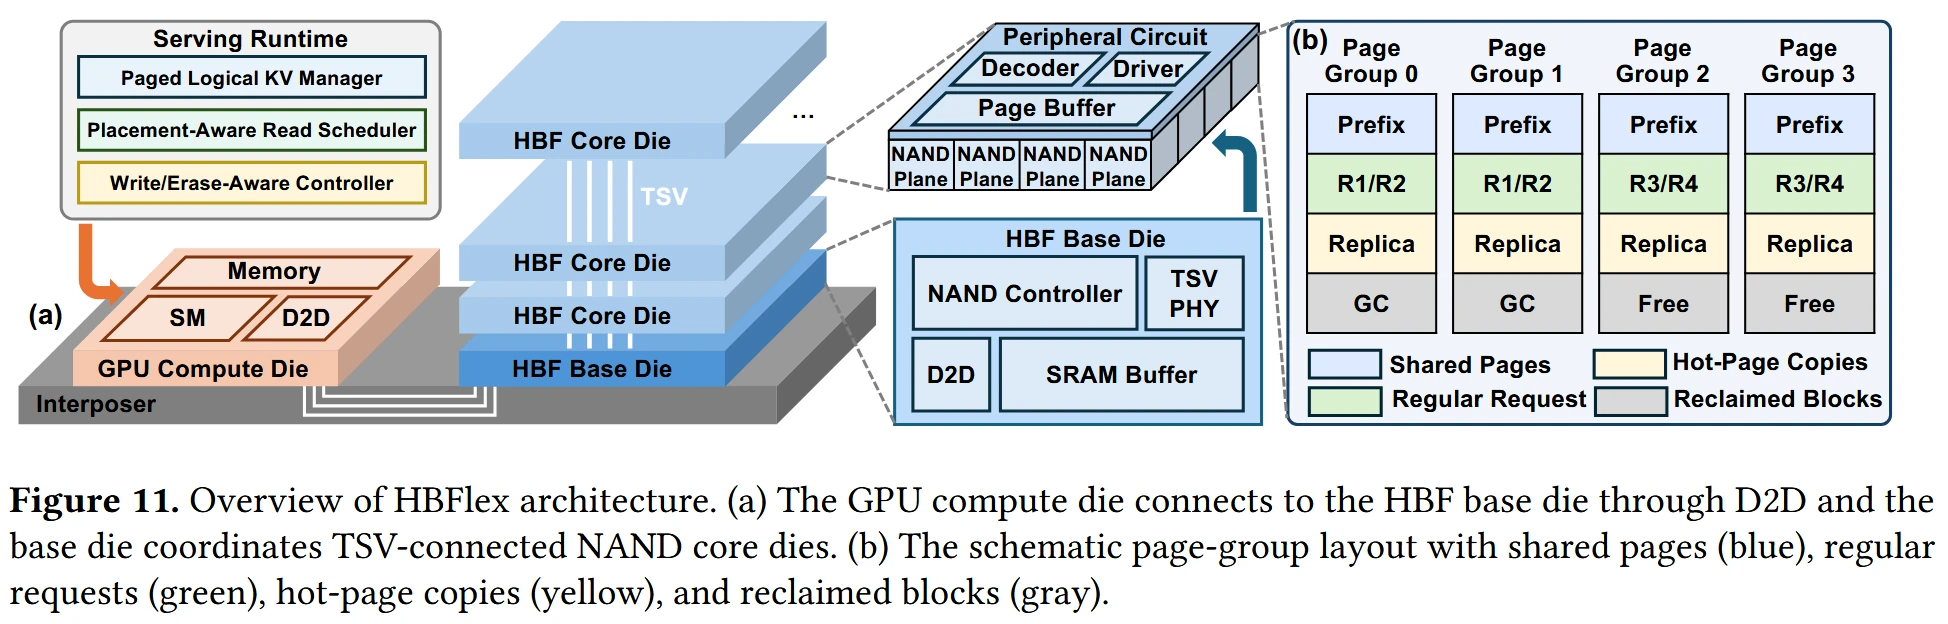
图 (a) 是物理层面:GPU 与 base die 之间有 D2D 链路,base die 与多片 core die 之间是 TSV。图 (b) 是页组(page group)布局示意:蓝色块是 shared pages,供多个请求共享的前缀复用;深色块是 hot-page copies,热页在 SRAM 里留副本;其余是普通请求页与待回收块。运行时有三条闭环:Paged Logical KV Manager 负责逻辑页分配、前缀复用与请求管理;Placement-Aware Read Scheduler 依据物理放置安排读;Write/Erase-Aware Controller 感知 KV 生命周期,调度 program 与 GC。这三条闭环分别对应前文的三个挑战。
挑战一:读的不均衡来自两处,而它们互相矛盾
HBFlex 把读不均衡拆成两种机制。第一种叫 placement imbalance(放置不均衡),来自 KV 本身的特性。一段对话请求的 KV,在请求完成时不再被读,原本分布均匀的 plane 负载随之下降;当同一段 KV 在后续对话中被重新激活,那些 plane 的负载又升上来。不同请求的生命周期错开,plane 负载就随时间漂移。报告的测量把这部分画成「不均衡比与热 plane 比例随时间变化」的曲线:在 450 秒的百炼 trace 上,负载超过均值 的 plane 被定义为热 plane,不均衡比随请求完成与重新激活在两个方向上来回漂移。
第二种叫 access imbalance(访问不均衡),来自 attention kernel 的设计。PagedAttention 加 chunked CTA 调度会读细粒度 page,同一轮读里多个 CTA 的页可能集中落到同一 plane。报告用一个 8 plane、12 MiB 读的例子说明:页的物理分布可以完全均匀,但只要一次读涉及的细页集中在少数 plane,轮次仍由最忙 plane 决定。(每个 stripe 一页,基本无条带)时最大 plane occupancy 为 3;(两页条带)时降到 2。这说明即使不做稀疏选择,访问顺序本身也会制造不均衡。稀疏选择会进一步加剧这一现象:SparseHBF 的 top-k 例子显示, 的选取下最忙 plane 可能需要 5 轮,而平均只有 2 轮左右。
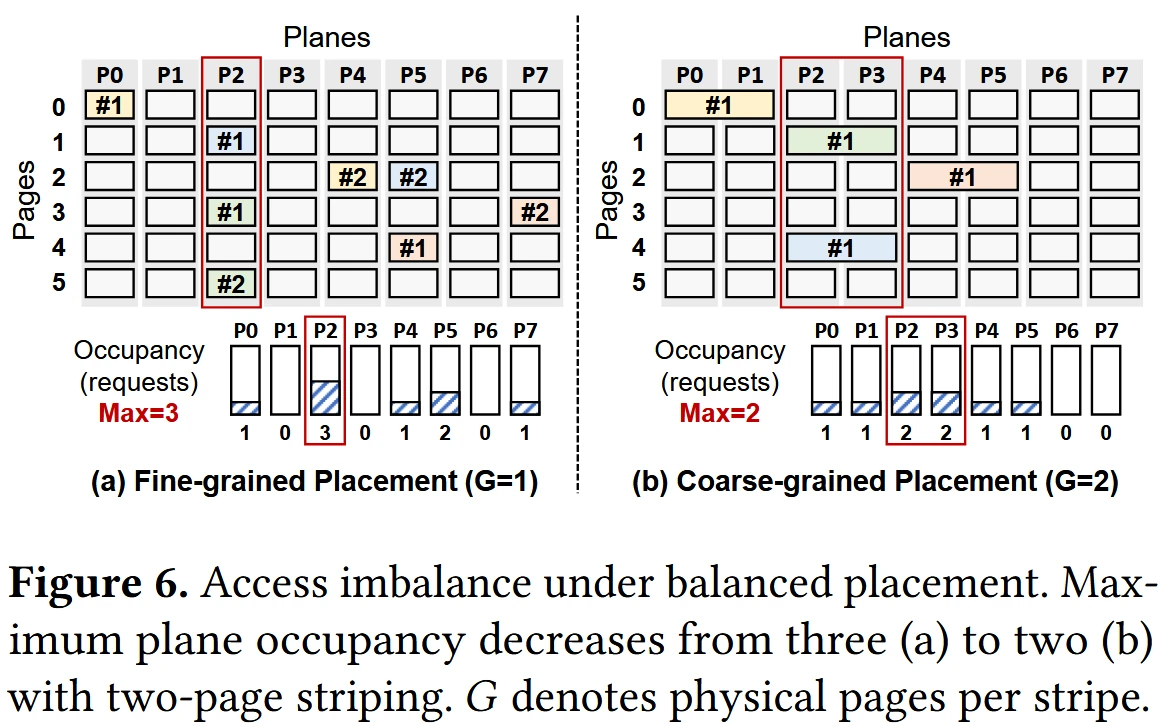
图中左右两侧都是 8 个 plane 的 occupancy 表。(a) 是细粒度放置():一次读的页在 plane 上分布不均,最大 occupancy 为 3;(b) 是粗粒度放置(,按两页一组条带):同样的读被铺得更均匀,最大 occupancy 降到 2。 表示每个条带覆盖的物理页数。这张图量化了「条带化能降低轮次」这个直觉,也解释了为什么 HBFlex 要把页分组而不是单纯增大页。
一个自然的想法是「增大 logical page 大小,让一次读覆盖更多数据,减少轮次」。但报告指出这是两难:增大页会减小 KV 复用的粒度。前缀复用(prefix caching)匹配的是完整的 logical page,页越大,能精确命中的前缀就越少,未命中的尾巴越长,重算也越多。报告把由此产生的额外重算称为 prefill amplification。这背后的权衡可以用一个简单模型说明:设页大小为 token,请求与前缀的公共长度为 ,页粒度对齐后实际复用的 token 数为 ,被放大的部分是 。 越大,被放大的尾巴越长。于是「小页」保复用、「大页」保带宽,HBFlex 的选择是:坚持小页,用调度来弥合不均衡。
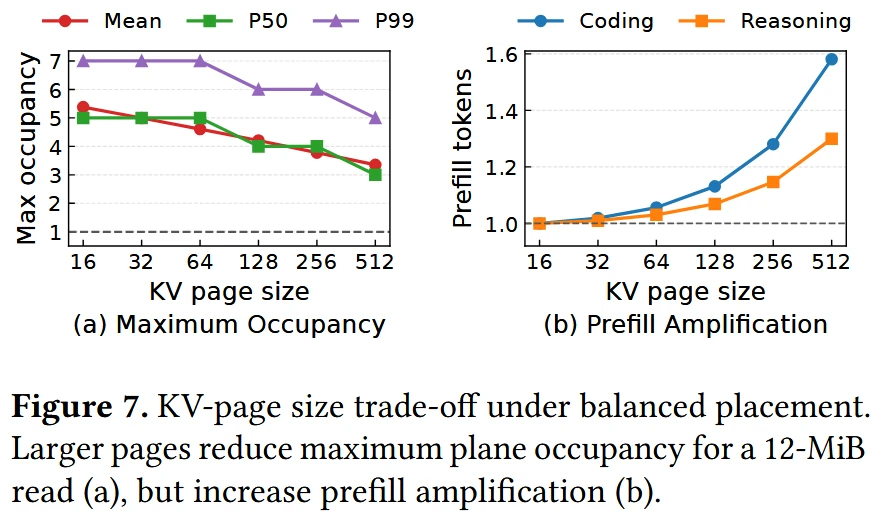
图 (a) 是最大 plane occupancy 随 KV page size(16 到 512)的变化:页越大,一次读覆盖的 token 越多,落到各 plane 的页数越少,最大 occupancy 下降。图 (b) 是 prefill amplification 随页大小的变化,Mean、P50、P99 以及 Coding、Reasoning 两类负载的曲线都随页增大而上升。两条曲线方向相反,交叉点取决于模型的前缀复用比例与读带宽压力;HBFlex 选择小页,等于把「复用精度」放在「单次读轮次」之前,再用条带化和调度去补带宽。
挑战二:decode 的写会阻塞 read
生成阶段的 KV 是逐 token 产生的。每生成一个 token,所有层的 attention 都要写入当前 token 的 K 和 V。如果 KV 直接写进 HBF,每个写入都要经历约 75 μs 的 NAND program。在 decode 阶段,GPU 的两次计算之间只有很短的间隙,通常远短于 75 μs。写入一旦发起,就会阻塞同一批请求后续的 HBF read,不断积累的 KV 还会占满缓冲。
这个问题的严重性取决于「读和写是否共享同一条路径」。在 HBF 中,同一个 plane 的读和写不能并行,控制器队列也会被 program 占住。报告用图示说明:读操作与计算交错进行,计算间隙短于 program,写入就把 read 挤到后面;如果 KV 缓冲不足,写入还会因为空间不够而被强制提前,进一步打断读。
挑战三:KV 生命周期分布导致擦除放大
NAND 有耐久限制。报告引用的典型值是 SLC Flash 约 10 万次擦写(P/E)周期。写入只能落到空 page,擦除必须以 block 为粒度。不同请求的 KV 寿命不同:短对话的 KV 很快失效,长对话的 KV 持续存活;但不同寿命的 KV 可能共享同一个 erase block。部分 page 失效后,要先迁移 block 里仍然有效的 page,才能擦除整个 block,这就是垃圾回收(GC)。
如果直接在 KV 失效时触发 erase,block 里其他的有效 page 会被反复迁移,报告测得 GC 写放大可达 ,极大地损耗耐久。另一种直接方案是把一个对话请求的所有 KV 放进同一个 block,这样同一请求的 KV 同时失效、整块可擦,但一个请求的 KV 只落在一个 block 上,就少了一个 plane 的并行读带宽,读带宽会掉。
HBFlex 的设计可以看成对这三个挑战分别给出了三个机制,而三者都依赖同一个前提:运行时能看到物理页的「位置」和「寿命」。
机制一:页分组、条带化、前缀复制与热 plane offload
HBFlex 的 KV 布局设计分四层:页分组(page grouping)、条带化(page striping)、前缀复制(prefix replication)与热 plane offload(hot plane offload)。
页分组与条带化解决的是 access imbalance。运行时把 plane 分成若干组(page group,PG),每个 PG 覆盖若干个 plane。分配 KV 页时,以 PG 为粒度连续分布:同一个请求的 KV 页不是紧挨着放在一起,而是按 PG 一轮一轮地铺开,使其在 plane 上均匀分布。这样做不改变 logical page 的大小,因此前缀复用粒度不变;改变的只是物理落点。
前缀复制解决的是 shared page 带来的新不均衡。系统提示词、对话模板、RAG 中的共享文档会被多个请求反复读,如果所有副本都落在同一组 plane,这组 plane 就成了固定热点。HBFlex 把频繁使用的前缀(如 system prompt)复制多份,放在实际读负载较低的其他 plane 上,读请求可以路由到不同副本。代价是容量:复制 份就占 倍容量,所以只对真正高频且体积不大的前缀做。
热 plane offload 解决的是短时热点。读负载高的 plane 上的部分 page 被 offload 到 base die 的 SRAM,读请求优先从 SRAM 命中。SRAM 只有 40 MB,远小于任一层的 KV 大小,所以它只能缓存「短时间局部热点」,不能缓存整段 KV。这与 CPU 的 cache 逻辑一致:容量小、命中率取决于时间局部性。
CTA 调度层面的配合是最后一环:调度 CTA 时,尽量选择那些 page 分布在不同 plane 上的请求组合,使一轮读的 max/average 比值接近 1。这需要调度器知道当前各 plane 的待读负载,本质上是在做在线负载均衡。
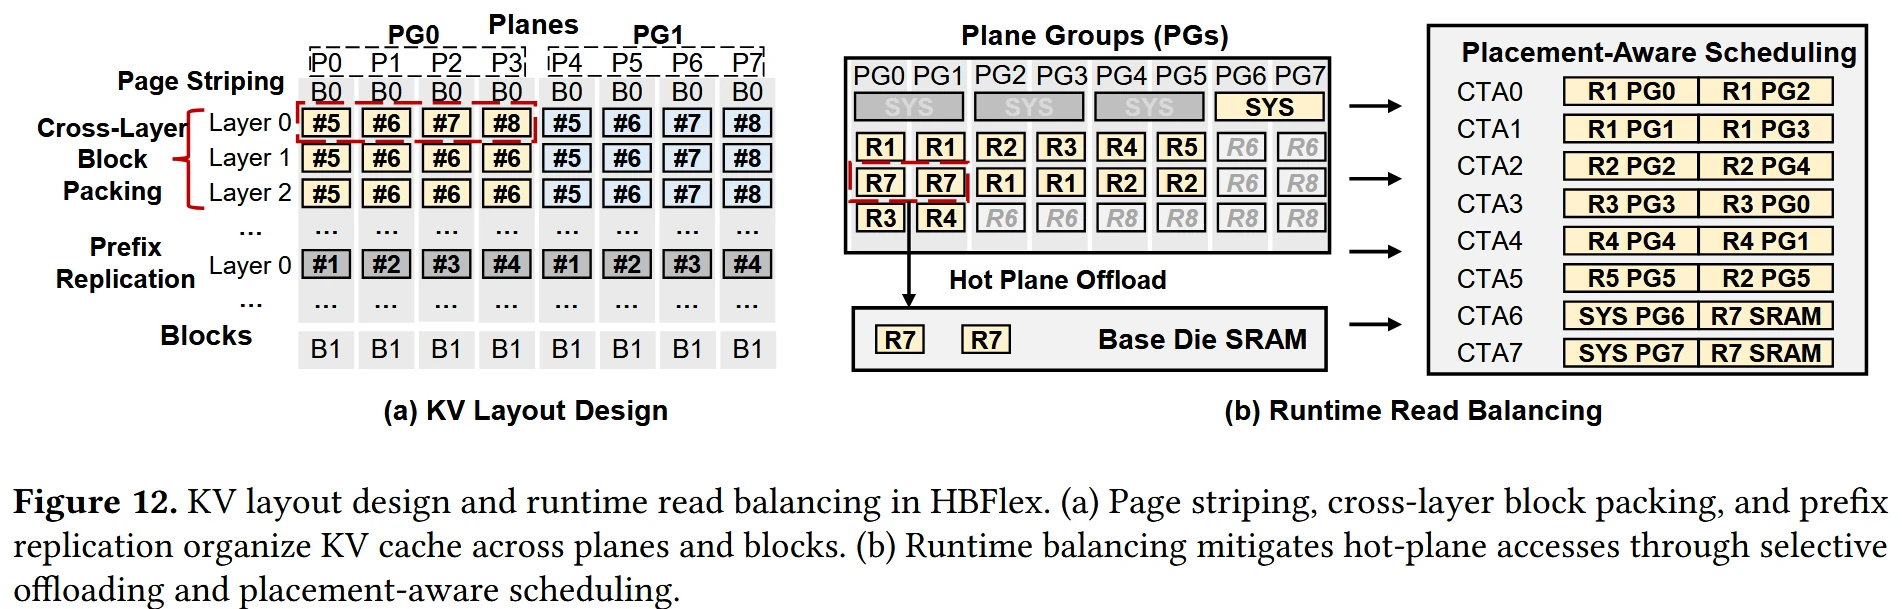
图中左侧 (a) 是布局:P0–P7 八个 plane 被划成 PG0–PG7 若干组,同一请求 R1 的页按 PG 条带化铺开;中间是跨层放置示意:同一个 block 里混放不同层的页(#5–#8),便于同一请求不同层一起失效;右侧是热 plane offload:部分页被搬到 base die 的 SRAM。图 (b) 是调度侧:CTA0 读 PG0 和 PG2,CTA1 读 PG1 和 PG3,CTA 之间的组合尽量错开。这个布局把「物理均匀」和「逻辑复用」拆成了两个独立决策,而不是用页大小同时控制两者。
机制二:窗口感知的 KV 写回
写入问题不能用「写得更快」解决,只能用「错开写入」解决。HBFlex 把 KV 的生成与 flash program 解耦:decode 阶段生成的 KV 先落在 SRAM buffer,只有在合适的窗口到来时才批量写入 HBF。
所谓「合适的窗口」,指的是 GPU 计算不依赖 HBF 读的时间段。prefill 阶段恰好提供了这样的窗口:prefill 的计算量大,GPU 在算 attention 和 FFN 时,HBF 的空闲时间更长。HBFlex 在 prefill 期间通过 HBF 预取操作把后续需要的数据提前取到 SRAM,从而制造出一段「HBF 空闲窗口」,把 decode 阶段攒下的 KV 批量 program 进去。
批量写入还带来第二个好处:program 的并行度更高。逐 token 写是单页写,对 plane 并行的利用很差;攒成一批再写,可以按 plane 对齐,把 program 带宽用起来。报告给了缓冲容量的经验判断:绝大部分输入积累的 token 少于 4K,对 DeepSeek-V4-Pro 这类 KV 极小的模型,这段 KV 不到 20 MB,恰好可以放在 40 MB 的 SRAM 里;接近容量上限时再强制写入。
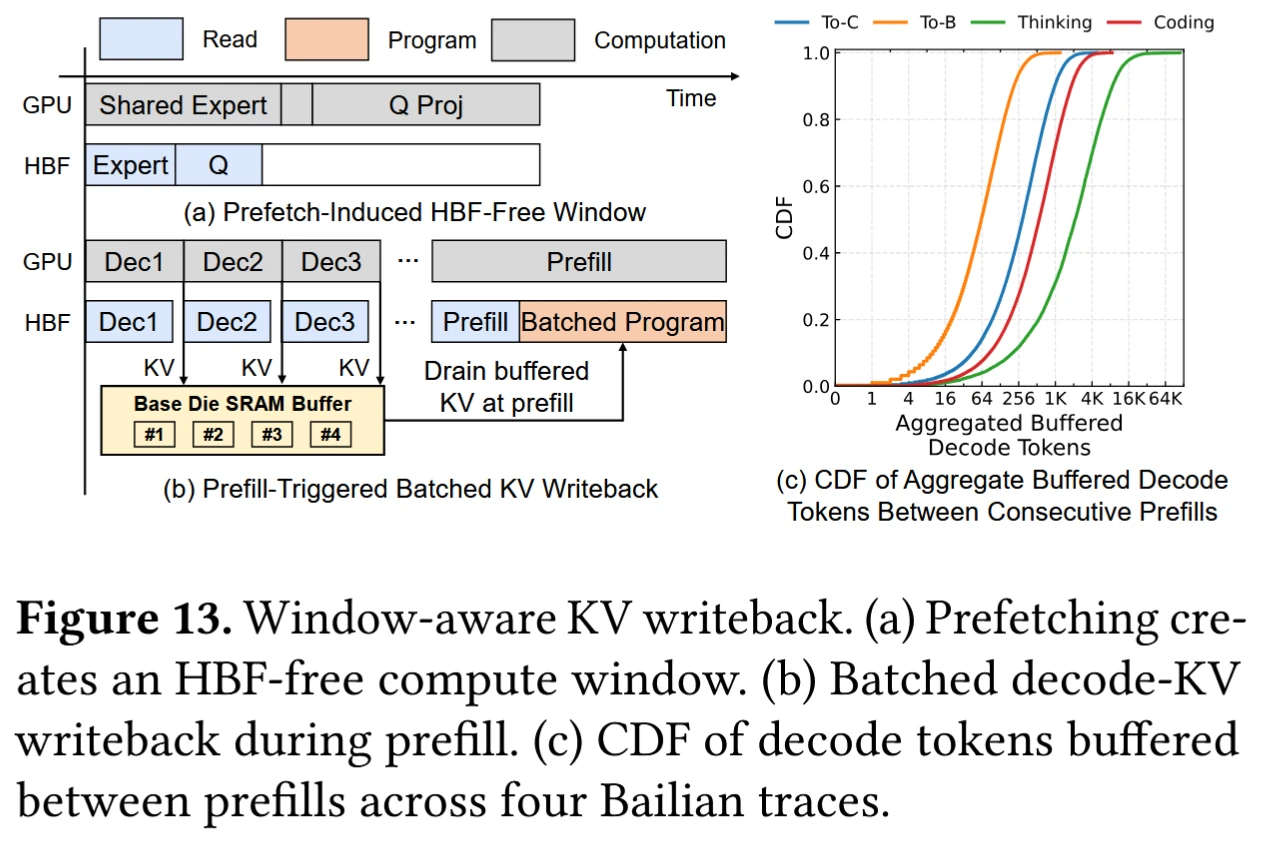
图 (a) 把时间轴上的读(Read)、program(Program)和计算(Computation)画在一起:prefill 段里 GPU 计算密集,HBF 有空窗,decode 段里 HBF 读密集,写入被推后到下一个窗口。图 (b) 是「Prefill-Triggered Batched KV Writeback」:把 Dec1、Dec2、Dec3 攒下的 KV 在下一个 prefill 开始前一次性 drain 进 HBF。图 (c) 是两次 prefill 之间积累的 decode token 数的累计分布,横轴从 0 到 64K,可以看到绝大多数情况落在很小的区间,这支撑了「用几十 MB SRAM 就能兜住」的设计判断。
这个设计有个隐含假设:prefill 和 decode 在同一节点上交替发生。如果采用 PD 分离(prefill 与 decode 分在不同节点),prefill 节点本就不产生 decode KV,写回窗口的形态会不同,后文 SparseHBF 讨论的写停顿正是 PD 分离下的变体。
机制三:按寿命放置与延迟回收
回收问题被拆成两个动作:放置和回收时机。放置上,HBFlex 把失效时间接近的 KV 放进同一个 block。同一请求的不同层 KV 会同时失效,所以尽量把同一请求不同层的 KV 放在同一个 block;不同请求的 KV 寿命相近,则尽量放到同一批 block。关键是「尽量」,不是「强制」:如果一个请求的所有 KV 必须放进一个 block,就牺牲了 plane 并行;HBFlex 允许一个请求的 KV 分散在多个 block,只要求这些 block 的「起始时间」相近。
回收时机上,HBFlex 把 KV eviction 与 erase 解耦。KV 逻辑失效时,只标记失效、不立即擦除;等更多 page 失效后,再选择有效 page 更少的 block 回收。这样 GC 时迁移的有效 page 更少,写放大更低。
这两个动作合起来的效果,报告用一组对比说明:基线方案 GC 写放大 ;加入生命周期感知的放置后降到 ;再加入延迟回收后降到 。相对基线降低 89.39%,把额外迁移写入和擦除次数减小接近 1 倍。收益主要体现在闪存耐久上,而不是端到端延迟上——这一点需要说清楚:延迟回收会让部分已失效的 KV 继续占着空间,容量利用率会略微下降,换来的是写放大和 P/E 周期的节约。
HBFlex 的实验口径与结果
HBFlex 的评测用四个模型:DeepSeek-V4-Pro、DeepSeek-V3、Hunyuan3、Qwen3-235B;负载是阿里百炼(Bailian)真实 trace 与 SWE-bench trace。硬件配置为每 GPU 6 个 HBF stack、每 stack 16 片 die、每 die 32 个 plane、每 plane 512 个 block、每 block 512 个 4 KB page;读延迟 4 μs、program 延迟 75 μs、读带宽 488 GB/s、program 带宽 27.2 GB/s。基线包括 H3、FA-CLI/FA-CSI(两种布局优化的混合 HBM+HBF 方案)和混合集成堆栈 IS,各方案按相同封装面积预算归一化。
HBFlex 的端到端结果遵循与 HBFWeave 相同的形态:并发任务少时,HBF 主要加速权重加载;并发上升后,KV 读写占比提高,放置与回收机制才开始主导。在四个模型、四条 trace 上,TTFT 与 TPOT 都低于各基线。相对 FA-CLI,平均 TTFT 与 TPOT 加速分别为 和 ;相对 FA-CSI 分别为 和 ;相对 H3,平均 TTFT 加速约 ,TPOT 加速约 。报告解释,TTFT 的大幅收益有一部分来自更少的 KV 容量排队,而不仅仅是单次读更快。
在 SWE-bench trace 上,HBFlex 的吞吐随并发任务数增加保持更快增长。最高并发下,相对 FA-CLI 和 FA-CSI 的平均吞吐加速分别为 和 ,相对 H3 最高达到 。低并发时更多 HBF plane 主要加速权重加载;高并发时 KV 读写占比上升,布局、写回和回收设计开始起效。这也解释了为什么 HBFlex 的收益在长上下文、多并发场景下最明显。
HBFlex 小结
HBFlex 的贡献不是某一个技巧,而是把「全 HBF 推理」这个极端形态从「不可用」推到「可设计」。它承认细页与粗 plane 的矛盾,不用增大页去掩盖,而是用页组条带化、前缀复制、热 plane offload 和 CTA 编排去消化;它承认写读干扰,用 SRAM 缓冲与 prefill 窗口把写入错开;它承认擦除放大,用寿命感知放置与延迟回收把 GC 成本压下来。代价也很清楚:40 MB SRAM 对热点的容量有限,窗口感知写回依赖 prefill 与 decode 的节奏,延迟回收牺牲了一点容量利用率。
HBFWeave:稀疏 KV 的缓存、残留 miss 与按请求分组的写入
HBFWeave 的出发点与 HBFlex 不同。它假设 KV 访问已经被稀疏注意力大幅削减:解码时只读被选中的少数 KV 条目,但为了保住精度与索引能力,完整的 KV 缓存仍然保留。这制造了一个新的矛盾:计算带宽只按被选中的条目算,而容量必须按完整缓存算。HBFWeave 的标题把这种矛盾称为 capacity–bandwidth mismatch(容量与带宽失配)。
稀疏注意力的容量悖论
稀疏注意力要解决的是计算量爆炸: 的注意力在长上下文下不可承受。它用 top-k 选择、块选择、压缩或滑窗把实际参与的 KV 降到少量。但无论选多少,模型仍需保留全部历史 KV,因为下一步的 top-k 可能指向任意位置,索引器也依赖全量 KV 或索引键。结果是:计算侧稀疏了,存储侧仍然稠密。
报告的模拟给出了规模:在 FP8 容量模型下,批大小 、上下文 1M 时,四个模型里 KV 占驻留容量的比例升到 60–92%。这与前文的定量估算一致:上下文越长、批越大,KV 越主导容量预算,权重反而变成次要项。
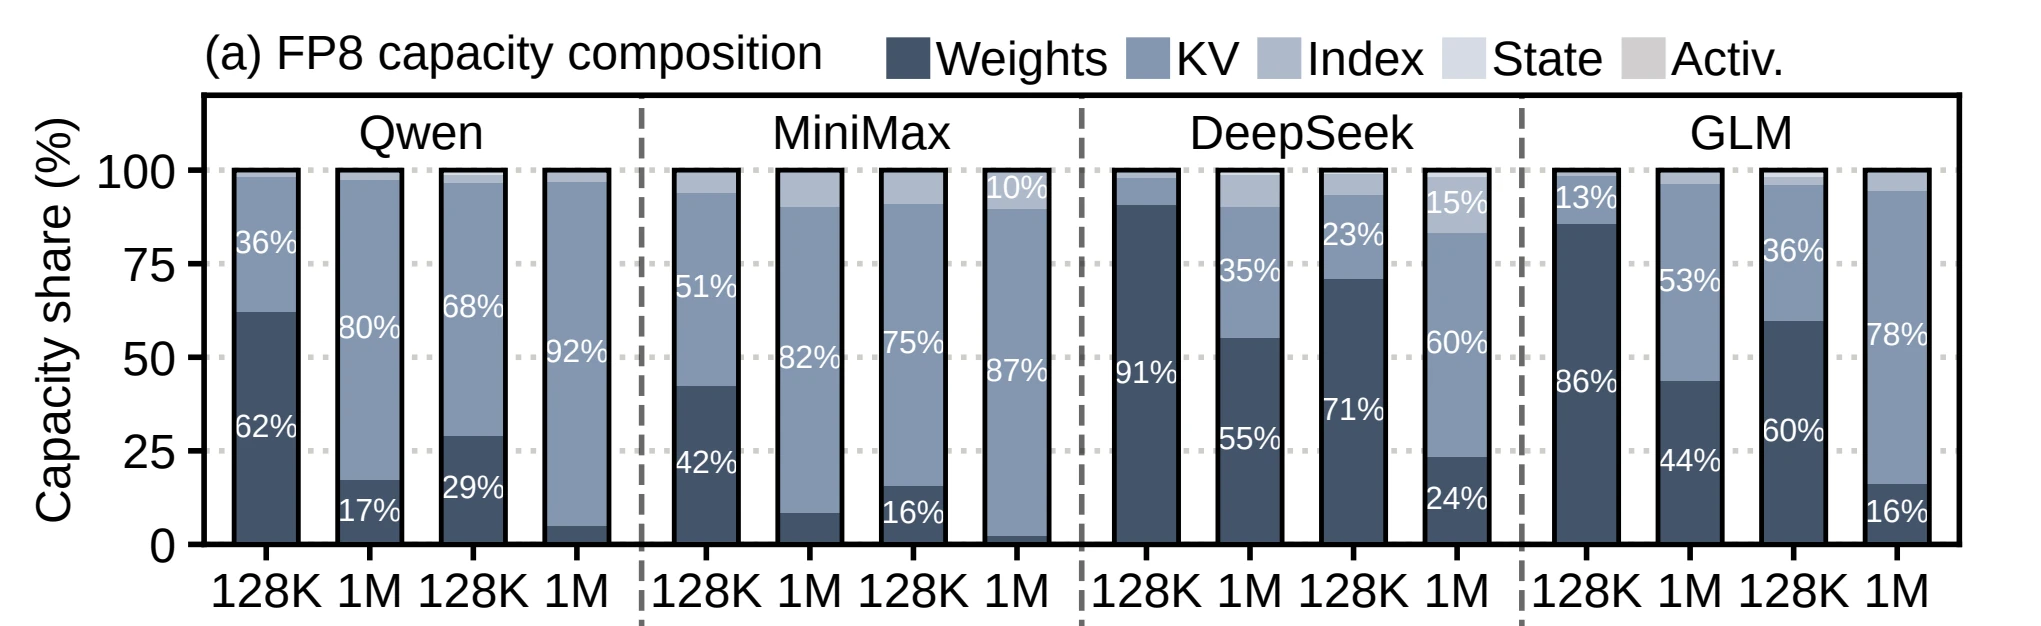
图 (a) 把容量构成拆成五类:KV、Index(索引器键)、State(线性注意力或滑窗状态)、Activ、Weights。四个模型在 128K 与 1M 两档上下文、 与 两种批大小下,堆叠柱给出各自占比。报告给出的区间是:在 、1M 时,四个模型的 KV 份额上升到 60–92%;图中同时把 Index 与 State 单列,说明即使模型用线性注意力、滑窗或索引器压缩了主 KV,KV 及其附属状态仍然占据容量主体。这张图说明混合架构(线性注意力、滑窗、索引器)虽然压缩了单 token 的 KV 大小,但在超长上下文与高并发下,KV 仍然是容量预算的最大项。
有意思的是,稀疏访问本身是高度集中的。报告测量发现,最热的 10% KV 条目承接了 92.7–98.0% 的访问。这看起来像是坏消息(热点会让 plane 失衡),但对缓存设计来说是好消息:只要把那 10% 留在 DRAM,大部分访问就不必去 HBF。问题在于,DRAM 预算太小,缓存容量远远不够装下那 10%。
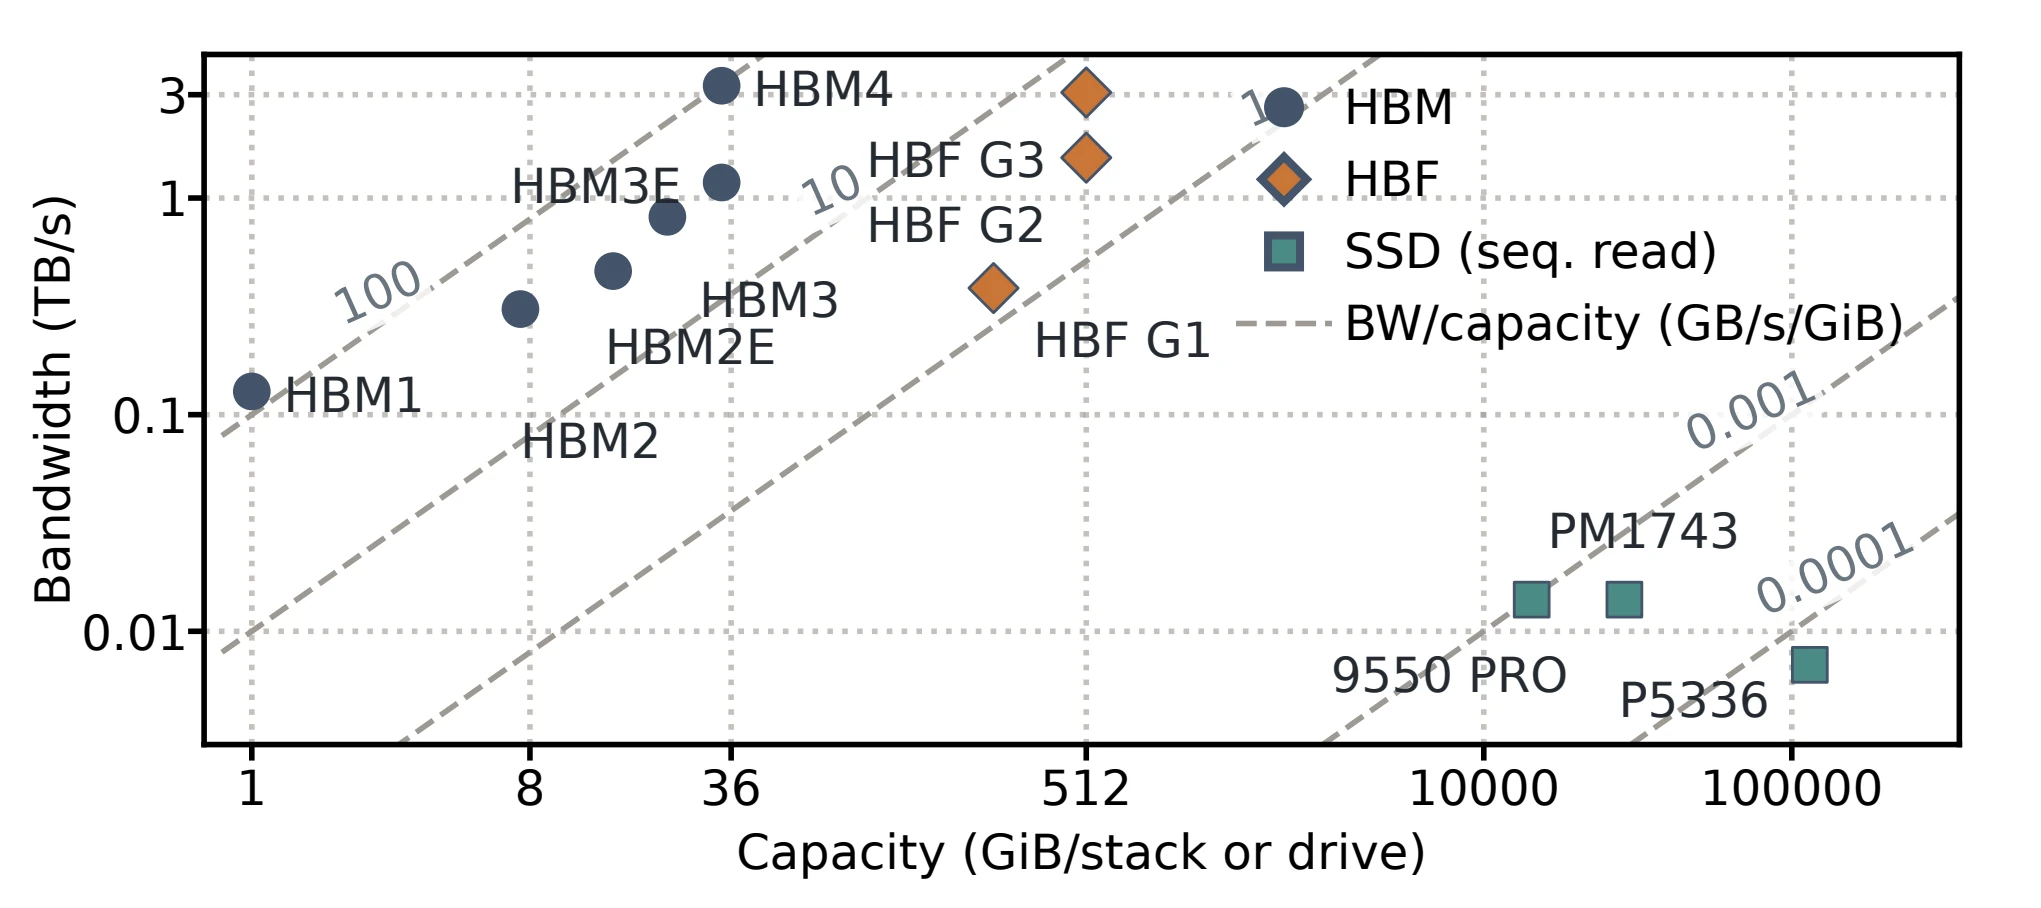
这张图把 HBM、HBF 各代、SSD(顺序读)放在「带宽/容量(GB/s per GiB)」与「容量」的二维坐标里。HBM 在左上:单位容量带宽极高、总容量小;SSD 在右下:容量大、单位容量带宽极低;HBF 落在中间偏右的位置,单位容量带宽比 SSD 高一个量级,总容量比 HBM 大一个量级。这个位置不是「HBM 的替代」,而是「容量层的替代」:它要接的是 SSD 原本承担的「读为主、容量大」的负载。图中标注的是理想 Flash 阵列带宽,不是有效随机读带宽,后者的折损正是 HBFWeave 要处理的。
混合堆栈的容量-带宽账本
HBFWeave 的系统形态是 DRAM 与 Flash 共处一个 stack。设 为 DRAM 切片数、 为 Flash 切片数,,报告给出的容量模型按每片 DRAM 贡献 2 GiB、每片 Flash 贡献 32 GiB 计,则总容量:
而 Flash 的带宽由 片 die、每片 32 个 plane、每 plane 4 KiB/4 μs 决定:
这两个式子揭示了一个线性交换关系:每把一片 DRAM die 换成 Flash die,容量净增 30 GiB,理想 Flash 带宽净增 32 GB/s。这意味着一份 16 层的 stack,若 ,容量 272 GiB、理想带宽 256 GB/s;若 ,容量 392 GiB、理想带宽 384 GB/s。报告把不同 比例下的容量和带宽画成对比图,基线方案在不同比例下各有优劣。
但「理想带宽」是前提。真实的有效带宽还要乘上 plane 利用率:如果读请求集中在少数 plane,实际带宽按 折损。HBFWeave 的方法设计,本质上是在两个变量上同时做文章:提高缓存命中率,减少 HBF 访问总量;提高 plane 利用率,让每次访问用到更多 plane。
挑战一:缓存太小,重复读闪存
报告用一个具体实验(标记为 Experiment 79,、128K 上下文)说明缓存问题。设 DRAM 缓存容量为 ,LRU 策略下页引用的命中率只有 29.9–60.8%。把缓存拓到 ,每个模型都会超出它的每 stack DRAM 预算。也就是说,在给定的封装配比下,DRAM 装不下足够多的热页,残余未命中的 KV 访问必须反复去 HBF 读。
这个数字需要解释清楚它的含义:LRU 只看访问时间,不看访问频率,而稀疏注意力的访问分布是长尾且带突发性的。一个页今天热、明天冷,LRU 会把它留下;一个页低频但持续有用,LRU 可能误逐。报告后来设计的 reuse-aware cache 正是针对这一点:用观测到的复用次数决定是否准入,而不是只用「最近是否访问过」。
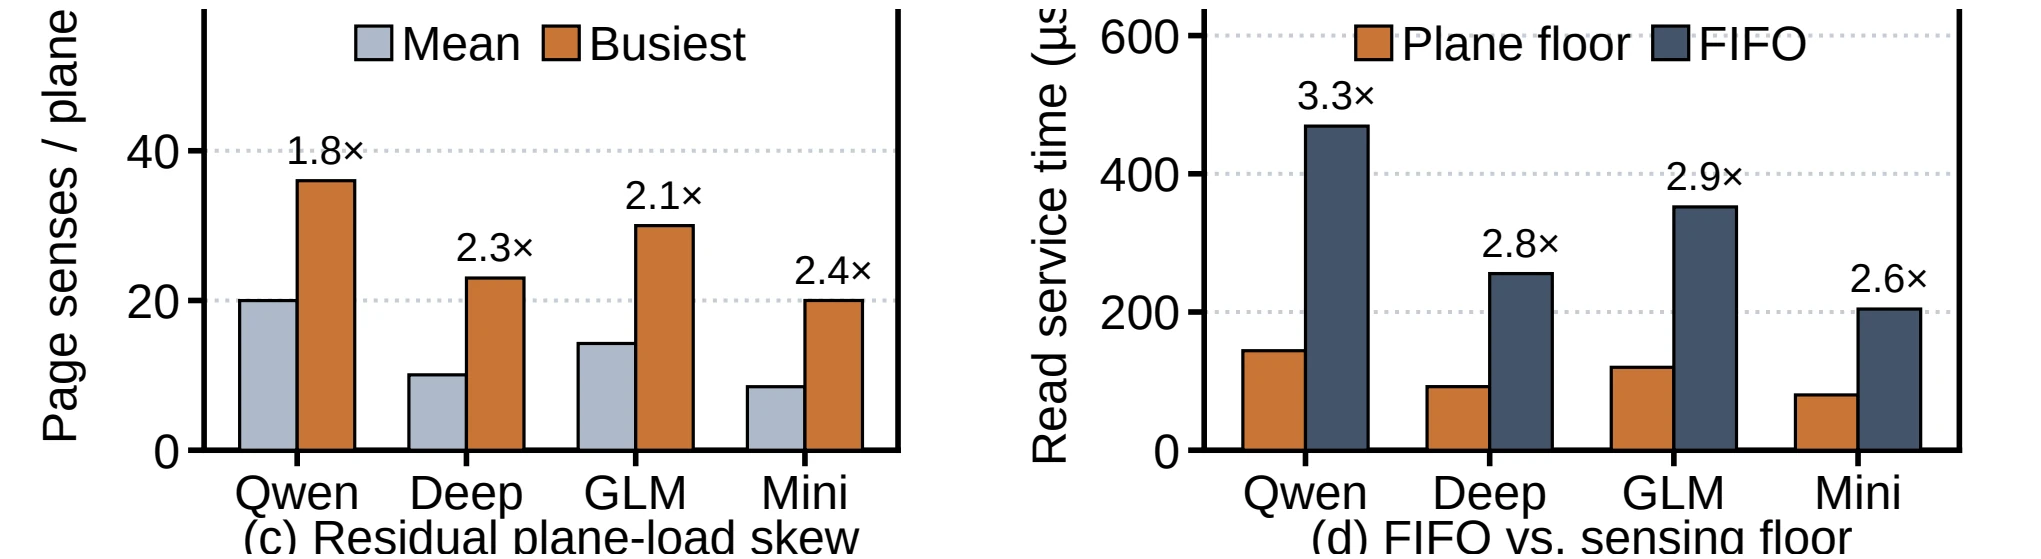
图中 (c) 是残余 plane 负载偏斜:最忙 plane 的绝对负载与平均 plane 负载的对比,四个模型标注的比值约为 、、、;(d) 是 FIFO 控制器下的读完成时间与「最忙 plane 感知下界」的比值,四个模型依次约为 、、、。这组数字量化的正是「细页随机访问 + 先进先出队列」造成的浪费:即使每个 plane 都能并行读,FIFO 让请求按到达顺序排队,热门 plane 的积压拖慢整轮。
挑战二:残余 miss 仍要等 plane 和队列
缓存只能吸收一部分访问。剩下的 miss 进入 HBF 后,还要经过两级排队:控制器队列(按 FIFO 排序)与 plane 的读出时间。报告用 FIFO replay 测量了这一段的延迟:读完成时间是最忙 plane 感知下界的 – 倍。也就是说,硬件下限是「等最忙 plane 读完」,而实际 FIFO 控制器因为不看 plane 状态,把请求排得比下限更糟。
这个问题看似只是调度顺序问题,但它与容量问题耦合。缓存越小,miss 越多,队列越长,FIFO 的顺序劣势越明显;缓存越大,虽然 miss 少了,但 DRAM 预算被吃光,HBF 占比下降。理想的解是按「ready plane」发请求:当一个 plane 空闲时,就把落在它上面的待读页发过去,而不是严格按到达顺序。这样每个 plane 的吞吐都被拉满,整批读的完成时间贴近「最忙 plane 读完」的下界。
挑战三:回收会复制存活页
混合请求生命周期带来的 GC 问题,HBFWeave 用另一个实验量化的(10,000 请求的 GC 压力测试代理)。当目标有效页比例设为 90% 时,GC 写放大为 –。这个量级与 HBFlex 测到的 30 倍不同,原因是 HBFWeave 的实验条件不同——它按 90% 的目标有效比例做回收,意味着每个 block 里只容忍 10% 的无效页,迁移量本就大;若按更低比例回收,写放大会下降但容量利用率变差。两个实验的口径不能直接比较,但结论一致:混合寿命的请求共享 block,必然让 GC 复制大量有效页。
机制一:复用感知的缓存准入
HBFWeave 的第一个机制是 reuse-aware cache admission(复用感知缓存准入)。它的逻辑与经典的 TinyLFU 思路相似:缓存不只按最近访问决定保留,还按观测到的访问频次决定准入。一个新页第一次 miss 时,系统记录它的访问次数;只有当它的复用次数超过缓存中某个候选被逐页的预计收益时,才允许它挤掉已有的页。
为什么对稀疏 KV 有用?因为稀疏注意力的访问分布高度偏斜却长尾:top 10% 条目承接 90% 以上访问,但剩余 90% 条目也各自有少量访问,并且随对话推进而变化。纯 LRU 会把一段时间没被访问但曾经高频的页逐出,把刚被访问一次的冷页留下;准入控制则让「一次性的冷页」直接穿透,不污染缓存,把有限 DRAM 留给真正会被复用的页。报告的结果是:单独 LRU 缓存带来 吞吐,加入准入控制后再带来 的稀疏读收益与 的吞吐提升(部分为投影值,见图注)。
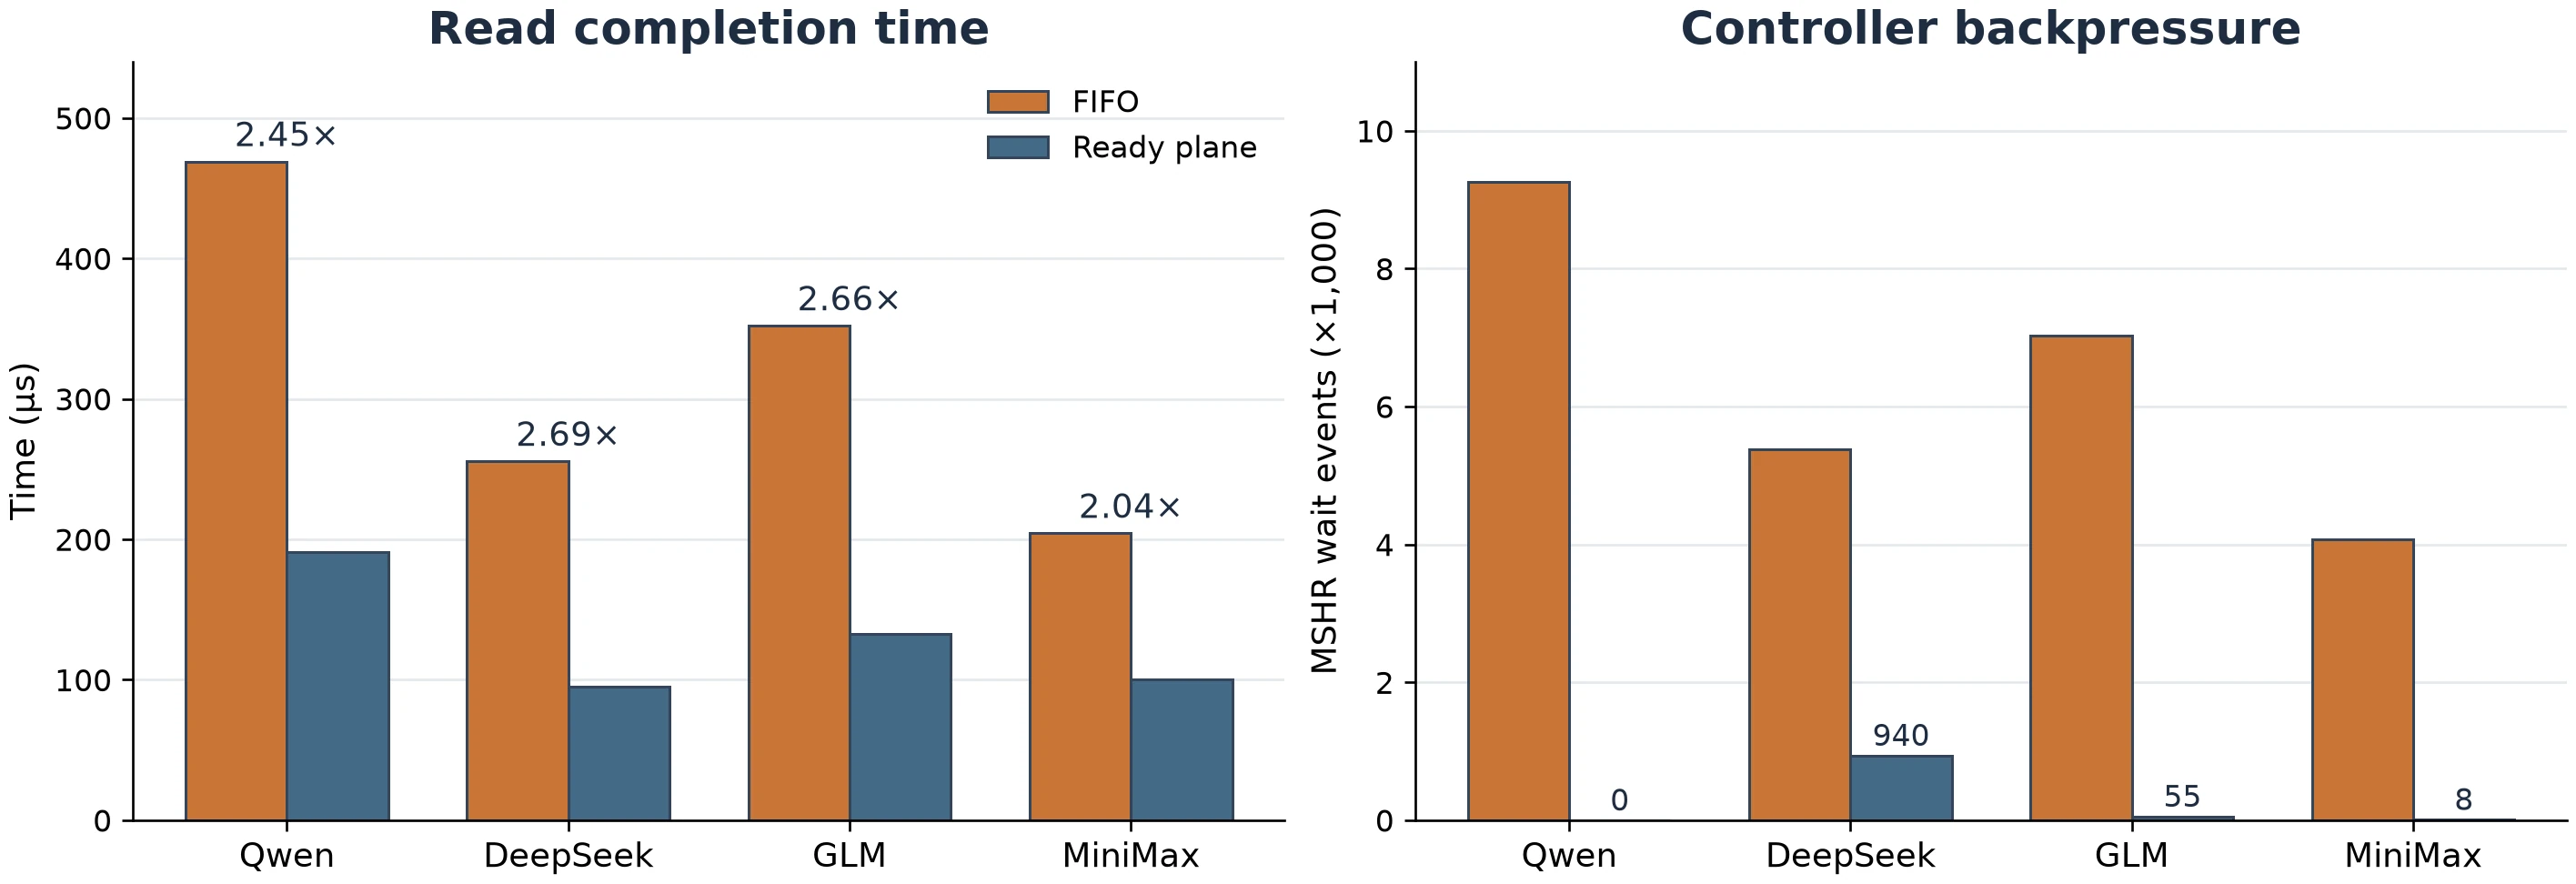
这张图对应第二个机制,但把它和第一个放在一起看更能理解「缓存 + 调度」的组合收益:缓存降低了 miss 数,调度降低了每个 miss 的等待时间,两者乘起来才是端到端的改善。
机制二:ready-plane miss 服务
第二个机制叫 ready-plane miss service(就绪 plane 未命中服务)。缓存查找失败后,残余的 page 读请求不再进入一条 FIFO 队列,而是按目标 plane 的就绪状态分发:哪个 plane 空闲,就把落在它上面的请求发过去;同一次读轮次里,尽量让每个 plane 都有活干。
它的效果不受缓存命中率影响:无论 miss 多少,只要队列里还有分布在各 plane 上的请求,就能把 plane 并行用满。报告在 Experiment 79(、128K,15F+1D 或 14F+2D 配置,单层代表、不做 miss 合并)下测得:读完成时间快 –,而 Flash page-sense 次数不变。这个「page-sense 次数不变」至关重要:它说明加速来自调度顺序,而不是读得更少。没有额外写、没有额外读,只是把同样的读请求排得更好。
图中左侧是读完成时间(FIFO 对 ready plane),四个模型分别快约 、、、;右侧是控制器背压(backpressure)随基线的位置变化,ready-plane 调度让请求以更平滑的速率进入控制器,避免 FIFO 下积压峰值的爬升。这个机制之所以在硬件上可实现,是因为 HBF 控制器本来就能观察每个 plane 的空闲状态,只是默认的 FIFO 策略没有利用它。
机制三:带缓冲、按请求分组的写入
第三个机制对应 GC 写放大:buffered, request-grouped writes。KV 与索引器键的写入先暂存在 stack DRAM 的写缓冲里,按「请求」而非「到达顺序」分组;写 Flash 时,把生命周期相近的请求放进同一批 block。这与 HBFlex 的「寿命感知放置」是同一个思想,只是 HBFWeave 把分组放在写入路径上,而不是放在分配路径上。
报告给出的结果:按请求分组后,GC 写放大代理从约 1.5–2.5 降到约 0.5(图中竖条对比),同时吞吐提升 –。这个吞吐提升一部分来自写放大下降后 GC 占用的时间减少,一部分来自写缓冲让 program 可以批量对齐 plane。
HBFWeave 的系统结构与实验
HBFWeave 的系统分为三层:预填充实例(prefill instance)、解码实例(decode pool)、与全局预填充池(global prefill pool)。软件层包括 memory-aware KV cache selection、调度器与请求队列、数据放置与 flash 布局、plane 组织与地址空间映射;硬件层是 HBFWeave memory stack,含 flash/bank、DRAM buffer、NAND 控制器、DMA 与全局地址缓存。
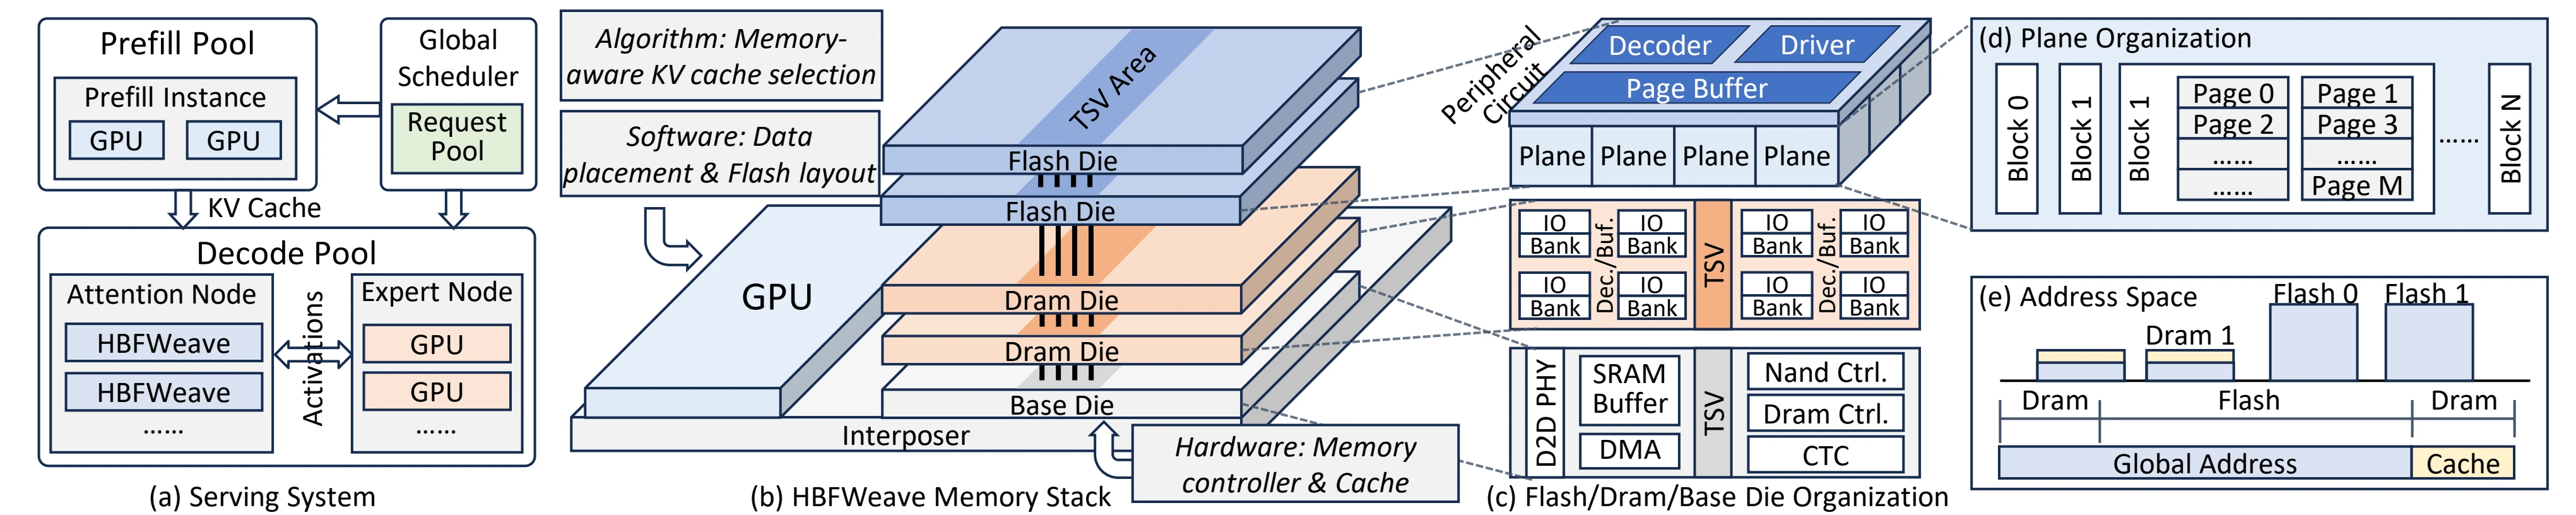
这张图信息密度很高,值得逐块解释。(a) 是服务系统层:左侧是全局预填充池,包含多个 GPU 与预填充实例;中间是 KV Cache 选择算法(Memory-Aware KV cache selection),决定哪些 KV 放进 cache、哪些留在 HBF;右侧是解码池,含 attention node 与 expert node,二者通过 A/F 边界交换激活——说明 HBFWeave 的架构里 attention 与 FFN/专家是分开部署的节点,KV 主要被 attention node 使用。(b) 是 memory stack:DRAM 与 NAND controller、DMA、全局地址缓存共同构成从 GPU 看过去的统一地址空间。(c) 是 Flash 布局:每片 die 分多个 bank/plane,软件按请求把页分配到不同 plane。(d) 是 plane 组织:Page 0 到 Page M 被铺到多片 die 的多个 plane 上。(e) 是地址空间:页号映射到控制器缓存,命中则直接返回。这五块合起来构成一条从「逻辑 KV 页」到「物理 plane 读」的完整链路。
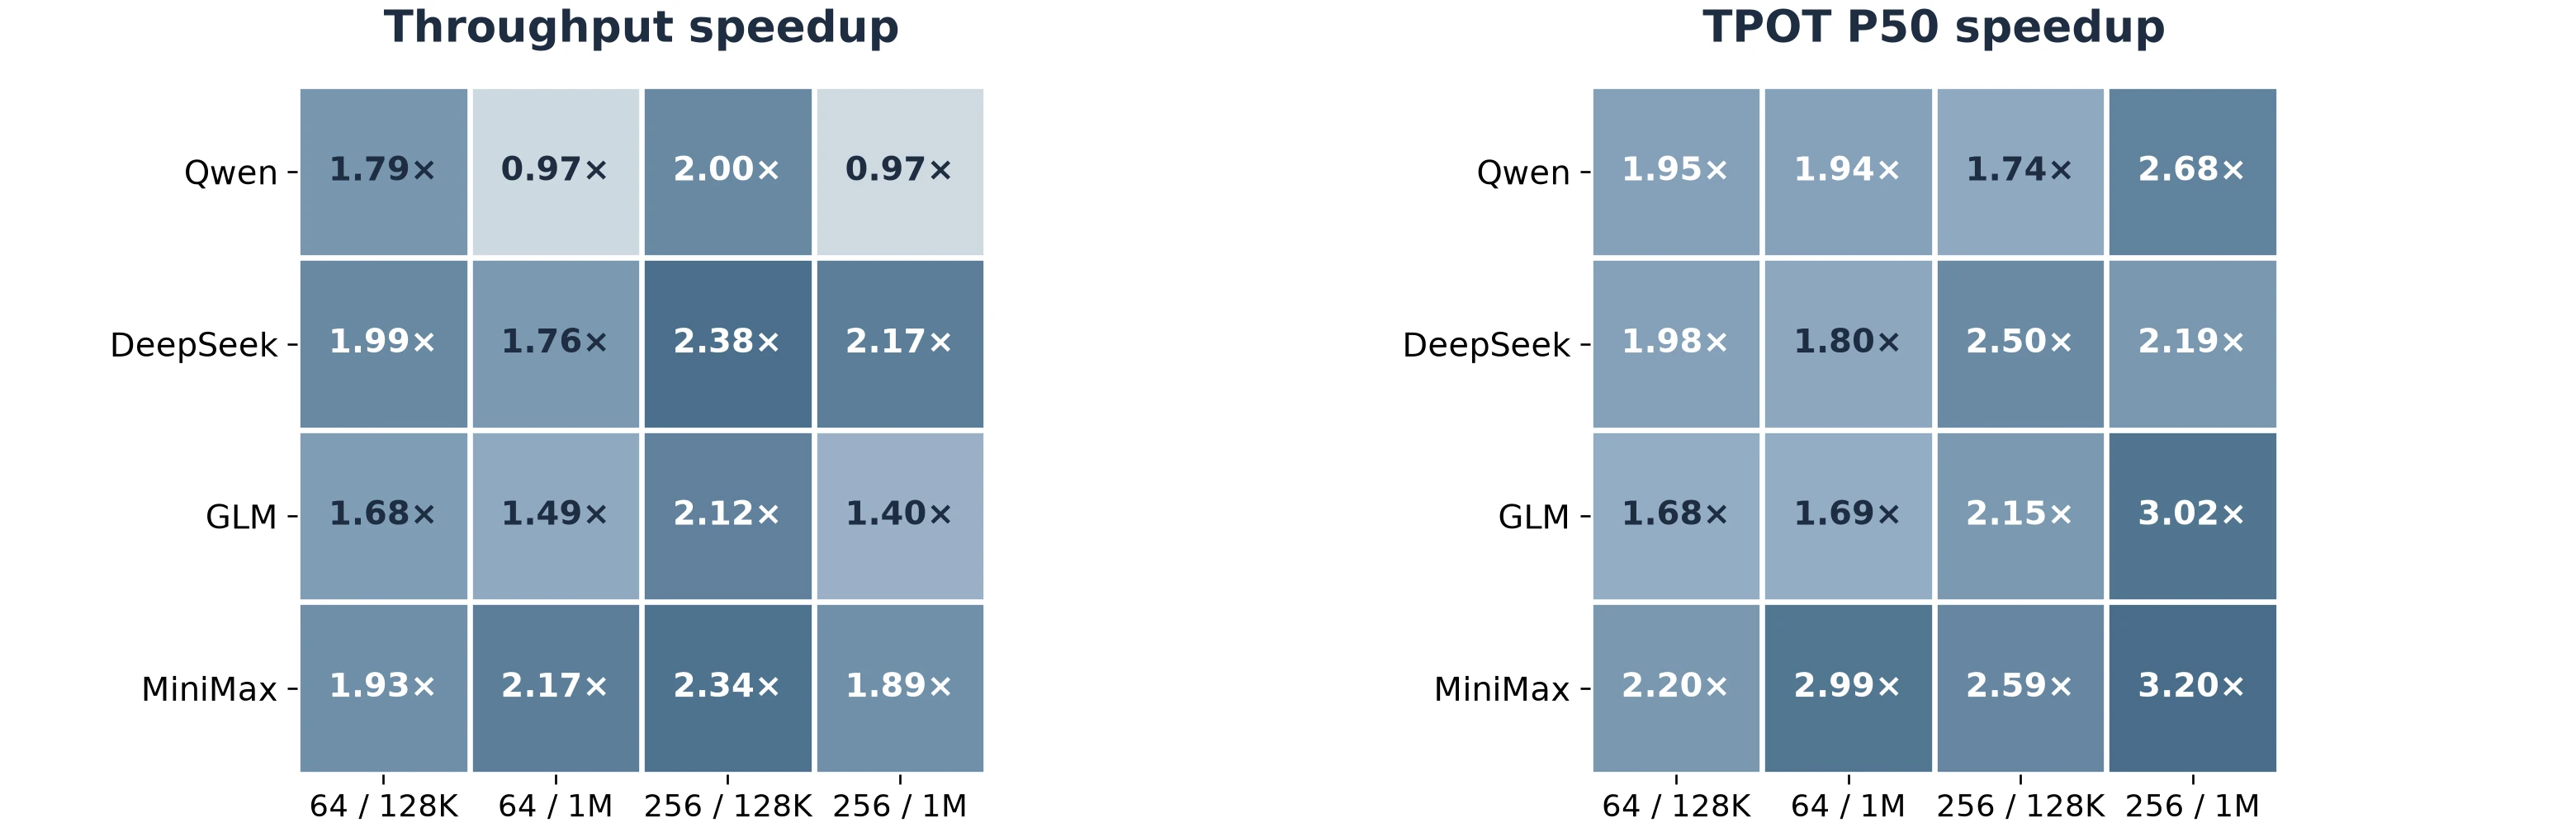
吞吐实验在 SWE-bench trace 上做,四个模型分别对应四个子图,横轴是并发任务数(128 到 4K),纵轴是相对基线吞吐。可以看到低并发时四条曲线都在 1 附近甚至低于 1(例如 Qwen 在 64/128K 下吞吐加速 ),高并发时 HBFWeave 的曲线拉开。这验证了前文的判断:并发低时 HBF 主要被权重加载使用,KV 机制收益有限;并发高时 KV 读写占比上升,缓存、ready-plane 调度与写入分组才起效。最高并发下相对 FA-CLI 和 FA-CSI 的平均吞吐加速为 与 ,相对 H3 最高 。
端到端延迟方面,报告给的是代理模型与解析回放的结果,而非硬件实测:中位吞吐加速 (16 个用例中 –),尾延迟(TPOT P99)则依赖负载,MiniMax 64/128K 为 (变差),Qwen 256/1M 为 。这个尾延迟结果很值得单独说:缓存与调度改善的是平均情况,尾延迟取决于 miss 的突发能否被 ready-plane 调度吸收。当某个请求的稀疏选择恰好集中到少数 plane、而控制器队列又被大量写请求占住时,P99 可能比基线还差。HBFWeave 报告并没有回避这一点,而是标注了它来自建模的 token 间隔,不是硬件测量。
HBFWeave 小结
HBFWeave 的贡献是给「稀疏注意力 + HBF」的组合提供了三条互相独立的机制:准入控制管缓存(减少 HBF 访问),ready-plane 调度管 miss(缩短每次访问),按请求分组管写入(降低 GC 成本)。三条机制分别对应 Experiment 78/79 中的不同 stage,报告在吞吐、平均延迟、尾延迟和写放大四个指标上都给出了分解结果——平均情况明显改善,尾延迟则随负载形态变化。它提醒读者,HBF 推理系统的评估不能只看中位数,还要看长尾是否被新的调度机制接住。
SparseHBF:当模型本身已经是稀疏注意力
前两套系统都在处理「稠密 KV」或「稀疏访问 + 全量 KV」的通用场景。SparseHBF 把镜头再收窄一层:模型架构本身就是原生稀疏注意力,HBF 只是它的存储底座。在这个前提下,瓶颈会从「KV 太大」转变成「KV 的读取模式与 HBF 的物理结构不匹配」。
为什么稀疏注意力没有解决容量问题
原生稀疏注意力(NSA)在 NSA 原生稀疏注意力(一) 里已经拆过:它用块选择、压缩选择和滑窗三个分支,让每个 query 只参与少量 KV。计算侧,它把注意力从 降到接近 ;存储侧,它仍然要求保留全部 KV,因为每个新 query 的 top-k 可能指向任何历史位置,滑窗与压缩分支也要持续读写全局状态。
报告用长上下文解码的视角重述了这个问题:在 PD 分离的 decode 节点上,高并发下超出容量的 KV 被迫 offload 到 SSD,SSD 百微秒级的读延迟直接进入解码的关键路径。HBF 的价值在这里很直接:它提供接近 SSD 的容量和接近 HBM 的带宽,让 decode 节点不必把超容量的 KV 推到更慢的层级。
但把 NSA 的 KV 放进 HBF 后,三类新的不匹配出现了:写停顿、索引器 K 的物理地址碎片、主 KV 的读取不均衡。三者分别对应前两套系统里也出现过的写读干扰、放置失衡与稀疏热点,只是在 NSA 模型下有更具体的形态。
模型参数决定了读什么、读多少
报告列了四类代表性 NSA 模型的注意力参数,这组表格是理解后续瓶颈的前提。
| 模型 | 主 KV 头数 | 头维度 | 索引器 KV 头数 | 索引头维度 | 索引块大小 | 索引 top-k | 层数构成 |
|---|---|---|---|---|---|---|---|
| DeepSeek-V4-Flash | 1 | 512(448 + 64 RoPE) | 1 | 128 | CSA 4;HCA 128 | 512 | 2 + 21 CSA + 20 HCA = 43 |
| Qwen3.8-Next | 2 | 256 | 1 | 128 | 4 | 512 | 36 GDN + 12 QSA = 48 |
| MiniMax-M3 | 4 | 128 | 1 | 128 | 128 | 16 | 3 + 57 MSA = 60 |
| GLM-5.3-Flash | 1 | 512(MLA 式 latent) | 1 | 128 | 4 | 512 | 34 KDA + 11 DSA = 45 |
表格里最重要的不是模型名,而是「主 KV 读取量」与「索引器 K 读取量」的比例。报告把它整理成另一张按存储粒度计算的表:每个模型的最小 KV 条目粒度(以字节计)、每个 4 KB page 能装多少个条目、KV 总大小、单步读 KV 大小、单步读索引器 K 大小。
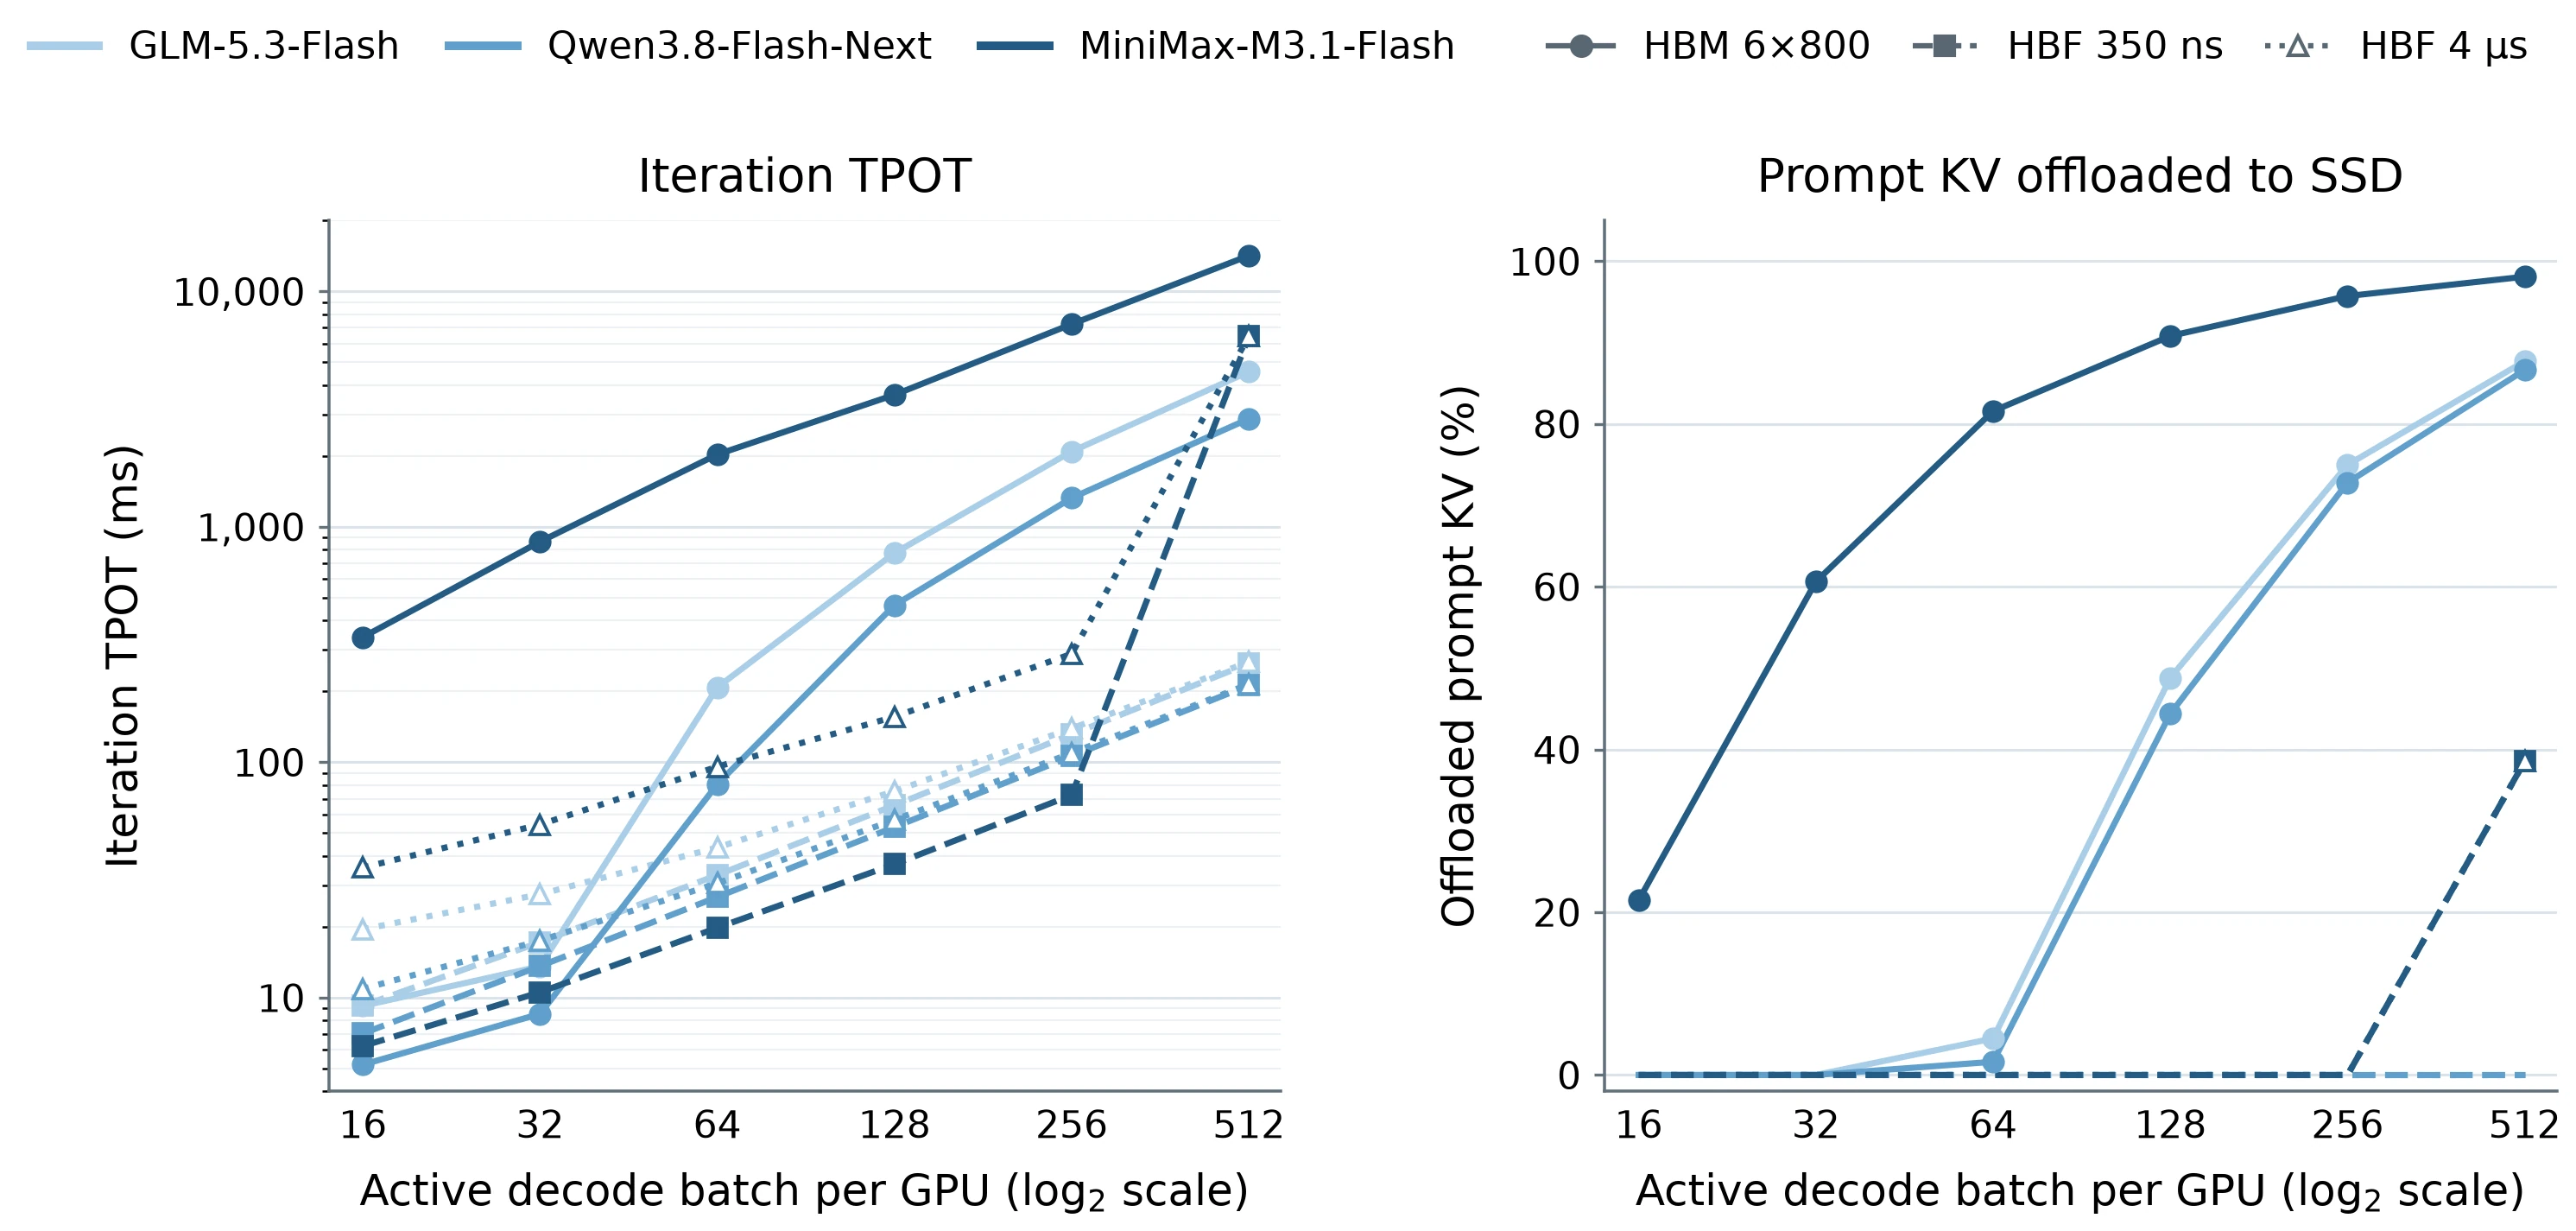
图里比较了几个模型在不同上下文长度(16 到 512,对数为横轴)与不同活跃解码批大小下的 TPOT,同时标出 HBM 与 HBF 的延迟档位与「Prompt KV offloaded to SSD」的位置。可以直接读出报告的结论:主 KV 读取量均不高于 2K token;当上下文超过约 64K 时,索引器头的读取量反而高于主 KV。原因是索引器要扫全量索引键才能选出 top-k,而主 KV 只读选中的块。这个反转让索引器 K 成了 HBF 上的主流量来源,它的物理布局是否碎片化,直接决定了读带宽。
这里能看出 NSA 设计里一个容易被忽略的工程含义:索引器虽然用低维、低头数,把「每 token 的索引开销」压得很小,但它是 dense 读——每次都要把整段索引键过一遍。与之相比,主 KV 是 sparse 读——只读 top-k 选中的块。dense 读看起来对 HBF 友好(整存整取,像权重加载),但它只有在物理地址连续时才能按 plane 并行;而 PagedAttention 在服务场景里分配 block ID 近似随机,索引器 K 的物理地址因此散落在各 plane。
挑战一:写停顿
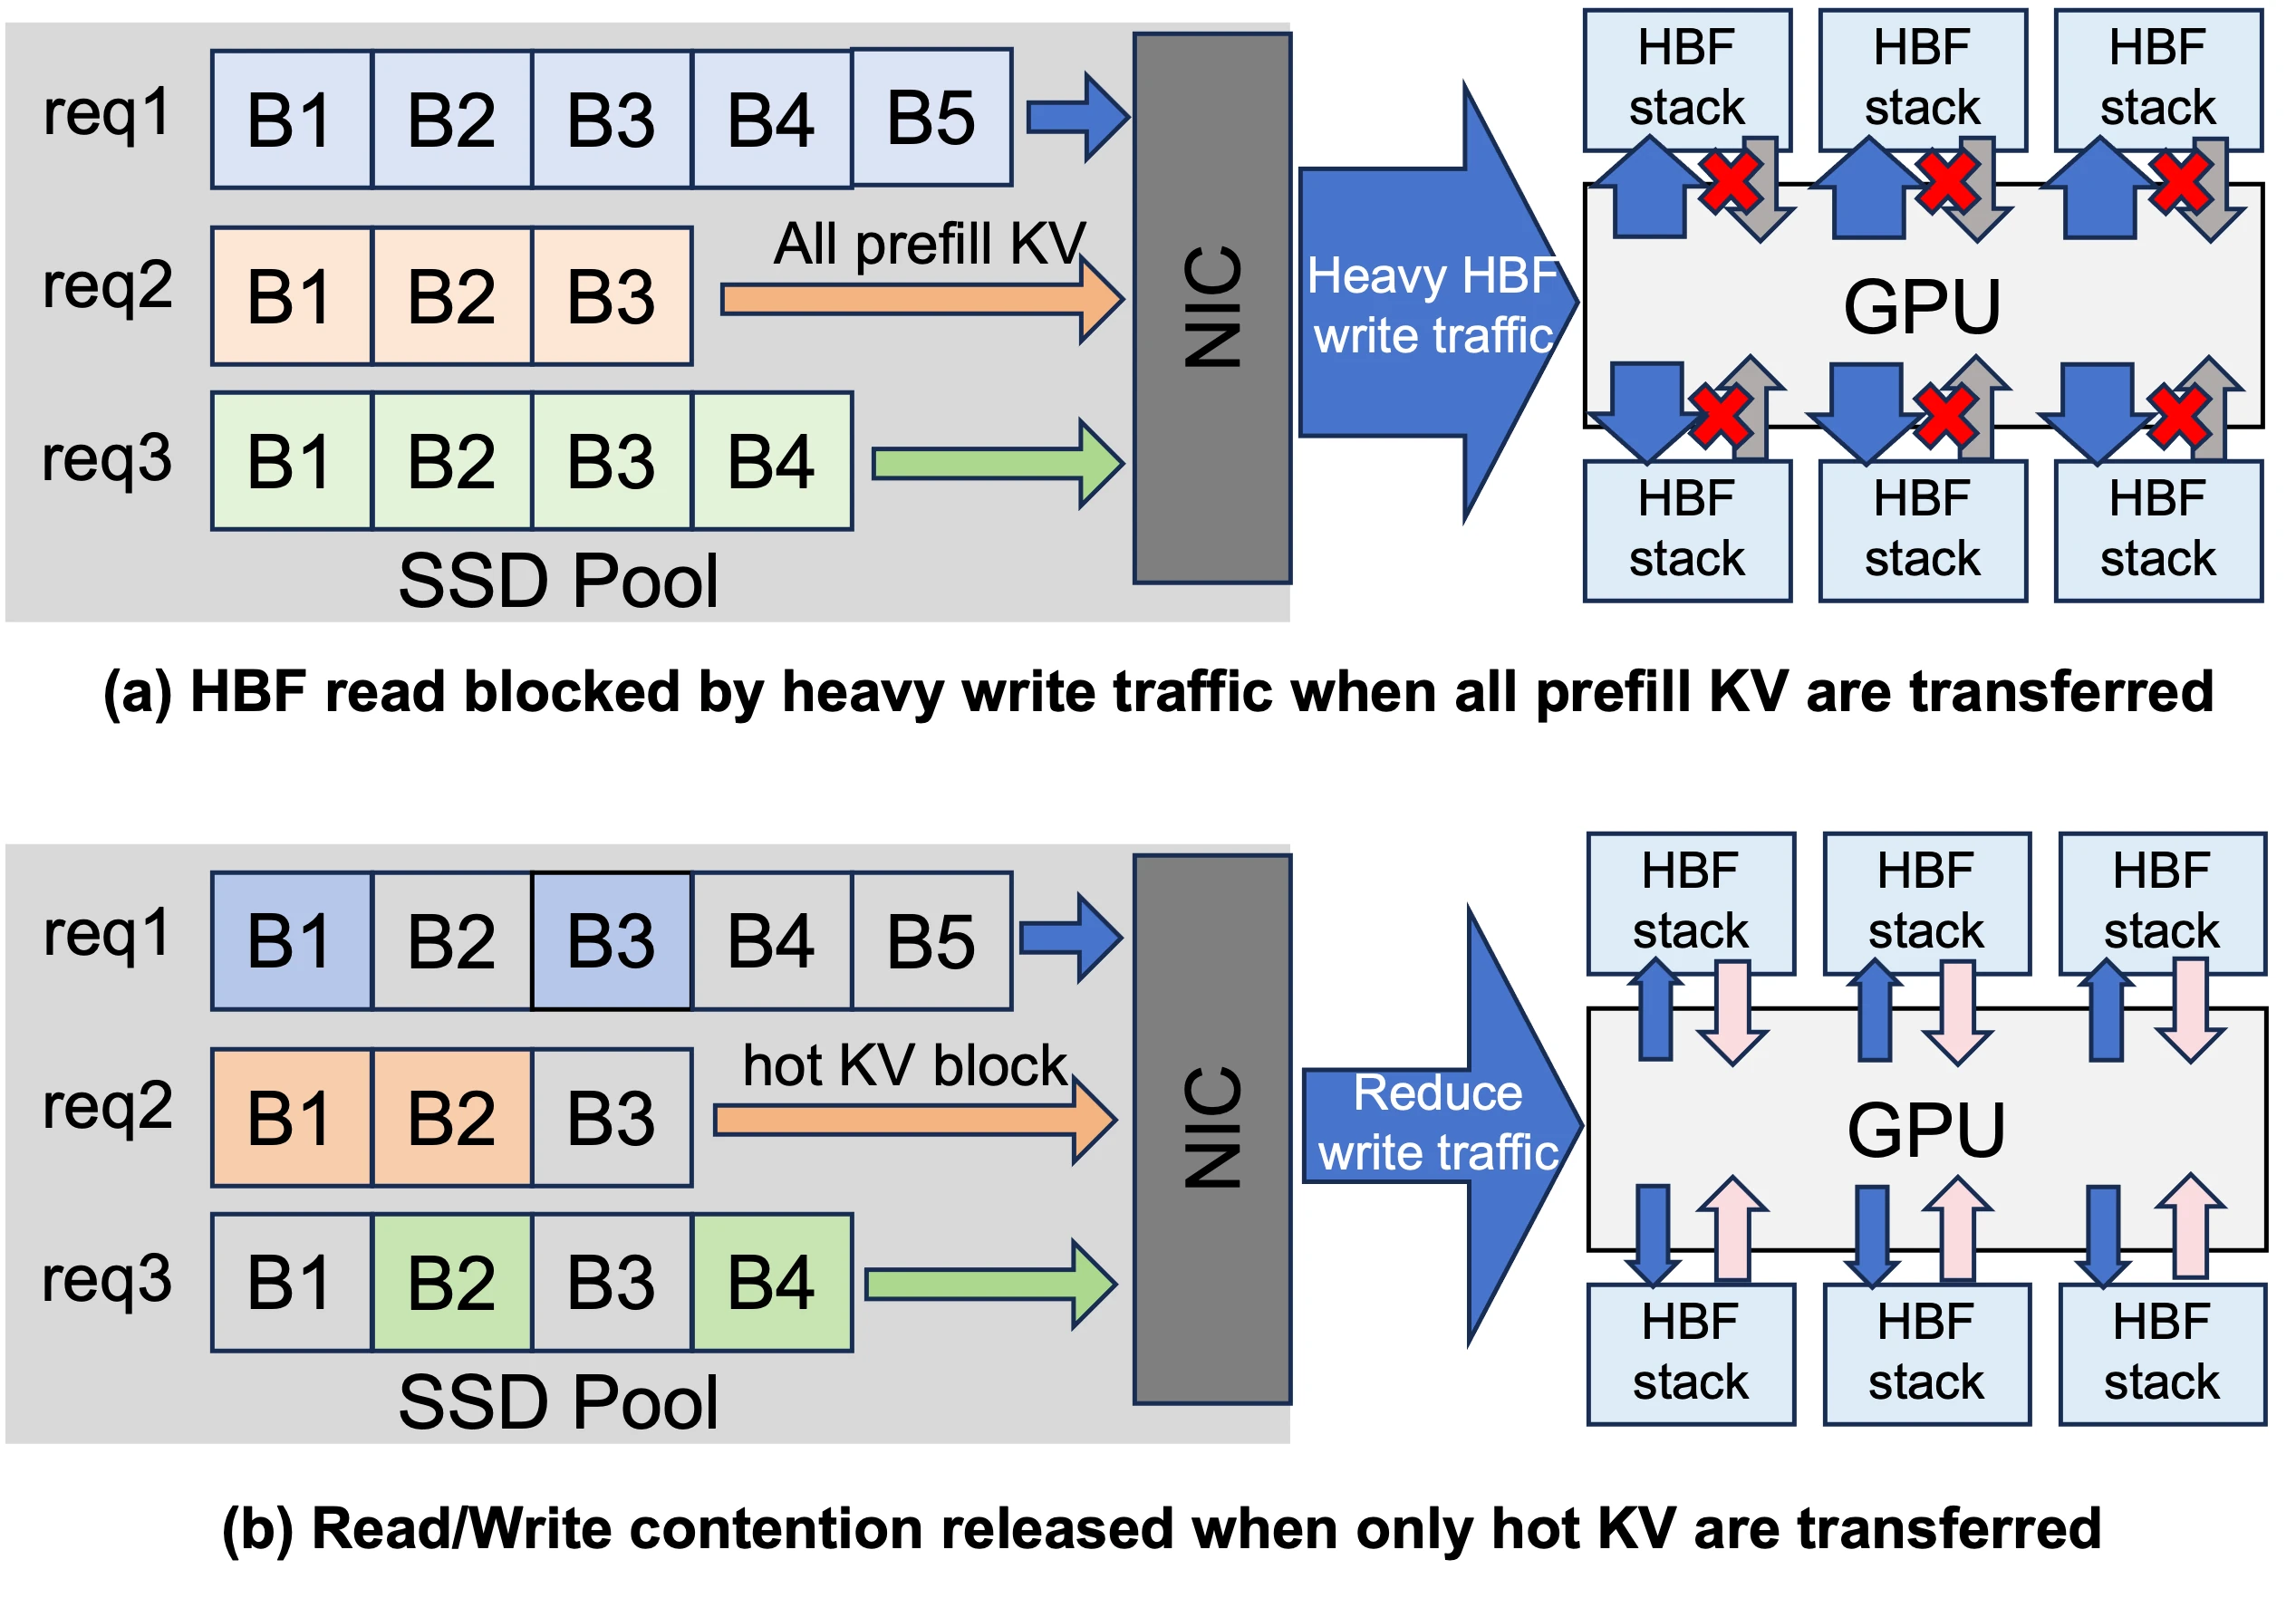
SparseHBF 的写停顿问题在 PD 分离下尤为突出。prefill 节点算出的 KV 与 decode 节点生成的 KV,会源源不断地写入 decode 节点的 HBF。NAND program 延迟远大于 read,且同一 plane 的读写不能并行,程序会阻塞正常的 read。报告用图把这层阻塞画得很清楚:req1、req2、req3 的全部 prefill KV 都写进 HBF 时,写流量把读堵住;只有热 KV 写进 HBF、冷 KV 写进 SSD 池时,读才通畅。
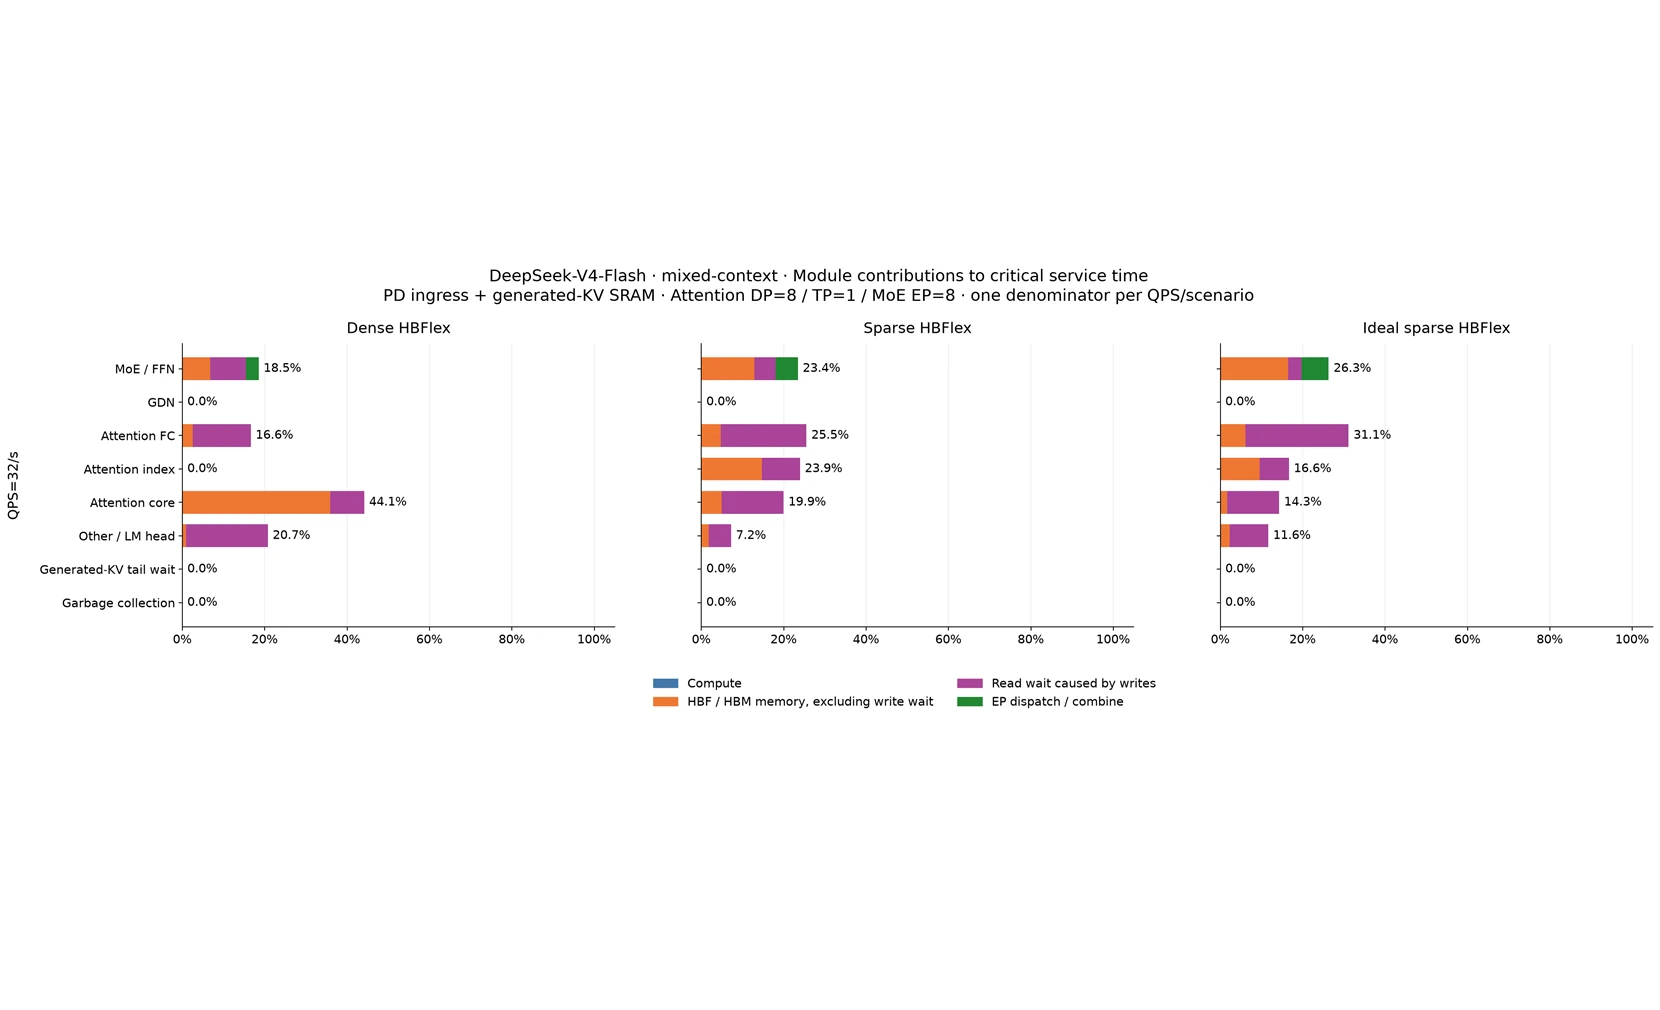
图 (a) 是「所有 prefill KV 都转移」的情况:三个 HBF stack 的写队列被 req1 的 B1–B5、req2 的 B1–B3、req3 的 B1–B4 填满,GPU 的读请求在后面排队。图 (b) 是「只写热 KV」的情况:req2、req3 的冷块直接写 SSD 池,HBF 只接收热块,读的通道被让出来。报告的结论是:利用 prefill 得到的激活信息判断热/冷 KV,把热 KV 留在 HBF、冷 KV 放到 SSD,可以减小写停顿,同时降低 endurance 消耗——因为主 KV 占据主要存储容量,把非热部分移出 HBF 直接减少了 program 数量。
这个设计与 KV Cache Offloading 完全拆解 里的分层思想一致,但方向反过来了:传统做法是把冷 KV 从 HBM 移到 SSD,让出 HBM 容量;SparseHBF 是把冷 KV 从 HBF 移到 SSD,让出 HBF 的写带宽。HBF 不像 HBM 那样能并行读写,所以「让出写带宽」和「让出容量」同样重要。
挑战二:索引器 K 的物理地址碎片
索引器 K 的读取是 dense 的:一次过完整段索引键,理论上可以像权重一样整存整取,正好适合 HBF 的多 plane 并行。问题出在物理地址。在 PagedAttention 机制里,KV block ID 由分配器从空闲队列里取,服务场景下请求交错、回收交错,block ID 近似随机;索引器 K 按请求存在这些 block 里,物理地址就随机散落。同一个请求的索引器 K 被分到很多 plane 上,单次读只用到少数 plane,热点集中,带宽用不满。
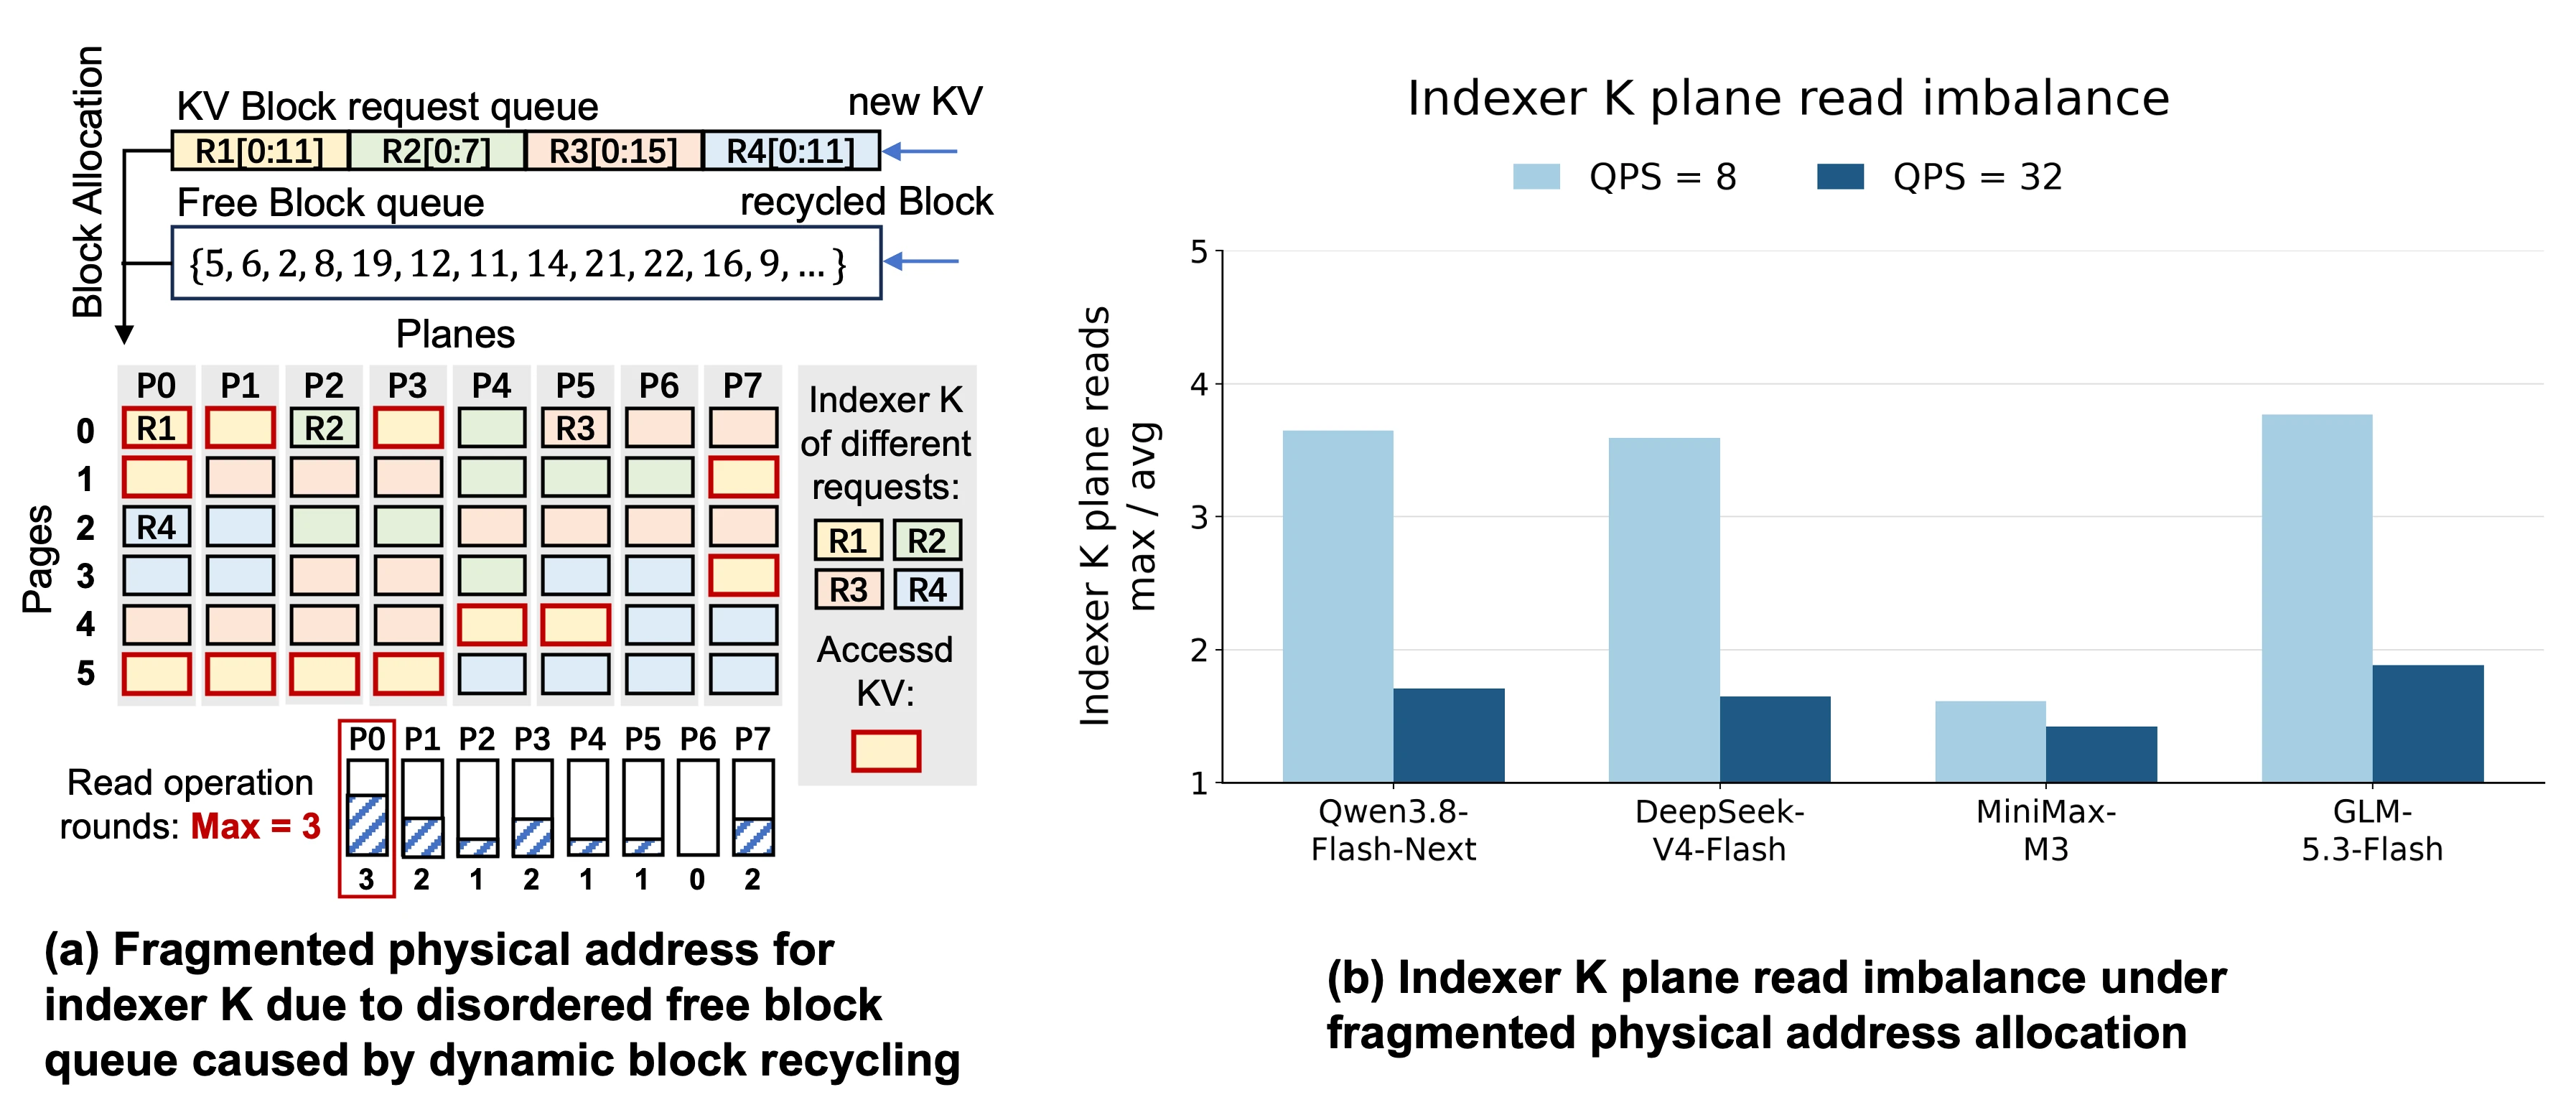
图 (a) 是碎片化成因:KV block 请求队列从空闲块队列里取出 {5, 6, 2, 8, 19, 12, 11, 14, 21, 22, 16, 9, ...} 这样的乱序块,再映射到 P0–P7 八个 plane;不同请求的索引器 K(R1[0:11]、R2[0:7]、R3[0:15]、R4[0:11])被切成小块铺到不同 plane,读轮次由最忙 plane 决定,图中例子是 Max = 3。图 (b) 是四个模型在 QPS=8 与 QPS=32 下的不均衡对比:有请求归属提示(allocation w/ hint)时曲线明显低于无提示。
解决方案是让 GPU 在发访存请求时附带 request ID 和该请求的需求容量,memory controller 为每个请求规划一块连续存储空间,使索引器 K 分散到不同的 plane 上。这与 HBFlex 的页组条带化思路相似,区别在于 HBFlex 条带化的是 KV 页、由运行时决定;SparseHBF 条带化的是请求的索引器 K,由控制器依据 hint 规划。两者都要求「分配时就知道物理 plane 的归属」,而不是事后在块表里查到。
挑战三:主 KV 的读取不均衡
主 KV 的问题与 HBFlex 的 access imbalance 同源:即使 KV 在物理上均匀分布,top-k 稀疏选取之后,不同 plane 被选中的 page 数仍然不匀。报告给的例子是 8 个 plane、 的选取:选中的 4 个块可能落在 3 个 plane 上,那个「多一块」的 plane 决定了读轮次。随着索引头读取量在 64K 以上反超主 KV,主 KV 的绝对量虽小,但它的不均衡仍然会在关键路径上产生延迟。
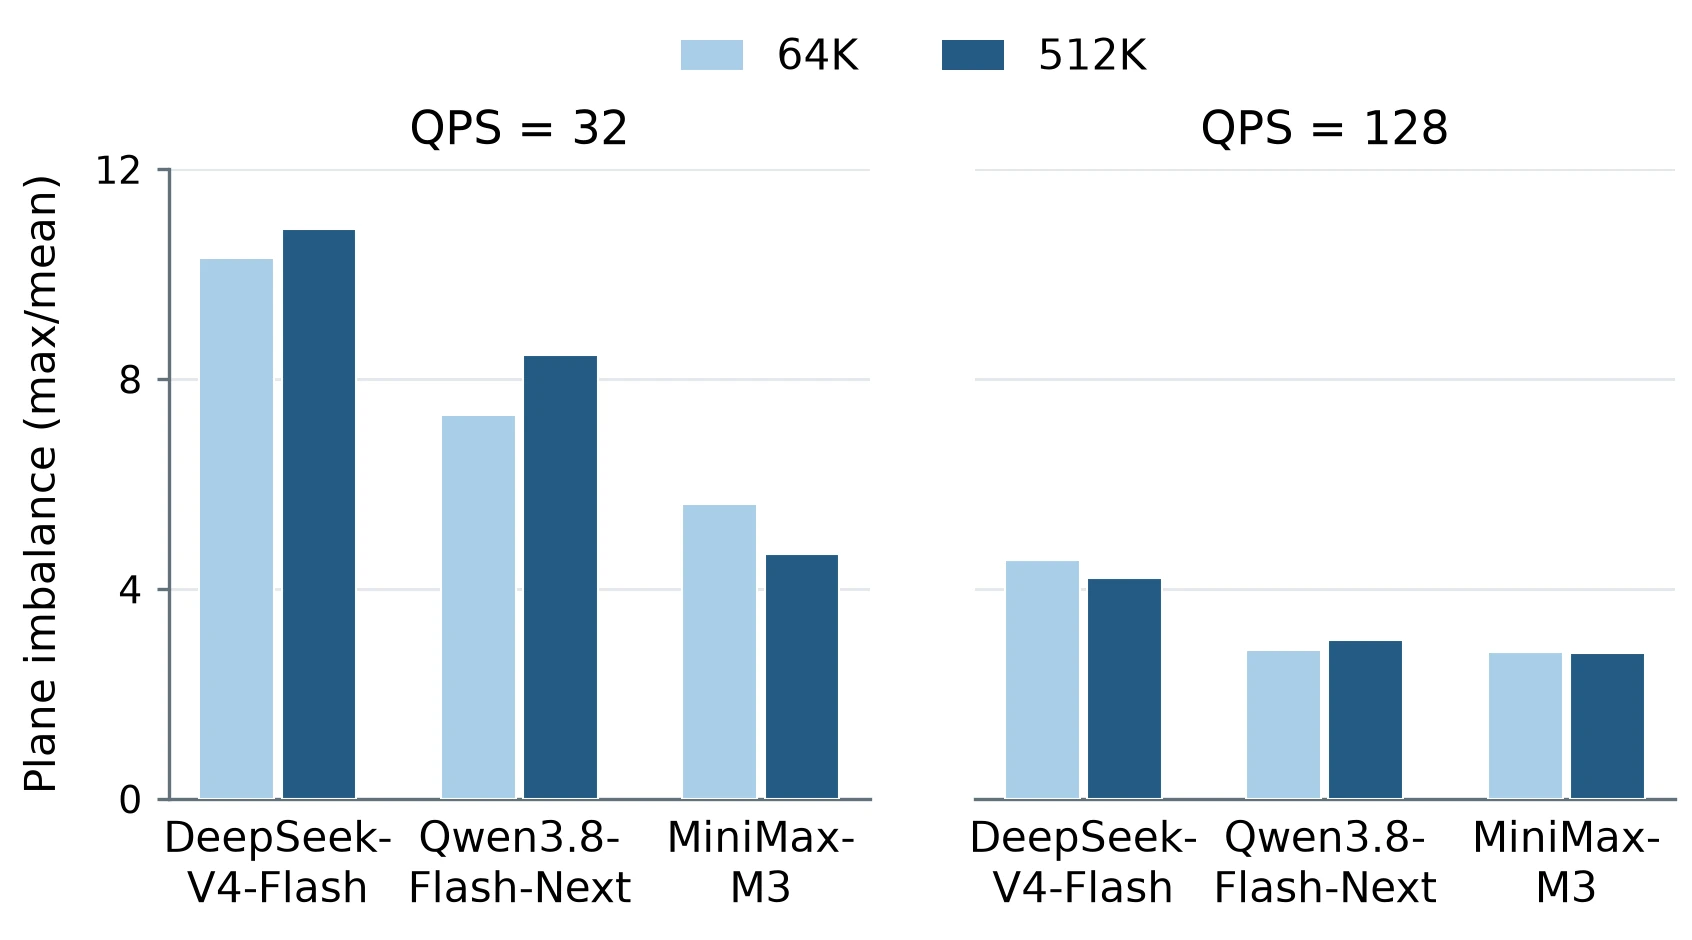
图 (a) 是选取示例:R1–R4 的不同请求各自的 KV 分布在 P0–P7,经过 k=4 选取后,各 plane 被选中的页数分别为 2、5、0、1、2、2、3、1,最忙 plane 要读 5 轮而最闲的为 0。图 (b) 是不同上下文(64K、512K)与不同 QPS(32、128)下四个模型的不均衡曲线,整体形态说明不均衡不是个别 case,而是稀疏选取的系统性后果。
SparseHBF 的方案是用 prefill 阶段的激活热度作为 hint 指导页分配,把热点页分散到不同 plane;同时在 DRAM 中缓存热页,缓解时间局部性上的 plane 热点。这两条与 HBFlex 的「前缀复制 + 热 plane offload」、HBFWeave 的「reuse-aware cache」是同一类思路的不同实现:都用「观察到的热」去反推「物理放置」,只是观察的来源(prefill 激活、缓存复用、请求归属)不同。
系统结构与参数
SparseHBF 的系统目标是给 NSA 模型搭一个 HBF 底座。报告列的配置是:每个 GPU 5 个 HBF stack;每 stack 16 片 HBF die、每 die 16 个 plane;每 plane 512 个 block、每 block 1024 个 4 KB page;每 stack 还有 1 片 4 GB DRAM die,读带宽 512 GB/s、读延迟 0.35 μs、写延迟 75 μs、擦除延迟 10 ms。与 HBFlex 的 32 plane 相比,这里每 die 只有 16 个 plane,聚合带宽更低(第三代 SanDisk OCP HBF stack 报告为 3 TB/s per stack,单 stack 读延迟约 0.35 μs 量级的口径来自报告参数),但单 stack 容量和卡间通信能力不同。
这张图是 SparseHBF 的系统总览,包含几个可用的细节:32 卡部署、卡间单向 450 GB/s 通信(报告特别注明不是 InfiniBand);prefill 得到的 KV 写入 decode 节点的 HBF,decode 阶段生成的 KV 先写入 DRAM,DRAM 容量不足时再存入 HBF;Qwen3.8 的线性注意力分支、DeepSeek-V4 的滑窗 KV 分支各有对应处理;还有写缓冲与缓存模块。它把「哪些 KV 走 HBF、哪些走 DRAM、哪些走 SSD」三层分流画成一条数据流,这条分流正是前面三个挑战的解法在系统层的组合。
SparseHBF 的结论:HBF 更适合谁
报告最后给出了一个对架构选择很关键的判断:在当前模型架构下,HBF 更适合边端而非云端。理由是云端对运行时存储容量的需求相对更低、对带宽需求更高,而边端的容量约束更紧、并发更低、对单位成本更敏感。如果要进行异构部署,HBF 更适合做 prefill 节点而非 decode 节点:prefill 对存储需求更大(一次要写入大段 KV),decode 对存储需求较小(每步只写一个 token 的 KV);KV 命中率是节省成本的第一要素,取决于 prefill 节点的命中情况。
这个结论值得细读。它并没有否定「decode 用 HBF」,而是说:在 PD 分离的部署里,把 HBF 放在 prefill 侧,收益更稳定。原因可以从前文的三个挑战反推:decode 侧的瓶颈是「每步都要读历史 KV + 每步都要写新 KV」,读写争用最严重;prefill 侧虽然要写入大段 KV,但读压力集中在一次性的 attention 计算上,写窗口更容易错开。报告还指出,HBF 的大粒度特性会带来许多新的研究场景,而算法研究天然导向细粒度控制——这句话点出了长期矛盾:模型层在追求更细的 KV 管理(更小的页、更精确的 top-k、更细的压缩),硬件层却以大 page/block 为单位。三套系统的全部设计,都是在两者之间找折中点。
三套系统横向对比
把三套系统放在同一组指标下对比,能看清它们各自的适用边界。
| 维度 | HBFlex | HBFWeave | SparseHBF |
|---|---|---|---|
| 封装形态 | 全 HBF | DRAM + HBF 混合堆栈 | HBF + 少量 DRAM(每 stack 4 GB) |
| 目标负载 | 通用稠密/混合 KV,长上下文、高并发 | 稀疏注意力 + 全量 KV 常驻 | NSA 模型(DeepSeek-V4、Qwen3.8、MiniMax-M3、GLM-5.3 类) |
| 读不均衡解法 | 页组条带化 + 前缀复制 + 热 plane offload + CTA 编排 | reuse-aware cache + ready-plane 调度 | 请求归属 hint 规划索引器 K + 激活热度指导主 KV 放置 |
| 写读干扰解法 | SRAM 缓冲 + prefill 窗口批量写回 | 带缓冲、按请求分组的写入 | 热/冷 KV 分流(热进 HBF、冷进 SSD) |
| GC 解法 | 寿命感知放置 + 延迟回收 | 按请求分组 + 缓冲 | 未单独展开(依赖热冷分流减少主 KV program) |
| 数据来源 | 论文级 manuscript 图与实验 | manuscript 图 + 代理/解析回放(Experiment 78/79) | 报告图 + 参数表 + 实验口径说明 |
| 关键定量结果 | GC 写放大 ;TTFT 相对 H3 约 | 中位吞吐 ;ready-plane 读完成快 – | 索引器 K 读写不均衡在 hint 下明显下降;主 KV 读取量 2K |
这张表里最值得注意的不是数字,而是三个系统没有互相替代。HBFlex 假定没有 HBM 兜底,必须自己处理全部读写回收;HBFWeave 假定 DRAM 是主缓存、HBF 是容量层,因此可以把一部分问题推给缓存;SparseHBF 假定模型已经把访问变稀疏,因此重点转向「索引器 dense 读」与「主 KV top-k 读」这两种模式的物理布局。同一个「HBF 接入推理系统」的问题,因为封装形态与模型形态不同,最优解也不同。
从演进上看,三套系统的共性比差异更值得记:它们都把 KV 的生命周期当成设计输入,都不再假设「块表查到哪里就读哪里」,都要求运行时或控制器知道物理 plane 的负载与空闲状态。这也是 HBF 与 HBM 最本质的差别:HBM 的 bank 级并行由内存控制器透明处理,软件几乎不需要关心;HBF 的 plane 级并行需要软件与控制器协同,谁来决定「这一轮读哪些 plane」,直接决定带宽利用率。
局限、争议与尚未回答的问题
这组工作给出的结果很有说服力,但读时需要保留几层保留意见。
第一,数据多来自代理模型与解析回放,不是硬件实测。 HBFWeave 的吞吐与延迟明确标注为代理回放与建模 token 间隔,尾延迟部分尤其如此;HBFlex 与 SparseHBF 的系统结论也建立在设计参数(plane 数、读延迟、program 延迟)之上。HBF 样品预计 2027 年初才出样,目前的评估是设计空间探索,不是产品规格。论文级 manuscript 的图(HBFWeave 部分)与报告图(HBFlex、SparseHBF 部分)口径不同,不能混用同一个基准线比较。
第二,SRAM/DRAM 缓存容量是硬约束。 HBFlex 的 40 MB SRAM、HBFWeave 与 SparseHBF 的每 stack 4 GB DRAM,都只是热点的缓存。一旦工作集超过缓存,收益依赖调度与放置,而这两者本身要消耗元数据与带宽。LRU 与准入控制的命中率在稀疏长尾分布下能到多少,报告给了区间而非保证;真实 trace 的突发形态可能让某些 case 的尾延迟比基线更差,HBFWeave 的 P99 数据已经展示了这一点。
第三,写放大与容量利用率的权衡。 延迟回收把 GC 写放大从 11.98 倍压到 1.04 倍,代价是失效页继续占容量;按 90% 目标有效比例回收时,写放大仍有 4.2–7.8 倍。这两者之间没有免费的午餐:闪存耐久与可用容量此消彼长,最终要按部署方的成本模型选择。
第四,模型侧的持续变化会改写结论。 SparseHBF 的表里已经看到,不同模型的层构成差异很大(GDN、KDA、MSA、CSA/HCA),索引器读取量反超主 KV 的上下文阈值也不同。当模型进一步把 KV 压得更细(更小的条目粒度、更多跨层复用),HBF 的大 page/block 粒度会越来越难对齐;当模型改用更激进的稀疏,索引器的 dense 读会成为更大的负担。HBF 的容量优势不会消失,但「如何把细粒度状态放进粗粒度介质」这个问题会长期存在。
小结
HBF 给推理系统带来的不是「更大的显存」,而是一层容量与带宽都介于 HBM 与 SSD 之间的介质。这层介质能不能用起来,取决于推理系统愿不愿意把 PagedAttention 的「逻辑页」翻译成闪存的「plane 轮次」。
HBFlex 回答了全 HBF 形态下的完整设计:页组条带化把逻辑页铺匀到 plane,前缀复制与热 plane offload 吸收共享热点,SRAM 缓冲与 prefill 窗口把 decode 写入错开,寿命感知放置与延迟回收把 GC 写放大压下来。HBFWeave 回答了混合堆栈形态下的稀疏 KV 问题:稀疏访问的集中性让缓存有价值,但缓存太小,于是用准入控制提高命中,用 ready-plane 调度缩短 miss,用按请求分组降低写放大。SparseHBF 回答了 NSA 模型落地 HBF 时的具体瓶颈:写停顿要靠热/冷分流,索引器 K 碎片要靠请求归属规划,主 KV 不均衡要靠激活热度指引,而 HBF 更适合做 prefill 节点而不是 decode 节点。
三套系统的共同结论可以压缩成一句:HBF 的带宽是按 plane 发放的,谁掌握了 plane 的负载与 KV 的生命周期,谁才能把容量优势变成吞吐优势。
参考资料
- 本站:H³ 完全拆解:HBM 与高带宽闪存(HBF)混合架构如何驯服长上下文推理的内存墙
- 本站:HotChip/FMS 内存墙(二):HBF、OCP HBF Spec 与 HBF-Compass,长上下文推理的容量层怎么设计
- 本站:KV Cache Offloading 完全拆解:把显存装不下的历史塞进 CPU、SSD 与远端内存
- 本站:PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率
- 本站:NSA 原生稀疏注意力(一):压缩-选择-滑窗三分支架构
- Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention(arXiv:2502.11089)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(arXiv:2309.06180)
- H3: Hybrid Architecture Using High Bandwidth Memory and High Bandwidth Flash for Cost-Efficient LLM Inference(IEEE Computer Architecture Letters,DOI:10.1109/LCA.2026.3660969)
- SK Hynix, Sandisk Unveil First Standard for High-Bandwidth Flash(SDxCentral,2026-08-04,OCP 首版 HBF 标准)
- SK hynix, Samsung, and SanDisk Bet on HBF — The Next Battleground in Memory Sector(TrendForce,2025-11-11,含 SanDisk–SK hynix MoU 与时间表)
- SK hynix Unveils AI Chip Architecture with HBF, Reportedly Boosts Performance per Watt by Up to 2.69×(TrendForce,2026-02-12)
- 下一个 HBM:HBF,能行吗?(半导体行业观察,HBF 论文中文解读与工程视角)
- SK 海力士探索 H3 混合存储:发挥 HBM 与 HBF 各自优势,优化 AI 推理负载能效(C114)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



