


单图秒级出三维:LRM、LGM、TripoSR 与 GS-LRM 重建模型的架构与推理账
从”优化很久”到”一次前向”
生成或重建一个物体的三维模型,长期有两种做法。第一种是逐形状优化(per-shape optimization):用多视角图像或可微渲染的分数蒸馏,对某个形状的 NeRF、网格或高斯参数做几百到几千步梯度下降,代表是各种基于分数蒸馏采样(Score Distillation Sampling, SDS)的文本生成三维方法。这类方法质量可以很高,但每来一个新物体都要重新优化一遍,耗时以分钟到小时计,而且无法把”形状长什么样”的先验积累下来——两个外形相似的杯子,也要各自从头跑一遍。
第二种是前馈重建(feed-forward reconstruction):拿一个在网络里训练好的编码器-解码器,输入图像,一次前向就输出三维表示。早期的前馈方法多是在 ShapeNet 这样按类别组织的小数据集上训练,换个类别、换种拍摄条件就明显退化。
本文讨论的大型重建模型(Large Reconstruction Model, LRM)由 Adobe Research 与澳大利亚国立大学等团队提出,论文于 2023 年 11 月公开在 arXiv。它把语言模型那套”大规模 Transformer + 海量数据 + 简单回归目标”的思路搬到三维重建上:一个约 5 亿参数的可微 Transformer,输入一张图,直接回归出这个物体的神经辐射场(Neural Radiance Field, NeRF),在单张 A100 上约 5 秒产出一个网格。随后一年里,围绕”三维表示换什么、骨干网络怎么设计、数据从哪里来”出现了多代改进,本文按 LGM、TripoSR、GS-LRM 的顺序拆解这条技术线的架构与推理开销。
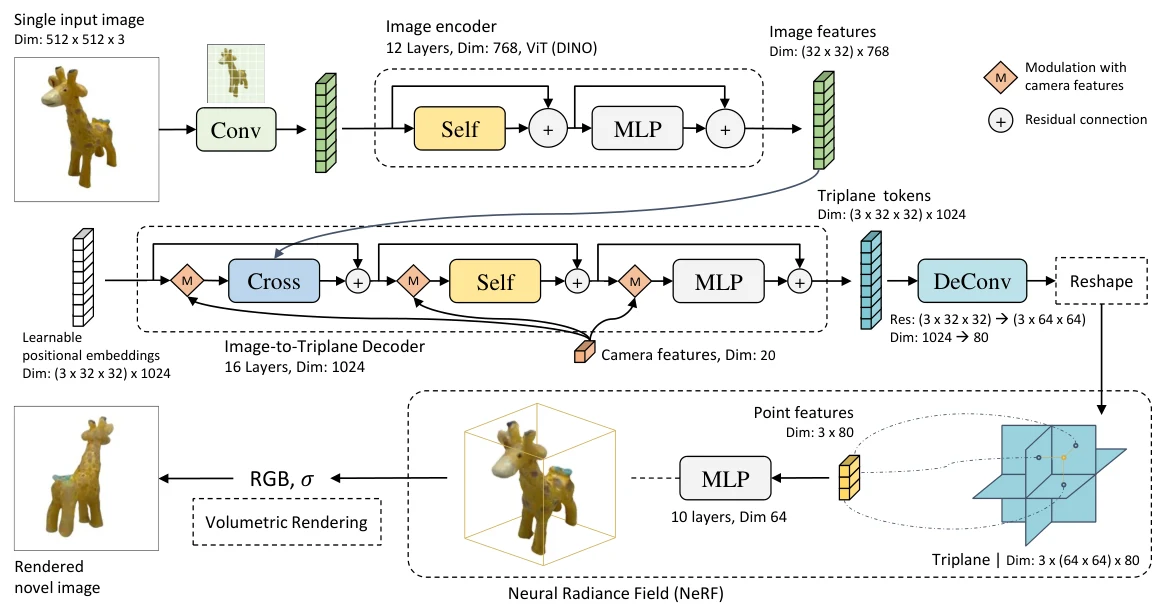
上图是 LRM 的官方架构图(来源:LRM 论文 Figure 1)。左边是输入图像,中间是 12 层的图像编码器,右侧是 16 层的图像到三平面解码器,最终接到一个 10 层、宽度 64 的多层感知机(MLP)与体积渲染器。图的读法集中在两件事上:三维信息以什么形式被网络输出,以及输出的表示如何被渲染回图像来监督。本文后续所有变体,改动的都是这两处中的一处或两处同时改动。
前馈重建难在哪:三个约束
要理解 LRM 的设计,先要把它的前置困境讲清楚。
逐形状优化为什么贵
体渲染的梯度要穿过”对每条射线采样若干点、每点查询网络、沿射线积分”这一长串操作。设一次渲染的射线数为 ,每条射线采样 个点,那么单次形状优化的每一步都要跑 次网络查询,还要保存这些中间结果做反向传播。NeRF 类方法通常要几万到几十万步这样的迭代。这不是算法不好,而是优化目标绑定在单个形状上,网络参数或几何参数不具备跨形状复用性。
对推理服务而言,这个结构的问题更直接:延迟与”物体个数”成正比,而不是与”请求批次”成正比;每个请求都要独占一段长任务,批处理无从谈起。
类别先验为什么迁移不了
ShapeNet 时代的前馈网络按类别训练,网络学到的是”椅子通常有靠背和四条腿”之类与类别绑定的结构。换到 Objaverse 这类包含上百万个不同类别物体的数据集上,早期网络容量不够,编码器给出的图像特征也太偏语义(ImageNet 预训练 ResNet、CLIP 这类特征更适合分类而不是几何),细节结构传递不下去。
LRM 论文对此的判断很直接:把这类方法推广到开放类别,需要 (1) 更强的网络容量,(2) 更大规模的三维数据,(3) 让模型学习跨形状的通用先验。这三点恰好对应它的三个设计决策:Transformer 骨干、约 100 万物体的训练数据、从 DINO 特征出发的图像到三平面投影。
表示本身也是瓶颈
第三条困境来自三维表示。逐形状优化的 NeRF 是隐式的,参数就在网络里;前馈方法要求网络直接输出一个有几何形状的表示,输出格式的选择决定了:输出的 token 数量、体渲染的查询次数、能否走渲染器、能不能提取网格。这一点是 LRM 之后那批变体最主要的差异来源,后文会反复回到它。
先把相机放进网络:位姿、射线与归一化
单图重建有一个容易被忽略的输入问题:相机位姿是未知的。训练集里的多视图渲染有精确位姿,但用户上传的照片没有;如果让网络直接处理任意位姿,它必须同时学会”这张图是从哪个角度拍的”与”这个角度下物体的三维形状”,两个未知量纠缠在一起,学习难度陡增。
LRM 的处理是相机归一化:训练时把所有样本的物体归一化到 的立方体内,相机放在球面上采样(半径 1.5–3.0,高度有范围限制),然后把所有相机的朝向归一到同一方向。推理时假设输入图也是从规范方向拍摄的方形图、背景已去除。这样网络学到的就是一个固定的”图像到三平面”映射,跨形状先验更容易被利用。
这个设计不是工程细节,而是影响泛化的关键。论文 Appendix 的相机位姿消融给出了三组对比:完全不做归一化(None)时 unseen 评测 PSNR 为 15.3;只做随机旋转增强(Random)提升到 18.0;归一化全部位姿(Normalized)达到 19.0。差距不是一点,而是”能不能用”的量级。归一化把问题从”学习任意位姿下的投影”降级为”学习规范位姿下的形状先验”,后者才是前馈网络擅长的。
多视图模型(LGM、GS-LRM)不需要这个假设,因为输入自带位姿。它们把位姿编码成逐像素的 Plücker 射线特征:对像素 ,由相机内参和外参得到射线方向 与原点 ,写成 6 维向量
其中 是射线的矩(moment),与方向一起唯一确定三维空间中的一条射线。与”把 相机矩阵作为全局向量拼接”相比,逐像素射线特征保留了”哪个像素对应哪条射线”的空间对齐关系,卷积或 patchify 后每个 token 都带着自己的几何位置信息。这也是为什么 LGM 把它和图像特征一起送进 U-Net、GS-LRM 把它和图像 patch 拼成 token。
对部署的启示很直接:输入预处理是模型契约的一部分。去背景、方形裁切、物体居中、规范尺度,这些步骤在训练时被固定下来,推理时如果跳过,规范相机假设就被破坏,重建质量会以难以调试的方式下降。
TripoSR 在这条思路上走得更远:它干脆不把相机参数作为条件输入,而是让模型在训练与推理中自己”猜”相机的内外参。论文给出的理由是,真实拍摄的图片很少带有准确的相机参数,显式依赖相机条件会让模型对”野外”输入很脆弱;去掉这个条件后,图像到三平面的投影完全由图像特征驱动,模型对拍摄条件更宽容。代价是牺牲了一部分”精确投影”的能力——在遮挡严重或透视畸变强的情况下,猜出来的相机与真实差异大,重建会走样。这是一个典型的鲁棒性与精度之间的权衡,也解释了为什么 TripoSR 在真实照片上表现稳定。
LRM:三平面 NeRF 作为回归目标
为什么选三平面
三平面表示(Triplane,来自 EG3D 等工作)把三维空间压缩到三张二维特征图上:坐标 对应的特征,由三张平面在对应位置的特征拼起来得到。
设每个平面是 分辨率、 通道,则三张平面的总参数为 ,而同等分辨率的体素需要 。分辨率 32 时, 个格子,体素则要 个。对”网络要一次吐出所有特征”的前馈路线,这个压缩比非常关键——它决定了输出 token 的规模与显存。
同时三平面保留了三向分解的结构:解码器在水平方向上可以借用图像特征中关于平面轮廓的信息,竖直方向则承担高度,网络在训练中会自然学到”把物体的侧面轮廓放到 、 平面,俯视图放到 平面”。
LRM 的三平面参数是:分辨率 、共 3 张、每张 80 通道()。
图像编码器
编码器用预训练的 DINO ViT-B/16,输入 图像,切成 的 patch,得到 个 patch token 加 1 个 [CLS] token,共 个 token,维度 。
为什么选 DINO 而不是 CLIP 或 ImageNet ResNet?论文给出的理由是:DINO 用自蒸馏训练,其注意力更聚焦于图像中显著物体的结构与纹理,而不是语义类别;对重建任务,几何结构比类别语义更重要。CLIP 的对齐目标是图文匹配,会把”这是一个杯子”这一语义信息放大,反而丢掉杯把的具体形状。
图像到三平面解码器:相机特征调制与交叉注意力
解码器是一个 16 层、隐维 1024 的 Transformer。它的输入不是文字 token,而是三平面上的网格 token:3 张平面各切成 个格子,每格对应一个可学习的 token,共 个 token。每层做三件事:
- 相机特征调制:输入图像的相机位姿被编码成特征 ,作为每条射线的全局条件。由于重建时的目标相机被归一化为固定朝向(训练时把所有样本的位姿归一到同一方向),网络实际上学的是”给定一张从标准方向拍的图,三平面长什么样”。论文附录的消融表明,不做位姿归一化(None)效果最差,只做随机旋转增强(Random)次之,归一化全部位姿最好——因为归一化后网络可以把”图像到三平面的投影”当成一个固定的空间映射来学,跨形状先验更容易被利用。
- 交叉注意力:三平面 token 作为 query,向 个图像 token 做 multi-head cross-attention。这一步等价于”每个三平面格子,从图像里找它应该对应的那块特征”。这与多视图重建里”把像素投影到三维”不同:投影是几何确定的,交叉注意力是学习出来的对应关系,允许网络在遮挡、透视变形等情况下做插值。
- 自注意力:三平面 token 之间做 self-attention,建模空间结构的关系。
输出被 reshape 成 个 维向量,再通过 MLP 上采样(LRM 用 与 反卷积两种可选,最终选了上采样到 ,每平面 80 通道)。
三平面 NeRF 与渲染监督
给定空间中任意点 ,从三张平面查特征拼接,送进 MLP(10 层、宽度 64),输出该点的颜色与体密度:
再按 NeRF 标准公式沿射线做体积渲染:
是射线 的预测颜色, 是从相机到 处的透射率, 是近远裁剪面。
训练目标是渲染出的新视角与真值图像的差异。每个训练样本用 个视角:输入视角加 3 个随机侧视角,训练时采样 128 个点/射线、渲染 的图像做监督:
是第 个视角的渲染结果, 是 GT 视角, 为逐像素 L2, 为感知相似度,论文设 。
这里有一个值得注意的推理侧含义:训练时只需要渲染 、每条射线 128 采样的图像来监督,重建质量并不依赖于体渲染端做得多精细。LRM 的训练规模是 128 张 40 GB A100、batch 1024、30 个 epoch、约 3 天;训练时每个样本随机取 4 个视角做监督,而推理时只输入 1 张图。这也说明它”推理时只需要一次前向”的前提——渲染只是给网络提供梯度信号的途径,网络本身学到的三平面才是产物。
五秒钟的账
论文给出单张 A100 上单图重建的耗时:图像到三平面前向约 1.14 秒,从三平面 NeRF 查询 个点约 1.14 秒,Marching Cubes 提网格约 1.91 秒,合计不到 5 秒。这个分解本身就说明了这条路线推理侧的主要开销去向:不是 Transformer,而是把三平面”翻译成几何”。1.14 秒的查询相当于对 个点各跑一次 10 层 MLP,1.91 秒的 Marching Cubes 是在 CPU/GPU 上构建等值面。对服务部署而言,这意味着显存峰值与吞吐由查询和网格化决定,网络前向的 batch 化收益有限。
Instant3D 与 LGM:把回归目标换成高斯
Instant3D 提出的两段式
Instant3D(2023 年 11 月)把 LRM 用进了”文生三维”流水线:先用多视图扩散模型生成 4 张固定视角(同一仰角、0°、90°、180°、270° 四个方位角)的图,再用一个 LRM 式的稀疏视图重建器从这 4 张图回归三平面 NeRF。论文报告从文本到三维资产约 20 秒,比逐形状优化的方法快两个数量级。它的贡献主要是流程组织,以及证明 LRM 架构可以从 4 视图输入工作;输出仍是三平面 NeRF,因此也继承了三平面分辨率的上限与体渲染的成本。
LGM 的第一个改动:输出高斯而不是 NeRF
LGM 全称 Large Multi-View Gaussian Model,2024 年 2 月由北京大学等团队提出。它的出发点是把 LRM 的输出表示从”三平面 + NeRF”换成”逐像素的高斯参数”。
理由是三维高斯泼溅(3D Gaussian Splatting, 3DGS)的渲染是光栅化(3DGS 由 Inria 的 Kerbl、Kopanas 等人在 2023 年 7 月发表于 SIGGRAPH 2023):每个高斯投影到图像平面得到一个椭圆,按深度排序后逐像素混合,成本与图像分辨率和高斯个数成正比,且不需要沿射线采样查询网络。对推理服务来说,光栅化的耗时与批次、分辨率的关系是可控的;而 NeRF 体渲染的耗时与”查询点数”成正比,分辨率一提高,查询点就以立方增长。
但前馈网络不能输出”任意个数、任意位置”的高斯,必须把输出绑定到可计算的张量布局上。LGM 的做法是每个输出像素对应一个高斯:网络输出 4 张特征图(每个输入视角一张),每张图的每个像素是一个高斯,通道数为 14(位置 3、缩放 3、旋转四元数 4、不透明度 1、颜色 3):
位置相对相机坐标预测,并截断到 的立方体内;颜色在 LGM 中直接用 RGB,而不是 3DGS 原版里的球谐系数。
LGM 的默认配置是:输入 4 张 的视图,U-Net 的输出特征图为 ,每个输出像素对应一个高斯,因此 4 个视角合计 个高斯。训练时可以把输入分辨率提到 ,但输出仍限制在 ——这正是”非对称”的含义:输入分辨率决定纹理与结构细节的丰富程度,输出分辨率决定高斯个数,两者解耦。
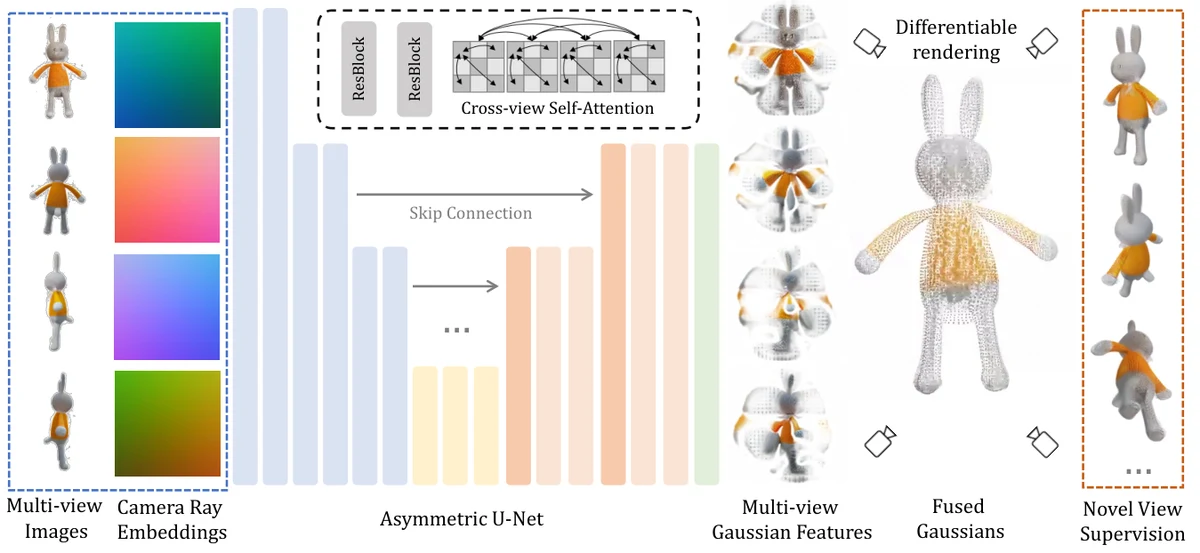
上图是 LGM 的官方方法图(来源:LGM 论文 Figure 3)。读法:左侧”Multi-view Images”与”Camera Ray Embeddings”一起进入 U-Net;中间黄色块是跨视图自注意力;右侧输出 4 张”Gaussian Features”图,经 “Multi-view Fused Gaussians” 融合后由”Differentiable Rendering”渲染出”Novel View”,与”Supervision”比较。右侧的”Skip Connection”是 U-Net 的常见做法,让浅层的高分辨特征直接并入上层。
为什么是”逐像素高斯”
这个设计有三层好处。
第一,输出规模与图像分辨率挂钩而不是与体积分辨率挂钩。三平面的格子数与体渲染的查询点数是三维分辨率的立方关系;高斯个数随输出图像分辨率平方增长,每个高斯又是常数长度的参数向量。分辨率翻倍时,高斯数变 4 倍,而三平面体素查询会变 8 倍。
第二,监督信号直接落在渲染图像上,和高斯渲染器一致。训练与部署用同一个渲染器,渲染器本身的差异(例如不同实现的高斯投影与排序策略)不会引入”训练有效、部署不一致”的问题。
第三,高斯是可编辑、可导出的显式表示。高斯可以被筛选、压缩、重排,也可以转为网格或作为游戏引擎资产生成的一部分,这是隐式 NeRF 做不到的。
非对称 U-Net 与跨视图自注意力
LGM 的骨干是 U-Net 而不是 Transformer。原因是高分辨率下的 token 数: 个像素若全部进 transformer 自注意力,复杂度是 ,显存上不可行。U-Net 通过下采样把空间维度减少,只在最后 3 个下采样块、中间块、前 3 个上采样块插入自注意力,其余用残差卷积,这是 diffusion U-Net 的通用做法(例如 Stable Diffusion 的 U-Net 也只在较低分辨率处加注意力)。
通道数排布为 (6 个下采样块)、(中间块)与 (5 个上采样块),每个块由残差层和可选的降采样/上采样组成。输出的特征图经一个 卷积降到 14 通道。
所谓”跨视图自注意力”:把 4 个视角的特征图展平后拼接成一条序列再做自注意力,与多视图扩散模型里”4 视图一起做注意力”的做法相同。这样每个视角在高斯参数上都能看到其他视角的信息,缓解单视图遮挡造成的空洞或不一致。
“非对称”指的是 U-Net 的输出分辨率小于输入分辨率:输入 ,输出 ,即每四个输入像素产出一个高斯。这既压住了高斯个数(4 视角合计 65,536 个),又允许输入图用更高分辨率承载更多纹理细节——论文报告训练分辨率可以提到 512 而输出高斯特征图仍保持 。论文还明确丢弃了显式射线投影所需的深度预测——早期方法(如 Splatter Image)需要在单视图上做射线级投影,深度预测引入另一组误差;LGM 不做这一步,把所有”像素到高斯”的映射交给网络学。
14 个通道的激活:为什么不能照抄 3DGS
标准 3DGS 的优化器会约束高斯参数的范围:位置限制在场景包围盒内,缩放限制在很小的量级,不透明度经 sigmoid 落在 。这些约束是为逐场景优化设计的——优化器从几十万个初始高斯出发,逐步调整。前馈网络直接回归参数时,同样的约束就变成了”初始化问题”。
LGM 的解决办法是把 3DGS 的约束搬到激活函数上:位置被 clamp 到 ,缩放经 softplus 后乘以 0.1,使训练初期所有高斯都挤在场景中心附近、尺寸很小。这样网络在训练开始时渲染出的是一个”模糊的中心团块”,梯度会逐步把这些高斯推开到正确的形状上;如果一开始就允许高斯散布到整个空间、尺寸任意大,早期渲染的遮挡关系混乱,梯度信号会很差。
这是前馈预测与逐场景优化的一个关键差异:优化可以靠多步迭代自己找到合理范围,前馈只有一次机会,所以必须在结构上(激活函数、归一化)把参数约束到合理的初始分布里。TripoSR 在三平面 NeRF 上的密度偏置 是同一个思路:让训练初期的密度接近 0,避免渲染结果一开始就全白或全黑。
两段式推理与 5 秒的算法
LGM 的推理流程分两段:
- 用现成的多视图扩散模型生成 4 张正交方位角(0°、90°、180°、270°)、固定仰角 0° 的视图——文本输入用 MVDream,图像输入用 ImageDream。DDIM 采样 30 步,引导系数分别为 7.5 与 5。
- 4 张视图 + 相机射线嵌入送入 U-Net,一次前向得到高斯。
论文报告整个流水线(含两个多视图扩散模型)推理显存约 10 GB,总耗时约 5 秒。这个数字比 LRM 的 5 秒更进一步,因为它把”多视图生成”也算进了流水线,而 LRM 的单图重建本来就不需要生成步骤。
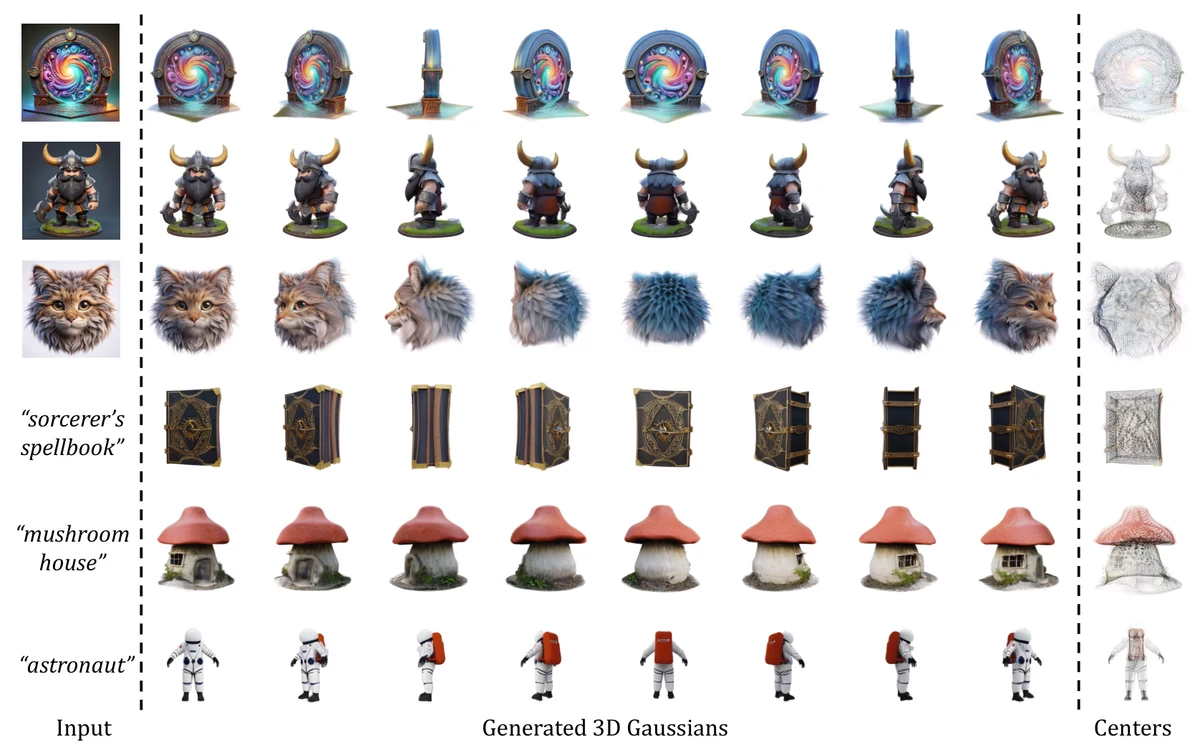
上图是 LGM 的 teaser 结果示例。可以看到,同一套网络同时支持文本(“sorcerer’s spellbook”、“mushroom house”)与图像输入,输出的高斯体在材质和细节上比基于 NeRF 的前馈方法更丰富。原因不只是骨干更强,而是表示本身:高斯可以直接承载颜色、不透明度与尺度,细节的”表达力”是显式的,不需要经过体渲染查询再折损一次。
训练数据与鲁棒性:grid distortion
LGM 的训练数据是从 Objaverse 筛选后约 8 万个模型、每个模型渲染 100 个视角()得到的多视图图像,但推理时输入的多视图是扩散模型生成的。两者存在域差距:生成的 4 视图在边缘、材质、视角一致性上与真实渲染并不相同。论文为此设计了两类训练增强,其中一类是 grid distortion(网格扭曲):对多视图图像施加整幅的网格形变,模拟扩散模型生成结果中常见的几何漂移。
配套的是相机抖动:训练时相机位姿在固定方位角附近加上随机扰动,抖动概率设为 50%。这两个增强的共同思路是”让重建网络对输入的不完美更宽容”,因为它的上游是一个生成模型,而不是精确的多视图拍摄。
这个设计对推理服务的启示很实际:在多段式流水线中,重建段的鲁棒性设计取决于上游输出的误差结构。如果直接把生成的多视图当成准确输入,重建网络会把扩散模型的小几何误差当成真实几何来拟合。
高斯到网格为什么慢
LGM 的输出可以直接用于实时渲染,但如果下游要网格资产,需要额外转换。论文附录说明,采用”高斯转 NeRF 再 marching cubes”的方式,优化好的实现约需 1 分钟。
这个时间与 LRM 的 1.91 秒差距很大,值得解释。LRM 的三平面本身就是一张可直接查询的场, 网格采样后 marching cubes 一次完成。LGM 的高斯是离散、无序、局部的:把高斯转成稠密场要先做泼溅(splat)到体素或三平面,再补洞、再提取等值面,而高斯本身没有”全局可查询的隐式场”。换句话说,LGM 在”渲染图像”上更便宜,但在”导出网格”上更贵。这是一个典型的表示选择带来的下游成本转移。
TripoSR:把 LRM 工程化
改了什么
TripoSR 是 2024 年 3 月由 Tripo AI 与 Stability AI 联合发布的技术报告(arXiv 编号 2403.02151),基于 LRM 架构,目标是”把 LRM 做成能开源、能在本地跑、速度再快一个数量级”的工程化版本。它在单张 A100 上产出网格不到 0.5 秒,论文开放 MIT 许可、权重、代码与在线 demo。
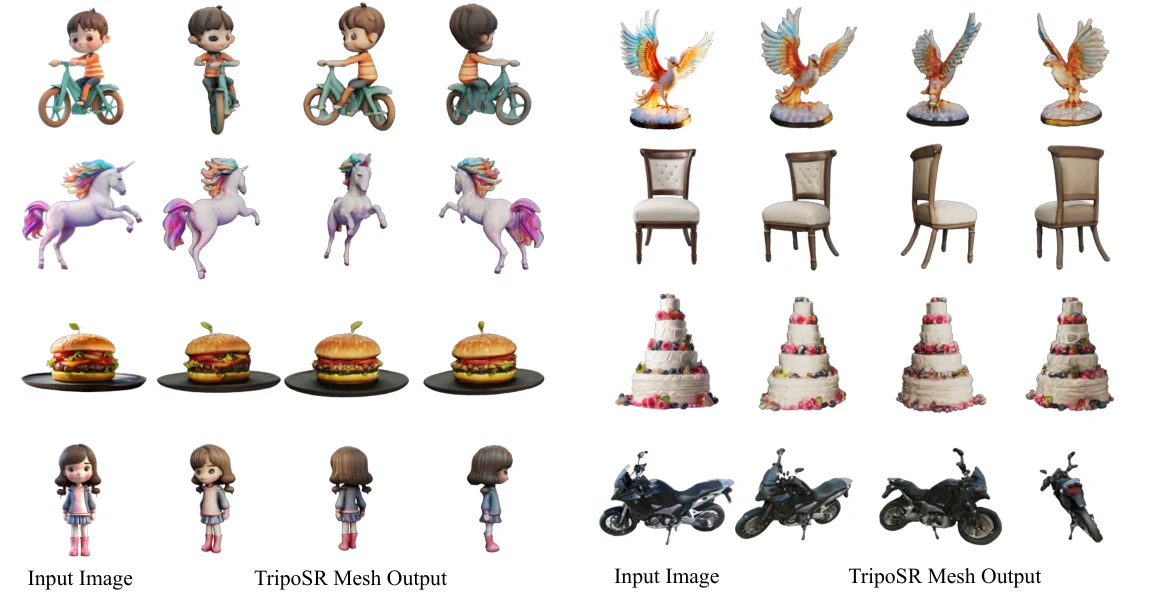
上图是 TripoSR 的输入与网格输出对比。左侧输入是拍摄的照片,右侧是提取出的网格。可以注意它对面部、毛发这类细薄结构的塑造——TripoSR 保留了 LRM 的三平面 NeRF,但在数据、训练与渲染的配置上做了大量调整,使模型对真实拍摄的照片更稳定。
三平面通道优化:显存与质量的中点
TripoSR 的配置相比 LRM 有明确的改变(论文 Table 1):
| 项目 | LRM | TripoSR |
|---|---|---|
| 图像编码器 | DINO ViT-B/16 | DINOv1 ViT-B/16 |
| 编码器层数 / 通道 | 12 / 768 | 12 / 768 |
| 三平面 token 网格 | ||
| 三平面最终分辨率 / 通道 | / 80 | / 40 |
| 骨干层数 / 通道 | 16 / 1024 | 16 / 1024 |
| MLP | 10 层,宽度 64 | 10 层,宽度 64 |
| 每射线采样 | 128 | 128 |
| 渲染分辨率 | ||
| LPIPS 权重 | 2.0 | 2.0 |
三平面通道从 80 降到 40、上采样前只有 16,是 TripoSR 的”Triplane Channel Optimization”。论文的解释是:三平面通道直接决定体渲染每点的输入维度与显存,通道多意味着容量大但显存紧;由于体渲染计算量大,通道数同时影响训练和推理的显存占用。论文通过实验取了 40 通道作为”质量-显存”的中点——分辨率已经在 ,空间细节由分辨率承担,通道则压缩到够用为止。
这个取舍在推理侧的意义:三平面通道与分辨率是两个独立的成本旋钮。通道决定每次 MLP 查询的输入维度与计算量,分辨率决定特征张量的内存占用与提取网格时的细节上限。两者在总成本中互相制约,某一项加大就必须从另一项找回来。
渲染器与数据打磨
TripoSR 的其它改进集中在渲染器与数据处理:
- 渲染器参数:射线半径设为 0.87(对应归一化到 单位球内物体),密度激活用 exp 并加 -1.0 偏置,让初始密度接近 0,避免早期渲染全白或全黑导致梯度消失。
- 数据筛选:论文指出 Objaverse 里大量模型质量差(残缺扫描、缺材质、水印文字等),因此按经验规则过滤。对开放类别重建,数据质量比数据量更关键,因为低质量形状会把网络往”平均形状”上拉。
- 训练配置:学习率 、AdamW、2000 步 warm-up、余弦退火,,另有 mask 损失权重 0.05,用输入图像的 alpha 通道约束重建形状与真实物体轮廓一致。
mask 损失值得单独讲。单纯用新视角渲染的 MSE/LPIPS,网络可以在”某个新视角恰好看起来对”的方向上走样;加入 mask 项(让重建物体的渲染轮廓与输入图轮廓一致)能给几何一个更直接的边界约束,减少悬浮碎片。这类监督设计在推理侧的体现是:召回率与精度之间的偏置由训练目标决定,服务要选择偏保守(少碎片)还是偏完整(多细节)时,可以从训练损失找根源。
0.5 秒怎么来的
TripoSR 的 0.5 秒包含图像编码、三平面解码与网格提取。相比 LRM 的 5 秒,快了一个数量级。从两者可比的部分来看,差别集中在三处:
- 网格提取的规模。LRM 在 的稠密网格上查询三平面并执行 marching cubes,约 个点各跑一次 10 层 MLP;TripoSR 的三平面在 分辨率下每平面只有 40 通道,并以更紧凑的实现完成等值面提取,查询与网格化时间因此显著缩短。
- 三平面通道数下降。每平面 80 通道降到 40 通道,体渲染查询时每次 MLP 读取的输入减半,查询阶段的计算量随之降低。
- 工程实现。TripoSR 把 DINO 编码、三平面解码、NeRF 查询与 marching cubes 串成一条紧凑的实现路径,并在开源时同步提供了可复现的推理脚本。
需要说明的是,TripoSR 的 0.5 秒是”从单图到网格”的端到端时间口径,具体数值依赖于输入预处理(去背景、方形裁切)是否计入。论文的对比表中,TripoSR 的几何精度(Chamfer Distance、F-score)也优于 One-2-3-45、ZeroShape、TGS(TriplaneGaussian)与 OpenLRM,说明它不是单纯牺牲质量换速度。
GS-LRM:直接从图像回归高斯
与 LRM 的区别
GS-LRM 是 2024 年 4 月由 Cornell 等团队提出的变体。它同时改了两件事:回归目标改成高斯,骨干改成纯 Transformer。
先说表示:前馈回归 3DGS 参数,渲染是光栅化而非体渲染,好处与前文 LGM 相同——细节表达强、渲染快、可导出。与 LGM 不同的是,GS-LRM 不依赖多视图扩散模型作为上游,而是直接从 2–4 张带位姿的稀疏图像一次前向输出高斯,单张 A100 约 0.23 秒。这让它成为”多视图重建”模型,适用于 3D 扫描、少量照片重建、场景级重建等场景。
再说骨干:它不再用 U-Net,而是把每张输入图 patchify 成 token,所有视图的 token 拼接成一条序列,过一串标准 Transformer block,最后从每个 token 直接解码逐像素高斯参数。论文明确写了:
“patchify input posed images, pass the concatenated multi-view image tokens through a sequence of transformer blocks, and decode final per-pixel Gaussian parameters directly from these tokens for differentiable rendering.”
从 token 到高斯是逐 token 的线性/MLP 映射,不需要特殊设计。这样就把”多视图融合”交给了标准自注意力,与前文 LGM 的”U-Net + 跨视图自注意力”形成对照。
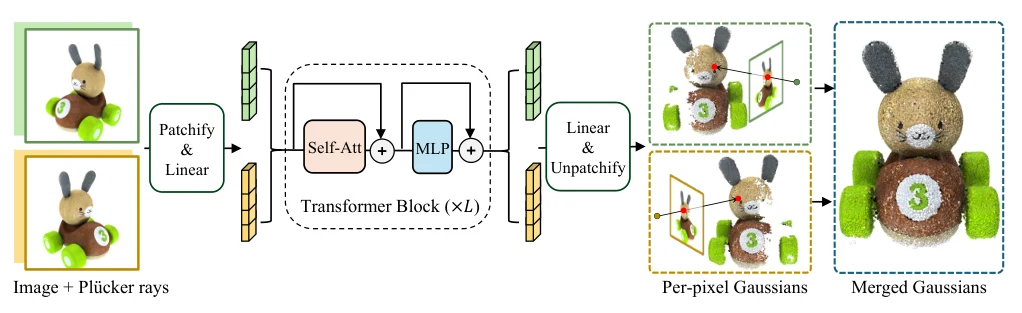
上图是 GS-LRM 的官方流水线图(来源:GS-LRM 论文方法示意图)。读法从左到右:每张输入图与其 Plücker 射线编码一起 patchify 成 token,经线性层投影后拼接成一条长序列;中间的 Transformer block 自注意力负责跨视图的信息交换;最后 unpatchify 回逐像素布局,由每个像素解出一个高斯,并把各视图的高斯合并。与 LGM 的 U-Net 不同,这里没有任何空间下采样,分辨率由 token 数直接决定——这也是它输入视图必须少(2–4 张)的原因。
Plücker 射线编码值得单独说明。相机射线在 Plücker 坐标下由原点叉乘方向 表示,是一个 6 维向量,它把射线的三维几何完整编码成与相机位置无关的形式(LGM 与 GS-LRM 的相机射线嵌入都用这个表示)。GS-LRM 直接把 RGB 与逐像素 Plücker 坐标在通道维拼接,得到 9 通道的逐视图特征图再 patchify;由于 Plücker 坐标随像素与视图变化,它天然充当空间与视图嵌入,论文因此没有额外加位置编码或视图编码。这是一个很省的设计:位姿不是外挂的条件,而是和像素内容融在同一张特征图里,卷积/patchify 会自然学到”从哪里看这条射线”。
为什么 Transformer 可行了
LGM 选用 U-Net,是因为高分辨率 token 的自注意力复杂度是平方级。GS-LRM 能用 Transformer,靠的是几点:
- 输入视图少(2–4 张),分辨率按预训练 、微调 计,token 数在 级别,远没到不可行的量级;
- 训练用 xFormers 的 memory-efficient attention、梯度检查点与 BF16 混合精度,把显存压下来;
- 体渲染被替换成 GS 光栅化,配合 deferred backpropagation 控制渲染阶段的显存。
这个演进说明了同一时期推理系统的共性问题:注意力的成本是可工程化解的,但表示的成本是结构性的。三平面 NeRF 的分辨率限制与体渲染查询成本,不是优化注意力就能绕开的,这也是后续变体纷纷换成高斯的原因。
0.23 秒与场景级扩展
0.23 秒比 LRM 的 5 秒和 LGM 的 5 秒都快,其中一个原因是它省掉了网格提取。GS 是直接可渲染的表示,服务端只要把高斯参数返回,渲染就交给客户端的 GS 光栅化器;只有需要网格时才做转换,而转换是可选的后处理。
场景级方面,GS-LRM 在 RealEstate10k 这类场景数据上做了重建,论文对比结果里与 pixelSplat 等方法的 PSNR/SSIM/LPIPS 有可比性;同时它在物体级(GSO、ABO)上对比 Triplane-LRM、LGM 等。需注意论文自己也指出:物体级与场景级的评测口径不同(物体在归一化坐标中,场景位姿是真实相机参数),跨口径的数值不能直接相减比较。
局限
这类方法共同的局限包括:
- 输入视角数量:2–4 张在覆盖面上是稀疏的,被遮挡区域需要网络用先验补全,补全部分与真实几何可能不一致;
- 非朗伯材质:GS 为每个高斯建模一个带各向异性的椭球、颜色与不透明度,对镜面反射、透明材质、薄结构(如睫毛、玻璃杯壁)建模能力有限;
- 尺度与远距离:物体级重建在归一化坐标中工作,扩到场景级时高斯尺度分布跨度变大,训练与显存都需要调整;
- 网格转换:正如 LGM 的 1 分钟,GS 到网格的转换是下游成本,且转换质量依赖补洞与等值面提取的实现。
还有一条更隐蔽的限制:高斯的”逐像素”布局有视图偏置。由于高斯是每个输出视角每像素一个,某个区域若只被一个视角看到,就会出现”一个视角贡献的高斯数量远多于其他视角”的情况,导致高斯分布不均匀、在新视角下出现拉伸或重复。稀疏视图的几何歧义只能靠网络先验补全这部分,这也是多视图扩散模型为什么要生成”正交四视图”——用尽量均匀的方位覆盖减少盲区。
训练这一层:渲染即监督,数据即先验
为什么不直接回归三维坐标
一个自然的想法是直接用三维监督:让网络输出点云或网格顶点,和真值做 Chamfer 距离。难点在于三维资产没有统一的”参数布局”。Objaverse 里的模型来自不同作者、不同工具,拓扑结构五花八门,顶点数和连接关系都不一致;同一个物体旋转 90° 后,顶点顺序完全不同。要直接做逐顶点回归,必须先把所有资产重拓扑或体素化成统一格式,这个过程既贵又有损。
渲染监督绕开了这个问题:网络输出的是一个可以渲染的表示(NeRF 场或高斯集合),监督信号是”从这个表示渲染出的图像与真值图像的差异”。它只要求表示可微渲染,不要求三维资产有统一拓扑;同一个损失可以用于三平面 NeRF、高斯、甚至网格。这是 LRM 能直接在 Objaverse 原始资产上训练的前提。
数据与训练配置
LRM 的训练数据由两部分组成:Objaverse 的合成多视图渲染与 MVImgNet 的真实视频帧,合计约 100 万个物体。每个 Objaverse 资产被归一化到 ,从半径 1.5–3.0 的球面上随机采 32 个视角、以 渲染。每个训练样本取 4 个视角(1 个输入视角 + 3 个随机侧视角)做监督,但渲染监督图只有 ,这是显存与吞吐的折中。论文附录的视角数消融显示,每个形状可用的训练视角从 4 增加到 16 时,unseen PSNR 从 18.8 升到 19.1,再往上(32+)不再提升——视角数量带来的收益在 16 左右饱和,这也说明数据规模的关键不是单形状视角数,而是形状总数。
LGM 的数据配置更能说明”质量优先”:它从 Objaverse 过滤出约 8 万个模型,每个渲染 100 个 视角。过滤规则是经验性的——检查 Cap3D 生成的描述与渲染图,剔除残缺扫描、缺纹理、整体发白的模型。用作者的话说,低质量资产会把网络往”平均形状”上拉,规模再大也补不回来。
TripoSR 也做了类似的数据筛选,并在训练目标里加了 mask 损失:输入图的 alpha 通道给出物体轮廓,重建物体的渲染轮廓要与之一致,权重 0.05。这个额外约束让几何边界更干净,减少悬浮碎片。
损失与显存技巧
渲染损失的具体形式是 MSE 加 LPIPS:MSE 管像素级颜色,LPIPS 管感知相似度,后者对纹理和边缘更敏感,能避免”平均颜色正确但细节糊掉”。LRM 取 ,TripoSR 沿用同样权重。
体渲染的反向传播非常吃显存:每条射线 128 个采样点,每个点都要保存 MLP 的中间激活。LRM 采用了 ARF 提出的 deferred back-propagation:前向时只保存采样点的最终颜色与密度,反向时按需重算中间激活,用计算换显存。GS-LRM 在渲染高斯时也用同样的技巧,并叠加 BF16 混合精度、梯度检查点与 xFormers 的省显存注意力。这些技巧不影响推理,但决定了”能不能在 40 GB 卡上训起来”。
评测口径
这套模型的评测分两层。渲染层用 unseen 视角的 PSNR、SSIM、LPIPS,以及 CLIP 相似度;几何层把输出转成网格后用 Chamfer Distance(CD)与 F-score 衡量。两层指标并不总是一致:渲染 PSNR 高的模型,网格可能因为密度场阈值选择而在薄结构处断裂;CD 低的模型,纹理可能糊。服务选型时要按下游用途选指标——要渲染图就重 PSNR/LPIPS,要网格资产就重 CD/F-score。
这条技术线的推理账
把 LRM、LGM、TripoSR、GS-LRM 的推理成本放在一起看,可以得到几条对部署有直接意义的结论。
| 模型 | 输出表示 | 输入 | 骨干 | 耗时口径(单 A100) |
|---|---|---|---|---|
| LRM | 三平面 NeRF | 1 张图 | Transformer 解码器 | 约 5 s(含 查询与网格) |
| LGM | 逐像素高斯 | 4 张多视图 | 非对称 U-Net | 约 5 s(含 30 步多视图扩散) |
| TripoSR | 三平面 NeRF | 1 张图 | Transformer 解码器 | 小于 0.5 s(到网格) |
| GS-LRM | 逐像素高斯 | 2–4 张带位姿图 | 纯 Transformer | 约 0.23 s(到高斯,不含网格) |
表示决定成本结构
- 三平面 NeRF:前向快,但”场到网格”是主要成本。查询点数与目标网格分辨率呈立方关系,部署时需要按网格分辨率设显存预算。
- 逐像素高斯:前向快,输出直接可渲染,但高斯个数与输入图分辨率平方相关。部署时按图像分辨率设显存与带宽预算,且需要提供 GS 渲染器或导出路径。
对推理服务来说,这决定了两类不同的资源分配策略:前者需要 CPU/GPU 的网格化阶段与体素查询内存;后者需要客户端的 GS 渲染能力,或额外的网格转换服务。
上游生成阶段常常才是真成本
LGM 的 5 秒里包含 30 步多视图扩散,扩散段是整条链路中不可忽略的一部分。这与扩散模型的推理成本直接相关,跨步缓存、并行采样与低精度量化在扩散推理上的收益可以参考站内 扩散模型从零讲起(八):推理加速工程——跨步缓存、并行采样与 4-bit 量化。
对服务端,这意味着”三维重建请求”的延迟预算要按整条流水线算:多视图扩散 → 重建 → 网格化 → 可选的资产压缩。任何一段的优化都要在整条链上衡量。
缓存与复用:多视图扩散的结果可以复用吗
多视图扩散的输出取决于文本或输入图像,对同一张输入图重复请求会重复采样一遍扩散。工程上可以把多视图结果按输入图的哈希缓存:同一物体的多次重建请求(例如服务端要同时生成高斯与网格两种格式)只跑一次扩散。但要注意缓存的语义边界——LGM 的多视图是固定四方位角的,同一张图在不同批次的采样中扩散结果可能有细微差异,缓存会固定其中一个结果;如果下游对多样性有要求,就不能缓存。
反过来,重建段的批处理应当按视图分辨率对齐:不同请求的输入图经过预处理后统一到同一分辨率,才能并成一个 batch。TripoSR 的开源推理脚本就包含了”去背景、居中、缩放到 512”这一步,它既是模型契约,也是批处理的前提。
部署形态的差异
四代模型在部署形态上的差异比耗时数字更值得关注:
- LRM/TripoSR 的输入是一张图,服务端可以只做图像预处理与一次前向,网格化在服务端完成,返回网格文件。
- GS-LRM 的输入是多张带位姿图,需要客户端提供位姿(典型场景是用户拍的一组照片或已有的扫描数据),返回高斯参数文件。
- LGM 的输入可以是文本或单图,但内部必须先跑一个多视图扩散模型,部署时需要同时维护扩散与重建两套模型权重。
三者的显存需求也不同:LGM 的报告里整条流水线约 10 GB,这是”扩散 + U-Net 重建”加在一起的口径;TripoSR 的权重规模与 LRM 同量级,在单卡上只需要几 GB 就能完成推理;GS-LRM 的输出高斯数最多,显存峰值出现在自注意力与高斯光栅化阶段。
一个可运行的伪代码骨架
把四代模型的共性抽出来,一次推理的结构大致是:
def reconstruct(image, camera=None, mode="mesh"): # 1. 预处理:去背景、居中、缩放到训练分辨率 img = preprocess(image, resolution=512) # 模型契约的一部分
# 2. 视觉编码:DINO/LRM 用 DINO,GS-LRM 直接 patchify + 线性层 tokens = encoder(img) # (N, D)
# 3. 跨模态投影:图像 token -> 三维表示 token # - LRM/TripoSR:相机特征调制 + 交叉注意力,输出三平面网格 token # - GS-LRM:把多视图 token 拼成序列,自注意力,输出逐像素高斯 token rep = decoder(tokens, camera) # triplane or gaussians
# 4. 表示到资产: if mode == "mesh" and isinstance(rep, TriPlaneNeRF): points = query_grid(rep.mlp, res=384) # 立方级查询 mesh = marching_cubes(points["density"]) return mesh if isinstance(rep, Gaussians): return rep.to_ply() # 网格化是可选的这个骨架说明了每一代模型改动的位置:decoder 的输出表示、encoder 的输入形状、以及最后的资产转换。对想要自己部署或改模型的开发者,改动通常只发生在其中一段,而其余三段保持不变。
推理精度与数值
体渲染的数值细节对推理结果的影响比想象中大。TripoSR 把密度激活设为 exp 并加 偏置,渲染射线半径设 0.87——这些不是任意选的常数:物体被归一化到 以中心为原点,0.87 是略小于 1 的截断半径,保证射线在物体外就停止采样,减少无效查询。密度在早期趋近 0,透射率接近 1,渲染颜色由背景色决定,梯度能稳定地流向”哪里该有密度”。如果把密度偏置去掉,训练初期透射率会迅速衰减,梯度在稀疏区域消失。
高斯路线的数值约束在激活函数里:缩放经 softplus 后乘 0.1,不透明度与颜色通道的取值范围也由激活决定。这些常数在模型权重里是”学出来的”,部署时如果自己实现高斯解码,必须照抄训练时的激活函数,否则高斯尺度会整体偏大或偏小,渲染立刻崩掉。
输入视图数量与质量的关系
各篇论文在”最多几张输入”上给出了相近的经验:给定稀疏视图,输入越多、质量越好,但收益递减。LRM 的训练视角消融显示每个形状的可用视角从 4 增加到 16 后 unseen PSNR 从 18.8 升到 19.1,再往上(32+)趋平;GS-LRM 则进一步把工作区间定在 2–4 张,并在附录里专门微调了一个接受 2–4 张 输入的模型。对服务端,这给出了一个实用的选型点:2–4 张是”信息足够且成本可控”的区间,再拍更多照片的边际收益不大,反而增加传输与预处理成本。
同时要注意输入视角的方位覆盖:四张正交视图的覆盖远好于四张都在同一侧的视图。LGM 用多视图扩散模型生成正交四视图,GS-LRM 则对输入的位姿不做同样约束,所以服务端如果从用户照片做重建,应该先按方位角挑选或聚类四张图,而不是随便取四张。
批处理的收益差异
Transformer 与 U-Net 前向都可以做 batch,多视图输入的 token 数固定,batch 化的显存收益明显。但网格提取(Marching Cubes)难以 batch 化,且其耗时与网格分辨率相关,服务端通常串行处理。所以对 LRM/TripoSR 类流水线,吞吐上限由网格化阶段决定,而不是网络前向。
小结
大型重建模型的核心贡献不是某个网络块,而是把”三维重建”重新表述成一个前馈回归问题:一张或几张图 → 一次前向 → 一个有明确内存布局的三维表示。LRM 用三平面 NeRF 证明这条路线可行;LGM 与 GS-LRM 把输出换成三维高斯,解决了隐式表示分辨率与渲染成本的问题;TripoSR 把 LRM 做成可用的开源工程,并在三平面通道、渲染器与数据筛选上做了细致取舍。
对推理侧,本文反复强调的一对关系是:表示选择决定成本结构,上游流水线决定实际延迟。选择三平面就意味着要接受网格化阶段的立方级查询;选择高斯就意味着要接受与分辨率平方相关的高斯个数与网格导出成本。任何一次服务部署的成本预算,都应该先画清楚这两条曲线,再决定网络规模与批处理策略。
三维输出并不是终点。高斯与网格进入渲染、动画、仿真、游戏资产管线后,下游的表示兼容性同样影响整体系统成本;世界模型对场景表示的选择可以参考站内系列文章,例如 世界模型从零讲起(十二):把世界建成一个可以走进去的场景——NeRF、3D Gaussian Splatting 与占用栅格。如果需要了解更完整的三维生成扩散路径,可以阅读 扩散模型从零讲起(十一):三维生成——点云、结构化隐空间与高斯泼溅的扩散路径,它与本文的前馈重建路线形成互补:一个是迭代去噪生成,一个是单次回归重建。
参考资料
- LRM: Large Reconstruction Model for Single Image to 3D
- LGM: Large Multi-View Gaussian Model for High-Resolution 3D Content Creation
- TripoSR: Fast 3D Object Reconstruction from a Single Image
- GS-LRM: Large Reconstruction Model for 3D Gaussian Splatting
- Instant3D: Fast Text-to-3D with Sparse-View Generation and Large Reconstruction Model
- 3D Gaussian Splatting for Real-Time Radiance Field Rendering
- Triplane Meets Gaussian Splatting: Fast and Generalizable Single-View 3D Reconstruction with Transformers
- One-2-3-45: Any Single Image to 3D Mesh in 45 Seconds without Per-Shape Optimization
- TripoSR 开源实现与预训练权重(GitHub)
- MVDream: Multi-view Diffusion for 3D Generation
- DMV3D: Denoising Multi-View Diffusion using 3D Large Reconstruction Model
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



