


分块 KV 压缩的周期性弱点:同一个 token,为何在某个相位就检索不出来
背景与问题定义
长上下文推理最先撞上的是 KV 缓存
Transformer 做自回归推理时,每生成一个 token 都要把之前所有 token 的 Key 和 Value 重新读一遍。KV 缓存把这次重算省掉了,代价却是显存:对于一个 层的模型,每层每 token 的 KV 缓存大小是
其中 是每层的 KV 头数, 是每个头的维度,乘 2 是因为 K 和 V 各存一份。以 128K 上下文为例,缓存总量随上下文长度线性增长,而解码阶段的注意力计算也随长度线性增长。这两条曲线叠加,使得许多系统在 32K 到 128K 区间就已经开始被显存和带宽卡住。
业界对此有两条主要路线:一条是驱逐,即在缓存里挑一部分 token 留下、其余的扔掉,H2O、SnapKV、StreamingLLM 都属于这一类;另一条是压缩,即不丢弃 token,而是把相邻若干个 token 的 KV 汇总成一个更少的缓存条目。站内 PagedAttention 完全拆解 与 KIVI 完全拆解 分别从分页管理和量化两个角度讨论了缓存开销,而本文关注的是一条结构上更激进的路线:分块 KV 压缩(chunked KV-cache compression)。
分块压缩在做什么
分块压缩的设定很简洁:把连续的 个 token 划分为一个窗口,每个窗口汇总为更少的缓存条目;窗口以固定的步长 滑动或平铺(compression stride)。这样,上下文长度从 个 token 变成 个压缩条目,注意力的规模随之下降。
DeepSeek-V4 的压缩稀疏注意力(Compressed Sparse Attention,CSA)就是这条路线在工业级模型上的落地:它把相邻 token 按固定步长聚合,再让查询去稀疏地选择需要重点查看的压缩块。站内 DeepSeek-V4 混合注意力完全拆解 与 DeepSeek-V4.1-Flash 推理侧完全拆解 已经详细分析了这类架构的压缩块划分、索引器与异构 KV 管理。
在压缩生效之前,有一个容易被忽略的前提:压缩发生在查询出现之前。在预填充阶段,模型看到”第 1 到第 1024 个 token”,并不知道后面要问什么,就必须把这些 token 折叠成若干压缩块。每一个压缩条目都是与查询无关(query-agnostic)的,它必须保存那些未来可能被问到、但此刻还不知道是什么的信息。这条限制是所有分块压缩方法共同面对的根本矛盾——压缩者必须替一个尚不存在的查询做取舍。
这一点也是后文”梯度流把门控推向极端选择”的理论分析能够成立的根本原因。
新增的那条坐标:相位
分块压缩除了原有的”绝对位置”之外,还引入了一条新的位置坐标。如果压缩步长是 ,那么每个 token 在窗口内的偏移可以写成
这里的 phase 就是本文标题中的相位(phase),它表示一个 token 相对压缩窗口边界的偏移。相位与绝对位置不同:绝对位置在 64K 处是唯一的,而相位只有 种取值,会在整个上下文中周期性重复。
问题就出在这种周期性上。如果把整段输入平移几个 token,token 的内容、token 之间的相对顺序、token 到查询的距离,全都没有变化;但哪些 token 会被折进同一个压缩块却变了。同一段信息,可能因为落在”块的开头”而被更完整地保留下来,也可能因为落在”块的末尾”而被平均掉。
这篇文章在讨论什么
2026 年 9 月,ByteDance Seed 联合普林斯顿、斯坦福与伯克利的研究者在 arXiv 上发表了 Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression。论文的核心发现可以概括为一句话:在使用分块 KV 压缩的模型里,同一段信息的检索准确率会随着它所在的相位周期性地剧烈变化,作者称之为相位敏感性(phase sensitivity)。在 DeepSeek-V4 系列等大型开放权重模型上,128K 上下文下的检索准确率在不同相位之间最多相差 40 个百分点,而普通的平均分可能掩盖掉这些周期性的弱点。
这个结论之所以值得认真对待,是因为它触及了压缩路线的评价方法论:如果一个模型在”平均准确率”上看起来没有退化,却在某些相位上系统性地失败,那么压测与部署时按平均成绩做出的判断可能是错的。本文沿论文的章节结构展开:先看现象(DeepSeek-V4 的代码补全翻转与受控检索),再看对照实验(从头训练的一族 Qwen3 模型),然后是机理分析(KV 头敲除与门控偏好),最后是理论解释(理想化模型下的最优压缩与梯度流)。
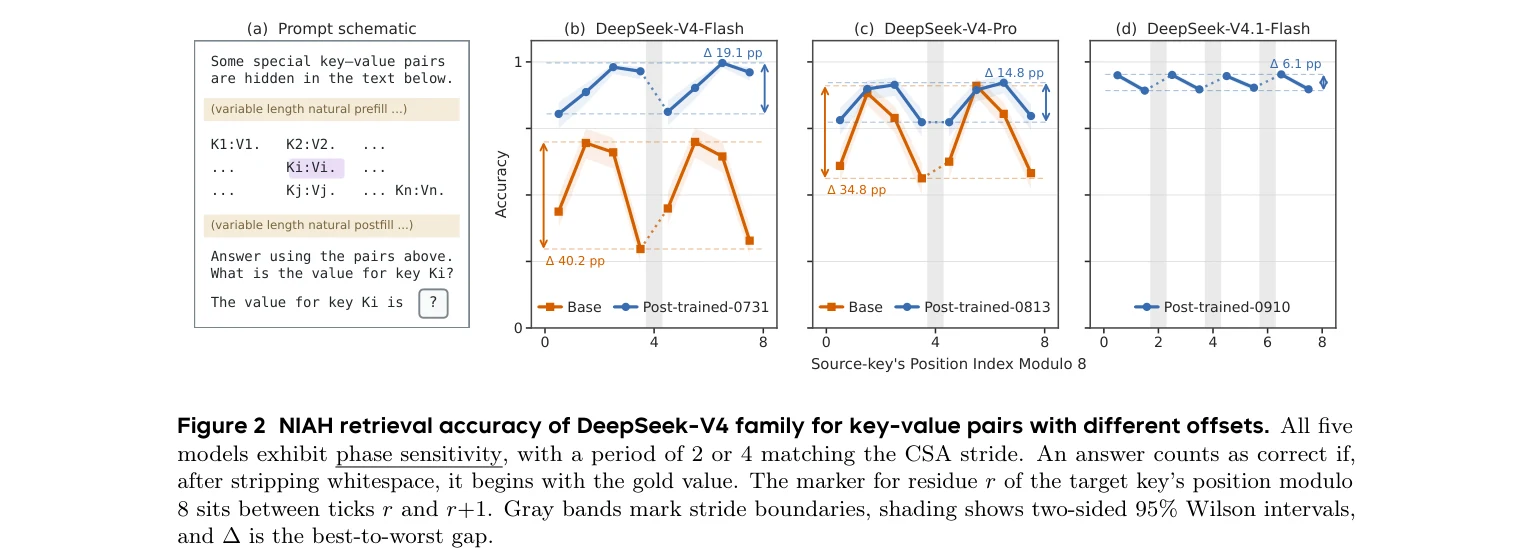
上图来自论文第 2 节的图 2:五个 DeepSeek 模型在同一批 128K 单 token 检索任务上的准确率,横轴是源键位置对 8 取模的相位,纵轴是准确率。可以看到曲线并非一条水平线,而是明显的锯齿状——两个相邻相位的准确率可以拉开几十个百分点。下文会逐条解释图中每一个细节。
现象一:同一段代码,补全结果会随填充长度翻转
论文的第一个证据来自 DeepSeek-V4 官方的推理代码。作者让 DeepSeek-V4-Flash-Base 补全一段 FP8 量化函数的类型转换代码:提示词停在 T.Cast(FP 处,原始源码的下一个 token 是 8(也就是 FP8 的后半段)。上下文里有两个要素支持这个答案:该函数本身就是把数值量化到 FP8 的,而外层那个 cast 已经把结果转换成了 compute_dtype(即 FP32),所以再写一次 32 既重复、又跳过了舍入。
为了检验这个预测是否依赖位置,作者在代码前面加了一段装饰性的 docstring,并只改变它的长度——在第二行重复若干个 = 字符。代码内容完全不变,每多一个填充 token,整段代码和补全的位置就向后平移一位。作者测试了 16 种填充长度(24 到 39 个 token),结果 top-1 预测按周期翻转:当填充长度 时模型预测 8(正确),其余八个长度预测 32(错误),而 的差值在 到 之间摆动。
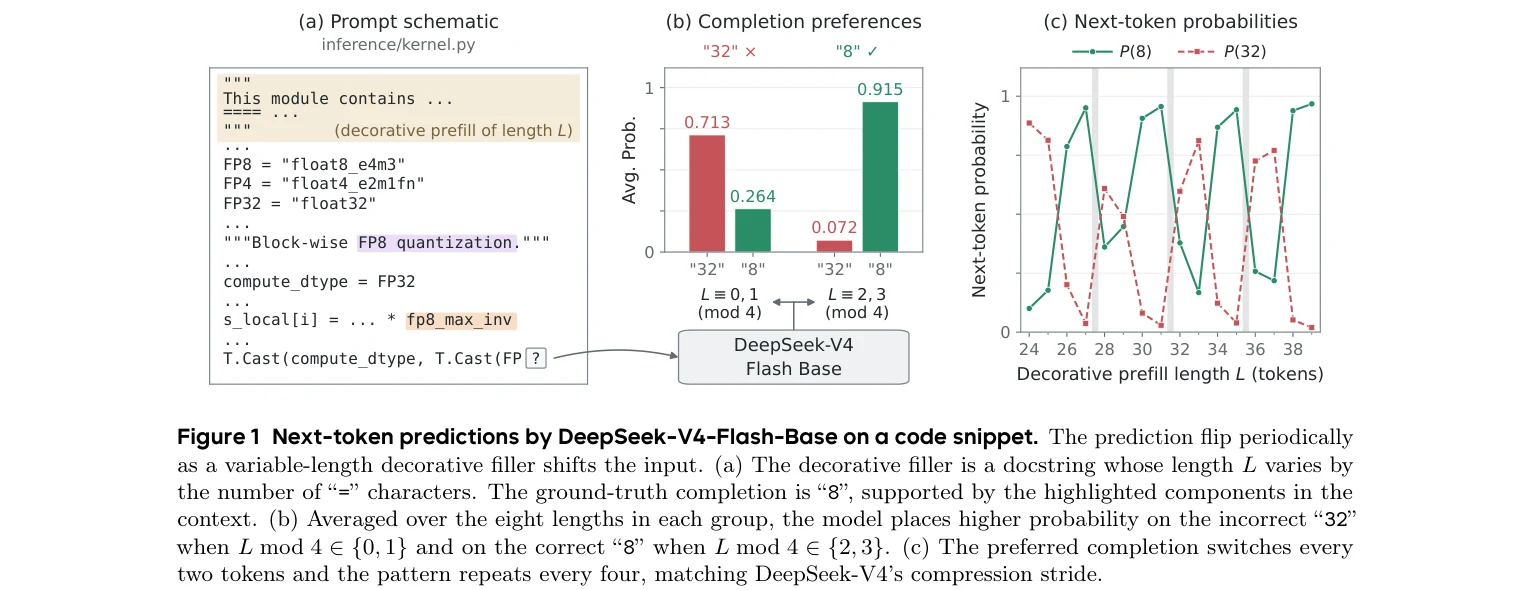
论文的图 1 把实验画得很清楚。左侧 (a) 是提示词结构:顶部是一个长度可变的 docstring 填充块,中间是固定的 tokenizer 代码,底部 T.Cast(compute_dtype, T.Cast(FP 之后就是被预测的位置。中间 (b) 用 16 个填充长度画出模型的 top-1 选择,可以看到 32 和 8 交替出现。右侧 (c) 画出两个候选 token 的概率随填充长度变化的曲线,两条曲线在每 4 个长度处交替反超,周期恰好是 4。
这个周期 4 并非巧合:它与 DeepSeek-V4 压缩稀疏注意力使用的压缩步长 完全一致。换句话说,补全结果取决于代码落在这个压缩窗口的哪个相位上。作者进一步发现,这种翻转并不局限于一种填充方式:四种填充族(两种天然语言文本、重复的 HTML 标签与 SQL 注释)中,大多数预测都遵循同样的四 token 模式;后训练版本的 DeepSeek-V4-Flash-0731 与压缩步长为 的 DeepSeek-V4.1-Flash 也呈现出与其步长匹配的周期翻转。作为对照,没有做分块 KV 压缩的 DeepSeek-V3.1-Base 在同一批 64 个输入中只在 4 个上把 32 排在 8 之前,而且差距极小。
论文还给了两个额外的代码补全例子,同样是只改变填充长度、周期性地出现错误补全。这些例子说明相位敏感性不是某个特定提示词或语法的偶发产物,而是与压缩结构强绑定的系统行为。
受控测量:把”相位”从位置里单独拎出来
代码补全的例子直观,但混入了太多变量:代码语义、docstring 内容、模型的训练分布。要用数字量化相位敏感性,必须构造一个检索任务,使得唯一发生变化的就是源信息的相位。
任务设计
论文采用经典的 key–value 检索(needle-in-a-haystack,NIAH)任务。每个 prompt 长为 128,000 个 token,其中包含 16,000 个 key–value 对,提问的对象是靠近上下文正中的某个源 key,要求模型回答它对应的 value。所有 prompt 中 key–value 绑定完全相同,prompt 总长度相同,查询位置也相同。
关键在于如何布置”自然语言填充”。为了让源 key 的绝对位置在不同相位组之间分布一致,作者在源 key 前面放长度 的自然语言填充,在它后面放长度 的填充,两者合计恒为 48 个 token。源 key 的起始位置定为
这样每个相位组的源 key 平均起始位置都是 64,000,位置方差都是 604 − 24² = 28。填充长度 取 8 到 40 之间且满足 的取值,每个相位组 256 个 prompt。于是,八组 prompt 之间唯一变化的是”源 key 落在压缩窗口的哪个位置”。由于 DeepSeek-V4 的步长是 4,八组覆盖两个周期;DeepSeek-V4.1-Flash 的步长是 2,八组覆盖四个周期。
评分指标是答案前缀准确率:
其中 是正确答案, 是模型生成的原始输出,strip 去掉首尾空白。这一指标允许模型在答案后面附加标点或解析器生成的文本,比逐 token 精确匹配更贴近实际使用。采样设置为温度 0、最多生成 8 个 token,不做思维链。
结果:最多 40 个百分点的落差
论文报告了五个模型在每个相位(源 key 位置对 8 取模)上的准确率,摘录如下:
| 模型 | r=0 | r=1 | r=2 | r=3 | r=4 | r=5 | r=6 | r=7 | 最大落差 |
|---|---|---|---|---|---|---|---|---|---|
| DeepSeek-V4-Flash-Base | 43.75 | 69.53 | 66.02 | 29.69 | 44.92 | 69.92 | 64.45 | 32.81 | 40.23 |
| DeepSeek-V4-Flash-0731 | 80.47 | 88.67 | 98.05 | 96.48 | 81.25 | 90.23 | 99.61 | 96.09 | 19.14 |
| DeepSeek-V4-Pro-Base | 60.94 | 88.28 | 78.91 | 56.25 | 62.50 | 91.02 | 80.47 | 58.20 | 34.77 |
| DeepSeek-V4-Pro-0813 | 78.13 | 89.84 | 91.41 | 77.34 | 77.34 | 89.45 | 92.19 | 79.69 | 14.84 |
| DeepSeek-V4.1-Flash | 95.00 | 89.22 | 95.12 | 89.69 | 94.69 | 90.31 | 95.31 | 89.73 | 6.09 |
几个结论值得单独拿出来:
- 基座模型最敏感。 DeepSeek-V4-Flash-Base 的平均准确率只有 52.6%,但相位起伏达到 40.23 个百分点;最好的相位(r=5,69.92%)和最差的相位(r=3,29.69%)几乎差了一倍。DeepSeek-V4-Pro-Base 的起伏是 34.77 个百分点。
- 后训练能抬平均值、也能压低起伏,但没有消除它。 后训练后平均准确率从 52.6% 升到 91.4%(Flash-0731),落差从 40.23 缩小到 19.14;Pro 的落差从 34.77 缩小到 14.84。但 19 和 15 个百分点仍然相当可观。
- 压缩更激进的版本反而更均匀。 DeepSeek-V4.1-Flash 的落差只有 6.09 个百分点,平均 92.38%。不过它的所有偶数相位组都高于所有奇数相位组,形成一种更细微但依然系统性的偏置。
- 周期性与步长吻合。 八组相位覆盖两个 4 的周期,如果周期是 4,那么 r 与 r+4 的准确率应该接近。作者统计了四个 DeepSeek-V4 模型上 的平均值,落在 1.07 到 1.95 个百分点之间,与四 token 周期性吻合。
这张表和上图一样揭示了一个容易被平均分掩盖的事实:在 128K 上下文、16,000 个干扰对的条件下,一个平均准确率 91.4% 的模型,仍然可能对落在某个相位上的信息有约 18% 的系统性漏检。
对照实验:从零训练一族模型,只改压缩
DeepSeek-V4 与标准 Transformer 的差异远不止分块 KV 压缩:它还有 MLA 低秩缓存、混合注意力层(CSA 与 HCA)、大规模 MoE 以及特殊的训练配方。仅凭它的表现,无法证明相位敏感性确实来自分块压缩。作者于是做了一组受控实验。
以 Qwen3-0.6B 为骨架的一族模型
作者以 Qwen3-0.6B 为骨架从头预训练了一族模型。骨架有 28 层、隐藏维度 1,024、16 个查询头、每个头的维度 。前馈层、残差连接与归一化都保持原样,唯一实质性的架构改变就是分块 KV 压缩。同时,他们还用同样的训练方式训练了全注意力(full attention)基线模型。
训练设置:AdamW,,,权重衰减 0.1,梯度裁剪范数 1,BF16,随机种子 42;打包语料过一遍,序列长度 2,048,全局批大小 1,024 个序列;学习率先按 2% 的步数线性预热到 ,再按余弦衰减到 。主实验中所有模型都取第 47,518 步的检查点。
压缩核的参数化:payload map 与门控
作者没有只测一种压缩方式,而是把压缩抽象成一个有参数的家族。对第 个窗口、窗口内的偏移 ,记隐藏状态为 。对分支 ,定义三种映射:
- payload map ,决定”每个 token 以什么方式贡献到压缩条目里”;
- gate map 与位置偏置 ,决定”每个 token 以多强的权重进入汇总”。
其中 是隐藏宽度, 是头维度, 是门控维度。
以 key 分支为例,先计算门控 logits
再在窗口内做 softmax 把 logits 变成门控分数,并用它对 payload 加权:
其中 按元素相乘,但广播规则取决于门控维度:标量门控()时所有 payload 维度共享同一个权重,向量门控()时每个投影维度可以偏好不同的窗口偏移。 在偏移维上归一化,即每个窗口内的权重之和为 1。value 分支完全对称。
这个参数化把主流压缩设计中的几个关键自由度都覆盖了:窗口大小 (一个条目汇总多少 token)、步长 (多久产出一个条目)、窗口是否重叠( 时一个 token 会出现在多个偏移上,但它的相位不变)、标量门控还是向量门控、K 与 V 分支是否共享参数、payload map 是否按偏移共享。
实验矩阵
作者以此为基础构造了 23 个压缩模型与 3 个全注意力基线。全注意力的 KV 头数有 1、4、8 三种;压缩模型则在以下维度上变体:随机种子(42–45)、KV 头数(1、2、4、8)、窗口与步长(W4/S4、W8/S4、W8/S6、W8/S8、W12/S12)、门控形式(标量、向量、均匀平均)、K/V 是否绑定、是否加位置偏置、是否用 RoPE 或 NoPE、是否做 Q/K RMSNorm、局部记忆策略,以及 DeepSeek 风格的压缩核(W=8、S=4,门控向量化、K/V 绑定,softmax 跨整个窗口的八个偏移)。
适配小模型的检索任务
小模型的检索任务规模与 DeepSeek 的 16,000 对 NIAH 不同。作者设计了一个 token 精确的动物名检索任务:64 个动物 key 与 64 个人名 value 一一对应(每个都是单个 Qwen3 token),目标是被打乱后的第 25 对(零基下标 24)。评测指标是全词表 next-token 准确率,即在预测下一个 token 时,正确答案在完整词表里的概率排名是否为第一。
为了让相位变化与干扰项的相位变化解耦,作者引入两种填充协议:
- 前缀填充(Prefix Padding):在映射体前面和后面放自然语言填充,平移时所有记录一起移动,干扰项的相位与目标一起变化;
- 序列内填充(In-sequence Padding):记录之间插入可变长度的间隔,目标移动时干扰项的相位不再同步移动。
在两种协议内部,查询位置固定,目标位置的期望深度与到查询的期望距离在不同相位组之间保持一致。相位组按源 key 位置对 24 取模划分(24 是所测步长 4、6、8、12 的公倍数),每组 1,000 个逻辑样本,误差棒是逐点的 95% 聚类自举区间。
核心发现
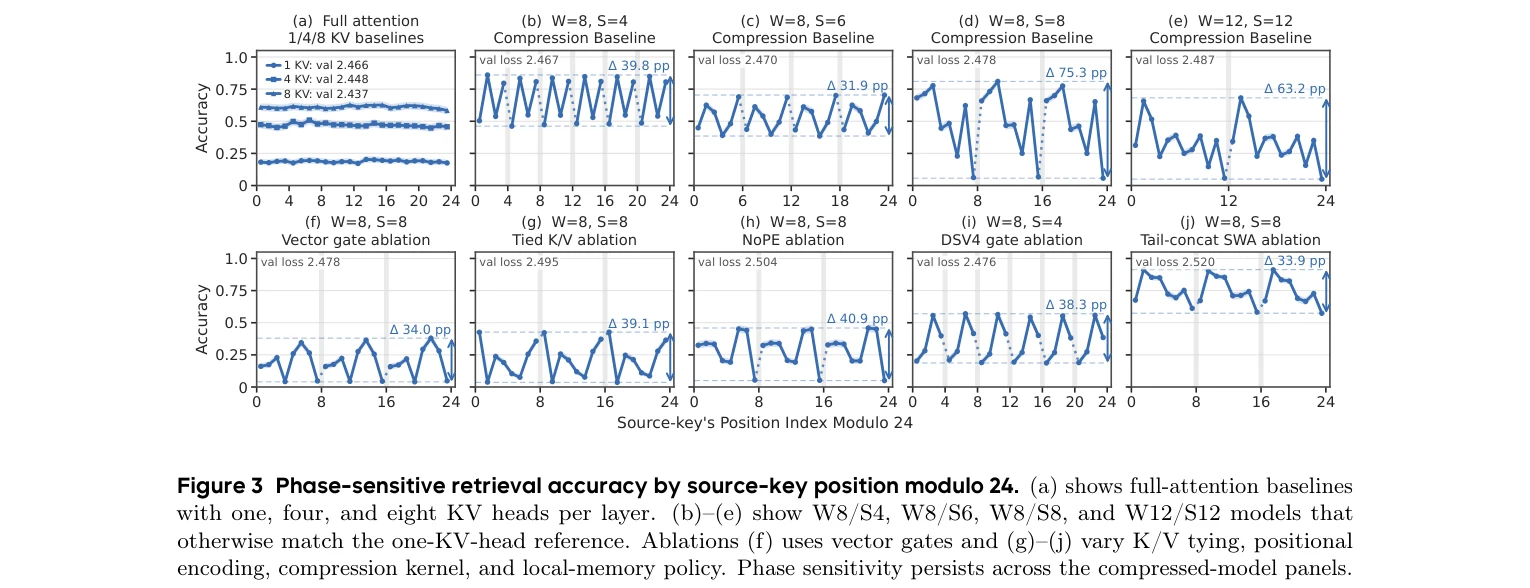
论文的图 3 是这组实验的主结果,横轴是源 key 位置对 24 取模,纵轴是准确率。图中 (a) 是全注意力的三个基线(1、4、8 个 KV 头),精度曲线基本是平的,三个基线的最大落差只有 3.1、6.1、4.3 个百分点。而 (b)–(e) 四个压缩模型——W8/S4、W8/S6、W8/S8、W12/S12——都出现了明显的周期性起伏:W8/S4 的周期约为 4,W8/S6 约为 6,W8/S8 约为 8,W12/S12 约为 12。周期跟着步长走,而不是跟着窗口大小走。
论文附表(表 8)给出的数字更直观。参考模型是单 KV 头、W=S=8、标量门控、K/V 分离的 W8/S8:
| 配置 | 验证损失 | 平均准确率 | 最差相位 | 落差(百分点) |
|---|---|---|---|---|
| 全注意力,1 KV 头 | 2.466 | 18.8 | 17.2 | 3.1 |
| 全注意力,8 KV 头 | 2.437 | 61.1 | 58.4 | 4.3 |
| 参考 W8/S8,1 KV,种子 42 | 2.478 | 50.6 | 5.7 | 75.3 |
| 参考 W8/S8,1 KV,种子 43 | 2.482 | 32.1 | 2.5 | 59.2 |
| W8/S8,8 KV 头 | 2.431 | 59.4 | 9.9 | 71.1 |
| W8/S4,重叠窗口,1 KV | 2.467 | 66.9 | 46.2 | 39.8 |
| 均匀平均替代门控 | 2.497 | 12.5 | 4.7 | 19.2 |
| DeepSeek 风格压缩核(向量门控) | 2.476 | 35.6 | 18.7 | 38.3 |
这张表里有好几个值得停下来想一想的地方:
- 平均分几乎骗过所有人。 8 KV 头的 W8/S8 压缩模型,验证损失 2.431 甚至优于全注意力基线(2.437),平均准确率 59.4% 也接近 8 头全注意力的 61.1%。按常规的”平均准确率 + 验证损失”来评估,会得出”压缩几乎无损”的结论。但它的最差相位只有 9.9%,而全注意力基线的最差相位是 58.4%。
- 落差远超基线。 参考模型在 24 个残差类上的落差高达 75.3 个百分点,是基线(3–6 个百分点)的一个数量级以上。
- 均匀平均也有相位敏感性。 把门控替换成固定的 平均,落差从 75.3 缩小到 19.2,但并没有消失。这说明相位敏感性并不依赖”学习到的门控”,它的根源更深。
- 重叠窗口能明显缓和,但没消除。 W8/S4 与 W8/S6 的落差分别是 39.8 与 31.9,比 W8/S8 小得多——因为一个 token 会出现在多个偏移上,某一次压缩得不好还有别的机会。但 30 多个百分点依然不可忽略。
作者还在表 8 中的全部 23 个压缩模型和两种填充协议上验证了这一点:没有任何一种配置能够消除周期性的弱点,尽管有些配置可以大幅缩小落差。均匀平均、随机种子、位置编码、归一化方式都会让精度曲线在相位上的形状发生变化,但弱点仍然以步长为周期出现。
边界不是全部原因
一个很自然的解释是窗口边界。在检索任务里,key 后面紧跟它的 value;如果窗口不重叠,一对 key–value 要么落在同一个窗口里,要么被拆到两个窗口。后者显然更难检索。在 W8/S8 参考模型中,只有相位 7 的 key 的 value 会落到下一个窗口。
如果相位敏感性仅仅来自边界,那么除相位 7 以外的所有相位(key 和 value 都在同一个窗口内)应该表现接近。但论文数据显示,在 W8/S8 模型中,相位 0 到 6 之间的准确率落差超过 50 个百分点。边界只能解释一个点,解释不了剩下的七个点。
这个观察把问题从”窗口怎么切”推向了更深的层次:模型是如何把信息写进压缩条目、又如何把它读出来的?答案指向论文的下一部分:不同注意力头的贡献在不同相位上不对称——作者称之为相位特化(phase specialization)。
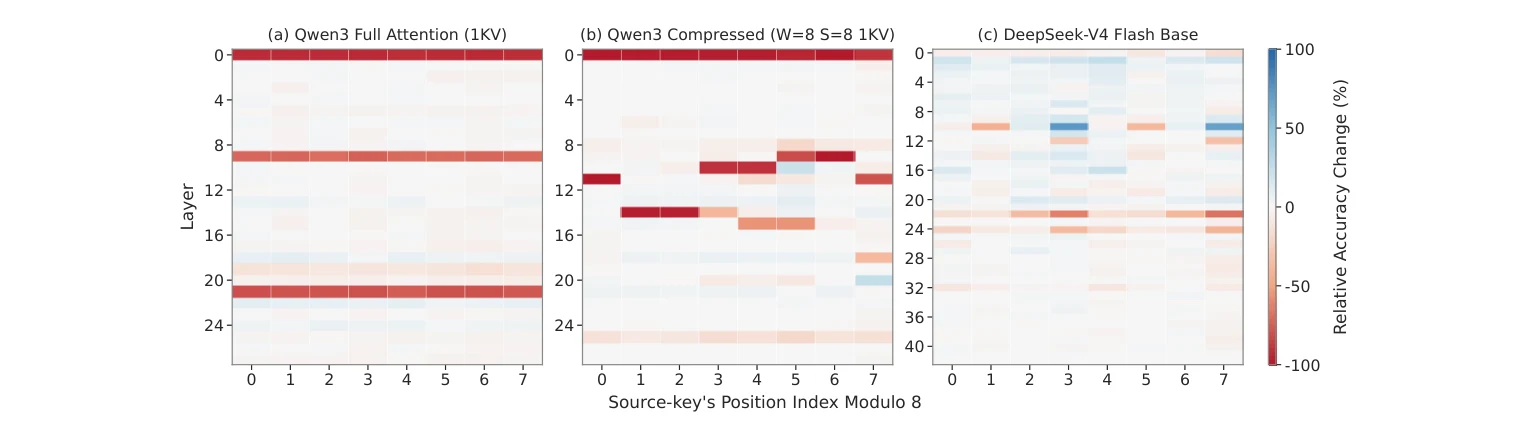
上图(论文图 4)是相位特化的直接测量。作者对每一层的 KV 头逐个做敲除(knockout):把该头在干预位置上的输出替换成它在许多其他 prompt 上的平均输出,当前 prompt 的特定信息就被抹掉了;如果准确率下降,说明该头的输出对当前检索有因果贡献。图中每行对应敲除一层,每列对应源 key 的一个相位,颜色表示”准确率变化 / 该相位干净准确率”的相对变化,红色表示损害。
(a) 是全注意力基线:大误差层在每个相位上都造成相近的损失,形成水平的条纹。这说明在全注意力模型里,每一层对每个位置的作用大致相同。(b) 是 W8/S8 压缩模型:有些头的损失集中在少数几个相位上,不同头的损伤分布在不同的相位上,图呈现斑块状。(c) 是 DeepSeek-V4-Flash-Base:最大的损失在相位之间分布不均,少数靠前的层只影响某些相位,并且以 4 为周期重复——恰好是它的压缩步长。此外,图中奇数列(那些大量使用 HCA、压缩率 128 的层)对检索几乎毫无贡献,这一点与站内 V4 架构分析中的讨论一致。
这张图传达了两个层次的信息。第一层是统计口径上的:相位敏感性是”头级别”的现象,不是一个全局的标量。第二层是机理上的:既然不同头在不同的相位上负责不同的信息,那么一个可能的原因就是每个头在压缩时保留的偏移不同——接下来要讲的”门控偏好”正是这一点。
相位特化:门控为什么会长出偏好
敲除实验回答了”哪些头在哪些相位上重要”,但没有回答”为什么”。论文在这一步把注意力放到了压缩门控上——也就是前面公式里的 与 :它们决定了窗口内每个偏移以多大的权重进入压缩条目。
两种集中方式
一个门控可以在窗口内集中权重,但集中有两种截然不同的方式:
- 静态集中:同一个头在每个窗口都偏好同样的偏移。无论输入是什么,它都把权重压在偏移 2 上;
- 输入依赖集中:每个窗口确实只选一个偏移,但选的偏移随内容变化,跨输入平均下来就分散了。
只有静态集中才会把一个头绑定到固定的相位上,因此论文用有效偏移数(effective number of offsets)把两者区分开来。定义窗口 的门控分数向量为 ,香农熵为
则有效偏移数为 :当门控是 one-hot 时等于 1,当门控均匀时等于 。在此基础上,论文定义两个指标:
其中期望在留出的自然语言验证文本的所有压缩窗口上取。横轴是 static,纵轴是 avg。一个对每个窗口都施加同样分数的门控会落在对角线上(因为期望与熵可以交换);一个”每窗口选一个但选择均匀”的门控会落在右下角 ;只有同时小的一对值才代表真正的静态集中。
预训练中的轨迹
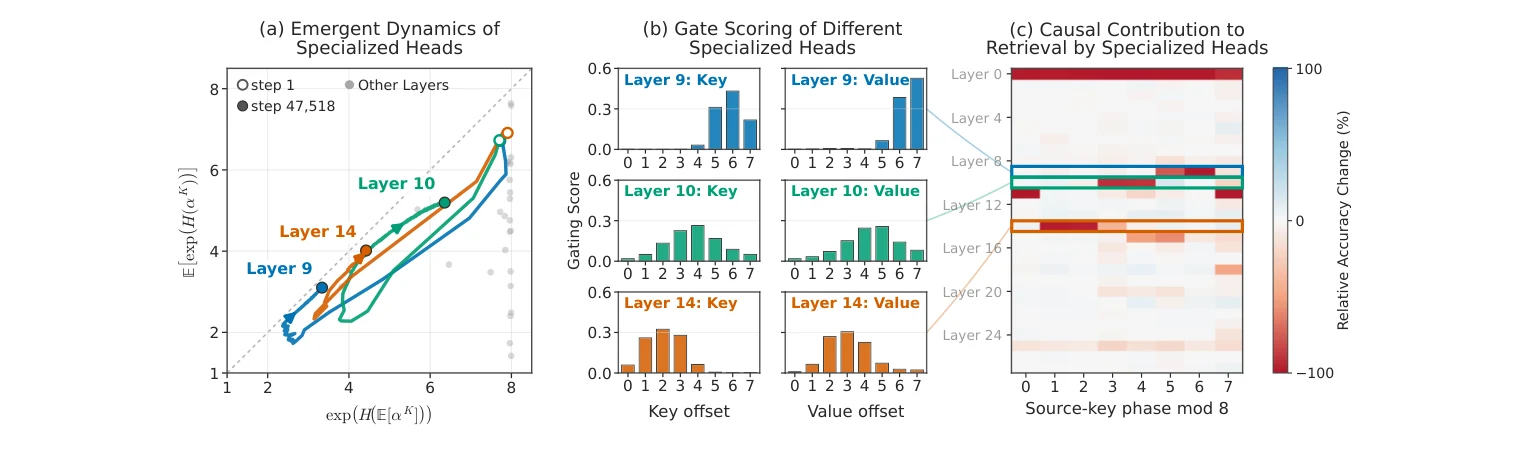
论文的图 5 把这件事画了出来。(a) 是 key 门控在预训练过程中的轨迹:初始化时所有门控都接近均匀,落在右上角;随着训练进行,少数头沿对角线向左下移动,最终形成静态集中(图中高亮的三条轨迹);其余头停在右侧边缘,只有不同程度的输入依赖集中,没有一致的偏移偏好。图中还标出了第 1 步与第 47,518 步的位置,可以清楚看到集中不是一步到位的,而是在训练过程中逐渐”漂移”出来的。
(b) 展示了这些集中头的平均门控分数。第 14 层的 key 门控在窗口前段达到峰值,第 10 层在中段,第 9 层在后段;而且每个头的 value 门控峰值都比 key 门控晚一个偏移。这个”晚一个”的细节不是巧合:在检索任务里,key 后面紧跟它的 value,所以一个头若想同时抓住 key 和它的 value,就必须让 key 门控落在 、value 门控落在 ,这正好构成一个 bigram 的结构。
(c) 把门控峰值与敲除损失叠在一起:对每个相位 ,背景色是该头在相位 上的敲除损害,黑色曲线是 key 门控在相位 上的平均分数,紫色曲线是 value 门控在相位 上的平均分数。三条信息是对齐的——门控偏好的相位,恰好就是这个头最重要、敲掉它损失最大的相位。除第 0 层外,最大的敲除损失都来自这些静态集中的头。
更多的头、更多的种子
论文附录给出了更广的检查。当每层有 4 个 KV 头时,静态集中变得更尖锐:许多头只在单个偏移上出现峰值,敲除损失也集中在单个相位上(例如第 5、16 层的 2 号头与第 10、12 层的 0 号头),这些尖锐的头合起来覆盖了全部八个相位。在四个随机种子(42–45)的复制实验中,每个种子都发展出 4 到 6 个集中头,分布在 4 到 18 层之间,但没有任何一层在四个种子里都出现集中头,而且它们偏好的相位覆盖了全部八个相位。唯一重复出现的模式是”key 门控偏好相位 0、value 门控偏好相位 1”的头,分别落在第 11、14、13、12 层。这与第 5 节的理论预测一致:每个头最终会收敛到某个尖锐的选择,具体位置取决于初始化,而且不同头并不必然覆盖互补的位置。
门控循环:因果性的直接检验
如果门控偏好真的决定了哪些相位被保留,那么把偏移相关的门控参数整体循环平移 个偏移,精度曲线应该也跟着平移 个相位。论文在附录 H 中做了这个干预。对非重叠窗口(),窗口偏移 就是相位 ;循环 的操作是
即把偏移 的门控参数应用到偏移 上,payload map 保持不变。作者在五个模型(两个 W12/S12、一个 W8/S8 参考模型及其两个种子复制)上测试了 六种循环。
结果相当一致:在排除边界相位后,实际精度曲线的平移与预测的平移高度吻合, 在 W12/S12 模型上是 0.96 到 1.00,在 W8/S8 参考模型上是 0.88 到 1.00,在两个种子复制上是 0.66 到 1.00。这为”门控偏好 → 相位精度”提供了直接的因果证据。
但有两个必须一起看的细节。第一,边界相位()不受循环影响:在所有循环下它的准确率都停留在 2.9% 以下,而模型未循环时它在 2.7% 到 23.9% 之间。第二,循环整体上降低了全词表准确率 3.3 到 18.4 个百分点。换句话说,循环只是把这些弱点从一个相位搬到另一个相位,并没有修复模型。这恰好对应论文在讨论部分的判断:边界与窗口内不对称是两套机制,门控只解释了后者。
理论:为什么最优压缩会选择极端
前两节是”发生了什么”,第 5 节转向”为什么会这样”。作者构造了一个可以解析的理想化模型,回答三个问题:未来查询未知时,为什么压缩要集中?集中为什么会变成静态的?不同的头会不会分工覆盖不同位置?
理想化任务
设上下文 ,包含 个互不重叠的块,每块 个互不相同的 token 嵌入,从大小为 的词表 中无放回地均匀采样。块内位置 就是偏移 ,也就是一个相位。压缩之后,查询 重复一个从 个非末尾块位置中均匀采样的 token,要求模型输出它在同一块内的后继 。这正是 induction head 的经典任务。
设有 个头,每个头把块 压缩成
其中 是 上的概率向量,在查询出现之前就已选定。每个头用 softmax 在块分数 上对压缩 value 加权,,再用一个共享的 unembedding(尺度 )把各头输出之和映射到 next-token logits。为简化分析,训练时固定嵌入,并把 query/key/value 映射取为恒等映射。
嵌入几何用一个理想化假设刻画:
其中 是所有 token 共享的公共分量(反映 token 表示的各向异性), 是误差上界。 时称为精确几何。在这个几何下,一个头的目标类 logit 正比于”它对正确块的注意力”乘以”它的 value 在答案上的权重”——两个因子都需要强度。
定义:一个头选择位置 ,如果它把全部 key 权重放在 上、把全部 value 权重放在 上。这是最极端的集中。
定理一:最优压缩是硬选择
论文先考虑一个”神谕类”(oracle class):压缩系数可以任意依赖上下文,但不能依赖查询。在这个类上最小化 population cross-entropy,得到:
定理 1(非正式):当 足够大、 足够小时, 上的每一个全局最小值,在每个上下文、每个块、每个头上都满足 、,其中 可以依赖上下文、块与头。当 时,同一上下文同一块内不同头选择的位置互不相同。
这个结论的关键在于它允许选择随上下文变化:最优性要求”在每个块内集中”,但不要求”对所有块都用同一个偏移”。这一点很重要,因为它把”集中”与”静态集中”分成了两件事——定理 1 只证明了前者。
背后的权衡值得单独讲清楚。一个头若把窗口内的位置平均,它对每个位置都保留了一点证据;若选择单个位置,它在被选位置上保留全强度证据,但完全放弃其他位置的直接证据。在精确几何下,错误块的 logit 主要由公共分量 决定,与怎么压缩关系不大;正确块的 logit 则与”注意力质量 × value 权重”成正比。把这两个因子都推到最大(都变成 one-hot),正确块的 margin 增长得比平均情况快得多。因此当词表足够大、干扰块足够多时,选择优于平均。这解释了为什么梯度会把门控推向极端。
定理二:梯度流把选择固定下来
定理 1 允许每个块选不同位置。但训练是连续的,参数被所有块共享,因此问题变成:梯度下降会不会把这种”每块可变的选择”变成”所有块一致的选择”?
作者把神谕类收窄为线性门控类 :每个头对每个位置 有一对向量 ,在所有上下文与块之间共享,且只有这些参数被训练:
在精确几何下, 沿嵌入均值的分量相当于位置 的一个输入无关偏置,因此这套门控可以表达静态集中——但参数化本身并不强制它。作者分析 上的梯度流(梯度下降的连续时间极限),从小随机初始化出发,得到:
定理 2(非正式):假设 ,初始化在零附近一个半径足够小的欧氏球内均匀分布。对固定的模型尺度、 相对 足够大,则以高概率成立:对每个头 ,存在位置 ,使得当训练时间趋于无穷时, 且 ,并且对所有上下文与块一致成立。不同的头可以选择相同的 。
这条定理回答了两个问题。第一,为什么集中会变成静态的:因为参数跨块共享,梯度流最终把每个头推到同一个位置,使得静态有效偏移数与逐窗口有效偏移数都趋于 1——也就是图 5(a) 的左下角。第二,为什么不保证互补覆盖:不同头可以选同一个位置,也可能恰好分散开,取决于初始化。这与第 4.2 节观察到的种子差异完全对应:每个种子都长出集中头,但位置各不相同,且没有一层在四个种子里都集中。
论文在附录 A.1 还给了一个两阶段两头的玩具例子,用闭式解展示”为什么头会锐化”与”为什么两个头倾向于分工”:在固定注意力质量和的情况下,logistic loss 对注意力质量的凸性使得两头均分比一头独吞更优,于是两个头走向互补的端点。这个例子不在一般定理的特例范围内(它取 、只保留 key、并理想化了 value 读出),但提供了理解一般证明的入口。
需要强调的是这套理论的范围:它刻画的是”压缩者必须在查询未知时做取舍”这一结构,因此结论(选择优于平均、梯度流使选择静态化)在理想的 induction 任务与精确几何下成立。真实模型中还会有 MLA 低秩结构、混合注意力、多层交互等因素,论文自己也把机制结论限定在受控设置内。
这对推理系统意味着什么
评估口径需要改变
论文最实用的结论不是某个具体数字,而是一条方法论:用平均准确率评估分块压缩模型是不够的。表 8 里 8 KV 头的 W8/S8 模型在验证损失和平均准确率上都与全注意力基线接近,但最差相位只有 9.9%,而基线是 58.4%。如果不跨相位测量,这个弱点在报表上完全不可见。
可操作的检验方式是平移不变性测试:保持被查询的信息、上下文内容、查询位置不变,只把整段输入平移几个 token(例如在系统提示或前置文档里加几个填充字符),然后观察回答是否改变。这与论文里”改变 docstring 长度即可翻转补全”的实验是同一个思路,成本极低,却能暴露按平均分看不到的系统性失败。论文在结论中也明确建议:评估这类模型时要在压缩相位上测量,而不是只看平均值。
部署中的现实影响
相位敏感性意味着同一段信息在不同上下文长度下的可检索性不同。在 RAG 场景里,检索文档被拼进 prompt 的位置、系统提示的长度、对话历史裁剪掉多少 token,都会改变目标内容的相位。用户可能会观察到”同一个问题,昨天答得对、今天答错了”这类难以复现的漂移,而根因不是模型随机性(温度为 0 时也会发生),而是输入整体平移导致的相位变化。
这并不是说分块压缩不可用。DeepSeek-V4.1-Flash 把落差压到 6.09 个百分点,说明工程上可以通过更细的步长、更强的后训练把问题控制到可接受范围。但它提醒系统设计者:不能把”平均 NIAH 分数”当作可靠性的全部证据。
与其他压缩路线的区别
站内已经讨论过多种 KV 缓存压缩路线:H2O 这类基于重击者分数的驱逐、SnapKV 这类基于观察窗口投票的压缩、KIVI 这类按通道/按 token 的量化,以及 MLA 的低秩压缩。它们的共同点是按内容选择:留下哪些 token、用多少位表示,取决于 token 的注意力分数或数值分布。
分块压缩不同,它按位置分组:无论内容是什么,每 个 token 就产生一个条目。这带来两个后果。其一,压缩发生在查询之前且与内容无关,模型必须替未知查询保留信息,理论分析正是围绕这一点展开。其二,失效模式带有周期性——不是”某些内容检索不到”,而是”某些位置上的内容检索不到”,这会随输入平移而整体搬移,因此更难通过增加检索量或改写内容来规避。
与稀疏注意力(NSA、DSA)的关系也值得说明。站内 稀疏注意力的新瓶颈 讨论过:当主注意力从 降到 之后,索引器本身仍是 ,成为新瓶颈。分块压缩解决的是另一维度的问题——把 KV 条目数量本身降下来;而相位敏感性是这种降维带来的副作用。两者可以叠加使用,但评估时必须分别考虑各自的失效模式。
缓解方向
论文的实验矩阵本身给出了几条线索:
- 让窗口重叠():一个 token 会以多个偏移出现在不同的压缩条目里,某一次压缩得不好还有别的机会。W8/S4 与 W8/S6 的落差(39.8 与 31.9)明显小于 W8/S8(75.3)。
- 缩小步长:DeepSeek-V4.1-Flash 用 ,落差降到 6.09。代价是压缩率下降,需要在内存与可靠性之间权衡。
- 均匀平均:把可学习门控换成固定平均,落差从 75.3 降到 19.2。这看起来反直觉——学习到的门控本应更聪明——但静态集中的门控会把资源押在特定相位上,平均反而更均匀。不过平均也会拉低整体准确率(12.5),所以它不是免费的。
- 保留精确分支:论文提到,像 NSA 那样保留一条对远距离 token 的精确分支,可能会掩盖压缩分支单独的失效;而 DeepSeek-V4 只在局部窗口保留精确 token,因此在完整模型上仍然能观察到相位敏感性。
论文没有给出”统一修复”。作者在讨论中把两个问题留作开放:边界相位为什么无法通过门控循环恢复?能否通过跨头、跨层的显式协调,在不牺牲平均性能与压缩率的前提下让检索质量在相位上更均匀?
局限
阅读这篇论文时需要注意几点边界。第一,机理分析主要在受控预训练模型(Qwen3-0.6B 骨架、100B token 训练)上完成,作者明确说这些结论不构成对大型异构模型中相位敏感性成因的普遍解释。第二,定理依赖精确几何与理想化 induction 任务,真实模型的嵌入几何、注意力尺度、多层耦合都会偏离假设。第三,门控循环实验揭示了因果性,但也显示循环会降低整体准确率,说明”把弱点搬走”不等于”修复”。第四,代码补全的例子虽然醒目,但只说明存在周期性错误,不能直接外推到所有任务;对鲁棒性相关行为(例如同一请求在上下文中平移后拒答/合规是否改变)的系统研究,作者留给了后续工作。
小结
分块 KV 压缩用固定步长把连续 token 折叠成更少的缓存条目,在降低长上下文推理成本的同时,也引入了一条新的位置坐标——相位。论文的证据链是完整的:
- 现象:DeepSeek-V4-Flash-Base 在只改变 docstring 长度时,补全结果按 4 token 周期翻转,与 CSA 的步长一致;128K NIAH 上五个 DeepSeek 模型的相位精度落差最高达 40.23 个百分点。
- 对照:从头训练的 Qwen3 一族模型中,23 个压缩模型全部出现相位敏感性,周期跟随步长而非窗口大小;全注意力基线保持平坦。8 KV 头的压缩模型在平均准确率与验证损失上接近基线,最差相位却只有 9.9%。
- 机理:KV 头敲除显示贡献随相位不对称,且以步长为周期重复;门控分析显示部分头发展出静态偏移偏好,key 门控与 value 门控相差一个偏移,其峰值与敲除损失峰值对齐;门控循环实验把精度曲线整体平移,为因果关系提供了直接证据。
- 理论:在理想化 induction 任务中,最优压缩是硬选择(每个头把 key 放在一个相位、value 放在下一个相位),梯度流则把这种选择固定为静态的;但不同头不保证互补覆盖。
对推理系统而言,最重要的启示是评估口径:压缩模型的可靠性必须在相位维度上测量,平移几个 token 的低成本测试就能暴露平均分掩盖的系统性弱点。至于如何在不牺牲压缩率的前提下让相位上的检索质量更均匀,仍是开放问题。
参考资料
- Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
- Qwen3 Technical Report
- Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
- Compressive Transformers for Long-Range Sequence Modelling
- H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models
- SnapKV: LLM Knows What You Are Looking for Before Generation
- RULER: What’s the Real Context Size of Your Long-Context Language Models?
- Lost in the Middle: How Language Models Use Long Contexts
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



