


CLIP 架构拆解:一段文字和一张图怎么被放进同一个空间——双塔对比学习、InfoNCE 与零样本推理
背景:分类器的最后一层能不能用自然语言写出来
过去十年里,视觉识别的主流做法是把「认识世界」压缩成一个封闭的选择题。模型看一张图,输出一千个类别的概率,取得分最高的那个。这套流程在 ImageNet 上被磨到极致,但它有一个与生俱来的限制:类别集合在训练开始前就被钉死了。想让模型认识一个新类别,要么重新标注数据、重新训练最后一层,要么至少准备一批该类别的样本做微调。模型本身没有「理解类别名字」的能力,它只认识编号。
自然语言本来可以打破这个限制。互联网上每天产生的图文对——商品图与标题、新闻配图与正文、社交媒体的照片与描述——规模远超任何人工标注数据集,而且文字本身就携带了「这张图里是什么」的信息。问题在于怎么把这种弱监督变成一个可优化的目标。2016 年前后的一批工作尝试过直接预测图像的描述文本(caption),或者把词向量与视觉特征对齐;其中 Visual N-Grams 在 2017 年用 n-gram 模型做零样本分类,ImageNet 上只有 11.5% 的准确率,基本停留在概念验证阶段。另一条路线是先训练一个图像描述模型,再用它的编码器做下游任务,但生成式目标要求模型逐词复现描述,而同一张图可以有无数种写法,容量被大量消耗在「换一种说法」上。
CLIP(Contrastive Language-Image Pre-training)由 OpenAI 在 2021 年提出,论文发表在 ICML 2021,arXiv 编号 2103.00020。它换了一个问法:与其让模型学会描述图像,不如让它学会判断哪段文字属于哪张图。这个看似更弱的代理任务,恰好保留了视觉与语言之间最本质的判别信息,同时抛弃了描述文本的多样性噪声。
论文里有一组很有说服力的效率对比。研究者先复现了「图像编码器 + 63M 参数 Transformer 语言模型」的生成式预训练路线,这个语言模型的算力已经是 ResNet-50 图像编码器的两倍;结果显示,它学会识别 ImageNet 类别的速度比一个只预测词袋(bag-of-words)编码的简单基线还慢 3 倍。把预测目标换成对比目标后,相对同一个词袋基线又快了 4 倍。两步叠起来,对比路线与最初的生成式语言模型之间是十几倍的效率差距。这组数字解释了 CLIP 的设计动机:在自然语言监督里,真正稀缺的是「把图文对起来」的判别信号,而不是「把文字写出来」的生成能力。
训练数据也按这个思路组织。CLIP 构建了 WebImageText(WIT)数据集,包含 4 亿个图文对。查询词表来自英文维基中出现至少 100 次的词、高互信息的二元组、搜索量靠前的维基条目名,以及 WordNet 的同义词集,合计约 50 万个查询;每个查询最多保留 2 万个图文对,做粗略的类别平衡。这 4 亿对数据没有人工清洗过的标签,只有网页上原本就存在的文字。
到这里,CLIP 要解决的问题可以精确地写成一句话:给定一批图文对,学习一个图像编码器和一个文本编码器,使得配对样本在某个共同空间里彼此靠近、非配对样本彼此远离;学成之后,用文本编码器把类别名字编码成向量,就能直接当分类器的权重使用。
核心思想:把「配对」变成「距离」
CLIP 的整个机制可以画成一张很朴素的图:一个 batch 里有 个图文对,图像编码器把每张图变成一个向量,文本编码器把每段文字变成一个向量,然后计算所有图像向量与所有文本向量的相似度,得到一个 的矩阵。矩阵对角线上的 个格子是真实配对,其余 个格子是错误配对。训练目标就是让对角线上的相似度尽可能高,让其余格子尽可能低。
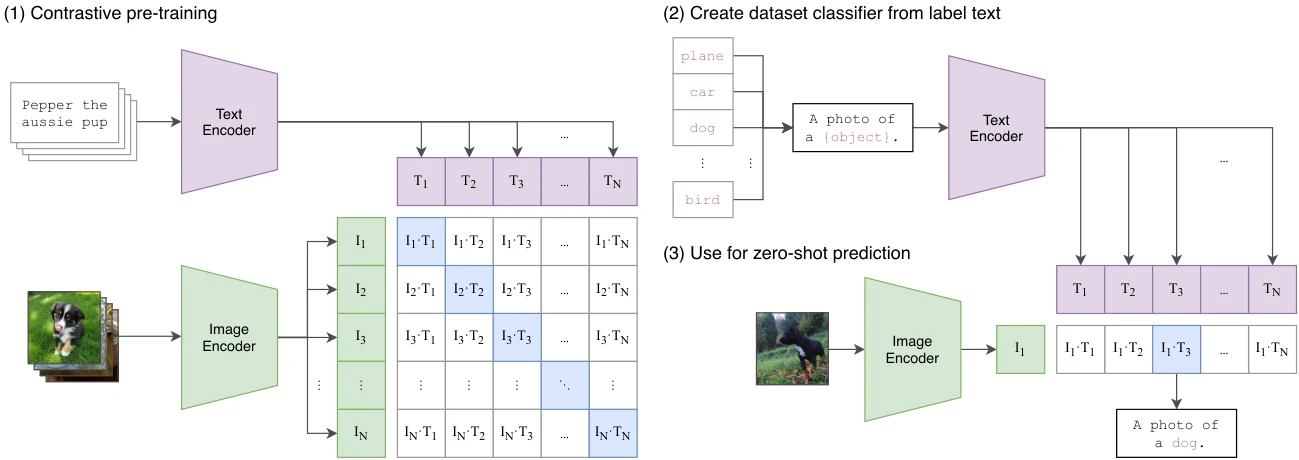
图中把 CLIP 分成三段。左边是预训练:图像塔与文本塔分别编码一个 batch,相似度矩阵的对角线(图中高亮的小格)是正样本,模型只被要求把对角线挑出来。中间是构造分类器:把数据集里的类别名字——plane、car、dog、bird——套进一个句子模板「A photo of a {object}」,送进文本塔,得到每个类别对应的一个向量;这些向量排在一起,就是一个分类器的权重矩阵。右边是零样本预测:一张待分类的图片经过图像塔变成一个向量,与所有类别向量算相似度,softmax 之后得到概率,取得分最高的类别。图中三段共用同一个文本塔和同一个图像塔,参数完全一致。
这个结构与当时主流的多模态模型有一个根本差别:两个塔之间没有任何跨模态层。图像塔在编码时看不到文本,文本塔在编码时也看不到图像,所有跨模态信息只在最后一步的向量内积处交换。对比之下,LLaVA 式的模型会把视觉特征投影成 token 塞进语言模型,让两种模态在 Transformer 内部逐层交互;Flamingo 会在语言模型的每一层插入交叉注意力去查询视觉特征。这些做法的表达能力强,但推理时必须让图文同时进入一次前向。CLIP 的双塔结构把两边的计算彻底解耦,这是它在检索和零样本分类场景里成本极低的原因。关于四种融合机制的系统对比,可参考多模态大模型的四种融合机制。
论文对零样本分类给了一个很有启发性的解释:文本编码器其实是一个超网络(hypernetwork),它根据自然语言描述生成线性分类器的权重。在通常的监督学习里,分类器的权重是从标注样本里学出来的;在 CLIP 里,权重是文本塔对一句「A photo of a dog」的输出。图像塔则是那个被这个分类器作用的主干网络。按这个视角,CLIP 的预训练相当于在一个有 32768 个类别、每个类别只有一个样本的代理数据集上训练视觉主干——每个 batch 就是一个这样的数据集,文本就是类别描述。
这个视角也解释了 CLIP 的能力边界。分类器完全由文字决定,那么文字没描述到的属性,模型就没有理由去编码;文字描述得含糊,分类器就含糊。反过来,只要能用一句话说清楚的类别,不需要任何训练样本就能构造出对应的分类器,这正是「零样本」三个字的实际含义。
原理详解(一):双塔怎么搭
图像塔:ResNet 与 ViT 两条路
CLIP 没有只押注一种视觉骨干,而是同时训练了 ResNet 系列和 Vision Transformer 系列,共 5 个 ResNet 变体和 3 个 ViT 变体。这个选择本身有工程意义:ResNet 在边缘设备和 CPU 上更成熟,ViT 在精度上更有潜力,两条路线可以互相验证对比目标本身是否与骨干无关。
ResNet 版本不是原版 ResNet-50。论文做了三处修改:采用 ResNet-D 中对 stem 和降采样路径的改进,加入抗混叠的 rect-2 模糊池化(antialiased blur pooling),以及把最后的全局平均池化换成注意力池化(attention pooling)。
前两处修改针对的是下采样带来的位移敏感性:stride 卷积和池化会破坏平移等变性,模糊池化在降采样前先做低通滤波,让特征对像素级的位移更稳定。第三处修改针对的是全局平均池化本身。全局平均池化对所有空间位置一视同仁地取平均,背景占比大的图像里,物体特征会被背景稀释;注意力池化则用一层「Transformer 风格」的多头 QKV 注意力,让查询向量由全局平均池化特征生成,再去对各个空间位置加权。换句话说,它学的是「这张图里哪些位置值得看」,而不是把所有位置等权压平。对于零样本分类这种依赖整体语义的任务,这个改动让图像向量更能代表主体。
ViT 版本基本沿用 ViT 原论文的实现,只加了一处小改动:在 patch 嵌入与位置嵌入相加之后、进入 Transformer 之前,额外加一层 LayerNorm。ViT 把图像切成固定大小的 patch(14、16 或 32 像素),每个 patch 线性投影成一个 token,加上位置嵌入,然后走标准的自注意力堆叠。
模型规模的扩展方式也值得说明。ResNet 系列不是单纯加深或加宽,而是按 EfficientNet 的思路做复合缩放:把新增算力大致平均分配到宽度、深度和输入分辨率三个维度,得到 RN50x4、RN50x16、RN50x64 三个更大的模型。ViT 系列训练了 ViT-B/32、ViT-B/16、ViT-L/14,其中 ViT-L/14 还在 336 像素分辨率上多训练了一个 epoch,记为 ViT-L/14@336px。文本塔不参与这套缩放,只按比例加宽,论文明确说 CLIP 的性能对文本塔容量不敏感——这个观察很重要,它意味着双塔的能力瓶颈几乎全在图像侧。
参数量上,文本塔固定为 6300 万参数;ViT-L/14 整体在 4 亿参数量级,是 CLIP 发布的模型中最大的一个。这个量级放在今天不算大,但它要处理的图像分辨率、patch 数量和文本长度都经过精心权衡,后文会算这笔推理账。
文本塔:一个 63M 的 Transformer
文本塔是一个 12 层、宽 512、8 个注意力头的 Transformer,约 6300 万参数。文本先转成小写,再用字节对编码(BPE)切分,词表大小 49152;序列两端加上 [SOS] 和 [EOS],最大长度截断到 76 个 token。
最终用来做对齐的,是最高层在 [EOS] 位置的隐藏状态,经过 LayerNorm 之后再线性投影到共享嵌入空间。为什么取 [EOS] 而不是把所有 token 平均池化?因为文本塔用的是带因果掩码的掩码自注意力:每个位置只能看到它之前的 token,只有 [EOS] 这个位置能看见整句话。如果改成双向注意力再做平均池化,理论上也能得到句子表示,但论文保留了掩码结构,理由是它保留了「用预训练语言模型初始化文本塔」或「加一个语言建模辅助目标」的可能性,虽然这些探索被留作后续工作。这也是 CLIP 与 BERT 式编码器的一个细节差异:同样是 Transformer 编码器,CLIP 的文本塔在结构上是自回归的,只是不拿它生成。
把最大长度卡在 76 也有明确的成本考虑。图文对里的文本大多是短句,长文本只会让注意力成本按长度平方增长;而在零样本分类时,文本塔要为每个类别名编码一次,如果类别有几千个、每段文本又很长,构造分类器的开销会迅速变得不可忽略。
投影与共享嵌入空间
两个塔的输出各自经过一个线性投影,映射到同一个维度的嵌入空间。ViT 系列的嵌入维度是 512;ResNet 系列随模型规模不同,维度也不一样。这里有一个容易被忽略的设计选择:CLIP 只用了线性投影,没有用 SimCLR 那样的非线性投影头。论文的说法是,在 4 亿图文对的数据规模下过拟合不是主要矛盾,线性与非线性投影在训练效率上没有观察到差别;而在自监督学习里非线性投影之所以重要,是因为它要与图像增强的细节共同适配。
得到两个向量之后,分别做 L2 归一化:
其中 是第 张图, 是第 段文本, 是图像塔(含线性投影), 是文本塔(含线性投影)。归一化之后,两个向量的内积就是余弦相似度,取值范围落在 :
归一化的作用不只是「让相似度可比」。它把向量的模长信息丢掉,只保留方向;如果不归一化,模型可以靠放大某个塔的输出模长来降低损失,而不是真的把语义对齐。归一化之后,唯一的尺度参数就只剩温度 ,这使得后面的 softmax 尖锐程度可以被单独控制。这也是为什么 CLIP 的相似度矩阵可以直接解释成「方向的一致性」。
原理详解(二):InfoNCE 为什么是这样写的
从「分类」的角度看对比损失
把相似度矩阵的第 行取出来,乘上温度并做 softmax,就得到一个概率分布:
这个分布回答的问题是:给定第 张图,它属于 段候选文本中哪一段?真实答案是 ,所以这一行的交叉熵损失是:
这就是多分类交叉熵的标准写法,只不过类别不是预定义标签,而是「同一个 batch 里的其他文本」。把 行平均,得到「图找文」方向的损失。同理,把矩阵的列拿出来做 softmax,得到「文找图」方向的损失。两个方向平均:
这个形式在对比学习文献里叫 InfoNCE。它的名字来自信息论视角:让模型在 个候选中认出正样本,本质上是在最大化正样本对之间的互信息下界; 越大,下界越紧。这个视角对理解「为什么 CLIP 需要超大 batch」很有帮助,后文会回到这一点。
为什么要用对称的双向损失?如果只优化「图找文」方向,模型只需要让每张图找到自己的文本,完全可以不去约束「文本找图」——比如让所有文本向量挤在一个小锥形区域里,任何图像都容易区分出自己那一段,而反过来查询时排序就乱掉了。对称损失要求 矩阵的对角线同时是每一行的最大值和每一列的最大值,两个方向都会受到约束。论文里用的词是「对称交叉熵」,数学上就是把同一个矩阵对行、对列各做一次 softmax。
梯度在做什么
把损失对相似度的梯度写出来,可以看到 InfoNCE 的力学结构。对单行损失,设权重 ,有:
正样本那一格的梯度是「」,是一个负数,会把 往上推;负样本每一格的梯度是「」,全是正数,会把 往下压。负样本受到的推力正比于它当前获得的 softmax 概率。
这个式子揭示了对比学习的核心动力:一个负样本越难区分,它分到的概率越大,被往下压的力度越强;已经很容易区分的负样本,概率接近零,几乎不产生梯度。换句话说,模型不断在挑当前最难的负样本去处理,这正是对比学习区别于普通分类的地方。普通 softmax 分类器在训练后期,错误类别的概率都已经很低,梯度趋于消失;对比学习同样会遇到这个问题,所以需要足够多的负样本维持难度。
batch 大小与「负样本的来源」
在 InfoNCE 里,负样本就是同一个 batch 中的其他样本。batch 为 时,每张图面对 个负文本,每段文本面对 个负图像。 越大,负样本越多,任务越难,学到的表示越有判别性。这就是 CLIP 使用 32768 这种超大 batch 的根本原因;它不是为了让梯度更稳定,而是为了让负样本池足够大。
但 直接决定了相似度矩阵的规模 ,当 时,矩阵有超过 10 亿个元素。论文在训练时不得不把相似度计算分片:每张 GPU 只计算本地 batch 与其他分片之间的那部分相似度,再把结果汇总。开源复现 OpenCLIP 里能看到同一机制的具体形态:分布式训练时先把各卡的图像、文本特征 all-gather 到一起(gather_features),再在完整 batch 上算相似度矩阵。这也是双塔结构训练时的一个隐性成本——两个塔各自的编码可以分片并行,但相似度矩阵是一个全连接的结构,规模化它的开销主要落在通信和显存上。
工程上还有另一个解决「负样本池不够大」的小技巧,叫队列(queue):把前几个 batch 的样本向量缓存下来,当成额外的负样本使用。MoCo 就用这个方法让小 batch 也能有大量负样本。但 CLIP 没有采用,因为队列中的向量相对当前编码器是「过时」的,需要动量编码器来维持一致性;在 4 亿数据的规模下,直接开大 batch 更简单。
温度 :可学习的「对比难度」
温度 出现在 softmax 里,起的是「尖锐度」的调节作用。 越大,相似度差异被放大,softmax 越尖锐,模型只盯住最难的负样本; 越小,分布越平缓,所有负样本都获得可观的梯度。
论文没有把 当成超参数来调,而是把它作为一个可学习的标量,在训练中直接优化。实现上,为了避免它取负值或变得离谱,CLIP 把它存成对数形式( 参数化),再用一个乘法标量表示,并做了裁剪,使得 logits 的缩放倍数不超过 100。论文说这个裁剪是为了防止训练不稳定。初始化值对应 ,即 ,这是从 Wu 等人 2018 年的对比损失工作里沿用的初值。这个细节可以直接对照 OpenCLIP 的实现:logit_scale 是一个 Parameter,前向时先 .exp() 再乘到相似度矩阵上,损失里用 F.cross_entropy 对两个方向分别计算。在源码里,这个裁剪对应 logit_scale 的上界(默认值 100)。
为什么 需要可学习?不同规模的负样本池、不同噪声水平的图文对,需要的「对比难度」不一样。数据里的描述噪声很大时,很多文本其实也部分描述了这张图,它们不应该是「硬负样本」,温度要调低一些;数据干净、负样本都很容易时,温度要提高,让最难的几个负样本压得更狠。让模型自己学这个参数,比人工调参更直接。
训练配方里的其他选择
CLIP 的训练配方相对于同时代的自监督工作显得很「素」。没有复杂的图像增强,只有随机方形裁剪加缩放这一种;没有非线性投影头;文本侧不做随机句子采样;温度是学出来的。论文给出的理由基本都是「数据量太大,过拟合不是主要问题」。
- 优化器用 AdamW,权重衰减只作用于非 gain、非 bias 的参数,学习率余弦衰减;
- 训练 32 个 epoch,混合精度 + 梯度检查点 + 半精度 Adam 统计量,都是为了在有限的显存里塞下更大的模型;
- 文本塔权重用了半精度随机舍入,进一步节省显存;
- 由于 32 epoch 在 4 亿数据上已经是 128 亿次图文对训练,论文认为不需要额外设计更多数据增强来防止过拟合。
这些选择在今天的 CLIP 复现里大多被保留了下来,OpenCLIP 的默认配方与论文基本一致,只是在大 batch 下的分布式策略上做了更工程化的处理。理解这些「素」的选择,有助于判断哪些技巧是 CLIP 这个规模下的特化优化,哪些是可以迁移到小规模场景的通用方法。温度可学习、只做简单裁剪这两条在中小规模复现里依然常见;而超大 batch 与分片相似度计算则是规模化带来的必然负担。
原理详解(三):零样本分类到底怎么算
构造分类器
给定一个包含 个类别的分类数据集,CLIP 不做任何训练,而是把类别名套进一个模板,构造出文本:
"A photo of a {class}."对每个模板实例做分词、截断、编码,取 [EOS] 位置的投影向量,再 L2 归一化,得到 个文本向量 。这些向量就是分类器的权重。和线性分类器的区别在于,它们不是从数据中学出来的,而是从文本语义中「生成」的。
推理时,一张图像编码成 之后,计算它与每个类别向量的余弦相似度,乘温度,softmax,取概率最大的类别:
论文说,这个预测层在数学上就是一个输入 L2 归一化、权重 L2 归一化、没有 bias、外加温度缩放的多元逻辑回归。区别只在于权重由文本生成。
这里有一个非常关键的工程结论:分类器一旦构造出来就可以缓存,对所有后续图像复用。论文的原话是这个成本可以「摊销」。假设一个 1000 类的数据集,文本塔只需要跑 1000 次(或 1000 × 模板数 次),之后每张图只需要跑一次图像塔加一次内积。与「每张图都重新构造一遍分类器」相比,这是三个数量级的差别。这个摊销结构,直接决定了 CLIP 在向量检索类服务里的成本模型。
prompt 模板为什么有效,又为什么是「零成本的增强」
CLIP 的预训练数据里,文本绝大多数是完整的句子,而不是孤立的单词。直接用类别名「dog」编码时,文本塔看到的是一个它很少在预训练中见到的输入形式:一个没有上下文的单词。模板「A photo of a {label}.」的作用是把类别名放回它熟悉的分布里:句子描述的就是图像内容。仅这一条模板,在 ImageNet 上就带来了 1.3 个百分点的提升。
多义词是另一类问题。ImageNet 里既有建筑用的吊车(crane),也有飞行的鹤(crane),两者的类别名完全一样,文本塔无法区分。牛津宠物数据集里的 boxer,既可以指拳击手也可以指一种狗。模板提供了语境:「A photo of a boxer, a type of pet.」时,boxer 的词义就被限定在宠物上。论文针对不同数据集推荐了一些变体:
- 细粒度分类(宠物、食物、飞机):加上类别所在的种类,「a type of pet」「a type of food」「a type of aircraft」;
- OCR 相关的任务:把待识别的文字或数字加引号,帮助模型聚焦到文字上;
- 卫星图像:用「a satellite photo of a {label}.」,把图像的来源也写进提示。
这些模板背后是同一个逻辑:把类别名放进它实际出现的那种文本环境里。文本塔对输入的措辞很敏感,因为它把整句话压成一个向量,任何词的选择都会改变这个向量的方向。
模板集成:在嵌入空间里做平均
既然模板有这么大的影响,自然会想到用多个模板。CLIP 的做法是把若干模板(如「A photo of a big {label}」「A photo of a small {label}」)生成的文本向量直接求平均,得到一个集成后的类别向量。在 ImageNet 上,用 80 个模板做集成,比单个默认模板又提升了 3.5 个百分点;算上模板本身的 1.3 个点,相对直接用类别名总共提升了接近 5 个点。
这个「接近 5 个点」的量级,论文与「用四倍算力训练基线模型」的提升相比较,并称其在这个意义上是「免费的」:因为集成的是一次性构造分类器的成本,摊销到整个数据集上是可忽略的。
这里有一个必须强调的设计细节:集成发生在嵌入空间,而不是概率空间。如果先对每个模板的预测概率做平均,那么每张图必须跑一次文本塔的预测,缓存的优势就没了;在嵌入空间平均,可以把平均后的向量缓存为一份「集成分类型器」,推理时仍然只有一次图像塔加一次内积。这就是为什么论文说集成的计算成本与单一分类器相同——前提是摊销足够多的预测。
一个具体的推理账本
把零样本分类的推理成本写成公式,可以更清楚地看到双塔的取舍。假设图像分辨率为 ,patch 大小为 ,图像塔有 层、隐藏宽度 、注意力头数 ;文本长度为 ,文本塔有 层、宽度 。忽略常数,一次前向的主要成本可以粗略写成:
- 图像塔自注意力:(token 数的平方 × 维度 × 层数);
- 图像塔 MLP 与 patch 投影: 量级;
- 文本塔自注意力:;
- 零样本打分: 次乘加(每个类别一次内积)。
关键在最后一个项。打分成本与类别数 成正比、与每张图的 patch 数无关;在一个 1000 类的数据集上,、,一次打分是 50 万次乘加,相比图像塔的运算量几乎可以忽略。真实部署里,主要成本永远在图像塔本身:ViT-L/14@336px 一张图是 24 × 24 = 576 个 patch,每层全注意力的开销就是 量级,这是把 CLIP 部署到单卡上时最先遇到的瓶颈。
把图像侧分开看,可以看到 CLIP 的服务成本具有「一次编码、多次查询」的形状:图像编码一次,结果向量就可以拿去和任意多个类别、任意多个文本查询比较。这与生成式多模态模型的「一次编码、一次生成」完全不同,后者的成本集中在解码循环和 KV 缓存上。CLIP 没有 KV 缓存,也没有解码循环,它的服务成本结构更接近一个向量数据库:一次性编码是重计算,查询是轻计算。
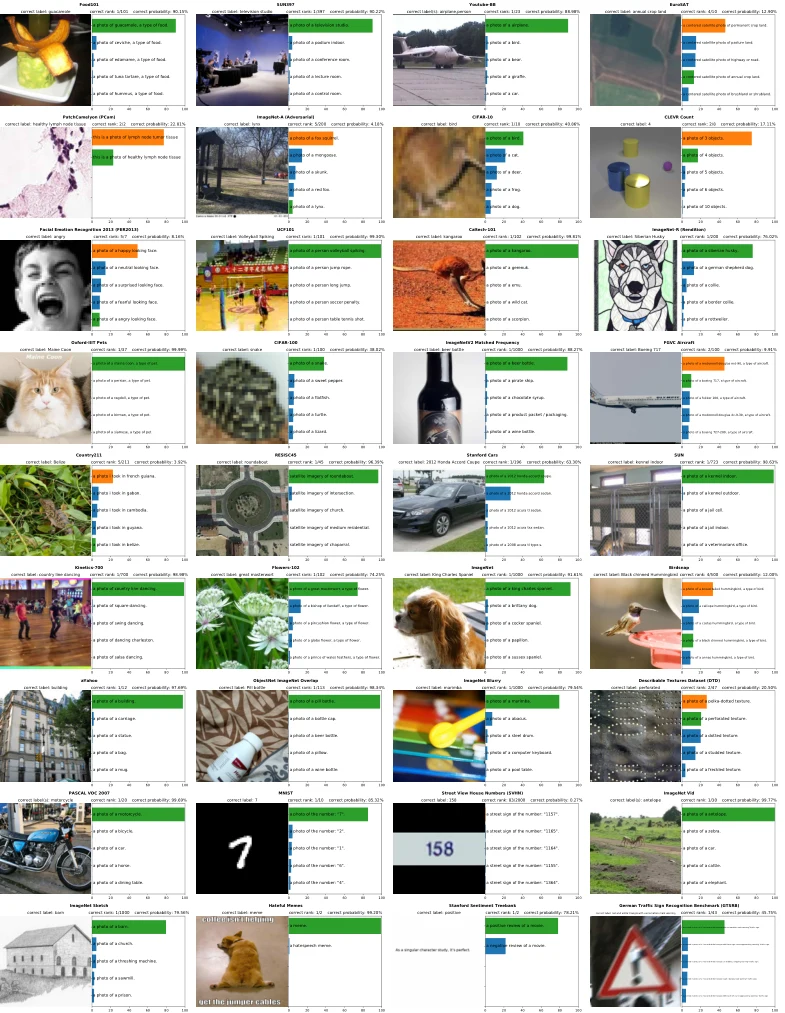
这张图展示了 36 个零样本分类器在各类数据集上的实际预测:每张样本下方列出前五个类别及其概率,正确预测标绿、错误标橙。可以看到,在食物、鸟类、车辆等整体语义特征强的数据集上,CLIP 的预测与语义高度一致;而在 MNIST 这类依赖细微笔画的数据集、以及部分细粒度数据集上,橙色明显增多。这张图直观解释了前面成本账本之外的一个事实:零样本分类的准确率取决于类别描述与图像语义的对齐程度,而文本塔把整句话压成一个向量,句子中没写到的细节,分类器就抓不到。这既是对 CLIP 能力边界的说明,也是对 prompt 设计的重要性——类别名字的措辞,直接决定了分类器「看到」什么。
零样本的实际水平:能打平 ResNet-50,但不是万能
按上述流程,CLIP 最好的模型 ViT-L/14@336px 在 ImageNet 上取得 76.2% 的零样本 top-1 准确率,top-5 是 95%。这个数字与原版 ResNet-50 的全监督结果恰好持平——后者用了 128 万张带人工标签的训练图,而 CLIP 没有用任何 ImageNet 训练样本。
论文还给出了一组更细的对照。在 27 个数据集的评测里,零样本 CLIP 在 16 个数据集上超过了「在 ResNet-50 特征上拟合逻辑回归」的全监督基线。在 Stanford Cars 和 Food101 上领先超过 20 个百分点;在动作识别类数据集上,Kinetics700 高出 14.5 个百分点,UCF101 高出 7.7 个百分点。论文推测动作类的优势来自自然语言监督对动词的覆盖——ImageNet 的标签几乎全是名词,而互联网文本里动作描述很常见。
反过来,它也有明确不擅长的领域。卫星图像分类(EuroSAT、RESISC45)、淋巴结肿瘤检测(PatchCamelyon)、合成场景计数(CLEVRCounts)、德国交通标志识别(GTSRB)、车距估计(KITTI Distance)都明显低于监督基线。这些任务要么需要专业领域的细粒度特征,要么需要空间计数、尺寸判断这类双塔不容易保留的信息。论文也承认:零样本评测对「学习者完全没有先验」的复杂任务未必是公允的评测方式。
还有一个容易被忽略的对照:零样本 CLIP 与少样本线性探针的表现相当。论文发现零样本 CLIP 大致等同于在同一个特征空间上训练 4 个样本的逻辑回归。这个结果有点反直觉——用语言直接「描述」类别,和从四个样本里「推断」类别,效果居然在同一水平。论文的解释是:从样本推断概念存在歧义,一张图里包含多个视觉概念,一两个样本无法说明「要学的是哪个」;而语言描述可以直接把概念说清楚。这个观察对理解 CLIP 的定位很重要:它提供的不是更强的特征,而是一种更直接的「指定任务」的接口。
分布偏移下的鲁棒性
CLIP 论文里最值得关注的结论之一,是零样本分类在分布偏移下的表现。图 13 把最好的零样本 CLIP 模型与「在 ImageNet 验证集上准确率相同」的 ResNet-101 做对比,后者是标准的全监督模型,两者在 ImageNet 上都是 76.2%。
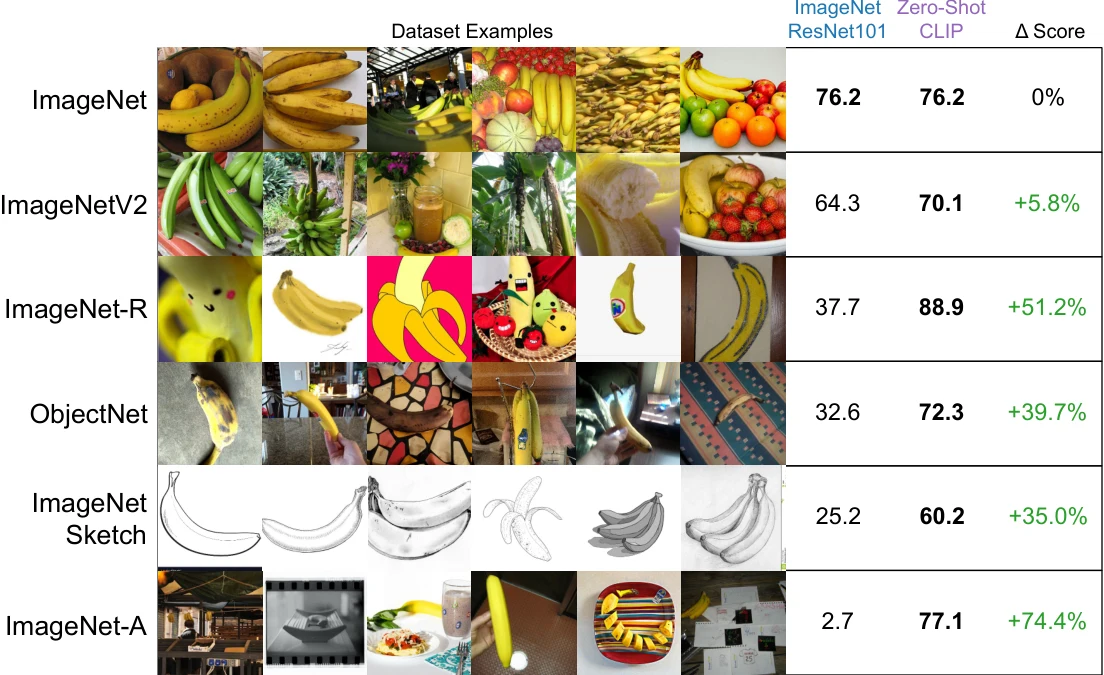
图右侧的表格给出了六个数据集上的数字:ImageNetV2 上 CLIP 70.1%、ResNet-101 64.3%;ImageNet-R 上 88.9% 对 37.7%;ObjectNet 上 72.3% 对 32.6%;ImageNet Sketch 上 60.2% 对 25.2%;ImageNet-A 上 77.1% 对 2.7%。也就是说,在「同分布准确率完全一样」的前提下,零样本 CLIP 在强分布偏移下的准确率高出几十个百分点。论文把这种现象称为「有效鲁棒性」(effective robustness),并指出零样本 CLIP 把鲁棒性差距缩小了最多 75%。
为什么零样本分类会更鲁棒?一个直接的解释是:它根本没有对这 1000 个 ImageNet 类别做参数拟合。全监督模型在 ImageNet 上学到的判别边界,会利用数据中大量只在 ImageNet 分布内成立的虚假相关;零样本分类器的权重来自语言,语言描述的是概念本身,不是某个数据集的采集偏差。这个解释与论文的另一组实验相互印证:如果把 CLIP 在 ImageNet 上做全监督适配,ImageNet 准确率提升了 9.2%,但平均鲁棒性反而略有下降(图 14)。适配带来的收益,正好是用鲁棒性换来的。
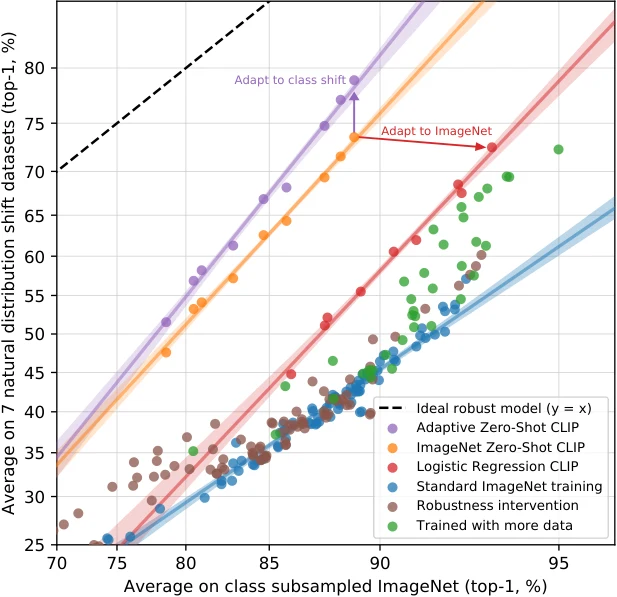
这张图把「鲁棒性干预」的效果画在一张散点图上:横轴是类别子采样 ImageNet 上的平均准确率,纵轴是分布偏移数据集上的平均准确率,虚线是理想鲁棒模型 。自适应零样本 CLIP 的点落在靠近虚线的位置,而标准 ImageNet 训练和用更多数据训练的点都明显低于虚线。图中还标出了「Adapt to ImageNet」这一干预:它把横轴推高,但纵轴几乎不动,意味着那 9.2 个点的 ImageNet 提升没有转化为鲁棒性。这条实验的工程含义很直接:如果你的目标是部署到与训练分布不同的真实场景,用少量数据微调 CLIP 的分类头可能不如直接用零样本文本分类器。
工程实现:从权重到服务
预处理必须对齐。 CLIP 的图像预处理是:把短边缩放到 224(ViT-L/14@336 是 336),双三次插值,再中心裁剪到正方形,最后按通道归一化。OpenAI 版本使用的均值是 ,标准差是 。这组数值来自 CLIP 仓库,很多复现因为用了 ImageNet 的均值方差而导致精度下降几个点。文本侧要对齐的是小写化、BPE 分词、加 [SOS]/[EOS]、截断到 76 个 token;中文场景通常需要替换成多语言文本塔,否则 BPE 词表覆盖不足。
温度不要写死成 100。 很多教程在推理时把 logit scale 固定为 100,理由是「CLIP 分类时温度很低」。这个做法对 argmax 没有影响——温度是正数,对所有类别同乘一个正标量,排序不变。但它会改变概率值的分布:固定成 100 会让 softmax 极度尖锐,几乎变成 one-hot,概率无法用于阈值判断或多标签打分。正确做法是从 checkpoint 读取学习到的 logit_scale(OpenCLIP 里是 model.logit_scale.exp()),需要校准概率时再在验证集上做温度缩放。这个细节在检索场景里尤其重要,因为检索常常要用相似度分数做召回阈值,而分数尺度直接受温度影响。
双塔可以分开部署。 图像侧与文本侧不共享计算图,可以分别跑在不同的硬件上。常见形态是:离线用 GPU 批量编码图库,把向量写入向量数据库或 ANN 索引;在线只跑文本塔编码查询,再做近邻搜索。这套链路的成本模型是「一次编码 + 多次查询」,与生成式多模态模型完全不同。以 512 维、fp32 的嵌入为例,一个向量占 2 KB;一亿张图就是 200 GB,换成 fp16 是 100 GB,再叠加乘积量化(PQ)可以压到几十 GB 量级。这决定了 CLIP 类检索系统的容量上限与索引设计。
类别多时,文本塔的批量编码是主要开销。 构造零样本分类器要对每个类别(乘模板数)跑一次文本塔。文本塔只有 6300 万参数,单条 76 token 的前向大约是数 GFLOP 量级;1000 个类别、80 个模板就是 8 万次前向,放在单卡上也要几秒到几十秒。工程上通常离线构造一次、缓存成矩阵,线上只做矩阵乘法。若类别集合会变,则要按变化频率决定是否重建。
图像侧的 patch 数量才是延迟大头。 ViT-B/32 在 224 分辨率下是 个 patch,ViT-B/16 是 ,ViT-L/14 是 ,ViT-L/14@336 是 。自注意力的成本随 token 数平方增长,所以从 256 到 576,注意力部分涨了约 5 倍;线性层(QKV、MLP)随 token 数线性增长,涨了约 2.2 倍。按 Transformer 的乘加次数粗算,ViT-L/14 在 224 下每张图约 次乘加(约 FLOP),336 下约为其 2.4 倍。这解释了为什么高分辨率 CLIP 在服务端要配更大的 batch 或更激进的量化。
多标签场景不要直接用 softmax。 CLIP 的零样本分类默认是互斥的多分类:softmax 归一化后只有一个 argmax。如果任务允许一张图同时属于多个类别(例如「狗」和「户外」),更合适的做法是把多分类的 softmax 交叉熵换成对每个「图像-类别」对独立的二分类交叉熵(即 sigmoid 损失),每对各自给一个独立的概率再按阈值判定;这正是 SigLIP 改用 sigmoid 损失后支持的做法。直接用 softmax 会强行把概率质量分给互斥类别,导致阈值不稳定。
下面这段代码是零样本分类的核心,与 OpenCLIP 的 ClipLoss 结构一致,只是把训练时的对称损失换成了推理时的打分:
import torchimport torch.nn.functional as F
@torch.no_grad()def zero_shot_logits(model, images, class_texts, templates, logit_scale): # 1) 构造分类器:每个类别 × 每个模板,编码后归一化 text_embeds = [] for template in templates: tokens = model.tokenize([template.format(c) for c in class_texts]) emb = model.encode_text(tokens) text_embeds.append(F.normalize(emb, dim=-1)) # 在嵌入空间做模板集成:先平均,再重新归一化 classifier = F.normalize(torch.stack(text_embeds).mean(dim=0), dim=-1)
# 2) 图像编码,形状 [B, d] image_embeds = F.normalize(model.encode_image(images), dim=-1)
# 3) 打分:温度只影响概率尺度,不影响 argmax return logit_scale.exp() * image_embeds @ classifier.t()
logits = zero_shot_logits(model, images, class_texts, templates, model.logit_scale)probs = logits.softmax(dim=-1) # 互斥多分类pred = probs.argmax(dim=-1)这段代码有两个容易踩的坑。第一,model.logit_scale 是学习出来的参数,不同 checkpoint 的值不同,直接硬编码 100 会让概率分布失真。第二,模板集成必须先平均再归一化;如果先归一化再平均但不重新归一化,得到的向量模长小于 1,打分尺度会整体变小,与单模板分类器的分数不可比。
对比目标的变体:从 InfoNCE 到 sigmoid 损失
CLIP 之后的对齐模型大体沿用双塔,改动最多的是损失函数。ALIGN 在 2021 年证明,用 10 亿级、未经严格清洗的噪声图文对配合对比损失,同样能训练出高质量的视觉语言表示;这条路线把「数据规模」推到了比 CLIP 更大的量级,说明对比目标对标签噪声的容忍度很高——配对判断只需要整体语义匹配,不需要描述逐字准确。
影响更大的是 SigLIP。它把 InfoNCE 的「多分类」视角改成了「逐个配对的二分类」视角:对矩阵里的每一个格子,不再和其它格子竞争 softmax 概率,而是独立地判断「这一对是否匹配」,用 sigmoid 加偏移项:
其中 是 sigmoid 函数, 表示 是真实配对(对角线), 表示非配对, 是一个可学习的偏置,用来补偿「一个 batch 里正样本只有 个、负样本有 个」的极端不平衡。论文还把温度放进 sigmoid 内部,并且让 这一项在对角线上取 、非对角线上取 ,形式与原始论文一致。
这个改动看起来只是把 softmax 换成了 sigmoid,但它对工程有实际影响。softmax 需要在整个 batch 上做归一化,所以每个 GPU 都必须看到全部 batch 的相似度;sigmoid 损失可以逐块计算与累加,不需要 all-gather 一个完整的 矩阵,分布式实现更轻。论文报告 SigLIP 在同等算力下训练出的模型精度更好,并且在小 batch 下也能较好工作——因为负样本不再是「batch 内竞争」的对象,而是被逐对监督。论文的核心发现可以概括为:把 softmax 换成 sigmoid 损失,在批量规模与算力效率上都有明显收益。
对读者理解 CLIP 来说,SigLIP 的意义是反衬:它说明了 CLIP 的许多工程特性——超大 batch、分片相似度矩阵、可学习温度——不是双塔结构本身的要求,而是 InfoNCE 这个具体损失的要求。换掉损失,这些约束会随之改变。今天大量开源的视觉塔(包括许多多模态大模型用的 SigLIP 视觉编码器)沿用双塔结构,但损失已经不再是 CLIP 原始的对称交叉熵。
局限:双塔对齐能做什么、不能做什么
CLIP 的能力边界几乎都可以从「整图一个向量、整句一个向量」这个结构推导出来。
第一,它不擅长组合性与关系判断。 两张图分别是一只狗追一个人、一个人追一只狗,两段文本分别描述这两种关系;每张图的整体语义都很接近这两段文本的整体语义,余弦相似度难以区分哪个搭配正确。词序、属性绑定(红色的杯子与蓝色的盘子、蓝色的杯子与红色的盘子)也有同样的问题:文本塔把句子压成一个向量,词袋式的整体语义占主导,句法结构的信息被稀释。后续的 Winoground 类基准专门测试这种能力,CLIP 系列模型的表现接近随机水平。
第二,计数、空间位置、细粒度定位弱。 图像塔最后把所有 patch 池化成一个向量,位置的精确信息在这个过程中被压缩。问「图里有几个苹果」「杯子在电脑左边还是右边」,CLIP 只能给出整体语义上更像哪个描述的分数,而不是真正去数、去定位。这是双塔结构的结构性限制,不是训练数据不够。
第三,文字识别与排版敏感。 CLIP 的预训练文本来自网页描述,图像里的文字并不是监督目标。实践中一个著名的现象是排版攻击:在苹果旁边贴一张写着「iPod」的标签,模型会把它判成 iPod,因为视觉特征里混入了文字的形状,而模型没有学会「标签文字不是物体本身」这个概念。OCR 类任务在零样本下普遍偏弱。
第四,类别名字的质量决定了上限。 零样本分类的权重完全由文本生成,类别名写得不准确、有歧义、或者根本缺失,分类器就好不了。论文提到 Flowers102 和 GTSRB 的发布版本甚至没有提供类别编号到英文名的映射,导致无法做零样本迁移。这不是模型的问题,而是任务定义的问题:CLIP 把「类别语义」的负担转移给了使用者。
第五,它没有生成能力,也没有细粒度 grounding。 CLIP 不能描述图像、不能回答问题、不能给出「这个词对应图里哪个区域」。它只输出一个匹配分数。这也是后续工作分化的起点:BLIP 在同一时期加入了跨注意力与生成头,既能做检索也能做描述;LLaVA 把 CLIP 的视觉塔接上投影层和大语言模型,用语言模型补上推理与生成;ImageBind 把双塔对齐扩展到六种模态,用图像作为锚点把音频、深度、热成像等模态拉到同一个空间。
第六,零样本的鲁棒性优势有前提。 前面看到,零样本在分布偏移下明显更稳,但这个优势建立在「分类器完全由语言生成」之上。一旦在目标数据集上做微调,优势会迅速消失;少样本 CLIP 的鲁棒性介于零样本与全监督之间。这意味着「用 CLIP 提特征再训分类头」这种常见做法,拿到的是更强的特征,但不再是那个对分布偏移免疫的零样本分类器。
数据层面的偏见与滥用风险同样存在。WIT 来自互联网,图像与文本都带有采集偏差;论文专门用两节讨论偏见与监控相关的影响。这些不是架构问题,但部署时需要单独评估。这里不展开,因为它们与本文要讲的计算机制是两条线。
小结
把 CLIP 的机制收拢成四句话:
- 共享空间靠归一化余弦相似度定义。 两个塔各自输出一个向量,L2 归一化后内积就是相似度;模长信息被丢弃,尺度只由温度控制。这保证了两个模态在同一个几何空间里可比。
- 目标是对称 InfoNCE。 一个 batch 构成一个 的匹配矩阵,对角线是正样本;行、列两个方向各做一次 softmax 交叉熵再平均。负样本来自 batch 内其他样本,因此 batch 越大,任务越难、表示越有判别性。温度 是可学习参数,控制 softmax 尖锐度,并在训练中被裁剪以防不稳定。
- 零样本分类器由文本生成。 类别名套模板、过文本塔、归一化,就得到分类器权重;这是一次性成本,可以缓存并摊销到所有预测。prompt 模板与嵌入空间集成是几乎零边际成本的精度提升手段。
- 推理成本高度不对称。 图像塔是重计算,类别打分是轻计算;双塔解耦使得「离线编码、在线查询」成为可能。CLIP 没有解码循环、没有 KV 缓存,它的服务形态是向量检索,而不是生成。
CLIP 的历史地位不在于它今天还是不是最强的视觉语言模型,而在于它把「用自然语言指定任务」这件事变成了一个可计算、可缓存、可部署的接口。今天大多数多模态大模型的视觉编码器仍然是 CLIP 或其变体,而零样本分类的那套流程——模板、文本嵌入、余弦打分——已经成了视觉语言系统里最基础的一段代码。理解了这段代码的成本结构与几何含义,再看后来的 SigLIP、BLIP、LLaVA,就能分清哪些是结构上的新东西,哪些只是把同一套对齐机制换了一个损失函数或接了一个更大的语言模型。
参考资料
- CLIP: Learning Transferable Visual Models From Natural Language Supervision
- OpenAI CLIP 官方仓库
- OpenCLIP: 开放复现与训练框架
- Representation Learning with Contrastive Predictive Coding(InfoNCE 来源)
- An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale(ViT)
- Learning Visual N-Grams from Web Data(Visual N-Grams)
- Sigmoid Loss for Language Image Pre-Training(SigLIP)
- Scaling Up Visual and Vision-Language Representation Learning With Noisy Text Supervision(ALIGN)
- BLIP: Bootstrapping Language-Image Pre-training for Unified Vision-Language Understanding and Generation
- Momentum Contrast for Unsupervised Visual Representation Learning(MoCo)
- Hugging Face Transformers 的 CLIP 文档
- ImageBind 架构拆解:一个联合嵌入空间如何装下六种模态
文中插图取自 CLIP 论文 arXiv 版本的 Fig. 1、Fig. 13、Fig. 14 与 Fig. 21,均已在本地转换为 WebP。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



