


PrefixSim 完全拆解:生产轨迹重放、留洞命中与计算节省率如何算准前缀缓存收益
为什么需要一台“前缀缓存专用的模拟器”
前缀缓存(prefix cache)已经是推理服务的默认配置。vLLM 的 Automatic Prefix Caching 按块哈希匹配最长公共前缀,SGLang 的 RadixAttention 用基数树组织已完成的请求,命中时直接跳过这段 prefill。只要请求之间存在公共前缀——系统提示、few-shot 示例、多轮对话的历史、Agent 循环里的工具返回——这部分矩阵乘就可以省掉。
真正难的问题不在一块块怎么存、怎么找,而在两件事上:
- 满了以后淘汰谁,决定了命中率;
- 命中的那块 KV 能省多少算力,决定了 TTFT 的下降幅度。
这两个问题都可以用“把一段真实请求轨迹灌进缓存、看它表现如何”的方式回答。但通用缓存模拟器(例如 libCacheSim 这类以 key-value 对象为单位回放轨迹的工具)直接拿来用会得到系统性错误的数字。原因不在实现细节,而在模型假设:普通缓存的对象彼此独立,前缀缓存里一个请求的所有块却必须同时驻留才能被服务。
本文围绕一个针对这个问题写的模拟器来展开:PrefixSim。它由 Yiyu Liu、Minlan Yu、Juncheng Yang 在 2026 年 9 月发布,配套论文是 When Fancy Eviction Fails: Rethinking Cache Replacement For LLM Prefix Reuse。论文的结论层面——十四种复杂算法为什么赢不了 LRU——站内已有专文分析,可参考 前缀缓存淘汰完全拆解:为什么 14 种复杂算法赢不了 LRU。本文换一个视角:从模拟器的建模出发,逐层拆开它是怎么把“一个请求必须整体驻留”这件事编码进服务循环、又是怎么把 block hit ratio 换算成 compute-savings ratio 的,以及这套建模与真实引擎(vLLM / SGLang)之间还剩哪些差距。
先交代它的定位:这是一个基于 libCacheSim 的 C++ 模拟器,论文报告它评估出的命中率与原生 vLLM 引擎非常接近,而相比 vLLM 的 Python 实现最多有 160 倍的评估加速。它不试图替代引擎,只把“给定轨迹和策略,缓存会怎样演化”这一层单独拿出来,做成可复现、可批量扫描的组件。理解它怎么做到这一点,比记住某条曲线更有用。
问题定义:普通缓存模型为什么会低估命中
先把模拟器要解决的问题讲清楚,后面的设计才有落脚点。
一个请求是一串有序的块
在前缀缓存里,一个推理请求不是单个对象,而是一个有序的块列表:
其中 是 prompt 的第一个 16-token 块(离根最近), 是最深的一块。轨迹文件里每个请求记录的就是这一串 block_id,按前缀顺序排列。要服务这个请求,引擎需要这些块全部物化在显存里:驻留的直接复用,缺失的做一次 prefill 写进新分配的槽位。
注意这里“缺失的”是中间缺洞,不一定是尾部缺失。假设缓存里存了 ,唯独 被淘汰了。这个请求照样能服务:用缓存的 起算,prefill 出 ,再从缓存里直接拿 接上。只要块的身份是“从根到它的整条路径”,缓存的 就是请求需要的那个 ,与 是否在缓存里无关。
通用模拟器错在哪
libCacheSim 的对象模型是“一次访问,查一下在不在”。为了模拟“整个请求要一起驻留”,最直观的写法是先腾出空间,再访问:
while (free_space < request_size) { cache->evict(cache, req);}这段循环有一个致命的盲区:淘汰逻辑不知道正在到来的是哪个请求。它会愉快地挑出这个请求马上要复用的块淘汰掉,把一次本来成立的命中变成一次 miss。请求越长、缓存压力越大,这种“自己淘汰自己要用的东西”的情况越多。
论文与仓库文档都把这称为 self-eviction。它不是实现细节里的偶发 bug,而是模型层面的系统性偏差:用这种写法跑出来的命中率会一致偏低,而且偏差随压力增大而放大。PrefixSim 的修法很朴素,但需要把请求“暴露”给分配步骤——下一节就进入它的服务循环。
服务循环:match → allocate → access
PrefixSim 的核心抽象只有三句话:每个请求作为一个整体被服务,分三个阶段完成,统计只取第一阶段的结果。
阶段一:match(只读,产出全部统计)
按前缀顺序逐个探测请求 的每个块是否驻留。这里不关心请求内部是否连续——遇到第一个 miss 也不停止。一个请求 到来时若只有 缺失:
request: A B C D Ecache: hit hit miss hit hit模拟器记 4 次命中,只把 算作需要重算的块。这一段是“留洞命中”(hit past a gap)。它是否成立取决于块身份的编码方式:在默认的 --block-id prefix 下,每个块的 id 名字本身就是从根到它的整条路径(由 (parent id, raw id) 对做精确 interning,块 id 按首次出现顺序编成 1、2、3…),两个块共享 id 当且仅当整条路径一致。所以被缓存的 恰好就是本请求需要的 。
这一步之所以重要,是因为它同时产出 hit ratio 与 compute-savings ratio——两者都在分配之前测,因此描述的是“请求到达时看到的缓存”,不会被服务它时产生的抖动污染。
阶段二:allocate(腾挪,且只把有效淘汰计入进度)
请求需要 个空闲槽位, 是去重后的缺失块数。已有空闲数为 cache_size - occupied,缺的槽位是:
然后按如下规则淘汰:
progress = 0while progress < needed: victim = evict() if victim in alpha: self_evicted += 1 # 不算进度 else: progress += 1为什么“淘汰掉请求自己要用的块”不算进度?因为它同时做了两件事:释放一个槽位,又给请求增加一个必须插入的块。净收益为零。这段算术是精确的:设命中 个、缺失 个、自我淘汰 次、有效淘汰 次,则第三阶段要插入 个块,而空闲槽位是 , 刚好抵消,剩余 。
阶段三:access
用普通的 cache->get() 把请求回放一遍,让策略按它惯常的方式感知这次访问。因为第二阶段预留了恰好数量的槽位,这里不应发生任何淘汰;如果发生了,会被记为 n_unexpected_eviction 并报警——这意味着记账和算法的行为对不上了。
self-eviction 与 pinning
把自我淘汰“不计进度”保证了算术正确,但淘汰确实发生过,策略内部的状态已经被污染了。一个在第一阶段被匹配上的块,如果被淘汰又通过 insert() 重新插入,多队列策略会把它按新块重新接纳:S3FIFO 的主队列淘汰不写 ghost 条目,块会落回小队列,几乎立刻又是淘汰候选;TwoQ 丢失 Am 成员资格;FIFO 和 Clock 反而被“续命”到队头,命中率被虚高。
真实引擎没有这个问题:在途请求的块有引用计数,压根不会被选作 victim。PrefixSim 现在也这样做:在第二阶段期间安装一个 pin 谓词,淘汰时跳过被 pin 的对象,第三阶段开始前再移除。
但 pinning 只能尽力而为(best-effort)。如果某个队列里的对象全被 pin 了,仍然会取原候选——否则会死锁:S3FIFO 的 ghost 队列、TwoQ 的 Aout、ARC 的 B1/B2 本身就是 FIFO/LRU 实例,它们看到的是同一个 pin 集合,而 cache_get_base() 会循环直到腾出空间。残留的自我淘汰数就是 n_self_eviction,它衡量“还有多少污染没被挡住”。
pin 感知能力挂在 LRU、FIFO、Clock、Sieve、SLRU 这些共享构件里,因此用它们拼出来的复合策略(S3FIFO 族、TwoQ、W-TinyLFU、QDLP、S4-FIFO)自动继承。自己实现 victim 选择的算法(LFU、GDSF、LHD、ARC、MRU、partial_node 与 session 族)则不支持 pin,模拟器在跑完后会检查计数非零并告警。LIRS 被标记为 unsafe:它的 LIRS_prune() 会直接读栈尾再调用 evict() 并期待那个对象被淘汰,跳过 victim 会让两边失步。文档强调这张 pin_safe 表是跑轨迹验证出来的,不是假设的。
回放顺序:为什么默认从最深的块开始
第三阶段回放时每个块被访问的先后,决定了它们在 recency 有序结构里的相对新旧。默认 --replay-order deepest-first:最深(最私有)的块先触,前缀根最后触。
理由是对称的:前缀根是缓存里最值钱的块,被所有共享同一 prompt 的请求复用;最深块最私有。如果按前缀顺序回放,根先触、落在 LRU 队尾,recency 策略就会优先淘汰复用价值最高的块。反过来最深先触,根停在 MRU 端,淘汰从远端向内啃,这也让驻留集合尽可能保持前缀连续。
文档给了一个诚实的量化:在 16k 块、uniform 成本、开 pinning 的设置下,LRU 因这个顺序多出 0.0014 的命中率,TwoQ 多出 0.0010;效果在 1e-3 量级、且并非对所有策略都为正——slru、random_compute_small_queue 反而略降。所以它是一个“应该固定住并报告”的配置项,不是白送的收益。belady 是唯一理论上不受影响的策略,可以作为对照。
一个容易被忽略的细节:recency 按请求打时间戳
random_compute、partial_node_* 这些策略按“成本 / 年龄”打分,年龄是 n_req - last_access。如果按块打时间戳,在 deepest-first 回放下,请求的第 块在回放结束时已“老”了 次访问——而 prefill 成本随位置增长(qwen3coder30b_blksz_16 模型是 ),于是 ,成本项恰好被年龄抵消,丢掉了它本该保护的深层贵块。
修法是每请求一个时间戳:在 record_request 里设 request_end_vtime = n_req + n,该请求所有块统一打到这个时刻。效果不小:fi-new 的 16k 块设置下,random_compute 从 0.6071(按块打)变成 0.6378(按请求打),也就是论文里报的数字。
另外 next_access 注释是按正向顺序计算的(request 0 的 block 0 是 vtime 1,block 1 是 2……),而 cache->n_req 按反向回放推进。两者在请求边界一致,请求内部最多差 。这个“请求内偏斜”是有意为之:它让 Belady oracle 从深端淘汰,方向与 recency 策略被反向回放推动的方向一致。
两个钩子:请求上下文先到,块路径后到
通用缓存算法只看到一串对象访问,而前缀缓存策略有时需要知道“这些块属于一次请求”以及“这是一次什么类型的请求”。PrefixSim 给 libCacheSim 加了两个可选回调,原因不只是接口整洁,而是两者有用的时机不同。
record_request 说“哪些块”,在 allocate 之后、access 之前调用:
if (cache_->record_request != nullptr) { cache_->record_request(cache_, request.blocks.data(), n_blocks);}必须在 allocate 之后,因为算法要在下一次请求到来、需要按路径淘汰时已经知道这条路径;必须在 access 之前,因为块还没进缓存,树把路径记为“尚未驻留”,第三阶段的插入再提升它们,树的驻留状态与缓存内容因此不会打架。只有模拟器能提供这个信息——它是唯一知道一次请求在哪结束、下一次在哪开始的组件。
set_request_ctx 说“什么类型的请求”,在 serve() 顶部、第一阶段之前触发:
if (cache_->set_request_ctx != nullptr) { cache_request_ctx_t ctx{request.timestamp, request.category, n_blocks}; cache_->set_request_ctx(cache_, &ctx);}两个钩子而不是一个,是因为如果一个策略按墙钟时间衰减,它在挑选 victim 时需要的是当前时间;如果按工作负载类分别拟合复用时间分布,它需要知道到达的请求属于哪一类。若把这些塞进 record_request,就会恰好晚一个请求。
ctx.timestamp 是 double 秒。request_t::clock_time 本来也能用,但它截断到整秒;KV 块的生命量级约 100 秒,同一秒内到达的块会塌成一个平局。ctx.category 是不透明 id,由轨迹的 type 与 turn 组合折叠而成——正是 arXiv:2506.02634 所说的 request category;它刻意不透明,因为“什么样的两个请求同类”是轨迹的属性,模式知识留在读取器里,算法只做相等比较。0 表示轨迹没带这两个字段,消费者应读作“单一未区分类”。
指标与成本模型:命中率不是省下来的算力
两个指标,同一段代码
| 指标 | 含义 |
|---|---|
block_hit_ratio | 块访问中命中驻留的比例,不论它在前缀的什么位置 |
compute_saving_ratio | 同样的计数,但每块按其 prefill 成本加权,省下的成本占总成本的比例 |
两者都在第一阶段测。第二个指标的引入,本质是承认同样的块大小,代价不同。
成本模型
成本被建模为块在请求中位置 的函数(0 起),这是轨迹里唯一的计算信号:
--cost-model | 成本 | 说明 |
|---|---|---|
linear:A,B | 任意 Transformer:每块 prefill FLOPs = 固定部分(投影、MLP)+ 随上下文增长的注意力部分 | |
table:FILE | 文件第 行 | 实测成本,一行一个整数 |
uniform(默认) | compute-saving 等于 hit ratio | |
position | 从根重建这个块所需的重算量 | |
qwen3coder30b_blksz_16 | Qwen3-Coder-30B 在 16-token 块上的实测每块 prefill 成本 |
linear:A,B 的形式来自 Transformer prefill 的结构:一块的 prefill FLOPs 由与位置无关的部分(QKV 投影、O 投影、MLP)加上注意力部分组成,后者需要这个块里的 token 去 attend 它之前的全部上下文,所以随位置 单调增长。qwen3coder30b_blksz_16 的斜率只有 2,范围很窄——文档自己承认:在这种模型下,成本感知策略与成本无关策略的排名会很接近。
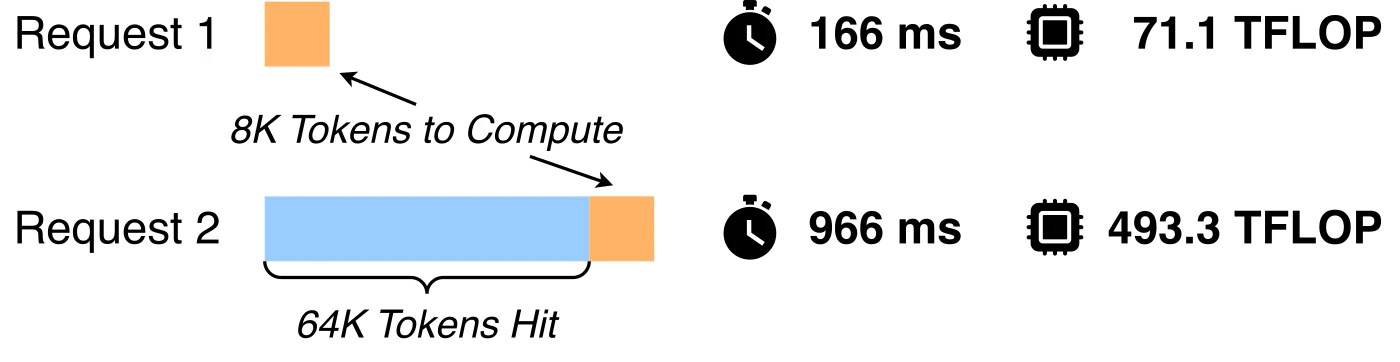
上图(论文 Figure 8,Qwen3-Coder-30B,NVIDIA H200)说明的正是“位置决定代价”这件事:两个请求都要计算 8K token,但第二个必须额外 attend 64K 个已缓存 token,注意力 kernel 里那部分 KV 读取与注意力乘加的代价随上下文变长而上升,于是它的重算更贵、TTFT 更高。只要 KV 缺失发生在更深的层,同一个“缺一块”的标签背后就是不同的代价。
--dump-holes:命中率之外的形状
命中率告诉你复用了多少,hole 分布告诉你复用的形状。一个洞是请求必须重算的一段连续块,即缓存给出的答案里的一处缺口。模拟器可以按算法各写一个文件:
prefixsim --trace qwen_coder_blksz_16_pos.jsonl --cache-size 8k \ --algo lru,partial_node_random_compute --dump-holes holes_logs/每行是 Request i: (idx: 位置, len: 洞长)。同样的命中率下,一条长尾巴和遍布缺口的 prompt 对引擎是完全不同的工作负载。文档里 LRU 在 8k 块设置下平均每请求只有 1.00 个洞,partial_node_random_compute 是 1.01 个、但最大值到 7——后者偶尔会在中间打洞。所有洞长之和可以复现 miss ratio,证明 dump 与统计同源、不会扰动模拟。
轨迹格式:让一次正向扫描就是完整模拟
模拟器的另一条主线是把轨迹流式化。这看起来是工程优化,实际上是让模拟器可用与否的分水岭。
JSONL 的问题
源轨迹是 JSONL,一行一个请求、带时间戳和 hash_ids。它是前缀缓存模拟的原始形态,但有一个结构性缺陷:没有存储“下一次访问”。Belady 类 oracle 读 next_access_vtime,session oracle 读 session 的下一次请求——这些都是未来信息,需要一次覆盖全轨迹的反向 pass 才能算出来。结果就是整条轨迹必须驻留内存:文档给出的数字是 fi-new 约 12.9 GiB(每块访问约 21 字节)。
一个策略一次跑一遍不算夸张,但做参数扫描时每个策略一个进程,就要各自 12.9 GiB。
lcp 格式
lcp(“libCacheSim prefix”)是为此设计的二进制格式,结构极简:
┌──────────────────────────────────┐│ header (8192 B) │ 读一次├──────────────────────────────────┤│ request record (68 B) │ ┐│ block entry (16 B) × n_blocks │ ┘ 一个请求├──────────────────────────────────┤│ request record ││ block entry × n │└──────────────────────────────────┘小端、紧凑布局,读者从不向前看:读一个 record 得知 n_blocks,读那么多 entry,输出,重复。没有偏移表、没有 seek,所以可以流式读取,也可以原样穿过 zstd 解压流。
请求记录 68 字节,关键字段包括 start_time_us、complete_time_us(块在这时注册进全局缓存并变得可复用,请求按它排序,因此后续 turn 一定在它扩展的请求之后)、chat_id / parent_chat_id、session_next_req、session_id、n_blocks、input_length / output_length、turn、type_id。块条目 16 字节:block_id(u64)与 next_access_delta(i64)。
未来信息被存成差分
每个 lcp 文件都带“下一次访问”,存法是同请求内相邻条目之间的差分:
next = 0for each block entry of the request: next += next_access_delta # 该块的下一次访问位置后续 turn 逐块复用父请求的前缀,所以相邻块的 next access 是相邻位置;一段再也不会被访问的块则全程是 -1。在仓库覆盖的每条轨迹里,超过 99% 的差分是 1 或 0。存差分不是为了省位宽,而是为了可压缩性:以绝对值存时,每个 next access 都是一个不同的 8 字节数,zstd 几乎压不动;fi-new 的 .lcp.zst 会从 72.5 MiB 膨胀到 1.33 GiB。
next_access_vtime 在全轨迹正向展开的访问序上计数(与 cache->n_req 一致);session_next_req 则按文件顺序计请求数。两者都是 1 起,-1 表示永不。
块身份:位置编码 + 精确 interning
块 id 是位置编码的并且稠密:两个条目共享 id 当且仅当块及其整个前缀相同,id 按首次出现顺序编成 1、2、3…。lcp 转换器只写这种 id,所以消费者没有选择权,--block-id raw 在 lcp 文件上是错误。
JSONL 读取器接受原始 hash_ids,而约定是文件自身的属性、不能假设——这就是 --block-id 存在的原因。默认 prefix 模式下按 (parent id, raw id) 对精确 interning。文档记载:早期用滚动 boost::hash_combine 折叠,在检查的五个 LLM 轨迹里有四个发生碰撞(每条 2 到 46 个被合并的前缀),因为它几乎不混合连续整数。raw 只在轨迹 id 本身已经是前缀唯一时才正确;qwen 轨迹不是——qwen_traceA_blksz_16.jsonl 里有 16,686 个 id 出现在多于一个前驱之下,52,168 个出现在多于一个位置,raw 会把不同路径合并成一个对象,8k 块下 LRU 被高估到 0.1450(应 0.1404)。文档的结论很清楚:prefix 永远不是更冒险的选择,raw 是唯一可能错的那个。
从文件到缓存:libCacheSim 之上补了什么
PrefixSim 的算法库来自 libCacheSim(一个构建启用了 LRB、3LCache、S4-FIFO 时有 46 种算法,不启用时 43 种)。但要让这些为通用缓存写的算法在前缀缓存里正确工作,补了三处。
驻留状态要问算法,而不是读主哈希表
算法认为“驻留”的集合,不总是 cache->hashtable 里的内容。S3FIFO 族把块放在带独立表的小缓存里,直接探测会报“不在”;ARC 和 LIRS 在主表里保留 ghost 条目,直接探测会报“在”。正确做法是调 cache->find(req, update_cache = false)。libCacheSim 已经用 update_cache 门控每个修改操作,所以只要算法自己的 find 也遵守,不修改的查询就不会记录任何东西。
这件事曾暴露两个算法的 bug:GDSF(以及 gdsf_compute)在每次查找时推进时钟,RandomCompute 在每次查找时重打 last access。后果不是“看起来像查找”:第一阶段屏蔽了被匹配的块,效果如 pin;驻留检查又把请求每个块都打上“结束时刻”的戳。RandomCompute 现在正确地遵守 pin,并有意给请求所有块同一个时间戳(见上一节);没有后半部分,修掉查找副作用会让它在 fi-new 的 16k 设置下掉 3 个点。
分配不依赖 victim 身份
自我淘汰的拆分需要知道每个被淘汰对象的身份。cache_evict_base() 已经在每次真实淘汰时调用 prefetcher->handle_evict,所以模拟器装了一个只做记录、不预读的 prefetcher。诱人的替代方案——调用 evict() 前先 to_evict() 偷看——是错的:RandomCompute、RandomComputeSmallQueue、BeladyCompute 等采样算法在 evict() 内部重新采样,而不是复用 to_evict_candidate,偷看到的是另一个对象。
复合算法会在小缓存内部淘汰,没有 victim 身份可用。这条路径上重新探测一次请求即可同时恢复剩余缺口与精确的自我淘汰数,只损失速度;n_unobserved_eviction_round 记录何时走了这条路。
一次 evict() 不一定释放任何东西
S3FIFO 族的一次淘汰可能只是把块从小队列提升到主队列,占用不变;cache_get_base 会再调一次直到腾出空间,分配循环也如此,只在 n_obj + 16 次调用后仍无释放时才报“无进展”。另有两个算法存在真正停滞的路径并已在原地修复(各自验证过 cachesim 的 miss ratio 不变):CAR 只在缓存满时淘汰,分配阶段“提前腾出空间”打破了这一前提;LIRS 的 1% 驻留 HIR 上限会淘汰在途请求的块(deepest-first 下最深的块作为最老的 HIR 进入),LIRS.c 现在在请求回放期间 pin 住它的块。
批量淘汰与 micro / drain
缺口在分配开始时就知道大小,所以算法若提供 cache->evict_n(),循环会一次要完剩下的量,而不是一次一块。采样算法每次调用付出采样代价,(按文档数字) partial_node_random_freq 在 8k、128 样本下批量后快 6 倍、命中率四位小数内相同;也几乎让运行时间与样本量无关。
partial-node 算法把这一批分成两种模式:micro(默认,最多 micro-batch=64 块,然后重采样重打分)与 drain(整段缺口)。micro 就是论文里的局部节点淘汰:一次削一块相当于引擎批处理预算的大小,再看一次。在一个请求能占满大半个缓存时它很重要——fi-new 16k 下 partial_node_random_compute 的 micro 省 0.6380,drain 是 0.6333;micro 多花约五分之一的墙钟时间。
一个刻意的排除:admission control
clockpro 被排除,理由不在模拟器而在前缀缓存本身。普通对象缓存里,拒绝接纳一个对象是无害的——客户端本来就从后备存储拿到了数据,缓存只是决定不留副本。前缀缓存没有后备存储可读:缓存的“数据”就是 KV 状态,模型只能对物理存在于 GPU 显存里的块做注意力。服务一个请求必须物化它的每个块:缺失的块被 prefill 并写入 HBM,不是从别处拉取。无论策略愿不愿意,块在服务期间都驻留了。
所以前缀缓存策略真正能做的唯一决定是请求结束之后留下什么。“拒绝存储这个块”在使用时刻没有对应物,最接近的可表达行为是随后立刻淘汰——那正是小编队或 quick demotion 惩罚做的事情。这也是为什么回放后的检查要求请求每个块都驻留:它不是严格性设置,而是建模不变量。
小于缓存的请求会被跳过
一个请求若去重后的块数比整个缓存还多,永远无法以此定义的服务方式满足,于是被跳过:对两个比例都无贡献,也不触碰缓存、不淘汰任何东西。n_req_skipped 记录数量。
这值得告警,因为它静默地改变了比例的平均对象:缓存大小低于轨迹里最大的 prompt 时,最难的请求恰好被丢掉,对所有策略都是同等“美化”的。被跳过的请求也不会进入 next access 注释,所以 oracle 只对真正被服务的请求做规划。
RESULT 行里的四个诊断
一次运行最后打印的 RESULT 行不只有两个比例,还有四个字段决定这次数字能不能信:
| 字段 | 含义 |
|---|---|
n_req_skipped | 去重块数比整个缓存还大的请求;被排除在所有比例之外,并且不被触碰(跳过不淘汰任何东西);每轮运行告警一次 |
n_eviction | 分配阶段淘汰的对象数 |
n_self_eviction | 其中正是到达请求自己需要的块;高值意味着策略在反复丢弃它马上要重读的东西,这正是“先腾空间再访问”那种写法在暗中付出的代价。开启 pinning 后,遵守 pin 的策略接近 0(剩下的就是尽力而为 pinning 的残留),不遵守的策略可能很大;非 0 时模拟器会告警 |
n_unexpected_eviction | 回放阶段的淘汰。必须为 0;否则说明分配算术与算法行为不一致,这次运行不可信 |
这四个字段把“模拟器看起来跑完了”与“这次结果有意义”区分开。尤其是 n_self_eviction:它衡量的不是命中率,而是策略实现与在途保护语义的贴合程度。一个不认 pin 的策略仍然会产出两个比例,但它的后续决策建立在被自我淘汰污染的内部状态上,跨策略比较时需要打折扣。
速度从哪来:流式读取与差分编码
三个数字把节省说清楚。单线程、AMD Threadripper PRO 7975WX、64k 块缓存、跑 freeinference 轨迹的一次 LRU:
| 输入 | 文件大小 | 时间 | 峰值内存 |
|---|---|---|---|
| JSONL | 6.79 GiB | 169 s | 12.9 GiB |
.lcp | 9.80 GiB | 103 s | 80 MiB |
.lcp.zst | 72.5 MiB | 105 s | 146 MiB |
三种格式结果完全相同。.lcp.zst 的峰值内存大部分是 zstd 的 128 MiB 解压窗口,不随轨迹增长。这组数字解释了两件事:
- 差分编码是压缩的前提,而不是可选的技巧。前面说过,以绝对值存 next access 会让 fi-new 的压缩文件从 72.5 MiB 膨胀到 1.33 GiB;一旦未来信息本身是“逐块差 1 或 0”的规律序列,zstd 才能把索引部分压到接近轨迹本身的规模。
- 流式是扫描的前提。一次策略对比往往跑十几个算法,每个算法各自顺序读一遍
.lcp.zst只需要 146 MiB 常驻,一台机器上并行跑多个进程也不会互相抢内存;换成 JSONL,每个进程都要先加载并反向注释一份 12.9 GiB 的结构。
代价也很直接:lcp 必须在转换期一次性算出 next access,所以 traceConvLLM 本身仍要用一次反向 pass 和足够内存;但这件事只做一次,之后所有策略、所有容量点都受益。把一次性的昂贵预处理与可重复的廉价扫描分开,是这类评估框架能跑大参数扫描的根本原因。
三层容量、两套时钟
“同一策略在不同容量上表现不同”这句话要成立,前提是把容量层级写清楚。论文与模拟器统一了两组参照:
| 层级 | 容量范围 | 块数(16-token 块) | 典型意义 |
|---|---|---|---|
| 单副本 HBM | 24–120 GiB | 16,384 / 32,768 / 65,536 | 直接供注意力 kernel 读取;24 GiB 是原生上下文下限,48 GiB 对应 1×H200 的 0.8 显存比例,96 GiB 对应 1×B200 的 bf16 权重 |
| 全局 DRAM/SSD 池 | 0.25–12 TiB | 699,051(1 TiB) | 为 GPU 预取或远程拉取可复用 KV;1 TiB 是 Mooncake 的全节点 |
块数按 Qwen3-Coder-30B 的 bf16 KV 长度折算:一块 16 token 约 1.5 MiB,1,024 块约 1.5 GiB。低于 24 GiB 不太实际,因为驻留约束会严重压短可服务的上下文。12 TiB 池按 16-token 块要索引约 840 万条目,这正是 Mooncake、LMCache 这类系统把粒度放宽到 256–512 token 的原因之一。
模拟器的时间轴也有两套:n_req 是块访问序(Belady 与 *_compute 的 oracle 用它),session_next_req 是请求序(session_belady 用它)。belady 与 session_belady 优化的是不同目标、数字不可能相同;把两者放在一张表里比较时,要先确认它们各自以哪个时钟为准。
算法光谱:从通用策略到会话级淘汰
PrefixSim 跑的策略大致分三层。
通用与计算感知
通用策略来自 libCacheSim 的经典集合——lru、fifo、clock、sieve、slru、lfu、arc、twoq、lirs、wtinylfu、s3fifo、s3fifod、gdsf、lhd 等,外加需要未来信息的 belady,以及需要编译选项才可用的 s4fifo、lrb、3lcache。
计算感知这一组(belady_compute、gdsf_compute、lhd_compute、random_compute、random_compute_small_queue)把每块按“命中它能省的 prefill 计算量”加权(--cost-model)。其中 BeladyCompute 是离线近似,是实际可实现的上界参考。
文献里的前缀缓存策略
--algo | 论文 | 信号 |
|---|---|---|
workload_aware | arXiv:2506.02634,KVCache Cache in the Wild(ATC’25)§4.2 | 按工作负载类的复用概率,再看前缀偏移 |
asym_cache | arXiv:2606.02964,Multi-Segment Attention §4.2–4.5 | 期望重算成本与墙钟寿命 |
两个实现都有值得注意的前提。asym_cache 需要位置相关的成本模型:它的 是论文式 7,在前缀位置上线性,正是 qwen3coder30b_blksz_16 计算的东西;在 uniform 下 为常数,策略退化为 LRU——论文自己也这么说(“若所有缓存块的重获成本为均匀常数,我们的算法退化为常规 LRU”),所以那个组合什么也测不出。
asym_cache 还跑在墙钟上,这就是全部故事。论文把复用时间分布定义在秒上,寿命 取 P99;若在块时钟上拟合, 会落在几千万块之外,超过任何缓存,于是所有驻留块的 , 变平,策略坍缩成成本加权 LRU——不再是被测的东西,所以只保留秒时钟。
两个策略都需要每请求元数据,因此同时安装 set_request_ctx 和 record_request。在没有这两者的驱动(纯 cachesim / 测试套件)下,它们退化为每次访问一个 tick、单一工作负载类——足够正确,但丢掉了有意思的部分。
会话级淘汰
session_lru、session_s3fifo、session_arc、session_belady、session_random_compute 淘汰一个对话而不是一个块,共享 libCacheSim 的 sessionCache.cpp 机制,只在选哪个会话上不同。
一个块并不只属于一个会话——fi-new 上 25% 的唯一块出现在多个会话中,覆盖 34% 的访问——所以“淘汰一个会话、释放它的块”会从仍然活跃的对话底下抽走块。做法是:每个会话认领它当前这一轮的块,只要至少一个认领存在块就驻留,淘汰一个会话只释放认领计数归零的块。一个会话的可淘汰大小因此是它的私有集合,随着其他会话 fork 出去又离开而移动。
认领差分还做了一件块级策略做不到的事:一轮先认领整条新路径、再释放旧路径,按这个顺序,两边都持有的块先 +1 再 −1,从不被释放又重接纳。当 256k token 的上下文滑动时(罕见,但 P99.9 里一轮掉了 6,891 块),所有留下的块一次性释放、立即可淘汰,而不必等到自然老化。
session_belady 是会话粒度的 oracle:淘汰下一次 turn 最远的会话,用轨迹里的 session_next_access。它与块级 belady 优化的是不同的东西,数字不会相同。
会话这一层在论文里对应什么
论文 5.3 节把会话结论落在容量尺度上:会话足迹的强尾部(4.5 节)与“容量过剩时收益极小”这两个观察,共同决定了淘汰粒度要与容量适配——HBM 用块级管理,避免大会话的 all-or-nothing 决定;大内存池则可以用会话级淘汰换取元数据效率、而几乎不损失命中。模拟器里会话级策略的存在,让这个判断可以被直接测出来,而不是只停留在叙述上;session_belady 与块级 belady 的差值,就是这两层目标函数不可互相替代的直接证据。
与真实引擎的距离
一台模拟器只要跑得快、数字对,就容易让人忘了它的模型边界。以下几处差距决定了它的数字该怎么读。
引擎的匹配停在第一个 miss。 vLLM 与 SGLang 目前遇到第一个缺失就停止匹配,会重算缺失块之后的所有块。这是匹配方式的限制,不是前缀缓存的限制。一个能跨过缺口匹配的引擎,省下来的正是 PrefixSim 报告的;同一策略在 vLLM / SGLang 上跑会有更少的节省——凡是策略留下洞的地方,差距就会出现。反过来,当缓存大、命中率高时两者差别很小。
块之间没有淘汰依赖。 块是独立对象,策略可以淘汰一个块而保留它后面的块,后者仍被正确地计为命中。以基数树构建的缓存(如 SGLang)只淘汰叶子,因此永远不会保留没有父节点的子节点;PrefixSim 不施加这个顺序。这使得它测的是“物理淘汰与逻辑前缀树解耦”的理想情形。
没有时间模型。 timestamp 会进入 req->clock_time,但回放按请求顺序进行;没有批处理、调度或并发。附录图以并发度为一个轴,那是对受约束场景的另一层刻画,不是服务循环本身的模拟。
不是所有策略都遵守 pin。 真实引擎会用 refcount 保护在途请求的块,PrefixSim 在第二阶段 pin 住它们,但只有部分策略遵守;其余仍可能淘汰它们,由 n_self_eviction 计数。统计不受影响(在第一阶段取),但策略后续的决定不是:自我淘汰的块会经 insert() 重新进入。
JSONL 轨迹全量驻留内存(每块访问约 21 字节,fi-new 12.9 GiB),因为 next access 要反向 pass 计算;转成 lcp 才能流式。
结果该怎么读
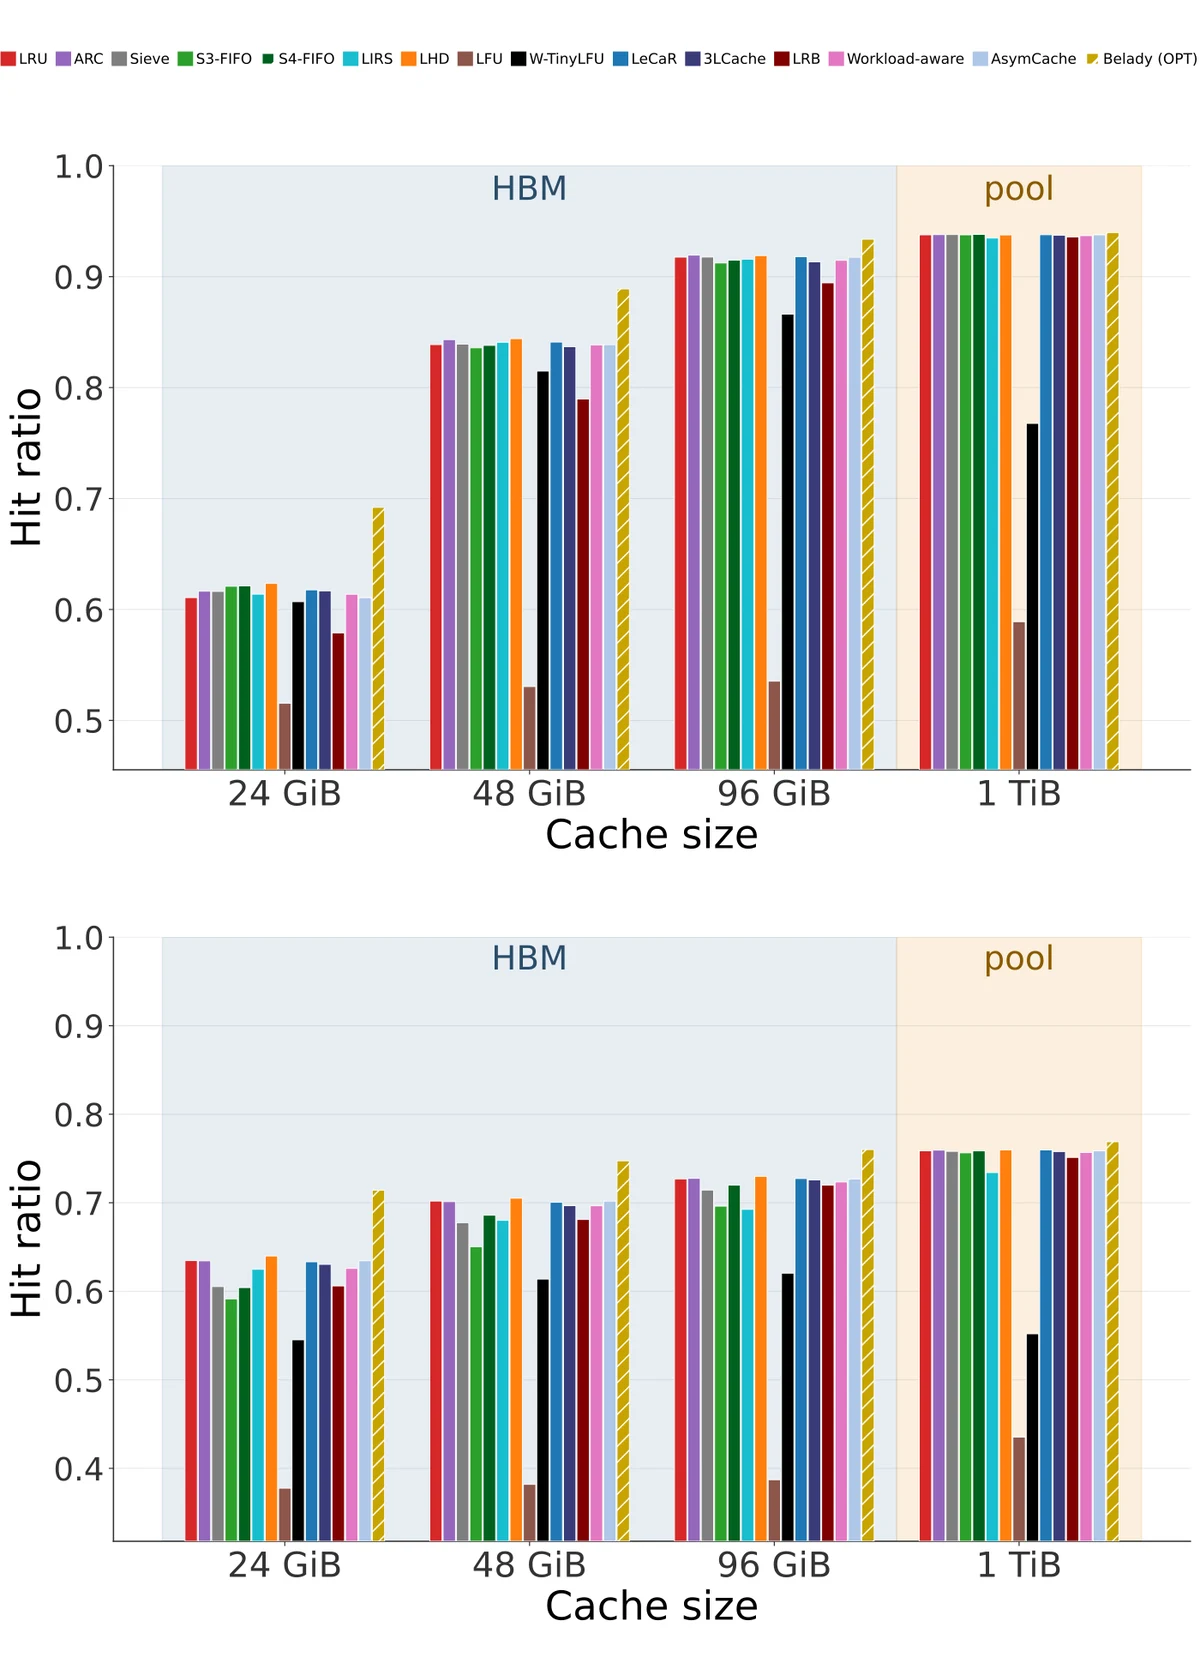
上图(论文 Figure 2 的两个面板,上为 FreeInference Trace、下为 Chutes Trace,横轴从 24 GiB 的 HBM 一直到 1 TiB 的 DRAM/SSD 池)展示了论文最反直觉的结果:在每一个容量点上,没有一种先进算法稳定胜过 LRU,而 Belady 离线最优始终留出一段可观的上界空间。频率导向的一族在许多点上甚至明显更低。解释不在算法优劣,而在访问结构——块的生命通常被会话截断,复用间隔短而集中,recency 因此是一个异常强的预测器;而频率主要记录会话已经进行了多少轮,对“下一轮何时来”几乎不提供信息。
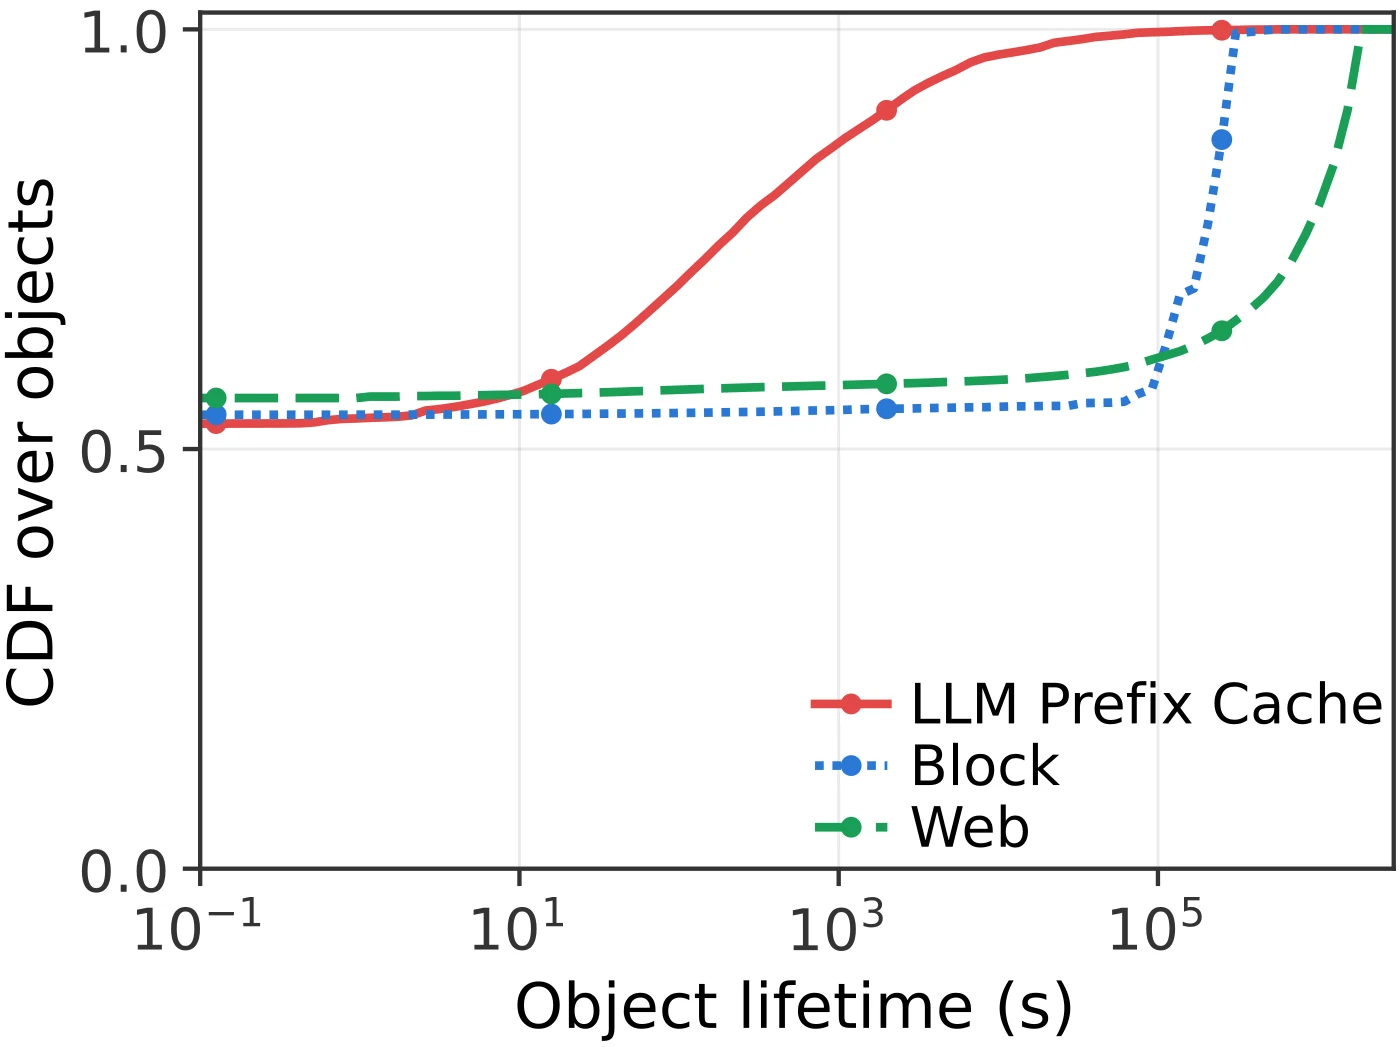
上图的 CDF 把这一点画成可比较的形状:LLM 前缀缓存的对象寿命以分钟计、由会话界定,而 Web 缓存和块存储的对象寿命以天计、带有持久的“热核”。这正是“把为 Web CDN 设计的复杂策略直接搬过来”会失效的根源。
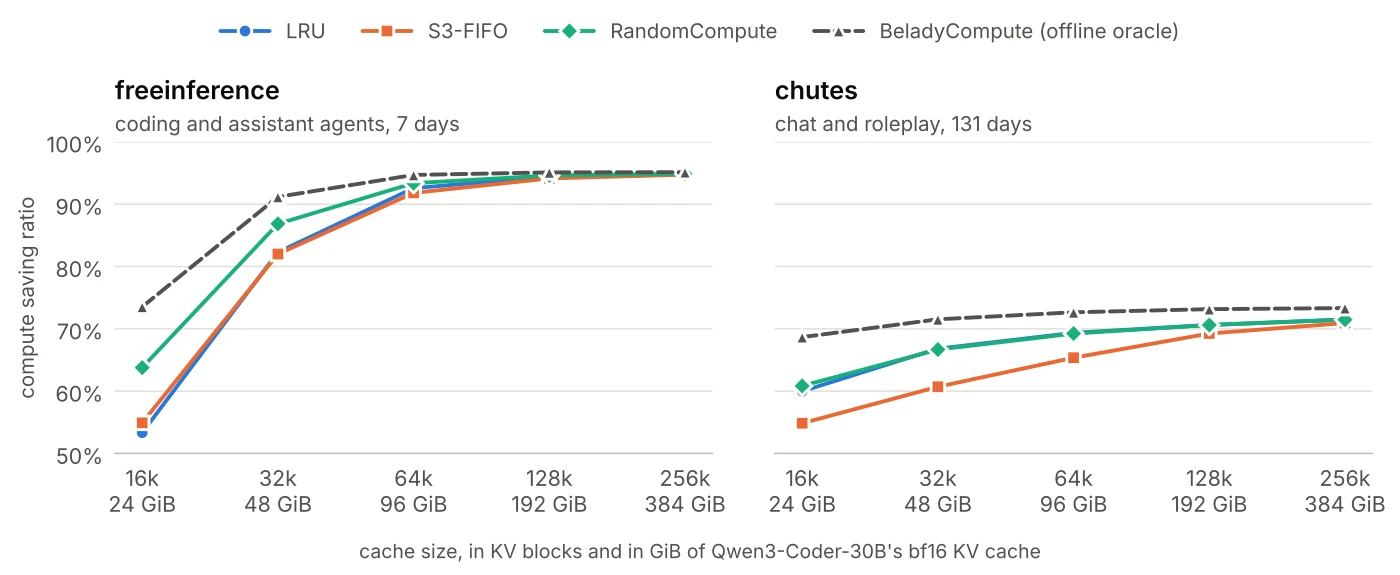
上面这张来自仓库文档的图把指标本身的差异画了出来:只改指标、不改算法,曲线就换了一副样子。按文档报告的数字,在 16k 块(Qwen3-Coder-30B 的 24 GiB bf16 KV)设置下,random_compute 的 compute-saving 比 LRU 高约 10 个百分点(0.6378 对 0.5333),而它的命中率更低(0.6068 对 0.6107)。同一个策略在两套指标下的排位反过来——这恰恰说明为什么论文要引入 compute-savings ratio:命中率不预测省下的算力。这个优势在缓存紧张时最宽,从 64k 块起所有策略都省下超过 91% 的 prefill,random_compute 的领先被压到 1 点以内。
Chutes 轨迹上是另一种形状:唯一块是 fi-new 的 3.5 倍,random_compute 从 32k 块起与 LRU 持平,S3-FIFO 落后两者,oracle 在 16k 领先 LRU 9 点、256k 时只剩 2 点。容量越大,简单策略越容易追上——这是读这些曲线时最容易忽略的维度。
端到端验证:模拟里的节省要落到 TTFT 才算数
模拟器的数字最终要在真实引擎上兑现。论文用 Qwen3-Coder-30B、48 GiB 缓存、真实 vLLM 引擎做了端到端验证:以 LRU 为基准,partial-node 计算感知设计把平均 TTFT 降低 19.9%(1.04 s 对 1.29 s),预填吞吐提升 18.8%(65.6K 对 55.2K tokens/s)。机制上也讲得通:它用便宜的浅层命中换昂贵的深层命中,所以中位 TTFT 反而略差于 LRU(171 ms 对 112 ms),但 P99 尾部从 26.0 s 压到 16.8 s。
另一个数字更能说明模拟器存在的意义:不做分片、直接逐块淘汰的 RandomCompute 在模拟里省得更多,但在真实引擎上不可用——它比 LRU 多出 4.0 倍的 TTFT、吞吐只剩约四分之一。原因就是碎片化:RandomCompute 平均每个请求留下 9.21 个洞,长尾可达数百个,每个洞都要单独触发一次注意力矩阵计算的开销,而不同的缺失段之间没有真实计算依赖,本可以拼批并行。partial_node_random_compute 从节点开头成段淘汰、每段对齐系统的连续批处理预算,平均洞数下降约 8.7 倍,把同样多的重算量装进更少更长的洞里,并行瓶颈随之消失,而在 24 GiB 上牺牲的 compute-saving 几乎可以忽略。
这段结果值得单独记住,因为它划出了模拟器指标与端到端收益之间最容易断裂的那一环:模拟器里的 compute-saving 只衡量省了多少算力,不衡量这些算力能不能被引擎高效地并行执行。读模拟结果时,命中率、compute-saving、洞数三者要一起看。
粒度与注意力架构怎么改变成本
论文讨论的另外两处边界,直接回答了两个实际部署里最常见的问题。
淘汰粒度必须匹配内存层级。 论文的会话级对块级对比给出了很明确的量级:在 24 GiB 这类高度受限的缓存下,会话级淘汰是灾难——LRU 掉 10.5 个点命中率,计算感知的 RandomCompute 丢掉高达 18.7 个点的 compute-saving;一个巨型会话吃满缓存却无法被部分修剪,会把许多有价值的会话挤出去。48 GiB 时惩罚仍然存在(LRU 3.3 点,RandomCompute 5.5 点)。而容量增大后,这个惩罚迅速消失,在大池子里块级与会话级的差距几乎测不出来。会话粒度唯一的永久缺陷是跨会话共享:整会话淘汰会连带清掉其他活跃会话还需要共享的系统提示,只是池子足够大时被掩盖。结论因此是:HBM 里严格用块级,大池子里可以按元数据组织的需要自由选择。
注意力架构决定成本谱的位置。 块大小一致,但底层注意力机制让重算成本差异极大。滑窗注意力会随着前缀深度封顶成本增长,目标更接近常数成本;混合注意力模型里,收益随全注意力层占比缩放;GQA、MQA、MLA、跨层 KV 共享与 KV 量化又会改变每 token 的 KV 字节和计算/传输比例。这些对会话层面的访问结构结论大体不影响,但 compute-aware 的具体权重不能跨模型照搬——qwen3coder30b_blksz_16 的斜率 2 只对应一种架构,换成 MLA 或混合注意力的模型,深块与浅块的差距会完全不同。
模拟器该怎么用
如果要把这套工具用在自己的场景里,合理的顺序是:
- 先采集轨迹。至少需要每请求的块哈希、前缀顺序、时间戳、会话 id;要测会话级策略,还需要 turn 编号与请求类型(见
lcp的set_request_ctx语义)。 - 转成
lcp,用traceConvLLM。之后所有策略共用一份流式文件,扫描的开销与轨迹大小脱钩。 - 用 LRU 建基线,跑
uniform与位置相关两种成本模型各一遍。如果两者排位一致,说明成本结构对这一决策不敏感;如果排位翻转,就要单独看 compute-saving。 - 看诊断字段:
n_self_eviction非零说明策略不认 pin,数字里的策略侧行为不可全信;n_unexpected_eviction必须为零;n_req_skipped不为零说明缓存比最大 prompt 还小,曲线上的点平均的是不同的请求集合。 - 开
--dump-holes看形状,再决定是否值得引入 partial-node 或计算感知。 - 端到端时在真实引擎里验证,同时看 TTFT 与吞吐,并与 kernel 支持的访问形状对齐——一个在模拟里省更多 prefill 的策略,如果产生散点驻留、迫使引擎做大量非连续页 gather,端到端可能并不占优。
一个具体细节值得单独说:--replay-order 会改变 recency 类策略的结果,所以任何两个数字只有在同一设置下才可比;RESULT 行并不记录它,需要自己在运行笔记里注明。同理,asym_cache 只在位置相关成本与秒时钟下才有意义。
小结
PrefixSim 的价值不在于多一个缓存算法评测框架,而在于把前缀缓存里几个容易被含糊处理的问题变成可编码、可复现的具体机制:
- 请求级驻留是前缀缓存区别于对象缓存的第一性约束。服务循环把“match 产出统计、allocate 腾挪、access 回放”分清楚,并把“淘汰自己马上要用的块”排除在有效进度之外,用 pinning 让策略侧的状态不被自我淘汰破坏。
- 留洞命中说明块身份是整条路径,命中不必连续;而 vLLM / SGLang 的“停在首个 miss”是匹配方式的约束,不是前缀缓存的极限。
- 命中率不预测省下的算力。
compute_saving_ratio加上位置相关成本模型,把“深块更贵”这件事放进目标函数——这正是复杂淘汰算法与 LRU 排位可能翻转的原因。 - 流的形状比算法名字更重要。
lcp的差分编码让一次正向扫描就是完整模拟,包含 oracle 所需的全部未来信息。 - 粒度要跟随容量:HBM 用块级、大内存池可以会话级;而 admission control 在前缀缓存里没有真正的对应物,因为块必须被物化才能服务。
模型边界同样是结论的一部分:匹配停点、块间无淘汰依赖、无时间模型、部分策略不认 pin。这些不是缺陷列表,而是解读数字时必须携带的前提。把它们先摆出来,比任何一条曲线都更决定这台模拟器能不能真正指导工程决策。
参考资料
- When Fancy Eviction Fails: Rethinking Cache Replacement For LLM Prefix Reuse(arXiv)
- PrefixSim GitHub 仓库
- PrefixSim 设计文档 doc/design.md(服务循环、pinning、指标与限制)
- lcp 轨迹格式规范
- PrefixSim 使用的生产轨迹数据集
- libCacheSim:高性能缓存模拟器与淘汰算法库
- KVCache Cache in the Wild: Characterizing and Optimizing KV Cache Runtime at a Cloud Vendor(ATC’25)
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
- Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM)
- SGLang: Efficient Execution of Structured Language Model Programs(RadixAttention)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



