


世界模型从零讲起(二十一):把物理写进结构——图网络、能量守恒与可组合的动力学
承接前二十篇:三条路线共同跳过的那一层
前二十篇把世界模型拆成了一条比较完整的链。第一篇给出形式定义,把世界模型写成「在内部表征里模拟观测随动作如何演化」的模型;第二篇到第五篇分别拆了重建式(Dreamer 的 RSSM)、联合嵌入(JEPA)、视频生成式(Sora、GAIA-1、Cosmos、Genie)与 WAM 四条路线;第六到第十篇处理评测、部署、规划与推理成本;第十一至二十篇补上了 Dyna 谱系、几何表示、物体中心、分层结构、记忆、共享状态、闭环误差与跨会话迁移。读到这里,一个自然的印象是:世界模型就是一个足够大的序列模型或去噪模型,喂足够多的数据,它自己会把物理学会。
这个印象有一半是对的,但它跳过了世界模型研究里另一条更老的路线。这条路线不把世界表示成一个稠密张量——不是一张图、一段视频 token、一个潜向量,而是一组实体以及实体之间的关系;它也不把物理规律完全交给数据去拟合,而是把守恒律、广义坐标、哈密顿结构直接写进模型的输出方式里。用一句话概括这两件事:前者决定「世界由什么组成」,后者决定「这些组成部分允许怎么动」。
先看三条主流路线在这一层上的共同点。重建式模型把状态压成一个潜向量 ,视频生成式模型把状态摊成一串时空 token,JEPA 把状态表示成一组 patch 嵌入。三者的状态都是定长、稠密、与实体身份无关的。这带来三个具体后果。
第一,对象数量的变化需要重新适配。一个在 4 个物体上训练的视频世界模型,遇到 40 个物体时,token 数量、注意力模式、训练分布全都变了;它可能仍然生成「看起来像」的画面,但没有任何机制保证第 37 个物体被单独跟踪。第二,守恒律只能被数据软性约束。损失函数在训练样本上惩罚能量偏差,但推理时没有任何结构阻止模型在 200 步 rollout 里凭空造出能量——第十九篇讨论过的闭环误差放大,在这里有了一个更具体的来源。第三,误差沿物体耦合。稠密表示里所有位置共享同一套参数,一个物体的预测偏差会通过注意力或卷积扩散到整个场景,而结构化模型可以把交互限制在真正相邻的实体之间。
这条被跳过的路线有两个分支,分别对应两种「结构」:
- 关系结构:把世界写成图,节点是物体或粒子,边是它们之间的相互作用。代表工作是 Interaction Networks(Battaglia 等,NeurIPS 2016)与 Graph Network Simulator(Sanchez-Gonzalez 等,ICML 2020)。
- 守恒结构:不改变「状态是一个向量」这件事,但改变网络输出向量场的方式,让输出自动满足能量守恒。代表工作是 Hamiltonian Neural Networks(Greydanus 等,NeurIPS 2019)与 Lagrangian Neural Networks(Cranmer 等,ICLR 2020 深度微分方程 workshop)。
这两条线都不是 2026 年的新工作,最老的已经十年。它们值得在这个系列里单独占一篇,原因不是「经典」,而是它们把世界模型设计里最难的一个问题摆到了台面上:哪些东西应该由结构保证,哪些东西才应该交给数据去学。 这个问题在今天的机器人世界模型、可微分仿真、物理一致性评测里仍然每天出现,只是换了一个说法。
形式化:把世界写成「实体 + 关系」
状态是一个集合,不是一个向量
设时刻 的世界状态为
其中 是第 个实体的位置, 是速度, 是它的属性(质量、半径、材质、类型)。这里第一个关键点是: 是一个集合,没有固定顺序。把第 1 个和第 7 个实体交换,世界是同一个世界。任何作用在 上的模型都必须满足这个对称性,否则它会把「编号」当成物理量来学——而编号是人为的。
稠密张量表示天然不满足这一点:把图像的第 3 行和最后一行对调,得到的是另一个输入;模型只能靠数据 augmentation 去逼近置换不变。集合表示则可以在结构上直接满足,办法是让所有实体共享同一个更新函数,并且用对顺序不敏感的聚合算子把邻居信息合起来。
图:谁和谁发生作用
实体之间不是全连接。桌面上相距两米的两个杯子不会互相推挤,只有接触或处在作用半径内的实体才有相互作用。把这种局部性写成图:
是作用半径(cutoff), 是邻居集合。对粒子系统, 通常取 2–3 个粒子直径;对刚体场景,边可以由接触检测或场景图给出。图不是模型的外部附件,它本身就是一种归纳偏置:信息只在有边的实体之间流动。
消息传递:局部交互的通用算子
图上最通用的计算原语是消息传递(message passing)。一层写成
是边函数,输入一对实体的状态与边特征 (相对位置、距离),输出一条消息; 把第 个实体的所有入边消息加起来; 是节点函数,把聚合后的消息与自身状态合成新状态。 与 通常是小的 MLP,所有节点、所有边共享同一组参数。
这三行公式包含了三个重要的结构性质。
置换等变。如果对节点做任意置换 ,消息集合只是被重排,求和结果不变,因此 不变,更新后的状态只是跟着编号一起置换。这就是「交换两个物体,物理不变」在模型里的实现,不需要数据增强。
局部性。一层消息传递只能把信息传一条边的距离。要让一个粒子感知到 10 个粒子之外的区域,需要堆叠多层,或者把图连得更密。GNS 用 10 层消息传递扩大感受野,本质上是把「局部规则」串成「较大范围的传播」。
可组合。 只见过两两交互,但模型可以处理任意数量的实体、任意连接方式;训练时 2.5k 个粒子,推理时可以 28k 个粒子,只要图还能建出来。
代价:复杂度与离散化
一层消息传递的边数是 , 是平均邻居数。若节点与边特征维度为 ,单层计算量大致是
是一条边经过一个两层 MLP 的乘加量。 层堆叠、每个仿真步还要重建一次图,总成本是 ,再乘以每个控制周期内的子步数。这个式子会在后面的推理账本里反复出现。
另一个容易被忽略的选择是离散时间还是连续时间。Interaction Networks 与 GNS 学的都是「一步之后的状态」或「一步之内的速度增量」,本质上是离散时间转移 ;Hamiltonian 与 Lagrangian 网络学的是一个连续时间向量场 ,再由数值积分器推进。前者实现简单、可以直接吃任意步长的数据;后者在结构上更容易表达守恒律,但需要积分器配合。这个区别决定了后面两类模型的能力边界。
Interaction Networks:第一批学会「撞」的模型
模型结构
Interaction Networks(IN)由 Battaglia、Pascanu、Lai、Rezende、Kavukcuoglu 在 2016 年提出,发表在 NeurIPS 2016,论文是 Interaction Networks for Learning about Objects, Relations and Physics。它要解决的问题很具体:给定若干个物体的位置、速度与属性,预测它们在下一个时刻的速度,并且希望模型在物体数量变化时仍然成立。
IN 把一次前向拆成两部分:关系推理(relational reasoning)与物体推理(object reasoning)。关系推理对每一对存在关系的物体计算一个交互项,物体推理把所有作用于某个物体的交互项聚合起来,更新这个物体的状态。用今天的术语说,这就是一层以边为中心的消息传递,只是当时还没有统一成「图网络」的语言。
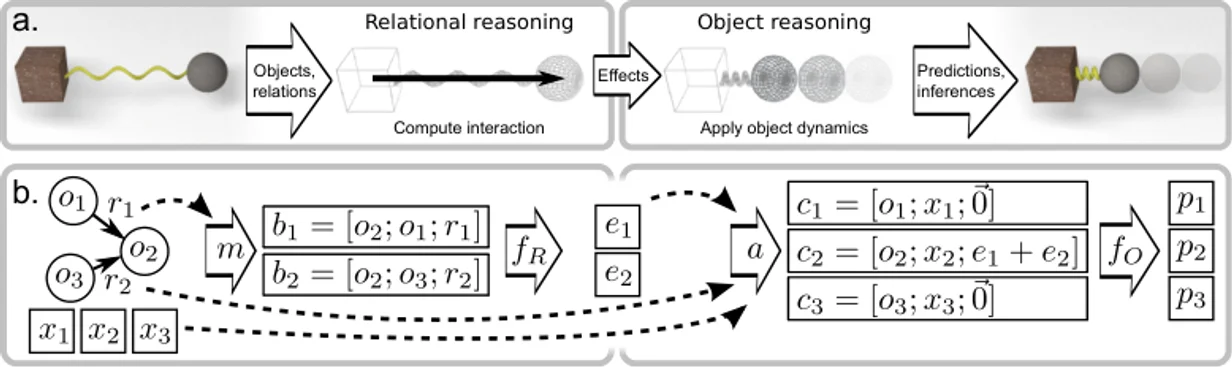
上图来自 IN 论文的模型示意图(arXiv:1612.00222)。左侧是关系推理:物体 与关系 被送进关系函数,输出每一对物体之间的交互项 ;右侧是物体推理:每个物体的交互项被聚合成一个向量,再与物体自身状态一起送进物体函数,输出更新后的状态。图中的 是物体属性, 是交互项,箭头方向表示信息流。这个结构已经包含了消息传递的三个要素:成对函数、置换不变的聚合、共享的更新函数。
写成公式,设第 个物体的状态为 ,它与第 个物体之间的关系特征为 ,则
与 都是 MLP。注意 用的是求和而不是拼接,这一步是置换不变性的来源;如果换成把邻居按编号拼接,模型就会依赖物体编号。
它学到了什么:从二体到多体
IN 的实验覆盖三类系统:n 体引力问题、刚体碰撞(台球)、非刚体动力学(绳、布一类的形变系统)。训练目标是下一步速度的均方误差,同时还有一个辅助任务:从状态估计系统的势能。论文报告的结果里,最值得注意的不是误差数字,而是泛化方式:模型可以处理几十个物体、上千个时间步的轨迹,并且在物体数量和关系配置与训练集不同时仍然给出合理的预测。这不是因为网络容量大,而是因为 只学「两个物体如何相互作用」,物体数量只影响求和的范围。
这也是结构化世界模型与端到端视频模型最本质的区别之一:前者把「数量」放在循环/聚合里,后者把「数量」放在输入维度里。前者的参数与 无关,后者的参数或计算图与 绑定。
训练里的两个工程细节
论文里有两个细节,后来被 GNS 继承并放大。第一个是噪声注入:在训练早期,对 20% 的输入位置和速度加高斯噪声,噪声标准差取该元素数据集标准差的 0.05 倍,然后在第 50 到 250 个 epoch 把噪声降到 0。目的是让模型见过「物理上不可能」的状态——真实推理时,模型自己的预测误差会把状态推到这些区域,如果训练时从没见过,模型就不知道如何把它们拉回可行流形。第二个是多步 rollout 评估:训练是一步预测,评估是把预测速度接回输入、连续推多步,观察画面是否仍然合理。一步误差低不等于多步稳定,这一点在结构化模型里同样成立。
IN 的局限
IN 的边是预先给定的:哪些物体之间存在关系、关系类型是什么,需要输入侧提供。它没有解决「从像素里发现物体和关系」的问题,也没有解决「接触是离散事件」的问题。它学的是固定时间步的转移,步长变化需要重新训练。更重要的是,IN 没有任何守恒律保证:它可以学会近似守恒,但误差仍然会沿 rollout 累积。这两个缺口分别由 GNS 与 HNN/LNN 补上。
GNS:把关系图扩展到上千个粒子
从「物体」到「粒子」
Interaction Networks 的节点是物体,适合刚体,但不适合水、沙、布料这类连续介质——它们没有天然的对象边界,只有大量彼此挤压的粒子。Graph Network Simulator(GNS)把节点换成粒子,把「关系」换成空间邻接,从而把消息传递扩展到了上万粒子的规模。论文是 Learning to Simulate Complex Physics with Graph Networks,作者是 Sanchez-Gonzalez、Godwin、Pfaff、Ying、Leskovec、Battaglia,发表在 ICML 2020。
GNS 的状态是 个粒子:每个粒子有位置 、速度 ,以及材质、边界等静态属性。每一帧按半径 建图,边特征取相对位移 与距离。模型不预测「下一个位置」,而是预测每个粒子的加速度,再用一个简单的积分器推进速度与位置。这个选择很重要:加速度是局部量,物理上由邻域内的相互作用决定;位置是积分量,交给积分器比交给网络更稳定。
三段式结构:编码—处理—解码
GNS 的前向分成三段,每一段都对应图上的一个操作:
这是编码器:把每个粒子的原始状态与每条边的相对几何编码成固定维度的节点特征与边特征。然后是处理器,由 层消息传递组成,每一层有自己独立的参数:
最后是解码器:
把最终的节点特征映射回每个粒子的加速度。整个流程里,节点特征维度与边特征维度通常取 128, 与 是两层 MLP。论文使用的是 层消息传递,而且每一层参数不共享——这一点和标准 GNN 的「多层共享」不同,作者的解释是不同层负责不同尺度的信息传播。
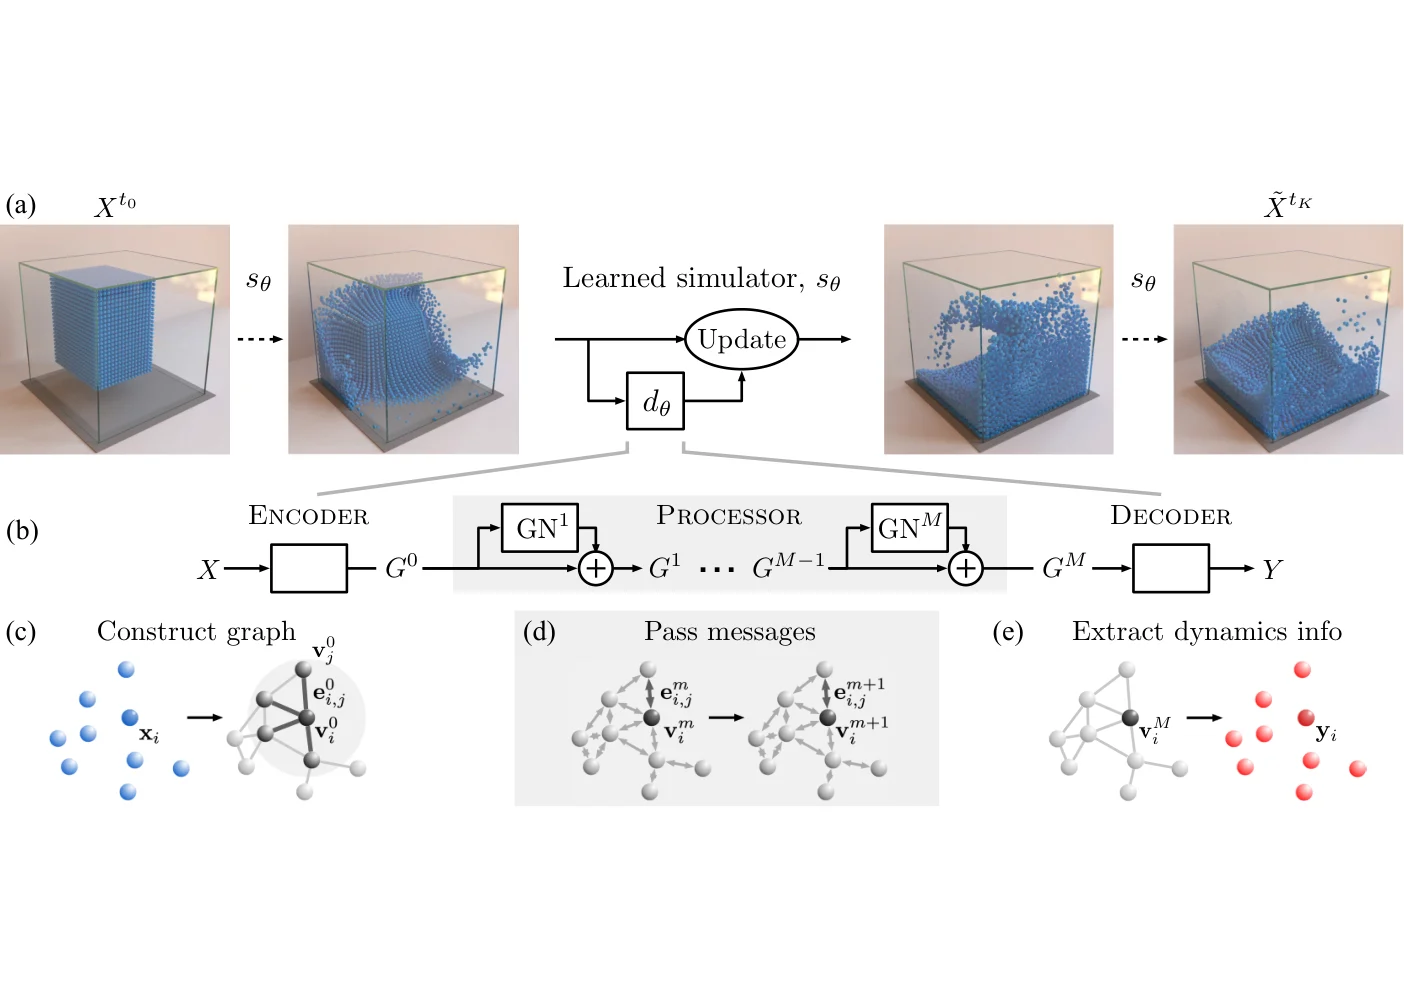
上图来自 GNS 论文的 Figure 2(arXiv:2002.09405)。(a) 是学习到的模拟器整体回路:从当前状态 建图、编码、处理、解码出加速度,再积分得到 ,新的状态又进入下一轮。(b) 是处理器内部的多层消息传递, 到 表示逐层更新的图,节点与边的隐特征在每层之间流动。(c) 到 (e) 依次是三个操作:根据粒子位置构建邻接图、在边上传递消息、从节点特征中提取每个粒子的动力学量。这三个操作在每个仿真步都要重复一次,因为粒子移动后邻接关系会变。
为什么每一步都要重建图
这是 GNS 与图像模型在系统层面最大的差别。图像模型的分辨率、patch 划分在推理时是固定的;GNS 的图是动态的:粒子在动,邻居在换,接触在发生和断开。每一步都要用空间哈希或网格做一次近邻搜索,把半径内的粒子连成边。这个操作的成本是 到 (取决于网格实现),在粒子数很大时会成为推理延迟的主要组成部分。
动态图带来一个好处和一个坏处。好处是模型天然支持拓扑变化:水花溅开、沙堆坍塌、物体断裂,都可以用边的增加与删除表示,不需要重新训练。坏处是图构建本身没有学习成分,它对噪声、穿透、异常位置很敏感;如果上一步的预测把两个粒子推到了不该有的位置,下一步的邻接就会错,错误会沿时间累积。
长 rollout 靠什么撑住
GNS 论文里最重要的消融结论,和大多数人的直觉不同:影响长程 rollout 精度的首要因素不是网络宽度,而是消息传递的层数与训练时的噪声注入。层数决定信息能传播多远——水中的压力需要经过多跳才能从一侧传到另一侧;噪声决定模型是否见过自己造成的误差分布。论文的训练方式是在输入粒子上加噪声,让模型学习把略微错误的状态拉回可行区域,这和 IN 的做法一脉相承,但在粒子系统上更关键,因为粒子系统的状态空间维度极高,一步误差很快就会把局部密度推歪。
论文展示的规模是:训练时约 2.5k 个粒子,rollout 时通过「入流」持续加入粒子,2500 步后场景里有约 28k 个粒子,比训练规模高一个数量级,模型仍然能预测出复杂的混沌动力学。这个结果说明图结构的泛化不是「插值」:模型没有见过 28k 粒子的训练样本,但它学到的是一条局部交互规则,粒子数只是规则被应用的次数。论文覆盖的材料包括水、沙、粘性流体(goop)以及多材料交互,并且验证了在更大区域、更多粒子上的泛化。
GNS 的边界
GNS 的代价也很直接。第一,它是短步长模型:训练数据的时间步通常是毫秒级,推理时也必须用同样量级的步长,否则一步预测的误差会大到无法积分。第二,它需要完整的状态:粒子的位置、速度、材质都要已知;从单目视频里恢复这些量本身就是一个难题。第三,接触与摩擦仍然是最脆弱的部分:硬球碰撞、静摩擦、粘附这些非光滑现象,用连续的消息传递去拟合,容易出现穿透或抖动。第四,图构建与 10 层消息传递的成本,使它更适合离线仿真或低速规划,而不是 1 kHz 的关节控制。
尽管如此,GNS 确立了一个很重要的范式:世界模型的骨架可以是「图 + 局部规则 + 积分器」,而不是「大张量 + 大注意力」。这个范式后来被大量可微分仿真、机器人操作世界模型与物理推理工作借用,只是换上了不同的编码器与更复杂的边函数。
从关系再进一步:把守恒定律变成结构
图结构解决的是「谁和谁相互作用」。它不解决另一个问题:一个没有相互作用的物体,在只有势场的情况下会怎么运动?一个摆锤在没有摩擦的情况下,为什么不会越摆越高或越摆越低?
对这类问题,图网络只能靠数据去学「这个系统大致守恒能量」。但在多步 rollout 里,任何微小的系统性偏差都会累积:一步损失 0.1% 的能量,两千步之后能量就掉到一半。这不是网络容量不够,而是模型的目标里根本没有「能量守恒」这件事,它只是在训练样本上碰巧拟合得好。Hamiltonian Neural Networks(HNN)与 Lagrangian Neural Networks(LNN)的做法是把守恒律写成输出形式,让模型无论参数是多少,都只能产生守恒的动力学。
哈密顿力学在一页里
哈密顿力学把系统的状态写成广义坐标 与共轭动量 ,用一个标量函数——哈密顿量 (通常就是总能量)——描述整个系统的演化:
这两个方程叫哈密顿方程。它们的几何含义是:状态在相空间 里沿着等能面流动,流场是由 的梯度旋转 90 度得到的,因此流场处处与 的梯度正交,沿流动方向 不变:
这个推导是整件事的核心。守恒不是额外加的一个约束项,而是方程形式本身的性质:只要你把向量场写成 ,能量就必然守恒,无论 是什么函数。
HNN:让网络只学哈密顿量
HNN 的想法非常直接:既然守恒由方程的形式保证,那就不要让网络直接输出向量场 ,而是让网络只输出一个标量 ,然后用自动微分构造向量场:
HNN 由 Greydanus、Dzamba、Yosinski 在 2019 年提出,发表在 NeurIPS 2019,论文是 Hamiltonian Neural Networks。训练时不需要标签之外的任何监督:损失只是预测的 与真实数据之间的均方误差,而 由 PyTorch 或 JAX 的自动微分求出。也就是说,网络从未被告知「要守恒」,它只是在学习一个标量场,守恒是这个标量场的梯度结构带来的副产品。
这个改造的参数量几乎不变:原来网络输入 输出 ,现在输入 输出一个标量。差别全部在输出层的组织方式上。
它为什么有效:相空间里的「环」
论文用三个任务说明效果:理想弹簧振子、理想单摆、真实单摆数据(来自 Schmidt & Lipson 2009 发表在 Science 上的工作)。每个任务 25 条轨迹,每条 30 个观测,观测被加上标准差 0.1 的高斯噪声。
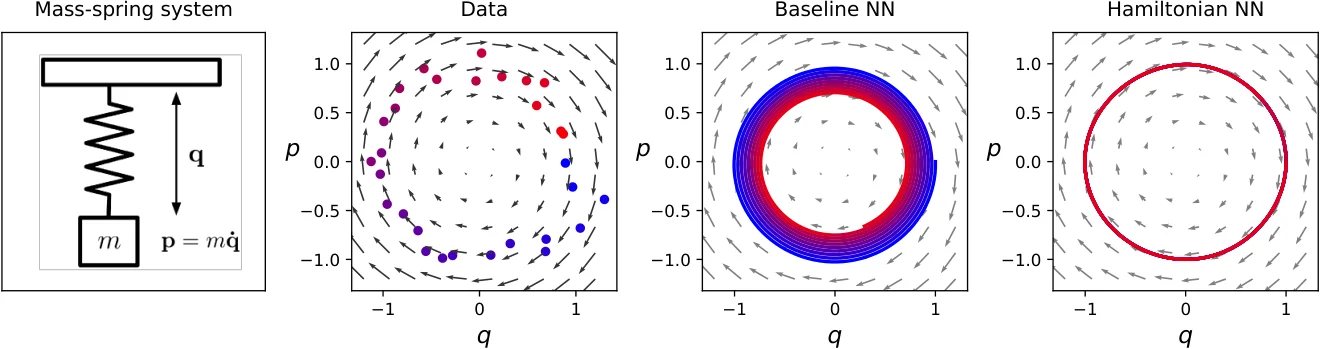
上图来自 HNN 论文附录的 Figure A.2(arXiv:1906.01563)。三组相空间轨迹分别标注为 Data、Baseline NN 与 Hamiltonian NN:数据本身是一条闭合的等能环;基线 MLP 直接预测向量场后积分,轨迹向内螺旋——每一步都损失一点能量,误差累积之后系统「自己停下来了」;HNN 的轨迹同样闭合,但半径与真实轨迹略有差别。
这个半径差别恰恰说明了 HNN 的性质。论文指出,HNN 学到的守恒量在数值上与真实总能量同量级,但差一个常数因子;由于能量是相对的(零点是人为选的),这在物理上完全可以接受。HNN 不是在拟合能量的绝对值,它在拟合等能面的形状,而等能面的形状决定了轨迹是否闭合。基线网络在中列之所以螺旋,是因为它没有「等能面」这个概念,只能逐点拟合向量,每个点的误差都朝中心偏一点。
论文的另一个发现是 HNN 的时间可逆性:由于哈密顿方程是一阶微分方程, 完全由 决定,在连续时间下这个映射是可逆的——倒着积回去能回到起点。基线网络没有这种保证,它的「倒放」与正放不等价。
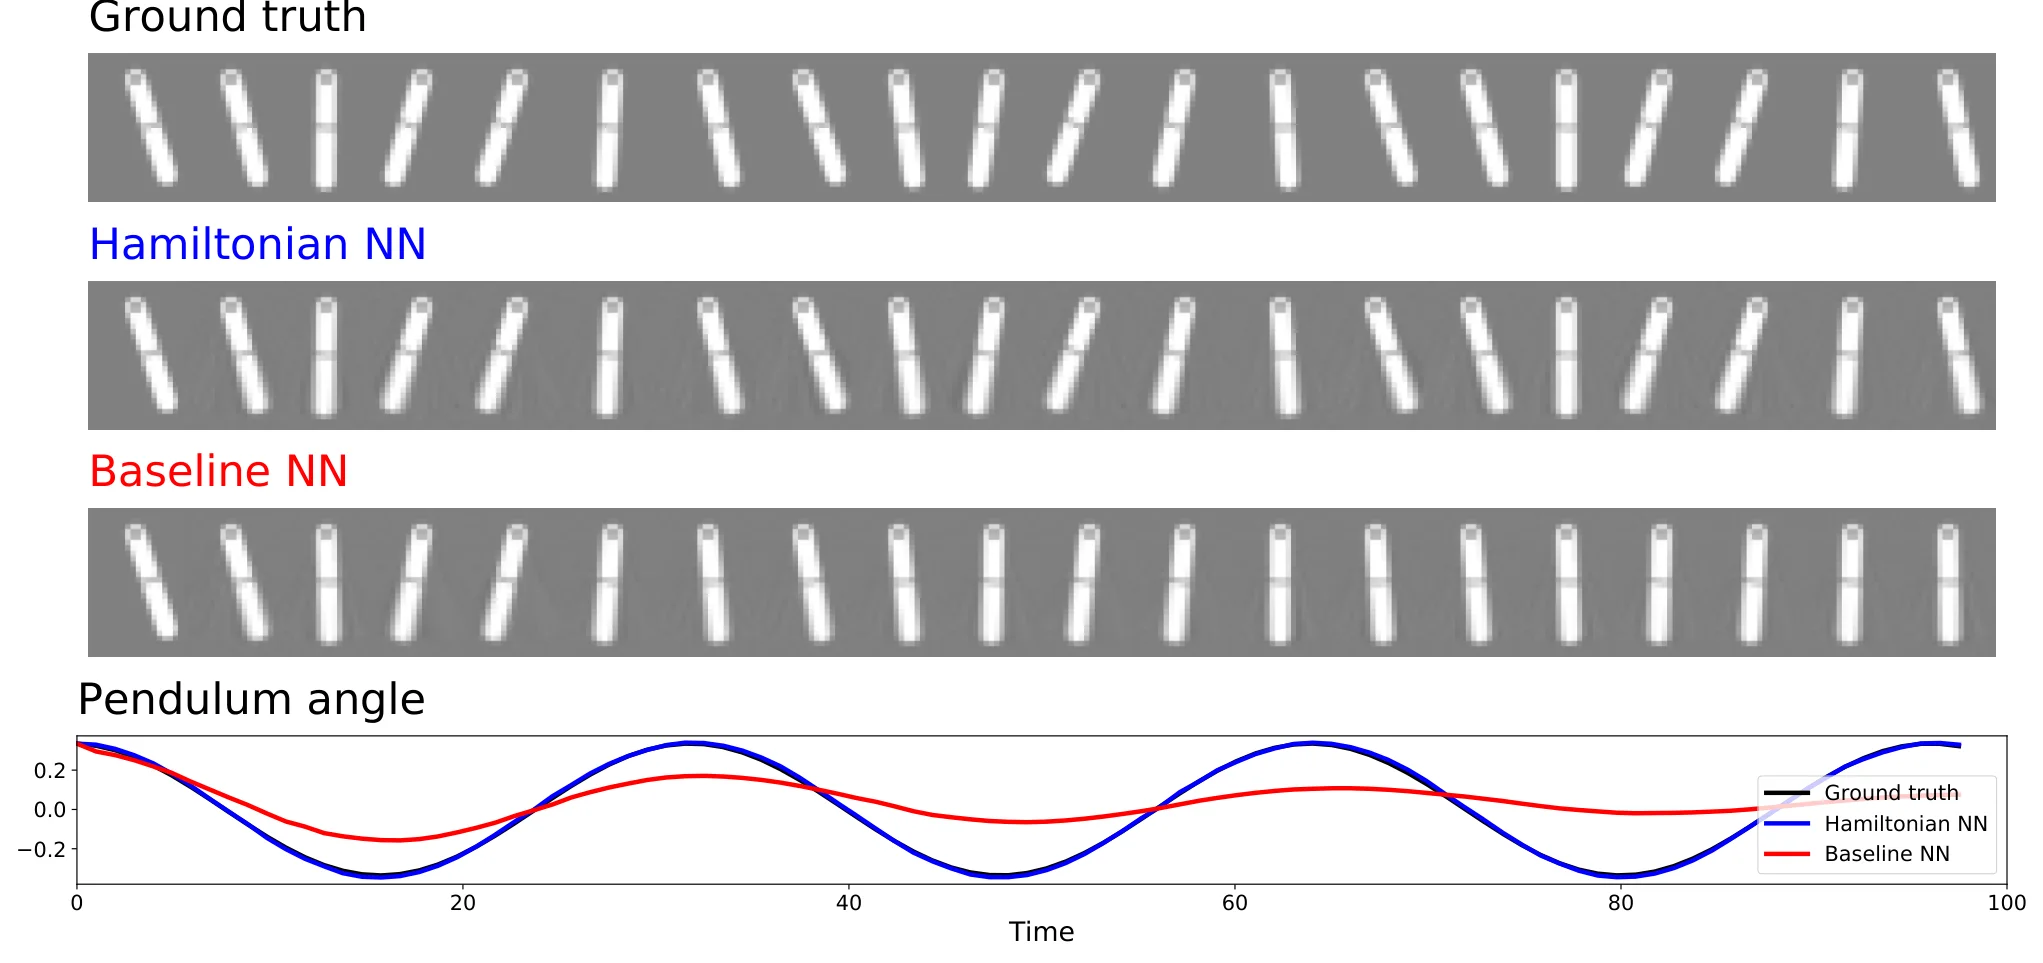
上图来自 HNN 论文的 Figure 4(arXiv:1906.01563)。这个任务不是直接给 ,而是先从单摆的像素观测里训练一个自编码器,把画面压成潜向量 ,再在潜空间上比较基线网络与 HNN,最后解码回像素做可视化。图例里的 Baseline NN 与 Hamiltonian NN 对应两条不同的模型。基线网络的预测快速衰减到更低能量状态,画面里的摆幅越来越小;HNN 在数百帧后仍然贴近真实轨迹。这张图把「结构保证」与「数据拟合」的差别表现得最清楚:两者在一阶拟合上的误差可能接近,但在长程积分里,结构带来的差异远远超过参数学习带来的差异。
LNN:哈密顿量不一定写得出来
HNN 有一个前提:要用哈密顿方程,就必须知道共轭动量 。在牛顿力学里 ,看起来很自然;但在很多系统里,状态变量不是 而是 ,且 与 之间隔着一个质量矩阵 :
如果质量矩阵随构型变化, 就不是 的简单倍乘,而是它的一个线性组合。旋转刚体、机械臂都是这种情形。HNN 需要先把观测转成共轭动量,这本身就需要知道 ,而 往往正是最难建模的部分。
Lagrangian Neural Networks(LNN)绕过了这一步。拉格朗日力学用拉格朗日量 (动能减势能)描述系统,其运动方程是欧拉—拉格朗日方程:
把它展开,得到加速度的表达式:
括号里的矩阵就是广义质量矩阵 ,它由网络输出直接算出并求逆,不需要预先知道物理形式。LNN 让网络输出标量 ,再用自动微分算出这个加速度,用积分器推进。论文是 Lagrangian Neural Networks,作者是 Cranmer、Greydanus、Hoyer、Battaglia、Spergel、Ho,发表在 ICLR 2020 的 Deep Differential Equations workshop。
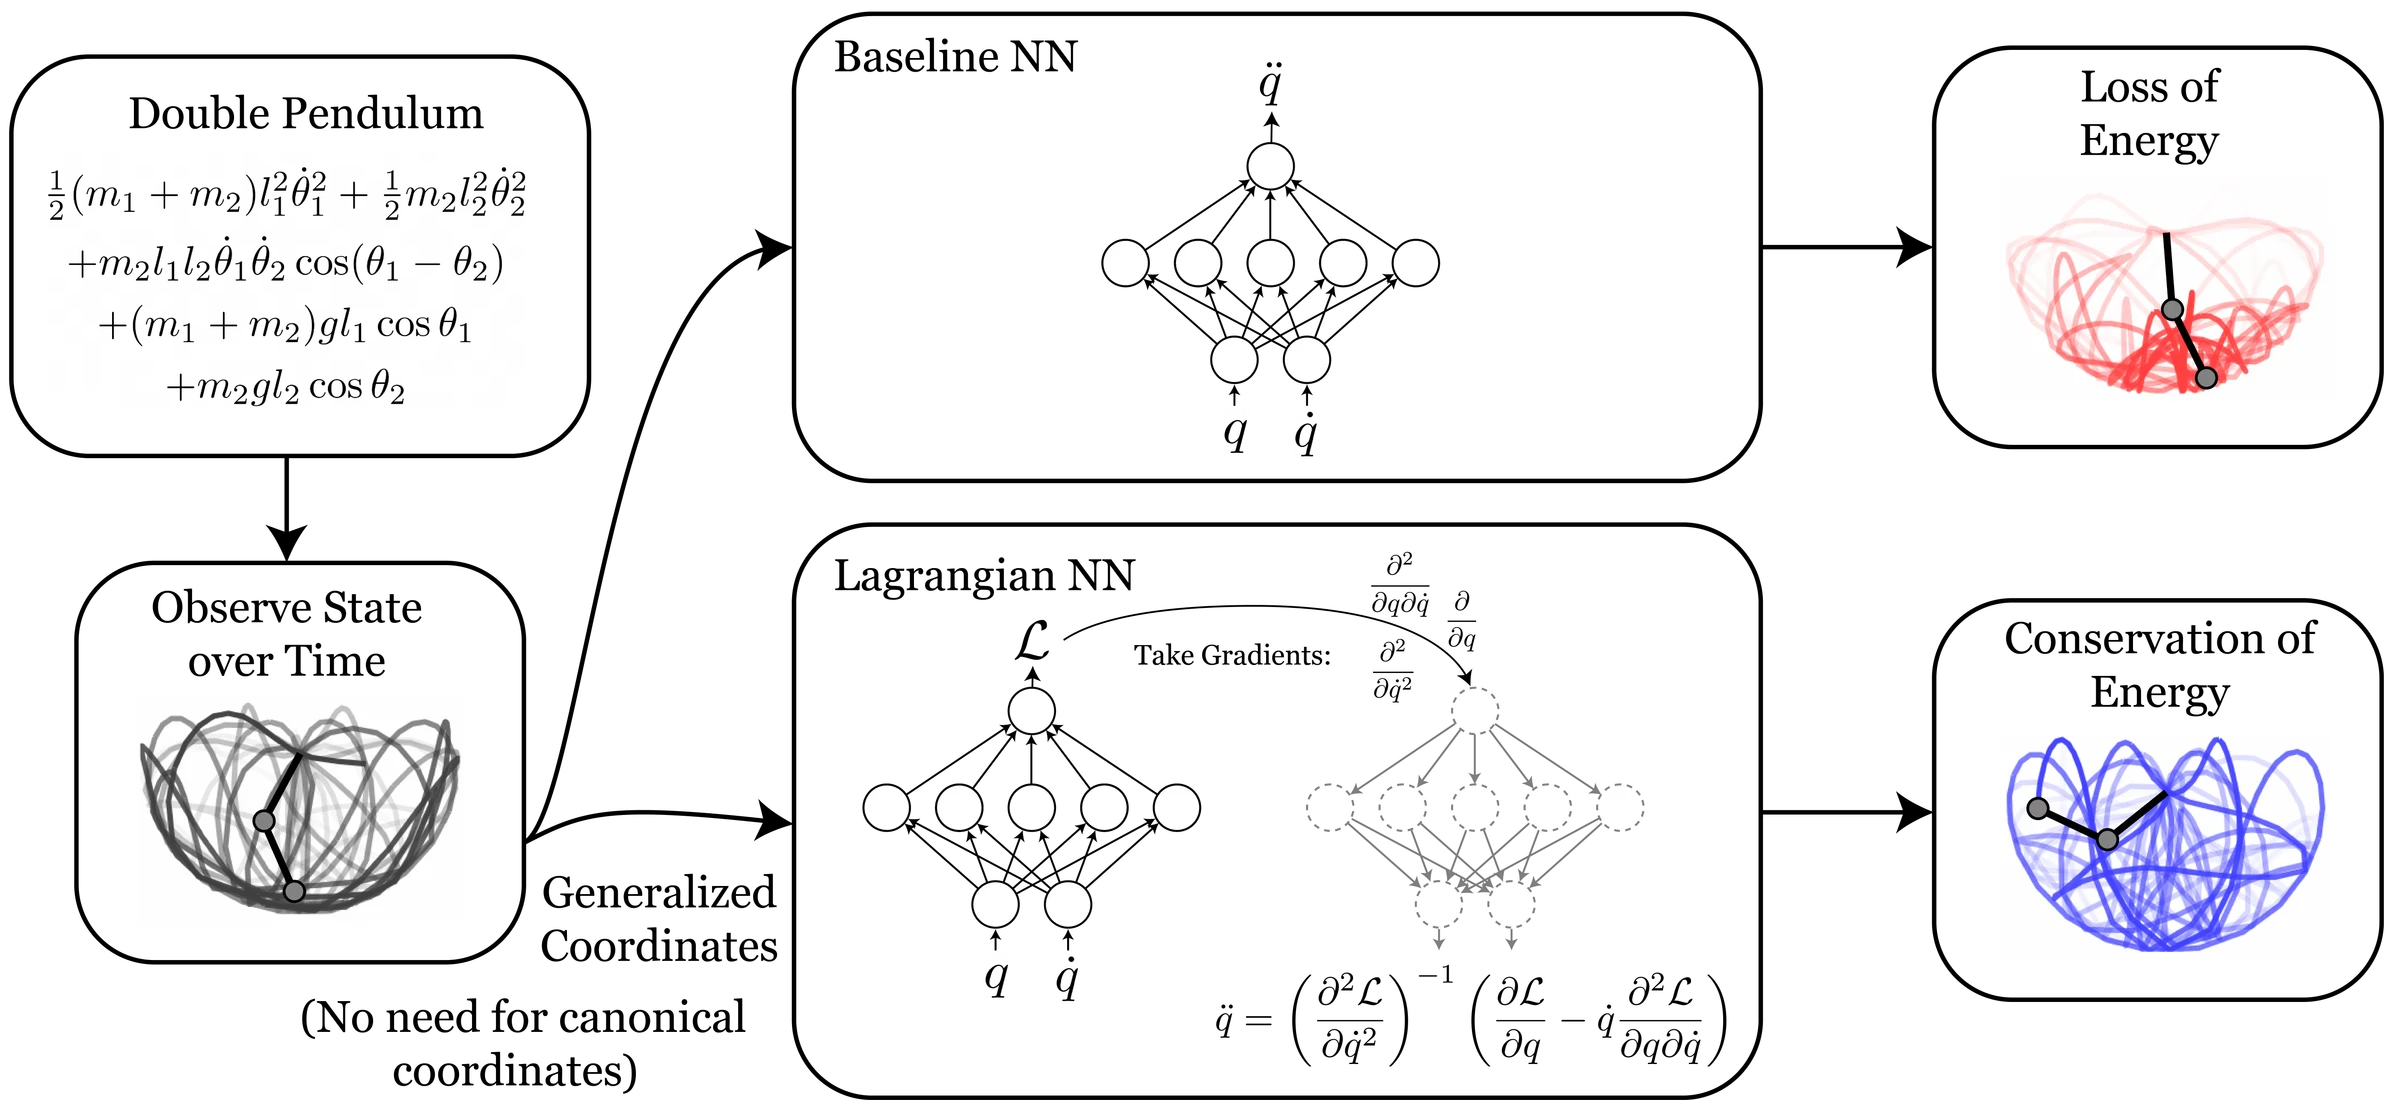
上图来自 LNN 论文的 Figure 1(arXiv:2003.04630)。图中把两套框架并排画出:哈密顿框架让网络输出 再求梯度;拉格朗日框架让网络从观测到的广义坐标与速度出发,输出 ,再对 与 求梯度,按欧拉—拉格朗日方程计算加速度,不需要共轭动量。图里同时给出同一条双摆轨迹的对比:基线网络的能量随时间单调下降(标注为 Loss of Energy),LNN 的守恒量保持在水平线上(标注为 Conservation of Energy)。图中标出了 与 ,双摆的拉格朗日量本身有显式形式,但 LNN 不依赖这个形式,它学的是任意函数。
LNN 的实验里,双摆任务使用 60 万个随机初始条件下的瞬时加速度作为训练数据;LNN 与基线网络的最终训练损失接近(7.3 与 7.4,量级为 )。在 40 个随机初始条件、每个 100 步的 rollout 上,平均能量误差占最大势能的比例分别是 8%(基线)与 0.4%(LNN)。第二个任务是一个相对论粒子:在相对论下,动量与速度不是线性关系,哈密顿方法需要知道非平凡的正则动量,而拉格朗日方法不需要——这正好展示了两者的边界。
能量守恒的数学:为什么结构比数据更可靠
守恒是「流场的旋度为零」
把哈密顿方程写成统一的向量记法。设 , 是标量函数,定义反对称矩阵
是正交的()且反对称()。沿轨迹对 求导:
由于 反对称,任意向量 都满足 ,所以 。这不是近似,是恒等式。基线网络输出任意向量场 ,它对应的 一般不为零;HNN 把 限制成 的形式,把旋度为零(更准确地说,是辛结构)写进了架构。
同样的事实也可以从「流场是梯度旋转」的角度理解:哈密顿流场沿着等 面的切方向流动,它与 处处正交,因此不能穿过等能面。基线网络可以随便穿过,训练数据上的误差小只意味着它在观测点附近恰好近似正交,远离观测点就无法保证。
离散化会破坏结构
上面的推导都假设连续时间。真实推断需要数值积分,而常用的积分器——前向欧拉、四阶龙格—库塔——本身会破坏辛结构。以欧拉为例,一步更新 之后, 与 的差是 ,长期累积会漂移。所以 HNN 的「精确守恒」有一个前提:要么用保结构积分器(辛积分,如蛙跳/Störmer–Verlet),要么像 LNN 那样只把加速度交给网络、由用户选择积分器。
这也是为什么 HNN 论文强调「在训练步长一致、使用合适的积分器时,学到的守恒量保持不变」。工程上常见的做法是用二阶辛积分器,它的能量误差在长时间上是有界的振荡而不是单调漂移——每走一步能量涨一点,下一步又掉一点,误差不累积。
什么时候结构不可用
结构化模型不是万能的,它有清晰的失效边界,而且这些边界往往正是真实世界模型最关心的场景。
耗散系统。加入摩擦、空气阻力、粘性之后,能量不再守恒,真实动力学是 。强行用 Hamiltonian 形式去拟合,等于要求模型在一个本不守恒的系统里找一个守恒量,结果要么拟合不好,要么误差被推到结构上(比如学到一个依赖 的「有效守恒量」,但它对长程预测毫无意义)。常见的绕法是把耗散也写进结构:,其中 是半正定的耗散矩阵,能量沿轨迹单调下降;这类 port-Hamiltonian 形式在控制理论里已有成熟体系,机器人关节的柔顺控制与电路建模大量使用它。
非光滑现象。碰撞、接触、静摩擦是状态空间中的跳变或切换,连续向量场无法表达「速度在接触瞬间被投影到可行锥」。HNN/LNN 在台球碰撞这类问题上的表现远不如在连续系统上稳定,原因就在这里。
非哈密顿坐标。很多系统的观测坐标不是共轭对:视觉观测、关节角与力矩、末端位姿。要把它们转成 ,必须先知道自己处在哪个坐标里。LNN 在这件事上宽松一些,因为它只需要 ,但仍然假设 是构型导数。
数据质量。HNN/LNN 假设数据来自真实动力学且噪声可控。如果数据本身有系统性偏差(例如传感器标定误差),结构化模型会把这个偏差「合法化」为一个守恒量,误差反而更难被发现。
这些边界告诉我们一个更一般的判断:结构的价值在于它对应的物理规律确实成立。当规律成立时,结构把参数学习的搜索空间缩小到「哪些函数满足这个规律」,样本效率和长程稳定性都会显著提升;当规律不成立时,结构会变成一种强制的错误假设。判断这一点,比选哪种网络结构更重要。
结构、数据与表达力的取舍
四类模型的对比
把这一篇讲的两类结构,与前二十篇的稠密表示放在同一张表里,差别会清楚很多。表中「保证」一列指的是模型在结构上能保证什么,而不是在训练集上表现如何。
| 模型 | 状态表示 | 对象数变化 | 物理保证 | 输入要求 | 典型成本 |
|---|---|---|---|---|---|
| 视频/潜空间生成式 | 定长 token 或潜向量 | 需要重新适配 | 无 | 像素或潜变量 | 每帧数十 TFLOP |
| 图粒子模拟(GNS) | 粒子集合 + 邻接图 | 天然支持 | 局部性、置换等变 | 完整粒子状态 | 每步数 GFLOP |
| 哈密顿/拉格朗日网络 | 低维 或 | 不涉及 | 能量守恒(连续时间) | 完整低维状态 | 极小 |
| 混合模型 | 结构化骨架 + 学习残差 | 视骨架而定 | 骨架部分的保证 | 状态 + 参数 | 介于两者之间 |
表中「典型成本」一栏只是量级参照,具体数字见后面的推理账本一节。视频模型每帧的成本随分辨率与去噪步数增长,图中粒子模型每步的成本随粒子数与子步数增长,两者在规模合适时相差两个数量级,但输出的信息粒度不同,不能直接比较大小。
这张表最重要的信息不是「谁更好」,而是保证与输入要求是绑定的。结构化模型能给出物理保证,代价是它要求一个干净、低维、语义明确的状态;视频模型能吃原始像素,代价是没有任何结构保证。真实系统往往落在中间:感知给出带噪的物体状态,模型在这个状态上做结构化预测,再用学习到的残差补上没建模的部分。
等变性与算子学习:两条相邻的路
关系结构之外,还有两条常被放在一起讨论的结构化路线。
一条是等变性。图网络只保证了置换等变,没有保证旋转、平移等变——把整个场景旋转 30 度,粒子的相对位置变了,但物理规律不变。E(n) Equivariant Graph Neural Networks(EGNN,Satorras、Hoogeboom、Welling,ICML 2021,arXiv:2102.09844)把边的消息限制成只依赖距离与相对方向的函数,使模型的输出随输入坐标一起旋转、平移,而不需要数据增强。对分子、刚体、机器人场景,这个性质能显著改善样本效率。它与消息传递是正交的改进:可以在 GNS 的边上直接换用等变边函数。
另一条是算子学习。Fourier Neural Operator(FNO,Li 等,ICLR 2021,arXiv:2010.08895)不学「有限个网格点上的状态转移」,而学「函数到函数的映射」,在频域里做卷积,因此训练在低分辨率、推理可以在高分辨率上进行。对 PDE 类世界模型(流体、热传导、波动),这解决的是「分辨率变化需要重新训练」的问题;代价是它假设了网格结构,处理不了任意分布的粒子。
这两条路与本篇的关系可以这样定位:消息传递解决「谁和谁作用」,等变性解决「作用在什么坐标系下表达」,算子学习解决「作用发生在什么分辨率的函数空间里」。三者可以叠加,也可以只取其一。
什么时候该把物理写进去
把上面的讨论收成几条可操作的判断,按优先级排列。
第一,看状态是否可得。 如果系统能提供物体级的状态(机器人关节角、仿真器内部状态、动捕数据),结构化模型几乎总是更划算:参数少、样本效率高、可解释。如果只有像素,先解决感知,再谈结构;把结构化模型硬接在噪声很大的感知输出上,结构带来的稳定性会被感知误差抵消。
第二,看规律是否成立。 守恒、可逆、辛结构这些性质,只有在对应的物理条件下才成立。室内机器人操作(有摩擦、有接触)不适合直接套 HNN;空间机械臂、分子动力学、无耗散的摆锤系统则非常适合。判断方法是先在一个小规模数据上做能量漂移诊断:如果真实系统的能量本身就在漂移,结构化模型只会把漂移学成「守恒量」。
第三,看时间尺度。 控制频率越高、单步时间越短,结构化模型的优势越大:它每一步只需要局部消息传递,而视频模型每一帧都要跑一次完整去噪。反过来,如果任务只需要秒级的粗粒度预测,视频模型的表达力更值得。
第四,看是否必须可微。 结构化模型天然可微,可以直接接进规划器、最优控制或策略梯度。可微分仿真器在机器人领域流行的原因就在这里:它把「预测」和「优化」放在同一个计算图里。视频模型也可微,但它的梯度要穿过几十步去噪,代价高得多。
第五,看工程预算。 结构不是免费的:建图、邻接搜索、积分器、坐标系转换、参数标定,每一项都是工程量。如果一个任务的物理规律简单到用解析模型就能写出来,直接写解析模型,不需要神经网络;如果规律复杂到无法写出,先考虑「解析骨架 + 学习残差」,而不是纯黑盒。
推理账本:图 rollout 的每一步花在哪
一笔可算的账
前面给过复杂度的形式,这里把它落到数字上。假设节点与边特征维度 ,每条边经过一个 64→128→64 的两层 MLP,平均邻居数 ,消息传递层数 。一条边的乘加量约为
(这里按每个乘加算两次浮点运算,且忽略偏置与激活。)那么一个仿真步的总计算量是
按有效吞吐 20 TFLOPS 估算(这是把 gather/scatter 与 MLP 都算进去的乐观值,实际 GNN 往往只有 5–10 TFLOPS),并假设每个控制周期需要 10 个仿真子步,可以得到下面这组数量级:
| 粒子数 | 边数 | 每仿真步计算量 | 每仿真步耗时 | 10 子步的控制周期 |
|---|---|---|---|---|
| 500 | 1 万 | 3.3 GFLOP | 约 0.17 ms | 约 1.7 ms |
| 2 000 | 4 万 | 13 GFLOP | 约 0.65 ms | 约 6.5 ms |
| 20 000 | 40 万 | 132 GFLOP | 约 6.6 ms | 约 66 ms |
这张表的用法是反推场景: 的粒子数可以支撑数百赫兹的控制; 大约对应 100–150 Hz; 只能做 10–15 Hz 的规划或离线仿真。GNS 论文里 28k 粒子的 2500 步 rollout 属于最后一档,它不是实时控制器,而是「在 GPU 上跑得比传统 SPH 求解器更快的仿真器」。
延迟不只在消息传递里
真实的推理链路比上面的公式多三项开销。
建图。每一步都要根据当前位置做近邻搜索。用均匀网格或空间哈希, 时大约是几毫秒量级;用暴力 会直接爆炸。建图的成本与 无关,主要取决于 与网格分辨率,因此它在小 时可以忽略,在大 时会和消息传递同量级。
积分与子步。上面按 10 个子步估算。子步数由稳定性决定:显式积分器的稳定步长与粒子间距、声速有关,流体场景往往需要比控制周期小一到两个数量级的时间步。子步数翻倍,延迟就翻倍,而且这部分是纯串行的时间推进,不能靠批处理摊掉。
状态搬运。节点特征、边特征、邻接表在每层之间都要读写显存。、 时边特征有 40 万条,每条 64 维 FP32 就是约 100 MB;10 层就是 10 次读写。这个数据量已经超过许多 GPU 的 L2 容量,实际性能会被显存带宽限制,而不是被 FLOPs 限制。工程上的常见优化是减少边特征维度、使用半精度、或者采用「无边特征」的 GNN 变体(边只用于路由,不存储特征)。
与视频 rollout 的量级对比
同一个预测任务,如果用视频世界模型做,成本结构完全不同。以 512×512、patch 16×16 为例,一帧是 1024 个 token;一个十亿参数的 DiT,单次前向约 TFLOP,去噪 20 步就是约 40 TFLOP 一帧。结构化模型在 时,10 个子步合计约 130 GFLOP,相差约三百倍。这个对比必须带两个限定:视频模型输出的是完整画面,结构化模型输出的是低维状态;视频模型的成本随分辨率与去噪步数增长,结构化模型的成本随粒子数与子步数增长。两者不是替代关系,而是分别对应「要画面」与「要状态」两种需求。
对推理系统而言,这个差别还带来一个部署上的后果:视频世界模型可以复用 LLM 服务里的 KV 缓存、连续批处理、PagedAttention 一整套基础设施;图模型没有 KV 缓存,它的状态是每步重建的图与粒子数组,调度单位是「仿真步」而不是「token」。把图模型塞进现有推理框架,通常要自己写一个状态管理器。
与其他路线的接口:几何、槽位、分层与闭环
结构化世界模型不是一条孤立的支线,它和前二十篇的许多部件可以直接对接。
与几何表示。第十二篇拆过 NeRF、3D Gaussian Splatting 与占用栅格。几何表示回答「场景长什么样、哪里可通行」,图模型回答「物体之间怎么作用」。两者最常见的接法是:用占用栅格或 SDF 做碰撞检测,把接触对变成图的边;用 3DGS 做渲染,把图模型的低维状态变成可看的画面。几何负责「空间」,图负责「动力学」。
与物体中心表示。第十三篇的 Slot Attention 把场景分解成若干槽位,每个槽位是一个物体级的向量。槽位天然就是图的节点候选:槽位的置换等变性与图节点的置换等变性是同一件事,槽位之间的注意力权重可以直接转成边的强度。这条路线解决的是「节点从哪来」——图模型一直假设节点已知,Slot Attention 提供了从像素到节点的前端。
与分层结构。第十四篇讨论过时间抽象。分层与图结构结合时,通常让高层输出「宏观动作或子目标」,低层用图模型做物理 rollout:高层决定「去推哪个箱子」,低层决定「用多大的力、在哪个接触点推」。两层的时间尺度不同,图模型只在低层高频运行,高层可以慢一个数量级。
与长程记忆。第十七篇把记忆从注意力里拆出来。对图模型,记忆的载体通常是「物体轨迹库」:每个物体的历史位置、速度、材质参数被存成一条轨迹,规划时按物体 ID 检索。图模型的优势是物体 ID 稳定,检索地址明确;难点是物体合并、分裂、遮挡后的身份保持。
与闭环误差。第十九篇分析了误差在闭环里的放大与抑制。结构化模型引入了一类新的误差来源:结构失配。例如把作用半径 设得太小,模型看不到远距离的流体压力,预测会系统性偏慢;这个偏差不是随机的,它在闭环里会被反馈放大成滞后或振荡。诊断方法与第十九篇一样:把环路增益测出来,而不是猜。能量漂移则提供了一个天然的观测量——如果守恒量在开环 rollout 里单调漂移,闭环里的控制器大概率会把它当成真实动力学去补偿。
与预算地图。第十五篇把世界模型的成本拆成参数、想象、规划与数据四项。结构化模型改变的是这四项的比例:参数少、单步便宜,但数据标注与工程实现更贵;它的「想象」成本低,适合做大量候选轨迹的 rollout。选型时可以把这篇的账本与上面的延迟表放在一起算。
局限与仍未解决的问题
节点从哪来
这一篇的所有模型都假设「实体与关系已知」。GNS 需要粒子划分,HNN/LNN 需要 或 ,IN 需要关系图。从原始观测里发现这些结构,是另一条完全不同的技术路线:Slot Attention 一类的槽位方法从图像中无监督地分出物体,视频推理工作从一段视频里推断接触、支撑、包含等关系,可微分渲染从多视角恢复几何。世界模型如果要同时具备感知能力与物理结构,就必须把这两层接起来,而目前的接法大多还停留在「先用一个模型提取状态、再喂给另一个模型」的两段式,端到端训练时结构约束能否传递到感知层,仍然缺少可靠的答案。
接触与摩擦
结构化模型最统一的失败模式是非光滑动力学。碰撞、接触、粘滑、断裂都涉及速度的不连续或力的切换。GNS 用连续消息传递去拟合硬球碰撞,需要很小的步长与大量数据才不会穿透;HNN/LNN 的向量场假设根本无法表达「速度瞬间改向」。可微分仿真里有一套成熟的绕法(互补约束、投影到可行集、事件检测),但它们要么不可微,要么在接触点处梯度病态。把图结构与事件驱动的接触模型结合起来,是工程上最常见但在公开工作里最少被系统讨论的部分。
尺度与泛化
GNS 展示了粒子数泛化,但没有展示尺度泛化的真正含义:当颗粒尺寸与作用半径之比发生变化,或者当流体从层流进入湍流,局部规则是否仍然适用?结构模型假设「局部规则在不同规模下不变」,这近似物理里的尺度不变性,但真实系统中尺度变化往往会引入新的有效规律(表面张力、湍流粘性)。纯数据驱动的稠密模型同样有这个问题,只是它把问题藏在了「分布外」这个词里。
与学习式世界模型的融合
2025–2026 年的一个明显趋势是把结构化骨架与大规模序列模型结合:用 Transformer 作为节点或边函数,用图结构限制注意力范围,或者用图结构为视频模型提供物体级中间表示。这类混合模型能同时享受结构带来的稳定性与大规模预训练的泛化,但也带来了新的问题——结构约束在多大程度上被模型真正利用了?一个常见的诊断是消融:把结构去掉、换成等参数的黑盒,比较长程 rollout 误差,如果差距消失,说明结构只是被当作了一种正则化。
没有解决的问题清单
把这一节收成几条,方便后续工作时对照:
- 从观测到结构:如何在带噪、部分可观测的感知输出上稳定地识别实体与邻接图。Kipf 等 2018 年的 Neural Relational Inference 尝试从轨迹里无监督地推断相互作用图,但它需要完整轨迹、且推断出的边没有物理语义(「有边」不等于「是摩擦还是粘附」),离可直接用于规划的结构还有距离。
- 非光滑现象:如何把接触与摩擦写进可微结构而不破坏梯度。
- 结构失配诊断:如何在不测真实系统的前提下,判断「结构假设是否成立」。
- 混合模型的可解释性:当结构化骨架与学习残差并存时,物理保证还剩多少。
- 部署形态:图模型的调度单位与 LLM 推理框架不兼容,缺少统一的运行时抽象。
小结
结构化世界模型的核心思想是:不要把所有东西都交给数据去学,把能写进结构的部分写进结构。 关系结构决定「谁和谁作用」,守恒结构决定「状态允许怎么变」。
Interaction Networks 把世界写成实体与关系,用成对函数加求和聚合,第一次让模型在物体数量变化时仍然成立;GNS 把节点换成粒子、把关系换成空间邻接,加入动态建图、多层消息传递与训练噪声,把规模推到数万粒子;HNN 让网络只学一个标量哈密顿量,用自动微分构造向量场,使能量守恒成为方程形式的副产品;LNN 在哈密顿量不可用的情况下改用拉格朗日量,绕开共轭动量,用广义质量矩阵的逆直接算出加速度。这四者共同回答了世界模型设计里的一个基本问题:哪些性质应当由结构保证,哪些才值得用参数去逼近。
从推理账本看,结构化模型的成本随粒子数与子步数增长,规模合适时比视频模型便宜两个数量级,但它需要干净的物体级状态,且对非光滑动力学最不擅长。从与系列其他路线的接口看,几何表示提供空间,槽位提供节点,分层提供时间尺度,记忆提供查询地址,闭环误差提供诊断——结构化的图与守恒量,是这些部件之间最容易互相咬合的一层。
在 2026 年的语境里,结构化世界模型正在以「混合形态」重新出现:图网络做骨架、Transformer 做节点函数、等变性做坐标对称、算子学习做分辨率泛化。理解这条老路线的机制与边界,是判断一个新世界模型工作究竟「多了一个结构」还是「只多了一个名字」的可靠依据。
本篇回填了系列里一直空着的那一层:世界模型不只是一串 token 或一个潜向量,它也可以是一组实体与一组约束。下一阶段,这条线要回答的是「结构从哪来」——感知、识别、标定、事件检测如何与图结构、守恒结构结合成一个端到端的闭环。站内已经拆过的几何表示(NeRF、3DGS 与占用栅格)、物体槽位(Slot Attention)与闭环误差诊断(误差走进闭环),恰好是这个问题上半部分最相关的三块积木。
参考资料
- Interaction Networks for Learning about Objects, Relations and Physics(Battaglia 等,NeurIPS 2016,arXiv:1612.00222)
- Learning to Simulate Complex Physics with Graph Networks(Sanchez-Gonzalez 等,ICML 2020,arXiv:2002.09405)
- Hamiltonian Neural Networks(Greydanus、Dzamba、Yosinski,NeurIPS 2019,arXiv:1906.01563)
- Lagrangian Neural Networks(Cranmer 等,ICLR 2020 Deep Differential Equations Workshop,arXiv:2003.04630)
- Relational inductive biases, deep learning, and graph networks(Battaglia 等,arXiv:1806.01261)
- Neural Relational Inference for Interacting Systems(Kipf 等,ICML 2018,arXiv:1802.04687)
- Neural Ordinary Differential Equations(Chen 等,NeurIPS 2018,arXiv:1806.07366)
- Physics Informed Deep Learning(Part I): Data-driven Solutions of Nonlinear Partial Differential Equations(Raissi 等,arXiv:1711.10561)
- E(n) Equivariant Graph Neural Networks(Satorras、Hoogeboom、Welling,ICML 2021,arXiv:2102.09844)
- Fourier Neural Operator for Parametric Partial Differential Equations(Li 等,ICLR 2021,arXiv:2010.08895)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



