


Mixture-of-Transformers 完全拆解:按模态拆开注意力与 FFN,多模态大模型如何用一半 FLOPs 追平稠密基线
多模态大模型近两年的主流做法是把一切模态都变成 token:图像切成像素块后过 VQ-VAE 量化成 1024 个离散 token,语音用自监督编码器抽成每 40ms 一个的语义 token,然后把它们和文本 token 拼成一条序列,喂给同一个 Transformer(代表工作是 Chameleon)。这条路线的诱人之处在于极简——不管什么模态,最后都只是词表更大的自回归语言模型。
但这套”统一词表、统一参数”的做法有一个被忽略了的事实:即使模型从头到尾只用一套权重、并且从未被告知哪些 token 属于哪个模态,它的中间特征仍然按模态自然地聚成三团。Mixture-of-Transformers(MoT)正是从这个观察出发:既然模型内部本来就在”分模态地处理”,为什么不把这件事显式地做在架构上?
MoT 由 Weixin Liang(Stanford University)与 Meta AI 团队提出,发表于 Transactions on Machine Learning Research(TMLR)2025 年 4 月,arXiv 编号 2411.04996。用一句话概括它的主张:在不改变 token 表示、不引入跨模态注意力层的前提下,把每个 Transformer 层里所有非嵌入参数按模态拆成几套独立的投影矩阵、FFN 与归一化,只保留”全局自注意力”这一处跨模态交互,就能用 37%~56% 的预训练 FLOPs 追平稠密基线。
这篇文章沿 MoT 的设计逻辑逐层拆解:为什么先要做特征空间分析、解耦发生在哪些参数上、全局注意力又是如何把被拆开的几路计算重新拼起来的;随后看它在三种多模态设定(纯自回归的 Chameleon、加入语音的三模态、文本自回归+图像扩散的 Transfusion)下的实验口径,逐项解读消融和 Leave-One-Out 分析给出的”哪一部分参数最值得拆”的结论;最后讨论它在 ML Systems 层面的参数-FLOPs 比、分组 GEMM 与推理部署时的批处理问题。
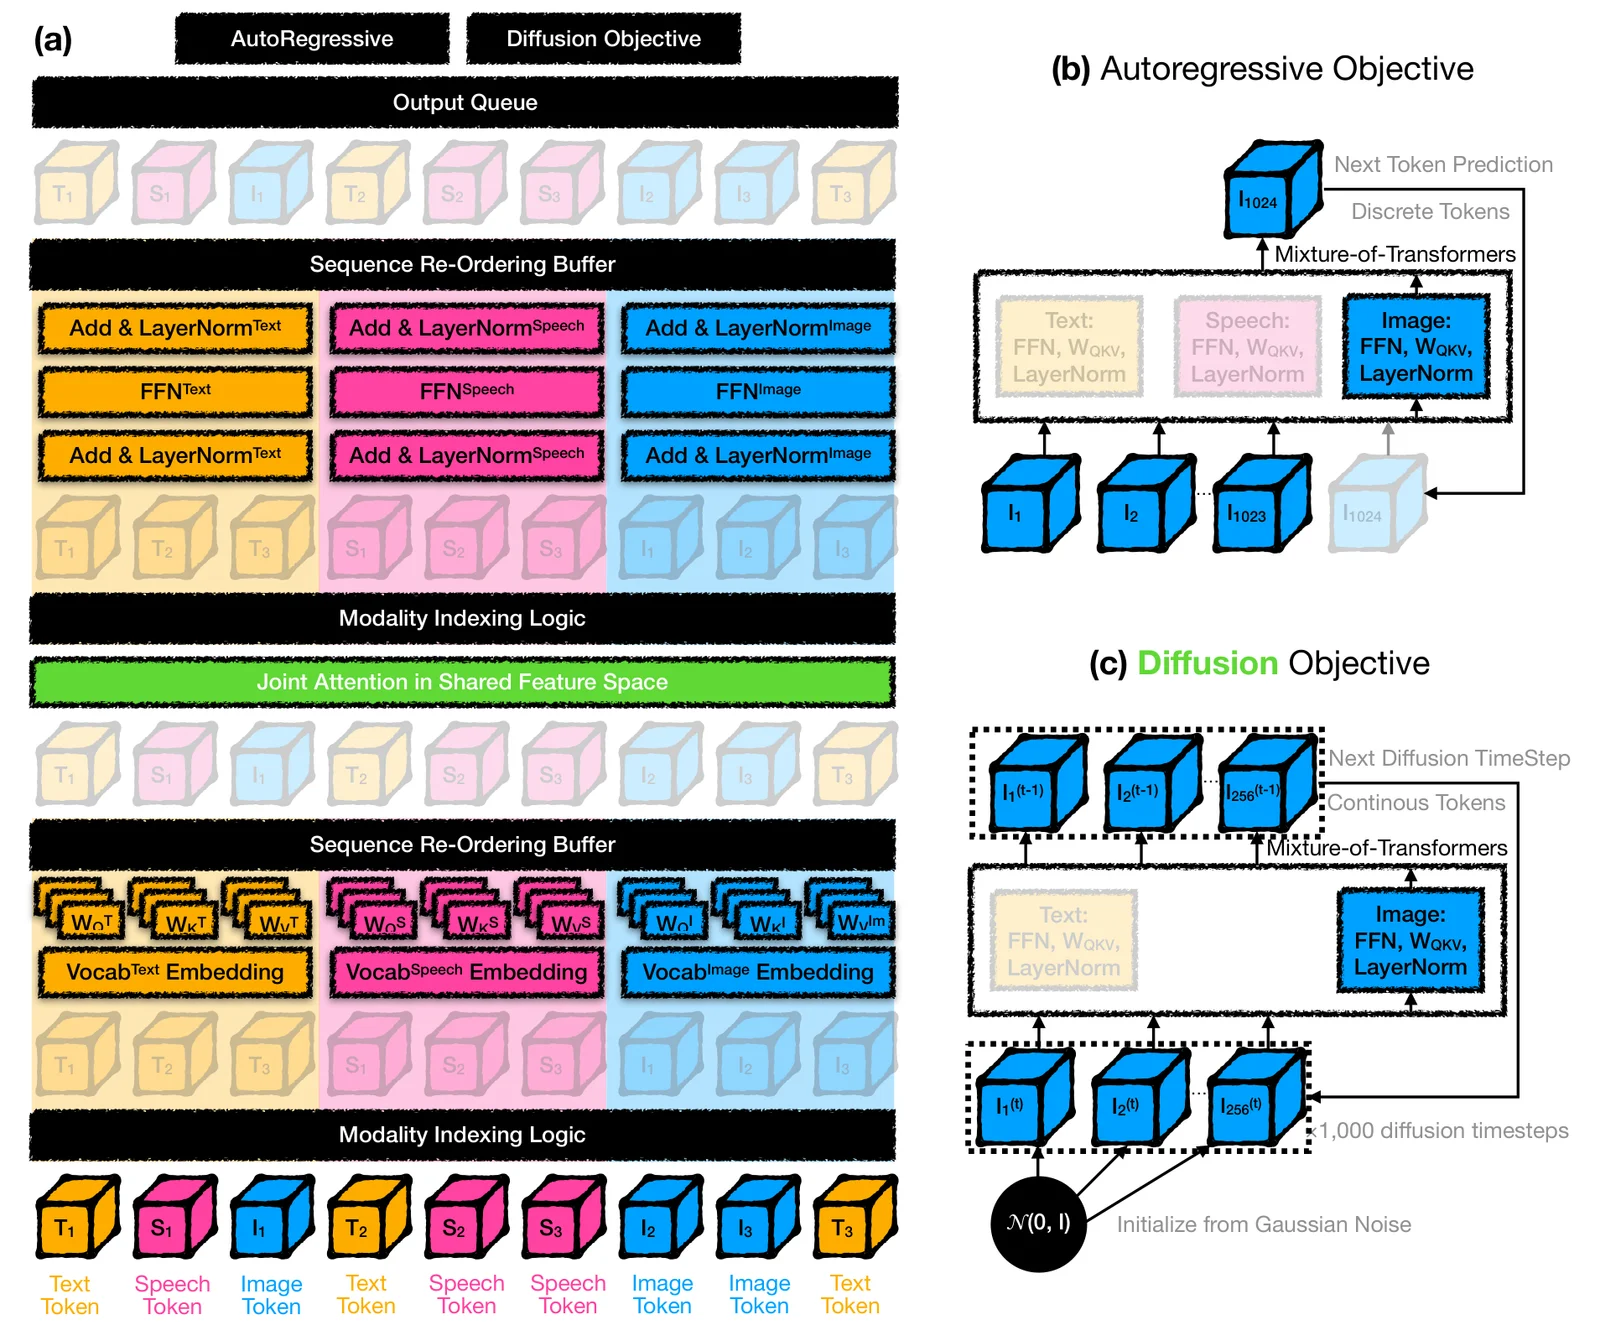
上图是论文图 1:上半部分是自回归目标下的多模态模型,文本、语音、图像的 token 拼成一条序列,每个 token 在每一层只激活对应模态那一套权重;下半部分(b)把图像换成扩散目标(第 步的带噪隐变量),MoT 的参数组织方式不变,变的只是输出头与损失函数。这张图先给出一个宏观印象:MoT 不是一个新的 tokenization 方案,而是在”已经统一成 token 序列”的既有数据格式上,重排参数的归属。
背景:统一 token 序列之后,代价落在哪里
要理解 MoT 为什么值得单独设计一套架构,得先把多模态基础模型的几条技术路线摆在一起。它们的分歧不在”要不要用 Transformer”,而在不同模态的信息在什么位置、以什么方式相遇。关于这几条路线(双塔对齐、投影连接、交叉注意力、统一词元)的信息流差异,站内另有一篇多模态大模型的四种融合机制做过横向对比,这里只取与 MoT 直接相关的两类。
早期融合:Chameleon 式的一条序列
Chameleon 是 MoT 最主要的实验底座。它把图像交给一个预训练的图像 tokenizer(VQGAN 一类),把一张图压成 1,024 个离散 token,词表因此同时覆盖文本与图像;训练时文本 token 与图像 token 按大致 1:1 的比例混在同一条序列里,用单一的自回归目标预测下一个 token。语音同理:MoT 的三模态实验里,语音被一个类 DinoSR 的 tokenizer 切成词表大小 500 的语义 token,每个 token 对应 40ms 音频,采样率相当于 25Hz。
这种做法的好处是干净:整个模型就是一个词表更大的语言模型,图像生成退化成”按顺序吐 1,024 个图像 token”的自回归解码,文本与图像可以在同一条序列里交错,天然支持”先写一段描述再画图”这类任务。代价则藏在计算里:每一个 token、每一层,都要经过同一套完整的注意力投影与 FFN,不管它是文本还是图像。一张 256×256 的图在 Chameleon 里要占 1,024 个位置,而一段 1,024 token 的中文文本大约是 700~800 个汉字的信息量;图像 token 的单位信息密度远低于文本,却和文本 token 付一样的参数访问成本。
论文给出的量化背景是:多模态模型的预训练相比纯文本 LLM 需要显著更大的数据量与算力。这句话可以拆成两层。第一层是序列变长:同样大小的图片塞进上下文,token 数远超等信息的文本。第二层是参数利用率:同一套 FFN 要同时拟合”下一个汉字是什么”和”这块 16×16 像素区域该是什么颜色”两种统计规律,梯度方向天然冲突,模型只能用更大的容量去兼容,而更大的容量又意味着每个 token 的 FLOPs 更高。
第二条路线:Transfusion 式的双目标
Transfusion 保留了文本的自回归目标,但图像不走离散 token,而是用 VAE 把 256×256 的图做 8×8 空间下采样,得到一串连续 patch 向量;文本位置用语言建模损失,图像位置用扩散损失(对加噪隐变量做去噪回归),两种损失在同一个 Transformer 里联合训练。图像序列用 BOI/EOI 特殊 token 包起来,和文本 token 拼在同一条序列中。
与 Chameleon 相比,Transfusion 的图像质量上限更高(连续表示不受离散码本限制),但它把”同一套参数要服务两种完全不同的目标函数”这件事摆到了台面上:文本位置要的是分类分布的交叉熵,图像位置要的是连续回归的去噪误差,两者对 FFN 的期望更新方向差别更大。MoT 的实验特意覆盖了这个设定,原因就在这里——如果按模态拆参数真的有效,那么在目标函数也按模态分裂时,收益应该更明显。
第三条路线:交叉注意力,以及它为什么不是 MoT
Flamingo 一类工作用独立的视觉编码器加一组 cross-attention 适配层,把图像特征注入语言模型。这条路线在工程上很成熟,模型可以分别训练、分别升级,图像编码器也不必和语言模型同宽。但它有两个结构性问题:
- 层数代价:cross-attention 是额外插入的层,不是替换原有层。为了不让插入层成为瓶颈,通常要在一个很深的语言模型里周期性插入,整体深度和显存都要增加。
- 归一化口径:cross-attention 的注意力权重只在”文本 query × 图像 key”之间归一化,图像 token 之间、文本 token 之间的注意力分布与统一自注意力不同。对于需要图像与文本在同一序列里互相决定”下一个 token 是什么”的交错生成任务,这种分离反而不自然。
MoT 明确选择了另一条路:不插入新层,只把原层里的参数按模态复制几份,注意力仍然在整条序列上做全局 softmax。这一点是全文最容易被误读的地方,后面讲公式时会展开。
直接证据:稠密模型的特征本来就按模态分团
MoT 的立论不是纯思辨,论文先做了一个诊断实验:拿一个已经训练好的 Chameleon+Speech 7B 稠密模型,取第 1、5、17、32 层的隐状态做 PCA,把 token 投影到二维平面上按模态染色。结果是:尽管模型从头到尾只用一套参数、也没有任何模态标记输入,文本、图像、语音的隐状态在各个深度上都聚成互相分离的团。论文附录还把 4%、24%、50%、100% 四个训练检查点都画了出来,这种分团在训练早期就已出现,并随训练推进变得更清晰。
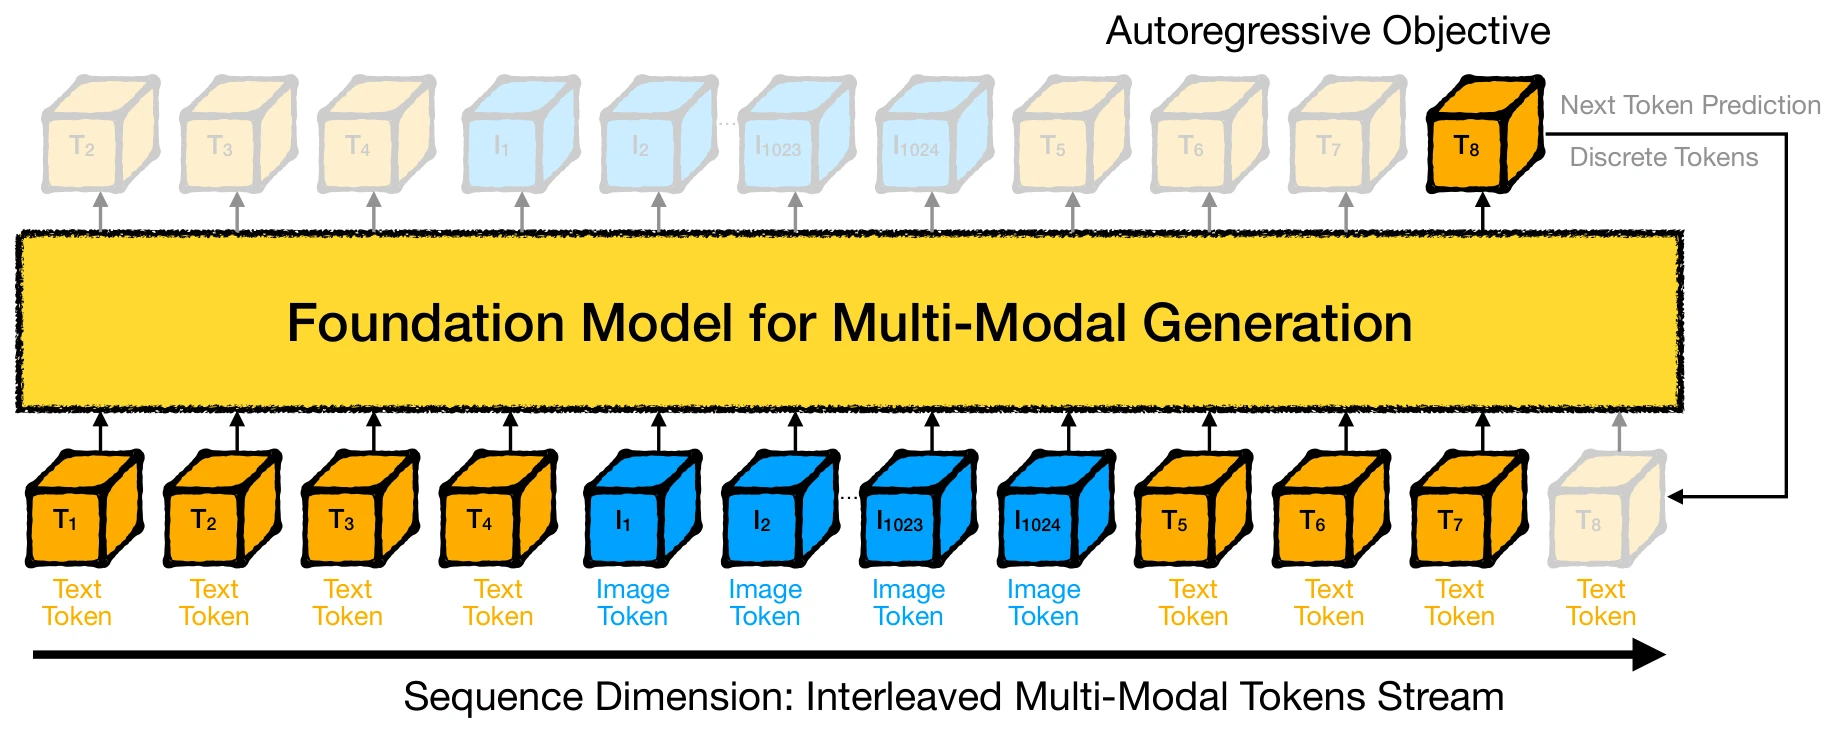
上图是论文图 2a 的稠密基线示意:文本 token(T)与图像 token(I)交错排成一条序列,全部经过同一个 Transformer。请注意它与 MoT 的差别不在输入格式——输入完全一样——而在每个位置实际调用哪一套权重。论文用这个诊断说明:稠密模型内部已经在特征空间里”分区”,但它在计算上仍然让所有 token 走同一条参数通路,等于把已经存在的分区结构浪费掉了;MoT 要做的就是把这种隐式的分区变成显式的、可调度的参数分区。
这一点也解释了 MoT 与 MoE 的动机差异。MoE 的稀疏性来自学习出来的路由:门控网络决定一个 token 去哪些专家,路由是数据相关的、需要负载均衡、需要 all-to-all 通信。MoT 的稀疏性来自token 自身携带的模态标签:这个 token 是文本还是图像,在 tokenization 阶段就已经确定,不需要任何网络去猜。前者是”学出来的稀疏”,后者是”结构给定的稀疏”。这个区别会一路影响到最后讨论的推理部署。
核心机制:拆开投影与 FFN,但保留全局注意力
一层 Transformer 的两种写法
先看标准稠密层。设输入序列为 ,每个 ,一层可以写成:
这里 是带因果掩码的多头自注意力, 是 Q、K、V、O 四个投影矩阵(每个形状 ,多头时按头切分), 是前馈网络参数,两层 LayerNorm 各有 个可学习参数。残差连接与归一化的位置是 Pre-LN 结构,这一点对后面的分析很重要:归一化发生在残差相加之后、进入子层之前,所以按模态拆归一化参数,等价于让每个模态用自己的尺度把残差流重新标准化。
MoT 把同一层改写成按 token 所属模态取参数的形式。设 是第 个 token 的模态:
对比两式,差别只有三处:注意力的计算从 变成 ;LayerNorm 的下标多了 ;FFN 的参数多了 。残差流 本身没有任何模态专属参数,token 嵌入也是共享的——这是 MoT 能保持”一个模型”而不是”三个模型拼起来”的关键。
全局注意力到底”全局”在哪里
论文把 展开成:
严格说,第一个式子是按第 行写的, 随 query token 的模态变化;把它写成一个矩阵乘法时,输出投影是一组按行拼接的分块操作。符号逐个解释:
- 是按 token 自身模态选择的投影矩阵。文本 token 用文本的 ,图像 token 用图像的 。
- 是把各模态分别投影后的结果按原始序列顺序拼回去得到的完整矩阵,形状仍是 。
- 是在整条序列上做的,跨模态的 query-key 对全部参与竞争同一个归一化分母。这就是”global”的含义。
- 又切回按 query token 的模态选择——输出投影属于”这个位置要写回哪个模态的残差流”。
这里有一个容易被忽略、但必须讲清楚的细节:Q 和 K 来自不同的投影矩阵。一个文本 query 与一个图像 key 做点积时,左边是 产出的向量,右边是 产出的向量。两个矩阵从不共享参数,模型必须自己学出”文本 query 空间”与”图像 key 空间”之间可比较的几何关系。这与标准自注意力(Q、K 同源)有本质区别,也是 MoT 里唯一需要跨模态对齐的学习问题。相比之下,V 与 O 的错配影响较小:V 只被加权求和,O 只做线性回写,二者的组合可以吸收一部分尺度差异。
反过来说,如果连注意力都按模态完全隔离(文本只注意文本、图像只注意图像),模型就退化成三个独立模型,交错生成时”文本描述决定图像 token”的能力会消失。MoT 选择保留全局 softmax,正是为了守住这条跨模态通路。
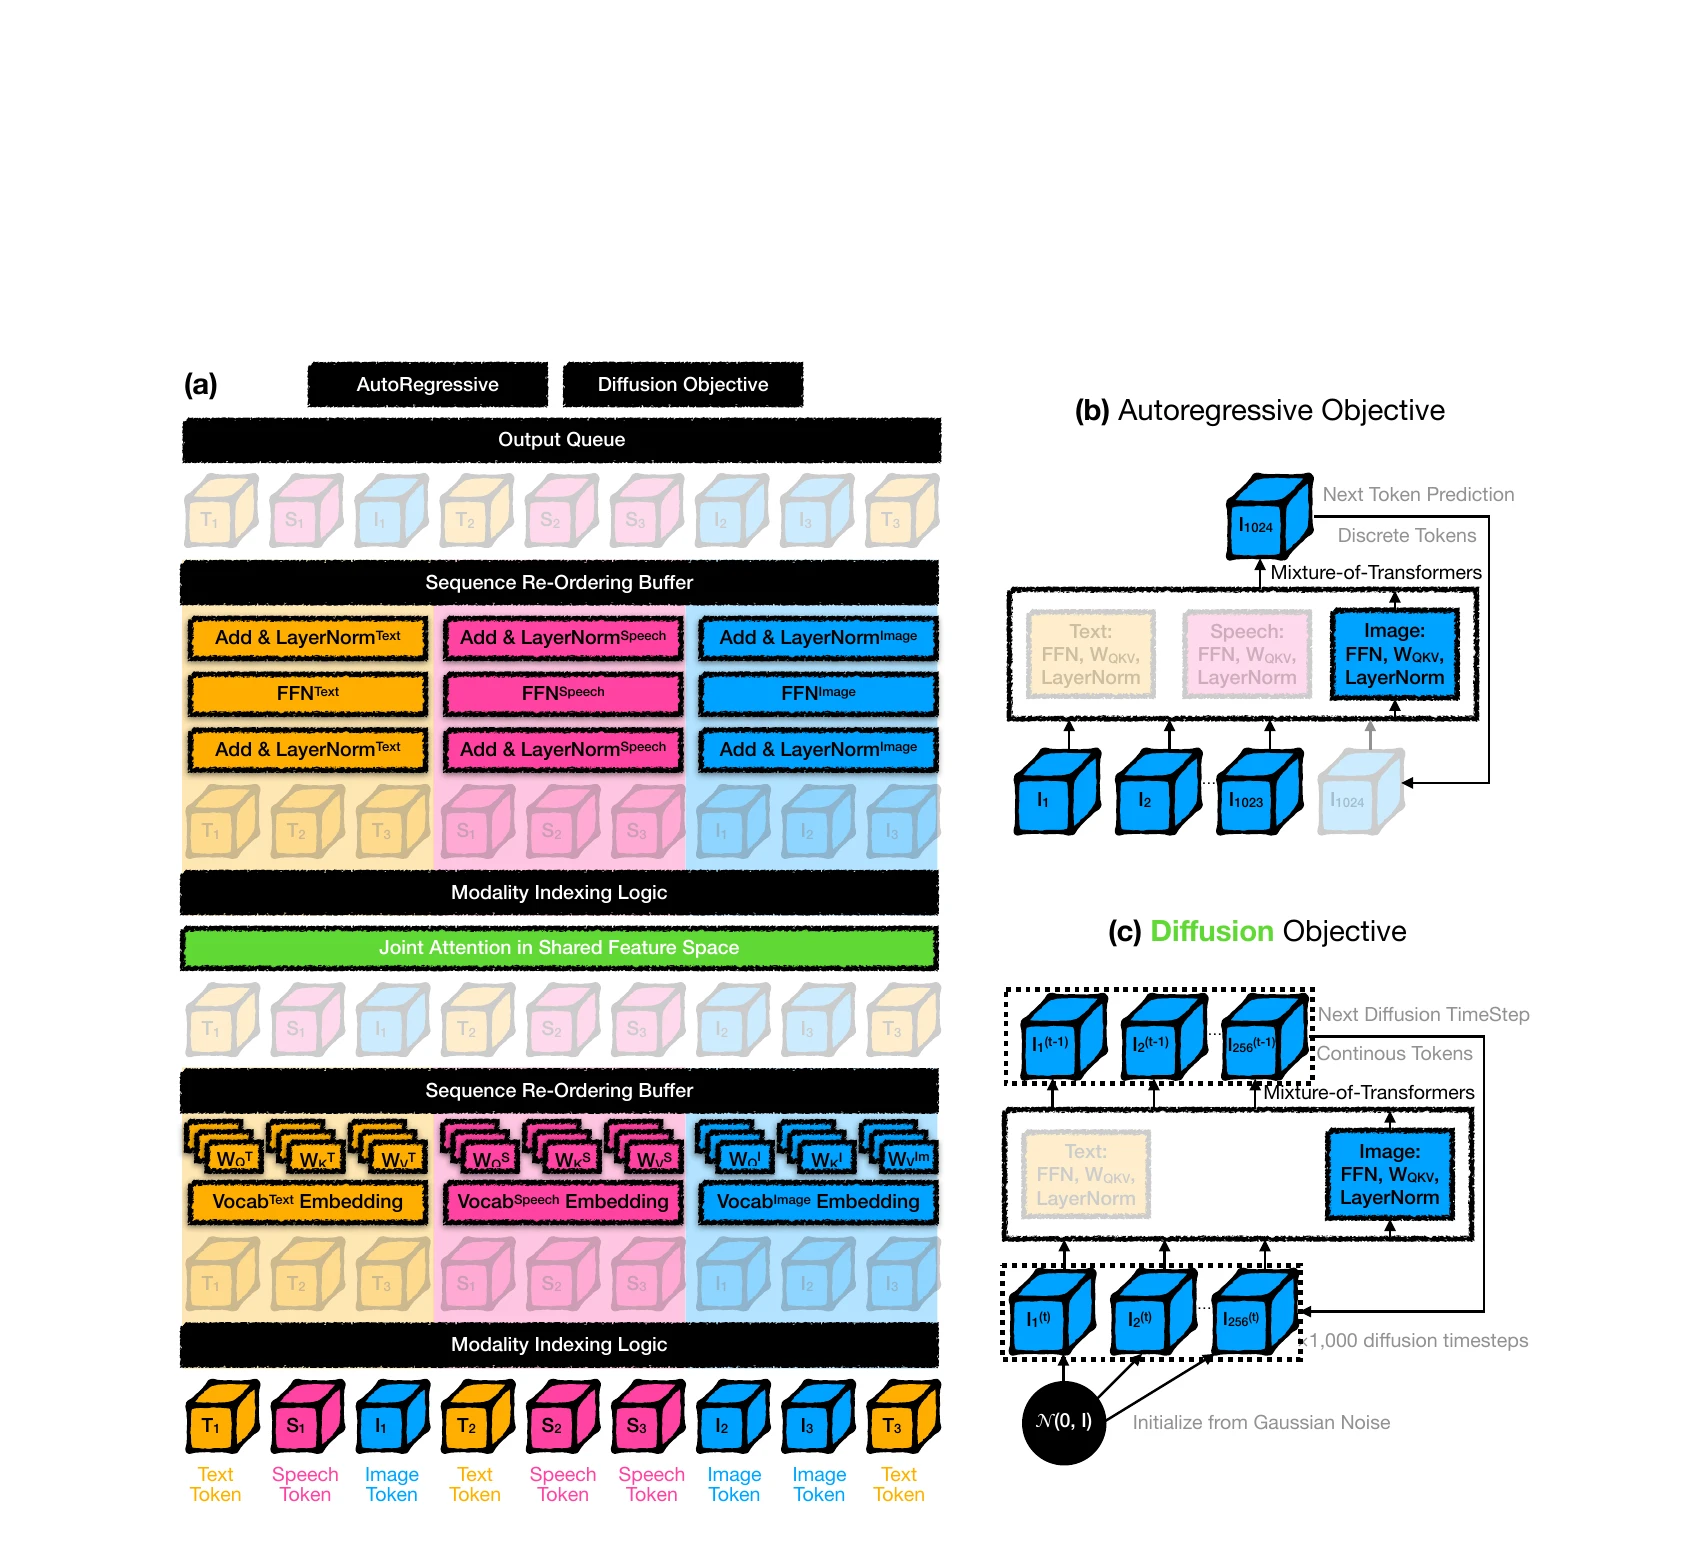
上图是论文图 3 的结构示意。左侧的 Modality Indexing Logic 是整张图的核心:它不学习、不产生权重,只根据 token 的模态标签把位置索引分成几组。中间一列是 Sequence Re-Ordering Buffer,负责把”按模态分组后连续排布”的张量在计算完投影之后还原成原始交错顺序——这个缓冲区是纯索引操作,不改变任何数值。右侧两个虚线框分别对应自回归目标与扩散目标:图像既可以是离散 token 序列(上),也可以是连续 patch 加噪后的隐变量(下),MoT 的参数组织对两者一视同仁。图中标注的 、、 分别是文本、语音、图像 token。
逐行读 Algorithm 1
论文给出的计算流程可以直接对照实现:
输入:序列 x = (x_1, ..., x_n),每个 x_i ∈ R^d,模态 m_i ∈ {text, image, speech}1: 令 M = {text, image, speech}2: for each modality m in M do3: I_m ← { i : m_i = m } # 该模态的 token 位置4: X_m ← { x_i : i ∈ I_m } # 按模态分组5: Q_m ← W_Q^m X_m6: K_m ← W_K^m X_m7: V_m ← W_V^m X_m8: end for9: Q ← 按原始顺序合并 {Q_m},K、V 同理10: A ← softmax(Q K^T / sqrt(d_k)) V # 全局自注意力11: for each modality m do12: A_m ← 取出 A 中属于模态 m 的行13: h_m ← X_m + LayerNorm_attn^m(A_m W_O^m)14: out_m ← h_m + LayerNorm_ffn^m(FFN_m(h_m))15: end for16: 按原始顺序合并 {out_m}这段伪代码里有两处工程上值得停一下:
第一,第 9 行的”按原始顺序合并”不是可选的整理步骤,而是正确性要求。因果掩码是按原始位置定义的:第 个 token 只能看到 。如果分组后忘记还原顺序,掩码就会作用在错误的索引对上,自回归训练直接失效。实现上通常预先算好一次 与逆置换 ,整个前向复用同一份索引——因为一条序列里 token 的模态不会变,这份索引在一次迭代内是常量。论文在系统章节也明确提到,缓存每个模态的序列索引可以显著降低索引开销,且每次迭代只需计算一次。
第二,分组只影响投影,不影响注意力的数值语义。把 连续排布只是为了让 能做成一次批量矩阵乘;投影完再散回原位,注意力矩阵与”逐 token 选矩阵、原地计算”完全等价。这也是为什么 MoT 可以用分组 GEMM 加速而不改变数学定义。
三个”为什么不”
为什么不像 MoE 那样让路由器决定? 因为模态标签是免费的。MoE 的门控要解决”这个 token 该给哪个专家”,而 MoT 的答案在 tokenization 阶段就写死了。省掉路由器不只是省一点 FLOPs,更重要的是省掉了路由带来的三个系统负担:负载不均衡、token 丢弃/复制、专家并行的 all-to-all。代价是 specialization 的粒度变粗——一个模态内部的所有 token 共享同一套 FFN,无法再细分(这一点后面会讨论)。
为什么不像 Flamingo 那样加 cross-attention? 因为 cross-attention 会增加层数与参数量,而且它的 softmax 只在”文本 query × 图像 key”上归一化,图像 token 彼此之间不竞争。MoT 想要的是”一条序列、一个 softmax”,这样图像 token 与文本 token 在同一个概率空间里互相解释,交错生成时的条件关系最自然。
为什么连 LayerNorm 也要拆? 动机是不同模态的激活分布尺度不同——图像 token 经过 VQ 码本查表,文本 token 经过词嵌入,两者的范数分布与各通道方差并不一致;用同一组 强行拉到同一尺度,会让某些通道对某一模态过大、对另一模态过小。不过论文的消融显示,拆 LayerNorm 带来的收益几乎可以忽略(下一节会给出具体口径)。这说明”按模态拆参数”的收益并不是均匀分布在所有参数上的,拆哪里很关键。
实验口径:FLOPs 受控的等预算比较
MoT 的实验设计里有一条规则必须先讲清楚,否则后面所有百分比数字都会被误读:所有对比模型都是等 FLOPs 的、都是从零预训练的。
这意味着 MoT 的收益不是”参数量更多所以更强”。论文特意强调,在每个训练 step 里,稠密基线与 MoT 实际使用(激活)的非嵌入参数数量几乎相同——MoT 不是靠每一步多用参数赢的,而是把活跃参数按模态组织成互不干扰的子集,让每个模态在自己的子集上获得更窄、更专注的更新方向。参数如何存储是另一回事,后面参数账本一节会算清楚:MoT 的存储规模远大于稠密基线。这一点与 MoE-4x 基线形成鲜明对比:MoE-4x 因为有多组专家分支,原始参数量本就更大,但论文发现这些额外参数并没有稳定转化为更好的跨模态表现。
训练侧的 “step matching” 怎么读
MoT 报告加速用的主指标是 step matching:在横轴上画出稠密基线达到某个损失所需的训练步数,纵轴画出 MoT 在同一损失水平下所需的步数,两者之比记作缩放系数 。 就表示 MoT 只要 45.5% 的步数就能追平。由于所有模型在相同的 GPU 数、相同的 batch、相同的序列长度下训练,步数比例可以直接换算成训练 FLOPs 比例。论文把这一步换算写得很明白:MoT 在 55.8% 的训练步数处就达到或低于稠密模型的最终验证损失,即训练 FLOPs 节省 44.2%。
这里有一个口径细节:训练损失与验证损失给出的比例并不完全一样(训练上 45.5%,验证上 55.8%)。论文用验证损失的数字来宣称 FLOPs 节省,是因为验证指标更贴近”训练之后模型能不能用”,而且它更保守——用更保守的数字宣称收益,在对比实验里是合理的做法。
三种设定下的结果与解读
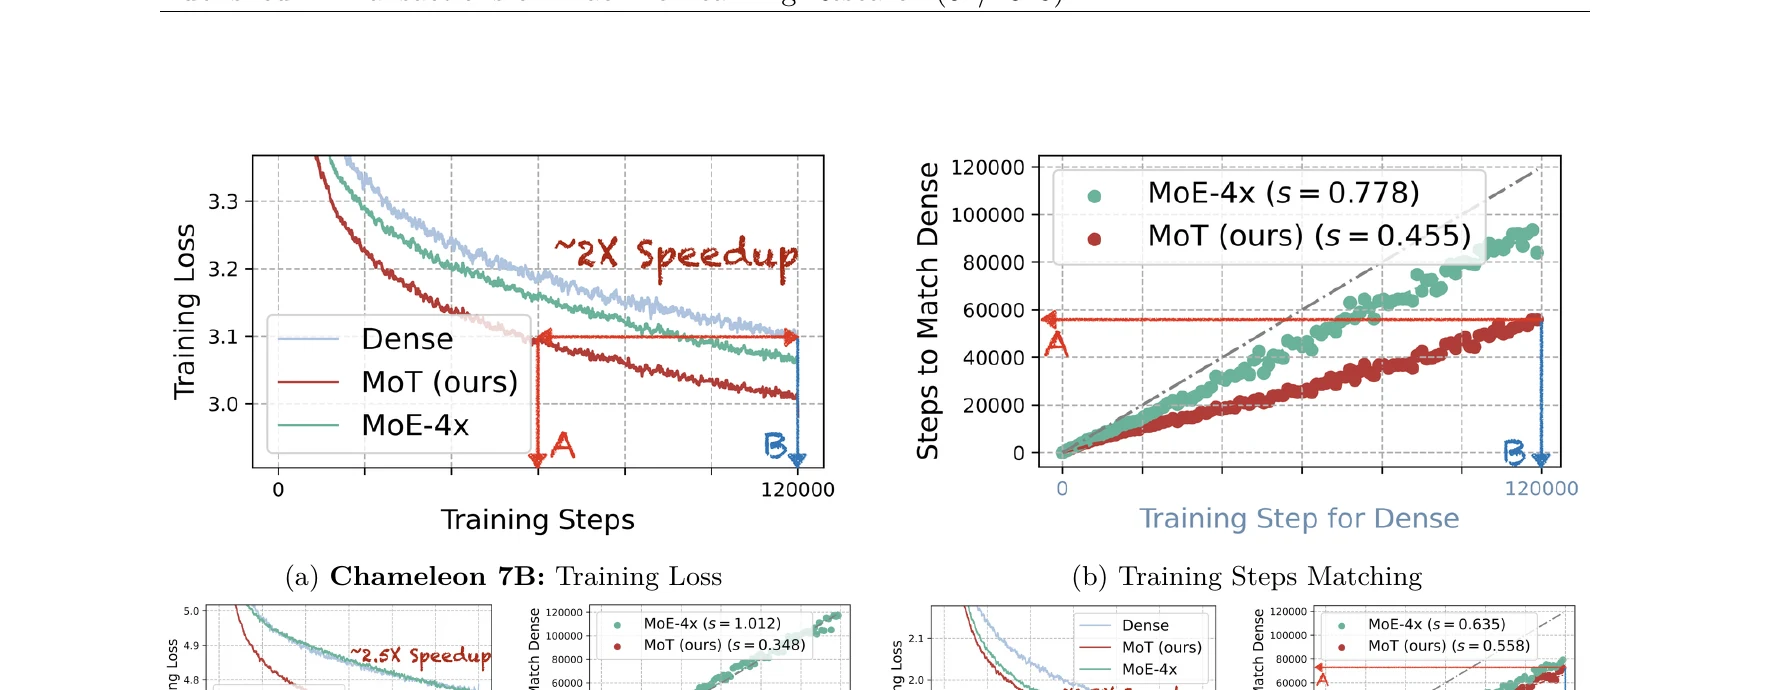
上图取自论文图 5 的上半部分,是整篇实验里信息量最密的一组曲线。(a) 是 7B Chameleon 设定的全局训练损失:MoT 的曲线在三个模型里下降最快,在 60,000 步时达到稠密模型 120,000 步的最终损失。(b) 是步数匹配图,图例标出的缩放系数很直观——稠密记作 1.0,MoE-4x 为 0.778,MoT 为 0.455。(c) 到 (f) 按模态拆开:图像模态上 MoT 的系数是 0.348,MoE-4x 是 0.635;文本模态上 MoT 为 0.558,MoE-4x 反而略差于稠密(约 1.012)。这组数字说明两件事:MoT 的加速主要来自图像模态;MoE-4x 的稀疏化对文本略有效、对图像基本无效,而 MoT 恰好补上了 MoE 补不上的那一块。
Chameleon:文本+图像,纯自回归
实验数据一律沿用 Chameleon 的混合模态训练集与图像 tokenizer,文本与图像 token 数量大致相当,序列长度固定 4,096。模型规模覆盖 37M、94M、443M、1.5B、7B 五档,隐层维度从 256 到 4096,层数 4 到 32,头数 8 到 32;小模型训练 160k 步、大模型 120k 步,总 token 数 0.168T 到 0.377T。
7B 档的结论前面已经列出:全局损失 45.5% 步数、图像 34.8%、文本与 MoE-4x 相当或略优。跨规模的结果更有意思:图像模态上 MoT 在所有规模都有显著加速,而 MoE-4x 的优势随规模增大逐渐消失,到 7B 时已经不明显。论文没有给出一个被证明的机制来解释这一现象,但结合后面系统章节的参数-FLOPs 比分析,一个合理的解读是:MoE 的专家容量随规模增长而膨胀,而图像 token 的信息密度低、单个 token 能消化的容量有限,多出来的专家容量在图像上找不到足够有效的用途;MoT 的每步活跃参数被锁定在稠密水平,不会出现这种”多余的容量”问题。
Chameleon + Speech:第三个模态
语音加入后,训练集约等于”语音集 : 文本图像集 = 1 : 6”。语音 token 来自类 DinoSR 的语义编码器,词表 500,每个 token 覆盖 40ms 音频。三模态的 7B 结果里,语音模态的加速最夸张:步数匹配系数为 0.229,也就是说 MoT 只花 22.9% 的训练步数就追平稠密模型的语音损失;对应验证损失口径下需要 37.2% 的 FLOPs。跨规模(443M 到 1.5B)时,语音模态的步数系数落在 15.1% 到 33.6% 之间。
语音为什么收益最大?一个站得住脚的解释是分布差异。语音 token 的词表只有 500,语义编码器输出的 token 分布与文本、图像 tokenizer 的输出截然不同,用同一套 FFN 去拟合三种差异巨大的分布,冲突最严重;一旦给语音单独一套参数,冲突立刻解除。反观文本:文本 token 在混合数据里占比高、统计规律与纯文本训练相近,稠密模型本就不算吃力,所以拆开后的增益相对小。
这里也是 MoE-4x 表现最不稳定的地方。三模态设定下,MoE-4x 在训练损失上能赢稠密基线,但在语音验证集(LL60K、PPL30K)上反而不如稠密基线。论文给出两个原因:一是 Expert Choice 路由对数据分布偏移敏感,语音验证集的分布与训练混合分布差别大,路由把 token 分到了不合适的专家上;二是 MoE-4x 原始参数更多,在语音 token 相对稀疏的混合集上容易过拟合。MoT 的按模态划分是确定性的、与数据分布无关,因此不受这类问题影响——这是”结构给定的稀疏”相对”学出来的稀疏”最直接的一次对比。
Transfusion:文本自回归 + 图像扩散
第三个设定更换了目标函数:文本用 Llama 2 分词器与语料做自回归,图像用 VAE 编码成连续 patch、以扩散目标训练,图像 256×256、8×8 下采样,并用 BOI/EOI token 包起图像序列。这里的核心对比是 760M 的 MoT 对比 1.4B 的稠密 Transfusion,前者训练与推理 FLOPs 都只有后者的一半:
| 指标 | 760M MoT | 1.4B 稠密 | 方向 |
|---|---|---|---|
| CLIP score | 0.214 | 0.206 | 越高越好 |
| FID | 21.145 | 24.688 | 越低越好 |
| CIDEr(图像描述) | 0.320 | 0.286 | 越高越好 |
这是全篇最能说明问题的一组数字:一个参数量略过一半的模型,在三个互补的图像指标上同时超过更大的稠密模型。跨规模看,图像模态的步数系数在 163M、760M、1.4B 三档分别为 17.5%~26.4%,比 Chameleon 设定下更激进——当图像目标函数与文本目标函数彻底分开时,参数分开的收益被进一步放大,这与”两种目标对 FFN 的更新方向冲突”的假设一致。
Transfusion 设定下 MoE-4x 的失败模式也值得记录:它在文本训练损失上优于稠密,但在验证集上没有体现,论文把原因归结为离散文本 token 与连续图像 patch 混在一条序列里让路由难以泛化。这一点对做推理系统的人有直接启示:MoE 的优势依赖路由质量,而路由在模态混合、目标混合的数据上最容易失准。
消融:到底哪一部分参数最值得拆
消融实验在 880M、Chameleon 设定下做,对比四个变体:(1)稠密基线;(2)只在 FFN 上按模态拆(对应早先工作 Lin et al. 2024 的做法);(3)FFN + Q、K、V 拆、但 LayerNorm 不拆;(4)完整 MoT。
结果分为两层。第一层:只拆 FFN 就已经带来明显提升,图像模态增益最大。第二层:在 FFN 之外再拆 Q、K、V,在 Obelisc 验证集上相对”只拆 FFN”再额外节省约 33.3% 的图像 FLOPs、10% 的文本 FLOPs。注意这里的措辞是”叠加节省”,论文同时指出,从稠密到”只拆 FFN”的收益,大于从”只拆 FFN”到”再拆注意力”的收益。第三层:在 FFN 与注意力都拆的基础上再拆 LayerNorm,指标变化几乎可以忽略。
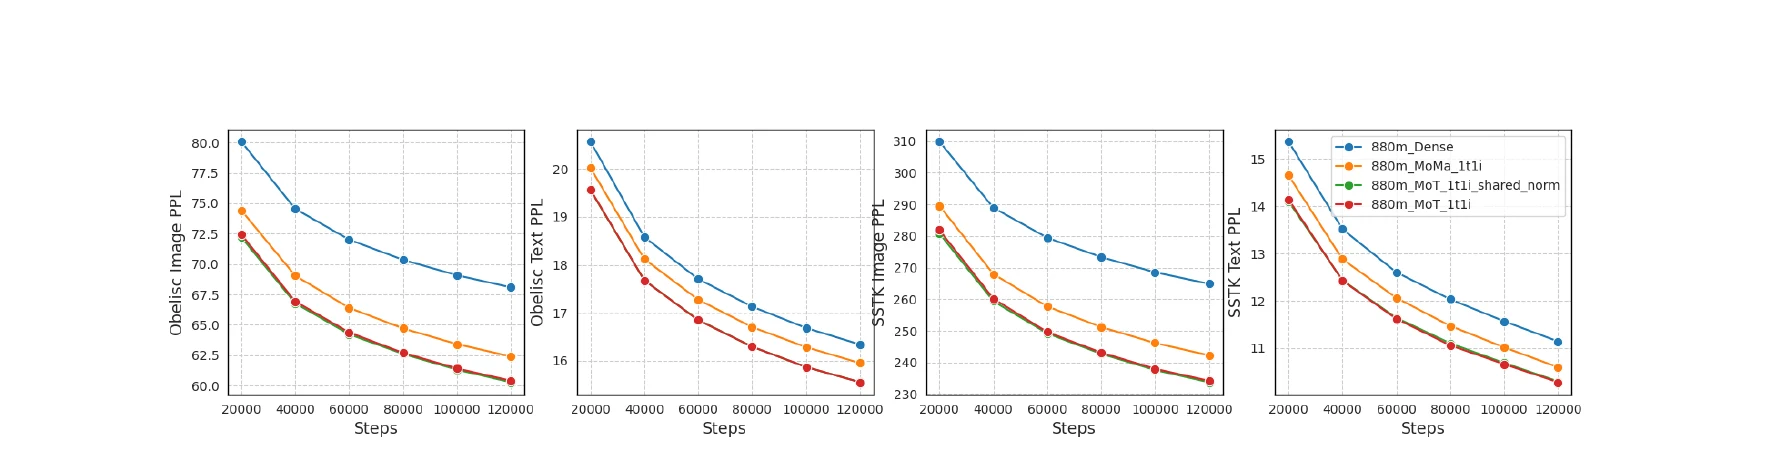
上图是论文图 14 的消融曲线,图例里能直接看到几个变体:稠密(880m_Dense)、只拆 FFN(880m_MoMa)、完整 MoT,以及一条名为”共享归一化”(shared_norm)的变体——它拆了 FFN 与注意力、但 LayerNorm 参数仍由各模态共用。曲线越早下落到低点,说明同等步数下损失越低。可以看到图像侧的差距最明显,文本侧几条曲线贴得更近,这与前面”图像收益最大、文本收益较小”的结论一致;共享归一化的那条曲线与完整 MoT 几乎重合,正是论文所说”再拆 LayerNorm 收益可以忽略”的直接体现。
为什么 FFN 的拆解收益大于注意力?论文给出两点解释,都值得展开:
- FLOPs 占比:在 4,096 的序列长度下,注意力随序列长度线性增长,FFN 随隐层维度平方增长;对一个固定宽度的模型,FFN 在每层 FLOPs 里占了更大比例。拆掉最”重”的部分,边际收益自然最大。
- FFN 是记忆:论文把 FFN 类比为 Transformer 里的”记忆组件”(与近年的”FFN 作为键值记忆”解释一致),每个模态需要记忆的模式不同,单独的记忆参数最有效。注意力则更像”检索”,它的检索规则可以共用一部分,只需把检索内容(Q、K、V 的空间)按模态区分开。
这也给了一个务实的设计指南:如果算力预算有限、只想做最小改动,先拆 FFN;如果还想进一步压 FLOPs,再拆注意力投影;LayerNorm 基本可以省。
Leave-One-Out:不是”模态越多越该分”,而是三路全分最好
三模态设定下,论文又做了一个 Leave-One-Out 实验:保持总 FLOPs 不变,把其中两个模态塞进同一个 Transformer 塔,只把一个模态单独拿出来,对比三种 LOO 变体与稠密基线。
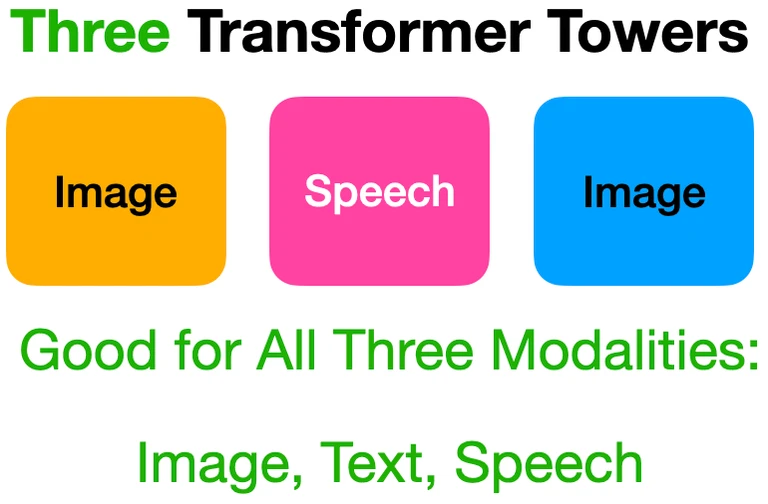
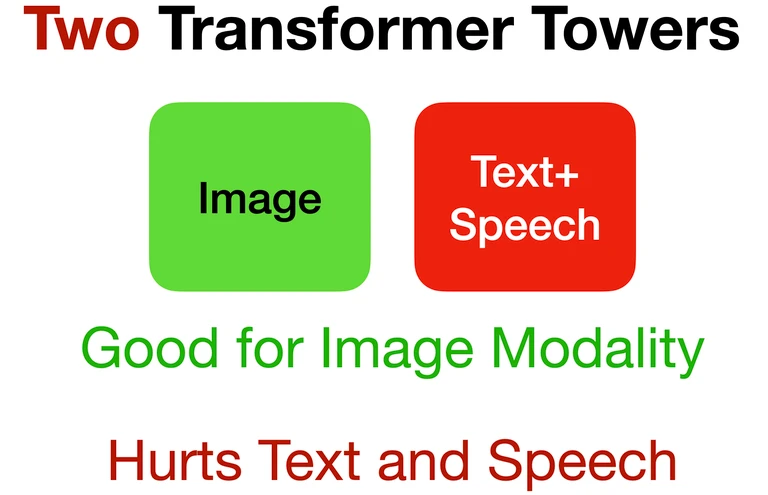
上面两张是论文图 15 中的结构示意。第一张是完整的 MoT:三个模态各一个塔。第二张是 LOO-image 变体:文本与语音合并共用一套参数,图像单列。另外两个变体与之对称(LOO-text 把图像与语音合并、LOO-speech 把文本与图像合并),第五张是全部塞进一个塔的稠密基线。
结果是:合并总是让性能变差。每个 LOO 变体在自己被单独拿出来的那个模态上损失最低,这一点是意料之中的;更有信息量的是论文观察到的非对称竞争:在 LOO-speech 变体里,单独拿出语音后语音保住了收益,但图像和文本的收益都消失了;在 LOO-text 变体里,语音与图像合并后语音性能变差,而图像基本保住了 MoT 的增益。这说明不同模态对共享参数的敏感度不同,不能简单按”模态数”均匀分配容量。这一结论对多模态模型的设计有直接意义:在模态数超过三个、或某些模态数据量很小时,把少数据模态与另一个模态合并可能比给它单独一个塔更合适,但具体怎么配,需要按模态间的竞争关系来定。
与 MoE 的组合:异构稀疏的两个正交方向
MoT 和 MoE 并不互斥,论文用两个变体验证了组合的可能:在 MoT 的文本塔里,把 FFN 换成 4 专家 MoE(其余结构不变),称为”MoT + Text MoE-4x”。论文把这一节定位为 proof-of-concept 的初步结果,而不是完整的可扩展结论,读的时候要按这个口径来理解。
在 Chameleon 设定(373M 档)里,这个混合模型在文本训练损失上进一步加速,比稠密、MoE-4x、纯 MoT 都快,同时图像侧的 MoT 加速被完整保留;在 Obelisc 验证集上,混合模型拿到最好的文本表现,图像表现与 MoT 相当或略好。Transfusion 设定(760M 档)里结论一致,且混合模型在 Transfusion 下的文本验证表现优于单纯的 MoE-4x。
这个结果的解读方式很关键:它说明”按模态稀疏”与”按专家稀疏”作用在不同的维度上。MoT 的稀疏轴是”这是哪个模态”,MoE 的稀疏轴是”这个 token 的内容适合哪些专家”。把 MoE 放进文本塔,等于在文本模态内部再做一层基于内容的细分——文本数据量大、统计规律复杂,值得更细的专家;图像塔保持 MoT 的单一 FFN,则是不动已经在图像上生效的那部分收益。站内关于 MoE 路由、DeepSeekMoE 细粒度专家切分的讨论(可参考 DeepSeekMoE 完全拆解)是理解这层细分能力的背景。
更一般地,可以把 MoT 看作对”稀疏维度”的一种重新设计。MoE 的稀疏维度是 token 内容,MoT 的稀疏维度是 token 来源。在多模态系统里,来源是免费的元信息,而内容需要学习;因此 MoT 本质上是一种利用结构先验的稀疏化,它提供的收益与 MoE 是互补的、不是替代关系。同一个系统里可以同时存在两套稀疏机制:模态层用 MoT 划分,模态内部的文本塔用 MoE 细分,两者互不冲突。
参数账本:MoT 省的到底是什么
读 MoT 的论文时,最容易产生的一个误解是”MoE 参数量大、MoT 参数量小”。这个说法只在”激活参数”的意义上成立,在”存储参数”的意义上恰好相反。把三个不同的预算分开,很多数字就顺了。
三个预算要分开算
第一,每 token 激活参数与每 token FLOPs。 MoT 的每个 token 只经过它自己模态那一套 Q、K、V、O、FFN 与 LayerNorm,所以每 token 激活的参数与同宽度稠密模型相同。稠密 7B 的每 token 前向 FLOPs 约为 GFLOPs(忽略注意力随序列长度的项),MoT 的 7B 档也是同一量级。MoT 在推理时并不比同宽度的稠密模型少算。
第二,存储参数。 这一项 MoT 比稠密大得多。设隐层维度 、层数 、模态数 ,按 SwiGLU 的中间维度 计算,单层参数约为:
MoT 存 套这样的参数,非嵌入部分的总参数量近似为:
以论文的 7B 档为例,、:单层约 M,32 层约 6.4B,加上约 65k 词表、 的共享嵌入(约 0.27B),稠密模型约 6.7B,与”7B”的名义规模吻合。K=3 时,MoT 的非嵌入参数变成三份:约 19.3B 加共享嵌入,总存储接近 19.6B,约为稠密模型的 2.9 倍。
这就是论文图注里”sparse model 的模型规模指激活参数”这句话的含义:MoT 的”7B”是每 token 激活 7B,不是只存 7B。论文在讨论 FLOPs 受控实验时也明确说过,稠密基线与 MoT 的非嵌入参数在每 token 使用的意义上几乎相同;MoE-4x 则因为专家分支多,原始参数量更大。
第三,训练总 FLOPs。 训练总 FLOPs 近似等于”每步 FLOPs × 步数 × 总 token 数”。MoT 每步 FLOPs 与稠密相同,节省全部来自步数——这正是 step matching 能直接换算成 FLOPs 比例的原因。
一张对照表
| 维度 | 稠密 | MoT(K 模态) | MoE(E 专家) |
|---|---|---|---|
| 每 token 激活参数 | 1 份 | 1 份 | 1 份专家(top-k) |
| 存储参数 | 1 份 | 约 K 份非嵌入参数 | 约 E 份 FFN |
| 路由方式 | 无 | 模态标签(确定性) | 学习门控(数据相关) |
| 路由开销 | 无 | 模态分组/索引 | top-k、scatter/gather、负载均衡 |
| 跨卡通信 | 按并行策略 | 模态塔间交换激活 | 专家 all-to-all |
| 负载均衡 | 天然均衡 | 各塔 token 数可能不均 | 需要辅助损失或 EPLB |
这张表把 MoT 的定位讲清楚了:它用存储参数换训练样本效率,同时用确定性路由换掉 MoE 的路由开销。这不是免费的午餐——多出来的 2~3 倍权重显存是真的,论文没有回避这一点,只是在训练场景里,权重显存相对于激活显存和优化器状态并不是最紧的那一项,而训练步数的节省是实打实的。
“55.8% FLOPs” 应该怎么引用
论文摘要里的”MoT matches the dense baseline using only 55.8% of the FLOPs”,指的是达到同等质量所需的训练 FLOPs。它不是”推理时每 token 省 44% 算力”,也不是”参数量减少 44%“。在引用这个数字时,把它写成”预训练 FLOPs 降到 55.8%“是准确的;写成”推理 FLOPs 降到 55.8%“就错了。
Transfusion 设定里”760M MoT 用一半训练与推理 FLOPs 超过 1.4B 稠密”的说法也是同理:这里的”一半”来自激活规模更小(760M 对 1.4B),而不是同一宽度下 MoT 比稠密快两倍。把这两个口径混在一起,会得出”MoE/MoT 能免费提速”的错误结论。
对推理部署的实际含义
把账算清楚之后,MoT 在推理侧的取舍就很明确了:
- 显存:如果同时服务三种模态,权重显存约为同宽稠密模型的 3 倍。对单卡部署这是硬约束,必须用更小的激活宽度或量化来抵消。站内讨论过的码本量化、低比特权重方案(可参考 XFP 的 3.4 位码本量化)在这里同样适用,而且因为各塔参数独立,量化粒度可以按模态分别调——文本塔对精度更敏感、图像塔可以更激进。
- KV 缓存:MoT 不减少 KV 缓存。全局注意力意味着文本 token 的每一层都要读取图像与语音 token 的 K、V,图像 token(Chameleon 里每张图 1,024 个)会把 KV 撑大。这与长上下文推理里”KV 是瓶颈”的结论一致;站内 KV Cache 相关文章里的分页、前缀复用机制在 MoT 上仍然需要,只是缓存的组织要按模态打标签。
- 只服务部分模态:如果线上只有文本+图像请求,就只需要加载两个塔,存储开销降到约 2 倍;这是 MoT 相对”统一大模型”的一个部署灵活性优势。
系统层面:参数-FLOPs 比、分组 GEMM 与开销来源
MoT 的训练收益最终要看墙钟时间,而墙钟时间在大规模分布式训练里由通信与参数访问主导,不只是 FLOPs。论文的系统章节按这个思路分析了三个方面。
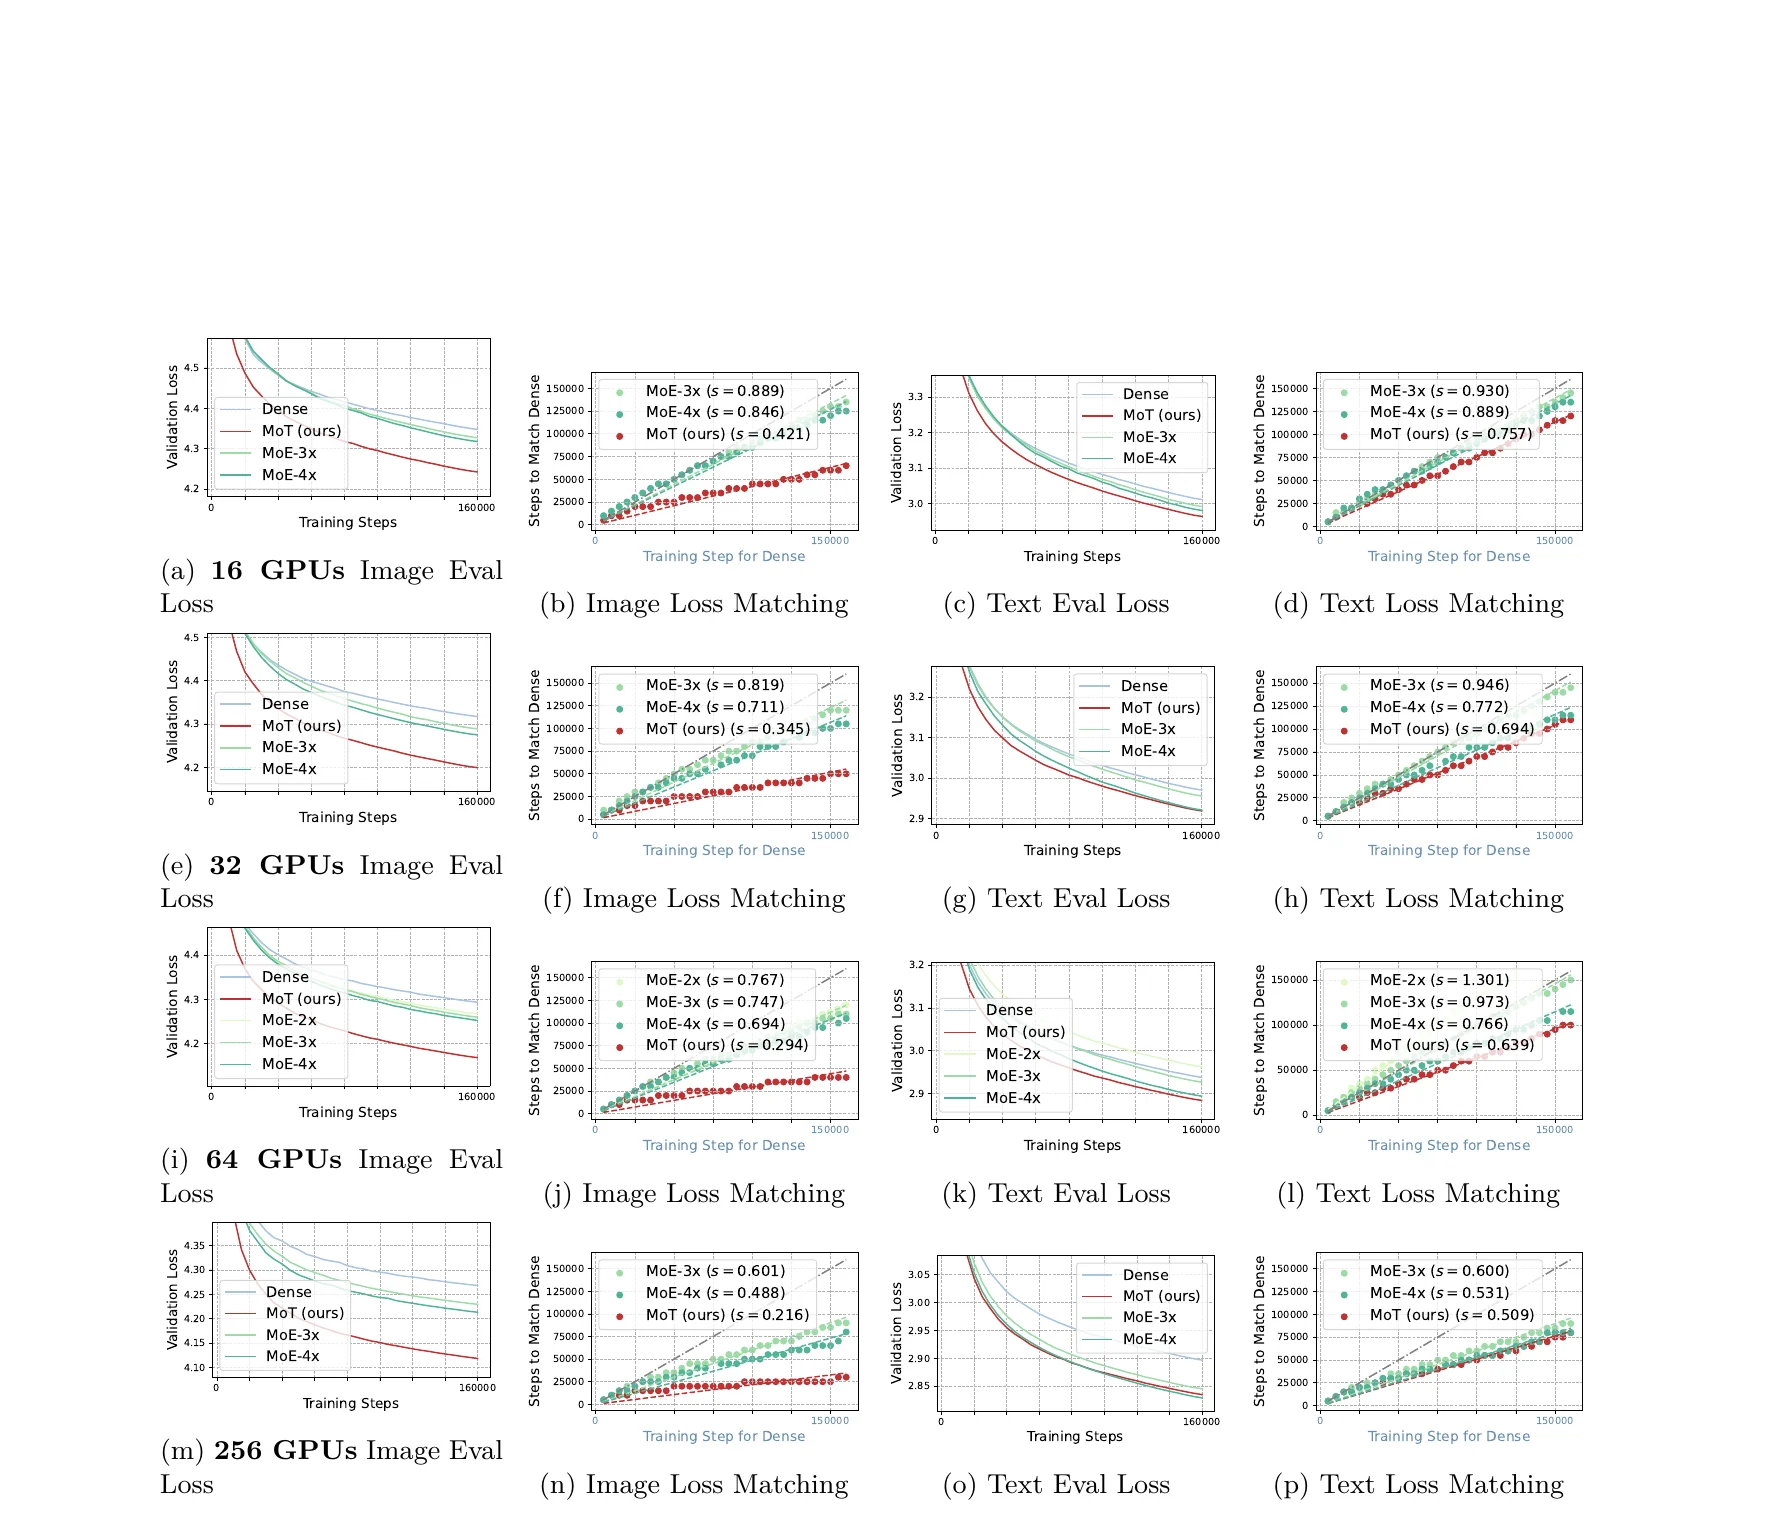
上图是论文图 18,横轴是训练步数、纵轴是 Obelisc 验证损失,四行分别对应 16、32、64、256 个 GPU 的实验。每行右侧是步数匹配图,可以看到 MoT 的系数从 16 GPU 时的图像 0.421、文本 0.757,降到 256 GPU 时的图像 0.216、文本 0.509。GPU 越多,MoT 相对稠密的优势越大——这一点正是下面参数-FLOPs 比分析的直接后果。
参数-FLOPs 比:为什么规模越大,MoT 越划算
论文引入参数-FLOPs 比(Parameter-to-FLOPs ratio,PpF)作为判断依据:在分布式训练里,每一步的 FLOPs 决定计算时间,而参数量决定权重同步与分片通信的量。PpF 越低,同样的 FLOPs 预算就能用更小的通信开销完成。
论文按一个 Swiglu FFN、隐层与嵌入维度均为 、注意力为 4 个 投影的典型结构做估算:单层 FFN 参数量 ,注意到 ,归一化参数因形状为 可忽略。
这里用的是论文的简化口径(FFN 记作 ),目的是比较数量级;按前文参数账本里 SwiGLU 更贴近实际的 计算,MoE 每个新增专家的额外参数约为 、MoT 每新增一个模态约为 ,两边的比例关系不变,下面的结论仍然成立。
MoE 在每层加入 个专家,额外参数等于”多出来的专家分支 + 路由器”:
路由器参数量论文记为 ( 为每个 token 选中的专家数,即 top-)。与 相比, 这一项小一到两个数量级,因此可以把 MoE 的额外参数近似记为 。
MoT 把 个模态拆开,额外参数为:
把两式放在一起看:MoE 的额外参数随专家数 线性增长,而 是一个自由的设计旋钮,真实系统里从几个到几百都有(GShard 的 top-2 路由、DeepSeekMoE 的数百专家都属于这个谱系);MoT 的额外参数只随模态数 增长,而 由业务决定,通常只有 2 到 4。换句话说,MoE 要获得有意义的稀疏比,往往需要把 调到几十甚至上百;MoT 则用一个很小的常数就把额外参数锁住了。这就是为什么在 GPU 数增加、全局 batch 放大之后,MoT 优势会变大:训练时的通信量很大程度上由参数量(权重同步、参数分片)决定,而 MoT 的额外参数量只按模态数线性增长,不会随稀疏粒度的细化而膨胀。
开销来源:MoT 慢在哪里
MoT 不是没有代价。论文明确指出它有两类路由开销:
- CPU-GPU 同步:按模态分组、做逐元素投影、再还原顺序,需要频繁的主机侧索引操作与设备侧同步;论文提到这些开销主要来自模态掩码引起的同步。
- 模态串行:如果不同模态分配到不同 GPU 上或本地 batch 里分布不均匀,几个模态的计算可能串行执行,导致 GPU 利用率不平衡。
论文给出的工程缓解方案很务实:缓存每个模态的序列索引,每个迭代只算一次;用专用的分组 GEMM(Group GEMM)或 Megablock 式块稀疏矩阵乘(可参考 MegaBlocks 论文)把所有模态的不均匀投影一次完成。论文补充说明,在他们的训练配置里这些开销并未出现在关键路径上,因此没有进一步优化——这既是诚实的边界说明,也说明具体集群的网络拓扑会影响 MoT 的实际墙钟收益。
顺带说明为什么”分组 GEMM”会是这里的关键工具。一个 batch 里文本 token 可能有几万行、图像 token 只有几千行、语音 token 更少,三个投影矩阵形状相同但行数差一个数量级。如果依次算三次,后两个 GEMM 的行数太少,无法把 Tensor Core 填满;分组 GEMM 把三个”行数不同、权重不同”的矩阵乘打包成一次 launch,每段各自分块,调度器仍能按照块大小交错执行。这与 MoE 推理里按专家对齐做分组 GEMM 的结构完全同构:那边是”按专家对齐、每个专家几行 token”,这边是”按模态对齐、每个模态几行 token”——同一套 kernel 模式,换了稀疏的维度。站内分组 GEMM 的逐行拆解可以直接作为理解这一点的参照。
墙钟时间:47.2% 与 75.6%
在 256 卡、AWS p4de.24xlarge(A100)的环境下,论文给出最实际的一组数字:MoT 在 47.2% 的 GPU 训练时间内达到稠密模型的图像训练损失,在 75.6% 的时间内达到文本训练损失,且图像损失在那之后继续下降。作为对照,MoE-4x 在文本上没有时间优势,在图像上甚至比稠密慢 1.7 倍。
这里最值得停下来想的是图像上的 1.7 倍慢。MoE-4x 的 FLOPs 与稠密相同,慢的部分纯粹来自系统开销:路由、索引、scatter 与 gather、以及在图像 token 上路由效果不好导致的无效专家访问。这与前面”MoE-4x 在图像上收益随规模消失”的性能结果相互印证——对图像 token 来说,MoE 既没省算力也没省时间。MoT 恰好把这个缺口补上:图像 token 走图像塔,不用路由器、不用跨专家通信,开销只剩按模态分组的那一点索引工作。
关于”墙钟优势随 GPU 数增大”的结论,论文自己限定了适用范围:实验在特定 AWS 基础设施上完成,不同集群的网络拓扑与互连带宽不同,MoT、MoE、稠密的相对表现会发生偏移。做工程判断时,这个 47.2% 更适合当作”在通信敏感的大集群上,MoT 的收益会放大”的方向性证据,而不是一个可以照搬的常数。
推理部署:一个被忽略的问题
论文在部署章节提出了一个多数论文会略过、但对推理服务很实际的问题:混合模态的请求不一定能填满每个模态分支。一条请求里如果只有 300 个图像 token、5,000 个文本 token,那么图像塔的 GEMM 在 batch 维度上很瘦,Tensor Core 利用率会很低。
论文给出两个互补的解决方向:
- 跨请求聚合:在延迟预算允许时,把多个请求里同类模态的操作合并成一个更大的 GEMM,即动态批处理(dynamic batching)与连续批处理(continuous batching)。这与 LLM 推理服务里早已成熟的连续批处理机制同构;站内推理框架源码系列里讨论的”按专家对齐、分组 GEMM 把每个专家的几行 token 塞满 Tensor Core”,在 MoT 里对应的就是”按模态对齐、分组 GEMM 把每个模态的 token 塞满 Tensor Core”。
- 补齐填充:当序列长度不会太长、或输入模态比较均匀时,把 token 少的模态补齐到 token 最多的模态同样的行数,用一次批量矩阵乘把所有模态的 GEMM 一起算完,用一点浪费的计算换更低的延迟。
这两个方向在 MoT 推理系统里都是”调度器问题”,不是模型问题。把不同请求里同模态的子操作攒在一起,意味着服务层需要像 MoE 的”攒 batch”一样,先按模态分桶再批处理;这与专家并行系统里按专家重排 token 的思路高度相似,只是维度从”专家”换成了”模态”。
再往前推一步,MoT 的参数布局给”模态并行”提供了天然切分点:注意力是全局的,Q、K、V、O 与 FFN、LayerNorm 都是按模态分开的。如果要把一个 MoT 模型拆到多卡上,最自然的切法不是把每一层按张量切,而是让每张卡负责一个模态塔的 FFN 与投影参数,注意力阶段再交换投影后的 Q、K、V。这条路径每层要做两次激活交换:一次把各塔的 Q、K、V 汇总给注意力计算方,一次把注意力结果按行送回持有对应 query 模态的卡。通信模式接近序列并行,但省掉了 MoE 式的 all-to-all 与负载均衡。它适合同机 NVLink 域内的部署,跨节点时每层激活交换的代价会吃掉收益——这与 DeepEP 类工作在不同互连上要分高吞吐/低延迟两套 kernel 的情况相似,可参考 DeepEP 完全拆解。这是结构上的推断,论文没有给出实测数据。
这里还需要把这个收益的来源讲精确。在交错生成(图像先出现、后面继续生成)的场景里,已生成图像位置的 token 会被写回历史,后续每个 decode 步在每一层都要重新计算这一位置在当前层的隐状态——否则它就无法参与这一层的注意力。这些位置走的是图像塔,因此 decode 步也照样调用图像塔的投影与 FFN。只有在”图像已经编码完成、之后只追问文本”这类请求里(图像作为只读上下文,且该位置不再被采样),图像位置的 K、V 才可以固定为 prefill 阶段算好的值,decode 步不再调用图像塔。这个区别决定收益能不能兑现:前者没有额外节省,后者的节省来自”图像塔只在 prefill 阶段跑一次”。
与 MoT 结构直接相关的推理收益值得指出:在”图像编码一次、随后多次追问文本”的请求形态里,图像塔的工作几乎全部落在 prefill 阶段,decode 阶段每步的 FFN 计算只发生在文本塔上,相比全共享参数的稠密模型可以省下一部分 FFN 算力。但要实现这个收益,服务端必须把图像位置标记成”只读上下文”,并在每一层为这些位置缓存 K、V 而不是缓存隐状态——否则 KV 缓存与注意力在 MoE/TP 下无法按层正确重建。论文没有对这个方向给出实验数据,工程价值还需实测。
局限与适用边界
MoT 的结论很漂亮,但它成立的边界同样清楚。把边界列出来,比记住几个百分比更有用。
第一,存储代价是真实的。 前文算过,K=3 时权重显存约为同宽稠密模型的 2.9 倍。论文的等 FLOPs 实验把这一点排除在比较之外,是因为训练场景里权重显存并非最紧的预算;但换到单卡推理、端侧部署或显存受限的池化服务,这 2~3 倍就是硬门槛。MoT 不是一个”免费提效”的方案,它把成本从”训练步数”转移到了”权重存储”。
第二,specialization 的粒度很粗。 模态内部的所有 token 共享一套 FFN。文本里代码、数学、多语言、对话的分布差异可能比”文本 vs 图像”还大,但 MoT 对它们一视同仁。这正是 MoE 的用武之地:MoE 按内容路由,能细到 token 级别;MoT 按来源划分,只能粗到模态级别。论文把两者组合的实验(文本塔 + MoE-4x)说明这两条稀疏轴可以叠加,但也仅做到 proof-of-concept,没有给出大规模下的可扩展性结论。
第三,模态数是线性成本。 每多一个模态就多一套非嵌入参数与一个塔。当前 3 个模态尚可接受,若未来模型要覆盖十几种模态(视频、音频、3D、传感器),MoT 的存储会线性膨胀,届时可能需要”模态分组”——把相近模态合并到一个塔,这正是 LOO 实验暗示的方向,但论文没有给出自动分组的算法。
第四,实验口径的局限需要如实标注。 论文明确说明这不是一项 scaling law 研究,模型规模只到 7B,训练 token 数 0.168T~0.377T,评估以验证损失、CLIP/FID/CIDEr 为主,缺少下游任务与人类偏好的系统评测。MoT 在更大规模、更多下游任务上的表现,论文没有回答。
第五,MoE 基线的对比有方法学上的瑕疵,论文自己也承认。 MoE-4x 用 Expert Choice 路由训练,而 Expert Choice 需要看到整条序列才能让每个专家选 top-k token;在自回归生成时这会破坏因果性。论文在评估时仍沿用 EC 路由,这带来两个方向相反的偏差:一方面路由器能看到未来 token,可能高估 MoE-4x 的验证表现(信息泄漏);另一方面当验证分布与训练分布差异大时,token 在专家间分布不均,又可能低估它的表现。因此”MoT 打败 MoE-4x”的结论应当理解为”在这个特定训练与评估口径下”,而不是 MoE 架构本身的上限。真正公平的对比需要 token-choice 路由的 MoE、或在推理时一致的因果路由,论文把这件事留给了后续工作。
第六,收益高度依赖模态的定义方式。 语音在 MoT 里收益最大(22.9% 步数),很大程度是因为语音 tokenizer 的词表只有 500、分布与文本差异极大。如果换一个与文本分布更接近的 tokenizer,收益可能缩小。这说明 MoT 的收益不是”多一个模态就自动多一份加速”,而是”模态的统计差异越大,拆开的收益越大”。
什么时候值得考虑 MoT
把上面的分析压缩成一个决策清单:
适合 MoT 的场景:
- 模型已经是”统一 token 序列”的早期融合架构,模态边界在 tokenization 阶段就明确;
- 各模态都有足够多的 token,不会出现某个塔长期吃不饱;
- 训练算力是主要瓶颈,且训练集群规模较大、通信对参数量敏感;
- 需要在一个模型里做交错生成(文本与图像互相条件),不能接受把模态彻底拆成独立模型;
- 权重显存相对宽裕,或可以按模态量化/按需加载。
不适合 MoT 的场景:
- 纯文本模型:只有一个模态,MoT 退化成稠密模型,没有收益;
- 端侧或单卡推理:2~3 倍权重显存会直接压垮预算;
- 模态内部需要细粒度专家化:应当用 MoE,或 MoT + MoE 的组合;
- 模态数据极度不平衡:小数据模态的塔可能欠拟合,LOO 实验说明合并有时比单列更好;
- 训练规模很小:MoT 的收益来自”减少达到同等损失所需的步数”,如果总步数本来就少,收益会被初始化与数据噪声淹没。
与站内其它稀疏架构工作的关系
MoT 在站内已有的技术地图上有几个明确的邻居,放在一起看能更清楚它的位置。
与 MoE 系列:MoT 和 MoE 共享”每个 token 只走一部分参数”的形式,但稀疏轴不同。DeepSeekMoE 的细粒度专家切分与共享专家隔离,解决的是”专家粒度与通用知识”的权衡(见 DeepSeekMoE 完全拆解);MoHGE 进一步把专家做成异构分组(见 MoHGE 完全拆解)。这些工作都在”内容路由”这条轴上做深,而 MoT 提供的是另一条正交的轴。把两条轴叠加,就是论文第 5 节的 hybrid 实验。
与条件记忆:Engram 把”查表式记忆”作为 MoE 之外的第二条稀疏轴(见 Engram 完全拆解)。MoT 的”按模态拆 FFN”与 Engram 的”按 N-gram 查表”在哲学上相似:都是利用输入中已经存在的结构信息(模态标签 / n-gram 哈希)来免掉学习式路由。区别在于 Engram 增加的是外部记忆容量,MoT 重排的是原有参数。
与多模态融合:站内多模态大模型的四种融合机制把双塔、投影、交叉注意力、统一词元四条路线的信息流讲清楚了。MoT 可以看作”统一词元”路线的参数层改造:输入表示不变、注意力不变,只改参数的归属。理解这一点,就不会把 MoT 误认为第五种融合方式。
与推理框架的多模态链路:vLLM、SGLang、TensorRT-LLM 的多模态输入处理(图像预处理、placeholder token、embedding 回填)在 MoT 上同样适用,区别只在模型侧多了”按模态选塔”的一步。如果未来有框架实现 MoT,调度器需要额外维护”每个请求每个模态的 token 数”这一维度的统计,才能做好前面说的按模态分桶。站内 vLLM 多模态输入拆解可以作为这条链路的参照。
小结
Mixture-of-Transformers 的想法可以用三句话概括:
- 观察:稠密多模态模型的特征空间本来就按模态分团,说明”统一参数”并不是多模态建模的必要条件,只是实现上的简化。
- 做法:把每个 Transformer 层的 FFN、Q/K/V/O 投影与 LayerNorm 按模态复制成几套,token 按自己的模态标签选参数;token 嵌入与全局自注意力保持共享,跨模态交互因此不被切断。
- 收益:在等 FLOPs 的受控实验里,用 37.2%~55.8% 的预训练 FLOPs 追平稠密基线;图像模态收益最大,语音次之,文本较小;与 MoE 组合可以叠加两条稀疏轴。
它的代价同样明确:权重存储按模态数线性增长、specialization 粒度只到模态级、收益依赖模态间的统计差异。把它理解成”用存储换训练效率、用结构先验换掉学习式路由”,比把它当成”更省算力的 Transformer”要准确得多。
对做推理系统的人来说,MoT 最值得借鉴的可能不是论文里的具体数字,而是它提出的两个工程问题:当一条序列里的 token 属于不同参数子集时,如何把形状差异巨大的 GEMM 打包成高效的批处理;以及当注意力仍然全局、而 FFN 已经按模态分开时,多卡切分应该切在哪一层。这两个问题在 MoE 系统里已经有过一轮答案(分组 GEMM、按专家对齐、EP/EPLB),MoT 只是把”专家”换成了”模态”,把”学习路由”换成了”查表”。理解了这层同构,读论文的实验表格会轻松很多。
参考资料
- Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models
- MoT 的 TMLR 评审页(OpenReview)
- Chameleon: Mixed-Modal Early-Fusion Foundation Models
- Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model
- Flamingo: a Visual Language Model for Few-Shot Learning
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- Mixture-of-Experts with Expert Choice Routing
- MegaBlocks: Efficient Sparse Training with Mixture-of-Experts
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



