DSpine 完全拆解:相邻因果注入如何让并行草稿沿网络深度建立 token 依赖
并行草稿的“一致性税”
投机解码(Speculative Decoding)的账本很直接:草稿模型一次猜出多个 token,目标模型用一次前向并行验证,接受得越多,每个输出 token 分摊到的验证成本越低。问题在于,草稿模型自己也要花时间。自回归草稿器(EAGLE-3 一类)每猜一个位置就要串行跑一步,块越长,草稿本身越贵;DFlash 把草稿改成“块扩散”式的并行预测,一个前向同时填满整块候选,草稿成本不再随块长线性增长。
并行化换来了速度,也带来一笔隐形的税:块内各位置在预测时,并不知道前驱最终会选哪个 token。DFlash 式草稿器的提议分布可以写成
每个位置只以已确认的上下文 为条件,对前驱的可能取值做了边缘化。于是单个位置看起来都合理,拼起来却可能互相矛盾。验证按前缀顺序接受,第一个不一致的位置就会截断整块草稿,后面的候选再便宜也用不上。换句话说,并行草稿真正卖的不是“猜得多”,而是“猜得连得上”。
这条路线上的近期工作都在补这块短板,但补的位置不同。Domino 在骨干网络之后加一个因果修正分支,DSpark 用一个轻量串行头调整后验,DFlash2 在骨干之后做 top- 候选的路径选择器,并在骨干内加入因果两抽头卷积。它们的共同点是:前驱信息进入后继的时机太晚,而且只以最后一层的词表空间形态出现。腾讯优图实验室在 2026 年 9 月提交到 arXiv 的 DSpine 则把这件事提前到了每一层:每个位置在每一层都接收相邻前驱当前预测出的特征,用门控写回残差流,于是 token 之间的因果条件链沿着网络深度一层层展开,而所有位置仍然在同一个前向里并行更新。论文题为 Draft in Parallel, Condition Through Depth: Adjacent Causal Injection for Speculative Decoding,推理代码以 Apache 2.0 协议开放在 Tencent/DSpine。
这篇文章按机制顺序拆:先看并行草稿为什么必然产生不一致,再看论文用两组实证实验确定了“什么时候注入”和“注入谁”;然后逐式拆解统一转移空间、逐层门控注入、前驱条件解码与 transition cache;最后看训练目标、接受长度与吞吐数据,以及 SGLang 插件在实际部署中的约束。
背景:并行草稿器在算什么
先把符号对齐。给定已确认的上下文 ,草稿器提出 个候选 ,目标模型一次前向验证。设 是草稿器在“上下文加上前面所有候选都被接受”这一条件下的真实提议分布, 是目标模型在同一前缀下的分布,两者都包含各自的采样变换。第 个候选在前驱全部被接受的条件下,接受概率为
一旦某个位置被拒绝,后面的草稿全部作废,目标模型从修正后的分布里补采一个 token;如果整块都通过,目标模型额外再给一个 token。平均接受长度定义为
其中 是连续被接受的草稿 token 数,加上的那个 1 是修正 token 或额外 token。在固定运行时配置下,忽略预填充和终止开销,每个输出 token 的平均时间约为
与 是一轮草稿与验证的平均成本。这个式子解释了为什么“并行”本身不够: 降下去了,但如果 也降,收益会互相抵消。DSpine 的全部设计都围绕一个目标——在不增加草稿轮次延迟的前提下把 抬上去。
DFlash 式并行草稿器处理一个包含 个位置的块:第 0 位是已知的锚点 ,后面 个是带掩码的候选位置。目标模型对 编码出的多层特征被融合后,作为每一层草稿层的 K/V 输入;草稿骨干用块内双向注意力一次性更新所有位置,最后用与目标模型共享的 LM head 产生各位置的候选分布。这里的“双向”很关键:位置 可以看到块内所有位置,包括它后面的位置。它解决了并行更新时的信息流通问题,却也让块内依赖变成了一种对称的混合,而不是因果的“前驱决定后继”。
自回归草稿器则不同:每生成一个 token,都以它前面已经选定的 token 为条件,因此提议分布天然满足链式法则。代价是 个位置需要 次串行前向。并行草稿把 次前向压成一次,却把条件依赖丢掉了。DSpine 想做的就是把这部分依赖找回来,但不是通过增加串行步数,而是通过增加网络深度上的信息传递。
两个实证发现:信息何时可用,前驱何时该到场
DSpine 的设计不是先验推演,而是从两组测量出发。实验对象是冻结的官方 Qwen3-8B-DFlash-b16 草稿器,正确答案由 Qwen3-8B 在贪心解码下生成(关闭 thinking,最多 1024 个新 token),评测集为 GSM8K 测试集与 HumanEval,每块一个锚点加 15 个候选。
浅层的早期位置已经“猜到”了 token
第一个问题:中间层的隐状态到底有没有可恢复的 token 预测信息?DFlash 的中间层状态不在目标 LM head 的输入空间里,不能直接解码。论文为每一层单独拟合了一个等容量的低秩读出器:
其中 是冻结的目标 LM head, 是不带可训练缩放系的 RMS 归一化, 是秩为 64 的低秩修正。读出器用 500 道 GSM8K 训练题拟合、100 道题选型,与测试集完全隔离。
结果如图 1(a):在相同的浅层深度上,块内靠前的位置读出准确率明显高于靠后的位置;所有位置组都会随深度增加而提升。这说明并行草稿虽然一次性更新所有位置,但预测信息的成熟度并不均匀——前缀位置在浅层就已经带有可恢复的线索,而后继位置还在形成中。一个自然的推论是:前缀可以在自己尚未“定稿”时,先把当前的预测传给后继,让后继的计算提前获得条件。
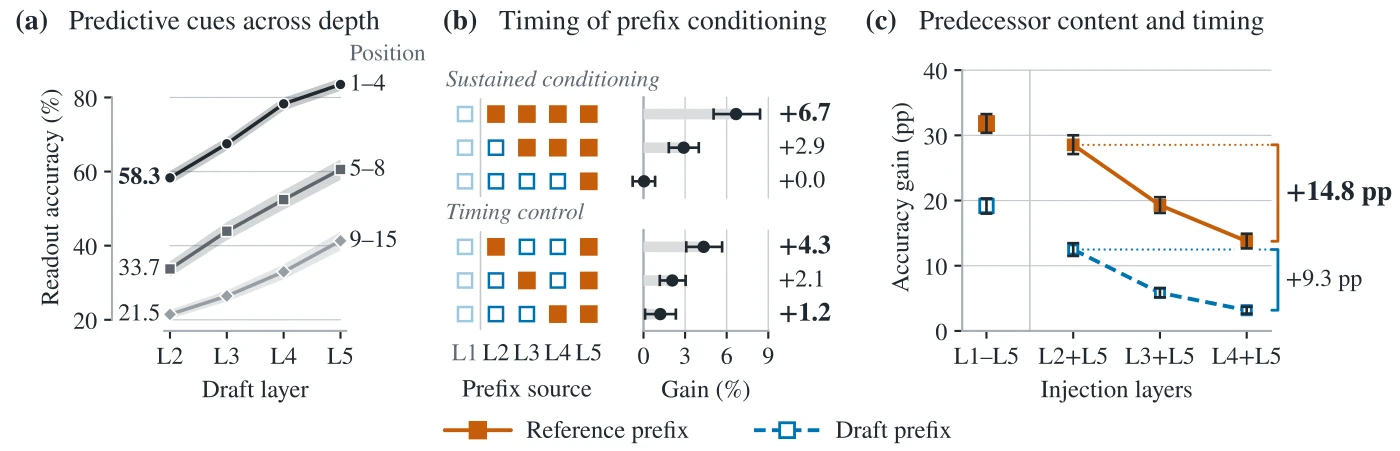
图 1 对应论文 Figure 2(图源:论文 PDF)。(a) 按块内位置分组(1–4、5–8、9–15),比较各草稿层的读出准确率:同一深度下靠前位置的可恢复信息明显更多,且所有位置组都随深度上升,到第 5 层时三组分别升到 58.3%、33.7%、21.5%。(b) 条件注入的时机:上半部分(sustained conditioning)比较“从某层起持续给正确前缀”,从第 1 层起给为 +6.7%,起始层推后到第 2、3 层时依次降到 +2.9%、+0.0%;下半部分(timing control)固定只注入两层、只移动较早那层,L4+L5 的 +1.2% 在提前到 L2+L5 后升到 +4.3%(L3+L5 居中为 +2.1%)。(c) 前驱内容与时机:横轴是注入层组合,两条曲线分别对应前驱之前的更早历史为正确 token(橙)或草稿预测(蓝),纵轴是后继准确率增益;图中标注了 +9.3 pp 与 +14.8 pp 两处增益,其中 +14.8 pp 对应固定注入层数后“较早层注入优于较晚层”的平均结果。三张子图共同支撑了 DSpine 的两个设计选择:从第一层开始注入,并且只注入相邻前驱。
正确的条件要早到,前驱本身不可替代
第二个问题分两半:条件信息应该什么时候进入后继?相邻前驱到底比更早的历史多贡献了什么?
先看时机。论文固定第 7 个 token 为新的锚点,把前面的 6 个位置分别填成草稿预测或正确 token,目标模型对到第 6 位为止的上下文编码,融合特征作为各草稿层的 K/V。第 1 层始终接收预测特征,第 2 至 5 层按不同调度接收正确前缀特征。以全预测调度为基线,比较第 8 至 15 位的连续正确 token 数 的相对增益。结果很直接:
- 第 1 层之后持续使用正确前缀特征,GSM8K 增益 6.23%,HumanEval 增益 7.12%;
- 把正确特征推迟到第 5 层才给,增益分别只有 -0.18% 和 +0.26%,基本归零;
- 固定只注入两层时,把较早的那层从第 2 层挪到第 4 层,增益从 4.3% 掉到 1.2%。
这里的对照很干净:总注入层数相同,仅仅改变位置,提前注入仍然更好。也就是说,正确条件不仅内容有用,“到场时间”本身也影响后继表示的形成。等到所有层都算完再修正,能改的只剩最终分布,改不了中间表示。
再看前驱。论文保留更早的历史为正确 token,只把紧邻的前驱替换成它的草稿预测,然后以这个前驱为新锚点评估后继。仅这一处替换,就让后继准确率平均下降 31.8 个百分点(三个块位置、五层全注入)。更细的数字是:在第 12 位、历史正确时,GSM8K 的后继准确率从 93.50% 掉到 51.00%,HumanEval 从 91.31% 掉到 48.78%。反过来,只把前驱修正为正确 token,就能带来 14 至 42 个百分点的提升。更早的历史再正确,也补不上紧邻前驱的错误。
最后一组实验固定前驱内容,只改变同一份正确前驱 K/V 进入的层。总注入层数相同、最后一层都给正确 K/V 的情况下,把另一层从第 4 层提前到第 2 层,后继准确率平均提升 14.8 个百分点;在正确历史下,GSM8K 的三个位置分别提升 7.38、17.00、18.63 点。这个结果和前缀实验互为印证:相邻前驱提供的是一类更早历史无法替代的条件,而且这类条件越早进入后继的计算,作用越大。
两个发现合起来,给出了 DSpine 的设计坐标:信息来源是相邻前驱,时间是从第一层开始,形式是前驱当前的预测特征而不是最终 token。剩下的问题是工程上怎么把“每一层都传”做得足够便宜。
统一转移空间:让“预测”和“已定的 token”同构
在讲注入机制之前,必须先解决一个表示问题。并行草稿时,前驱还没有 token,我们能传的是它的隐状态;前驱条件解码时,前驱已经有了 token,能传的是它的词嵌入。如果两者处于不同的向量空间,后继就得分别用两套模块去理解,层内注入和块末解码也就无法共享同一条通路。DSpine 的做法是造一个两者共用的空间,论文称之为统一转移空间(unified transfer space)。
出发点来自目标模型 LM head 的结构。LM head 给 token 的打分是 ,其中 是词表中 token 对应的那一行输出嵌入。所以输出嵌入本身就在编码“一个状态倾向于预测哪个 token”。论文就用它来构造空间:
- 对 LM head 的每一行做 归一化,得到 ;
- 计算词表上的均值 ,以及中心化 Gram 矩阵 的前 个特征向量 与特征值 ;
- 得到固定、所有层共享的嵌入表
这三步对应一次带白化的 PCA 降维。 是白化,作用是让保留下来的 个方向方差归一,避免某个方向因为方差大而主导距离;中心化减去 则去掉了所有 token 共享的那个分量,否则任何两个 token 向量都会因为这一共享分量而显得“相似”。经过白化之后, 中的方向才真正用来区分 token。论文为 Qwen3-8B 取 。
有了这个固定空间,两类信息就能用同一种形式进入:
未定 token 的预测特征。 第 层注入前的状态记作 ,即第 个 Transformer 层的输出。每一层有一个自己的学习投影 ,把状态映到 维:
这里没有经过中间的词表解码。如果先把隐状态解码成 token 再取嵌入,梯度就要穿过不可微的 argmax 或采样,而且会丢掉比“最可能 token”更细的信息。直接投影到同一个空间,既保留了连续特征,又对齐到了词嵌入的位置。
已知 token。 锚点或被解码过的前驱,直接以 进入空间。
乘 是为了和 的量级对齐:归一化向量的范数是 1,乘以 后与 维空间里“满能量”的向量尺度相当,这样两种来源的向量在后续门控和投影中不会因为范数差异而失衡。
论文用一个细节把这两类信息来源串起来: 用 初始化。也就是说,训练开始时每一层的前驱投影,恰好就是构造 时用的那个降维方向。 是从目标模型的输出嵌入里算出来的,而 本身是 维到标量打分的那一行, 把它落到 维白化空间。用相同的方向初始化 ,等于让“隐状态投影”起步时就靠近“词嵌入”所在的位置,之后的训练只需要在两个本就相近的空间之间做微调。
这个统一空间有一个直接的好处:层内注入传的是 (预测),前驱条件解码传的是 (已定 token),两者只是同一个 映射的两种输入。注入模块完全不需要知道自己拿到的是哪一种,一套门控和写回逻辑通吃。论文 Appendix A 里说注入模块只增加约 33M 参数,约为骨干的 3%,也受益于此——不需要为解码阶段再训一套模块。
相邻因果注入:每层一次门控写回
现在进入 DSpine 的核心。如图 2(a) 所示,完成第 个 Transformer 层之后,位置 只从紧邻的前驱 接收一条消息;图 2(b) 放大了一层内的注入结构。
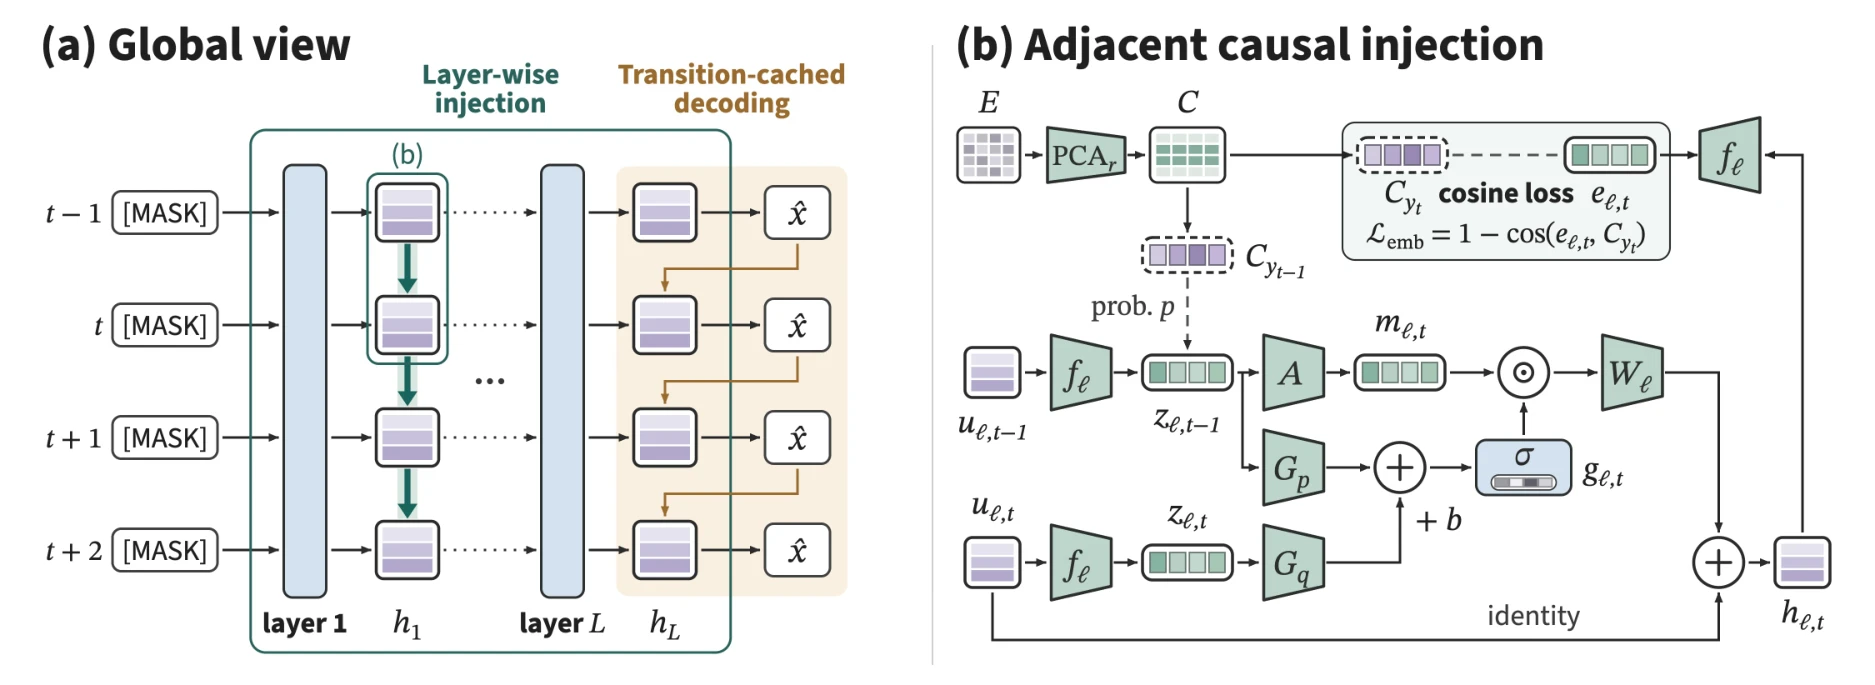
图 2 对应论文 Figure 3(图源:DSpine 论文,arXiv:2609.36173)。(a) 全局视角:贯穿各层的相邻因果注入,只在第 层之后把位置 的消息交给位置 ;末层之后另有一条基于 transition cache 的前驱条件解码路径。(b) 单层注入的细节:前驱特征 与后继特征 共同决定门控,前驱特征经投影后按门控写回后继残差流;训练时额外加入与 的余弦对齐损失 ,并以概率 把前驱特征替换成正确 token 的嵌入 。图中右侧的 identity 跳线说明注入初始时( 与 零初始化)是恒等映射,这一点下一段会解释。
门控与写回
浅层的前驱特征还在形成中,可靠性不均匀,如果无条件地把消息写进后继,等于往残差流里塞噪声。所以注入做成门控式:后继自己决定吸收多少。论文给出的形式是
逐个符号拆解:
- 是逐维的 sigmoid 门控。它同时看后继特征 和前驱特征 ,两个矩阵 与 在所有层间共享。共享的好处是门控语义一致——不同层对“什么样的前驱消息值得吸收”用同一套判断,而参数预算也省。
- 是把前驱特征投影成消息, 同样跨层共享。注意投影的输入是前驱的预测特征本身,而不是前驱的完整隐状态;这样做的好处是把“前驱预测什么 token”这个信息与“前驱收集到的上下文”分开,后继拿到的是条件,不是一锅混合。
- 写回时, 是每层独有的写矩阵,因为不同深度的残差流在语义和量级上都不同,需要各自的写入方式。RMS 归一化用后继自身的隐藏状态 做尺度,使写入量的幅度随后继状态自动缩放,而不是固定幅度。
- 是逐维相乘,门控可以只放行部分维度,这比标量门更细。
初值的设计保证了安全性: 与 零初始化,。零初始化下 , 仍然非零,但 让写回量为零,每次注入起步时都是恒等映射。这意味着在训练早期,DSpine 的前向与 DFlash 完全相同,不会因为“多出来的模块”而先经历一段性能崩塌,再靠训练慢慢爬回来。这一点对 6 个 epoch 的小规模草稿训练尤其重要。
还有两个容易被忽略的细节:
- 所有消息使用注入前特征。 同一层内,位置 的消息来自 之前算出的 ,而不是该层注入后的状态。因此一层内的所有注入可以先并行算好,再统一写回,层内没有新的顺序依赖。
- 锚点不参与注入。 第 0 位已经确定,不存在“前驱”,它只作为后继的前驱存在。
块因果注意力
DFlash 的块内注意力是双向的,DSpine 改成块因果(block-causal):位置 只注意目标上下文的 K/V 和块内位置 。这一个改动承载了两层设计意图。
第一,注意力和注入共享同一个方向——都是从前往后。如果注意力仍然双向,位置 可以通过注意力看到后面的位置,前驱至后继的方向就模糊了;改成块因果之后,块内信息只有一条从前往后的通路,注入加进去的条件不会通过注意力绕回前面。
第二,它在训练上提供了隔离。DSpine 训练时会把浅层的前驱特征以一定概率替换成正确 token 的嵌入(见下文“正确前驱课程”),如果注意力是双向的,位置 就可以通过双向注意力看到位置 收到的“正确信息”,相当于训练时给前驱开了后门,推理时这个后门不存在,模型会退化。块因果注意力从结构上杜绝了这种泄漏,论文在 4.5 节明确提到了这一点。
需要强调的是,块因果注意力并不破坏并行性。注意力本身是对块内矩形的下三角区域做矩阵乘,所有位置仍然是同一个前向、同一批 kernel 里更新,只是关注范围变了。
沿深度传播的因果链
单个层里的注入只连接了相邻位置。真正有意思的是这些注入叠加起来的效果:第 层收到的消息会进入第 层的计算,从而塑造第 层向外发送的预测特征。举个例子:位置 在第 层传给 的信息,会影响 在第 层传给 的消息。于是信息在块内沿着位置逐格、沿着网络逐层地传递,形成一个平行四边形形状的传播路径。
这就是标题里 “Condition Through Depth” 的含义:并行草稿的因果条件链不是靠串行时间展开的,而是靠网络深度展开的。 个位置仍然一次前向全部更新,但它们之间的依赖通过 层的多次注入逐步建立。这也从机制上解释了为什么“越早注入越好”——早注入的层数越多,沿深度传递的链条越长,能覆盖的位置间隔越大;晚注入等于把传递压到了最后几层,链短了,效果也就有限了。这和前面“固定两层、提前一层”的实验结论严格对应。
融合 kernel
逐层注入如果直白实现,会引入大量小操作:每层一次归一化、投影、门控、残差写回,外加中间张量的显存往返。这些操作的算术强度很低,kernel 启动开销可能超过真实计算。论文做了两项合并:
- 把 、 与 的三次投影合并成一次矩阵乘,也就是把权重拼成一个大矩阵,一次 GEMM 出结果;
- 用两个融合 kernel:一个负责门控消息,一个负责残差写回并顺带做下一层的输入归一化,全部放在草稿骨干已有的 CUDA graph 里运行。
效果在 5.4 节的延迟分解里量化了:五层注入一轮最多增加 0.15 ms,这个数字放到后面和 DFlash2 的整轮时间对比会更有意义。
前驱条件解码与 transition cache
骨干前向结束后,每个位置的最后一层输出 经过最终 RMSNorm 与共享 LM head,得到各位置的初始 top- 候选集 。到这里,候选还只是各自独立算的。真正决定这一轮接受长度的,是从左到右选 token 的过程。
Last-write refinement:用已定 token 重做最后一层写回
并行草稿阶段,后继拿到的前驱消息来自前驱的预测特征 。但选完前驱的 token 之后,前驱已经是确定的了,继续用预测特征就浪费了这个信息。DSpine 的做法是不引入新模块,直接再走一次同样的最后一层注入:
- 前驱位置 选出的 token 记为 。它是已知 token,直接进入统一转移空间:;
- 用缓存下来的注入前状态 ,重做最后一层注入——门控 与消息 都会因为前驱特征从预测换成 而改变;
- 得到新的末层特征 ,再过共享 LM head,得到条件分数 ,只在初始候选集上打分。
论文把这一步称为 last-write refinement(最后一次写回的精修)。之所以能这样做,是因为前 1 到 层的结果并不依赖于前驱最终选了什么——前驱选 token 是末层之后的动作。因此只需要重算末层注入,计算量很小。这也是统一转移空间价值的直接体现:同一条注入通路,骨干内传预测,解码时传 token,代码与参数都不用变。
串行的代价与 transition cache
问题在于依赖关系。位置 的分数依赖位置 的选择,位置 又依赖 ,所以逐位置做 last-write refinement 就退化为 步串行。整块 个位置各做一次“门控 + 写回 + LM head 打分”,每一步只处理一个位置,GPU 上这些小 kernel 的利用率很低,串行依赖还会把 kernel 启动延迟全部暴露出来。
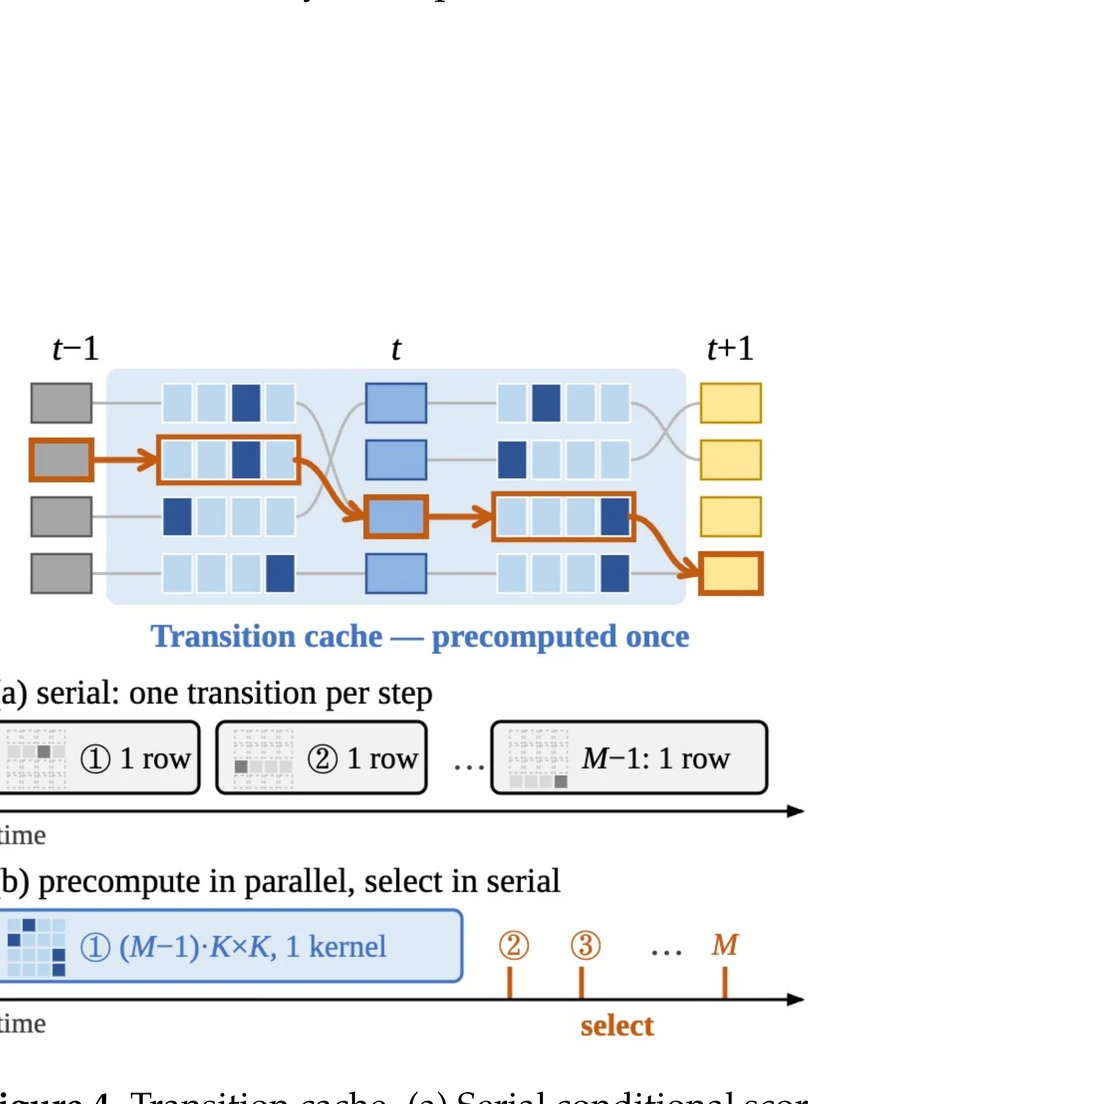
论文的解决办法是 transition cache:既然精修只依赖前驱的 token,而前驱的 token 只可能在它的 个候选里,那么干脆把 种可能全部提前算好。
图 3 对应论文 Figure 4(图源:论文 PDF)。(a) 串行方式:每一步只计算一个位置到后继的转移,串行链上叠着 行打分;(b) transition cache:先在一个 kernel 里并行算出 个相邻候选对的分数,再串行走一遍查表完成选择(图中为贪心实现)。点击图片可查看原始裁切图。
具体地,对每对相邻位置 与 :
也就是枚举前驱 的每个候选 作为“假定的已选 token”,对后继 的每个候选 算出条件分数。 个分数可以在一个 kernel 里并行算完,因为这时所有前驱候选都是已知的常量,不存在真正的顺序依赖。之后的选择阶段从左到右走一遍:先定第 1 个位置的 token,用它的索引去 里查后继分数分布,选出第 2 位,再去 里查……整个选择只剩下查表和 argmax,没有矩阵运算,也没有注入模块的调用。
这是一个典型的用并行计算换串行链长度的权衡:
- 多算了什么:每个转移要处理 对候选,而串行方式只需要 个(每个位置只有一个真实前驱)。以草稿层共享的 LM head 评分计,多出来的打分工作量是 倍。
- 换回了什么:串行链上不再有“门控 → 写回 → LM head”的整条依赖,只剩下 的 argmax 查表。
越大,多算的打分越多;串行链虽然变短,但每一步的查表范围也变大。论文报告 时额外成本很小(见 5.4 节的延迟分解),这个值也是 DSpine 训练时用的候选数。值得说明的是,贪心解码时选择阶段只需在 个后继候选里取最大,查表只需要 这一行( 是前驱实际选中的候选索引);采样解码时则需要按前驱选择后的重归一化分布采样,但同样可以在这个张量上完成。transition cache 的收益主要来自把“带参数的注入计算”从串行阶段移走,而不是把整个选择过程并行掉。
另外,候选生成本身也在减少串行依赖:LM head 打分对所有位置是并行的,只有选择阶段是串行的,而选择阶段不涉及大矩阵运算。
训练:双输出蒸馏、逐层对齐与正确前驱课程
DSpine 的训练目标由三部分组成:分布蒸馏损失、逐层输出嵌入对齐损失、以及一个用于早期训练稳定的正确前驱课程。草稿器训练时,目标模型、共享输入嵌入与 LM head 全部冻结,只训练草稿骨干与注入模块。
论文的训练设置交代得很具体:从训练序列里切草稿块,每块一个锚点加 15 个候选,全局 batch 为 112 个序列,AdamW 无权重衰减,峰值学习率 ,4% 线性预热(146 步)后余弦衰减到零,训练序列最长 3072 token,共 6 个 epoch(3655 步)。所有对比的草稿器都用同一份 ShareGPT 数据,并由目标模型重新生成回答,这是对比公平性的前提。
双输出监督
训练时监督两个输出:
- 常规末层输出:全词表预测,决定每个位置的 top- 候选;
- 精修输出:与推理时相同,用正确前驱 token 替换预测特征、重做末层注入,但只在 top- 候选上预测。
两个输出共用一个损失。设 、 为位置 在正确前缀下的草稿与目标分布,论文沿用了 DSpark 的损失设计,把 token 交叉熵与概率 距离加权混合:
其中 是混合权重(Qwen3-8B 取 0.1), 是随块内位置衰减的权重,。两项损失各有分工:交叉熵是对正确 token 的直接拟合,推动候选集里有正确 token; 距离约束整个分布的形态,让草稿分布在目标分布附近,这对采样模式和拒绝修正都重要。位置衰减权重让越靠前的位置权重越大——越靠前的位置越容易被接受,也越值得把预算花在上面。
精修输出之所以也纳入 ,是因为它才是推理时真正用于选择分数的那个头。如果只训练常规末层输出,候选集会不错,但条件分数会偏离目标分布;两个都监督,等于同时训练“候选生成”与“前驱条件解码”。精修输出的目标分布需重归一化到候选集上;交叉熵项只在正确 token 位于 个候选内时计算, 项只在候选集合计目标概率超过 时计算,避免在候选几乎不可能的情况下引入无意义梯度。两个输出在损失里等权相加。
逐层输出嵌入监督
注入传递的预测特征承担两个角色。第一个角色是条件后继,从第一层开始就要有用;但前面实验已经显示,浅层的预测特征虽然带有可恢复线索,却仍在形成中,而最终损失只通过后续计算间接塑造它们,监督信号很弱。第二个角色是解码阶段的“替身”:骨干内注入接收预测特征,前驱条件解码接收 token 嵌入,两者在统一转移空间里应当尽量靠近;如果预测特征与词嵌入的系统性距离很大,last-write refinement 就等于换了一个分布,效果打折。
所以 DSpine 对每一层的预测特征加一项直接监督。用注入时用的投影 ,从注入后的状态读出
再与正确 token 的嵌入做余弦对齐:
这里 是正确 token, 与前面相同的衰减权重。
几个设计点值得说明:
- 方向对齐而非数值对齐。 损失只约束低维投影的方向,不约束整个隐藏状态。隐藏状态仍然可以自由承载上下文计算;被约束的是“用于传递的那部分信息”。如果改成让隐藏状态逐层预测全词表,就会逼迫中间层提前做词表分类,干扰后续层的上下文组织。
- 读出在注入之后。 是注入后的状态,所以这个损失同时训练“特征怎么形成”和“后继怎么使用收到的消息”,而不只是让前驱输出一个好看的特征。
- 监督目标就是 。 对齐目标正是统一转移空间中的正确 token 嵌入,这与构造空间、初始化 、前驱条件解码的目标完全一致,三处用同一个参考系。
论文的消融给了这项监督很强的证据(表 3):在同样的 DFlash 骨干上,不加逐层监督时 MATH-500 接受长度为 3.75,加 token 交叉熵监督反而降到 3.67,加嵌入余弦监督升到 3.85;MBPP 与 MT-Bench 上呈现同样的顺序(3.48/3.40/3.63,2.91/2.84/2.99)。也就是说,逼中间层去分类 token 有害,逼中间层对齐到词嵌入空间有益。这和“方向对齐不破坏上下文计算”的解释一致。
正确前驱课程
训练早期,预测特征携带的信息很少,注入模块从中学不到东西,还容易收敛到“忽略前驱消息”。论文借用教师强制(teacher forcing)的思路:在浅层,以一定概率 把前驱特征替换成正确 token 的嵌入 ,而接收端特征仍由模型自己产生(对应 Bengio 等人提出的 scheduled sampling 思想)。统一转移空间让这个替换是零成本的——正确 token 嵌入本来就在这个空间里。
课程安排是:对每个草稿块做一次伯努利抽样,这次抽样结果同时决定第 1 至 3 层是否使用正确前驱嵌入,而不是每层各抽一次; 在训练前六分之一为 0.5,线性衰减到训练三分之一处降为 0。第 4 至 5 层不参与替换,last-write refinement 始终使用正确前驱。浅层替换、深层不替换是有讲究的:浅层特征最不可靠,最需要早期扶持;而且正因为接收端特征始终由模型自己产生,模型不会学到“只要复制前驱”这种捷径。last-write refinement 在推理时本来就拿到正确 token,训练时也用正确 token,训练与推理一致。
块因果注意力在这里再次发挥作用:因为注意力方向只有一个,替换进去的正确信息只能向后流,不会被前驱位置“看到”,推理时没有这个后门,也就不会出现训练-推理错位。
总目标
其中 , 是骨干输出的 token 交叉熵, 表示停止梯度。 在前 146 步(正好是学习率预热期)从 0 线性升到 0.5。
为什么要用骨干交叉熵作为门控?训练早期骨干输出还很差,此时强行施加逐层对齐,可能让浅层特征朝着“词表分类”的方向被拉走;用骨干的交叉熵作为“骨干已经学到多少”的代理,骨干还差时对齐损失权重低,骨干进入正常训练后再逐步加大。停止梯度保证门控不会反过来影响骨干的优化路径。
Qwen3-8B 的其余超参数:草稿层数 5,隐藏维度 4096,接收的目标特征层为第 1、9、17、25、33 层,转移空间维度 ,消息维度 ,候选数 ,每条序列 512 个锚点,梯度范数裁剪 1.0。
实验结果
评测覆盖三类任务、七个基准:数学用 GSM8K 与 MATH-500,代码用 HumanEval、MBPP 与 LiveCodeBench(LCB),对话用 MT-Bench 与 Arena-Hard。Qwen3-4B 与 Qwen3-8B 均关闭 thinking 模式。接受长度 在 SGLang 中于温度 0 与 1 下测量;吞吐在 GSM8K、MATH-500、HumanEval、MBPP 上测温度 0、并发 2 至 32,所有方法使用固定相同的验证预算。对比对象是四种代表性并行草稿器:DFlash、Domino、DSpark、DFlash2。
接受长度
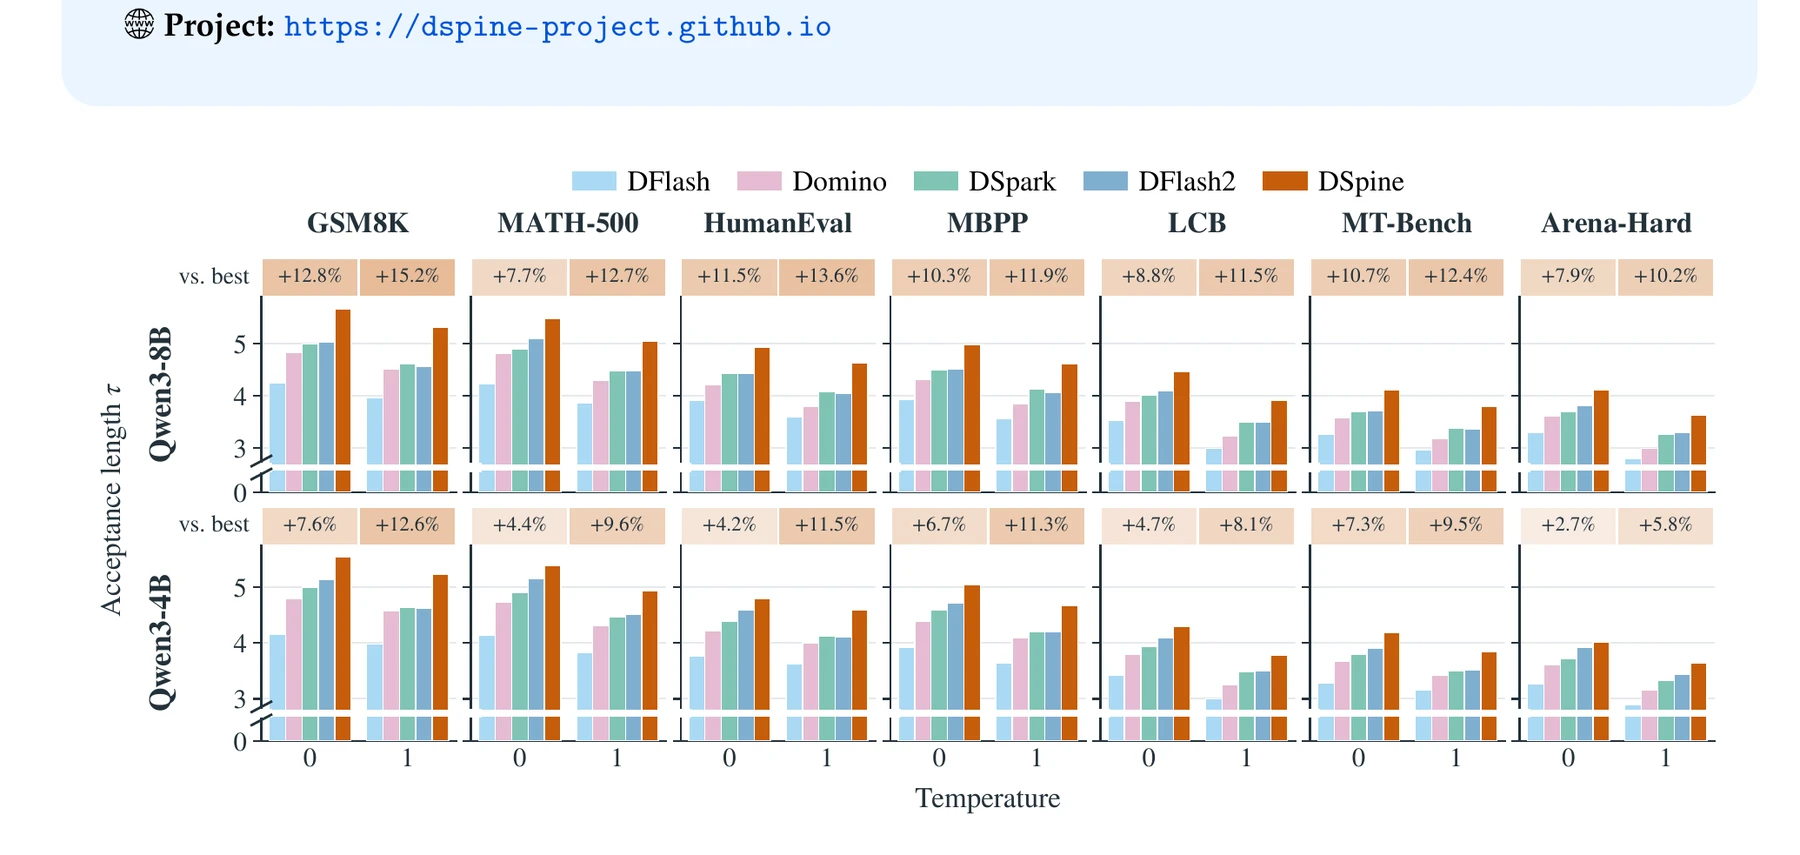
图 4 对应论文首页的 Figure 1(图源:论文 PDF),是七个基准上各草稿器的平均接受长度柱状图,同时列出相对最强基线的领先幅度。在 Qwen3-8B 上,温度 0 时 DFlash 为 3.77,Domino 4.18,DSpark 4.32,DFlash2 4.39,DSpine 4.82;温度 1 时依次为 3.39、3.69、3.92、3.90 与 4.42。DSpine 相对最强基线分别领先 10.0%(贪心,DFlash2)与 12.8%(采样,DSpark)。Qwen3-4B 上,平均 从 DFlash 的 3.71 升到 4.75,温度 0 下领先 DFlash2 5.4%,温度 1 下领先 10.1%。
逐基准看,提升分布比较均匀。Qwen3-8B 温度 0 时,GSM8K 从 DFlash2 的 5.03 升到 5.67,MATH-500 从 5.10 升到 5.49,HumanEval 从 4.43 升到 4.94,LCB 从 4.09 升到 4.46,MT-Bench 从 3.71 升到 4.11。相对增幅大致落在 7% 到 13% 之间,没有出现“某一类任务特别吃这套机制、另一类完全无效”的分化。
一个容易被忽略的现象是:Domino、DSpark、DFlash2 这三个“骨干之后做条件”的方法,相对 DFlash 的增幅已经很大(Qwen3-8B 温度 0,3.77 到 4.39),而 DSpine 在它们之上再提 10%。论文的解释是:骨干之后的条件修正只能改最终分布,改不了中间表示;DSpine 在每一层注入并且又在选择阶段再做一次,把两端的条件都用上了,增益在采样模式下更明显(12.8%),因为采样时分布形态本身对候选一致性的影响更大。
消融
模块消融(表 2,Qwen3-8B)分三个版本:完整版;去掉 last-write refinement;精修与注入都去掉(即退化为 DFlash 的独立选择)。MATH-500 上分别为 5.49、5.11、4.93;MBPP 4.98、4.65、4.54;MT-Bench 4.11、3.82、3.67。
换算成相对降幅:去掉精修使 下降 6.6% 至 7.1%;再把并行注入也去掉,下降扩大到 8.8% 至 10.7%。两个组件互补——注入让候选本身更一致,精修让选择阶段利用已定 token 再拉一次。缺任何一块都拿不到完整收益,这也说明“沿深度注入”和“末层用真实 token 重写”不是冗余的设计,而是分别作用在形成阶段和使用阶段。
监督目标的消融前面已经讨论过,嵌入余弦对齐优于不加监督,也优于 token 交叉熵。这个结果对写并行草稿器的人有直接参考价值:中间层需要的是“与词嵌入空间对齐”,而不是“提前做词表分类”。
服务吞吐与延迟分解
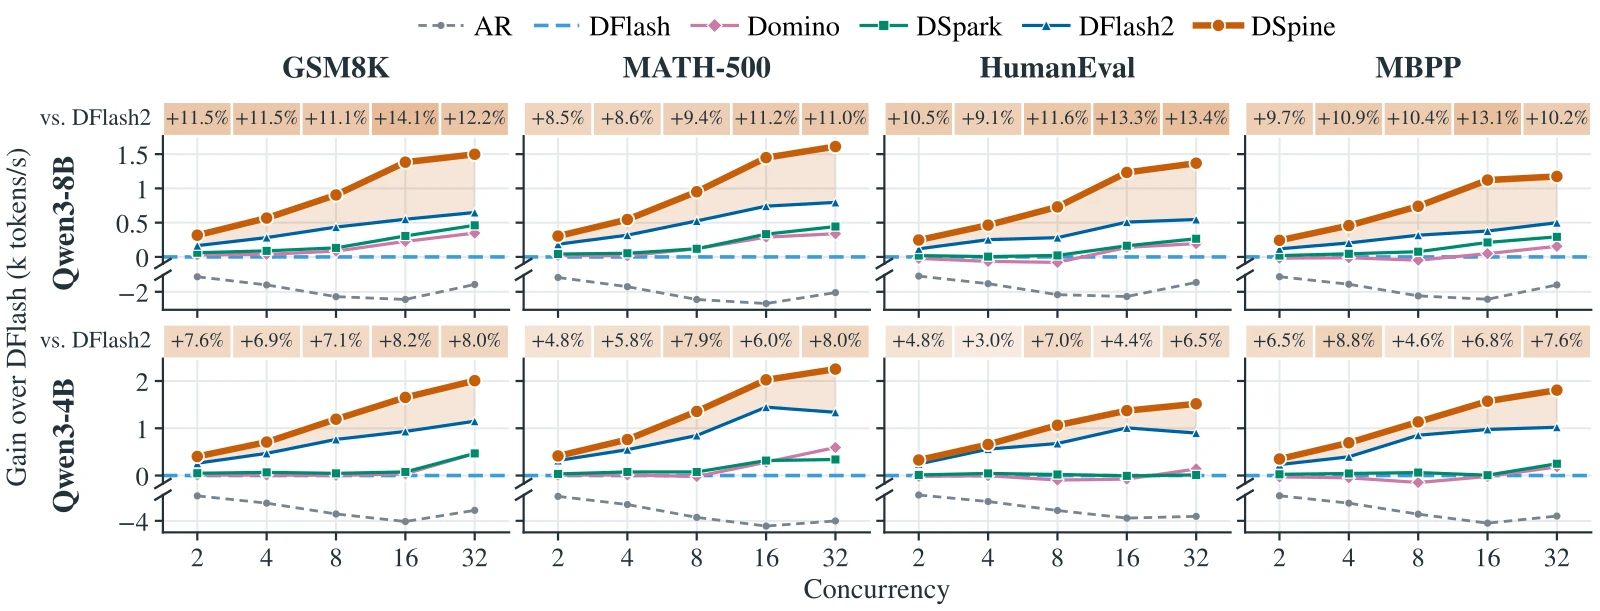
图 5 对应论文 Figure 5(图源:论文 PDF),以 DFlash 为零线,展示各任务、各并发下的吞吐增益。Qwen3-8B 上 DSpine 在所有任务与并发下都最高,相对最强基线 DFlash2 平均提升 11.1%,相对自回归解码最高达到 4.0 倍(表 8);Qwen3-4B 上相对 DFlash2 平均提升 6.5%。论文摘要中给出的“相对 DFlash 平均吞吐提升 23.3%”是另一个口径:以 DFlash 而不是 DFlash2 为基准,增益自然更大。读这些数字时要把基准对齐,避免不同口径混用。
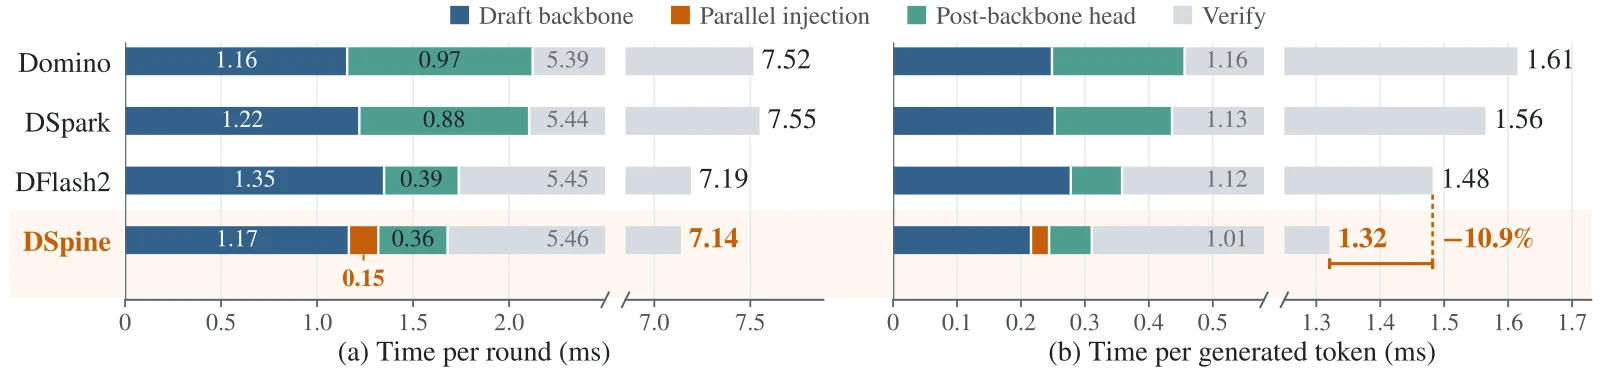
图 6 对应论文 Figure 6(图源:论文 PDF),是 Qwen3-8B 解码时间的模块级分解,按草稿与验证两个阶段拆。左图是一轮总时间,右图是每个生成 token 的时间;图注标出的 DSpine 相对 DFlash2 每轮总时间基本相同、每 token 时间少 10.9%,与此段正文一致。关键数字:
- 验证阶段占一轮时间的 72% 至 76%,且各方法基本相同。这符合预期:草稿器的设计不改变目标模型验证的成本,收益只能来自“每轮多接受几个 token”;
- DSpine 的并行注入在五层全部加上后,一轮最多增加 0.15 ms;
- 前驱条件解码(候选打分加 transition cache 选择)的成本不到 DSpark 与 Domino 骨干后模块的一半;
- 一轮总时间上,DSpine 约 7.14 ms,DFlash2 约 7.19 ms,两者基本持平;由于每轮接受更多 token,DSpine 每个生成 token 的解码时间比 DFlash2 少 10.9%。
这组数据是整篇最实际的部分:注入与 transition cache 的额外开销被控制到几乎可以忽略,收益完全来自接受长度的提升。如果每层注入加上了一个毫秒级开销,那么 10% 的 提升很可能被吃掉——这正是逐层门控注入需要融合 kernel 的原因,也是“统一转移空间”能省掉一套解码模块的原因。
延迟分解也解释了为什么 transition cache 值得做。如果逐位置串行做精修,串行链上有 个“注入 + LM head”小 kernel,时间会叠加;提前并行算 转移,把带参数的注入从串行链上移走,代价只有额外的候选打分,没有额外的参数计算。
部署:SGLang 插件的形态与约束
DSpine 的推理代码作为 SGLang 0.5.22 的插件发布,仓库结构是 sglang_dspine/(插件与运行时)、dspine_mlx/(Apple Silicon)、docs/。理解插件的工作方式,比只看数字更能看清它的工程边界。
插件入口 plugin.py 用 hook 的方式替换 SGLang 内部若干函数:handle_speculative_decoding 之后接管参数校验与 DFlash 参数处理;spec_need_hidden_states 对 DSpine 返回 False;草稿 worker 的 decode CUDA graph 换成 DSpineDraftCudaGraphRunner;模型配置层把 DFlashDraftModel 映射成 DSpineDraftModel,并检查 dflash_config.selected_prefix_code_bridge 是否存在;采样验证钩子换成 accept_dspine_sampled_round。算法侧 spec.py 定义 DSpineSpecAlgo,声明 is_dflash_family() 为真、由目标模型为草稿做验证、支持 grammar overlap、不需要 top-k 路由、不携带 draft hidden states;ragged 验证是否可用由运行时环境决定。
这些声明背后是一组明确的限制,在 handle_dspine_server_args 中以硬报错的形式写出:
- 必须 CUDA,
tp_size必须为 1; - 不支持
--speculative-draft-window-size; - 不支持 prefill/decode 分离(disaggregation),因为其验证提交的是稠密草稿块的前缀;
- 不支持 NVFP4 / MX-FP4 的 KV cache,理由同样是“验证提交的是稠密草稿块的前缀,只在默认 KV cache 下验证过”;
- 开 ReplaySSM 时
pp_size必须为 1,必须用标准非统一内存的 Mamba 池,必须开启 radix 前缀缓存且 Mamba 缓存策略为extra_buffer,--mamba-ssm-dtype必须为 float32,线性注意力前后端必须是 Triton,且不能与 decode 侧 ReplaySSM 同开。
对于 Qwen3-8B,官方给出的启动命令为:
sglang serve \ --model-path Qwen/Qwen3-8B \ --speculative-algorithm DSPINE \ --speculative-draft-model-path tencent/Qwen3-8B-DSpine-b16 \ --speculative-num-draft-tokens 16 \ --tp-size 1 \ --dtype bfloat16 \ --attention-backend fa3 \ --page-size 1 \ --mem-fraction-static 0.65 \ --context-length 8192 \ --max-running-requests 64 \ --cuda-graph-bs-decode 1 2 4 8 16 32 64 \ --trust-remote-code命令中的 --speculative-num-draft-tokens 16 与论文的块大小 16、候选数 对齐;--page-size 1 是官方配置的单 token 页粒度;CUDA graph 批大小列表覆盖了论文的并发测试范围。其余显存与并发参数是官方给出的服务配置,论文正文没有逐个解释,实际部署应以仓库 README 与当前 SGLang 版本的参数说明为准。
插件还处理了一个容易踩坑的细节:带有 DSpine code bridge(即 selected_prefix_code_bridge)的草稿检查点必须用 --speculative-algorithm DSPINE 启动,否则会报错;反过来,没有 bridge 的普通 DFlash 检查点也不能当作 DSpine 用。这是为了避免用错算法后静默地得到“看起来像 DFlash”的结果。
训练代码随 SpecForge(SGLang 团队的官方草稿训练框架)的 DSpine 支持发布,README 指向 PR #1038,其中包含 Qwen3-8B 的在线训练示例;该 PR 修正了 DSpine 的损失归一化默认值,并对 refinement 的交叉熵与 分别归一化后再按每个微批中被监督的行数缩放,同时让对齐损失的预热与学习率预热保持一致。这些修正不影响机制,但说明训练实现中“损失怎么归一化”对结果有实际影响。
Apple Silicon 上另有 dspine_mlx,支持 mlx-lm 与 SGLang-MLX;Qwen3.8-27B 版本沿用 DSpark 的动态验证,并与 ReplaySSM 搭配处理混合线性注意力层的状态。这部分的具体做法与本文的数据不在同一口径,这里不展开。
局限与值得继续追问的地方
论文自己在结论里点出了方向:层内信息传递的通信范围是否可以更灵活(目前只传相邻前驱)、以及其他并行解码架构里能否复用同样的注入思路。除此之外,还可以从机制出发指出几条边界:
只传相邻前驱是权衡结果。 实验显示相邻前驱提供的条件更早历史无法替代,但这并不说明更早的前驱没有价值。相邻前驱的传递使信息逐层向后传播,距离越远的位置需要越多的层才能“看到”前面的信息;在块大小 16、层数 5 的配置下,最远的位置间隔 15 格,而深度只有 5 层。如果需要更长的传播距离,可能需要多跳注入或更大的传播窗口,代价是消息数量从 增长到 。
验证成本仍是主项。 延迟分解显示验证占一轮的 72% 至 76%。这意味着草稿器的上限收益受制于目标模型的验证速度,草稿器做得再好,每轮多接受 10% 的 token,也只有对应比例的端到端收益。对于验证已经采用大块并行、验证利用率高的场景,收益边界会更清晰。
候选数 与 transition cache 的规模耦合。 时 的提升已经明显,但 transition cache 需要 个分数的张量与打分。 增大时,打分工作量按 增长,而且这些分数需要在验证阶段之前算好并占用 GPU 显存。论文没有给出 的系统扫描,只是说明 16 足够且额外成本小。
部署约束比较硬。 当前实现只支持单卡张量并行、不支持 PD 分离、不支持 FP4 KV cache。这些限制至少在这份实现里来自“验证提交的是稠密草稿块前缀”这一形态,与并行草稿族的验证方式相关。对于需要 PD 分离的大规模服务,插件目前不能直接落地。
与采样模式的交互。 论文在温度 1 下领先基线更多,说明条件修正对分布形态的改善在采样时更有价值;但采样模式下的修正采样与 transition cache 的配合、以及与结构化输出(grammar)的交互,论文只在插件层面声明了声明式支持,没有给出公开的详细数据。
小结
DSpine 把并行草稿的一致性问题拆成了两个可测的量:什么时候传条件,传谁的条件。实验回答得很干脆——从第一层传,只传相邻前驱。机制上,它用一个从目标模型输出嵌入里白化降维得到的统一转移空间,把“预测特征”和“已知 token”统一成同一种向量;在每一层用门控写回把前驱特征注入后继,让块内的因果链沿网络深度而不是沿串行时间展开;在末层用同一套注入把已选 token 写回,并用 transition cache 把 个转移的分数并行预算;训练上用逐层余弦对齐和正确前驱课程把它稳定下来。
结果层面,Qwen3-8B 上七基准平均接受长度从 DFlash 的 3.77 升到 4.82,SGLang 吞吐相对 DFlash2 平均提升 11.1%,而注入与解码阶段的额外开销在一轮中几乎被验证时间的波动淹没。对于关心并行草稿器设计的人,最值得带走的两点:中间层的监督目标应该是“对齐到词嵌入空间”,不是“提前分类 token”;以及在并行前向的前提下,块内依赖不必靠增加串行步数找回,可以靠增加深度上的信息传递找回。
站内对这条路线的背景可以延伸阅读 DFlash 块扩散解码:以并行扩散替代自回归草稿,实现无损 6 倍推理加速 和 DSpark:半自回归生成与置信度调度的投机解码,前者是 DSpine 的基座,后者在候选后验修正上走的是另一条路线。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放