


DeepInfer 源码拆解(二十一):CP 组对象广播——共享内存环、双通道与按路径回填
上下文并行(Context Parallel,CP)把一条长序列切成若干段,分给同组的多个 rank 各算一段。切分本身不难,难的是切完以后,每个 rank 手里的“这一小段”必须和别处的段保持同一套账:attention 的 mask 边界、KV 块索引、序列长度、采样状态、CUDA Graph 的输入槽位,任何一项对不上,算出来的 logits 就是错的。张量可以走 NCCL 的 broadcast,Python 对象不能——broadcast 只认同形、同 dtype、已分配的连续张量。于是推理引擎必须在集合通信之外,另建一条专门传“控制面对象”的通路。
DeepInfer 的选择写在 deepinfer/distributed/shm_broadcast.py 里:一个只在写者与读者之间共享的共享内存环(shared memory ring),加上一条 ZeroMQ 发布/订阅通道处理溢出和多机读者。这套代码的骨架来自 vLLM 的 ShmRingBuffer/MessageQueue,DeepInfer 改了两处关键地方——溢出标志被塞进环的每个 chunk 首字节,句柄析构与资源追踪也做了显式清理——然后把它的用途从“前端向引擎传请求”改成了“CP 组内广播对象与方法调用”。
这一篇沿着源码回答四个问题:CP 组为什么需要这条通道;环的字节布局与四个状态如何保证无锁正确;写者和读者各自怎么拿到一块可用的 chunk;上层三种用法(方法调用、broadcast_tensor_dict、InputMetadata.broadcast)如何把“对象”与“张量”拆成两段走。最后交代这套设计的边界条件,包括它默认同节点、写者固定为 rank 0 这些不那么显然的假设。
从一次 CP 前向说起:哪些东西必须广播
先把手头的问题具体化。假设 CP=4,一条 32K token 的 prompt 被切成 4 段,每个 rank 拿到 8K 个 token 的输入和对应位置的 KV。DeepInfer 在 prefill 阶段用的是 mirror 式 CP 布局:每个 rank 按 prepare_cp_mirror 算出的 mirror_cp_index 把 varlen 序列重排成自己负责的那一段,再通过 cp_broadcast_multi_tensor 拿到全组拼好的 K/V(具体集合通信在 prepare_cp_mirror.py 与 communication_op.py 里,不在本文范围)。为了让 4 个 rank 算出同一份结果,每一步至少有三类信息要同步:
- 输入元数据:
input_ids的 varlen 布局、每个序列的seqlen_q/seqlen_k、block table 的地址、mask 参数、采样温度以及各种开关。这些大多是 Python 的 int、list、dict、dataclass 字段,不是张量。 - 方法调用:worker 是分进程的,driver worker 决定“下一步跑
execute_model_step,参数是这些”,其余 worker 必须执行同一个方法、同一组参数。 - 张量本体:真正的大块数据仍然走 NCCL/HCCL;但接收端必须先知道“要收几个张量、每个多大、什么 dtype”,才能提前
torch.empty出接收缓冲区。
第 3 点是最容易被忽略的:NCCL broadcast 是原地操作,要求发送端和接收端的缓冲区形状与 dtype 完全一致。也就是说,张量数据的广播依赖于元数据先到。这构成了一个天然的两段式协议:先广播“清单”,接收端照单分配,再广播数据。清单是 Python 对象,于是问题落到“怎么把一个小对象低延迟地发给组内其他 rank”。
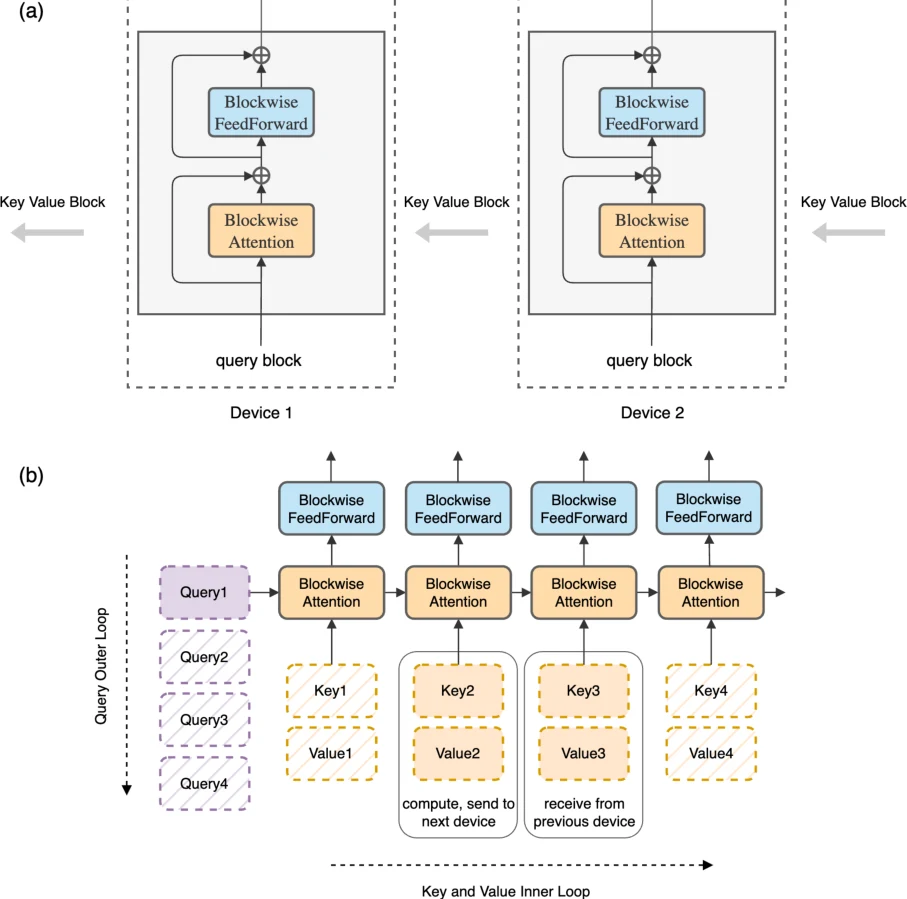
图:Ring Attention 的分块循环计算(图 2):每个 host 持有一个 query 块,key-value 块在 host 组成的环上逐个传递;上一个 host 收到的块要等全部 host 算完才会绕回。CP 组内每个 rank 只持有序列的一段,元数据必须逐 step 对齐。来源:Ring Attention 论文(arXiv:2310.01889)。
最直接的做法是 torch.distributed.broadcast_object_list,它在 gloo 后端上做 pickle、切块、TCP 传输、反序列化。功能上没问题,代价是:每次调用要走一遍 socket、经过 GIL、并且在接收端阻塞等待。DeepInfer 的 CP 组每步都要广播 InputMetadata,decode 阶段一步只有几十微秒的 GPU 时间,这条路径的开销不能忽视。共享内存环要解决的就是这部分开销:同一台机器上的进程,用 memcpy 加几个字节的标志位完成传递,绕开内核网络栈。
在工程部署里,CP 很少单独出现,并行拓扑的整体划分可参考 DeepInfer 源码拆解(十三):DP Attention 与 Wide-EP。它通常与 TP、DP 组成二维切分:TP 切隐藏维,CP 切序列维;同一组 CP rank 往往又和 TP 组重叠,形成 Ulysses 式的 all-to-all 交换,或 Ring 式的 KV 环传递。下图给出两种典型编排:SP-Ulysses 把序列切成段、用 all-to-all 换成“每卡一段全头”的布局;SP-Ring 则让 KV 块沿环逐跳传递。无论哪种,“哪个 rank 负责哪一段、这一步的 seqlen 和 block 表是什么”都必须先对齐,这正是对象广播要解决的问题。
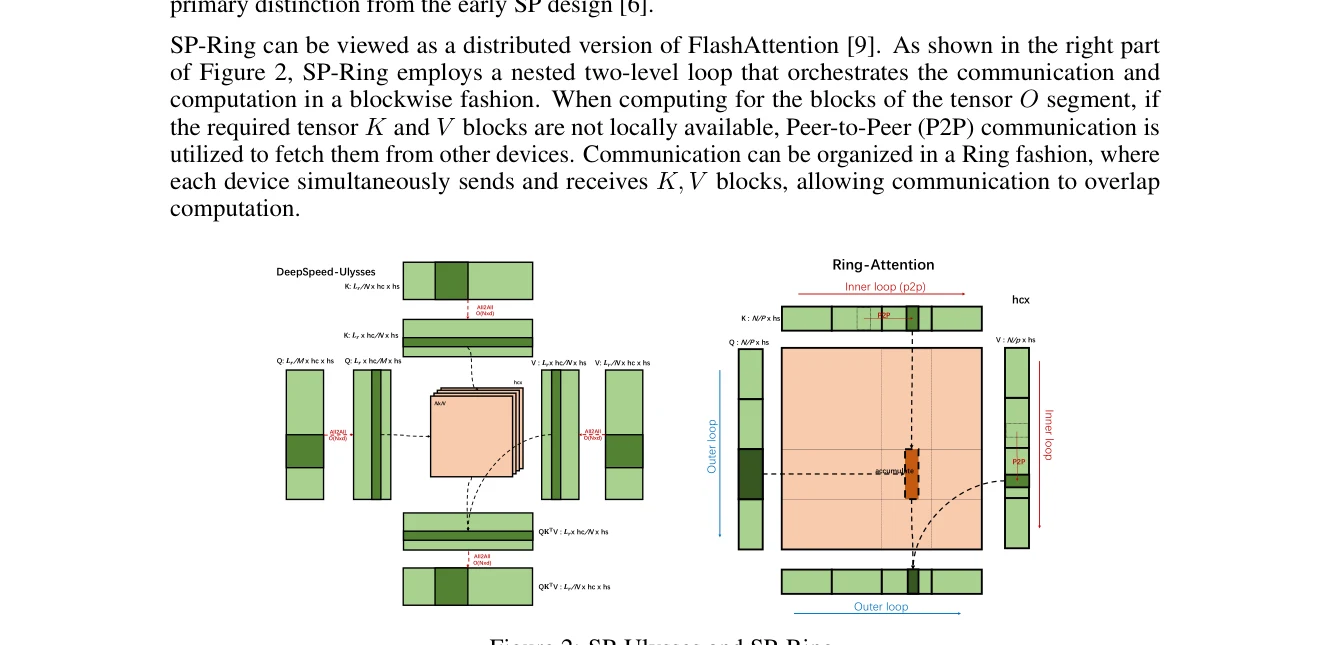
图:SP-Ulysses 与 SP-Ring 两种序列并行编排,引自 Unified Sequence Parallelism 论文(arXiv:2405.07719)图 2。DeepInfer 的 CP 元数据广播要为这类编排提供逐 step 一致的控制面。
这里有一个前提必须说清楚:共享内存只在同节点进程间有效。MessageQueue.create_from_process_group 的注释明确写着 “assume the group does not cross nodes, so every reader is a local reader”。DeepInfer 的 CP 组按 rank 连续切分,实际部署里 CP 组通常落在同一节点内;一旦跨节点,代码会走另一条 ZeroMQ 通道,延迟回到网络栈的水平。这个假设在后面讲句柄和溢出通道时还会再出现。
一块共享内存的字节布局
ShmRingBuffer.__init__ 先把整块共享内存切成两段,再按 max_chunks 等分:
total_bytes = (max_chunk_bytes + 1 + n_reader) * max_chunks
+-------------------------------+------------------------------------------+| chunk0 | chunk1 | ... | chunkK | meta0 | meta1 | ... | metaK |+-------------------------------+------------------------------------------+| max_chunks x max_chunk_bytes | max_chunks x (1 + n_reader) bytes |^ ^data_offset = 0 metadata_offset = max_chunk_bytes * max_chunks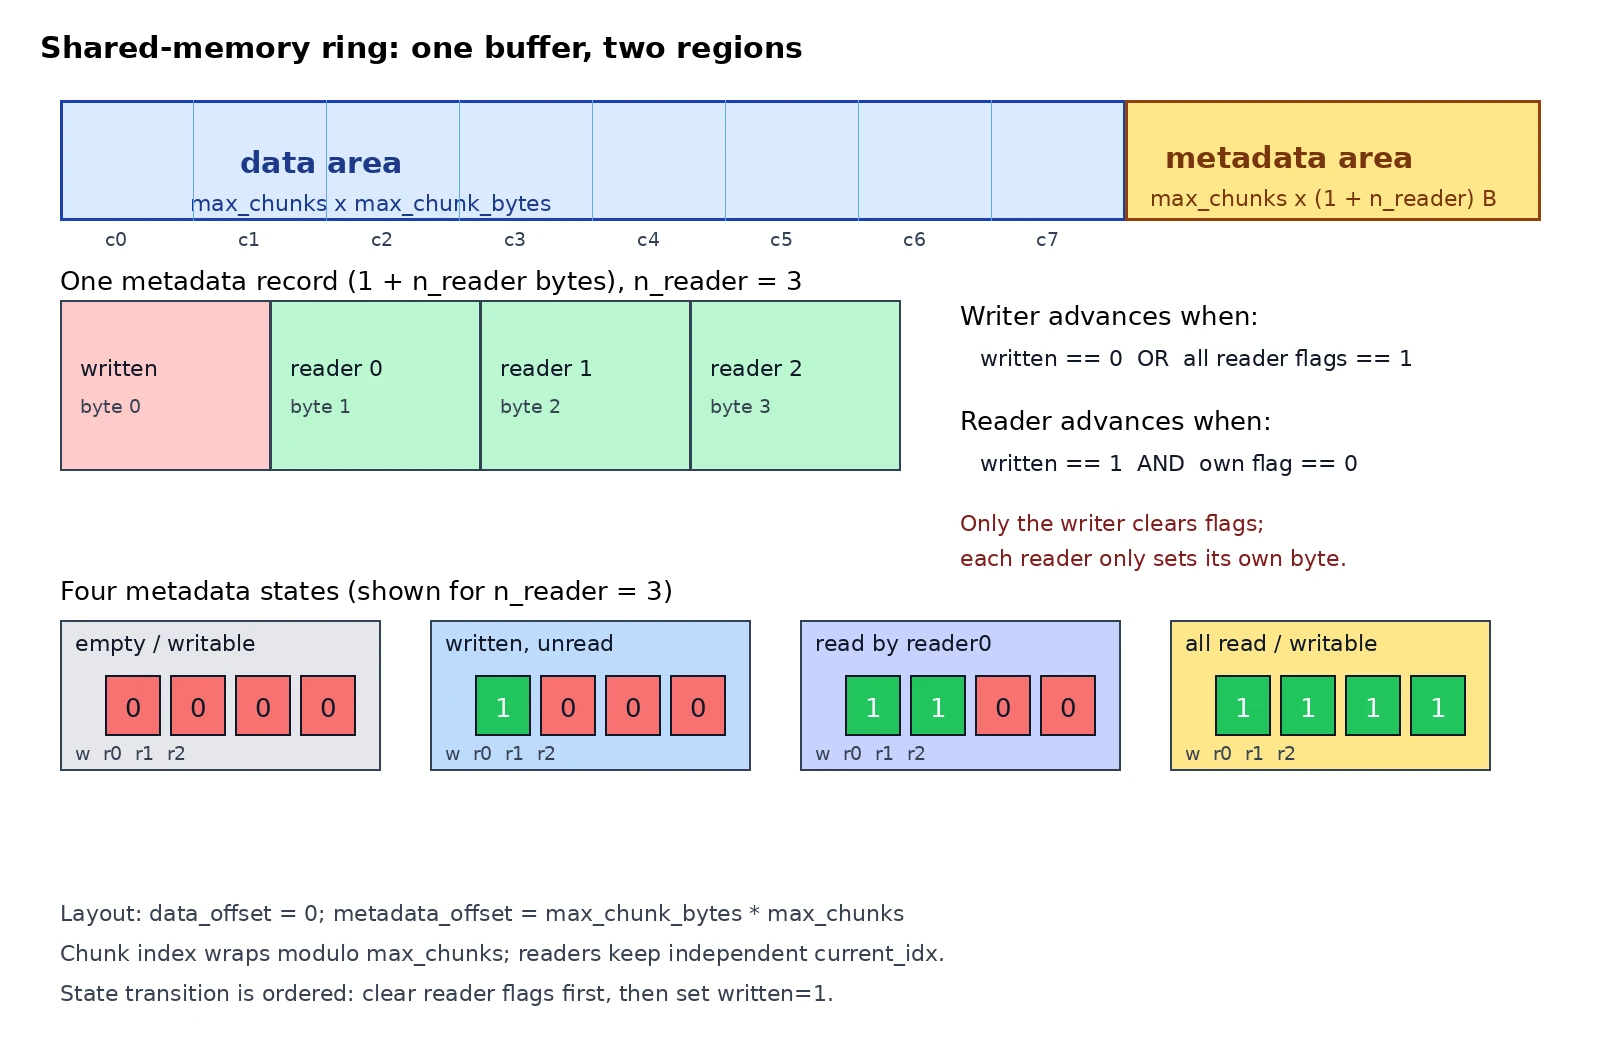
图:ShmRingBuffer 的字节布局与四态转移。数据区与元数据区在同一段共享内存里顺序排布;每个 chunk 对应 1 + n_reader 个标志字节。
每个 chunk 的元数据是 1 + n_reader 个字节。第 0 字节叫 written_flag,第 到第 字节分别是读者 0 到读者 的 read_flag。代码里没有用整数计数器,而是用单字节标志位,原因很实际:标志位只需要两种状态,用 byte 更新可以避免多字节写撕裂;读者数量在构造时就固定,索引也就能算死,不需要原子自增。
四个状态的语义写在 ShmRingBuffer 的文档字符串里:
| 状态 | 各字节取值 | 写者能做 | 读者能做 |
|---|---|---|---|
| 刚初始化 | 0 0 0 ... 0 | 可写 | 不可读 |
| 刚写入 | 1 0 0 ... 0 | 不可写 | 可读 |
| 部分读者已读 | 1 1 0 ... 0 | 不可写 | 未读的读者可读 |
| 全部读完 | 1 1 1 ... 1 | 可写 | 不可读 |
这个状态机是经典的单写多读环形队列:写者前进的条件是“当前 chunk 的 written_flag == 0,或者所有读者都已读”;读者前进的条件是“written_flag == 1 且自己那一位还是 0”。读位置不共享——每个读者各自维护一个 current_idx,从 0 开始、到 max_chunks 回绕,因此不需要任何“读指针”的同步。
为什么写者的顺序不能反过来
acquire_write 的收尾有两步,注释特意标了 NOTE:
# caller has written to the buffer# NOTE: order is important here# first set the read flags to 0# then set the written flag to 1for i in range(1, self.buffer.n_reader + 1): metadata_buffer[i] = 0metadata_buffer[0] = 1如果先置 written_flag = 1、再把读者标志清零,中间会短暂出现 1 1 1 ... 1 之后又变成 1 0 0 ... 0 的窗口。读者看到 written_flag == 1 且自己那一位为 1,会认为“这个 chunk 我已经读过了”,于是一整块新数据被跳过——直到环回绕一圈才会再遇到。反过来,先把读者位清零、再置写入位,中间状态只可能是 0 0 0 ... 0,读者看到写入位为 0,只会继续自旋,不会误读。
写者开头还有一步 metadata_buffer[0] = 0,作用是把“全部读完”(1 1 ... 1)或“刚初始化”(0 ... 0)都归约到“不可读、可写”。注意这一步发生在 yield 之前,也就是在调用方真正写数据之前。这个提前量是必须的:如果先让调用方写数据、再清标志,读者可能在这段时间里看到旧的 written_flag == 1,读到一半新一半旧的数据。
读者只置位,写者负责清零
读者读完以后只做一件事:metadata_buffer[local_reader_rank + 1] = 1,然后自己的 current_idx 前进一格。读者从不碰 written_flag,也不碰其他读者的标志位。所有清零动作都由写者完成。这样每个字节只有一个写者,避免了“多个进程同时写同一个字节”的竞态,代价是写者必须等所有读者都读完才能复用 chunk——这也是环大小的下界:max_chunks 必须大于“最慢读者落后写者的步数”。
DeepInfer 在 CP 组里给的值是 1 << 20 字节的 chunk、10 个 chunk(MessageQueue.create_from_process_group(self.cpu_cp_group, 1 << 20, 10)),即每块 1 MiB、总共约 10 MiB 共享内存。对“元数据 + 方法名 + kwargs”这类对象,1 MiB 已经远超正常大小;10 个槽位是给“读者短暂落后”留的缓冲,不是给大对象留的。
写者与读者:自旋、让出与超时
抛开上层对象,环本身只暴露两个上下文管理器:acquire_write() 和 acquire_read()。它们都是“自旋直到拿到块 → yield 给调用方读写 → 收尾更新标志 → 前进下标”的循环。
@contextmanagerdef acquire_write(self, timeout=None): start_time = time.monotonic() n_warning = 1 while True: with self.buffer.get_metadata(self.current_idx) as metadata_buffer: read_count = sum(metadata_buffer[1:]) written_flag = metadata_buffer[0] if written_flag and read_count != self.buffer.n_reader: n_warning = self._spin_wait(start_time, n_warning, timeout) continue metadata_buffer[0] = 0 with self.buffer.get_data(self.current_idx) as buf: yield buf for i in range(1, self.buffer.n_reader + 1): metadata_buffer[i] = 0 metadata_buffer[0] = 1 self.current_idx = (self.current_idx + 1) % self.buffer.max_chunks breakget_metadata 和 get_data 都是对 shared_memory.buf 的切片再包一层 memoryview。每次循环重新取视图而不是缓存下来,是为了让偏移随 current_idx 变化;memoryview 的 with 退出会释放导出计数,避免长期持有导致共享内存无法关闭。
_spin_wait 做三件事:
os.sched_yield()elapsed = time.monotonic() - start_timeif elapsed > envs.DEEPINFER_RINGBUFFER_WARNING_INTERVAL * n_warning: logger.debug("No available shared memory block after %.1f seconds", elapsed) n_warning += 1if timeout is not None and elapsed > timeout: raise TimeoutError第一,os.sched_yield() 把 CPU 让给同优先级的其他线程。这里没有用 sleep:等待通常只有微秒级,睡过去再唤醒的代价比让出一次大;也没有用忙等死循环,因为在 CPU 核数与 GPU 数不对等、多个 worker 共享同一批核心时,纯忙等会把写者线程饿死。第二,按 DEEPINFER_RINGBUFFER_WARNING_INTERVAL(默认 60 秒)的整数倍打 debug 日志——只是提示,不是错误;环被长期堵住说明某个读者卡了,但 60 秒的阈值足以过滤掉正常的慢 step。第三,timeout 是可选参数,到点抛 TimeoutError,把“死锁”变成“可捕获的异常”。不过 broadcast_object 这条常用路径不传 timeout,实际运行时仍然是无限等待,调试期需要靠日志和 py-spy 之类的外部工具。
读者侧的循环对称,但判断条件换成了“写入位为 1 且自己的读位为 0”:
if not written_flag or read_flag: n_warning = self._spin_wait(start_time, n_warning, timeout) continuewith self.buffer.get_data(self.current_idx) as buf: yield bufmetadata_buffer[self.local_reader_rank + 1] = 1self.current_idx = (self.current_idx + 1) % self.buffer.max_chunkslocal_reader_rank 不是全局 rank,而是“我在 local_reader_ranks 列表里的下标”,由 create_from_handle 时用 handle.local_reader_ranks.index(rank) 算出来。这个细节决定了读者位的位置:如果误用全局 rank,CP=4 而写者是 global rank 8 时,索引会越界或错位。
两个通道:小对象走环,大对象走 socket
MessageQueue.enqueue 并没有把所有对象都塞进环。它先 pickle,再看长度是否超过 max_chunk_bytes:
serialized_obj = pickle.dumps(obj, protocol=pickle.HIGHEST_PROTOCOL)if self.n_local_reader > 0: overflow = len(serialized_obj) >= self.buffer.max_chunk_bytes with self.acquire_write(timeout) as buf: buf[0] = overflow if not overflow: buf[1 : len(serialized_obj) + 1] = serialized_obj if overflow: self.local_socket.send(serialized_obj)if self.n_remote_reader > 0: self.remote_socket.send(serialized_obj)chunk 的第 0 字节被复用为溢出标志,payload 从第 1 字节开始。读者先看这个字节:0 就从环里 pickle.loads,1 就去本地 XPUB/SUB socket 收完整对象。为什么需要这条溢出通道?因为环的槽位大小固定,而对象大小不可控:一次 prefill 的 InputMetadata 可能带着几千个 block id 的列表,序列化后超过 1 MiB 完全可能。若强行截断,接收端只能拿到半截 pickle;若动态扩环,则要重新映射共享内存,代价更大。把“大对象”降级到 socket,环只负责传一个字节的标志位,语义简单,也保住了小对象的快路径。
socket 用的是 ZeroMQ 的 XPUB/SUB,不是普通 PUB。差别在订阅确认:XPUB_VERBOSE 让写者能收到每一个订阅消息,wait_until_ready 才能准确地等到“所有读者都连上了”再返回:
def wait_until_ready(self): if self._is_writer: for n_reader, socket in ((self.n_local_reader, self.local_socket), (self.n_remote_reader, self.remote_socket)): for _ in range(n_reader): socket.recv() if n_reader > 0: socket.send(b"READY") elif self._is_local_reader: assert self.local_socket.recv() == b"READY" ...写者先收齐每个读者的订阅消息,再回一条 READY。读者收到 READY 才退出初始化。这个握手解决的是 ZeroMQ 的“慢加入”问题:PUB socket 在订阅者连上之前发出的消息会被直接丢弃,如果没有握手,先启动的写者可能在读者就绪前就 send 了第一帧,读者永远等不到那一帧。
多机读者则完全不走共享内存:create_from_handle 只给他们建 remote_socket(SUB),dequeue 直接从 socket 收整个对象。写者侧对 remote reader 也不做环操作,只 remote_socket.send(serialized_obj)。换言之,同一个 MessageQueue 可以同时服务“本地读者走环 + 远程读者走网络”,但 DeepInfer 的 create_from_process_group 目前把所有 CP 组读者都当成 local reader,跨节点分支实际没有被这条路径启用。
句柄:怎样让另一个进程找到同一块内存
共享内存的本质是一个名字加一段物理页。Python 的 multiprocessing.shared_memory.SharedMemory 用名字打开已存在的段,但要先知道名字,而名字在写者进程里随机生成。解决方案是把构造参数打包成可 pickle 的句柄,借已有的控制面通道——这里是 gloo 后端的 broadcast_object_list——发一遍:
@staticmethoddef create_from_process_group(pg, max_chunk_bytes, max_chunks, writer_rank=0): group_rank = dist.get_rank(pg) group_world_size = dist.get_world_size(pg) global_ranks = dist.get_process_group_ranks(pg) n_reader = group_world_size - 1 local_reader_ranks = [i for i in range(group_world_size) if i != writer_rank] if group_rank == writer_rank: buffer_io = MessageQueue(n_reader=n_reader, n_local_reader=n_reader, local_reader_ranks=local_reader_ranks, max_chunk_bytes=max_chunk_bytes, max_chunks=max_chunks) dist.broadcast_object_list([buffer_io.export_handle()], src=global_ranks[writer_rank], group=pg) else: recv = [None] dist.broadcast_object_list(recv, src=global_ranks[writer_rank], group=pg) buffer_io = MessageQueue.create_from_handle(recv[0], group_rank) buffer_io.wait_until_ready() return buffer_ioHandle 数据类里有 connect_ip、local_reader_ranks、buffer_handle(三元组 + 名字)、local_subscribe_port、remote_subscribe_port。注意 src 用的是 global_ranks[writer_rank]——组内 rank 0 不等于全局 rank 0,而 broadcast_object_list 要的是全局 rank。写者构造时 MessageQueue.__init__ 同时绑定了本地 XPUB(tcp://127.0.0.1:<port>)和远程 XPUB(tcp://*:<port>),端口由 get_open_port() 临时申请,因此句柄必须把端口一起传过去。
这里有一个工程上的坑:写者先建共享内存、后广播句柄,中间没有任何同步。如果某个读者进程启动得比写者晚很多,共享内存仍然存在(因为写者持有它),句柄广播也会让 broadcast_object_list 阻塞直到所有读者到达,所以不会出现“句柄到了但段被删了”的情况——前提是写者进程在等待期间不退出。
patch 掉 resource_tracker 的原因
with patch("multiprocessing.resource_tracker.register", lambda *args, **kwargs: None): self.shared_memory = shared_memory.SharedMemory(name=name)Python 在进程退出时,resource_tracker 会检查本进程创建的资源有没有被释放。对于“只是打开、并未创建”的共享内存段,tracker 也会记录,并在退出时抱怨“leaked shared memory”。补丁只是在打开期间屏蔽注册,退出前由 cleanup_shm_broadcast 显式 close(),创建者再 unlink()。DeepInfer 的 worker 停止时走的顺序是:
dist.barrier()userbuffer.close()dist.barrier()self.model_runner.destroy_cuda_graphs()PG.cleanup_shm_broadcast()dist.destroy_process_group()os._exit(0) 在非 driver worker 上会跳过析构器,所以必须在 barrier 之间显式调用 cleanup_shm_broadcast;否则用户缓冲区的析构 barrier 会被卡住。这是一处典型的“Python 析构不可靠,资源释放要写成显式流程”的工程取舍。
两种广播的汇合:_prepare_input 的三段拆分
到这一步,环和两条上层的用法可以合起来看。ModelRunner._prepare_input 是 driver 与 follower 的分叉点:
def _prepare_input(self, seq_metadata_list, metadata_zos, total_q=None): if self.is_driver_worker: return self._prepare_input_driver(seq_metadata_list, metadata_zos, total_q) return self._prepare_input_follower()follower 拿到什么?
def _prepare_input_follower(self): input_metadata_dict = broadcast_tensor_dict(src=0) input_metadata_type = input_metadata_dict.pop("type") run_cuda_graph = input_metadata_dict.pop("run_cuda_graph") total_q = input_metadata_dict["total_q"] num_reqs = input_metadata_dict["num_reqs"] if run_cuda_graph: graph_size, cuda_graph_used = self.cuda_graph_runner.select(total_q) input_metadata = self._graph_input_metadata(cuda_graph_used, num_reqs) else: input_metadata = input_metadata_type.from_flatten_dict(input_metadata_dict) cuda_graph_used = None graph_size = 0 return input_metadata, total_q, run_cuda_graph, cuda_graph_used, graph_sizedriver 侧的条件逻辑很关键:
if PG.context_parallel_group().size() > 1: with cpu_timer.record("broadcast_input_metadata"): input_metadata_dict = { "is_prompt": is_prompt, "type": type(input_metadata), "run_cuda_graph": run_cuda_graph, "total_q": total_q, "num_reqs": num_reqs, } if not run_cuda_graph: assert hasattr(input_metadata, "is_prompt") input_metadata_dict.update(input_metadata.to_flatten_dict()) broadcast_tensor_dict(input_metadata_dict, src=0)run_cuda_graph 为真时,清单里只有五个标量。 原因是 CUDA Graph 路径上,张量数据不走这条“每步重新广播”的路径。driver 用 _prepare_input_tensors(..., out_dict=cuda_graph_used.input_metadata_source.to_dict()) 把本 step 的输入直接写进图自己的输入缓冲区——ZOS 的 prepare_decode_v4_zos 用 get_or_create 从 args.out 里取已有缓冲区并原地填充,这些缓冲区在 capture 时就分配在 CUDA 上,source 和 device 是同一块存储,不需要额外的 H2D 拷贝。follower 只需要知道:这步要不要走图、走哪档图(total_q)、有效请求数(num_reqs)。它调 cuda_graph_runner.select(total_q) 选到本地同一档的 CudaGraphData,取它的 input_metadata_device,再把 num_reqs 写进去。
follower 的张量数据从哪来?来自 capture 时被录进图里的 NCCL broadcast 节点。capture 阶段 _run_model 在每档 batch 上调用过一次 input_metadata_device.broadcast(),其中 cp_broadcast_multi_tensor 的每个 dist.broadcast 都被 CUDA Graph 捕获成一个 collective 节点。replay 时,各 rank 重放各自的图,这些节点在组内重新配对执行:rank 0 把当前 step 填好的图输入广播给其他 rank。对象广播只在 capture 时发生一次,传的是 padding 元数据,负责把“结构”建起来;每步变化的是张量内容,负责把“数据”送过去。这正是“对象一次性、张量每步”的分工——如果每步都在 replay 之外重新跑一遍 InputMetadata.broadcast(),非张量字段会随 padding 布局被反复覆盖,图里已经固定的 host 侧标量反而对不上。
run_cuda_graph 为假时,清单才带上 to_flatten_dict() 的全部字段。 这里有两种子路径。
prefill 走 prepare_prompt,在 CPU 上生成一堆 Python 列表和 torch.Tensor,再 recursive_fn(lambda x: x.cuda(non_blocking=True)) 搬到 GPU。之后 to_flatten_dict() 把所有字段展平:一级字典字段(例如以压缩比为键的 positions_c、slot_mapping_store_ca)被展开成 "positions_c.128" 这样的键,值若是张量,就由 broadcast_tensor_dict 识别为张量、走 NCCL;值若是标量就留在清单里。接收端的 from_flatten_dict 按第一个 . 折回字典。展平与折回的规则必须严格镜像,否则“多一个键少一个键”会让 cls(**d) 直接抛 TypeError。注释里写明“更深嵌套不会出现”,所以只做一层展平就够。
ZOS decode 走 prepare_decode_v4_zos,路径完全不同。该函数接收 args.out(即 input_metadata_source.to_dict()),用 get_or_create(args.out, "klen", [total_q], torch.int32) 这类调用从已有缓冲区字典里取 tensor,不够就补分配,然后原地填充数值。于是 driver 侧的 InputMetadata 字段与图里的源缓冲区是同一批 tensor 的引用;to_flatten_dict 后再广播,走的仍然是 broadcast_tensor_dict。
两条子路径汇合在同一个 broadcast_tensor_dict 调用上,差别只在“张量从哪里来”:prefill 是新建的、只活一步;ZOS decode 是图里常驻的,地址稳定。这也解释了两者在接收端的差异:follower 收到 InputMetadataV4 的 from_flatten_dict 后,它拿到的是新分配的接收缓冲区,地址与 driver 的不同,但形状 dtype 一致,forward 时各自的 CUDA Graph(follower 侧同样捕获过)会从本地的 input_metadata_device 读数据,而 from_flatten_dict 返回的这份只在非图路径下参与计算。
还有一处细节:driver 在 broadcast 前没有把 input_metadata 同步到所有 rank,而是先 broadcast_tensor_dict 再本地返回。这意味着张量广播在 driver 调用处是同步阻塞的(dist.broadcast 是阻塞调用),follower 的 dequeue + torch.empty + dist.broadcast 也在同一调用栈里完成。CP 组的每步前向因此天然带一个集合通信屏障:谁都跑不到 forward 之前。
上层用法一:把方法调用变成共享内存消息
MessageQueue 在 DeepInfer 里不只传数据,还承担 worker 之间的 RPC。driver worker 的 run_workers 是发送端:
def run_workers(self, method, driver_kwargs=None, **kwargs): with cpu_timer.record("broadcast_method", enable=False): assert self.is_driver_worker cp_group = PG.cpu_cp_group if cp_group and cp_group.size() > 1: cp_broadcast_object((method, kwargs)) return getattr(self, method)(**(driver_kwargs or {}), **kwargs)非 driver worker 在 start_slave_worker_loop 里死循环接收:
def start_slave_worker_loop(self): set_pdeathsig(signal.SIGKILL) while True: method, kwargs = cp_broadcast_object(None) getattr(self, method)(**kwargs)这段代码揭示了一个重要的架构事实:CP 组内的 worker 不是各自独立调度的,而是由 driver 单点指挥的。driver 先广播方法名和参数,再在本地执行同一方法;slave 收到后执行。两边执行的是同一份 Python 方法,区别只是 driver_kwargs 里有 driver 特有的参数(比如本地的 block table 地址、只有 rank0 知道的调度结果),而 kwargs 是所有人共享的部分。
这么做的好处是控制面只有一条路径:不需要每个 worker 各自跑一遍调度器,也不需要为“谁先谁后”设计复杂的同步协议。坏处是 driver 成了单点,且整组必须严格 lockstep——driver 每步只能 enqueue 一次,任何一次多传或少传都会让后续所有步骤错位。代码里 start_slave_worker_loop 没有退出消息,worker 停止靠 dist.barrier() 加 os._exit(0),而不是往队列里塞一个哨兵对象。
cpu_timer.record("broadcast_method", enable=False) 这一行也值得注意:计时器默认关闭,说明作者量过这条路径,认为它不在关键路径上,不想为它引入额外开销;但它仍保留在代码里,需要时可以打开看单步广播耗时。
上层用法二:张量字典的两段式广播
broadcast_tensor_dict 是把“元数据走环、张量走 NCCL”写得最清楚的一处:
def broadcast_tensor_dict(tensor_dict=None, src=0): cp_group = PG.context_parallel_group() if cp_group.size() == 1: return tensor_dict assert src == 0, f"Invalid src rank ({src})"
tensors = [] if cp_group.rank() == src: metadata_list = [] for key, value in tensor_dict.items(): if isinstance(value, torch.Tensor): assert value.is_cuda metadata_list.append((key, TensorMetadata(value.dtype, value.size()))) tensors.append(value) else: metadata_list.append((key, value)) cp_broadcast_object(metadata_list) else: tensor_dict = {} for key, value in cp_broadcast_object(None): if isinstance(value, TensorMetadata): tensor_dict[key] = torch.empty(value.size, dtype=value.dtype, device="cuda") tensors.append(tensor_dict[key]) else: tensor_dict[key] = value cp_broadcast_multi_tensor(tensors, src) return tensor_dict发送端把每个值分成两类:张量只留一个 TensorMetadata(dtype, size) 占位,非张量原样放进清单;然后先广播清单,再广播张量本体。接收端遍历清单,遇到 TensorMetadata 就地 torch.empty 出同形张量,凑成一个与发送端顺序一致的列表,最后调 cp_broadcast_multi_tensor。
这个顺序不能颠倒。cp_broadcast_multi_tensor 内部是:
for tensor in inputs: dist.broadcast(tensor, src=..., group=cp_group)它逐个张量调用 dist.broadcast,没有用 batched collective(源码里有 TODO 提到未来可能换 DeepEP 的 multi-tensor broadcast)。逐个调用意味着每次都有一次 NCCL 调用开销,但好处是实现简单、对任意数量的张量都成立。如果清单还没到就广播张量,接收端根本不知道该分配多大的缓冲区。
另外注意 src 被硬编码断言为 0。这一限制来自调用方的约定:CP 组内只有 rank 0 是“主”rank,它持有调度结果和完整的输入元数据;其他 rank 是镜像执行者。若将来需要从其他 rank 发起广播,这个断言会先拦住,而不是让程序带着错误的 rank 语义继续跑。
上层用法三:InputMetadata.broadcast 的按路径回填
真正复杂的是 InputMetadata.broadcast。InputMetadata 是一个 dataclass,字段里既有张量(input_ids、positions、mirror_cp_index),也有标量(num_reqs、total_q、cp_mirror_len),还可能嵌套 dict(ratio buckets、defaultdict)。如果直接把整个对象 pickle 过去,张量会被序列化,几 MB 到几十 MB 的数据走共享内存,既浪费带宽又增加延迟;如果只传标量,接收端的张量字段又没有值。DeepInfer 的做法是先收集、再按路径回填:
def broadcast(self): non_tensor_values = {} tensor_list = [] visited = set()
def collect_values(obj, path=""): obj_id = id(obj) if obj_id in visited: return visited.add(obj_id)
if isinstance(obj, torch.Tensor): assert obj.is_cuda tensor_list.append(obj) elif isinstance(obj, dict): if obj: for k, v in obj.items(): collect_values(v, f"{path}.{k}" if path else k) elif path: non_tensor_values[path] = obj elif hasattr(obj, "__dataclass_fields__"): for f in fields(obj): collect_values(getattr(obj, f.name), f"{path}.{f.name}" if path else f.name) elif path: non_tensor_values[path] = obj
collect_values(self)
if PG.context_parallel_group().rank() == 0: cp_broadcast_object(non_tensor_values) else: for path, value in cp_broadcast_object(None).items(): *parents, last = path.split(".") obj = self for part in parents: obj = obj[part] if isinstance(obj, dict) else getattr(obj, part) if isinstance(obj, dict): obj[last] = value else: setattr(obj, last, value)
if tensor_list: cp_broadcast_multi_tensor(tensor_list)几个设计点:
路径而非索引。 发送端用 "a.b.c" 这样的点分路径标识每个非张量值,接收端按路径逐级 getattr 或 obj[part] 找到容器,再 setattr 或赋值。这样做的原因是 dataclass 的字段顺序和 dict 的键顺序在两端可能不同(尤其是 defaultdict 动态插入的键),用索引对应会错位;路径是稳定的语义地址。
空 dict 也要传。 elif path: 分支处理空字典:如果 obj 是空 dict,递归不会产生任何子路径,接收端就不知道这里应该有一个空 dict。所以在 if obj: 为假且 path 非空时,直接把空 dict 本身放进 non_tensor_values。
visited 防环。 对象图里可能有引用环(比如 metadata 里嵌了指向自身的字段,或者同一个 dict 被多处引用)。visited 记录 id(),避免无限递归;代价是同一个对象被多处引用时只按第一条路径发送,接收端第二条路径指向的仍是原对象——在“接收端对象结构由发送端路径驱动”的语义下,这恰好是对的。
非 rank 0 的接收端必须已经有一份同构的 InputMetadata。 代码里 obj = self,然后逐级查字段;这意味着接收端在调用 broadcast() 之前,必须先用同样的构造逻辑建好空壳(张量字段为 None 或已分配)。这与“先 torch.empty 再收张量”是同一套思路:结构先行,数据后填。
num_reqs 的注释也印证了这一点:
num_reqs: int = 0"""Real request count (excludes cudagraph padding). Needed by non-driver CP ranks."""CUDA Graph 会把 batch 补齐到固定档位,driver 侧的 num_seqs 含 padding,而真正有效的请求数只有 driver 知道;非 driver 的 CP rank 要靠这个字段跳过 padding 对应的输出。它是个标量,走环里的几个字节就够,但少了它整个输出解析都会错。
读环的几个易错点
源码里的这些细节看起来琐碎,但每一条都对应一种真实的 bug 形态。把它们单独列出来,便于在自己实现或改造时对照。
current_idx 的起点。 写者和本地读者的 current_idx 都从 0 开始,非本地读者(remote reader)设为 -1。写者与读者各自维护独立的下标,靠 metadata 标志位配对,而不是共享一个“队头指针”。如果错误地让读者读写者的下标,环形队列就变成了需要原子操作的共享队列。
读者位下标是本地读者列表里的位置。 metadata_buffer[self.local_reader_rank + 1] 中的 local_reader_rank 来自 local_reader_ranks.index(rank),是“我在本地读者列表中的位置”,不是全局 rank,也不是组内 rank。CP 组若只占全局 rank 8 到 11 的一段,而 local_reader_ranks=[0,1,2,3],那么写者是组 rank 0,读者位 1..3 对应组 rank 1..3。索引错位一个,读者就永远读不到“自己的”那一块。
acquire_write 里的 sum(metadata_buffer[1:])。 写者判断“所有读者都读完”用的是读者位之和,而不是逐个比较。在单写多读、每个读者只置位一次的语义下,这个求和等价于“全部为 1”;前提是读者位只能从 0 变 1、且只在写者清零时才回到 0。如果有人在中途清零了某一位,求和结果就会偏小,写者会继续等待。
get_data/get_metadata 的切片。 两者都按 current_idx 计算偏移,get_data 返回的是 max_chunk_bytes 大小的 memoryview,get_metadata 返回 1 + n_reader 字节的 memoryview。enqueue 里 buf[1 : len(serialized_obj) + 1] = serialized_obj 的赋值是 memoryview 切片赋值,长度必须完全一致。溢出判断用的是 len(serialized_obj) >= max_chunk_bytes,所以恰好等于 max_chunk_bytes - 1 的边界值仍然走环内路径,buf[1:] 刚好装下;再多一个字节就会被判为溢出,不会走到越界赋值。
溢出标志与 metadata 的关系。 overflow 写在 chunk 数据区的第 0 字节,读者读的是数据区而不是 metadata 区的 written_flag。两者含义不同:written_flag 表示“这个 chunk 有没有新消息”,overflow 表示“这条消息在不在 chunk 里”。把两者混用,就会在“溢出消息”上读到旧数据。
wait_until_ready 是集合操作。 写者要收到每个读者的订阅消息,再发 READY;读者要等到 READY 才能 dequeue。漏掉这一步,ZeroMQ 的“慢加入”会让第一批消息丢失。源码注释里特意写了 “This is a collective operation”,意思是所有进程必须调用它,不能只让写者调用。
析构顺序。 __del__ 里先 close() 再 unlink(),且只在 is_creator 时 unlink()。接收端打开的是写者创建的段,若接收端也 unlink(),写者或其他读者可能正在使用,段名会被提前释放,新进程再也无法通过名字打开。这个细节在 resource_tracker 报泄漏时特别容易被“顺手加上 unlink”破坏。
patch 的位置。 在 create_from_handle 里,patch("multiprocessing.resource_tracker.register", ...) 只包住打开共享内存的语句。如果把它包在 __init__ 整体上,创建者也会跳过注册,而创建者恰恰需要由 tracker 跟踪,才能在本进程退出时提醒未释放的段。这里的粒度是故意取窄的。
这条通路到底省了什么:一次广播的成本拆解
把对象广播拆成可计量的几段,才能判断它值不值得存在。
发送端:pickle.dumps(obj) 把 Python 对象转成字节串。对 InputMetadata 的展平字典,主要成本是几十到几百个标量的序列化,以及少量小张量的描述符;如果直接把张量本体 pickle,成本会随 token 数线性上升——这也是 InputMetadata.broadcast 要单独收集张量、走 NCCL 的原因。
环内传递:一次 cudaMemcpy 级别的内存拷贝(实际是 CPU 的 memcpy,不经过 GPU),大小等于 payload 长度;加一次 metadata 写入、一次读者 metadata 读取。对 1 KiB 级对象,这部分在微秒量级。
接收端:pickle.loads 反序列化,重建字典与元组。这是纯 Python 开销,通常比发送端的 dumps 更贵,因为要分配对象、填充字典。
对照方案:torch.distributed.broadcast_object_list 在 gloo 上同样要 pickle,但还要把字节串切成块、经 socket 发送、在接收端重新拼装,并且走一遍 gloo 的线程模型。对单机内的小对象,这条路径的固定开销(系统调用、线程唤醒、可能的 GIL 争用)明显高于共享内存的直接读写;集合通信本身的成本模型可参考 AllReduce 完全拆解:Ring、树算法与 NCCL。DeepInfer 选择共享内存,本质上是在“单机、小对象、每步都要发”这个特定场景下,把 gloo 的通用性换成了常数更小的路径。
代价也很直接:这条通路不能跨机。一旦 CP 组跨节点,写者仍可以在本地环里写,但远程读者必须走 socket;代码里 remote reader 分支虽然存在,create_from_process_group 却没有启用它。所以这套实现的服务边界是“CP 组同节点”,跨节点部署需要另做一层 handle 协商与网络传输。这不是缺陷,而是一个明确的适用范围。
还有一个隐性成本:序列化格式的兼容性。pickle 的协议版本、类的模块路径、字段顺序都会影响反序列化。写者和读者是同一份代码、同一个 Python 环境时没有问题;如果一边是训练框架导出的对象、另一边是推理引擎的类,模块路径不同就会失败。DeepInfer 的 cp_broadcast_object 只传引擎自己构造的元组、字典和 InputMetadata 字段,不传任意用户对象,规避了这个问题。
顺序、时序与 CUDA Graph:对象广播在图里图外各算什么
InputMetadata.broadcast() 在 CudaGraphRunner._run_model 里被调用,而 _run_model 既用于 warmup/capture,也用于非图路径的普通前向。这个位置决定了它的两重语义。
非图路径(prefill、未启用 CUDA Graph 的 decode):每次前向都真正执行一遍 broadcast()。发送端先 cp_broadcast_object(non_tensor_values),接收端按路径回填;随后 cp_broadcast_multi_tensor(tensor_list) 逐张量 dist.broadcast。这是一个完整的、每步都发生的控制面同步。
图路径(decode):CUDA Graph 的捕获与重放机制本身可参考 DeepInfer 源码完全拆解(十二):CUDA Graph 捕获与重放。broadcast() 在 capture 时执行一次,写入的是 padding 元数据;cp_broadcast_multi_tensor 的每个 dist.broadcast 被录进图,成为图里的 NCCL 节点。replay 时,图重新执行这些节点,rank 0 当前的输入张量被广播给其他 rank;而 cp_broadcast_object 的共享内存写入不会在 replay 时重放。于是:
- 张量:每步更新,由 captured NCCL 节点搬运。
- 非张量字段:capture 时固定,replay 时不变。任何需要每步变化的标量,要么被编码进张量,要么在
get_clean_list()里清空、在 forward 里从张量重新计算。InputMetadataV4.get_clean_list()返回的kv_ca_index_len、kv_swa_index、kv_ca_index、mlp_relu_schedule_metadata、flash_mla_sched_meta_dict就是这类“capture 后清空、forward 重算”的字段。 num_reqs:不属于图内标量,由_graph_input_metadata在每步 replay 前直接写进 Python 对象的属性。它只影响 sampler 对输出行的解释,不进入 GPU kernel 的参数,因此可以在图外改。
这解释了一个容易误读的点:对象广播不是“每步都跑”的热路径。在 CUDA Graph decode 下,它只在 capture 时跑一次;真正的每步开销是图内 NCCL 广播和 recursive_copy_/ZOS 的输入填充。把对象广播当成每步都要 pickle 一次,会高估它的成本,也会误判优化方向。
对 broadcast_tensor_dict 这条路径则不同:它在 _prepare_input 里被调用,发生在 model_runner.execute_model 的每次 prepare 阶段,不管走不走图都会执行(_prepare_input_driver 里的 if PG.context_parallel_group().size() > 1 分支没有区分 run_cuda_graph,只是图的路径下清单更短)。所以要看具体调用点,不能一概而论。
一次 CP decode step 的时序
把前面的零件按时间排一遍,能看到广播在关键路径上的确切位置。
- 调度:driver 的调度器选出本步要跑的序列,生成
SequenceMetadata。这一步只有 driver 有完整结果,follower 不参与。 - 构造输入:driver 调
_prepare_input_tensors,ZOS 路径下用prepare_decode_v4_zos原地填充图输入缓冲区;follower 走_prepare_input_follower,调broadcast_tensor_dict(src=0)等 driver 的清单。 - 控制面广播:driver 把
type、run_cuda_graph、total_q、num_reqs等标量放进清单;非图路径还要展平全部字段。小对象走共享内存环,大对象走溢出 socket;张量只传描述符。follower 收到清单后按from_flatten_dict重建对象,或者按select(total_q)选中本地同一档的 CUDA Graph。 - 数据面广播:非图路径下
cp_broadcast_multi_tensor逐张量dist.broadcast,follower 的缓冲区由 driver 的数据填充;图路径下这一步被录在 graph 里,replay 时由 captured NCCL 节点完成。 - 前向与采样:driver 和 follower 各自 replay 或 eager forward;采样与输出解析只在 driver 上做,follower 的输出被丢弃或仅用于校验。
关键路径上的阻塞点有两个:acquire_write 等环空位、acquire_read 等新消息,以及 dist.broadcast 的集合通信。前者是 CPU 侧的微秒级等待,后者是 GPU/NCCL 侧的同步。对象广播的设计目标,是让第一个阻塞点尽可能短;第二个阻塞点则由张量大小和网络决定,不是共享内存能解决的。
边界条件:这套实现不承诺什么
把代码的假设逐条列出来,比笼统地说“高性能”有用。
同节点假设。 create_from_process_group 的注释明确假设组不跨节点,所有读者都是 local reader。跨节点时 ShmRingBuffer 的 shared_memory.SharedMemory(name=...) 在另一台机器上会 FileNotFoundError,代码用 suppress 吞掉异常,但 self.shared_memory 不会被赋值,后续 get_data 会失败。真正跨节点的路径需要走 remote_socket,而这条路径没有被 create_from_process_group 启用。部署时必须保证 CP 组落在同一节点,或者自行改造成 remote reader。
写者固定为 rank 0。 broadcast_tensor_dict 断言 src == 0;create_from_process_group 的默认 writer_rank=0。这不是任意的约定:CP 组内只有 rank 0 持有完整调度结果和 sampler 输入,其他 rank 是镜像执行者。把写者换成别的 rank,需要同时改调度器与 sampler 的职责划分,不能只改一个参数。
没有显式的内存屏障。 标志位是普通字节写,acquire_write/acquire_read 依赖共享内存的缓存一致性。x86 的 TSO 模型下,写顺序与读顺序基本符合直觉;ARM 等弱内存序平台上,理论上需要 acquire/release 语义或 std::atomic_thread_fence。DeepInfer 在 Ascend/ARM 主机上运行这套代码时,这一层保证来自内核与硬件的缓存一致性协议,而不是语言级原子操作。把它当成“形式化验证过的无锁队列”是不准确的;它是一个在目标平台上经过实践检验的工程实现。
环容量与慢读者。 max_chunks 必须大于“最慢读者可能落后的步数”。如果一个读者卡住超过 max_chunks 步,写者会在 acquire_write 里自旋等待,整个 CP 组停摆。代码用 DEEPINFER_RINGBUFFER_WARNING_INTERVAL 打日志提示,但没有自动降级或踢出慢读者的机制。生产环境里,读者的卡顿通常来自 Python GC、采样分支或日志 I/O,而不是 GPU;这也是为什么 worker 初始化时要做 gc.freeze()、gc.collect(),并在 init_model 之后启动 slave loop。
没有真正的“多写者”支持。 MessageQueue 的文档写明“only one will enqueue and multiple will dequeue”。如果两个 rank 同时 enqueue,current_idx 会互相覆盖,metadata 的 written flag 也会被对方清掉。上层只有一个 driver 调用 run_workers,所以这个约束在 DeepInfer 的用法里成立;但作为通用组件,它不能被当成 MPMC 队列使用。
对象生命周期。 pickle.dumps 之后,enqueue 立即把字节写入环;调用方可以马上修改原对象,不会影响已发送的数据。接收端 pickle.loads 得到的是独立副本。这一点与“传引用”的朴素直觉相反,但正是跨进程通信需要的语义。反过来,如果对象里有 torch.Tensor,pickle 会尝试序列化张量本体;这就是上层要避免把张量放进 non_tensor_values 的原因。
设计空间:还有哪些路可以走
“同机多进程传对象”不是只有共享内存一条路。把备选方案摆在一起,才能看清 DeepInfer 的选择是哪种约束下的最优,而不是唯一解。
方案一:gloo 的 broadcast_object_list。 优点是接口标准、支持任意拓扑、跨机也能用;缺点是每次都要 pickle、切块、走 socket,接收端还要等后台线程把数据搬完。对“每步一次、对象几百字节”的 CP 控制面,固定开销占比过高。它更适合“偶尔一次”的初始化同步,比如广播句柄本身——DeepInfer 正是这么用的。
方案二:CUDA IPC。 可以把 GPU 显存映射到另一个进程,适合传大张量;但 Python 对象不在显存里,而且 CUDA IPC 的句柄管理、生命周期和跨平台支持都比 POSIX 共享内存复杂。对象广播的 payload 是 Python 结构,不是 GPU buffer,用 CUDA IPC 属于杀鸡用牛刀。
方案三:文件系统 / mmap 文件。 用 mmap 映射一个文件,也能实现跨进程共享;但需要处理文件路径、清理、权限和落盘语义。multiprocessing.shared_memory 在 Linux 上落到 /dev/shm,本质是 tmpfs,不会写磁盘,生命周期由文件描述符和 unlink 控制,比普通文件更轻。DeepInfer 选它,是因为它同时满足“零磁盘 I/O”和“内核管理生命周期”。
方案四:Unix domain socket。 比 TCP 少一层网络栈,但仍然是内核拷贝 + 系统调用;对 1 KiB 对象,延迟通常高于共享内存的直接读写。ZeroMQ 的 inproc 传输也只能在同一进程内,不解决跨进程问题。
方案五:RDMA / 共享内存网络。 跨机场景的最优解,但需要专门硬件与编程接口;DeepInfer 的 CP 组同节点假设下用不上,跨节点时才会考虑。
这张对照表的结论是:共享内存环的优势区间非常窄——同机、进程数固定、对象小、频率高。离开这个区间,gloo 或 socket 的通用性更划算。DeepInfer 的代码没有试图做“通用 IPC 库”,它只在这个区间内把常数压到最低,然后把区间外的退化路径留给调用方判断。
与 vLLM ShmRingBuffer 的差异
DeepInfer 的 shm_broadcast.py 头部写着 Derived from vLLM; modified by DeepSeek.。把差异挑出来,能看清它为什么不是简单的复制。
第一,溢出标志的位置。 vLLM 的实现里,环只负责固定大小的消息;DeepInfer 在每个 chunk 的首字节写入 overflow 标志,payload 从第二字节开始。这个改动让同一个环既能传小对象,又能用“一个字节 + socket”处理大对象,不需要为两种大小维护两套接口。
第二,句柄与清理。 DeepInfer 的 ShmRingBuffer.__del__ 会 close(),创建者再 unlink();cleanup_shm_broadcast() 在 dist.destroy_process_group() 之前显式调用。vLLM 的原始实现依赖 Python 析构与 resource_tracker,在 os._exit(0) 跳过析构的进程模型下容易留下泄漏警告。DeepInfer 的 worker 正好使用 os._exit(0),所以必须显式清理。
第三,用途。 vLLM 的 MessageQueue 主要用于前端进程向引擎进程传请求(以及多进程间的对象广播);DeepInfer 把它用在 CP 组的控制面:cp_broadcast_object、run_workers、InputMetadata.broadcast。用途变了,热路径的调用频率、对象大小、读者数量都不同,但底层协议保持不变。
第四,socket 通道的触发条件。 vLLM 的实现里,超过 max_chunk_bytes 的对象走本地 socket;DeepInfer 保留了这个逻辑,但 CP 组的 chunk 是 1 MiB,正常元数据远小于它,溢出分支更多是兜底而不是常态。
这些差异说明:共享内存环本身是一个相对稳定的“机制”,真正随系统变化的是“策略”——谁写、写给谁、传什么、什么时候清。读源码时把这两层分开,比逐行对比实现更有价值。
小结
DeepInfer 的 CP 组对象广播由三块拼成:
ShmRingBuffer:一段共享内存,前段是固定大小的 chunk 数据区,后段是每 chunk1 + n_reader字节的标志区。单写多读,写者等“全部读完”才复用,读者只置自己的位。MessageQueue:在环之上加句柄协商、ZeroMQ 溢出通道和READY握手。小对象走环,大对象走 socket;本地读者走共享内存,远程读者走网络(当前未启用)。- 上层协议:
run_workers把方法调用变成队列消息;broadcast_tensor_dict把“清单”和“张量本体”拆成两段;InputMetadata.broadcast按路径回填嵌套字段,并把张量交给 NCCL。
它解决的是一类很具体的问题:同一节点内、每步都要同步、对象小但结构复杂。这类问题用 gloo 的 broadcast_object_list 能做,但常数太大;用纯共享内存能做得更快,但需要自己处理同步、溢出、生命周期和跨机退化。DeepInfer 的代码把这几件事都写了出来,也把边界条件留在了注释和分支里。
下一篇可以接着讨论 InputMetadata 的构造侧:prepare_prompt_v4 与 prepare_decode_v4_zos 如何把调度器的 SequenceMetadata 变成这些字段,以及 ZOS 路径下“原地填充”与“重建对象”两种策略的取舍。那是这份元数据在进入广播之前的上游,也是理解 CP 镜像布局的关键。
参考资料
- Ring Attention with Blockwise Transformers for Near-Infinite Context
- DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models
- Unified Sequence Parallelism: Long Sequence Training from System Perspective
- vLLM 源码:distributed/shm_broadcast.py
- Python multiprocessing.shared_memory 文档
- ZeroMQ XPUB/SUB 模式说明
- DeepInfer 官方仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



