


CacheBlend 完全拆解:RAG 多段 KV 缓存拼接,为什么还要重算一小部分 token
背景:RAG 把 Prefill 变成了一笔重复账
检索增强生成(Retrieval-Augmented Generation,RAG)的典型请求里,用户问题往往只有几十个 token,而检索回来的文档片段动辄几千甚至上万 token。模型每一轮都要把这些文档重新读一遍:分词、嵌入、逐层计算注意力、写出 KV Cache,最后才轮到生成那几十个 token 的答案。Prefill 阶段的计算量随上下文长度线性增长,而它产出的 KV 只是为这一次请求服务,请求结束就随缓存一起释放。
这看起来是一笔很傻的账。同一份知识库文档,今天被十个用户检索到,明天还会被另外一百个用户检索到;每次都要从零开始算同样的 QKV、同样的注意力。前缀缓存(prefix caching)已经解决了其中一部分问题:如果两次请求的开头完全相同,第二次可以直接命中第一次留下的 KV,只算新增的后缀。问题是 RAG 的上下文很少长成「共享前缀 + 不同后缀」的形状。
前缀缓存能命中,是因为它要求「同一段文本出现在请求的最前面,且前面所有内容逐字节相同」。一段被检索出来的文档,今天是第 3 段上下文,明天可能就是第 1 段;今天的上下文由 A、B、C 三篇拼成,明天是 B、D、E 三篇。只要它前面接了别的内容,缓存键就不再匹配,整段文档仍然要重新 Prefill。RAG 的真实访问模式恰好是「同一批文档片段被不同问题反复取用,但每次拼接顺序和邻居都不同」,这正是前缀缓存最不擅长的形状。
为了绕开这个问题,另一条思路是「全量 KV 复用」(full KV reuse),代表工作是 PromptCache(arXiv:2311.04934)。它把文档片段单独做 Prefill,再用缓冲区补齐位置编码,最后把各片段的 KV 直接拼起来。拼接是快的,但拼出来的 KV 与真正一次性 Prefill 得到的 KV 并不是一回事——因为它漏掉了片段之间的交叉注意力。结果就是:速度接近零 Prefill,质量却明显下滑。
CacheBlend 正是在这两者之间给出的第三条路:复用拼接好的 KV,但在每一层挑出一小部分 token,把它们的 KV 真正重算一遍,从而把丢失的跨片段信息「补」回来。该方法由 Jiayi Yao、Hanchen Li、Yuhan Liu 等人以芝加哥大学为主完成,2024 年 5 月首次上传 arXiv,随后被 EuroSys ‘25 接收(DOI 10.1145/3689031.3696098,CacheBlend 论文),代码并入 LMCache 项目,后续工程实现中也作为 LMCache 的 cacheblend 混合模式落地。
要理解 CacheBlend 的设计,先要把「KV 缓存里到底存了什么、拼接时丢了什么」拆开。这不是一个位置编码补丁就能解决的问题:真正丢失的是片段与片段之间的注意力。下一节从一次完整的 Prefill 出发,把这条信息链逐层摊开。
问题:拼接的 KV 缓存到底少了什么
Transformer 的每一层都做同一件事:把上一层输出的隐藏状态 分别乘上三个投影矩阵,得到查询、键、值:
其中 在 RoPE 模型里还会被旋转矩阵按 token 位置旋转。Prefill 的产物就是每一层、每个 token 的 与 ,按层和 token 拼起来就是 KV Cache。解码时,新 token 的 query 只需要与这些已经算好的 做点积、再对 加权求和,不必回头重算历史 token 的隐藏状态。
关键在于, 本身是上一层注意力输出的结果。对于第 层的第 个 token,它的隐藏状态来自第 层中该 token 对所有前序 token 的注意力。因此一份「完整 Prefill 出来的 KV」不只记录了每个 token 自己的内容,还记录了它在每一层「看过哪些前序 token、看了多少」。这份跨 token 的依赖关系,是后面所有层继续计算的基础。
前缀缓存之所以能做到与全量 Prefill 完全一致,是因为因果注意力的三角结构:前缀 token 不可能看到它后面的 token,所以只要前缀文本不变,它的 KV 就与后面接什么内容无关。把前缀 KV 直接拿来用,后续 token 再对这段前缀做注意力,得到的结果与一次性 Prefill 完全相同。
非前缀片段没有这个性质。假设输入由 、 两段文本拼接而成,真正做全量 Prefill 时, 里的 token 在第 0 层会看到 ;第 1 层的 已经包含了从 吸收来的信息,于是第 1 层的 也带着跨片段信息。若把 单独 Prefill,它在第 0 层只看到自己, 就已经与全量 Prefill 不同;从第 1 层开始, 全面偏离。层数越深,偏差被逐层放大,而不是只错在某一层。
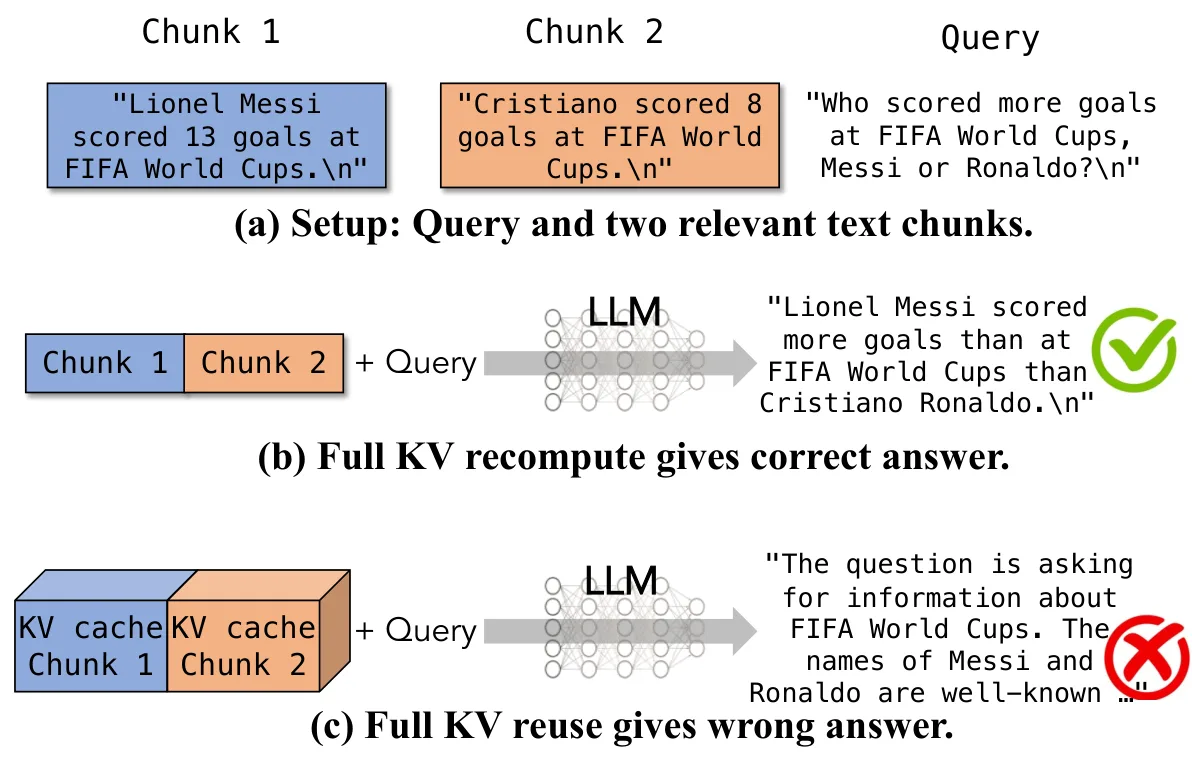
上图用一个具体问题说明偏差如何变成错误答案。用户问「梅西在世界杯上比 C 罗多进了几个球」,上下文是两段分别介绍两名球员职业生涯数据的文本。全量 Prefill 让第二段在每一层都能参考第一段,模型能把两个人的数字放在一起比较;全量复用则把两段各自独立算出的 KV 直接拼接,第二段从未看过第一段,生成时自然无法建立「梅西 vs C 罗」的对应关系,输出开始跑题。图源:CacheBlend 论文 Figure 3。
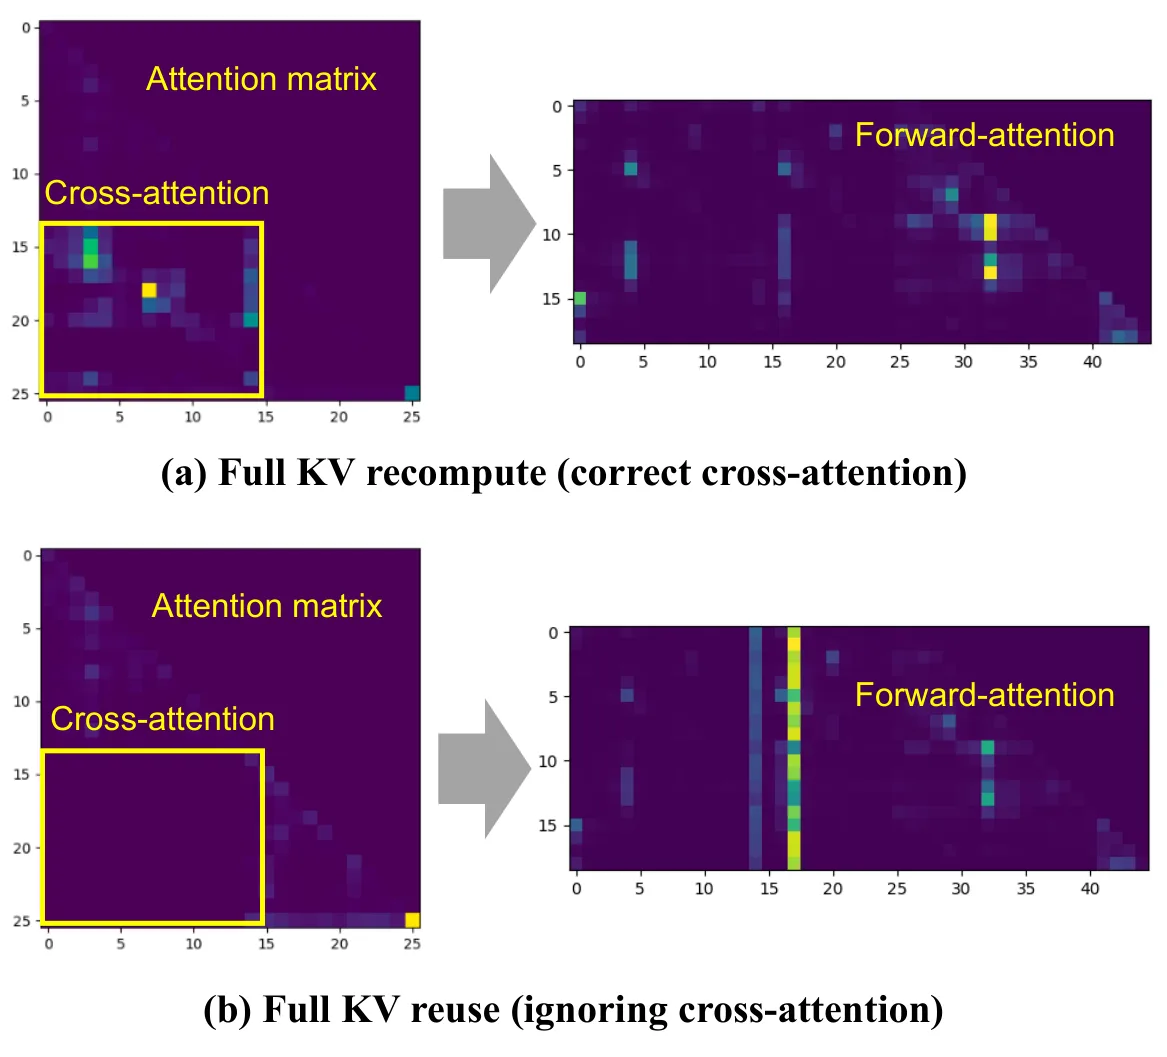
上图把差异落到注意力矩阵上。左侧两幅是每一层内部的 token 对 token 注意力:全量 Prefill 的矩阵里,第二段对第一段有完整的跨片段注意力块;全量复用拼出来的矩阵里,这块区域是空的,因为两段从未一起计算过。右侧两幅是真正决定生成结果的「前向注意力」——上下文 token 对最后几个 query token 的注意力权重。跨片段块缺失后,前向注意力的分布明显偏移。图源:CacheBlend 论文 Figure 4。
PromptCache 已经意识到位置问题:它先给待缓存的片段垫一段长度不小于前序文本的假前缀,让片段在「未来会被放到的位置」上完成 Prefill,再把这段假前缀丢掉。这样 RoPE 的绝对位置对上了,拼接时不会因为位置错位而崩。但位置正确并不等于语义正确:假前缀不是真实的前序文本,片段在 Prefill 时仍然没有看过真正会排在它前面的内容。位置可以靠旋转矩阵恢复,跨片段注意力却没有这样的闭式补丁。
代价有多大,可以用论文给出的量级感受:在 A40 上,4K token 的 Prefill,Llama-34B 约需 3 秒,Llama-70B 约需 6 秒;而 RAG 场景里这类长度只是常规上下文。前缀缓存只能省掉第一段,后面的片段越长、越多,省下的比例越小。全量复用能把这段时间几乎清零,但代价是上面那部分注意力信息完全丢失。CacheBlend 要做的,就是在「全量重算的 3 到 6 秒」与「全量复用的零计算但答错」之间,找一条只花很小一部分计算、却能把注意力偏差压回去的路径。
核心思想:只重算偏差最大的那一小撮 token
CacheBlend 把问题写成优化目标:给定一份拼接好的、带位置修正的预计算 KV,记为 ,希望更新出一个新的 KV,记为 ,使得每一层的「前向注意力」尽量接近全量 Prefill 的结果。用公式表示,对第 层:
其中 是第 层的前向注意力矩阵——上下文 token 对用于生成的那些 query token 的注意力权重。这个矩阵直接决定下一个 token 的 logits,所以它比「整张注意力矩阵是否相似」更贴近生成质量。
直接优化这个目标不可行:要算 就得先做全量 Prefill,问题绕回去了。CacheBlend 退一步,用「KV 偏差」作为可观测的代理量。对第 层第 个 token:
它衡量的是「这份缓存里这个 token 的 K/V,与真正全量 Prefill 出来的 K/V 差了多少」。论文的实证结论是:在一层里挑出 KV 偏差最大的那些 token 重算,注意力偏差下降得最快;而且偏差分布高度稀疏,通常只有 10% 到 15% 的 token 明显高于其余 token。这与注意力稀疏性的观察一致:一个 token 真正「在意」的其他片段 token 只是少数,大部分跨片段注意力权重很小,对应的 KV 即使有偏差,也不会显著改变前向注意力。
第二个观察更关键:相邻层的 HKVD token 高度相关。第 层偏差大的 token,在第 层往往还是偏差大的那一批。原因不神秘——Transformer 的隐藏状态逐层变化是缓慢的,而 K/V 只是隐藏状态的线性投影;上一层输入变化大的 token,下一层大概率仍然变化大。论文用 Spearman 秩相关系数验证了这一点:相邻层的 token 偏差排序保持高度一致。
这两个观察合起来,给出了一个不需要知道全量 KV 也能选 token 的办法:逐层过滤。若平均想保留 的 token,第一层先选 (略高于 ),只把这些 token 的隐藏状态传到第二层;第二层重算它们的 K/V,再在其中选 (略低于 )传给第三层;如此逐层收缩,最终稳定在 左右。每一层都在「上一层已经重算过的 token」里再挑一次,相当于要求一个 token 必须在多层都表现出高偏差,才会被保留到最后。这比只看第一层、然后一路沿用同一批 token 更稳健。
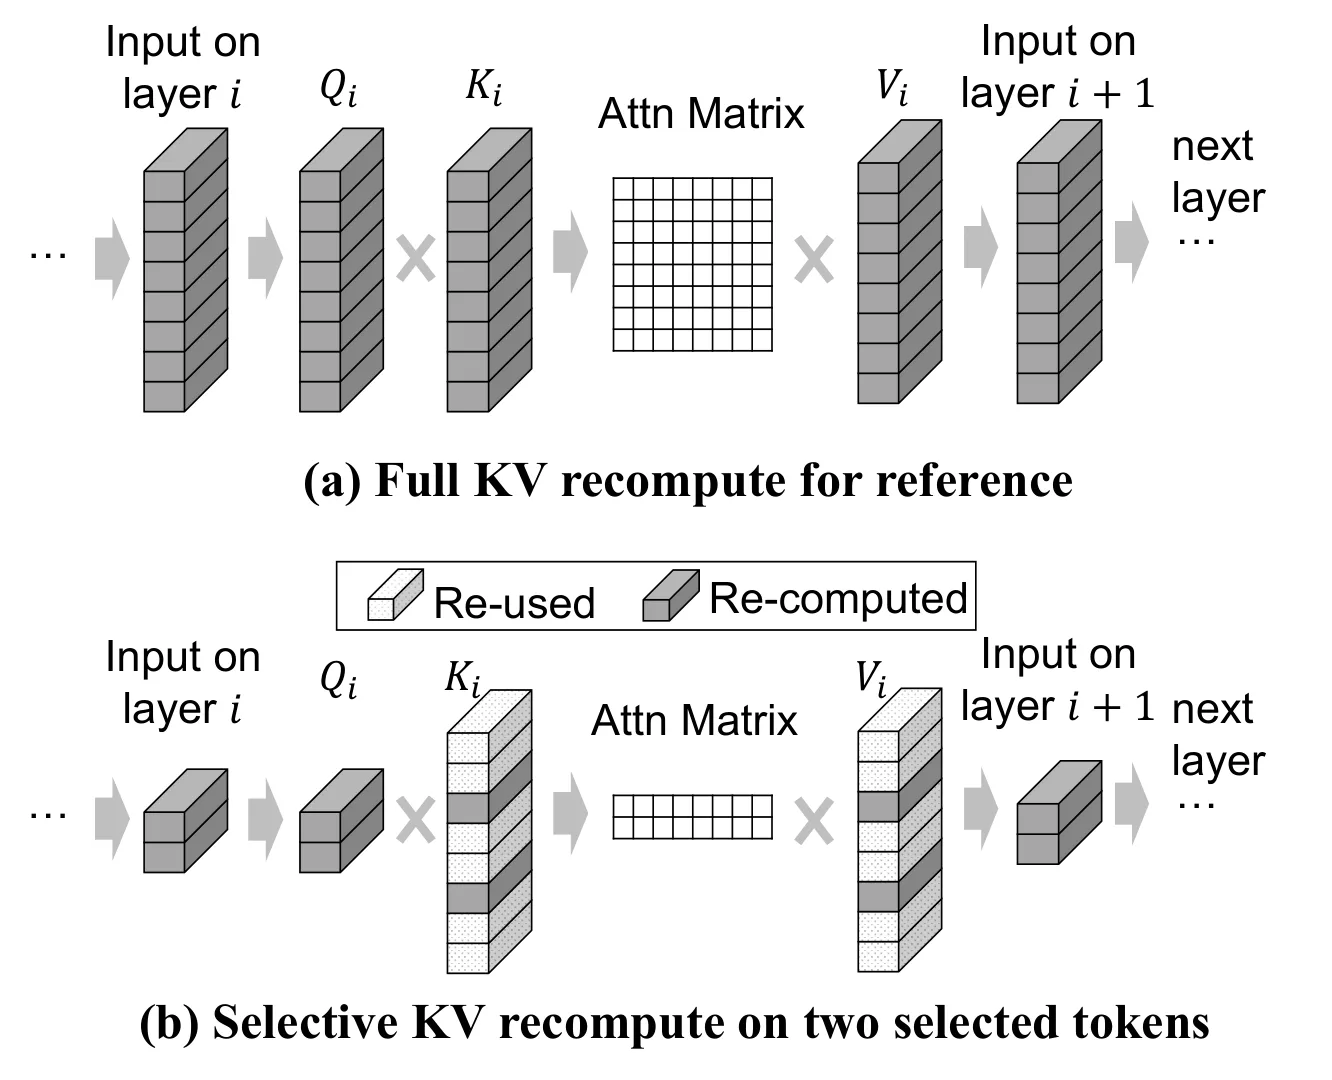
上图对比了单层内的两种做法。左侧是全量重算:这一层的所有 token 都重新算 QKV,再做完整注意力。右侧是选择性重算:先把输入掩码到选中的 token 集合,只算这几个 token 的 Q、K、V;然后用缓存里的 K/V 补齐未选中 token 的位置,拼出一份完整的 K/V;最后让选中的 query 对全部 token 做注意力,只把选中 token 的注意力输出传给下一层。重算的计算量正比于选中比例,未选中的 token 只作为 key/value 参与,不重新过投影。图源:CacheBlend 论文 Figure 5。
这里有一个容易被忽略、但决定算法能否成立的细节:被选中的集合必须逐层嵌套、只减不增。原因是隐藏状态的传播链。第 层只为集合 产生了新的隐藏状态;到了第 层,只有 里的 token 拥有「用新上下文算出来的输入」。如果第 层突然想重算一个不在 里的 token,它拿不到该 token 在第 层的新隐藏状态,只能用旧缓存里的 K/V,重算也就无从谈起。逐层收缩的 正好保证 :集合越来越小,每个保留下来的 token 都有一路更新下来的隐藏状态。
第一层需要一次完整的计算来建立参照。此时还没有任何「上一层选出的集合」,模型必须先在全部 token 上算出这一层的注意力/KV,才能比较出谁偏差大、选出 。这一次性的固定成本相当于一层全量 Prefill;对 30 层以上的模型,它只占整体的一小部分,后面 30 多层都只处理收缩后的集合。论文的实现还把第一层选出的 token 集合作为后续层的初始候选,避免每层重新全量扫描。
内存上,HKVD 计算需要在当前层同时持有「更新后的 KV」和「预计算的 KV」两份数据,用来比较偏差。但预计算的那一份在进入下一层后立即丢弃,不跨层保留,所以额外占用只发生在单层内,相对于整份 KV 缓存可以忽略。这一点很重要:CacheBlend 没有为「选择」再引入一套长期缓存,系统复杂度仍然集中在原有的 KV 存储与传输上。
选 token:HKVD、逐层过滤与 15% 这个经验值
CacheBlend 把每层被选中的 token 称为 HKVD token(High-KV-Deviation token)。名字听起来像要预先知道真实 KV,实际流程是反过来的:
- 第一层先做一次完整的层内计算,把「用当前上下文算出的 K/V」与「从缓存加载的 K/V」逐 token 比较,得到第一轮的偏差排序,选出 作为初始 HKVD 集合。
- 从第二层开始,只对上一层的 HKVD 集合计算 QKV。因为这些 token 的隐藏状态已经带着跨片段信息,新算出的 K/V 与缓存里的旧 K/V 之间的差异,就是这个 token 在当前层的真实偏差代理。在这一批 token 内再按偏差排序,选出更小的 传给下一层。
- 重复这个过程,集合逐层收缩,直到最后一层。
论文的图示把这条漏斗画得很清楚:每一层只在上层留下的候选里比较,越往后候选越少,但留下的都是「在前几层都表现出高偏差」的 token。
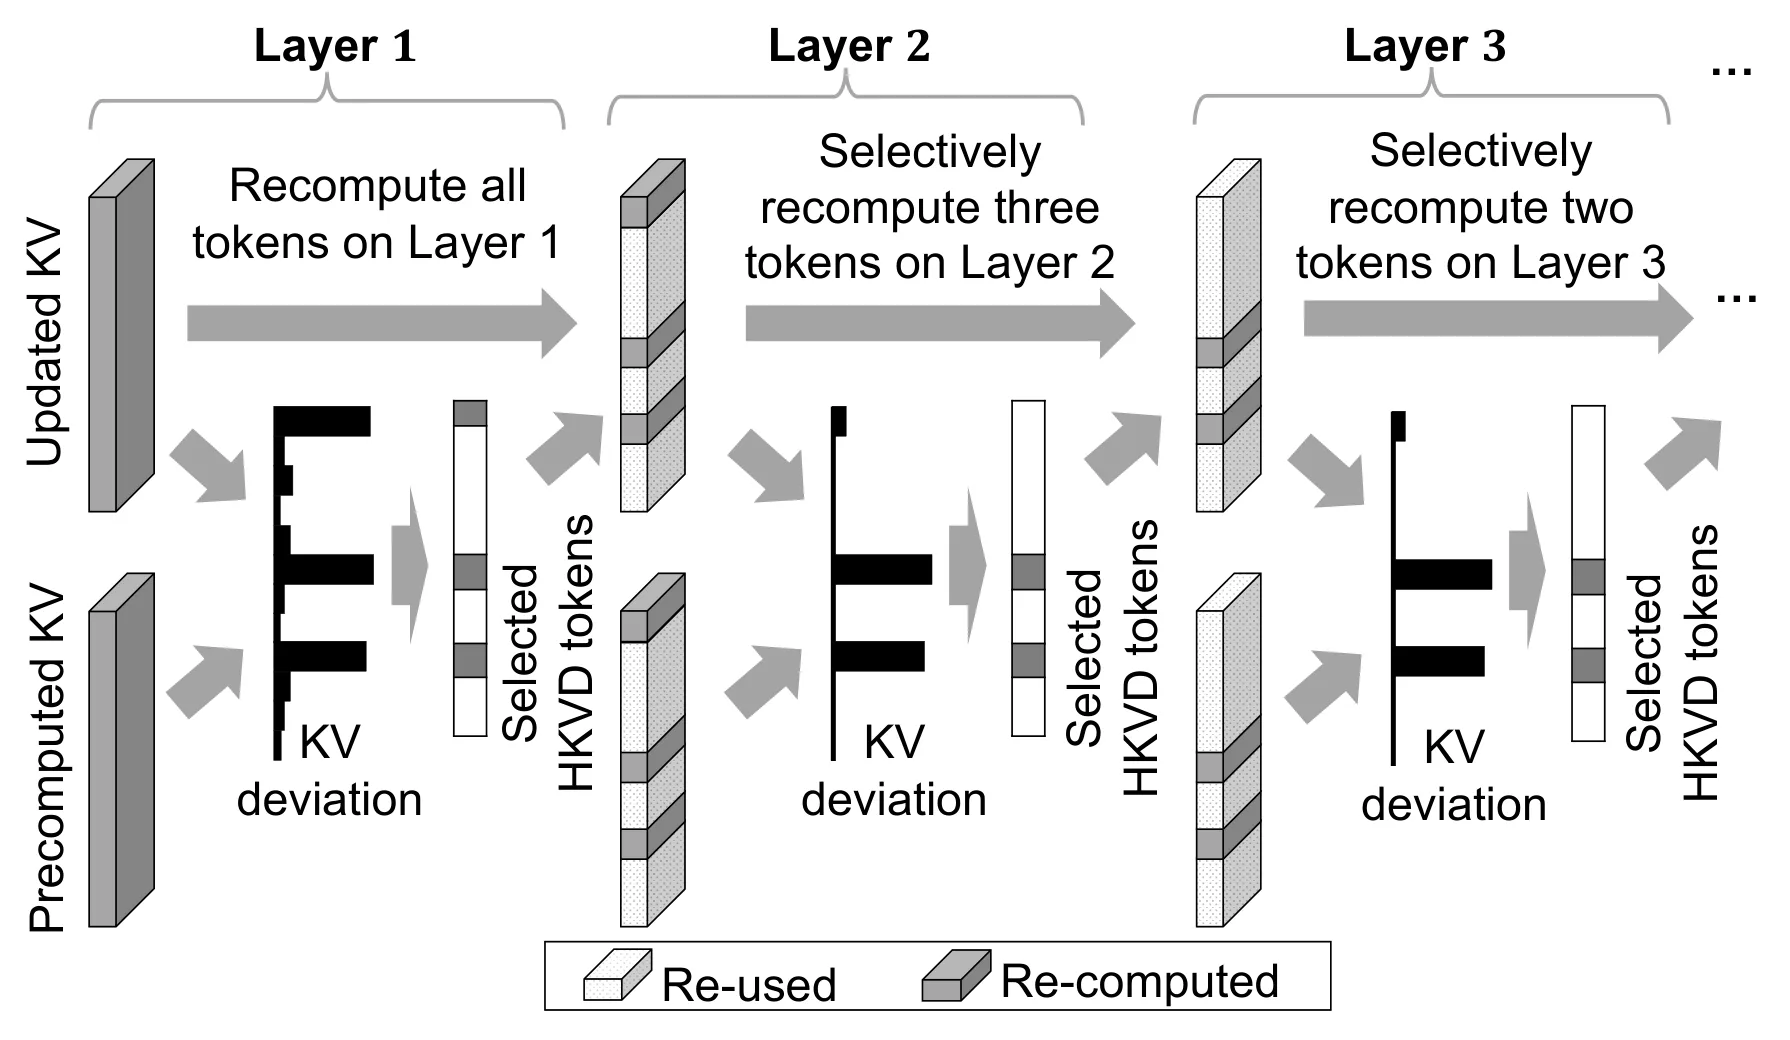
上图是逐层选择的示意。左侧一层里,所有 token 都有偏差分数,深色的是高偏差 token;进入下一层时,只保留这些高偏差 token 继续计算,并在其中重新排序、再筛掉一部分。这个过程把「单层偶然偏高」的 token 淘汰掉,留下的是跨层持续需要更新的位置。图源:CacheBlend 论文 Figure 9。
为什么是 15% 左右?论文在 Yi-34B 上扫了不同的重算比例:5% 到 18% 的区间内,生成质量相对全量 Prefill 的损失最多 0.002(F1 或 ROUGE-L),对应 TTFT 降低 4.1 到 6.6 倍;相比前缀缓存,TTFT 降低 3.4 到 6.1 倍。比例再往下压,质量开始出现肉眼可见的下降;往上加,收益递减,因为高偏差 token 已经被覆盖,多算的主要是低贡献 token。
这个 15% 不是拍脑袋的固定常数,而是「质量下限」:系统设计里把它记为 ,作为重算比例的下界。最终选多少,还要和 KV 加载时间做匹配,下一节会讲。
从计算账上看,若每层重算 的 token,且忽略第一层的固定开销,总计算量约为全量 Prefill 的 。以 15% 计算,Prefill 的主体计算被压到原来的六分之一左右;再加上第一层的一次性全量计算,30 层模型的实际比例会略高于 15%,但仍远低于全量重算。论文报告的整体 TTFT 降幅是 2.2 到 3.3 倍,而不是理论上的 6 倍,原因就在于第一层固定成本、KV 加载、注意力核的固定开销以及调度开销都会摊薄收益。
需要说明的是,HKVD 选择是一个经验启发式,不是带误差上界的精确算法。它假设「KV 偏差大的 token 对前向注意力影响大」,并用跨层相关性来弥补单层估计的噪声。论文用注意力稀疏性和秩相关实验支撑这个假设,但没有给出「选出的集合一定覆盖所有关键 token」的证明。对质量极度敏感、要求与全量 Prefill 逐 token 一致的场景,前缀缓存仍然是唯一严格无损的选项;CacheBlend 的目标是「质量统计上等价」,而不是「逐位相同」。
位置恢复、KV 存储与加载流水线
拼接 KV 的第一个工程问题是位置。各片段独立 Prefill 时都从位置 0 开始,拼到上下文里之后,第二段的第一个 token 可能实际位于第 4096 位。如果不修正,RoPE 的相对距离全错,注意力直接失效。CacheBlend 用一个很轻的操作解决这件事:只旋转缓存的 K。
RoPE 的定义是,对位置 的 query 和位置 的 key:
其中 是由 、 组成的块对角旋转矩阵。注意力分数为:
它只依赖相对位置 。假设某段文本在独立 Prefill 时,第 个 token 被放在位置 ,缓存里存的是 。拼接后它应该位于全局位置 ,只要再左乘一个旋转矩阵:
得到的就是它位于位置 时应有的 key,而 value 不含位置信息,不需要动。每个 token 只需一次旋转,成本可以忽略。论文附录把 维、 个旋转对的推导补全了;结论对任意维数成立。
这个技巧有清晰的适用边界。它依赖「位置信息以旋转形式乘在 K 上」这一结构。绝对位置嵌入是加到隐藏状态上的,缓存里没有可分离的位置分量,无法靠旋转恢复;ALiBi 用的是 query-key 距离偏置,拼接后距离天然正确,也不需要恢复。对只在一部分维度上做 RoPE 的模型(例如 MLA 的解耦 RoPE),只能旋转那部分维度,压缩潜变量里的内容分量不能动。CacheBlend 的实验基于标准 Transformer 的 MHA,这套位置恢复在 GQA/MLA 上的适配需要按模型结构单独处理,不能直接照搬。
第二个工程问题是 KV 放在哪里。CacheBlend 允许把预计算的 KV 放在 CPU 内存或 NVMe SSD 上,用文本哈希做索引;论文给出哈希表本身约占 16 MB/百万片段,相对于 KV 数据很小,可以常驻 CPU。请求到来时,系统按片段文本查出对应层的 KV,再搬到 GPU。搬运和重算被组织成流水线:第 层的选择性重算开始后,另一个线程同时去取第 层的 KV;每层开始前用一次同步确保该层数据已经到位。这样只要搬运不慢于重算,重算的额外延迟就被藏在搬运背后。
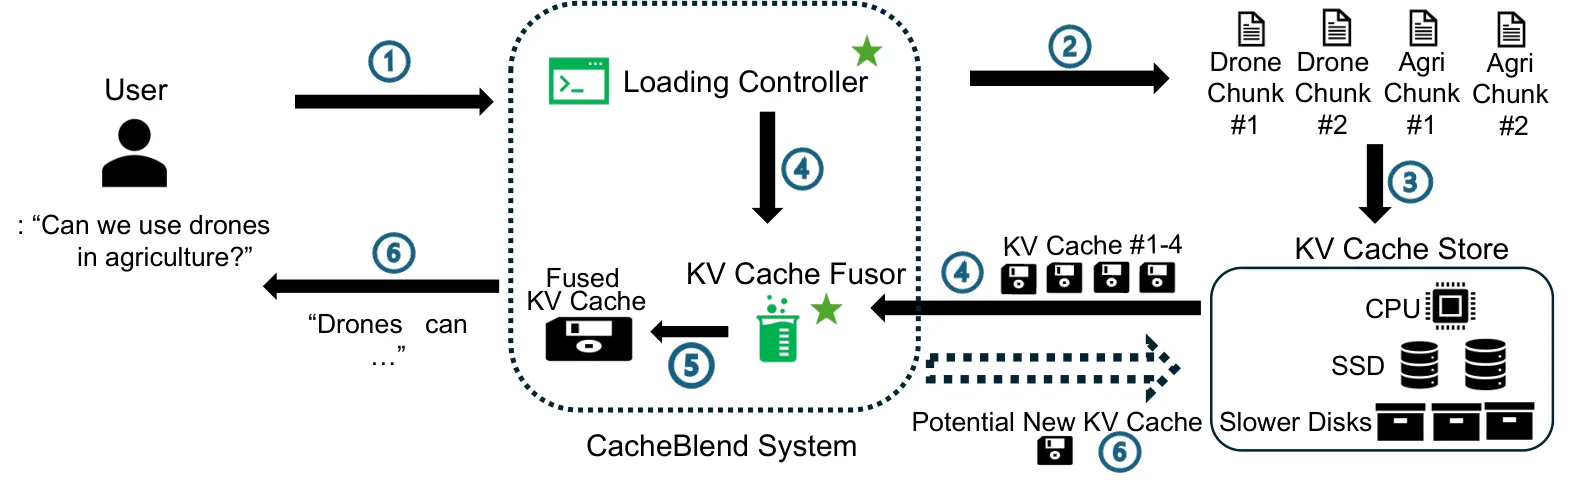
上图是系统全貌。用户问题先经过检索器拿到若干文本片段;加载控制器向 KV 管理器查询这些片段的 KV 是否存在、存在哪一层存储上;控制器算出这条请求的重算比例,把 KV 加载到 GPU 队列;融合器逐层重算 HKVD token、把更新后的 KV 拼成完整缓存;最后整份 KV 交给推理引擎,直接从解码开始。图源:CacheBlend 论文 Figure 11。
加载控制器要回答两个问题:重算多少,以及 KV 放哪种存储介质。
重算延迟的估算很直接:若全量 Prefill 的耗时为 ,重算比例为 ,则
全量 Prefill 耗时可以离线测好。加载延迟则按每 token KV 大小和存储带宽估算:
控制器先找一个让 接近 的比例,再取它与质量下限 的较大值。含义是:如果存储很慢,加载本身就要很久,那么多重算一些 token 是「免费」的,可以顺便把质量做高;如果存储很快,重算反而会成为额外延迟,此时就压到 15% 的质量底线,不再往上加。
论文给了两个具体例子。Llama-7B、4K 上下文、15% 重算,每层约 3 ms;从 NVMe 加载一层 KV 约 16 ms,重算完全被加载遮住。Llama-70B 同样 15%,每层重算约 7 ms,而加载一层只要 4 ms,重算就露出一部分。存储介质的选择也遵循同一笔账:在「加载时间不超过 15% 重算时间」的设备里,挑每 GB 成本最低的那个。SSD 比内存便宜,只要带宽够,就优先放 SSD;带宽不够时再退回内存。
实现层面,论文在 vLLM 上改了约 3000 行 Python(PyTorch 2.0),抽出三个接口:fetch_kv(text, layer_id) 按文本哈希取一层 KV,prefill_layer(input_dict, KVCache) 做一层选择性重算,synchronize() 在层间等待加载完成。input_dict 里带一个 check_flag 和一组 HKVD_indices:前者决定这一层是否重新比较偏差、选新集合,后者记录当前要重算的 token 下标。KV 若在运行时被完整重算出来,会被搬到 CPU 并用后台线程写回磁盘,避免下次再算。后续这套逻辑进入 LMCache,成为其 cacheblend 模式的一部分。
实测:质量、延迟与吞吐
论文的评测覆盖四个任务:2WikiMQA 与 MuSiQue 是多跳问答,考的是跨文档推理;SAMSum 是对话摘要;MultiNews 是多文档新闻摘要。前两个用 F1 衡量答案重叠度,后两个用 ROUGE-L 衡量摘要相似度。每段上下文切成 512 token 的块;问答数据集每条请求取最相关的 6 段,按 L2 距离检索;SAMSum 使用原文自带的 200 到 400 token 块。为了让「复用」真正发生,论文另建了一套扩展数据集:从 1500 个问题出发,用 GPT-4 生成相似问题,凑成 6000 条查询,同一片段会被不同请求反复检索到。
基线有五类:全量 KV 重算、前缀缓存(采用 SGLang 的实现,并且从内存/SSD 加载 KV 时假设零延迟,对前缀缓存有利)、全量 KV 复用(PromptCache 式做法)、MapReduce、MapRerank。模型上选 Mistral-7B、Yi-34B、Llama-70B,覆盖 7B 到 70B 三档;后两者用 8-bit 量化。硬件是 2 张 A40、128 GB 内存、1 TB NVMe(实测 4.8 GB/s);70B 模型用两张卡。
结果按三个维度看。
质量:在 6 段上下文、512 token 每段的设置下,CacheBlend 相对全量 Prefill 的 F1/ROUGE-L 下降不超过 0.02。这个差值在统计噪声范围内,说明跨片段注意力的「主干」已经被少数 HKVD token 补回来了。全量复用在片段数增加时质量差距迅速拉大——论文的多跳 QA 实验里,从 1 段扩展到多段,全量复用与全量 Prefill 的 F1 差距也随之扩大,因为片段越多,相互引用的依赖越密。CacheBlend 在多数场景下把这一差距收窄到可以忽略。
延迟:TTFT 相对全量重算降低 2.2 到 3.3 倍,覆盖三个模型和四个数据集。相较前缀缓存也有明显优势,原因有二:前缀缓存对同一片段的不同前缀位置需要存多份 KV,存储预算固定时命中率更低;而 CacheBlend 只存一份,命中与位置无关。相对全量复用,CacheBlend 的 TTFT 更高(多做了重算),但质量优势远大于延迟差。
吞吐:在扩展数据集、不同请求速率下,CacheBlend 的同时吞吐比全量重算和前缀缓存高 2.8 到 5 倍。吞吐的提升来自两方面:Prefill 被压缩,使 GPU 更早进入解码;KV 可以放在更便宜的大容量介质上,缓存命中范围扩大,减少需要完整重算的请求。
敏感性分析给出几组有用的数字。重算比例在 Yi-34B 上扫 5% 到 18%,所有数据集的质量损失不超过 0.002,对应 TTFT 降低 4.1 到 6.6 倍——这个区间比默认 15% 更宽,说明质量对比例不敏感,控制器有很大的调度空间。片段数量和片段长度变化时,维持同等质量的必要计算量占比基本不变。批大小增大时,解码时间增长慢于 Prefill,Prefill 在总延迟中的占比上升,CacheBlend 的收益会随并发升高而更明显。存储从 NVMe 换成内存或更慢的 SSD,CacheBlend 仍能稳定降低 TTFT,只是与全量复用的延迟差距会因加载时间变长而缩小。
MapReduce 和 MapRerank 的对比说明了另一件事:把每段分开处理、再合并结果,MapReduce 的延迟是 CacheBlend 的 2 到 5 倍,因为多了第二轮 LLM 调用;MapRerank 延迟略低,但质量差很多,因为每段独立处理、再做选择,丢掉了段落之间的依赖。CacheBlend 的定位正好卡在「不额外调用、也不丢依赖」这一点上。
局限与边界
论文自己列出的边界有几条值得展开。
架构限制。方法建立在标准 Transformer 的 KV 缓存上,对 Mamba、Griffin 这类带递归状态的模型没有直接对应——它们的「缓存」是固定大小的状态,不是逐 token 的 KV,选择哪一部分 token 重算这件事本身就变了。对 MLA、GQA 这类压缩或分组的注意力,位置恢复和 KV 比较需要按结构改写:MLA 的 KV 是一段低维潜变量,HKVD 比较要在潜空间里做,选择粒度和偏差度量都可能与标准 MHA 不同。
严格无损性。CacheBlend 追求的是统计意义上的质量等价,不是逐位一致。对必须与全量 Prefill 结果完全一致的场景(例如要求 batch-invariant 的确定性推理),它不满足条件。HKVD 选择是启发式,极端输入下仍可能出现「漏选」某个关键 token 导致答案偏移的情况,只是论文的统计层面没有观察到明显退化。
评测条件。Llama-70B 和 Yi-34B 使用 8-bit 量化,量化误差可能影响 HKVD 偏差分布;论文没有系统比较不同量化位数下的质量曲线。推理引擎只集成了 vLLM,没有测试 DistServe 这类 P/D 分离引擎;而在 P/D 分离下,Prefill 端正是 CacheBlend 的主战场,与分离架构结合可能有额外收益,也可能带来 KV 传输与重算流水线的新的耦合问题。跨节点共享 KV 也未研究,多机场景下加载路径与重算流水需要重新设计。
后续工作在几条线上继续推进。CacheRepair(arXiv:2609.35139)不再在线重算,而是训练一个小网络学习「独立 Prefill 的 KV」到「联合 Prefill 的 KV」之间的差值,用轻量修复网络在线修正,把重算开销从 GPU 计算挪到一次前向;SAFE-KV(arXiv:2610.15186)把问题重新定义为「行为保持」,从某个起始文档开始重编码因果后缀,在组合缓存上做更激进的修复;CacheClip(arXiv:2510.10129)用小辅助模型来定位还原跨片段注意力所需的关键 token,思路与 HKVD 的「用便宜的方式找关键位置」一脉相承。这些工作共同表明:非前缀 KV 复用的核心矛盾不是「怎么拼」,而是「怎么用最少的信息补回跨片段注意力」,CacheBlend 给出的是第一条可落地的工程路径。
读源码时的几个观察点
如果要在 vLLM 或 LMCache 里读 CacheBlend 的实现,有几个位置值得重点看。
prefill_layer 的入口参数。check_flag 决定这一层是否做偏差比较。注意它是按层传的、不是全局开关:只有需要重新选集合的层才会打开,其余层沿用上一层的下标;HKVD_indices 是跨层传递的唯一状态,它比整个隐藏状态小得多,是「层间只传集合」这一设计的直接体现。
偏差比较的精度。HKVD 的偏差计算在什么 dtype 下进行、是否只用部分维度近似距离、是否对 K 和 V 分别加权,这些细节决定了选择的稳定性。对 FP8 或 BF16 缓存,偏差的量化噪声可能让排序抖动,实现中往往会做平滑或只看少量层。
与 KV 存储的接口。fetch_kv 的哈希键是文本本身还是 token 序列,跨 tokenizer 是否可比,决定缓存能否在模型间共享。LMCache 统一用 token 序列做键,这对同一 tokenizer 的多模型部署更友好,但不同模型之间仍需确认 tokenizer 一致。
同步点。每层开始前的 synchronize 是流水线的节拍线;如果加载线程与计算线程共用同一个 CUDA 流,同步会变成隐式串行,流水线失效。读实现时要看 KV 加载是否走独立流、是否有 pinned memory 中转。
参数化。重算比例、第一层的初始选择比例 、每层收缩步长,这些在实现中通常集中在一个配置对象里;它们与加载控制器算出的 是联动的,改其中任何一个都要重新校准质量与延迟的平衡点。
把账算细:一份 KV 有多大,15% 重算值多少钱
前面的讨论都停在比例上,真正做容量规划时要把比例换成字节和毫秒。KV 缓存的大小可以用一个很直接的公式估算:
系数 2 对应 K 和 V 两份; 是层数, 是 KV 头数, 是每头维度。以 Llama-7B 为例:32 层、32 个 KV 头(MHA)、每头 128 维、FP16 每元素 2 字节,每 token 约 512 KiB;4K 上下文就是 2 GiB。Llama-70B 用 GQA,只有 8 个 KV 头,80 层、每头 128 维;若按 8-bit 存储,每 token 约 160 KiB,4K 上下文约 640 MiB。GQA 把 KV 头数从 64 压到 8,单这一项就把缓存缩小了 8 倍,这也是长上下文服务普遍采用 GQA 的原因之一。
这也解释了为什么 CacheBlend 要把 KV 放到 CPU 或 SSD:一份 4K 上下文的 7B 模型缓存就是 2 GiB,多存几个片段很快吃满显存;而 RAG 请求的片段集合又在不断变化,全部常驻 HBM 不现实。放到 NVMe 上,按论文实测的 4.8 GB/s 顺序带宽,2 GiB 大约 0.42 秒;但按层加载时是小块随机读,有效带宽远低于峰值,论文测到的单层加载时间是 16 ms,而不是理论上的 3 ms 左右。工程上必须以实测带宽做预算,不能拿 SSD 的标称顺序带宽直接除。
重算的账则按 token-layer 计。4K 上下文、32 层、15% 比例,重算的 token-layer 数是 ,全量是 131072,比例约 15%;再加上第一层为建立参照而做的一次全量计算(4096 个 token-layer),总比例约 18%。70B 模型 80 层,第一层的固定开销占比更小,总比例更接近 15%。这与论文报告的整体 2.2 到 3.3 倍 TTFT 降幅是自洽的:理论计算量降到 1/6 左右,但加载、注意力核启动、调度和第一层固定成本会吃掉一部分收益。
把两边放在一起,就能理解 15% 这条线的含义。它首先是质量底线:低于它,HKVD 覆盖不足,跨片段注意力补不回来;它同时是调度锚点:当存储慢、加载时间长时,可以把比例往上抬,把等待时间用来做「免费」的重算;当存储快、加载时间短时,就压回 15%,避免重算成为新的关键路径。所谓「自适应」,本质上是在质量、加载带宽和计算预算三者之间找一个当前请求的平衡点,而不是固定一个全局比例。
和前缀缓存、PagedAttention 的分工
CacheBlend 不是前缀缓存的替代品,两者解决的是不同形状的复用。前缀缓存处理「逐字节相同的开头」,命中时严格无损,应该作为第一道防线;CacheBlend 处理「相同片段但不在开头、邻居不同」的情况,是有损但质量受控的第二道防线。一个成熟的 RAG 服务通常是:模板与系统提示走前缀缓存;检索到的文档片段先查前缀树,能命中的部分照常命中;剩下的非前缀片段走 CacheBlend 的哈希缓存与选择性重算。两条路径共用同一套 KV 存储和加载通道,调度器需要知道哪些块是精确命中、哪些块需要融合,才能正确计算这次的 Prefill 预算。
和 PagedAttention 的关系则更偏底层。分页 KV 把逻辑块映射到物理块,块表让同一段 KV 可以被多个请求共享;CacheBlend 要在这种分页结构上做三件事:按片段找到对应的物理块、把块表拼成一条完整请求的映射、在重算后把选中 token 的新 K/V 写回正确的物理位置。写回会带来两个细节:若目标块被多个请求共享,必须先做写时复制,不能原地改;若选中 token 跨页,写回要按页边界拆成多次,和分页注意力核的寻址方式对齐。前缀缓存的命中路径只读不写,所以这些问题不明显;CacheBlend 的「融合」是读写混合,块管理的复杂度更高。
淘汰策略也需要重新算账。前缀缓存按前缀树的节点热度淘汰,一个节点被共享得越多越值得留;CacheBlend 的缓存单位是片段,价值取决于「这个片段被检索到的频率 × 省下的 Prefill 时间 − 存储与加载成本」。同一片段在不同请求里可能出现在不同位置,但 KV 本身与位置无关(位置在拼接时恢复),所以只需存一份,这一点比前缀缓存按不同前缀存多份更省。可以参考 前缀缓存淘汰完全拆解:为什么 14 种复杂算法赢不了 LRU 里对生产轨迹的讨论:在真实负载下,简单的 LRU 往往已经足够,CacheBlend 的片段缓存同样不应过早引入复杂替换算法,先把「哪些片段值得预计算」这件事算清楚更重要。
还有一个容易在文档里被忽略的边界:租户隔离。KV 缓存里保存的是文档内容经过模型后的表示,跨租户共享同一份片段缓存,等于让不同租户的请求共用同一段上下文状态。前缀缓存也有同样的问题,但 CacheBlend 把「片段级共享」做得更彻底,缓存键与租户维度的绑定必须显式设计,不能默认全局共享。
工程落地清单:chunk 粒度、缓存键与灰度
第一项是 chunk 粒度。片段切得小,复用命中率高,但片段数量、哈希表条目、跨片段边界都变多,HKVD 需要补的跨片段注意力也更分散;片段切得大,单段 KV 更大、预计算成本更高,但一段内部的语义更完整,跨片段依赖相对少。论文的问答实验用 512 token 块,摘要任务用原文自带的 200 到 400 token 块,这个范围可以作为起点。真正上线时要按业务文档结构调整:法规条文、产品手册这类结构清晰的文档,按章节切比固定长度更合理;对话记录则适合按轮次切。
第二项是缓存键。键至少要包含 token 序列、模型版本、tokenizer 版本、RoPE 配置和量化配置。少任何一项都可能出现「命中了一段形状相同但语义不同的 KV」:换了 tokenizer,同一段文字切出的 token 不同;换了 RoPE base 或缩放策略,缓存的 K 旋转方式不同;换了量化位宽,K/V 的数值精度不同。把这些配置拼进键里,宁可多失效,也不要错命中。键里不建议放请求 ID 或时间戳,否则缓存永远不命中;也不建议只放文本哈希而不放 token 序列,文本相同但预处理不同(比如空白、大小写归一化)时会埋下隐患。
第三项是预计算的经济性。预计算一段片段要跑一次完整 Prefill,成本并不低;只有当这段片段在后续请求中被重复命中足够多次,这笔投入才回本。可以粗略估算:单段预计算成本约为该段全量 Prefill 的时间,单次命中节省的时间约为该段 Prefill 时间减去加载与融合时间;命中次数超过「预计算成本 / 单次节省」时开始盈利。真实系统还要算存储占用和淘汰带来的失效,因此「所有检索到的片段都预计算」通常不划算,优先缓存高频、长片段、跨多个业务的公共知识。
第四项是质量监控与灰度。CacheBlend 的输出不是逐位可复现的,必须有线上质量观测:抽样请求走全量 Prefill 作为影子基线,比较答案的 F1/ROUGE 或模型评审分数;同时记录每层的 HKVD 比例、平均 KV 偏差、加载耗时与重算耗时,出现比例异常或偏差漂移时自动降级到全量 Prefill。灰度时按租户或业务线逐步放开,先放开对质量不敏感、上下文以文档片段为主的场景,再扩到多跳问答这类对跨片段依赖更强的任务。回退路径要显式存在:缓存未命中、加载超时、重算比例被压到质量下限以下,都应能无条件下沉到全量 Prefill,而不是让请求失败。
小结
CacheBlend 的出发点是一个非常具体的缺陷:非前缀片段的 KV 缓存不是文本本身,而是「在前序上下文条件下算出的因果状态」;把它挪到别的位置,位置能靠旋转矩阵补,跨片段注意力不能。它给出的补法是选择性的:在每一层挑出偏差最大的少数 token 重算,用这个少数 token 的新隐藏状态向下传导,带动后面所有层逐步靠拢全量 Prefill。逐层收缩的集合、跨层的偏差相关性、与 KV 加载流水线对齐的 15% 底线,是这套方法能够工程落地的三个支点。
它没有解决「无损」问题,也不适用于所有架构,但它把非前缀 KV 复用从一个「速度很快但答错」的方案,变成了一个「速度接近复用、质量接近重算」的方案。对 RAG 这类上下文由多个独立片段拼成、且片段会被反复检索的工作负载,这是一条值得记住的技术路线。
参考资料
- CacheBlend: Fast Large Language Model Serving for RAG with Cached Knowledge Fusion(EuroSys ‘25,DOI 10.1145/3689031.3696098)
- Prompt Cache: Modular Attention Reuse for Low-Latency Inference
- LMCache 项目仓库
- SGLang: Efficient Execution of Structured Language Model Programs
- RadixAttention 完全拆解:用前缀树自动复用 KV Cache,让共享前缀只计算一次
- 前缀缓存命中之后:五个推理框架如何把一段旧 KV 接进一次新前向
- KV Cache Offloading 完全拆解:把显存装不下的历史塞进 CPU、SSD 与远端内存
- RoPE 完全拆解:旋转位置编码的原理、实现与长度外推
- CacheRepair: Learning to Repair Cross-Chunk Context in RAG for KV Cache Fusion
- SAFE-KV: Causal Suffix Repair for Behavior-Preserving Non-Prefix KV Cache Reuse in RAG
- CacheClip: Accelerating RAG with Effective KV Cache Reuse
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



