


BitBLAS 完全拆解:低比特权重如何在 Tensor Core 上边解码边计算
问题:模型压成 4 bit,为什么推理不一定更快
权重量化首先改变的是模型文件和显存占用,却不会自动改变 GPU 的执行效率。以最常见的权重 4 bit、激活 16 bit 推理为例,线性层在逻辑上要计算 FP16 激活与 INT4 权重的乘法;但许多 GPU Tensor Core 并没有直接接受“FP16 × INT4”的矩阵乘指令。最朴素的实现只能分成三步:从显存读取压缩权重、把 INT4 解包并反量化成 FP16、再调用 FP16 GEMM。若中间结果真的写回显存,省下来的权重流量会被读写 FP16 临时张量抵消;即使把反量化写成单独 Kernel,也会多一次 Kernel Launch,并失去生产者与 GEMM 之间的局部性。
真正有用的实现应当让低比特权重一直保持压缩状态,直到它即将进入矩阵乘的寄存器片段时才解码,并让解码、缩放、布局变换和 MMA 计算处在同一条流水线中。问题因此从“怎样写一个反量化函数”升级为四个互相约束的问题:
- 一个 32 bit 存储字中的 8 个 INT4 应由哪些线程读取和解包;
- 解包后的元素如何排列,才能直接匹配
ldmatrix与mma要求的 fragment 布局; - scale、zero point 与非线性码表应在哪一级存储中读取,何时施加;
- 对单 token 解码的 GEMV、小批量 GEMM 和长序列 Prefill,是否还应该采用同一套 tile 与线程组织。
BitBLAS 正是为这类混合精度 BLAS 而设计的运行库。它的编译基础来自 Microsoft Research 等团队在 OSDI 2024 发表的 Ladder:Ladder 用硬件感知张量变换统一描述自定义低比特类型、内存布局与计算指令,BitBLAS 则把其中的低精度算子能力包装成可供 PyTorch、GPTQModel 和推理框架调用的库。这里讨论的是推理 Kernel 与部署路径,不涉及量化模型如何训练。
需要先区分“量化算法”和“量化 Kernel”。AWQ决定哪些通道更敏感以及怎样缩放,GPTQ决定怎样逐列补偿量化误差;BitBLAS 接收这些算法产出的整数权重、scale 和 zero point,解决怎样把它们高效乘起来。两层能力缺一不可,但评价指标不同:前者看误差和模型质量,后者看延迟、吞吐、显存流量与硬件利用率。
从数学表达式到真实存储:混合精度 GEMM 的计算对象
设激活矩阵为 ,权重矩阵按输出通道存为 ,线性层输出为:
这里 是一次参与计算的 token 数, 是输出维度, 是输入维度。推理库常把布局记为 nt: 按非转置布局访问,而权重逻辑上取转置,因此最终得到 输出。单请求逐 token 解码时 往往等于 1;连续批处理会把不同请求的 token 合并,使 增大;Prefill 则可能让 达到数百或数千。仅仅改变 ,Kernel 就会从典型的访存受限 GEMV 逐渐变成计算受限 GEMM。
对分组非对称量化,权重并不是一个可以直接相乘的 INT4 数组。若第 组的比例因子和零点分别为 、,量化整数为 ,且 ,则运行时恢复值为:
是 group size。 越小,每组更贴合局部分布,通常量化误差更低,但 scale 和 zero point 的元数据更多,Kernel 也更频繁地读取并切换参数。对称量化可令 ;只有 scale 的路径因此更短。若是 NF4 一类非均匀格式, 不是等间距整数,而是码表索引:
这时位提取之后还多一次查表。所谓 W4A16 并不充分描述 Kernel:同为 4 bit 权重,INT4、UINT4、NF4、是否带零点、group size 多大,都对应不同的解码数据流。
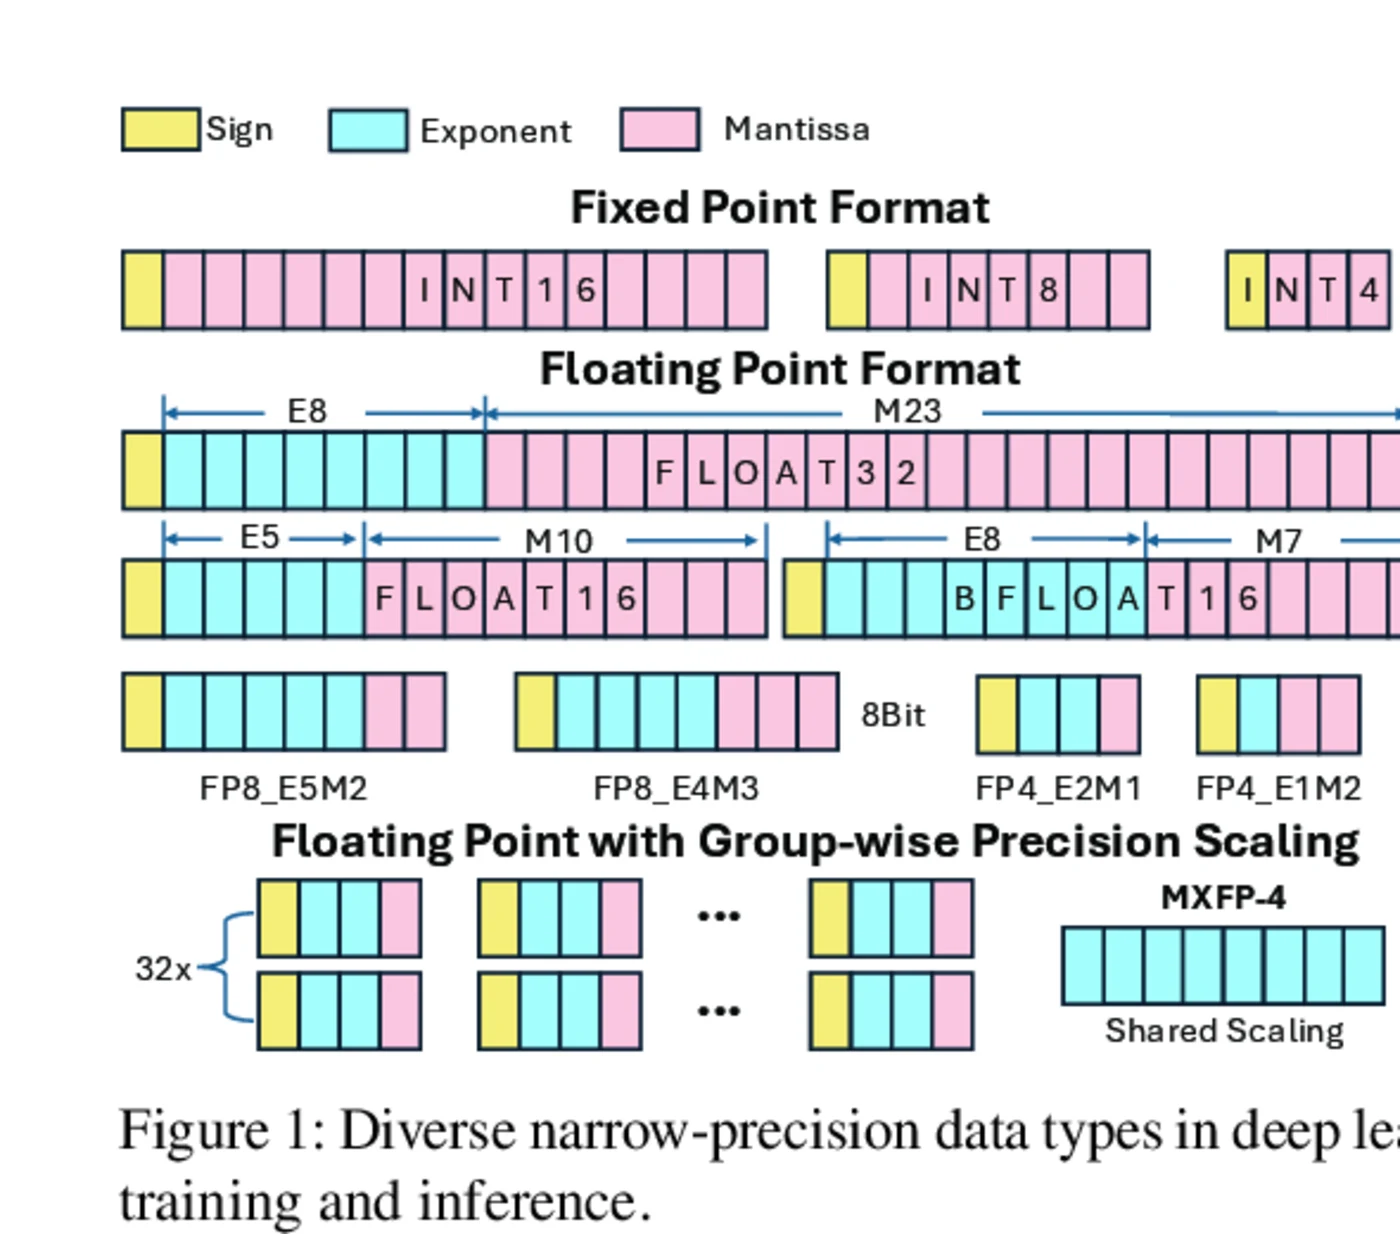
图 1 来源于 Ladder 论文。上半部分把 INT4、FP8、FP4 的位宽和符号、指数、尾数结构并列;下半部分说明块格式还会携带共享 scale。关键不是“数字越短越快”,而是存储类型、元数据粒度与 Tensor Core 原生计算类型未必一致。BitBLAS 要在二者之间插入一个足够便宜的转换层。
如果量化权重使用 bit,而承载它的存储字宽为 bit,则一个存储元素容纳的逻辑权重数为:
INT4 装进 UINT32 时 ;INT2 时 。于是权重的物理形状不再是 ,而近似为 ,外加 scale、zero point 或 LUT。逻辑矩阵乘的索引空间与物理存储的索引空间由此分离,这正是普通“按元素 dtype”抽象难以表达的地方。
BitBLAS 的系统结构:把算法、布局和硬件调度放进同一个搜索空间
Ladder/BitBLAS 的核心不是某一条神奇的 PTX 指令,而是把“低比特类型如何存、何时转、转成什么布局”提升为编译器可以搜索的对象。Ladder 用三个层次描述它:
tType描述一组同质元素的位宽、组形状、共享元数据,以及可无损转换到哪些计算类型。例如 NF4 可表示为每元素 4 bit、带码表元数据,并提供 NF4 到 FP16 的转换函数;MXFP8 则可表示 32 个 8 bit 元素共享一个 scale。tTile在tType之上加入小块的形状与布局。它对应的不是完整张量,而是一次内存事务、一次ldmatrix或一次 MMA 所处理的细粒度 tile。tTile-device把 GPU 抽象成由全局内存、共享内存、寄存器和计算核心组成的层次,每一层都声明偏好的数据粒度与 tile 形状。
有了这三个对象,编译过程可以把一个算子展开为 Transform-Load → Compute → Transform-Store。其中变换只有四类基本原语:slice 取出子块,pad 补齐不规则边界,map 重排元素地址,convert 改变数据类型。简单原语组合起来,既能表达 INT4 解包,也能表达 NF4 查表、共享内存 swizzle 和 MMA fragment 的线程内排列。
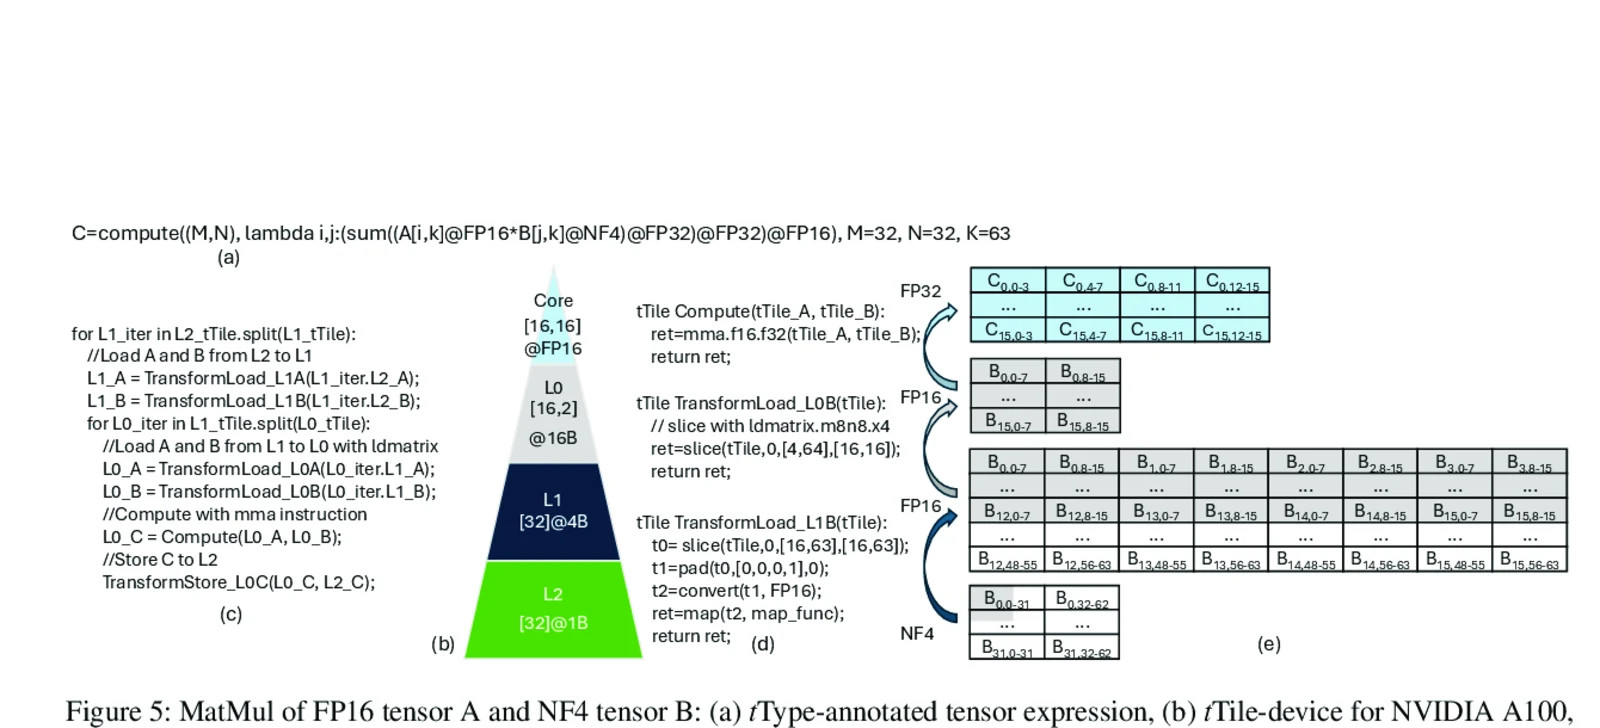
图 2 同样来自 Ladder 论文,展示 与 相乘的完整路径。最下方的 NF4 权重在 L2/全局内存中保持压缩;进入 L1/共享内存的过程中,slice 取出 子块,pad 把 补成 64,convert 转为 FP16,map 再把元素排成上层加载所需的布局。随后 ldmatrix 把 片段送入寄存器,MMA 用 FP16 输入、FP32 累加,最后输出再转为 FP16。
这个例子揭示了两个容易忽略的设计点。
第一,转换放在哪一层并没有固定答案。早在全局内存侧转换,后续计算轻,但 FP16 中间数据会扩大 4 倍;推迟到寄存器才转换,流量最低,却会增加寄存器压力和整数指令,严重时造成 spill。第二,布局变化最好前移到离线权重预处理:模型权重在请求之间不变,可以在加载模型时执行一次 permutation,把运行时的地址重排换成连续读取;激活随请求变化,通常只能在 Kernel 内变换。
BitBLAS 的 transform_weight 因而不是普通类型转换。它会把权重打包成特定 Kernel 期望的物理布局。变换后的数组通常不能再被当作常规 INT4 矩阵解释,但能让线程按合并访存读取,并减少运行时 shuffle。算子配置、预处理布局与生成的 Kernel 必须配套,不能只替换其中一项。
位级打包:4 bit 权重怎样进入 32 bit 存储字
以无符号 INT4 为例,8 个逻辑权重 可装进一个 32 bit 字 :
其中 & 15 保留低 4 位,<< 4i 把第 个值移到对应 nibble。读取第 个值时执行:
若格式是有符号 INT4,还需把 解释成 。一种做法是先取无符号值,再进行符号扩展;另一种做法是在量化定义里使用偏置零点,把它并入 。两者数学等价,但生成的指令数、向量化机会与 zero point 存储方式不同。
简单循环逐个 shift-and-mask 能得到正确答案,却通常不是最快答案。一个 warp 若每个线程都串行解 8 个值,整数流水线会出现长依赖链;解出的 FP16 还可能处于与 MMA fragment 不一致的次序,需要额外 prmt、shuffle 或共享内存中转。高效解码需要同时决定三件事:每个线程拿哪个 32 bit 字、每条位运算一次产出几个半精度值、产出位置是否正好对应当前线程的 MMA 操作数槽位。
3 bit 更能说明抽象的重要性。32 不能被 3 整除,Ladder 的处理方式是仍以 GPU 友好的 4 byte 粒度存储,例如一个 32 bit 字容纳 10 个 3 bit 值并留下 2 bit 空隙。若一味追求理论上的无空洞位流,跨字边界的元素会让每次读取需要拼接两个存储字,增加分支和位运算。牺牲少量容量换取对齐,可能得到更低的实际延迟。
打包轴也很关键。权重物理布局至少要满足:相邻线程的 32 bit/128 bit 读取能够合并;同一组 scale 覆盖的量化值在访问上尽量连续;解码后 维元素能顺序参与点积;每个 warp 所需数据最好不跨越过多 cache line。所谓 layout permutation,就是在这些目标之间找到一个与具体 MMA 形状相容的排列。
解码路径:为什么要在寄存器里完成反量化
权重只读一次却参与许多乘加时,最理想的路径是“压缩读取、寄存器解码、立即消费”。以 INT4 到 FP16 为例,概念上的内层循环是:
uint32_t packed = load_global_or_shared(weight_ptr);#pragma unrollfor (int i = 0; i < 8; ++i) { int q = (packed >> (4 * i)) & 0xF; half w = __float2half(scale * (q - zero)); mma_consume(w);}生产实现不会真的保留这个标量循环,而会用向量寄存器与 PTX 位运算批量构造半精度值。Ladder 论文特别指出,对 4 bit 以下整数到浮点的转换可利用 LOP3。LOP3 能用一个 8 位真值表表达三个输入的任意逐位布尔函数,因此可合并多步 mask、xor、or 操作。常见技巧不是把整数逐个执行通用 int-to-float 转换,而是把低位嵌入一个具有固定指数的 FP16 位模式,再通过浮点减法消掉预置偏置。这样一次位级拼装可以并行形成多个 half,减少串行指令。
不过“越晚解码越好”只在没有副作用时成立。寄存器解码有三类成本:
- 整数指令与浮点 FMA 会和地址计算、MMA 发射争用调度槽;
- 同时保留 packed word、scale、zero、解码结果和累加器会提高每线程寄存器数,降低 occupancy;
- group size 较小时,scale/zero 读取更频繁,元数据访问可能取代权重成为新瓶颈。
因此融合的目标不是消灭所有中间步骤,而是把中间状态限制在最便宜、生命周期最短的存储层。某些 tile 会选择“全局内存保持 INT4,在 shared memory 中转成适配布局的紧凑形式,寄存器内变成 FP16”;另一些 tile 可能在 shared memory 就完成类型扩展,以换取更少的寄存器指令。BitBLAS 的价值正在于让这些位置成为调度参数,而不是固定写死。
Tensor Core 数据通路:解码后的数怎样喂给 MMA
Tensor Core 并不接收普通二维数组,它接收由一个 warp 或 warpgroup 分散持有的 fragment。以 Ampere 常见的 mma.sync.aligned.m16n8k16 为例,一条 warp 级指令协作计算 输出块在 方向上的一次累加。每个线程只持有 A、B 和 C 片段中的若干元素,而且寄存器编号到逻辑矩阵坐标的映射由指令规范固定。
这带来一个关键约束:反量化后的元素“值正确”还不够,它们必须出现在正确线程的正确寄存器槽位。若先按普通行优先顺序解码,再通过共享内存转置成 MMA 布局,会增加一次写入、同步和读取;若依靠 warp shuffle 重排,则要付出额外指令并占用寄存器。BitBLAS/Ladder 的做法是反向设计物理权重布局:从 MMA 需要的 fragment 顺序出发,推导每个线程应读取哪些 packed word,再把这一 permutation 固化进离线权重变换。
完整流水线可以分成五级:
- 全局内存以 16 byte 或更大粒度合并读取压缩权重;
- 使用
cp.async等机制把下一 tile 搬进 shared memory,与当前 tile 计算重叠; ldmatrix或普通向量加载把压缩片段送入线程寄存器;- 位运算、LUT、scale 和 zero point 在寄存器中恢复计算类型,并直接形成 MMA operand;
mma.sync执行矩阵乘加,累加器通常保留 FP32,再由 epilogue 转成输出类型并可融合 bias。
双缓冲的意义是隐藏全局内存延迟。设搬运一个 tile 的时间为 ,解码加计算时间为 。串行执行每轮需要 ;稳定流水线理想情况下接近:
这个近似成立的前提是 shared memory 足够容纳多级 stage,寄存器没有把 occupancy 压得太低,而且异步拷贝与计算没有争用同一关键资源。低比特权重缩短了 ,却增加了解码部分的 ;当两者交叉后,继续减少位宽不再按比例加速。
对 的 GEMV,输出并行度有限,Tensor Core tile 可能包含大量无用行,CUDA Core 的向量点积反而更合适;对中等或较大的 ,复用一个权重 tile 的激活行增多,Tensor Core 的优势迅速扩大。所以“支持 GEMV 和 GEMM”不是同一 Kernel 覆盖所有形状,而是同一算子接口在多个实现族之间选择。
Ladder Permutation:先改变布局,再消除运行时搬运
BitBLAS 代码和接口中的 weight transform 可以理解为一种硬件感知的 Ladder permutation。它并非数学上的矩阵转置,而是一组可组合的地址映射:外层可能先按 thread block tile 划分,中层按 warp tile 划分,内层再按 ldmatrix/MMA fragment 的 lane 映射重排,同时把多个低比特值塞进整数存储字。
设逻辑权重坐标为 ,打包和置换后的物理地址可抽象为:
决定元素属于哪个 block/warp tile, 决定由哪个 lane 消费, 决定它落入存储字的哪几个 bit。三个映射只改变位置,不改变线性层的数学意义。运行时逆向读取后,元素直接落在消费者附近。
为什么不让编译器在每次调用时动态重排?因为权重在成千上万次 token 解码中保持不变。若离线变换一次花费 ,每次省下 ,调用次数为 ,则变换值得执行的条件很简单:
常驻服务中的 很大,摊销几乎总是成立;临时加载、只运行一次的小模型则要把预处理与编译时间算入端到端成本。部署系统还必须缓存变换后的权重,否则每次进程启动都重新 permutation,会让冷启动明显变慢。
布局传播还能跨算子消除转换。如果前一算子的输出仅被后续算子消费,编译器可以让前一算子直接写出后者需要的布局,而不是先写标准布局再启动 transpose Kernel。权重线性层的输入通常来自 LayerNorm 或激活函数,这为 producer-consumer 融合留下空间;但通用推理框架要求张量可被多个后端理解,过度私有化布局也会增加集成成本。这是库级 Kernel 与整图编译器之间长期存在的边界。
调度与自动调优:不同 M、N、K 为什么需要不同 Kernel
一个混合精度 GEMM 配置至少包含 block tile 、warp tile、warp 数量、pipeline stage 数、是否使用 Tensor Core、shared memory swizzle、解码向量宽度和 split-K 等参数。它们之间不是独立旋钮:增大 能提高数据复用,却会扩大 shared memory 占用;增大 stage 数能隐藏延迟,却会进一步消耗 shared memory;扩大每线程输出块会提高算术强度,同时增加累加器寄存器。
Ladder 的硬件感知策略从各存储层的自然粒度产生 hint,再让上层 tile 与它们的最小公倍数对齐。例如全局内存偏好 32 byte 合并事务,shared memory bank 宽度通常是 4 byte,ldmatrix 和 MMA 又各有固定形状;调度器先选接近目标低比特类型的硬件计算类型,再确定满足这些粒度的 tile,最后插入 slice、pad、convert、map。这比穷举所有布局组合小得多,候选生成后仍需实际 profile 选出最快方案。
可以用资源约束理解为什么不存在万能配置。若一个 block 使用的 shared memory 为 ,每个 SM 可用共享内存为 ,寄存器约束允许的 block 数为 ,线程约束允许的 block 数为 ,那么并发 block 上限近似为:
是架构规定的 block 上限。多加一个 pipeline stage 也许让单 block 快 10%,却可能使 跨过阈值,把每 SM 的驻留 block 从 2 降到 1,最终吞吐反而下降。自动调优必须测最终 Kernel,而不能只看某个局部指标。
形状也会改变最优目标:
| 场景 | 典型 | 主要约束 | 调度倾向 |
|---|---|---|---|
| 单 token 解码 | 1 | 权重带宽、并行度不足 | 小 、扩大 并行、专用 GEMV |
| 连续批处理解码 | 数十到数百 | 带宽与计算混合 | Tensor Core、适中 tile、减少 padding |
| 长提示 Prefill | 数百到数千 | Tensor Core 吞吐 | 较大 tile、多级流水、提高复用 |
| 不规则投影层 | 小 或尾块 | 边界浪费 | 更小 tile 或专用 fallback |
把动态 编译成过多专用 Kernel 会产生编译和缓存压力;只保留少数 bucket 又会增加 padding 与次优调度。实际服务通常对高频形状预编译并缓存,低频形状落到通用 Kernel。这与推理调度器的批次策略耦合:调度器改变 batch 中 token 数,就可能让线性层跨入另一个性能区间。
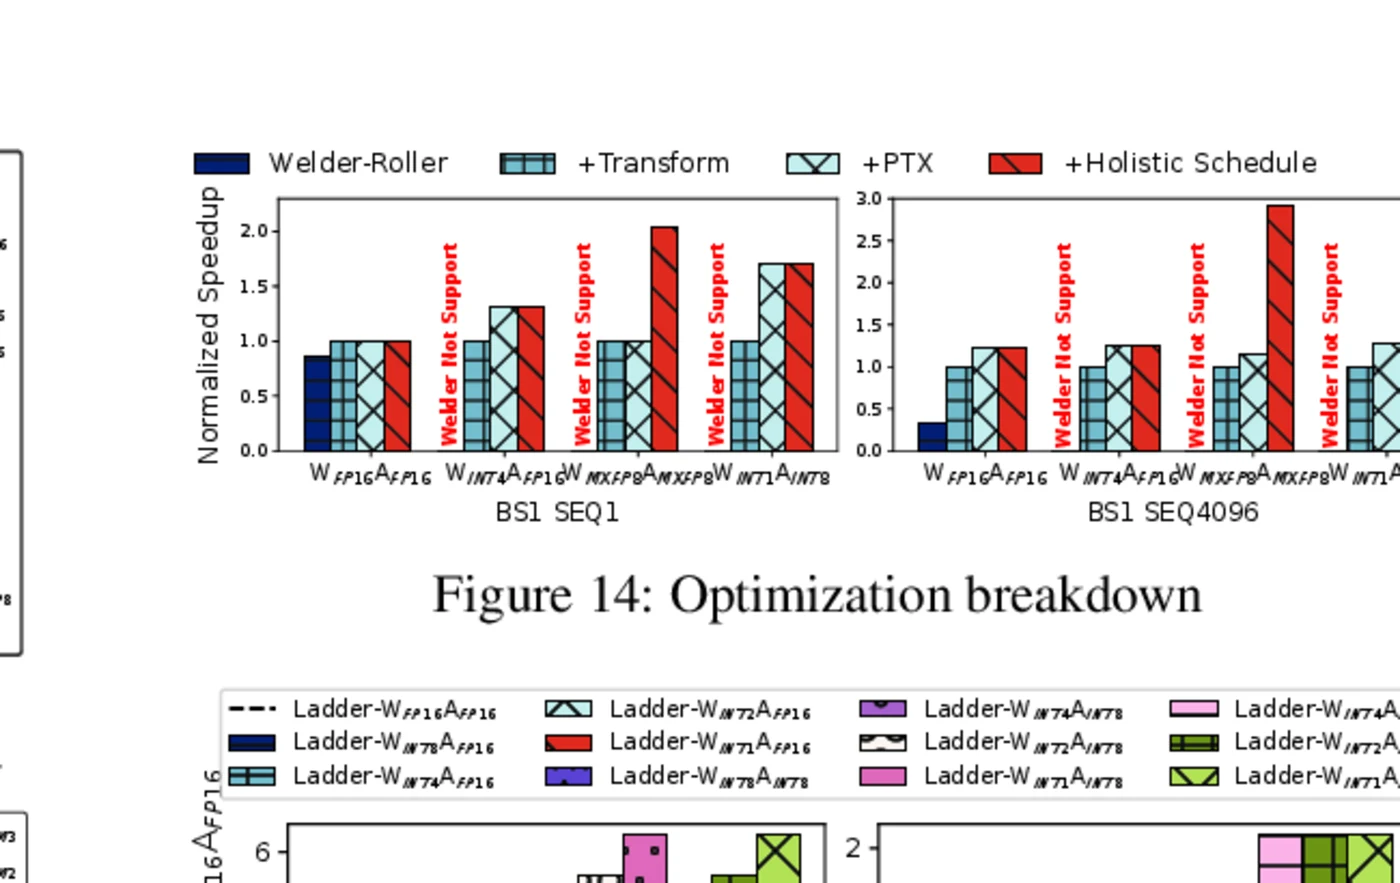
图 3 是 Ladder 论文对 LLaMA-70B 单层 Kernel 的逐步消融。+Transform 先带来低比特类型支持和 tile 变换,+PTX 用更底层的指令优化加载与转换,+Holistic Schedule 再联合选择布局和调度。图中 BS1/SEQ1 与 BS1/SEQ4096 的收益结构明显不同:前者更接近带宽受限,后者更依赖计算 tile 与转换开销的平衡。论文报告 tile-aware transform 相对 Roller 基线可达 2.0 倍,PTX 优化进一步最高约 1.7 倍,整体调度在部分配置中最高约 2.5 倍;这些数字是分阶段消融,不应相乘当作普遍加速比。
量化格式接入:对称、非对称、分组缩放与零点
BitBLAS 的算子配置需要把数学格式显式告诉 Kernel 生成器。最基本的参数包括激活、权重、累加和输出 dtype,以及 group_size、with_scaling、with_zeros 和 zero point 模式。下面是一个简化的 W4A16 接口示意:
import bitblas
config = bitblas.MatmulConfig( M=1, N=4096, K=4096, A_dtype="float16", W_dtype="int4", accum_dtype="float32", out_dtype="float16", layout="nt", group_size=128, with_scaling=True, with_zeros=True,)
op = bitblas.Matmul(config)packed_weight = op.transform_weight(weight)output = op(activation, packed_weight, scale, zeros)示例的重点不是参数名称,而是四类数据拥有不同生命周期:activation 每次请求变化;packed weight 在模型加载后长期只读;scale 和 zero point 随权重常驻;output 可能继续进入 bias、激活或残差融合。只有把它们分开,运行库才能针对静态权重做离线布局变换,并把动态路径缩到最短。
对称量化只有 scale,恢复式为 ,最容易向量化。非对称量化需要减 zero point,若 zero point 也被低比特打包,就要再走一次位提取;但它通常能更好覆盖不以零为中心的权重分布。group size 影响三项代价:量化误差、元数据容量、scale/zero 复用。以 权重、每组 个元素、每个 scale 用 16 bit 为例,仅 scale 的容量为:
INT4 权重本体是 bytes,因此 scale 相对权重的容量比例为 。 时约为 3.125%, 时升到 12.5%;再加入 zero point 后还会增加。位宽越低,元数据所占比例越不能忽略。
NF4 的码表通常很小,可以驻留在常量缓存或寄存器可快速访问的位置,但查表会形成与均匀 INT4 不同的指令序列。FP4 又包含指数与尾数拆解,某些新架构有原生指令,旧架构则需代理计算类型。BitBLAS 把格式转换作为 convert 的一部分,使同一套 tile 调度可以挂接不同解码函数;这也是它相对只支持单一 W4A16 格式的手写 Kernel 更通用的地方。
与 Marlin、CUTLASS 和通用反量化方案的边界
几条路线都能完成低比特矩阵乘,但优化目标并不相同。
| 路线 | 核心方法 | 优势 | 代价与边界 |
|---|---|---|---|
| 单独反量化 + cuBLAS | 先生成 FP16 权重,再调用成熟 GEMM | 实现简单、覆盖形状广、容易验证 | 中间张量与额外显存流量大,解码阶段通常不划算 |
| Marlin | 为 W4A16 自回归推理手工设计高度优化的 CUDA Kernel | 目标格式和目标形状上控制精细、性能强 | 格式与架构扩展需要专门工程,通用性较低 |
| CUTLASS/CuTe | 用 C++ 模板或 DSL 描述分层 GEMM、数据搬运与 MMA | NVIDIA 架构覆盖广,紧跟新指令和原生低精度格式 | 模板与布局体系复杂;自定义非原生格式仍需设计转换路径 |
| BitBLAS/Ladder | 把自定义类型、tile 变换、PTX 优化和自动调优统一起来 | INT1/2/4、NF4、FP4、混合输入组合灵活,可生成多种形状 | 编译、调优和权重预处理有成本;生成质量依赖目标后端 |
Marlin把 W4A16 的数据通路做得非常专:它围绕自回归推理的中小 batch 设计权重分区、异步加载、反量化和锁同步,追求接近从 FP16 到 INT4 的理想 4 倍带宽收益。BitBLAS 更像“生成一族 Marlin 类 Kernel 的基础设施”,但通用生成器未必在每个固定组合上都胜过长期手工雕刻的实现。
CUTLASS 与 BitBLAS 的关系也不是简单竞争。CUTLASS 提供分层 GEMM 构件、CuTe 布局代数和新架构指令封装,适合明确知道目标数据通路的 Kernel 作者;BitBLAS 更强调从逻辑混合精度算子出发,自动选择低比特转换与调度。随着 CUTLASS 对 block-scaled FP4/FP6/FP8 等格式的原生支持不断扩展,硬件已直接支持的格式优先使用厂商路径往往更稳;BitBLAS 的突出价值仍在于硬件没有原生混合乘法的组合,以及快速探索新格式。
“通用”也不意味着零成本。每增加一种 source format,至少要定义逻辑解码、存储打包、scale/zero 元数据布局和数值验证;每增加一种架构,还要重新核对 MMA 形状、异步拷贝能力、shared memory bank 行为和寄存器限制。编译器可以复用搜索框架,却不能凭空绕开硬件差异。
性能判断:带宽、解码和 Tensor Core 谁是瓶颈
判断量化 Kernel 是否值得使用,不能只看“权重缩小 4 倍”。一个实用的上界模型应同时考虑权重流量、元数据、激活与输出流量,以及计算和解码吞吐。对 ,FLOP 数约为 。若权重位宽为 ,忽略缓存后权重字节数约为 ;激活和输出若为 FP16,分别约为 与 bytes。算术强度近似为:
是 scale、zero point 和其他格式元数据。当 很小时,分母由权重项主导,INT4 相比 FP16 把最大项缩小约 4 倍,极有机会获得显著加速;当 增大,权重被更多 token 复用,算术强度上升,瓶颈转向 Tensor Core,单纯压缩权重不再提供 4 倍收益。
把 GPU 峰值计算吞吐记为 ,显存带宽记为 ,不考虑解码时 Roofline 上界为:
混合精度 Kernel 还要再加入解码上限 :
不是一个固定硬件指标,它取决于格式、位运算序列、LUT、scale/zero 读取、寄存器压力和与 MMA 的重叠程度。INT4 对称量化的 通常高于带细粒度 zero point 的非对称路径;NF4 查表又可能表现不同。这个三上限模型解释了为什么同样的 4 bit 模型,在 时受益明显,在大 Prefill 上可能与 FP16 差距有限,甚至因解码开销落后。
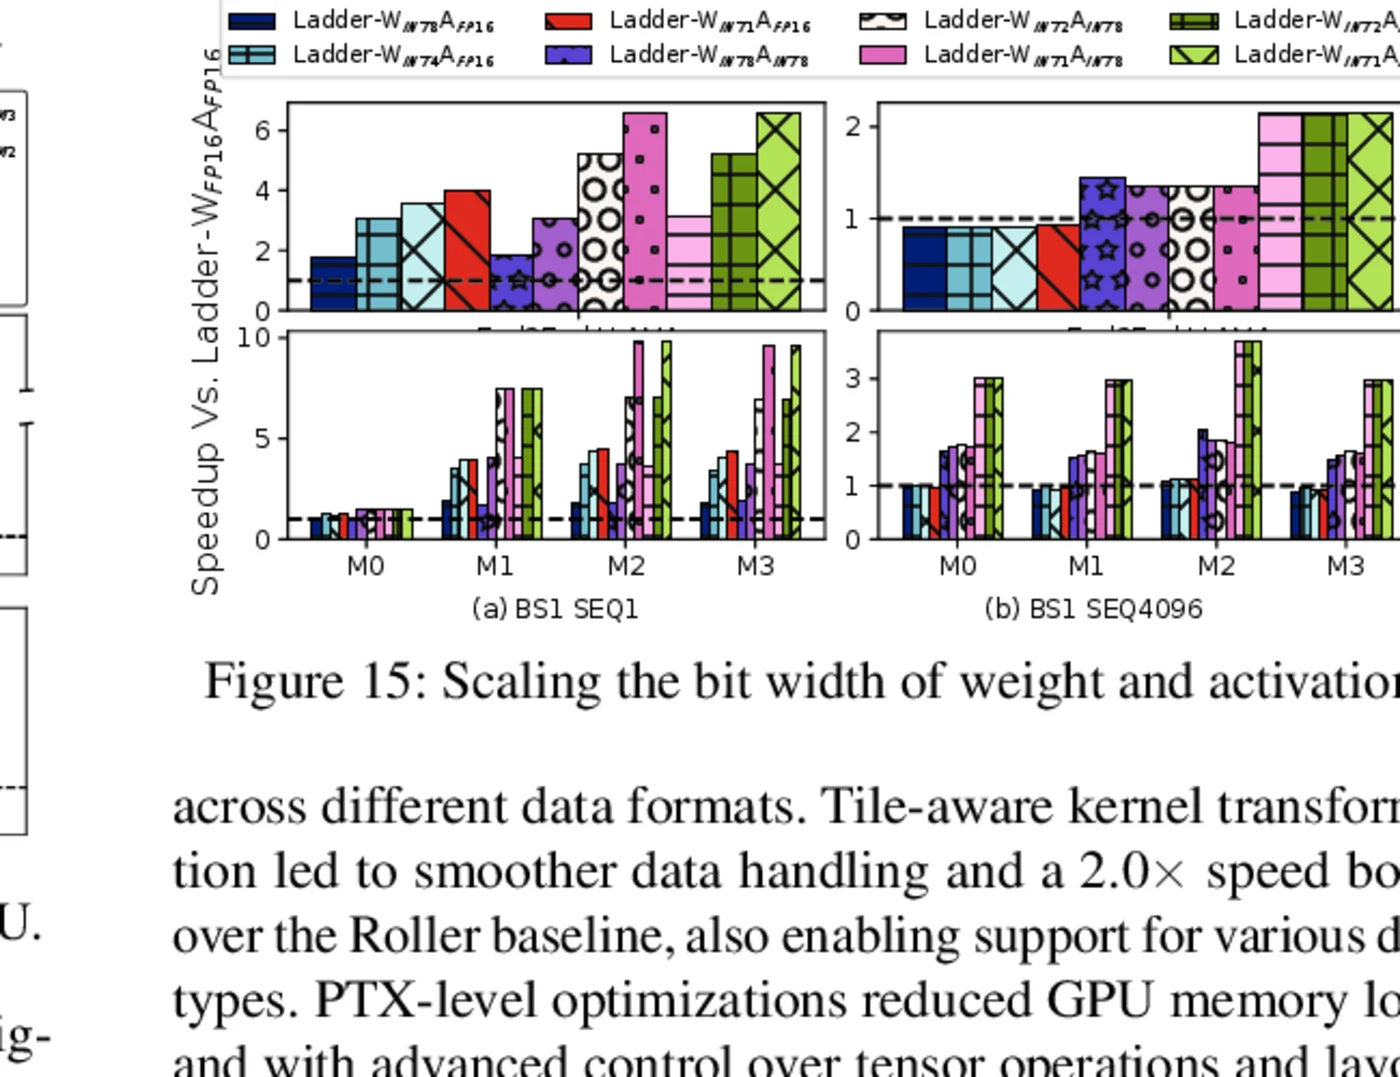
图 4 来源于 Ladder 论文。左列 BS1/SEQ1 代表接近单 token 的内存受限场景,降低权重位宽后加速比随之增长;右列 BS1/SEQ4096 更接近计算受限 Prefill,继续把权重从 INT4 降到 INT2/INT1,并不会等比例提高使用较高精度计算单元的混合精度路径。图中的虚线以 WFP16AFP16 为基线,不同纹理对应不同 W/A 位宽组合。它展示的是“瓶颈迁移”,而不是低 bit 在所有形状上都必然更快。
论文在 A100 上报告 WINT4AFP16 相对当时 vLLM 量化路径平均约 2.3 倍加速;单 token、极低位宽路径的收益更高。但该实验使用特定版本的软件栈,LLaMA-70B 与 BLOOM-176B 因容量限制以单个 decoder layer 作为代理。正确解读是:硬件感知变换能够把低比特容量收益转成真实 Kernel 收益,而不是把 2.3 倍当作任何模型、任何 GPU 上的固定承诺。
部署前应至少测四组数据:
- 分开测 、常见动态 batch、长 Prefill,而不是只测一个方阵;
- 同时报告 Kernel latency、端到端 token latency 与吞吐,避免忽略调度和通信;
- 将权重预处理与 JIT 编译时间单独报告,明确是否计入冷启动;
- 用相同量化权重比较后端,并检查输出误差,避免把格式差异误认为 Kernel 差异。
工程落地:什么时候适合用 BitBLAS
BitBLAS 最适合三个条件同时成立的场景:权重已被压成硬件不直接支持的格式;线性层占据显著推理时间;服务会重复调用同一组权重,使编译和 permutation 成本可摊销。典型例子是 Ampere/Ada 上的 GPTQ/AWQ W4A16、实验性的 INT2/NF4 路径,以及需要快速比较多种混合输入格式的研究系统。
一条稳妥的接入流程如下。
1. 固定语义,而不是先固定 Kernel
先记录量化权重的 source format、位宽、符号定义、group size、scale 轴、zero point 模式与原始逻辑布局。尤其要确认 zero point 是量化整数空间中的值,还是已与 scale 融合的偏置。格式语义不一致时,Kernel 可以运行得很快,却会静默地产生错误输出。
2. 建立独立参考实现
用 PyTorch 写清楚“解包 → 反量化 → FP32/FP16 matmul”的慢速实现。对随机矩阵、边界值、非整除的 和真实模型权重分别比较。误差阈值要依据累加类型设置:FP32 accumulation 通常比 FP16 accumulation 稳定,但最终输出转换仍会引入舍入。
3. 对真实形状调优并缓存
不要只用 方阵。收集模型中 Q/K/V/O 投影、门控投影与 down projection 的实际 ,再按服务流量统计 分布。把调优结果以 GPU 架构、CUDA 版本、BitBLAS 版本、dtype 配置和形状作为 cache key;部署镜像变化后要允许失效重编译。
4. 权重变换只做一次
模型加载时调用 weight transform,并把结果与 scale/zero 按后端需要的布局常驻设备或保存为派生制品。若同时支持多个后端,应保留原始量化权重作为事实来源,不要尝试把某个后端的私有 packed layout直接交给另一个后端。
5. 设置 fallback
未知 shape、尾维不满足对齐、GPU 架构不支持或 JIT 失败时,应退回已验证的通用量化 Kernel 或反量化加 GEMM。生产服务宁可在少数请求上变慢,也不能因一个未覆盖的维度组合中断整个模型。
6. 用 profiler 验证瓶颈
先看 Kernel 时间线确认没有额外反量化 Kernel和隐式同步,再看显存吞吐、Tensor Core 利用率、整数指令、寄存器数和 occupancy。若显存带宽已接近上限而 Tensor Core 低,继续调 MMA tile 收益有限;若带宽不高、寄存器 spill 明显,应先缩短解码活跃区间或降低 stage/tile;若长 Prefill 的 MMA 利用率低,则应检查布局、padding 和 pipeline。
BitBLAS 官方仓库提供 Matmul 与类似 nn.Linear 的 Linear 接口,也曾提供 PyTorch、GPTQModel、AutoGPTQ、vLLM 与 BitNet 等集成。需要特别留意项目生命周期:Microsoft 的官方 GitHub 仓库已在 2026 年 2 月归档为只读。已有代码与论文仍有很高的学习和复用价值,但新项目选型必须同时评估 CUDA 新版本、Blackwell 后端和上层推理框架的维护兼容性,不能只依据历史 benchmark。
局限与可继续改进的方向
第一,自动生成并不保证全局最优。Ladder 为控制搜索时间,把 tiling 与 transformation 在一定程度上分阶段处理,再用硬件 hint 缩小空间。这种策略能生成高质量方案,却可能错过只有联合改变 tile、转换层级和跨算子布局才出现的最优点。论文也明确把这种实践描述为有效但可能次优。
第二,动态推理形状削弱离线调优。静态 来自模型结构,但 由调度器实时决定。为每个 编译专用 Kernel 不现实,少数 bucket 又会留下性能台阶。更深的服务集成应让批处理调度器感知 Kernel 性能曲线,使请求合批不仅满足 token 预算,还尽量落在高效形状上。
第三,低位宽收益受硬件演进影响。新 GPU 开始原生支持 FP4、block scaling 和更强的数据搬运指令后,旧架构上必要的代理解码可能变成多余;相反,新的 fragment 和内存层次又需要新的布局映射。一个可持续的系统必须把格式语义与具体 PTX 实现分离,并持续维护目标描述。
第四,算子最快不等于端到端最快。真实 LLM 推理还包含注意力、KV Cache、采样、通信和调度。若线性层只占端到端延迟的一部分,Amdahl 定律给出的整体上限为:
是原始时间中可被混合精度 GEMM 加速的比例, 是 GEMM 加速比。即使 ,若 ,整体最多约 倍。因此需要把 Kernel benchmark 放回完整推理链路中验证。
第五,数值正确性不能交给性能测试顺带验证。不同累加精度、scale 融合顺序、subnormal 处理和舍入模式都可能造成差异。对生成模型而言,小的逐层误差还可能随长序列累积。Kernel 单测除随机误差外,还应覆盖极值、全零组、饱和码、非整除边界和长序列端到端回归。
小结
BitBLAS 解决的不是“把 INT4 转回 FP16”这么单一的问题,而是怎样让压缩存储、位级解码、scale/zero、内存布局与 Tensor Core fragment 成为一条连续流水线。它继承 Ladder 的关键抽象:用 tType 表示自定义低比特语义,用 tTile 表示各级硬件处理的数据块,再用 slice、pad、map、convert 把逻辑算子映射到全局内存、共享内存、寄存器与 MMA。
理解这套机制后,可以得到三个稳定结论。其一,量化节省容量只是起点,只有避免 FP16 中间张量和额外访存,容量收益才会变成延迟收益。其二,权重静态使离线 permutation 极具价值:把复杂布局变换提前一次完成,运行时便能按 MMA 消费顺序读取。其三,最优 Kernel 由形状和瓶颈决定:单 token 解码关注带宽与并行度,长 Prefill 关注 Tensor Core 吞吐,解码指令和元数据又构成第三条上限。
BitBLAS 官方实现已经归档,但它提出的问题没有过时。无论后续使用 CUTLASS/CuTe、TileLang、Triton 还是手写 CUDA,只要硬件计算类型与模型存储类型不一致,就仍需回答同一组问题:在哪里转换、怎样排布、由谁读取、如何与矩阵乘重叠。这正是低比特推理 Kernel 的核心。
参考资料
- Ladder: Enabling Efficient Low-Precision Deep Learning Computing through Hardware-aware Tensor Transformation(OSDI 2024)
- Microsoft BitBLAS 官方仓库
- BitBLAS 的 Matmul Dequantize 实现
- NVIDIA PTX ISA 文档
- NVIDIA CUTLASS Documentation
- MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models
- TVM: An Automated End-to-End Optimizing Compiler for Deep Learning
- Welder: Scheduling Deep Learning Memory Access via Tile-graph
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



