


DialRouter 完全拆解:从单轮贪心选择到多轮对话的长程模型路由
单轮最优,为什么会输掉整段对话
LLM 路由通常被描述成一道选择题:输入一个请求,在小模型、中模型和大模型里挑出最合适的一个。若请求彼此独立,这个抽象很自然;路由器只要估计每个候选模型回答当前问题的质量,再结合延迟或价格做一次决策即可。
多轮对话却不是一串互不相干的选择题。模型在第 轮给出的回答,会改变用户第 轮问什么、还需要澄清什么,甚至会改变任务能否继续。例如客服在第一轮只说“不能修改地址”,可能立即得到投诉;若先确认目的地、解释跨城市限制并给出重下单方案,后续问题就会转向退款时间。两条路径在第一轮的表面正确率或许接近,最后完成的用户目标却完全不同。
From Myopic Selection to Long-Horizon Awareness 由上海交通大学与腾讯微信团队于 2026 年 4 月发布。论文提出 DialRouter,把模型选择从单轮分类改写成多轮序列决策:离线阶段用蒙特卡洛树搜索(Monte Carlo Tree Search,MCTS)探索“选不同模型会把对话带向哪里”,在线阶段则用一个轻量路由器复现搜索得到的长程选择,不在服务热路径运行树搜索。
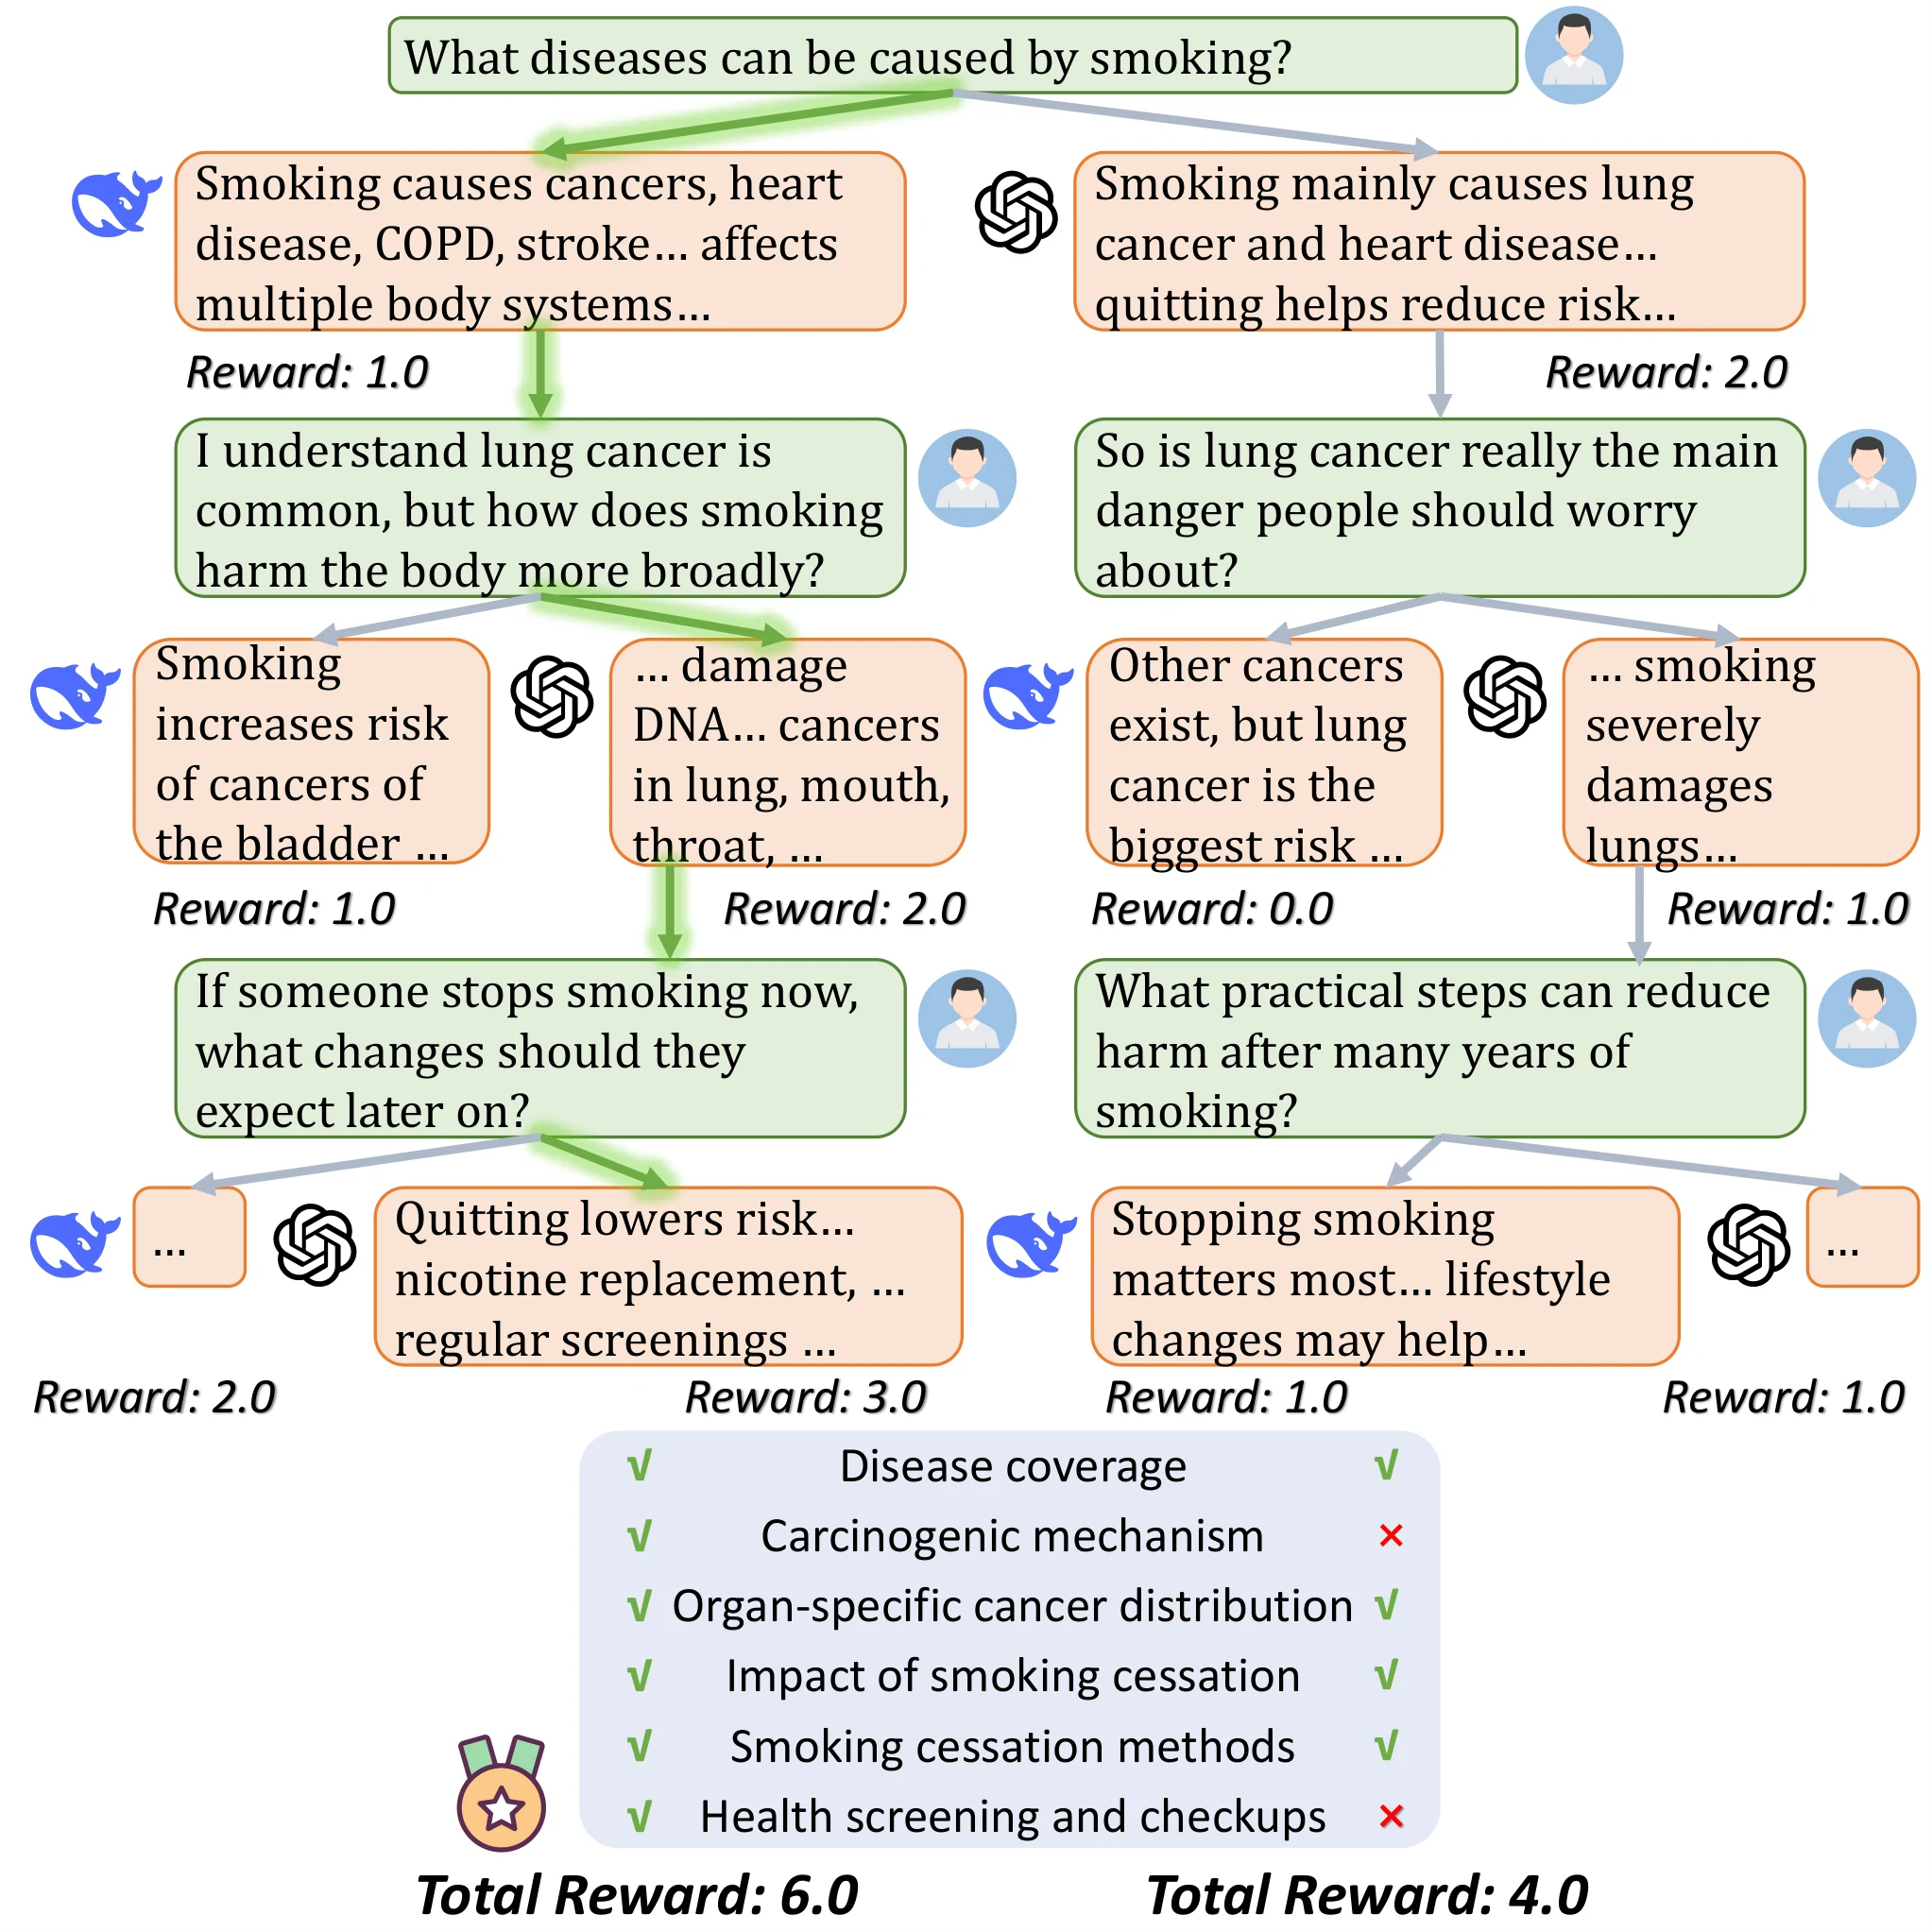
图源:DialRouter 论文图 1(b)。图中每一层是一个对话轮次,每条分支代表选择不同模型后产生的响应与下一条用户输入。绿色路径强调一个关键事实:当前回报最高的分支,不一定通向累计回报最高的叶节点。
这里有三个彼此耦合的问题。
- 交互动力学:模型不是只消费状态,也参与生成下一状态。路由动作会通过回答内容影响用户的后续行为。
- 延迟回报:需求是否完整满足,往往只能在对话结束后评价。某轮没有立刻得分,可能是在收集后续回答必需的信息。
- 路径相关成本:同一模型连续服务可以复用提示词缓存;切换模型通常要在新端点重新处理整段历史。成本不仅取决于“用了哪个模型”,还取决于模型序列。
因此,单轮路由器真正忽略的并不只是更多历史文本,而是动作对未来状态和未来成本的影响。把完整历史喂给一个分类器,仍然可能是“看得多、想得短”:分类器知道过去发生了什么,却没有接受过哪种当前选择会改善最终结果的监督。
把多轮路由写成序列决策问题
设一段对话在第 轮结束,用户输入与系统响应分别记为 、,完整轨迹为
第 轮开始时,路由器可见的状态是
候选模型集合记为 。动作 不是生成一个词,而是选择其中一个模型;被选中的模型生成 。随后用户根据当前对话继续输入 ,系统转移到 。这里的状态转移不是固定规则,而是由模型响应、用户行为和任务上下文共同决定。
用 checklist 把模糊目标变成可累加回报
“回答得好”很难直接分解到各轮。DialRouter 先把高层目标拆成 checklist:
每个 是一个可检查的约束或子目标,例如“确认修改地址涉及的城市”“说明跨城不可改”“提供替代方案”“给出不同支付方式的退款时间”。在第 轮之后,奖励模型把每项判为完成、部分完成或未完成,对应 ,累计完成分数为
动作的即时回报不是本轮回答的独立评分,而是 checklist 的增量:
这样定义有一个很干净的性质。把所有轮次相加后,中间项会抵消:
因为初始完成分数 ,最大化累计增量与最大化最终 checklist 完成度完全等价。部分完成的 0.5 分也有意义:它把原本只有对话结束时才出现的稀疏信号,变成能沿搜索路径逐步传播的较密集信号。
但 checklist 并没有消除长程依赖。假设第一轮模型 A 先问清楚订单号,当轮没有完成任何业务目标, 可能为 0;第二轮却能凭订单号一次处理多个子目标。贪心策略会嫌弃第一轮的零回报,长程策略则会看到它创造的后续价值。
什么情况下可以退化成单轮路由
若下一轮用户输入与此前响应条件独立,即
那么当前动作不影响未来问题,多轮任务才近似退化为若干独立的单轮路由。现实客服、问诊、代码修改和需求澄清显然通常不满足这个条件。论文真正挑战的,正是单轮路由隐含的这个独立性假设。
MCTS 如何搜索模型选择造成的对话分叉
穷举所有路由序列不可行。若候选池有 个模型、对话最多 轮,仅动作序列就有 种;每条边还要真实调用模型生成回答,再模拟用户后续输入。DialRouter 用 MCTS 把计算集中在更有希望的分支上。
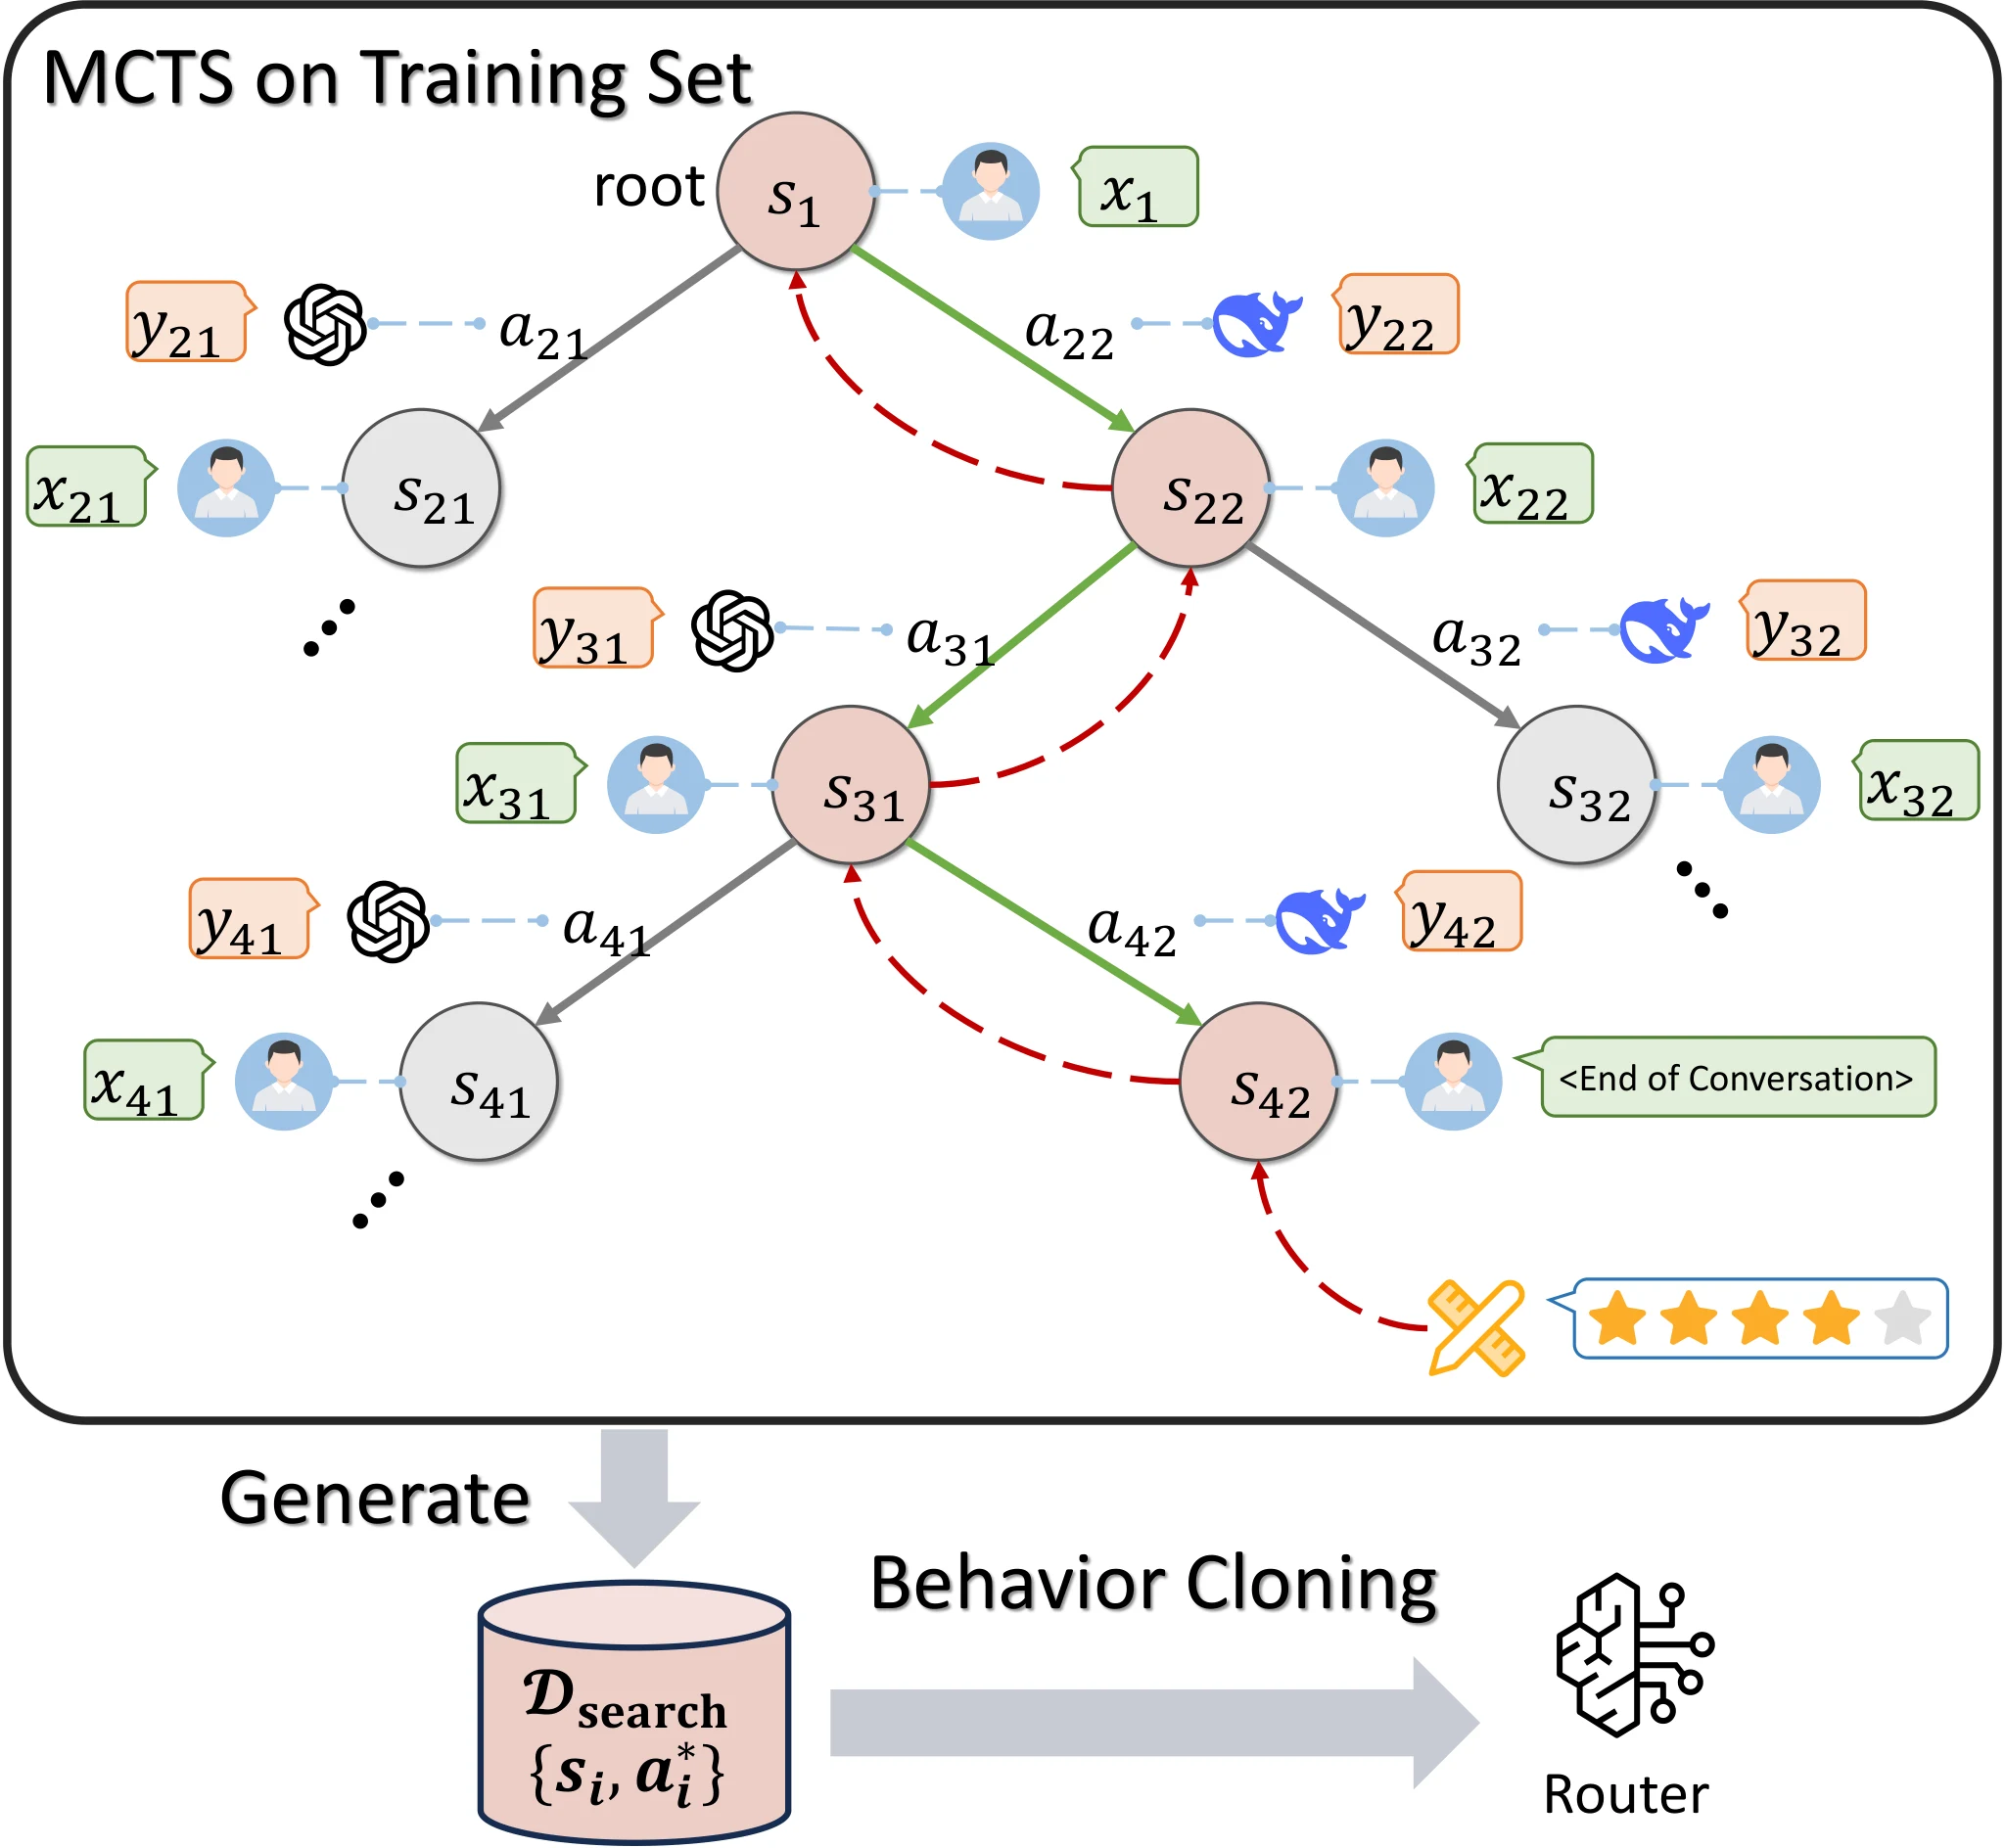
图源:DialRouter 论文图 2。左侧是昂贵但只在离线阶段执行的搜索:候选 LLM 生成回答,用户模拟器推动对话,奖励模型检查目标完成度;右侧把高回报路径拆成状态—动作样本,得到不需要在线搜索的路由策略。
四个阶段各自解决什么
- 选择(Selection):从根节点向下,根据 UCT 分数选择已有子节点。
- 扩展(Expansion):到达尚未完全展开的叶节点后,选择一个未探索的候选模型,实际生成回答并产生新状态。
- 模拟(Simulation):从新节点继续用一阶贪心策略推进,由用户模拟器生成后续问题,直到对话结束或达到最大轮数。
- 回传(Backpropagation):把整条模拟轨迹的折扣累计回报传回经过的状态—动作对,更新它们的价值估计。
选择阶段采用 Upper Confidence Tree(UCT):
是目前观测到的长期回报均值; 是状态 的访问次数; 是动作 被选择的次数; 控制探索强度。第一项偏向已知高价值模型,第二项给少试过的模型“探索奖金”。若只取第一项,搜索很容易因为早期少量随机结果过早锁定某个模型;若 太大,又会把调用预算平均浪费在明显较差的分支上。
一条 rollout 从第 轮开始的价值为
其中 是折扣因子。论文取 ,几乎不削弱远期回报,这与“完整满足整段对话意图”的目标一致。回传时使用在线均值更新:
完成 次搜索后,根节点选择
论文实验设置为 、、最大对话轮数 。这不是充分探索整棵树,而是在调用成本受限时获得一个比单步贪心更有远见的近似专家。
用户模拟器和奖励模型为何既必要又危险
MCTS 必须知道“这句回答之后用户会怎么继续”。DialRouter 用 Qwen3-Max 同时实现用户模拟器与奖励模型:模拟器根据预先提取的用户画像 和当前轨迹生成下一条输入,并决定是否终止;奖励模型根据 checklist、当前状态和回答给出各项完成度。
这两个组件使反事实搜索成为可能:同一状态分别调用三个候选模型,可以得到三种响应,再观察三种不同的后续用户行为。真实日志通常只记录实际选中的一条路径,无法直接提供这些反事实分支。
代价是,搜索最优只意味着“在模拟器和奖励模型构成的世界里最优”。若模拟用户比真实用户更耐心、奖励模型偏爱与自己同族的候选模型,搜索轨迹就会带有系统偏差。论文用 GPT-5.1 作为独立评价器检查排序一致性,但这只能降低、不能消除同源评价偏差。上线前仍需用真实会话完成率、人工审计与安全指标校准。
把搜索结果压缩成在线轻量路由器
直接把 MCTS 放进线上请求链路会发生两类爆炸。第一类是调用次数:一次路由决策不再调用一个候选模型,而是为多个分支执行生成、用户模拟与评分。第二类是时延:树搜索是串行依赖很强的控制流,哪怕并行展开部分分支,也无法把多个搜索深度压成一次常数时间分类。
DialRouter 因而把 MCTS 当作离线专家。每个训练对话经过搜索后得到一条高回报动作序列,再拆成状态—专家动作对:
在线路由器 做的是多分类:输入当前对话状态,输出选择各候选模型的概率。它用行为克隆拟合 MCTS 的动作:
是路由器参数;目标函数就是专家动作标签上的交叉熵。长程知识不是来自这个损失本身,而是来自标签 :标签由完整 rollout 的累计回报决定,而不是由当前轮得分决定。换句话说,行为克隆负责压缩,MCTS 才负责规划。
实验中的状态编码器基于 Qwen2.5-0.5B,仅解冻最后三个 Transformer 层以抑制小数据集过拟合。模型总参数量为 472.9M,可训练参数为 44.42M;训练使用 AdamW、学习率 、batch size 32、15 个 epoch。这里不应把“0.5B”误解为完全免费的控制面:论文报告在线路由仍占用 3636 MiB GPU 显存。对已经部署多个候选模型的服务,这通常可接受,但对极小规模端侧部署未必成立。
行为克隆还有一个结构性缺陷:稀有却关键的动作容易被高频动作淹没。论文在成本实验中观察到,MCTS 偶尔调用昂贵模型挽救关键轮次,而蒸馏后的 DialRouter 更偏向训练轨迹里高频的低价动作。因此 DialRouter 的成本低于在线 MCTS,但成功率也低一些。这不是实现噪声,而是从搜索策略压缩到分类策略时常见的模式平均化。
未来状态近似:不用在线搜索也能看远一步
只用 做分类仍有信息鸿沟。MCTS 选出 时看过后续分支,轻量路由器却只看到当前状态。两个表面相似的当前问题,可能因潜在目标不同而需要不同模型;单靠当前文本很难反推出专家为何这样选。
DialRouter 的办法不是生成未来,而是从搜索日志借一个未来。给定当前状态 ,固定检索器在 中找语义最相似的历史状态:
然后取该状态在高回报轨迹中的真实后继 ,将它作为当前未来状态的近似 。实验使用 BGE-M3 做固定检索器。这个设计的计算逻辑可以分成三步:
- 当前对话在语义空间中寻找相似的历史局面;
- 不复制那个局面当时的动作,而是读取它在成功轨迹中“下一步变成了什么”;
- 把这个后继状态当作可能的演化趋势,与当前状态共同决定模型选择。
它像一种非参数世界模型:知识保存在轨迹库里,预测通过近邻检索完成。相比让生成模型写出未来对话,检索结果更便宜、更稳定,也天然来自搜索找到的高回报路径;相比只检索当前状态对应的动作,读取后继状态向路由器暴露了“这个选择试图把对话带到哪里”。
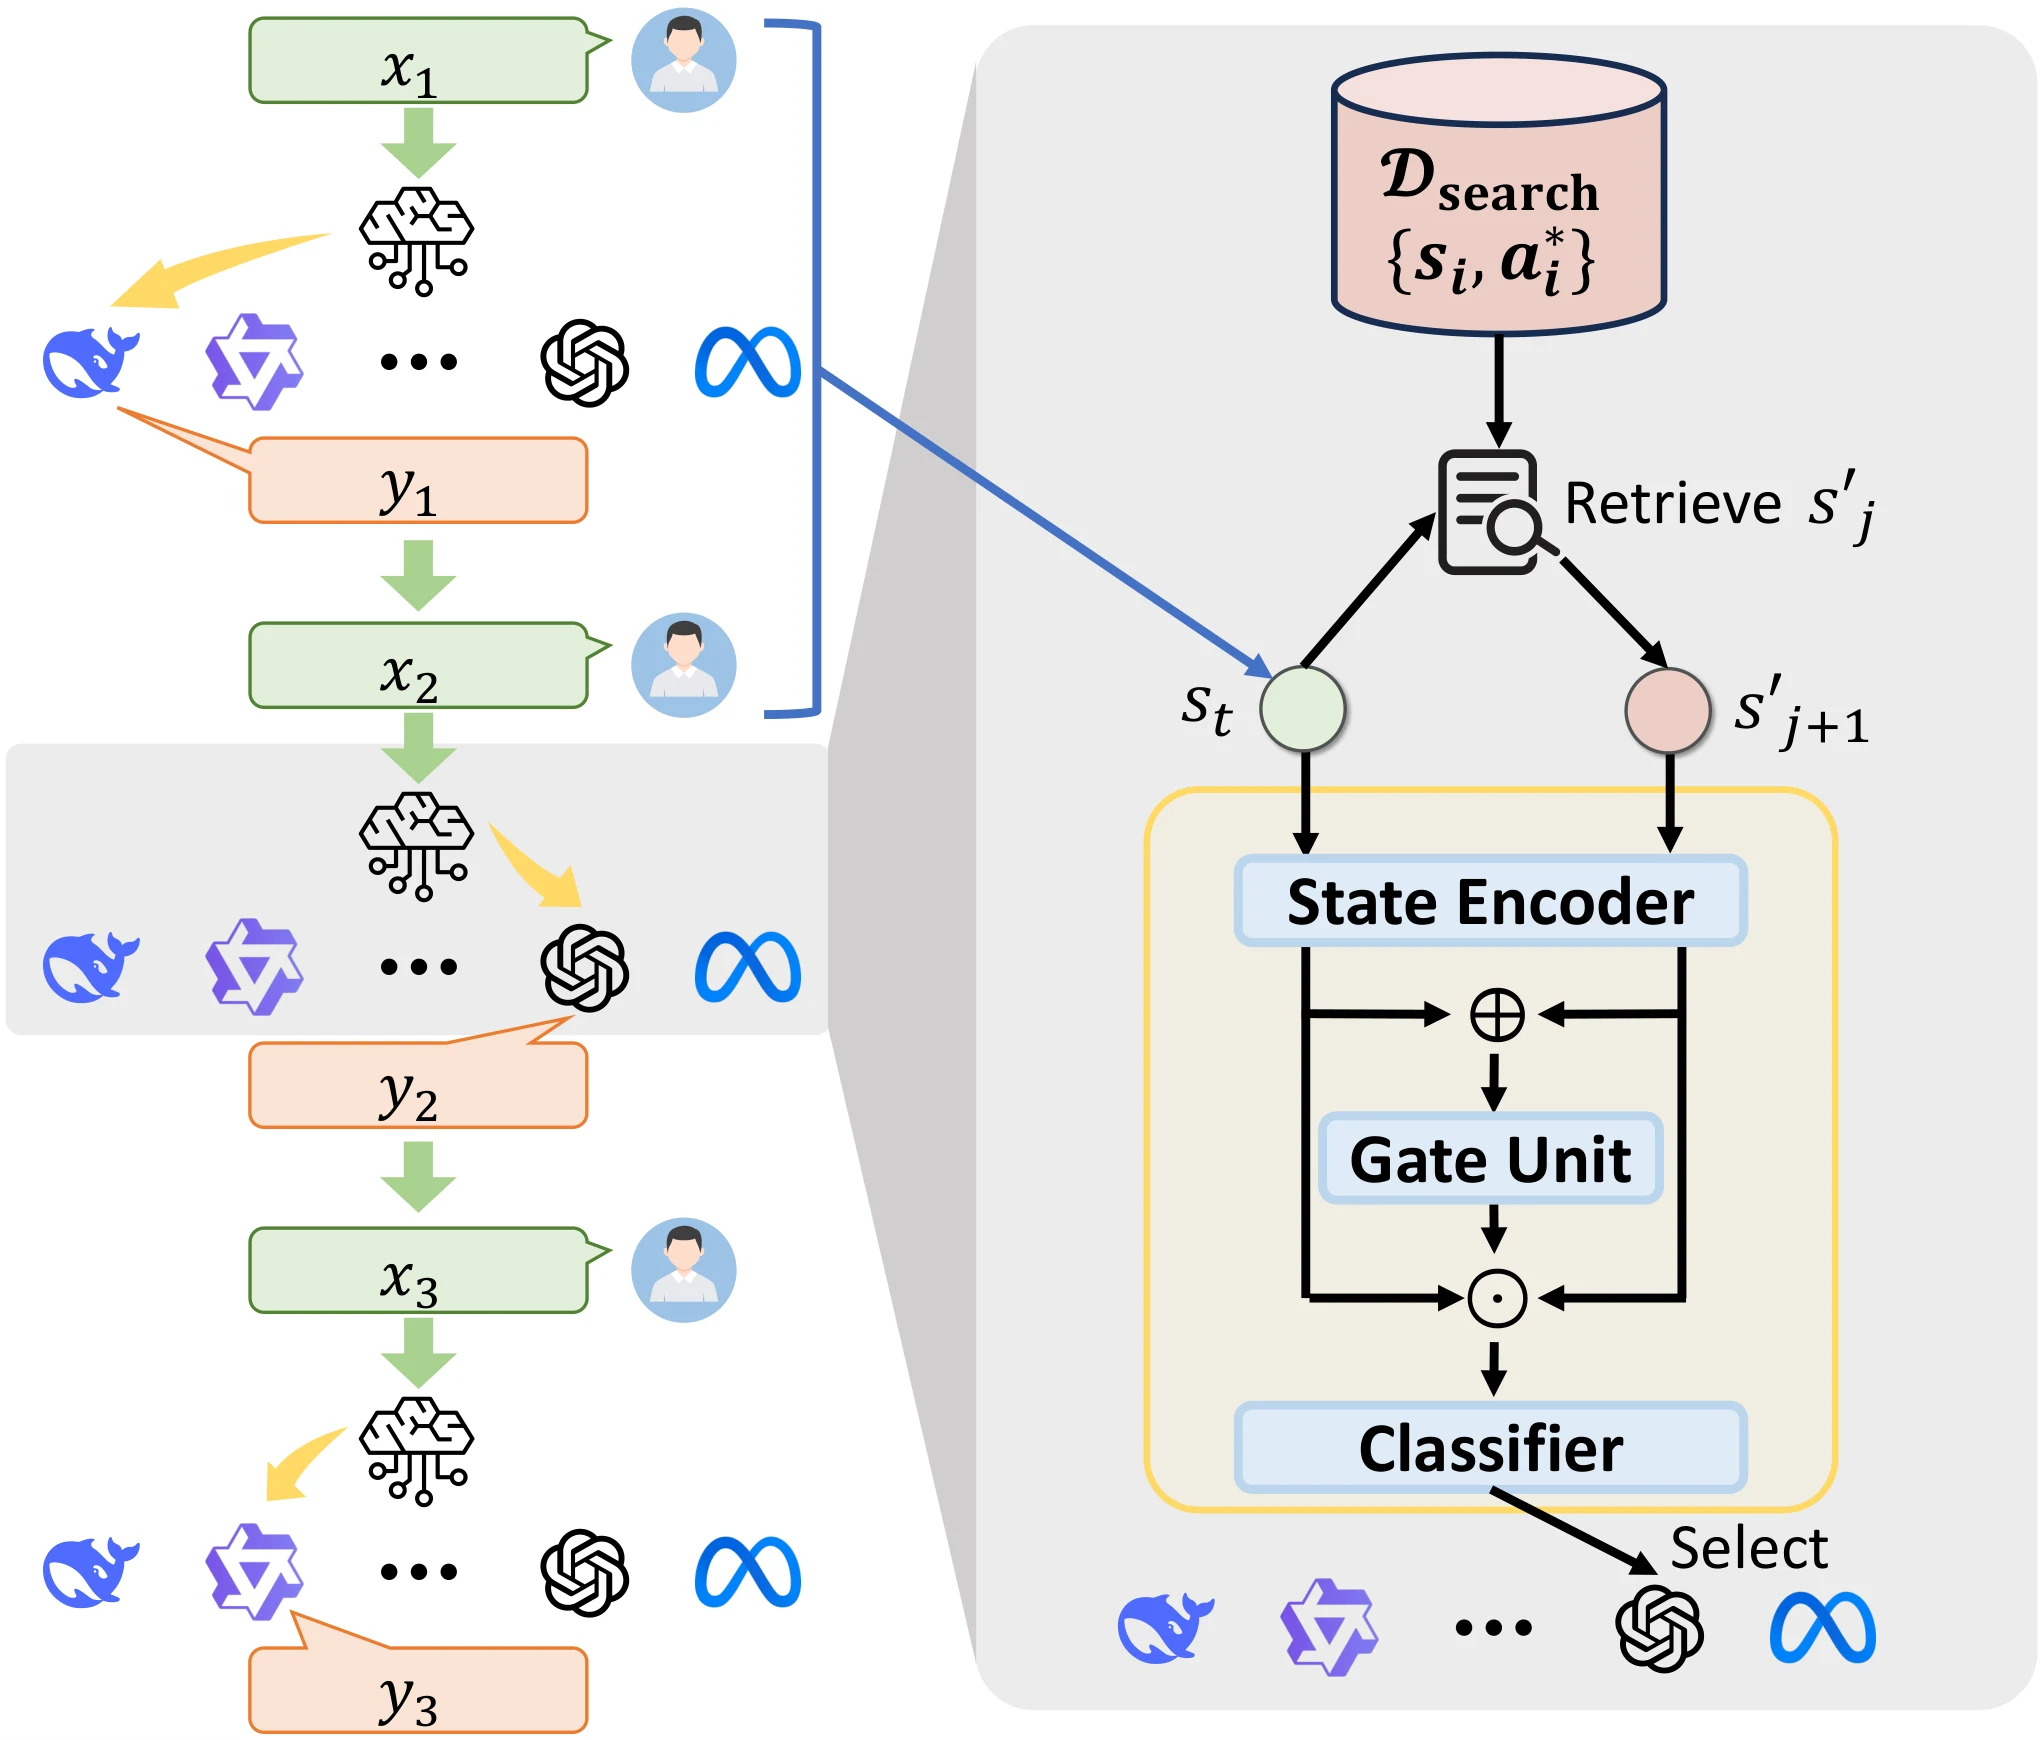
图源:DialRouter 论文图 3。图中的检索库不是普通问答知识库,而是 MCTS 产生的状态—动作轨迹库;被取出的也不是一段参考答案,而是相似状态的后继对话状态。
门控融合不是装饰
状态编码器 分别编码当前状态与检索到的未来近似:
再通过门控融合:
表示向量拼接, 是可学习映射, 把每个维度压到 0 和 1 之间, 是逐元素乘法。某个维度上 接近 1 时更信当前状态,接近 0 时更信检索未来。最终分类头根据 输出候选模型分布。
为什么不直接相加或拼接?因为检索不是预言。近邻只保证当前语义相似,无法保证隐藏目标、用户耐心、领域风险和后续行为一致。门控为路由器提供了按样本、按特征抑制错误未来的能力。论文消融也支持这一点:完整方法在 Qwen 候选集上的三数据集平均成功率为 83.31%;直接相加为 80.85%,直接拼接为 80.77%。去掉检索后为 80.02%,随机检索进一步降到 78.97%。错误未来比没有未来更糟,说明检索质量处在决策关键路径上。
该机制也有明确边界。若线上状态远离轨迹库分布,最近邻仍会返回某个结果,但“最近”不代表“足够近”。稳健实现应记录相似度、近邻间距与检索域,在低置信度时让 偏向当前状态,或直接走不带未来近似的回退策略。论文没有把这种分布外拒绝机制做成完整系统,这会是生产部署必须补上的一层。
成本感知奖励:模型价格之外还有 KV Cache
多轮 API 成本不能简化成“模型单价乘本轮 token 数”。设模型 的输出、普通输入、缓存命中输入的每 token 价格分别为 、、,并且通常满足
若第 轮输出长度为 ,输出成本奖励写成负成本:
输入侧更复杂。论文用缓存块大小 近似供应商的提示词缓存计费。当本轮与上一轮使用同一模型时,历史中完整缓存块按命中价收费,不足一个块的尾部与新输入按普通价收费:
若切换模型,论文采用保守的最坏情况假设:此前缓存完全失效,整段历史与新输入都按普通输入价计费。
总成本奖励为 ,再与完成度增量相加:
是质量与成本之间的换算系数。因为 为负,增大 会加强成本惩罚。这个式子把“切换税”放进序列目标:即使昂贵模型在当前轮略强,若切换导致长历史重新计费,它也可能不再值得;反过来,若关键轮次能显著提高最终完成度,长程策略仍可能接受一次高价切换。
这种建模与服务系统里的 KV Cache 有联系,但不能混为一谈。自托管 vLLM 中,切换模型意味着另一组权重和另一套 KV 地址空间,通常无法直接复用缓存;相关的分页管理可参考 PagedAttention 完全拆解。云 API 的 prompt caching 则是供应商侧的前缀复用与计费机制,客户端看不到实际物理 KV。论文建模的是可观测账单规则,不是证明某个供应商内部一定“完整删除了 KV”。
为什么质量除以成本会失效
一种看似自然的指标是把质量增量除以成本。但当候选模型价格相差很大时,分母会支配排序:极便宜模型即使质量一般,也可能获得极高比值。论文的 ratio-based reward 实验中,贪心路由几乎退化为总选最低价 DeepSeek,MCTS 与 DialRouter 也出现性能下降。
加权和虽然需要调 ,却能把“多完成一个目标值多少钱”表达为稳定的边际权衡。生产系统更适合用离线回放或约束优化校准 ,并把预算、SLO 与安全门槛独立成硬约束,而不是期望一个比值同时承担所有策略。
在线推理链路与系统开销
把离线部分全部拿掉后,一次在线决策只剩五步:
输入:当前历史 τ_(t-1)、用户输入 x_t1. 组装当前状态 s_t2. BGE-M3 编码 s_t,并在搜索轨迹库检索最近状态 s'_j3. 读取该轨迹的后继状态 s'_(j+1)4. 状态编码器分别编码 s_t 与 s'_(j+1),门控融合并分类5. 调用 argmax_a π_R(a | s_t) 对应的候选模型,保存本轮路由与计费状态输出:模型响应 y_t论文在单张 NVIDIA RTX 4090D 上报告,每次决策约 0.03 秒,其中检索约 0.01 秒。离线生成一个数据集的 750 段搜索轨迹约需 3 小时 40 分钟;在线路径不再调用用户模拟器、奖励模型或 MCTS。这个对比说明 DialRouter 的主要价值不是让规划本身便宜,而是把昂贵规划的结果摊销到大量线上会话。
不过,0.03 秒不能直接当作端到端开销。候选模型通过本地 vLLM 部署时,路由器、向量索引和模型服务是否共卡,会改变显存竞争与排队时延;调用闭源 API 时,网络和候选模型生成时延通常远大于 30 ms,路由开销占比较低。评测一个实现至少要分开报告:
- 路由器编码与分类时间;
- 向量检索时间及索引规模;
- 候选模型排队、首 token 和完整生成时间;
- 模型切换造成的缓存未命中与重复 prefill;
- 每段对话的成功率、总成本与模型切换次数。
路由控制面和模型数据面如何分开
DialRouter 输出的是模型 ID,不负责候选服务内部如何组 batch、分页 KV 或调度 GPU。更合理的部署方式是把它放在控制面:维护会话状态、执行检索和决策,再把完整或增量上下文送到对应模型池。每个模型池的数据面仍可使用连续批处理、前缀缓存和 PagedAttention。
这里与 token 级模型切换系统的边界尤其重要。DialRouter 每个对话轮次做一次选择,动作间隔通常是一整段模型响应;TokenRouter 则允许一次响应生成过程中按 token 切换模型,必须维护更细粒度的请求迁移、KV 生命周期与异步批处理。前者解决“下一轮该用谁”,后者解决“下一个 token 该由谁算”。二者可以组合,但不能把轮级策略直接当成 token 级执行协议。
会话状态不能只存文本
若要忠实执行成本感知策略,路由服务至少还要保存上一轮模型 ID、各端点的缓存键、可复用前缀长度、token 计数与计费版本。只把聊天文本交给分类器,会让策略以为连续调用能够命中缓存,而实际请求可能因模板变化、系统提示改动、缓存过期或租户隔离而未命中。
因此,论文中的状态 更像算法状态,生产状态还应包含系统变量 :
可以包含剩余预算、模型健康状态、限流配额、缓存命中估计和数据合规区域。若这些变量影响可选动作或真实成本,却没有进入策略输入,离线奖励与线上环境就会错位。
实验结果该如何解读
论文使用三个多轮数据集:开放域 ShareGPT、中文电商客服 JDDC、中文医疗咨询 MedDG。每个数据集各取 750 段训练对话;测试集分别为 90、100、100 段。候选池包括三档 Qwen、三档 Llama、二者混合的六模型池,以及 Qwen3-Max、DeepSeek-Chat-V3.2、GPT-5.1 构成的闭源池。所有候选模型以 temperature 0、非推理模式运行。
主要指标 Success Rate(SR)是终局 checklist 平均完成度:
Average Turns(AT)则衡量完成一段任务所用的平均轮数。SR 更高不必然表示回答的所有维度都更好,它只表示论文构造的 checklist 覆盖更完整;尤其在医疗场景,安全性、事实正确性和风险分级不能仅由完成项数量替代。
三组最有信息量的结果
| 设置 | 最强固定模型 SR | DialRouter SR | 在线贪心 SR | 在线 MCTS SR |
|---|---|---|---|---|
| Qwen 三模型池,三数据集平均 | 77.64 | 83.31 | 83.94 | 89.77 |
| Llama 三模型池,三数据集平均 | 72.60 | 78.88 | 79.70 | 86.53 |
| Qwen + Llama 六模型池,ShareGPT | — | 88.32 | 90.06 | 94.99 |
第一,DialRouter 分别比最强固定 Qwen3-14B 和 Llama3.1-8B-Instruct 高 5.67 与 6.28 个百分点,说明候选模型之间确有可利用的互补性。若路由器只是学会“总选最大模型”,它至多追平最强固定模型,不会超过它。
第二,在线 MCTS 明显更高,但它为每次选择运行搜索和模拟,不能与轻量路由器按同一服务预算比较。更准确的定位是近似 oracle:它显示候选池和搜索环境里还存在多少策略空间。DialRouter 与它的差距来自策略压缩、检索误差和分布偏移,而不是证明必须在线搜索。
第三,DialRouter 与在线贪心接近,却不等于长程建模没有作用。消融中,把训练标签从 MCTS 轨迹换成一阶贪心轨迹,平均 SR 从 83.31% 降至 79.77%;去掉未来状态检索则降至 80.02%。完整方法的收益是“长程标签 + 未来近似 + 门控融合”共同产生的。
跨域结果说明什么、不说明什么
ShareGPT-LF 只包含训练集未出现的法律和金融主题。DialRouter 在 Qwen 池上取得 83.69% SR,在 Llama 池上取得 83.03%,分别高于对应最强固定模型 1.95 和 2.85 个百分点。这说明路由策略没有完全记住训练主题,语义检索与模型互补性在新主题上仍有一定作用。
但“法律与金融未出现在训练集”不等于完整的生产分布外泛化。用户表达风格、对话模板、候选模型版本和评价流程仍与训练环境共享。更强的验证应跨时间、跨语言、跨供应商版本测试,并单独报告检索相似度很低的会话。
成本实验的真正结论
在闭源模型池的 ShareGPT 测试集上, 时 DialRouter 的 SR 为 89.92%、总成本为 0.44 美元。取论文所谓 Balance 设置 后,SR 为 88.69%、成本为 0.09 美元:成本约降 80%,SR 相对下降约 1.4%。这组数字展示的是同一实验价格表和测试集上的策略变化,不应外推成固定的线上节省比例。
更重要的机制结论是:显式建模缓存命中和切换成本后,策略没有完全坍缩到最低价模型,而部分 KNN、聚类式基线在成本压力下几乎总选 DeepSeek-Chat-V3.2。长程回报给昂贵模型保留了“关键时刻值得调用”的空间,序列成本又抑制了无意义的来回切换。
论文所用价格来自实验时的供应商公开计费,价格与缓存规则会变化。实际复现应读取当前端点价格和真实账单,而不是硬编码论文表格;成本模型本身可以保留,系数必须重新标定。
局限、失败模式与部署边界
1. 搜索轨迹继承模拟世界的偏差
用户模拟器决定未来问题,奖励模型决定哪条路径更好,两者又都由 Qwen3-Max 实现。即使独立评价器给出相近的方法排序,也无法证明模拟用户覆盖了真实用户的中断、反复、情绪变化、提示注入或故意对抗。高质量搜索数据仍可能在错误环境里形成自洽闭环。
更稳妥的生产流程是把真实匿名会话用于离线回放,用人工抽检校准 checklist,在影子模式下比较路由建议与现网选择,再小流量上线。医疗、法律等高风险域还需要固定安全模型、升级人工通道与不可被成本目标覆盖的硬规则。
2. checklist 会定义系统“看见”的成功
checklist 的好处是可解释、能分解,坏处是容易把未列出的品质变成零权重。客服回答可能完成全部流程项,却语气生硬;医疗回答可能覆盖症状、检查和用药项,却给出不适当的处方建议。若奖励只统计完成度,搜索会优化可计分行为,而不是抽象意义上的全面质量。
部署时可把奖励拆成多维向量:任务完成、事实性、安全、合规、用户体验和成本分别评估。安全和合规更适合约束而非软惩罚,避免一个很高的完成度分数抵消严重风险。
3. 检索未来可能造成错误类比
相似当前状态未必共享相似未来。尤其在短输入中,“想退款”可能对应未发货、已签收、跨境单或欺诈争议;语义向量相近,业务状态完全不同。随机检索消融比完全移除检索更差,已经说明错误辅助信号会主动伤害路由。
可行的防线包括元数据过滤、混合稀疏与稠密检索、相似度拒绝阈值、多近邻一致性检查,以及把业务结构化字段直接加入状态。轨迹库还要做版本化:候选模型升级后,旧轨迹里的模型强弱关系可能失效,不能无限期复用。
4. 最坏情况缓存失效是假设,不是定律
论文假设切换模型后历史缓存完全失效,这对不同供应商端点和不同权重模型是合理的保守近似,却没有覆盖所有系统。若同族模型支持跨模型 KV 映射、共享前缀编码,或服务端把公共 system prompt 独立缓存,切换税会变小;若缓存有最短前缀、TTL、对齐和容量限制,连续使用同一模型也未必全部命中。
相反,自托管场景除了 token 计费,还要考虑 GPU 驻留、冷启动、跨节点传输和 batch 碎片。成本函数可扩展为
四项分别表示 token 处理、模型切换、排队和冷启动代价。只有第一项能从公开 API 单价直接得到,其余三项必须从实际服务遥测估计。
5. 候选模型故障与拥塞尚未进入决策
论文实验中候选模型始终可用,价格固定,延迟也没有作为主要奖励。线上环境里,大模型池可能限流,小模型池可能排队更长,模型端点也会出现错误。一个只根据语义和历史成本选模型的策略,可能把请求送向当下最拥塞的服务。
因此路由动作应经过可用性掩码:先排除故障、超预算或不满足数据区域要求的候选,再在剩余集合上归一化策略概率。若候选集合频繁变化,固定分类头也会变得笨重;把“对话状态—模型描述”编码成可比较分数,会更容易增加或移除模型,但需要重新验证长程策略能否保持。
6. 适用边界
DialRouter 最适合目标可分解、对话会因回答而演化、同一任务有多个互补模型、线上量足以摊销离线搜索的场景。若请求天然独立、对话只有一两轮、模型差异很小,单轮路由已经足够。若每步动作直接改变真实世界且错误不可逆,纯模拟轨迹和软奖励又不够,需要更严格的规则、工具验证或人工批准。
小结
DialRouter 把多轮 LLM 路由中的三个隐变量显式化了:当前选择会改变未来用户状态,任务价值要在整段对话上累计,模型切换会改变缓存复用与实际成本。它用 MCTS 在离线模拟环境里寻找高回报路径,再通过行为克隆和检索式未来状态近似,把规划知识压进一次在线分类。
最关键的设计不是“给路由器看完整历史”,而是让监督信号来自长期结果。检索后继状态进一步给轻量策略提供一个便宜的未来锚点,门控则承认这个锚点可能出错。成本函数把输入、输出、缓存命中和切换序列放进同一目标,避免把多轮账单误算成若干独立调用。
它仍不是开箱即用的全局最优调度器。真实部署必须补上检索拒绝、轨迹版本化、服务健康与延迟状态、安全硬约束,以及基于真实缓存命中和账单的成本校准。DialRouter 提供的是一种重要的系统抽象:路由不只是判断当前问题难不难,而是在有限预算下选择一条更可能完成整段任务的模型路径。
参考资料
- From Myopic Selection to Long-Horizon Awareness: Sequential LLM Routing for Multi-Turn Dialogue
- DialRouter 论文 HTML 全文与官方图表
- RouteLLM: Learning to Route LLMs with Preference Data
- RouterBench: A Benchmark for Multi-LLM Routing System
- BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- MTRouter: Cost-Aware Multi-Turn LLM Routing with History–Model Joint Embeddings
- SeqRoute: Global Budget-Aware Sequential LLM Routing via Offline Reinforcement Learning
- OpenAI Prompt Caching documentation
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



