


CHAI 完全拆解:运行时聚类注意力头,免重训压缩 KV Cache 与计算
问题不在头数,而在重复做了多少遍
CHAI(Clustered Head Attention)由威斯康星大学麦迪逊分校与 Meta FAIR 团队提出,发表于 ICML 2024。它针对的不是训练阶段,也不要求修改权重后再微调,而是一个纯推理时优化:先观察当前请求中各注意力头产生的注意力分布,把行为相近的头聚成一组;之后每组只让一个代表头计算 Query–Key 分数,再把这份分数复用给组内其他头。
这个表述里有三个容易混淆的边界。
第一,CHAI 聚类的是“对 token 的关注方式”,不是直接比较 、 或 权重是否接近。两个权重矩阵相差很大,仍可能在某段具体上下文上产生相似的注意力概率;反过来,离线平均行为相似的两个头,也可能因请求内容不同而分开。
第二,CHAI 并不把整个头删掉。它复用的是由 产生的注意力分数,Value 路径仍然保留。论文的附加实验恰恰表明:若连代表头的 也一起复用,LLaMA-7B 在 ARC-Challenge 上会从 47.0 降到 41.29,在 PIQA 上会从 77.8 降到 61.93,质量损失明显扩大。
第三,“免重训”不等于“零准备工作”。一个新模型上线前仍需用一小批样本确定每层适合保留多少个簇;每个新请求到来后,还要用最初五个 token 的注意力分布识别当前请求的簇成员。CHAI 把昂贵、与模型绑定的“簇数选择”放到离线阶段,把必须理解当前上下文的“成员选择”留在在线阶段。
论文摘要称,多头注意力可能占模型内存与计算需求的一半以上。这个数字不是任何模型、任何批量下都成立的常数,但它抓住了解码阶段的核心矛盾:自回归生成一次只产生一个新 token,却要反复从显存读出历史上下文的 K、V。上下文越长,KV Cache 的容量与读取流量越难忽略。若多个头反复读取相似的 Key、算出相似的注意力分布,那么它们的独立性就值得重新审视。
CHAI 的实验覆盖 OPT-66B、LLaMA-7B 和 LLaMA-33B,以及 PIQA、HellaSwag、ARC-Challenge、ARC-Easy、BoolQ 五个任务。论文报告的最好结果是 KV Cache 存储需求降低 21.4%、推理延迟最高加速 1.73 倍,同时不需要微调。后文会把这些数字还原到具体实验口径,而不是把“最高值”当成普遍承诺。
从 MHA 到 CHAI:压缩对象究竟是什么
先把一层 MHA 拆成两次矩阵乘
设一层有 个注意力头,序列长度为 ,每个头的维度为 。对第 个头,标准缩放点积注意力为:
是查询, 是历史 token 的 Key 与 Value, 是因果掩码。Prefill 时通常有 ;逐 token 解码时 ,而 随生成过程不断增长。
第一步 回答“新 token 应该关注历史上的哪些位置”,输出一行 logits;Softmax 把它归一化为概率分布 。第二步 用这组概率加权汇总 Value,得到头输出 。多头结果拼接后再经过输出投影。
在逐 token 解码中,每层、每个 token 的两次乘法都大约需要 次乘加相关操作; 个头的注意力主体因而与 成正比。更麻烦的是,K、V 必须从显存读取。若元素占 字节,一层一个请求的标准 MHA KV Cache 容量为:
前面的系数 2 分别对应 K 和 V。这个公式也说明了为什么延长上下文、增加并发或扩大批量会直接推高显存需求。
相似的是注意力分布,不一定是输出向量
CHAI 的观察对象是 。若两个头 在当前上下文中满足 ,那么没有必要分别计算两次 。可以从这个簇选一个代表头 ,只计算:
然后令簇内每个头都使用 ,但仍乘自己的 :
表示代表头 所在的簇。这样做保留了 Value 子空间的差异:即使两个头看向相同位置,它们从这些位置提取的特征仍可能不同。CHAI 只近似“去哪里取”,没有强迫“取回什么”也完全相同。
论文以 LLaMA-7B 第 20 层为例画出两两头相关性。图中亮色方块意味着一组头对 token 的权重变化高度同步,作者指出头 12 与 26、头 20 与 25 分别形成相关簇,其余头构成另一组。这里的重点不是固定记住这几个编号,而是看到相关结构具有明显块状性。
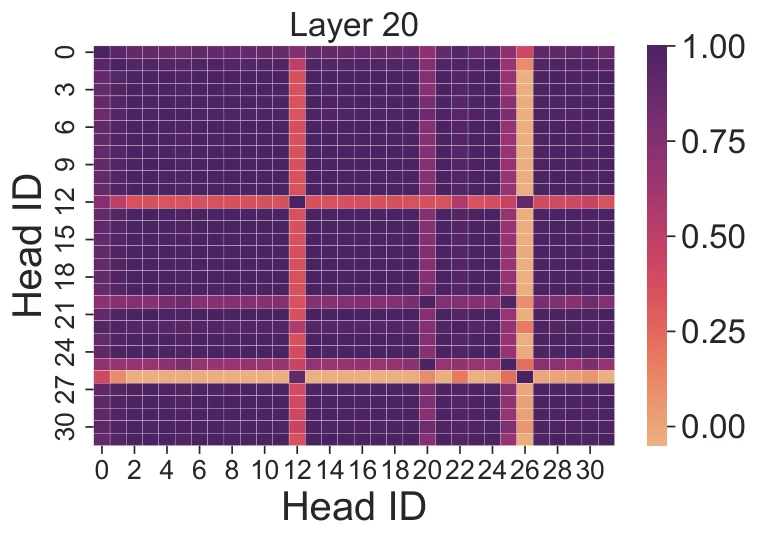
图源:CHAI 论文 arXiv HTML,Figure 2。横纵轴都是头编号,颜色表示两头注意力激活的相关程度。
这种冗余并非各层均匀分布。论文对 C4 的 1024 个样本统计后发现,较早层通常需要更多簇,后层相关性更强、可合并的头更多。因此,给所有层硬套同一个压缩率会把“层间差异”抹掉:保守设置浪费后层机会,激进设置又容易破坏前层信息。
CHAI 的完整推理流程
CHAI 把问题拆成三个阶段:离线确定每层簇数、在线识别当前请求的簇成员、在剩余推理过程中固定分组并复用注意力分数。
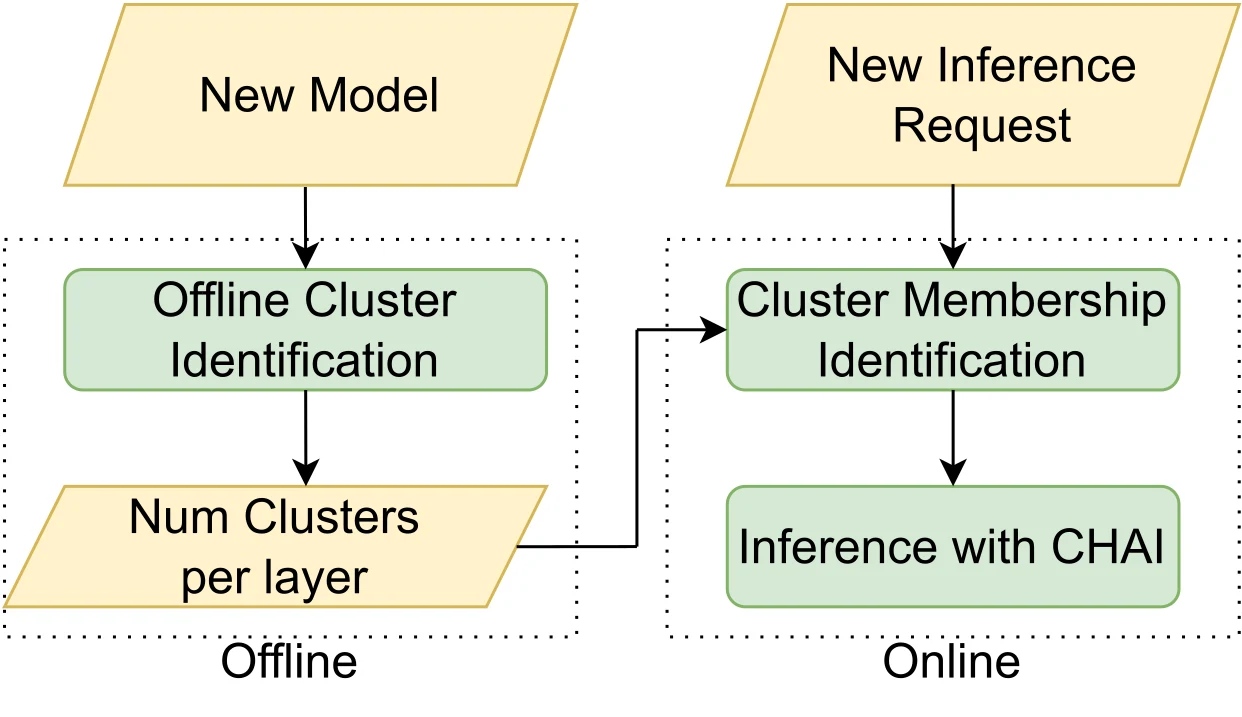
图源:CHAI 论文 arXiv HTML,Figure 5。蓝色虚线左侧只对新模型执行一次;右侧的成员识别则对每个新请求执行。
阶段一:每个模型离线决定每层保留多少个簇
论文从 C4 数据集中抽取 1024 个样本,收集各层注意力激活。对候选簇数 运行聚类,计算所有头到最近簇中心的平方距离之和:
是层编号, 是第 层第 个头在采样数据上的注意力特征, 是头 的簇标签, 是对应中心。 增大时误差必然下降;真正要找的是曲线由陡转缓的“肘部”,也就是再增加簇数只能换来很小误差改善的位置。
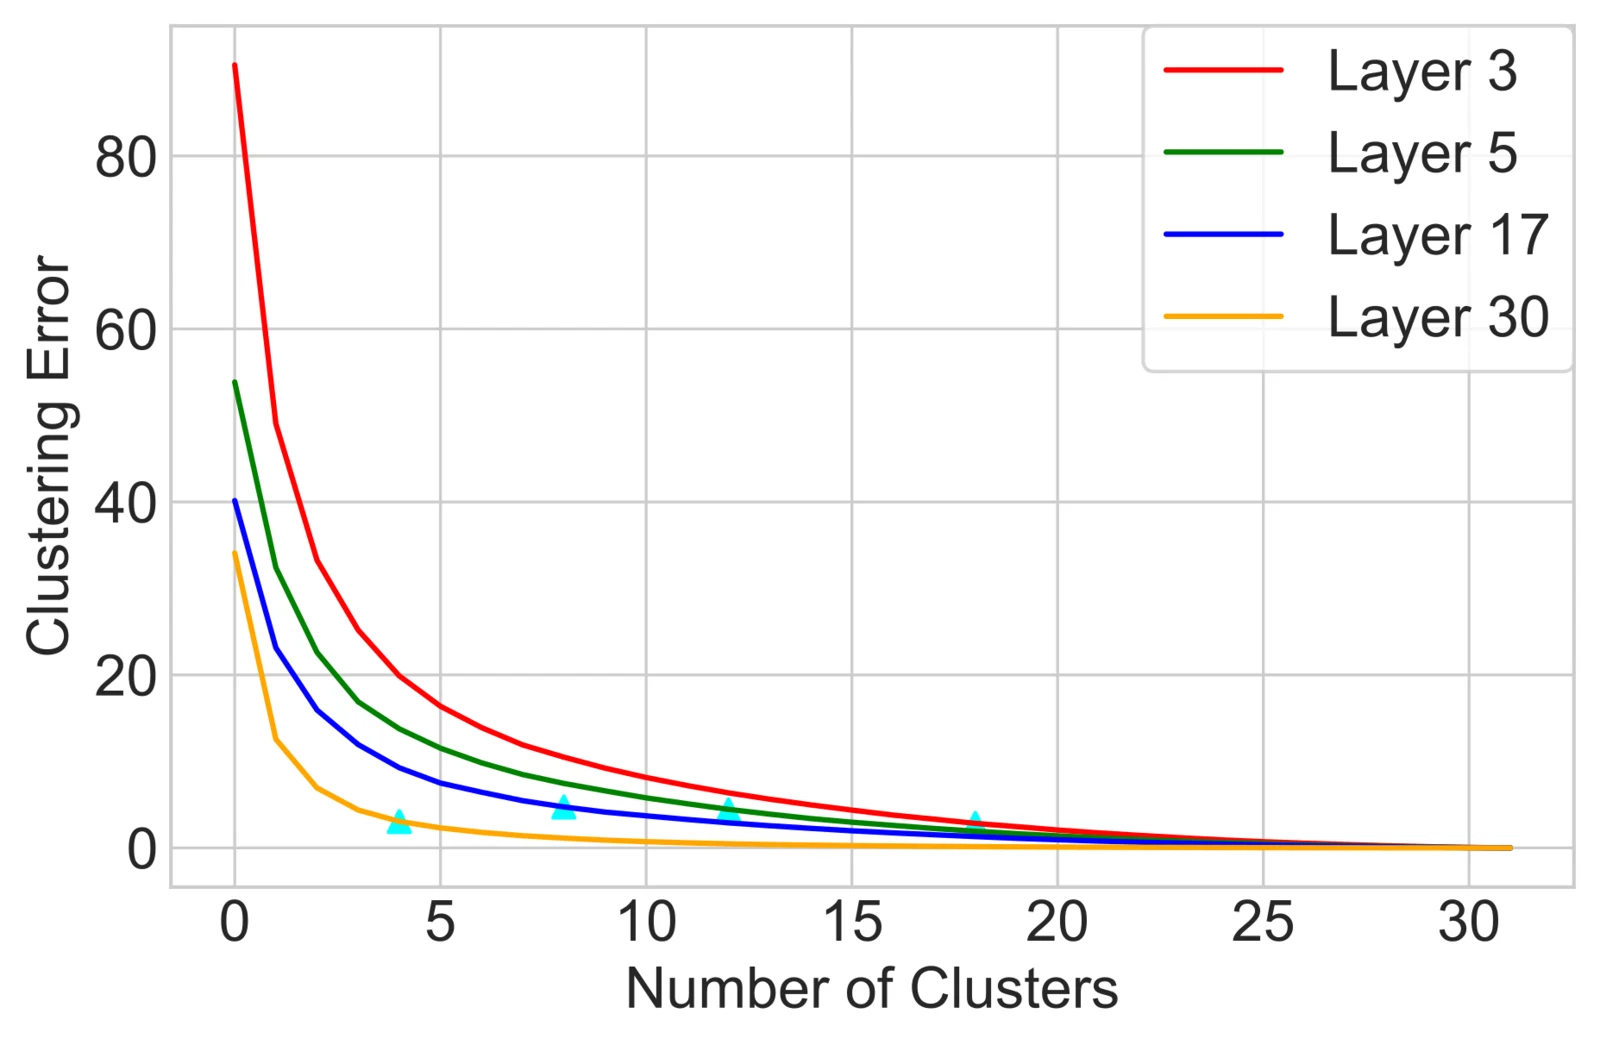
图源:CHAI 论文 arXiv HTML,Figure 8。各条曲线对应不同层,标记点是作者为该层选定的簇数。
这一步回答的是“这一层大致需要几种不同的关注模式”,它只与模型绑定,不随每个请求重做。公开仓库中的 LLaMA-7B 参数给出了一个很直观的例子:前 18 层保持 32 个头不合并,后 14 层每层只设 4 个簇。LLaMA-33B 的配置更细,从 48、36、24 逐步降到 8 和 6,体现越靠后的层通常越可压缩。
需要区分论文叙述和参考脚本的实现细节。论文写的是在 1024 个 C4 样本上分析;公开 perform_offline_clustering.py 的误差累积循环在读到第 500 条时停止,并对每层枚举 1 到 32 个 K-Means 簇。也就是说,仓库是便于复现思路的参考实现,不应把代码里的采样数和论文实验设置混为一谈。
阶段二:每个请求用最初五个 token 定簇成员
固定簇数还不够。假设某层离线决定用 4 个簇,仍需知道当前请求的 32 个头应该怎样分到这 4 组。若直接沿用 C4 上统计出的固定分组,就得到论文中的 CHAI-static;它忽略了提示词内容会改变头之间的相似关系。
CHAI 的在线策略是先按原始 MHA 处理最初五个 token,收集每个头的注意力概率,将每个头的五 token 注意力块展平为向量,再计算头间余弦距离:
当两头分布方向一致时,余弦相似度接近 1,距离接近 0。公开代码随后使用平均链接的凝聚层次聚类,把距离矩阵聚成该层预先指定的 个簇。论文正文将在线步骤概括为 K-Means;代码实际采用“余弦距离 + AgglomerativeClustering”。两者不影响三阶段设计,但复现时必须以所用版本和代码路径为准。
为什么是五个 token?这不是理论保证,而是作者的经验观察:随着用于识别的 token 数增加,后续解码中簇成员变化次数迅速下降;超过第五个 token 后,变化已经很少。更长的观察窗口可能更稳,却会推迟进入加速阶段;更短则容易把尚未稳定的头关系冻结下来。
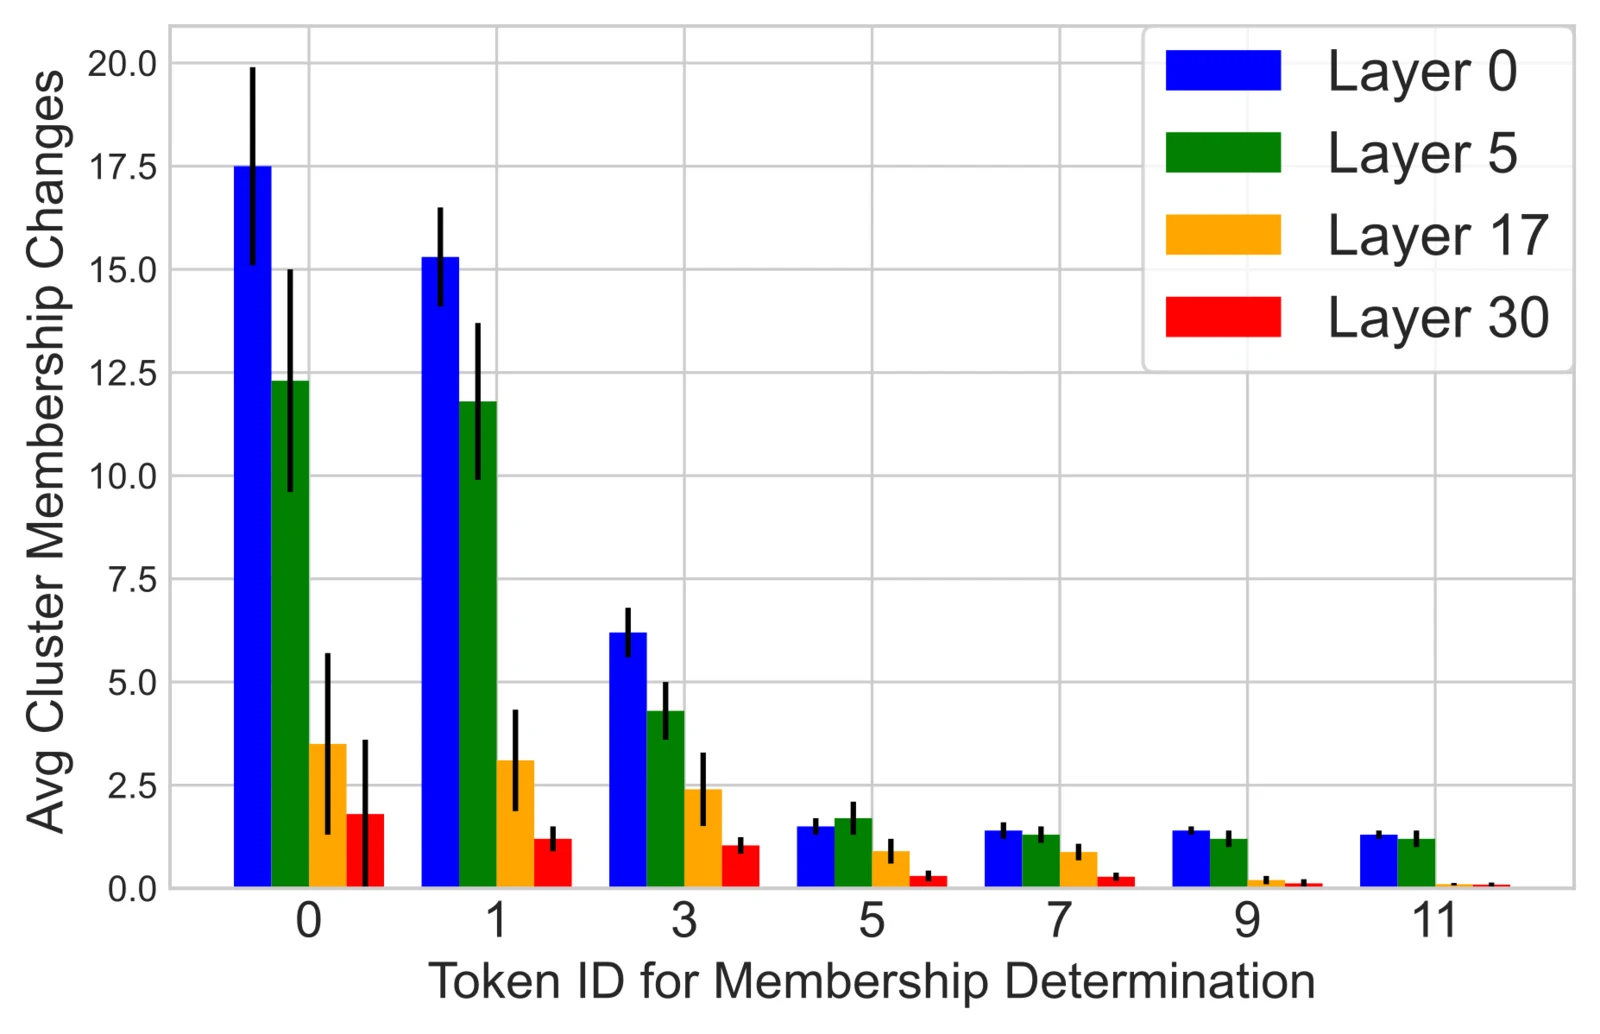
图源:CHAI 论文 arXiv HTML,Figure 9。曲线表达的是“用前若干 token 定组后,后续成员还会改变多少次”;五 token 是成本与稳定性的经验折中。
阶段三:固定分组,剩余 token 只算代表头的 Q–K
在线聚类完成后,CHAI 为每个簇选取一个代表头。公开实现直接取该簇成员列表中的第一个头,并保存分组映射。之后每个解码步只收集代表头的 Q、K,计算 份注意力 logits,再按映射把每份 logits 广播回簇内原始头;Softmax 后,每个头仍与自己的 V 相乘,最后按原模型的头顺序拼接并通过 。
用伪代码概括这一过程:
offline(model): for each layer l: collect attention patterns on calibration prompts choose cluster count G[l] from the elbow curve
serve(request): run ordinary MHA on the first five tokens for each compressible layer l: build pairwise cosine-distance matrix between heads grouping[l] = cluster(heads, n_clusters=G[l]) representative[l, g] = first_head(grouping[l, g])
for every later decoding step: compute QK scores only for representative heads broadcast each representative score to its member heads compute score_h @ V_h for every original head h这里没有改变模型权重,也没有额外训练一个预测器。近似误差只来自簇内头共享注意力分数;输出投影、MLP、归一化以及未被压缩的层都保持原样。
头相关性如何度量,聚类如何形成
为什么不直接聚类 Q、K 权重
若目标是减少当前请求中的重复注意力,最自然的特征应当是注意力分布,而不是静态权重。第 个头在输入隐状态 上产生:
即使 与 在参数空间相距很远,特定 仍可能使 与 指向相同 token。参数距离只描述两个线性变换本身,不能直接说明它们在当前上下文上的功能距离。CHAI 因而用激活驱动的聚类:先让模型真正处理一小段上下文,再判断哪些头可共享。
此外,Softmax 前后的相似性也不同。对任意一行 logits 加上同一个常数不会改变 Softmax;直接比较原始 可能把函数等价的两头判为不同。公开实现先计算 Softmax,再将五 token 对应的概率矩阵展平,这更贴近“最终关注哪些位置”的语义。
五 token 特征到底有多大
公开补丁从 Q、K 中截取前五个位置,计算形状为 的注意力概率,再将每个头展平成 25 维向量。对因果模型而言,矩阵上三角位置本来应被掩蔽;参考实现的这段聚类代码没有在 scores_four 内显式加入因果掩码,因此复现时还需检查底层输入排列和版本差异。一个更稳妥的生产实现应只把有效的下三角元素纳入特征,避免固定的无效位置主导相似度。
五 token 之所以便宜,是因为头数通常只有几十,构造 距离矩阵的 CPU 代价并不大。例如 时只有 1024 个两两关系。但在线路径会把激活从 GPU 搬到 CPU,并调用 SciPy 与 scikit-learn;单请求参考代码还能工作,高并发服务中却可能造成同步、PCIe 传输和 Python 调度开销。若要真正部署,应把距离计算和小规模聚类搬到 GPU,或至少异步批量处理多个请求。
平均链接层次聚类如何合并
凝聚层次聚类开始时把每个头视为一个簇。每轮选择平均距离最小的两个簇合并,直到只剩预定的 个簇。两个簇 的平均链接距离为:
单链接只看两个簇中最近的一对头,容易通过一串“局部相似”产生链式合并;全链接只看最远一对,可能过于保守。平均链接兼顾簇内整体相似性,而且不需要随机初始化。代价是它不是针对最终语言模型损失直接优化的:聚类空间里相近,不等于对最终 logits 的影响完全相同。
簇数与成员为何必须分开决定
离线同时固定簇数和成员最省事,却会退化为 CHAI-static。在线同时搜索最佳簇数和成员又太贵:每个请求、每层都要比较不同 的聚类误差甚至质量变化。CHAI 的拆分利用了两个不同时间尺度:
- 每层“能压缩到什么程度”主要是模型结构属性,跨请求相对稳定,适合离线决定。
- “哪些头这次表现相似”与上下文有关,必须在线决定。
这是一种常见的系统设计方法:把慢变化的容量参数离线化,把快变化的路由状态在线化。代价则是离线确定的 成为硬上限。如果部署流量与 C4 校准数据差异很大,例如代码、数学、超长检索或多语言请求占主导,固定簇数未必仍处在合适的质量点。
聚类后的注意力如何计算
设第 层有 个原始头,被分成 个簇。定义映射 ,表示头 属于哪个簇; 表示簇 的代表头。CHAI 先计算代表头 logits:
再把它广播给全部成员:
最后仍用每个头自己的 Value:
所有 按原始头顺序拼接,因此后续输出矩阵 不需要改形状。这个细节使 CHAI 可以插入现有 MHA 权重而不用重构检查点。
一个四头例子
假设原模型有四个头,在线聚类得到 、,代表头分别为 0 和 1。标准 MHA 会计算四组 ;CHAI 只计算头 0、头 1 两组,然后进行如下复用:
| 原始头 | 使用的注意力分数 | 使用的 Value | 是否保留独立输出 |
|---|---|---|---|
| 0 | 头 0 | 是 | |
| 1 | 头 1 | 是 | |
| 2 | 头 0 | 是 | |
| 3 | 头 0 | 是 |
因此,头 0、2、3 虽然看向同一组位置,但取出的内容分别经 表达,仍可形成不同输出。这也说明“Clustered Head Attention”比“头剪枝”更准确:被合并的头没有从输出通道中消失,只是共享了寻址权重。
代表头选择不是无关紧要的细节
公开代码取簇中第一个头作为代表。这种做法简单、确定,却不保证该头最接近簇中心。更严格的选择应使用 medoid,即让簇内总距离最小的真实头:
不能直接使用 K-Means 的虚拟质心,因为质心只存在于注意力特征空间,未必对应一组可从原模型中直接取出的 。选择 medoid 不需要合成新权重,也可能降低近似误差,但会增加一次簇内距离归约。论文没有报告这项消融,所以它是合理的工程改进方向,而不是 CHAI 已验证的结论。
Softmax 应在广播前还是广播后
同一个代表 logits 广播到多个成员后,掩码相同,理论上“先 Softmax 再广播”和“先广播再 Softmax”结果一致。公开实现选择后者:先把 份代表 logits 写回 个头的位置,再统一执行 Softmax。这样保持后续张量形状与原 MHA 一致,但也会重复做组内相同的 Softmax。
若要继续优化,可在簇维度完成一次 Softmax,再通过索引让多个 Value 头读取同一概率块。这样会减少 Softmax 计算与中间分数存储,但需要注意广播视图、内存布局和融合 kernel 的支持,否则索引开销可能抵消收益。
为什么它能同时减少 KV 存储与计算
KV Cache 为什么只省掉 K 的一部分
因为 CHAI 让簇内头共享代表头的 Q–K 路径,所以稳定分组后只需要为每个簇保存一份历史 K;每个原始头的 V 仍需保留。忽略前五个未压缩 token 和元数据,一层的缓存近似变为:
相对 MHA 的节省率为:
若 32 个头压成 4 个簇,单个已压缩层的理论 KV 节省率是 ,而不是 87.5%。后一数字只对应 K 头数量下降,不能用于包含完整 V 的 KV 总量。又因为 LLaMA-7B 配置只压缩后 14 层,整网节省会进一步被前 18 个未压缩层稀释。
以公开参数为例,假设所有层的头维度相同,LLaMA-7B 的整网稳定阶段理论节省率为:
这个粗略值与论文报告“最高 21.4%”处在同一量级,但不能据此反推论文测量方式完全相同:最初五 token、缓存分配粒度、张量并行切分和具体层配置都会影响实测值。
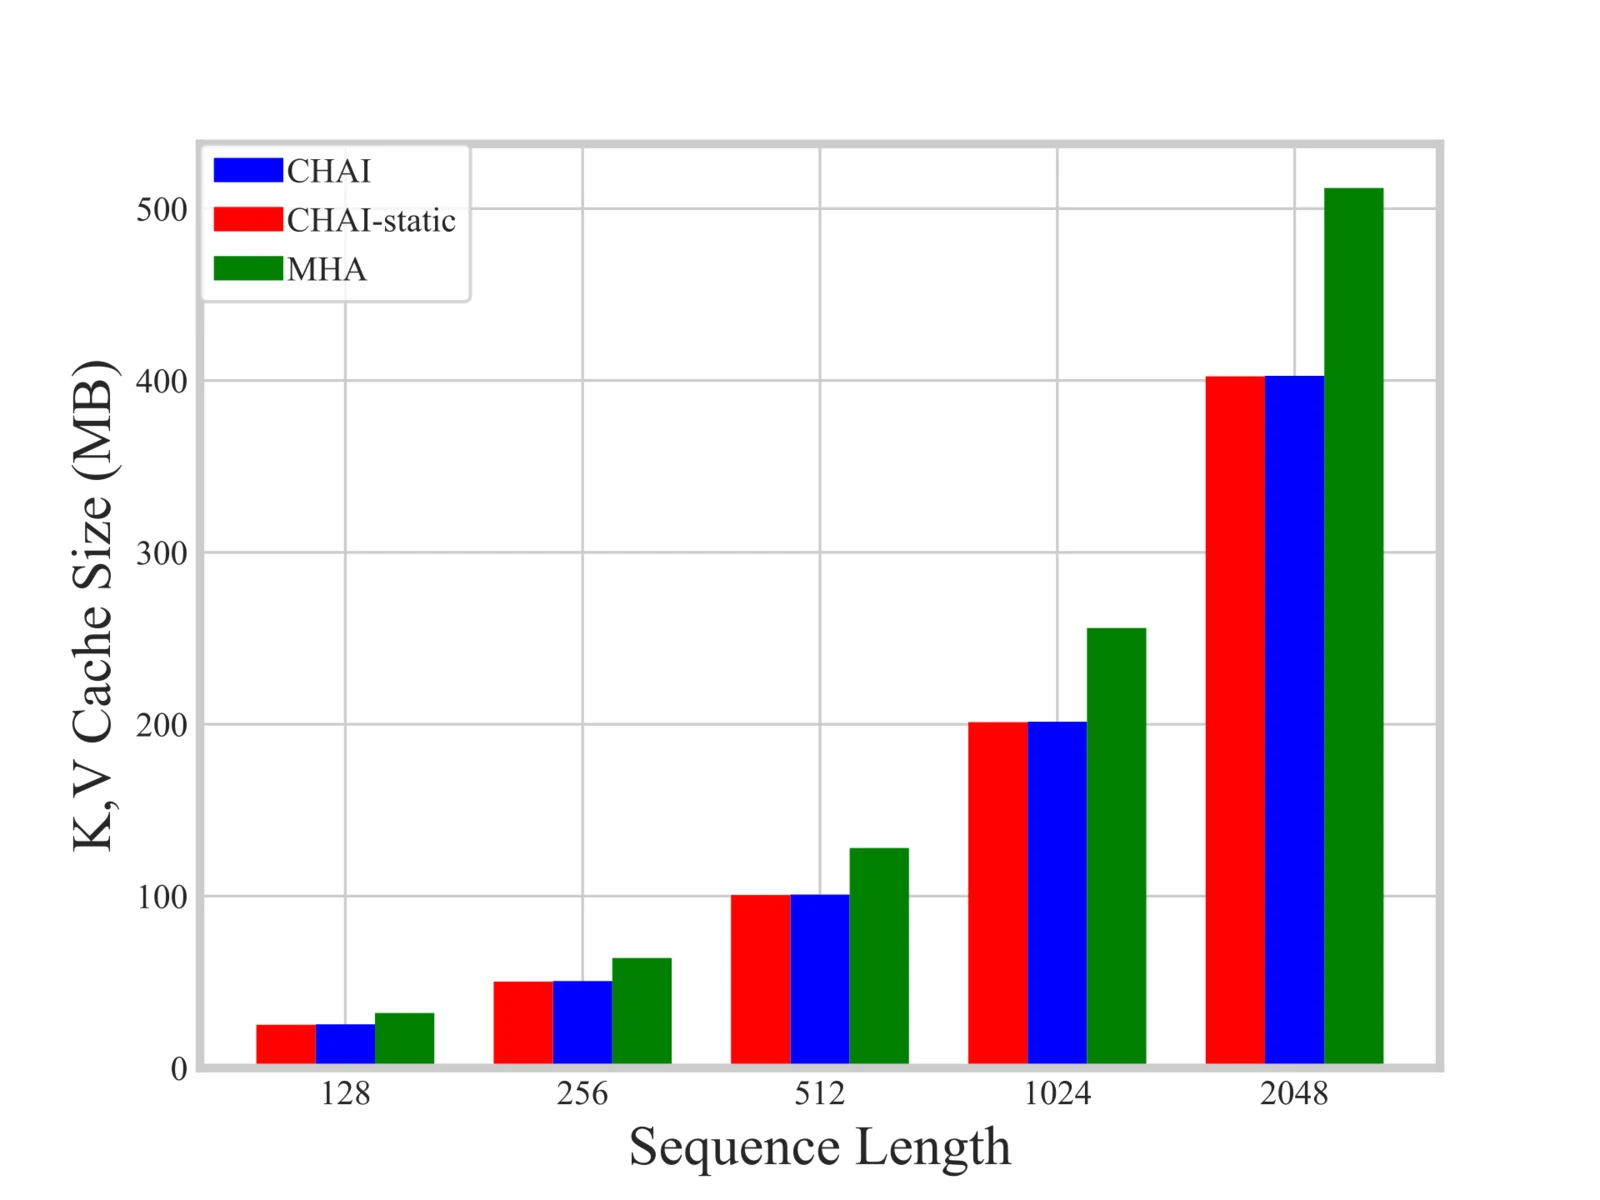
图源:CHAI 论文 arXiv HTML,Figure 11。图中给出不同序列长度下的缓存需求,论文报告最高节省 21.4%。
还有一个重要上限:由于 V 完全保留,即使 接近 1,单层 KV Cache 也最多接近减半。CHAI 的价值是免重训和同时减算,而不是像 MQA 那样把 K、V 头一起压到一个。
计算减少发生在哪一半
标准注意力对每头计算一次 和一次 。若把两者成本粗略看作相同,MHA 的注意力主体与 成正比;CHAI 则是 次 Q–K 加上 次 A–V:
理想化的注意力算术加速上限为:
32 头压成 4 簇时约为 1.78 倍。这个公式没有计入 Q/K/V 投影、输出投影、MLP、归一化、Softmax、聚类、索引和内核启动,所以不能直接当作端到端速度。另一方面,真实解码常受 HBM 带宽制约,减少 K 读取还可能带来超出纯 FLOP 比例的局部收益。
为什么结构化共享比任意稀疏更容易喂给 GPU
DejaVu 一类上下文稀疏方法会动态跳过头或 MLP 通道,常需要专门稀疏 kernel 才能把理论稀疏度换成时延收益。CHAI 保留下来的代表头仍可堆成规则的稠密张量,例如 与 ,因此核心 Q–K 仍是稠密批量矩阵乘。
不过,“仍是稠密计算”不等于“任何框架自动加速”。若实现先算出所有头的 Q、K,再逐头复制到新张量,或者把代表分数物化回完整 头张量,内存搬运会吃掉收益。真正高效的 kernel 应让簇索引进入数据布局:只加载代表 K,按簇计算概率,再让组内多个 V 头共享这份概率而不复制。
运行时系统如何落地
论文在 NVIDIA V100 上评测:LLaMA-7B 用单卡,LLaMA-33B 用四卡,OPT-66B 用单节点八卡,系统基于 Meta xFormers。这个实验环境说明结果来自较早一代 GPU 和 LLaMA 1 风格实现;将 1.73 倍直接外推到 H100、FlashAttention、PagedAttention 或现代连续批处理服务并不稳妥。
一条可部署的数据路径
生产实现至少需要以下状态:每层簇数 、每个请求每层的 head_to_cluster 映射、每簇代表头、压缩后的 K 页表,以及完整的 V 页表。请求生命周期可以这样组织:
- Prefill 的前五个有效 token 走普通 MHA,并暂存用于聚类的注意力统计。
- 在 GPU 上为各层构造小型头间距离矩阵,生成或查询簇映射。
- 对已产生的前缀 K 做一次压缩,只保留代表头;V 原样保留。
- 后续 decode 直接生成或写入代表 K,计算 份分数,再以只读共享方式供 个 V 头使用。
- 请求结束时,与 KV 块一起释放簇映射和代表头元数据。
步骤 3 很容易被忽略:如果先以完整 MHA 布局存下前缀 K,之后只是“逻辑上不用”,显存并不会自动归还。分页 KV 系统需要真的重排或重建 K 页面。关于分页块、块表和回收机制,可参考 PagedAttention 完全拆解;CHAI 若与分页缓存结合,块管理器还必须支持 K 与 V 不对称的头数和布局。
Prefill 与 Decode 的收益并不相同
论文把“前五个 token”描述为成员识别窗口,但真实服务的 prompt 往往一次 Prefill 几百到几千 token,而不是逐 token 喂入。若在完整 Prefill 结束后才聚类,已经支付了整段 prompt 的全头计算和 K 写入成本,只能加速后续 Decode;若要在 Prefill 中尽早切换,需要把 prompt 拆出一个五 token 探针段,这会引入额外 kernel launch,也可能破坏高效的大块 Prefill。
因此,工程实现要根据输入输出长度比选择策略:短 prompt、长生成更适合在线探针后长期复用;长 prompt、短回答则可能还没摊薄聚类和重排成本,请求就结束了。论文报告的序列长度趋势也显示,上下文越长,固定开销越容易被节省的注意力计算摊薄。
连续批处理下不能假设一个 batch 共用分组
CHAI 的簇成员依赖请求上下文。连续批处理中,同一 GPU step 内的请求 A、B 可能在同一层使用不同的 head_to_cluster。如果为了合并 kernel 而让整个 batch 共用一组簇,会退化成近似 CHAI-static;如果每个请求单独发 kernel,又会增加碎片和启动开销。
可行方向是按簇配置对请求分桶,或让 kernel 接受每请求索引表并通过 grouped GEMM/自定义注意力核处理异构映射。前者提高规则性,却会与 token 级调度争夺批处理自由度;后者保持调度灵活,但索引和负载不均衡更复杂。原论文以 batch size 1 的参考路径为主,没有解决现代服务系统的这一层问题。
公开代码说明了什么,也没有说明什么
Meta 公开的 facebookresearch/chai 仓库把逻辑补丁打到 LLaMA 1 的 Attention.forward。代码确实只对代表 Q、K 做主要 score 矩阵乘,再把 score 写回原头位置;但它仍先执行完整 wq、wk、wv 投影,预分配完整 cache_k 和 cache_v,并在每步构造新张量、运行 Python 循环。
所以该仓库更适合验证算法语义,而不是直接作为高吞吐服务内核。论文的“可降低 KV 存储”描述的是方法允许采用的压缩布局;仅运行参考补丁,不代表框架分配器里一定立刻少占相同百分比显存。复现实验时应分别测量:逻辑有效 K 元素数、PyTorch 实际分配显存、端到端吞吐和 token 延迟。
实验结果应当怎样解读
质量:动态分组明显优于静态分组
论文以原始 MHA 为绝对分数基线,其他方法报告相对变化。LLaMA-7B 的结果如下:
| 方法 | PIQA | HellaSwag | ARC-Challenge | ARC-Easy | BoolQ |
|---|---|---|---|---|---|
| MHA 绝对分数 | 79.8 | 76.1 | 47.5 | 72.8 | 76.0 |
| CHAI-static 变化 | -4.0 | -4.3 | -3.7 | -2.5 | -0.8 |
| CHAI 变化 | -2.0 | -3.2 | -0.5 | +0.3 | +0.1 |
同一个离线簇数下,利用当前请求前五个 token 重算成员,五项任务都比固定成员更好。这是 CHAI 最关键的消融:它证明“头冗余存在”还不够,冗余关系本身会随上下文变化。
LLaMA-33B 上,CHAI 相对 MHA 的五项变化依次为 0、-0.14、-0.21、+0.9、-0.04;OPT-66B 上为 -0.15、+0.1、+0.1、-0.1、-0.6。正变化不应解释为 CHAI 系统性提升能力,更可能是近似扰动、评测方差或离散题目命中变化。安全结论是:在论文选择的模型、任务和簇数下,动态 CHAI 大体维持了基线质量。
摘要写“最大 3.2% deviation”,表格中动态 CHAI 最大负变化确实是 LLaMA-7B HellaSwag 的 3.2 个百分点。正文另有一句“maximum degradation of 3.7% for CHAI”,这与同页表格更像是把 CHAI-static 的 ARC-Challenge 下降混入表述。引用时应明确是百分点变化,并优先给出具体表格,而不是用模糊的“准确率损失 3.2%”。
与运行时剪枝基线的比较也有口径限制。LLaMA-7B 上 DejaVu 10% 稀疏时,各项下降为 3.18 到 7.4 个百分点;稀疏度升到 30% 后,部分任务下降超过 18 个百分点。作者据此认为较新的参数高效模型上可利用的无结构稀疏更少。可是论文无法做硬件时延对比,因为当时 DejaVu 没有公开论文所用专用 kernel;这部分只能比较准确率与理论稀疏,不是严格的同系统性能对决。
内存:21.4% 是特定模型配置的最高值
论文称 LLaMA-7B 在序列长度 2048 时,KV Cache 约 1.2 GB,而模型权重约 12 GB;CHAI 的缓存需求最高降低 21.4%。缓存节省的价值不只在“同一个请求少占多少”,还可能转化为更长上下文或更多并发请求。
不过,是否真能多塞入请求取决于服务系统的瓶颈。若权重已占绝大部分显存且批量很小,释放几百 MB 未必改变可调度批量;若高并发下 KV 已成为主要占用,同样比例可能直接增加并发。分页粒度也会产生内部碎片,逻辑元素减少 21.4% 不保证物理页数量精确同比下降。
时延:区分 TTFT 与 TPOT
论文分别测量首 token 和下一 token。首 token 时延包含为上下文建立 KV Cache 以及聚类开销;下一 token 时延假设历史缓存已经存在,不计在线聚类。LLaMA-7B、序列长度 2048 时,论文图注报告首 token 最高约 1.73 倍加速,正文写 1.72 倍;下一 token 图注报告超过 5 倍。
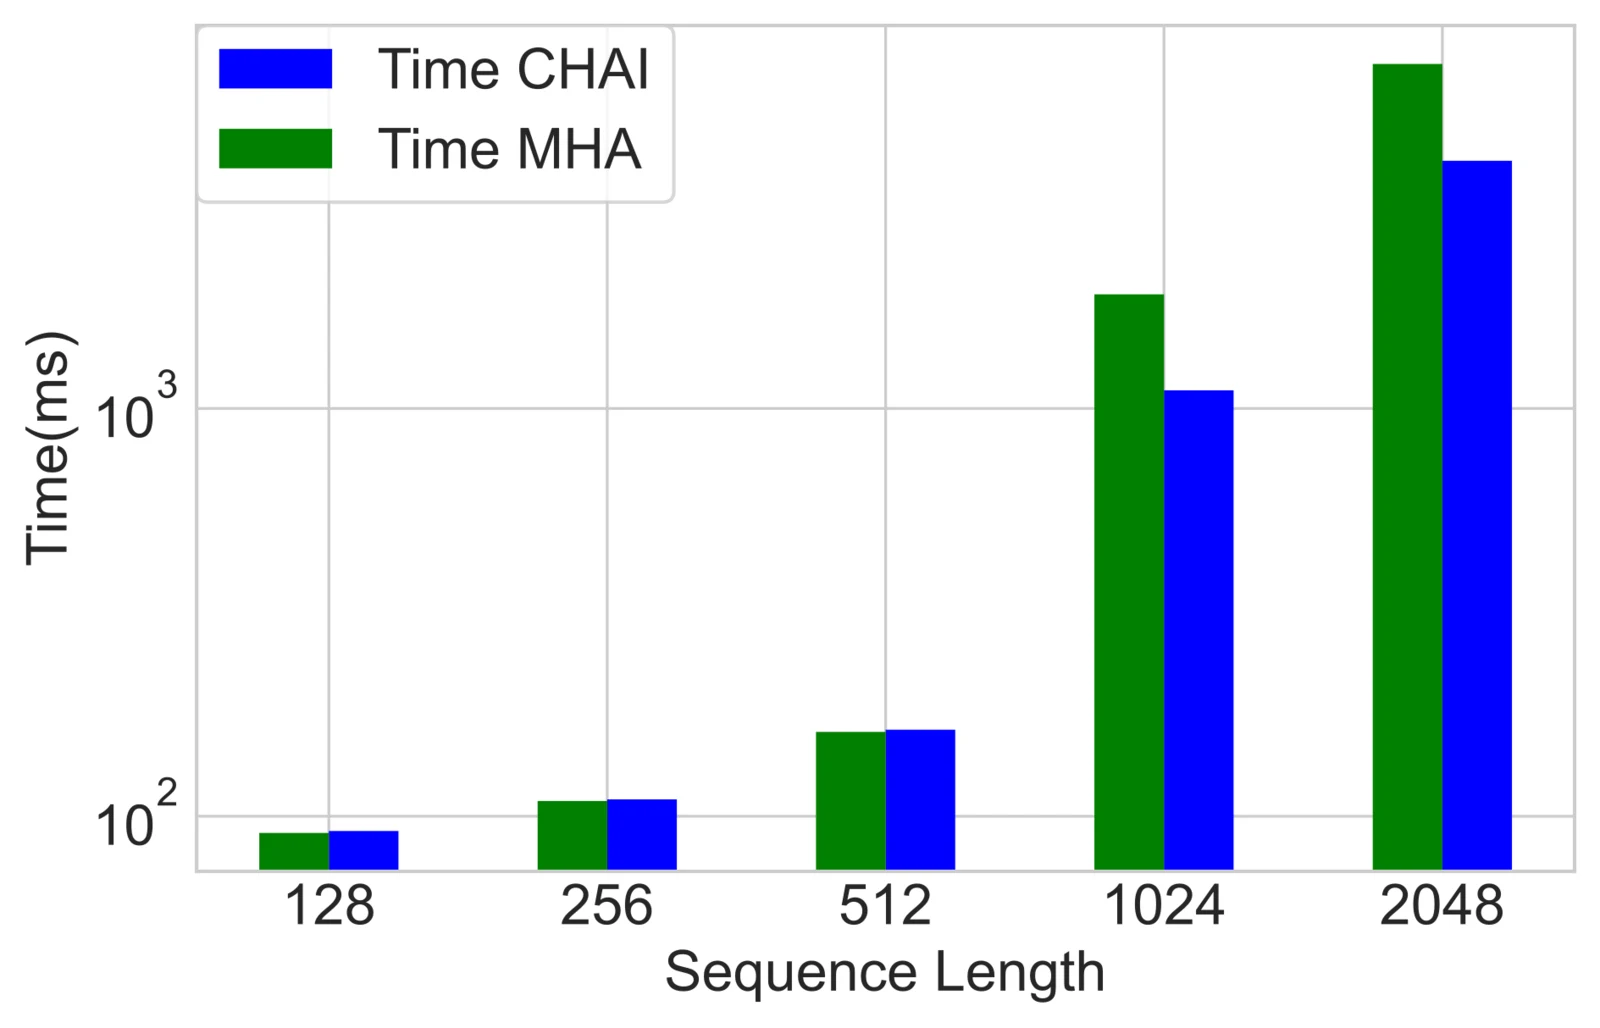
图源:CHAI 论文 arXiv HTML,Figure 12(a)。图中的 CHAI 时间已经包含聚类开销,序列越长,固定开销越容易摊薄。
“下一 token 超过 5 倍”不能和前面的简化算术上限直接比较。简化模型只统计 QK 与 AV 的乘加,真实实现还受 K 读取、临时张量、xFormers 路径和基线 kernel 效率影响。它也不是论文摘要采用的端到端主数字。部署评估时更应报告请求级 TTFT、每输出 token 时延(TPOT)、吞吐、峰值显存和批量,并在同一现代内核栈上重新测量。
实验没有回答的变量
论文的三种模型都是 MHA 架构,硬件是 V100,主要延迟图围绕 LLaMA-7B、batch size 1。以下变量没有得到系统覆盖:
- 多请求连续批处理时,每请求不同分组的 kernel 效率;
- 已原生使用 GQA/MQA 的模型还能否找到足够冗余;
- 32K、128K 等远长于 2048 的上下文中,前五 token 分组是否仍稳定;
- 代码、数学、多语言、检索增强生成等分布偏移;
- 与 FlashAttention、PagedAttention、量化 KV Cache 叠加后的真实收益;
- H100、Blackwell 等新硬件上,Tensor Core 与 HBM 比例变化带来的瓶颈迁移。
因此,论文数字证明了机制可行,不构成跨模型、跨硬件的性能保证。
与 MQA、GQA、头剪枝和稀疏注意力的边界
| 方法 | 共享或删除什么 | 分组何时决定 | 是否改权重结构 | 主要收益 | 主要代价 |
|---|---|---|---|---|---|
| MQA | 所有 Q 头共享一组 K、V | 模型设计时固定 | 是 | 极大压缩 KV、降低解码带宽 | 表达能力与质量权衡 |
| GQA | 每组 Q 头共享一组 K、V | 模型设计或转换时固定 | 是 | 在 MHA 与 MQA 间折中 | 需要适配检查点 |
| CHAI | 簇内共享注意力分数与 K,保留各自 V | 簇数离线、成员按请求在线 | 否 | 同时减 K 缓存和 QK 计算 | 近似误差与在线聚类开销 |
| 头剪枝 | 整个头及其输出被移除或跳过 | 静态或运行时 | 视方法而定 | 减少更完整的头计算 | 质量更敏感,常需稀疏支持 |
| Token/块稀疏注意力 | 每头只访问部分历史 token | 每步或分块决定 | 通常否 | 长上下文下大幅减少 KV 读取 | 选择器开销与召回风险 |
CHAI 与 GQA 看似相近,压缩轴却不同
GQA 让多个 Query 头从结构上共享 K、V 头,其分组对所有请求固定。CHAI 面向已经存在的 MHA 模型,在运行时发现哪些头的注意力分数可以共享;它保留每个头自己的 V,成员还会随请求改变。前者的优势是布局规则、缓存压缩更彻底;后者的优势是无需重做模型权重,能直接作用于现有检查点。
GQA 的完整机制与 KV 压缩比例可参考 GQA 完全拆解。若新模型从一开始就为高效解码设计,GQA/MQA 往往更容易进入成熟推理框架;若手上是无法重新训练或转换的 MHA 权重,CHAI 的部署切入点更直接。
CHAI 不是 Token 稀疏注意力
Quest 等方法在每个头内部选择少量相关 KV 页,压缩的是 token 维;CHAI 在头维聚类,但代表头仍可看完整上下文。两者理论上可以正交叠加:先按 CHAI 确定代表头,再为每个代表头选择 KV 页,组内成员复用页选择与注意力分数。
但组合误差不是简单相加。若代表头本来就只是簇内近似,再用其分数筛掉 token,少数成员头独有的重要位置可能被双重掩盖。Quest 的页级上界与查询感知选择可参考 Quest 完全拆解;组合系统需要专门评测“共享头选择是否降低成员头的关键 token 召回”。
CHAI 与 FlashAttention 解决的不是同一层问题
FlashAttention 保持精确注意力结果,通过分块与在线 Softmax 减少 HBM 读写;CHAI 改变需要计算的头集合,是近似算法。理想实现可让 FlashAttention kernel 只处理 个代表 Q–K,再把概率用于 个 V 头。难点是现成 fused kernel 通常把 、Softmax、 连在一起,不会暴露可跨头复用的概率矩阵。要组合二者,可能需要新的不对称头 kernel,而不是简单套两个开关。
与整头动态剪枝的差别
若直接删除一个头,它的 输出也消失;CHAI 则保留 路径,输出维度和 输入不变。这种较温和的近似解释了其质量更稳,也解释了节省上限较低。CHAI 更像“聚类共享寻址”,不是“判定某些头完全无用”。
局限、风险与适用条件
五 token 稳定性是经验规律,不是正确性保证
后续生成可能发生主题切换、工具结果注入或长程检索,头之间的相关结构也可能变化。CHAI 在第五个 token 后冻结分组,没有漂移检测。若代表头逐渐偏离成员头,误差会一直累积到请求结束。
可行的保护机制是每隔 个 token 抽样恢复一次完整 MHA,重新估计簇内误差;当最大距离超过阈值时重聚类。这样会增加周期性开销,但能为长会话建立质量护栏。阈值、周期和回退策略需要按任务校准,论文没有提供现成答案。
校准数据决定簇数,存在分布偏移
论文使用 C4 来确定每层簇数,并明确不为下游数据集重新选择。实验中这种设置仍取得不错结果,但 C4 不代表所有生产流量。离线簇数过小会造成不可逆的信息损失,过大则收益不足。
更稳妥的上线方式是从真实、脱敏且覆盖主要请求类型的校准集估计误差曲线,并保留几档配置,例如保守、均衡、激进三种 。调度器可按 SLO 和任务风险选择配置,但不能在没有质量回归的情况下仅根据显存压力动态压缩。
代表头复用不是误差有界近似
余弦距离小只说明五 token 注意力向量方向相近,没有给出最终 logits 或生成概率的严格误差界。残差连接能缓冲一部分扰动,也可能让多层小误差累积。对需要确定性复现、严格概率校准或安全敏感的应用,应把 CHAI 视为有损推理模式,并保留原始 MHA 回退。
内存节省要求真正改变缓存布局
算法层说“只保留代表 K”很简单,服务层却要处理前五 token 的完整 K、后续 token 的压缩 K、V 的完整头数、张量并行分片和分页回收。若为了兼容现有 kernel 始终按 个 K 头分配,只是其中部分不再读取,容量收益为零。
尤其在张量并行中,某个簇的成员可能跨 rank。若代表头位于另一张卡,为共享 K 或 score 引入通信,节省的本地计算可能被跨卡传输抵消。一个实用约束是只在每个 TP rank 的本地头内聚类,代价是簇数可能增加、压缩率下降。
现代模型未必还有同样空间
CHAI 评测的 MHA 模型每层为每个 Query 头保留独立 K、V。现代开源模型大量使用 GQA、MQA 或 MLA,头维冗余已经在架构层被压缩。对这类模型再次做 CHAI,K 头数量更少,潜在缓存收益和聚类自由度都会改变。不能只凭 LLaMA-7B 的结果推断现有 GQA 模型也能省 21.4%。
最适合与不适合的场景
CHAI 更适合以下条件:现有模型是 MHA;无法承担权重改造;输出较长,足以摊薄五 token 聚类和缓存重排;显存或长上下文注意力是明确瓶颈;业务能接受经过验证的小幅近似误差。
它不太适合短请求、极小批量之外却没有异构分组 kernel 的服务、已使用少量 KV 头的模型,以及要求逐 token 概率与原模型严格一致的场景。最可靠的决策依据不是模型名称,而是四项实测:簇内相关性曲线、真实流量质量回归、物理显存变化和同服务栈下的端到端延迟。
小结
CHAI 的核心不是“注意力头很多,所以删几个”,而是把注意力头的工作拆成寻址与取值两部分:相关头可以共享 Q–K 寻址结果,但仍用各自的 V 提取内容。它用离线肘部分析为每层确定容量,用每个请求最初五个 token 识别上下文相关的成员,再在后续推理中固定分组。这样的拆分使既有 MHA 权重无需重训,也让 Q–K 计算和 K 缓存同时减少。
它的边界同样清楚。V 不压缩使 KV 节省存在约 50% 的单层理论上限;在线分组增加同步和实现复杂度;公开仓库主要验证算法语义,并未直接提供适配连续批处理、分页 KV 和现代融合注意力的生产内核。论文在 V100、三种 MHA 模型和五个零样本任务上的结果说明这条路线可行,但每个新模型、新任务和新硬件仍需重新测量。
从系统设计角度看,CHAI 最有启发性的地方是把冗余从“模型固有属性”改写为“模型层级约束 + 请求级状态”:簇数慢变化,成员随上下文快变化。它为免重训推理优化提供了一条中间路线,位置恰好介于固定 GQA/MQA 与逐 token 动态稀疏之间。
参考资料
- CHAI: Clustered Head Attention for Efficient LLM Inference(ICML 2024 / PMLR)
- CHAI arXiv 论文与官方 HTML 图表
- facebookresearch/chai 官方参考实现
- Attention Is All You Need
- Fast Transformer Decoding: One Write-Head is All You Need(MQA)
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- Deja Vu: Contextual Sparsity for Efficient LLMs at Inference Time
- SpAtten: Efficient Sparse Attention Architecture with Cascade Token and Head Pruning
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



