


GPU GEMM 优化完全拆解(四):tcgen05 与 Blackwell——矩阵单元如何变成一台挂载在 SM 上的独立处理机
回顾与路线图:从“调用指令”到“驾驶一台协处理器”
三部曲止步于 Ampere 时代的 mma.sync:warp 用 32 个线程集体调用一条指令,操作数来自寄存器或共享内存,累加器也回到寄存器。到 Hopper,wgmma 把操作数搬进共享内存、把发起者扩成一个 warpgroup(128 线程),但累加器的归宿依旧是寄存器。Blackwell 的 tcgen05.mma 把最后两块牵绊也剪断了:累加器搬进一块物理上独立的 TMEM(Tensor Memory,每个 SM 256 KB),发起者收缩到一个线程。
前三篇一路走到 Hopper 的 wgmma:操作数从寄存器让给了共享内存,发起者从单个 warp 扩到 128 个线程的 warpgroup,异步流水线让搬运和计算重叠。但截至那时,累加器仍然必须回到寄存器文件。Blackwell(sm_100,2024 年)的 tcgen05.mma 把最后两块牵绊一起剪断:累加器搬进一块物理上独立的 TMEM(Tensor Memory,每个 SM 256 KB),发起者收缩到一个线程。
这一变化不是接口美化。它把矩阵单元从”warp 调用的一条指令”改造成”一台挂在 SM 上、自己带工作内存、由单线程下命令的协处理器”。理解这台协处理器的资源账本、命令格式与同步语义,是读懂所有 Blackwell 推理 kernel 的前提:FlashAttention-4 的前向流水线、DeepGEMM 的 FP8/FP4 主循环、CUTLASS 的 KernelTmaWarpSpecialized2SmSm100,写的都是同一套东西。
本篇要回答的问题:
- 为什么累加器必须离开寄存器文件?128×256 的 FP32 累加器在寄存器里到底占多少?
- TMEM 的 128 条 lane、512 个 column 怎么编址,为什么一个 warp 只能碰其中 32 条 lane?
tcgen05.mma的指令描述符(idesc)与共享内存描述符分别编码了什么?为什么形状表里的 K 随位宽变化?- 双 CTA(
cta_group::2)模式如何把一次 MMA 拆给两个 SM,A、B、D 分别怎么分? - 块缩放(block scaling)里,E8M0/E4M3 的 scale 为什么也住进 TMEM?NVFP4 与 MXFP4 差在哪?
- 一条 Blackwell GEMM 的 warp specialization 流水线长什么样,epilogue 为什么是新的瓶颈?
- 这些机制在推理负载上带来什么,又吃掉什么?
一、Hopper 留下的三个尾巴
把 Hopper 的 wgmma 拆开看,它已经解决了大部分问题:A、B 从共享内存直接读,不需要先搬进寄存器;一条指令由 warpgroup 集体发起,硬件负责整块矩阵乘;异步语义让它和 TMA 搬运重叠。但它留了三个尾巴,正好对应 Blackwell 的三处改动。
尾巴一:累加器还在寄存器里
GEMM 的累加器 D 是读写最频繁的数据。K 维每推进一个 tile,D 就要被读一次、写一次;一个 的 FP32 tile 有 32768 个元素。寄存器文件每个 SM 只有 64K 个 32-bit 寄存器(256 KB),这一个累加器就吃掉一半。剩下的寄存器还要装地址、索引、流水线状态和 epilogue 的临时值。于是 Hopper 时代的 kernel 必须在”更大的 tile(更高算术强度)“和”更少的寄存器压力”之间折中:tile 一大,occupancy 就塌,编译器开始 spill,性能反而掉。
Hopper 的解法是让 wgmma 直接把结果写进寄存器,靠”分散到 128 个线程”摊薄每线程的份额: 的 FP32 tile 摊到 128 个线程是每线程 256 个寄存器,正好顶到架构上限。这意味着一个 warpgroup 只能服务一个这样的累加器,别的活几乎没法干。FA3 的 ping-pong 调度之所以要两个 warpgroup 交替,本质上就是在绕这个上限。
尾巴二:发起必须是集体动作
wgmma 的发起单位是 warpgroup:128 个线程必须都到达,指令才生效。这带来两个约束。其一,生产者与消费者之间需要 wgmma.fence、wgmma.commit_group、wgmma.wait_group 一整套 warpgroup 级同步,任何一条线程走岔都会让整组卡住。其二,矩阵单元的工作节奏被 warpgroup 的调度绑架:矩阵乘在跑的时候,这 128 个线程不能去干别的重活,否则寄存器冲突。
尾巴三:没有 4-bit/6-bit 的原生路径
Hopper 的 FP8 是”最小的原生类型”。想把权重压到 4 bit,只能在 kernel 里先解包成 FP8 再送进矩阵单元,解包本身要走 SM 的整数/移位单元,反而把非矩阵单元变成瓶颈。而推理侧对 4-bit 的渴望是明确的:权重占了显存的大头,decode 阶段又是带宽受限,能把权重从 8 bit 压到 4 bit,等于把每 token 的权重流量砍半。
Blackwell 的三处改动与这三个尾巴一一对应:TMEM 接管累加器(尾巴一)、单线程发起(尾巴二)、kind::mxf4 / kind::mxf4nvf4 原生 4-bit 与块缩放(尾巴三)。三者不是独立特性,而是一套重新划分职责的方案:矩阵单元自己管工作内存、自己管执行、自己管反量化,SM 的通用资源被腾出来做别的事。
二、TMEM:把累加器搬出寄存器文件
2.1 结构:128 条 lane,512 个 column
TMEM 是每个 SM 上一块 256 KB 的专用片上存储,专为矩阵单元设计(第五代 Tensor Core),warp 只能通过 tcgen05.ld/st 显式读写它。它的组织方式是一个二维矩阵:
- lane:128 条,对应矩阵的 M 维(行)。一条 lane 横跨所有 column。
- column:512 个,每个 cell 32 bit。一个 column 在 128 条 lane 上各有一个 32-bit 单元,所以一个 column 是 。
于是总容量是 ,与官方口径一致。这个尺寸不是随手定的:一个 的 FP32 累加器正好填满;一个 的 FP32 累加器占一半,剩下的一半可以放第二个累加器(双缓冲)或 softmax 的中间结果。FA4 就是按这个思路分配 TMEM 的。
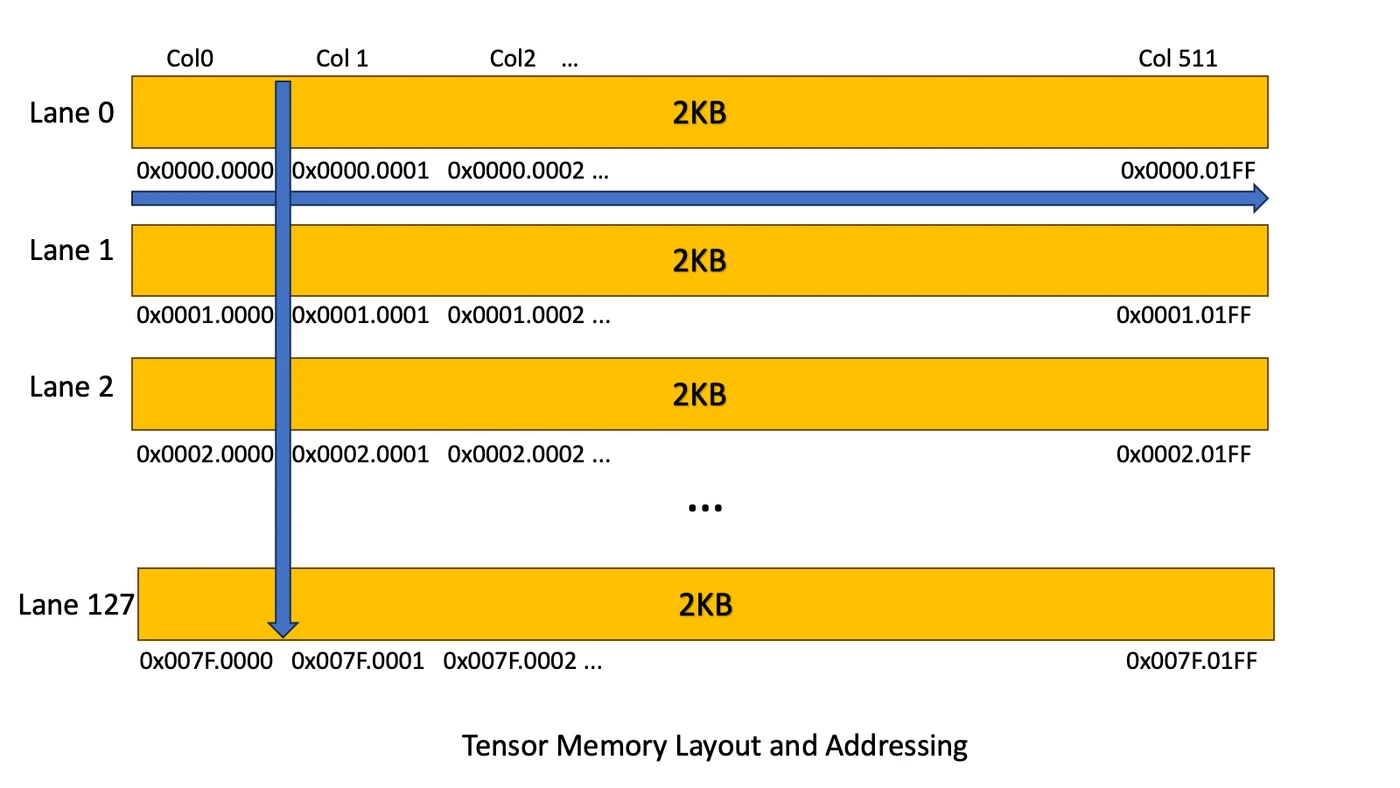
地址是 32 bit,高 16 位是 lane 索引、低 16 位是 column 索引。也就是说 TMEM 的”指针”不是字节地址,而是二维坐标打包:改 column 只动低半字,改 lane 只动高半字。CUTLASS 里 TMEM::DP 常量就是 ,用来在指针上做 lane 偏移。
2.2 为什么值得单独造一块存储
有人会问:共享内存也是片上存储,为什么不把累加器放共享内存?原因有三层。
第一层是访问频率。累加器在每个 K tile 上都被读改写,而 A、B 操作数每个 tile 只用一次。把最高频的数据放在离矩阵单元最近、且专供矩阵单元使用的存储里,比放在还要服务 TMA、epilogue、softmax 的共享内存里更划算。共享内存的带宽是所有 warp 共享的(FA4 的微基准显示 Blackwell 上仍是 128 B/clk/SM),矩阵单元如果和 softmax、TMA 抢同一份带宽,流水线就会互相踩。
第二层是寄存器压力。前面算过, FP32 累加器占半个寄存器文件。搬进 TMEM 之后,寄存器只用来做 epilogue 的搬运和地址计算,occupancy 立刻松绑,kernel 可以开更多 warp 做 TMA、做 softmax、做修正。
第三层是异步性。MMA 写 TMEM 不需要等寄存器写回,也不需要 128 个线程同时在场。矩阵单元可以连续发多条 MMA,把结果一块块叠进 TMEM,而 SM 的 warp 继续跑自己的事。这正是 FA4 能在前向里把 softmax 和 MMA 真正重叠起来的物理基础。
2.3 分配协议:32 列为单位,必须是 2 的幂
TMEM 是动态分配的:kernel 启动时并不知道自己要用多少,必须显式申请与释放。
tcgen05.alloc{.exclusive}.cta_group.sync.aligned{.shared::cta}.b32 [dst], nCols;tcgen05.dealloc{.exclusive}.cta_group.sync.aligned.b32 taddr, nCols;tcgen05.relinquish_alloc_permit.cta_group.sync.aligned;规则很具体,也很容易踩坑:
- 分配单位是 32 个 column(16 KB),一次分配必须覆盖全部 128 条 lane。不能只申请”半条 lane”。
- 非独占模式下
nCols必须是 2 的幂,范围 。也就是说可以申请 32、64、128、256、512 列,不能申请 96 列。想在 256 列的累加器之外再挤 96 列给 softmax 是不行的,只能拆成 64 + 32 两次分配。 - 分配指令必须由一个完整 warp 发起,且同一个 CTA 内多次分配必须由同一个 warp 执行。原因是 TMEM 的分配许可(allocation permit)是 CTA 级状态,多个 warp 并发申请会打乱顺序。
tcgen05.alloc是阻塞指令:没有足够的 column 时会一直等。这既是保护(不会静默失败),也是死锁来源——如果两个 warp 各自持有一半 TMEM 又都在等对方释放,就会卡死。因此真实的 kernel 里,TMEM 的规划是静态的:启动时一次性申请,运行期不再申请。- kernel 退出前必须显式
tcgen05.dealloc,否则硬件状态泄漏到下一个 kernel。这一点和共享内存完全不同:共享内存随 CTA 结束自动回收,TMEM 不会。 .exclusive模式用于”我要独占整块 TMEM”的场景(典型是单 kernel 占满 SM),它拿到 allocation permit 后其他分配一律阻塞,nCols放宽到 32 的任意倍数,sm_100 上限仍是 512。
申请结果不是返回值,而是写进共享内存的一个 32-bit 地址([dst])。于是典型序列是:warp 0 执行 alloc 把地址写进 shared,__syncthreads(),其他 warp 从 shared 读出这个基址再各自加偏移。CUTLASS 的 TMEM::Allocator1Sm 把这套协议封装成 allocate(nCols, dst_ptr),并在注释里把上述前置条件逐条写明。
2.4 访问限制:一个 warp 只能碰 32 条 lane
TMEM 虽然是一个 CTA 的资源,但 tcgen05.ld/st 的访问权限被切得很死:一个 warpgroup 的四个 warp 各自拥有 32 条 lane,warp 0 只能访问 lane 0-31,warp 1 只能访问 32-63,以此类推;但所有 column 都可以访问。
这条限制的工程含义很直接:TMEM 里的数据布局必须与 warp 的分工对齐。如果一个 的累加器要由 4 个 warp 协作搬回寄存器,天然的分法就是每个 warp 拿 32 行 × N 列。反过来,如果 kernel 想让某个 warp 处理”第 100 行”,它做不到——第 100 行属于 warp 3。这也是为什么 CUTLASS 的 TMEM epilogue 采用 “4 warp 各管 32 lane” 的固定分块,而不是任意切分。
分配时”整列分配”、访问时”按 lane 分权”,两条规则合起来决定了 TMEM 的使用范式:列是资源单位,lane 是权限单位。
三、tcgen05.mma:一条标量指令如何指挥一次矩阵乘
3.1 指令形态
最小的一条第五代矩阵乘指令长这样:
tcgen05.mma.cta_group.kind [d-tmem], a-desc, b-desc, idesc, {disable-output-lane}, enable-input-d {, scale-input-d};逐项拆开:
[d-tmem]:累加器 D 在 TMEM 里的地址(32 位坐标打包)。D 既是输入也是输出。a-desc/b-desc:64 位的共享内存矩阵描述符,描述 A、B 在共享内存中的起始地址、跨步与 swizzle 方式。注意这里给的是”描述符”而不是地址:硬件需要知道的不只是”从哪开始”,还有”行与行隔多远、按什么方式错位”。idesc:32 位的指令描述符,把 M、N、数据类型、主序、转置、是否稀疏、是否用块缩放等元数据打包进一个寄存器。{disable-output-lane}:可选的操作数,指定哪些 lane 不写回。用于 M 方向的边界 tile(行数不是 128 的整数倍时)。enable-input-d:谓词。为假时执行 ,为真时执行 。这就是”第一条 MMA 清零、后续累加”的实现方式。scale-input-d:可选立即数 ,把输入的 D 乘 。它只对kind::tf32与kind::f16有效,用途是 softmax 的在线重缩放——把”先乘旧最大值、再除新最大值”合并进 MMA 的累加项,省掉一次单独的 TMEM 读改写。FA4 正是靠这个机制把 softmax 的重缩放折进 MMA。
A 还有第二种来源:把 a-desc 换成 [a-tmem],即 A 直接从 TMEM 读取。这条路径在注意力里很有用: 的结果已经躺在 TMEM,紧接着 需要把 当 A,于是不必把 写回共享内存再读一遍。FA4 前向里 S/P 复用同一块 TMEM 区,正是这个用法。
3.2 单线程语义:谁发指令,谁不等结果
tcgen05.mma 是标量指令,具有单线程语义:一个线程执行它,整块矩阵乘就被启动;不需要 warp 内其他 31 个线程到场,也不需要 warpgroup 的 128 个线程同步。对比 mma.sync(warp 级集体)与 wgmma(warpgroup 级集体),这是一次彻底的角色变化:SM 上出现了一个”只负责下命令”的控制线程,矩阵单元则像 DMA 引擎一样自己干活。
这带来两个直接后果。
其一,发射成本几乎为零。一条 的 MMA 在硬件里要跑上百个周期,而发射它只用一条标量指令的槽位。控制线程发完就可以去轮询 mbarrier、准备下一组描述符、甚至去做 epilogue 的地址计算。
其二,同步责任转移给程序员。既然发起不是集体动作,硬件就不会替你保证”所有线程都到齐了”。操作数的可见性、TMEM 的读写顺序、mbarrier 的到达,全部要显式表达。这就是 tcgen05.fence 与 tcgen05.commit 存在的原因。
3.3 指令描述符:32 位里塞进一张”乘法合同”
idesc 是整条指令里信息密度最高的部分。按 PTX 与 CUTLASS 的位域定义,非块缩放版本的布局是:
| 位 | 字段 | 含义 |
|---|---|---|
| 0-1 | sparse_id2 | 稀疏 MMA 的 metadata 选择 |
| 2 | sparse_flag | 0 稠密,1 稀疏(仅 F16/S8/MXF8F6F4) |
| 3 | saturate | 是否饱和(仅 S8) |
| 4-5 | c_format | 0=F16,1=F32,2=S32 |
| 7-9 | a_format | A 的元素类型编码 |
| 10-12 | b_format | B 的元素类型编码 |
| 13 | a_negate | A 取负 |
| 14 | b_negate | B 取负 |
| 15 | a_major | 0=K-major,1=MN-major |
| 16 | b_major | 0=K-major,1=MN-major |
| 17-22 | n_dim | ,取值 1..32(即 N=8..256) |
| 24-28 | m_dim | ,取值 4/8/16(即 M=64/128/256) |
| 29 | k_size | 仅 MXF8F6F4 用:0=K32,1=K64 |
| 30-31 | max_shift | .ws 指令的最大滑动量 |
块缩放版本把 c_format 的位置换成了 b_sf_id,把 k_size 让给 a_sf_id,并在 bit 23 增加 scale_format(0=E4M3,1=E8M0)。也就是说,块缩放模式必须告诉硬件”scale 用哪种浮点格式”以及”用四组 scale 中的哪一组 ID”。
几个设计细节值得注意:
m_dim只允许 64/128/256。这不是编码偷懒,而是硬件事实:单 CTA 模式下 M 最大 128(128 条 lane),双 CTA 模式下 M 最大 256(两个 CTA 各 128 条 lane)。64 则是给较小 tile 或.ws模式留的档位。n_dim以 8 为粒度,因为 N 方向落在 TMEM 的 column 上,而 column 本来就是 32-bit 单元;N 的每一步对应 scale factor 的对齐要求。a_major/b_major只有部分类型支持 MN-major。FP4/FP6 这类窄类型只支持 K-major,因为它们的打包格式(两个 4-bit 挤进一个字节)是按 K 方向排的。这也是为什么 FP4 kernel 的权重布局通常要预先转置成 K-major。a_negate/b_negate是给量化推理用的:把”减去零点”或”取负”折进矩阵单元,省掉一次预处理。对称量化里 可以直接由 negate 位完成。
3.4 共享内存描述符:地址、跨步与 swizzle
A、B 的描述符是 64 位,字段与 Hopper 的 wgmma 描述符同源:
| 位 | 字段 | 含义 |
|---|---|---|
| 0-13 | start_address | 共享内存起始地址,低 4 位省略(即 16 B 对齐) |
| 16-29 | leading_byte_offset | 前导维跨步,低 4 位省略 |
| 32-45 | stride_byte_offset | 步长维跨步,低 4 位省略 |
| 46-47 | version | 描述符版本 |
| 49-51 | base_offset | swizzle 的基址偏移(3 位) |
| 52 | lbo_mode | 前导偏移模式 |
| 61-63 | layout_type | 0=无 swizzle,1=128B_base32B,2=128B,4=64B,6=32B |
三个偏移量都以 16 B 为单位编码,这解释了为什么 TMA 的 SMEM tile 必须按 16 B 对齐、swizzle 模式必须与 TMA 的 swizzle 设置匹配。layout_type 不是”性能选项”,而是正确性选项:TMA 往共享内存写数据时按 128 B swizzle 打散,MMA 读的时候必须用同样的打散规则还原,否则读到的矩阵是错的。这是 Blackwell kernel 最常见的 silent bug 之一——数值不对但不报错。
3.5 形状表:K 为什么随位宽变化
PTX 给出的合法形状可以归纳成一张表(单 CTA 模式,稠密):
| kind | A/B 类型 | M | N | 每指令 K |
|---|---|---|---|---|
f16 | f16/bf16 | 64/128 | 8..256,步长 8 | 16 |
tf32 | tf32 | 64/128 | 8..256,步长 8 | 8 |
f8f6f4 | e4m3/e5m2/e2m3/e3m2/e2m1 | 64/128 | 8..256,步长 8 | 32(K1=64 时仅 e4m3/e5m2) |
mxf8f6f4 | 同上 + ue8m0 scale | 128(单 CTA M 仅 128) | 8..256 | 32 或 64 |
mxf4 | e2m1 + ue8m0 scale | 128 | 8..256 | 64 或 96 |
mxf4nvf4 | e2m1 + ue8m0/ue4m3/ue5m3 | 128 | 8..256 | 64 或 96 |
i8 | s8/u8 | 64/128 | 8..256 | 32 |
K 的取值有一个清晰的规律:位宽减半,K 翻倍。f16 是 16 bit、K=16;f8 是 8 bit、K=32;f4 是 4 bit、K=64。为什么?因为矩阵单元的输入端口宽度是固定的:每个周期从共享内存吃进固定字节数的操作数。位宽越窄,同样字节数能装下的 K 越多。于是”一条指令”在硬件里处理的元素数量大致恒定,指令的周期数也大致恒定。
用峰值反推可以验证这一点。B200 的 BF16 稠密峰值是 2.25 PFLOPS,148 个 SM、约 1.85 GHz,折合每个 SM 每周期 8192 次运算(4096 次乘加)——FA4 论文给出了同样的推导。一条 的 MMA 是 次乘加,按 4096 MAC/clk 需要 128 个周期。再看 FP8:峰值翻倍到 8192 MAC/clk,而 K 翻倍到 32, 次乘加,仍然是 128 个周期。FP4:峰值再翻倍到 16384 MAC/clk,K=64, 次乘加,还是 128 个周期。
这里有一个口径需要说明:CUTLASS 文档把 kind::f8f6f4 标注为 “2x Hopper Fp8 Tensor Core”、mxf4 标注为 “4x Hopper Fp8 Tensor Core”,但没有给出这组倍数的统一基准。本文不用这组相对值,而是按 BF16 为 1x 的自身口径推导(BF16 = 1x、FP8 = 2x、FP4 = 4x),因为只有这个口径与形状表里的 K=16/32/64 严格对应。引用官方倍数时应当注明它相对的是哪一代、哪一种精度。
这条”128 周期”的规律说明:形状表不是随意列的,而是围绕”一条指令占满矩阵单元 128 个周期”设计的。对写 kernel 的人,它的实际含义是:指令粒度越宽,发射开销摊得越薄;但 K 越大,单个 tile 的 K 维跨度越大,共享内存里要预留的操作数缓冲也越大。CUTLASS 的 SM100 主循环里把”指令级 K”乘 4 作为 pipeline 的 K tile(文档里写成 4*MMA-K),就是在发射开销与缓冲深度之间取的折中。
3.6 完成与顺序:mbarrier、commit、fence
MMA 是异步的,但它的完成不能靠 tcgen05.wait——wait 只跟踪 ld/st。矩阵乘类操作(mma、cp、shift)的完成通过 mbarrier 观察:
tcgen05.commit.cta_group::1.mbarrier::arrive::one.shared::cluster.b64 [mbar];tcgen05.commit 让指定的 mbarrier 跟踪”本线程此前发出的所有异步 tcgen05 操作”,等它们全部完成后在 mbarrier 上做一次 arrive。于是消费者线程只需要 mbarrier.try_wait,就能知道”这块 TMEM 的结果可以读了”。.multicast::cluster 变体还能把这次 arrive 广播到 cluster 内多个 CTA 的 mbarrier 上——双 CTA 模式下, leader CTA 完成 MMA 后要同时通知 peer。
顺序上还有两个容易忽略的点:
tcgen05.fence::before_thread_sync/after_thread_sync。它们不等待完成,只做”代码移动屏障”:前者保证之前的 tcgen05 指令不会被重排到某个线程同步之后,后者保证之后的不会被重排到同步之前。当你用普通的内存 flag(而不是 mbarrier)在线程间传”TMEM 已就绪”时,必须成对使用,否则编译器和硬件都可能把指令挪过同步点。- 同一 warp 内的流水线配对。PTX 明确列出哪些指令对是”隐式流水”的:例如同一个 accumulator 地址上的
mma → mma(读 C 与写 D)保证按发射顺序访问 TMEM;而不同 warp 发出的指令永远不保证顺序。这条规则决定了一个基本设计:对同一块 TMEM 累加器的 MMA 必须由同一个线程(同一个 warp)发出。CUTLASS 的 2SM kernel 里,只有 leader CTA 的一个线程发 MMA,原因就在这里。
3.7 .ws 与 collector buffer:把 B 钉在矩阵单元里
除常规 MMA,Blackwell 还有一族 .ws(weight stationary)指令:M 只允许 32/64/128,N 只允许 64/128/256,但配了一个collector buffer。collector 是矩阵单元内部的 B 操作数缓存,用 .collector::bN::fill/use/lastuse/discard 控制:
fill:把这次从共享内存读到的 B 填进 collector #N;use:直接从 collector 读 B,不再访问共享内存;lastuse:读完这次就作废;discard:丢弃内容。
它的价值场景是同一组权重被多个 M tile 复用:卷积的 weight-stationary 数据流、以及 decode 阶段”权重固定、激活变化”的 GEMM。把小 M tile 沿 N 方向扫过去时,B 只从共享内存读一次,后面全部命中 collector,直接省掉共享内存带宽。这和推理侧 decode 的形态高度契合(batch 小、权重复用高),但代价是 M 被限制在 128 以内、且必须显式管理 collector 的生命周期。PTX 还提供 zero-column-mask-desc,可以按列屏蔽 B(相当于把某些输出列置零),用于变长或 padding 场景。
四、TMEM 的读写:epilogue 的新算法
4.1 数据搬运形状:lane × bit
tcgen05.ld/st 用”形状 + 重复次数”描述一次搬运:
- 形状
.32x32b/.16x64b/.16x128b/.16x256b/.16x32bx2,表示 lane 数 × 每 lane 的位数; .num表示沿 column 方向重复几次(x1..x128);.pack::16b表示把两个 16-bit 值打包进一个 32-bit 寄存器(读 FP16 累加结果时省一半寄存器)。
以 .32x32b.x1 为例:32 条 lane、每 lane 32 bit,即 32 个 32-bit 字,正好由 warp 的 32 个线程各拿一个。.16x256b.x1 则是 16 条 lane、每 lane 256 bit(8 个 column),共 4096 bit,摊到 32 个线程是每线程 4 个寄存器。通用的寄存器数公式是:
这条公式解释了为什么 epilogue 的 tiling 必须围着”寄存器预算”设计:.16x256b.x16 一次就是每线程 64 个寄存器,再来一组就顶到上限。
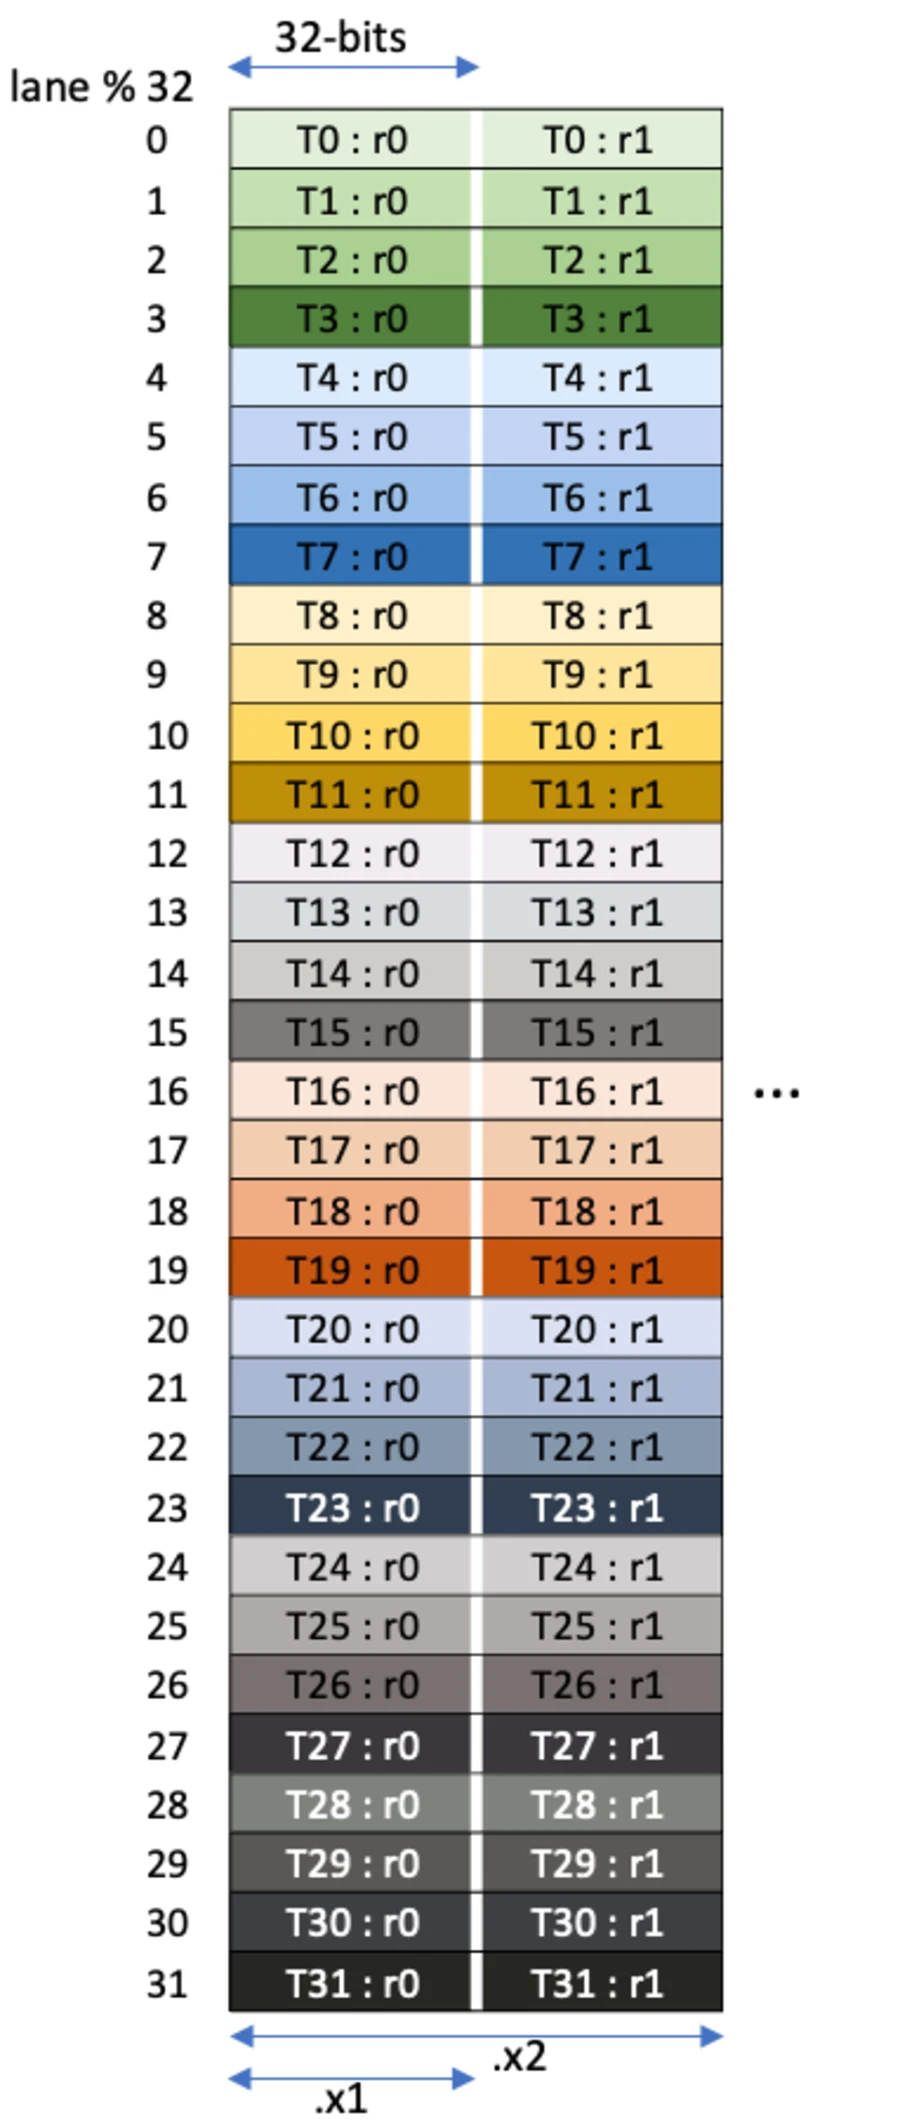
.16x32bx2 是个特殊形状:它做两次 .16x32b 访问,第二次的基址由立即数 immHalfSplitoff 给出。用途是把”同一批 lane 上两段不相邻的 column”一次读出来——典型场景是累加器分成两块(比如 S 和 P 各占一段)却要一起搬。
4.2 三个必须遵守的约束
taddr必须全 warp 一致,且必须是这次集体搬运的基址。每个线程自己算出的不同地址是未定义行为。- lane 权限:warp 只能访问自己那 32 条 lane(见 2.4)。因此一次 的 epilogue 必须由 warpgroup 的 4 个 warp 各搬 32 行,且每个 warp 的
taddr高 16 位要指向自己的 lane 段。 tcgen05.ld/st的完成靠tcgen05.wait::ld/::st,不靠 mbarrier。它们与mma/cp/shift是两套完全不同的完成机制,混用会读到半成品。
4.3 epilogue 的结构与瓶颈
一个典型的 Blackwell GEMM epilogue 是:
- 4 个 warp 各自
tcgen05.ld把自己那 32 条 lane 的累加器搬进寄存器; tcgen05.wait::ld;- 在寄存器里做 dequant(乘 scale)、bias、激活、类型转换;
- 按输出布局重排(TMEM 的 lane 是 M 维,输出可能是行主序也可能是列主序);
st.global或 TMA store 写回。
这条路径的代价常被低估。TMEM 的读带宽虽然高,但它是矩阵单元的专用存储,ld/st 与 MMA 共享同一套端口;当 epilogue 在搬上一块结果时,MMA 正在写下一块结果,两者会在 TMEM 上打架。于是生产 kernel 的常见做法是双缓冲累加器:一块在算、一块在搬,用 mbarrier 在两者之间切换。 的 FP32 累加器占 256 列,正好两块填满 512 列 TMEM;这也是为什么 Blackwell 上的大 tile kernel 往往把 N 定在 256 而不是更大——再大就放不下双缓冲了。
另一个变化是 epilogue 从”warpgroup 的事”变成”warp 的事”。Hopper 时代 epilogue 天然由参与 MMA 的 128 个线程完成(因为累加器就在它们寄存器里);Blackwell 时代 MMA 只由一个线程发起,epilogue 必须由另外的 warp 承担,否则控制线程会被搬运工作堵住。这就是 Blackwell warp specialization 里 “MMA warp / epilogue warp / TMA warp / softmax warp” 四分法的由来。
五、双 CTA:一次 MMA 拆给两个 SM
5.1 为什么需要跨 CTA
单 CTA 的 MMA 把 M 限制在 128(TMEM 只有 128 条 lane)。想让 M=256,有两条路:用两个累加器、发两次 MMA、再在 epilogue 里拼——但那样 B 操作数要被读两遍,共享内存流量翻倍;或者把 B 也切得更细——但 N 再大,TMEM 的 column 就不够。Blackwell 的答案是第三条路:让一对 CTA 协作完成同一次 MMA,两个 SM 的矩阵单元、两个 SM 的 TMEM 合起来当作一台更大的矩阵单元。
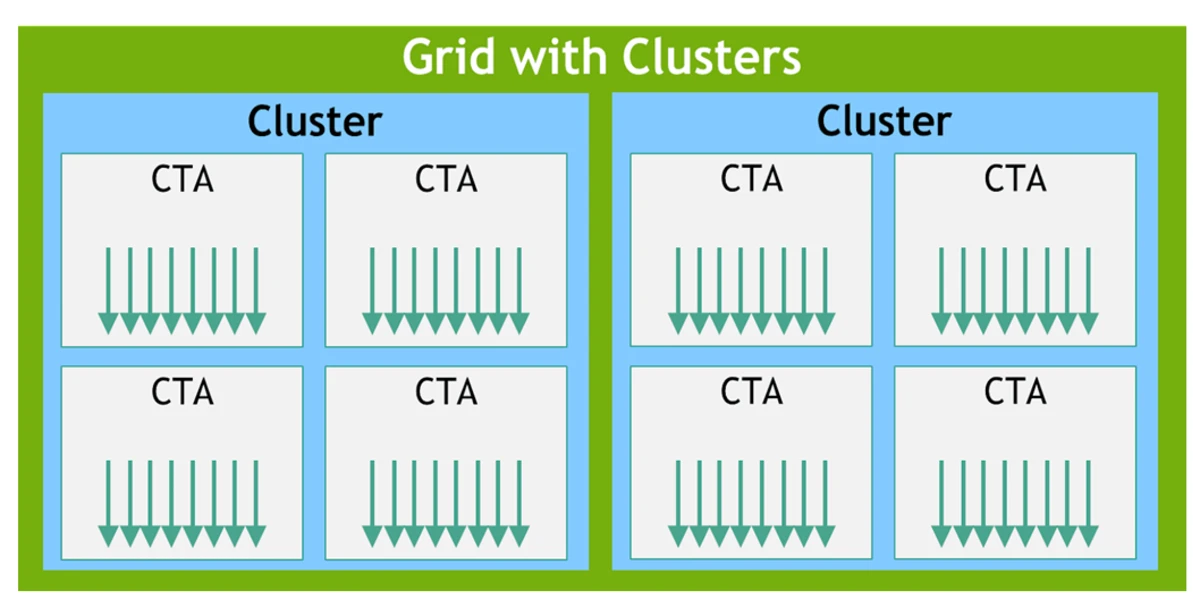
前提是 cluster:CTA 必须以 cluster 形式启动,一对 CTA 落在同一个 GPC 里,共享分布式共享内存(DSMEM),并保证”成对启动、保持存活”。这不是可选优化,而是硬约束——cta_group::2 的 MMA 只要 peer CTA 不在,就无从执行。
5.2 切分规则:A 与 D 沿 M 分,B 沿 N 分
FA4 论文对 2-CTA 模式给出了简洁的切分描述:A tile 与累加器沿 M 维劈成两半,各 CTA 各持有 128 行;B tile 沿 N 维劈成两半,各 CTA 只在自己共享内存里放一半的 B。硬件在乘法时把两个 CTA 的 B 拼成完整的 K×N 操作数。
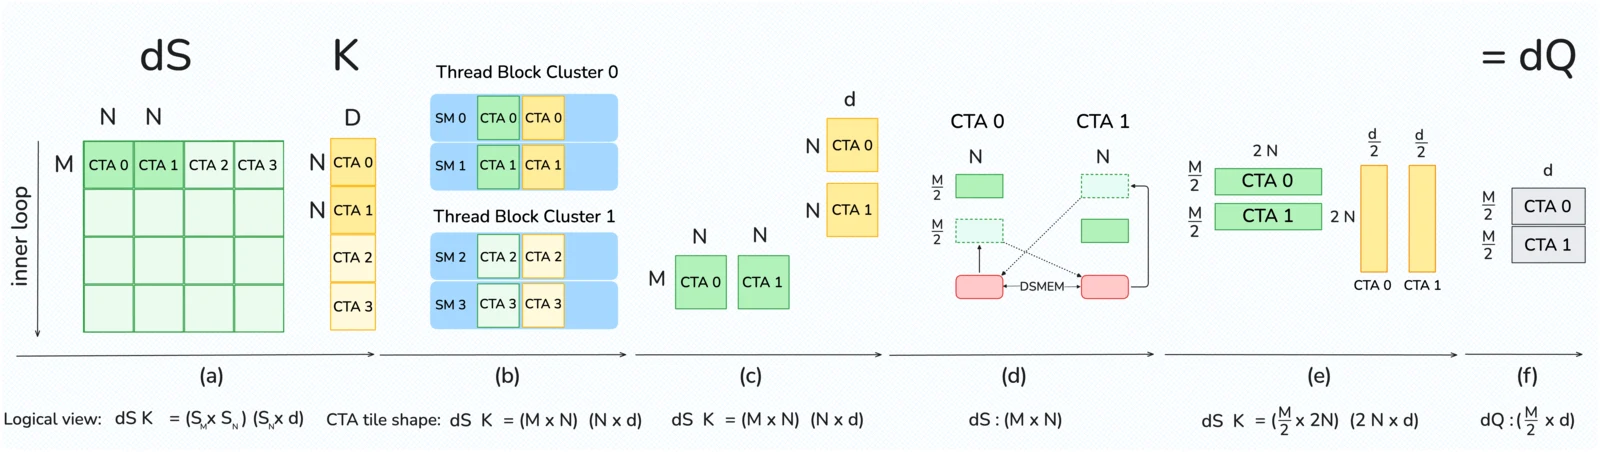
注意图中那个反直觉的细节:FA4 在 dQ 计算里,两个 CTA 先通过 DSMEM 交换了半个 dS。为什么?因为 dQ 的规约维是 N,而 2-CTA MMA 只切输出 tile、不切规约轴;each CTA 仍要为自己那 128 行做完整规约。于是 FA4 把 dS 重排成 的形状——行减半、列翻倍,让规约维上的两份数据都落在同一个 CTA 本地,规约就变成”同一行内相加”,不再跨 CTA。这是一个典型的工程判断:先接受硬件给的切分规则,再把数据重排成符合规则的样子。
5.3 收益与代价的量化
以 的 GEMM 为例,单 CTA 方案的 B tile 是 ,两个 CTA 都要完整读一遍 B,共享内存读流量为 个元素。2-CTA 方案里两个 CTA 各只放 64 列 B(),每个 CTA 只搬自己那半份,读流量等于 ,直接减半。在 FP8 下,一份 B tile 是 16 KB,减半即省 16 KB 的共享内存流量;放到整块 GEMM 的 K 循环里,这就是可观的带宽节省。
代价有三条:
- 必须成对启动。cluster 尺寸固定为 2 的倍数,调度器要能同时给出两个相邻 SM 的空位;在 SM 数量不被 2 整除、或资源紧张时,吞吐会受影响。
- 所有 tcgen05 指令必须统一
cta_group。PTX 明确规定,一个 kernel 内所有 tcgen05 指令的cta_group必须一致,不能”这里单 CTA、那里双 CTA”。于是 TMEM 分配、MMA、cp、commit 全部要按双 CTA 写,连 epilogue 的ld也要考虑 peers。 - TMEM 分配变成集体操作。
tcgen05.dealloc.cta_group::2在释放前要求两个 CTA 的 warp 先同步 TMEM 访问,否则结果未定义。
还有一个容易被忽略的收益:原子操作减半。单 CTA 方案里两个 CTA 各自持有部分 dQ,需要各自做一次全局原子加;2-CTA 方案把两个累加器在 TMEM 中合并后只需一次。FA4 在 dQ 步骤里明确利用了这一条。
5.4 什么时候不该用双 CTA
并非所有负载都值得。判据可以写成:N 是否足够大,使”省下的 B 流量”大于”cluster 调度与同步的开销”。当 N 很小(比如 decode 阶段的 GEMV,N=1),B 的 tile 本来就只有一个向量,减半无意义,反而引入 cluster 启动的额外约束。DeepGEMM 的 SM100 路径可以作为一个旁证:它要求 scale factor 以打包的 UE8M0 形式、按 TMA 对齐且转置的布局存放,并把 MXFP4/MXFP8 作为 SM100 的输入格式;这类大 tile 主循环面向的正是形成规模化 GEMM 的 prefill 形态,而 decode 的窄形态更依赖带宽而非矩阵单元。这种”按形态选模式”的思路在推理服务里非常普遍。
六、块缩放与 NVFP4:反量化交给矩阵单元
6.1 问题:4-bit 的 scale 放在哪
把权重压到 4 bit 不是难事,难点是精度:整张矩阵共用一个 scale,量化步长太粗;每个元素一个 scale,元数据又太大。折中方案是分块缩放(block / microscaling):每 32 个(或 16 个)元素共享一个低精度 scale,元素本身是 FP4,scale 是 E8M0(MX 标准)或 FP4 的 E4M3(NV 标准)。
计算上,这意味着 GEMM 变成:
其中 是 scale 向量长度(稠密时 32 或 16)。朴素实现要在 kernel 里先把 A、B 解量化成 FP8 再送 MMA——解包要走整数/移位单元,把本已吃紧的非矩阵资源再挤一遍。
6.2 Blackwell 的答案:scale 成为 MMA 的一类操作数
tcgen05.mma 的 block_scale 变体(kind::mxf8f6f4、mxf4、mxf4nvf4)直接把 scale 表当操作数:
tcgen05.mma.cta_group.kind.block_scale{.scale_vectorsize} [d-tmem], a-desc, b-desc, idesc, [scale-A-tmem], [scale-B-tmem], enable-input-d;关键点:scale 表住在 TMEM 里,以 TMEM 地址([scale-A-tmem])传入,而不是共享内存。为什么?因为 scale 表与累加器一样,是被高频、小规模访问的数据:每个 K tile 都要读一遍,但每次只读几十个字节。放在 TMEM 里既不占共享内存带宽,也不占寄存器,还可以和累加器共用 column 预算。CUTLASS 的 InstrDescriptorBlockScaled 里 scale_format_ 一位决定 E4M3 还是 E8M0,a_sf_id_ / b_sf_id_ 两位选择四组 scale 表中的哪一组——这意味着一个 kernel 可以同时持有四份 scale 表(对应 MX 的四个版本或不同分块粒度),在 K 循环里切换。
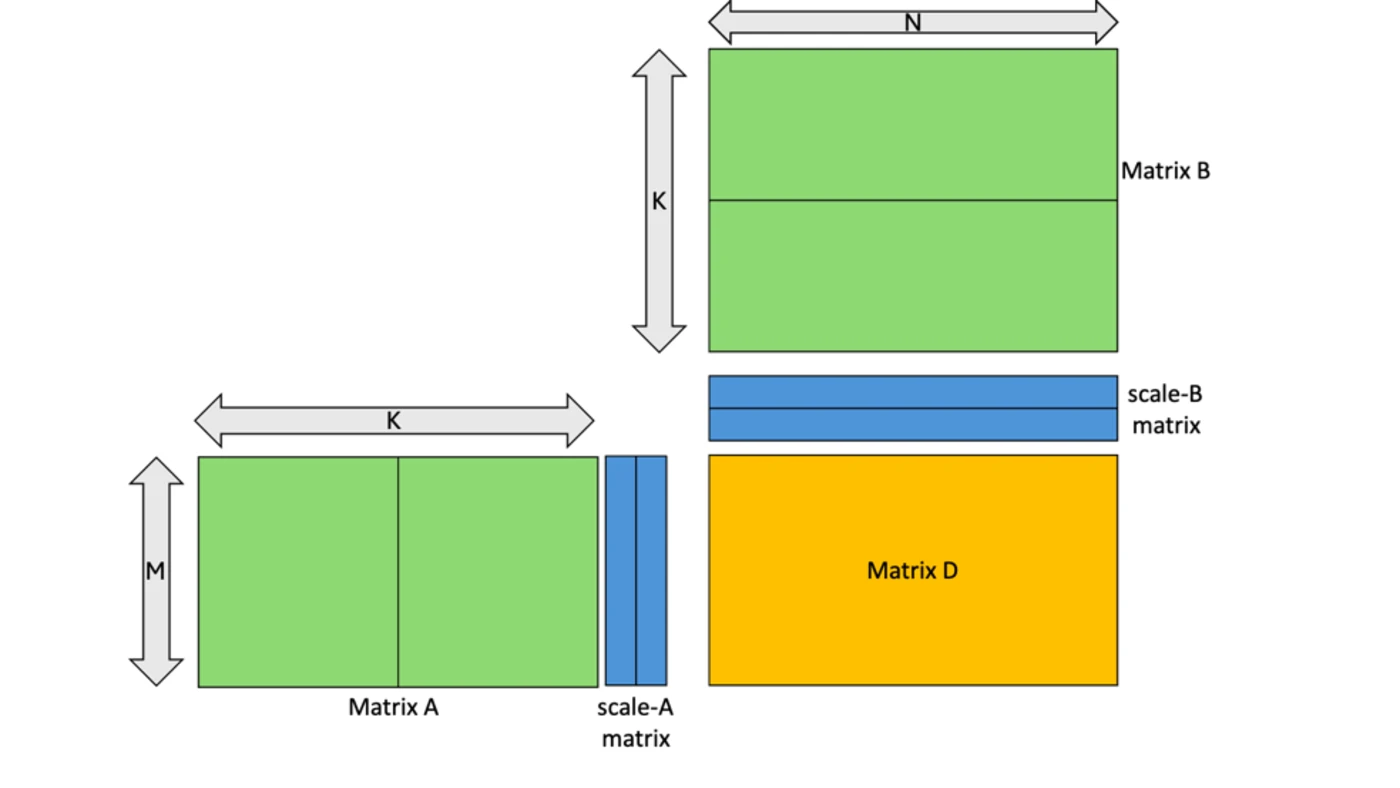
6.3 MXFP4 与 NVFP4:差在 scale 的位数与分块
两者用同一族 kind::mxf4nvf4 指令,差别在 scale 格式与向量长度:
| 方案 | 元素格式 | scale 格式 | scale 向量长度(稠密) | 是否 OCP |
|---|---|---|---|---|
| MXFP4 | E2M1 | E8M0(8 bit,纯指数) | 32 | 是 |
| NVFP4 | E2M1 | E4M3(8 bit,带尾数) | 16 | 否,NVIDIA 自定义 |
E8M0 只有指数、没有尾数,scale 只能是 2 的幂,粒度较粗;E4M3 有 3 位尾数,scale 可以取任意浮点值,精度更高。但 16 元素一个 scale 意味着 scale 表更大。这两点是相反的取舍:MXFP4 用粗 scale 换低元数据开销,NVFP4 用细 scale 换精度。
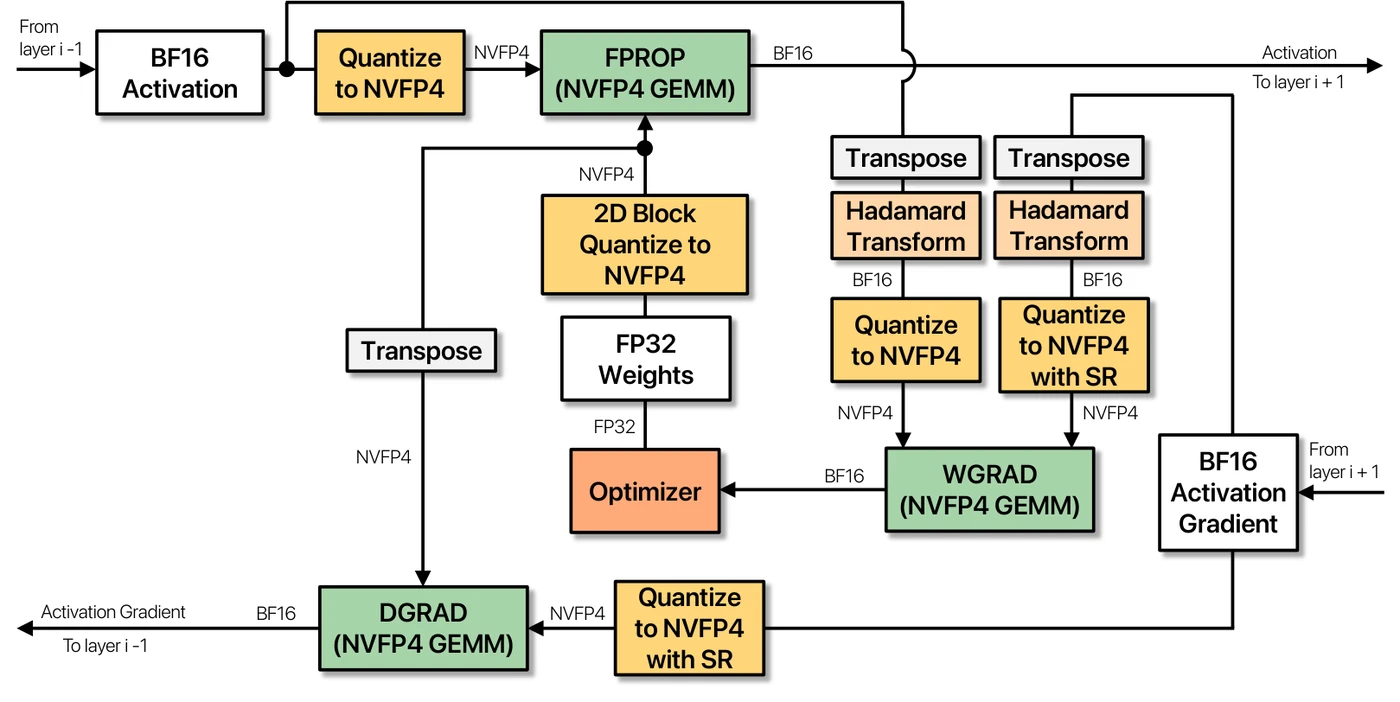
NVIDIA 在 2025 年发布的 NVFP4 预训练论文(arXiv:2509.25149)给出了这组设计的依据:4-bit 训练的难点不在矩阵乘本身,而在量化误差的统计性质。论文用两项技术处理它——随机 Hadamard 变换(RHT)把离群值摊平到各通道,随机舍入(SR)把舍入误差变成无偏噪声;同时 GEMM 内部保持 FP32 累加,误差只在输入量化那一刻引入。这一点与 Blackwell 的硬件能力直接相关:块缩放 MMA 的累加器始终是 FP32,CUTLASS 文档对此写得很明确(“Always float for block scaled tcgen05.mma instructions”)。也就是说,4-bit 输入的精度损失只发生在输入量化那一刻,累加环节不受影响。
6.4 稀疏与查找表解压:另外两个原生特性
同一个 tcgen05.mma 还带着两件对推理有用的东西。
结构化稀疏(.sp)。2:4 稀疏把 K 压缩 2 倍,K 相应翻倍(f16 稠密 K=16,稀疏 K=32)。它不是”跳过零”,而是硬件按固定的 2:4 模式取数,metadata 由 sparse_id2 选择。对推理来说,稀疏权重的价值在于”同样的显存装更多有效参数”,前提是模型在训练时已经按 2:4 剪枝。
查找表解压(.decompress::lut::b)。这是 Blackwell 上一个相对冷门但很有针对性的特性:B 以 3-bit 索引存储在共享内存,每 8 个列对齐的元素共享一张 8 项的查找表,表的内容(8 个 E4M3 值)放在 TMEM。硬件在做乘法时用索引查表得到 E4M3 元素,再送进矩阵单元。它的实际效果相当于”3-bit 权重 + 8 值码本”,与 XFP 这类质量地板驱动的自适应码本量化思路同源,只是把解压这一步挪到了矩阵单元内部。限制也很明确:B 不支持转置,只允许 E4M3,查找表的 TMEM 布局有特殊要求。
七、一条 Blackwell GEMM 的完整流水线
把前面所有机制拼起来,才能看清一个真实的 SM100 kernel 长什么样。以 CUTLASS 的 KernelTmaWarpSpecialized2SmSm100 为例(2SM、TMA、warp specialization),它的执行结构大致是:
- 启动阶段。两个 CTA 以 cluster=2 启动;leader CTA 的一个 warp 执行
tcgen05.alloc申请 TMEM(双缓冲累加器 + scale 表),地址写入共享内存;两个 CTA 交换 scale 表位置;tcgen05.relinquish_alloc_permit。 - 生产者(TMA warp)。按 K tile 顺序用 TMA 把 A、B 从全局内存搬进共享内存的多级 pipeline buffer,每级 buffer 用 mbarrier 标记”已满”。
- MMA 线程(leader CTA 单线程)。等待”满”信号,构造描述符与 idesc,发一条
tcgen05.mma.cta_group::2;在同一个 accumulator 上连续发多条,靠隐式流水保证 C 读 / D 写的顺序;发完一个 K 段后tcgen05.commit到一个 mbarrier。 - 消费者(epilogue warps)。等 commit 的 mbarrier,4 个 warp 各用
tcgen05.ld搬 32 行,tcgen05.wait::ld,做 dequant 与激活,TMA store 写回全局内存;随后通知 MMA 线程”这块 TMEM 可以复用”。 - 循环。TMEM 的双缓冲让第 3 步和第 4 步并行;共享内存的 pipeline 让第 2 步与第 3 步并行。三级流水(全局→共享、共享→TMEM、TMEM→全局)各自闭环。
这条流水线里有四个”谁来做”的决策,每一个都对应本系列前文的机制:
- 谁发 MMA:只能是一个线程,因为 TMEM 累加器的流水顺序只对同 warp 的指令有保证;
- 谁搬 epilogue:必须是另外的 warp,因为控制线程不能被搬运堵住;
- 谁管 mbarrier:生产者/消费者各自持有自己的 barrier,
tcgen05.commit只把矩阵乘的完成接到消费者那一端; - 谁分配 TMEM:只能是一个 warp,且必须是稳定的同一个 warp。
7.1 共享内存布局与 swizzle:正确性先于性能
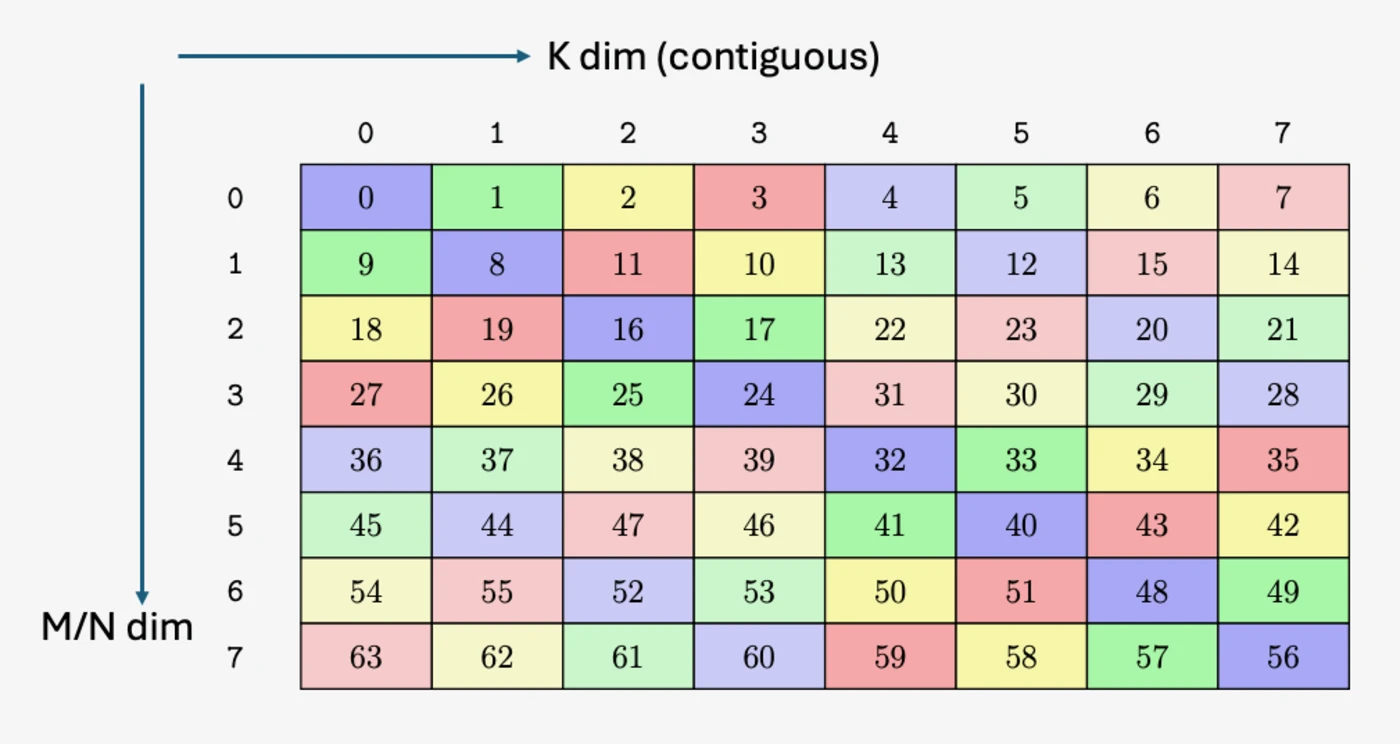
上图是 A 操作数在 128 B swizzle、K-major 下的排布。MMA 描述符的 layout_type=2(128B swizzle)必须与 TMA 的 swizzle 设置一致,否则矩阵单元读到的元素顺序与 TMA 写入的顺序不匹配。这种错误的特点很隐蔽:没有任何报错,只是结果错。调试时最快的判别方法是把 swizzle 关掉(layout_type=0)看结果是否正确,若正确再逐项对齐 swizzle 参数。
对于 FP4/FP6,还有额外的打包格式要求(PTX 的 “Packing format used for matrix A by .kind::mxf4” 等章节):两个 4-bit 元素挤进一个字节,且必须沿 K 方向排列。这意味着 NVFP4 的权重预处理(pack)必须按硬件期望的字节序做,否则硬件会把相邻两个 K 元素解读成错位。
7.2 与 Hopper 时代 kernel 的形态差异
| 维度 | Hopper(wgmma) | Blackwell(tcgen05) |
|---|---|---|
| 累加器位置 | 寄存器,分散在 128 线程 | TMEM,专用片上存储 |
| 发起单位 | warpgroup,128 线程集体 | 单线程,标量语义 |
| 最大原子 | m64n256(FA3 常用 m64n128) | m128n256 单 CTA,m256n256 双 CTA |
| K 粒度 | 16(f16)/ 32(fp8) | 16 / 32 / 64(fp4) |
| 4-bit 原生 | 无,需解包 | 原生 FP4/FP6 + 块缩放 |
| 完成机制 | wgmma.commit_group + wgmma.wait_group | mbarrier + tcgen05.commit |
| 寄存器压力 | 随 tile 增大而陡增 | 与 tile 大小解耦,epilogue 阶段才占寄存器 |
| 典型瓶颈 | 寄存器 spill、发射同步 | TMEM 读写与 MMA 争端口、epilogue 带宽 |
这张表解释了一个现象:Blackwell 上的算子重写,往往不是”把 Hopper 代码改几条指令”,而是重排整条流水线的所有权。FA4 之所以能同时把前向和反向都重做一遍,根源就在这里。
八、对推理负载意味着什么
8.1 谁直接受益
- 大 batch 的 prefill:M 由 token 数决定,动辄几千行;2-CTA 的 M=256 tile 与双 CTA 的 B 流量减半,直接把 prefill 的 GEMM 效率拉高。DeepGEMM 自 2025 年 7 月起同时支持 SM90 与 SM100,其 SM100 路径就建立在这套机制上。
- 长上下文的 attention:FA4 的前向与反向都依赖 TMEM 做 softmax 与 MMA 的交接。前向里 / 放在 TMEM,softmax warp 直接读写,省掉”经过共享内存”的往返;反向里 5 个 GEMM 的中间结果同样走 TMEM。共享内存带宽在 Blackwell 上并没有随算力翻倍,FA4 的 roofline 分析显示非 MMA 部分可以占到执行时间的 25%–60%,TMEM 的存在正是为了把这些流量从共享内存上挪走。
- 4-bit 权重的 decode:NVFP4 让权重从 8 bit 降到 4 bit,每 token 的权重读取量减半;块缩放把反量化折进矩阵单元,decode 时不再需要单独的 dequant kernel。对”显存容量决定并发数”的服务系统,这是实打实的容量收益。
- MoE 的分组 GEMM:每个 expert 的权重是固定的小矩阵,
collectorbuffer 与.ws模式可以减少同一份权重在多个 M tile 间的重复读取。
8.2 谁需要等待
- 小 batch decode 的 GEMV:N 很小,2-CTA 与
.ws的价值都下降;真正制约的是带宽,而不是矩阵单元。这类负载更适合单 CTA 路径、甚至非 Tensor Core 的专用 kernel。 - 消费级 Blackwell:数据中心级 B200/GB200 才有完整的 TMEM 与 tcgen05 路径,消费级 GPU 没有 TMEM,FA4 一类 kernel 无法直接跑。也就是说,同一份 kernel 代码要按架构分叉,这不是配置问题,而是功能缺失。
- 依赖旧指令的 kernel:
wgmma在 Blackwell 上仍可运行但被标记为 deprecated;对 MX-FP4 负载继续用它,峰值会被浪费掉相当一部分。
8.3 一个容易犯的直觉错误
很多人把 tcgen05 理解成”更快的 mma 指令”,于是按”换指令 → 变快”的线性思路做迁移。实际经验是:迁移的主要工作量在所有权重新划分——哪些 warp 管 TMA、哪个线程管 MMA、哪组 warp 管 epilogue、TMEM 怎么分段、mbarrier 谁持有。指令本身的替换只是最后一步。这也是为什么 CUTLASS 为 SM100 提供了一整套 collective builder,而不是让用户手写 PTX:手写 PTX 能跑通单测,但很难跑出接近峰值的性能。
小结
Blackwell 的 tcgen05 不是 Hopper wgmma 的”再快一档”,而是把矩阵单元重新设计成一台有独立工作内存、独立发射、能自行处理低精度操作数的协处理器:
- TMEM 以 128 条 lane × 512 个 column 的组织接管累加器,把 D 的高频读写从寄存器挪走;分配以 32 列为单位、必须 2 的幂、必须由一个 warp 完成且退出前释放。
- 单线程发起让 MMA 成为标量指令,发射成本趋近于零,但同步责任转移给程序员:同一累加器上的指令必须同 warp 发出,跨 warp 不保证顺序,完成要靠 mbarrier +
tcgen05.commit。 - idesc 与共享内存描述符把形状、类型、主序、swizzle、稀疏、缩放全部编码成 32/64 位字段;形状表里 K 随位宽翻倍,使每条指令在硬件里大致占 128 个周期。
- 双 CTA 把 A、D 沿 M 切、B 沿 N 切,省下重复的 B 流量与原子操作,代价是成对启动与全局统一的
cta_group。 - 块缩放把 scale 表放进 TMEM,让矩阵单元自己做反量化;NVFP4 与 MXFP4 的差别在 scale 的格式与向量长度。
- 流水线从”warpgroup 包办一切”变成”TMA / MMA / softmax / epilogue 各管一段”,epilogue 成了新的主要瓶颈,TMEM 双缓冲成为标配。
回到本系列的起点:GEMM 优化的本质是”把数据留在尽可能快的存储里、把算术强度提上去、让搬运和计算重叠”。Blackwell 没有改变这三条原则,只是把”尽可能快的存储”从寄存器往前推进了一格——矩阵单元自己拥有了一块存储。理解这一点,再看 FA4、DeepGEMM 与 CUTLASS 的 SM100 kernel,它们的骨架就清晰了:它们不是在写 GEMM,而是在调度一台协处理器的三段流水。
参考资料
- PTX ISA 文档:TensorCore 第五代指令(TMEM、tcgen05.mma、ld/st、块缩放与数据搬运形状的权威定义)
- CUTLASS:Blackwell SM100 GEMMs 文档(7 类 tcgen05.mma、块缩放、形状与对齐要求)
- CUTLASS
cute/arch/mma_sm100_desc.hpp(UMMA Instruction Descriptor 与 Matrix Descriptor 位域定义) - CUTLASS
cute/arch/tmem_allocator_sm100.hpp(TMEM 分配协议与前置条件) - FlashAttention-4: Algorithm and Kernel Pipelining Co-Design for Asymmetric Hardware Scaling(arXiv:2603.05451,2026;TMEM 布局与 2-CTA MMA 的论文描述)
- Pretraining Large Language Models with NVFP4(arXiv:2509.25149,2025;NVFP4 的 E4M3 块缩放与量化器设计)
- OCP Microscaling Formats (MX) Specification v1.0(MXFP4/MXFP8 的 E8M0 scale 与 32 元块定义)
- NVIDIA Blackwell 架构官方页面(数据中心级 Blackwell 的架构概览)
- GPU GEMM 优化完全拆解(三):Tensor Core、MMA/wgmma 指令与异步流水线(本系列第三篇,wgmma 与 CUTLASS 基础)
- GPU GEMM 优化完全拆解(一):从朴素 Kernel 到共享内存分块(本系列第一篇)
- GPU GEMM 优化完全拆解(二):寄存器分块、向量化访存与 Warp Tiling(本系列第二篇)
- FlashAttention-4 完全拆解:面向 Blackwell 的算法-流水线协同设计(本站拆解 FA4 的 warp specialization 与混合指数)
- DeepGEMM 完全拆解:300 行 FP8 GEMM 内核,如何逼近 Hopper 的算力峰值(Hopper 时代的 FP8 主循环)
- XFP:质量地板驱动的自适应码本量化——3.4 位在双卡工作站跑通 397B MoE(查找表式码本量化的工程对照)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



