


TileLang 完全拆解:DeepSeek 的 tile 级内核 DSL 如何接管 V4 的热路径
这篇在 DeepSeek 技术时间线上的位置
2026 年 4 月 26 日,DeepSeek 把 V4 系列的技术报告挂上了 arXiv,编号 2606.19348,标题是 DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence。模型侧的两套架构,V4-Pro(1.6T 总参数、49B 激活)与 V4-Flash(284B 总参数、13B 激活),本站已经在 DeepSeek-V4 混合注意力完全拆解里拆过一轮:CSA 压缩稀疏注意力、HCA 重度压缩注意力、闪电索引器、异构 KV Cache。如果把这篇文章放在 DeepSeek 技术全景那条从 67B 稠密模型到 1.6T 稀疏模型的时间线上,它讲的是模型内部的算法。
这份报告还有另外一半,标题朴素得多:第 3 章「General Infrastructures」,也就是支撑 V4 跑起来的系统层。这一章里有四件事:专家并行下的细粒度通信-计算重叠(MegaMoE2 融合 mega-kernel)、用 TileLang 做算子开发、batch-invariant 与确定性 kernel 库、以及训练框架的 Muon 适配。其中第二件和第一件,都指向同一门语言——TileLang。
这正是本篇要拆的东西。TileLang 不是 DeepSeek 发明的,它出自北京大学与微软亚洲研究院的合作(论文 arXiv:2504.17577,2025 年 4 月,DeepSeek 在 V4 报告里把它引用为 ICLR 2026 论文)。但 V4 是把它的职责写进技术报告、并明确交代”把几百个细粒度 ATen 算子换成融合 kernel”的一次。换句话说,别人写 DSL 是为了让新手更容易上手,DeepSeek 用 DSL 是为了把已有的手写 kernel 换掉,而且不损失性能。
这篇会沿着五个问题走:为什么 V4 需要一门自研 DSL;TileLang 的 tile 级抽象到底比 Triton 多给了什么;布局推断、软件流水线、host codegen、Z3 整数分析这四个编译器机制各自解决什么问题;MegaMoE2 融合 kernel 拿到了什么;以及”逐比特可复现”这套要求如何反过来约束编译器设计。所有代码示例都来自 TileLang 与 TileKernels 的官方仓库,会标明文件路径。
为什么 V4 需要一门 DSL
先说清楚 V4 架构带来了多少”非标准算子”
标准做法是把模型写成一个 PyTorch 模块,让每个算子落到 ATen 上,ATen 再调用 cuBLAS、cuDNN 或者某个 fused kernel。这条路在 Transformer 时代很好用,因为网络结构基本固定:Linear、LayerNorm、Softmax、Attention,每个都有厂商优化过的实现。
V4 不走这条路。报告的原文很直白:
In practice, our elaborate model architecture would have resulted in hundreds of fine-grained Torch ATen operators. We adopt TileLang to develop a set of fused kernels to replace the vast majority of them.
翻译过来:V4 这套架构如果按常规写法实现,会产生几百个细粒度算子;DeepSeek 用 TileLang 写了一组融合 kernel 把它们替掉了绝大部分。那”几百个”从哪来?
- 混合注意力:CSA 要先对 KV 做压缩、再用闪电索引器算 top-k、再按索引 gather 出稀疏 KV、最后做带 sink 的注意力。每一步的中间结果(压缩后的 KV、索引分数、top-k 索引)都是独立的张量,都是独立的算子。
- 归一化与门控的碎片:V4 的注意力对 query 和 KV 直接上 RMSNorm,配合可学习的 sink logits;mHC 需要 Sinkhorn 归一化;MoE 需要 top-k 门控、权重归一化、token 重排。
- 量化转换:FP8 与 FP4 之间来回转换,per-token、per-block、per-channel 三种粒度混用。
- 通信-计算交界处:专家并行下的 dispatch 与 combine 本身就是通信算子,和它紧邻的 GEMM 归约、激活函数、量化都属于”通信前最后一公里”和”通信后第一公里”。
这些算子里,绝大多数有一个共同特征:它们是 memory-bound 的,而且很小。一个 per-token FP8 量化,要做的事情就是把数据读进来、算一个 amax、除以 scale、写出去——没有矩阵乘,用不上 Tensor Core。这类算子的理论下限完全由 HBM 带宽决定。
小算子的账:为什么”多个小 kernel”是最坏的选择
假设一个算子需要读 500 MB、写 250 MB,在 HBM 带宽 3 TB/s 的卡上,理论时间是 毫秒。看起来很便宜。但如果这个逻辑被拆成 5 个算子,每个算子都多读一遍、多写一遍,数据在 HBM 上往返的总量就翻了数倍。更糟的是,每次 kernel 启动都要付一笔固定开销:
- GPU 侧的 kernel launch 本身有几十微秒量级的调度时间(在 CUDA Graph 之外);
- CPU 侧要经过 PyTorch 的 dispatcher、Python 层的参数校验、tensor 元数据构造,这笔账在下面的 host codegen 一节里会详细算。
一笔一笔加起来,一个本该 0.25 毫秒的活,实际可能要 1 毫秒以上。这就是”融合”的经济学动机:把多次 HBM 往返变成一次,把多次启动变成一次。
那为什么不用 Triton
Triton 是目前最流行的 kernel DSL,它的抽象层次是块级(block-level):用户写 tl.load、tl.dot、tl.store,编译器负责决定这些块操作如何映射到具体的线程、寄存器布局与内存地址。对绝大多数 kernel 来说这个抽象是够的,但报告与 TileLang 论文都指出它在极端场景下会卡住。TileLang 论文的原文批评得很具体:
Triton, for example, supplies intuitive block-level primitives but hides thread behavior, memory layout, and address-space annotations behind automatically generated strategies. … Furthermore, even though Triton exposes a user-friendly pipeline knob (num_stage), it does not allow users to define an entirely custom pipeline.
拆开就是三条:
- 线程行为、内存布局、地址空间被隐藏了。写量化 kernel 时经常需要内联汇编做向量化的数据类型转换,或者需要一个和硬件 buffer 精确对齐的自定义布局——这些在 Triton 里要么做不到,要么需要绕路注册 PTX。
- 流水线只有
num_stages一个旋钮。Triton 的软件流水线是编译器推断的,用户没法说”第 0 阶段的 copy 要排在第 1 阶段的 GEMM 之后发射”这种话。而 Hopper 之后的 warp 特化(warp specialization,生产者 warp 搬数据、消费者 warp 做计算)本质上要求用户能表达非平凡的流水线结构。 - Triton 的降低路径是 MLIR 直下 PTX,用户很难在中间某一层插手。
CUTLASS 是另一个极端:性能上限最高,但门槛也最高——模板元编程、编译时间动辄几分钟,而且布局一旦被模板封装就很难从外部覆盖。TileLang 论文里有一个数字很说明问题:
Analysis using the NVCC 12.8 trace tool shows that template expansion accounts for approximately 90% of compilation time for CUDA code generated by tilelang.
注意这里的措辞:即使是在 TileLang 生成的代码里,模板展开也占了 CUDA 编译时间的大约 90%(因为 TileLang 默认把 T.gemm 派发到 CUTLASS CuTe 的模板实现)。如果连生成的代码都这样,手写 CUTLASS 的编译负担可想而知。
TVM 则是第三条路:它早就把计算与调度分开了,但用户需要显式地写调度、手动注册新的 tensor 指令、手动指定 buffer layout,写起来”难写也难读”。TileLang 恰恰是 TVM 生态里长出来的——它的编译基础设施直接建立在 TVM 的 TIR 之上,但把用户接口从”写调度”改成了”写 tile 数据流,编译器猜调度,猜不到的地方给你逃生舱”。
这三条对照下来,TileLang 的定位就清楚了:保留 Triton 的易用性,但把 Triton 藏起来的东西重新暴露出来,作为可选项。
TileLang 的三层接口与 TVM 血统
一个渐进降低的编译流程
TileLang 官方文档把接口分成三层,对应编译流程里三个不同的高度。
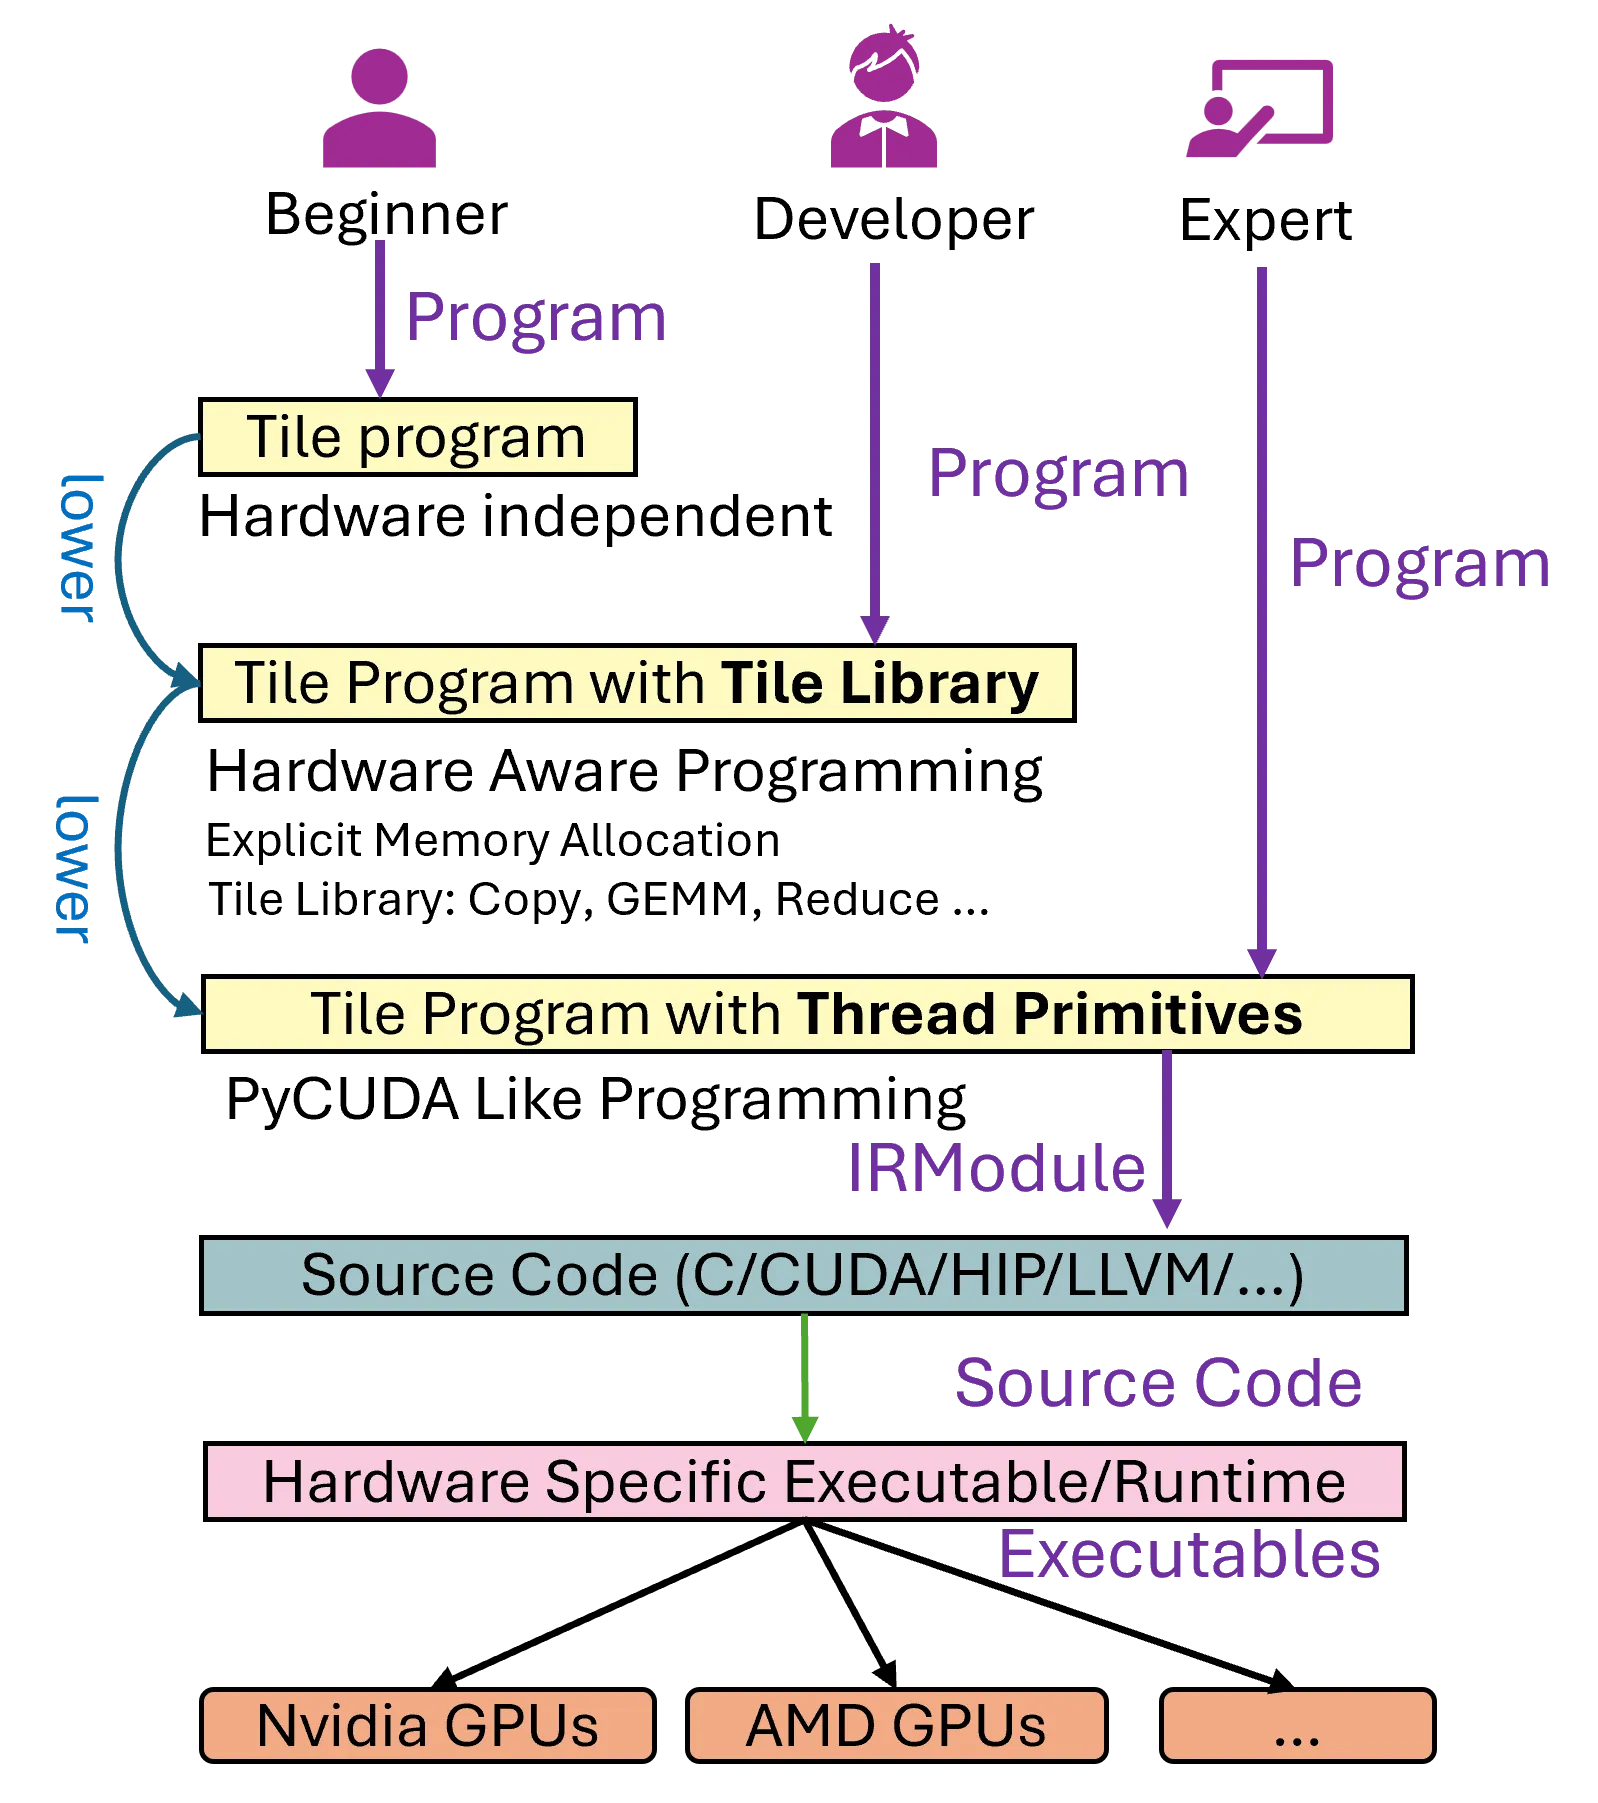
图:TileLang 的编译流程。同一个内核里可以混用三层接口,按需要下钻。来源:TileLang 官方文档 docs/get_started/overview.md
从上往下看:
- Beginner(硬件无关):直接描述数学,不关心内存层次。文档明确写着这一层”尚未完全实现”,所以现阶段它更多是设计目标。
- Developer(硬件感知 + Tile Library):用
T.copy、T.gemm、T.reduce这类 tile 级原语拼数据流,显式声明 buffer 放在哪一级存储层次(global / shared / fragment),但不写线程索引。这是日常用得最多的一层。 - Expert(线程原语):直接操作线程。用
T.get_thread_binding()拿线程号、用T.alloc_barrier手动管 mbarrier、用T.ws()显式划分 warp 角色。MegaMoE2 那种级别的 kernel 才会走到这一层。
编译流程本身是五段:解析 Python AST → 构建 TileLang AST → 转成 TVM IR(IRModule)→ 做图优化与调度变换 → 生成 LLVM IR / CUDA C++ / HIP C++ 等后端源码。最后一段交给 NVCC、HIPCC 或 NVRTC 编译成可执行模块。
“建立在 TVM 之上”这件事不是包装,而是实实在在的复用。TileLang 直接吃 TVM 的 IRModule,用 TVM 的 tvm.arith.Analyzer 做整数表达式分析(后面 Z3 就是集成进这个 Analyzer 的),用 TVM 的 FFI 做 host 侧的函数绑定。这也解释了它为什么能相对快地支持那么多后端:CUDA、ROCm/HIP、Apple Metal、LLVM CPU、WebGPU,以及一堆厂商适配分支。
tile 级抽象的实际样子:一个完整的 GEMM
空谈抽象没用,看代码最直接。下面这段来自 TileLang 官方仓库的 examples/quickstart.py,是仓库里”最短的完整例子”。为了讲清楚,我加了中文注释,逻辑一字未改。
import tilelangimport tilelang.language as T
@tilelang.jitdef matmul(A, B, block_M: int, block_N: int, block_K: int): # T.const 声明三个符号维度,实际数值在调用时由张量形状绑定 M, N, K = T.const("M, N, K") dtype = T.float16 accum_dtype = T.float32 A: T.Tensor((M, K), dtype) B: T.Tensor((K, N), dtype) C = T.empty((M, N), dtype)
# T.Kernel 定义 tile 程序的网格:每个格子是一个线程块 # 返回的 (bx, by) 在 CUDA 上就是 blockIdx.x / blockIdx.y with T.Kernel(T.ceildiv(N, block_N), T.ceildiv(M, block_M), threads=128) as (bx, by): # 显式声明每一块 buffer 落在哪一级存储层次 A_shared = T.alloc_shared((block_M, block_K), dtype) B_shared = T.alloc_shared((block_K, block_N), dtype) C_local = T.alloc_fragment((block_M, block_N), accum_dtype)
T.clear(C_local)
# T.Pipelined 把 K 方向的循环变成多缓冲软件流水线 for ko in T.Pipelined(T.ceildiv(K, block_K), num_stages=3): T.copy(A[by * block_M, ko * block_K], A_shared) T.copy(B[ko * block_K, bx * block_N], B_shared) # 一条语句完成整块矩阵乘,降低到目标后端的 tensor core 指令 T.gemm(A_shared, B_shared, C_local)
# ReLU 尾声:T.Parallel 是元素级并行循环,会被映射到线程 + 向量化 for i, j in T.Parallel(block_M, block_N): C_local[i, j] = T.max(C_local[i, j], 0)
T.copy(C_local, C[by * block_M, bx * block_N])
return C代码来源:tile-ai/tilelang examples/quickstart.py,注释为本篇所加。
这三十行里有四个关键设计决策值得展开。
第一,buffer 的位置是声明出来的,不是推断出来的。 T.alloc_shared 明确说”这块放共享内存”,T.alloc_fragment 明确说”这块是每个线程私有的寄存器片段”。在 Triton 里,用户写不出这种话——共享内存和寄存器的作用域完全由编译器决定。TileLang 论文把这条列为它区别于 Triton 的第一设计原则:T.alloc_shared 对应 NVIDIA GPU 上的共享内存,“ideal for caching intermediate data”,而 fragment 对应寄存器文件。这份显式性带来两个后果:好的一面是用户能精确控制什么数据被复用、什么数据只过一次;坏的一面是用户得知道自己在干什么,这也就是为什么它需要三层接口。
第二,T.copy 是一个语义,不是一个指令。 编译器看到 T.copy(A[by*block_M, ko*block_K], A_shared) 时,知道”要把一块 global memory 搬到 shared memory”,但具体用哪条指令是后面才决定的:可能是同步的 SIMT 拷贝 ld.global、可能是 cp.async(Ampere 的异步拷贝)、可能是 TMA 的 cp.async.bulk(Hopper 及以后)。官方文档在讲 T.async_copy 时特意写了一句:
The compiler is free to lower it to different mechanisms (synchronous SIMT copy
ld.global, warp-level copyldmatrix, async copy via TMAcp.async.bulk, old async copycp.async, etc.) depending on target/hints, but the observable semantics …
第三,T.Pipelined 把整个循环体当作一个整体来安排。 num_stages=3 的含义是:K 方向被切成 ceildiv(K, block_K) 个迭代,数据要提前三期取到,使得”第 i 期的计算”能和”第 i+1、i+2 期的数据搬运”同时进行。编译器会把这个循环重写成”序言 + 稳态 + 尾声”三段结构,并且给共享内存 buffer 复制出三份(术语叫 multi-versioning / 多版本化)。
第四,T.gemm 是最有意思的一条。 它看起来像一次函数调用,实际上是整个 tile 库的核心:一条语句要完成 MMA 指令选择、shared memory 到 register 的数据搬运(ldmatrix 之类)、寄存器布局匹配、累加器初始化策略等一系列决策。TileLang 论文里列了 T.gemm 支持的访存模式组合 ss、sr、rs、rr,其中 r 表示寄存器、s 表示共享内存——也就是 A 和 B 可以各自来自共享内存或寄存器。在 CUDA 后端它派发到 NVIDIA 的 CUTLASS,在 AMD 上则同时使用可组合算子和手写 HIP 代码。
把这段代码和硬件对应起来看更直观:
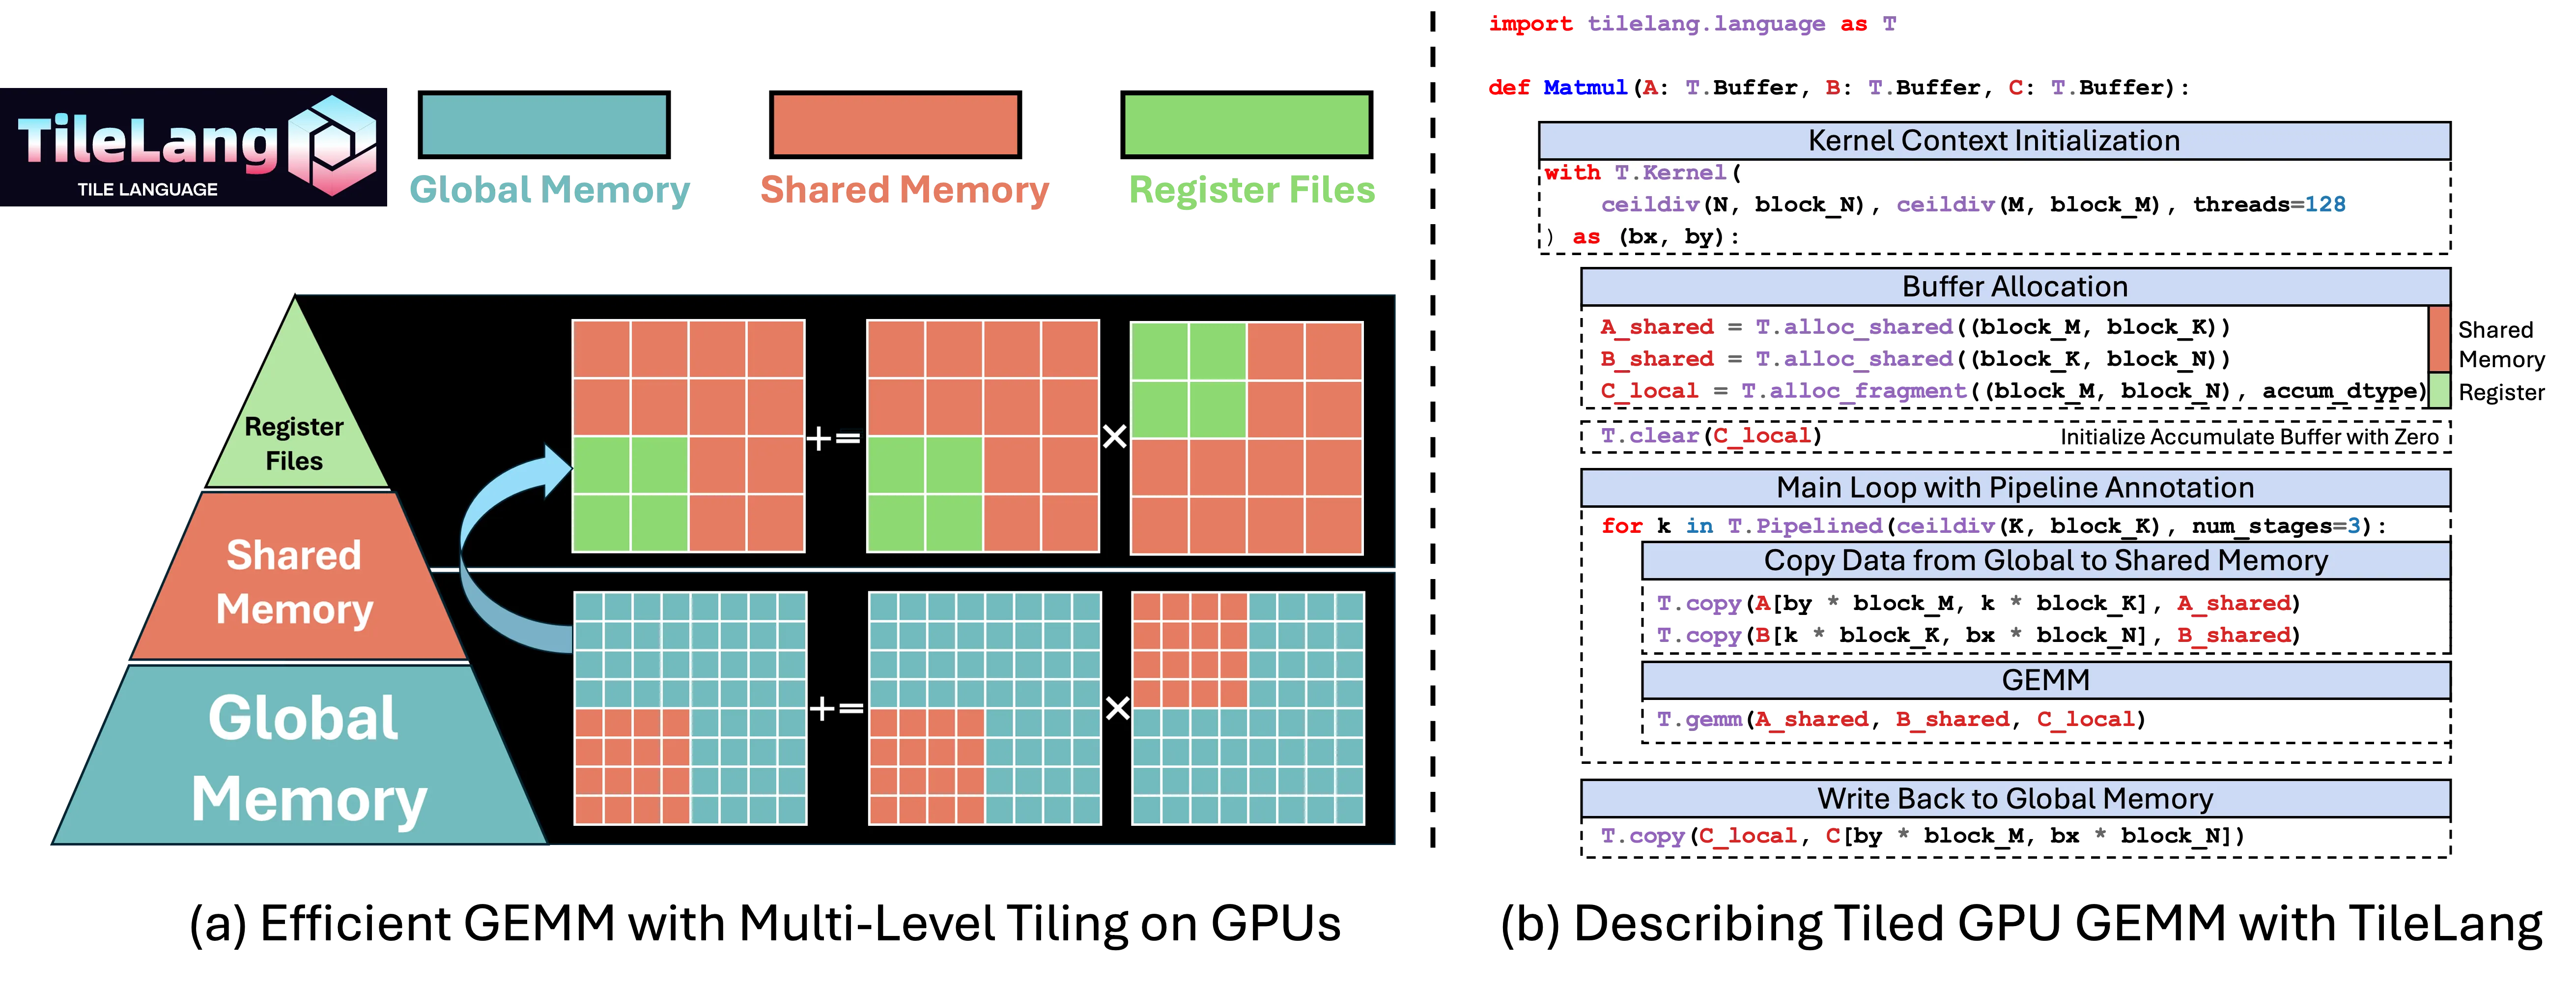
图:左边是三级存储层次的金字塔(Register Files / Shared Memory / Global Memory),右边是同一个 kernel 在 TileLang 里的四个动作:T.Kernel 初始化上下文、T.alloc_shared/alloc_fragment 分配资源、T.Pipelined 主循环里做 T.copy + T.gemm、最后写回。来源:TileLang 官方文档 docs/_static/img/MatmulExample.png
”tile 级”和”块级”到底差在哪
这个问题值得单独说,因为”tile”这个词在 GPU 编程里被大量混用。
Triton 的 block-level 指的是:用户描述一个程序实例处理的数据块(比如 BLOCK_M x BLOCK_N 的输出),编译器负责把这个块在多个线程之间切分。用户看到的是块,看不到线程。
TileLang 的 tile-level 多出一层:用户既能描述块,也能描述块内部的数据在各线程之间怎么分,甚至能指定”这一块数据用哪种 layout 存在寄存器里”。TileLang 论文里的说法是,把调度空间(thread binding、layout、tensorize、pipeline)从数据流里解耦出来,然后”encapsulated as a set of customization annotations and primitives”。数据流是必须写的,调度是可选的——不写就编译器猜,写了就按你写的来。
这解释了为什么 TileLang 论文里反复强调它”既简单又灵活”:默认路径和 Triton 一样简单,但天花板比 Triton 高。论文给的一个数字可以佐证天花板确实更高——在 A100 上的反量化 GEMM(dequantize GEMM)测试里,配合 BitBLAS 的 W_INT2 A_INT8 配置,相对 cuBLAS 的 W_FP16 A_FP16 做到了最高 7.65 倍加速;论文把原因归给”暴露了线程级编程接口,允许控制数据布局和流水线配置”,并且明确说”这些优化在 Triton 里很难实现”。
布局推断:TileLang 编译器的心脏
问题定义:一条 T.copy 要变成什么
看这一行:
T.copy(A[by * block_M, ko * block_K], A_shared)语义是清楚的:从 A 里取一块 block_M x block_K 的子矩阵,放进共享内存。但要在 GPU 上真的执行,编译器必须回答一堆问题:
- 这块数据由多少个线程协作搬运?128 个线程,还是 256 个?
- 每个线程负责哪几个元素?
- 每个线程一次搬几个元素(向量化宽度是 1、2、4 还是 8)?
- 共享内存里这些元素的物理排列是什么?是按行连续排,还是做 XOR swizzle 打散以避免 bank conflict?
- 源地址和目的地址的索引表达式是否需要边界谓词(predicate)来防止越界?
这些问题在 CUDA 里全部要手写。TileLang 的做法是全部交给一个叫 Layout Inference(布局推断) 的 pass,这个过程在论文里被拆成四个阶段,官方文档给了一张非常清晰的图:
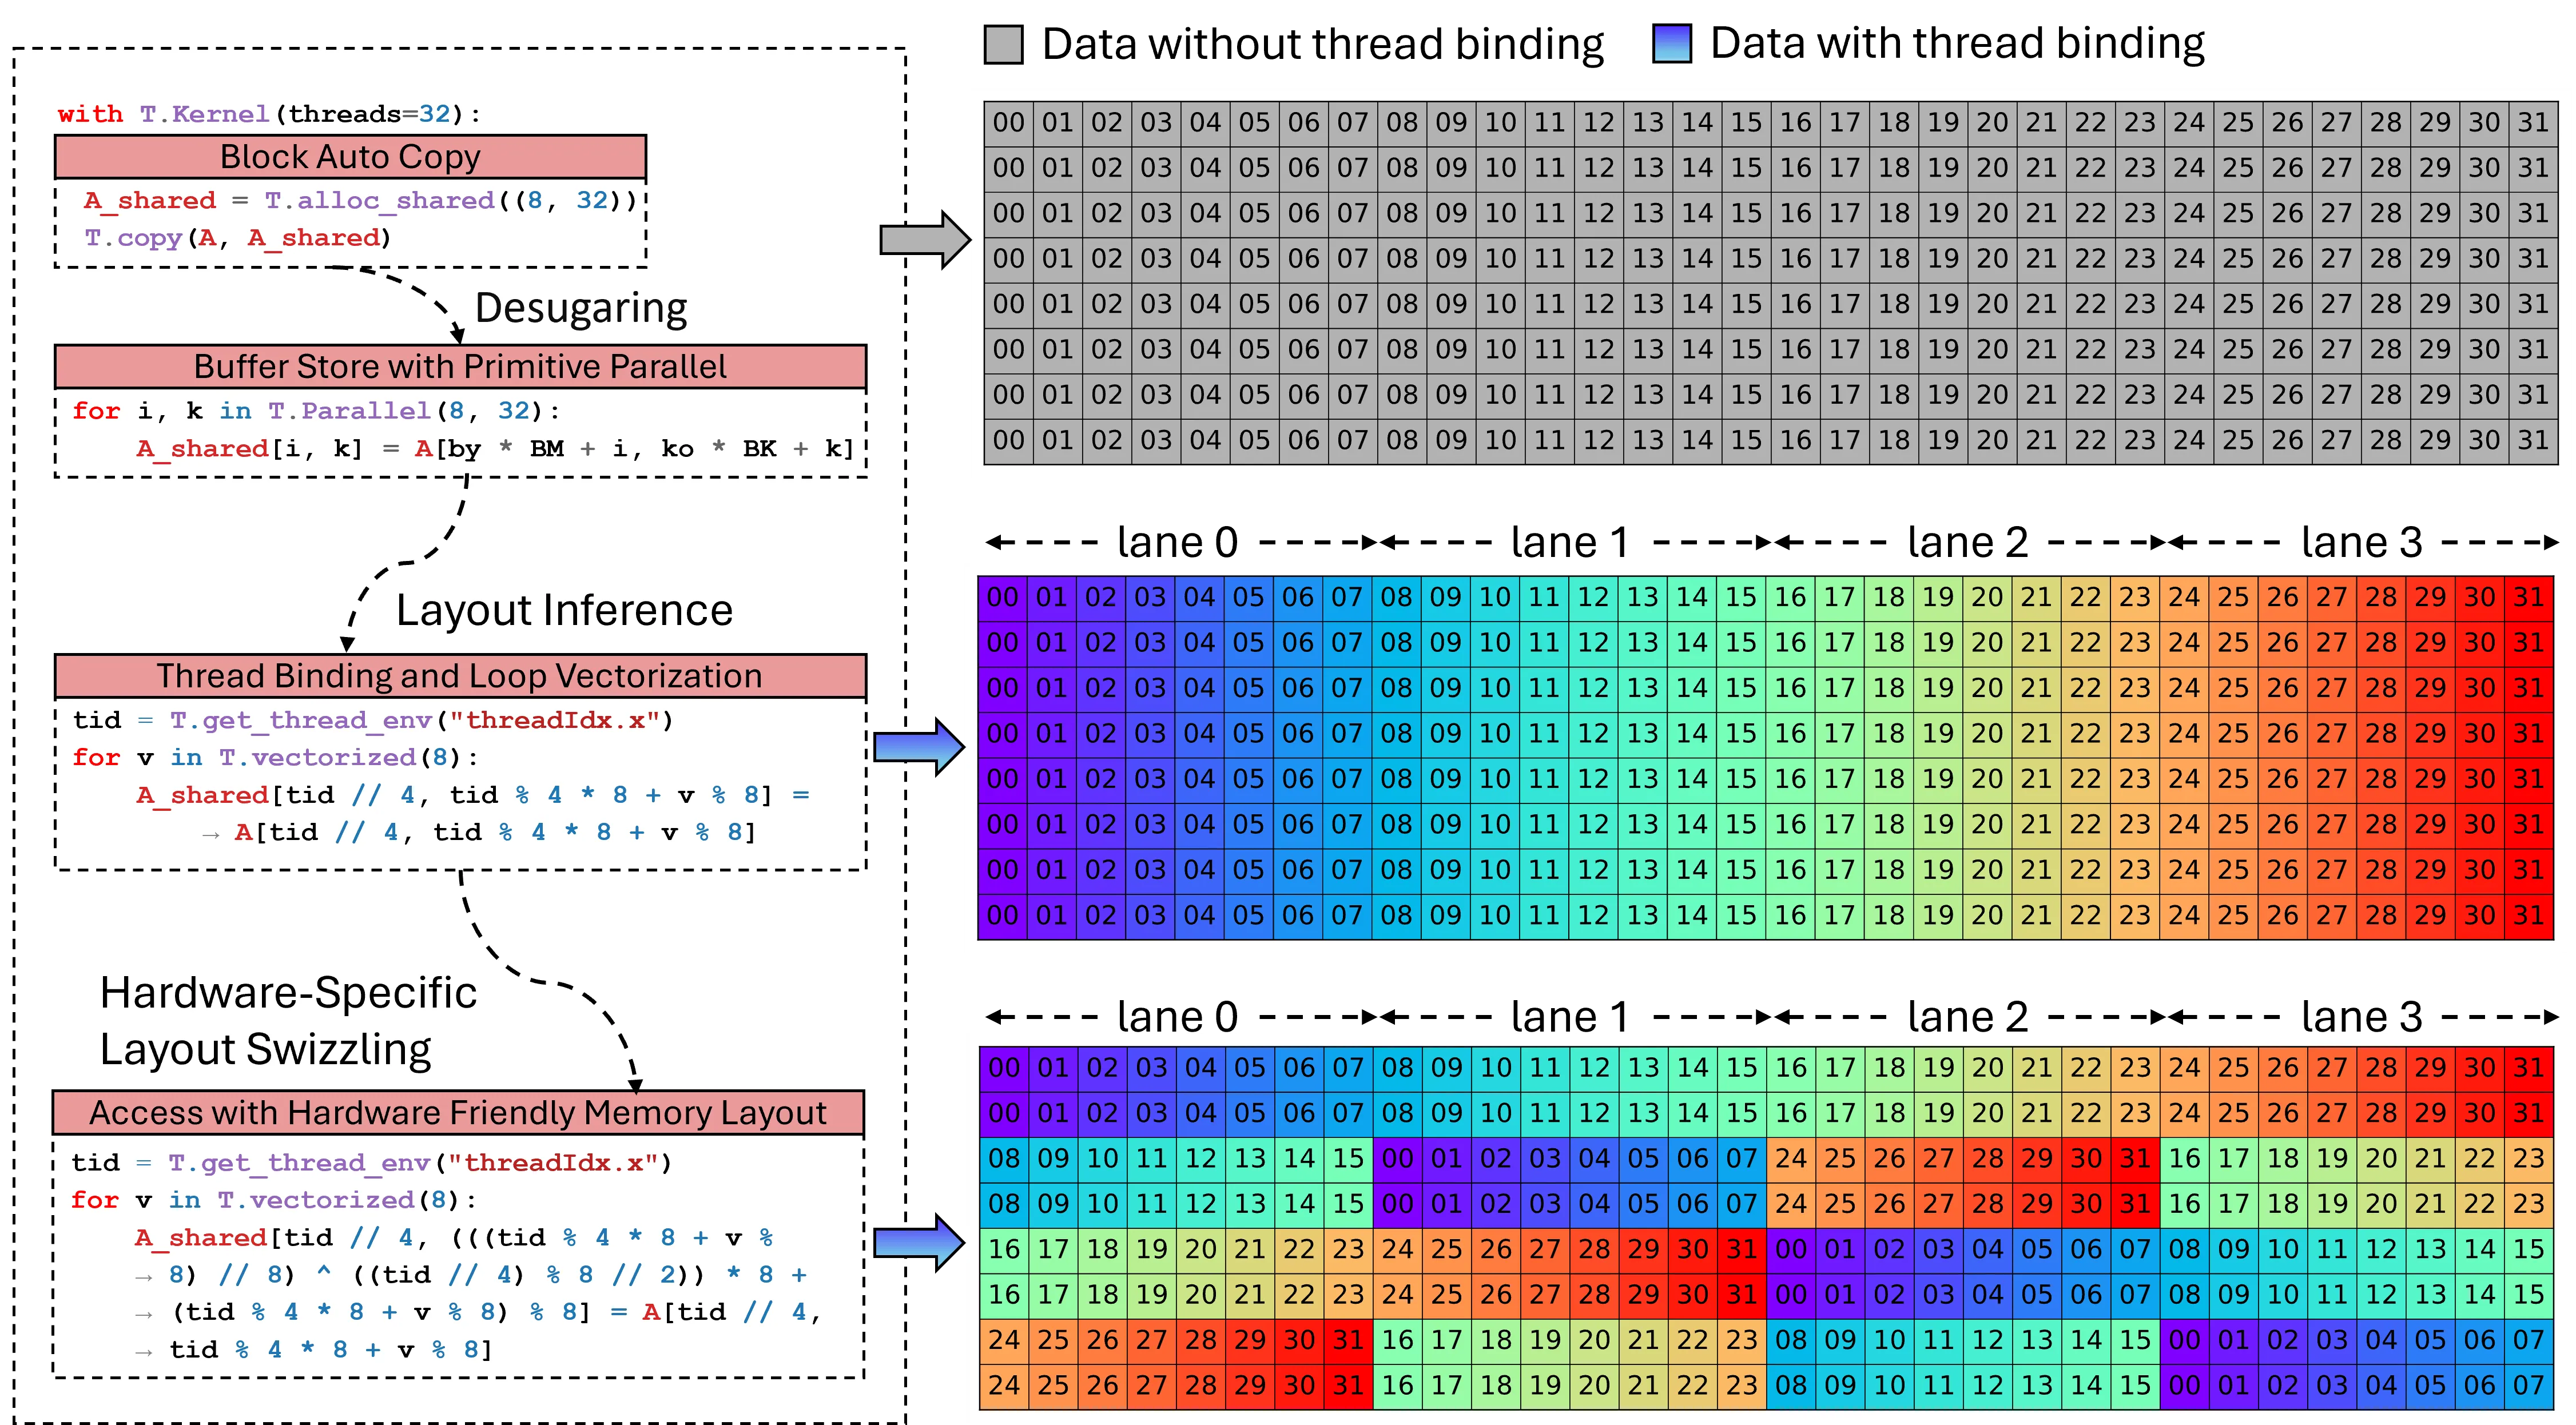
图:从 T.copy(A, A_shared) 到最终带硬件友好布局的线程级代码。中间三张热力图分别表示:按行主序直接切分(有 bank conflict)、推断出的线程绑定 + 向量化访问、以及 swizzle 之后的物理布局。来源:TileLang 仓库 docs/_static/img/LayoutInference.png
第一步:脱糖(Desugaring)
T.copy 先被展开成一个携带 T.Parallel 的循环:
for i, k in T.Parallel(8, 32): A_shared[i, k] = A[by * BM + i, ko * BK + k]这一步是纯粹的语义展开——T.copy 只是一个语法糖,展开之后编译器面对的和其他 tile 算子一样,都是”并行循环 + 访存”。这样做的好处是布局推断只需要处理一种 IR 形态。
第二步:布局推断本身
这是整个编译器里最关键的一步。要理解它在算什么问题,得先理解 TileLang 的两个核心抽象:Layout 和 Fragment。
Layout 描述的是”逻辑索引到物理地址”的映射。论文里的形式化写法是,一个 layout 可以表示成线性化地址表达式 ,其中 是第 维的索引、 是该维贡献的步长。TileLang 沿用 TVM 的思路,把它写成基于 IterVar 的可组合、可叠加的 layout 函数:
也就是从 维逻辑索引到 维物理坐标的映射。为什么输出也是多维?因为物理坐标不只有”地址”,还包括”这块数据属于哪个线程”和”在这个线程的寄存器里排第几”。
Fragment 就是在这个基础上加了两样东西的 Layout:forward_thread(哪条线程持有这个逻辑元素)和 replicate_size(这份数据在线程组之间复制了几份)。合起来,一个 Fragment 描述的是一个三向映射:
replicate_size 为什么必要?论文里给了一个很具体的例子:矩阵 是 GEMM 的结果,形状 ,分布在 8 条线程上,每条线程负责 2 个元素。现在要对 逐元素加上 bias 。 的每一行由 2 条线程共同负责,那么这 2 条线程都需要访问 里同一个元素。所以 必须被复制——同一份 bias 值要在多条线程的寄存器里各存一份,才能保证加法在每条线程上都能本地完成。
这就是 thread binding 问题的本质:register file 是线程私有的,但逻辑上的张量元素可能被多个线程需要。 解决方式只有两种——要么复制,要么走共享内存通信。前者便宜但占寄存器,后者省寄存器但引入同步。TileLang 靠推断来决定用哪种。
推断的规则是分层优先级、自顶向下。论文原文:
We define a hierarchical priority system for tile operator layouts, where higher priority levels indicate stricter layout requirements and greater performance impact. TileLang processes layout inference in a top-down manner, sequentially inferring layouts from the highest to the lowest priority levels. At each priority level, TileLang attempts to infer layouts for all undetermined buffers until no further progress can be achieved, before proceeding to the next lower priority level.
优先级的依据是”这个算子对布局的要求有多严”。GPU 上 T.gemm 走 Tensor Core,而 Tensor Core 的寄存器布局是被硬件指令钉死的(mma 的 fragment 布局、wgmma 的 warpgroup 布局),所以 GEMM 优先级最高;元素级算子(加法、ReLU、类型转换)对布局几乎没要求,优先级最低。于是推断逻辑就变成:先满足最挑剔的 GEMM,再让元素级算子去适配已经定下来的布局。论文里那张 的图就是这条规则的具体体现——GEMM 的布局决定了 的线程绑定, 的布局只能跟着走。
这套机制在 LayoutMap 里统一维护所有 buffer 的布局信息。论文还提到布局函数有四个组合算子(repeat、repeat_on_thread、replicate、reshape 一类):一个 m16k16 的 warp 级 mma fragment 布局,通过 repeat 可以扩展成单 warp 消费 m32k16 的 warp_layout,再通过 repeat_on_thread 和 replicate 扩展成 4 个 warp 共同消费 m128k16 的 block_layout。也就是说,硬件指令的基础布局是”积木”,块级布局由积木搭出来。
第三步:线程绑定与向量化
布局定下来之后,编译器把 T.Parallel 循环的迭代空间映射到线程和向量上。图上第二步给出的结果是:
tid = T.get_thread_env("threadIdx.x")for v in T.vectorized(8): A_shared[tid // 4, tid % 4 * 8 + v % 8] = A[tid // 4, tid % 4 * 8 + v % 8]读法:128 个元素按每线程 8 个(v 从 0 到 7)分给 16 条线程(tid // 4 给出 8 行里的行号,tid % 4 给出 4 个列分组)。T.vectorized(8) 表示这 8 个元素要被打包成一条向量访存指令——如果数据类型是 float16,8 个元素就是 128 位,正好是 ld.global.v8.f16 或等价的双 128 位访问。这个”宽度选 8”不是拍脑袋定的:它既要匹配硬件的最大向量宽度,又要保证地址对齐,还要保证不会因为切分方式而导致访存不连续。
这一步就是”自动向量化”,也是 Z3 发挥作用的第一个地方——编译器必须证明”tid % 4 * 8 + v 这组索引在 v 取满 0 到 7 时是连续且对齐的”,才能安全地把它变成一条向量指令。
第四步:布局 swizzle
前两步得到的访存是连续的,但共享内存里的物理布局还是行主序,这会导致 bank conflict:同一个 warp 里的线程如果访问的地址落在同一个 bank 上,这些访问就得串行化。TileLang 的解决办法是 XOR swizzle,把物理布局改成:
A_shared[tid // 4, ((tid % 4 * 8 + v % 8) // 8) ^ ((tid // 4) % 8 // 2) * 8 + (tid % 4 * 8 + v % 8) % 8] = ...看起来吓人,本质是一个 XOR:把列索引的高位与行索引的某些位做异或,使得同一列上的不同行被映射到不同的 bank。第三张热力图里那些色块正是这种非线性排列的视觉表现。论文把”内存布局被自动生成的策略隐藏起来”明确列为 Triton 的局限之一,而 TileLang 除了自动推断,还提供了 T.annotate_layout 作为手动覆盖的入口。
逃生舱:手动指定 layout
推断不可能总是对。当用户比编译器更清楚该用什么布局时,TileLang 允许直接写:
def x_layout_fn(i: int, j: int): id = i * block_k + j return (id // num_vectorize % num_threads, id // (num_vectorize * num_threads) * num_vectorize + id % num_vectorize)
T.annotate_layout({ x_fragment: T.Fragment( (block_m, block_k), forward_fn=x_layout_fn, )})代码来源:deepseek-ai/TileKernels tile_kernels/quant/per_token_cast_kernel.py
这里 x_layout_fn 返回的是一个二元组:第一个分量是线程 ID,第二个分量是该线程内部的寄存器下标。这就是上面说的三向映射里被显式写出来的那部分。DeepSeek 在 TileKernels 的 per-token 量化 kernel 里用这种方式固定了向量化宽度和线程划分,因为量化 kernel 的性能完全被访存模式决定,任何推断失误都会直接体现在带宽利用率上。
V4 报告里还有一句话值得记下来:T.annotate_layout 同时被用来锁定与参考 CUDA 实现一致的累加顺序,从而实现逐比特一致的输出。也就是说,这个 API 既是性能旋钮,也是可复现性旋钮。
软件流水线:从 num_stages 到显式 stage/order
默认路径
T.Pipelined(T.ceildiv(K, block_K), num_stages=3) 是绝大多数 kernel 的写法。它做的事情是:分析循环体里各条语句的依赖关系,判断谁在产生数据、谁在消费数据,然后自动生成”序言 + 稳态 + 尾声”的流水结构,并且把共享内存 buffer 复制成多份。
官方文档对这张图的解释很到位:
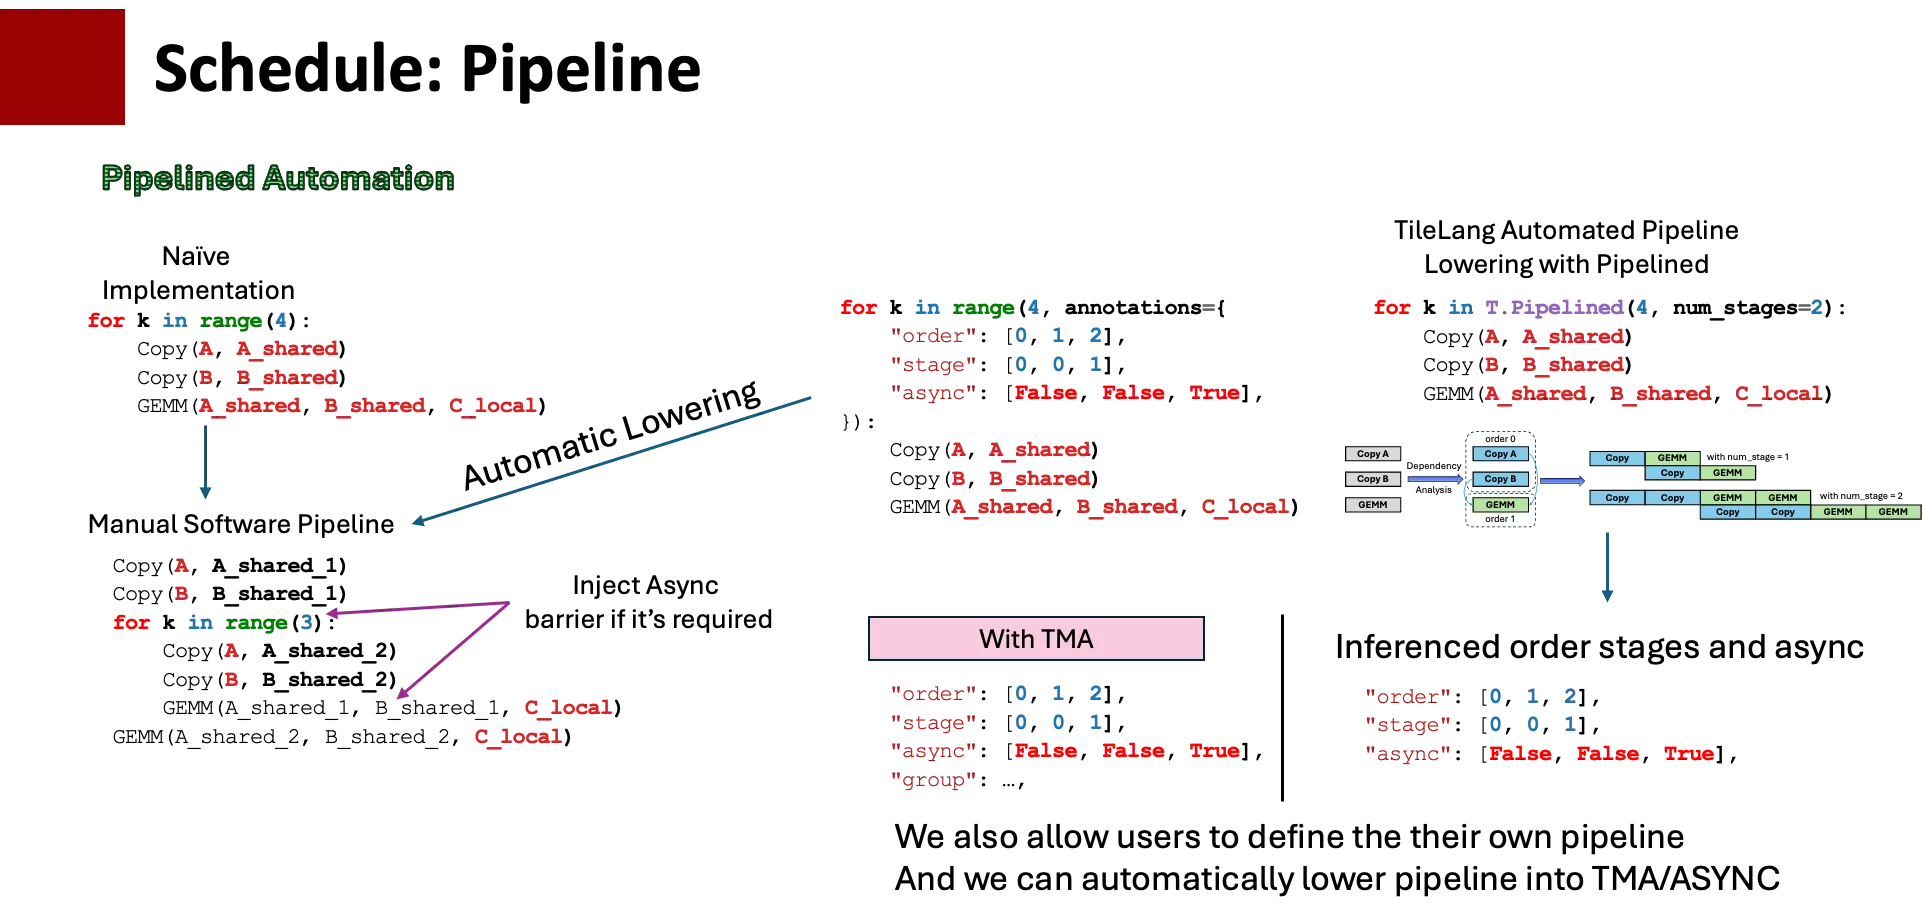
图:从左到右是四个阶段。最左是朴素实现(拷贝—拷贝—GEMM 顺序执行);往右是被展开成带 stage/order/async 注解的手写流水线;再往右是编译器自动推断出的注解;最右是 TileLang 生成的”多版本 buffer + 交错发射”的结构。来源:TileLang 官方文档 docs/_static/img/software_pipeline_inference.png
展开后的手写形态在图上很清楚:
Copy(A, A_shared_1)Copy(B, B_shared_1)for k in range(3): Copy(A, A_shared_2) Copy(B, B_shared_2) GEMM(A_shared_1, B_shared_1, C_local) # 用上一轮的数据计算 GEMM(A_shared_2, B_shared_2, C_local)GEMM(A_shared_2, B_shared_2, C_local) # 尾声看到”数据搬两轮、计算滞后一轮”这个结构,就理解了 num_stages=2 在做什么:它把”搬第 轮数据”和”算第 轮”放进了同一个循环体,让硬件有机会让它们并发。至于”有机会”能不能变成”真并发”,取决于数据搬运是否被编译成异步指令——Ampere 上 cp.async 是异步的,Hopper 之后 TMA 更是完全由独立硬件单元驱动。
手动路径
num_stages 不够用的时候,TileLang 允许直接给出 schedule。官方文档给出的接口是两个数组:
for ko in T.Pipelined( T.ceildiv(K, BK), stage=[0, 0, 1], order=[0, 1, 2],): T.copy(A[ko * BK], A_shared) T.copy(B[ko * BK], B_shared) T.gemm(A_shared, B_shared, C_local)两个数组按源码顺序对齐到”可调度语句”上:语句 0 是拷 A(stage 0,order 0),语句 1 是拷 B(stage 0,order 1),语句 2 是 GEMM(stage 1,order 2)。stage 是逻辑流水级别,小的先执行;order 是同一次发射里的顺序。依赖约束是:同一 stage 内 producer 的 order 必须小于 consumer;不同 stage 之间 producer 的 stage 必须小于等于 consumer。
order 真正体现威力的地方是乱序:
for ko in T.Pipelined( num_tiles, stage=[0, 1], order=[1, 0],): T.copy(A[ko * BK], A_shared) T.gemm(A_shared, B_shared, C_local)这里 copy 是 stage 0 但 order 是 1,GEMM 是 stage 1 但 order 是 0。语义是”先发射当前迭代的 GEMM,再发射下一轮迭代的 copy”——这是在手工构造软件流水时非常典型的写法。
TileLang 的文档里还花了很大篇幅讲一个看起来很琐碎的问题:可重放的标量绑定(replayable scalar Bind)不参与调度。比如
base: T.int32 = ko * BKT.copy(A[base + tx], A_shared[tx])B[base + tx] = A_shared[tx]base 这个定义只算一个值别名,不算一条可调度语句,所以 stage/order 数组里不该有它的位置。为什么?文档给的理由很扎实:流水线重写之后,copy 可能需要”未来迭代”的 base,而 store 需要”当前迭代”的 base——如果强行给 base 分配一个 stage,就会对其中一个使用者表达出错误的逻辑迭代。所以 TileLang 把它当作”用在哪里、就在哪里重放”的值别名,stage/order 只描述真正有副作用、有存储的操作。
这条规则的工程价值在于让手动调度不容易出错。很多框架的流水线接口要求用户枚举循环体里的每一条语句,用户一旦漏掉或错位就得到莫名其妙的错误结果。把”值别名”排除在调度之外,等于把最容易数错的一类语句自动过滤掉了。
另一个值得注意的细节是 T.Pipelined 与 T.serial 的关系:底层其实就是在 T.serial 上挂注解,文档里给出了裸写法:
for ko in T.serial( 0, num_tiles, annotations={ "software_pipeline_stage": [0, 1], "software_pipeline_order": [1, 0], "software_pipeline_async_stages": [0], },): ...async_stages 是用来显式指定”哪一级 stage 的访存要走异步通道”的。这三组注解就是前面那张图里”Automatic Lowering”箭头所指的东西——用户在高层写 T.Pipelined,编译器生成的就是这组注解。
手写 warp 特化:T.ws 与 mbarrier
自动流水线解决的是”数据搬得够早”的问题,但 Hopper 之后真正的性能分水岭是 warp 特化:把线程块内的 warp 分成生产者(管数据搬运,通常用 TMA)和消费者(管计算,用 wgmma / tcgen05),两边通过 mbarrier 同步。这样做的好处是生产者 warp 可以长时间阻塞在 TMA 上而不占用计算 warp 的发射槽,寄存器分配也能各按所需来切。
TileLang 论文里的说法是它能自动做这件事:
In TileLang, we automatically perform warp specialization optimization during the lowering process. Specifically, TileLang analyzes the buffer usage of all statements and determines their roles (producers or consumers). Based on this analysis, producers and consumers are divided into different execution paths according to threadIdx. To ensure computational correctness, TileLang leverages Live Variable Analysis to determine the appropriate synchronization points and inserts memory barriers (mbarriers) accordingly.
也就是说:分析每条语句用到的 buffer,判断它是生产者还是消费者;按 threadIdx 把两类角色分成不同的执行路径;再用活跃变量分析决定在哪些点插 mbarrier。这套自动化在 2026 年 3 月合入主线(PR #1909,同时引入了 T.tma_copy)。
但自动推断出来的特化不一定是最优的,所以 TileLang 也允许手写。官方仓库里有一个特别干净的例子,只有二十来行核心代码:
import tilelangimport tilelang.language as T
@tilelang.jitdef matmul_warp_specialize_copy_0_gemm_1(A, B, block_M, block_N, block_K, dtype=T.float16, accum_dtype=T.float32): M, N, K = T.const("M, N, K") A: T.Tensor((M, K), dtype) B: T.Tensor((K, N), dtype) C = T.empty((M, N), dtype)
with T.Kernel(T.ceildiv(N, block_N), T.ceildiv(M, block_M), threads=256) as (bx, by): A_shared = T.alloc_shared((block_M, block_K), dtype) B_shared = T.alloc_shared((block_K, block_N), dtype) C_local = T.alloc_fragment((block_M, block_N), accum_dtype)
# 两个 mbarrier:数据就绪、计算完成 data_is_ready = T.alloc_barrier(arrive_count=128) compute_is_done = T.alloc_barrier(arrive_count=128)
with T.ws(1): T.clear(C_local)
for ko in T.Pipelined(T.ceildiv(K, block_K), num_stages=0): with T.ws(0): # warp 组 0:生产者 T.barrier_wait(compute_is_done, (ko + 1) % 2) T.tma_copy(A[by * block_M, ko * block_K], A_shared, barrier=data_is_ready) T.tma_copy(B[ko * block_K, bx * block_N], B_shared, barrier=data_is_ready) T.barrier_arrive(data_is_ready) with T.ws(1): # warp 组 1:消费者 T.barrier_wait(data_is_ready, ko % 2) T.gemm(A_shared, B_shared, C_local) T.barrier_arrive(compute_is_done)
with T.ws(1): T.copy(C_local, C[by * block_M, bx * block_N])
return C代码来源:tile-ai/tilelang examples/warp_specialize/example_warp_specialize_gemm_copy_0_gemm_1.py,注释与省略了 host 侧测试部分。
逐行读:
threads=256配合T.ws(0)/T.ws(1):256 条线程被分成两个 warp 组,名字里的copy_0_gemm_1就是在说”组 0 负责 copy、组 1 负责 gemm”。T.alloc_barrier(arrive_count=128)分配并初始化 mbarrier,arrive_count=128表示需要 128 次 arrive 才算一次完整的到达计数——正好是一个 warp 组的线程数(128 条线程 = 4 个 warp)。T.barrier_wait(compute_is_done, (ko + 1) % 2)里的第二个参数是 phase(相位)。mbarrier 的相位每完成一轮到达就翻转一次,用(ko+1) % 2和ko % 2交替取 0/1,就能在不重置 barrier 的情况下区分”上一轮”和”这一轮”,这是 CUDA 里管 mbarrier 的标准手法。T.tma_copy(..., barrier=data_is_ready)把 TMA 传输直接绑到 barrier 上:TMA 硬件完成传输后自动 arrive,生产者侧再补一次T.barrier_arrive(data_is_ready)凑满计数。这样消费者侧的T.barrier_wait才能确认数据真的到了共享内存。- 生产者循环体里的第一句是”等消费者把上一轮算完”,消费者循环体里的最后一句是”告诉生产者我算完了”——这是一个标准的双向握手,保证共享内存不会被提前覆写。
T.clear(C_local)和最后的T.copy都放在T.ws(1)里,因为C_local是消费者私有的寄存器片段。
对比一下:同样的逻辑在纯 CUDA 里要写 mbarrier 初始化、cp.async.bulk.tensor 的描述符、mbarrier.arrive.expect_tx、以及精心安排的 elect.sync 让单个线程发起 TMA。TileLang 把这一整套压成了四个原语。
顺便说一句,T.ws 不是唯一的路径。在 MLA 解码这种更复杂的场景里,官方示例走的是更原始的一层——examples/deepseek_mla/example_mla_decode_ws.py 里直接手写 T.alloc_barrier、T.barrier_wait、T.wgmma_gemm、T.wait_wgmma、T.set_max_nreg(240, 1)(给不同 warp 组分配不同的寄存器额度)和 T.get_thread_binding()。T.set_max_nreg 这个 API 的存在本身就说明了特化的意义:setmaxnreg 是 Hopper 提供的指令,允许生产者 warp 主动把寄存器让给消费者 warp,而寄存器数量正是限制 Tensor Core 性能的关键资源之一。
Host Codegen:把一微秒还给 GPU
问题的量级
前面所有优化都在 GPU 侧,但 V4 报告专门用一个小标题讲了一个 CPU 侧的问题:
Reducing Invocation Overhead with Host Codegen. As accelerators continue to grow in performance, CPU-side orchestration overhead becomes increasingly prominent. For small, highly optimized kernels, such fixed host overhead can easily cap utilization and throughput. A common source of this overhead is that host-side logic, such as runtime contract checks, is typically written in Python for flexibility and thus incurs a fixed per-invocation cost.
逻辑很朴素:GPU 越快,固定开销占比越高。一个 kernel 本体跑 5 微秒,如果每次调用都要花 30 微秒在 CPU 上做参数检查,那么 GPU 有 85% 的时间在等 CPU。对 V4 这种”几百个融合 kernel”的模型来说,这不是边角问题——每一层都有好几个 kernel,每个 kernel 都要付这笔钱。
这笔钱具体花在哪?PyTorch 的调用路径上,一次 kernel(a, b, c) 要经过 Python 层的函数调用、torch.Tensor 的属性访问(dtype、shape、stride、device)、dispatcher 的 key 计算与分发、以及框架层面的各种检查。这些动作单个只要几百纳秒到几微秒,但叠加起来就是几十微秒。
TileLang 的解法
报告给出的方案叫 Host Codegen,核心是在编译期把 host 侧的逻辑也生成出来:
Specifically, we first co-generate the device kernel and a lightweight host launcher at the IR (Intermediate Representation) level, embedding the necessary metadata—such as data types, rank/shape constraints, and stride/layout assumptions—parsed from the language frontend. The launcher is then lowered to the host source code built on top of the TVM-FFI framework, whose compact calling convention and zero-copy tensor interop together minimize host-side overhead. At runtime, this generated host code performs validation and argument marshaling, shifting all per-invocation checks out of the Python execution path.
拆成四步:
- 在 IR 层同时生成设备 kernel 和 host launcher。也就是说,编译器不只是把 tile 程序变成 CUDA,还同时产出一个”启动器”。
- 把元数据嵌进 launcher:数据类型、rank/形状约束、stride/layout 假设——这些信息本来在前端 AST 里就有(
T.Tensor((M, K), T.float16)白纸黑字写着),编译期就能固化成常量。 - launcher 降低成基于 TVM-FFI 的 host 源码。TVM-FFI 的调用约定紧凑,并且支持零拷贝的 tensor 互操作——传进去的是张量的指针和形状,不需要在 Python 和 C++ 之间做数据搬移或格式转换。
- 运行时的校验和参数编组全部由生成的 host 代码做,Python 路径上只剩下”把张量递过去”这一个动作。
效果:报告的实测结论是 CPU 侧校验开销”从几十到几百微秒,降到每次调用不到一微秒”(原文:drops from tens or hundreds of microseconds to less than one microsecond per invocation)。
这套机制在仓库里的样子
TileLang 仓库里能找到这条链路的完整骨架。tilelang/backend/README.md 给出了后端架构:
target-backend language dialect | v frontend IR | vshared BackendContext resolution | vtarget-backend PassPipeline | vhost/device split | +-----------> HostCodegen ----+ | | +-----------> DeviceCodegen --+ v shared ExecutionBackend Build -> Load -> Launch来源:tile-ai/tilelang tilelang/backend/README.md
关键是中间那个 host/device split:IR 在这里被切成两份,一份往下走 HostCodegen(生成主机侧源码),一份走 DeviceCodegen(生成设备源码),最后由执行后端负责 Build、Load、Launch。仓库里对应的实现是 tilelang/backend/host_codegen.py,它注册了两个 host codegen 入口:
STANDARD_HOST_CODEGENS: Mapping[str, HostCodegen] = MappingProxyType( { "c": HostCodegen("c", build=global_func_host_codegen("target.build.tilelang_c_host")), "llvm": HostCodegen("llvm", build=global_func_host_codegen("target.build.llvm")), })代码来源:tile-ai/tilelang tilelang/backend/host_codegen.py
target.build.tilelang_c_host 就是生成 C 语言的 host 代码。对应的 C++ 实现在 src/backend/common/codegen/codegen_c_host.cc。仓库里甚至专门有一个 maint/host_checks/ 目录,把 host 侧要做的检查逐条列成了可运行的复现用例:参数个数不匹配、指针类型错误、维度不匹配、dtype 不匹配、形状不匹配、stride 不匹配、设备类型不匹配、设备 ID 不匹配、空指针、标量类型不匹配——刚好十项。这十项就是”从 Python 挪到生成代码里”的那些检查。
把这些散落的证据拼起来,Host Codegen 的设计意图就非常清楚了:校验逻辑的内容不变,变的只是它在哪执行。 放在 Python 里,每次调用都要重建一遍;放在编译期生成的 C 代码里,检查变成几条整数比较和指针判空,编译器还能顺手把它们优化掉一部分。这就是”几十微秒到一微秒以内”这个数量级差距的来源。
对做推理系统的人来说,这个数字值得记住。当你在设计一个小 kernel 密集的模型时,主机侧的开销不是”次要项”,它可能比 kernel 本身还贵。
Z3:用形式化方法换更激进的优化
为什么编译器需要”证明”的能力
编译器在优化时必须回答大量”某个条件是否一定成立”的问题。在 TileLang 这类 tile DSL 里,这些问题几乎全是整数问题:
- 布局推断:这条
T.Parallel循环的访问模式,是否对所有合法索引都落在 buffer 边界内?如果不是,需要加谓词。 - 向量化:这 8 个连续迭代对应的地址是否连续、是否对齐?只有证明成立了,才能合并成一条向量指令。
- 内存冒险检测(memory hazard detection):这两条语句访问的地址区间是否一定不相交?只有证明不相交,才能安全地重排它们的顺序。
- 边界分析(bound analysis):这个索引表达式的取值范围是什么?决定了 buffer 要分配多大、谓词要怎么写。
V4 报告对这一点的描述是:
TileLang kernels involve complex tensor index arithmetic that requires strong formal integer analysis. During compilation passes such as layout inference, memory hazard detection, and bound analysis, the compiler must verify whether integer expressions satisfy specific properties to enable the corresponding optimizations. Therefore, stronger formal analysis capabilities can unlock more advanced and complex optimization opportunities.
注意最后一句的因果关系:分析能力越强,能安全做的优化越多。这是一个典型的编译器困境——传统做法是”分析不了就保守处理”,保守处理的代价就是性能。比如证明不了”这 8 个地址连续”,就只能退化成 8 次标量访存,带宽利用率直接掉一个数量级。
为什么是 QF_NIA
TileLang 的选择是把整数表达式翻译成 Z3 的无量词非线性整数算术(Quantifier-Free Non-linear Integer Arithmetic,QF_NIA):
We strike a balance between computational overhead and formal expressiveness by translating TileLang’s integer expressions into Z3’s quantifier-free non-linear integer arithmetic (QF_NIA).
选择 QF_NIA 而不是更强的理论(比如带量词的算术),核心考虑是”表达力够用且可判定”。而选择它而不是只用一个整数线性规划(ILP)求解器,是因为线性不够用。报告里说得很明白:
Based on Integer Linear Programming (ILP) solvers, QF_NIA seamlessly resolves standard linear integer expressions common in kernels. Furthermore, its inherent non-linear reasoning capacity effectively addresses advanced challenges like vectorization over variable tensor shapes.
前一句意思是:kernel 里最常见的线性整数表达式,QF_NIA 处理起来和 ILP 一样轻松(因为线性是它的子集,且 SMT 求解器内部就带线性算术的专用推理)。后一句才是关键:变长张量上的向量化属于非线性问题。
这里的”非线性”从哪来?举一个真实场景:V4 的输入序列长度是可变的,某个 buffer 的形状写成 T.dyn["K"] 这样的符号维度,那么索引表达式里就会出现 i * K + j 这种两个变量相乘的项。要证明”这样访问在 K 取任意合法值时都是连续的、对齐的”,就需要非线性推理能力。纯 ILP 在这里会直接放弃,编译器就只能生成保守代码。
代价也被控制住了:
Under reasonable resource limits, Z3 elevates overall optimization performance while restricting compilation time overhead to just a few seconds. The impact is substantial across multiple passes, including vectorization, barrier insertion, and code simplification.
“限制在几秒的编译时间开销”——对 JIT 编译来说这是一个可以接受的数量级(对比一下:CUTLASS 模板展开动辄几分钟)。换个角度算账:多花几秒编译时间,换来的是 vectorization、barrier insertion、code simplification 三个 pass 的优化质量提升,而这个 kernel 会在生产环境里被调用几百万次。这笔投资几乎总是划算的。
集成细节
Z3 是在 2025 年 12 月合入 TileLang 主线的(PR #1367,标题是 “Integrate Z3 in TVM Arith Analyzer”)。也就是说,Z3 不是 TileLang 自己造的一层新分析器,而是直接增强 TVM 的算术分析器——所有依赖 Analyzer.can_prove 的 pass 自动获得更强的证明能力,不需要逐个改造。
PR 描述里给出的能力边界很清楚:只支持整数表达式,TVM 的 lanes 和 vscales 不支持。新增的 API 有四个:analyzer.get_smtlib2() 导出 SMTLIB2 格式的约束、analyzer.get_smtlib2(expr) 额外把待证表达式加进去、analyzer.set_z3_timeout_ms(t) 设超时、analyzer.set_z3_max_step(step) 设最大步数。后两个是资源限制的旋钮——形式化方法必须能”算不出来就放弃”,否则编译时间不可控。
PR 里有一个很好的例子。给定约束 ,要证明:
这个命题在整数算术下是真的(因为 )。用 Z3 接口写出来是:
from tvm.tir.expr import Var, Andfrom tvm.arith import Analyzer
analyzer = Analyzer()a = Var('a', 'int32')b = Var('b', 'int32')c = Var('c', 'int32')
with analyzer.constraint_scope(And(And(a > 0, b > 0), c > 0)): try_to_prove = (a - b) // c * c + b <= a print(analyzer.can_prove(try_to_prove))代码来源:tile-ai/tilelang PR #1367
它内部生成的 SMTLIB2 表达式也能打印出来(这里截取了添加待证命题后的关键部分):
(set-option :timeout 5)(declare-fun a () Int)(declare-fun b () Int)(declare-fun c () Int)(assert (<= (- 2147483648) a))(assert (<= a 2147483647)); ... b、c 的 int32 范围约束 ...(assert (and (> a 0) (> b 0) (> c 0)))(assert (let ((?x53 (- a b))) (let ((?x54 (div ?x53 c))) (let ((?x55 (* ?x54 c))) (let ((?x56 (+ ?x55 b))) (let (($x57 (<= ?x56 a))) (not $x57)))))))(check-sat)注意 (assert ... (not $x57)) 这个写法:SMT 里证明” 恒真”的标准做法是断言 并检查可满足性——如果 unsat,说明找不到反例,命题成立。这是一个很值得记的细节,因为它解释了形式化方法在编译器里的正确性来源:不是”我算了几个例子都对”,而是”不存在任何反例”。
为什么这是 DSL 编译器值得走的一步
把 Z3 集成进编译器,本质上是在做一个权衡交易:用编译期的一次性形式化求解,换运行时的优化自由度。
传统编译器在遇到”不确定”的整数表达式时,选项只有保守(不优化)或激进(假设成立,错了就错)。这是为什么很多编译器有 -ffast-math 之类的开关——它们把正确性赌在用户的承诺上。Z3 提供的是第三条路:把”我不知道”变成”我能证明”或者”我证明不了”。证明得了就放开做,证明不了就保守,绝不会出现”假设错了但编译通过了”。
对 TileLang 这种要同时保证性能和正确性的场景,这条路几乎是必须的。前面说过,V4 要求逐比特可复现——如果编译器对索引表达式的处理在边界情况下出错,产生的不只是性能问题,而是数值结果不可复现,这会让”用 TileLang 写的 kernel 与手写 CUDA 对齐”这件事彻底失效。用可判定的形式化方法把这类风险关掉,是让整个可复现性叙事成立的技术前提。
从数字看 TileLang 拿到了什么
V4 报告没有给出”用 TileLang 之后总吞吐提升多少”这样的端到端数字,但 TileLang 论文里的数据可以说明它的性能水位:
- MLA 解码:在 H100 上,TileLang 实现达到手写优化 FlashMLA 的 98%,代码量约 70 行 Python;在 MI300X 上达到手写 AITER 库的 95%。相对 Torch 的加速分别是 1075.9 倍与 129.2 倍。
- FlashAttention:相对 FlashAttention-3 加速 1.36 倍,相对 Triton 1.41 倍,相对 PyTorch 1.70 倍。论文解释了为什么能手写库更快:FlashAttention-3 的 tile 尺寸是固定的,序列长度较短时会次优;而 TileLang 的实现能按 workload 调整。
- GEMM:在 RTX 4090、A100、H100、MI300X 上,相对厂商库分别是 1.10、0.97、1.00、1.04 倍——也就是基本持平;相对 Triton 是 1.08、1.03、1.13、1.25 倍。
- 线性注意力:相对 Triton 平均加速 1.77 倍与 2.10 倍。
这些数字加起来说明一件事:用 DSL 写不等于性能妥协。这正是 DeepSeek 敢于把 V4 的热路径交给 TileLang 的前提。论文里也有一句很实在的话,说明作者对局限是清醒的:
Second, we aim to extend TileLang to support a range of distributed scenarios by introducing tile-level communication primitives and scheduling policies.
也就是说,截至论文写作时,TileLang 的原语只覆盖”单卡内的 tile 级计算”,跨卡通信还是得靠别的库——这直接引出下一节。
MegaMoE2:把 MoE 的五个阶段融成一个 kernel
背景:MoE 层本来长什么样
一个专家并行(Expert Parallelism,EP)下的 MoE 层,可以拆成四个阶段:Dispatch(把 token 按路由结果发给对应专家所在的 rank)、Linear-1(专家内的第一个 GEMM,通常是 gate + up 投影)、激活(SwiGLU 加量化转换)、Linear-2(down 投影),最后是 Combine(把结果收集回原 rank)。其中 Dispatch 和 Combine 是通信受限的,两个 GEMM 是计算受限的。
V4 报告的核心观察是:在单个 MoE 层内,通信的总时间小于计算的总时间。
Our profiling reveals that within a single MoE layer, the total time of communication is less than that of the computation. Therefore, after fusing communication and computation into a unified pipeline, computation remains the dominant bottleneck.
这句话是整个设计的地基。既然通信时间本来就少于计算时间,那么只要让两者充分重叠,通信就可以完全藏进计算里——“藏起来”之后,互连带宽就不再是瓶颈。报告于是给出了一个硬件设计的定量建议:设峰值算力 、互连带宽 ,通信能被完全隐藏的条件是
其中 是计算量、 是通信量。对 V4-Pro,每个 token-专家对需要 FLOPs(SwiGLU 的 gate、up、down 三个投影),而通信量只有 字节(FP8 的 Dispatch 加 BF16 的 Combine),于是
报告的解读是:每 1 GB/s 的互连带宽,就足以藏住 6.1 TFLOP/s 的算力对应的通信。一旦带宽达到这个阈值,继续堆带宽的边际收益就很小了。这是一个”建议硬件设计瞄准平衡点,而不是无条件堆带宽”的结论——这种话从一家自研模型的公司嘴里说出来相当罕见,因为它实际上是在告诉硬件厂商”别把成本花在我们不需要的地方”。
从 naive 到 Comet 再到 wave
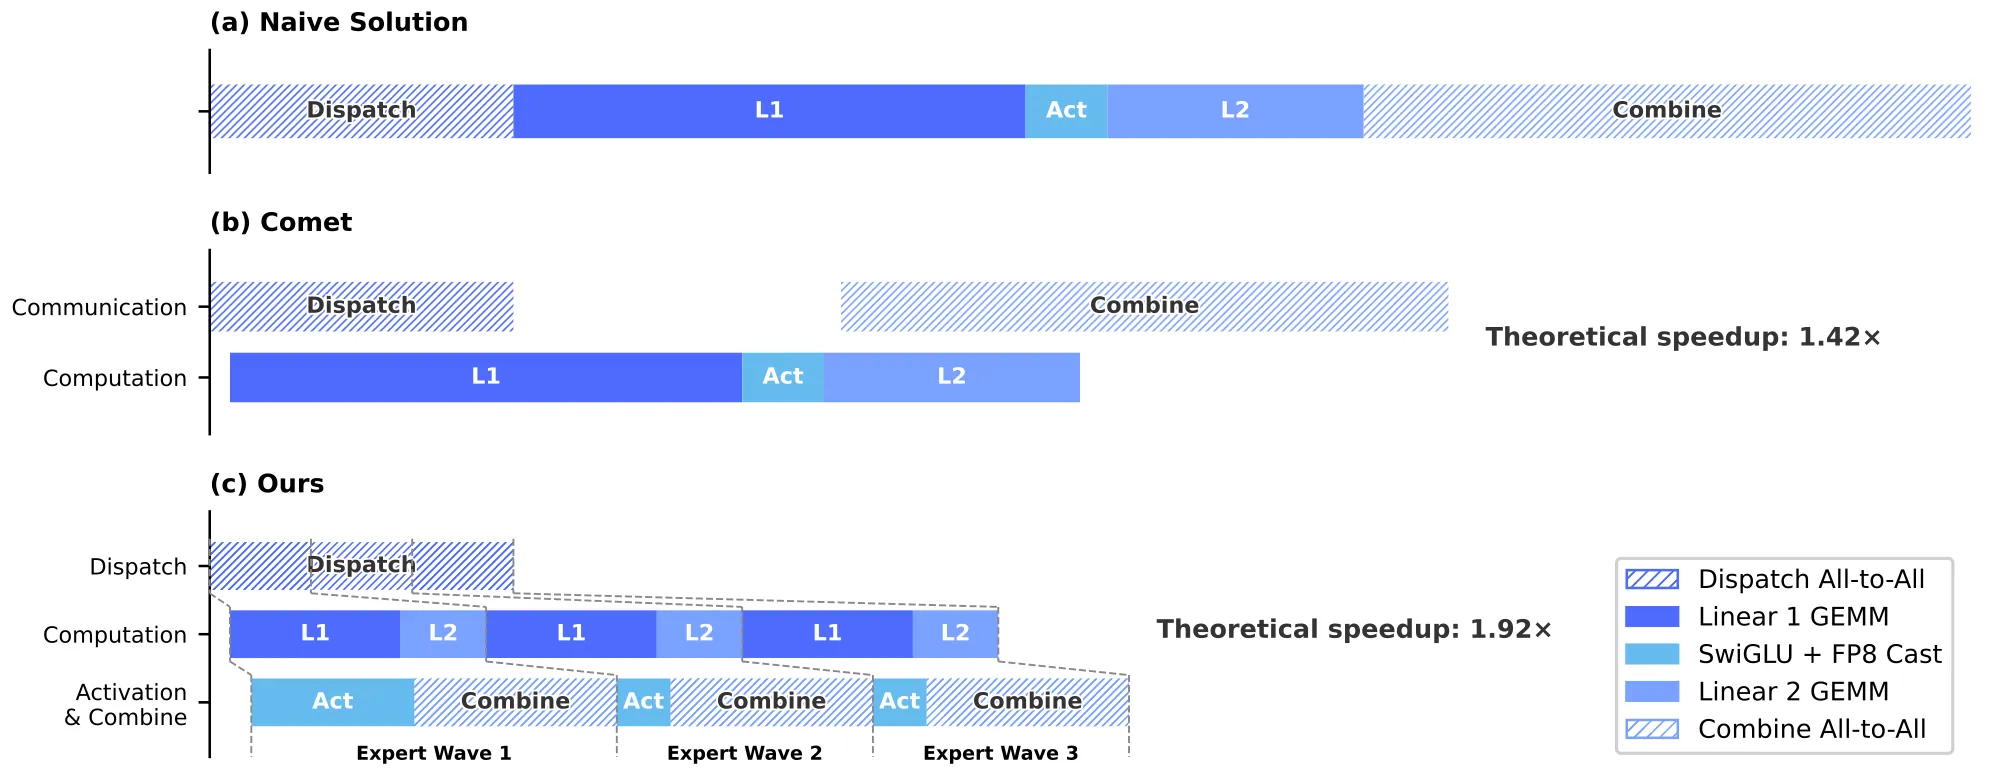
图:V4 技术报告 Figure 5。(a) 朴素方案,Dispatch 与 Combine 完全串行在计算两端;(b) Comet 方案,把 Dispatch 与 Linear-1 重叠、Linear-2 与 Combine 重叠,理论加速 1.42 倍;(c) V4 方案,把专家切成多个 wave,稳态下当前 wave 的计算、下一 wave 的 token 传输、已完成专家的结果发送三者并行,理论加速 1.92 倍。来源:DeepSeek-V4 技术报告 arXiv:2606.19348 Figure 5
这张图是理解 MegaMoE2 的关键,三行分别是三种方案的时间轴:
- (a) 朴素方案:Dispatch(斜纹)→ Linear-1(深蓝)→ 激活(青色)→ Linear-2(浅蓝)→ Combine(斜纹)。五个阶段首尾相接,通信期间计算单元闲着,计算期间网络闲着。
- (b) Comet:把 Dispatch 和 Linear-1 重叠、Linear-2 和 Combine 重叠。通信条和计算条在时间轴上并列了,理论加速比 1.42 倍。但重叠的粒度是”整个 MoE 层的通信”对”整个 MoE 层的计算”,一旦通信量分布不均(比如某个 rank 的专家特别热),重叠就会出现气泡。
- (c) Ours:把专家切成多个 wave(图中是 Expert Wave 1/2/3)。每个 wave 只包含一小部分专家,只要这个 wave 内的专家都收齐了 token,计算就可以立刻开始,不必等其他 wave。稳态下三条流同时跑:当前 wave 的 GEMM、下一个 wave 的 token 传输、以及已完成专家的结果发送。理论加速比 1.92 倍。
“按 wave 切分”的收益在长尾场景下最明显。报告明确指出这套调度的价值在于”极端情况,比如强化学习的 rollout,通常遇到长尾小 batch”。这个逻辑不难理解:如果是常规推理的大 batch,各专家的负载比较均衡,粗粒度重叠就够了;但 RL rollout 时的 batch 小且分布极不均匀,可能三个 token 路由到一个专家、一万个 token 路由到另一个专家,这时候粗粒度重叠会让最热的那个专家成为整层的串行瓶颈。切成 wave 之后,热专家被拆到多个 wave 里,它的计算可以和别的 wave 的通信交错开。
融合到底省掉了什么
“融合”这个词经常被滥用,这里具体拆一下:
- kernel launch 次数:五个阶段变成一次启动。对一个每层都要跑 MoE 的模型,这个数字乘以层数乘以 token 数,非常可观。
- HBM 往返:这是最实质的收益。非融合实现里,Dispatch 的输出必须先写进显存,Linear-1 再从显存读回来;Linear-1 的输出写回显存,激活函数再读一遍、写一遍。融合之后,中间结果可以在片上(共享内存、寄存器、Tensor Memory)流转,只有真正的输入输出才碰 HBM。报告里用了”extreme kernel fusion drives compute, memory, and network to high load simultaneously”这个说法,也就是说这个融合 kernel 会把三类资源同时打满。
- 全局同步:非融合实现里每个阶段之间都要同步——所有 rank 的 Dispatch 都完成才能开始算,所有专家都算完才能 Combine。融进一个 kernel 之后,阶段之间的依赖变成了 kernel 内的 mbarrier 握手,granularity 从”整个 batch”降到”一个 wave”。
- 通信的发起方式:报告在这里有一条很有意思的工程观察——dispatch 阶段采用的是 pull-based(拉取式) 设计,让每个 GPU 主动去读远端 GPU 上的激活值,而不是等对方推过来。原因写得很直白:避免细粒度 push 带来的高通知延迟。报告还顺势给硬件提了个建议——未来如果跨 GPU 的信号延迟能降下来,push 会变得可行,通信模式也能更自然。
实测数据
MegaMoE2 的 CUDA 实现已经开源,是作为 DeepGEMM 的一个组件放出来的(DeepGEMM PR #304,2026 年 4 月)。同一批 PR 里还有一个专门的性能对比(PR #316),在 8 路专家并行(EP8)下、跨 8 个 rank 取平均:
| 模型 | Batch | 时间 (μs) | 计算 (TFLOPS) | 显存带宽 (GB/s) | 互连带宽 (GB/s) | 相对旧实现加速 |
|---|---|---|---|---|---|---|
| V4-Flash | 1 | 56.5 | 5 | 1311 | 1 | 1.96× |
| V4-Flash | 512 | 146.5 | 1056 | 3192 | 266 | 1.73× |
| V4-Flash | 8192 | 1283.1 | 1928 | 998 | 499 | 1.56× |
| V4-Flash | 32768 | 4855.5 | 2038 | 794 | 529 | 1.62× |
| V4-Pro | 1 | 108.1 | 7 | 1758 | 1 | 1.61× |
| V4-Pro | 512 | 369.6 | 1098 | 4619 | 182 | 1.54× |
| V4-Pro | 8192 | 2818.5 | 2304 | 1094 | 393 | 1.50× |
| V4-Pro | 32768 | 10655.2 | 2438 | 692 | 417 | 1.54× |
数据来源:deepseek-ai/DeepGEMM PR #316。V4-Flash:256 专家、top-k=6、hidden 4096、中间维度 2048;V4-Pro:384 专家、top-k=6、hidden 7168、中间维度 3072。
这张表里有几个值得停下来看的点。
Batch = 1 那一行最能说明问题:只有 5 TFLOPS 的计算、1 GB/s 的互连带宽,加速比却有 1.96 倍。这是纯延迟场景——GPU 大部分时间在等,融合省下的是启动、同步和等待的时间。这也解释了报告里”延迟敏感场景最高 1.96 倍”这个说法。
Batch 8192 那一行是带宽场景:V4-Pro 跑到 4619 GB/s 的显存带宽(在 batch 512 时),说明这个 kernel 是中段偏大 batch 时把 HBM 打满了。到了 32768,计算涨到 2438 TFLOPS,显存带宽反而降到 692 GB/s——因为大 batch 下算术强度提高,计算成了瓶颈。
表格标题里的”vs legacy” 指的是与非融合实现对比。这 1.50 到 1.96 倍的区间,正是报告里”通用推理负载 1.50–1.73 倍、延迟敏感场景最高 1.96 倍”的来源。
还有一个数字对得上:报告里说理论加速比是 1.92 倍,而实际在 batch 1 的 V4-Flash 上测到了 1.96 倍。超过了理论值这个现象其实不矛盾——理论模型算的是流水线的重叠收益,而实际实现还额外省掉了非融合版本里的 kernel launch 和 HBM 往返,那部分不在理论模型里。
一件常被忽略的事:这个 kernel 是在两套硬件上跑通的
报告在讲性能之前,先说了一句:
We validated the fine-grained EP scheme on both NVIDIA GPUs and HUAWEI Ascend NPUs platforms.
这句话的分量在于,昇腾平台上跑的不是”某个简化版本”,而是同一个细粒度 EP 方案。结合 TileLang 本身的多后端设计,这构成了 V4 报告里”去 NVIDIA 化”叙事的完整链条:算法(MXFP4 量化感知训练,可参考 面试疑难(三)里对 MXFP4 与 FP4 的讨论)+ 语言(TileLang)+ 通信 kernel(MegaMoE2) 三层同时不依赖单一厂商。
逐比特可复现:为什么 DeepSeek 愿意为它付性能代价
batch invariance 是什么
V4 报告第 3.3 节标题是”High-Performance Batch-Invariant and Deterministic Kernel Libraries”,目标写得很清楚:
Therefore, we implement end-to-end, bitwise batch-invariant, and deterministic kernels with minimal performance overhead. These kernels are helpful for debugging, stability analysis, and consistent post-training behavior.
两个概念:
- batch invariance(批不变性):给定一个 token,它在 batch 里的位置不影响输出,且输出的每一位(bit)都相同。也就是说,同一个请求单独跑和混在一百个请求里跑,结果完全一致。
- determinism(确定性):同一个输入跑两次,结果完全一致。
这两件事在 GPU 上都不是自动成立的。浮点加法不满足结合律,,所以只要并行归约的分组方式变了,结果就会变。而 GPU 上”分组方式”恰恰是最容易变的东西:SM 数量、warp 划分、线程块的调度顺序、是否用了 split-K,都会影响归约的树形结构。
为了实现它,DeepSeek 放弃了什么
报告把代价写得很坦率,三处:
注意力:不能用 split-KV。 split-KV(论文引用 Dao et al., 2023,也就是 FlashDecoding 的思路)把一个序列的注意力计算拆到多个 SM 上跑,用来平衡负载。论文原文:
To achieve batch invariance, we cannot use the split-KV method, which distributes the attention computation for a single sequence across multiple Stream Multiprocessors (SMs) to balance the load of SMs. However, abandoning this technique will lead to severe wave-quantization problems.
wave quantization(波量化)指的是:如果总工作量不是恰好填满整数个”波次”,最后一波会有大量 SM 闲置。batch 小的时候这个问题尤其严重——比如只有 3 个序列要算,而 SM 有 132 个,那 129 个 SM 就只能看着。
DeepSeek 的方案是双 kernel 策略:第一个 kernel 把整个序列的注意力放在单个 SM 内算完,这样计算路径完全确定;第二个 kernel 专门服务最后一个填充不满的波次,用多个 SM 处理单个序列来减少延迟。为了保证两个 kernel 的输出逐比特一致,第二个 kernel 的计算路径被精心设计成与第一个 kernel 完全相同的累加顺序,并且利用 thread-block cluster 的分布式共享内存(Distributed Shared Memory,DSM)在 SM 之间做高速数据交换。报告的结论是这套方法把 batch-invariant 解码的开销压到了”可忽略”。
矩阵乘:不能用 split-K,还要换掉 cuBLAS。 报告写得更直接:
Traditional cuBLAS library cannot achieve batch invariance. Therefore, we replace it end-to-end with DeepGEMM. Furthermore, for very small batch sizes, conventional implementation usually employs split-k techniques to improve performance. Unfortunately, split-k techniques cannot guarantee batch invariance, a pivotal feature in DeepSeek-V4. Therefore, we abandon split-k in most scenarios, which, however, may cause performance degradation. To address this, we introduce a set of optimizations that enable our implementation of matrix multiplication to match or even surpass the performance of standard split-k in most major scenarios.
这段信息的密度很高:cuBLAS 做不到 batch invariance,所以 V4 端到端换成自研的 DeepGEMM;小 batch 下常规做法是上 split-k,但 split-k 同样保证不了 batch invariance,所以放弃;放弃会导致性能下降,于是又做了一组优化把性能补回来,声称在大多数主要场景下能追平甚至超过标准 split-k。这里值得记的是”补回来”这件事的难度——split-K 本来就是为小 batch 场景设计的,放弃它等于放弃了那个场景下的标准答案,必须用别的手段(大概是更好的 tile 调度和 persistent kernel 设计)把利用率重新拉起来。
确定性:三处 atomicAdd 带来的不确定性逐个消掉。 报告列出训练中三处非确定性来源,全部与”多个 SM 并发写同一块 buffer”有关:
- 注意力反向:常规实现用
atomicAdd累加 KV token 的梯度,浮点加法的非结合性导致顺序不确定。解法是为每条 SM 分配独立的累加 buffer,最后做一次全局的确定性求和。这是把”并发写”换成”分区写 + 归约”的标准手法,代价是额外的显存和一次额外的归约 kernel。 - MoE 反向:来自不同 rank 的多个 SM 并发写接收端 rank 上的同一 buffer 时,“协商写入位置”这个过程本身就不确定。解法是每个 rank 内部先做 token 顺序预处理(让写入位置在本地就确定下来),再加上跨 rank 的 buffer 隔离。
- mHC 里的矩阵乘:mHC 有一个输出维度只有 24 的矩阵乘,小 batch 下被迫用 split-k,而朴素实现会导致非确定性。解法是把每个 split 部分单独输出,再用后续 kernel 做确定性归约——性能和确定性都保住。
注意这三处的解法模式是一致的:把不确定的并发写入,换成确定的分区写入加一次有序归约。 代价都是多一次归约,收益是每一处都变成可复现的。
为什么 RL 特别需要这个
报告在讲 rollout 服务时提到了一个更底层的动机。RL/OPD 的 rollout 服务要可抢占、可容错,DeepSeek 的实现是给每个生成请求写一份 token 粒度的预写日志(Write-Ahead Log,WAL)。被抢占时暂停引擎、保存未完成请求的 KV Cache;恢复时用日志和 KV Cache 接着解码。报告接下来的一段话值得原文引用:
Importantly, it is mathematically incorrect to regenerate unfinished requests from scratch, as this introduces length bias. Because shorter responses are more likely to survive interruption, regenerating from scratch makes the model more prone to producing shorter sequences whenever an interruption occurs.
这段话点出了一个统计偏差问题:如果每次中断都从头重新生成,那么中断会系统性地偏向短序列(因为短序列更可能跑完),模型就学会了”遇到中断就变短”。这是数学上错误的行为,不是工程瑕疵。报告给出的两条出路是:要么精确恢复(用 WAL),要么在一个 batch-invariant 且确定性的推理栈上、用一致的随机种子重新生成。后者仍然要重跑解码,效率更低,但它之所以能成立,恰恰是因为整个推理栈是确定性的。
这解释了一个看起来奇怪的工程取舍:DeepSeek 愿意为了逐比特可复现付出性能代价,是因为不做这件事,RL 的数据分布本身就是错的。
数值精度的三条规矩
第 3.2 节末尾单独讲了数值精度与逐比特可复现的关系,给出了三条具体规矩:
- 默认关闭 fast-math。编译器层面关掉,不做那些”数学上等价但数值上不等价”的变换(比如把除法变成乘以倒数、把
x/y重排成x * (1/y))。 - 有损近似只能显式开启。
T.__exp、T.__log、T.__sin这类快而不准的算子,必须由用户在前端显式写出——不能由编译器”顺手”替换。 - 需要严格 IEEE-754 时给专用内建。
T.ieee_fsqrt、T.ieee_fdiv、T.ieee_add这些允许显式指定舍入模式,让用户能精确控制数值行为。
还有一条关于”对齐”的:
We also target bitwise reproducibility for validating kernels against hand-written CUDA baselines. We align TileLang’s algebraic simplification and lowering rules with mainstream CUDA toolchains (e.g., NVCC) to avoid transformations that introduce unintended bit-level differences. Layout annotations (e.g., T.annotate_layout) further allow users to pin down layout-dependent lowering decisions, keeping evaluation and accumulation order consistent with the reference CUDA implementation and thus enabling bit-identical outputs when desired.
也就是说,TileLang 的代数化简规则是主动向 NVCC 对齐的——目的不是”更聪明”,而是”不要聪明到产生位级差异”。加上 T.annotate_layout 能钉死与参考实现一致的累加顺序,整条链路才具备”和手写 CUDA 输出逐比特一致”的能力。
最后,报告给了一个让这整套设计更容易被接受的结论:这些以精度和可复现为优先的默认选择,并没有牺牲性能——保守默认下 kernel 仍然有竞争力,同时提供了”按需放开数值约束换速度”的旋钮。
回到最初那个对照:编译器一贯的默认路线是把精度当成可以交换的资源——允许重排、允许近似、换取更快的代码;而 DeepSeek 需要的是”可复现”。当你的核心业务是 RL,可复现性的价值高于几个百分点的吞吐——但前提是,几个百分点的吞吐确实只值几个百分点,而不是几十个百分点。V4 报告那段话就是在证明这后一件事。
TileKernels:DeepSeek 把内核库也开源了
2026 年 4 月,DeepSeek 开源了 TileKernels——一个用 TileLang 写的 LLM 算子库,MIT 许可。这是 V4 那条”几百个 ATen 算子换成融合 kernel”的公开化:虽然不可能是全部(报告说的是”内部训练和推理场景中已经使用”),但足以看出这套 kernel 的组织方式。
仓库的模块划分本身就是一张 V4 架构的侧面图:
tile_kernels/├── moe/ # MoE 路由相关:top-k 门控、token 到专家映射、融合扩展/归约、权重归一化├── quant/ # FP8/FP4/E5M6 量化:per-token、per-block、per-channel 转换├── transpose/ # 批量转置├── engram/ # Engram 门控:融合 RMSNorm、前向/反向、权重梯度归约├── mhc/ # 流形约束超连接:Sinkhorn 归一化、mix 的拆分与应用├── modeling/ # 高层 torch.autograd.Function 封装,把底层 kernel 组合成可训练层├── torch/ # PyTorch 参考实现└── testing/ # 测试与基准工具来源:deepseek-ai/TileKernels README
几个观察:
第一,模块名直接对应 V4 的架构组件。engram(条件记忆,DeepSeek 与北大联合提出的稀疏轴)、mhc(流形约束超连接,V4 用来替换传统残差连接)都是 V4 新引入的结构。这些算子在 PyTorch 里没有现成实现,只能自己写——这正是”自研 DSL”最直接的应用场景。
第二,torch/ 目录里有 PyTorch 参考实现,testing/ 里有测试与基准工具。这是一个成熟 kernel 库的标志:每个 TileLang kernel 都有一个可对比的参考实现,用来验证正确性。结合 V4 报告里”与手写 CUDA 基线做逐比特对齐”的说法,这套基础设施是刻意搭起来的。
第三,modeling/ 层是 torch.autograd.Function 封装。这一点说明了 DeepSeek 的野心不只是”写 kernel”,而是”把 kernel 组合成可训练的层”——包括反向传播。engram/engram_grad_w_reduce_kernel.py 这样的文件名(权重梯度归约)说明反向 kernel 也是用 TileLang 写的。
环境要求也值得记一下,因为它划定了这套东西的适用范围:
Python 3.10 或更高PyTorch 2.10 或更高TileLang 0.1.9 或更高NVIDIA SM90 或 SM100 架构 GPUCUDA Toolkit 13.1 或更高来源:deepseek-ai/TileKernels README
“SM90 或 SM100”意味着 Hopper 与 Blackwell;“TileLang 0.1.9 或更高”给出了语言版本的下限。这不是一个”什么卡都能跑”的通用库,而是明确为现代 NVIDIA 数据中心 GPU 写的。
看一个具体的例子,感受一下”小算子”用 TileLang 写出来是什么样。下面是 mHC 的 Sinkhorn 归一化 kernel(前向),它的数学内容就是反复做行归一化和列归一化,把矩阵迭代成一个双随机矩阵:
import tilelangimport torchfrom tilelang import language as T
_PASS_CONFIGS = { tilelang.PassConfigKey.TL_DISABLE_WARP_SPECIALIZED: True,}
@tilelang.jit(pass_configs=_PASS_CONFIGS)def _mhc_sinkhorn_fwd(hidden_size: int, token_block_size: int, repeat: int, eps: float) -> tilelang.JITKernel: num_tokens = T.dynamic('num_tokens')
@T.prim_func def mhc_sinkhorn_kernel( comb_res_mix: T.Tensor[(num_tokens, hidden_size, hidden_size), T.float32], comb_res_mix_out: T.Tensor[(num_tokens, hidden_size, hidden_size), T.float32], ) -> None: with T.Kernel(T.ceildiv(num_tokens, token_block_size)) as pid_x: comb_frag = T.alloc_fragment((token_block_size, hidden_size, hidden_size), T.float32) row_sum = T.alloc_fragment((token_block_size, hidden_size), T.float32) col_sum = T.alloc_fragment((token_block_size, hidden_size), T.float32)
T.copy(comb_res_mix[pid_x * token_block_size, 0, 0], comb_frag)
# 行方向 softmax,再加 eps 保证严格正 row_max = T.alloc_fragment((token_block_size, hidden_size), T.float32) T.reduce_max(comb_frag, row_max, dim=2) for i, j, k in T.Parallel(token_block_size, hidden_size, hidden_size): comb_frag[i, j, k] = T.exp(comb_frag[i, j, k] - row_max[i, j]) T.reduce_sum(comb_frag, row_sum, dim=2) for i, j, k in T.Parallel(token_block_size, hidden_size, hidden_size): comb_frag[i, j, k] = comb_frag[i, j, k] / row_sum[i, j] + eps
# 列方向归一化 T.reduce_sum(comb_frag, col_sum, dim=1) for i, j, k in T.Parallel(token_block_size, hidden_size, hidden_size): comb_frag[i, j, k] = comb_frag[i, j, k] / (col_sum[i, k] + eps)
# 交替迭代 repeat - 1 次 for _ in T.serial(repeat - 1): T.reduce_sum(comb_frag, row_sum, dim=2) for i, j, k in T.Parallel(token_block_size, hidden_size, hidden_size): comb_frag[i, j, k] = comb_frag[i, j, k] / (row_sum[i, j] + eps) T.reduce_sum(comb_frag, col_sum, dim=1) for i, j, k in T.Parallel(token_block_size, hidden_size, hidden_size): comb_frag[i, j, k] = comb_frag[i, j, k] / (col_sum[i, k] + eps)
T.copy(comb_frag, comb_res_mix_out[pid_x * token_block_size, 0, 0])
return mhc_sinkhorn_kernel代码来源:deepseek-ai/TileKernels tile_kernels/mhc/sinkhorn_kernel.py,略有删节。
这段代码把前面所有概念串起来了:
T.dynamic('num_tokens')声明运行时才知道的符号维度(推理时 token 数不固定),这就是 Z3 非线性推理要处理的那类变量。- 整个 kernel 只有 一个 grid 维度(
T.Kernel(...)不传轴名,只有一个轴),threads 用默认值 128。Sinkhorn 是纯元素级 + 归约的算子,没有矩阵乘,不需要 Tensor Core,也不需要复杂的分块。 - 所有中间结果都在 fragment(寄存器)里:
comb_frag、row_sum、col_sum、row_max。数据只从 HBM 进一次、出一次。这正是”小算子融合”的核心收益所在——如果把 softmax、除法、求和拆成四个独立的 PyTorch 算子,每一步都要把(tokens, hidden, hidden)这么大的张量写回显存再读出来。 - 三维的
T.Parallel(token_block_size, hidden_size, hidden_size)和T.reduce_sum(..., dim=2)都是声明式的:用户说”对第 2 维求和”,编译器负责决定这个归约走 warp shuffle 还是走共享内存,以及如何与已有的 layout 兼容。 pass_configs={...TL_DISABLE_WARP_SPECIALIZED: True}是一个反向的例子——这个 kernel 是纯计算密集型的元素级操作,warp 特化(把一部分 warp 变成生产者)对它没有意义,反而会增加 mbarrier 的开销。所以显式关掉。这是一个很好的示范:自动优化不等于无条件开启优化,用户需要能关掉它。
值得留意的是 T.serial(repeat - 1):迭代次数是编译期参数,会被展开成循环(这里是串行的,因为每一轮都依赖上一轮)。Sinkhorn 迭代天然串行,这类算子没法通过并行化加速,只能靠”把数据留在寄存器里”来省带宽——这也解释了为什么它适合融合。
生态与硬件可移植性
TileLang 的后端矩阵
截止 2026 年 8 月的 v0.1.13,TileLang 官方仓库里支持的后端可以排成这样一张表:
| 后端 | Target | 平台与硬件 | 支持级别 |
|---|---|---|---|
| NVIDIA CUDA | cuda | Linux x86-64/AArch64、Windows;SM70 到 SM120 | Primary |
| AMD ROCm/HIP | hip | Linux;CDNA 与 RDNA,含 gfx942/gfx950 | Supported |
| Apple Metal | metal | Apple 芯片上的 macOS | Supported |
| LLVM CPU | llvm | 主机 CPU | Experimental |
| NVIDIA CuTe DSL | cutedsl | NVIDIA GPU | Experimental |
| WebGPU | webgpu | WebGPU 运行时 | Experimental |
| 华为昇腾 | Ascend C / NPU IR | Ascend A2、A3 | Ecosystem |
| 沐曦 MetaX MACA | maca | MetaX C500、C600 | Ecosystem |
| 摩尔线程 MUSA | musa | S5000、S4000、M1000 | Ecosystem |
| 海光 HYGON | hcu | BW1000、BW1100、BW150、K100_AI | Ecosystem |
| 曦望 Sunrise-AI TANG | tang | Sunrise S2、S3 | Ecosystem |
数据来源:tile-ai/tilelang README 的 Platform and Backend Support 表
这张表里的 “Ecosystem” 一列是关键:它们不在主仓库里,而是独立仓库,各自跟随独立的兼容节奏——tilelang-ascend、tilelang-metax、tilelang-musa、tilelang-hygon、tilelang-sunrise。这解释了为什么 TileLang 的分支版本号可以各不相同(比如摩尔线程那条线基于 0.1.8)。
这个架构本身就是”可移植性”的答案:数据流是硬件无关的,后端是硬件相关的。 一个用 TileLang 写的 Sinkhorn、一个稀疏注意力、一个量化算子,换后端时改的是编译目标,不是算法描述。V4 报告里那句”降低向国产芯片迁移的成本”,落到工程上就是这个意思,可参考 AI 编译器开发工程师那篇里对”从计算图到后端指令”这条流水线的拆解。
摩尔线程:Day-0 支持
2026 年 4 月 24 日,摩尔线程宣布其 TileLang-MUSA 在国产全功能 GPU 上率先实现对 DeepSeek-V4 TileKernels 的 Day-0 支持,也就是说模型开源当天就能跑。几个具体事实:
- TileLang-MUSA 基于 TileLang 0.1.8 版本深度优化;
- 该分支已成为 TileLang 官方主线版本;
- 基于 MUSA 架构的 TileLang 原生算子单元测试覆盖率超过 95%;
- MUSA 后端仓库已经开源(
tile-ai/tilelang-musa)。
来源:至顶网:Day-0 支持,摩尔线程 TileLang-MUSA 率先支持 DeepSeek-V4 全新 TileKernels
这里最值得琢磨的是”95% 单元测试覆盖率”和”进入官方主线”这两条。“支持一个新后端”很容易做成 demo——挑几个 kernel 跑通就能发新闻;但做到 95% 单测覆盖率、并且把分支合回官方主线,意味着这个后端要长期维护、要跟上游的每次重构保持同步。对 TileLang 来说,这是”多后端”从设计目标变成工程现实的分水岭;对芯片厂商来说,这是”我们的软件栈能接住前沿模型的算子需求”的证明。
顺带说一句,这种”DSL + 多后端”的组合,与 TileRT 那种在特定硬件上做到极致延迟的路线是两种不同的解法:一个赌”语言足够好,换个后端就换一片硬件”;另一个赌”把单点硬件压榨到极限”。V4 报告两个都用了——TileLang 管开发效率与可移植性,MegaMoE2 的手写 CUDA 实现管极限性能。
昇腾:V4 算子的现成清单
昇腾侧的证据更具体。tilelang-ascend 的 v0.1.1.010-release(2026 年 4 月 30 日发布)明确写入了对 DeepSeek V4 算子的支持,给出的示例文件清单是:
examples/deepseek_v4/sparse_flash_attention.py # 稀疏 Flash Attentionexamples/deepseek_v4/hc_split_sinkhorn.py # mHC 拆分与 Sinkhornexamples/deepseek_v4/act_quant.py # 激活量化examples/deepseek_v4/int8_gemm.py # INT8 GEMM来源:tile-ai/tilelang-ascend v0.1.1.010-release
对照一下 NVIDIA 路径的 TileLang 主仓库,examples/deepseek_v4/ 目录下是 act_quant.py、fp8_fp4_gemm_1d1d_sm100.py、sparse_attn_fwd_sm90.py —— 都是 2026 年 5 月通过 PR #2148 加进去的。两边共有的部分是 act_quant.py(激活量化)和稀疏注意力,这恰好是 V4 里最重的两个热路径。
还有一个细节值得记:昇腾那条线的发布说明里,act_quant.py 和 hc_split_sinkhorn.py 都在列,也就是说 mHC 的 Sinkhorn 这种”小算子”也被移植过去了。这印证了前面那个判断——V4 里真正带来移植成本的,不是那些有名有姓的大算子(FlashAttention 类的实现到处都有),而是这些零散、专用、以前只在 CUDA 上存在的小算子。TileLang 的价值恰恰在这样的地方兑现。
三个需要说清楚的 caveat
写到这里,需要把几件容易误解的事情说清楚。
第一,DSL 并不自动等于高性能,TileLang 的默认后端仍依赖 CUTLASS。 论文里提到,CUDA 后端的 T.gemm 默认派发到 NVIDIA 的 CUTLASS;作者把”建立自托管的 Tile Library、彻底去掉对 CUTLASS 和手写 CUDA/HIP 包装代码的依赖”列为未来工作。也就是说,今天 TileLang 的 GEMM 峰值性能仍然部分来自 CUTLASS 而不是 TileLang 自己,论文中”模板展开占编译时间约 90%“这个数字也来自这条路径。
第二,host codegen 的数字来自 DeepSeek 自己的测量。 “从几十到几百微秒降到一微秒以内”这句话出现在 V4 报告里,措辞是 “Our measurements show”,没有给出测试代码、硬件配置或测量方法。这个量级在业界是合理的(正文里也解释了 PyTorch 调用路径上确实有这些开销),但它是一个厂商自测数字,不是第三方复现结果。
第三,Z3 的收益是”能启用更多优化”,不是”所有优化都变快了”。 报告说的是”在合理的资源限制下,Z3 提升了整体优化性能,同时把编译时间开销限制在几秒”,生效的 pass 是 vectorization、barrier insertion、code simplification 这三个。换句话说,如果某个 kernel 的索引算术本来就是纯线性、简单到传统分析器就够了,Z3 不会带来额外收益——它解决的是”变长张量、复杂索引”这类原先根本优化不了的情况。
另外,报告里也说了 TileLang 是一条正在共建的路径,原文是”we collaborate closely with the TileLang community”。这意味着 V4 所用的一些特性(比如 DeepSeek V4 算子示例、DeepSeek V3.2 的 top-k 优化、稀疏 MLA 反向)是以 PR 形式回到上游的,而不是私有分支——这一点对生态的理解很重要:这不是”DeepSeek fork 了 TileLang”,而是”DeepSeek 在 TileLang 上做了贡献并大规模使用”。
小结
把这篇的内容收一下:
- 背景:V4 的架构(CSA/HCA 混合注意力、mHC、FP4 量化的 MoE 与索引器)如果用标准 PyTorch 实现会碎成几百个细粒度算子,每个算子都要付一次 kernel launch、若干次 HBM 往返、若干次全局同步的代价。这类算子里很多是 memory-bound 的小算子,融合后的收益远大于单算子优化。
- TileLang 的定位:它建立在 TVM 的 TIR 与 Arith Analyzer 之上,走”tile 级”而不是 Triton 的”块级”——写数据流是必须的,写调度是可选的。用它写 GEMM 大约 30 行,写 MLA 解码大约 70 行;H100 上 MLA 达到手写 FlashMLA 的 98%,GEMM 与厂商库基本持平。
- 四个编译器机制:布局推断把
T.copy一路降低到”线程 ID + 寄存器下标 + 向量宽度 + swizzle”;软件流水线从num_stages一路展开到 stage/order 注解;warp 特化可以用T.ws+ mbarrier 手写,也可以让编译器自动插;host codegen 把每次调用的参数校验从 Python 挪进编译期生成的 host 代码,DeepSeek 自测的开销从几十到几百微秒降到一微秒以内。 - Z3:把整数表达式翻译成 QF_NIA,让布局推断、内存冒险检测、边界分析、向量化这些 pass 能证明更强的性质,从而安全地做更激进的优化;代价被限制在几秒编译时间。
- MegaMoE2:把 Dispatch/Linear-1/SwiGLU/Linear-2/Combine 融成一个 kernel,用专家分 wave 的调度让三条流并行,省掉的是 kernel 启动、HBM 往返和全局同步;实测通用负载 1.50–1.73 倍,延迟敏感场景最高 1.96 倍(batch=1 的 V4-Flash 实测),并已在昇腾上跑通。
- 可复现性:为了 batch invariance,注意力不能用 split-KV(改用单 SM 双 kernel + cluster 分布式共享内存),矩阵乘不能用 split-K 且要换掉 cuBLAS(改用 DeepGEMM);为了确定性,三处 atomicAdd 被改成”分区写 + 确定性归约”。这些代价是为 RL 训练的数据正确性付的,不是为洁癖付的。
- 生态:TileKernels 把 DeepSeek 的内核库开源;TileLang 的后端矩阵覆盖 CUDA、ROCm、Metal、LLVM、WebGPU 以及昇腾、沐曦、摩尔线程、海光、曦望等国产平台,其中 TileLang-MUSA 基于 0.1.8、单测覆盖率超过 95% 且已进入官方主线,TileLang-Ascend 已经提供了 V4 算子的现成示例。
如果只记一件事,我建议记这个:DeepSeek 用 TileLang 换来的不是”更容易写”,而是”在保持手写 CUDA 级性能的前提下更容易维护和迁移”。 前者是 DSL 的常规卖点,后者才是 V4 这份报告真正在证明的东西——当一个模型的结构复杂到需要几百个专用算子、而硬件又要同时覆盖好几家厂商时,算子层的抽象能力和它的性能上限是同等重要的。TileLang 在两个方向上都被验证过一次了。
参考资料
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence(arXiv:2606.19348)
- TileLang: A Composable Tiled Programming Model for AI Systems(arXiv:2504.17577)
- tile-ai/tilelang 官方仓库
- TileLang 官方文档
- TileLang 文档:The Tile Language: A Brief Introduction
- TileLang examples/quickstart.py
- TileLang 文档:Software Pipeline Annotations
- TileLang 文档:Language Basics
- TileLang 示例:warp 特化 GEMM
- TileLang 示例:DeepSeek V4 算子
- TileLang 示例:DeepSeek MLA 解码(含 warp 特化版本)
- TileLang 后端架构说明
- TileLang PR #1367:Integrate Z3 in TVM Arith Analyzer
- TileLang PR #1909:Producer-consumer warp specialization 与 T.tma_copy
- TileLang PR #2148:DeepSeek V4 operators
- deepseek-ai/TileKernels 仓库
- TileKernels:mHC Sinkhorn kernel 实现
- TileKernels:per-token 量化 kernel 实现
- DeepGEMM PR #304:Introducing Mega MoE, FP4 Indexer and other features
- DeepGEMM PR #316:Mega MoE 性能基准
- tile-ai/tilelang-musa 仓库
- tile-ai/tilelang-ascend v0.1.1.010-release
- 至顶网:Day-0 支持,摩尔线程 TileLang-MUSA 率先支持 DeepSeek-V4 全新 TileKernels
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


