


AI 编译器开发工程师:一条计算图如何变成 GPU Kernel——岗位工作流与硬核知识体系
背景:为什么会出现「AI 编译器」这个岗位
先回答一个最直接的问题:AI 编译器在编译什么?传统编译器把 C/Python 这类语言翻译成机器指令,而 AI 编译器处理的输入是计算图——一个由张量算子(矩阵乘、卷积、归一化、激活函数、注意力等)组成的 DAG,输出则是能在 GPU/NPU/CPU 上高效执行的底层代码(CUDA kernel、PTX、厂商私有指令等)。它处在深度学习框架与硬件之间,负责回答一个问题:同一个算子或同一张计算图,如何在不同硬件上都快。
这个岗位之所以近十年才成规模出现,有两条清晰的历史线索。
第一条线索是「算子库路线」的边界。深度学习爆发初期(2014-2017 年前后),业界靠 cuDNN、cuBLAS 这类厂商算子库解决问题:框架把每个算子派发到库里预先手工调优过的 kernel。这套路线的局限在 2017 年前后集中暴露:硬件种类暴增(移动 GPU、FPGA、各类 AI ASIC),算子的形态快速演化(注意力变体、MoE、量化算子层出不穷),而每个新算子都要等人手工写 kernel,每个新硬件都要重新移植算子库,工程上不可持续。Google 的 XLA 于 2017 年随 TPU 生态对外发布(TensorFlow 博客),第一次把「编译器自动优化计算图」作为 TPU 的默认路径;华盛顿大学陈天奇等人 2018 年在 OSDI 发表的 TVM(论文)则系统提出了图级与算子级双层优化、面向任意硬件的代码生成框架,论文摘要里写得很直白:当时的主流框架「依赖厂商算子库、只为少数服务器级 GPU 优化」,把负载部署到手机、嵌入式设备、FPGA 上需要大量手工劳动。这两件事基本定义了 AI 编译器要解决的原始问题:性能可移植(performance portability)。
第二条线索是「框架侧 Python 生态」与「底层异构硬件」之间的鸿沟越来越大。PyTorch 为代表的动态图框架语义灵活,但逐算子派发带来巨大的 Python 解释与 kernel 启动开销;Transformer 大模型推理又有强烈的算子融合与访存优化需求。PyTorch 2.0 于 2023 年 3 月正式发布,把 torch.compile(TorchDynamo 前端 + TorchInductor 后端)作为默认编译路径——官方博客给出 163 个模型平均约 38% 的 GPU 训练加速(推理侧收益更依赖模型形态),标志着「框架自带编译器」成为标配。与此同时,MLIR(2020 年并入 LLVM 项目、CGO 2021 论文)提供了可扩展的多级 IR 基础设施,被 Google IREE、torch-mlir、OpenXLA 以及大量芯片厂商的自研编译器采用;OpenAI 开源的 Triton(MAPL 2019 论文,2021 年 7 月由 OpenAI 官方博客发布)则让「写一个像 Python 的 kernel、把底层优化交给编译器」成为主流工作方式。
一个岗位的价值取决于它解决的问题有多大。AI 编译器工程师恰好站在三条交汇线上:上层是每天都在变的模型与框架,中间是每半年更新一代的 GPU 和雨后春笋般出现的 NPU,下层是算子库永远覆盖不全的长尾算子。下面按照「全景 → 工作流 → 硬核机制 → 知识体系」四层展开,把这条链路讲透。
全景:编译流水有哪些阶段,各阶段在干什么
先看一张总览图,它出自 TVM 论文(OSDI 2018)的系统总览,虽然发表于 2018 年,但把 AI 编译器的分层结构画得仍然准确:
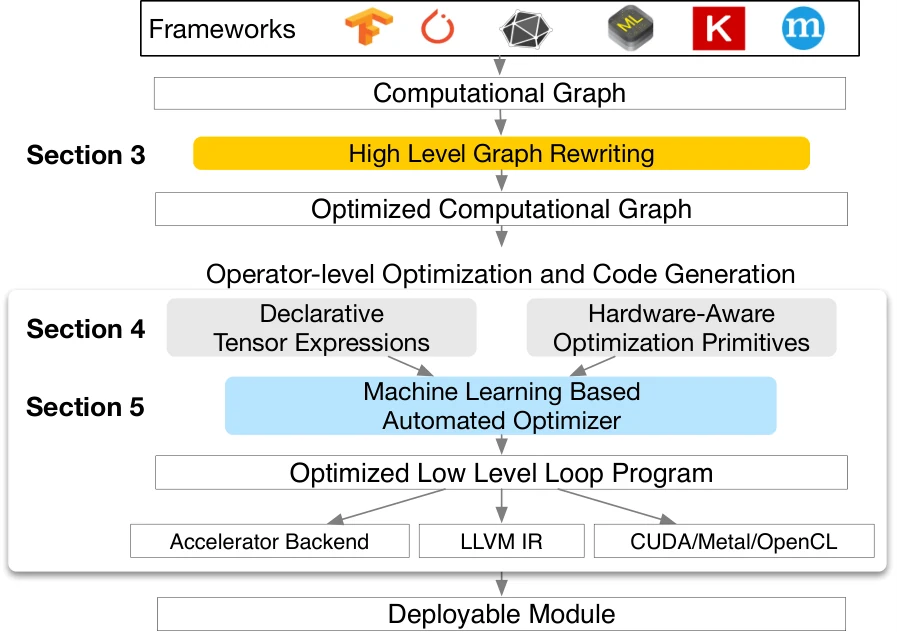
图中上方是前端:吃进 PyTorch/ONNX/TensorFlow 等框架产出的模型描述。中间是编译器的本体,分两大层:
- 图级(graph-level):把模型当作算子 DAG 看待,做算子融合、常量折叠、死代码消除、布局与数据类型推导这类「不展开循环也能做」的优化;
- 算子级(operator-level):把每个算子(或融合后的算子子图)展开成循环结构,做分块(tiling)、向量化、线程绑定、访存调度,最终生成目标硬件的代码。
下方是运行时与硬件:生成的 kernel 由运行时负责加载、启动与内存管理。
如果与传统编译器对照,各阶段能一一对应:
| 阶段 | 传统编译器(如 GCC/Clang) | AI 编译器 |
|---|---|---|
| 前端 | 词法/语法/语义分析,生成 AST | 捕获或导入计算图(TorchDynamo、ONNX 导入器) |
| 中间表示 | LLVM IR(SSA、基本块、CFG) | 图级 IR(FX 图、HLO、Relay)、循环级 IR(TIR、linalg、TritonGPU) |
| 优化 | 常量折叠、GVN、内联、循环优化 | 算子融合、布局传播、调度变换、内核生成优化 |
| 后端 | 指令选择、寄存器分配 | 代码生成到 CUDA/PTX/厂商指令,调算子库 |
| 运行时 | 链接器、加载器 | Graph Executor、JIT 缓存、kernel 启动 |
有两点根本差异值得点出,它们决定了 AI 编译器的难点分布与传统编译器完全不同。
第一,AI 编译器的「源代码」语义很薄,性能差距全在优化层。传统编译器里,同样的 C 代码在 x86 和 ARM 上编译结果差距有限;AI 编译器面对同一个 GEMM,手工调优的 cuBLAS 和朴素实现可以差 10 倍以上,而「正确的 kernel」距离「快的 kernel」之间隔着共享内存分块、寄存器分块、异步拷贝、Tensor Core 排布这一整套调度学问。所以 AI 编译器的工作重心不在前端解析,而在优化与代码生成。
第二,中间表示必须携带形状与数据类型信息。张量操作的循环边界、并行划分、内存大小都依赖 shape 与 dtype,编译器不能在运行时才「发现」维度,所以 shape/dtype 在 IR 里显式存在,甚至要支持符号化的动态形状(symbolic shape),否则 batch 变化就得整图重新编译。这一点在后面 IR 一节还会展开。
为了下文叙述方便,定义一个贯穿全文的微型例子:对输入 计算
其中 是 的权重矩阵, 是偏置,GELU 是逐元素激活函数。这个「矩阵乘 + 加偏置 + 激活」的组合(业内叫 GEMM with epilogue,尾部操作)是几乎所有线性层与 MLP 的骨架。后面每一层优化都拿它当靶子:图级优化把它融成一个算子,算子级优化为它选分块方案,代码生成把它变成一段 CUDA/Triton 代码。
典型工作流:一个编译任务从需求到上线的七个步骤
岗位日常不是「写编译器」,而是在一条具体的编译流水中修修补补、让性能达标。一个典型任务长这样:
第一步:拿到需求,先跑通基线。 需求通常来自几个方向:算法组拿来一个用 PyTorch 写的新模型(新注意力变体、新激活函数、量化权重格式);硬件组发布了一款新芯片或新指令;线上服务报告某个算子成为热点。无论哪种,第一步都是把模型在 eager 模式下跑通、记录正确输出与基线性能,作为后续一切对照的基准。没有基线的编译器改动无法验证——你连「编译坏了」和「模型本来就这样」都分不清。
第二步:前端捕获。 把动态的 Python 模型变成静态计算图。以 torch.compile 为例,TorchDynamo 通过 CPython 的帧求值钩子逐字节码解释执行 Python 代码,把张量操作抽取成 FX 图;遇到无法静态化的代码(数据相关的分支、.item()、调用外部库)就产生一次 graph break,把图切成多段,中间退回 Python 执行。这一步是编译器工程师最常打交道的地方之一,因为新模型的第一道坎往往是「图没捕全」。调试手段很直接:设置环境变量 TORCH_LOGS="graph_breaks,recompiles" 查看断点原因,或用 torch._dynamo.explain 拿到结构化报告;对于 TVM/XLA 这类面向静态图的编译器,这一步是 ONNX/TorchScript 导入,模型里有不支持的算子时导入器直接报错。
第三步:图级优化。 前端产出计算图后,编译器跑一系列图级 pass:常量折叠(把编译期就能算完的子表达式提前算掉,比如 RoPE 里的 cos/sin 表)、死代码消除(没被消费的输出)、公共子表达式消除,以及最重要的算子融合。融合的逻辑是:把多个算子的计算合并进同一个 kernel,让中间结果留在寄存器或共享内存里,而不是写回显存再读出来。这一步的产物是一个融合后的、算子数量大幅减少的图。Inductor 的融合可以做一个简单的量化感受:一个 Transformer 层在 eager 模式下要启动几十次 kernel,编译后通常能降到十次以内。
第四步:算子下沉与调度。 图级 IR 里的每个「算子节点」要变成可生成的循环结构:确定循环嵌套、每个循环的步长、数据放哪个内存层次。这一步是调度(schedule)的主战场——分块大小、循环顺序、向量化宽度、线程与 block 的组织——调度方案直接决定 kernel 能不能打满硬件。传统上这是手工 kernel 开发者(如 CUTLASS)的全部工作;在 TVM/Halide 传统里,它表现为对循环的显式变换;在 Triton 传统里,编译器自动完成线程级映射,人只需要指定 tile 大小与流水级数。
第五步:代码生成。 调度定型后,编译器把循环 IR 逐层降级:先是结构化的循环与算术运算,再变成目标硬件指令。NVIDIA GPU 上常见两级:生成 LLVM IR 再由 NVPTX 后端产出 PTX,最后经 ptxas 汇编成 SASS;TVM 等框架也支持直接生成 CUDA C 源码。这一步的产出物是 kernel 二进制或源码,以及配套的启动参数(grid/block 尺寸、共享内存大小、动态形状的掩码逻辑)。
第六步:数值与性能验证。 编译产物要同时过两关。数值关:把编译后 kernel 的输出与 eager/参考实现对比,用最大绝对误差、最大相对误差或逐元素误差的统计分位来衡量(误差阈值按算子与精度类型设定,FP32 通常要求 1e-5 量级的相对误差容忍,FP16/BF16 放宽到 1e-2 量级,且要区分是编译器 bug、快速数学近似还是重关联带来的正常差异)。性能关:用 ncu/nsys 这类剖析器看 kernel 是否达到预期的算术强度与带宽利用率,并对照 roofline 模型判断瓶颈在计算还是访存。这两关的结论决定改动是「可以合入」还是「回去改调度」。
第七步:回归、测试与发布。 编译器改动影响面极大:一个 pass 的重写可能让几十个模型变快或变慢,所以要有三层护栏——IR 级单元测试(golden 文件比对,编译某段输入应产出特定 IR)、数值等价性测试(随机输入下输出与参考实现一致)、端到端性能回归(固定硬件上跑基准模型集,看几何平均吞吐变化)。性能回归用几何平均而非算术平均,是为了避免个别模型的大幅提升掩盖其他模型的回退。发布后还要维护与框架版本的兼容——编译器往往和框架、运行时同仓演进,一个 IR 字段的重命名会牵动整个上下游。
这一节概括了「怎么做」,但每个步骤背后都是硬机制。下面五个小节把最核心的机制逐个拆开:算子融合为什么是收益大头、多级 IR 为什么这么设计、调度具体在变换什么、代码生成与运行时如何分工、自动调优怎么解决「方案太多试不过来」。
硬核(一):算子融合——为什么是编译器收益的最大来源
访存 vs 计算的 roofline 视角
GPU 上一条朴素的性能法则:一个 kernel 能被多快,取决于它是受计算限制还是受访存限制。用算术强度(arithmetic intensity)表达:设一次执行的总运算量为 (FLOP)、总内存流量为 (字节),则
设硬件的计算峰值是 (FLOPS)、内存带宽是 (字节/秒),则只有当 时计算才能打满,否则时间由内存流量决定。 通常叫 ridge point。以 A100(FP16 Tensor Core 峰值约 312 TFLOPS,HBM 带宽约 2 TB/s)为例,ridge point 约 156 FLOP/字节——意味着平均每从显存取回 1 字节,至少要配套 156 次浮点运算才不浪费算力。而逐元素类算子(激活、归一化、逐元素加)每个元素只有个位数运算、却要读写 4-8 字节,算术强度只有 1 以下,天然是访存受限。
这直接推出了融合的必要性。把 n 个逐元素算子串成一条链,若不融合,每两个算子之间都要把中间张量整个写回显存、再由下一个 kernel 读回,总流量约正比于算子个数;融合成一个 kernel 后,中间结果全部留在寄存器里,每个中间张量只产生一次写入与一次读取。设两种方案的总搬运时间分别为 (不融合)与 (融合):
其中 是元素个数, 是每个元素的字节数, 是带宽。直观数字:100 万个 fp32 元素(4 MB),5 个逐元素算子串行不融合要搬运 MB,融合后只搬 8 MB——在 2 TB/s 带宽上分别是 20 微秒与 4 微秒。省下的不只有带宽,还有 4 次 kernel 启动(每次约几微秒)和 Python/派发层的开销。这就是为什么编译器里「把能融合的都融合」优先级最高:它同时削减了访存与启动两大开销。
三类融合形态
按算子的消费关系,融合大致分三类:
- 尾部融合(vertical/epilogue fusion):计算密集算子 + 其后的逐元素链,如矩阵乘后接加偏置、激活。矩阵乘把结果写进寄存器/共享内存后不落显存,直接在片上做后续逐元素运算。这是收益最稳定的一类——注意力里的 softmax 归约、量化推理里的反量化(dequant)与缩放都这么融进主算子。
- 横向融合(horizontal fusion):多个输入相同或相互独立的逐元素算子合并成一个 kernel,共享一次数据读取。典型如残差连接里的多个分支相加、LayerNorm 里多个统计量的计算。
- 循环级融合(loop/pattern fusion):把跨 kernel 的计算压缩到同一层循环内复用数据,FlashAttention 是教科书案例——把 QK^T 与 softmax、softmax 结果与 V 的矩阵乘融合,避免 整块落显存(FlashAttention 论文,本站另有 FlashAttention 系列拆解其分块与在线 softmax 细节)。
融合的合法性条件:编译器怎么判断「能不能融」
融合不是无脑合并,编译器必须做合法性检查,核心条件有三个:
- 无中间消费者:producer 的输出只能被这一个 consumer 使用(或所有使用者都能一起融进来),否则融掉后其他消费者读不到中间结果。
- 依赖与别名安全:被融合的算子之间不存在读后写、写后读冲突——尤其当算子带副作用(in-place 修改、随机状态)或存在内存别名时必须保守处理。这也是为什么现代图 IR 普遍把算子写成纯函数式(functional):每个算子不修改输入、只产出新张量,别名问题在 IR 层面就被消灭,融合与重排的安全性分析大幅简化。AOTAutograd 里的 functionalization pass 就是把 PyTorch 的 in-place 操作改写成函数式的等价形式,正是为此。
- 循环结构兼容:被融合的算子要能在同一套循环嵌套下计算。逐元素算子之间天然兼容;归约类算子(softmax 的求和、矩阵乘的 K 维累加)融合后,逐元素部分必须位于归约循环之外或采用与之匹配的分块策略,否则要么写回显存、要么引入额外的部分和归约。
工程实现上,TVM 的 Relay 用 FuseOps 把图按「能否在同一条循环链上计算」分组,融合成子图后再整体下沉;XLA 的融合 pass 生成带 fusion 属性的 HLO 节点;Inductor 则在它的循环级 IR 上做调度节点(SchedulerNode)的分组。三个系统殊途同归:融合决策发生在图级,但合法性论证要落到循环级——这也是为什么图级 IR 与循环级 IR 必须分层存在。
融合的代价:为什么不把整个模型融成一个 kernel
读者可能追问:既然融合这么好,为什么不把所有算子融进一个巨型 kernel?答案是资源约束与并行度:
- 寄存器与共享内存有限:片上存储是融合的物理上限。中间结果要驻留在寄存器或共享内存里,A100 每个线程最多 255 个寄存器、每 block 最多约 160 KB 共享内存,融合过多算子会导致溢出(spill)或占用率暴跌,得不偿失。编译器的融合决策本质是在「省访存」与「省并行度」之间做权衡。
- 冗余计算 vs 保留中间结果:有些中间张量被多个消费者使用,融合每个消费者就要重算一次(重计算)。重算开销小时划得来,开销大(比如大矩阵乘的输出)时不如保留中间结果,融合反而亏。
- 并行粒度:算子融合后单个 kernel 的并行度由最紧的依赖链决定,融合过多会缩小可并行的 block 数,在小模型上反而跑不满 GPU。
顺带纠正一个常见误解:GEMM 这类计算密集算子的尾部融合,收益并非总是巨大。还是用数字说话:4096×4096 的 fp16 GEMM 计算量约 FLOP,A100 上约 0.44 毫秒;若偏置与激活写成独立 kernel,中间张量 4096×4096×2 字节 ≈ 33.6 MB,读写往返约 67 MB、约 34 微秒——相对 440 微秒只占约 8%。也就是说在 Prefill 这类大矩阵乘场景,融合 epilogue 是锦上添花;真正的收益大头在访存受限场景:解码阶段的逐 token 算子链、逐元素长链、注意力中间结果,以及 FP8/低精度推理(算力翻倍后访存占比更突出)。理解「融合收益随场景变化」才能理解为什么编译器需要全局的成本建模,而不是一条规则吃遍天。
硬核(二):多级中间表示——每一层只保留该层需要的语义
为什么一层 IR 不够
早期方案(2016-2018 年的图编译器)普遍只有一层「张量算子图」IR,优化直接作用在算子节点上。很快撞上两个问题:一是算子粒度太粗,无法表达「把矩阵乘的 K 维拆成两段并行累加」这类循环级优化;二是算子粒度太细(把一切拆成标量运算)又丢失了张量级信息,融合与并行分析寸步难行。结论是IR 必须分层,每一层只保留那一层优化需要的语义,越往下越接近硬件:
- 图级 IR:节点是张量算子,边是张量。承载算子融合、布局/数据类型传播、常量折叠、内存规划。语义是「数据流 DAG」。
- 循环级 IR:算子被展开为带循环嵌套、访存语句、线程/block 维度的程序。承载分块、向量化、并行化、访存调度。语义是「带显式循环的程序」。
- 硬件级 IR/汇编:目标指令。承载指令选择与调度,之后交给硬件汇编器。
以 TVM 为例:Relay(图级,函数式、带显式 shape 与 dtype 的算子图)在融合后下沉到 TIR(循环级,类型化、SSA 风格的低层 IR),TIR 再做调度变换并最终代码生成;两级的形状可以通过一个具体案例感受——同一段「矩阵乘 + 加偏置 + GELU」,图级 IR 里是三个节点,循环级 IR 里变成若干层 for 循环与一个累加器。XLA 对应 HLO 与后端私有 IR,PyTorch 对应 FX 图与 Inductor 内部 IR,Triton 对应 TTIR 与 TritonGPU IR——命名各异,两级(或多级)结构一致。
每一层「显式携带」什么
IR 设计的好坏决定优化的可实现性。几个关键设计点:
- 显式类型与形状:图级 IR 的每个张量标注 dtype 与 shape。有了 shape 才能算融合后 kernel 的访存量、做内存规划;有了 dtype 才能决定降精度是否安全、指令怎么选。动态形状用符号维度表达(如
tensor<?x?xf32>里带?的维度),运行时再绑定具体值。 - SSA 与函数式语义:每个值只被定义一次,算子不修改输入。这让 pass 之间的数据流分析(谁消费了谁、能否重排)变成纯结构问题。代价是 in-place 优化需要专门的「写回识别」pass,但整体收益远大于代价。
- 区域与嵌套结构:循环、条件、子图在 IR 里以嵌套区域(region)表达,pass 可以递归地下钻。MLIR 把「带区域的操作树 + 多方言」抽象做到了极致,这是它能同时托管图级与循环级 IR 的原因。
MLIR:把多级 IR 变成基础设施
既然每层 IR 都需要自己的语法、类型系统与 pass,自然有人想:能不能造一套可扩展的 IR 基础设施,让每个项目只定义自己的方言(dialect),共享 pass 框架、文本格式、转换工具?这就是 MLIR(Multi-Level Intermediate Representation,Google 主导、2020 年并入 LLVM 项目)的出发点。它把「操作(Operation)、区域(Region)、块(Block)、值(Value)」作为统一骨架,方言定义算子集合,比如:
- 前端方言:
tensor(张量类型与操作)、linalg(结构化张量算子,linalg.generic可以表达任意逐元素/归约算子); - 变换方言:
affine(仿射循环与索引分析)、scf(结构化控制流 for/if); - 目标方言:
llvm、nvvm、gpu,以及各芯片厂商的私有方言。
一段典型的「降级链」是:linalg.generic(一个带索引映射与迭代器类型的通用算子模板)→ 分块成 scf.for 循环 + memref 张量 → 向量化与并行化 → llvm/nvvm → 机器码。每一次变换由方言转换(dialect conversion)框架执行,pass 写成匹配某方言操作、重写为另一方言操作的规则。MLIR 还提供 mlir-opt 这类命令行工具,每个 pass 都可以单步执行并打印 IR——调试编译器从此有了「编译器里的 GDB」。
MLIR 被 IREE(Google 开源的 MLIR 推理编译器,支持 CPU/CUDA/ROCm/Vulkan 与多家 NPU)、torch-mlir、OpenXLA 的 HLO 方言体系以及大量国产芯片编译器采用,不是因为它性能更好,而是因为它把「造一个编译器」的成本从零降到了「定义方言 + 写转换」——对必须快速跟进新指令集的芯片厂商尤其关键。理解这一点,就理解了 AI 编译器行业 2020 年后的人才技能迁移:从「会写 pass」转向「会设计方言与转换」。
硬核(三):调度——把循环变出花样的学问
从算子到循环嵌套
图级融合完成后的一个子图,最终要被翻译成循环程序。仍以 GEMM 为例,数学上是 ,朴素写法是三层循环:
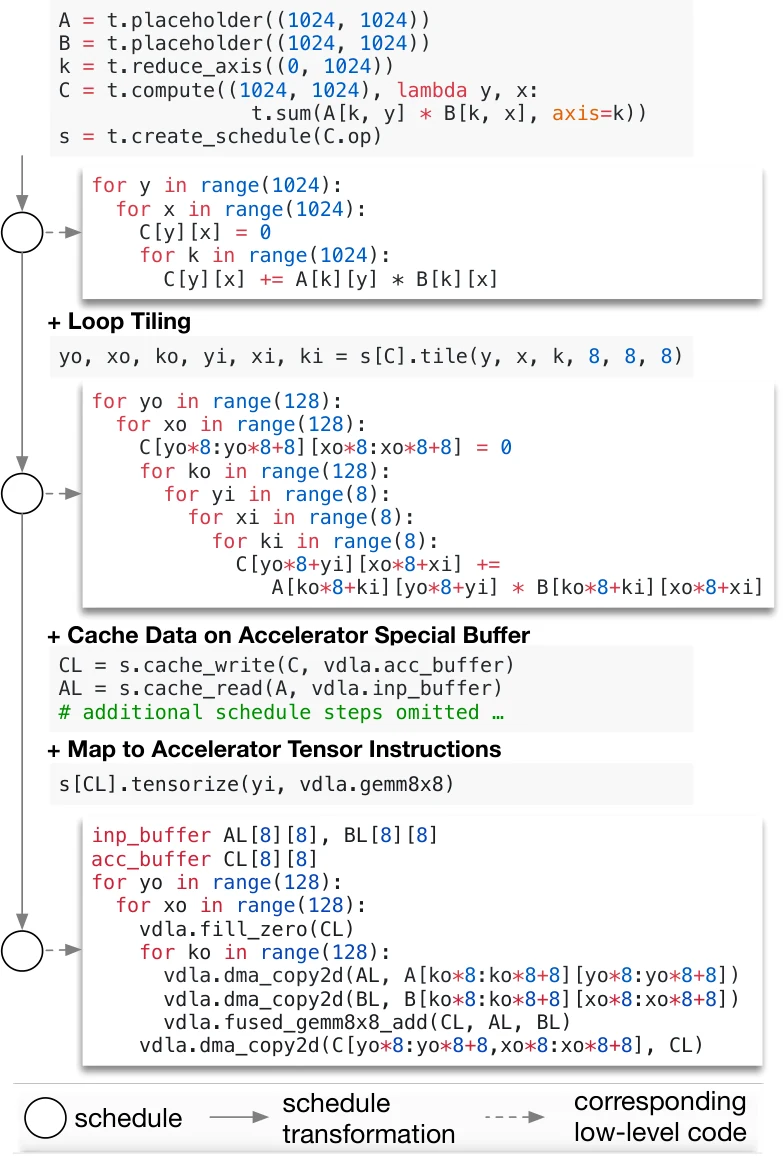
for i in range(M): for j in range(N): for k in range(K): C[i][j] += A[i][k] * B[k][j]这版代码在任何现代 GPU 上都会慢得离谱:最内层 k 循环里 A 的访存不连续(行优先存储下 A[i][k] 跳着走),没有向量化,没有数据复用——每个 的累加都要从显存取 个元素。编译器的工作,就是把这版「语义正确但性能为负」的循环,变换成能打满硬件的形态。下面这张图是 TVM 论文(OSDI 2018)中针对专用加速器的 GEMM 调度变换示例,展示了同一条计算在不同调度下的「程序形状」差异:
调度的本质:变换迭代空间
Halide 在 2012/2013 年(PLDI 论文)提出并系统化了核心思想:把「计算什么」(算法)与「怎么算」(调度)分离。算法声明后,调度通过一组原语变换循环的迭代空间:
split:把一层循环按因子切成内外两层,例如把for i in 0..1024切成for i0 in 0..16: for i1 in 0..64(1024 = 16 × 64);fuse:合并相邻循环(降低启动/控制开销或为并行化腾空间);reorder:交换循环次序,决定哪个维度在片上复用、哪个维度跨 block 分布;vectorize:把最内层循环变成向量指令(一条指令处理 4 个 fp32);parallel/bind:把某层循环绑定到 block/线程维度;unroll:展开循环体,消除分支、暴露指令级并行;compute_at:控制某个中间计算的存放位置(放进消费者循环内就近重算,还是物化到共享内存)。
这些原语之所以强大,是因为它们不改变计算结果(循环变换保持依赖关系),编译器可以放心组合。以 GEMM 为例,一套教科书式的调度变换链是:
- 把 M、N 维各切成块:外层 tile 大小 128×128(对应一个线程块),内层留作线程内/线程间分配;
- 把 K 维切成 32 的块,让 A、B 的块先搬进共享内存(每块只从显存读一次,被 128×128 次计算复用);
reorder让共享内存加载与计算尽量交错;- 最内层向量化(fp16 下 8 元素 16 字节的向量访存);
- 把外层循环
bind到blockIdx、内层bind到threadIdx。
变换后的程序形态(伪代码)大致是:
for block_m, block_n in grid: # 每个 block 负责 BM×BN 的输出块 load A_tile, B_tile to shared memory # 协作加载,合并访存 for k0 in range(0, K, BK): load next A/B tile (双缓冲, 与计算重叠) for i in range(BM): for j in range(BN): acc[i][j] += A_tile[i][k0..] · B_tile[k0..][j] # 最内层向量化/张量核指令 write acc to global memory对照真实硬件:外层两个循环对应 CUDA 的 grid 划分(一个 block 一个输出 tile),内层 for i/j 的展开与向量化对应线程内寄存器分块——acc[i][j] 这组局部变量最终就是寄存器里的累加器。调度选择 = 手工 kernel 优化的全部内容:输出 tile 多大、每线程算几个元素、共享内存如何排布避免 bank 冲突、异步拷贝怎么和计算重叠。FlashAttention、DeepGEMM 这类手工 kernel 的精髓,本质都是同一套调度的极端精细版。
值得强调的是「每线程算几个元素」这个参数:寄存器分块越大,数据复用越好(访存次数越少),但占用率越低(能并发的线程越少)。吞吐 = 复用收益 × 并行度损失,最优解在中间。这组权衡让「拍脑袋定调度」变得不可能,也让编译器的自动调优(后面专节讲)有了存在理由。
内存层次与访存调度:软件流水
GPU 的存储层次是 寄存器 → 共享内存 → L2 → HBM,每差一级带宽约一个数量级。调度的另一半工作就是让数据在正确的时间出现在正确的层次:全局内存只访问一次(经合并访存整块搬入共享内存)、共享内存的数据被反复复用、寄存器里的中间结果不落回显存。
跨层搬移与计算重叠靠软件流水(software pipelining)实现。把循环体按迭代展开成三个阶段:prologue(预取第一批数据)、steady(边算第 t 批、边搬第 t+1 批)、epilogue(收尾)。这样访存延迟被计算掩盖,kernel 时间逼近「max(计算时间, 访存时间)」而非二者之和。硬件层面,A100 的 cp.async 与 Hopper 的 TMA 指令提供了异步拷贝原语,编译器据此自动插入双缓冲(double buffering):一块共享内存在算、另一块在载。Triton 里对应的参数是 num_stages——它直接控制软件流水的级数,这也是为什么 Triton kernel 性能调优时 num_stages 与 num_warps 是最高频被调整的两个旋钮。
归约与并行化的冲突:以 softmax 为缩影
逐元素循环可以任意并行,但归约(求和、求 max)引入跨迭代的依赖,是调度难点的集中体现。以行 softmax 为例:为数值稳定要先求行内最大值,再求指数和,最后才能归一化——朴素实现要把数据完整扫两遍以上,中间量还得落显存,访存开销翻倍。FlashAttention 一类方案用「在线更新」把多次扫描合成一遍(维护运行中的 max 与部分和,见本站 FlashAttention 系列拆解);编译器侧则常把归约维拆成多段并行(split-K 思路): 设每段长度为 ,各段独立累加部分和:
每个并行单元算一段的部分和,最后要么原子累加、要么多级归约合并。代价是部分和引入了额外访存或同步,S 取多大又是权衡。这类「归约拆分 + 部分和合并」的模式在 LayerNorm、softmax、跨头注意力、量化统计里反复出现,是编译器代码生成器里的常客。
硬核(四):代码生成与运行时——编译产物如何被真正执行
多级降级:为什么最后一段不自己写
调度完成后,循环 IR 需要变成可执行代码。TVM 论文里把这段流程画得很清楚——调度后的 TIR 经降低与代码生成,最终产出目标平台代码与运行时调用:
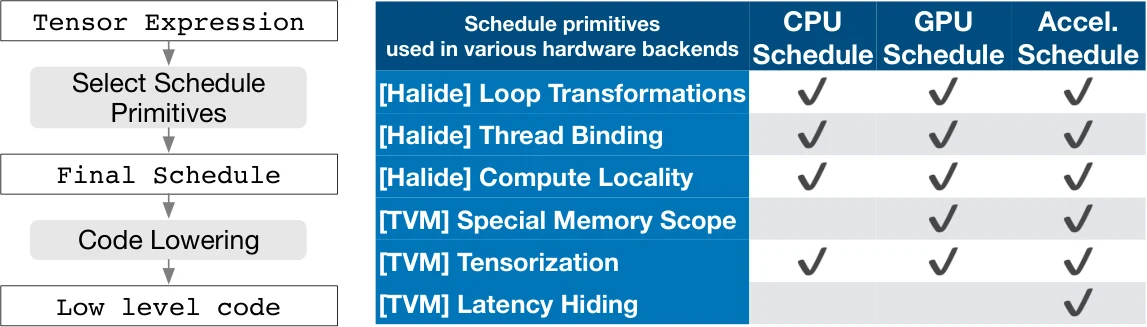
常见的做法是借道 LLVM:把循环 IR 翻译成 LLVM IR,再交给 LLVM 后端做指令选择、寄存器分配与指令调度,产出 PTX(NVIDIA 的虚拟汇编)或直接的目标代码。为什么不让 AI 编译器自己写最后这段?因为通用优化器里寄存器分配、指令调度这类 NP-hard 问题,LLVM 已打磨了二十年;AI 编译器把精力集中在张量级问题上更有价值。代价是 LLVM 对张量级结构(共享内存排布、Tensor Core MMA 指令、线程组协作)一无所知——所以 AI 编译器在 LLVM 之前自己完成「张量级指令选择」:把 dot 变成 mma.sync/wgmma 指令、把共享内存访问安排成无 bank 冲突的排布、决定每线程的数据分片(fragment)布局。也就是说,通用优化交给 LLVM,张量级优化自己做。
Triton 的降级链是这条思路的现代范本(社区对源码的分析已经很完整):Python 编写的 kernel 先经 AST 解析进入硬件无关的 TTIR(Triton IR,算子包括 tt.load/tt.store/tt.dot/tt.reduce),再降级到 TritonGPU IR——这一层做布局推断:为每个张量决定线程/线程组到元素的映射(常规访存用 Blocked 布局、Tensor Core 用 MMA 布局),插入必要的布局转换(经共享内存或 warp shuffle),并做访存合并分析(把连续访问向量化成 128 位宽的 ld.global);之后降级到 LLVM IR(NVIDIA 侧为 NVPTX 方言),LLVM 后端产出 PTX,最后 ptxas 汇编为 SASS。num_warps、num_stages 等编译选项在此时生效。整条链的哲学与手写 CUDA 完全不同:程序员只描述 tile 级数据流,线程映射、布局、向量化由编译器推导——这让不熟悉 GPU 底层细节的开发者也能写出可用的 kernel,也是 Triton 成为 torch.compile 默认代码生成器、并被多家 NPU 厂商选作前端的原因。
JIT、编译缓存与 AOT:编译时间也是一种开销
编译产物最终要进入运行期,这里有一个 AI 编译器特有的矛盾:编译本身耗时,而推理服务对启动时间敏感。torch.compile 首次编译一个模型需要数秒到数十秒(官方文档明确提示 warmup 成本),如果每次进程重启都重新编译,在线服务根本等不起。于是有了三层缓解:
- 编译缓存:kernel 源码的哈希作为缓存键,进程间共享磁盘缓存,第二次运行直接命中。torch.compile、Triton、TVM 都有各自的缓存目录(Inductor 缓存于
~/.cache/torch/inductor,Triton 缓存于~/.triton/cache等)。 - Guard 与动态形状:Dynamo 为每次编译记录一组运行期断言(shape、dtype、设备、常量),下次调用先验 guard,全过则复用、有变则重编译——这就是「同一函数换一个 shape 就触发重编译」的机制来源。XLA 的做法类似:shape 特化缓存(shape-specific compiled executable),动态 shape 会导致缓存爆炸,因此编译器的「形状通用性」与「编译缓存命中率」是一对必须平衡的指标。
- AOT 预编译:把编译挪到部署之前。TensorRT 的典型工作流就是构建期(build time)把模型编成引擎文件(plan),部署时直接加载——代价是构建耗时以分钟计、且引擎与 GPU 架构绑定(换个架构要重新构建);TensorRT-LLM 沿用同一模式:构建引擎、运行时只做加载与调度。昇腾 CANN 的 ATC 工具同样把模型转换成
.om离线模型再部署。对生产推理而言,「提前编好、运行时只加载」几乎是标配。
运行时的职责边界
编译器工程师写的代码不止于 kernel:运行时(runtime)负责 kernel 的加载与启动、设备内存池、流(stream)依赖管理、以及把多个 kernel 按图调度执行。图执行器(graph executor)把编译好的 kernel 序列按依赖拓扑启动,尽量用 CUDA Graph 之类机制把启动开销摊薄。运行时与编译器的边界因系统而异:vLLM/SGLang 这类推理服务框架直接管理 KV 内存与请求调度,把「算子执行」交给底层(如 TensorRT-LLM 引擎或自研 kernel);TVM 提供轻量 runtime 用于加载编译产物;MLIR 侧的 IREE 则把「编译产物 + 运行时」打包成部署单元。理解这条边界很重要:岗位上的很多问题(「为什么 kernel 快了端到端没快」「为什么显存多了」「为什么首 token 延迟高」)答案都藏在编译产物与运行时的交接处——kernel 启动间隙、内存规划碎片、形状假设不匹配,往往比 kernel 本身更伤人。
硬核(五):自动调优——调度方案太多,让机器自己找
搜索空间有多大
前面说过,调度参数(分块大小、向量化宽度、循环顺序、线程组织、流水级数)的组合是指数级的:一个 GEMM 仅 tile 尺寸 × 线程数 × 向量宽度 × 是否拆分 K 维就能组合出天文数字的候选,穷举不可行,而硬件行为(缓存、占用率、bank 冲突)又复杂到无法精确静态建模。于是行业的主流答案从「专家手工写调度」转向「搜索 + 成本模型」。
AutoTVM(随 TVM 论文提出)的做法是:把调度模板化——模板里留下 tile 尺寸、向量宽度等旋钮(knob),用机器学习成本模型(论文用 XGBoost)预测每个旋钮组合的性能,再在真机上采样验证,迭代逼近最优。TVM 论文里的自动调优框架总览图如下:
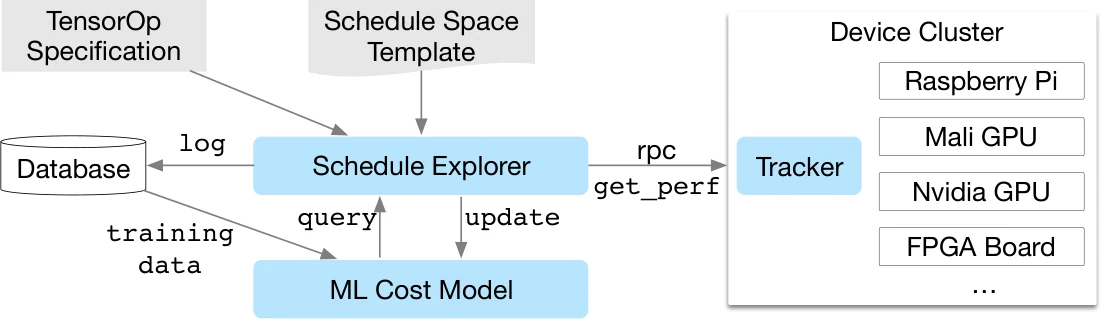
模板化的问题在于模板本身限制了搜索空间——模板没写进去的调度(比如某种新的数据流)永远不会被找到。Ansor(OSDI 2020,论文)对此的改进是程序合成:不再依赖人工模板,而是先从高层算子声明生成一批「草图」(sketch,覆盖多种分块与循环结构),再对草图做细粒度的参数注释,用进化搜索 + 学得成本模型在真机反馈下精调。论文报告相对当时 SOTA(含 AutoTVM 与专家手工优化)在 Intel CPU、ARM CPU、NVIDIA GPU 上最高提速 3.8 倍、2.6 倍与 1.7 倍——数字本身有时代性,但「搜索空间设计决定性能上限」的结论不过时。
自动调优的工程现实
真正生产级的自动调优,难点不在算法而在工程:
- 编译时间预算:搜索要跑真机采样,一个算子的调优可能耗时数分钟到数小时。推理服务的部署流程通常只有几分钟预算,所以调优结果必须离线完成并缓存(tuning cache 随部署分发),在线只能接受「不完美但可用」的 kernel。
- 成本模型的冷启动:新硬件没有历史数据,学得成本模型在一开始是瞎猜。常见做法是先用通用特征(访存量、算术强度、占用率估算)做启发式,再随采样数据增量训练——即「先试跑、后建模」的反馈闭环。
- 迁移性:在 A100 上调好的方案搬到 H100 未必最优(共享内存容量、指令集、SM 数都变了)。因此调优缓存通常按 GPU 架构分桶,跨代不共享。
- Triton 的实用主义:Triton 生态没有 AutoTVM/Ansor 那样宏大的搜索框架,主流做法是
triton.autotune——程序员手写几个候选配置(BLOCK 尺寸、num_warps、num_stages),框架在首次调用时逐个 benchmark、自动选中最优并缓存。Inductor 的max-autotune模式也类似。这种「把搜索空间缩小到几个手选点再自动挑」的折中,是工业界最常用的形态。
自动调优还给编译器工程师带来一个视角转变:调度不再是「写死的最优解」,而是「一个带约束的搜索问题」。于是编译器团队里开始出现「把调优算法本身当作产品」的工程师——设计搜索空间、写成本模型、管调优数据——这是 AI 编译器岗位上最有意思的分支之一。
端到端走查:同一个算子在两条主流路线里各走一遍
把上面的机制串起来,用本节的例子算子(矩阵乘 + 加偏置 + GELU)分别走一遍 PyTorch 路线与 TVM 路线,感受两种「前端哲学」的差异。
路线一:torch.compile(动态图生态的编译器)
算法组交付的代码是几十行 Python。torch.compile 的完整链路是:TorchDynamo 字节码捕获 → FX 图 → AOTAutograd(推理时只处理前向)→ TorchInductor → Triton kernel。
Dynamo 捕获阶段如果顺利,产出一张 FX 图,节点大致是:
graph(): %x : [num_users=1] = placeholder[target=x] %w : [num_users=1] = placeholder[target=w] %b : [num_users=1] = placeholder[target=b] %matmul : [num_users=1] = call_function[target=torch.ops.aten.mm](args = (%x, %w)) %add : [num_users=1] = call_function[target=torch.ops.aten.add](args = (%matmul, %b)) %gelu : [num_users=1] = call_function[target=torch.ops.aten.gelu](args = (%add,)) return gelu(实际输出由 TORCH_LOGS="graph" 打印,此处为结构示意。)Inductor 拿到图后把它降低成自己的循环级 IR:识别出 matmul 是主算子、add 与 gelu 是它的逐元素尾部(epilogue),合并成一个调度节点,最后生成一个 Triton kernel。生成的 kernel 与手写 Triton 的结构一致(示意):
import tritonimport triton.language as tl
@triton.jitdef linear_gelu_kernel(x_ptr, w_ptr, b_ptr, out_ptr, M, N, K, stride_xm, stride_wn, BLOCK_M: tl.constexpr, BLOCK_N: tl.constexpr, BLOCK_K: tl.constexpr): pid_m = tl.program_id(0) pid_n = tl.program_id(1) offs_m = pid_m * BLOCK_M + tl.arange(0, BLOCK_M) offs_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N) offs_k = tl.arange(0, BLOCK_K) acc = tl.zeros((BLOCK_M, BLOCK_N), dtype=tl.float32) for k0 in range(0, K, BLOCK_K): # K 维分块 a = tl.load(x_ptr + offs_m[:, None] * stride_xm + (k0 + offs_k)[None, :]) b = tl.load(w_ptr + (k0 + offs_k)[:, None] + offs_n[None, :]) acc += tl.dot(a, b) # 张量核指令 bias = tl.load(b_ptr + offs_n)[None, :] acc = acc + bias # 尾部融合:加偏置 cdf = 0.5 * (1 + tl.math.erf(acc * 0.70710678)) # 尾部融合:GELU out = acc * cdf tl.store(out_ptr + offs_m[:, None] * N + offs_n[None, :], out)注意 tl.dot 之外的代码全部是对 acc 的寄存器内逐元素运算——这就是 epilogue 融合落地的样子:matmul 的结果从未离开寄存器。编译器随后自动做线程映射、布局推断与软件流水,num_warps/num_stages 由自动调优决定。
路线二:TVM(静态图生态的编译器)
在 TVM 里,同一算子从图级 IR(Relay)出发,融合成一个子图算子后,用算子级表达式声明计算、用调度原语逐层变换,再代码生成。以早期 TE 风格表达(现版本以 TIR 表达同类变换,此处为示意):
# 算子表达式:声明「算什么」k = te.reduce_axis((0, K), name="k")C = te.compute((M, N), lambda i, j: te.sum(A[i, k] * W[k, j], axis=k), name="C")D = te.compute((M, N), lambda i, j: te.sigmoid(C[i, j]) * C[i, j] + b[j])# 调度:声明「怎么算」s = te.create_schedule(D.op)bm, bn = 128, 128 # 输出分块bx, tx = s[C].split(C.op.axis[0], factor=bm) # 切外层...s[C].vectorize(...) # 向量化s[C].bind(bx, te.thread_axis("blockIdx.x")) # 绑定并行维度之后 TVM 把调度后的循环程序交给 TIR 代码生成器,产出 CUDA C 或 PTX;调度空间若交给 AutoTVM/Ansor,则上述 split/bind 的参数由搜索决定而不是手写。
两条路线对照,能直观看出 AI 编译器工程师的两种日常:在 PyTorch 生态里,主要工作是让 Dynamo 捕获更多 Python 语义、改进 Inductor 的融合判定与模板;在 TVM/自研编译器生态里,主要工作是设计 IR 与写调度/代码生成 pass。前者贴近用户、改动频繁但约束在框架内;后者贴近硬件、自由度大但每一行都影响面广。两条路线都需要同一套底层功夫——本节前面几章讲的融合合法性、循环变换、布局与数值。
验证与测试:编译器工程师的日常武器
编译器代码的正确性验证比普通业务代码难一个维度:bug 不表现为崩溃,而表现为悄悄变慢或悄悄算错。行业积累的验证手段分层如下:
- IR 级测试(golden/diff 测试):给定输入 IR,断言优化后的 IR 与期望一致。LLVM/MLIR 生态用 FileCheck 文本匹配;TVM 有基于
tvm.script的 IR 断言测试。这类测试跑得快、能精确定位是哪一步 pass 改变了 IR,是编译器团队的主力测试。 - 数值等价性测试:随机输入下编译产物与参考实现(eager/高精度库)逐元素对比。误差度量通常用最大绝对误差与最大相对误差,并辅以统计量(如误差的 99.9 分位)防个别离群点误导:
其中 是参考输出、 是编译输出,floor 是防止除零的小量。阈值的设定本身就是学问:FP32 算子链通常允许 1e-5 量级;FP16/BF16 到 1e-2 量级;而编译器开启的快速数学近似(如把除法变倒数乘法、允许重关联、FMA 合并)会系统性改变误差分布——测试要能区分「预期内的精度损失」与「真正的编译错误」。一种有效的中间手段是只关掉优化跑一遍:若关闭某 pass 后误差消失,问题就定位在该 pass。
- 性能回归测试:固定硬件、固定数据形状,跑基准算子集与端到端模型,比较几何平均吞吐与分位延迟。编译器改动最常见的回归不是算错而是「某个模型慢了 5%」,这只有靠持续的性能基线才能发现。
- 内存与启动检查:编译产物是否产生意外的大中间张量、共享内存是否溢出到局部内存、kernel 启动次数是否异常——这些用剖析器就能扫出来,是性能排查的第一动作。
调试工具方面,各生态都有自己的「编译器内窥镜」:MLIR 的 mlir-opt --print-ir-after-all(每跑一个 pass 打印一次 IR)、TVM 的 script 输出与 TVM_LOG_DEBUG、PyTorch 的 TORCH_LOGS(可以细到打印 dynamo 的 guard、inductor 的 fusion 决策)、Triton 的 TRITON_KERNEL_DUMP 与 --ptx 输出、XLA 的 XLA_FLAGS=--xla_dump_to=...。一个合格编译器工程师的调试日常,一半时间在盯这类 IR/决策日志,另一半时间在 ncu 里看 kernel 的访存与占用。
知识体系:这个岗位到底要求什么
把上面所有机制抽象回去,AI 编译器工程师的知识体系可以画成一棵四层树。
第一层:经典编译原理。 这是地基,不可跳过但也不需学成编译器研究员。必须掌握:编译流程的整体图景(前端/IR/优化/后端)、SSA 与数据流分析(def-use、活跃变量)、pass 的组织方式、经典标量优化(常量折叠、死代码消除、公共子表达式、循环不变量外提)——因为 AI 编译器里的张量级优化大量复用这些思想(比如图级 DCE 就是标量 DCE 的张量版);以及把「张量程序」当「程序」看的能力:依赖分析、循环变换合法性(这直接对应调度那节的 split/reorder 为什么安全)。参考书与资料:编译原理教材(龙书或 Engineering a Compiler 二选一即可)、LLVM 的 Kaleidoscope 教程(动手写一个玩具语言)、MLIR 官方 Toy 教程(mlir.llvm.org 文档)——Toy 教程从零实现一个方言并逐步接入方言转换,是理解「现代编译器基础设施」最快的入口。
第二层:并行体系结构与 GPU 编程。 编译器是为硬件服务的,不懂目标机器的编译器工程师写不出好调度。必须掌握:GPU 的执行模型(SIMT、warp、block/grid)、存储层次与带宽量级(寄存器/共享内存/L2/HBM)、同步与原子操作、访存合并与 bank 冲突、占用率与延迟隐藏的关系;以及 roofline 模型——它几乎是调度决策的第一性原理。动手要求:能手写并优化一个 GEMM kernel(GPU GEMM 优化系列讲了从朴素 kernel 到 Tensor Core 的完整路径,可作为配套阅读),能读懂 PTX 与 SASS 的关键片段(至少知道 mma.sync、cp.async、ld.global 在干什么)。对 NPU 岗位,还要理解非 GPU 形态的硬件抽象:DMA、片上缓冲、脉动阵列/立方单元(本站的 TPU 系列与 FPGA 系列覆盖了这类架构的底层模型)。
第三层:领域工具链与框架(选一条主线精通,其余了解)。 当前主流生态分四支,全部精通不现实,但至少一条主线要有「能改源码」的熟悉度,其余达到「能读懂架构文档」:
- MLIR/LLVM 支:方言设计、pass 编写、方言转换;上手路径是 Toy 教程 + IREE 源码阅读(iree.dev);
- TVM 支:Relay/TIR、调度原语、AutoTVM/Ansor;上手路径是官方文档的 microTVM/TVM 教程与 tvm.apache.org 入门;
- Triton 支:写 kernel、读 TTIR/TTGIR 输出、理解布局推断;上手路径是官方教程(写一个 fused softmax 与一个 GEMM,再用
--ptx观察生成结果); - PyTorch 编译栈支:TorchDynamo/Inductor 的内部结构(guard、FX、lowering、模板);上手路径是 PyTorch 官方 torch.compiler 文档与
TORCH_LOGS实战。
第四层:数值与数学基础。 张量语义的底层是数值计算:浮点表示与舍入(FP32/FP16/BF16/FP8/INT8 的动态范围与精度差异)、混合精度下的误差传播、量化算子的数学等价变换(scale/zero-point 如何在融合时重组)。这些决定编译器敢不敢做某个重写——把两个算子交换顺序是否安全、能不能用快速近似、降精度收益与风险怎么权衡。本站的浮点数与数值稳定性系列、量化系列是现成的配套读物。
工程能力本身也占很大比重:编译器几乎全是 C++(MLIR/LLVM/TVM 核心)与 Python(前端生态与工具链)混合开发,模板元编程与内存管理是日常;多仓协作(框架/编译器/运行时/硬件驱动常跨团队)要求扎实的代码评审与文档习惯;而「性能工程」的品味——先剖析再优化、用数据说话、区分噪声与真实差异——是这个岗位区别于普通后端开发的标志。
与相邻岗位的边界
「AI 编译器工程师」在招聘市场常与几个岗位混在一起,实际分工差异明显:
- 与推理框架工程师:推理框架(vLLM 等)解决请求调度、KV 内存管理、批处理策略;编译器解决算子怎么生成。框架把「执行哪个算子在什么数据上」安排好,编译器决定「这个算子怎么算最快」。两者在 kernel 层交汇——框架也常内置手工 kernel(《大模型推理框架开发工程师:岗位地图、开发工作流与硬核知识体系》有该岗位的完整地图)。
- 与算子/内核工程师:算子库团队(如 cuDNN/CUTLASS 开发者)手工为每个算子的每种形状调最优实现,质量上限最高;编译器工程师把同类知识固化成调度策略与代码生成规则,覆盖面更广、单点性能略逊。行业里两者互相输送:编译器的新调度想法先在手工 kernel 里验证,成熟后又沉淀回编译器模板。DeepGEMM 这类「300 行手工 kernel」与 Inductor 自动生成的 kernel 是这条光谱的两端。
- 与算法工程师:算法侧决定模型结构与训练方式,编译器侧只负责执行。双方的交集是「硬件友好的模型设计」(MLA 低秩压缩、GQA 共享 KV、稀疏注意力结构),编译器工程师需要能读懂这类结构性改动并评估其编译期影响。
- 与芯片验证/工具链工程师:新芯片流片前,编译器团队与硬件团队紧密协作:指令集模拟器、编译器先于硬件就绪(如 TPU 的软件先行策略),芯片验证工程师用编译器产出的 kernel 做功能验证。这条线上编译器工程师的角色是「硬件的第一批用户」,对指令集设计的反馈(这条指令编译器用不上/这条指令的语义难表达)往往影响最终架构。
岗位的分布也分几类:芯片厂商(自研指令集 NPU/GPU,编译器从零到一,如昇腾 CANN 的图引擎 GE 做图级优化与离线模型生成、算子编译框架 TBE 演进到 Ascend C、ATC 做模型转换——国内自研芯片厂商普遍自建编译器栈);云厂商与框架团队(torch.compile/XLA/TensorRT 的性能与稳定性维护,服务海量模型,编译时间与缓存命中率是核心 KPI);开源社区与创业公司(Triton/MLIR/IREE 生态,把编译器能力产品化)。不同去处对技能侧重不同:芯片厂重体系结构与代码生成,云厂重全链路稳定性与调优,开源重抽象设计与工程质量。
学习路线:从零到能改第一个 pass
最后给一条可执行的路线。按顺序走完,基本具备投递编译器岗位并上手真实工作的能力:
阶段一(约 4-6 周):地基。 并行做三件事:手写并优化一个 GEMM kernel(从朴素到共享内存分块到 Tensor Core,本博客 GEMM 系列即为此设计);通读 roofline 模型与 GPU 存储层次资料(NVIDIA 官方博客与 CUTLASS 文档);把编译原理的关键概念(SSA、数据流、pass 结构)过一遍。产出物:一个能讲清「为什么这块 tile 是 128×128、为什么用双缓冲」的 GEMM kernel。
阶段二(约 4-6 周):进入编译器世界。 用 Triton 重写你的 GEMM 与一个 fused softmax,开启 kernel dump 观察 TTIR→TTGIR→PTX 的降级过程,把每个 num_warps/num_stages 的效果与硬件对应起来。同时跑完 MLIR Toy 教程(约一天的量)与 LLVM Kaleidoscope 教程,理解 dialect、pass、方言转换的机械结构。产出物:能解释「Triton 把 tl.dot 变成了什么指令、布局推断在解决什么问题」。
阶段三(约 6-10 周):第一次真实改动。 三条可选:给 Inductor 提交一个融合规则或模板改进;给 TVM/Triton 修一个 issue(这类项目对新手友好的 issue 很常见);在 MLIR 上为自己的玩具方言写一个 pass 并做方言转换。关键不只是改动本身,而是走完「复现 → 定位 → 改 → 数值验证 → 性能验证 → 提 PR」的完整闭环——这个过程会把前面所有概念焊死。产出物:一个合并或可展示的 PR,以及一套自己常用的调试命令(TORCH_LOGS/mlir-opt/ncu)。
阶段四(持续):深读论文与源码。 论文按顺序读:Halide(调度分离思想)、TVM(图级+算子级双层与自动调优框架)、Ansor(搜索空间设计)、MLIR(多级 IR 基础设施)、Triton(tile 抽象与编译器自动映射);每个都配合对应源码的局部精读。到这个阶段,面试与实战中的「硬核题」(融合合法性、布局传播、调度权衡、编译时间与缓存命中)基本都能系统作答。
小结
把全文收成三句话:AI 编译器的工作是把算子级性能工程(融合、分块、布局、流水、指令选择)自动化、泛化到任意模型与任意硬件;这个岗位的全部复杂度来自两对矛盾——计算与访存的矛盾(roofline 决定一切收益)、编译期与运行期的矛盾(编译质量 vs 编译时间的权衡);因此它的核心能力不是某一门语言或框架,而是在多个抽象层次间自由穿行:能从一段 Python 模型一路看到 SASS 指令,也能从一条硬件指令的特性反推 IR 该暴露什么语义。
行业趋势也指向同一个方向:模型结构半年一变、硬件一年一代、算子库永远追不上长尾,能自动适应变化的编译器栈(MLIR 化、Triton 化、可微分调度与学习型成本模型)正在吃掉越来越多原本属于手工 kernel 的工作。AI 编译器工程师要做的,恰恰是让「编译」这件事本身越来越自动化——包括自动化地设计编译器本身。
参考资料
- TVM: An Automated End-to-End Optimizing Compiler for Deep Learning(OSDI 2018 论文)
- Ansor: Generating High-Performance Tensor Programs for Deep Learning(OSDI 2020 论文)
- MLIR: Scaling Compiler Infrastructure for Domain-Specific Computation(CGO 2021 论文)
- Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations(MAPL 2019)
- OpenAI Triton 官方博客与开源公告
- triton-lang/triton 官方仓库
- PyTorch 2.0 官方博客(torch.compile 与 TorchInductor 介绍)
- torch.compiler 官方文档(TorchDynamo、Guard、Graph Break 概念)
- MLIR 官方文档与 Toy 教程
- TVM Apache 项目官方文档
- Halide 官方网站(算法与调度分离)
- OpenXLA 项目主页(XLA 开源化与 PJRT)
- NVIDIA TensorRT-LLM 开源公告(NVIDIA 技术博客)
- IREE:基于 MLIR 的 AI 编译器项目
- ONNX 开放模型格式官方站
- 昇腾 CANN 开发者文档(ATC 模型转换、图引擎与算子开发框架)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


