


带有记忆的 VLA 完全拆解:从滑动窗口到层次化持久记忆,机器人为什么必须学会记住
引言:VLA 为什么突然开始谈“记忆”
过去两年,Vision-Language-Action(VLA)模型把机器人控制从传统模块化管线推向了端到端范式:相机图像进入视觉编码器,人类指令进入语言模型,模型直接输出动作 token、连续 action chunk 或扩散式动作轨迹。这个路线继承了 VLM 的语义泛化能力,也让机器人系统第一次有机会把“看见什么、听懂什么、怎么动”放进同一个模型里训练。
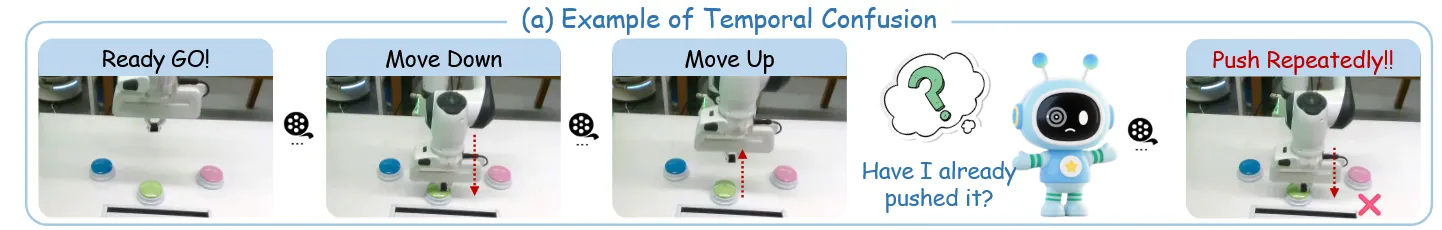
但 VLA 的一个基本假设正在暴露问题:很多模型仍然把当前观测当成足够充分的状态,只根据当前图像和当前指令预测下一段动作。这近似于马尔可夫控制。真实机器人任务却经常不是马尔可夫的。机器人刚刚把杯子放到哪里、抽屉是否已经打开、遮挡背后物体是什么颜色、当前任务执行到第几步、刚才失败的原因是什么,这些信息未必存在于当前图像里,却会直接决定下一步动作。
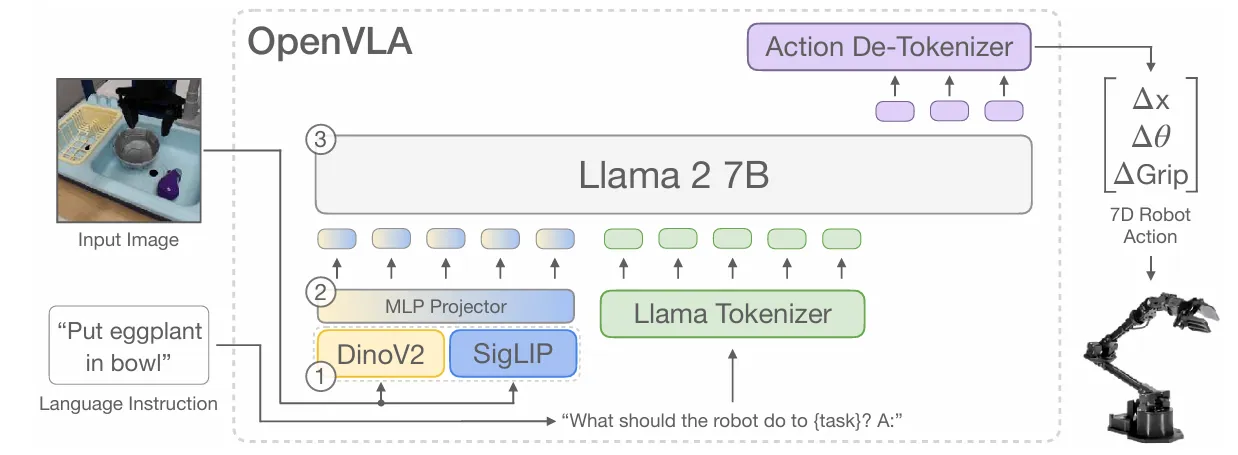
带有记忆的 VLA 试图解决这个矛盾。它给机器人增加一条时间维度上的信息通路:模型不仅处理“此刻看到什么”,还要处理“之前发生过什么”。这篇文章把 Memory+VLA 拆成四类:Sliding-Window Memory、Episodic Retrieval Memory、Latent State / Fast Weight Memory、Hierarchical Persistent Memory。它们看起来都叫 memory,但在系统中的位置完全不同:有的把历史帧直接塞进上下文,有的检索关键帧,有的把经验压进可更新参数,有的把任务进度写成上层语义状态。
本文会从 VLA 的基本架构讲起,再逐一拆解 DREAM-ZERO、KEMO、LaMem-VLA、RoboTTT、MEM、RMBench / Mem-0 和 -VLA,最后给出一个面向工程实现的统一接口视角。
VLA 的基本结构:从“看懂任务”到“输出动作”
具身智能任务大体可以分成导航和操作。导航任务要求机器人在已知或未知环境中找到目标位置、目标物体或目标区域。操作任务要求机器人通过接触完成抓取、放置、推动、堆叠、开关门、整理物体等动作。它们和纯文本大模型的最大区别在于:机器人必须和真实物理世界闭环交互,输出不是句子,而是会改变环境状态的动作。
一个 VLA 模型通常包含三部分。
第一部分是视觉编码器。它把相机图像、多视角图像或视频帧编码成视觉 token,负责空间理解、物体识别、几何关系和场景状态表示。第二部分是语言模型或多模态 backbone。它接收视觉 token 与指令 token,完成语义对齐和任务理解。第三部分是 action head。它把 backbone 的输出转成机器人动作,可以是离散化动作 token,也可以是连续动作向量、action chunk、diffusion action 或 flow matching action。
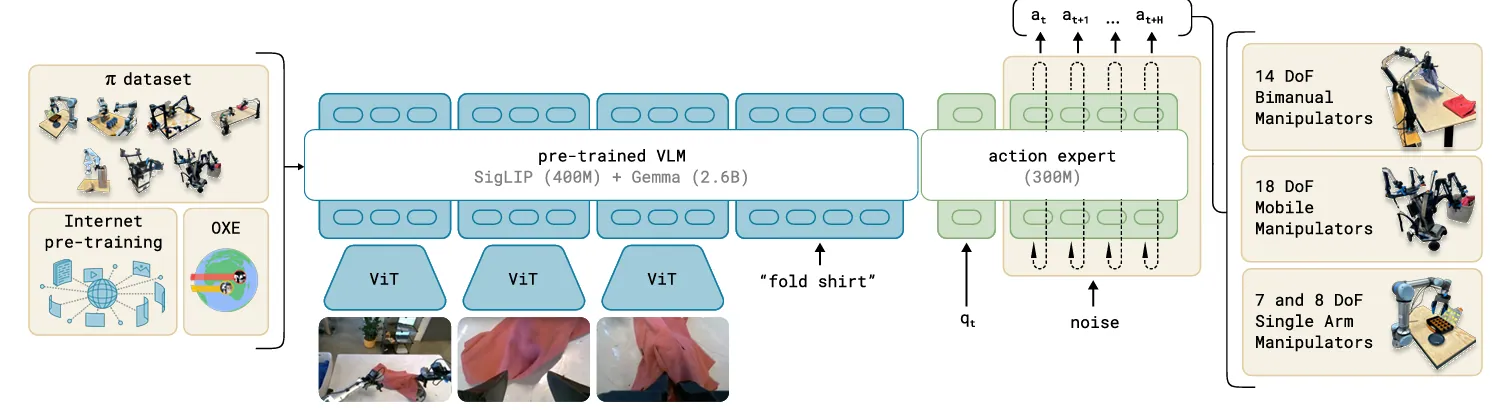
这种结构的优势很明显。预训练 VLM 已经在互联网图文数据中学到了大量物体、场景、语义和常识,VLA 通过机器人数据微调,把这些知识迁移到动作预测里。问题也同样明显:如果模型每一步只看当前图像,它很难知道当前图像背后的任务历史。一个桌面场景在不同任务阶段可能长得几乎一样,但正确动作完全不同。
这就是记忆进入 VLA 的入口。
记忆解决的不是一个问题,而是三类问题
Memory+VLA 的动机可以分成三类,这是理解这个方向最好的切入点。
第一类是辅助当前动作决策。很多短程操作需要历史细节。例如机器人刚刚看到目标物体在左侧,但当前视角被机械臂遮挡;它刚刚翻开盒盖,看见里面有红色物体,但下一帧只看到盒盖外观;它刚刚接触到某个物体,接触结果会影响下一步夹爪姿态。这类信息不需要跨越十分钟,但需要跨越当前观测的盲区。
第二类是提升长程任务完成能力。清理厨房、做三明治、整理桌面、按顺序完成多个子任务,都需要机器人知道“已经做了什么”和“下一步应该做什么”。这类任务的难点不只是低层控制,还包括任务进度追踪、子任务切换、错误恢复和计划更新。
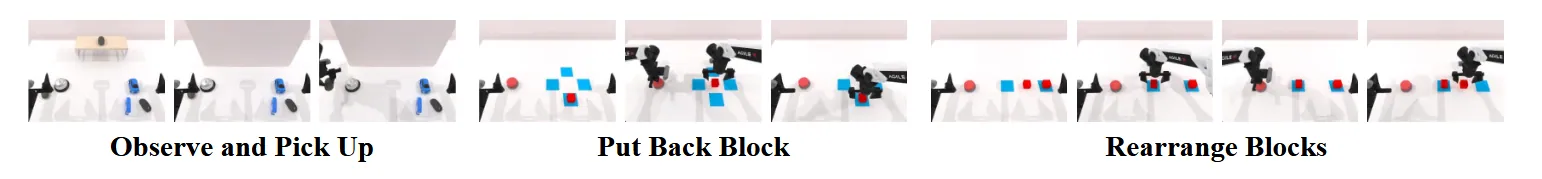
第三类是帮助 VLA 学习新技能。一些方法把人类视频、其他机器人视频或历史示范以 in-context learning 的方式输入模型,让模型在测试时模仿训练中没有见过的技能。此时“记忆”不再只是任务过程中的临时状态,而变成了测试时适应的载体。
这三类问题对应三种不同的时间尺度:几帧到几十帧的短期工作记忆、跨越整个 episode 的关键事件记忆、跨任务或跨示范的技能记忆。不同 Memory+VLA 方法的差异,本质上就是它们选择在哪个时间尺度上存什么、怎么取、怎么插入策略网络。
四类 Memory+VLA:同一个词,四种系统位置
现有带记忆的 VLA 可以分成四类。这个分类非常适合工程理解。
| 记忆模式 | 存储对象 | 读取方式 | 优点 | 主要代价 |
|---|---|---|---|---|
| Sliding-Window Memory | 最近若干帧图像、文本、KV cache 或动作上下文 | 固定窗口直接输入模型 | 简单、稳定、容易部署 | 没有长期记忆,窗口外信息会丢失 |
| Episodic Retrieval Memory | 关键帧、关键事件、短期/长期 latent memory | 用 query-key 相似度或事件触发检索 | 保留长程关键信息,计算量可控 | 检索机制难设计,漏检会直接伤害动作 |
| Latent State / Fast Weight Memory | 隐状态、可更新 fast weight、测试时训练状态 | 通过 recurrent state 或 TTT 层参与推理 | 上下文长度可扩展,不必显式保存所有历史 | 容量有限,训练和稳定性复杂 |
| Hierarchical Persistent Memory | 上层语义进度、子任务状态、下层短期视频 | 上层规划、下层控制分层消费 | 适合长程任务和错误恢复 | 系统复杂,延迟和训练成本更高 |
下面按这四类展开。
Sliding-Window Memory:最直接,也最容易遇到窗口边界
Sliding-Window Memory 的思路最朴素:把最近一段历史作为上下文输入模型。这个历史可以是最近几帧图像,可以是最近的语言描述,可以是最近动作 chunk,也可以是 transformer 里的 KV cache。它的优点是几乎不需要额外设计复杂的检索器,只要扩大输入上下文或保留缓存,就能让模型看见近期信息。
缺点也清楚:窗口长度决定记忆上限。窗口太短,关键事件一旦滑出上下文就消失;窗口太长,视觉 token 数暴涨,推理延迟和显存成本不可控。Sliding window 适合短程控制和局部遮挡,不适合需要跨分钟追踪任务进度的场景。
DREAM-ZERO:把视频扩散模型变成 World Action Model
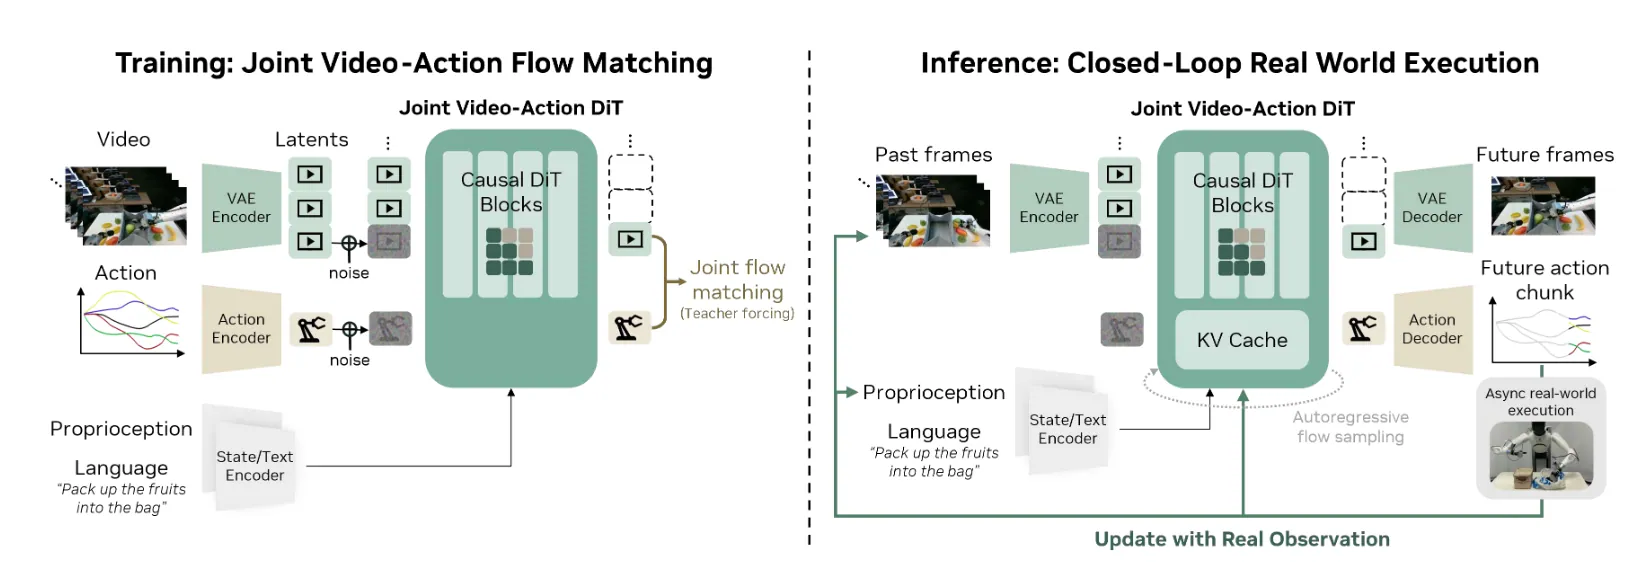
DREAM-ZERO 是这一类里很有代表性的系统。论文题目是 World Action Models are Zero-shot Policies。它不再把机器人策略理解成“当前图像到动作”的映射,而是把动作预测和未来世界状态预测绑在一起:模型同时生成下一段视频和下一段 action。这样做的好处是,视频本身成为密集的世界状态表示,动作不再脱离物理动态孤立预测。
DREAM-ZERO 以 Wan2.1-14B 这类视频 DiT 作为基础模型。训练时,它把最后一帧图像和下一阶段 action 共同解码。推理时,它保留最近四帧作为记忆,指导后续图像预测和动作生成;这些记忆以 KV cache 的形式参与模型。为了避免预测视频误差滚雪球,系统在执行 action 后会把真实观测重新输入模型,用真实世界反馈校正下一轮预测。
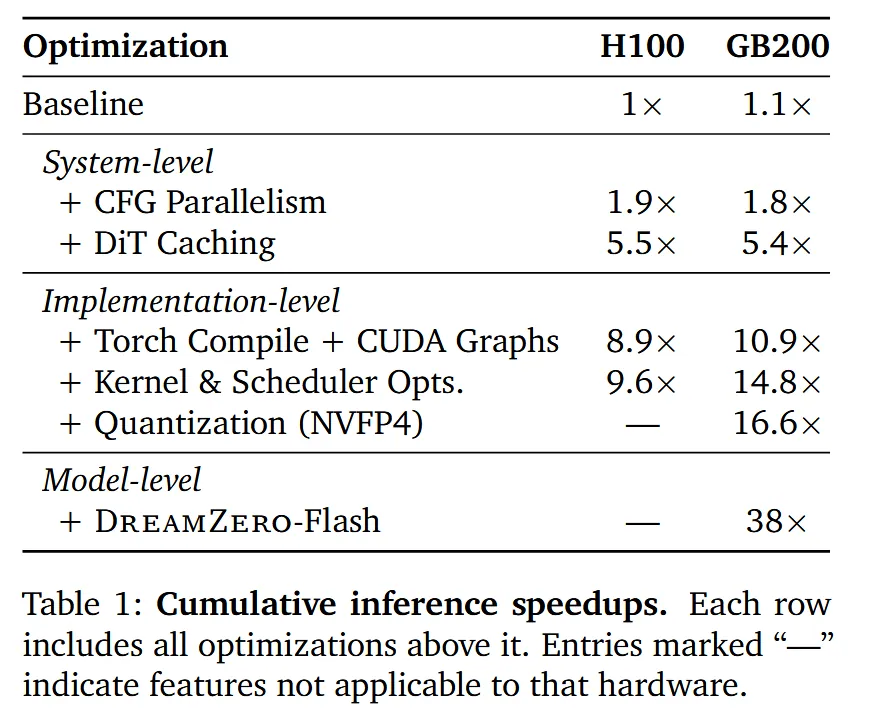
这条路线很强,但计算量也很大。DREAM-ZERO 原始单次推理约 5.7 秒,论文和项目页也强调它通过一系列系统和模型优化把 14B 视频扩散模型压到实时闭环控制。关键优化包括四层。
第一层是异步闭环执行。传统串行方式下,机器人执行完上一段动作后等待模型预测下一段动作。异步执行把 action 预测和上一个 action chunk 的执行重叠起来,用控制链路掩盖推理时间。这不能提高机器人对突发变化的反应速度,但可以减少“机器人空等模型”的时间。
第二层是系统级并行与缓存。Classifier-Free Guidance 中的有条件去噪和无条件去噪可以分配到不同 GPU。DiT caching 则减少 diffusion 去噪步数,相关系统优化把去噪次数从 16 次减少到 4 次。
第三层是实现级优化,包括 CUDA Graph、post-training quantization、kernel 和 scheduler 优化。这里包括 NVFP4 量化和固定推理流程下的 CUDA Graph 优化。
第四层是 DreamZero-Flash。它希望把四次 diffusion 去噪进一步优化成一次,但此时 action 必须在视频仍然较噪声的阶段预测。训练时给 video 和 action 不同噪声程度,让 action head 学会在视频尚未完全去噪时做出动作判断。相关结果显示,整体 latency 可以压到 150ms 以内。公开资料中,DREAM-ZERO 也报告了 7Hz 闭环控制、相对现有 VLA 在新任务和新环境上超过 2 倍的泛化提升,以及通过人类或其他机器人视频示范带来超过 42% 的未见任务表现提升。
Sliding window 在 DREAM-ZERO 中不是孤立存在的。它和世界模型、视频预测、异步控制、KV cache、量化和 kernel 优化绑在一起。这说明 Memory+VLA 并不只是模型结构问题,它会立刻变成系统问题:历史信息越多,推理链路越长,实时控制越依赖工程优化。
Episodic Retrieval Memory:不要记住一切,只记住关键事件
如果 sliding window 的问题是“窗口外信息会丢”,最直接的补救是建立 memory bank,把历史中的关键事件保存下来。每次推理时,模型不读取完整历史,而是检索和当前场景相关的记忆,再输入 VLA。
Episodic Retrieval Memory 的核心难点有两个。第一是存储:哪些帧值得保存?如果保存太多,memory bank 会膨胀,检索也会慢;如果保存太少,关键事件会丢。第二是检索:当前 observation 和 instruction 应该如何构造 query?相似度看视觉外观、动作状态、语言语义,还是任务阶段?一旦检索漏掉关键事件,后面的 VLA 再强也可能做错。
KEMO:用机器人运动事件触发关键帧记忆
KEMO 的全称是 Event-Driven Keyframe Memory for Long-Horizon Robot Manipulation with VLA Policies。它的出发点很实际:长程操作里,有些历史帧比其他帧重要得多。比如机器人完成一次抓取、移动到新区域、物体状态发生明显变化,这些都是任务阶段变化的线索。KEMO 不平均采样历史,也不只保留最近帧,而是自动选择和任务进展相关的 keyframe。
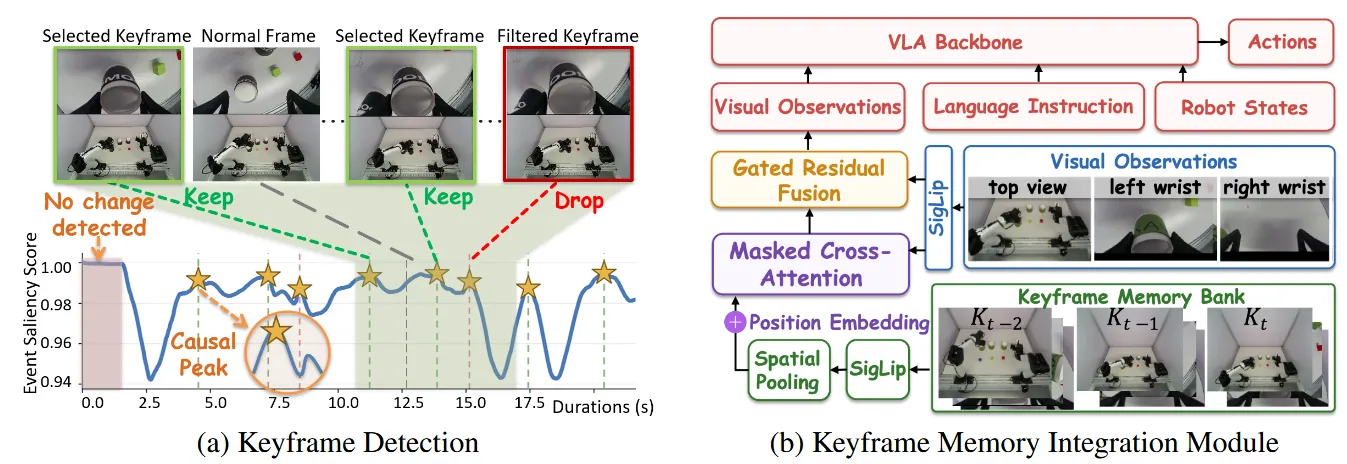
KEMO 的 keyframe 选择分两步。第一步用轨迹连续性找候选点。当机械臂关节速度下降时,系统认为这里可能是关键帧候选,因为速度下降常常对应接触、放置、抓取完成或阶段切换。第二步用 DINOv2 视觉特征和上一个关键帧比较,只保留相似度低的候选帧,避免保存重复画面。
被选出的 keyframe 会被编码成 token,并通过 cross-attention 与当前观察融合。训练早期,为了避免 memory 分支突然引入过大扰动,KEMO 给融合了 memory 的输入加一个初始为 0 的权重,让模型逐渐学会使用记忆。训练时还会提高关键帧附近 action 的权重,因为这些位置往往对应任务阶段转折点,对成功率影响更大。
公开摘要中,KEMO 在双臂真实操作任务上比无记忆基线提升了 23.6% 的任务成功率和 34.1% 的阶段完成率。这个结果也说明,事件驱动关键帧不是“把更多帧塞给模型”,而是在用机器人自身的运动信号帮助模型判断哪些历史值得记住。
LaMem-VLA:把历史经验重构成短期和长期 latent memory
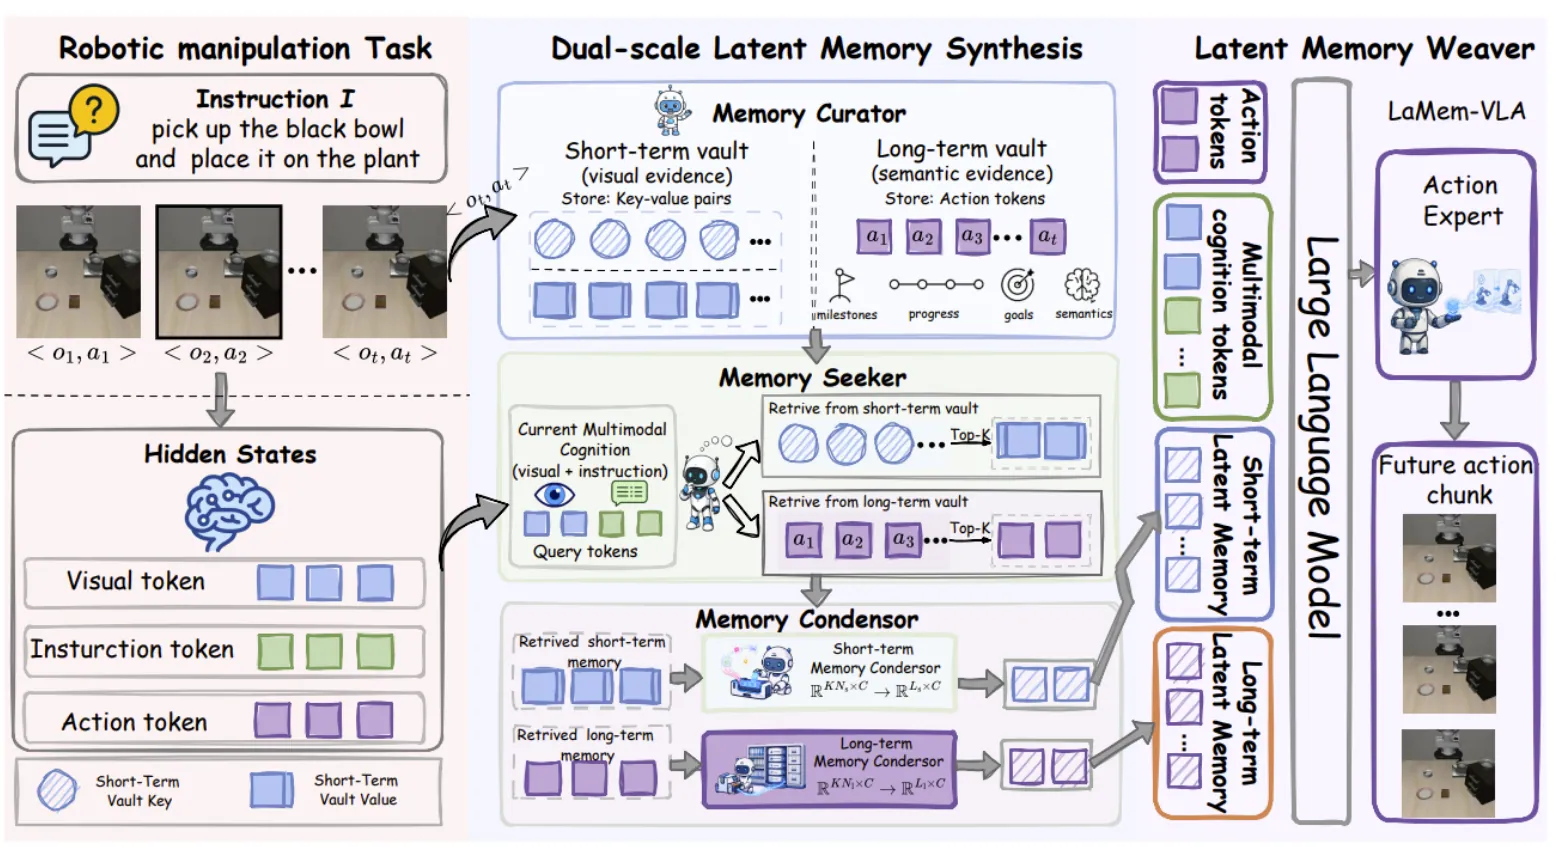
LaMem-VLA 的全称是 Dual Latent Memory in Vision-Language-Action Models for Robotic Manipulation。它关注的问题比 KEMO 更偏表示空间:如果 memory 只是作为策略外部的辅助上下文存在,它和 VLA backbone 的推理过程仍然隔了一层。LaMem-VLA 希望把历史经验重构成 VLA 原生 latent token,让记忆直接参与多模态推理和动作形成。
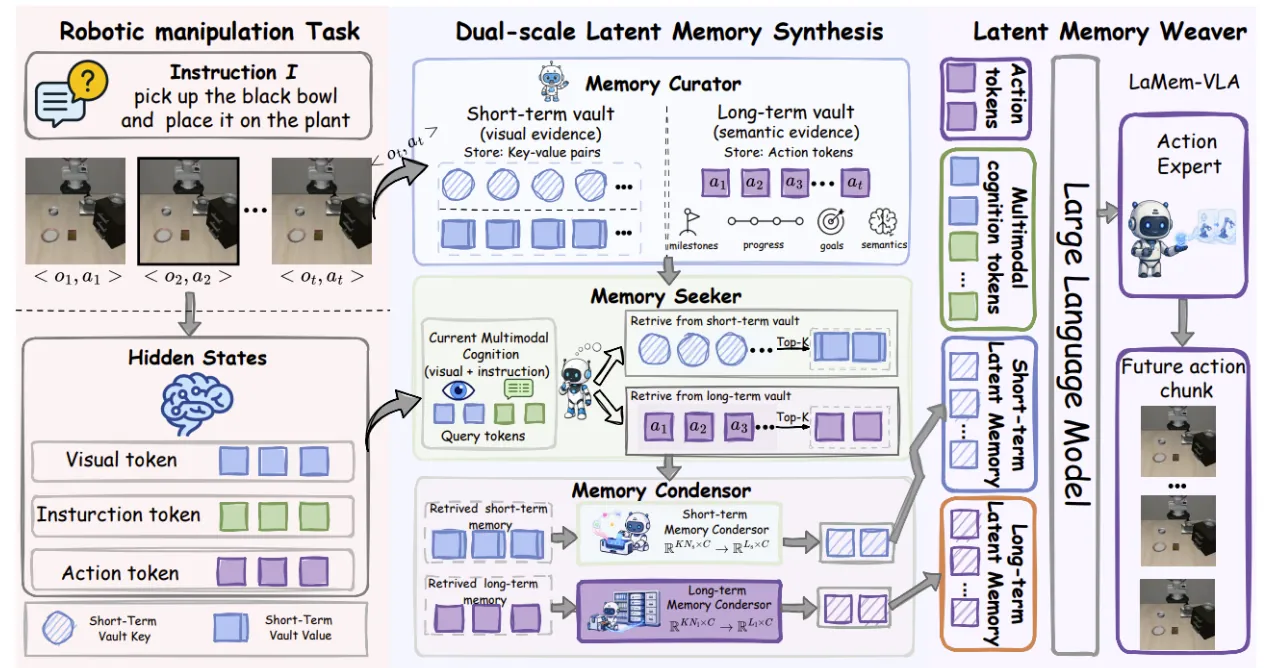
LaMem-VLA 把记忆分成短期记忆和长期记忆。短期记忆主要保存 visual embedding,强调近期视觉细节。长期记忆主要保存 action embedding,强调跨阶段动作和任务历史。短期 visual token 经过 SE-bottleneck block 压缩,并用 mean pooling 得到 key。检索时,当前图像和指令经过 transformer 得到 query,再用余弦相似度从 memory vault 中找相关记忆。检索出的记忆经过 transformer block 压缩为 latent memory token,再和当前 observation、instruction 拼成连续 embedding 序列输入 VLA,最后 action expert 预测动作。
LaMem-VLA 还处理了 memory bank 满了以后的合并问题。当短期记忆存储满后,系统计算每两个相邻短期记忆的余弦相似度,把相似度最高的两个记忆平均融合。这是一个简单但有意义的 memory consolidation 策略:相近历史保留为一个压缩状态,给新历史腾出容量。
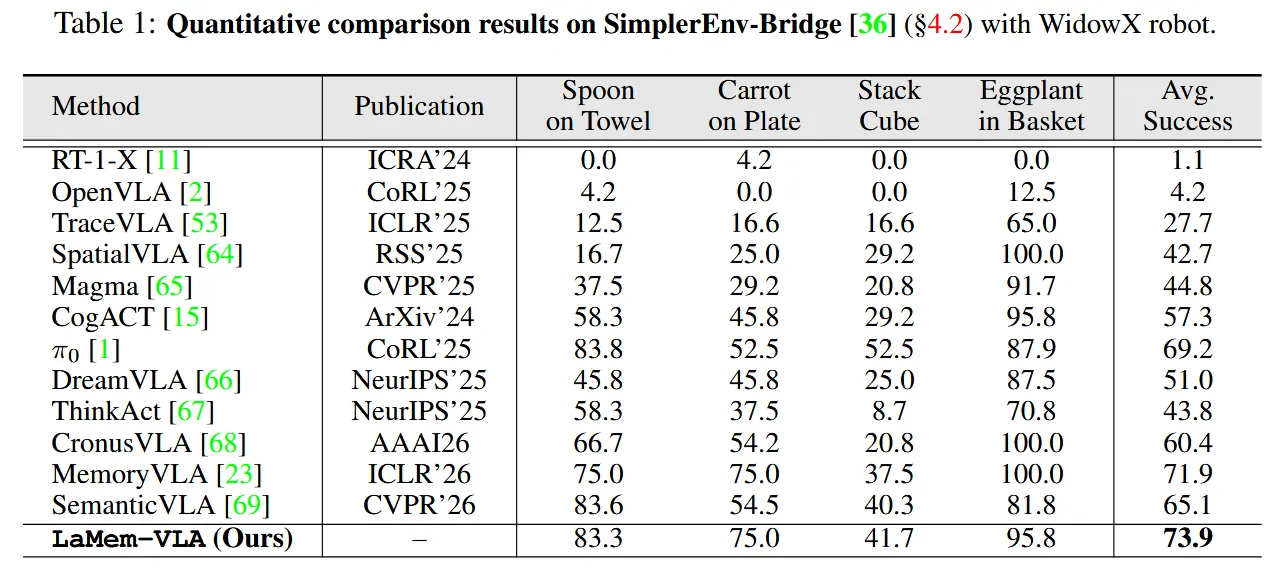
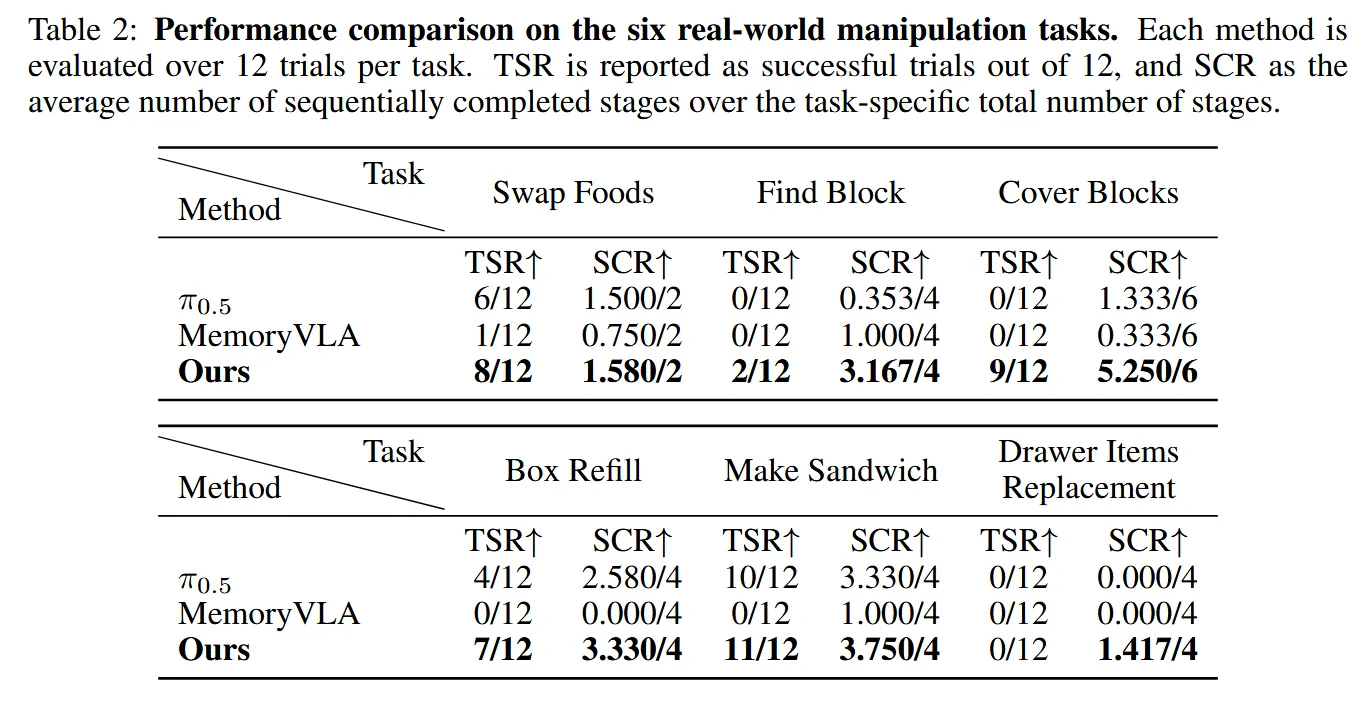
KEMO 和 LaMem-VLA 代表了 episodic retrieval 的两种方向。KEMO 从“什么时候值得记”出发,用事件检测选择关键帧;LaMem-VLA 从“记忆应该以什么表示进入模型”出发,把历史经验变成短期/长期 latent token。前者更像 memory selection,后者更像 memory representation。
Latent State / Fast Weight Memory:把历史压进可更新状态
Episodic memory 显式保存历史条目,检索时再读出来。另一条路线把历史压进隐状态或可更新参数里。这样做的吸引力在于:历史长度可以增长,但每次推理时不必线性读取所有历史帧。代价是记忆容量更难解释,训练也更复杂。
RoboTTT:测试时训练作为机器人工作记忆
RoboTTT 的题目是 Context Scaling for Robot Policies。它把 Test-Time Training(TTT)引入机器人策略,用 fast weight 作为 memory,把 visuomotor context 扩展到 8K timesteps。论文摘要中写到,这比当时的策略上下文长三个数量级,而且不增加推理延迟。
RoboTTT 把权重分成 static weight 和 fast weight。Static weight 保存训练中学到的通用技能。Fast weight 则在测试时随着时间步不断更新,保存部署过程中获得的信息。这个 fast weight 更新过程可以概括为:
这里 是当前 fast weight, 可以理解为当前时间步构造出的训练信号, 是用于更新 fast weight 的局部目标。更新后的 fast weight 再参与输出:
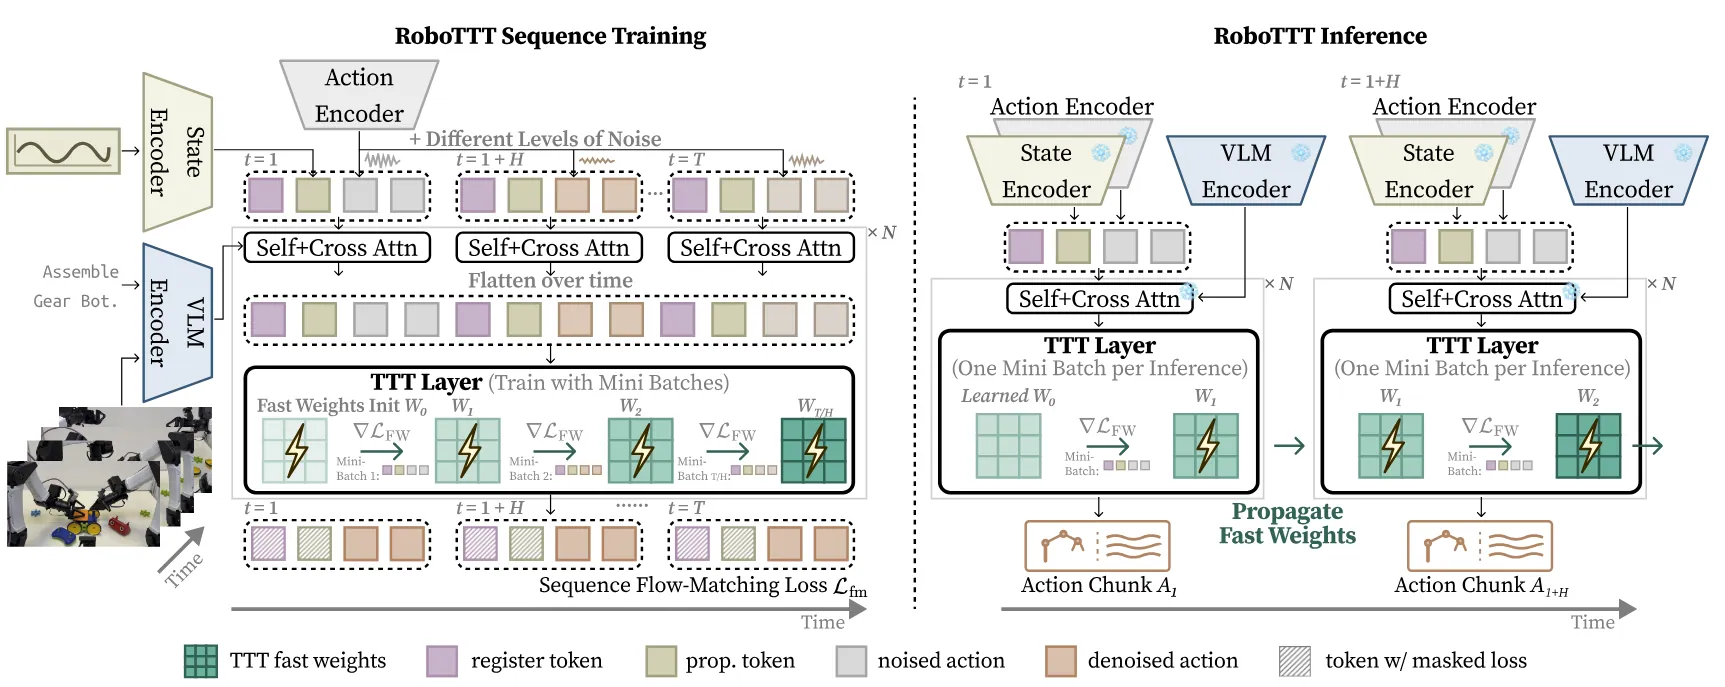
RoboTTT 将 fast weight 以 MLP 形式插入 DiT 每一层。为了让网络稳定使用这条新通路,训练时使用 tanh gating 学习 向量,初始化为 0,让 TTT 层权重逐步进入主干输出:
这个初始化策略很重要。若一开始就让未训练好的 TTT 分支强行干预动作预测,模型容易不稳定;从 0 开始逐步打开,相当于给原模型加一个可学习的记忆残差。
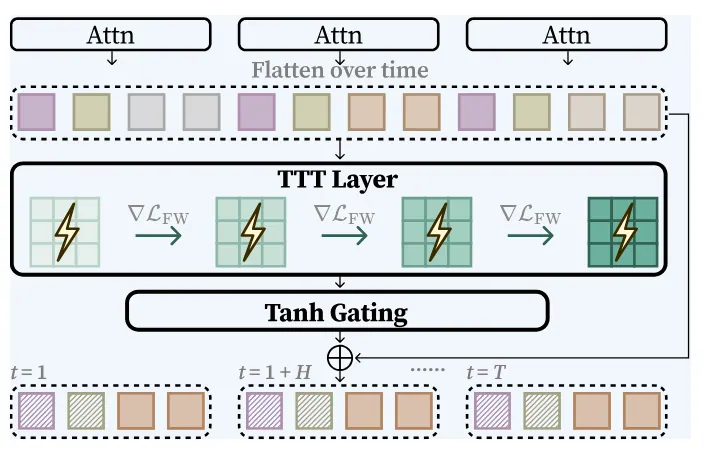
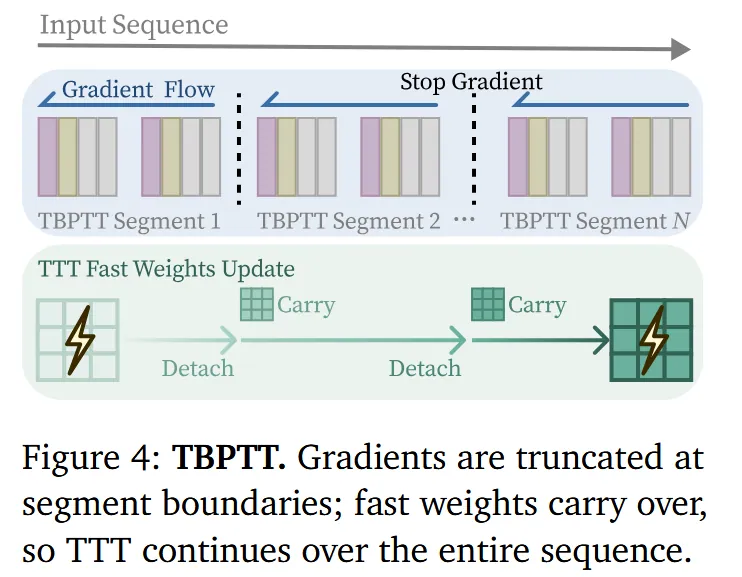
长序列训练带来显存问题。Fast weight 贯穿整个轨迹,反向传播如果保留全部 activation,内存会爆炸。RoboTTT 用 truncated backpropagation through time(TBPTT)截断梯度,把长轨迹分成多个片段。每段之间 fast weight 继续传递,但梯度在边界停止。这样模型仍然能在前向过程中携带长期状态,同时把训练显存控制在可承受范围内。
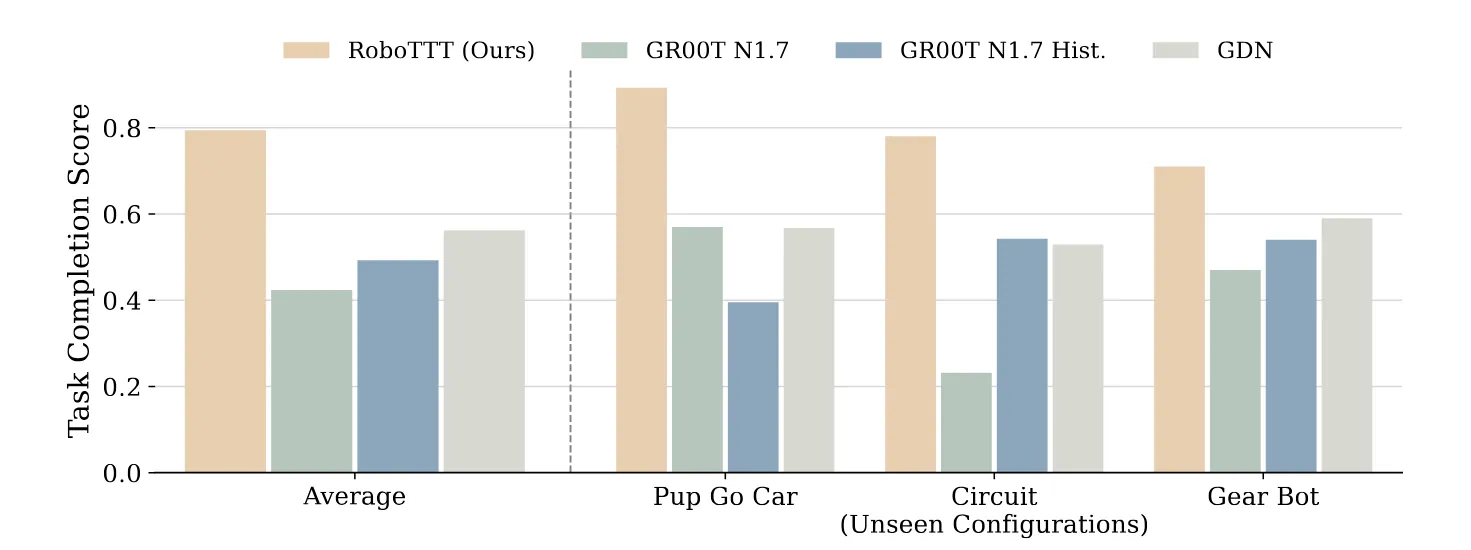
RoboTTT 还使用 Sequence Action Forcing:给整个轨迹的不同 action chunk 分配不同 noise 等级,避免整条轨迹对模型来说过难或过简单。公开摘要中,RoboTTT 训练到 8K-timestep context 后,在真实机器人任务上比单步上下文基线整体性能提升 87%,并完成了一个五分钟、十阶段的装配任务;8K context 版本还比 1K context 版本提升 62%。
RoboTTT 的启发在于:memory 不一定要是外部数据库,也可以是模型内部的可更新状态。它把“机器人记住了什么”转化为“fast weight 如何改变下一步计算”。这条路线很适合上下文极长、显式检索成本太高的任务,但调试难度也更高,因为 fast weight 中到底存了什么并不直观。
Hierarchical Persistent Memory:把长程任务拆成上层记忆和下层控制
当任务时间尺度继续变长,单一 memory 机制很难同时满足两个需求:下层控制需要近期细节,上层规划需要抽象进度。Hierarchical Persistent Memory 采用分层策略:上层 policy 维护任务进度、子任务和语义记忆,下层 policy 根据当前子任务和短期视频/图像记忆输出动作。
MEM:短程视频记忆加长程文本记忆
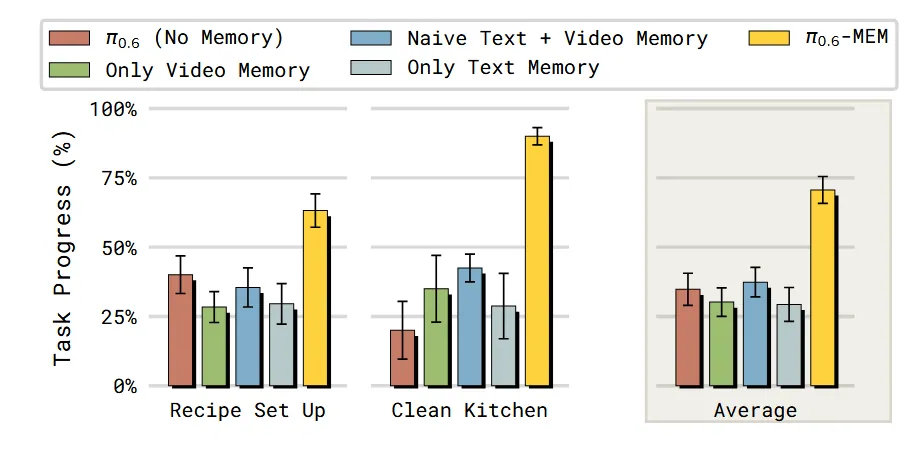
MEM 的全称是 Multi-Scale Embodied Memory for Vision Language Action Models。它的核心判断是:长程机器人记忆应该用多种模态、多个粒度表示。短程记忆要保留最近细节,比如物体被机械臂遮挡前的位置;长程记忆要记录抽象语义,比如“菜谱已经进行到哪一步”。
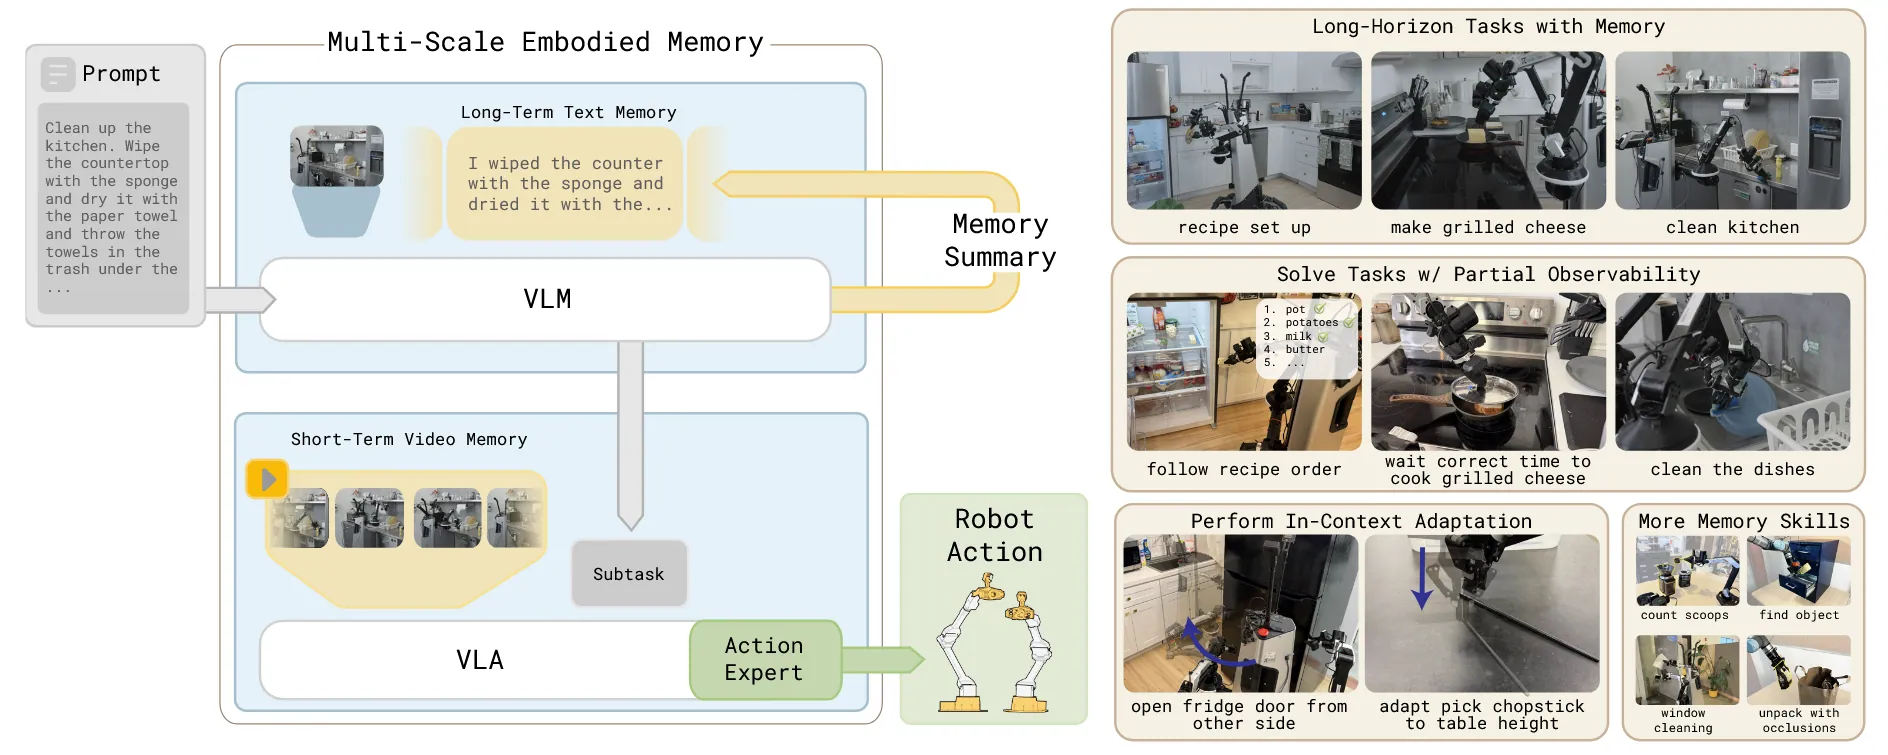
MEM 的推理流程可以分成高层和低层。高层输入当前观察图像和上一帧记忆,输出更新后的长程记忆和当前子任务。低层接收子任务和最近一段时间的视频,输出 action。低层还可以监测子任务是否完成,把完成信号反馈给高层。这里还引出一个工程问题:high-level 和 low-level 是否可以用不同频率运行。这个问题很关键,因为高层规划不需要每个控制步都跑,低层动作却要满足实时性。
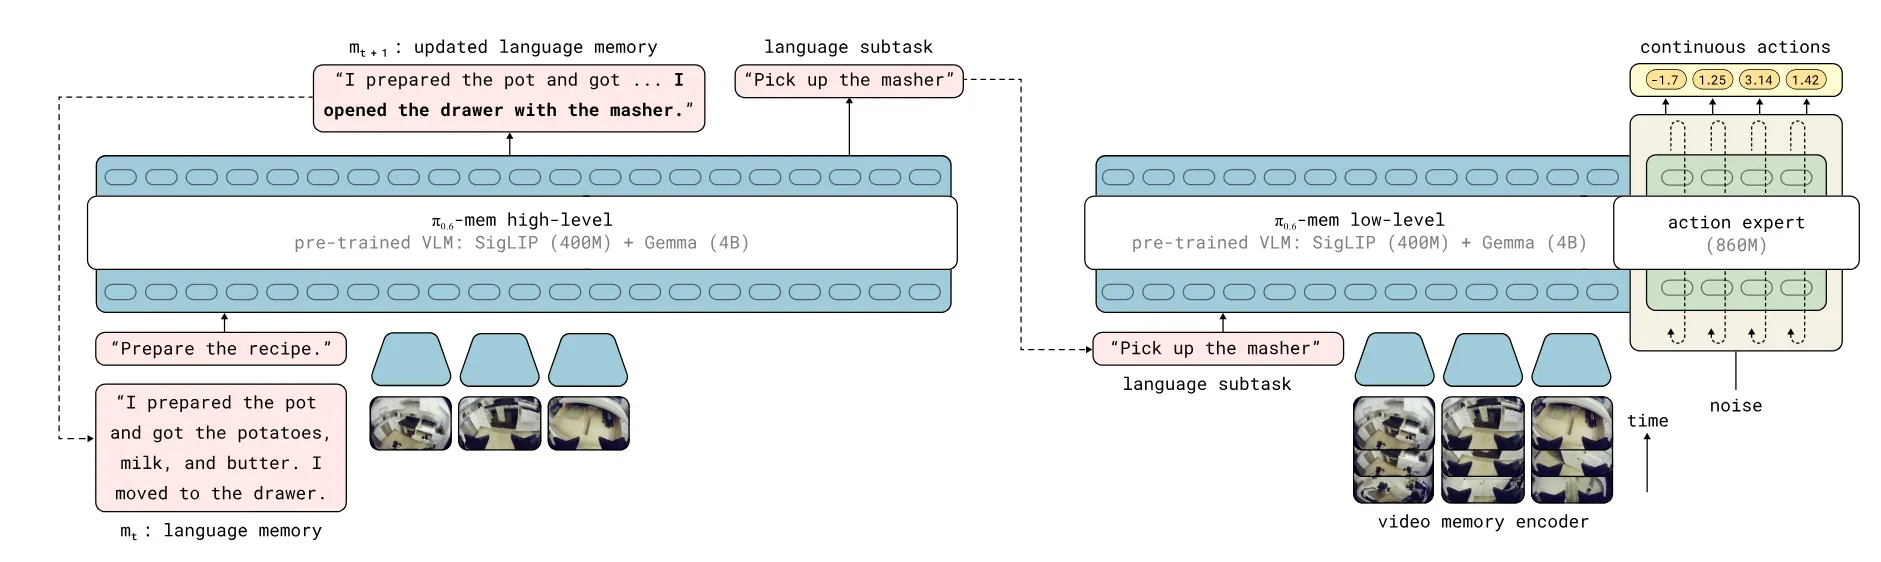
MEM 的视频编码器也做了效率设计。视频包含多张图片,直接做完整时空 attention 会导致 token 数和计算量暴涨。MEM 将时间 attention 和空间 attention 解耦,每四层插入一次时间 attention,对不同时间的相同 patch 做因果 attention。低层 policy 每次只输入当前时间步图像对应的 token;历史帧信息通过时间 attention 的 KV cache 提供。这样可以在保留历史信息的同时控制 token 规模。
公开资料中,Physical Intelligence 的 MEM 项目页提到 MEM 可以支持最长约 15 分钟的任务,处理部分可观测性,并通过 in-context adaptation 纠正策略。它展示了一个很重要的方向:长程 VLA 的 memory 不应该只在模型输入端堆帧,而要变成一套跨层级、跨模态、跨频率的系统。
RMBench 与 Mem-0:先把“需要记忆的任务”定义清楚
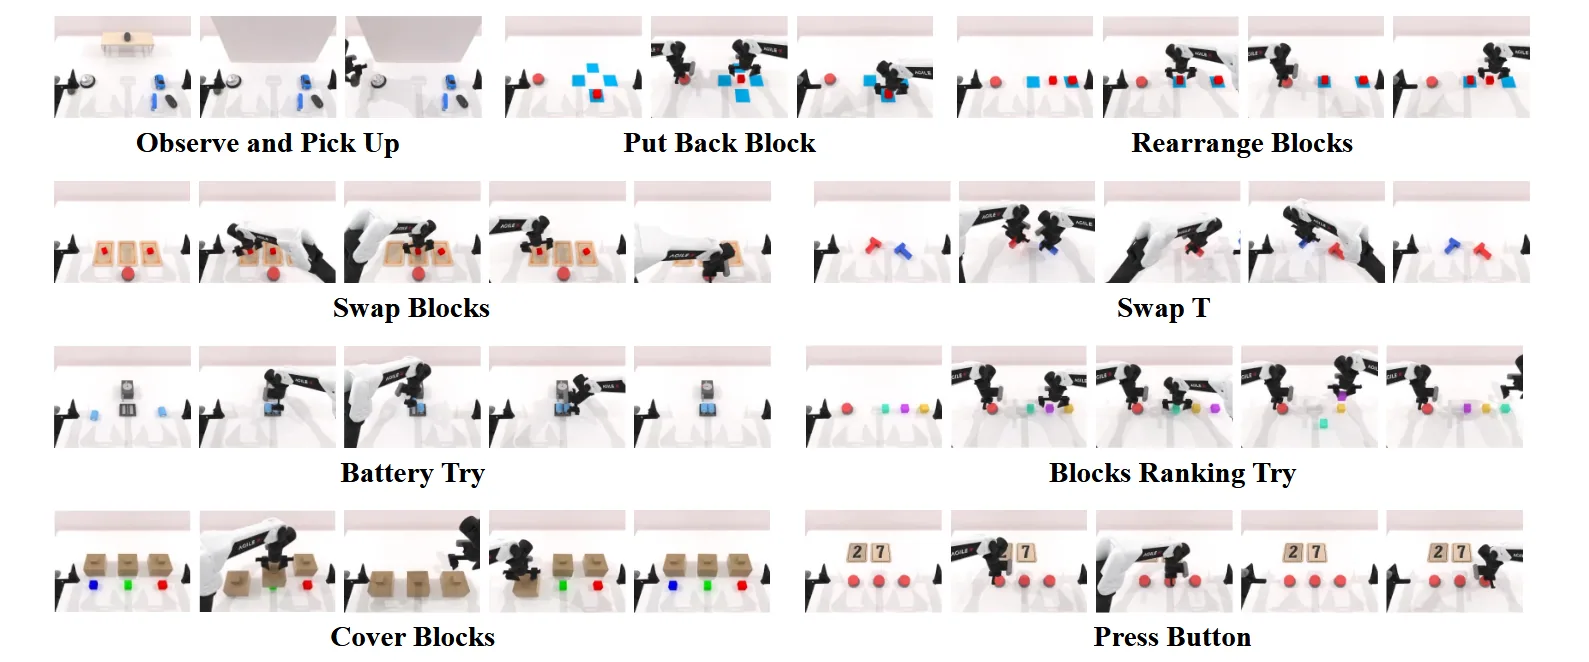
RMBench 不是单纯提出一个更强策略,而是提出一个 memory-dependent robotic manipulation benchmark。这个工作非常重要,因为 Memory+VLA 如果没有专门 benchmark,很容易只在普通任务上比较成功率,无法知道模型到底有没有使用记忆。
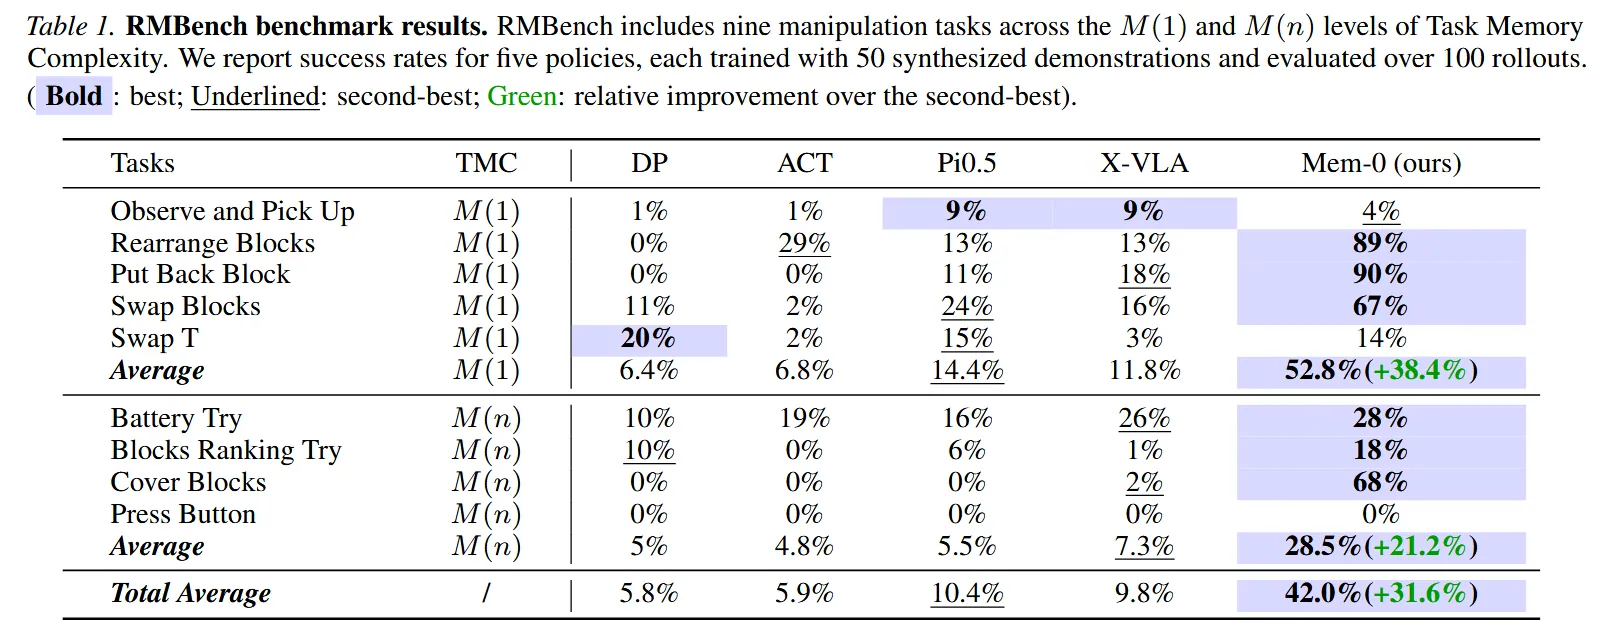
RMBench 设计了 9 种需要记忆的操作任务,并分成 和 两类。 任务至少需要一帧历史信息才能完成, 任务需要多帧历史信息。它们覆盖了物体恒常性、阶段依赖、过去事件影响当前动作等场景。
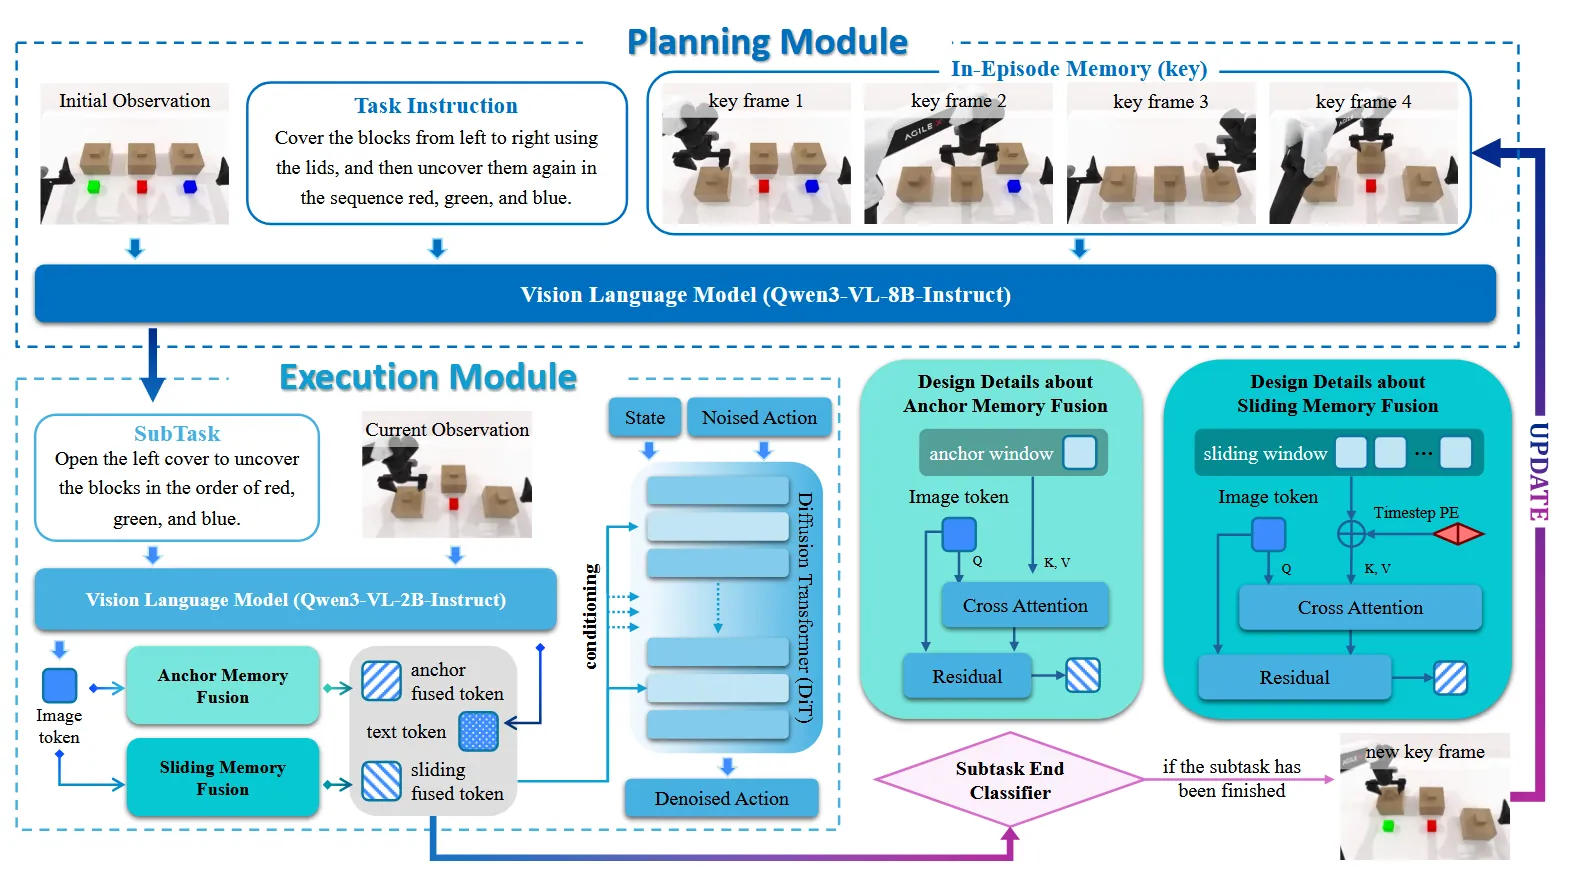
RMBench 还提出了 Mem-0,一个带显式 memory 的模块化策略,用于受控消融。Mem-0 分成上层 planning 和下层 execution。上层使用每个子任务结束时的图像作为 keyframe 记忆,并结合首帧图像进行子任务规划。下层使用子任务内首帧和最近几帧 sliding window 作为短期记忆,把当前图像和记忆 embedding 输入 DiT 预测动作。同时,Mem-0 设计了 sub-task 结束判断器,输入近几帧场景和子任务,判断是否应该进入下一次规划。
RMBench 的价值在于,它把“记忆能力”从泛泛而谈变成可测对象。一个 VLA 在普通 LIBERO 或 SimplerEnv 上成功,不等于它真的会记忆;它可能只是当前观测足够充分。Memory+VLA 需要 RMBench 这类专门任务来拆分模型能力边界。
-VLA:高层策略也可以做测试时搜索
-VLA 把 hierarchical memory 和 test-time computation 结合起来。长程操作中,高层策略的每一次子任务决策都很关键:一旦子任务顺序错了,低层再稳也无法完成目标。大多数 hierarchical VLA 每次高层决策只做一次 forward,-VLA 则把高层子任务生成视为一个可扩展计算的问题。
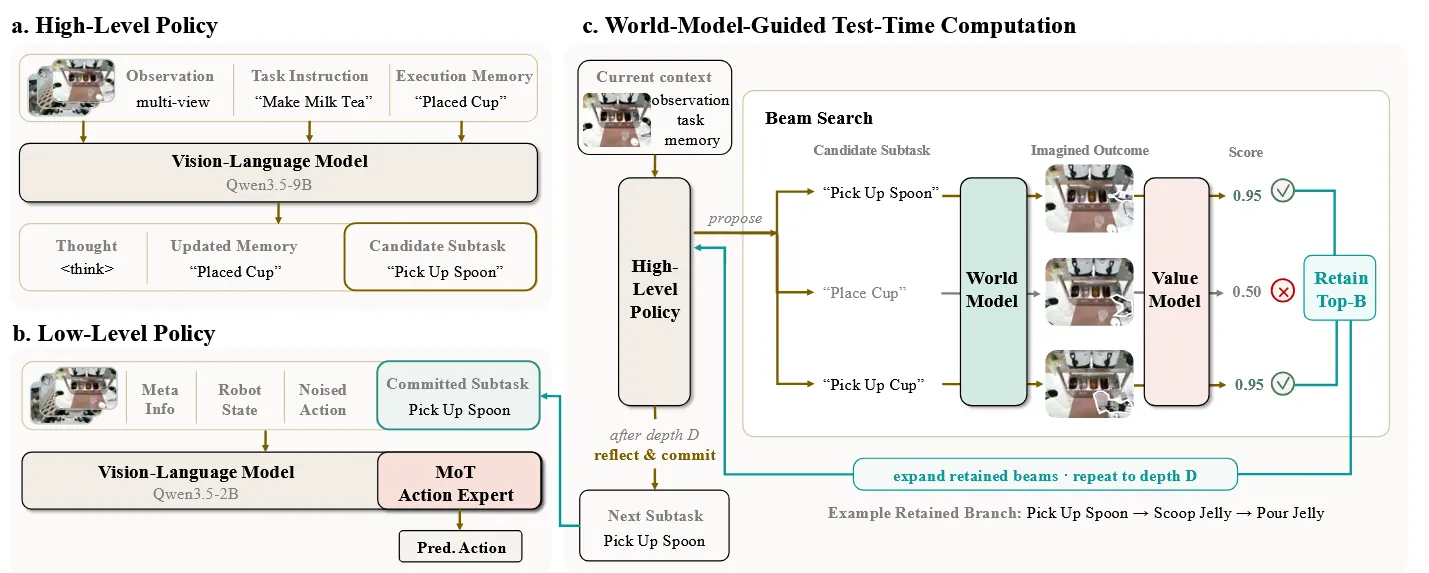
它的高层 policy 维护 execution memory,根据当前观察和历史记忆生成下一步子任务。当置信度足够高时,系统直接执行;当置信度不高时,系统进行子任务搜索。搜索过程使用 beam search:每一轮提出多个 candidate,再用 value model 打分,对高分候选继续 rollout。World model 负责预测执行某个子任务后的环境状态,从而让高层策略在提交动作前评估多个未来分支。
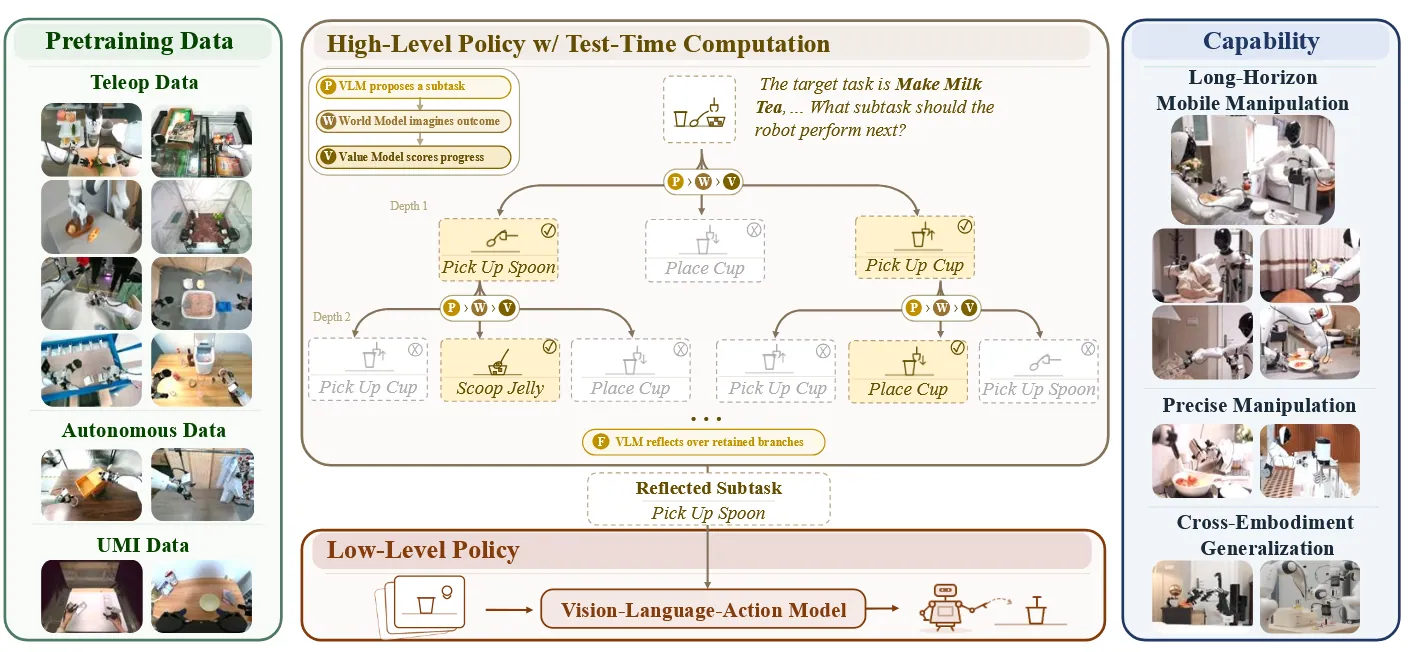
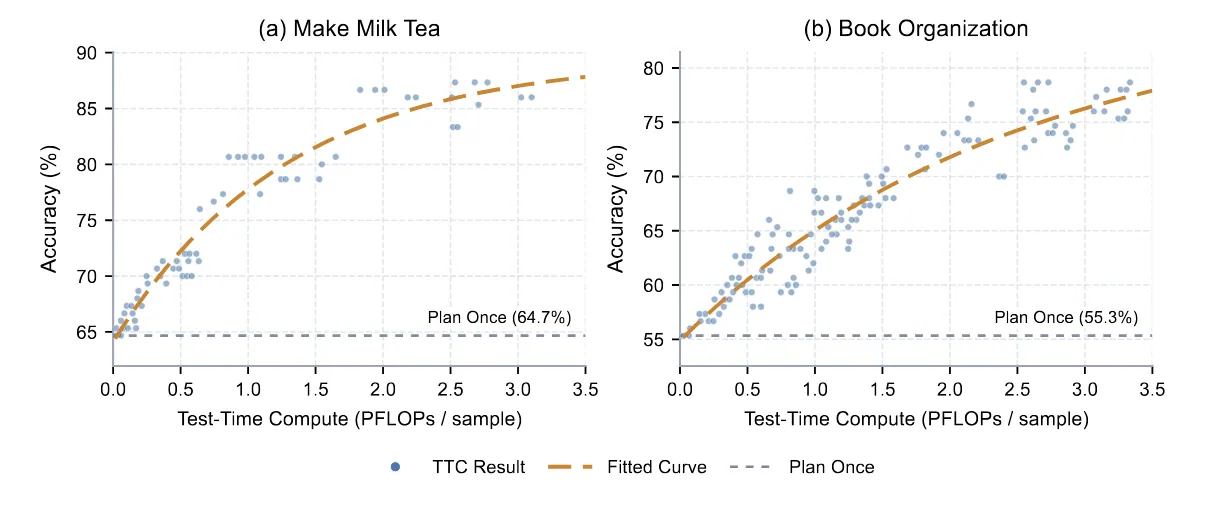
公开摘要中,-VLA 使用 40,115 小时异构真实世界数据训练。它强调高层策略可以在难决策上分配更多 test-time computation,提高下一子任务预测准确率,并转化为长程闭环任务成功率。相关实验也展示了它在真实长程任务上的 scaling law:更多计算预算可以带来更好的高层决策。
-VLA 说明,Memory+VLA 不只是“多给模型看历史”。当任务拉长后,记忆会进入规划、搜索、世界模型和 value model,形成一套上层决策系统。
一个统一工程视角:Memory+VLA 的四层接口
从工程角度看,Memory+VLA 可以分成四个层次。
第一层是 memory 存储层。它决定保存什么。可以按 timeline 顺序保存文字、图片、视频、hidden state、KV cache、action embedding 或 fast weight state。
第二层是 memory 检索层。它决定取什么。策略可以是 window context、固定间隔、固定位置、query-key 匹配、事件触发、阶段触发、world-model guided search。
第三层是 memory 处理层。它决定怎么把取出的 memory 送进模型。可以直接拼输入,可以插入 cache,可以变成 latent token,可以进入 cross-attention,也可以更新 fast weight。
第四层是 memory 更新层。它决定一次 VLA 推理结束后如何写回 memory。更新可以是追加新帧、合并相似记忆、替换旧 memory、更新文本摘要、更新 fast weight、更新任务阶段状态。
这个抽象比论文分类更适合落地,因为不同论文的方法可以拆成组件重新组合。比如 KEMO 的事件触发关键帧可以作为检索层策略;LaMem-VLA 的短期/长期 latent memory 可以作为存储和处理层设计;RoboTTT 的 fast weight 可以作为处理和更新层的一种实现;MEM 的文本长程记忆和视频短程记忆可以作为存储层的多模态策略;-VLA 的 world-model search 可以作为高层检索和规划策略。
一个自然的用户接口设想,是用 YAML 文件定义 memory 的存储、提取、插入模态和数量。这个方向很合理。未来的 Memory+VLA 引擎不应该把 memory 策略写死在模型里,而应该像推理框架配置 KV cache、batching、quantization 一样配置 memory。
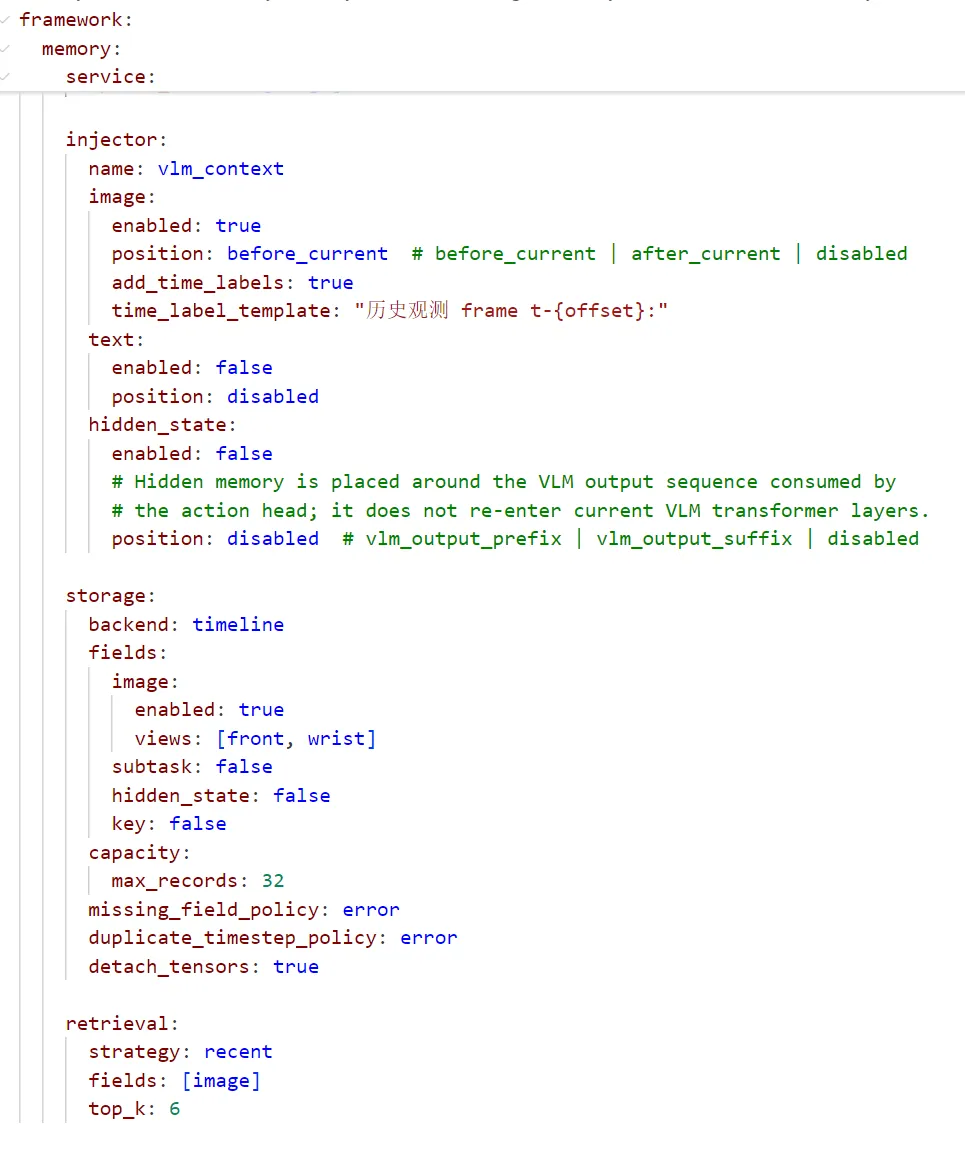
一个可能的配置可以长这样:
memory: storage: short_term: modality: [image_embedding, action] capacity: 16 update: sliding_window episodic: modality: [keyframe, text_summary] capacity: 64 update: event_triggered latent: modality: fast_weight update: test_time_training
retrieval: short_term: method: latest count: 4 episodic: method: query_key query: current_image_instruction count: 8
injection: visual_memory: cross_attention text_memory: prompt_prefix latent_memory: ttt_layer
metrics: - success_rate - subtask_completion - step_latency - retrieval_latency - encoding_latency - gpu_peak_memory真正有用的框架还需要评估维度。需要同时记录 SR、subtask completion、每 step 延迟、memory 检索延迟、memory 编码延迟、训练效率、GPU peak memory、CPU/GPU 传输量。这些指标很关键,因为 Memory+VLA 的工程瓶颈往往不是“成功率是否提升”,而是“提升的成功率是否值得这份延迟、显存和系统复杂度”。
把这个接口落到真实系统里,还需要把一次控制循环拆成更细的执行时序。一个典型周期可以写成五步:先从相机和机器人状态读取 observation,再根据当前 instruction 和阶段状态生成 memory query,然后从短期窗口、episodic bank、latent state 或上层文本记忆里取出候选,再把这些候选转换成模型能消费的 token、cache、prompt 或 fast weight,最后执行动作并把新的 observation、action、阶段判断写回 memory。
这个时序里最容易被低估的是“更新”。很多论文强调 retrieval,但机器人闭环里 memory 写入同样关键。如果写入太频繁,memory bank 会被重复帧淹没;如果写入太保守,关键事件会漏掉;如果写入只看视觉相似度,可能把外观相近但语义不同的阶段合并;如果只看语言摘要,又会丢掉空间细节。因此一个工程化 Memory+VLA 系统最好同时提供四类写入触发器:固定时间间隔、运动事件触发、视觉变化触发、子任务完成触发。KEMO 更接近运动事件触发,LaMem-VLA 更接近相似度压缩和 latent consolidation,MEM / Mem-0 更接近子任务完成触发。
另一个必要设计是异步化。低层控制频率可能是 10Hz、20Hz 甚至更高,而检索、视频编码、文本摘要、world-model rollout 不一定能在每个控制步内完成。更合理的实现是:低层 policy 每步读取已经准备好的热记忆;后台线程持续编码新帧、更新 keyframe、维护文本摘要;高层 policy 只在阶段切换或置信度不足时运行。DREAM-ZERO 的异步闭环执行、MEM 的高低层频率分离、-VLA 的按需搜索,本质上都在把 memory 相关计算从每步同步阻塞路径里移出去。
逐篇方法对照:每篇论文到底解决了哪个瓶颈
如果只按四类 memory 记忆,容易忽略各篇方法真正解决的问题。把它们放在同一张表里,会更清楚地看到技术路线的演进。
| 方法 | 主要记忆对象 | 关键机制 | 解决的瓶颈 | 仍然存在的问题 |
|---|---|---|---|---|
| DREAM-ZERO | 最近视频帧、动作上下文、DiT KV cache | World Action Model、异步闭环、DiT caching、DreamZero-Flash | 把短期历史和世界动态合并,提升零样本策略能力 | 视频扩散模型重,实时性依赖大量系统优化 |
| KEMO | 任务过程中的关键帧 | 关节速度事件触发、DINOv2 去重、cross-attention 融合 | 避免 sliding window 丢失长程关键事件 | keyframe 选择错误会导致检索遗漏 |
| LaMem-VLA | 短期 visual latent、长期 action latent | SE-bottleneck、query-key retrieval、memory weaving、相邻记忆合并 | 把历史经验变成 VLA 可直接消费的 latent token | memory 表示和压缩策略会影响可解释性与泛化 |
| RoboTTT | 测试时更新的 fast weight | TTT 层、tanh gating、Sequence Action Forcing、TBPTT | 把上下文扩展到数千时间步且不显式读取全部历史 | fast weight 难解释,训练和部署状态管理复杂 |
| MEM | 短程视频记忆、长程文本记忆 | 高低层策略、时空 attention 解耦、token pruning、KV cache | 同时处理低层细节和长程任务进度 | 系统链路长,高层错误会传导到低层 |
| RMBench / Mem-0 | 子任务 keyframe、首帧、最近帧 | 记忆依赖任务集、上层规划、下层执行、子任务结束判断 | 把“模型是否真的需要记忆”变成可测问题 | benchmark 覆盖范围仍需扩展到更多真实任务 |
| -VLA | 文本化执行记忆、未来子任务候选 | 高层 world-model rollout、beam search、value model 打分 | 在关键高层决策上增加测试时计算 | 搜索增加延迟,world model 错误会影响规划 |
从这张表可以看到,Memory+VLA 的技术路线并不是从简单到复杂单线演进,而是在四个瓶颈上并行推进。第一个瓶颈是“当前观测不完整”,用短期窗口和视频记忆解决。第二个瓶颈是“历史太长不能全读”,用关键帧、latent memory 和检索解决。第三个瓶颈是“显式历史太贵”,用 fast weight 和 latent state 把历史压进状态。第四个瓶颈是“长程任务需要规划”,用高低层分离、文本记忆、world model 和搜索解决。
评测与部署:Memory+VLA 不能只看成功率
评价一个 Memory+VLA 系统,至少要分三层。
第一层是任务效果。最基础的是 success rate,但长程任务里仅有 success rate 不够。还要看 subtask completion,因为很多方法可能前几个阶段成功,最后失败;也要看错误恢复率,因为 memory 的价值经常体现在失败后能否回到正确阶段;还要看跨场景泛化,因为 keyframe 和 retrieval 策略可能对特定环境过拟合。
第二层是记忆质量。对于 retrieval memory,要看检索召回率:关键历史是否被取出;还要看检索污染率:无关历史是否被误取。对于 latent / fast weight memory,要看长期保持能力和遗忘曲线。对于 hierarchical memory,要看上层阶段判断是否准确,子任务切换是否提前或滞后。RMBench 的 / 分类其实就是在逼迫模型暴露这些能力差异。
第三层是系统成本。Memory 编码延迟、检索延迟、每 step 控制延迟、GPU peak memory、CPU/GPU 数据传输、后台线程占用、训练峰值显存都应该单独统计。一个方法如果让成功率提高 5%,但把每步延迟从 100ms 提到 800ms,在真实机器人上可能并不可用。反过来,一个简单的 sliding window 如果在目标任务上已经足够稳定,就没有必要引入复杂的 world-model search。
部署时可以按热、温、冷三层管理 memory。热记忆放在 GPU 上,包含最近窗口、当前子任务 keyframe、低层 policy 必须立即读取的 KV cache。温记忆放在 CPU 内存里,包含 episode 内较旧的 keyframe、压缩 visual embedding、action embedding 和文本摘要。冷记忆放在磁盘或数据库里,包含跨 episode 的示范、失败案例和长期经验。控制循环只读取热记忆,后台进程负责从温/冷记忆中异步召回并预热到 GPU。
从研究到实现:一个可落地的 Memory+VLA 引擎长什么样
如果要把这些方法做成统一推理引擎,核心不是复现某一篇论文,而是把 memory 做成可插拔组件。主框架可以参考 StarVLA 这类 VLA 训练/推理框架,评测可以接入 vla-evaluation-harness,端侧推理和机器人执行可以结合 Jetson-PI、FlashRT 或 LeRobot 生态。
接口上,用户不应该直接改模型代码,而是声明四件事:保存什么、什么时候保存、怎么检索、怎么注入。比如短任务可以配置 sliding_window(image, action, count=4);多阶段任务可以配置 episodic_keyframe(trigger=joint_velocity_drop, encoder=dinov2, topk=8);长程任务可以配置 semantic_summary(update_on=subtask_end);需要测试时适应的任务再打开 fast_weight(update=ttt)。这些策略在同一个 episode 中可以共存,由 scheduler 决定哪些每步运行、哪些低频运行、哪些异步运行。
训练上,统一引擎要支持三类数据。第一类是普通机器人轨迹,用来训练基础 VLA。第二类是带阶段标注或可自动切分的长程轨迹,用来训练 keyframe、subtask detector 和 high-level policy。第三类是专门的 memory benchmark,如 RMBench、RoboTwin 2.0、LIBERO 长程变体和 CALVIN,用来检查模型是否真的使用历史。没有第三类评测,系统可能只是把 memory 做成装饰。
最终贡献不应该只是“加一个 memory 模块”,而应该是:同一个 VLA backbone 下,系统性比较 sliding window、episodic retrieval、latent memory、hierarchical memory 在不同任务长度、不同遮挡程度、不同部署预算下的效果和成本;给出动态 memory 策略,例如短任务自动退化为窗口记忆,长任务自动打开高层语义记忆,置信度不足时才触发搜索或额外检索。
如何选择记忆机制:任务长度、可观测性和部署预算
把这些工作放在一起,可以得到一个实用选择表。
| 场景 | 更适合的记忆模式 | 原因 |
|---|---|---|
| 短程遮挡、局部状态变化 | Sliding window、短期 visual memory | 当前动作主要缺最近几帧信息,窗口足够解决 |
| 多阶段操作、关键事件稀疏 | Episodic keyframe retrieval | 需要保存阶段转折点,不能让关键帧滑出窗口 |
| 人类视频示范、长上下文技能适应 | Fast weight / TTT、world-action model | 需要把测试时示范压进策略状态或世界动态 |
| 十分钟级长程任务 | Hierarchical persistent memory | 需要上层记录进度、下层执行局部控制 |
| Benchmark 和模型诊断 | RMBench / 显式 memory ablation | 需要确认模型是否真的依赖历史,而不是当前图像足够 |
| 端侧或实时部署 | 窗口记忆、压缩 latent memory、低频高层策略 | 检索和编码延迟必须受控 |
这里有一个容易被忽视的点:Memory+VLA 的收益和成本不在同一层出现。收益通常体现在任务成功率、阶段完成率和错误恢复能力上;成本却体现在 token 数、检索耗时、视频编码耗时、GPU memory、CPU/GPU 数据搬运、训练稳定性上。一个方法在论文 benchmark 上表现好,不代表它能直接部署到真实机器人;一个方法在真实机器人上能跑,不代表它能扩展到更多任务和更多机器人形态。
因此,设计 Memory+VLA 时不应该先问“哪篇论文最强”,而应该先问五个问题。
第一,任务需要多长时间的历史?如果只需要 2 秒内的信息,sliding window 足够。第二,关键历史是否稀疏?如果关键节点很少,retrieval memory 更合适。第三,历史信息是否能用文字表达?如果可以,长程 text memory 比保留所有视频便宜。第四,模型是否允许测试时更新状态?如果允许,fast weight 或 recurrent memory 可能扩展更长上下文。第五,部署预算有多紧?如果控制频率必须很高,上层 memory 应低频运行,下层 policy 需要轻量化。
对系统和硬件的影响:Memory+VLA 会把瓶颈从模型推到运行时
Memory+VLA 的系统问题比普通 VLA 更复杂。
首先是视觉 token 爆炸。多帧、多视角、长视频都会增加 token 数。MEM 通过时空 attention 解耦和 KV cache 复用降低成本,LaMem-VLA 通过 bottleneck 和 latent token 压缩历史,KEMO 通过关键帧选择减少输入帧数。它们都在回答同一个问题:历史不能原样全塞,必须先压缩、筛选或缓存。
其次是检索延迟。LLM 的 RAG 检索可以花几十毫秒甚至更久,机器人控制不一定等得起。每一步都做 DINOv2 embedding、query-key 搜索、transformer condenser,可能会把高频控制拖慢。实际部署时,需要把记忆更新和检索拆到异步线程,或让高层 memory 低频运行。
第三是 CPU/GPU 数据搬运。如果 memory bank 放在 CPU,检索后再拷贝到 GPU,会引入额外延迟。如果全部放在 GPU,显存占用又会上升。未来 Memory+VLA 引擎可能需要像 LLM 推理框架管理 KV cache 一样,管理多级 memory:GPU 热记忆、CPU warm memory、磁盘冷记忆。
第四是训练稳定性。KEMO 给 memory 融合分支加 0 初始化权重,RoboTTT 用 tanh gating 和 TBPTT,LaMem-VLA 用 condenser 和 weaver 控制 latent token 形态。这些设计都说明,memory 不是简单拼接历史。历史信息一旦以错误方式进入模型,会让训练 loss、动作分布和闭环稳定性变差。
第五是评估闭环。离线 action prediction loss 不能完全说明 memory 是否有用。真正重要的是闭环 success rate、subtask completion、错误恢复、扰动鲁棒性和长程任务完成时间。RMBench 这类 benchmark 的意义也在这里。
结论:Memory+VLA 的本质是把机器人从“反应式策略”推向“带状态的执行系统”
VLA 最初的吸引力在于端到端:看图、读指令、出动作。但真实机器人任务要求模型带着历史行动。Memory+VLA 的发展说明,端到端并不等于无状态。恰恰相反,越是长程、复杂、真实的机器人任务,越需要把状态管理纳入模型和系统设计。
Sliding-Window Memory 提供最简单的短期上下文,适合近期遮挡和局部状态。Episodic Retrieval Memory 选择关键帧和关键事件,让模型不必读取完整历史。Latent State / Fast Weight Memory 把历史压进可更新状态,把上下文长度扩展到数千步。Hierarchical Persistent Memory 把任务进度和低层控制分离,让上层策略维护语义记忆、下层策略执行动作。
这四类方法不是互斥路线。未来更可能出现的是混合系统:下层保留短期视觉窗口,中层维护关键帧 memory bank,上层保存文本化任务进度,模型内部还有 fast weight 或 recurrent state。工程上再用统一配置描述 memory 的存储、检索、插入和更新策略。
机器人要在真实世界里完成任务,就必须知道自己刚刚做过什么、为什么做到这里、下一步可能带来什么后果。Memory+VLA 的意义正在于此:它把 VLA 从单步反应式策略,推向一个带时间、带状态、带执行进度的具身智能系统。
参考资料
- World Action Models are Zero-shot Policies(DREAM-ZERO)
- KEMO: Event-Driven Keyframe Memory for Long-Horizon Robot Manipulation with VLA Policies
- Dual Latent Memory in Vision-Language-Action Models for Robotic Manipulation(LaMem-VLA)
- RoboTTT: Context Scaling for Robot Policies
- MEM: Multi-Scale Embodied Memory for Vision Language Action Models
- RMBench: Memory-Dependent Robotic Manipulation Benchmark with Insights into Policy Design
- -VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation
- MemoryVLA: Perceptual-Cognitive Memory in Vision-Language-Action Models for Robotic Manipulation
- MemoryVLA++: Temporal Modeling via Memory and Imagination in Vision-Language-Action Models
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


