


Hyperparameter Scaling Laws Across MoE Sparsity:稀疏 MoE 的激活比率为什么必须进缩放律
蚂蚁 Ling Team 的论文 Hyperparameter Scaling Laws Across MoE Sparsity 于 2026 年 9 月 8 日提交到 arXiv,研究的问题很窄也很关键:当 MoE 模型越来越稀疏时,传统只看参数量、训练 token 数或 FLOPs 的超参数缩放律为什么会失效,最佳学习率和 batch size 应该怎样随稀疏度迁移。
这篇工作的技术主线可以浓缩成一句话:MoE 的稀疏度不是一个可以被“总参数量”或“激活参数量”吸收掉的附属属性,而是一个独立缩放维度。论文把激活比率定义为 ,并提出用 预测最佳学习率,用 预测最佳 batch size。这里 是每个 token 激活的专家数, 是总专家数, 是训练计算量, 是训练 token 数。
虽然这是一篇面向训练超参数选择的论文,它对推理侧同样有价值:推理系统经常把 MoE 看成“每 token 激活多少专家”的运行时问题,例如专家并行、专家缓存、dispatch/combine 通信和负载均衡;而这篇论文提醒我们,模型在训练阶段形成的稀疏行为本身就会随 改变。也就是说,一个 的超稀疏 MoE 不是“更大的专家池加同样的 recipe”那么简单,它的路由、专家专化和稳定性都来自一套不同的尺度规律。MoE 推理相关的运行时问题,可与站内 DeepSeekMoE 完全拆解 和 DeepEP 完全拆解 对照阅读。
问题从哪里来
MoE 的基本承诺是“总容量变大,单 token 计算不等比例变大”。在一个 top-k MoE 层里,路由器从 个专家中选出 个专家,只有被选中的专家参与当前 token 的计算。于是模型有两个参数尺度:
- 总参数量 :所有专家和共享模块加起来的容量。
- 激活参数量 :一个 token 实际经过的那部分参数。
这两个尺度在稠密 Transformer 中基本是一回事:所有 token 经过同一套 FFN 参数。但在 MoE 中,它们被路由拆开了。一个模型可以有很大的 ,却保持很小的 ;也可以保持相同的 ,只是把专家池拆得更细、更稀疏。
传统缩放律常常试图回答两类问题:
- 给定更大的模型和数据,最佳学习率 怎么变。
- 给定更长的训练 token 数,最佳 batch size 怎么变。
在稠密模型里,把模型参数量 、数据量 、计算量 放进幂律关系通常已经能解释相当多现象。MoE 的麻烦在于:相同 、相同 、相同 下,改变专家池稀疏度以后,曲线最低点仍会移动。
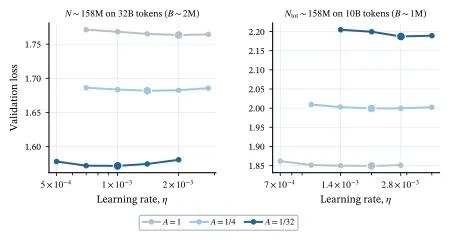
图源:Hyperparameter Scaling Laws Across MoE Sparsity Figure 2(a)。左图匹配激活参数量 ,右图匹配总参数量 。如果“参数量”已经解释了学习率最优点,那么不同颜色的曲线最低点应该基本重合;实际结果是,激活比率 变小以后,验证损失曲线的最佳学习率位置仍然发生偏移。
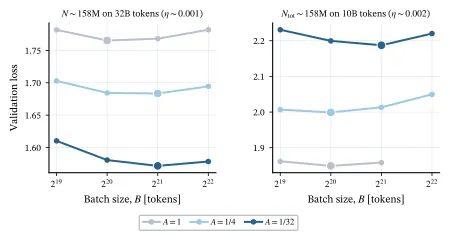
图源:Hyperparameter Scaling Laws Across MoE Sparsity Figure 2(b)。这张图对应 batch size。即使固定数据量 、激活参数量 和训练计算量 ,最佳 batch size 仍会随 改变。这里的 是每 token 的解析 FLOPs,论文没有直接使用常见近似 ,而是按具体架构计算非 embedding FLOPs/token。
这两张图给出的结论很硬:无论用激活参数量还是总参数量对齐,超稀疏 MoE 的最佳超参数都会移动。稀疏度不是噪声项,而是一个必须被建模的变量。
论文怎样定义变量
论文先把问题写成一个标准的最优化形式。设:
- :每个 token 激活的非 embedding 参数量。
- :总非 embedding 参数量。
- :训练 token 数。
- :每 token 的解析非 embedding FLOPs。
- :训练计算量。
- :每个 token 激活的专家数。
- :总专家数。
激活比率定义为:
越小,模型越稀疏。例如 top-2 路由下,如果总专家数是 32,则 ;如果总专家数扩大到 128,则 。注意 不是“激活参数量占总参数量”的精确同义词,但在固定 top-k 和相似专家结构下,它是描述专家稀疏度的直接变量。
给定某个模型配置和训练设置,论文把验证交叉熵写成:
这里 是峰值学习率, 是每次优化器更新处理的全局 token batch size。于是最佳学习率和最佳 batch size 是二维搜索空间中的最低点:
实际实验不会得到连续空间上的精确最低点,只能在有限网格上搜索。论文因此使用两个口径:一个是网格观察到的最优点,另一个是近似最优集合,也就是验证误差不超过最小值 的候选点。这样做能降低单个 noisy grid point 对拟合的影响。
先分清学习率和 batch size 各自看什么
论文没有一上来就把所有变量塞进一个大公式,而是先做了一个很重要的拆分:在固定稀疏度 的前提下,学习率和 batch size 分别由什么变量组织得最好。
结论是:
- 最佳学习率 主要随训练计算量 呈幂律变化。
- 最佳 batch size 主要随训练 token 数 呈幂律变化。
这个拆分看似细节,其实是全文的骨架。如果学习率和 batch size 都用同一个变量,比如都用 或都用 ,就会把两个不同物理含义混在一起。
学习率控制的是每次参数更新的步长。论文发现,在固定 时,即使 分配不同,也就是“更大模型训练较少 token”和“较小模型训练更多 token”的组合不同,最佳学习率变化并不大。这说明 对学习率的组织能力比单独的 或 更强。
batch size 控制的是一次优化器更新看到多少 token。论文发现, 更直接跟训练 horizon 绑定:训练 token 数越多,最佳全局 batch 往往越大。直觉上,固定总 token 数 时,增大 会减少优化器更新步数 ;因此 batch size 的选择本质上是在“每步梯度噪声更小”和“总更新次数更少”之间平衡。
把这个固定稀疏度下的基础幂律写出来,就是:
其中 是某个最佳超参数, 是对应的尺度变量, 是前因子, 是幂律指数。取对数后:
这也是为什么论文里大量图都在 log-log 空间看线性关系:如果幂律成立,对数坐标下就是一条直线。
稀疏度如何进入公式
有了固定稀疏度下的基础幂律,下一步是看 怎么改变这些曲线。论文观察到两个方向相反的趋势:
- 越小,最佳学习率越低。
- 越小,最佳 batch size 越大。
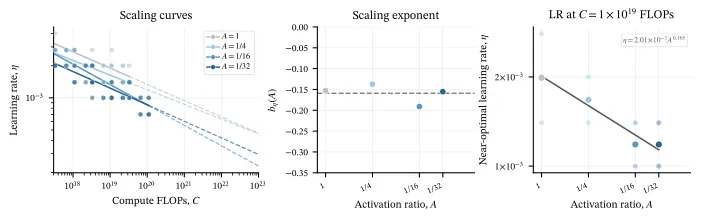
图源:Hyperparameter Scaling Laws Across MoE Sparsity Figure 5。左侧是在四个激活比率下分别拟合 与 的幂律关系;中间显示不同 下的指数波动不大;右侧在匹配 FLOPs 的切片上看 与 的关系。重点不在某一个点,而在曲线整体随稀疏度改变前因子。
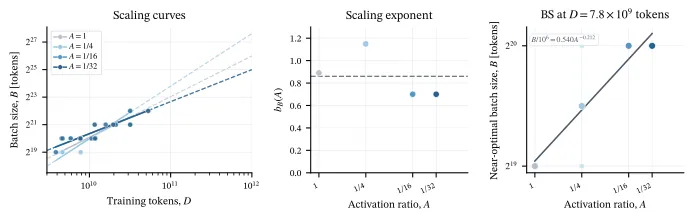
图源:Hyperparameter Scaling Laws Across MoE Sparsity Figure 6。batch size 的趋势与学习率相反:更小的 倾向于更大的 。中间图同样说明,基础指数在不同稀疏度下没有剧烈变化,因此把 放进乘性前因子是一个简洁模型。
论文最终采用统一形式:
对数形式是:
这两个式子里, 是常数前因子, 是基础尺度变量的指数, 是激活比率的指数。对应到两个超参数,就是:
论文拟合得到的系数为:
| 超参数 | 输入变量 | |||
|---|---|---|---|---|
| 学习率 | 0.8343 | -0.1385 | 0.1361 | |
| batch size | 6.4765 | 0.5181 | -0.0841 |
这里最值得看的不是 的绝对数值,因为它依赖 、、 的单位定义;真正有解释力的是指数符号:
- :训练计算量越大,最佳学习率越低。
- :训练 token 数越多,最佳 batch size 越大。
- :因为 ,当 变小, 也变小,所以最佳学习率下降。
- :当 变小, 变大,所以最佳 batch size 上升。
换句话说,超稀疏 MoE 的 recipe 不是“沿用 dense 或普通 MoE 的学习率,再把专家数加大”。如果激活比率一路降到 ,学习率和 batch size 都应该系统性迁移。
为什么更稀疏需要更大 batch
论文附录给了一个简单的梯度噪声模型,用来解释 和 的符号。这个解释很有用,因为它把“稀疏度”从架构词汇翻译成了优化噪声。
考虑一个 MoE 层,全局 token batch size 是 。在负载均衡较好的情况下,每个专家平均收到的 token 数大约是:
如果 ,一个专家每步平均看到 个 token;如果 ,它每步只看到 个 token。全局 batch 没变,但单个专家的有效 batch 被稀疏路由切薄了。
在独立样本近似下,某个专家梯度估计的方差与有效样本数成反比:
是第 个专家的梯度估计。这个式子的含义很直接: 越小,单专家看到的样本越少,专家侧梯度噪声越大;要降低噪声,就要增大全局 batch 。
但 不能无限增大。固定训练 token 数 时,优化器更新次数约为 。batch 越大,更新越少,可能带来“步数不够”的惩罚。同时,模型里还有共享参数,例如 attention、router、共享 embedding 或共享专家,它们接收的是全局 batch,不会像单个 routed expert 那样被 稀释。
论文把这个权衡写成一个局部近似:
三个项分别表示:
- :batch 变大后,更新步数减少带来的损失。
- :共享参数的梯度噪声,随全局 batch 增大而下降。
- :专家参数的梯度噪声,取决于单专家有效 batch 。
对 最小化后,可以得到:
这个式子解释了两个现象。第一, 的指数 不直接依赖 ,这对应论文主模型里 batch size 对 共享一个基础指数。第二, 越小,括号中的 越大,因此 上升。
但 不会按 那么激烈地上升。原因是全局 batch 增大也会减少更新步数,而且共享参数并不被稀疏路由切薄。论文把这个局部弹性写成:
这正好对应拟合到的 :方向是负的,但幅度不大。更稀疏确实需要更大 batch,但不是简单保持 完全不变。
为什么更稀疏需要更低学习率
学习率的直觉可以从同一个有效专家 batch 出发。专家侧一次更新中的噪声影响可以粗略写成:
表示专家侧由优化步长和样本噪声共同诱发的扰动强度。 越小,如果还用同样的 ,专家参数每次更新面对的噪声就更大。
论文用一个指数 概括优化器和共享参数的缓冲效应:
由于 随 变小而增大,但增大幅度不足以完全抵消 变小, 仍然会下降。因此最佳学习率也下降。局部指数写成:
这就是 的来源。因为 ,正指数意味着 越小, 越小。
这套解释没有声称从第一性原理推出具体系数。它只说明方向为什么合理:稀疏路由让专家看到的样本变少,专家侧梯度噪声上升;更大的 batch 只能部分补偿,因此学习率也要下降。
实验规模与拟合协议
论文的实证规模很大:1,800 次预训练实验,覆盖六个激活参数量级,主实验激活比率为 ,最高到 6B 总非 embedding 参数,合计处理约 20 万亿 token,成本约 200,000 等效 H800 GPU 小时。
实验控制项包括:
- 使用相同混合预训练数据,包含网页、书籍和代码。
- 序列长度为 4,096。
- 主干是 hybrid linear-attention/MLA 架构。
- 优化器使用 Muon。
- MoE routing 使用 sigmoid routing 和 auxiliary-loss-free load balancing。
- 训练 schedule 是 WSD:1% warmup,稳定阶段保持峰值学习率,最后 10% 指数衰减。
主网格搜索的学习率为:
主网格搜索的 batch size 为:
held-out 配置单独使用更适合超稀疏大模型的搜索范围:
拟合时,论文只用 的 development data。最后的 目标在模型选择、交叉验证和系数拟合阶段完全冻结不用,直到预测坐标固定后才看损失面。
这种协议很重要。否则如果先看 的损失面,再调整公式或系数,就很容易把外推验证变成事后解释。
为什么选择乘性形式
论文比较了四类候选公式:
| 候选族 | 形式 | 参数数 | 解释 |
|---|---|---|---|
| scale only | 2 | 不看稀疏度,只看基础尺度变量 | |
| additive | 4 | 把尺度和稀疏度做加法组合 | |
| log interaction | 4 | 允许基础指数随 改变 | |
| multiplicative | 3 | 尺度幂律乘上稀疏度前因子 |
评估方法有两个:
- LOAO:leave-one-activation-ratio-out,留出一个激活比率,考察能否预测未见过的 。
- LONO:leave-one-active-scale-out,留出一个激活参数量级,考察能否预测未见过的规模。
误差使用绝对 base-2 log-ratio,也就是预测值和观测最优值相差多少个“翻倍单位”。例如误差 0.5 表示约在 倍范围内。
论文表 3 的核心结果是:乘性模型在四个误差指标中有三个最低;log interaction 在 LR 的 LOAO 上略低,0.150 对 0.153,但它多一个参数。作者最终选择乘性形式,不是因为它在每个小指标上都压倒性胜出,而是因为它以更少参数给出相近或更好的预测,并且解释最清楚。
这个取舍是合理的。缩放律最怕公式过度灵活:拟合时很好看,外推时很脆。乘性形式的含义很明确:基础尺度变量决定主趋势,稀疏度改变前因子。
held-out 外推:1/64 激活比率能不能预测
论文最关键的验证是一个 held-out 超稀疏目标:
- 激活参数量 。
- 总参数量 。
- 激活比率 。
- 训练 token 数 。
- 训练计算量 FLOPs。
这里 是拟合集中见过的最大边界尺度,但 、、 都超出拟合范围,因此它是一个联合外推点。
论文给出的预测为:
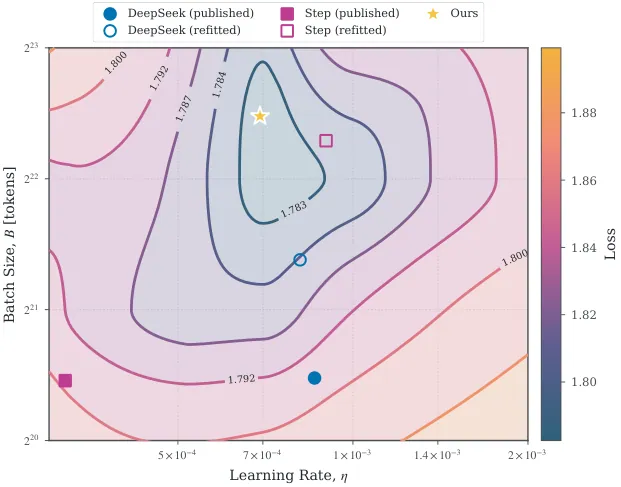
图源:Hyperparameter Scaling Laws Across MoE Sparsity Figure 8(a)。星号是论文提出的乘性缩放律预测点,其他标记是对比缩放律的预测。训练损失面显示,预测点落在低损失区域。
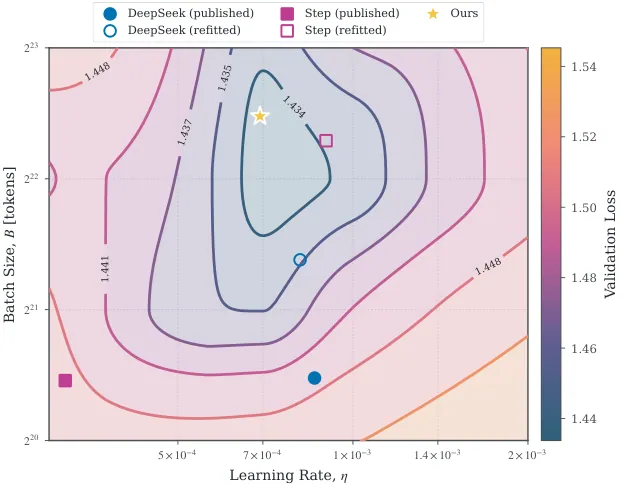
图源:Hyperparameter Scaling Laws Across MoE Sparsity Figure 8(b)。验证损失面比训练损失面更能说明泛化。论文没有声称单点外推足以证明公式普适,但这个点至少说明,在 的超稀疏配置上,显式包含 的公式没有偏离 near-optimal plateau。
表 4 中,若直接使用 published DeepSeek Law,预测为学习率 、batch size ,相对本文预测点的训练损失 gap 为 7.22‰;published Step Law 预测学习率 、batch size ,gap 为 9.02‰。把这些 baseline 用同一批样本重新拟合以后差距会缩小,但本文公式仍给出更接近 held-out loss surface 的预测坐标。
这里要避免误读:7.22‰ 或 9.02‰ 不是“模型能力提升多少”的结论,而是 held-out 搜索面上不同预测点对应的训练损失差。它的意义在于比较超参数预测是否落在好区域,而不是宣称某个模型训练 recipe 最终能力提升了几个百分点。
专家粒度不是同一件事
论文还做了一个很有意思的控制实验:把“激活比率”与“专家粒度”拆开。
参考配置是:
它的激活比率是 。其中 是专家宽度。
专家粒度控制配置是:
这个配置把激活专家数和总专家数都翻倍,同时把专家宽度减半,因此激活比率仍是 ,总容量和激活容量也尽量匹配。若最佳超参数主要由“专家个数”本身决定,那么这个配置应当明显移动;但论文发现 near-optimal 区域和最优位置相近。
稀疏度控制配置是:
这个配置保持总专家数和专家宽度,但把激活专家数从 2 提到 4,因此 从 变成 。这时最优学习率和 batch size 都发生方向符合预测的移动。
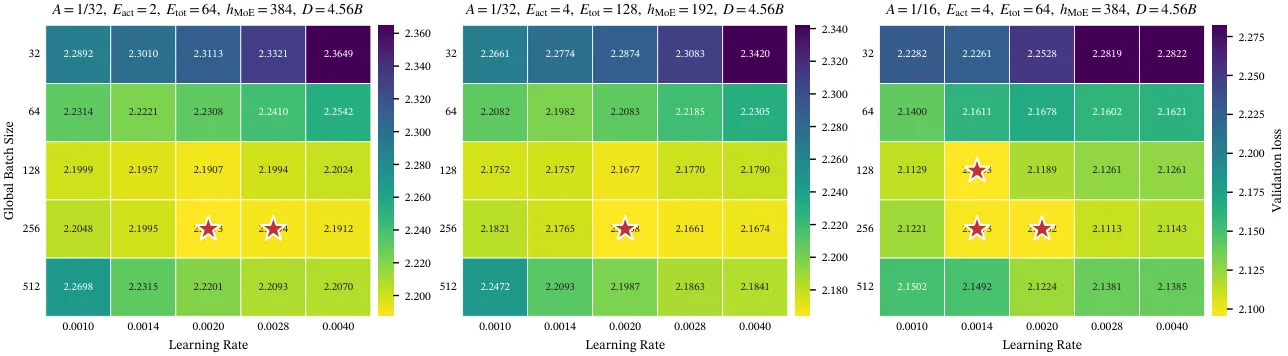
图源:Hyperparameter Scaling Laws Across MoE Sparsity Figure 9。左图是参考配置,中图保持 但改变专家粒度,右图改变 到 。结果支持一个更细的判断:影响超参数迁移的核心变量不是“专家绝对数量”或“专家宽度”单独某一个,而是激活比率这个稀疏轴。
这对推理系统也有启发。工程上常常会讨论“专家数更多是否更难调度”“专家更细是否更利于缓存命中”。这些问题当然重要,但从模型尺度规律看,不能只盯专家数量。两个 MoE 可能专家数不同、专家宽度不同,但只要 和容量关系相近,超参数行为可能接近;反过来,总专家数不变,只改变 top-k 导致 变化,也可能改变模型形成的优化状态。
与已有缩放律的差异
论文把自己的公式放在几条已有路线旁边比较:
| 方法 | 学习率变量 | batch size 变量 |
|---|---|---|
| DeepSeek Law | ||
| Microsoft Law | 未提供 | |
| Joint MoE Scaling Law | 未提供 | |
| Step Law | ||
| 本文 |
这张比较表的价值不在于判定谁“错”,而在于说明这些方法回答的问题不同。DeepSeek Law 把学习率和 batch size 都组织到计算量 上;Step Law 对 batch size 使用 ,但学习率使用总参数量和数据量;Joint MoE Scaling Law 引入专家数量,但不是连续建模激活比率如何移动最佳超参数。
本文的贡献是把两个观察合到一起:
- 学习率和 batch size 的基础尺度变量不同,分别是 和 。
- MoE 稀疏度会作为额外乘性因子改变前因子。
所以公式很短,但拆分逻辑很细:
这比“MoE 比 dense 需要更大 batch”更精确。后者只是经验判断;前者给出在不同 下怎样迁移的可计算关系。
局限性
这篇论文的局限也很清楚。
第一,实验来自单一主干族、单一数据混合、单一优化器和一套路由设置。主干是 hybrid linear-attention/MLA,优化器是 Muon,路由是 sigmoid routing with auxiliary-loss-free load balancing。公式能否迁移到标准 softmax top-k MoE、不同归一化、不同优化器、不同数据配比,还需要更多验证。
第二,外推验证只有一个 held-out 点。这个点设计得很有价值,因为它同时超出了 、、 的拟合范围;但单点不能分辨到底是沿 外推稳,还是沿 和 外推稳,也不能给出完整不确定性估计。
第三,超参数最优性用验证 loss 定义。验证 loss 对训练 recipe 很敏感,但它不等价于下游能力、推理稳定性或工具调用表现。对于 MoE 模型,特别是面向长上下文、代码、agent 的模型,能力曲线可能有自己的尺度规律。
第四,论文没有把推理系统成本写进目标函数。 影响的不只是优化噪声,也影响推理时的专家并行通信、专家缓存工作集、prefill/decode 的专家分布、dispatch/combine 负载。一个面向部署的 MoE scaling law 可能需要把训练 loss、推理吞吐、显存容量和通信代价放进同一个多目标框架。
对 MoE 系统的启发
这篇文章最值得带走的不是某个系数,而是一个建模习惯:MoE 的稀疏度应该被当成独立坐标。
在推理系统里,这个习惯同样重要。比如专家并行调度不能只看总专家数,还要看每 token 激活比例;专家缓存不能只看模型文件大小,还要看路由工作集随上下文和任务如何变化;通信优化不能只看单个 expert kernel 的吞吐,还要看 变化后 dispatch payload、combine payload 和负载均衡如何重排。
这篇论文给训练超参数提供了一个简洁答案:
更重要的是,它解释了为什么答案应该长这样:固定稀疏度时,学习率看计算量,batch size 看训练 token;跨稀疏度时,激活比率改变专家侧有效样本数,从而改变梯度噪声结构。这个逻辑比“更稀疏所以更难训”更具体,也更容易迁移到 MoE 架构和系统设计里。
对正在研究 MoE 推理的人来说,一个自然的下一步问题是:既然训练阶段的最优超参数必须显式包含 ,那么推理阶段的服务律是否也应该显式包含 ?例如 TTFT、TPOT、专家缓存命中率、跨节点 dispatch 带宽,是否也存在类似 的缩放关系。MoE 进入超稀疏时代后,单独讨论“参数量”已经不够了;激活比率会同时进入训练 recipe、模型行为和推理系统账本。
参考资料
- Hyperparameter Scaling Laws Across MoE Sparsity
- Hyperparameter Scaling Laws Across MoE Sparsity HTML version
- Unified Scaling Laws for Routed Language Models
- Predictable Scale: Part I — Optimal Hyperparameter Scaling Law in Large Language Model Pretraining
- Joint MoE Scaling Laws: Mixture of Experts Can Be Memory Efficient
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- DeepSeek LLM: Scaling Open-Source Language Models with Longtermism
- DeepSeek-V3 Technical Report
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


