


Multi-Agent Memory 完全拆解:把 Agent 记忆当成计算机体系结构问题
多智能体系统里最容易被低估的瓶颈,不是某个 agent 的提示词写得不够漂亮,而是多个 agent 共享、读取、缓存、覆盖同一批上下文时,系统到底有没有一套像样的“记忆架构”。
Zhongming Yu 等人在 2026 年 3 月提交并修订的论文 Multi-Agent Memory from a Computer Architecture Perspective: Visions and Challenges Ahead 把这个问题说得很直接:多智能体记忆不应该只被看成 RAG、向量库、prompt history 或聊天记录管理,而应该被看成一个计算机体系结构问题。传统计算机系统会区分 I/O、cache、main memory,会讨论带宽、延迟、容量、一致性和访问协议;多智能体系统如果要从玩具式 demo 走向可靠服务,也需要类似的分层和协议。
这篇论文只有三页,性质更像研究议程,而不是完整系统论文。它真正有价值的地方,是把一堆原本散落在 agent 框架、长上下文、KV cache 复用、RAG 记忆库里的问题,统一放进“多处理器共享内存”的视角里重新命名。命名一旦准确,工程问题就不再只是“怎么让 agent 记住更多”,而会变成更可落地的几个问题:记忆放在哪一层?谁能读?谁能写?写入什么时候对别的 agent 可见?多个 agent 同时改同一条事实时,系统应该相信谁?
| 目录项 | 内容 |
|---|---|
| 标签 | Multi-Agent、Agent Memory、AI Infra、体系结构、他山之石 |
为什么 agent 的 context 正在变成记忆系统
早期的 LLM agent 可以粗略理解成“一个模型 + 一段 prompt + 几个工具调用”。这类系统的上下文生命周期很短:用户给一个问题,agent 读 prompt,调用工具,把结果塞回上下文,然后生成答案。这里的“记忆”经常只是对话历史,或者从向量库检索出来的一小段文本。
多智能体系统把这个简单模型打碎了。一个复杂任务会被拆给 planner、executor、critic、researcher、coder、verifier 等多个角色;每个角色都有自己的上下文、工具轨迹、局部结论和中间产物。它们之间既要通信,又不能把所有信息都塞进每次消息里。于是 context 不再是一段静态 prompt,而更像一个动态数据系统。
论文把 context 复杂化归纳成几类来源:长上下文任务要求跨很长历史做多跳追踪;多模态任务把图片、视频、图表加入上下文;结构化任务引入 SQL schema、执行轨迹、日志和状态机;交互式环境还会让外部世界状态成为记忆的一部分。这里的关键变化是:agent 不只是在“读资料”,而是在持续读写一个会变化的工作集。
用系统视角看,agent 运行期至少有三类数据:
| 数据类型 | 例子 | 系统风险 |
|---|---|---|
| 输入上下文 | 用户消息、网页、文档、图片、工具返回值 | 体积大、格式杂、进入上下文窗口成本高 |
| 中间状态 | 子任务计划、工具调用轨迹、验证结果、局部摘要 | 生命周期短,但对当前推理路径很关键 |
| 持久记忆 | 长期事实、偏好、历史决策、项目知识库 | 会跨会话复用,容易过期或互相矛盾 |
如果只有一个 agent,这些数据已经足够麻烦;如果有多个 agent,它们还会带来并发问题。一个 agent 更新了需求理解,另一个 agent 可能还在用旧版本;一个 agent 把错误观察写进共享记忆,后续 agent 可能把它当成事实;两个 agent 同时总结同一个任务,系统可能留下两份语义冲突的记录。此时“记忆”不再是功能模块,而是可靠性的核心边界。
共享记忆与分布式记忆
论文首先给出两个基本原型:shared memory 和 distributed memory。它们直接对应传统多处理器系统里的两种直觉:所有处理单元访问同一块共享内存,或者每个处理单元维护本地内存并通过通信同步。
图 1 来自 arXiv 论文官方 HTML。左侧共享记忆架构里,多个 agent 都读写同一个 memory pool;右侧分布式记忆架构里,每个 agent 有自己的 memory,agent 之间通过同步或通信交换状态。
共享记忆的优点很明显:知识复用简单。Planner 写下“用户最终目标是部署一个低延迟推理服务”,coder、benchmark agent、deployment agent 都可以读到这个结论。共享向量库、共享文档数据库、共享任务状态表都属于这个方向。
但共享记忆的问题也同样明显:一旦大家都能写,系统就需要 coherence。这里的 coherence 不只是“数据库没有坏”,而是“不同 agent 看到的事实是否一致”。例如:
| 场景 | 共享记忆中的问题 |
|---|---|
| 多个 agent 并行总结同一份日志 | 两条摘要互相矛盾,但都被后续检索命中 |
| verifier 推翻了 executor 的假设 | 旧假设没有被失效,planner 仍然基于旧假设拆任务 |
| agent 把临时观察写入长期记忆 | 一次性环境状态被误当成持久事实 |
| 权限边界不清 | 一个 agent 读到了不该读的私有上下文,或覆盖了别人维护的记录 |
分布式记忆走另一条路。每个 agent 有自己的局部工作集和长期记录,只有必要时才同步。这样隔离性更好,局部推理更稳定,也更适合角色差异很大的系统。例如代码 agent 保存编译错误与修复尝试,研究 agent 保存论文摘录与证据链,规划 agent 保存任务 DAG 与依赖关系。
分布式记忆的代价是同步变难。每个 agent 都可能拥有“局部正确”的状态,但全局并不一致。研究 agent 找到了一条新证据,代码 agent 是否应该立刻知道?如果 planner 在同步之前已经发出下一步任务,后续执行是否要回滚?这些问题不是 prompt engineering 能解决的,而是状态传播协议的问题。
真实系统通常会落在两者之间:短期上下文和角色私有状态放在本地,经过验证的结论、可复用证据、任务级状态进入共享层。这个折中很像现代计算机系统里的多级缓存:每个核心有私有 L1/L2,芯片上还有共享 LLC,最终再落到主存。区别在于,硬件缓存处理的是字节和 cache line,agent 记忆处理的是摘要、证据、计划、工具轨迹和语义对象。
把 agent 记忆拆成三层
论文第二个核心观点是:不要把 agent memory 看成单一存储。计算机体系结构从来不会只说“内存”,而会区分寄存器、缓存、主存、磁盘、网络存储,因为每一层的容量、延迟、带宽和持久性都不同。agent 系统也应该这样分层。
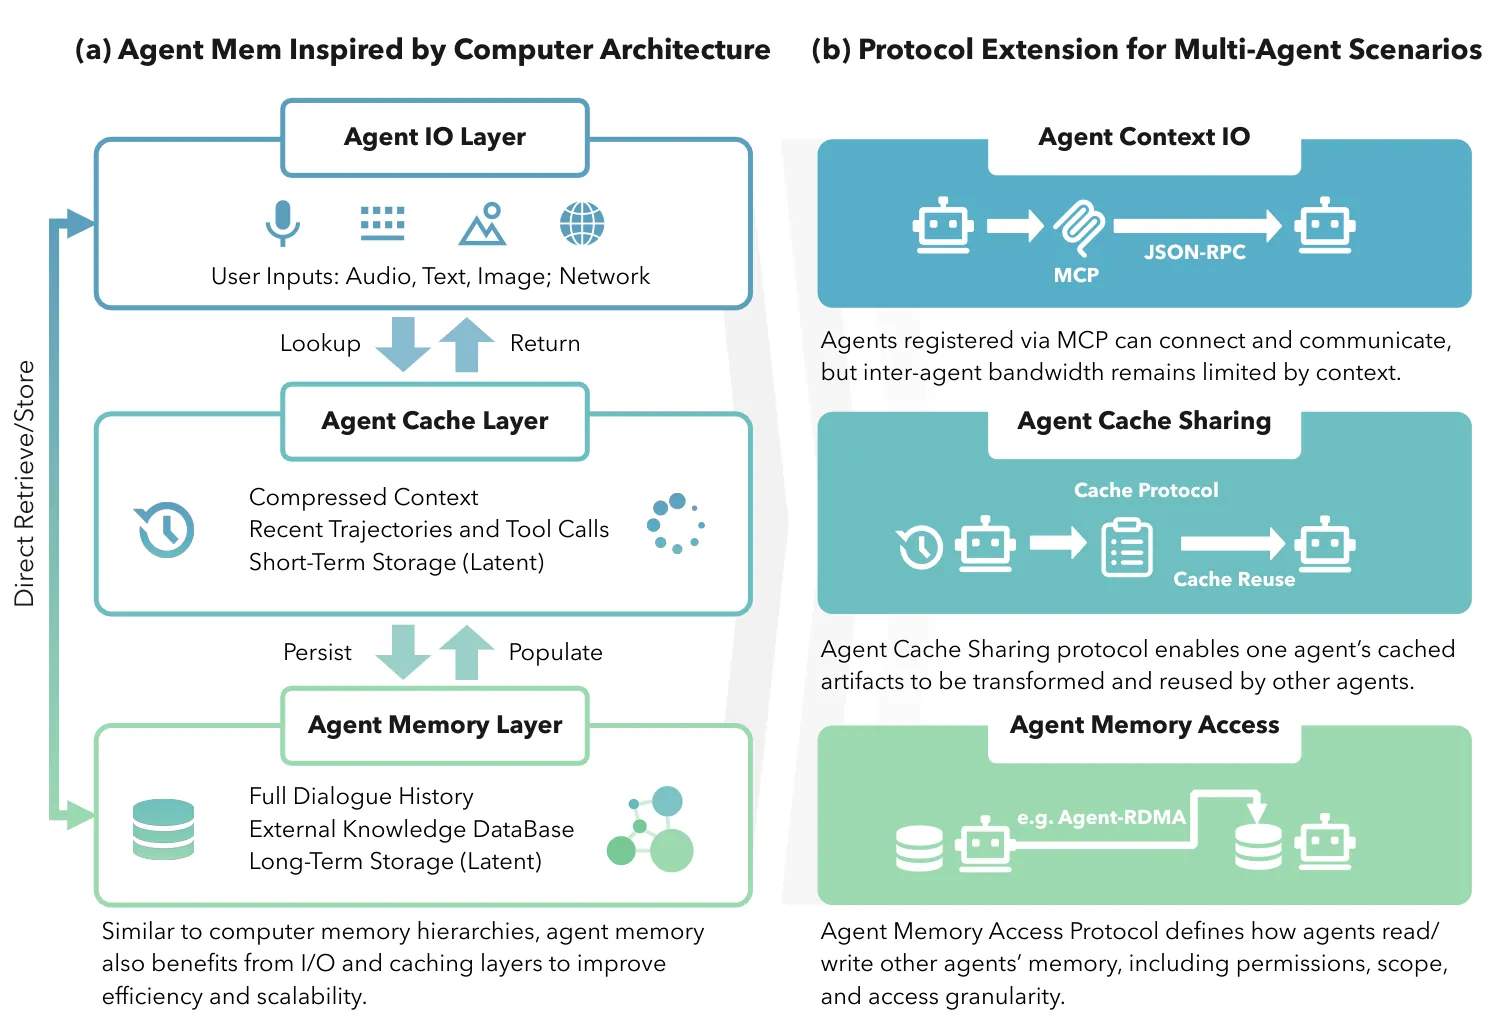
图 2 同样来自论文官方图。上半部分把 agent 记忆映射成 I/O layer、cache layer、memory layer;下半部分指出现有 MCP/JSON-RPC 主要解决 context I/O,而 cache sharing 和 memory access 仍缺少标准协议。
这三层可以这样理解:
| 层次 | 作用 | 典型内容 | 系统指标 |
|---|---|---|---|
| Agent I/O layer | 接入外部世界 | 用户输入、网络请求、文件、图片、音频、工具输出 | 输入吞吐、格式转换成本、权限边界 |
| Agent cache layer | 支撑当前推理 | 压缩上下文、最近轨迹、工具调用结果、KV cache、embedding cache | 低延迟、命中率、失效策略、显存占用 |
| Agent memory layer | 持久保存知识 | 全量对话历史、向量库、图数据库、文档库、长期偏好 | 容量、检索质量、版本管理、访问控制 |
这套分层最重要的提醒是:agent 性能是端到端数据移动问题。很多 agent 失败并不是模型不会推理,而是关键上下文没有在正确时间进入正确层。相关信息如果只存在长期文档库里,但当前推理时没有被检索出来,模型等于没看见;工具调用结果如果每轮都重新注入完整文本,context 带宽会被浪费;一段已经算好的 KV cache 如果不能被复用,系统会反复支付 prefill 成本。
这里可以用一个简化符号描述单个 agent 的记忆状态。设第 个 agent 在时间 的记忆为:
其中, 表示 I/O 层在该时刻可见的外部输入与工具结果, 表示 cache 层里服务当前任务的短期状态, 表示长期 memory 层中可持久化、可跨任务复用的记录。这个公式不是论文原文的形式化定义,而是为了把三层关系说清楚:一个 agent 的“记忆”不是一个向量库对象,而是三类状态的组合。
多智能体系统会进一步变成:
这里 是 agent 数量, 是共享记忆或共享状态。难点不在于把这些对象存下来,而在于定义 与 之间什么时候同步、同步什么粒度、谁有权覆盖谁,以及同步失败时如何恢复。
这个视角也能解释为什么“把所有历史塞进长上下文模型”不是最终答案。长上下文扩大了 的容量上限,但没有自动解决检索、写入、失效、权限和一致性。长上下文更像更大的 cache,而不是完整的内存系统。本站前面关于 PagedAttention 完全拆解 和 GQA 完全拆解 的文章都从推理内存带宽角度讲过 KV cache 的物理成本;多智能体记忆问题是在更高系统层面追问:哪些语义状态值得进入当前上下文,哪些缓存可以跨 agent 复用,哪些长期记录应该被更新。
MCP 解决了连接,不等于解决了记忆
论文提到 MCP 时给了一个很重要的定位:MCP 更像 agent context I/O 协议。它让模型应用可以标准化地连接工具、数据源和外部服务,减少每个工具都单独写适配层的混乱。根据 Model Context Protocol 官方文档,MCP 的目标是让 AI 应用以标准方式访问外部系统。
但连接协议不等于记忆协议。一个 agent 能通过 MCP 调用数据库,并不意味着多个 agent 就知道如何共享缓存、如何读取彼此记忆、如何处理并发写入。可以把它类比成计算机系统:PCIe、网络协议、系统调用解决“设备和程序如何通信”,但 cache coherence、memory consistency、文件锁、事务隔离解决的是“多个执行单元如何安全地共享状态”。
论文指出两个缺失的协议层。
第一是 agent cache sharing protocol。它面向短期、热数据、可复用中间状态。典型例子是 KV cache、压缩上下文、工具返回摘要、已验证证据片段、局部规划结果。它的问题不是“能不能发给别人”,而是“发什么格式、带什么元数据、如何判断可复用、如何失效、如何转换”。
第二是 agent memory access protocol。它面向长期记忆和共享状态。这里的问题更像数据库和操作系统:一个 agent 是否能读取另一个 agent 的长期记忆?读到的是只读快照,还是可写对象?访问单位是 document、chunk、key-value record、trace segment,还是一条带 provenance 的语义事实?写入需要审计吗?删除旧信息是覆盖、追加 tombstone,还是保留版本链?
把这两个协议分开很关键。cache sharing 追求低延迟和复用,memory access 追求权限、持久性和可解释性。混在一起会出问题:如果把短期 cache 直接当长期事实保存,系统会记住大量过期中间判断;如果把长期 memory 每次都整段塞进 cache,系统又会浪费上下文带宽。
Cache sharing 为什么不只是“把 KV 发过去”
论文把 KV cache sharing 列为已有相关方向之一,并引用了 DroidSpeak、Cache-to-cache、KVComm 这类工作。以 DroidSpeak 为例,它关注的是跨 LLM 或微调变体之间共享 KV cache,避免多个模型对相同上下文重复 prefill。DroidSpeak 的关键观察是,不同模型变体的 KV cache 并不一定逐层完全兼容,因此需要识别关键层并选择性重算,在吞吐和质量之间做折中。
多智能体 cache sharing 比普通 KV cache 复用更复杂,因为 agent 间共享的不一定是同一个模型、同一段 token、同一种任务。一个 researcher agent 的缓存可能包含论文摘要、引用证据和检索路径;一个 coder agent 需要的却是 API 约束、错误日志和补丁上下文。即使底层都是文本,语义对象的用途也不同。
因此,一个可用的 agent cache sharing protocol 至少要描述以下字段:
| 字段 | 含义 | 为什么必要 |
|---|---|---|
| producer | 哪个 agent 产生了缓存 | 用于可信度、审计和错误回溯 |
| scope | 缓存适用的任务、会话或子问题 | 防止跨任务误用 |
| representation | 文本摘要、embedding、KV cache、工具轨迹还是结构化对象 | 决定 consumer 如何读取 |
| dependency | 缓存依赖哪些输入、工具版本、环境状态 | 输入变化后才能正确失效 |
| freshness | 生成时间、版本号、过期条件 | 避免读到陈旧状态 |
| transform | 是否允许压缩、投影、重编码或局部重算 | 支持异构 agent 复用 |
如果只把 cache sharing 理解成“把前一个 agent 的消息复制给下一个 agent”,系统很快会撞上上下文带宽墙。更合理的做法是按语义对象传递:证据列表、候选计划、反例、失败日志、局部结论、可复用 KV 片段分别有不同生命周期。短期 cache 的访问单位越清楚,系统越容易做命中率统计、淘汰策略和错误归因。
这也解释了为什么多智能体系统里的“压缩上下文”不能只靠普通摘要。摘要会丢失 provenance,后续 agent 难以判断某个结论来自哪份证据;摘要还会把临时猜测写得像确定事实,导致后续推理被污染。一个 cache artifact 最好同时携带内容、证据来源、置信状态和依赖边。这样它才像 cache line,而不是一段没人负责的自然语言。
Memory access protocol 需要定义权限、粒度和版本
长期 memory 层的问题更偏系统安全与数据管理。很多 agent 框架已经支持“memory”,例如 MemGPT 把 LLM 上下文管理类比成操作系统虚拟内存,用显式函数调用在上下文窗口和外部存储之间搬运信息。论文还引用了 A-Mem、Mem0、MemoRAG 等 agentic memory 方向工作,它们都在探索长期记忆如何组织、检索和更新。
但在多智能体系统里,长期记忆不是一个 agent 自己的扩展上下文,而是多方读写的共享状态。一个 memory access protocol 至少要回答三组问题。
第一组是权限。谁能读?谁能写?谁能删除?权限是否随任务变化?例如 deployment agent 可以读服务配置,但不应该随意覆盖需求文档;verifier 可以把某条事实标记为 rejected,但不一定能删除原始证据;planner 可以更新任务图,但不能修改工具执行日志。
第二组是粒度。访问单位太粗会浪费带宽,太细会丢失语义完整性。以代码修复任务为例,读取整个仓库历史太重,读取单个 chunk 又可能缺少调用关系;更合适的单位可能是“一个错误栈 + 相关文件片段 + 已尝试补丁 + 测试结果”的 trace segment。多智能体记忆需要的粒度,往往比 RAG 的普通 chunk 更接近“带类型的事件对象”。
第三组是版本。长期记忆会被更新,更新不是简单覆盖。很多事实存在生命周期:需求可能从 A 改成 B,工具结果可能因为环境变化失效,早期计划可能被后续验证推翻。如果系统只有最后写入值,就很难解释为什么 agent 做出某个决定;如果系统保留所有版本但没有可见性规则,后续 agent 又会检索出互相冲突的旧记录。
因此,长期 memory 更适合采用 append-only log + materialized view 的组合。原始事件按时间追加,方便审计;当前可用事实由视图层生成,并带有版本号、来源和状态。这样既能追溯,也能避免每个 agent 都直接在同一份“事实表”上互相覆盖。
多智能体一致性:真正的核心难题
论文最有力量的一节是 memory consistency。传统计算机体系结构里,一致性模型规定的是多个处理器的读写操作以什么顺序对彼此可见。它不只关心“读到了什么值”,还关心“某个写入什么时候变得可见”“两个写入是否必须被所有核心按同一顺序观察到”。
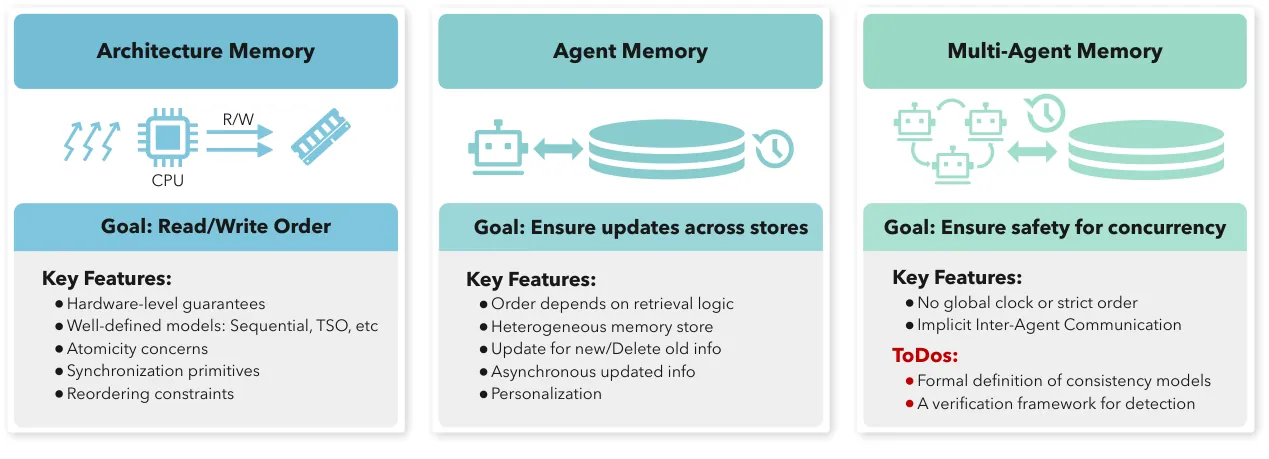
图 3 来自论文官方图。它把硬件 memory、单 agent memory、多 agent memory 放在一起比较:硬件侧有读写顺序、原子性、同步原语和重排序约束;agent memory 侧还要处理检索逻辑、异构存储、异步更新、个性化和隐式跨 agent 通信。
可以用一个简化关系来理解一致性。设 表示 agent 在时间 把对象 写成版本 , 表示 agent 在时间 读取对象 。如果系统承诺写入先于读取可见,可以写成:
这里的 表示系统定义的可见性顺序,不一定等于真实物理时间顺序。硬件里,这类顺序可以通过内存屏障、锁、原子操作和一致性协议约束;agent 系统里,这个顺序经常是隐含的:一条消息到了、一个向量库更新完成了、一个 summary 被写进共享文档了、一个工具结果被另一个 agent 读到了。
单 agent 的一致性已经不简单。一个 agent 可能同时维护 working memory、episodic memory 和 semantic memory。某条新事实写入 episodic memory 后,semantic memory 的摘要什么时候更新?当前上下文里的旧摘要是否要失效?如果检索模块把旧事实和新事实一起召回,模型应该相信哪一个?这些问题在 Generative Agents 这类长期记忆系统里已经出现,但通常没有被形式化为一致性模型。
多 agent 会进一步放大问题。论文把多智能体一致性拆成两个要求:
| 要求 | 关心的问题 | 类比 |
|---|---|---|
| update-time visibility and ordering | 写入什么时候对其他 agent 可见,并以什么顺序可见 | 硬件内存一致性模型 |
| read-time conflict resolution | 读到冲突或过期 artifact 时如何合并、拒绝或降级 | 数据库冲突解决、分布式系统 merge policy |
第一个要求处理“时间”。例如 verifier 已经写入“方案 X 不可行”,planner 是否必须在生成下一版计划前看到这条写入?如果系统允许 eventual consistency,那么 planner 短时间内读到旧状态是否可接受?哪些任务可以接受最终一致,哪些任务必须强一致?
第二个要求处理“语义”。硬件内存里同一个地址通常只有一个值,冲突是字节级问题;agent 记忆里的冲突可能是两段自然语言证据互相否定,也可能是一个计划与一个环境状态不兼容。例如一个 agent 记录“API 支持参数 temperature”,另一个 agent 记录“当前部署版本禁用了 temperature”。它们不是同一 key 的简单覆盖,而是需要结合版本、作用域和环境约束判断。
这就是论文强调“多智能体记忆一致性尚未被正式定义”的原因。没有形式化定义,就很难写测试,也很难判断系统什么时候错了。一个 agent 给出错误答案,可能不是模型能力问题,而是读到了陈旧 cache、未授权 memory、未合并的冲突版本,或者被另一个 agent 的 speculative write 污染。
可以从硬件一致性借哪些概念
硬件内存模型不能直接搬到 agent 系统,但它提供了很好的概念工具箱。
Sequential consistency 可以启发“全局顺序记忆”。系统维护一个统一事件日志,所有 agent 都按同一顺序观察关键写入。这最容易理解,也最利于调试,但吞吐和延迟代价高。它适合高风险决策点,例如最终发布、交易执行、权限变更、长期事实提交。
Total Store Order 可以启发“本地写缓冲 + 受控刷新”。每个 agent 可以先把局部结论写入本地 buffer,等通过验证或达到同步点后再发布到共享 memory。这样能保留局部探索效率,同时避免未验证内容立刻污染全局状态。很多 planner-executor-verifier 架构其实已经隐式采用这种模型,只是缺少协议化描述。
Release consistency 可以启发“同步点驱动的记忆可见性”。agent 在 acquire 某个任务上下文时读取一组一致快照,在 release 结果时提交一组写入。中间过程的临时思路不必全局可见,只有通过同步点的 artifact 才进入共享层。这很适合多 agent 并行搜索:各自探索时保持隔离,合并阶段再解决冲突。
Eventual consistency 可以启发“低风险长期知识传播”。例如多个 research agent 对不同论文做摘要,短时间内不一致可以接受,后续由整理 agent 合并。这里系统更关心最终收敛、来源保留和冲突标记,而不是每次读取都看到最新状态。
这些模型的价值,不是让 agent 系统变成 CPU 模拟器,而是迫使系统设计者明确承诺:哪些写入必须立即可见,哪些可以延迟;哪些冲突必须阻塞任务,哪些可以保留多个版本;哪些 agent 拥有提交权,哪些只能产生候选 artifact。
一个更工程化的多智能体记忆栈
把论文观点落到工程系统,可以得到一套比较清晰的运行时栈。
第一层是 event log。所有重要读写都记录成事件,包括 agent ID、对象 ID、版本号、依赖、时间戳、权限上下文和状态。event log 不一定每次都进入模型上下文,但它是审计和回放的基础。
第二层是 typed memory objects。不要只存自然语言 chunk,而要存带类型的对象,例如 Evidence、Plan、ToolTrace、Decision、RejectedHypothesis、UserConstraint。类型决定访问权限、过期规则和冲突处理策略。
第三层是 cache manager。它管理短期 artifact,包括摘要、embedding、KV cache、工具结果和局部状态。cache manager 需要知道依赖关系:如果底层工具输出变了,依赖它的摘要和计划都应该失效或降级。
第四层是 access controller。它不只是鉴权,还要处理 scope。一个 agent 可以读项目级公开知识,但不能读另一个 agent 的私有 scratchpad;可以追加证据,但不能直接改最终决策;可以读旧版本,但生成答案时必须优先使用当前 committed view。
第五层是 consistency coordinator。它定义同步点、提交规则和冲突策略。例如任务开始时 acquire 一致快照,任务结束时 release artifact;多个候选结论进入仲裁;被 verifier 标记为 rejected 的记录从默认检索视图中移除,但保留在审计日志中。
这套栈可以对应到一个简化流程:
External input -> Agent I/O layer -> typed event -> local cache / local memory -> shared commit protocol -> global memory view -> retrieval / cache reuse -> next agent这个流程强调两件事。第一,agent 之间传递的最好不是裸文本,而是带元数据的 typed artifact。第二,长期 memory 不应该直接等同于检索库;检索库只是当前可见视图的一种索引,背后还需要版本、权限和一致性规则。
与推理服务系统的关系
这篇论文虽然不是传统意义上的 GPU 推理优化论文,但它和推理服务系统关系很深。多智能体系统本质上会把一次用户请求拆成多轮、多模型、多工具、多状态读写的执行图。只优化单次 decode latency 不够,还要优化整个执行图里的数据复用和状态传播。
在推理服务里,KV cache 是显存里的热数据;在 agent 系统里,工具轨迹、检索证据、局部摘要和长期记忆视图也是热数据。前者的瓶颈是 HBM 带宽、显存容量和调度;后者的瓶颈是上下文窗口、检索带宽、语义一致性和访问控制。两者表面不同,但都在回答同一个系统问题:算力不一定是瓶颈,数据移动才经常是瓶颈。
这也解释了为什么未来 agent serving 不会只是“一个 HTTP 请求调一个大模型”。它更可能包含:
| 服务组件 | 类比推理系统 | 负责的问题 |
|---|---|---|
| Agent scheduler | 请求调度器 | 决定哪些 agent 并行、哪些必须等待同步点 |
| Context cache | KV cache / prefix cache | 复用可共享上下文,减少重复 prefill |
| Memory runtime | 存储引擎 | 维护 typed artifact、版本和索引 |
| Consistency layer | 并发控制 / coherence | 定义读写可见性和冲突处理 |
| Policy engine | 权限系统 | 控制 agent 对记忆的读写边界 |
如果把 agent serving 看成推理服务的上层扩展,那么 memory runtime 很可能会成为新的核心基础设施。它既要懂模型上下文,也要懂存储系统;既要服务低延迟 cache,也要服务长期审计;既要支持自然语言对象,也要支持结构化 trace。
局限:这篇论文提出问题多于给出答案
这篇论文的定位是 position paper,因此它没有实现一个完整系统,也没有给出实验评测。它的贡献不是“某个 benchmark 提升多少”,而是提出一个统一框架:多智能体记忆应当按照体系结构问题来研究。
这也带来几个明显空白。
第一,它还没有形式化定义多智能体一致性。论文指出需要 formal definition 和 verification framework,但没有给出类似 SC、TSO 那样可执行的语义。后续工作需要定义读写对象、事件顺序、同步原语、冲突类型和可验证性质。
第二,它没有区分不同任务风险等级。写代码、整理资料、执行金融交易、控制机器人,对一致性的要求完全不同。高风险任务需要强同步和可审计提交;低风险资料整理可以允许最终一致和多版本并存。一个通用 memory protocol 必须允许不同一致性等级共存。
第三,它没有展开隐私与安全边界。多智能体记忆访问协议一旦做成共享层,就会天然涉及最小权限、跨 agent 数据泄漏、prompt injection 污染长期记忆、恶意 tool trace 写入等问题。只谈访问粒度还不够,协议还要定义信任域和污点传播。
第四,它没有讨论成本模型。系统要在强一致、低延迟、高吞吐之间取舍,必须知道每类同步的代价。例如共享 KV cache 节省 prefill,但可能增加转换和验证成本;长期 memory 版本化提高可靠性,但会增加存储和检索复杂度;全局事件日志利于调试,但会带来写放大。
这些空白不削弱论文价值,反而说明这个方向还处在概念框架刚成形的阶段。它像是在 agent 系统上重新提出一个老问题:当多个执行单元共享状态时,没有协议,规模一大就会失控。
小结
Multi-Agent Memory 这篇论文最值得记住的不是某个具体算法,而是一个判断:多智能体系统的记忆问题,正在从 prompt 技巧变成体系结构问题。
共享记忆带来复用,也带来 coherence;分布式记忆带来隔离,也带来同步;三层记忆结构把 I/O、cache、memory 的职责拆开;MCP 等连接协议解决了外部工具接入,却没有自动解决 cache sharing 与 memory access;真正的难题是多智能体一致性,也就是多个 agent 并发读写语义状态时,系统如何定义可见性、顺序和冲突处理。
从工程角度看,未来可靠的 agent runtime 需要的不只是更长上下文和更强模型,还需要 typed memory objects、版本化事件日志、缓存复用协议、访问控制和一致性协调。没有这些基础设施,多智能体系统越复杂,越容易在“记错、读旧、互相覆盖、错误复用”里失去可靠性。
参考资料
- Multi-Agent Memory from a Computer Architecture Perspective: Visions and Challenges Ahead
- Model Context Protocol 官方文档
- MemGPT: Towards LLMs as Operating Systems
- DroidSpeak: KV Cache Sharing for Cross-LLM Communication and Multi-LLM Serving
- A Primer on Memory Consistency and Cache Coherence
- Generative Agents: Interactive Simulacra of Human Behavior
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


