


Jev 完全拆解:把 Agent 的语义判断编译成类型化并行决策
大模型已经很擅长把一个问题回答成一段文字,但软件真正需要的往往不是文字,而是一个能直接进入 if、switch 或调度器的值:这张工单属于哪个部门,这次工具调用是否安全,这段上下文是否还值得保留,下一步应当执行哪个动作。
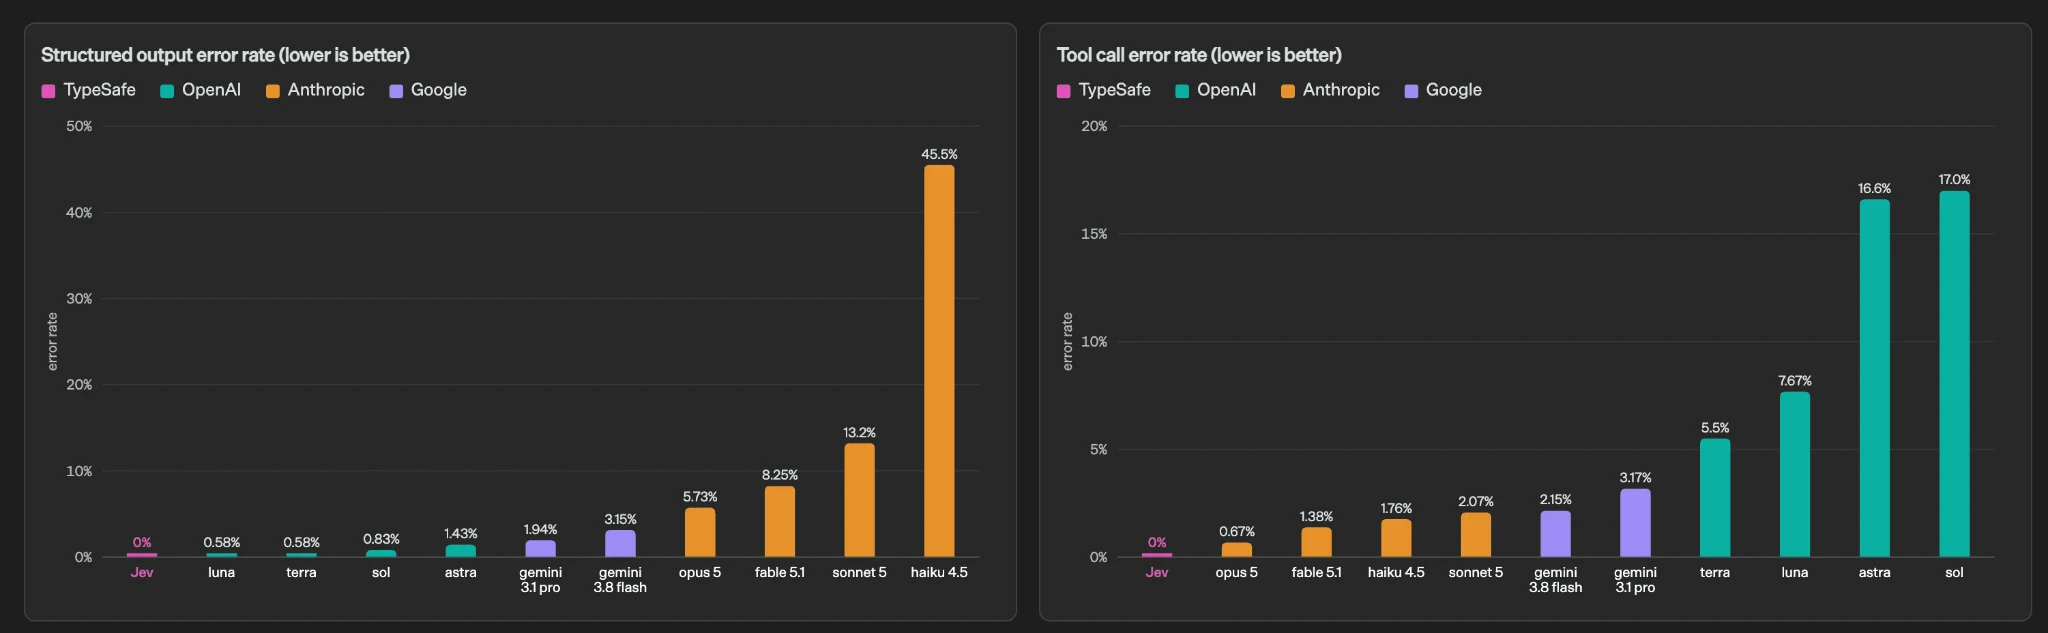
传统做法是让生成模型输出 JSON,再经历生成、解析、校验、失败重试。这个流程看似已经“结构化”,底层却仍然在逐 token 生成字符串。答案空间明明只有三个枚举值,系统仍需为任意词表上的自回归解码付费,还要防范多余解释、字段遗漏、非法枚举和格式漂移。
TypeSafe AI 在 2026 年 9 月 15 日发布 Jev,并把它定义为首个公开的 System One model:输入自然语言或结构化状态,输出预先声明类型的概率化决策,而不是开放文本。官方用一句话概括其接口:unstructured state in,typed probabilistic decisions out。这个定位的技术价值不在于“更小的聊天模型”,而在于改变推理服务的契约:模型不再拥有回答格式的控制权,软件先定义合法答案集合,模型只负责在集合内分配概率。
“System One”这个名字借用了 Daniel Kahneman 在《Thinking, Fast and Slow》中推广的 System 1/System 2 区分,强调快速、直觉式判断;“Jev”则取自经济学家 William Stanley Jevons。TypeSafe 用 Jevons paradox 作类比:当单位智能的成本下降,用量可能不是线性增加,而是涌现出原本不值得调用模型的新场景。这个命名只是一种产品隐喻,不应被理解为模型在实现人类认知理论。工程上真正可检验的仍是输入契约、输出分布、延迟、校准和失败边界。
这篇文章从接口、概率语义、推理路径和系统集成四层展开。需要先划清一条证据边界:TypeSafe 尚未公开 Jev 的参数规模、网络结构和完整推理内核;公开信息足以确认其 API、并行采样行为、延迟区间和产品边界,但不能据此断言其内部就是某种特定 Transformer。后文对候选 logit 读出和单步 canvas 的细节来自开源项目 Djev。Djev 是基于 DiffusionGemma 的独立实现,不是 Jev 的开源权重,也不能被当作 Jev 私有架构的反向证明。
为什么 Agent 工作流需要另一种推理接口
一个典型 Agent 流程可以拆成两类节点。
第一类节点负责开放生成:制定计划、写代码、解释结果、组织最终回复。它们需要较长上下文、自由文本和多步推理,生成式大模型很适合。
第二类节点负责有限判断:选择工具、判断任务是否完成、给风险分级、决定是否保留记忆、把请求路由到子 Agent。它们的共同特征是答案空间有限、调用频率高、处在自动化关键路径上。此时自由文本反而成为负担。
假设路由器只有 billing、technical、sales 三种合法结果。传统结构化生成的时延可以抽象为:
其中 是 JSON 回答的 token 数。即使最终信息量只有“technical”一个标签,模型也可能生成键名、括号、引号、概率解释乃至多余文字。约束解码可以保证语法,但没有消除逐 token 解码本身。
面向有限决策的理想路径则更接近:
readout 表示一次或少数几次模型读出,normalize 表示只在合法候选上归一化。这里并不是说所有决策模型都必然只做一次前向,而是指出它们可以删掉开放文本生成、字符串解析和格式重试这三段工作。
TypeSafe 公布的区间是端到端 70–500 ms,并宣称在其 workflow eval 中达到 193.6 倍速度和 444.6 倍成本优势。下图左侧比较单次调用的延迟,右侧比较调用成本;它说明的是官方选定工作流中的服务结果,不是跨所有任务、所有输入长度都成立的硬件常数。
图源:TypeSafe 官方发布文章。图中最大的差异来自输出形态:生成模型要生产字符串,Jev 只返回决策。实际收益还会受网络距离、输入长度、问题数量、并发和基线模型影响。
“类型安全”到底保证了什么
Jev 请求由三部分组成:model、state 和 questions。
state是待判断的共享上下文,可以是字符串、JSON 对象或文本数组。questions是具名问题集合,每个问题声明类型、指令和合法候选。- 返回值按问题 ID 对齐,包含类型化答案及其概率信息。
一个客服分流请求可以写成:
{ "model": "jev-1.13.0", "state": { "message": "我的信用卡被重复扣款,账户也无法登录。", "customer_tier": "pro" }, "questions": { "department": { "type": "choice", "instructions": "哪个团队应当主责处理?", "criteria": { "billing": "扣款、账单与退款问题", "technical": "登录、故障与集成问题", "sales": "购买、定价与方案咨询" } }, "urgent": { "type": "noul", "instructions": "这条消息是否需要立即处理?" }, "frustration": { "type": "score", "instructions": "客户表现出的挫败程度", "criteria": [ "平静陈述事实", "不满但克制", "强烈愤怒或威胁流失" ] } }}这里的类型安全只保证结构和候选边界。department.choice 一定来自三个键之一,模型不会返回一个未声明的 customer_success,也不会漏掉 JSON 右括号。但它仍可能把重复扣款错误地判给 technical。因此,“不会 hallucinate”应当理解为不会在输出模式之外编造值,而不是语义判断永远正确。
这一区分很重要。语法正确性可以由构造式接口保证,语义正确性只能由评测、校准、阈值、复核和业务规则共同保证。把二者混为一谈,会让类型安全变成危险的自动执行许可。
三个决策原语:Choice、Score 与 Noul
Jev 没有通用的“请生成任意 JSON”入口,而是把常见判断压缩成三种 primitive。它们并非只是返回字段不同,而是表达三种不同的统计问题。
Choice:在无序候选中选一个
Choice 适合部门、工具、意图、类别这类互斥或近似互斥的枚举。设合法候选集合为 ,模型对每个候选给出证据分数 。候选集 softmax 的一般形式是:
是温度,决定分布尖锐程度; 是候选 的归一化概率; 是最终选择。Jev 官方没有公开内部是否直接使用这条公式,但其 API 返回完整候选分布,开源的 Jev-like 实现通常会采用候选 logit 归一化或专用分类头。
Choice 最容易踩的坑是候选集合不完备。如果真实输入可能不属于任何已列类别,却没有 other 或 none_of_the_above,归一化仍会强迫某个错误候选成为第一名。一个看似高概率的答案,只能说明它在给定候选中相对占优,不能证明候选集合覆盖了现实。
Jev 1.13 的官方上限是每个 Choice 255 个选项。高基数分类并不意味着应把整个企业 taxonomy 平铺为 255 类;当类别具有天然层次时,按层级做 Choice,再用 beam search 保留多个高概率路径,通常比一次硬选更容易诊断。
Score:对有序等级求概率加权位置
Score 适合严重程度、情绪强度、质量等级这类有序尺度。假设等级编号为 ,返回分布为 ,则官方定义的 score 是期望位置:
例如三个等级的分布是 ,那么 。这不是模型创造了一个“1.43 级”类别,而是它在等级 1 与等级 2 之间存在分歧。应用若只保存 score,会丢掉分布形状: 与 的期望都可能是 1,但前者集中、后者两极分化。
Jev 支持 2–10 个等级。等级描述应该写成可观察情形,例如“核心功能中断,但存在绕行方案”,而不是“中等严重”。数字只是等级索引,语义来自描述。Jev 官方也明确提醒,不应把 Score 当成精密数值回归器,更不能用插值结果重建金额、时间或计数。
Noul:判断一个命题为真的概率
Noul 是二元判断,返回一个 ,代表命题为真的概率;反面概率是 。它没有单独的 confidence 字段,因为一个数字已经完整描述二元分布。
Noul 与 Score 不能互换。“候选人是否熟练使用 Python?”返回 0.5,可能表示证据不足或正反证据相当,并不表示技能处于中等水平。若业务需要能力等级,应使用带具体等级描述的 Score;若只需要“是否满足岗位最低要求”,则应把最低要求写清楚,再使用 Noul。
一个 Noul 只应包含一个命题。“客户是否愤怒并要求退款?”把两个条件塞进同一个概率,代码无法知道低分来自哪一半。更稳妥的做法是并行询问 is_angry 与 requests_refund,再在代码里做逻辑组合。
置信度不是正确率
Choice 和 Score 同时返回 probabilities 与 confidence。概率向量回答“模型如何在候选之间分配信念”,置信度则把分布的集中程度压成 0–1 的单值。官方文档没有把生产服务的精确计算式承诺为稳定 API,只说明分布越尖锐,置信度越高,并鼓励需要特殊统计量的应用直接使用完整概率。
一种常见的集中度定义是归一化熵:
当概率均匀分布时,,置信度为 0;当全部质量集中在一个候选上时,熵为 0,置信度为 1。Djev 明确使用熵集中度。TypeSafe 文档中的三选项交互示例则用 近似展示“峰值越高,置信度越高”的直觉。二者都描述分布形状,但不是“这次答案正确的概率”。
校准讨论的是另一件事:在大量预测中,声称 0.8 的样本是否大约有 80% 正确。常用的 Expected Calibration Error 可以写成:
是落在第 个置信区间的样本集合, 是样本总数。ECE 小只说明分桶后的概率与频率接近,不保证任意单个高置信预测正确,也不能替代类别召回率、代价敏感错误率和分布漂移监控。
工程上应把阈值绑定到动作代价,而不是绑定到模型品牌。例如读取余额可以在较低阈值自动执行,转账、删除数据或驱动机械臂则需要更高阈值、二次确认或独立安全检查。阈值还必须按模型版本重新标定;官方 jev-latest 会移动,生产系统更适合固定到 jev-1.13.0 这类版本 ID,并记录响应中实际使用的版本。
一次 prefill,为什么能问很多问题
System One 接口最有系统价值的特性,不是单个分类,而是让多个独立问题共享同一份 state。官方文档称每个问题独立针对 state 评估,问题彼此不作为隐藏上下文,同时在一次请求中并行处理。
若 state 长度为 ,第 个问题长度为 ,把 个问题拆成请求会重复发送和处理 state:
合并请求则更接近:
这只是 token 与共享输入的抽象,不等同于 GPU FLOPs 的精确公式;不同实现仍可能为每个问题建立独立读出。但当长文档占据绝大多数输入时,避免把同一 state 发送 次,网络、计费和 prefill 都会明显受益。
TypeSafe 官方 cookbook 用约 5.4 万字符的 GDPR 文档测试 13 个问题。一次合并请求平均成本为 0.000497 美元、耗时 0.27 秒;13 次串行请求合计 0.006090 美元、2.71 秒,对应 12.2 倍成本差和 10.0 倍串行时间差。若把 13 次请求并发发出,墙钟时间差会缩小,但 state 仍被计费和传输 13 次。
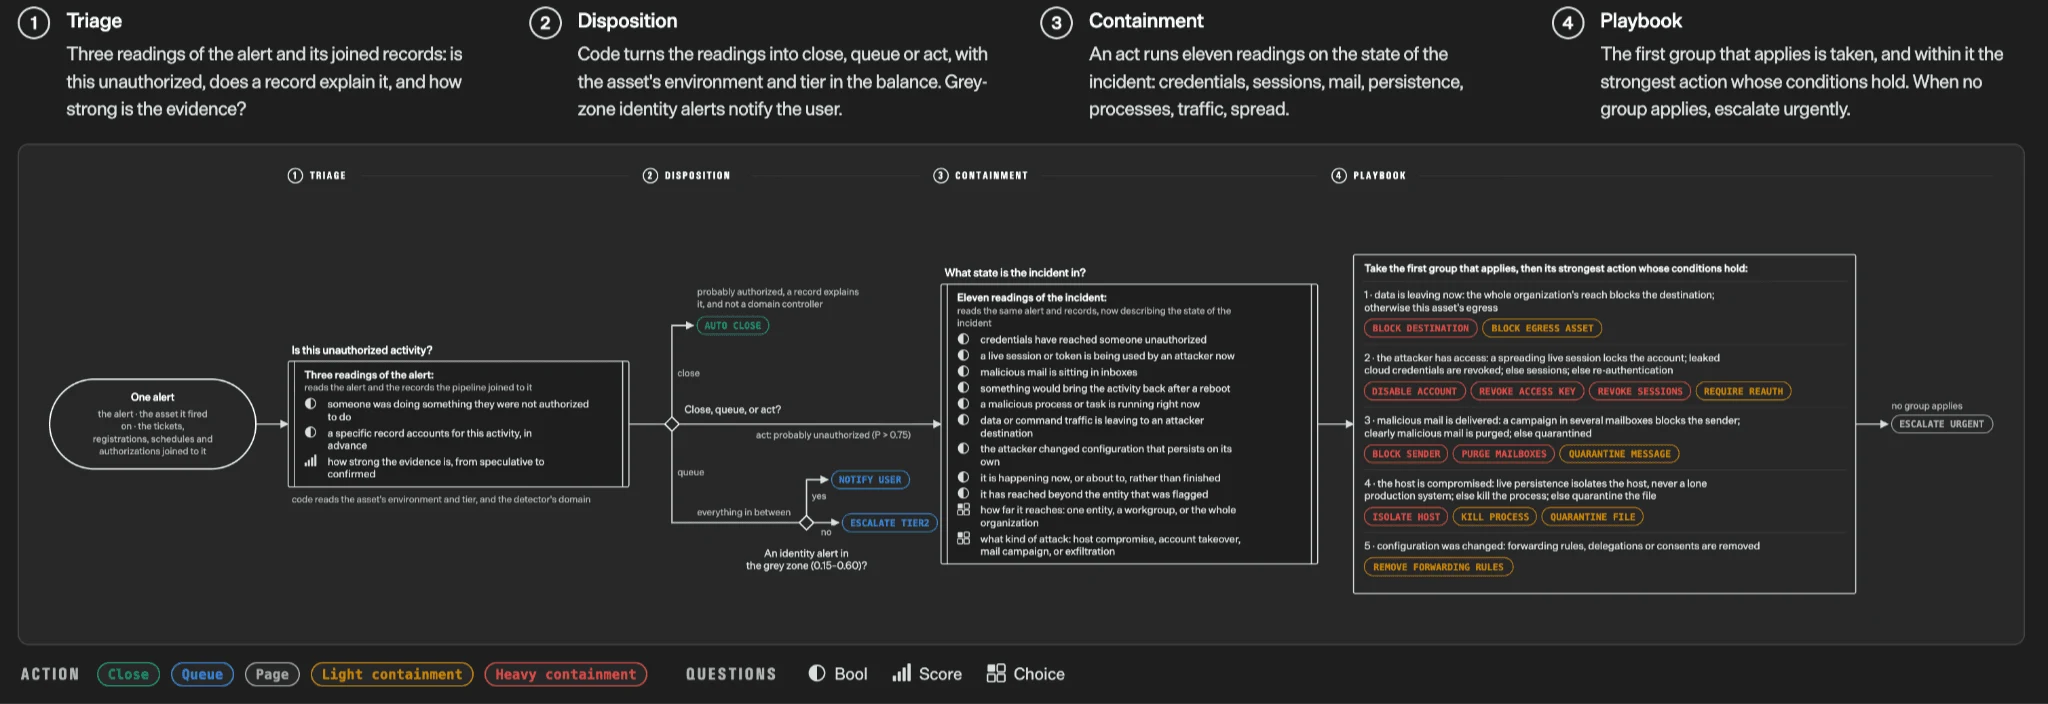
图源:TypeSafe 官方发布文章。图中 Stage、Disposition、Containment 和 Payload 不是让模型一次给出笼统结论,而是把领域流程拆成细粒度问题,再由代码根据概率组合。这种“模型提供语义特征,代码拥有控制流”的边界,才是并行问题真正的工程意义。
Jev 1.13 当前公开的每请求上下文上限为 64k token,同时约束 state 加最长问题不超过 32k token;定价是每百万输入 token 0.042 美元,输出不计费;公开速率限制为每秒 25 万 token、每分钟 1200 请求。限制可能动态调整,因此容量规划应以实际账户返回和服务文档为准。
从完整词表到候选词表:开源实现揭示了什么
Jev 没有公开内部结构,但“有限答案无需生成完整字符串”并不是黑箱魔法。一个自回归语言模型在最后隐藏状态 上通常计算全词表 logits:
若合法标签已经被编译成 token ID 集合 ,服务端可以只收集这些位置的 logit:
这样做有三个直接结果。
第一,返回值天然属于候选集合,结构错误概率降为零。第二,不需要生成完整 JSON。第三,服务可以保留完整概率向量,而不是让模型在文本里“自报置信度”。
但它也有三个限制。标签如果由多个 token 组成,就不能只比较单个位置的 logit,需要累积序列条件概率并处理长度偏置;不同标签的 token 化可能产生系统性偏差;候选顺序、描述措辞和温度都会影响分布。更彻底的实现会给每个候选分配固定单 token 代码,或训练专用决策头,但 Jev 是否采用这些办法没有公开信息。
Djev:用 DiffusionGemma 做单步结构化读出
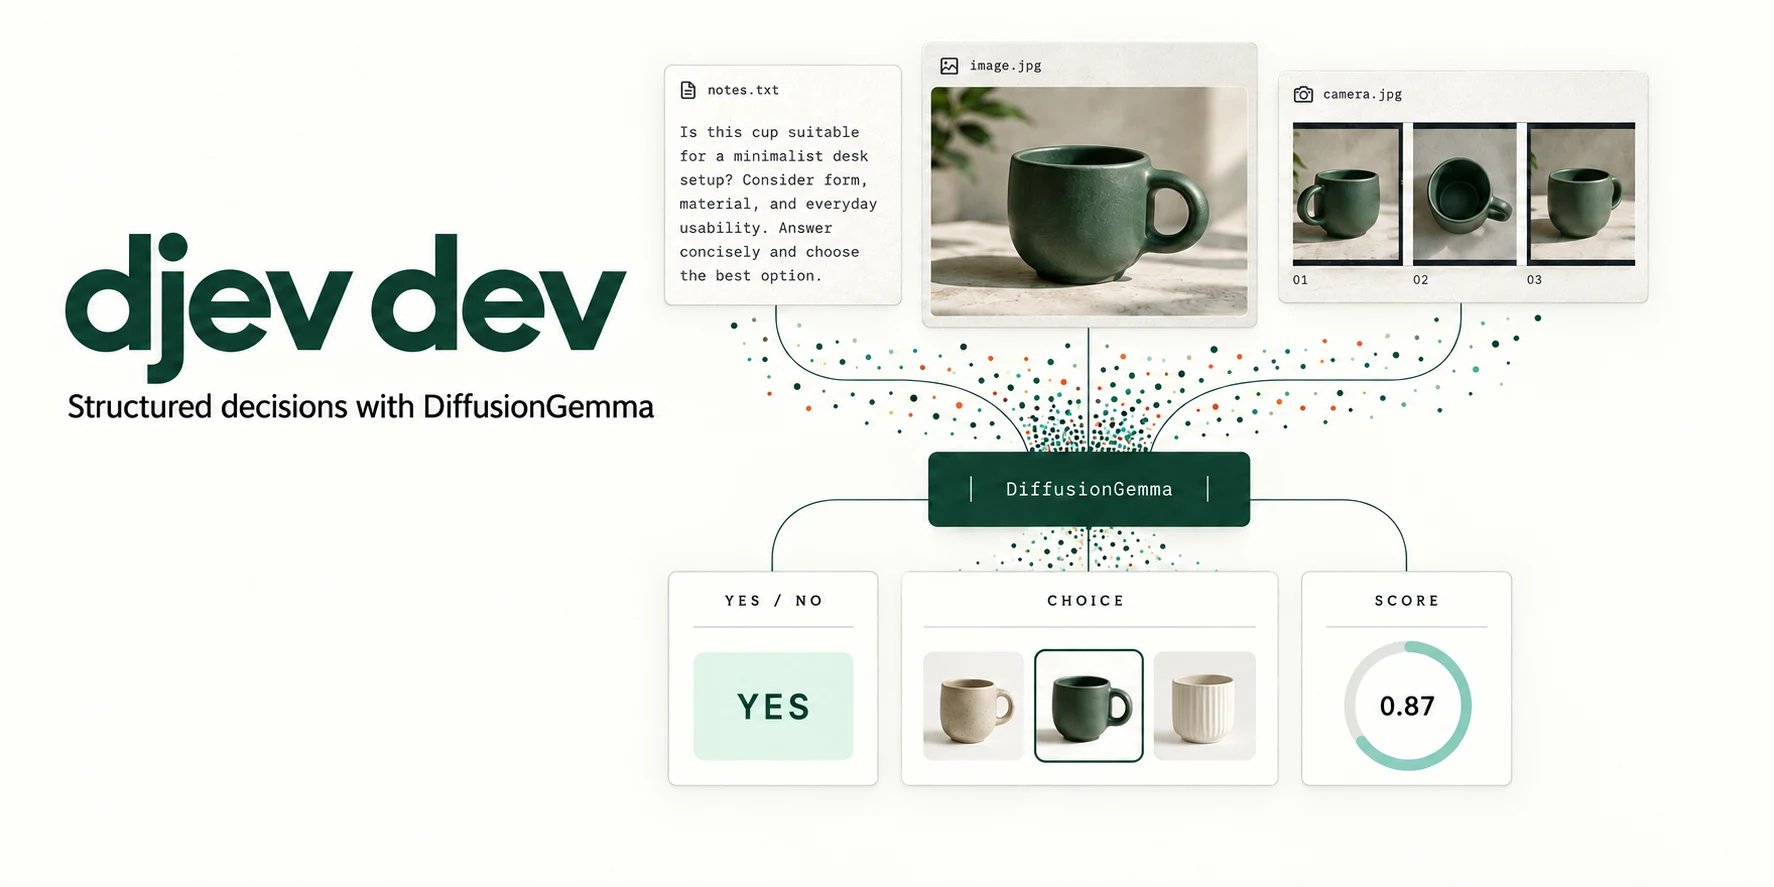
Djev 是理解这类推理路径的一个可运行样本。它基于 Google DiffusionGemma 26B-A4B 和修改后的 vLLM,提供 Noul、Choice、Score、图像输入和图像候选。项目没有训练新的 Djev 权重,而是把原始 DiffusionGemma checkpoint 适配为类型化决策服务。
图源:Djev 开源仓库。其核心不是让扩散语言模型完整生成答案,而是把答案位置布置在一个紧凑 canvas 中,做一次结构化读出,然后只取合法标签概率。
DiffusionGemma 的推理结构包含两个相关部分:编码器对上下文做 causal prefill 并形成 KV cache;解码器在 generation canvas 内使用双向注意力,让多个待填位置彼此可见。普通扩散生成会多轮去噪,逐步完成一整个文本块。Djev 的默认路径只执行一次去噪读出,因为决策所需的证据已经体现在答案位置的 logits 中,无需把 canvas 继续完善成自然语言。
其流程可以分成五步:
- 校验 state、问题、候选和图像限制。
- 把问题编译为系统指令、固定模板和答案槽位,并记录每个合法标签的精确 token ID。
- 选择能容纳模板的最小 canvas 宽度,只在答案槽位注入带种子的噪声。
- 让 DiffusionGemma 做上下文 prefill 和一次 canvas 读出,返回答案位置上指定 label 的 log probability。
- 在候选集合内归一化,构造类型化响应。
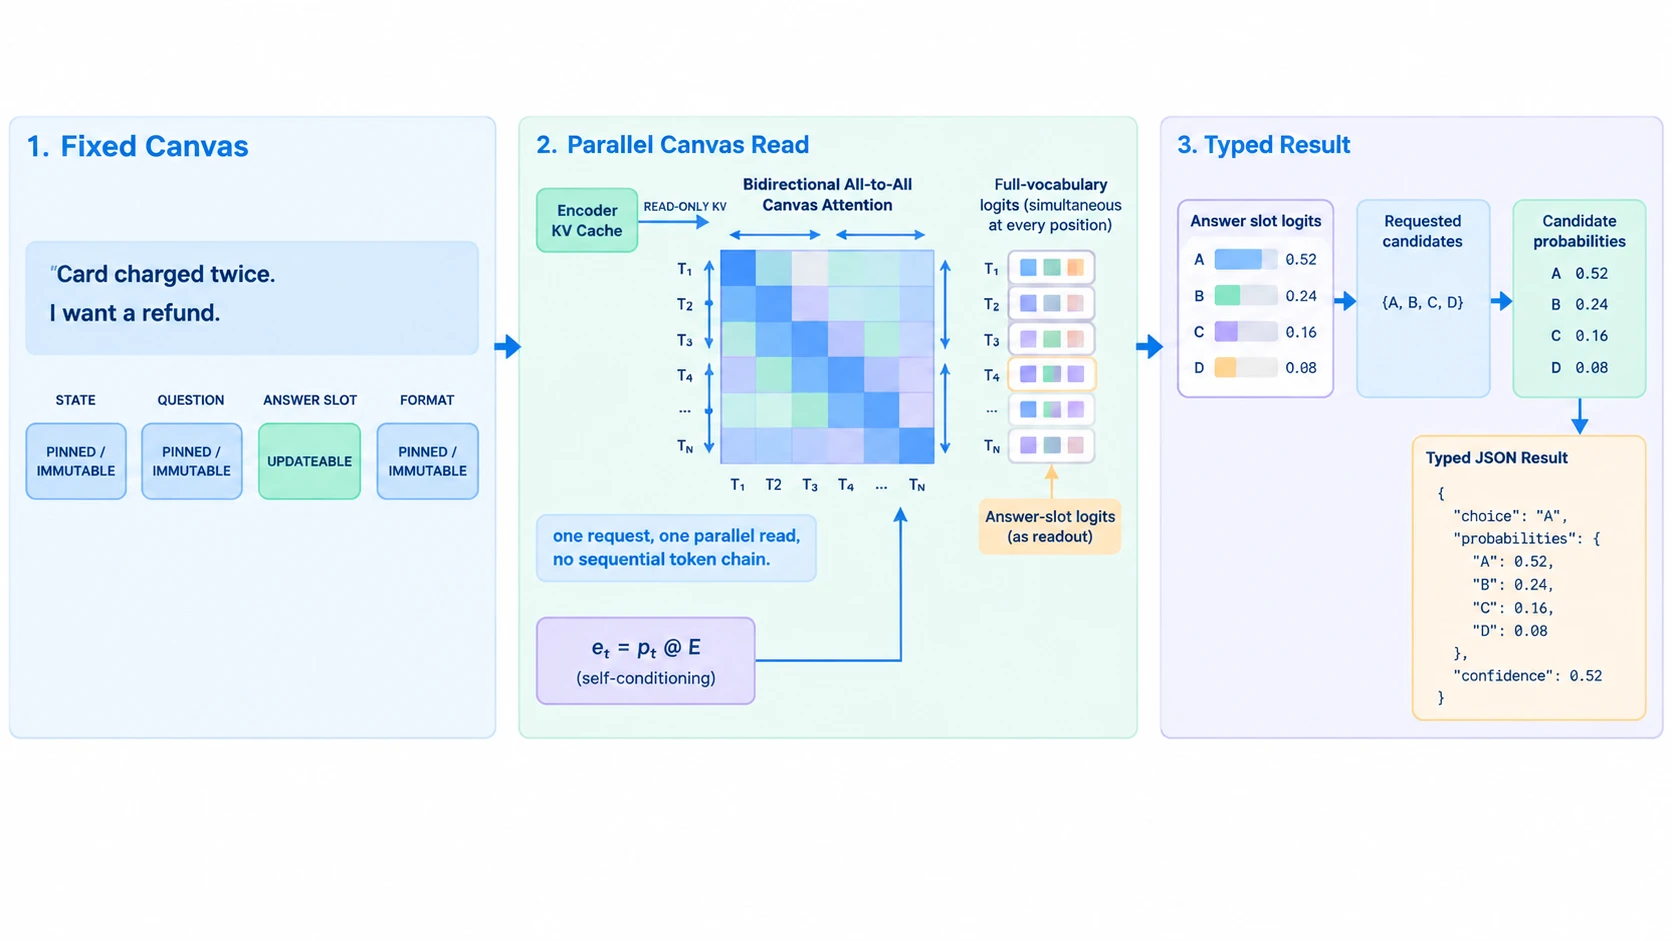
图源:演讲材料中的 Djev 推理示意,机制依据 Djev 架构文档 核对。左侧表示上下文只做一次 prefill 并写入 KV cache;中间 canvas 同时放置多个答案槽;右侧直接得到 Choice、Noul 和 Score。它解释的是 Djev 的公开实现,不代表 Jev 的私有内部结构。
Djev 还做了几项面向服务的优化:复用已编译的文本 schema 与可复用前缀;按模板大小选择紧凑 canvas;直接请求精确 label logits,避免合法标签落出 top-k;用有界并发限制在途请求;图像请求则禁用不安全的前缀复用,确保完整 image span 被调度。
它的参考部署是单张 NVIDIA B200、CUDA 13、BF16 权重与 BF16 KV cache。项目报告的历史短文本配置在 1000 次开发样例上达到 HTTP p50 76.87 ms、p95 86.40 ms,但那是更早的量化配置,不代表当前 BF16 release。当前 BF16 小样本的模型调用 p50/p95 为 59.10/86.60 ms,而完整 HTTP p50/p95 为 375.55/1098.70 ms。两组数据的精度、样本和网络边界不同,不能拿来计算版本速度提升。
更关键的反例是 Score:同一个开发提示在混合负载下出现三种概率轮廓和两个获胜等级,16 次重复都没有落入作者设定的目标区间。因此,“格式永远合法”和“概率可用于自动执行”之间仍隔着任务级评测与校准。
如果要进一步理解 Djev 为什么依赖 vLLM 的调度、模型 runner 和 KV 管理,可参考 vLLM 源码完全拆解(一):整体架构与模块全景。Djev 不是给 vLLM 套一个 HTTP 外壳,而是修改了 canvas 调度、结构化读出、视觉 span 和 logits 返回路径。
为什么“100 倍更快、更便宜”不能脱离口径
TypeSafe 的官方 workflow eval 把多个模型放进同一业务计算图,以大型外部模型给出的平均概率作为参考,比较工作流准确度、成本和延迟。官方同时披露了几个重要限制:参考答案来自 GPT-6 Astra 与 Fable 5.1,可能偏向这些模型的判断;工作流由内部 capability 团队成员制作,可能存在选择偏差;193.6 倍与 444.6 倍位于实际收益的较高端;延迟从美国西海岸的笔记本测到当前服务区域,包含特定网络条件。
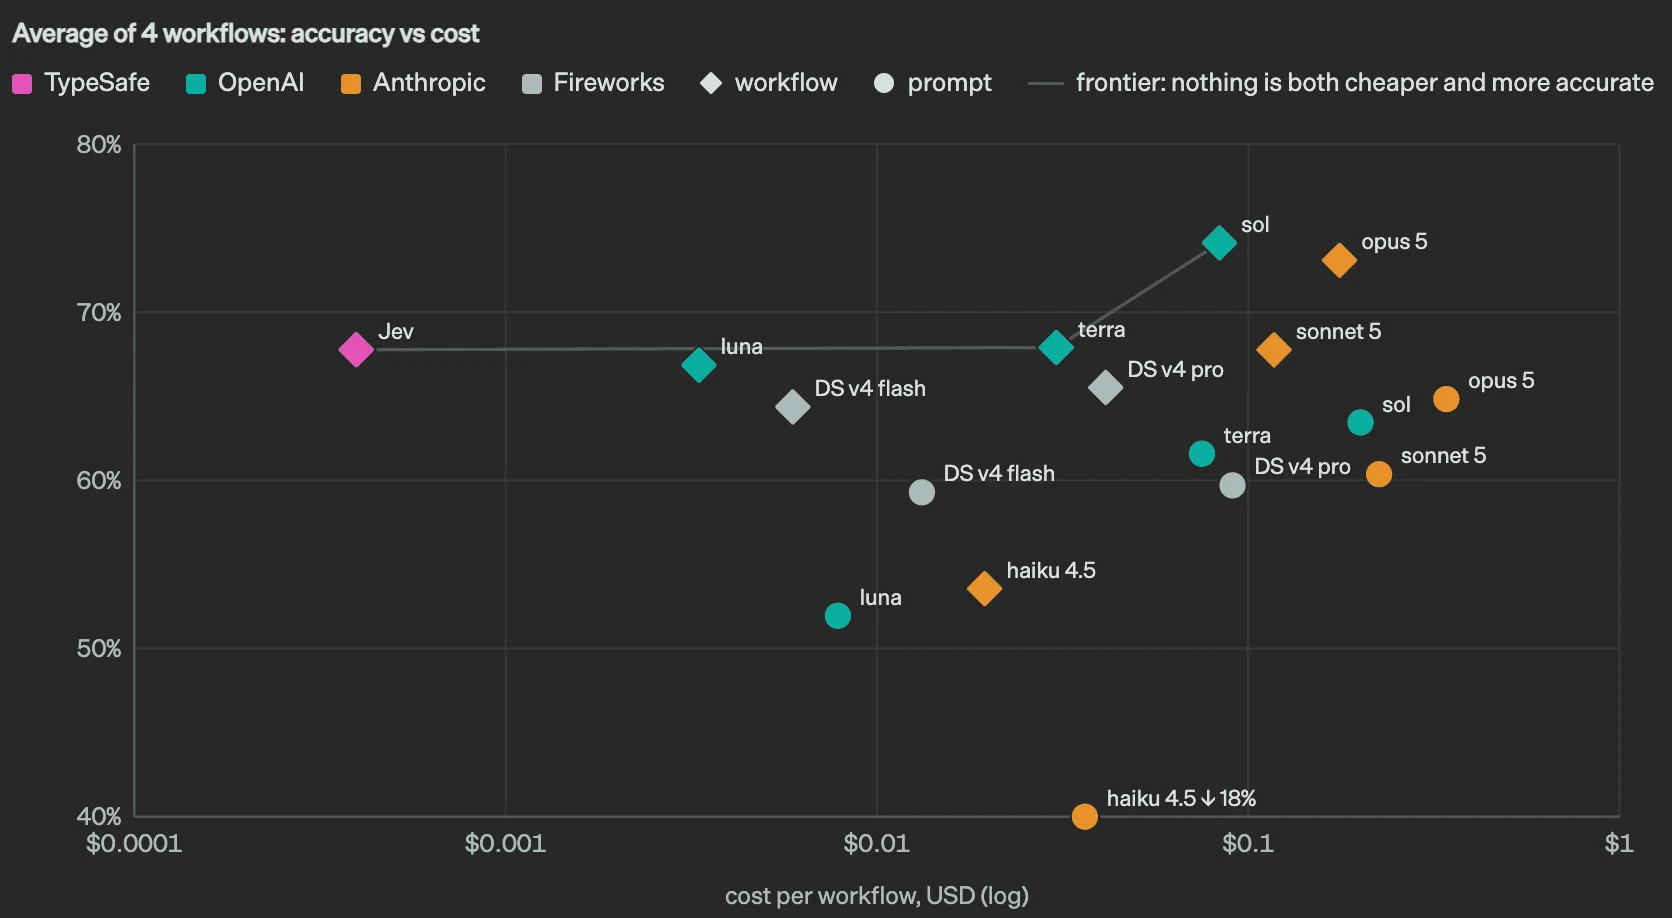
图源:TypeSafe 官方发布文章。横轴是每个 workflow 的成本,纵轴是四个工作流的平均准确度。图能支持“在这套工作流与参考口径中处于成本—质量前沿”,不能支持“所有分类任务都比任意 LLM 准确”。
独立的 JevBench 进一步说明榜单会随任务集和评分规则快速变化。其当前 v1.4.2.1 把 chance-corrected intelligence、calibration、speed、cost 组成等权调和平均,Jev 1.13.0 排在第三;但公开题可能被训练或选择利用,封闭题规模有限,复合分数也取决于四个轴的权重。最合理的使用方式不是引用一个总分作采购结论,而是复用其方法:固定任务、记录完整概率、把准确率与校准分开、报告 p50/p95、统一成本单位,并保留 held-out 数据。
比较决策模型与生成模型时至少要统一五个条件:
- 同一 state、同一候选和同一任务定义。
- 同一网络边界,不能拿 GPU kernel 时间对比公共 API 的端到端时间。
- 同一并发和缓存状态,冷启动与稳态分开报告。
- 同时报告语义正确率、校准、格式成功率和尾延迟。
- 生成模型的成本要包含重试与解析失败,决策模型的成本也要包含问题拆分产生的物理读出。
把 Jev 放进 Agent:它应该控制哪里
System One 决策层适合放在“语义模糊、动作有限”的边界上,而不应取代整个 Agent。
工具选择与结果验收
工具路由是 Choice:候选就是当前允许的工具。结果验收可以拆成多个 Noul,例如“是否满足用户要求”“是否包含可验证证据”“是否需要继续调用”。真正执行工具前,代码仍应检查权限、参数类型、速率限制和幂等键。模型负责判断“像不像该走这条路”,程序负责确认“能不能走、走了会怎样”。
推理强度选择
一个编码 Agent 可以在每一步执行前,让 Jev 在 low、medium、high 三档推理强度中选择。简单问候用低档,跨文件调试或架构修改用高档。这样做的收益不是让 Jev 解决编码问题,而是避免主模型对每一步都使用最高推理预算。
但控制器不能只看任务描述。合理的 state 还应包括当前步骤类型、最近工具错误、剩余预算、修改范围和不可逆风险;并由代码设置下限,例如涉及数据库迁移时不得降到低档。Jev 的选择只是预算调度信号,不应覆盖安全策略。
Agent 历史记录过滤
长任务常用摘要压缩历史,但摘要会改写原文,可能丢掉错误栈、文件路径、参数和用户原话。另一种做法是逐条询问“这条记录对后续是否仍有用”,保留原始高价值条目,删除低价值中间结果。
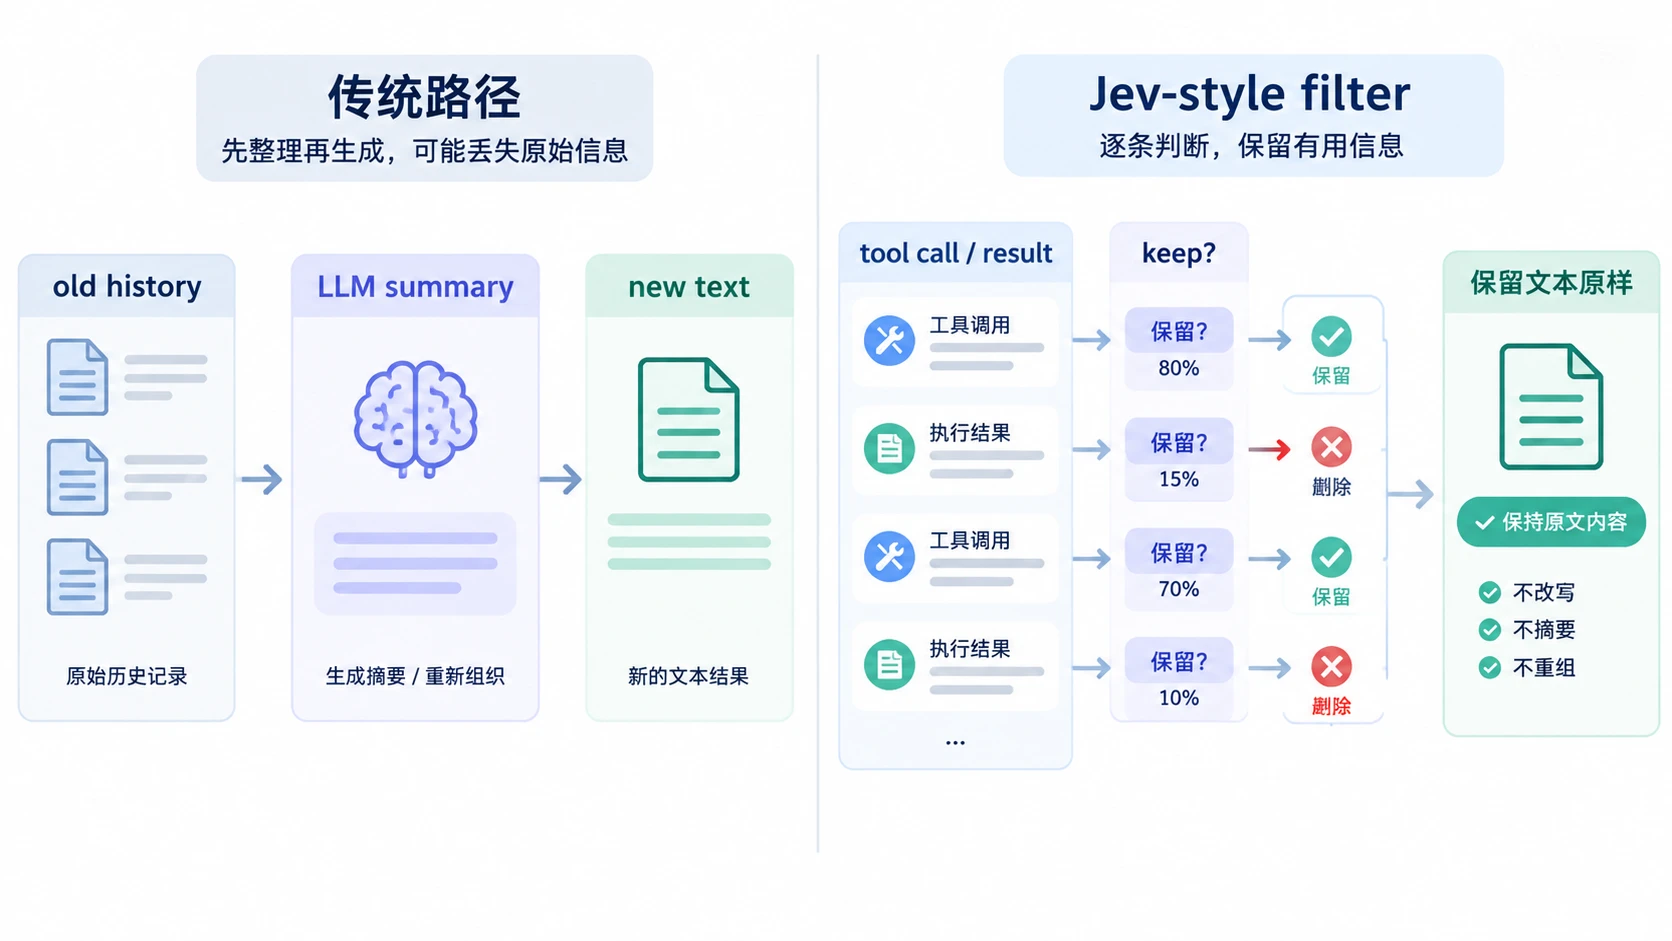
图源:演讲材料中的 Agent 上下文过滤示意。右侧方法不生成新摘要,只对每条工具调用、执行结果和约束计算保留概率,因此被保留的信息仍是原文。它减少了改写损失,但不保证时间关系完整:某条看似无用的失败结果可能解释后续决策,独立逐条判断也可能破坏因果链。
稳妥的记忆过滤应加入四条规则:用户约束、已确认事实和未解决错误默认保留;工具调用与对应结果成组处理;低置信条目延迟删除;压缩前后都保存可恢复日志。关于多 Agent 记忆中的持久层、共享层和一致性问题,可参考 Multi-Agent Memory 完全拆解:把 Agent 记忆当成计算机体系结构问题。
安全与审计
内容安全、提示注入检测、输出验收都适合 Noul 或 Choice,但不能把同一个模型既当执行者又当唯一审计者。高风险系统应使用异构检查:规则处理确定性约束,决策模型处理语义信号,必要时再交给人或更强推理模型。模型返回的概率应写入审计日志,连同输入版本、问题 schema、阈值和最终动作一并保存。
一条可落地的服务链路
把 Jev 接进线上系统时,不宜让业务代码到处直接拼请求。更稳妥的边界是建立独立 decision gateway,集中管理 schema、版本、阈值、回放和降级。
请求进入后,网关先从 schema registry 读取问题定义。registry 中不仅保存 Choice 选项或 Score 等级,还要保存版本号、适用语言、风险等级和离线评测集。业务只传 state 与 schema ID,可以避免十个服务分别维护十份略有差异的提示。
第二步是确定性预处理。日期先解析成时间戳,金额先转成统一货币,列表先由代码计数,权限和资源存在性先查询数据库。只有剩余的语义判断进入模型。这个顺序既避开 Jev 的数值弱点,也减少无关上下文。
第三步是按共享 state 合并问题。所有独立问题进入一次调用,有依赖的问题则分阶段执行。例如先用 Choice 选部门,再只对该部门运行专属风险量表。前者减少重复 prefill,后者避免让无关问题污染输入;并不是问题越多越好。
第四步是 policy engine。它读取答案、完整概率和业务代价,决定自动执行、澄清、升级或拒绝。设误执行代价为 ,漏执行代价为 ,理想阈值应来自期望损失最小化,而不是拍脑袋选择 0.8:
这里 是阈值, 是验证集上的经验风险。不同动作的两个代价不同,因此同一个 Noul 输出可以有不同阈值。安全告警通常更怕漏报,阈值可能较低;自动退款更怕误报,阈值和复核要求会更高。
第五步是观测与回放。每次决策至少记录模型版本、schema 版本、state 哈希、概率向量、阈值分支、端到端延迟、重试次数和最终业务结果。只有拿到延迟之后的真实结果,才能回答“0.9 是否真的比 0.7 更可靠”。监控面板不应只看平均准确率,还要看 p95/p99、各置信区间样本量、自动执行率、人工推翻率和分布漂移。
降级策略也应提前定义。服务超时不等于答案为否;429 不应被吞成低置信;解析 state 失败不能进入默认类别。低风险读取可以退回规则或缓存,高风险写操作应 fail closed 并要求确认。若采用 jev-latest 做灰度,新旧版本应 shadow 一段时间,比较完整概率和阈值翻转率后再切换。
从游戏到机器人:bounded action 为什么关键
游戏控制是最直观的闭环:程序把位置、目标、可用动作编码为 state;模型只在上、下、左、右等有限动作中选择;游戏执行动作并产生新状态。模型不能虚构“传送到终点”,因为这个动作不在候选集中。
TypeSafe 官方展示过 Doom 与 Wikiracing 两类例子。Doom 演示给模型的是带文本字段的结构化游戏状态,并非像素画面;其意义是低延迟闭环,而不是视觉理解。Wikiracing 每一步要从当前页面的链接中选下一跳,高基数候选会放大“编造不存在链接”的累计风险。Jev 的 Choice 上限为 255,当链接更多时,官方采用先独立打分、再显式 Choice 的两阶段流程。这里同样能看到程序与模型的分工:爬取页面和列出真实链接由代码负责,模型只负责语义上更可能通往目标的选择。
这个模式迁移到机器人后,候选动作约束更加重要,但也更容易产生错觉。Jev 本身不负责逆运动学、碰撞检测、关节限位和成功判定。完整闭环应当是:
是结构化状态, 是代码生成的安全候选集合, 是模型选择, 是控制器实际执行量。将“选了哪个动作”和“动作是否安全、是否成功”分离,才不会让语言模型的自我陈述冒充物理事实。
Jev × LIBERO:物理预演后再做分层选择
jev-libero 在 MuJoCo/LIBERO 中先对 27 个原子输入做短程可逆物理预演,再依据碰撞距离和任务条件筛出候选效果。Jev 分三层选择当前 intent、接触或运动族、最终原子输入,控制器执行一步后重新观察。
公开记录包括关闭微波炉 14 次决策/111 个环境步、关闭顶层抽屉 20/155、抓取并放下罐头 40/314。每个任务只展示一个通过原始 LIBERO 条件的记录,因此它们是可检查的运行样例,不是成功率统计,也不能推出跨任务泛化能力。
RoboJEV:意图与笛卡尔运动分两阶段
RoboJEV 让 Jev 读取 TCP 与物体位姿、速度、夹爪宽度、接触和近期动作,不直接读取相机。第一阶段从任务相关意图中选择 approach、grasp、lift、carry、lower、release;第二阶段分别选择 X/Y/Z 的 negative、zero、positive,以及夹爪的 open、hold、close。非零轴归一化为约 1 cm 平移,接近插孔时减小到 4 mm。
动作随后进入阻尼最小二乘逆运动学、关节位置控制和 2 ms MuJoCo 物理步。独立 evaluator 根据接触、位姿和任务条件判定成功,Jev 的回答不能直接宣布完成。固定种子 0–9 的结果中,pick-and-place、surface push、loose-fit insertion 都是 10/10,pedestal stack 为 8/10,gate pick-and-place 为 5/10;规则基线在对应任务上为 10/10、10/10、10/10、10/10、8/10。每项仅十次试验,门控任务还暴露了碰撞、方向反复和响应不一致,证据更适合说明失败边界,而非证明模型优于规则。
EmbodiedJev:把输入模态与控制边界拆开
EmbodiedJev 提供 LIBERO、Meta-World 与 Panda 工作台,接入 Jev、Claude、OpenAI-compatible API 和本地 MiniCPM。它把 MuJoCo 结构化状态、RGB-D 检测坐标与逐步 RGB 三类输入分开:Jev 当前只接收文本,因此读取结构化坐标;支持视觉的模型可以直接读取相机帧。控制器统一负责候选动作、逆运动学、安全检查、执行和成功判定。
其 Jev 分层 XYZ 搬运的两次公开试跑分别用了 89/88 个动作、178/176 次请求和约 72/80 秒,两次都到达托盘并撤离,但下放时均失去抓持。这组结果很好地说明“候选概率不等于动作成功率”:模型只是在当前描述下选择方向,误差会经过控制循环累积,接触动力学仍需独立测量。
三个项目共同说明,System One 模型在具身系统中的合理角色不是端到端控制器,而是受限动作空间中的语义选择器。状态估计、几何计算、物理预测、安全约束和执行验证都应留在可测试的程序中。
已知失败模式与生产防线
Jev 1.13 官方的 jaggedness 文档列出了九类边界。把它们转成系统设计规则,可以得到一张更实用的清单。
| 失败模式 | 为什么发生 | 应对方式 |
|---|---|---|
| 字面理解 | 模型回答写出来的问题,而非开发者心中隐含意图 | 把边界条件写入 instructions/criteria |
| 计数与精确算术 | 语义模型不是计算器 | 用代码计数、排序、比较日期和金额 |
| 多跳间接关系 | 问题需要跨多层引用 | 先检索和计算,直接指向相关字段 |
| 无关长上下文 | distractor 稀释有效证据 | 先过滤,只发送问题需要的 state |
| 对抗内容 | state 中的注入文本可能影响判断 | 精确写规则,单独检测注入,高风险复核 |
| 指令与 criteria 冲突 | 同一问题定义出两套语义 | 把 criteria 当作 instruction 的展开 |
| 结构不变量不成立 | 问命题与问其否定不一定互补 | 不跨问题强加 |
| 类型之间不可迁移 | Noul 与 yes/no Choice 的分布口径不同 | 每种 primitive 单独标定阈值 |
| 开放生成 | 连续 Choice 拼字又慢又差 | 需要文本时调用生成模型 |
特别需要警惕“共同常识不变量”。官方示例中,同一个退款问题用 Noul 得到 0.22,用 yes/no Choice 却给 yes 0.01、no 0.99;另一个命题和它的否定分别用两个 Noul 询问时,概率之和达到 1.19。原因在于每次提问都是独立条件化过程,措辞、候选和归一化空间不同。应用不能把跨调用结果当成同一个联合概率模型。
生产防线应至少包括:固定模型版本与 schema 版本;保存完整概率而非只存 winner;用业务数据做 held-out 校准;对选项顺序和释义做扰动测试;把低置信送入澄清、复核或更强模型;为不可逆动作增加确定性检查;监控输入分布和阈值通过率;保留失败样本并定期回放。
什么时候不该用 Jev
以下任务不符合 System One 的形状:需要写作、代码生成或解释;需要精确算术和日期比较;需要长链规划;答案空间无法预先枚举;错误后果高而又缺少独立验证;输入主要是 Jev 当前不支持的图像、音频或视频。
即使答案空间有限,样本量很大且标签长期固定时,传统监督分类器、reranker 或小型 encoder 也可能更快、更便宜、更容易自托管。Jev 的独特价值在于候选和语义规则可在请求时声明、任务经常变化、又希望得到统一的概率化接口。若 taxonomy 稳定且拥有充足标注数据,专用模型并不天然落后。
更现实的架构是异构推理栈:程序完成精确计算和权限控制;检索系统压缩上下文;Jev 处理高频、有限、语义性的判断;生成模型负责开放推理与文本;人处理高风险和低置信尾部。所谓 System One 与 System Two,不是二选一,而是把不同计算形状送到不同执行单元。
小结
Jev 的核心创新首先是接口而不是神秘网络结构:软件预先声明答案类型和候选集合,模型返回概率化决策,控制流仍由代码拥有。Choice 解决无序枚举,Score 表达有序等级上的分布与期望,Noul 表达单个命题为真的概率;一次请求中的多个问题共享 state,避免重复传输与重复 prefill。
Djev 证明了这条路线可以被实现为真正不同的推理路径:把问题编译成固定模板和标签 ID,在 DiffusionGemma 的紧凑 canvas 上做单步读出,只收集候选 logits,再构造类型化结果。它同时暴露了边界:格式可靠不代表语义可靠,分布集中不代表概率已校准,低平均延迟也不代表尾延迟、图像路径和混合负载同样稳定。
最值得带走的系统原则是把智能判断缩到最小,把可验证边界留给程序。模型选择工具,权限系统决定能否调用;模型选择动作,控制器和物理检查决定能否执行;模型给出概率,业务损失函数决定阈值。只有这样,快速的语义判断才会变成软件组件,而不是一个换了 JSON 外壳的聊天模型。
参考资料
- Introducing System One Models & Jev — TypeSafe AI
- System One — TypeSafe AI Documentation
- Primitives: Choice, Score, Noul — TypeSafe AI Documentation
- Confidence — TypeSafe AI Documentation
- Parallel questions — TypeSafe AI Cookbook
- Jev 1.13 jaggedness — TypeSafe AI Documentation
- Models and serving limits — TypeSafe AI Documentation
- Djev: structured decisions with DiffusionGemma and vLLM
- DiffusionGemma Model Card — Google AI for Developers
- JevBench: benchmark for typed decision models
- Jev × LIBERO: physics-grounded robot control
- RoboJEV: two-stage Jev control of a Franka Panda
- EmbodiedJev: robot decision workbench
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


