


mHC 完全拆解:流形约束超连接,如何让宽残差流稳定堆到 61 层
这篇论文在 DeepSeek 技术线上的位置
前面几篇文章沿着 DeepSeek 的技术时间线,把注意力机制(DeepSeek-V4 混合注意力完全拆解、MLA 完全拆解)、专家混合(DeepSeekMoE 完全拆解)、多 token 预测(MTP 完全拆解)以及推理服务系统(DeepSeek-V3/R1 推理系统完全拆解)这一整条链拆过了一遍,全景索引在 DeepSeek 技术全景。这些工作绝大多数属于所谓微观设计(micro-design):改的是一个计算块内部怎么算——注意力怎么压缩 KV、FFN 怎么稀疏化。
2025 年 12 月 31 日挂上 arXiv 的这篇《mHC: Manifold-Constrained Hyper-Connections》(arXiv:2512.24880,DeepSeek-AI,2026 年 1 月 5 日修订到 v2)走的是另一条路。它一个字都没改注意力,也没改 FFN,动的是块与块之间的连接拓扑——也就是宏观设计(macro-design)。论文一作兼通讯作者是解振达(Zhenda Xie),共同一作还有韦毅轩(Yixuan Wei)、曹焕琦(Huanqi Cao),梁文锋署名在作者列表末尾。
这篇文章要讲透的事情是:为什么把一个 的可学习混合矩阵强行约束成双随机矩阵(doubly stochastic matrix,非负且行列和都为 1),就能把 2024 年字节跳动 Seed 团队提出的超连接(Hyper-Connections,HC)从”训练到 12k 步就炸”救回来,并且只付出大约 6.7% 的额外训练时间。
背景:残差连接、恒等映射,以及 HC 为什么要加宽残差流
2015 年那条 到底好在哪里
ResNet 由何恺明等人于 2015 年提出(CVPR 2016 的 “Deep Residual Learning for Image Recognition”),它给单层网络写下的是这样一行式子:
其中 是第 层的输入, 是隐藏维度; 是输出; 是这一层真正干活的那个函数(在 Transformer 里就是 Attention 或 FFN 子层); 是这一层的可学习权重。加号右边第一项 就是那条”什么都不做、原样抄下去”的恒等通路。
把这一行逐层展开,从第 层推到第 层( 更深):
这一步推导没有任何技巧,就是反复代入:。式子的含义是:浅层信号原封不动地出现在深层,深层只不过是在它上面叠加了一串累加的增量。
论文里反复强调的恒等映射(identity mapping)说的就是 这一项。它的价值有两面:
前向方向,第 层的信号经过 次传播后仍有系数恰好为 1 的直达通路,不会因为层数增加而被稀释掉。
反向方向,对损失 求梯度:
括号里那个 是单位矩阵,它是恒等通路的”梯度镜像”。哪怕后面那一长串累加项全部趋近于零(比如某一层的雅可比奇异了),梯度仍然可以通过 原样回传到浅层。何恺明 2016 年的后续工作 “Identity Mappings in Deep Residual Networks” 把这一点讲得更明白:真正让极深网络可训练的不是”残差”这个概念本身,而是残差分支不动主干、主干必须保持恒等这个结构约束。
HC:把一条残差流拆成 条
十年过去, 从卷积换成了注意力、换成了 MoE,但加号两边那个结构几乎没变。一层的表达能力受限于 内部的宽度,而残差通路本身只有 个通道——所有层共享同一条 维的信息高速路。
2024 年 9 月,字节跳动 Seed-Foundation-Model Team 的 Defa Zhu 等人在 arXiv 上提出 Hyper-Connections(arXiv:2409.19606,v3 于 2025 年 3 月更新)。它的做法是把这条单车道改成 车道:输入 先被复制扩展成一个 的隐藏矩阵 ,然后引入三个可学习映射来管理这 条流的读写与混合:
三个映射的分工是这样的:
- 负责读出(read-out)。它把 条流聚合成 1 条 维向量,交给层函数 。这一步把流宽 压回 ,所以 的计算量和标准 Transformer 完全一样、FLOPs 一分没多。
- 负责写回(write-in)。它把 输出的 维结果重新分配到 条流上;因为形状是 ,公式里写成转置 ,与 维列向量相乘后得到 的增量矩阵。
- 负责残差混合。它是唯一作用在流维度( 那一维)上的矩阵,做的是”把 条流互相掺一掺”。
称为扩展率(expansion rate)。这三个映射都是可学习的,而且每个映射的系数由两部分组成:依赖当前输入的动态映射(dynamic mapping)和不依赖输入的静态映射(static mapping)。原始 HC 的写法是
符号逐个解释一下。 是先把 的流矩阵在最后一个维度上做 RMSNorm 的结果(RMSNorm 在最后一维上做,所以是对每条流的 个特征独立归一化)。 和 是线性投影的参数, 的形状是 ,刚好对上 的形状;同理 是 。 把动态部分压到 区间。 是三个可学习的门控标量(gating factor),初始化到很小的值——论文附录给出的初值是 。 和 是静态偏置,也就是”与输入无关”的那部分系数。
因为 (典型值 4)远小于 (数千),这些映射带来的额外计算量可以忽略。HC 由此给出了一条独立于”堆 FLOPs”和”堆数据”的第三根扩展轴:残差流的宽度 。论文在附录里把这条轴和另外两条并列,说它”补充了预训练缩放定律讨论的传统缩放维度”。
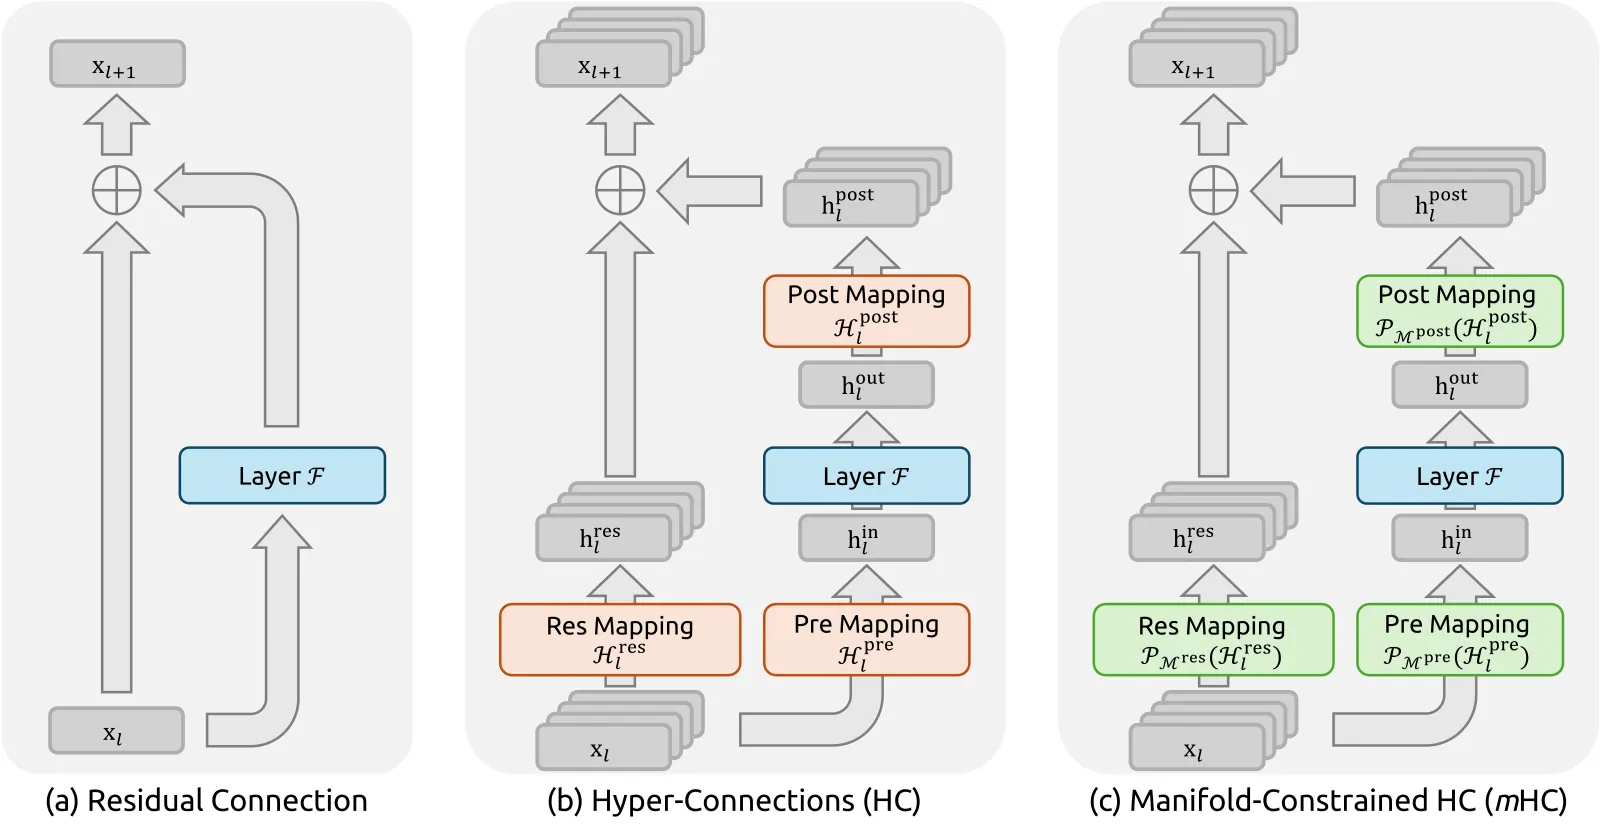
图:三种残差范式对比。(a) 标准残差连接:单条 维主干加一条层函数分支;(b) HC:主干被扩成 条并行流,三个可学习映射 、、 分别负责读出、写回与流间混合;(c) mHC:把三个映射都投影到受限流形 上,用约束换取跨层稳定性。(图片来源:mHC 论文)
上图是论文的第一张图,把三种范式并排放在一起。左边 (a) 是标准残差:一条粗箭头是主干,一条细的绕行分支是 ,两者在加号处合并。中间 (b) 是 HC:主干变成了一叠 条平行的灰色片(代表 的 条流),读出端有 (Pre Mapping),写回端有 (Post Mapping),主干末端有 (Res Mapping)在流之间重新混合。右边 (c) 是本文的主角:结构完全一样,但三个映射外面各套了一层绿色框,写的是 、、——这就是”流形约束”四个字在图上的样子。
HC 论文自己给出的原始结构图更直白地说明了这三条流在干什么:
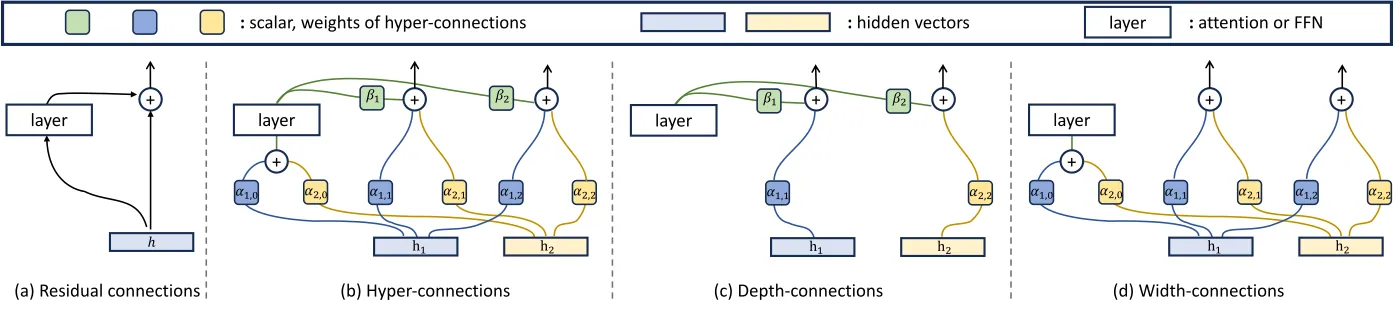
图:HC 原始论文的图 1。(a) 标准残差连接;(b) 超连接, 时两条流 之间的蓝色/黄色可学习权重同时控制”深度连接”(,跨层的写回权重)与”宽度连接”(,流之间的横向混合);(c)(d) 分别只保留深度连接或宽度连接的退化形式。(图片来源:Hyper-Connections 论文)
消融给出的关键提示:真正起作用的是残差混合矩阵
一个自然的疑问是:三个映射里哪个才是提升性能的主力?论文在 27B 模型上做了消融,做法是”关掉某个映射、换成一个固定的等价映射来维持形状一致”:关掉 时用均匀权重 ;关掉 时用全 1 的均匀权重;关掉 时用单位矩阵 。
| 绝对损失差 | |||
|---|---|---|---|
| (全关,即退化为残差连接) | 0.0 | ||
| ✓ | −0.022 | ||
| ✓ | ✓ | −0.025 | |
| ✓ | ✓ | ✓ | −0.027 |
这里的”绝对损失差”是相对于全关配置(也就是普通残差连接)的差值,负号代表损失更低、更好。读法很清楚:只打开残差混合矩阵 ,就能拿到 −0.022 里的大部分;再叠加 只多 0.003,再加 也只多 0.002。论文的结论是”残差映射带来的性能增益最显著,凸显了残差流内部有效信息交换的重要性”。
这个结论直接决定了 mHC 的设计取舍:要约束就约束 ,另外两个映射保持 HC 原样(只加一个轻量的非负约束)。如果三个都做大改造,既没有收益证据,又会把系统的复杂度推高。
HC 的两个致命问题
问题一:复合映射不再保持恒等映射
HC 的性能增益是真的,但它把式 里那个”干净的 1”换成了一个自由学习的矩阵。把 HC 的单层递推同样逐层展开:
和标准残差那条式子对比,第一项从 变成了 。注意 的乘法顺序:,从深层往浅层左乘,正好对应信号从第 层向前传到第 层时依次穿过每一层的残差混合矩阵。
标准残差里这个”复合映射”恒等于 ,所以浅层信号在深层处一字不改地出现。HC 里它是一个 的可学习矩阵连乘,没有任何机制保证它接近 。论文的原话是:这个复合映射”无法保持特征的全局均值”(fails to preserve the global mean of the features),随之而来的是无界的信号放大或衰减(unbounded signal amplification or attenuation),最终在大规模训练中表现为不稳定。
用数学语言说清楚一点。设 是某层的 条流。如果 是一个列随机矩阵(column-stochastic,每列和为 1,元素非负),那么:
也就是说,“所有流上的平均特征”被精确保持。这一步用到的就是列和为 1。而如果 只是行和为 1(行随机),得到的则是”每条输出流是输入流的凸组合”,保证的是逐流的范数不放大;均值反而会漂。HC 的矩阵两样都不满足——它是完全自由的,既可能把某些流放大 20 倍,也可能把它们压到接近 0。
论文用两个可测量的指标把这个现象量化了,叫 Amax Gain Magnitude(最大增益幅度):
- 前向指标:复合矩阵的行和绝对值最大值 。之所以是行和,是因为矩阵的 -范数(诱导范数)正是最大绝对行和,,而 ——它衡量的是”前向传播中最坏情况下信号能被放大多少倍”。
- 后向指标:复合矩阵的列和绝对值最大值 。反向传播时梯度经过的是 ,而 恰好等于 的最大绝对列和。
在 27B 模型上实测,HC 的复合映射 Amax Gain Magnitude 峰值达到 3000 左右。3000 是什么概念?如果复合映射等价于每层均匀放大 倍,那么 意味着 ——每层只要平均多放大 14%,累积 61 层就是三个数量级的爆炸。而因为矩阵是自由学习的,它要么整体偏大(前向炸),要么整体偏小(梯度消失),两种失败模式在训练中都不罕见。
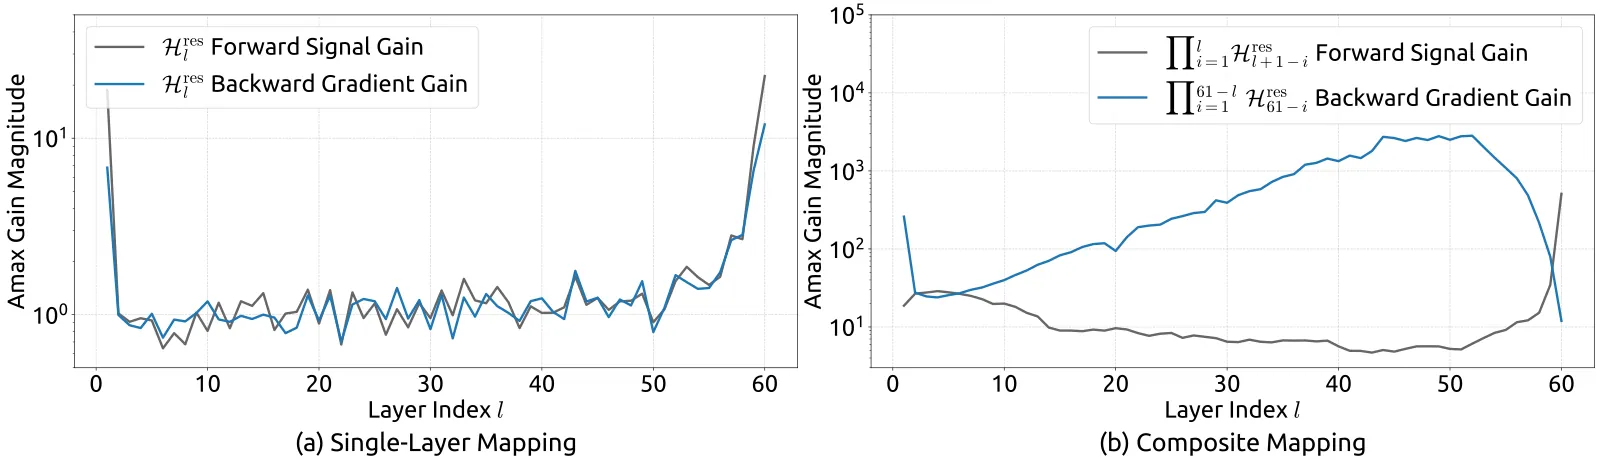
图:HC 的传播不稳定性,论文图 3。(a) 单层映射 的前向信号增益(灰)与后向梯度增益(蓝)随层索引变化,基本在 1 附近抖动;(b) 复合映射 的增益,注意纵轴是对数刻度——后向梯度增益从第 10 层之后一路爬升,在 40 到 55 层区间达到 量级,峰值约 3000。横轴 把每个标准 Transformer 块展开成 Attention 与 FFN 两个独立层,因此 30 层的 27B 模型在这里对应到 61 个子层。(图片来源:mHC 论文)
这张图是整篇论文最有说服力的一张。左图 (a) 说明单层没问题:每一层自己的 增益都在 1 附近波动,最坏也就是十几——如果只看单层,HC 看起来完全健康。右图 (b) 说明复合起来就出事了:把 61 个子层的矩阵乘起来之后,后向梯度增益单调爬升,在第 40~55 层之间稳定在 量级。这也解释了一个容易被忽视的事实——不稳定性是深度的函数,模型越深、复合的项越多,问题越严重。这正是”扩展性受限”的确切含义:不是 HC 在小模型上不能用,而是它随深度增长的行为不可控。
损失的实测曲线也印证了这一点。论文在 27B 规模上观察到 HC 在训练到 12k 步附近出现一次意外的损失突增,并且这次突增与梯度范数的异常高度相关;作为对照的 mHC 则保持平稳。
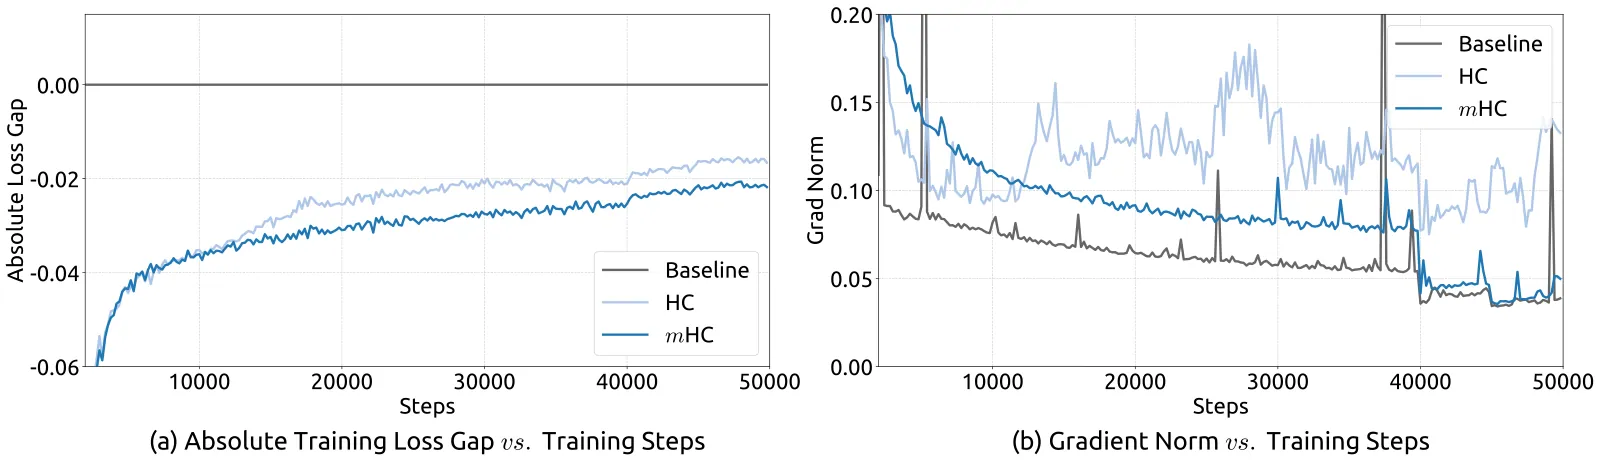
图:27B 模型上三种配置的训练稳定性,论文图 5。(a) 相对 Baseline 的绝对损失差:HC(浅蓝)在 40k 步之后明显发散,mHC(深蓝)全程稳定收敛;(b) 梯度范数:HC 在 12k~30k 步之间剧烈抖动并出现尖峰,mHC 的曲线与 Baseline 几乎重合。(图片来源:mHC 论文)
问题二:访存墙与通信放大
第二个问题不涉及数学,纯粹是系统层面的账。论文指出,现代模型架构的主要瓶颈之一是访存(I/O),也就是常说的”内存墙”(memory wall)——这个词在 FlashAttention 那篇工作是标志性的(论文引用的是 Dao 等人 2022 年的 FlashAttention)。架构设计经常忽略这一点,但访存成本对实际运行效率有决定性影响。
论文按 pre-norm Transformer 的常见实现,逐项统计了每个 token 在单个残差层里维持残差流所需的访存元素数(不含层函数 内部的访存):
| 方法 | 操作 | 读(元素数) | 写(元素数) |
|---|---|---|---|
| 残差连接 | 残差合并 | ||
| 超连接 HC | 计算 | ||
| 应用 | |||
| 应用 | |||
| 应用 | |||
| 残差合并 | |||
| 总计 |
代 进去:HC 每 token 每层要读 个元素、写 个元素,而标准残差层只读 、写 。读放大了大约 10 倍。注意这里还没算 内部的访存——也就是说,即便 的处理量完全没变,光是”把加宽的残差流搬进搬出”这一件事,就足够把训练吞吐吃掉了。论文的说法是:如果不用融合 kernel 去缓解,这样的 I/O 需求会显著降低训练吞吐。
三个衍生成本还在后面排着:
显存。、、 都带可学习参数,它们的中间激活必须在反向传播时用到,于是必须存下来。流宽变成 倍,这部分激活也跟着涨,往往要动用梯度检查点(gradient checkpointing)才能把显存压到可接受范围。
通信。在流水线并行中,stage 之间传递的激活就是残差流本身,流宽变 倍就意味着通信量变 倍。通信量涨了,流水线气泡(bubble)变大,吞吐进一步下降。
两者叠加:既要多存激活,又要多传数据,还要多读写 HBM——HC 在 FLOPs 账面上”免费”,但它把成本全转嫁到了带宽和容量上。
mHC 的核心思想:把残差混合矩阵投影到双随机流形上
为什么不能直接令
看到”复合映射不再保持恒等”这个问题,最直接的解法是回到起点:干脆令 。这样复合映射恒为 ,一切稳定性问题消失。
但论文明确否定了这条路:原始的恒等映射”从根本上排除了残差流内部的信息交换”,而信息交换恰恰是多流架构的价值所在。上一节的消融表已经证明了这一点——把 关掉换成 ,性能增益从 −0.027 直接掉回 0.0。换句话说, 就是 HC 的收益来源,也是 HC 的不稳定来源,二者是同一个东西。
所以 mHC 要解决的问题不是”要不要 “,而是:能不能找到一个矩阵集合,它既允许流之间充分交换信息,又保证复合之后不会失控?
Birkhoff 多面体与三条性质
论文的答案是双随机矩阵(doubly stochastic matrix):元素非负、每行之和为 1、每列之和也为 1。把 约束在这个集合上,记作 ,形式化定义为
三个条件逐个读:( 是全 1 的 维向量)说的是行和为 1,即矩阵右乘全 1 向量得到全 1 向量; 说的是列和为 1; 是逐元素非负。这个集合 在数学上有名字,叫 Birkhoff 多面体(Birkhoff polytope)。
一个漂亮的边界情形:当 时,这三个条件退化成一个标量必须等于 1,即 ——标准残差连接恰好是 mHC 在 时的特例。这说明 mHC 不是对残差的背离,而是把残差连接”嵌入”进了一个更大的、按 分层的矩阵族: 是残差, 是 mHC。这个嵌套关系在后面解释稳定性时还会用到。
论文给出了双随机约束带来的三条性质,我把它们逐条展开。
性质 1:范数保持(Norm Preservation)。 双随机矩阵的谱范数不超过 1,即 。谱范数(最大奇异值)是矩阵对向量 范数的最大放大倍数,。它 意味着这个线性映射是非扩张的(non-expansive):任何向量的 长度经过它都不会变长。
这个结论可以一行推出来。对双随机矩阵,诱导 1-范数 就是最大列和,等于 1;诱导 -范数 就是最大行和,也等于 1。而谱范数被这两者夹住:
这一步用的是矩阵范数的内插不等式(等价于 Hölder 不等式在矩阵上的形式)。因此信号经过任意一层都不会在 意义下被放大。
性质 2:乘法封闭(Compositional Closure)。 两个双随机矩阵相乘仍是双随机矩阵。验证只要三行:;;非负矩阵相乘仍非负。既然每一层的 都在这个集合里,那么任意深度的复合映射 也一定落在这个集合里。性质 1 于是对任意深度自动成立——这才是真正的关键:不是”每层不放大”,而是”任意多层叠起来也不放大”。HC 恰恰缺的就是这一条,因为自由矩阵的乘积依旧是自由矩阵,范数没有任何界限。
性质 3:Birkhoff 多面体的几何解释。 集合 是置换矩阵的凸包(convex hull of permutation matrices)——这就是 Birkhoff–von Neumann 定理。它的含义很直观:任何一个双随机矩阵都可以写成 ,其中 是置换矩阵(每行每列恰有一个 1,其余为 0), 且 。代入残差混合:
也就是说,残差混合等于”若干种流重排方式的加权平均”。置换不改变任何一条流的内容,只改变它在哪条车道上;加权平均则是把重排结果按权重融起来。这解释了为什么论文说”重复施加这类矩阵会单调地增加流之间的混合程度,起到稳健的特征融合作用”——每次乘一个双随机矩阵,都是在原有混合基础上再做一次凸平均,混合只会更均匀,不会出现某一维被无限放大的通道。回到 的特例:那时唯一的置换矩阵就是 ,凸包退化成单点 ,也就是恒等映射。
均值守恒与范数正则化的推导
论文说 表现为”输入特征的凸组合”,这句话值得展开确认,因为它同时给出了均值守恒和范数正则化两个结论。
设 的 行分别是 条流。 双随机、非负、行和为 1,于是输出第 行是
这是一个标准的凸组合:输出流的每个元素都落在输入流对应元素的凸包内。凸组合的两个直接推论:
- 逐元素有界:,对任意通道 成立。这条比”谱范数 “更细——它说的是逐坐标都不会越界,是比整体范数更硬的约束。
- 均值守恒:因为列和也为 1,,前面已经推过。流上的平均特征在第 层和第 层完全相同。
这两条合起来就是论文说的”良态的信号传播:特征均值被保持,信号范数被严格正则化,有效缓解了信号消失或爆炸的风险”。注意这里的逻辑链条是:非负 → 凸组合 → 均值守恒 + 有界;缺了非负这一条,凸组合就不成立,前面那两条会一起失效。
输入/输出映射的非负约束
论文对 和 也加了约束,但只是非负约束,没有要求行列和为 1:
其中 是 Sigmoid 函数,、 是未经约束的原始输出。Sigmoid 的值域是 ,所以 的每个元素落在 内; 的值域是 ,中心在 对应的 1。
论文给的理由是:“这一约束防止了正负系数复合造成的信号相消”,并且把它也看作一种特殊的流形投影。这一点值得单独强调,因为它和残差映射的约束是两种不同性质的约束: 上的双随机约束同时管住了”非负”和”守恒”两件事,而 只做非负——因为它们本来就要做降维/升维,行列和为 1 在形状上根本不成立( 和 的形状没法同时满足两侧归一化)。
那 前面的 2 是哪来的?一个自然的解释是保持恒等参照:当原始 logit 为 0 时 ,对应”把层函数输出按 1:1 的权重写回每条流”,这与 HC 消融实验里”关掉 就用全 1 权重”的参照系一致; 那一侧同理, 的均匀读出权重落在 值域的内部。换句话说,两个映射的约束形式选得让”恒等/均匀参照”恰好是可到达的、且位于值域内部的点,而不是被挤在边界上。
Sinkhorn-Knopp:如何把一个任意矩阵投到双随机矩阵上
约束定义好了,接下来的问题是怎么把任意一个 的矩阵投上去。这是 mHC 工程实现的核心调用,也是论文里唯一一个需要迭代求解的算子。
从”归一化”到”熵投影”
论文给的算子叫 Sinkhorn-Knopp,引自 Sinkhorn 与 Knopp 1967 年发表在 Pacific Journal of Mathematics 上的经典文章 “Concerning nonnegative matrices and doubly stochastic matrices”。论文对该算子的描述是两步:
“The Sinkhorn-Knopp(·) operator firstly makes all elements to be positive via an exponent operator and then conducts iterative normalization process that alternately rescales rows and columns to sum to 1.”
第一步是指数化:给定原始矩阵 ,先算
这里的 是逐元素的(论文写法就是用普通的 记号)。这一步把所有元素(包括负的 logit)映到严格正数上,解决了非负约束;同时它保留了原始矩阵的序信息——原来大的元素指数化之后还是大的,相对大小的排序不变。
第二步是交替归一化,把行和、列和轮流拉回 1:
其中 和 分别表示行归一化和列归一化。把它们写成显式形式更清楚:
把每一行除以它自己的行和,做完之后行和全部变成 1; 把每一列除以它自己的列和。一次 之后行和已满足,但列和被打乱;再做一次 把列和拉回来,行和又被打破。这就是为什么必须交替迭代——单独一次归一化永远只能满足一侧。
论文给出的收敛结论是:
并且明确说明实验中取 作为实用值。
伪代码大致长这样:
输入:原始残差混合矩阵 H_tilde ∈ R^{n×n},迭代次数 t_max输出:近似双随机矩阵 H_res ∈ R^{n×n}
M = exp(H_tilde) # 逐元素指数化,保证严格为正for t in 1 .. t_max: row_sum = M.sum(dim=1, keepdim=True) # 每行的和,形状 n×1 M = M / row_sum # T_r:行归一化,行和变为 1 col_sum = M.sum(dim=0, keepdim=True) # 每列的和,形状 1×n M = M / col_sum # T_c:列归一化,列和变为 1return M # 此时行和列和都近似为 1,且元素 > 0最后一行返回时,矩阵刚刚做完一次列归一化,所以列和精确为 1,行和则带着上一轮回合残留的一点偏差——这一点在论文的稳定性分析里被明确观测到了(后面细说)。
对”熵投影”(entropic projection)这个说法,补一点背景。Sinkhorn-Knopp 迭代本质上求解的是这样一个问题:在所有非负矩阵里,找那个”最接近” 、同时满足行列和为 1 的矩阵,距离用广义 KL 散度衡量。它最经典的解法叫迭代比例拟合(IPF,iterative proportional fitting),而交替行列归一化正是 IPF 在这一问题上的具体形式。之所以有”熵”字,是因为 是熵的共轭势函数的梯度,把 logit 映到正数这一步本身就带着”最大熵”的味道。换个角度看:如果强行在 logit 空间做归一化(比如直接除行和),得到的东西在概率意义上没有合适的解释;而指数化之后,矩阵的每个元素可以直接读作非负权重,归一化后读作概率/混合比例——这才是”凸组合”语义能成立的前提。
为什么不是简单的行列归一化
这里有一个容易被跳过的设计决策:既然要的是”行列和都为 1”,为什么不把 和 各做一次就收工?
答案在上一小节已经埋好了:一次交替到不了不动点。做完 之后行和是 1,做 之后列和是 1,但此时行和已经不是 1 了。只有当迭代进入不动点()时,行列和才同时严格为 1。所以”两次归一化”给的只是一个近似,而且这个近似有多好完全不受控——它依赖矩阵本身的形状。迭代到一定轮数,是在用确定的计算量把”双随机”这个前提买到手。
第二个原因在于非负性必须显式保证。如果拿到的 里有负数,直接除行和得到的是一个”行和为 1 但含负元素”的矩阵。这种矩阵看起来像归一化了,但它既不是双随机矩阵,也不满足上一节推的那套”凸组合 → 均值守恒 + 逐元素有界”的论证——负系数的组合会造成信号相消(signal cancellation),正是论文在 上加非负约束时明确要防的东西。 这一步把负元素变成正的小量,从源头上堵住了这个问题。
第三,指数化让整个算子可微且平滑。 处处可导, 是除法(在其定义域内可导),于是整个投影可以端到端反向传播。论文 §4.3.1 里专门提到他们为 Sinkhorn-Knopp 迭代写了自定义的反向 kernel——这也间接说明这个算子确实在前向/反向计算图里。
顺带一提另一个”看似更简单”的方案:为什么不用 softmax?softmax 确实能一次性给出非负且和为 1 的向量,但它归一化的是单个向量的维度。如果对矩阵的每一行做 softmax,得到的是行随机矩阵;对每一列做 softmax,得到的是列随机矩阵;两者不能同时满足。要行、列两个方向的约束同时成立,就必须在矩阵层面做交替投影——这正是 Sinkhorn-Knopp 的适用场景。
为什么取
直接决定投影的精度和开销:迭代越多,得到的矩阵越接近真正的双随机矩阵,但前向的开销线性增长,反向还要把整个迭代过程重算一遍(论文 §4.3.1 明确写了”for the backward pass, we derive a custom backward kernel that recomputes the intermediate results on-chip and traverses the entire iteration”)。所以每次把 翻倍,代价是实打实的。
是论文在”精度够用”和”开销可控”之间选的实用值,而且这个选择的后果被明确量化了。论文 §5.4 的稳定性分析说:
理想情况下,单层映射满足双随机约束,前向信号增益和后向梯度增益都应等于 1。但用 Sinkhorn-Knopp 算法做实际实现时,为了计算效率必须限制迭代次数。在他们的设置里用 20 次迭代得到近似解,结果是图 7(a) 中后向梯度增益略微偏离 1。
偏离有多大?论文给了具体数字:复合映射上的偏离会增大,但仍然有界,最大值约 1.6。对比 HC 的 3000,这是三个数量级的改善。
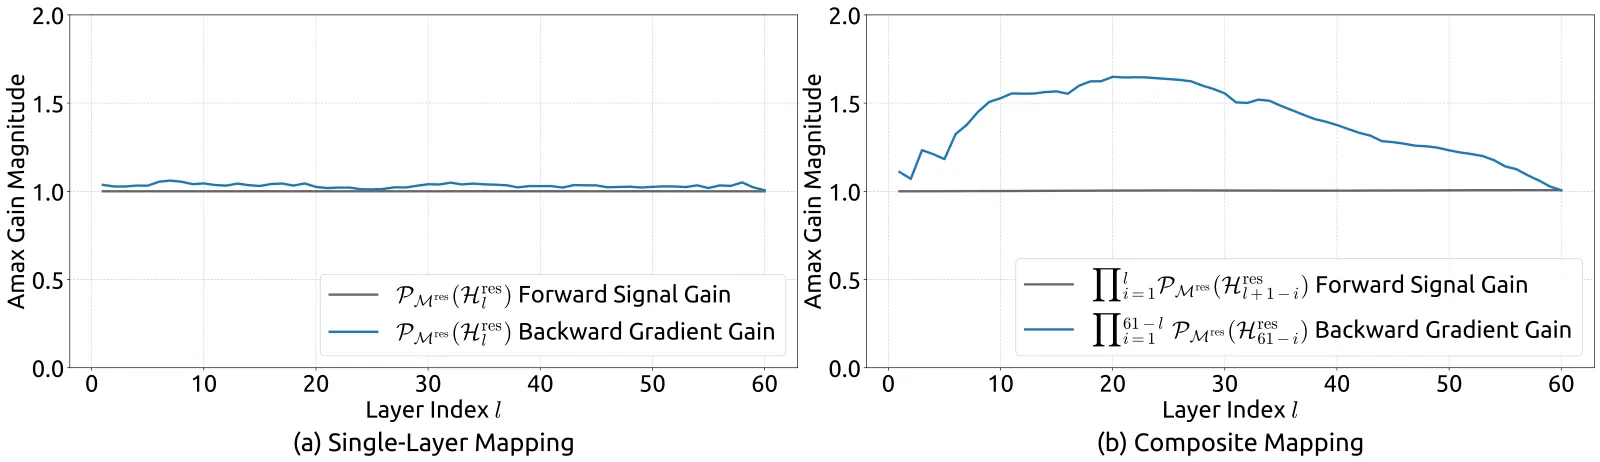
图:mHC 的传播稳定性,论文图 7。(a) 单层映射 :前向信号增益(灰)与后向梯度增益(蓝)都紧贴 1.0,只在迭代未完全收敛的后向增益上有极轻微的偏离;(b) 复合映射:与 HC 图 3(b) 同一个纵轴尺度(0 到 2、横轴 0 到 61 子层),后向梯度增益最高爬到约 1.6,全程有界。两张图与 HC 版本对比,横轴范围一模一样,纵轴从 的对数刻度变成了 2 —— 这就是”降低三个数量级”在图上的样子。(图片来源:mHC 论文)
把 HC 和 mHC 的映射矩阵直接画出来看更直观:
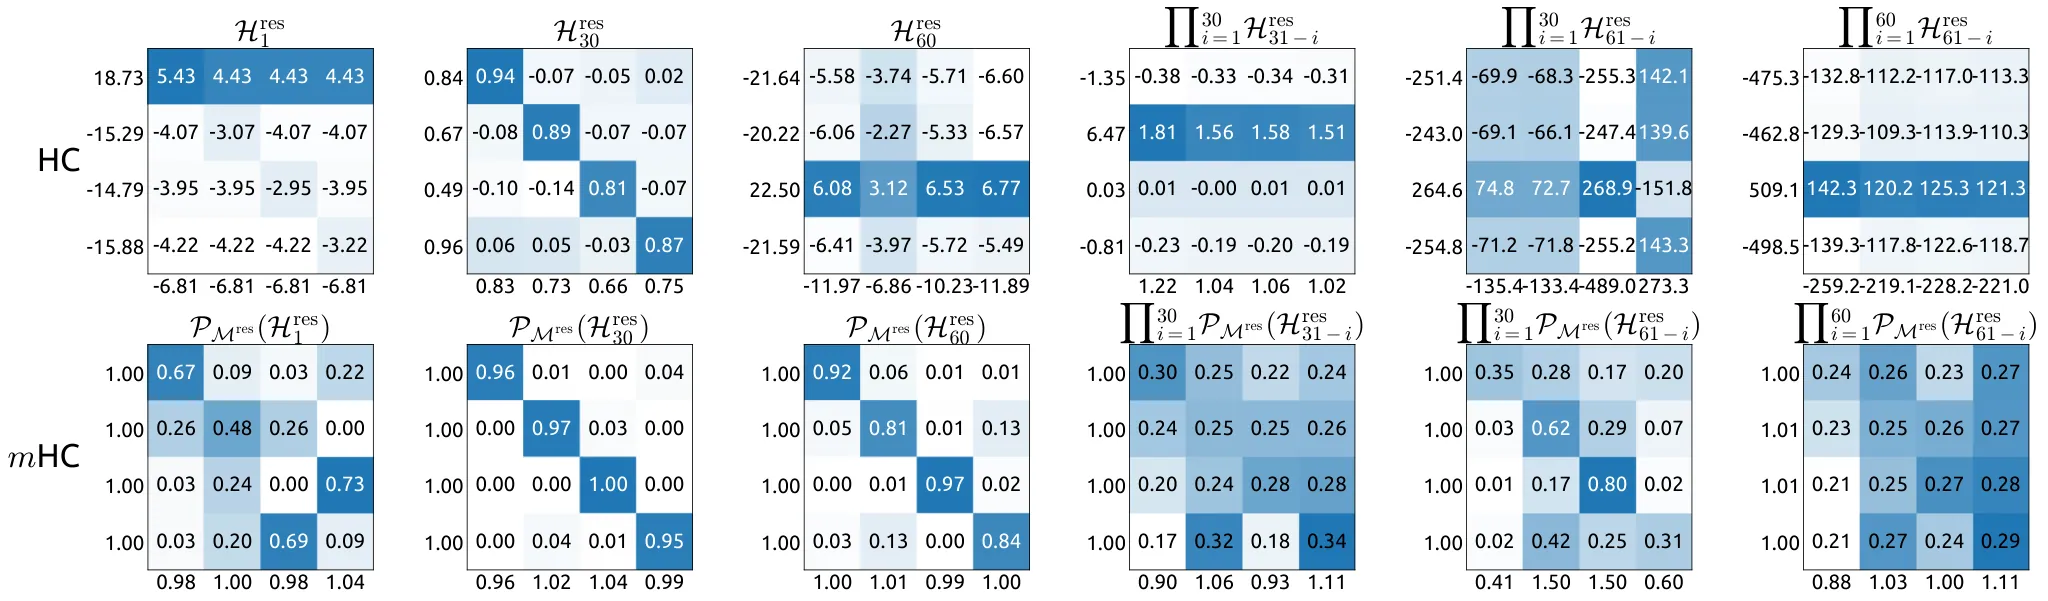
图:可学习映射的可视化,论文图 8。第一行是 HC,第二行是 mHC;六列分别是单层的 、、,以及 30 层、30 层跨段、60 层的复合映射。矩阵按 token 平均得到。横轴标注的是后向梯度增益(列和),纵轴标注的是前向信号增益(行和)。(图片来源:mHC 论文)
这张图信息量极大,值得逐块读。第一行 HC:单层的 里就出现了 、 这种量级的元素,行和标到 、列和标到 ;到 更夸张,元素绝对值到 、,行和到了 ;再看复合映射那一侧,第 4 列(30 层复合)的元素已经到了 、,第 5 列(跨段 30 层复合)出现 、,第 6 列(60 层复合)干脆到 、,行列和的标注值是 、、、。论文的观察是:“对 HC 来说,当最大增益很大时,其他值也往往很大,说明所有传播路径上都是普遍的不稳定。”
第二行 mHC:所有元素都是正的小数。单层 的行和列和都精确标成 1.00(如 ), 是 ——这已经非常接近双随机。复合映射的偏差大一些:60 层复合的列和是 ,跨段 30 层复合最坏的那一列标到 ——正是论文说的”约 1.6”的来源。但注意这里的关键差异不是数值大小,而是符号和有界性:HC 的复合矩阵元素可以正负几百万地抵消,列和可以是负数(意味着后向梯度经过它会被反向放大);mHC 的复合矩阵每个元素非负、行列和都在 1 附近的正数区间,最坏也只是 1.5 倍的放大。
参数化:动态映射、静态映射与门控
mHC 保留 HC 的动态映射/静态映射框架,但做了两处关键改动,对应论文的式 (7) 和式 (8)。给定第 层的隐藏矩阵 :
改动一:把流矩阵展平。 是把 的流矩阵拉成一条 维向量。对比 HC 的 :HC 里第 行系数只与某个流做内积,而 mHC 里展平之后 的每一列都能看到全部 条流的信息。论文把这个改动的理由写成”to preserve full context information”,即保留完整上下文信息。这在直觉上合理: 是要在流之间做混合的算子,决定”第 条流该给第 条流多少权重”时,理应参考全部 条流的当前状态,而不是只看其中一条。
是形状还原函数,把 的向量 reshape 成 。
改动二:去掉 ,把约束交给下游。 HC 里 充当软约束,把动态部分压在 ;mHC 里线性投影后面直接乘门控 ,然后交给 或 Sinkhorn-Knopp。这是一个分工上的调整:既然最后会有一个真正把矩阵投到流形上的算子,前面的 tanh 就多余了——它只会限制表达能力,却不能提供任何可证明的保证( 只保证逐元素有界,管不了行列和与复合行为)。把有界性交给 、把守恒性交给 Sinkhorn-Knopp,每一层约束都有明确的数学含义。
三个投影矩阵的形状分别是 和 。把它们拼成一个大矩阵 的话, 时列数是 。mHC 每层新增的可学习参数就是 量级(外加 个静态偏置和 3 个门控标量 ),而这个量级在维度 数千、层内还挂着 MLA 与 MoE 的模型里完全可以忽略。论文在介绍 HC 时也说过类似的话:“引入这些映射带来的计算开销可忽略,因为典型扩展率 例如 4,远小于输入维度 。”
顺带说明初始化的作用: 初始化为 ,意味着训练开始时门控几乎关死,,动态部分几乎不起作用;而静态偏置 初始化为接近单位矩阵/均匀权重的值。这样一来,训练初期模型的行为接近标准残差连接,稳定性最好,然后随着 学习增大逐步引入流间混合。HC 论文附录里讨论过初始化策略,mHC 沿用”小 “的思路,并把它与投影算子组合成一套完整的”训练早期近乎恒等”的启动方式。
系统优化(一):Kernel 融合与 TileLang 混合精度核
数学上把稳定性问题解决了,但上一节算过的那笔访存账还在: 时每 token 每层读 、写 个元素,相比之下标准残差层只读 写 。论文在 §4.3 的开头就说得很直白:通过这些基础设施优化,mHC()在大规模模型上的额外训练开销只有 6.7%。下面三节把这三件事拆开讲。
第一件事是 kernel 融合(kernel fusion)。论文给出的思路是:既然 、、 三者共享同一份输入 ,那就应该只读一次,用一个 kernel 把它们全部算出来。
先看一处很妙的等价改写。原始的 HC 写法里,动态映射要先对 做 RMSNorm,再乘投影矩阵:
由于 RMSNorm 是”除以范数”再乘一个逐元素权重,而”除以范数”是一个标量:(这里 是逐元素的可学习权重)。标量可以提到矩阵乘法外面:
论文的做法正是如此:“观察到 mHC 里的 RMSNorm 作用在高维隐状态 上会带来显著延迟,我们把’除以范数’的操作重排到矩阵乘法之后。这个优化保持数学等价,同时提升效率。“这在系统上意味着:先用矩阵乘法单元处理未归一化的输入(GEMM 效率最高),把归一化作为一个廉价的逐元素后处理,而不是先做一次昂贵的归一化(要多读多写一遍 的数据)再做矩阵乘法。论文的式 (14)~(16) 就是这条流水线的三段:
注意这里把三个映射的投影参数拼成了一个矩阵 ,一次 GEMM 同时算出三者的未缩放结果。 是 RMSNorm 的缩放因子( 是归一化的分母常数,对应”均方根”的定义); 是把三个静态偏置拼在一起的结果;论文还特别说明”RMSNorm 的权重也被吸收进了 “,也就是把 折进了投影矩阵——这又是减少一次逐元素乘法的常规手法。
接着是三个约束算子各自的 kernel:
论文对这三步的处理是:“这些作用在小系数上的轻量操作被顺手融进单个 kernel,显著减少 kernel 启动开销。“确实, 只有 个元素, 也是 4 个, 是 个——比起 量级的隐状态,这些是微不足道的计算量,但它们一个一个单独启动 kernel 的固定开销并不小。而 Sinkhorn-Knopp 因为有 20 轮迭代,被实现为单个 kernel 内完成的完整迭代;反向传播则”推导了自定义反向 kernel,在片上重算中间结果并遍历整个迭代过程”——这既省显存(不存 20 轮中间矩阵),又避免多次 kernel 启动。
混合精度的分工写在论文的式 (10)~(13):
| 张量 | 精度 | 形状 / 说明 |
|---|---|---|
| tfloat32 | ,投影参数 | |
| bfloat16 | ,隐状态 | |
| float32 | 标量门控 | |
| float32 | ,静态偏置 | |
| 中间结果与输出 | float32 | 见式 (14)~(19) |
这套分工的逻辑很清晰:唯一的”大矩阵乘法”()用 tfloat32 与 bfloat16 混合做,把算力吃满;而所有小尺寸但数值敏感的量——门控标量、静态偏置、以及要被 Sigmoid 和 Sinkhorn-Knopp 处理的中间结果——全部保持 float32。因为 只有 24,用 float32 存它们的代价微乎其微;但如果让 Sinkhorn-Knopp 在 bfloat16 上迭代 20 轮,误差会被反复放大。相比之下, 用 bfloat16 是安全的:它只参与一次矩阵乘法,结果立刻被提升到 float32。论文对这套设计的总结是”用混合精度策略在不牺牲速度的前提下最大化数值精度”。
最后是应用阶段的融合。系数算出来之后,还要用它们去作用:(读出)和 (写回并混合)。论文把 和 的应用与残差合并融到了同一个 kernel 里,效果是:
代 :读从 降到 ,写从 降到 。对照上一节 HC 那张总账(读 、写 ),融合之后每层的实际访存已经回到和残差连接同一个量级了——这就是”6.7%“从哪来的核心答案:不是算法变便宜了,而是把本该发生的内存流量直接消掉了。
论文还交代了一个工程细节:“除了式 (14)~(15) 之外,我们的大部分 kernel 都是用 TileLang 高效实现的。“TileLang 是 2025 年提出的一套分块(tile)编程模型(arXiv:2504.17577),它让开发者用接近 Python 的语法描述分块级别的数据流,由编译器负责生成高效代码。论文对选它的理由是:“这个框架简化了复杂计算流程的 kernel 实现,让我们用最少的工程量把内存带宽吃满。“——典型的”手写 CUDA 成本高、通用编译器优化不够”的中间路线。
系统优化(二):选择性重计算与最优重算块大小
第二件事是选择性重计算(selective recomputing)。动机是显存: 条流的激活比单条流大 倍,全部存下来做反向传播是不现实的。论文的方案是:“在前向传播之后丢弃 mHC kernel 的中间激活,在反向传播中即时重算——重新执行 mHC 的 kernel,但不执行那个沉重的层函数 。”
这句限定语非常关键:重算的只是 mHC 那几个轻量 kernel,不重算 。 是 Attention/FFN,它的重算是梯度检查点的全部成本所在;而 mHC kernel 只涉及 维向量的几次矩阵乘法和一个 上的 Sinkhorn 迭代,重算便宜得多。用一个廉价的算子重算,换掉一批昂贵的激活存储,这笔账划算。
论文的表 3 列出了反向传播需要的激活,以及各自是”存”还是”重算”:
| 激活 | 大小(元素数) | 处理方式 |
|---|---|---|
| 每 层存一次 | ||
| 每层都存 | ||
| 在 层内是临时量(transient) | ||
| 在 层内是临时量 | ||
| 在 层内是临时量 |
表示这 层连续层里的第一层。读法是:每 层只在最开头存一个 的流矩阵 ,中间所有层的 量级激活都只在当前块内短暂存在;而 的输入输出( 量级,比 小 倍)每层照存不误,因为它重算太贵。这就是”选择性”三个字的含义——按重算成本的高低,选择不同的保留策略。
于是显存占用分成两部分:常驻部分 (总共 层,每隔 层存一个 )和临时部分 (当前活跃块内需要同时驻留的量,它决定了反向传播的峰值显存)。论文把 的最优值写成:
这个式子值得拆开看。第一项随 增大而减小(块越大,需要常驻的 越少, 是常驻块数);第二项随 增大而线性增大(块越大,块内临时量越多)。一个反比项加一个正比项,最优点就在两者大致相等处——把 近似成连续的 ,对 求导令其为零:,解出 ,即 。
代 、(27B 模型)进去:。论文接着指出一个约束:“大规模训练中的流水线并行有一个限制——重算块不能跨越流水线 stage 的边界。“而实践中他们发现,理论最优的 通常正好与每个流水线 stage 的层数对齐,于是干脆”把重算边界与流水线 stage 同步”。这是个很务实的收尾:不为了追求那个 的小数点而破坏流水线结构,而是取一个结构上自然、性能上接近最优的整数。 这个上取整也说明,当 不整除 时会浪费一点显存,取整本身也在推动设计向”整齐切分”走。
系统优化(三):在 DualPipe 调度里把通信藏起来
第三件事是通信重叠。大规模训练用流水线并行来分摊参数和梯度显存,DeepSeek 在 V3 里用的是自家的 DualPipe 调度(论文引用的 Liu et al., 2024b 就是 DeepSeek-V3 的技术报告)。DualPipe 的核心能力是”有效地重叠 scale-out 互连上的通信流量,比如专家并行和流水线并行里的那些”。
问题在于:mHC 让流水线 stage 之间传递的激活变成了 倍,通信延迟因此显著上升;同时,在 stage 边界处要为 层全部重算 mHC kernel,这又是一块不可忽视的计算开销。两件事叠在一起,正好压在最需要重叠的边界上。
论文的应对是”扩展 DualPipe 调度”,在流水线 stage 边界处更好地重叠通信与计算:
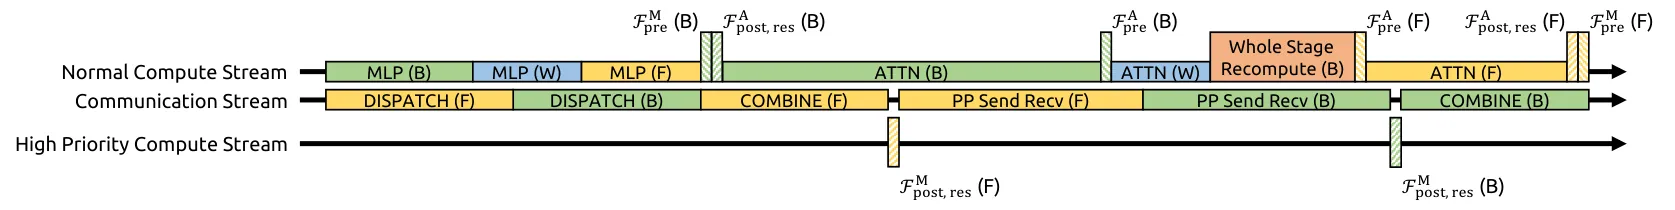
图:mHC 的通信-计算重叠,论文图 4。三条时间线从上到下分别是普通计算流、通信流和新增的高优先级计算流。色块标注了正在执行的内容:(F) 前向、(B) 反向、(W) 权重梯度计算; 与 分别代表 Attention 和 MLP(FFN)对应的 kernel。注意最下方那条独立的”High Priority Compute Stream”上只挂了两个小方块—— 和 ,即 MLP 层的 post/res 融合 kernel。图中各块长度仅作示意,不代表实际时长。(图片来源:mHC 论文)
图里有两个值得点出的设计决策。
决策一:把 MLP 的 kernel 放到独立的高优先级计算流上。 论文的原话是:“为了防止阻塞通信流,我们在一条专用的高优先级计算流上执行 MLP(即 FFN)层的 kernel。“看看图就明白了——通信流那条线上排满了 DISPATCH、COMBINE、PP Send Recv 这些通信块,中间几乎没有空隙。如果一个计算 kernel 和它抢同一个流的资源,通信就会被推迟,而通信延迟在流水线里会直接转化成气泡。给它一条高优先级的独立流,意味着它可以抢占、插队,把通信的等待时间填满。
决策二:Attention 层不用持久化 kernel(persistent kernel)。 论文的理由是:“我们进一步避免在 Attention 层对长耗时操作使用持久化 kernel,从而防止长时间的停顿。这一设计让重叠的注意力计算可以被抢占,允许灵活调度,同时保持计算设备处理单元的高利用率。“持久化 kernel 的优点是省去反复启动的开销、便于常驻资源,但它的缺点是一旦启动就会长时间占住 SM 不放,无法被打断——这在需要灵活插入通信或其他 kernel 的调度里是致命的。换个角度看,DeepSeek 在别的地方是持久化 kernel 的积极使用者(比如 DeepEP 完全拆解里的低延迟 kernel、DeepGEMM 完全拆解里的常驻 JIT kernel 设计),所以这里”反其道而行”是一个针对调度场景的明确定位取舍,而不是风格问题。
还有一处被顺手解决的问题:“重算过程与流水线通信依赖解耦了,因为每个 stage 的初始激活 本来就缓存在本地。“——这正是上一节那个”每 层存一个 “的设计带来的额外好处:重算需要的起点在本地就有,不用等通信。两条优化在这里咬合上了。
实验结果
实验设置
论文用语言模型预训练来验证,对比三个配置:Baseline(标准残差连接)、HC、mHC。模型是受 DeepSeek-V3 启发的 MoE 架构,注意力用 MLA,位置编码用 RoPE,归一化用 RMSNorm。HC 和 mHC 的扩展率都设为 。
一共训了四个模型变体:
| 属性 | 3B | 9B | 27B | 3B(1T token) |
|---|---|---|---|---|
| 词表参数 | 331M | 496M | 662M | 331M |
| 激活参数 | 612M | 1.66B | 4.14B | 612M |
| 总参数 | 2.97B | 9.18B | 27.0B | 2.97B |
| 层数 | 12 | 18 | 30 | 12 |
| 路由专家数 | 64 | 64 | 72 | 64 |
| 激活专家数 | 6 | 6 | 6 | 6 |
| 共享专家数 | 2 | 2 | 2 | 2 |
| 隐藏维度 | 1280 | 1920 | 2560 | 1280 |
| FFN 维度 | 896 | 1280 | 1536 | 896 |
| 注意力头数 | 16 | 24 | 32 | 16 |
| 注意力维度 / KV 秩 | 128 / 512 | 128 / 512 | 128 / 512 | 128 / 512 |
| 序列长度 | 4096 | 4096 | 4096 | 4096 |
| 词表大小 | 129280 | 129280 | 129280 | 129280 |
| 批大小 | 320 | 512 | 1280 | 2560 |
| 训练步数 | 30000 | 50000 | 50000 | 100000 |
| 训练 token 数 | 39.3B | 105B | 262B | 1.05T |
| 基础学习率 | 8.6e-4 | 5.9e-4 | 4.0e-4 | 9.0e-4 |
| mHC/HC 扩展率 | 4 | 4 | 4 | 4 |
| 门控初值 | 0.01 | 0.01 | 0.01 | 0.01 |
| Sinkhorn-Knopp | 20 | 20 | 20 | 20 |
四个变体的分工是:27B 模型是系统级主结果的主角,用与其参数量成比例的数据量训练;3B 和 9B 用于观察算力缩放行为(三个规模、各自算力最优的配置点);单独的 3B 模型在 1 万亿 token 的固定语料上训练,用来单独考察 token 缩放。优化器统一是 AdamW,、、权重衰减 0.1,2000 步预热,学习率用分段衰减(衰减步比例 ,衰减率 )。
主结果:8 个下游基准
27B 模型在 8 个基准上的表现(全部来自论文表 4):
| 基准 | BBH | DROP | GSM8K | HellaSwag | MATH | MMLU | PIQA | TriviaQA |
|---|---|---|---|---|---|---|---|---|
| 指标 | EM | F1 | EM | Acc. | EM | Acc. | Acc. | EM |
| 样本数 | 3-shot | 3-shot | 8-shot | 10-shot | 4-shot | 5-shot | 0-shot | 5-shot |
| 27B Baseline | 43.8 | 47.0 | 46.7 | 73.7 | 22.0 | 59.0 | 78.5 | 54.3 |
| 27B w/ HC | 48.9 | 51.6 | 53.2 | 74.3 | 26.4 | 63.0 | 79.9 | 56.3 |
| 27B w/ mHC | 51.0 | 53.9 | 53.8 | 74.7 | 26.0 | 63.4 | 80.5 | 57.6 |
三件事值得注意。
第一,从 Baseline 到 HC 是大跨步,从 HC 到 mHC 是稳中有升。BBH 从 43.8 涨到 48.9 再到 51.0,DROP 从 47.0 到 51.6 再到 53.9,GSM8K 从 46.7 到 53.2 再到 53.8。加宽残差流带来的增益是真实的,而 mHC 在把训练稳定性修好之后没有把这份增益还回去——这是整篇论文最关键的一条实证:约束不是用性能换稳定。
第二,mHC 在 8 个基准里的 7 个上超过或追平 HC,唯一低于 HC 的是 MATH(26.0 对 26.4,差 0.4)。论文的表述是”mHC 在多数基准上超过 HC”,并且特别点出”相比 HC,mHC 进一步增强了模型的推理能力,在 BBH 上提升 2.1%、在 DROP 上提升 2.3%“。BBH(BIG-Bench Hard)和 DROP(离散推理阅读理解)都是重推理的基准,这个方向上的提升与”信号传播更良态 → 深层推理能力更好”的叙事是自洽的。
第三,27B 相对 Baseline 的最终损失降低了 0.021。这个数字要和”HC 的损失曲线在 40k 步之后发散”放在一起看——HC 的最终损失更低(图 5(a) 中 HC 的曲线在 −0.02 附近波动),但那是训练崩溃之前的读数。mHC 的 −0.021 是一条平稳收敛曲线上的读数,性质完全不同。
稳定性:从 3000 到 1.6
稳定性是这篇论文的核心主张,实测数据在前面的章节已经引过,这里做一个汇总对比:
| 指标 | HC | mHC | 改善 |
|---|---|---|---|
| 复合映射 Amax Gain Magnitude 峰值 | 约 3000 | 约 1.6 | 降低约 3 个数量级 |
| 单层映射后向梯度增益 | 抖动 | 紧贴 1.0 | 稳定 |
| 损失曲线 | 12k 步附近突增,40k 步后发散 | 与 Baseline 同步平稳收敛 | 稳定 |
| 梯度范数 | 12k~30k 步剧烈抖动、尖峰 | 与 Baseline 接近重合 | 稳定 |
论文对”为什么 mHC 的复合增益是 1.6 而不是严格的 1”给了诚实的解释:双随机约束是理想目标,实际用 Sinkhorn-Knopp 时为了效率只能跑 20 次迭代,得到的是近似解。单层映射上这个近似已经很好(后向增益略微偏离 1),但复合 60 层之后偏差会累积到约 1.6。论文的措辞是”偏差增大但仍保持有界”——有界才是要点:1.6 是一个和深度无关的量级,而 HC 的 3000 是随深度增长的。
这里也能看出 与稳定性之间的直接关系: 越大,投影越精确,复合偏差越小,但反向重算的开销越高。20 是论文在这个权衡上选的点,且 1.6 这个结果说明这个点选得够用。
可扩展性:算力曲线与 token 曲线
如果 mHC 只是”在小模型上能用”,那它的意义有限。论文做了两组缩放实验:
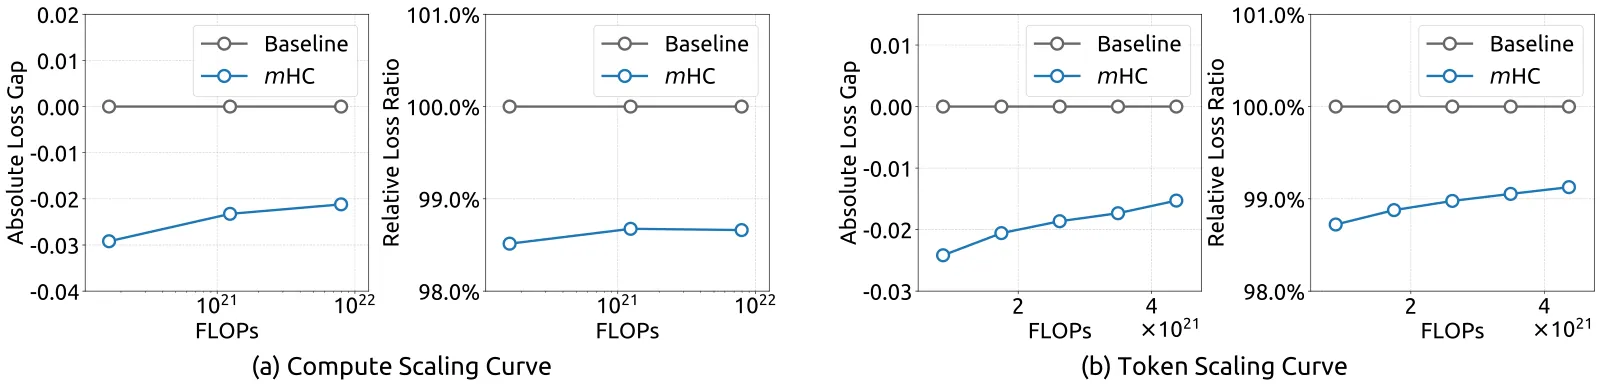
图:mHC 相对 Baseline 的缩放特性,论文图 6。(a) 算力缩放曲线:横轴是 FLOPs 的对数刻度,每个点是一个算力最优的(模型规模, 数据量)配置,从 3B、9B 覆盖到 27B,四条子图从左到右依次是更细的粒度;(b) token 缩放曲线:3B 模型训练过程中性能随 token 数变化的轨迹。(图片来源:mHC 论文)
左半部分 (a) 是算力缩放。纵轴是”绝对损失差”和”相对损失比”两种口径,横轴是 FLOPs(从 到 量级)。mHC 的绝对损失差从 3B 规模下的约 −0.029,收窄到 27B 规模下的约 −0.021;换成相对口径是从约 98.5% 收窄到约 98.7%。论文对这个趋势的描述是:“轨迹表明,即使算力预算更高,性能优势依然稳健地保持,只出现边际衰减。”——“边际衰减”是诚实的表述:优势确实在缩小,但没有消失,也没有反号。
右半部分 (b) 是token 缩放:同一个 3B 模型在训练过程中,mHC 相对 Baseline 的优势从早期约 −0.026 一路缓慢演化到约 −0.015。这条曲线看的是”训练到一半时优势是否就消失了”——答案是没有,整条轨迹上优势持续存在。
论文的说法是这两组结果”共同验证了 mHC 在大规模场景下的有效性”,并补充”这一点还被我们内部的大规模训练实验进一步证实”——这就是摘要里那句”in-house large-scale training indicates that mHC supports training at scale”的来源。
代价: 时 6.7% 的额外时间开销
论文在 §4.3 开头给的总账是:通过严格的优化,mHC 在 的大规模模型上只带来 6.7% 的边际训练开销;摘要里的说法是”内部大规模训练表明 mHC 支持大规模训练,在扩展率 时只引入 6.7% 的额外时间开销”。
把账摊开:算法层面,mHC 每层新增 量级的参数和若干次小矩阵运算,FLOPs 增量可忽略;系统层面,不做融合时访存要涨到 读、 写(),但 kernel 融合把应用阶段的读写压回 和 ,重计算把 量级的激活从常驻改成临时,DualPipe 扩展把多出来的通信藏进调度空隙。最终落到 wall-clock 上就是 6.7%。
作为一个”只改连接拓扑、不改层函数”的架构改动,这个开销换来的是:8 个基准上的全面提升(相对 Baseline),加上从”训练到 12k 步就崩”到”稳定收敛”的定性变化。论文对此的评价是”以可忽略的计算开销交付了这些改进”。
mHC 与 DeepSeek-V4 的关系
mHC 解决的是一个纯粹深度的问题:约束的收益在复合映射上才显现,而复合的长度等于网络的深度。论文的稳定性分析之所以要画到 61 个子层,就是因为要观察”任意深度之间”的复合行为——把 30 层 Transformer 块的 Attention 与 FFN 各自展开成独立层,恰好得到 这个横轴范围。前端 1~60 层还在各自阈值内,第 61 层处的复合增益才会把问题完全暴露出来。深度越深,mHC 与 HC 的差距越大——这是它的适用场景。
这正是 DeepSeek-V4 需要它的原因。V4 在架构上继续往深处和宽处推:注意力侧用 CSA + HCA 的混合结构把百万上下文做便宜(细节见 DeepSeek-V4 混合注意力完全拆解),KV Cache 侧靠 CED 因果编码器与跨层复用在推理时把每 token 的缓存压到 890 字节(见 DeepSeek-V4.1-Flash 推理侧完全拆解)。这些工作的共同前提是模型本身得训得稳——一个残差通路会在 60 层复合之后放大 3000 倍的架构,堆得越高风险越大;而 mHC 给出的是一条与深度无关的稳定上界。
论文自己在展望里也说得很清楚:mHC 作为一个通用框架,其价值不只是双随机这一个选择,而在于”把宏观架构设计重新拉回研究视野”——通过加深对拓扑结构如何影响优化与表示学习的理解,去回答当前架构的局限、并为下一代基础架构的演进指出可能路径。DeepSeek 在 V3 时代改的是微观(MLA + DeepSeekMoE + MTP),V4 时代开始在宏观连接拓扑上动手,mHC 是这条新路上的第一步。整个演进脉络可以对照 DeepSeek 技术全景 那条时间线来看。
局限与开放问题
论文没有回避几个层面的开放问题,这里客观列出。
投影是近似的,不是精确的。 Sinkhorn-Knopp 需要 才收敛到严格的双随机矩阵,实用中取 20 次迭代,因此单层映射的行列和、复合映射的增益都只是”接近 1”。实测复合增益最高约 1.6——虽然与 HC 的 3000 相比是巨大改善,但离”严格守恒”仍有距离。 与精度、开销的三方权衡没有闭式解,20 是实验选点。
约束的是残差混合矩阵,不是全部。 和 只做了 Sigmoid 非负约束,它们不满足行列和为 1(形状上也不可能),所以严格意义上的”均值守恒”只在残差混合这一步成立。整个前向传播的守恒性依赖”残差混合是唯一跨层传递路径”这个结构前提。
双随机只是一种流形选择。 论文明确说这是”确保稳定性”的一种手段,框架本身”容纳针对特定学习目标定制的多种流形约束的探索”,并预期”对不同几何约束的进一步研究可能产生更好地权衡可塑性与稳定性的新方法”。换句话说,双随机矩阵是一个有理论保证的起点,不一定是终点——候选方向包括其他具有封闭性和范数界的矩阵族。
系统优化的收益依赖硬件与实现。 6.7% 这个数字来自 DeepSeek 内部的大规模训练环境,它依赖 DualPipe 调度、专用高优先级计算流、TileLang 生成的 kernel 以及流水线并行的具体切分方式。换一套并行策略或换一代硬件,这个数字会变——论文没有给出跨平台的对比数据。
参数量与激活的额外开销没有消失,只是被压低了。 每层 量级的新增参数在 时可忽略,但 继续增大时这个量级按 增长(因为 的列数是 ),流间的 矩阵乘法和 Sinkhorn 迭代的开销也按 增长。 能推到多大是一个论文没有回答的问题——所有实验都在 上做的。
小结
把这篇论文的逻辑链条完整地走一遍:
问题的根源是残差连接里那个”1”被换成了自由学习的矩阵 。单层没问题,但 层复合之后 既不能保持特征均值,又没有范数上界,实测在 61 个子层上把后向梯度放大了约 3000 倍,训练到 12k 步就开始出现损失突增。同时, 倍的流宽把每层每 token 的访存从 读 / 写推高到 读 / 写,在 时约 10 倍。
解法是把 投影到 Birkhoff 多面体——双随机矩阵流形上。非负保证 是凸组合,行列和为 1 保证均值守恒和谱范数 ,而乘法封闭性保证这些性质对任意深度的复合映射自动成立。 时这个约束退化为标量 1,标准残差连接成了 mHC 的特例。论文对这一点讲得很清楚:它不是在”表达力”和”稳定性”之间做取舍,而是把无约束的 HC 换成一个在数学上同时具备表达力与稳定性的集合。
投影算子是 Sinkhorn-Knopp:先逐元素 把矩阵变成严格正(这一步是”熵投影”的由来,也保证了非负和可微),再交替做行归一化 和列归一化 。必须迭代而不是各做一次,因为两次归一化互为破坏,只有不动点处行列和才同时为 1。实际取 。
工程闭环由三件事构成:kernel 融合把 RMSNorm 的除法重排到矩阵乘法之后、用一次 GEMM 算出三个映射、把 与 的应用融进残差合并,使读写从 / 降到 /;选择性重计算只重算轻量的 mHC kernel 而保留昂贵的 激活,最优重算块大小 且与流水线 stage 对齐;在 DualPipe 里把 MLP 的 post/res kernel 放到高优先级计算流上、避免 Attention 用持久化 kernel,从而把多出来的通信藏起来。
结果是:8 个下游基准上 mHC 全面超过 Baseline 并在 7 个上超过 HC(BBH +2.1%、DROP +2.3% 相对 HC),27B 上最终损失比 Baseline 低 0.021,复合增益从约 3000 降到约 1.6,3B/9B/27B 的算力缩放与 3B 的 token 缩放都维持优势,代价是 时 6.7% 的额外训练时间。
最后值得记住的一点是这篇论文在方法论上的取向:它讨论的是一个纯粹的架构拓扑问题,用的是一个经典数值线性代数工具(Sinkhorn-Knopp,1967),并且全程用系统工程的账本(访存元素数、显存、通信、wall-clock 百分比)来判断设计是否成立。数学给出保证,系统给出价格,两者缺一不可。
参考资料
- mHC: Manifold-Constrained Hyper-Connections(arXiv:2512.24880)
- mHC 论文 HTML 全文(arXiv:2512.24880v2)
- Hyper-Connections(arXiv:2409.19606,字节跳动 Seed)
- Deep Residual Learning for Image Recognition(He et al., CVPR 2016)
- Identity Mappings in Deep Residual Networks(He et al., ECCV 2016)
- Concerning nonnegative matrices and doubly stochastic matrices(Sinkhorn & Knopp, 1967)
- TileLang: A Composable Tiled Programming Model for AI Systems(arXiv:2504.17577)
- DeepSeek-V3 Technical Report(DualPipe 调度出处,arXiv:2412.19437)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135)
- Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts(arXiv:2408.15664)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


