


CSBP 完全拆解:块并行如何让长上下文扩散语言模型少传无效 KV
Block Parallelism for Efficient Distributed Long-Context Diffusion Language Model Training 是 Stanford Scaling Intelligence Lab 等团队在 2026 年 9 月提交到 arXiv 的系统论文,arXiv 编号是 2609.19242。它讨论的问题非常窄:块扩散语言模型做长上下文计算时,传统上下文并行会把“干净上下文”和“当前损坏块”一起跨卡交换,但损坏块只服务自己的目标块,不值得在多张 GPU 之间来回搬。
论文提出两层方案:第一层是 Block Parallelism,简称 BP,把每个目标块的完整计算交给一个 rank;第二层是 Context-Sharded Block Parallelism,简称 CSBP,在 BP 之上继续把可复用的干净上下文切到多张卡上。这样一来,块内损坏 token 的 和梯度留在本地,只有可被多个目标块复用的干净上下文 参与跨卡通信。
这篇文章不把重点放在模型配方、优化器或数据集上,而是把 CSBP 当作一个长上下文注意力系统来拆:它为什么成立,为什么传统 CP 会传错东西,BP 为什么不够,CSBP 怎样同时解决通信和显存问题,以及实验数字到底说明了什么。
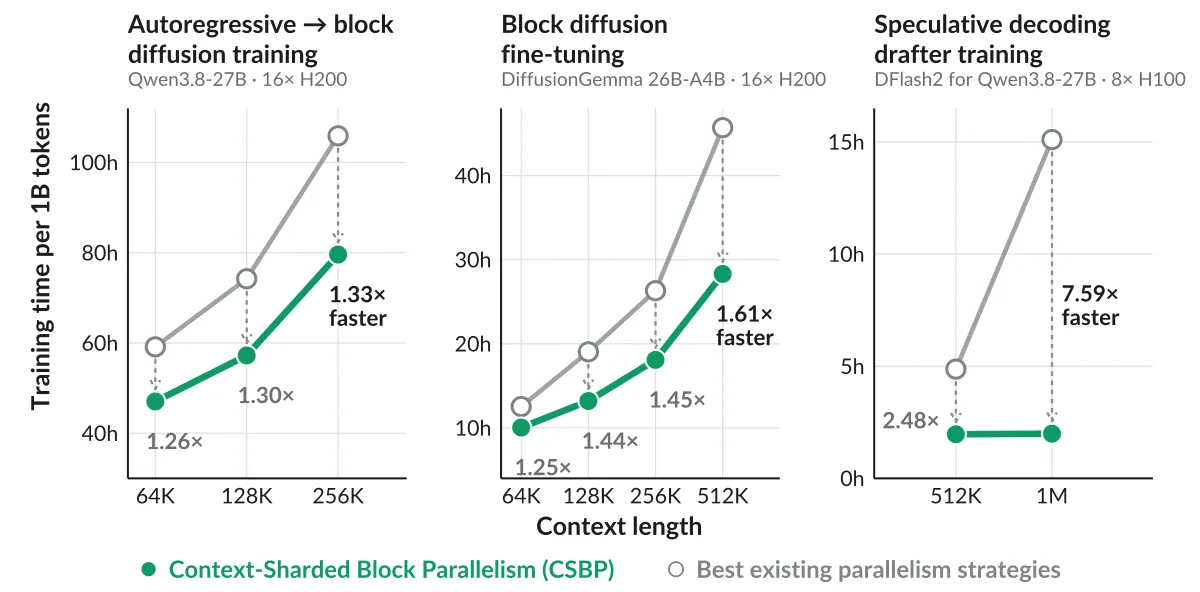
图源:论文 Figure 1,arXiv:2609.19242。图中横轴是上下文长度,纵轴是吞吐或相对吞吐,核心信息是:上下文越长,传统上下文并行越容易被无效通信拖住;CSBP 的优势随序列长度扩大。
块扩散模型到底多了哪一种并行机会
自回归语言模型的序列概率分解很熟悉:第 个 token 依赖前面所有 token。块扩散语言模型多了一层块结构。设完整序列为 ,把它切成 个连续块,每块长度为 :
这里 表示第 个块, 是总 token 数, 是块数, 是块大小。块扩散语言模型保留块与块之间的自回归依赖,但块内部用并行去噪建模:
是第 个块之前的干净前缀, 是模型参数为 的条件分布。这条式子的直觉是:第 个块仍然要看之前已经确定的上下文,但块内部的多个位置可以作为一个整体并行处理。
训练时,目标块 会被扰动成 。 是这个块采样到的噪声强度或扩散时间, 是扰动过程。论文把块扩散目标写成:
这个公式里, 是随噪声强度变化的损失权重,期望表示对不同扰动时间和扰动样本取平均。真正关键的是求和符号:总损失可以拆成每个目标块的损失之和。第 个损坏块只影响第 个损失项 ,但干净前缀 会被多个后续块复用。
这就是 CSBP 的系统切入点。普通上下文并行只看到“这是一个很长的序列”,于是按 token 位置切分;CSBP 看到的是“这条长序列里有两类 token”:一类是可复用的 clean context,另一类是只服务当前块的 corrupted block。系统应该按复用关系切,而不是按张量外形一刀切。
这个思路和推理侧的 KV Cache 优化有相似之处:不是所有 都有同样的生命周期和复用价值。自回归推理里,已提交前缀的 KV 可以长期缓存;块扩散长上下文计算里,干净前缀的 KV 可以跨多个目标块复用,而当前损坏块的 KV 是块私有状态。关于块扩散推理侧的背景,可参考站内的 DFlash 块扩散解码 和 DFlow 完全拆解。
传统上下文并行为什么会传错东西
上下文并行 CP 的出发点很合理:序列太长,一张 GPU 放不下或算不动,就按 token 位置把序列切给多张 GPU。注意力层需要让本地 query 看到全局 key/value,于是每张卡都要拿到其他卡上的 分片,算完后还要在反向传播中把 梯度送回对应 owner。
对普通因果 Transformer,这个策略是自然的。设 rank 拥有本地 query ,所有 rank 的 key 和 value 拼起来是 、,注意力输出可以写成:
是每个注意力头的维度, 是本地 query 对应的注意力 mask。CP 的任务就是让 能够访问完整的 和 ,同时尽量隐藏通信延迟。
问题出在块扩散训练的输入形态。标准实现通常会同时放入两份序列:一份 clean copy,一份 corrupted copy。clean copy 是完整干净上下文;corrupted copy 包含各目标块的损坏版本。对目标块 的 corrupted query 来说,它真正需要的 key/value 是:
是目标块 自己的损坏块 key/value; 是前面干净块的 key/value。它不需要其他目标块的 corrupted 。第 7 个块的损坏 token 不会给第 3 个块当上下文,第 3 个块的损坏 token 也不会给第 7 个块复用。
传统 CP 不理解这个语义。它把 clean 和 corrupted 两份表示拼成一个长张量,再按位置切分。于是跨卡 attention 通信里会同时出现两类流量:
- 干净上下文 :后续多个块可能都会用,跨卡交换有复用价值。
- 损坏块 :只给本块 query 用,跨卡交换通常没有复用价值。
前向传播时,CP 会交换 clean 和 corrupted ;反向传播时,它还要把 clean 和 corrupted 的 梯度都送回 position shard owner。对 BDLM 来说,后一类通信很尴尬:数据被传出去了,但别的块基本用不上它。
BP:把损坏块留在本地
Block Parallelism 的第一步很直接:既然每个块的损失可以拆开,那就让每个 rank 负责一组完整目标块。设 rank 分到的块集合是 ,它本地计算:
这里 是第 个目标块对应的损失。因为总损失本来就是所有块损失的求和,所以所有 rank 的梯度加起来仍然等于原始目标的梯度:
这条式子解释了 BP 为什么不是近似算法。 是并行组里的 rank 数, 表示对模型参数求梯度。BP 改变的是每个块的计算归属,不改变目标函数,也不丢掉任何块的梯度。只要最后的参数梯度按同样规则聚合,训练语义就是等价的。
BP 的好处是损坏块本地化。第 个块的 corrupted 、中间激活、反向梯度都留在 block owner 上。不同 rank 并行算不同目标块,跨卡通信中不再需要搬这些块私有状态。
但纯 BP 有一个很大的短板:干净前缀会被重复保存。假设 rank 1 负责靠前块,rank 8 负责靠后块,rank 8 需要看到很长的 clean prefix。多个 rank 的 clean prefix 大量重叠,后面的 rank 甚至接近保存完整 clean sequence。上下文一旦到 128K、256K、512K,纯 BP 的显存复制会迅速变成灾难。
论文附录里的消融很直观:NemotronDiffusion 14B 上,纯 BP 在 64K 时更慢且更吃显存,128K 直接 OOM;DiffusionGemma 26B-A4B 在 64K 和 128K 都 OOM。也就是说,BP 找到了正确的块归属,但没有解决共享上下文的存储问题。
CSBP:BP 管损坏块,CP 管干净上下文
CSBP 的核心设计是把 BP 和 CP 叠在同一组 rank 上,但让它们管理不同对象:
- BP 负责 corrupted block:每个目标块的损坏 、激活、梯度都留在 block owner。
- CP 负责 clean context:干净序列按 token 位置分片,每个 rank 保存 左右的 clean shard。
这样一来,每张卡同时有两种身份。它既是某些目标块的 owner,也是一段 clean context 的 owner。目标块做注意力时,本地已经有自己的 corrupted ,只需要从 CP 组里取可见的 clean 分片。
论文里的 CSBP 前向可以写成:
是目标块 的 query, 是本地损坏块 key/value, 是来自 clean shard 的前缀 key/value。CSBP 只通信 clean 部分;corrupted 部分不跨 rank。
反向传播也对应拆开。block owner 本地得到 corrupted ,这些梯度不需要出卡;clean 的梯度来自多个目标块,需要被累加回 clean shard owner。于是跨卡梯度通信也只剩 clean 。
这带来一个很清楚的通信账本:
| 方案 | 前向跨卡通信 | 反向跨卡通信 | 显存形态 |
|---|---|---|---|
| 传统 CP | clean + corrupted | clean + corrupted | clean 与 corrupted 都按位置分片 |
| 纯 BP | 通常不传 corrupted | corrupted 梯度本地 | clean prefix 大量复制 |
| CSBP | 只传 clean | 只传 clean | clean 分片,corrupted 分块本地 |
从复杂度角度看,CSBP 没有减少有效注意力对数。论文明确说传统 CP 和 CSBP 都计算相同的合法注意力关系,总注意力工作量仍是 ,平衡后每 rank 仍约为 。收益不是来自“少算了模型应该算的注意力”,而是来自两个工程事实:第一,不再把块私有 corrupted 拿去跨卡通信;第二,不再像纯 BP 那样复制越来越长的 clean prefix。
在线 softmax 合并:为什么分两段算仍是同一个注意力
CSBP 的实现还有一个关键细节:一个目标块的注意力由两部分组成,本地 corrupted block attention 和分布式 clean prefix attention。两部分可以分别 launch,然后用 log-sum-exp 统计量合并,得到与一次性对拼接 做 attention 等价的结果。
设两组互不重叠的 key/value 集合分别算出归一化输出 ,以及每一行的 log-sum-exp 值 。合并时先取:
然后定义权重:
最终输出和新的 log-sum-exp 是:
这就是 FlashAttention 里常见的在线 softmax 合并思想。 不是普通权重,而是各自 key 集合上 softmax 分母的对数;减去 是为了数值稳定,避免指数溢出。实现上,论文提到 numerator、 和 normalizer 会用 FP32 保存到最后一步,再归一化输出。
这一步很重要,因为它说明 CSBP 不是“近似把两个注意力结果加起来”。如果直接平均 和 ,那当然会错;正确做法必须按两个 key 集合各自的 softmax 分母重新加权。只要保存每行 LSE,就可以把多个分块 attention 精确合并。这个思想和本站 FlashAttention 完全拆解(一) 中的在线 softmax 是同一条数值稳定路线。
论文的实现调度大致是:
1. 异步 all-gather 本 rank 的 clean K/V shard。2. 先对本地 corrupted block 做 block-diagonal attention。3. 等 clean K/V gather 完成后,对 clean prefix 做 masked attention。4. 用 LSE merge kernel 在 FP32 中合并两部分输出。5. 反向传播时把 corrupted 梯度留在本地,只 reduce-scatter clean 梯度。这个执行顺序还有一个隐藏好处:本地 corrupted block attention 可以和 clean K/V 的通信重叠。通信没有完全消失,但它被限制在真正有复用价值的 clean context 上,并且可以被本地块计算部分遮住。
负载均衡:为什么要首尾块配对
长上下文注意力有天然的不均衡。靠前的块可见前缀短,靠后的块可见前缀长。如果简单把连续块分给 rank 1、rank 2、rank 3,那么负责后段的 rank 会做更多 attention 工作,其他 rank 等它。
CSBP 用 dual-end strategy 做负载均衡:把靠前块和靠后块配到同一个 rank,比如第 个块和第 个块一组。这样每个 rank 拿到的前缀长度之和更接近,块计算更均衡。
clean sequence sharding 也沿用类似 zigzag 思想,把早期和晚期 clean chunks 搭配起来,减少因果注意力中的工作量倾斜。这个点听起来像实现细节,但在长上下文上很关键。CSBP 的核心优化是减少通信;如果块分配导致某些 rank 长时间空等,通信省下来的收益会被同步等待吃掉。
实验数字:256K 上下文下的主结果
论文在两类任务上评估 CSBP。第一类是已有块扩散语言模型的 SFT,包括 NemotronDiffusion 3B/8B/14B 和 DiffusionGemma 26B-A4B;第二类是 AR-to-BDLM conversion,把 Qwen3.5-27B、Qwen3.8-27B 这类自回归骨干转成块扩散模型。硬件方面,完整模型实验使用 2 个节点、共 16 张 H200,每张 141 GiB HBM3e;DFlash2 drafter 实验使用单节点 8 张 H100,每张 80 GiB HBM3。
256K 上下文的主表可以压缩成几个关键数字:
| 工作负载 | 模型 | baseline tok/s | CSBP tok/s | 加速比 | 峰值 HBM 变化 |
|---|---|---|---|---|---|
| BDLM fine-tuning | NemotronDiffusion 3B | 13,434 | 16,027 | 1.19x | 57.1 GiB 到 57.0 GiB |
| BDLM fine-tuning | NemotronDiffusion 8B | 9,668 | 11,379 | 1.18x | 97.5 GiB 到 97.5 GiB |
| BDLM fine-tuning | NemotronDiffusion 14B | 7,884 | 9,301 | 1.18x | 91.1 GiB 到 90.6 GiB |
| BDLM fine-tuning | DiffusionGemma 26B-A4B | 10,557 | 15,359 | 1.45x | 118.1 GiB 到 113.6 GiB |
| AR-to-BDLM conversion | Qwen3.8-27B | 2,623 | 3,490 | 1.33x | 120.7 GiB 到 111.1 GiB |
| AR-to-BDLM conversion | Qwen3.5-27B | 2,641 | 3,351 | 1.27x | 120.7 GiB 到 111.1 GiB |
这张表的重点不是“所有模型都快了一点”这么简单,而是两个信号。
第一,CSBP 没有用更多显存换吞吐。多数行峰值 HBM 持平或下降,Qwen 转换任务甚至从 120.7 GiB 降到 111.1 GiB。这符合设计预期:CSBP 省掉的是无复用 corrupted 通信和 pure BP 的 clean prefix 复制,不需要额外保存一堆副本。
第二,DiffusionGemma 26B-A4B 的收益明显更大。附录解释说,DiffusionGemma 有 30 个注意力层,其中 25 个使用 1,024-token sliding window。baseline CP 在所有层里都按完整 shard 交换 K/V;CSBP 在滑窗层只交换本地 query 需要的 clean rows,只有少数 global attention 层交换完整 clean shard。因此它的 logical attention traffic 降低 93.5%,exposed attention communication 降低 93.4%。端到端 step time 没有下降 93%,因为 GEMM、MoE、优化器等部分仍在,但 DiffusionGemma 的 step time 仍下降 31.3%,形成 1.45x 总加速。
并行度越高,CSBP 越值钱
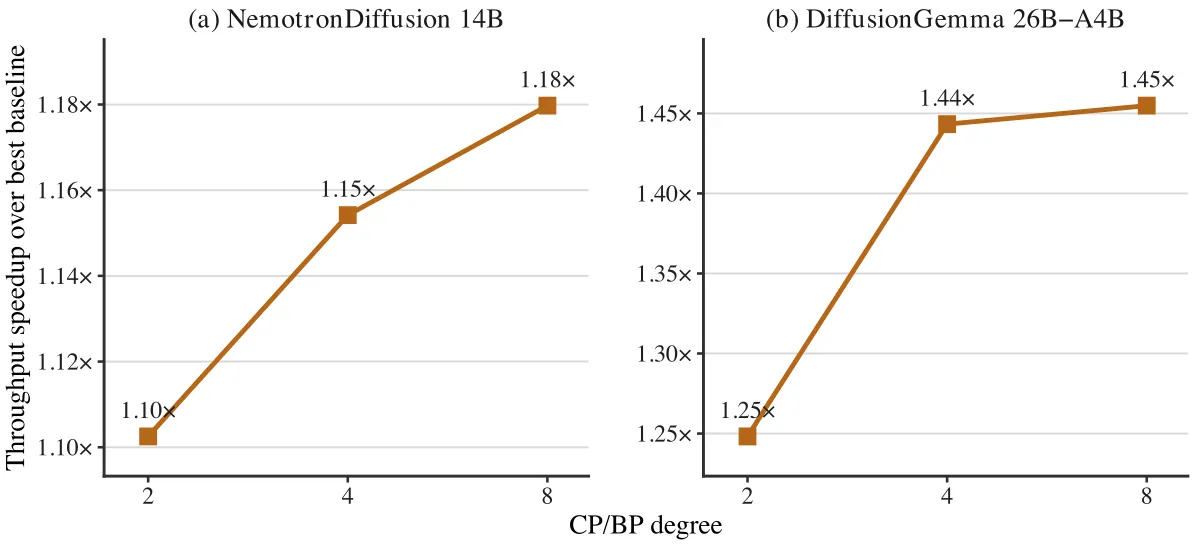
图源:论文 Figure 4,arXiv:2609.19242。横轴是 CP/BP degree,纵轴是相对吞吐。NemotronDiffusion 14B 的加速比从 1.10x 上升到 1.18x;DiffusionGemma 26B-A4B 从 1.25x 上升到 1.45x。
这个趋势很符合通信账本。并行度低时,一部分通信可以被计算遮住,rank 数也少,传统 CP 的跨卡交换还没有完全主导。并行度升高后,序列 shard 更细,参与 attention collective 的 rank 更多,传统 CP 对 corrupted 的无效搬运更显眼。CSBP 把 corrupted 块固定在 owner 上,越到高并行度越能省。
这里也能看出 CSBP 和普通 kernel 优化的差别。kernel 优化通常在单个算子内部榨性能,比如更好的 tiling、更少的 shared memory bank conflict、更高的 Tensor Core 利用率;CSBP 改的是分布式张量所有权。它不一定让单次 local attention kernel 更快,但让网络上少传了不该传的张量,让反向传播少做了不该做的梯度搬运。
上下文越长,传统 CP 的错配越严重
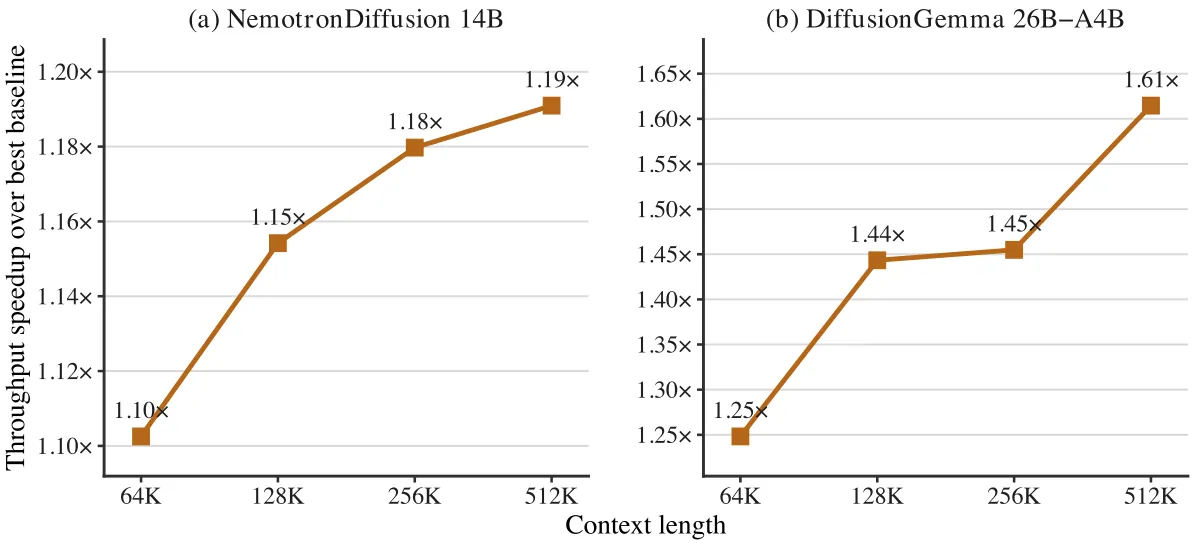
图源:论文 Figure 5,arXiv:2609.19242。把上下文从 64K 扩到 512K 后,NemotronDiffusion 14B 的加速比从 1.10x 到 1.19x,DiffusionGemma 26B-A4B 从 1.25x 到 1.61x。
长上下文会同时放大三件事。
第一,attention 可见前缀变长,clean context 的复用价值提高。CSBP 让 clean shard 仍然按 CP 方式分布,不会像 pure BP 那样复制出很多重叠前缀。
第二,传统 CP 里的 corrupted 交换也变大。损坏块本身可能只是当前目标块,但在 clean-plus-corrupted 拼接表示里,它仍然被当作普通序列 shard 的一部分参与跨卡 attention 通信。
第三,反向传播里的 返回路径更贵。前向多传了无复用 ,反向就要为它们再传梯度。CSBP 同时切断这两条路径。
因此,CSBP 的收益不是“短上下文也能神奇加速”,而是非常明确地面向长上下文。当上下文还短、batch/data parallel 足够铺满 GPU 时,它可能不占优。论文 DFlash2 表里就有一个例子:Qwen3.8-27B 在 256K 上,DP8 baseline 比 DP4/CP2/BP2 的 CSBP 还快 19.2%,因为完整副本还能放下,纯数据并行避免了序列并行开销。但到 512K 和 1M,情况反转得很彻底。
DFlash2 drafter:为什么加速能到 7.59x
CSBP 在 DFlash2 drafter 训练上的收益更大。论文表 2 给出的 Qwen3.8-27B 数字是:
| 上下文 | baseline topology | CSBP topology | baseline tok/s | CSBP tok/s | 加速比 |
|---|---|---|---|---|---|
| 256K | DP8 | DP4/CP2/BP2 | 167,228 | 140,350 | 0.84x |
| 512K | DP4/CP2 | DP4/CP2/BP2 | 57,027 | 141,222 | 2.48x |
| 1M | DP1/CP8 | DP4/CP2/BP2 | 18,389 | 139,541 | 7.59x |
这个表容易误读。7.59x 并不是说一个神奇 kernel 把同一份计算加速了 7.59 倍,而是拓扑和重复工作的组合效果。
DFlash2 drafter 的目标是给投机解码训练一个长上下文块扩散草稿器。传统 CP 在长上下文下会复制 block-local decoder、vocabulary loss 和 selector 等块局部工作;CSBP 把 draft block 交给一个 owner,避免在多个 context ranks 上重复这些块局部路径。上下文越长,baseline 越不得不提高 CP degree,重复和通信越重;CSBP 则可以用 BP 维度把块分开,同时保留更多数据并行副本。
论文给了一个更细的剖面:在 512K 上,CSBP 把每 GPU exposed attention communication 从 105.4 ms 降到 7.5 ms。这个数字解释了为什么 MFU 会从 13.1% 提到 32.4%。GPU 不是忽然更会算了,而是少等了大量没有复用价值的 attention 通信。
这个结果也把 CSBP 和推理侧联系了起来。DFlash/DFlash2 是推理加速里的草稿模型路线,本站已经拆过 DFlash 块扩散解码;但草稿器要支持更长上下文,离不开高效的长上下文构建过程。CSBP 本身不是在线推理调度器,却直接影响“能不能用合理成本训练出长上下文草稿器”。
固定时间预算下是否真的更好
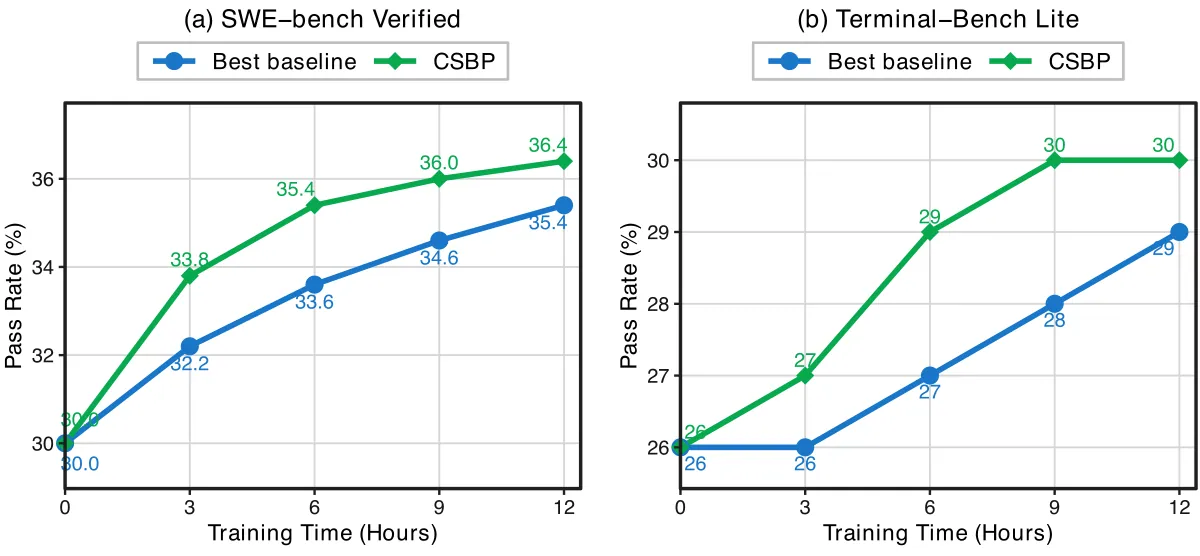
图源:论文 Figure 6,arXiv:2609.19242。作者用 best baseline 和 CSBP 各训练 DiffusionGemma 26B-A4B 12 小时,每 3 小时在 SWE-bench Verified 和 Terminal-Bench Lite 上评估一次。CSBP 在所有 checkpoint 上都更高,最高领先 1.8 个百分点和 2 个百分点,12 小时后两个基准都仍领先 1 个百分点。
系统论文里的吞吐提升有时会遇到一个问题:tok/s 更高不一定代表固定时间内模型更好。比如并行策略可能改变数值顺序,或者为了吞吐牺牲了 batch 组织,最后质量曲线不一定同步改善。CSBP 的这组实验想回答这个疑问。
它的结论比较克制:CSBP 在相同 wall-clock 下确实推进得更快,但领先幅度不是压倒性的质量跃迁,而是符合吞吐差异的稳定优势。这里更应该关注“没有破坏训练语义”这件事。CSBP 的目标是保留同一个 BDLM objective 和同一批目标块,只重排 clean/corrupted 的所有权;固定时间结果说明这种重排没有在下游 checkpoint 上引入明显副作用。
这项工作的边界
CSBP 的适用边界也很清楚。
第一,它依赖块扩散目标的块级可分离性。只有当 corrupted block 的计算确实只服务自己的块损失时,才能安全地把 corrupted 和梯度留在 block owner。本质上,这是利用目标函数结构做系统切分,而不是通用替换所有 CP。
第二,它主要解决 attention 通信和 clean prefix 复制,不会自动减少 dense GEMM、MoE expert GEMM、优化器 step 等计算。论文附录也强调,93% 级别的通信下降发生在 attention communication 上,不是完整训练 step。端到端能到多少取决于通信在总耗时里占多大比例,以及模型结构是否有 sliding window、global attention 混合这类特点。
第三,短上下文或副本能完整放下的场景未必需要 CSBP。Qwen3.8-27B DFlash2 在 256K 时 DP8 baseline 更快,就是一个提醒:如果数据并行能直接跑满,加入 CP/BP 反而可能引入额外调度和通信成本。
第四,实现复杂度不低。CSBP 需要调度器知道 clean shard ownership、block ownership、dual-end block assignment、异步 all-gather、LSE merge、packed backward、clean gradient reduce-scatter 等路径。它不是只改一个 attention mask 就能自然出现的优化。
小结
CSBP 的核心贡献可以压成一句话:块扩散长上下文计算里,clean context 和 corrupted block 的复用语义不同,分布式系统不该把它们当作同一种序列 shard 来通信。
传统 CP 的问题不是“上下文并行不好”,而是它对 BDLM 的 clean-plus-corrupted 表示过于机械:clean 有跨块复用价值,corrupted 没有。BP 把 corrupted block 留在本地,解决了无效通信;CSBP 再把 clean context 分片,解决了纯 BP 的前缀复制。两者合起来,才形成一个既保持训练语义、又适合长上下文的并行维度。
对系统设计的启发更宽一点:分布式并行不只是 DP、TP、PP、CP 的排列组合,还要看模型目标函数里的“复用边界”。只要某类状态只服务局部目标,就应尽量留在局部;只有真正会被多处复用的状态,才值得进入 collective。CSBP 把这个原则落到了块扩散语言模型的 attention 和梯度通信上。
参考资料
- Block Parallelism for Efficient Distributed Long-Context Diffusion Language Model Training
- ScalingIntelligence/Turbo-dLLM 官方实现
- Block Diffusion: Interpolating Between Autoregressive and Diffusion Language Models
- DFlash: Block Diffusion for Flash Speculative Decoding
- Ring Attention with Blockwise Transformers for Near-Infinite Context
- DeepSpeed-Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- DiffusionGemma Technical Report
- Nemotron-Labs-Diffusion: A Tri-Mode Language Model Unifying Autoregressive, Diffusion, and Self-Speculation Decoding
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


