


世界模型从零讲起(四十六):形状的身份怎么延续——持久化表示、跨物体再关联与形状记忆的存储与遗忘
上一篇《形状被改写之后》把一个发生了塑性变形的物体拆成三层来解释:表示层解决「形状怎么存」,物理层解决「形状为什么变成这样」,维护层解决「什么时候把变形固化成新的参考形状」。那一篇的结尾留下了一个更长期的问题:当物体的参考形状不再是一个静态网格,而是随操作持续变化的分布时,几何本身的「身份」靠什么延续?换句话说,世界模型不能只回答「这个物体现在长什么样」,它还要回答「三个月后我再看到它,我怎么知道它还是同一个东西」。
这一篇讨论的就是这个问题的三面:形状不再是单点而是分布时怎么表示、同一个物体在多视角、多物体、多会话里怎么被重新关联,以及形状记忆在长期运行中怎么存、怎么忘。它仍然属于「世界模型从零讲起」这个系列的物理—几何支线,接在(四十四)塑性状态和(四十五)形状维护之后。
先定位:形状变了之后,「同一个东西」还剩什么
(四十五)的维护层已经给出了一组锚点:几何锚、物理锚、任务锚,用来决定什么时候把当前的变形固化进参考形状。那套机制回答的是「一个物体在几分钟的操作窗口内,参考形状怎么更新」。一旦把时间尺度拉长,问题会变成另一种形态。
设想一张实验台上的三个硅胶块。它们出厂时一模一样,机器人先后抓过、压过、摔过,现在每一块都有了不同的凹痕和永久弯曲。十分钟后,摄像头被机械臂挡住了一次,再恢复视野时三块的位置都变了。世界模型需要回答:
- 现在画面里的这一块,是十分钟前记录里的哪一块?
- 如果它被放进了抽屉、半小时后才拿出来,记录还能认出来吗?
- 这三块形状状态每块要占多少内存?如果桌上有三百块,或者连续运行三个月,这份形状记忆该怎么裁剪?
这三个问题分别对应身份的表示、身份的再关联与记忆的预算。它们看起来是三个工程问题,底层却是同一个形式化对象:形状身份不是一个几何量,而是一个被持续维护的假设。物体不会因为形状变了就变成另一个物体;但形状又是世界模型唯一能直接观测到的证据之一。身份必须在「形状会变」和「形状可辨认」之间取得平衡。
这一篇的路线是:先把身份写成可计算的形式,再讨论形状作为分布怎么持久化,然后进入多物体关联,最后落到存储与遗忘的预算账本。
身份的形式化:同一个物体是一个被维护的假设
三种身份,三种用途
「同一个物体」在日常语言里是含混的。工程上至少要拆成三种身份,因为它们的判定依据和失效代价完全不同。
数值身份(token identity)指跨越时间的同一个物理个体。它回答「这一块硅胶是不是刚才那一块」。数值身份是形状状态能够累积的前提:塑性应变、损伤、寿命消耗都必须挂在一个稳定的 id 上,否则两件物体的历史会被混在一起。这是这一篇的主角。
类别身份(type identity)指同一个型号、同一类物体。它回答「这是一块 5 cm 见方的硅胶块」。类别身份不要求个体同一,但它提供先验:同型号物体的质量、名义刚度、典型尺寸都在一个范围内,这些先验能在观测不足时约束形状估计。类别身份是可以在多个个体之间共享的,因此也是记忆压缩的入口。
指称身份(referential identity)指语言里被提到的那个对象。它回答「把红色那块递给我」里的「红色那块」。指称身份需要把语言描述、空间位置和数值身份对上,(二十八)讨论语言接地时已经处理过一部分。这里只需要强调一点:指称解析的底层依赖数值身份,如果 id 发生了交换,语言指令就会作用到错误的对象上。
三种身份的关系是:类别身份提供先验,数值身份承载状态,指称身份消费状态。把它们混为一谈,就会写出「形状相似就认为是同一物体」这种在软物体上必然失败的逻辑。
为什么不能拿形状本身当身份判据
最直接的想法是:比较两个时刻的形状,相似度高于阈值就认为是同一物体。这个做法在刚体上勉强能用,在可塑性物体上有两个致命缺陷。
第一,判据与被判定的量是同一个东西。形状是世界模型要追踪的状态,它随时间单向漂移。今天记录的参考形状是 ,明天它变成 ,两者差异可能比另一件同型号物体的差异还大。如果每次都用「与上次形状的相似度」来判断身份,那么一次重压就能让物体「变成另一个物体」。判据必须比被追踪的量更慢、更稳定。
第二,形状相似度对合法变化和非法替换没有区分力。同一个物体被压扁是合法的形状变化;另一件同型号物体恰好也被压扁,是非法替换。两者的 Chamfer 距离可能一样小。身份判定需要的不是「像不像」,而是「这个变化是否在同一个个体允许的演化范围内」。这是一个假设检验问题,不是最近邻问题。
正确的做法是把身份证据分成不同的时间尺度,只用慢变量做判据,快变量做辅助。
身份证据的时间尺度
把可观测特征按「同一物体在正常操作下的变化速度」排序,可以得到一张很有用的表:
| 证据 | 变化时间尺度 | 对合法形变的鲁棒性 | 对替换的敏感度 | 身份价值 |
|---|---|---|---|---|
| 位姿、速度 | 毫秒到秒 | 高(与形状无关) | 低(可被复制) | 辅助 |
| 弹性形变、接触状态 | 毫秒到秒 | 本身就是变化 | 低 | 几乎无 |
| 外观纹理、颜色 | 分钟到小时 | 中(污渍、光照) | 中 | 辅助 |
| 表面磨损、划痕 | 天到月 | 高(缓慢累积) | 中高 | 较强 |
| 塑性疤痕、永久弯曲 | 不可逆 | 极高(写入后不变) | 高 | 强 |
| 材料参数(刚度、屈服应力) | 天到月 | 高(慢变量) | 高 | 强 |
| 质量、质心、惯量 | 月到年 | 高 | 高 | 强 |
| 类别、型号、标记 | 永久 | 极高 | 极高 | 最强 |
这张表的核心洞察是:塑性变形的不可逆性,恰好使它成为最好的身份证据。一个凹痕一旦形成就不会自己消失,它像指纹一样把「这个个体经历过什么」写进了几何。反过来,弹性形变和位姿变化虽然显眼,却几乎不能用于身份判定——任何一件同型号物体都能摆出同样的姿态。
用统计语言可以把这件事写成判别比。对某个特征 ,定义
其中分子是不同个体之间该特征均值的方差,分母是同一个体在允许的形变范围内的方差。 就是 Fisher 判别比:它衡量这个特征把「不同个体」和「同一个体的不同状态」分开的能力。疤痕特征的分子大、分母接近零, 很大;弹性形状特征的分子和分母都可能很大, 反而小。身份特征的选择应该按 排序,而不是按「看起来像不像」排序。
这个比值还解释了为什么外观嵌入(appearance embedding)只能做辅助:同一件物体在不同光照、不同污渍下,嵌入的类内方差并不小;而两件同型号物体的类间均值差可能很小。它在刚体重识别里够用,在软物体上必须与疤痕、材料参数联合使用。
关联的贝叶斯形式
把时刻 的观测集合记作 ,上一时刻维护的记录集合记作 。每个记录
包含形状状态 、不确定度 、证据日志 与存在信念 。关联就是求一个映射 ,使后验最大:
先验 编码运动连续性、遮挡状态与上一帧的分配;似然 编码外观、几何、动力学与历史证据的匹配程度。取负对数后,最大化后验等价于最小化一个代价矩阵:
在实际系统里, 通常是若干项的加权和,权重由标定或元学习得到。这个形式看起来是标准的多目标跟踪,但软物体给它加了两个新约束:几何项必须对合法形变不变,历史项必须能携带不可逆的疤痕信息。
关联错误的不对称代价
身份关联有两类错误,代价极不对称。
错误合并(false merge)把两个不同个体并入同一条记录。后果是两条塑性历史被叠加:一个物体的 被另一个物体的变形污染,疤痕清单混在一起,材料参数被平均。这个错误几乎不可逆——一旦原始观测被丢弃,就无法指出哪一部分状态属于谁。更糟的是,污染会沿着后续的物理预测传播:世界模型会用错误的参考形状去预测下一次接触。
错误分裂(false split)把同一个体拆成两条记录。后果是记忆浪费、历史断裂、疤痕被分散在两条记录里。但它是可恢复的:两条记录都还在,后续可以通过相似度和共同观测把它们重新合并。
这个不对称性决定了系统的默认策略:不确定时倾向于分裂,并把「可能重复」的关系显式记下来。这与记录链接(record linkage)里的经典结论一致:在无法确认时保留候选,比强行合并安全。工程上的做法是给记录加一个 alias 或 candidate_merge 字段,让不确定的关联以软链接的形式存在,等证据足够时再固化。
同样的道理适用于存在性。物体被遮挡时不应该删除记录,而应该把存在信念 从「在场」降到「被遮挡」,并让 随时间衰减。遮挡与消失的区别只能通过再观测来确认;提前删除记录等于提前放弃了再识别的可能。
形状作为一个分布:持久化表示
从单点形状到形状后验
(四十五)维护的是一个形状状态:一组映射参数、一份 、一组锚点。那是最大后验意义下的单点估计。长期运行中,单点估计不够用,因为形状状态本身带着两类不确定性。
第一类是估计不确定性:观测只有表面、只有部分视角,非刚性配准是欠约束问题,反推出来的形变场在一个零空间里可以有无数解。第二类是过程不确定性:两次观测之间物体可能被移动、被压、被别的物体碰撞,形状在没有被看见的时候仍在演化。世界模型必须把「我没看见的时候它可能变成什么样」也记下来,否则再观测时会把一个合法的变化当成身份异常。
因此持久化的对象不是 ,而是后验 。工程上有三种常见实现:
- 高斯近似:把形状参数向量化,维护均值与协方差。优点是更新便宜、可以做卡尔曼式预测;缺点是形状参数空间高度非线性,单峰高斯无法表达「这里可能凹、也可能裂」这种多模态。
- 粒子集合:维护 个形状样本,每个样本是一套完整的 与映射参数。优点是能表达多模态、能直接用于鲁棒规划;缺点是内存乘以 ,更新要做重采样。
- 低秩协方差:只在少数主导形变模式上维护方差,其余维度视为确定。优点是紧凑;缺点是需要先做形变模式分解,模式会随物体变化而漂移。
对世界模型来说,选择依据不是统计纯度,而是这份后验能不能直接进入推理回路。规划器需要的是「如果我这样推,最坏情况下它会怎么变形」,粒子集合直接给出最坏样本;卡尔曼式高斯要额外做线性化,误差在接触处会被放大。所以接触密集的任务更适合粒子式,搬运、放置这类准静态任务用高斯近似就够。
一条记录的四层结构
把形状身份落成数据结构,一条记录至少要分四层,每层的更新频率和生命周期不同:
ShapeRecord: id # 数值身份,永不变 type_id # 类别身份,指向共享的类别先验 canonical # 参考形状(网格 / 高斯 / 粒子),带版本号 residual # 相对 canonical 的塑性残差(F^p 或形变节点) uncertainty # 上述两层的后验(协方差或粒子集合) scars[] # 不可逆几何标记:位置、深度、方向、时间 material # 慢变量:E、σ_y、H、密度、阻尼 existence # 在场 / 遮挡 / 离场 / 未知 tier # hot / warm / cold / archive provenance[] # 每个字段来自哪次观测、哪次接触 version # 单调递增四层的分工值得逐一说明。
类别层是共享的。同型号物体共用一份模板、一份名义材料参数、一份典型尺寸分布。300 个同型号硅胶块只需要一份类别先验,这是记忆压缩最大的一笔收益。类别层也是身份判定失败时的兜底:如果数值身份实在无法确定,至少可以用类别先验加疤痕清单做候选排序。
参考层是(四十五)里的「固化后的参考形状」。它不是一个原始扫描,而是上一次再锚定时刻的快照。参考层的版本号必须单调递增,所有依赖它的量(残差、疤痕坐标、锚点)都要记录自己基于哪个版本计算。否则一次回滚会让坐标系统错位。
残差层是当前形状与参考层的差。它有两种等价写法:一是每个材料点的塑性变形梯度 ;二是形变图节点上的仿射变换。前者物理含义明确、能与 MPM 直接对接;后者紧凑、适合渲染与配准。实际系统往往两样都存: 给物理,节点给视觉,二者通过采样互转。
不确定层是这一篇新增的重点。它不只记「形状有多不确定」,还要记「不确定性长什么样」:是整体尺度不确定,还是某个局部区域不确定,还是拓扑不确定(可能裂了、可能粘上了)。只有知道形状,才能决定下一次该看哪里——这正是(二十九)主动感知所需要的输入。
事件溯源:形状日志与快照
直接把最新状态覆盖写回是最省事的做法,但它有三个无法回避的问题:无法回滚错误的关联、无法审计某个疤痕是哪次操作造成的、无法在两条记录合并时重建历史。形状状态恰恰是这三件事都需要的。
事件溯源(event sourcing)把每次改变写成一条不可变事件,当前状态由事件重放得到:
event = { type: "plastic_write" | "reanchor" | "contact" | "observation" | "merge" | "split", t: timestamp, base_version: int, payload: {...}, provenance: {sensor, frame_id, estimator_version}, hash: 上一状态的摘要}事件类型里最重要的是 plastic_write。它不应该记录整张 ,而应该记录被改写的材料点集合与增量:一次抓取通常只影响接触区域附近百分之几的粒子,记录稀疏增量既省空间又保留了因果信息。hash 字段用于检测事件链断裂:如果某条事件的父摘要对不上,说明中间有事件丢失或被错误合并,账本必须拒绝继续追加。
快照策略决定重建成本。设事件数为 、每条事件平均触及 个粒子、重放一个粒子的成本为 ,则从上一个快照重建的代价约为
如果每次观测都做快照,存储会爆炸;如果从不做快照,重建会随运行时间线性增长。常用的折中是按塑性功阈值做快照:累计塑性功超过某个比例(例如参考构型体积变化超过 2%)时固化一次,这样快照数量与真实变形量成正比,而不是与时间成正比。一个连续运行三个月的物体,如果大部分时间只是被搬来搬去,快照可能只有十几次。
事件溯源的另一个好处是与(四十四)的状态账本对齐。塑性应变、损伤、寿命消耗都是事件的结果,而不是独立的状态。把三者写进同一条事件流,才能保证「几何上有个凹痕,损伤记录里却没有对应事件」这种内部矛盾不会出现。
压缩:参考形状、残差与低秩基
形状记忆的规模最终由字节数决定。先算一笔账。假设一个物体用 4096 个 MPM 材料点,每个点存位置、速度、变形梯度、塑性变形梯度、损伤与材料编号:
| 字段 | 维度 | 字节(fp32) |
|---|---|---|
| 位置 | 3 | 12 |
| 速度 | 3 | 12 |
| 变形梯度 | 9 | 36 |
| 塑性部分 | 9 | 36 |
| 损伤 | 1 | 4 |
| 材料编号 | 1 | 4 |
| 合计 | 26 | 104 |
4096 个点约 426 KB。这是 hot 层的量级。如果同时有 50 个物体处于可操作状态,约 21 MB——对服务器不算什么,对机载计算单元就要认真对待。
粒子状态之所以值得作为 hot 层的载体,是因为它同时是物理与几何的存储单元。Particle-Grid Neural Dynamics 这类工作把可变形物体的动力学学成一个「粒子—网格」结构:多视角深度图融合出粒子位置与速度,点编码器提取逐粒子特征并预测速度场,速度场再被投影到三维网格上估计空间分布,最后用预测速度更新粒子位置做迭代 rollout。
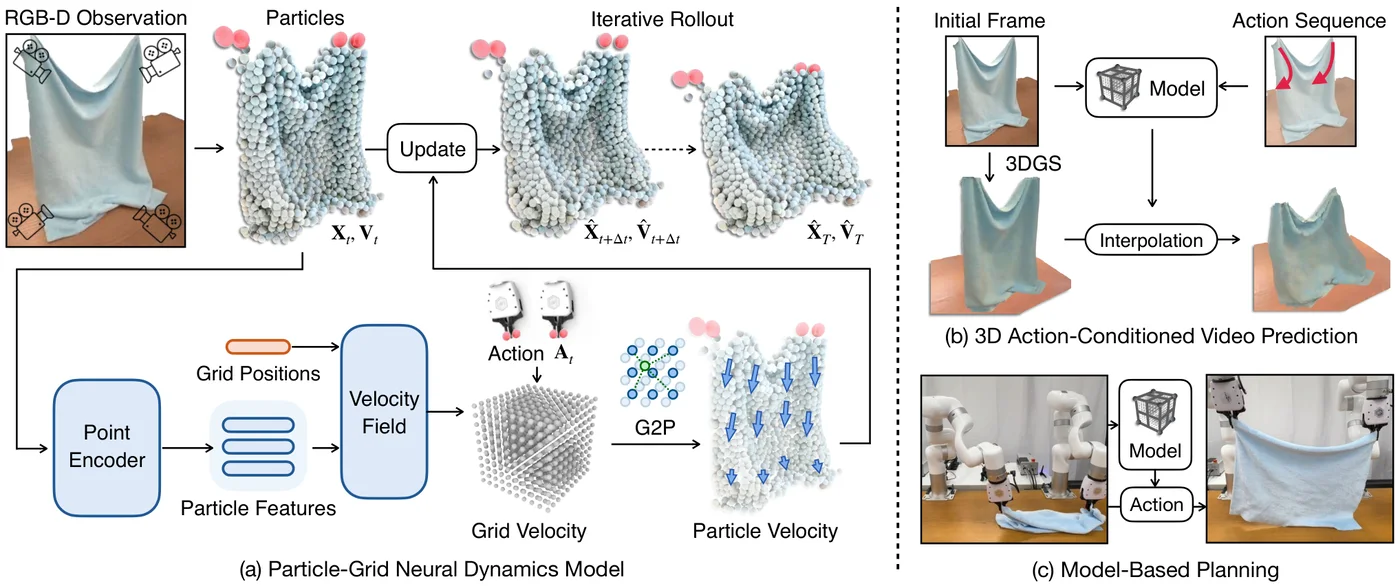
上图的价值在于它展示了粒子表示的一种折中:粒子携带身份与局部状态,网格承担空间正则化与邻域计算。对形状记忆来说,这种折中意味着可以只持久化粒子上的显式状态(位置、、损伤),而把网格看成每次推理时重建的临时结构。网格不进记忆,粒子进记忆,存储量就由物体本身的自由度决定,而不是由分辨率决定。
压缩的第一招是降低残差的表示维度。 在空间上是光滑的,除了接触边缘附近,大部分区域的塑性变形梯度变化缓慢。用形变图的 200 个节点表示整体形变,每个节点存一个 矩阵加平移:
再加上接触区域的稀疏残差(假设 3% 的粒子、每粒子 36 B): KB。两者合计约 14 KB,相比 426 KB 压缩了 30 倍。代价是失去逐粒子的精确物理状态,恢复时需要把节点形变插值回粒子,误差在折痕处最大。所以这种压缩只适合 warm 层,不适合正在被操作的 hot 层。
第二招是量化。 通常接近单位阵,直接存九个浮点数浪费动态范围。改存对数变形 (或位移场),按物体做最小-最大归一化后压成 int16,误差约千分之一,对形状的影响远小于视觉分辨率。九个数从 36 B 降到 18 B,整体减半。再配合稀疏化,warm 层可以做到每物体几 KB。
第三招是关键帧加增量。参考层不必每次快照都存完整网格,可以存「上一个关键帧 + 若干次形变增量」。这与视频编码的 I 帧/P 帧是同一个思想:参考形状变化缓慢,增量稀疏。关键帧的间隔由形变速率决定,而不是固定时间。
第四招是按任务相关性分级。不是所有几何细节都同等重要:抓取点附近的曲率、接触面的平整度、质心位置影响操作;远离接触区域的微小凹凸可以丢。可以用一个任务敏感度权重 对残差做非均匀量化,把比特花在会被用到的区域。这个权重来自(四十五)的任务锚,也来自当前的任务分布。
不确定性怎么随时间增长
后验不只是存储问题,它还会在没有观测的时候膨胀。考虑一个简化的标量模型:某个形状参数 (例如某区域的永久凹陷深度)在每次操作中有概率被进一步改写,改写量为零均值、方差 的噪声。经过 次未观测的操作后,
一次观测带来噪声 ,按高斯共轭更新:
这两条式子给出一个很实用的判据:当 远大于 时,再观测一次几乎能把不确定性压回观测噪声水平;当 已经小于 时,再看也学不到多少。主动感知的调度器可以用这个比值排序候选观测,而不是对所有物体平均用力。
多维情形下,形状后验的熵可以写成
其中 是形状参数的协方差。这个量有两层用途:一是作为记忆压缩的指标——熵低的记录可以粗略存,熵高的必须保留细节;二是作为身份判定的置信度——形状后验越宽,几何证据的权重就应该越低,关联应该更依赖疤痕和材料参数。
把不确定性显式存下来还有第三个好处:它让「同一个物体」的判定变成一个带置信度的决策。两条记录的形状后验重叠度高,只能说明它们可能是同一个;要确认,需要看疤痕、材料参数这些慢变量是否也一致。这正是下一节关联代价矩阵要处理的事。
跨物体的再关联
局部证据不足:分割先于关联
身份关联的第一步不是匹配,而是分割:把观测流拆成「一个物体的表面」与「另一个物体的表面」。对刚体,这一步通常由实例分割完成;对软物体,分割本身就是一个难题,因为它们会变形、会相互接触、会粘连。
分割错误的传播方向值得注意。一次错误分割会把两个物体的表面并成一个观测,后续匹配看到的是一个「尺寸翻倍」的物体,很容易被判为新的个体;反之,把同一物体切成两半会得到两个「尺寸减半」的观测,又可能被判为两个新个体。所以分割与关联不能串联处理,而应该做联合推断:分割假设与关联假设共享同一个后验,错误可以在两步之间互相纠正。
视觉分割这条线上,一个绕不开的进展是 SAM 2。Meta 在 2024 年发表的 SAM 2: Segment Anything in Images and Videos 把提示式分割从单帧扩展到了视频流。它的结构是流式的:图像编码器对每一帧只跑一次,产出的特征交给记忆注意力,与目标从历史帧累积下来的记忆做交叉注意力,再由掩码解码器输出当前帧的掩码,最后 memory encoder 把预测与图像特征一起写回记忆。
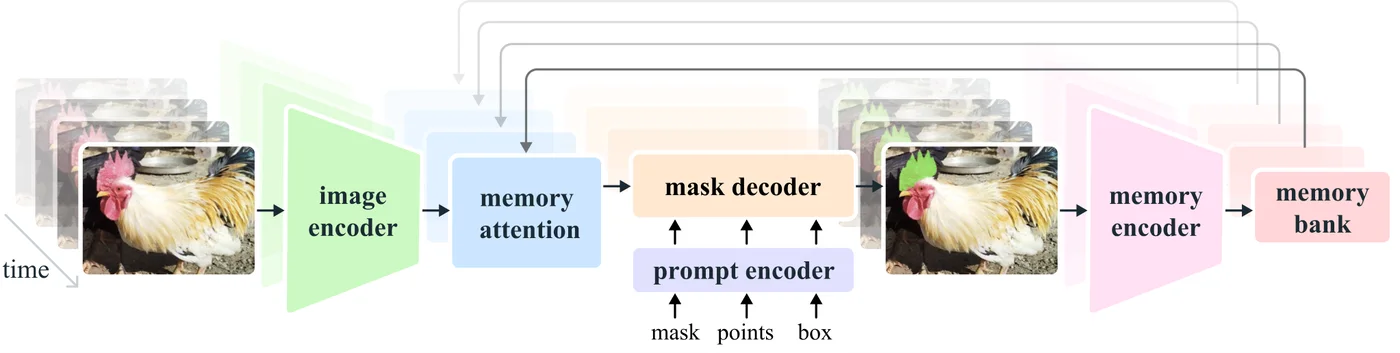
上图是 SAM 2 的架构。图中下方的记忆注意力是关键:当前帧的特征不是独立解码的,而是与目标在过去帧留下的记忆做交叉注意力,因此同一目标的掩码在帧间是连贯的。这张图对世界模型的意义在于,它展示了「身份」在视觉层如何以记忆的形式被携带——不是靠几何匹配,而是靠特征层面的历史累积。软物体的分割需要同样的东西,但记忆里还要带上形变速度与接触状态,否则物体一变形,记忆就过期了。
对世界模型而言,SAM 2 式的视频记忆提供了一个可以借鉴的模板:记忆按目标组织,而不是按帧组织。每个数值身份的记录都应该自带一份「它长什么样、上次在哪、当时在干什么」的记忆,分割时按目标查询,而不是每帧重新从零分割。这种组织方式也天然支持长时间遮挡后的再分割——只要记忆没被清空,目标就还能被重新找到。
多物体场景里的匹配
单物体跟踪解决的是「这一块去哪了」,多物体场景要解决的是「哪一块是哪一块」。经典的多目标跟踪把问题写成检测与关联两段:先检测,再用代价矩阵与匈牙利算法做分配。ByteTrack 在 2022 年提出的思路对软物体特别有启发:它不丢弃低置信度的检测框,而是先用高置信度框做第一轮关联,再用低置信度框做第二轮,把已经被遮挡或变形的目标从低置信度检测里找回来。软物体在接触时常常只露出一小块表面,检测置信度很低,但那一小块往往正是身份判据(疤痕位置)所在,丢弃它等于丢掉最好的证据。
对形状状态,匹配代价至少由四项组成:
其中 是当前观测的形状, 是对记录 的参考形状做其合法形变空间内最接近的拟合, 是拟合残差而不是直接距离。这一项的构造是关键:如果直接用 Chamfer 距离,同一个物体被压扁就会被判为不同;如果用「在合法形变空间内的拟合残差」,那么合法形变只贡献很小的残差,非法替换(另一件物体)的拟合残差会很大,因为它的疤痕和材料参数无法通过合法变形从记录 产生。
四个权重不应该固定。它们应该随状态自适应:对象处于遮挡状态时 要降、 要升;两件物体刚被分开时 可以高一些;运行时间长、疤痕多的记录应该更信任 。自适应权重的依据是各自的置信度,而置信度就是从第二节的不确定性层里来的。
动态场景里的形状与运动分离
再往前一步,观测不仅是单帧的物体表面,还可能是随时间变化的一串几何。把「形状在变」和「物体在动」分开,是关联的前置条件。DeformGS 在 2023 年末的工作里把这件事做成了一个可操作的形式:一组带标准(canonical)属性的高斯,通过一个形变函数 映射到度量空间,形变函数输入高斯的参考位置与查询时刻,输出旋转与度量位置。
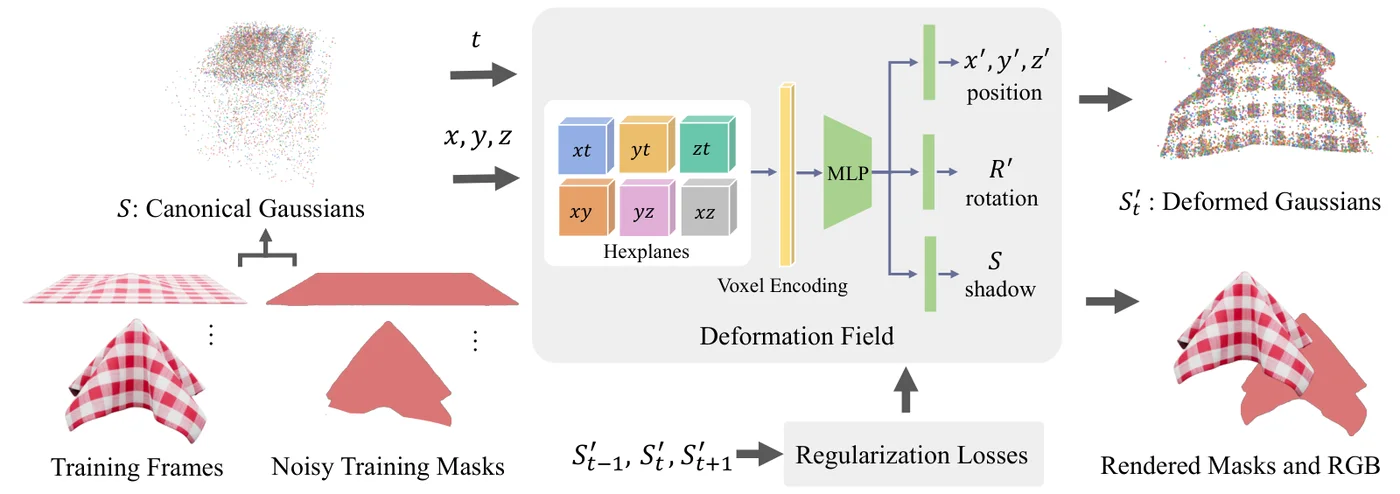
上图展示了这个映射的方向:标准空间里的高斯是身份稳定的那一份,度量空间里的位置是当前观测对应的那一份。对于身份关联,这意味着两张不同时刻的画面可以在标准空间里比较:把观测逆形变回标准空间之后再计算相似度,合法形变就变成了「标准空间里几乎不动」,而疤痕在标准空间里保持不动的位置。这正好印证了第二节的结论——身份判据应该在比观测更慢的坐标里做比较。
把这一层接进第二节的代价矩阵, 就可以写成「观测逆形变到标准空间后的残差」,而不是直接在世界坐标里比较。这个改写让同一个物体在弯折、拉伸之后的形状差异不再被计入身份代价。
跨会话:时间尺度再拉长
如果关联窗口从分钟变成天、周,问题会再变一次形态。物体可能被放在抽屉里、被装箱、被运到另一个房间,甚至被换成了同型号的新件。这时可用的证据只剩下最慢的那几个:类别、疤痕、材料参数、质量。
跨会话关联有一个天然的优势:物体在这段时间里的形状变化通常很小。没有操作就没有塑性写入,参考形状基本冻结。这会让直接的形状比较重新变得可靠——不是因为形状是稳定的身份判据,而是因为在没有塑性事件的间隔里,形状恰好可以当作快照使用。这个观察给出了一个重要的工程规则:跨会话关联应该以「上次会话结束时的形状」为基准,而不是以初始形状为基准。初检录的模板可能已经被无数操作改写,而会话末的快照至少还带着最近期的疤痕。
跨会话的失败模式主要有三种。
第一种是同类替换:同型号物体互换。只靠形状必然失败;靠疤痕可以,但前提是疤痕被可靠地记录了位置与深度。所以疤痕记录必须与局部几何坐标系绑定,而不是与世界坐标系绑定——物体被搬动后,世界坐标变了,局部坐标没变。
第二种是重涂或清洗:表面被擦干净,颜色、污渍全部改变,外观特征全部失效。这时只能靠塑性几何与材料参数。这也说明为什么长期记忆的根必须放在几何上而不能放在纹理上。
第三种是缓慢漂移导致的判据失效:物体在三个月里被反复压,疤痕越积越多,初检录的模板早已面目全非。如果关联的代价计算始终以旧模板为参考,拟合残差会越来越大,最终所有候选都判成「新物体」。解决办法是让跨会话关联的参考随快照滚动——每一轮会话结束都把当前形状写进参考层,并保留旧版本用于审计。
位姿与形状解耦:六自由度对象跟踪的启示
身份再关联的几何部分,可以拆成两件事:这个物体在哪里(位姿)、它现在是什么形状(形变)。刚体跟踪只需要前者,软物体两件都要,但两件事的解耦是关键——如果把位姿误差混进形状估计,一个被转过的物体会被误认为变形了。
FoundationPose 是 NVIDIA 在 2023 年提出的统一新物体位姿估计与跟踪方法,它的结构对这件事很有参考价值:用神经网络隐式场(object-centric neural field)表示物体,先在世界里撒一批候选位姿,再由精化网络逐个迭代,最后用打分模块选出最佳位姿并做 render-and-compare。它支持有模型和无模型两种模式,两者共享同一套精化与打分结构,区别只在于参考几何从哪里来。
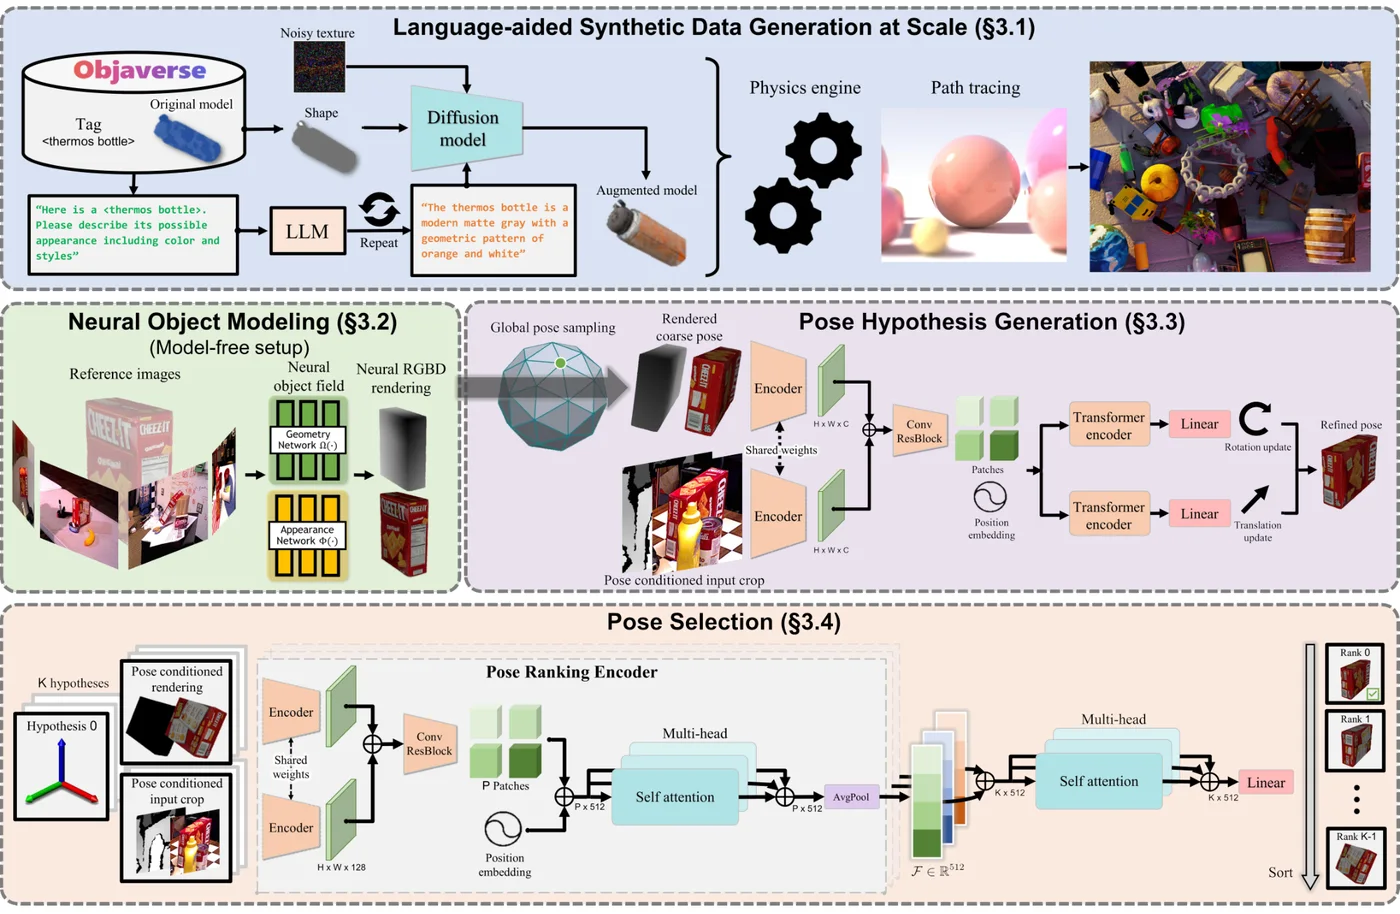
上图是 FoundationPose 的框架。对世界模型的形状身份来说,这个结构提供了一个「先粗略生成候选、再逐个精化、最后用评分确认」的范式。软物体的候选生成无法只靠刚体位姿,因为形状本身也在变;但评分阶段可以直接接入第二节的代价矩阵——用形变不变的几何残差、疤痕一致性与材料参数给候选打分。位姿精化只负责对齐刚体部分,形状残差在精化之后单独估计,两者互相不污染。
把这一层分开还有一个直接的好处:位姿跟踪失败时不会破坏形状状态。如果物体被突然翻面,位姿跟踪会短暂失效,但形状参考层与疤痕清单仍然完好;等位姿重新锁定后,用位姿做坐标变换再恢复形状对齐,比重新估计整个形状便宜得多。
身份漂移与合并的决策
关联不是一次性的判定,而是一个持续的过程。两条记录在某个时刻被判定为不同个体,在几个月后可能因为新的证据而被判定为同一个;反之亦然。系统需要一个显式的合并/拆分决策,而不是让记录无限增殖。
合并决策的输入至少有三样:形状后验的重叠度、疤痕清单的兼容性、材料参数的一致性。合并的形式不是简单相加,而是贝叶斯合并。若两条记录的参数后验都近似高斯, 与 ,独立观测合并后的后验仍是高斯,其精度相加:
这个形式的含义是「信息相加」:两条记录各自掌握的证据被累加,不确定性只会变小不会变大。它成立的前提是两条记录确实是同一个体、且观测相互独立;如果它们其实是不同个体,精度相加会把两个错误的峰强行压成一个更窄的错误峰,合并后的置信度反而更高。这就是错误合并最危险的地方——它不仅污染状态,还会伪造置信度。
这两个式子只对高斯近似成立。对粒子集合,合并意味着把两组粒子按权重拼接后重新重采样;对非参数后验,则可以直接保留两组并加上关联假设。合并要记进事件流,并保留原始记录作为 alias,以便将来撤销。
合并还有一个容易被忽略的前提:两条记录必须在同一参考坐标系下。如果一条记录的参考形状是三个月前的扫描,另一条是昨天的,直接求均值会把坐标系错位当成形状差异。所以合并之前必须先做参考对齐:用疤痕与慢变量估计一个刚体变换,把旧参考搬到新参考下,再合并。
形状身份与物理状态的一致性
最后需要强调一点:身份判定与物理状态更新必须是同一份账本。如果关联把观测 分给了记录 ,那么 的塑性状态必须按 的证据更新;如果关联被撤销,这次更新也必须被撤销。这要求所有状态写入都带事务边界:一次关联是一个事务,事务内修改的字段与原值一起写入事件流。
没有这个约束,就会出现很隐蔽的错误:一次错误的合并污染了 ,之后关联被纠正了,但 里已经混进了别的物体的变形。由于 只被写入、不被还原(这是(四十五)强调的物理性质),这种污染无法通过反向计算消除。唯一可靠的修法是回到合并前的事件点,重放从那里开始的所有合法事件。
这也是为什么事件溯源不是「可选的工程优化」,而是身份正确性的必要条件。
形状记忆的存储与遗忘
分级存储
身份、形状、疤痕、材料参数加在一起,按访问频率与大小,可以自然地分成四级:
| 层级 | 内容 | 典型规模 | 访问频率 | 读延迟预算 |
|---|---|---|---|---|
| hot | 正在操作物体的完整粒子状态 + 后验 | ~400 KB / 物体 | 每控制周期 | 微秒级 |
| warm | 近会话物体的参考层 + 压缩残差 | ~15 KB / 物体 | 每帧到每次会话 | 毫秒级 |
| cold | 疤痕清单 + 慢变量 + 摘要 | ~1 KB / 物体 | 跨会话 | 秒级 |
| archive | 事件日志 + 关键快照 + 撤销记录 | MB/物体 | 审计、恢复 | 分钟级 |
分级的意义不是省磁盘,而是让读取延迟与推理回路匹配:控制回路只需要 hot 层,观测更新只需要 hot 加 warm,身份判定需要 cold,审计需要 archive。如果所有东西都放在一个扁平存储里,控制回路就会被不必要的反序列化拖慢。
hot 层的淘汰规则应该由塑性事件驱动:如果一个物体连续 秒没有被触摸、也没有被观测,它就可以降级到 warm。这比固定时间窗口更合理——搬运中的物体可能长时间被握住,但它仍然是 hot 的。
遗忘什么,保留什么
「遗忘」在形状记忆里不是一个模糊的比喻,它有明确的三类对象。
遗忘观测细节,保留状态摘要。某个物体上周的某一帧点云不必保留,它已经被融合进参考形状。删除它是安全的,因为所有影响都被转化成了状态增量。判断标准很简单:如果删掉之后重放事件流能得到同样的状态,它就可以删。
遗忘合法的弹性形变历史,保留塑性改写。弹性形变是瞬时的,恢复之后不留痕迹。它的历史只在任务分析时有用,对身份和物理状态没有贡献。
不遗忘疤痕。疤痕是身份证据,也是材料疲劳的指针。它可以被压缩(降低分辨率、只保留位置与深度),但不能被删除,除非有明确的证据表明它已经不存在(例如物体被重新熔铸)。
这三类对象的遗忘策略可以写成一句话:遗忘可以从状态重建出来的,保留重建状态所必需的,以及不能重建的。疤痕属于第三类,因为它一旦被观测错误就会永久污染身份;事件日志属于第二类,因为它是重建的唯一来源。
遗忘的信息论视角:Atkinson–Shiffrin
在视频对象分割领域,XMem(2022 年提出、发表于 ECCV 2022)把一个经典的人类记忆模型搬进了神经网络。Atkinson–Shiffrin 记忆模型把记忆分成三个存储:感觉记忆、工作记忆和长期记忆,三者之间有关联强度。XMem 的动机很直接:处理几个小时长的视频时,如果每帧都进记忆,内存会无限增长;如果只保留最近几帧,又会丢掉早期出现过的目标。
XMem 的做法是把记忆分成三层:感觉记忆每帧更新,只保留当前帧的特征;工作记忆每 帧更新一次,容量固定;长期记忆在工作记忆满时做一次「巩固」,把多帧的特征归纳成原型再写入,并随访问次数的减少逐步遗忘。
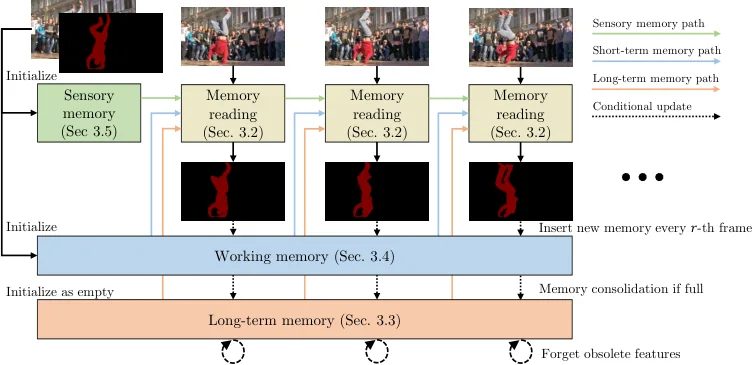
上图是 XMem 的总体结构,可以清楚看到三层记忆的读、写路径不同:读取时三层都参与,写入时感觉记忆是每帧的、工作记忆是每 帧的,长期记忆只有在工作记忆满的时候才通过巩固写入。这个设计对形状记忆的启发不在于具体网络,而在于把「多久写一次」和「存多少」分开管理。
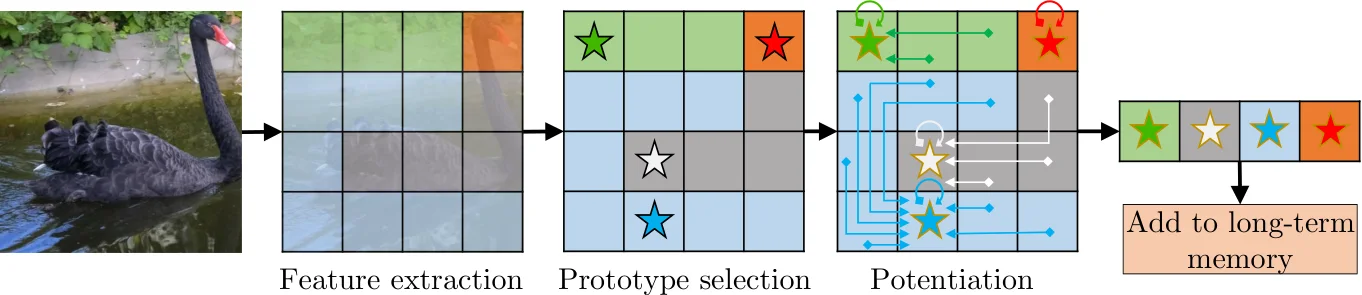
上图是巩固过程:先从一堆候选特征里挑出少量原型键(图中的星号),再用非局部聚合把全部候选的值汇成更代表性的原型值(金色轮廓),最后只把这少数原型写入长期记忆。它本质上是一种基于代表点的降采样:同样的信息量用一个原型的读取次数就够了,没必要保留所有帧。
把这两个思想搬到形状记忆上,可以得到三层写策略:每帧写感觉层(当前形状观测);每个塑性写入事件写工作层(局部增量);当某个物体的累计变化超过阈值时,做一次巩固,把这段时间的所有增量归纳为一次快照与一条疤痕摘要,写入长期层。
巩固与检索:用原型表示一个形状记忆簇
巩固的具体形式可以借鉴检索问题里的原型做法。假设一个物体在长期里有 次再锚定快照 ,我们不想存 份完整网格。可以做两件事:
第一,计算形状的主形变模式。把每次快照相对初始模板的形变写成向量 ,做奇异值分解:
保留前 个左奇异向量 与对应的系数,任意快照可以用 重建。如果塑性只在少数几个部位反复发生, 通常远小于 ,存储从 份网格降到 个基向量加 组系数。这与(三十三)里多粒度抽象的「低维有效动力学」是同一种思路。
第二,为每个快照维护一个检索键——不是整张形状,而是若干代表性特征:疤痕质心的局部坐标、主要弯曲角、接触面法向分布。跨会话关联时先用检索键做粗筛,再对少量候选做精细配准。这样做让检索成本与候选数量而非存储量成正比。
原型本身也要更新。如果某个基向量的系数在最近很多次快照里都接近零,说明这个形变模式已经不再发生,可以把它从活跃集中移出(但保留在 archive 里以备审计)。这就是「遗忘」在低秩表示上的具体形态:遗忘的是不再被使用的主模式,而不是原始数据。
带约束的遗忘阈值
遗忘决策必须与身份证据绑定,否则会出问题。一个直接的做法是给每个字段设置「遗忘半衰期」,但这对疤痕是危险的:疤痕随时间只增不减,遗忘它等于自毁身份。
更合理的做法是给每个字段定一个访问记账:记录它上次被用于身份判定、状态更新或任务执行的时间与结局。遗忘策略据此决定:
- 如果某个疤痕在最近 次身份判定里都参与过且从未造成误判,保留。
- 如果某个疤痕在最近 次判定里从未被使用,降低分辨率。
- 如果某个疤痕曾被用于判定但随后被证明属于错误合并的产物,标记为可疑,等审计后删除。
这个记账规则与(四十四)的寿命余量是同一类账本:两者都要求「有证据才删除」,而不是「时间到了就删除」。
记忆预算与分配
当物体数量增长,记忆分配就变成一个优化问题。设物体 的记忆代价为 ,其中 是分配给它的字节数;物体 在接下来一段时间内被操作的概率为 ;如果记忆不足导致的额外误差代价为 (例如形状压缩误差导致的抓取失败损失)。在总预算 下:
这个拉格朗日问题的解有一个很直观的形式:在最优处,各物体的边际收益相等:
也就是说,被频繁操作的物体应该多分记忆,因为它每次失败代价都乘以 ;长时间不用的物体可以分得少,甚至可以完全压成摘要。 是预算的边际价格。
这个公式还给出一个实用推论:不确定性熵高的物体应该多分记忆。因为熵高意味着形状压缩的误差大, 对 更敏感;反之,一个已经被摸得很熟、形状几乎不动的物体,即使被频繁操作,压缩误差也很小,可以少分。
检索索引
存储之外,读取速度同样重要。身份再关联时要在几百条记录里找到候选,不能线性扫描。可用的索引至少有两类。
几何索引:用形状的低维嵌入(例如 的系数,或者形状检索键)建近邻结构,如 KD-tree 或 HNSW。它回答「哪些记录的当前形状最接近这个观测」。
拓扑索引:用疤痕图谱的关系建图——哪些物体曾一起出现、哪些物体可以放入哪些容器、哪些物体在空间上常相邻。拓扑索引回答「这个物体可能在哪些位置」。
两类索引的组合可以显著减小候选集。查询时先用拓扑索引把范围缩到可能位置附近的记录,再用几何索引做形状匹配,最后用疤痕与材料参数做精细判定。
索引的维护成本也要计入预算。插入一条记录是便宜的;更新形状嵌入要重建索引位置,如果每次观测都更新,索引会被写爆。折中的做法是只在再锚定或巩固时更新索引,与快照策略保持一致。这样索引更新频率与真实形状变化频率挂钩,而不是与观测频率挂钩。
推理链路里的成本账
把以上机制接进世界模型的推理回路,可以得到一张分时间尺度的成本表。
| 环节 | 频率 | 主要操作 | 典型成本来源 |
|---|---|---|---|
| 分割与观测更新 | 每帧 | 视频分割、配准、残差更新 | 前端网络推理 |
| 身份关联 | 每帧到每会话 | 代价矩阵、分配 | 候选数 × 配准次数 |
| 塑性写入 | 每次接触 | 返回映射、事件追加 | 粒子数 × 迭代 |
| 巩固 | 形变阈值触发 | SVD、原型写入 | 快照数 × 基向量数 |
| 跨会话识别 | 每次会话开始 | 检索索引、粗配准、精细匹配 | 候选数 × 配准次数 |
| 审计与恢复 | 异常时 | 事件重放 | 事件数 × 触及粒子数 |
每一行都可以独立优化,但它们共享一个约束:控制回路的时间预算。控制周期通常是毫秒到十毫秒量级,身份关联如果做在控制回路里,候选数必须很少;如果放在控制回路之外(例如在感知线程里每几十毫秒做一次),候选数可以多一些,但关联延迟会影响下一次抓取时 id 的可用性。
一个实用的分工是:hot 层的身份维持放在控制回路,用运动连续性做快速关联;跨物体、跨会话的复杂关联放在低频线程,用全套证据做精细判定。两层之间用「暂时性 id」衔接:低频线程的结果回来以后,再合并或改判。
与(四十五)的推理账相比,这一篇新增的成本主要有三项:关联的代价矩阵计算、事件的追加与重放、索引维护。前两项随物体数增长,第三项随快照数增长。三项里最容易被低估的是事件重放——一次错误的合并在三个月后才被发现,需要从三个月前的事件开始重放,成本可能是分钟级。所以事件流必须设计成可以按子区域重放:只重放被污染的粒子及其邻居,而不是整个物体。
动手算一算:三个硅胶块的身份关联
把前面的机制缩到一个最小场景里算一遍,能看清每个参数到底在做什么。
三个同型号硅胶块 ,名义边长为 5 cm,名义质量 40 g。经过一段操作后,三者都有了不同的疤痕: 在左上角被压出一个 3 mm 深的凹痕, 中段被弯出约 8° 的永久弯曲, 有两个 1 mm 凹点。现在三块被重新摆放,位置换过,外观光照也变了。
形状项的残差用「在记录 的合法形变空间内拟合后的残差」计算。对 ,若观测的形状是 再被压 2 mm(合法塑性写入),拟合残差约为零;若观测的是 的弯曲形状,合法形变空间里无法用 的疤痕去产生一个中段弯曲,残差约等于弯曲带来的顶点均方偏差,例如 4 mm。外观项在光照变化后可能对全部候选都很接近,差异只有 0.2 左右。疤痕项则直接给出判别: 的凹痕在局部坐标里位置固定, 的观测上找不到这个位置的凹痕。
取权重 ,把各项归一化到同一量纲后,一个典型代价矩阵大致如下(行是观测,列是记录,单位为相对代价):
| 新建 | ||||
|---|---|---|---|---|
| 观测 1(左上凹 3 mm) | 0.1 | 3.4 | 2.6 | 2.0 |
| 观测 2(中段弯曲 8°) | 3.2 | 0.2 | 2.9 | 2.1 |
| 观测 3(两个小凹点) | 2.7 | 2.8 | 0.3 | 1.9 |
「新建」列的代价是常数,代表「不匹配任何记录」的先验。三行的最小值都在对角线上,分配没有歧义。如果观测 3 被遮挡,只剩两个凹点、置信度很低,ByteTrack 式的二轮关联仍然应该保留它——因为它对 的代价远小于对 或 ,而遮挡结束后疤痕位置就是决定性的证据。
如果再加一个第四块 ,它出厂后从未被操作,形状与三者都不同且有 0.3 mm 的表面瑕疵,观测 4 对 的代价为 0.2、对「新建」为 1.9,也能正确分配。真正困难的情形是 恰好有一个 3 mm 的左上凹痕与 一致:这时几何项无法区分,只能靠材料参数( 被反复压过,屈服应力已下降约 15%)与质量差异来拉开距离。这就是为什么第二节的表格把材料参数列为「强」证据。
再算一次记忆账。三块物体各 4096 个粒子,hot 层 426 KB × 3 ≈ 1.3 MB;若其中两块已经十分钟没有触碰,被降到 warm 层,用形变节点加稀疏残差表示,各约 14 KB,hot 层只剩一块的 426 KB,合计约 454 KB。这 30 倍的差距,就是「分级存储」在一张桌子上的实际意义。
小结
这一篇把(四十五)结尾提出的「形状身份如何延续」拆成四层来回答。
身份的形式化上,身份不是几何量,而是一个被维护的假设。数值身份承载状态,类别身份提供先验,指称身份消费状态。判定身份必须用比形状更慢的证据——疤痕、材料参数、质量——而不是形状相似度本身。关联错误的两类代价不对称,错误合并不可逆、错误分裂可恢复,这决定了系统应该默认分裂并保留候选。
形状的持久化上,存的是后验而不是单点,一条记录分四层:共享的类别层、版本化的参考层、可压缩的残差层、记录形状的不确定层。事件溯源是身份正确性的必要条件,因为它把每一次塑性写入与关联决定都变成可重放、可撤销的记录。
跨物体再关联上,软物体要求分割与关联联合推断;匹配代价应在合法形变空间内取残差,而不是直接比形状。跨会话的参考应滚动到会话末快照,因为初检录的模板会被操作改写。合并要在一个统一参考坐标系下做,并记入事件流以便撤销。
记忆的存储与遗忘上,分级存储让读取延迟与推理回路匹配;遗忘的对象是可以从状态重建的观测细节与弹性历史,而不是疤痕和事件日志。XMem 的三层记忆与巩固机制给出了「写频率与容量分开管理」的模板,低秩主模式则给出了「用原型表示一个形状记忆簇」的具体做法。记忆分配本质上是一个预算优化问题,最优解让各物体的边际收益相等。
把这一篇压缩成一句话:形状身份要经得起形状改变——它靠的不是几何相似,而是「慢证据做判定、后验做表示、事件流做账本、分级存储做预算」这套同时在运行时成立的结构。
至此,软物体几何这条支线走完了一个闭环:表示与形变场在(四十五),塑性与损伤在(四十四),身份与记忆在这一篇。再往下,问题就不再是「一个物体的几何怎么记」,而是多个物体如何组成结构、结构如何被操作——那属于装配与任务层,与本支线共用同一套事件流,但需要另一套关于关系的表示。
参考资料
- SAM 2: Segment Anything in Images and Videos
- XMem: Long-Term Video Object Segmentation with an Atkinson-Shiffrin Memory Model
- FoundationPose: Unified 6D Pose Estimation and Tracking of Novel Objects
- DeformGS: Scene Flow in Highly Deformable Scenes for Deformable Object Manipulation
- Particle-Grid Neural Dynamics for Learning Deformable Object Models from RGB-D Videos
- Robust Shape Estimation for 3D Deformable Object Manipulation
- Neural Stress Fields for Reduced-order Elastoplasticity and Fracture
- ByteTrack: Multi-Object Tracking by Associating Every Detection Box
- PhysGaussian: Physics-Integrated 3D Gaussians for Generative Dynamics
- 世界模型从零讲起(四十五):形状被改写之后——形变场、参考形状重建与一个会变的形状状态
- 世界模型从零讲起(四十四):软物体不会一直原样——塑性变形、疲劳与材料属性漂移
- 世界模型从零讲起(二十九):不确定的时候该往哪看——主动感知、信息增益与下一次观测的选择
- 世界模型从零讲起(三十三):同一套动力学,换一层粒度还成立吗——多粒度结构管理与抽象误差账本
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



