


世界模型从零讲起(四十四):软物体不会一直原样——塑性变形、疲劳与材料属性漂移
上一篇《接触之外的黏滞》把软接触拆成黏附、液桥、湿摩擦与黏弹性四条线,最后落在一个表示问题上:哪些量该写进世界状态,哪些量可以由公式临场求值。那一篇的讨论有一个始终没有说出口的前提——材料的属性是常数。黏附能 、杨氏模量 、松弛时间 、摩擦系数 被当作一组固定的数,标定一次,之后一直用。
这个前提在实验室里勉强成立,在一次完整的真实任务里几乎从不成立。一块橡皮泥被捏过十次之后不再是同一块橡皮泥:它被拉长过、压扁过,松手之后回不到原来的形状;一根硅胶软管反复弯折几百次之后,弯折处出现发白的细纹,刚度下降;一块海绵吸了水又晾干,硬度变了一个档;一只软体夹爪用了三个月,抓同样的杯子需要更大的气压。形状变了、刚度变了、寿命少了——这三件事都不是观测噪声,而是物体自身的状态发生了不可逆的改变。
这一篇讨论的就是这个「软物体不会一直原样」的问题。核心结论可以提前说:材料参数不是常量,而是慢变量;塑性应变、损伤与寿命消耗不是观测量,而是必须由模型自己积分的隐藏状态。世界模型如果只把它们当成标定常数,就会在第一次卸载之后开始漂移,并且漂移的方式是系统性的——不是随机误差,而是每次都朝同一个方向偏。
先定位:这一篇与系列的关系
系列此前多次碰到过「物体属性会变」的边缘,但没有正面处理。(三十九)把世界状态里的量分成状态量、慢变量、常量先验与导出量四类,当时把材料参数放在「常量先验」里,理由是标定一次够用;(三十五)讨论过在线更新如何改写误差账本,但更新的是模型参数,不是被建模物体的物理参数;(四十一)讨论宿主与内容物的双向耦合,耦合矩阵里用的刚度仍然当作已知;(四十二)与上一篇讨论接触的离散状态与软接触的连续量,材料的本构关系被默认为弹性或黏弹性,没有塑性。
这一篇要做的修正很具体:把「常量先验」里的材料参数降级为慢变量,把「导出量」里的一部分(残余形状、当前刚度)升级为状态量,并给出这三个新状态——塑性应变、损伤、寿命消耗——的演化方程与推理成本。它也会顺带回答一个工程上很常见的问题:为什么同一个抓取策略在新物体上有效、在用了两个月的同一个物体上失效。
塑性变形:形状为什么回不去
从胡克定律到屈服
弹性体的定义是:卸载之后回到原状。胡克定律把它写成 ,应力与应变一一对应,路径无关。软材料在小应变下近似满足这条规律,硅胶在 10% 应变以内的应力-应变曲线基本是一条直线。
但软材料能承受的应变远大于金属。硅胶可以拉伸到 300%,橡皮泥可以被压扁到原厚度的一半,面团可以被擀成薄片。在这些量级上,线性关系先失效,接着弹性本身失效:应力达到某个阈值之后,材料开始「流动」——应变继续增加,应力却基本不涨;卸载时应力沿着一条与加载时不同的路径下降,卸载到零应力时应变不为零。剩下的这部分应变就是塑性应变 。
用一句更形式化的话说:总应变可以分解成弹性部分与塑性部分,
弹性部分承担应力,塑性部分不承担应力但改变了物体的参考形状。加载时两部分一起增长;卸载时只有 回退, 留在原地。这就是「回不去」的全部机制。
屈服准则:什么时候开始流动
判断材料是否进入塑性,需要一个屈服函数 ,约定 表示纯弹性, 表示正好在屈服面上, 在物理上不允许(数值上会出现,靠返回映射拉回来)。
对金属和很多软聚合物,最常用的是 von Mises 准则。它只依赖应力偏量 ,写成
其中 叫等效应力, 是单轴屈服应力。这个准则的物理含义是:屈服由形状改变的能量驱动,与静水压力无关。把一块硅胶放进深水里,它的屈服行为不变,这与金属的实验事实一致。
对橡皮泥、湿沙、面团、奶油这类颗粒性或含孔隙的材料,静水压力会显著改变屈服强度:你把手掌平压在橡皮泥上,压得越深,它越难继续变形。这时要用压力敏感的准则,最常见的是 Drucker-Prager:
其中 是应力第一不变量,, 与 由内摩擦角 与黏聚力 换算:
时退化为 von Mises。内摩擦角越大,材料对围压越敏感。这个细节在机器人操作里不是学术装饰:橡皮泥被压扁时,侧向的约束会改变它的表观屈服强度,同一个按压深度在宽容器里和窄容器里得到的力不一样。如果世界模型用 von Mises 拟合橡皮泥,它在薄片状物体上的预测会系统性偏软。
流动法则与体积守恒
屈服之后应变往哪个方向增长,由流动法则决定。关联流动假设塑性应变率沿屈服面的法向:
对 von Mises,,这是一个纯偏量、迹为零的方向。也就是说塑性流动不改变体积。这一点非常重要:一块橡皮泥被压扁,它的厚度减小,宽度和长度必须相应增加,总体积不变。很多视觉方法看到物体「变小了」,其实是投影或遮挡,而不是体积真的消失了;真正发生体积变化的通常是压实、含水率变化或断裂,那是另一类机制。
对 Drucker-Prager, 含有静水分量,塑性流动会带来体积压缩(剪胀或剪缩),这正是颗粒材料「越压越实」的来源。
硬化与返回映射
屈服面不是固定的。材料屈服之后继续变形,通常需要更大的应力才能继续流动,这叫硬化。两种最常见的写法:
等向硬化把屈服应力写成累积塑性应变的函数:
其中 是等效塑性应变, 是塑性模量。 叫理想塑性,屈服之后应力不再增长; 叫硬化。
随动硬化不改变屈服面的大小,而是让它整体平移,用背应力 表示中心位置。Armstrong 与 Frederick 在 1966 年提出的非线性随动硬化模型写成
第一项让背应力跟随塑性应变增长,第二项叫动态恢复,让它在应变累积中逐渐饱和到 。这个模型能复现 Bauschinger 效应:先正向拉伸再反向压缩时,反向屈服应力明显低于正向屈服应力。橡皮泥和金属丝都有这个现象,等向硬化模型完全预测不出来。
数值上,有限元与 MPM 都用返回映射(return mapping)把试探应力拉回屈服面。以 von Mises 加线性等向硬化为例,先按弹性算出试探偏应力 与试探等效应力 ;若 ,这一步是弹性的;否则塑性修正量为
新的偏应力为
其中 是剪切模量。对实时性要求更高的场景,神经应力场一类降阶方法把弹塑性求解压缩到低维子空间,用少量自由度重建应力场 [6];它牺牲了一部分局部精度,换取可以在毫秒级完成的求解。
这个式子的几何意义很直观:屈服面在偏应力空间里是一个以原点为心的圆(三维里是柱面),试探点落在圆外,返回映射就沿着半径把它拉回圆上,所以叫径向返回。 出现在分母,是因为弹性卸载斜率与硬化斜率共同决定了「多走一步需要多少塑性应变」。这个算法的隐式一致性切线由 Simo 与 Taylor 在 1985 年给出 [10],它决定了牛顿迭代能否二次收敛;在可微物理里,它同时决定了梯度是否准确。
同一套仿真,不同的退化行为
塑性不是唯一一种「回不去」的方式。把几种常见软材料放在同一套仿真框架里,可以看出它们的退化路径完全不同。PhysGaussian 在 2023 年底给出过一个很直观的对照 [1]:同一套基于 3D Gaussian 的表示,加上不同的本构模型,就能分别模拟弹性体(狐狸玩具)、塑性金属(被压弯的飞机模型)、脆性断裂(烤面包被掰开)、颗粒材料(废墟)、黏塑性材料(果酱)以及多体碰撞(沙发)。
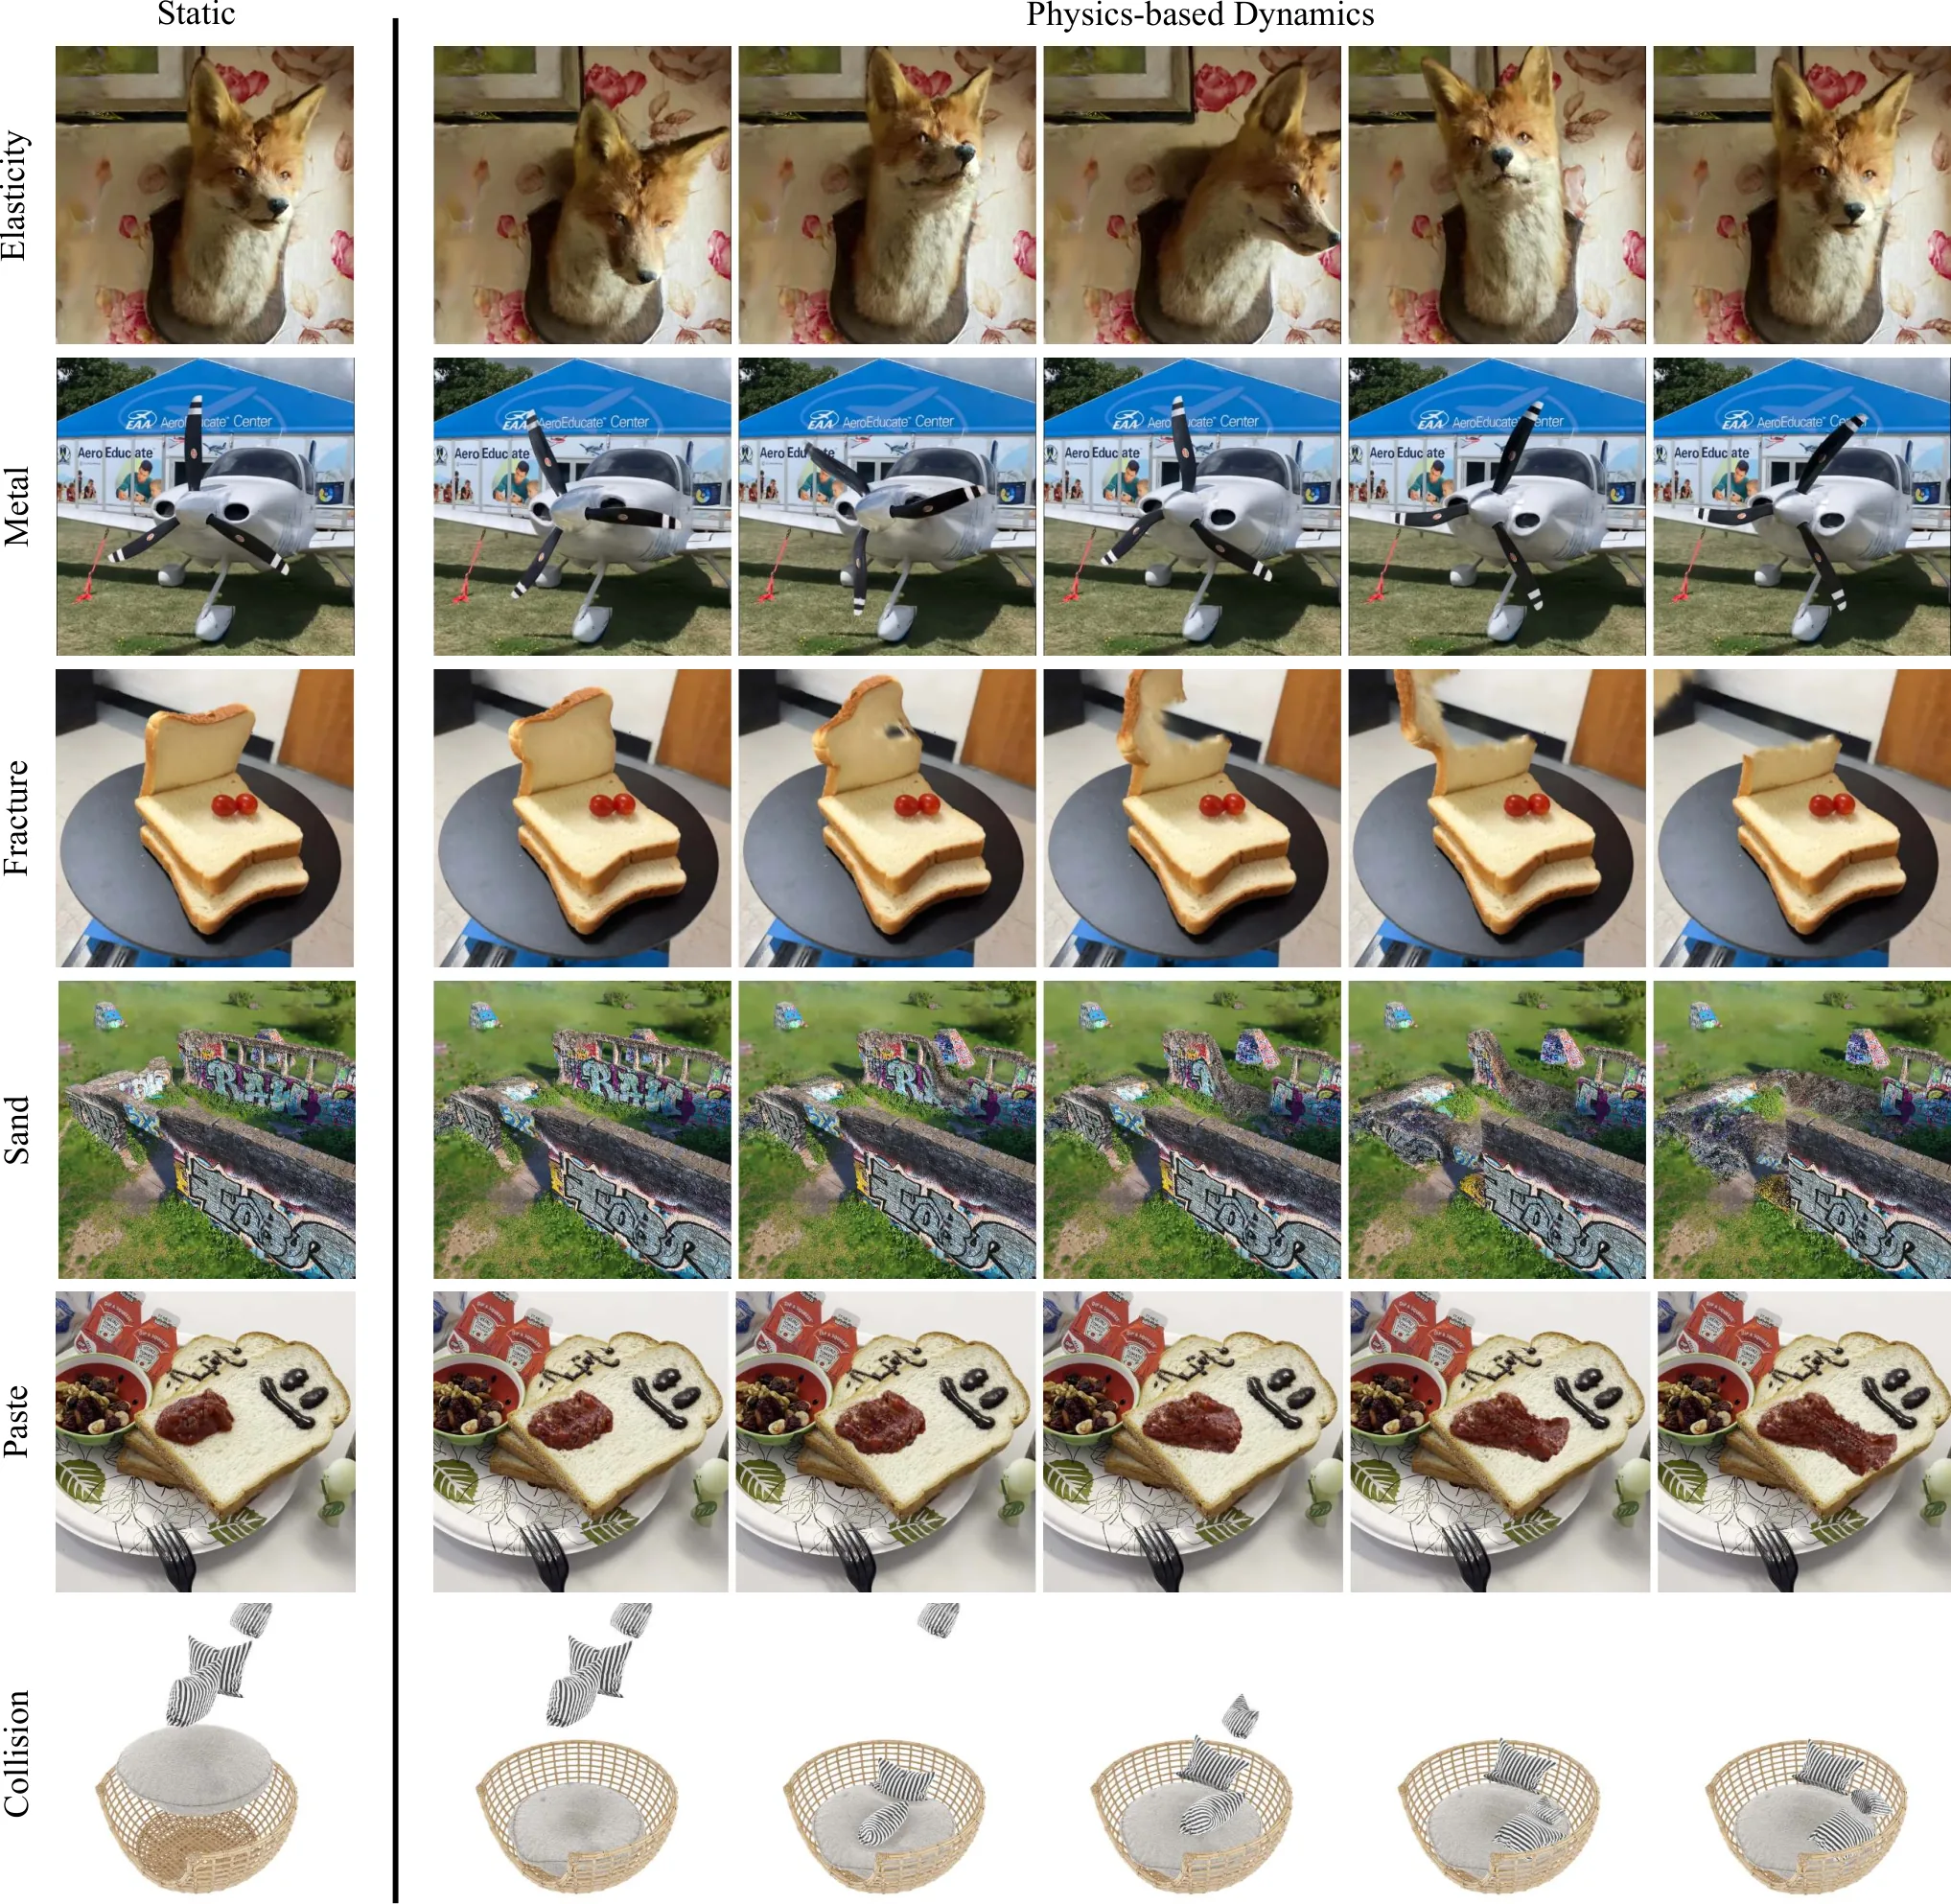
图中六个例子的差别不在渲染,而在本构:狐狸用弹性模型,卸载后恢复原状;飞机模型用塑性金属模型,弯折后保留永久变形;烤面包用断裂模型,裂纹一旦产生就不愈合;废墟用颗粒模型,没有内聚;果酱用黏塑性模型,既有屈服又有流动。对世界模型来说,这意味着「材料类别」本身就是状态的一部分——不能用一个弹性模型通吃。
对机器人操作最常见的三类软物体,退化形态可以这样对照:橡皮泥属于塑性材料,捏过之后保留形状,下次抓取时几何已经变了;面团介于塑性与黏弹性之间,静置时会自己摊平,形状随时间漂移;硅胶属于超弹性材料,单次加载后基本恢复,但在反复加载下会出现疲劳与永久形变。三者的共同点是:材料参数不能只看一次标定,必须假设它随载荷历史缓慢变化。
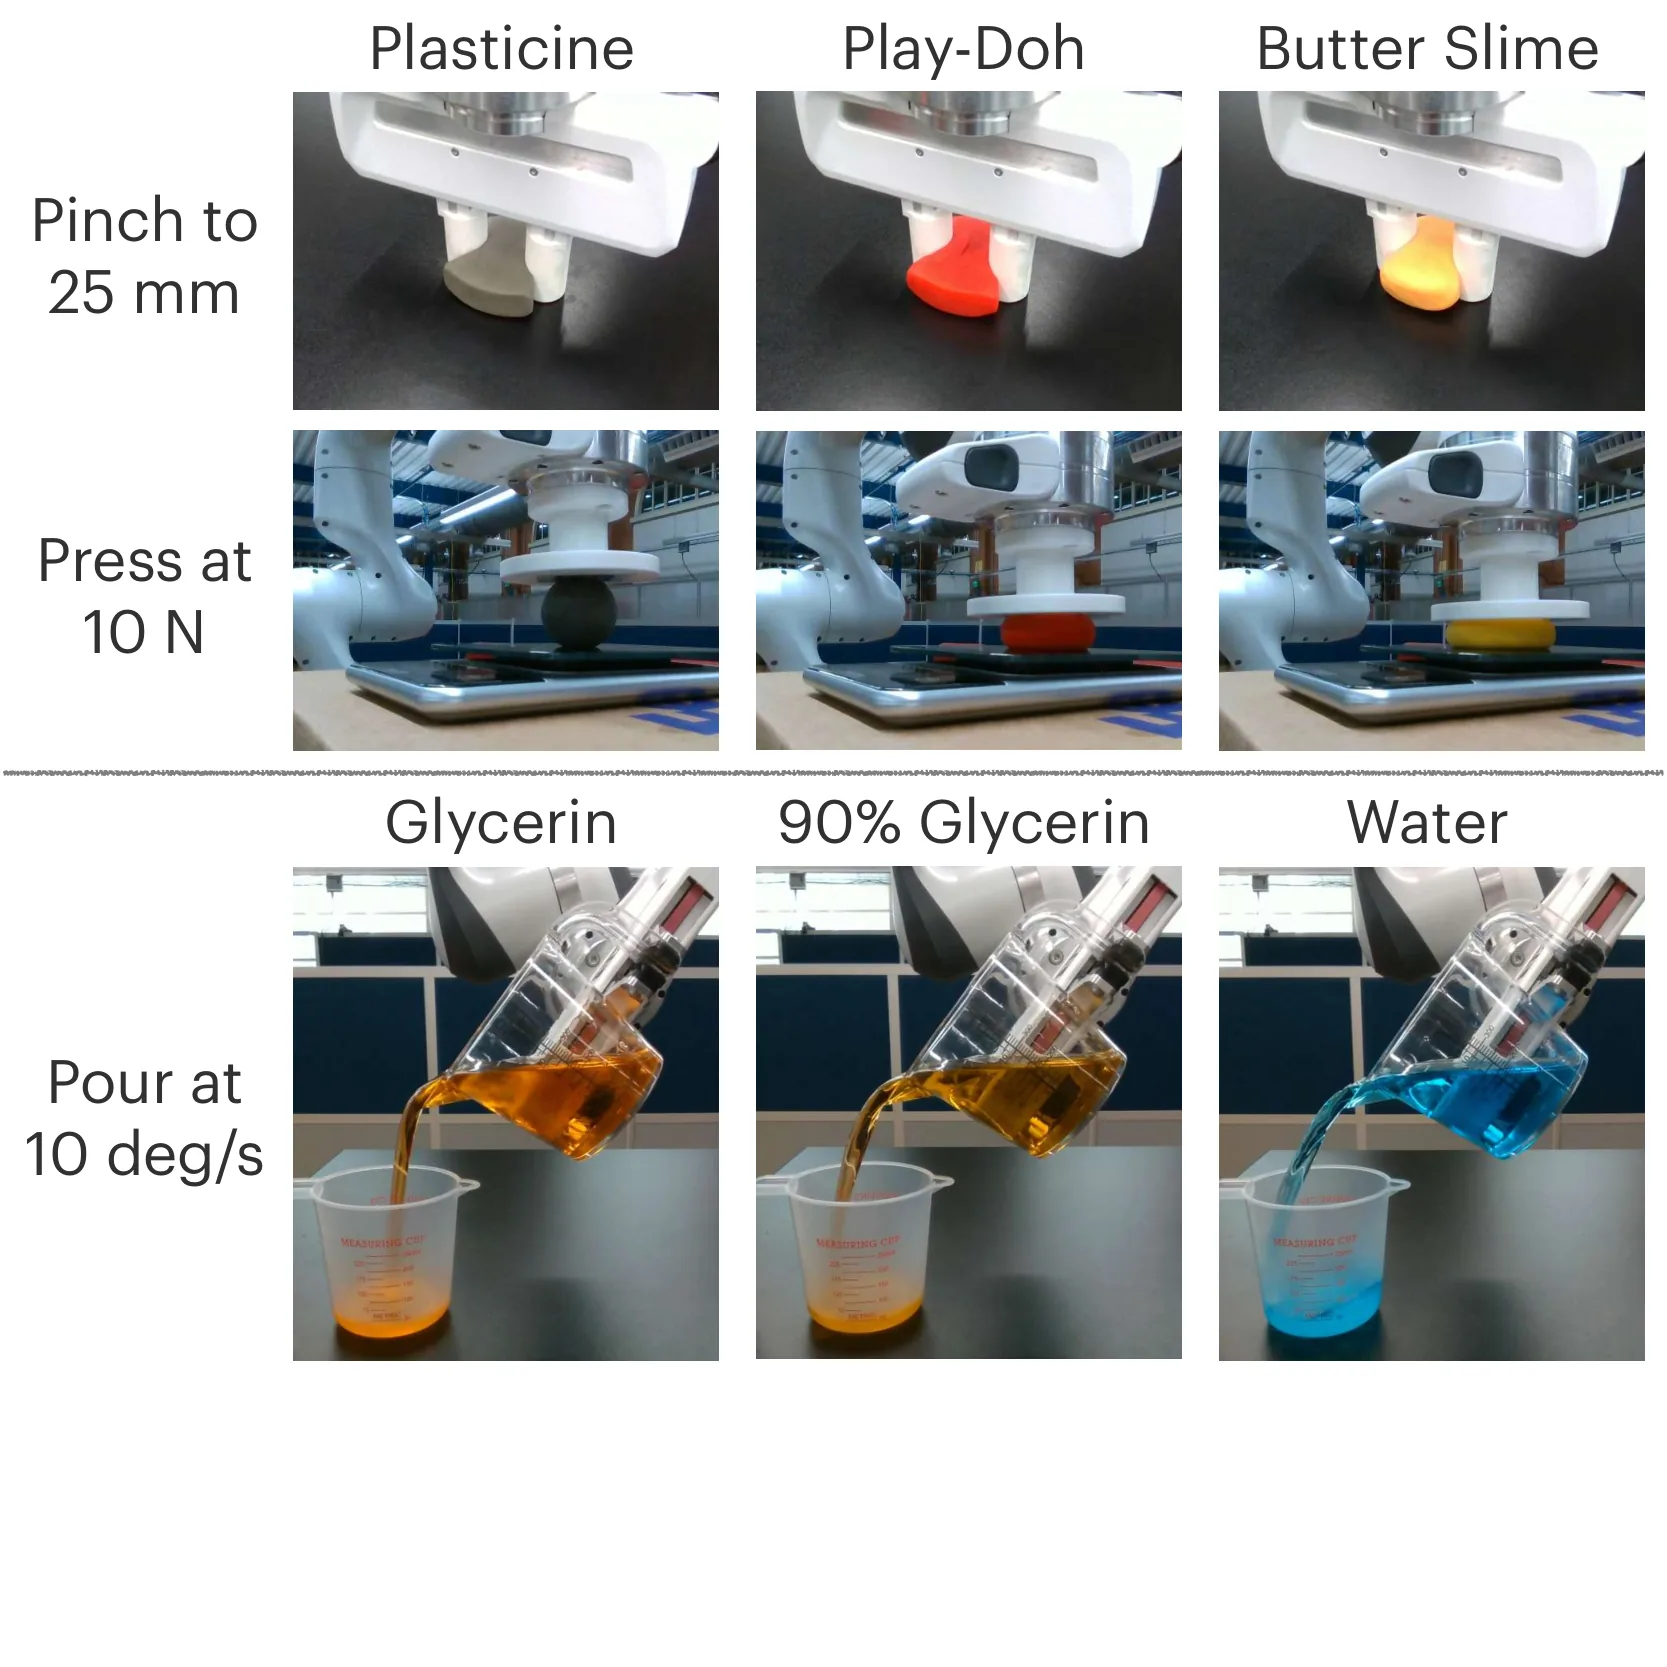
上图来自 FORM 的论文 [9],它把这件事做成了受控实验。上排是三种塑性材料(橡皮泥、黄油史莱姆、Play-Doh),从相同的初始形状出发,执行同样的 25 mm 夹取与 10 N 按压,变形量由各自的刚度与屈服阈值决定。下排是同一种倾倒动作、不同黏度的甘油溶液,流态完全不同。这里传递的信息是:动作相同,响应不同,差异全部来自看不见的材料参数。世界模型的任务就是从一次交互的响应里把这些参数反推出来。
一个可以手算的例子:拉伸、卸载、残余应变
把上面的公式套进一个具体数字,可以看清塑性应变有多大。取一根硅胶条,,屈服应力 ,线性等向硬化 。这三个数在软硅胶的合理范围内:模量几兆帕,屈服应力约百分之一模量,塑性模量约为模量的百分之一。
屈服应变是 。把它拉伸到总应变 ,此时
卸载时应力按弹性斜率 回退,回退的应变量是 。于是残余塑性应变为
也就是说,拉伸 30% 之后松手,这根硅胶条会永久变长近 25%。它的长度从 变成 。如果世界模型仍然用 做几何先验,下一次抓取时它会在一个错误的位置合拢手指,误差就是这根条子长度的四分之一。
这个例子还揭示了另一件事:塑性应变的大小依赖于加载路径。同一根条子,先拉到 30% 再卸载,与先拉到 20%、卸载、再拉到 30%,得到的残余应变略有不同,因为硬化历史不同。世界模型如果只用「当前形状」作为状态,它无法区分「本来就这么长」与「被拉长成这样」;而这两者的未来行为完全不同——前者的屈服储备已经用完,后者还保留着原始材料的状态。
循环载荷:滞回、Bauschinger 与每循环耗散
单次加载只损失一部分可恢复性。真正让软物体「老去」的是循环。抓取-放下-再抓取,每一次都让材料走一遍加载-卸载回路。若加载幅度超过屈服,应力-应变轨迹不再重合,而是形成一个闭合环,叫滞回环。
对理想弹塑性材料(),在对称循环下应变幅为 ,滞回环的面积可以手算。加载段从 到 :弹性段斜率 ,在 与 之间;塑性段应力恒为 。四条边围出的面积是
代入前面的数:,,,得到 。一块体积为 的橡皮泥,每个循环耗散 ;在 1 Hz 的抓放频率下,一小时耗散约 72 J。这些能量不会消失,它变成了材料内部的热与微观损伤——这正是疲劳的来源。
滞回环还有形状信息。真实材料的卸载段不是直线,加载与卸载的斜率不同,环的形状不对称,这来自黏弹性与随动硬化。Masing 规则给出过一个经验假说:循环稳定后的滞回环分支,等于单调曲线放大两倍。它对很多金属成立,对软材料经常不成立,因为软材料的黏弹性让响应依赖加载速率。世界模型若用一条静态的应力-应变曲线去预测循环行为,误差会集中在每个循环的转折点。
Bauschinger 效应在循环里表现得最清楚:正向加载到塑性后卸载,再反向加载,反向的屈服应力低于正向。用等向硬化模型,屈服面只会变大,反向屈服应力应该更高;实验里它反而更低。这说明屈服面在平移,而不是单纯膨胀。对操作来说,这意味着「压下去需要 10 N,抬起来再压一次可能只需要 8 N」——同样的动作,第二次的力反馈会小一截。如果世界模型用第一次的力标定参数,之后每一次都会高估所需力。
疲劳:损伤如何累积成一个看不见的状态
两种寿命:低周与高周
材料在循环载荷下失效,按循环次数分成两个区间。低周疲劳对应大应变、少循环(通常 次以下),主导机制是塑性应变的累积;高周疲劳对应小应变、多循环,主导机制是应力幅与微观缺陷。
低周区间用 Coffin-Manson 关系描述:
其中 是塑性应变幅, 是失效循环数, 是疲劳延性系数(约等于断裂延性), 是疲劳延性指数(典型值 到 )。高周区间用 Basquin 关系:
是疲劳强度系数, 是疲劳强度指数(典型值 到 )。两条曲线在某个寿命处相交,交点叫过渡寿命,它标记了「塑性主导」与「弹性主导」的分界。
代入前面的数字可以感受量级:,,塑性应变幅 ,则 ,解得 ,即 次循环。软材料在 10% 应变幅下只有几十次寿命,这个结论与橡皮泥反复折叠很快断裂的日常经验一致。金属在 0.5% 应变幅下可以有上万次寿命,两者的差别全在塑性应变幅上——因为指数 是负的,应变幅小一个数量级,寿命大两个数量级。
Miner 累积与它的失效场景
实际任务里的载荷不是等幅的。今天轻抓两次,明天重压一次,寿命怎么算?工程上最常用的是 Miner 线性累积准则:
是在第 级载荷下实际经历的循环数, 是该载荷幅下的失效寿命。 达到 1 时判定失效。它的假设是每级载荷消耗寿命的比例可以线性叠加,与顺序无关。
这个假设在软材料上经常不成立。低幅循环若落在疲劳阈值以下,几乎不消耗寿命;一次高幅过载可能让后续低幅循环的寿命反而延长(过载迟滞),也可能因为局部损伤而缩短。顺序效应的大小取决于材料:对橡皮泥这类颗粒材料,压实历史会显著改变后续强度;对硅胶,交联网络的损伤相对单调。世界模型使用 Miner 时,应当把它当成一阶近似,并把累积误差标在误差账本里,而不是当成精确的寿命预言。
连续损伤力学:把「坏掉多少」写成一个变量
Miner 给出的是一个无量纲的寿命消耗比例,它不告诉你刚度掉了多少。连续损伤力学(CDM)补上了这一环。Lemaitre 在 1985 年提出的延性损伤模型 [11] 引入损伤变量 ,把有效应力定义为
是完好材料, 是彻底失效。损伤的微观解释是微裂纹与微孔洞减少了承载面积,宏观上表现为刚度按 退化:
这个式子对世界模型特别有用,因为它把「看不见的损伤」变成了「可以测的刚度」。如果模型的参数估计显示 从 2.0 MPa 降到 1.4 MPa,那对应 。损伤演化通常写成载荷幅的函数,例如
其中 是阻力应力, 是材料指数。 出现在分母,意味着损伤越大,同样的应力幅造成的新损伤越多——这就是「最后一段坏得特别快」的数学表达。
软材料的疲劳阈值
这类「无模型」的塑形方法在视觉伺服里很有效 [19]:它不显式建立材料模型,而是用图像特征定义状态并直接优化动作。代价是策略与材料绑定,换一种橡皮泥就要重新调参——这从反面说明了为什么世界模型需要显式的材料状态。
软材料与金属的一个重要区别是有没有疲劳阈值。金属有疲劳极限:应力幅低于某个值,寿命趋于无限。软材料,尤其是水凝胶与弹性体,往往没有明确的无限寿命,但存在一个疲劳阈值 :循环能量释放率低于它时,裂纹不扩展。2020 年前后的一系列实验把合成水凝胶的疲劳阈值定在 1 到 100 J/m² 量级 [13],比单次断裂韧性低一到两个数量级。2021 年关于聚合物网络纠缠的研究给出了更细的口径 [14]:在聚丙烯酰胺水凝胶里,未纠缠网络的断裂韧性与疲劳阈值几乎相等;而纠缠网络的断裂韧性可以比疲劳阈值高十倍以上(最多 16 倍),这一提升来自裂纹尖端的局部耗散(链拔出与局部链脱粘),而不是整体滞回。也就是说,链纠缠拉大的是「单次断裂」与「疲劳扩展」之间的差距,疲劳阈值本身的量级仍然由单层链的断裂能决定。
对软材料疲劳的数值模拟还给出另一个提醒:接近疲劳极限时,失效时间并不服从常用的幂律,而是呈幂律发散,且强烈依赖材料的无序程度 [20]。这意味着任何基于少量循环的外推,在接近极限的区域都不可信。
对世界模型,这给出一个可用的判据:每次循环的耗散如果是阈值以下的小量,可以不计入寿命;超过阈值才进入累积。这比 Miner 的无条件线性叠加更接近实验。数值上,把 与单位面积的阈值能量做比较,需要知道裂纹面积;工程近似可以用「耗散功率密度 特征体积 / 特征裂纹面积」来估计。
参数漂移:标定一次为什么不够
漂移的几种来源
即使物体没有明显失效,它的材料参数也会随时间与载荷历史缓慢改变。可辨认的漂移来源至少有五类。
第一类是可逆的软化:交联聚合物在反复加载后出现 Mullins 效应,前几次加载的应力-应变曲线都比稳定后高,之后趋于一条下界曲线。Mullins 效应只依赖历史最大应变,卸载后不会立刻恢复,静置数天可以部分恢复。对世界模型,这意味着标定要取第二次加载的曲线,而不是第一次。
第二类是含水率变化:海绵、面团、橡皮泥的刚度与含水率强烈相关。橡皮泥放一天会变硬,切开的海绵干燥边缘更硬。含水率是一个慢变量,它的时间尺度是小时到天。
第三类是温度:温度同时改变模量与松弛时间。处于橡胶态的硅胶与天然橡胶,剪切模量由交联密度与绝对温度共同决定,温度升高时模量略升;接近玻璃化转变或结晶熔点时,模量随温度急剧下降。长期热老化还会改变交联密度,让材料整体变硬或变脆。
第四类是塑性应变导致的各向异性:多次单向拉伸后,材料在拉伸方向上变硬,在垂直方向上变软(Hill 在 1948 年的各向异性屈服理论 [15] 描述的就是这种情况)。各向异性意味着刚度不再是一个标量,而是一个方向依赖的张量。
第五类是损伤:刚度下降的一部分被 解释,另一部分来自微孔洞与局部脱粘,后者可能表现为黏弹性特征的改变——阻尼比升高,松弛时间变短。
这些漂移的共同特征是时间尺度远大于单次操作,但远小于「永远不变」。这正是慢变量的定义。把它们当常量,误差会随着任务次数线性累积;把它们当状态量并用观测更新,误差被约束在一次观测周期内。
在线表征:从观测反推材料状态
怎么知道参数漂移了多少?最直接的办法是给世界模型加一条「测量通道」:执行一个可控的小动作,观察响应,反推参数。FORM 在 2026 年提出了一个不需要迭代优化的做法 [9]:它用弱形式的动量平衡,把观测到的形变与接触力转换成关于未知参数的线性方程组,用一次最小二乘求解即可得到参数。
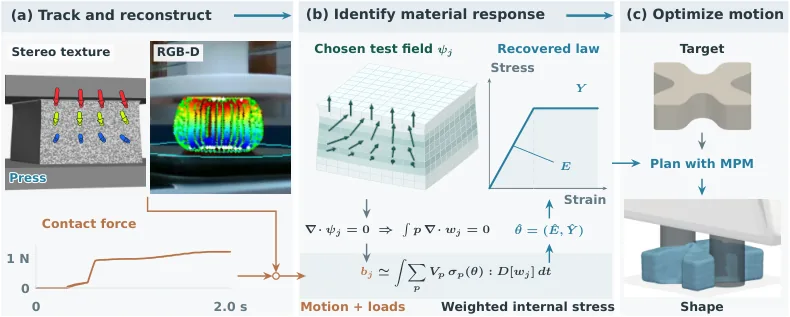
图中三个方框分别对应三段流程。第一步从立体视觉的纹理追踪与 RGB-D 重建出形变与接触力;第二步选取一组无散度的试探场 ,写出弱形式的平衡方程
试探场取无散度,是为了把静水压力项消掉——压力在无散度场下不做功,于是方程只剩下偏应力部分,而偏应力线性依赖于刚度 与屈服阈值 。这样一来,识别就变成了求解
其中 由试探场与形变的离散积分给出, 由惯性项与边界力给出。每个试探场给出一个方程,取多个试探场就得到一个超定方程组。论文报告的对照实验里,两块材料共享 ,但屈服阈值分别为 1 kPa 与 10 kPa;一次按压就能区分它们,识别出的模型能直接用于规划新的夹取动作。这个方法的代价很低:一次线性最小二乘,不需要跑几百次可微仿真。
迭代优化路线与它的代价
弱形式是一次求逆;另一条更通用的路线是可微仿真加梯度下降。UniPhy 在 2025 年的做法是学习一个统一的材料潜空间 [2]:它训练一个变形梯度投影网络与一个本构律网络,把这两者嵌入可微的 MPM 仿真器,再对材料潜变量 做梯度优化,使仿真轨迹与观测轨迹的 误差最小。
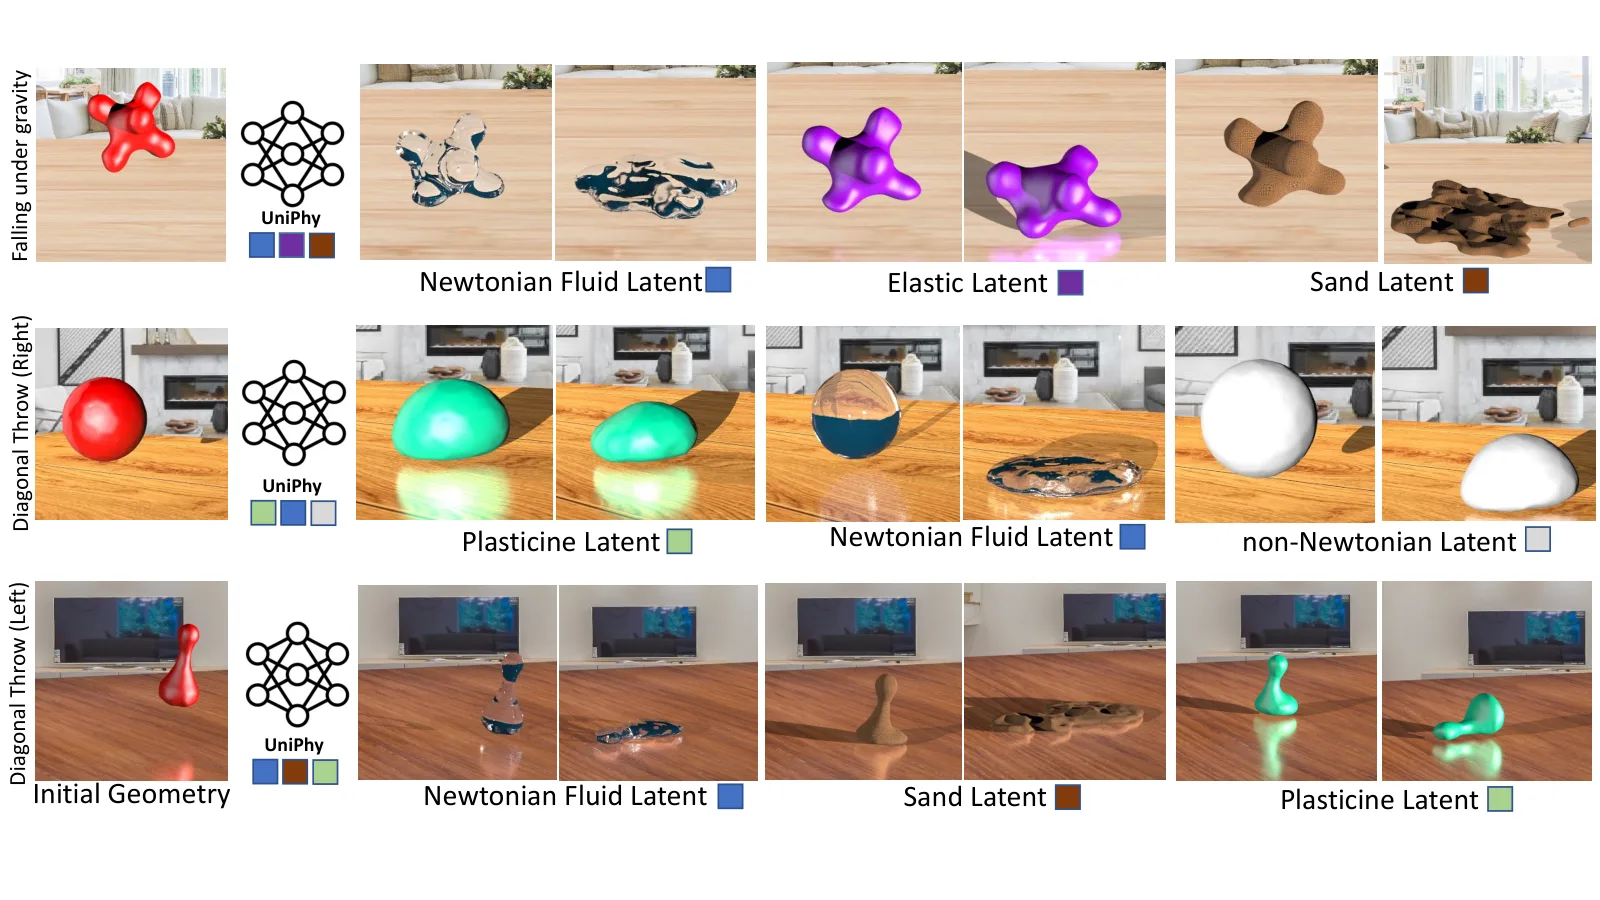
这张图说明 UniPhy 的关键设计:材料属性不再是一组手工指定的物理参数,而是一个潜向量。同一个几何形状,配上代表牛顿流体的潜向量会摊开,配上代表弹性体的潜向量会回弹。潜空间的好处是它能覆盖传统本构写不下的材料(例如既有塑性又有流体性的混合物),代价是潜变量没有物理意义——你无法从潜向量直接读出屈服应力,也无法与工艺参数(材料批次、固化时间)对话。
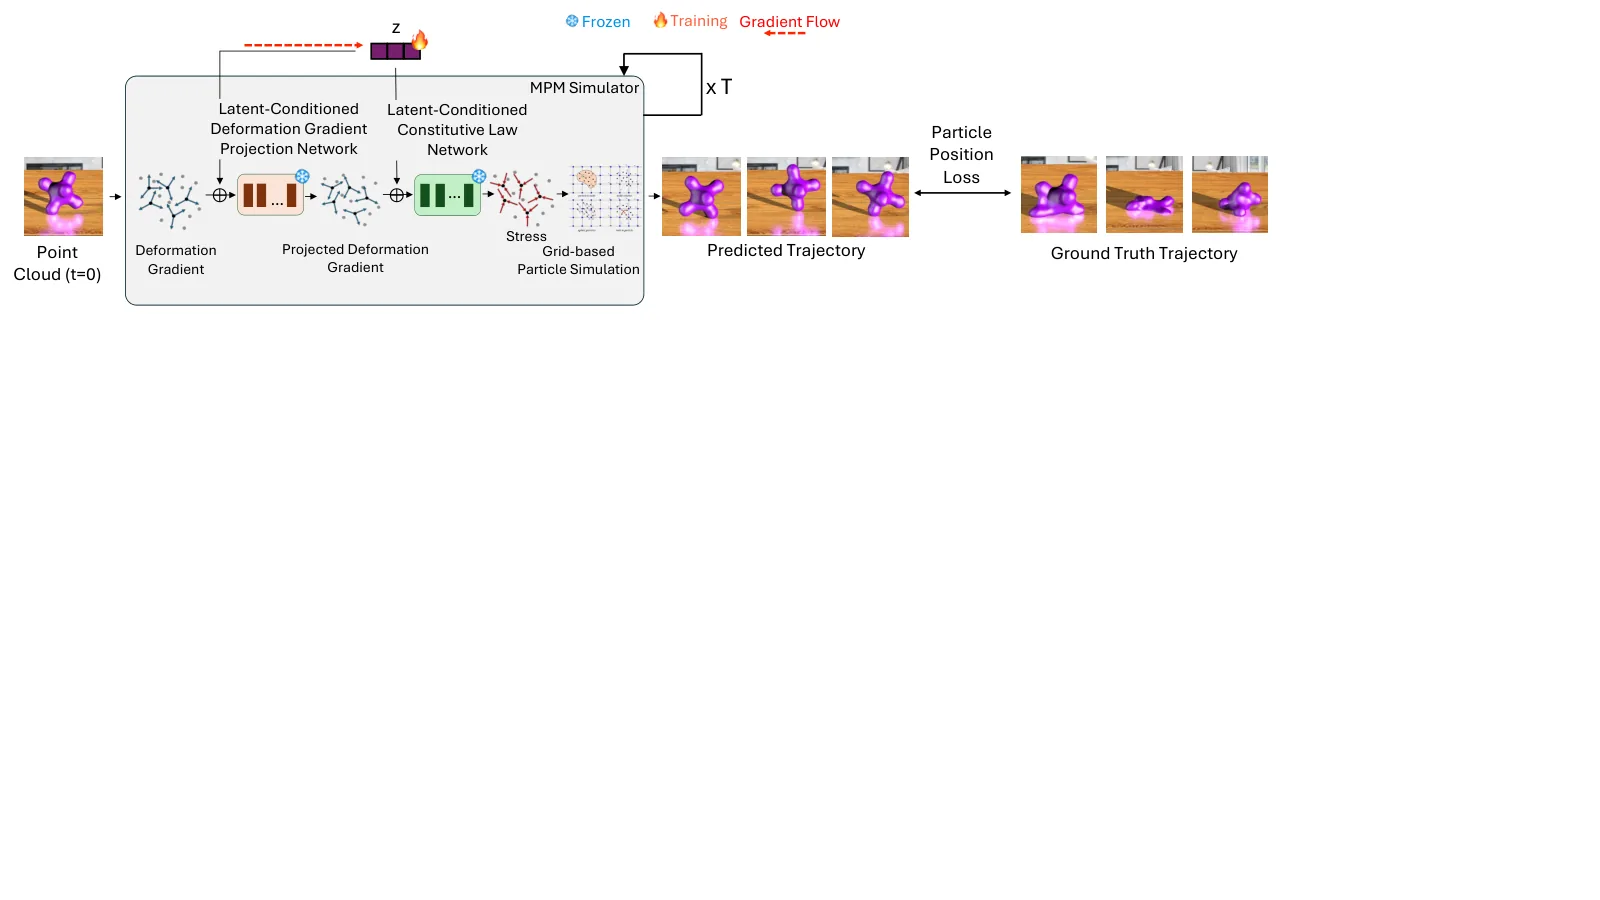
第二张图展示推理流程。注意图中标注「权重冻结」:优化发生在潜变量上,网络本身不再更新。这保证了推理的确定性,也让「材料表征」成为一次纯优化问题,可以反复做、可以做在线更新。但它的每个梯度步都要跑一遍 MPM 的前向与反向,长时程、多接触的轨迹上代价很高;这正是 FORM 用弱形式替代迭代的原因。
本构关系本身能不能学
第三条路线是把本构律本身当成可学习对象。PC-NCLaws 在 2025 年把弹性本构与塑性本构分别用两个网络表示,并嵌入动力学方程 [3]:弹性部分学习应力对弹性形变的映射,塑性部分学习塑性流动的方向与阈值。这样做的好处是本构律不再被限制在固定形式内,坏处是网络需要大量训练数据覆盖不同的变形路径,尤其在卸载-反向加载这类路径上。另一条相关路线不去替换本构,而是给神经网络本构加上热力学一致性约束——屈服与耗散必须满足第二定律,否则模型会在某些加载路径上「凭空产生能量」 [8]。
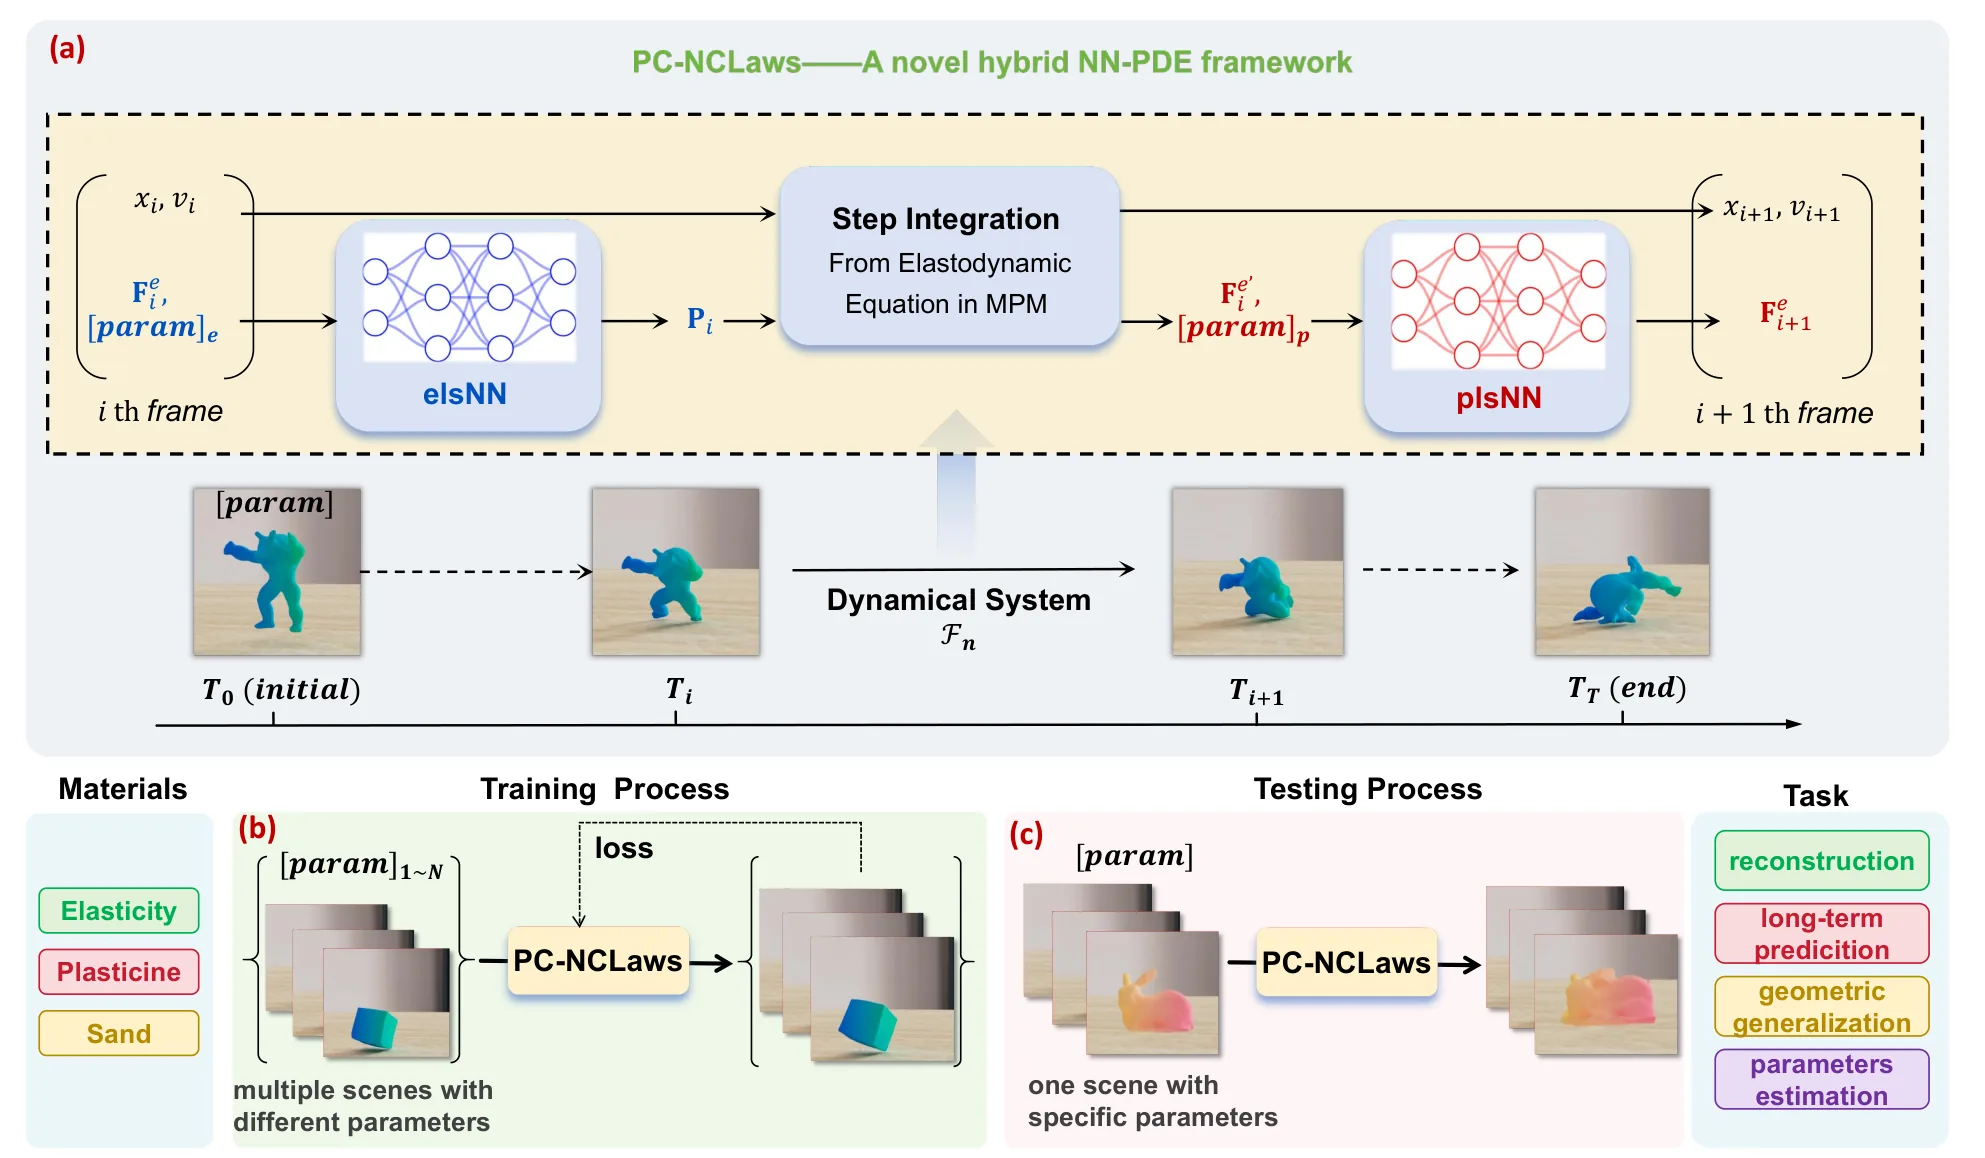
图中上半部分是训练时的结构:物理参数作为输入,两个网络输出应力与塑性增量,与 MPM 的积分步骤耦合,逐步推进到下一帧。下半部分是测试时的用法:给定运动序列,初始化一组物理参数,用训练好的模型仿真,比较与真值的误差并反向传播来修正参数。这个结构与 UniPhy 的区别在于:它的参数是物理意义的量(弹性模量、泊松比、屈服阈值),因此识别出来的结果可以直接解释。
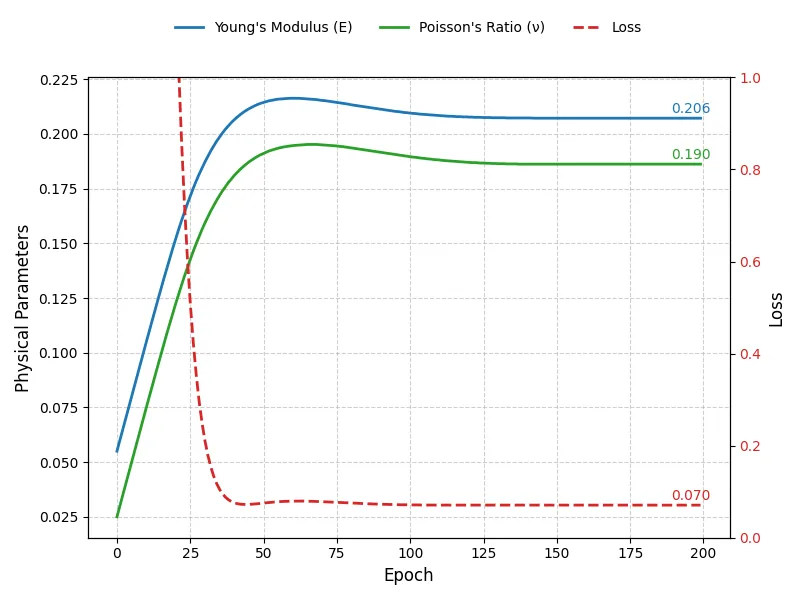
这条曲线是参数识别的收敛过程:真值是 、,两条曲线从初始化值出发,在两百轮以内收敛到真值附近,损失同步下降。它说明就算用梯度优化,只要参数有物理含义、网络训练充分,几十到几百步就足够。对在线表征来说,这个量级是可以接受的。
三条路线的取舍
把三条路线放在一张表里比较:
| 路线 | 参数含义 | 单次开销 | 能识别的参数 | 主要限制 |
|---|---|---|---|---|
| 弱形式线性求解(FORM) | 物理量(、) | 一次最小二乘 | 弹性模量、屈服阈值 | 依赖可靠的形变与力观测;本构形式需事先指定 |
| 可微仿真 + 潜变量优化(UniPhy) | 潜向量 | 数十到数百次 MPM 前反向 | 任意本构,覆盖范围广 | 潜变量不可解释;长轨迹梯度不稳定 |
| 学习本构 + 参数回归(PC-NCLaws) | 物理量 | 训练后一次前向 + 少量迭代 | 弹性与塑性参数 | 需要多场景训练数据;泛化依赖覆盖 |
对世界模型的在线表征,一个实用的组合是:用弱形式做常态更新的快速通道(每次轻接触都能刷新 与 ),用学习本构做潜变量的底座(在弱形式无法覆盖的复杂材料上保底),用可微优化做定期校准(例如每小时或每 100 次操作一次),三者共享同一个误差账本。
作为隐藏状态:世界模型的软物体身份
回到世界模型。把上面的力学结论翻译成系统的语言,需要回答三个问题:这些量在状态里放在哪、它们怎么演化、它们怎么被观测修正。
状态向量的扩展
对一个可塑性软物体,一个够用的状态向量至少包含:
其中位姿与当前几何是显式可观测的;等效塑性应变 是一个标量,用来判断当前几何是「原始形状被拉伸」还是「本来就长」,以及剩余的可拉伸余量;损伤 是一个标量,用来修正刚度;寿命余量是累积账本,用来决定何时报警或换料;材料慢变量(含水率、温度、老化程度)是缓慢变化的几个标量,用来解释参数为何漂移。
这个划分与(三十九)篇的四类身份对应:位姿是状态量,几何是被塑性应变改写的状态量,材料慢变量是典型的慢变量, 与寿命余量必须由模型积分、不能直接观测,因而也是状态量。它们共同的特性是:不能由当前这一帧的观测单独确定。你看见一块变长的橡皮泥,无法判断它是被拉长的还是本来就这么长;要区分,必须有历史。
演化方程
每次操作结束后,用本次操作中观测到的应变与应力量级更新状态。一个最小可用的更新规则是:
第一个式子积分塑性应变,第二个积分损伤,第三个用损伤修正刚度并把慢变量的影响叠上去。 是本次操作里识别出的「等效循环数」——对一个完整的抓取-放置可以记为一个循环,对一次持续按压则可以按载荷幅折算成若干分数循环。
注意第二个式子里 出现在分母:损伤越大,同样的载荷造成的新损伤越多。这是疲劳「后段加速」的来源,也是为什么寿命余量不能用线性插值估。它同时意味着一个数值陷阱: 时更新步长会发散,实现里必须把 截断在例如 0.95,并在 时触发换料建议。
观测修正:测得到多少,就修多少
上述积分在没有观测时会累积误差。修正的方式与状态估计一致:把参数当成缓慢变化的随机变量,用一次观测更新它的后验。(三十)篇讨论过的两类不确定性在这里分工: 与 的识别本身有噪声(观测不确定性),而 与寿命余量在两次观测之间的演化有模型不确定性。一个实用的滤波器是对每个慢变量维护一个标量卡尔曼更新:预测步用零漂移与漂移方差,更新步用弱形式识别的结果与它的协方差。
的更新更特殊。它不是直接测得的:弱形式给出的是当前形状与参考形状之差,这个差里包含弹性部分与塑性部分。一个可操作的做法是:在物体处于自由状态(无接触、无载荷)时记录形状作为参考形状,在有载荷时记录形状与载荷,利用「卸载后形状回到参考加塑性应变」这一性质,把塑性应变从总应变里分离出来。
推理成本
这些状态对世界模型的推理成本影响不大,因为它们是标量。真正有成本的是两件事:参考形状的维护与参数识别的频度。
参考形状如果存下来,对可变形物体来说是一整个点云或高斯集合,内存占用与几何采样密度成正比。一个折中是只存低分辨率的参考形状(例如每个方向 32 个体素),在需要时用本构模型从低分辨率参考重建高分辨率几何。
参数识别的频度决定了精度与开销的平衡。每次接触都识别,成本是每次一次弱形式最小二乘,对 1000 个采样点来说是一次规模为几十乘几十的矩阵求解,可以忽略;每小时一次可微优化,成本是数百次 MPM 步骤,对离线计划可以接受,对在线执行则太高。实际上,可以按「操作幅度」触发:轻接触只更新 的积分,超过屈服阈值的接触才触发完整识别。
把辨识接进世界模型:一条完整链路
上面三条路线各自解决「怎么估参数」。把它们接进一个运行中的世界模型,还需要把几何、参数与状态串起来。DPSI 在 2024 年给出的框架是一个可参照的样本 [4]:它从真实 RGB-D 观测重建物体的几何与轨迹,用可微 MPM 做正向仿真,再以观测轨迹与仿真轨迹的差异为损失,联合优化几何与物理参数。
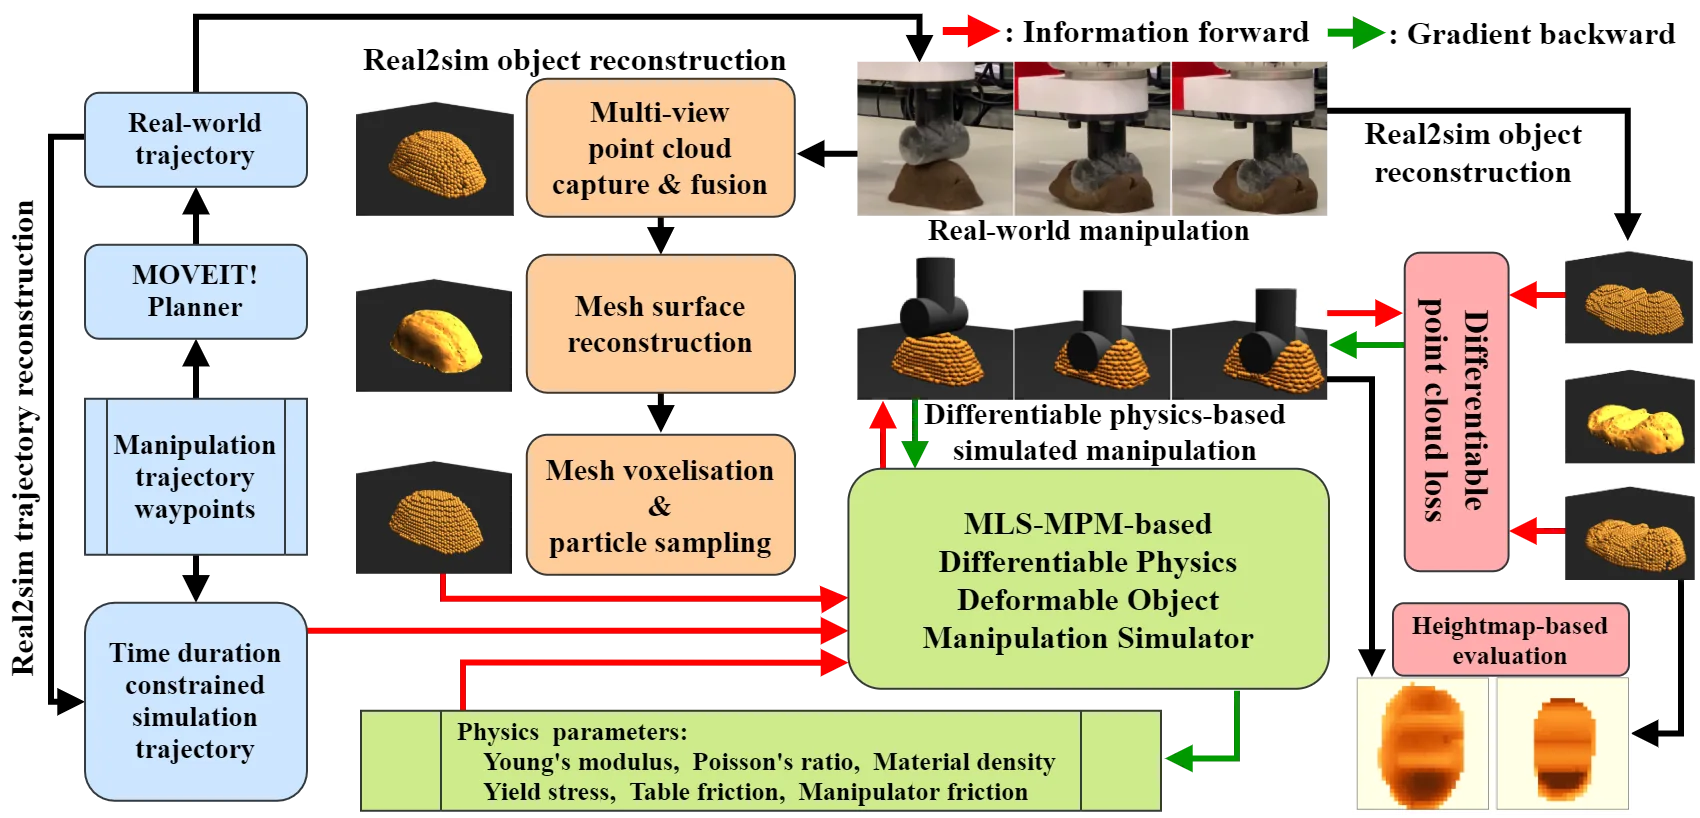
图中四种颜色对应四个模块。绿色是可微动力学与物理参数,它把固定共转弹性、von Mises 塑性、动态摩擦写进 MPM,参数集合是六个量:杨氏模量 、泊松比 、屈服应力 、材料密度 ,以及桌面与夹爪的摩擦系数 、。橙色与蓝色分别是物体几何与轨迹的真实到仿真重建,粉色是优化与评估损失。四者合起来,给定一次真实交互的观测,就能得到一组能复现这次交互的物理参数。
DPSI 的论文报告了一个对工程很有用的口径:只用一次真实交互,就能估计出上述六个参数,并且用这些参数仿真未见过的长时程操作,形变行为仍然合理。这一点比「在仿真里拟合参数」更难,因为真实观测有噪声、遮挡、不完整的轨迹,参数与几何之间存在耦合。
这个耦合值得展开。给定一次压缩,观测的是力-位移曲线,能唯一确定的是刚度组合 与屈服力 ,其中 是承压面积、 是高度。如果几何未知, 与 无法分开——这正是 PAC-NeRF 在 2023 年要解决的问题 [5]:它把几何当成未知量,用连续介质力学约束 NeRF 重建的密度场,联合估计几何与材料参数,做到「几何无关的系统辨识」。它的结论是:几何与材料可以同时估计,但需要足够的观测多样性,单一视角的单一动作不足以确定两者。
对一个在线运行的世界模型,这条链路可以简化成四步:先用视觉与触觉得到当前几何;再用一次受控按压得到力-位移曲线;用弱形式或少量可微步得到 、 与几何的联合估计;最后把估计结果写回状态与误差账本。每一步都可以失败,失败时应当退回先验而不是写入错误的参数——这一点在下一节展开。
表示层:塑性应变存在哪里
塑性应变与损伤在数学上是标量或张量,在系统里必须有载体。不同几何表示对应的载体不同,成本也不同。
对基于粒子的 MPM,每个粒子携带一个塑性变形梯度 ( 矩阵)与一个损伤标量。 个粒子的场景, 用 float32 存是 ,对显存来说可以忽略; 个粒子则是 36 MB,相当于一个中等模型的权重。MPM 的粒子数通常由体积与目标分辨率决定,软物体操作里 到 是常见量级。
如果推理侧不想承担逐粒子的塑性积分,可以训练一个多任务网络,直接从当前几何与动作预测下一时刻的弹塑性形变 [7];它的实时性更好,但预测的可靠性仍然受训练分布约束,适合作为快速通道而不是唯一通道。
对基于网格的有限元,塑性应变存在积分点上,每个单元若干积分点,内存与单元数成正比。优势是更新局部、并行度高;劣势是拓扑变化(断裂、粘连)需要重新划分网格。
对 PhysGaussian 这类基于 3D Gaussian 的表示,形变通过每个高斯的形变场传播,塑性部分需要一个额外的每高斯参数来记录永久形变。 个高斯,每个多 9 个浮点数,就是 36 MB;相对 1M 高斯的基础属性(位置、协方差、颜色、不透明度约 59 个浮点数,约 236 MB)增加了约 15%。这个比例不算离谱,但如果场景里有十个物体、每个都独立维护,开销就到了 GB 级。
一种降低开销的思路是把塑性状态从「每高斯」降到「每区域」。塑性的空间相关性很强:一次按压影响的是一块连续区域,不是孤立的高斯。可以把物体划分成若干区域,每个区域共享一个塑性变形梯度,高斯只记录自己属于哪个区域。这样内存从「高斯数乘 9」降到「区域数乘 9」,代价是区域边界处的形变不连续。区域划分的粒度本身是一个设计选择,与(三十四)篇的混合粒度调度同源:接触密集的区域用细粒度,远离接触的区域用粗粒度。
另一个开销来自更新带宽。如果在 30 Hz 的渲染循环里更新每个高斯的塑性参数, 个高斯每帧 36 MB,带宽约 1.08 GB/s,对 PCIe 4.0 的 16 条通道(约 32 GB/s)不算瓶颈,但对移动端 GPU 的共享内存就是压力。实际实现通常只更新「活跃区域」——与夹爪或接触面相邻的那部分高斯,其余保持不动。
损伤的表示更便宜:一个标量,可以存在物体级,也可以存在区域级。区域级损伤能表达「局部磨薄」这类现象,物体级只能表达「整体变软」。世界模型在做参数辨识时,如果观测到刚度下降但形状没有变化,应当优先怀疑区域级损伤而不是整体材料变化,因为后者需要含水率或温度的解释。
失效边界:什么时候这套东西会骗你
参数与损伤的混淆
最常见的失效是把「变软」全部归因于材料参数漂移。实际上刚度下降有两个来源:材料本身变软(含水率、温度、老化)与损伤累积( 增大)。两者在力-位移曲线上都表现为斜率下降,单次测量无法区分。
区分它们需要空间信息与时间信息:损伤通常局部化(弯折处、接触点附近),材料变化通常全局;损伤随时间单调累积,材料变化可能随环境可逆。世界模型应当把「刚度下降」当成一个观测,把它的两个解释当成两个假设,用后续观测做区分。这与(三十八)篇的物体假设信念是同一套机制:多个解释竞争,用证据淘汰。
训练分布外的载荷幅值
学习式本构的泛化边界由训练数据的载荷幅值决定。如果训练数据只覆盖 10% 以内的应变,模型在 30% 应变下的预测没有依据。更隐蔽的是卸载路径:很多数据集只记录加载段,模型学到的「塑性」实际上是一条单向的偏移,遇到反向加载就给出错误的屈服点。
判断一个学习式本构能否用于当前任务,有一个低成本的自检:取一次已知的加载-卸载循环,比较模型预测的滞回环面积与实测面积。面积差超过 20% 就说明模型的耗散机制不对,应当退回解析本构。
疲劳外推
用几十次循环的数据外推上万次寿命,在统计上没有依据。Coffin-Manson 与 Basquin 都是幂律,幂律外推对指数极其敏感:指数差 0.1,寿命可以差一个数量级。工程上的稳妥做法是只做「寿命余量」的定性判断(例如「还剩一半以上」与「不足一成」),不做精确的剩余寿命数字;精确数字留给专门的台架试验。
数值可靠性
可微物理的梯度在长时程、多接触的轨迹上并不可靠。2026 年的一项系统研究 [12] 用两个 MPM 系统辨识基准测试了这一点:GPU 上多对一求和的顺序随线程调度变化,会让长时程梯度出现非确定性的偏差;接触的离散切换让梯度在切换点附近不连续;隐式求解器的迭代次数不足会让梯度与真实敏感度脱节。论文的结论不是「可微物理不能用」,而是「不要盲信梯度」:应当用有限差分做抽查,或者优先使用弱形式这类不依赖长时程反向传播的方法。
对世界模型的实践含义是:参数识别的结果必须带一个可信度。弱形式给出的是线性最小二乘的残差与协方差,可以直接用;梯度优化的结果需要额外的验证,例如用识别出的参数正向仿真一段留出的轨迹,比较误差。没有验证的参数不应写入状态。
工程取舍
把这一篇的结论落到几个具体场景,取舍是不同的。
实时抓取:每次抓取都做完整辨识不现实。可行的做法是只维护损伤与寿命账本,材料参数按任务开始时的一次标定使用,并在每次抓取后用力反馈的偏差做一次标量修正。偏差超过阈值时触发重新标定。
长时程操作:例如连续塑形一小时。塑性应变会累积到几十个百分点,几何持续变化,必须在线更新参考形状。更新的频率可以与控制频率解耦:控制用当前几何,参考形状每几秒刷新一次。
多物体场景:每个物体的参数独立,但材料可能同批。可以维护一个材料先验库,按外观与首次交互的响应把新物体归类到某个先验,再用少量观测微调。这能显著降低每个物体的标定成本。
安全相关:食品、医疗这类场景里,材料参数漂移可能意味着污染或变质,寿命账本不只是效率问题。这时应当把参数漂移当成告警信号,而不是默默补偿。
小结
这一篇从「材料参数是常数」这个隐含假设出发,拆开了软物体在长时间使用中发生的三类不可逆变化,并把它们翻译成世界模型的状态与更新规则。
第一,塑性变形。屈服准则(von Mises 对压力不敏感,Drucker-Prager 对压力敏感)决定材料何时开始流动;关联流动法则给出塑性应变的方向,对 von Mises 意味着体积守恒;硬化模型(等向与随动)决定屈服面如何变化;返回映射把试探应力拉回屈服面。一个手算例子说明: MPa、 MPa 的硅胶条拉伸 30% 后卸载,残余应变接近 25%。
第二,循环与疲劳。超过屈服的循环形成滞回环,理想塑性下每循环耗散 ;Coffin-Manson 与 Basquin 分别描述低周与高周寿命;Miner 线性累积给出工程近似,但对软材料有顺序效应;连续损伤力学用 把寿命消耗与刚度退化连起来,;软材料还存在疲劳阈值,低于阈值的小循环不应计入寿命。
第三,参数漂移。Mullins 效应、含水率、温度、塑性各向异性与损伤共同让标定值缓慢改变。漂移的时间尺度介于单次操作与永久之间,属于慢变量。
第四,在线表征的三条路线:弱形式线性求解最快、参数可解释;可微仿真加潜变量优化最通用、代价最高、潜变量不可解释;学习本构加参数回归介于两者之间。三者的共同前提是观测要足够「有激发性」——不越过屈服就看不到屈服阈值,不做反向加载就看不出随动硬化。
第五,状态的扩展。塑性应变、损伤与寿命余量必须由模型积分,不能由单帧观测确定;材料参数从常量降级为慢变量;参考形状需要单独维护,因为它被塑性应变改写。这四项构成软物体的「身份」,也是(三十九)篇四类身份划分在塑性场景下的具体化。
第六,失效边界。参数与损伤会混淆,学习式本构在训练分布外不可信,疲劳外推在统计上没有依据,可微物理的梯度在长时程上不可靠。每一条都对应一个工程防线:多假设竞争、滞回环自检、只做定性寿命判断、用弱形式或有限差分验证梯度。
把这一篇压缩成一句话:软物体的材料参数不是标定出来的常数,而是随载荷历史缓慢漂移的慢变量;塑性应变、损伤与寿命消耗是必须由模型自己积分的隐藏状态,世界模型的「软物体身份」就是这三者加上一组会变慢的材料参数。
下一篇讨论形状被改写之后的几何问题:当物体已经永久变形,参考形状不再是初始扫描,世界模型如何重建、配准并维护一个会变的形状状态——这涉及形变场的表示、形状配准与重定位,是塑性从「状态量」走向「可操作的几何」的必经一步。
参考资料
- PhysGaussian: Physics-Integrated 3D Gaussians for Generative Dynamics
- UniPhy: Learning a Unified Constitutive Model for Inverse Physics Simulation
- PC-NCLaws: Physics-Embedded Conditional Neural Constitutive Laws for Elastoplastic Materials
- Differentiable Physics-based System Identification for Robotic Manipulation of Elastoplastic Materials
- PAC-NeRF: Physics Augmented Continuum Neural Radiance Fields for Geometry-Agnostic System Identification
- Neural Stress Fields for Reduced-order Elastoplasticity and Fracture
- Towards a Real-Time Simulation of Elastoplastic Deformation Using Multi-Task Neural Networks
- Thermodynamically consistent neural constitutive models for elastoplasticity via eigen-representations
- FORM: Robot Manipulation through Direct Material Law Identification
- Simo and Taylor, Consistent tangent operators for rate-independent elastoplasticity(1985 年)
- Lemaitre, A Continuous Damage Mechanics Model for Ductile Fracture(1985 年)
- On the Numerical Reliability of Differentiable Physics-Based Optimization for Robotic Material Manipulation
- Anti-fatigue-fracture hydrogels
- Fracture and fatigue of entangled and unentangled polymer networks
- Hill, A theory of the yielding and plastic flow of anisotropic metals(1948 年)
- Armstrong and Frederick, A mathematical representation of the multiaxial Bauschinger effect(1966 年,2007 年再刊)
- Miner, Cumulative Damage in Fatigue(1945 年)
- Coffin, A Study of the Effects of Cyclic Thermal Stresses on a Ductile Metal(1954 年)
- Model-free vision-based shaping of deformable plastic materials
- Fatigue failure in glasses under cyclic shear deformation
- 世界模型从零讲起(四十三):接触之外的黏滞——黏附、湿摩擦与可变形表面
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



