


世界模型从零讲起(十八):同一个世界,多个入口——共享世界状态的并发、分叉与合并
承接前十七篇:一个会话之外
前面十七篇把世界模型拆成了一条完整的链:第一篇给出形式定义,把世界模型写成「在内部表征里模拟观测随动作如何演化」的模型;第二、三、四篇分别拆了重建式(Dreamer 的 RSSM)、联合嵌入(JEPA)与视频生成式(Sora、GAIA-1、Cosmos、Genie)三条路线;第五篇讲 WAM,把动作从输入变成输出;第六篇讲评测,把物理一致性、反事实响应与长程记忆分成三层;第七、九、十篇分别讲部署、推理系统与能耗;第八篇讲潜空间规划;第十一至十五篇补了 Dyna 谱系、几何表示、物体中心、分层结构与预算地图;第十六篇收在动作接口上;第十七篇把长程记忆从注意力里拆出来,放进记忆库、点云、慢权重与分层 KV。
这些篇目有一个共同的前提:一个世界只有一个入口。 无论是单个玩家、单个相机,还是单个机器人,状态 都是某个会话的私有变量——它在这个会话里被推进、被渲染、被丢弃,别的会话看不到也不需要看到。第十七篇结尾留下了这个前提被打破后的空白:当多个会话、多个智能体共享同一个世界时,记忆该如何并发、分叉与合并。
这一篇就来填这个空白。它讨论的不是又一个视频生成模型,而是共享世界状态带来的系统问题:世界状态的「写」发生在哪里,多个写者如何定序,一个世界如何复制成多条世界线,两条世界线又能不能接回去。 这些问题在数据库和多人游戏里已经有成熟答案,但世界模型的状态表示——KV 缓存、潜变量、点云、慢权重——决定了哪些答案能直接照搬,哪些必须重写。
共享的粒度:从共享权重到共享状态
「共享」这个词在世界模型语境里被用得很松。两个智能体用同一套模型权重,可以叫共享;两个玩家看到同一个场景,也可以叫共享。这两件事的技术含义完全不同。先把粒度分开。
形式化:世界状态、联合动作与逐视角渲染
把一个有 个入口的世界写成三元组:
其中 是世界状态, 是同一 tick 内所有入口的联合动作, 是外生输入(游戏里的随机刷新、真实世界里的风与摩擦), 是学到的转移, 把世界状态投影到第 个相机, 是该相机的内外参, 是渲染器。这个写法看起来只是把第一篇的公式加了上标,但它把「共享」落到了两个不同的对象上:
- 共享转移:所有入口用同一个 推进同一个 。
- 共享观测生成:所有视角从同一个 渲染,但渲染彼此独立。
真正决定系统形态的是第二条。如果每个入口各自维护一份自己的 ,那么即使初始状态相同、权重相同,只要动作不同,状态就会分叉,世界也就不再是同一个。下面按共享对象把现有做法分成四层。
第一层:只共享权重,不共享世界
这是最常见也最容易被误称为「多智能体世界模型」的形态。每个智能体各自加载一份模型,各自 rollout,各自维护自己的历史。权重是只读的,所以共享它没有任何并发问题;但世界不是共享的——智能体 A 在房间里推倒的箱子,智能体 B 的世界里不会出现。
这一层适合两类场景:独立采样的规划(每个候选动作序列各自想象,最后只选一条执行),以及多机器人各自探索不同区域、事后才对齐地图。它的优点是零同步成本,缺点是任何需要「你看到我、我看到你」的任务都不成立。
第二层:共享观测历史,把多视角拼进同一个上下文
再往上一步,是把多个入口的观测拼进同一个序列,让注意力在视角之间流动。Solaris 的做法是代表:它把 个玩家的视频 token 沿序列维度交错排列,用一个改造过的 DiT 块做跨视角注意力。
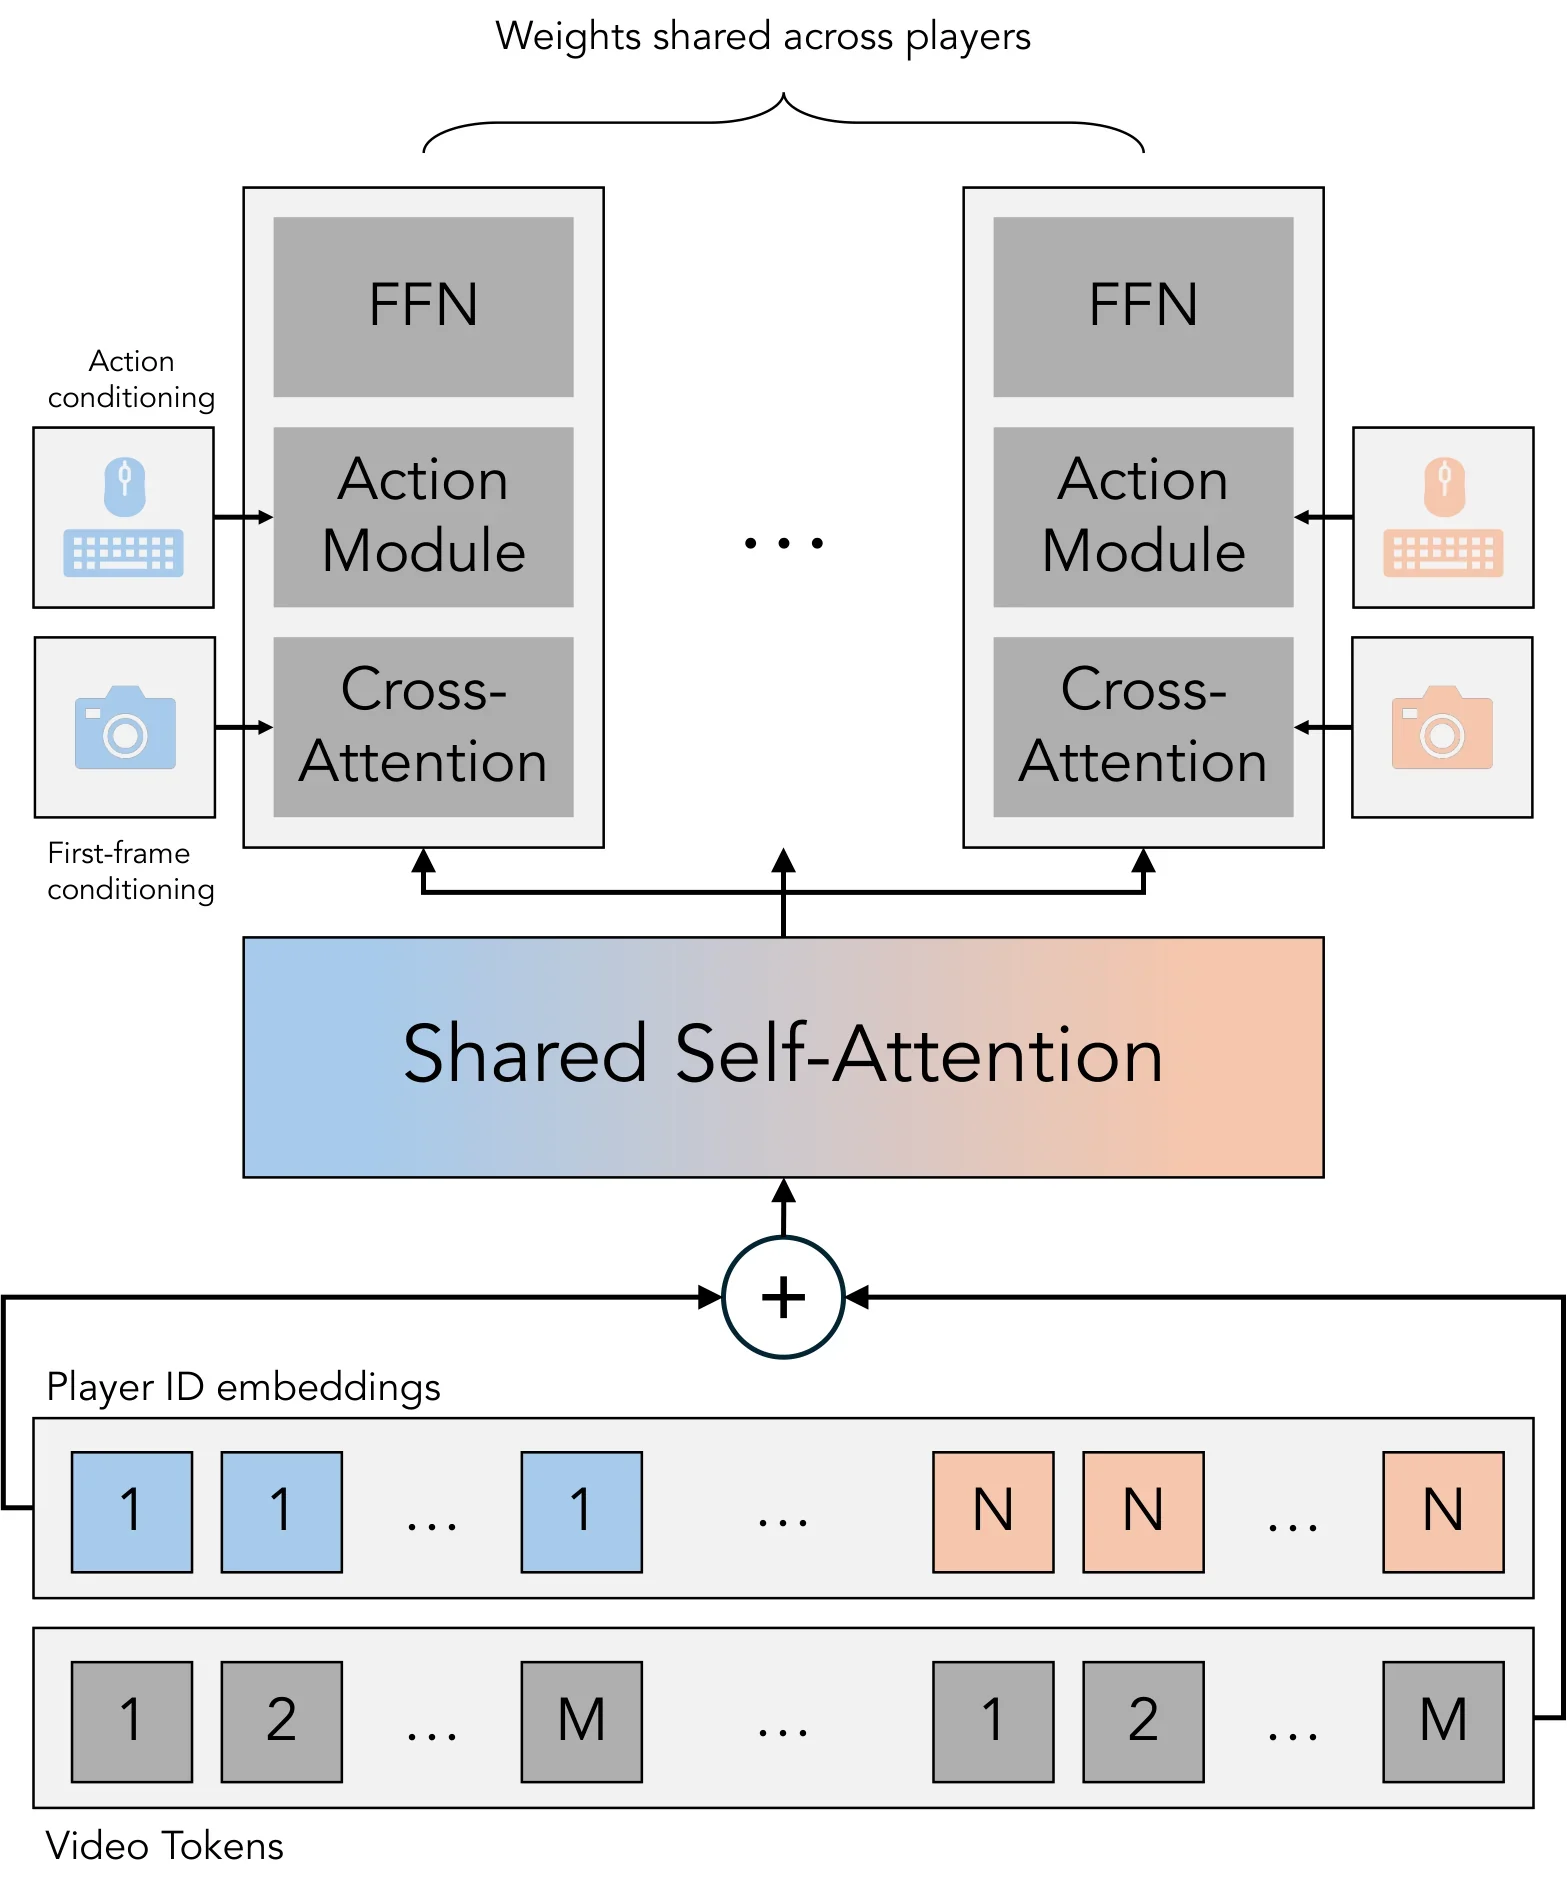
上图来自 Solaris 论文 Figure 5(arXiv:2602.22208)。左侧的 weights shared across players 表示所有玩家共用一套注意力权重;中间的 self-attention 作用在交错排列的 token 序列上,因此第 个玩家的 token 可以直接 attend 到第 个玩家的 token;玩家 ID 嵌入与首帧条件负责告诉模型「这段 token 属于谁、长什么样」。
共享观测历史的优点是实现直接:不需要显式的状态对象,一致性由注意力自己学出来。代价有两个。第一,序列长度随玩家数线性增长,而注意力的计算随长度超线性增长——在 WorldCast 的对照实验里,Solaris 把所有玩家放在一张 GPU 上时,注意力算力从 2 个玩家的 34 TFLOP/s 涨到 4 个玩家的 137、8 个玩家的 548,16 个玩家直接显存不足。第二,一致性没有结构保证:两个视角对同一个物体的描述是否一致,只能靠训练数据和损失函数去逼,而不能由系统保证。
第三层:共享潜状态,逐视角解码
第三层不再共享像素或 token 序列,而是先预测一个与视角无关的状态,再从它解码任意视角。MASS 与 Khora 都属于这一层,但状态的形态不同。
MASS 用的是类型化状态(typed state)。它用一个 schema 声明世界里有哪些实体、每个实体有哪些字段、各有多少个:
在每个 tick,状态是一串实体记录:
在论文的 Snake 实验里,schema 声明了 1 个全局记录(tick 计数)、1024 条蛇、4096 个食物区域,一个 tick 共 条记录。每条记录被 tokenizer 编成定长序列,Logic Engine 是一个 decoder-only Transformer,逐记录预测下一 tick 的字段;渲染器只读投影后的状态,不读 RGB 历史。
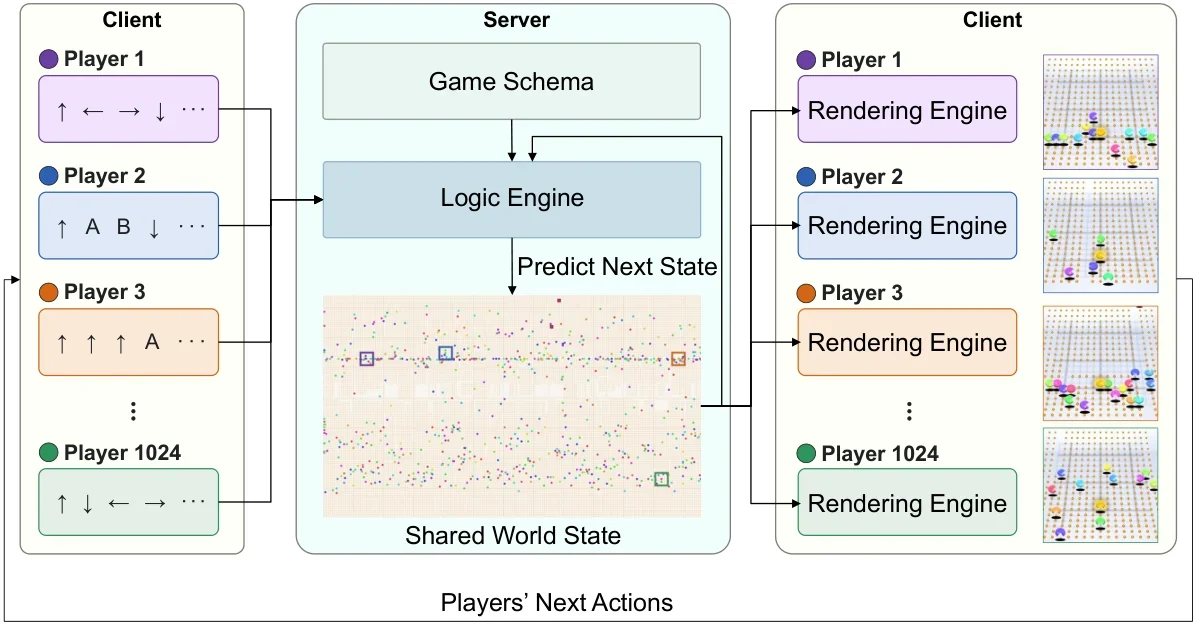
上图来自 MASS 论文 Figure 2(arXiv:2608.06257)。左侧是客户端,每个玩家只负责提交动作与渲染自己的视角;中间是服务端的 Game Schema 与 Logic Engine,世界转移在每个 tick 只跑一次;右侧把更新后的状态分发回去,每个客户端用同一个状态加自己的相机生成画面。这张图把「共享什么」画得很清楚:共享的是中间那一份类型化状态,不是像素,也不是注意力特征。
Khora 的思路更接近「状态演化与渲染解耦」的抽象版本:世界状态的演化不假设智能体数量,渲染接口对任意数量的查询视角开放,因此在推理时可以扩展到训练时没见过的智能体数量,成本随被查询的视角数近似线性增长。它没有把状态写成显式 schema,但同样拒绝了「把玩家数编进注意力序列长度」这件事。
第四层:共享权威状态,分布式渲染
第四层在第三层的基础上再拆一刀:状态不仅与视角无关,还被当作同步对象——带版本号、可分发、可作为冲突仲裁的唯一参考。MASS 的服务端/客户端划分属于这一层;WorldCast 把它推到点对点:每个玩家跑一个客户端,客户端之间只交换状态,不交换注意力特征。
WorldCast 的共享状态由两部分组成:玩家状态(每个玩家一条记录,含位置、朝向、控制、武器)与场景状态(一个记忆库,每条是某个客户端生成的一块 latent,附带相机位姿与粗深度)。每个客户端生成下一块时,只读其他玩家最新发布的记录与至多一条场景记忆,因此生成器的注意力序列不随玩家数增长。
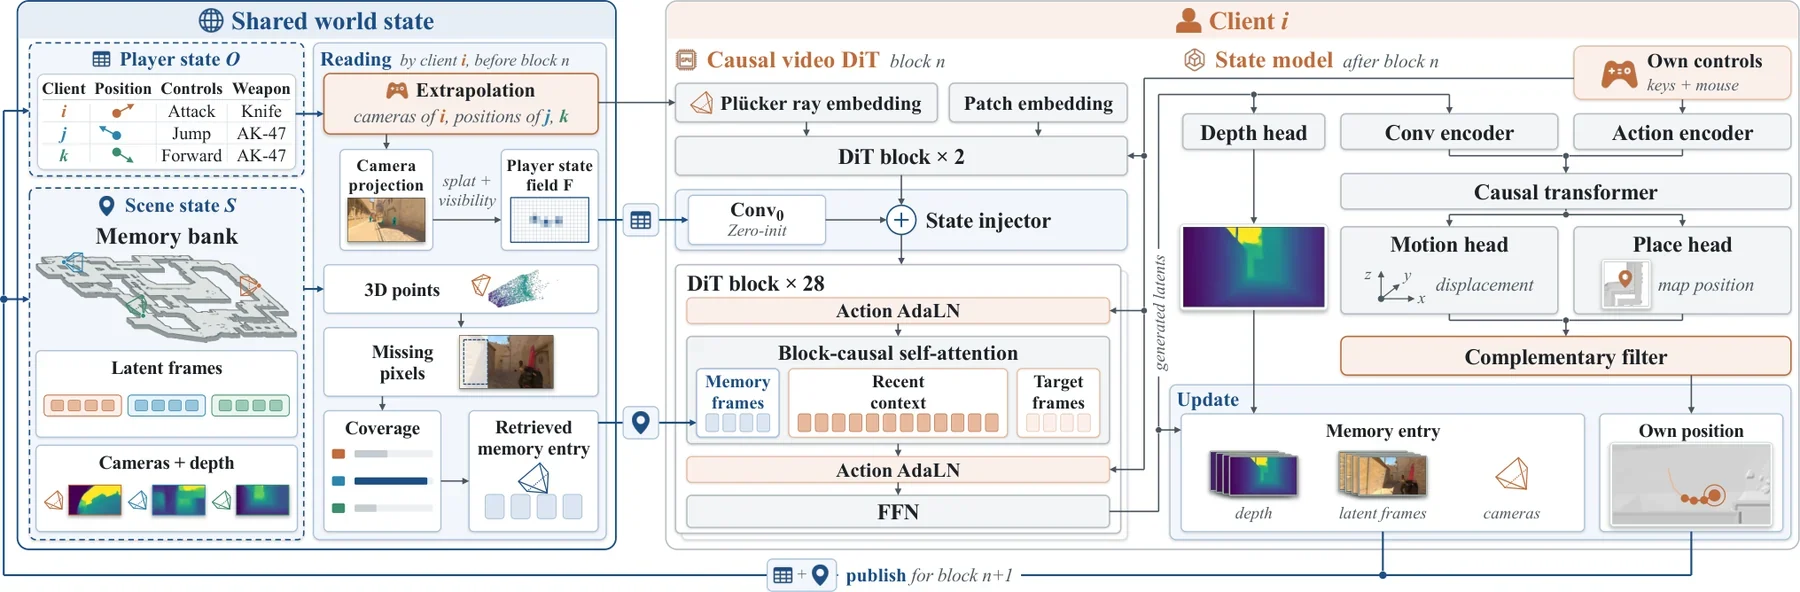
上图来自 WorldCast 论文 Figure 3(arXiv:2610.12412)。左上角的「shared world state」被画成两块:player state 是逐玩家的记录,scene state 是记忆库;中间用箭头标出「块 n 生成前读、块 n 生成后写」的节奏。右侧是客户端 i 的因果视频 DiT:玩家状态场从第二个 DiT 块之后注入,记忆帧与最近上下文、目标帧一起进入注意力,每个 token 额外带 Plücker 射线编码。这张图说明了第四层架构里「写」与「读」的单位:读写都以块为单位,状态模型是唯一的回写者。
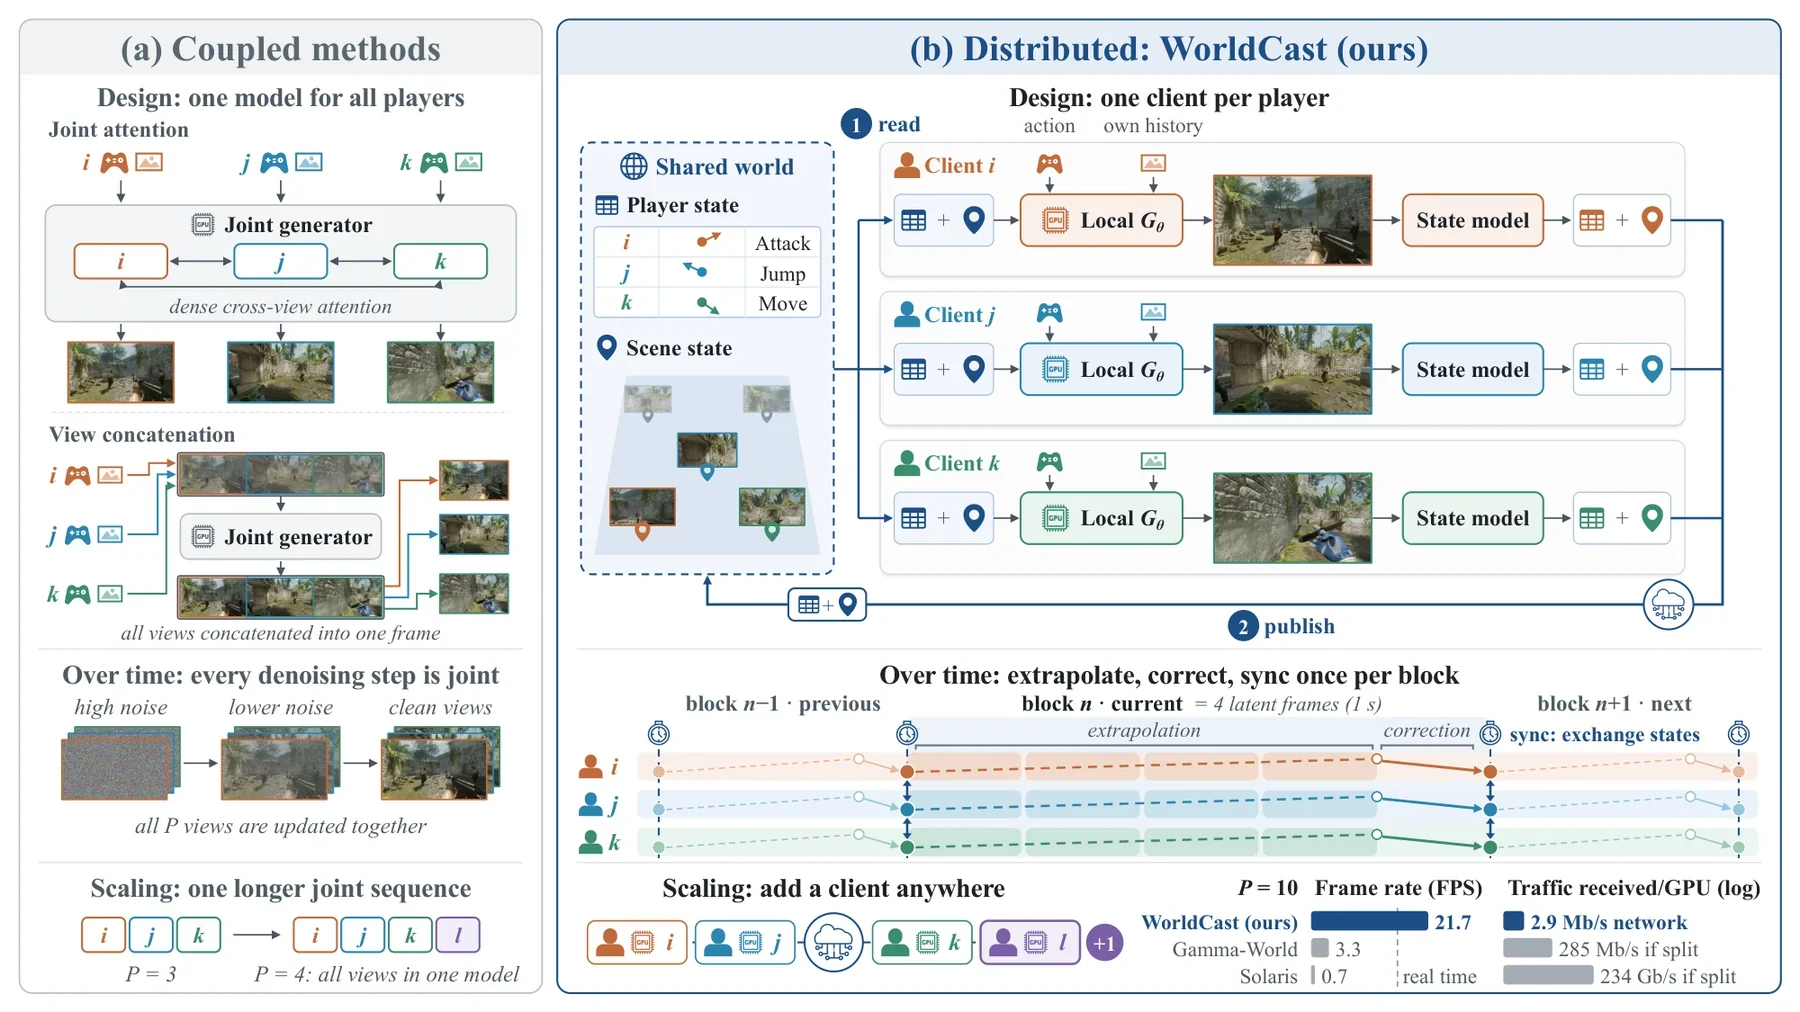
上图来自 WorldCast 论文 Figure 2(arXiv:2610.12412)。左侧 (a) 是耦合式:所有视角的 token 拼成一条长序列,每个去噪步都做联合注意力,扩缩放的方式是「把序列拉得更长」;右侧 (b) 是分布式:每个客户端有自己的生成器与状态模型,块与块之间只交换状态,扩缩放的方式是「加一个客户端」。图下方的两组小图给出了同一实验里的直接对比:WorldCast 在 16 个玩家时每客户端 18.7 FPS、每 GPU 接收 3.5 Mb/s;Solaris 在同一条件下显存不足,按每玩家一块 GPU 拆分时接收流量为 389 Gb/s。
四层架构的成本结构
把四层放在同一张表里,差别一目了然:
| 层级 | 共享物 | 一致性来源 | 世界转移成本 | 渲染成本 | 代表系统 |
|---|---|---|---|---|---|
| 只共享权重 | 参数 | 无 | 每入口一次 | 每入口一次 | 独立 rollout |
| 共享观测历史 | 拼接的 token 序列 | 注意力学习 | 随入口数增长 | 联合去噪 | Solaris、frame concat |
| 共享潜状态 | 一个 dense latent / typed state | 结构保证(同一状态解码) | 一次(理论上) | 逐视角解码 | MASS、Khora、B-UN |
| 共享权威状态 | 带版本的 typed state + 状态消息 | 版本与单写者 | 一次 | 客户端本地 | MASS、WorldCast |
这张表里最容易被忽略的是第三、四层的「一次」。共享潜状态之所以能把世界转移的成本从「每入口一次」降到「一次」,前提是转移的输入必须包含联合动作,而不是某个入口的单个动作。MASS 的 Logic Engine 一次吃下所有玩家的动作,输出一份状态;WorldCast 的每个客户端只推进自己的玩家记录,世界转移被拆成了「每个客户端各写各的记录」。两种做法的并发语义完全不同,这正是下一节的主题。
从系统角度看,第四层把世界模型变成了一个「状态服务器 + 无状态渲染器」的架构。这个形状与 LLM 推理服务里的「调度器 + worker」有相似之处,但有一个关键差别:LLM 的每个请求彼此独立,共享的只有权重与显存;共享世界模型的每个请求都读写同一份状态,所以它更像一个多人在线游戏的服务端,而不是一个普通的推理服务。第九篇讨论的 KV 缓存、批处理与流式调度仍然适用,但它们只覆盖了渲染侧;状态侧的并发控制是这一层新增的。
并发:世界模型的「写」发生在哪里
一个世界被多个入口共享之后,第一个冒出来的问题是谁能改它。在单人世界里,「写」这件事是隐式的:模型生成下一帧,帧就是状态的唯一副本,没人会与它竞争。多入口之后,每一帧的生成都可能来自不同的人,同一时刻的多个入口都在推进「下一步」。
三种写方式
按写者是谁、写什么,可以把并发结构分成三类。
第一类是单写者顺序推进。 世界状态只由服务端一处推进,每个 tick 收集所有入口的动作,合成联合动作 ,跑一次转移,再分发新状态。MASS 是这种:客户端只发动作,服务端拿 schema 与 Logic Engine 推进完整状态,然后把带版本号的快照广播出去。它的优点是顺序天然明确——只有一个写者,不需要锁;缺点是转移必须等齐所有动作才能跑,任何一个入口慢都会拖住整个 tick。
第二类是记录级多写者。 世界状态被拆成若干单写者拥有的记录:每条记录只有一个客户端能写,但不同记录之间可以并行写。WorldCast 是这种:玩家状态里每个玩家一条记录,只由该玩家的客户端发布——位置由它自己的状态模型从自己生成的画面里估计,朝向、武器等属性取自它的输入。别的客户端只读这条记录,不写它。场景状态也被组织成「每条记忆块只有一个所有者」的记忆库,所有者负责发布与按冗余度回收,其他客户端只读。
第三类是无状态者的写。 渲染不需要写状态:客户端拿到状态后,在自己的相机上生成画面,不往共享状态里写任何东西。WorldCast 的生成器正是如此,输出只是画面,不改变世界;真正改变世界的是该玩家的状态模型对自己的位置估计。
这三类的组合决定了系统的同步成本。第一类把成本压在「收齐动作」上,第二类把它压在「消息数量」上,第三类没有成本。下表是对照:
| 写法 | 谁是写者 | 状态单位 | 同步要求 | 同步成本 | 适用场景 |
|---|---|---|---|---|---|
| 单写者顺序推进 | 服务端 | 整个世界状态 | 每 tick 全量广播 | 状态大小 × 接收者数 | 强交互、小世界、小规模 |
| 记录级多写者 | 各入口客户端 | 单条实体记录 | 每块交换记录与记忆 | 记录大小 × 订阅者 | 大世界、玩家多数不直接交互 |
| 无状态写 | 无 | 无 | 无 | 零 | 纯渲染、离线回放 |
同步成本:从「一个状态」到「一份状态消息」
单写者顺序推进的成本可以直接写成公式。设世界有 个实体、 个状态接收者、每份快照大小 字节,服务端每 tick 的工作量是:
前一项是学习到的转移,后一项是分发。MASS 用这个式子强调的是两件事:转移只跑一次,与渲染视角数无关;分发随接收者数线性增长。对 1024 个模拟玩家实体、10000 个 tick 的实验来说,这条式子意味着世界推进的总成本与「有多少相机在看」完全解耦——这是第四层架构相对第二层架构的结构性优势。
记录级多写者把 从「整个状态」压到「单条记录 + 偶尔的记忆块」。WorldCast 的实测给出了具体量级:16 个玩家时,每个客户端每块接收来自其他 15 个客户端的 12.0 kB 消息,加上偶尔检索到的 387 kB 记忆块,平均 3.5 Mb/s;同一条件下按每玩家一块 GPU 拆分的 Solaris 需要传递所有玩家的 KV,接收流量达到 389 Gb/s,差了两个数量级以上。这组数字解释了一个看似矛盾的现象:共享状态越显式、越稀疏,同步越便宜;共享状态越隐式、越稠密(比如直接共享注意力特征),同步越昂贵。
定序:同一 tick 的顺序谁来定
多写者一旦成立,就有一个无法回避的定序问题:A 的动作与 B 的动作,在世界状态推进里谁先?
单写者推进把答案定在服务端:所有动作按 tick 聚合后再跑转移,先后被 tick 边界掩盖。WorldCast 的做法是按块定序:一块是 4 个 latent 帧(16 fps 下 1 秒),客户端之间每块交换一次状态,并在这套实验里以锁步推进。锁步的好处是简单——所有客户端看到的都是「上一块结束时的状态」;代价是帧率需要扣除等待时间,虽然论文在计时时把等待排除在外,但真实部署里锁步会把最慢的客户端变成整个系统的节拍器。
如果要打破锁步,就会出现「A 已经看到 B 在第 块的状态,B 还在用 A 在第 块的状态」这类不一致。第十七篇讨论过的检索式记忆在这里恰好提供了一个启发:读不一定要读到最新。 只要每个读操作拿到的是一个一致版本,而版本之间的差异在物理上足够小,系统就可以允许读写异步。这正是下一节「一份可落地的共享状态设计」里版本号设计要解决的。
客户端预测:在断线时用同一个转移往前推
多入口系统里另一类并发问题是缺数据:某个入口的更新没到,本地还要不要画画?
MASS 给了一个干净的做法:在更新停滞时,客户端拿最新权威状态,用同一个 Logic Engine 在本地往前推。自己玩家的动作照常填入,其他玩家的动作和外生输入留空,等下一次服务端版本到达再对齐。论文在 Snake 上报告,停滞 1 到 8 个 tick 时,本地玩家(local avatar)的位移误差始终为 0——因为它的动作是已知的,转移又是同一个模型;而在本地动作之外,视野内其他物体与服务器状态的一致度会随停滞长度下降:
| 停滞长度 | 1 | 2 | 4 | 8 |
|---|---|---|---|---|
| 视野内一致度(联合动作已知) | 1.000 | 1.000 | 1.000 | 1.000 |
| 视野内一致度(仅本地动作) | 0.815 | 0.652 | 0.604 | 0.429 |
表中两行只差一个变量:远程玩家的动作是否已知。第一行用真实的联合动作,客户端本地推进 8 个 tick 后仍与服务器完全一致;第二行只填本地动作、其它玩家按空动作处理,一致度从 0.815 一路降到 0.429。这个对照说明:在同一模型下,停滞造成的误差几乎全部来自缺失的远程动作,而不是转移本身的不确定性。想让客户端预测更有用,重点应该是猜测远程动作(例如沿用上一步的方向),而不是让模型更稳。
WorldCast 用的是同一条思路:每个客户端在生成下一块前,按其他玩家最新发布的状态与控制外推位置与相机位姿,外推之后再用状态模型在生成完的画面里校正自己的位置。它的位置估计是两个来源的融合:
其中 是第 个 latent 帧的位置估计, 是运动头从生成画面里预测的位移, 是定位头在整张地图上的绝对位置估计。前一项依赖运动头的帧间位移累积,会漂移;后一项依赖地图识别,会偶尔定位错误。两个来源各取一半权重,本质上是一个互补滤波:一方短期准、长期漂,另一方长期准、短期跳。
分歧的根源:每个入口都是「局部观测」的推断者
多写者架构还有一个更深层的并发挑战:写者自己对状态的估计就可能不一致。
WorldCast 的玩家位置不是游戏引擎给的,而是从它自己生成的画面里估计出来的。也就是说,玩家 A 眼中「A 在哪」,玩家 B 眼中「A 在哪」(B 从 A 发布的状态里读),以及真实记录里「A 在哪」,三者是三份不同的推断。论文在整回合的部署里报告,位置误差以「身体宽度」为单位度量(一个身体宽度是 32 u,约 0.61 m),整回合中预测出来的位置误差明显高于记录视频上的误差;同时,场景状态开启后,客户端之间的一致性在四项一致度指标上全面改善:以回合开场 30 秒内的视图匹配像素数为例,关闭场景状态时为 72.0K,开启后为 92.1K;30 秒之后分别为 31.1K 与 44.3K,开启后仍高出约四成。
这条原则可以反过来读:共享状态的真正价值是把「推断」变成「读取」。 如果每个入口都从自己的观测里猜别人的状态,同一时刻不同入口会得到互相矛盾的世界,而且没有任何机制能告诉它们分叉了;而如果存在一份被所有人读的权威记录,分歧就被转换成一个可度量、可收敛的量——上一段说的「位置误差以身体宽度计」,只有在状态是显式的时候才能被这样度量。
分叉:把一个世界复制成 N 个「如果」
并发回答的是「谁来写」,分叉回答的是「改写一份会怎样」。这是世界模型比普通游戏引擎多出来的一种用法:世界模型的核心卖点就是能低成本地想象「如果」,而想象最自然的组织方式就是从某个状态出发复制出多条世界线,每条线走不同的动作,最后比较结果。这件事有三个层次,成本依次上升。
层次一:只分叉画面,不分叉状态
最便宜的分叉是渲染侧分叉:世界状态只有一份,多个视角从同一状态渲染。MASS 的「状态条件渲染」就是这一层——同一套「状态到画面」的接口在八种游戏上复用,每种游戏只换 tokenizer、嵌入与权重,渲染器与转移分离。它本质上不是分叉,而是「一份状态、多个出口」;但它证明了一件事:只要状态是显式且与外观解耦的,改变渲染参数就不需要重新推进世界。
对规划系统来说,这一层的意义在于视角选择。第八篇讲潜空间规划时,CEM 与 MPPI 每次都要评估多个候选动作序列;如果每个候选都要付一次完整的渲染成本,评估就变得昂贵。把「状态推进」与「渲染」分开后,候选之间可以先只在状态层面上滚动,只在必要时才渲染出画面给人看或给下游视觉模型用。
层次二:分叉状态,共享前缀的 KV
第二层是真正意义上的世界线分叉:给定 与联合动作 ,世界会走到 这些互不相同的状态。对自回归或扩散式世界模型来说,状态推进依赖历史——第十七篇讲过的 KV 缓存就是历史的载体。于是分叉的第一个问题必然是:新分支要不要复制前缀的 KV?
答案是「几乎永远不要复制整份按字节计的 KV」。前缀分叉在 LLM 推理里已经有成熟的对应物:PagedAttention 把 KV 切成物理块,RadixAttention 用前缀树共享相同前缀的 KV,多个请求共享前缀时只在分叉点之后分配新块。同样的结构可以搬到世界模型上:
前 个块由所有分支共享(引用计数管理),第 个块之后各分支独占。这样做有三个直接好处:
- 存储: 个分支共享前缀时,前缀只存一份,存储从 块降到 块加分支独占的部分。
- 计算:分支生成第一步时只需要对分叉点之后的新 token 做 prefill 的增量运算,前缀的注意力已在缓存里,不需要重算。
- 一致性:所有分支的前缀是同一个对象,因此它们对「在分叉之前发生了什么」的记忆是逐字节一致的,不会出现两个分支对过去给出不同描述的经典失败。
第三个好处常被低估。第十七篇讨论过「检索错帧」会让世界模型在回访时画出不一致的场景;分叉场景下的同类问题是「两个分支对同一个过去记忆不同」,它会直接毁掉「比较不同未来」这件事的意义——如果两条世界线连出发点都不同,比较结果就没有依据。
层次三:分叉状态,同时分叉慢权重
第二层的 KV 共享假设历史全在缓存里。但如果记忆载体是慢权重(第十七篇的 World-T3 路线)或线性注意力的固定状态(HLA-WM 路线),历史就被压进了参数或状态矩阵里,而参数空间不适合按分支复制——每复制一份就是一整套权重。
这里有三种处理方式,各有代价:
| 策略 | 做法 | 存储 | 计算 | 主要问题 |
|---|---|---|---|---|
| 分支各持有状态副本 | 分叉时深拷贝慢权重 / 状态矩阵 | 状态大小 | 无额外 | 状态随分支数线性涨;写入互不可见 |
| 分支只读、共享写入 | 分叉时不复制,分支只做只读查询 | 常数 | 无额外 | 分支的写入会污染所有分支 |
| 延迟分叉 | 分支期间只记动作日志,需要时再重放 | 动作日志 | 重放成本 | 重放要走完整 rollout,延迟高 |
World-T3 的 fast weights 更新正是递归最小二乘的在线求解,一旦某个分支往里写了新内容,别的分支就读到被污染的状态。所以对慢权重路线,最稳妥的做法是「延迟分叉」或「分支各持副本」;而对 KV 路线,前缀共享是默认做法。这个差别说明:分叉成本取决于记忆载体,而不是取决于世界模型本身。 第十七篇那张「四种载体的地址与成本」表,在分叉场景下会重新排序——循环状态分叉最便宜(复制一个固定大小的隐状态),KV 分叉次之(写时复制),记忆库分叉较贵(要决定哪些条目共享、哪些独立),慢权重分叉最贵(参数级复制)。
分叉的质量:反事实评测
分叉便宜,不代表分叉有意义。世界模型能复制出十条世界线,不等于这十条线真的对应「改了一个变量之后的十个合理未来」。这一点有专门的评测在测。
What-If World(Cai 等,2026 年 5 月,arXiv:2605.27589)把「反事实分叉」做成了成对任务:给模型两条只差一个物理变量的提示,比较两条生成的视频是否按物理规律在该变量上分叉。它从 nuScenes 与 DROID 的真实帧构造了 319 对提示,覆盖六个跨驾驶与操作的物理变量;评分用四部分量表 APEO——Adherence(是否遵循提示)、Physics(是否物理一致)、Environment(是否保持同一个场景)、Outcome(结尾是否出现正确差异)。
结果很能说明问题:九个当时最好的模型里,没有系统在成对得分上超过 52%,开源模型集中在 28% 附近。更有意思的是分数的分布——模型得分与「干预在画面上有多显眼」相关,而不是与「底层物理有多可解」相关:视觉上不明显的干预只拿到 14.2%,视觉上明显的能到 40.4%。这意味着模型学到的往往不是「改了这个变量世界会怎样」,而是「这个变量的视觉痕迹长什么样」。
对分叉系统来说,这条结论划出了一条可靠性上限:分支之间的差异必须能被模型真正建模,否则分叉出来的不是「另一个未来」,而是「另一段看起来合理的视频」。 规划时若把后者当成本来用,就会得到一条在物理上不成立的世界线;第十七篇讨论过的复合误差会沿着分支继续放大,让越深的分支越不可信。这也是为什么第八篇的潜空间规划更愿意在短视野内搜索、在长视野上回退到真实交互——分叉的边际价值随深度下降,速度比大多数人预期的快。
分叉的语义问题:分支之间的因果关系
分叉做完还有一层的语义要交代,这一层不在任何论文里,但会影响任何想把它用起来的人。
分支之间的实体身份要处理。 如果分叉的是「玩家 A 的世界」,那么玩家 B 在 A 的两条分支里是同一个人还是两个人?从外部看,玩家 B 只存在一次;从分支内部看,每个分支都需要一个「B 在这个分支里的状态」。这就引出一个约定:分支是观察者的私有结构,不是被观察实体的复本。 分叉只复制世界线的状态,不复制参与者的身份;参与者依然是单写者,只是在不同分支里被读到不同的值。
分支之间的时间要对齐比较。 规划里要比较「走左」与「走右」的结果,就必须保证两条分支在同一个时刻被比较,否则就是拿一条分支的第 5 秒去比另一条分支的第 10 秒。这在实现上要求分支推进带一个「逻辑时钟」或 tick 计数,作为与其他状态字段同等重要的字段——MASS 的 schema 里全局记录就存了 tick 计数,它不是装饰,而是分叉比较的基础。
分支需要有预算约束。 分叉的诱惑是无限复制,但每条分支都要真金白银的计算。一个可用的规则是把分叉预算与第十五篇的预算地图接起来:给定一份算力预算,要么把分支铺宽(多想象几条),要么把每条分支推远(每条想象更久),两者的边际收益都由复合误差决定。分支越宽,单条分支的视野越短;分支越长,误差累积越大。
自回归世界模型的推理侧有一笔与分叉直接相关的账:为了保证长视频的显存可控,生成器通常用一个固定长度的滑窗 KV 缓存,新的 latent 块进来、旧的块被挤出。分叉时,窗内的那段前缀是所有分支共享的同一份缓存;窗外的历史则已经被丢掉,无法从缓存里恢复。这与第十七篇讨论的「窗口外到期」是同一个结构性问题:分叉能共享的只有还留在窗口里的历史,窗口外的过去必须靠外部记忆来补齐。 这也是为什么共享世界状态的系统更愿意把长期历史放进可合并的外部存储,而不是指望把 KV 窗口拉长。
合并:两条世界线能不能接回去
分叉的反面是合并。两个机器人分别探索了房子的两半,各自的世界模型里有一半的场景;把它们的世界合成一个,理论上就能得到完整的房子。这件事在几何建图里已经被解决,在帧式记忆里也不难,但在 KV 与循环状态里几乎不可能。原因不在模型能力,而在状态表示的代数结构。
先问三个性质:交换、结合、幂等
把合并写成二元运算 ,它对状态的要求可以拆成三条:
这三条正是无冲突复制数据类型(CRDT)的基础。交换律保证两个副本以任意顺序到达都能得到同一结果;结合律保证多副本可以两两合并、不必约定全局顺序;幂等律保证同一条消息重复到达不会改变结果。世界状态很少同时满足三条,但不同表示满足的子集不同,这决定了它们能支持什么样的合并。
加权几何场:最容易合并的一类
第十二篇与第十七篇都出现过 TSDF 融合的更新式:
其中 是体素, 是截断符号距离, 是累积置信权重, 与 是第 次观测的距离与权重。这条式子本身就是一次合并:把「已有地图」与「一次新观测」合成一张图。
两张独立建好的地图也可以用它合并,只要把状态存成充分统计量 ,其中
而不是只存 :
合并就是逐体素相加:
为什么强调存充分统计量而不是存 ?因为对 直接做加权平均,只有在两边权重相同时才等价于对充分统计量的合并;一旦权重不同,先平均再合并与先合并再平均会得到不同结果。存 则天然满足交换律与结合律——加法是满足的。这个细节在多机器人建图里是硬性要求,在论文里往往一句「we fuse the TSDF」带过。
占用栅格是同一类。每个体素的占用概率用对数几率表示,更新与合并都变成加法:
OctoMap 这类系统把它做成八叉树,节点分裂与剪枝只是索引层面的操作,不改变「对数几率相加」这个代数事实。
几何场之所以友好,是因为它的状态是可加的观测量。这也解释了为什么多机器人 SLAM 能做成分布式:每台机器人只需要上传自己的观测充分统计量,服务端逐体素相加,不需要对齐任何隐藏状态。
集合型记忆:并集简单,驱逐不简单
场景记忆库在形式上是集合:每个记忆条目是一块 latent 加相机位姿与深度。两个客户端的记忆库合并,最直接的做法是并集——集合并满足交换律、结合律、幂等律,是标准的 G-Set。
但 WorldCast 的记忆库不是纯 G-Set,因为每个客户端只保留至多 条自己的条目,超出后按冗余度收回。收回是非单调操作:它会让集合变小,而 G-Set 只允许增长。如果允许多个客户端同时收回同一条目,就需要共识;WorldCast 用了一个更简单也更聪明的约束——条目只有一个所有者,只有所有者能发布和收回。 于是并集仍然收敛:任何非所有者看到的所有条目都是所有者当前的公开集合,所有者内部的收回对它而言等价于「这条从来没出现过」。
这个约束值得单独记下来,因为它是分布式系统里的通用技巧:把非单调操作限制在单一所有者身上,就能在不引入共识的前提下保持收敛。 同样的技巧可以用在玩家状态上:每个玩家只写自己的记录,别人只读。它牺牲的是「任意节点都能修改任意数据」的灵活性,换来的是「不需要协调者」。
离散事件:只能仲裁,不能平均
到目前为止讨论的都是连续量。世界状态里还有一类字段是离散的:谁得分、谁死亡、门是否被打开、物品被谁拾取、任务是否完成。这类字段没有「平均」的语义——把「得分 1」和「得分 0」平均成 0.5 不会得到一个合法状态,只会得到一个两边都不认的世界。
对离散字段,可用的合并规则只有三种:
- 最后写入者胜(LWW)。每条字段带版本或时间戳,合并取版本最大的。它满足交换律(版本全序时)与幂等,但会静默丢失一条分支的结果。
- 所有者仲裁。字段归某个实体所有,只有它的写者能改。玩家分数归计分实体,门的状态归门实体。它把并发写变成了串行写,代价是所有权划分必须覆盖所有字段。
- 权威日志。所有离散事件写进一条带序号的日志,合并 = 拼接日志 + 重放。它不丢失任何事件,但要求重放是确定性的。
前两种适合在线系统,第三种适合离线分析。三者都不满足「两个分支的离散结果都保留」这件事——因为这本身就不成立:一个门不可能既开着又关着。离散状态天然排斥合并,这是世界线合并的根本难点。
序列型历史:KV 只能共享前缀,不能合并后缀
现在看最不友好的一类:KV 缓存。
假设两条分支从同一个前缀出发,各自走了一段。能不能把两段 KV 接起来?把注意力写成
再接一段后缀,等价于在求和里加入新的键值对,分母随之变大,所有已有 token 的注意力权重都会被重新归一化。也就是说,拼接后的序列里,前半段对后半段的注意力分布与任何一条分支里都不相同——它描述的是一个从未存在过的上下文。
还有两个更硬的障碍。其一是位置:自回归世界模型用 RoPE 或可学习位置编码,位置索引决定旋转角度;两条分支各自从分叉点往后编号,拼在一起时位置会冲突,除非重算位置编码。其二是因果掩码:分支 A 的后缀在生成时看不到分支 B 的后缀,拼接后两者互相可见,注意力图与生成时不一致。
因此 KV 层面的「合并」只有一种合法形式:共享公共前缀,不合并分叉后缀。 PagedAttention 的写时复制与 RadixAttention 的前缀树做的正是这件事——它们不试图合并两条不同的历史,只保证相同的前缀只存一份、只算一次。对世界模型来说,这意味着两条分支即使后来观察到了同一片区域,也不能把各自的 KV 拼起来得到一个「更完整的历史」;它们能做的只是把观测写进一个外部的、可合并的记忆库(例如几何场或场景记忆),再从合并后的状态重新渲染。
这条限制有一个很实际的推论:想让世界可合并,就不要把世界只存在 KV 里。 KV 是渲染的缓存,不是世界的表示。第十七篇把记忆搬出注意力,解决的是长程回访;这一节给出了第二个理由——可合并性。外部记忆可以是集合或几何场,KV 不行。
递归状态与慢权重:一个不能合,一个能合但要留统计量
RSSM 的隐状态更新是 ,一串非线性函数的复合。两条从同一点出发的轨迹,各自复合了不同的函数序列,合并没有任何自然定义;顺序也不能交换,因为 不满足交换律。唯一可行的做法是「保留两条轨迹,交给一个能同时读两者的新模型」,那已经是另训一个模型,不是合并。
慢权重不同。World-T3 的 fast weights 是带权岭回归的在线解:
它的解由正规方程给出:
与 都是求和,因此两份独立的记忆可以合并:
减去一个 是因为正则项是「先验」,每条分支各算了一次,合并时只能保留一次。这个细节说明:可合并的前提是状态里保留了充分统计量。 如果实现只暴露最终的 ,合并就退化成「再解一次方程」,而那需要原始键值对;只有保留 与 (或等价的 加 ),才能在不重放历史的情况下合并。
当然,这只是代数上的可合并。数值上, 在长序列上会变得病态,浮点求和的顺序会影响结果,所以工程上通常会在合并前做一次条件数检查,或者用双精度累加。这也提醒一件事:「理论上可合并」与「工程上可合并」之间隔着一个数值稳定性问题,与本站数学基础方向的文章讨论的数值计算是同一类问题。
事件溯源:把「合并状态」换成「合并历史」
前面几类都在直接合并状态。还有一条更彻底的路线:不合并状态,只合并历史,然后重放。
具体做法是把世界写成事件的折叠(fold)。每条事件带上足够定位它的信息:
世界状态是这条日志按序应用转移函数的结果:
合并两份日志就是把它们按 归并排序、去重,再重放。这个做法的性质非常好:
- 交换律与结合律由归并排序保证;幂等由事件 id 去重保证。
- 合并后的状态一定可达——它就是从某条(可能是新的)事件序列重放出来的,这一点在下一小节会看到有多重要。
- 审计性好:任何时候都能回答「这个状态是怎么来的」。
代价也很直接:重放成本随日志长度增长。工程上的标准解法是检查点:每 个 tick 存一份状态快照,合并时从最近的公共检查点开始重放,只重放后缀。快照本身不需要可合并,它只是加速结构。
事件溯源还给分叉提供了一种几乎零成本的组织方式:日志是追加写的,分叉点之前的日志是两个分支共享的同一段字节;分叉之后的日志各自追加。这与 KV 的前缀共享结构同构——分叉与合并的对称性,在日志结构里看得最清楚。
合并幻觉:可达性是硬约束
现在回到那个最容易被跳过的问题:合并出来的状态,一定是一个「可能的世界」吗?
答案是否定的。两条分支各自都是可达的,但它们的逐字段拼接通常不可达。举一个具体的例子:
- 分支 A:玩家先拿到钥匙,再打开门。结束状态是「门开着,钥匙在手里」。
- 分支 B:玩家先打开门,钥匙留在了原处。结束状态也是「门开着,钥匙在原处」。
- 逐字段合并可能得到「门开着,钥匙在原处,且门是从里面反锁的」——这个状态没有任何一条动作序列能到达。
可达性的形式化条件不复杂:存在一个动作序列(或动作序列的交错),使转移函数从同一个初始状态出发能得到合并后的状态。但检查它通常是组合爆炸的,因为要枚举交错。工程上的折衷是三条:
- 只合并连续可观测量,离散事件由权威日志决定。 几何场、占用栅格、外观 latent 可以合并;谁得分、谁开门这类字段不参与几何合并,而是从日志里读。
- 合并后做一致性校验。 schema 约束(MASS 的类型化状态天然支持)、物理约束(物体不能穿模、门不能同时开与关)、渲染-状态互检(渲染出来的画面能否被状态解析器还原成同一个状态)。第六篇的三层评测在这里可以直接复用。
- 校验失败就报「不可达」,而不是硬合并。 对下游规划来说,一个明确标记为「不一致」的状态,远好过一个看起来合理但从不存在的世界。
第 3 条与第十七篇的降级原则是同一个:模型必须有能力说「我不知道」。合并系统也一样,它必须有能力说「这两个世界接不上」。
三种合并策略与适用场景
把上面的分析收成一张表:
| 策略 | 合并对象 | 需要的结构 | 是否产生统一世界 | 典型场景 |
|---|---|---|---|---|
| 观测级合并 | 几何场、占用、场景记忆 | 充分统计量 + 单所有者 | 部分(几何统一,事件不统一) | 多机器人建图、多相机重建 |
| 权威仲裁 | 离散事件、实体记录 | 单写者 / 版本号 | 是 | 多人游戏、共享会话 |
| 日志重放 | 整段历史 | 事件 id + 确定性转移 | 是(且可审计) | 离线分析、回放、评测 |
三种策略的取舍可以用一句话概括:观测级合并便宜但不完整,权威仲裁完整但需要中心,日志重放最完整但最贵。 真实系统往往三者混用:几何走观测级合并,玩家状态走单写者仲裁,赛后分析走日志重放。
这也解释了为什么「共享世界状态」这件事在 2025 到 2026 年的多人世界模型里突然变得重要:早期的视频世界模型连单玩家的长程一致性都做不到,谈合并为时过早;当 MASS、WorldCast、Khora 这一类系统把状态显式化、版本化、可分发之后,「两个入口看到的是不是同一个世界」第一次变成了一个可以设计、可以度量、可以合并的工程问题。
一份可落地的共享状态设计
前面四节是分析,这一节把分析压成一份可执行的设计。它不绑定任何具体模型,只规定状态在系统里的组织方式。
状态必须分层:世界层、入口层、渲染层
任何共享世界模型都可以把状态拆成三层:
- 世界层:与视角无关的实体记录与几何。它是唯一权威,带版本号。在 MASS 里是类型化状态,在 WorldCast 里是玩家记录加场景记忆,在几何建图里是 TSDF 与占用栅格。
- 入口层:每个入口私有的视图状态——最近若干帧的 latent、最近一段 KV、相机轨迹。它是渲染的缓存,不参与跨入口共享。
- 渲染层:生成器本身。它是无状态的计算过程,输入是「世界层的一版快照 + 入口层的缓存 + 相机参数」,输出是画面。
三层的边界是这份设计里最重要的约束。世界层不能存 KV,入口层不能写世界层,渲染层不能记住任何东西。 违反第一条,世界就不可合并;违反第二条,就会退回到「每个入口各写各的」那种不可收敛的状态;违反第三条,渲染就会变成又一个隐式的状态持有者。
版本号与因果戳
每个世界层快照带三个字段:
- 是逻辑时钟,单调递增,所有分支共享同一套刻度。
- 在分叉或合并时递增。两条分支即使 tick 相同,epoch 也不同,因此不会被误当成同一时刻。
- 记录快照的来源节点或分支标识,用于合并决策与调试。
读侧拿到快照后,按三元组比较新旧:tick 更大则更新;tick 相同但 epoch 不同,说明是另一条分支,不能互相覆盖;origin 相同而 tick 倒退,说明消息乱序,应当丢弃。这三条规则合起来,就实现了上一节讲的「读不一定读到最新,但一定读到一个一致版本」。
单写者与订阅
对实体记录,采用 WorldCast 的所有权规则:每个实体只有一个写者,其他节点订阅它的更新。实现上只需要一张「实体 id → 写者节点」的路由表,发布与回收都由所有者负责。这使得:
- 不需要分布式锁;
- 不必对同一记录做冲突解决——冲突从源头上被路由掉了;
- 合并操作退化为「交换订阅副本」,而这天然收敛。
对几何场,采用充分统计量 ,由各节点增量上传,任意节点都可以把两份统计量相加。
客户端预测与校正
渲染侧在缺数据时的推进顺序应该是:
- 用最新快照作为起点,把本入口的已知动作填入;
- 其他入口的动作按「上一步动作延续」做启发式填充(MASS 的实验显示,停滞误差主要来自缺失的远程动作,所以这一步是该填的地方);
- 用同一个学习到的转移在本地推进所需 tick 数,渲染画面;
- 新快照到达后,用互补滤波类的方式校正——对位置这类连续量融合「位移预测」与「绝对定位」,而不是直接覆盖。
第 4 步用融合而不是覆盖,理由是 WorldCast 的实测:从生成画面里估计的位置有漂移,而从地图识别得到的绝对位置会偶发跳变;两者各取一半,短期和长期误差都被压低。
一套最小伪代码
把上面的规则写成伪代码,可以看清它们的组合方式:
class SharedStateStore: def __init__(self, schema, node_id): self.schema = schema # 世界层:类型化实体与几何 self.node_id = node_id self.owner = {} # 实体 id -> 写者节点 self.records = {} self.geo = {} self.events = [] self.version = (0, 0, 0) self.tick = 0
def write_record(self, node_id, entity, fields): # 单写者:只有 owner 能写 if self.owner[entity] != node_id: raise PermissionError(entity) self.records[entity].update(fields)
def advance(self, joint_actions, exogenous): # 只有权威节点推进;一次转移吃下全部联合动作 self.records = self.logic_engine(self.records, joint_actions, exogenous) self.tick += 1 self.version = (self.tick, self.version[1], self.node_id) return self.snapshot()
def fork(self): # 写时复制:世界层浅拷贝,入口层按需复制 child = self.clone_shallow() child.version = (self.tick, self.version[1] + 1, self.node_id) return child
def merge(self, other): # 只合并可加量;离散字段按版本仲裁,不可达则拒绝 geo = add_sufficient_stats(self.geo, other.geo) events = arbitrate(self.events, other.events) if not reachable(self.schema, geo, events): return MergeResult.failed("unreachable") return MergeResult.ok(SharedStateStore.from_parts(geo, events))这段代码刻意省略了转移函数的具体形式——它可以是 MASS 的 Logic Engine,也可以是几何融合;重要的是三件事:单写者路由、写时复制的分叉、只合并可加量的合并。
三个常见误区
这份设计对应着三个在工程里反复出现的误区:
误区一:让每个入口各持一份完整的 KV 当作共享状态。 这时一致性只能靠训练数据强行拉齐,而且 KV 不可合并、不可压缩、不可分叉,每个入口都是全量复制——第二层架构的成本结构会原样复现。
误区二:分叉时深拷贝整份状态。 深拷贝 KV 会让分叉的开销按历史长度线性增长,而大部分分支只需要共享前缀。应改用写时复制或按块引用计数,这正是 PagedAttention 完全拆解 与 RadixAttention 完全拆解 已经提供的基础设施。
误区三:合并时逐字段取平均。 对位置、外观这类连续量,平均通常可以接受;对离散字段,平均会造出不可达状态。合并必须区分「可加量」与「须仲裁量」,并且在合并后做可达性校验。
小结:共享的不是模型,是状态的读写协议
这一篇把世界模型从「一个会话」推进到「多个入口共享一个世界」。按共享对象分了四层:只共享权重、共享观测历史、共享潜状态、共享权威状态。四层的一致性来源完全不同——第一层没有一致性,第二层靠注意力学出来,第三层靠「同一状态解码」的结构保证,第四层靠单写者与版本号。
并发部分拆了三类写法:单写者顺序推进、记录级多写者、无状态渲染。它们分别把同步成本压在「收齐动作」「消息数量」「零」上。MASS 的服务端公式说明世界转移的成本可以与视角数解耦;WorldCast 的实测说明记录级交换能把流量从 Gb/s 量级压到 Mb/s 量级。客户端预测的对照实验给出了一个反直觉的结论:停滞误差主要来自缺失的远程动作,而不是转移本身。
分叉部分按状态载体区分成本:循环状态最便宜,KV 写时复制次之,记忆库需要区分共享与独占,慢权重最贵。前置共享的结构与 PagedAttention 完全拆解 里的物理块、RadixAttention 完全拆解 里的前缀树是同一套机制,区别只在于这里的「请求」是「世界线」。
合并部分给出了代数上的判断标准:可加量(几何场、占用对数几率、岭回归的正规方程统计量)满足交换律、结合律与幂等律,可以直接相加;集合型记忆靠「单所有者」把非单调操作局部化;离散事件只能仲裁;KV 与递归状态在结构上不可合并,只能共享前缀。最后落到「可达性」这条硬约束:两条可达分支的字段拼接通常不可达,合并系统必须有能力拒绝。
如果只留一句话:共享世界模型的工程核心不是共享一个更大的模型,而是给状态设计一套读写协议——谁能写、写什么单位、版本怎么比较、分叉怎么复制、合并怎么判定。这套协议在多人游戏与分布式数据库里已经有几十年的答案,世界模型给它加了一条新的约束条件:状态是一张可以被解码成画面的表,所以协议的每一个设计选择,最终都会显形在「两个入口看到的画面是不是同一个世界」上。
系列走到这里,世界模型的「表示、路线、规划、评测、部署、推理、硬件、预算、动作、记忆、共享」已经连成一条链。还有一条链没有被单独处理:当世界模型作为策略的一部分被嵌进闭环系统,世界状态的误差如何被策略的反馈放大或抑制——这需要把第十二篇的复合误差与第七篇的闭环部署合在一起看,是这条路线上下一个值得单独展开的问题。
参考资料
- MASS: Multiplayer World Models with Authoritative Shared State(Cai 等,2026-08,arXiv:2608.06257)
- WorldCast: Distributed Multiplayer World Models(Ye 等,2026-10,arXiv:2610.12412)
- Solaris: Building a Multiplayer Video World Model in Minecraft(Savva 等,2026-02,arXiv:2602.22208)
- Population-Scalable Multi-Agent World Modeling across Scene Geometries(Khora,Zhao 等,2026-08,arXiv:2608.08600)
- Khora: A Scalable Multi-Agent World Model(技术预览,2026)
- IC-World: In-Context Generation for Shared World Modeling(Wu 等,2025-12,arXiv:2512.02793)
- What-If World: A Causal Benchmark for General World Models in Embodied Scenarios(Cai 等,2026-05,arXiv:2605.27589)
- Gamma-World: Generative Multi-Agent World Modeling beyond Two Players(Liu 等,2026,arXiv:2605.28816)
- MultiWorld: Scalable Multi-Agent Multi-View Video World Models(Wu 等,2026,arXiv:2604.18564)
- ShareVerse: Multi-Agent Consistent Video Generation for Shared World Modeling(Zhu 等,2026,arXiv:2603.02697)
- MetaWorld: Scaling Multi-Agent Video World Model from Single-View Video Data(2026,arXiv:2606.02753)
- MultiGen: Level-Design for Editable Multiplayer Worlds in Diffusion Game Engines(2026,arXiv:2603.06679)
- Conflict-free Replicated Data Types(Shapiro 等,INRIA 技术报告 RR-7687,2011)
- KinectFusion: Real-time Dense Surface Mapping and Tracking(Newcombe 等,ISMAR 2011,DOI:10.1109/ISMAR.2011.6092378)
- OctoMap: An Efficient Probabilistic 3D Mapping Framework Based on Octrees(Hornung 等,Autonomous Robots,2013)
- World-T3: Test-Time Training as Persistent Memory for Real-Time Video World Models(2026-10,arXiv:2610.17434)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM,2023-09,arXiv:2309.06180)
- SGLang: Efficient Execution of Structured Language Model Programs(RadixAttention,Zheng 等,2023-12,arXiv:2312.07104)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



