


世界模型从零讲起(三十七):接触从来没有被看见——边界不可观测时的信念记账
从上一篇接上:边界被估计了,但仍然被看见
上一篇把分段边界当作随机变量处理,推导了穿越时刻对状态误差的敏感度,给出了 CUSUM、BOCPD、HMM 三件在线估计工具,并把账本的条目改成带区间与污染标记的形式。那条路的出发点是:边界虽然不精确,但至少有一个能把边界估计出来的观测——力阈值、电流尖峰、触觉电阻跃变,都是对「接触」这个事件的直接测量。
这一篇处理更糟的情形:边界根本不可观测。指尖被工件完全挡住,触觉传感器没有覆盖接触点,传感器坏了,材料松软到接触力始终低于噪声,或者接触发生在一个从外部看不到的封闭结构里。此时没有任何观测能直接告诉我们「已经接触了」。能看到的只有后果:夹爪闭合速度突然变慢,电机电流缓慢爬升,工件开始随末端移动,世界模型的预测误差从某一刻起持续偏离。
后果不是边界。同一个后果可以由不同的边界时刻造成:电流从 安爬到 安,可能因为 毫秒前发生了轻触,也可能因为 毫秒前发生了较重接触。从后果反推边界,得到的是一个分布,不是一个数。上一篇的账本还能按时间索引,是因为边界至多有一个窄的区间;这一篇要面对的是边界区间宽到与段长同量级、甚至多峰的处境。
路线分五步:先把「不知道」写成信念状态,说明它为什么是这一篇的基本记账单位;再比较粒子滤波、交互多模型与流匹配提案三条滤波路线,说明它们各自补哪块短板;然后把记账换到信念空间——不再问「现在在第几段」,而是问「每个假设还缺多少证据」;接着把信念接进部分可观测规划,算清探测动作与多等几帧的决策代价;最后落到滑窗滤波的预算账本、可观性条件与工程失效模式。
前文的边界误差来源见 (三十六):边界不在你写的那一刻,混合粒度调度见 (三十四):同一任务里哪里该粗、哪里该细,闭环误差的放大机制见 (十九):误差走进闭环,POMDP 形式化与信念状态的入口见 (一):一个模型如何学会「想象」世界。
看不见的边界:三个真实的困境
先让问题具体起来。下面三种场景,在机器人的日常任务里都很常见,它们的共同点是:接触已经发生或可能发生,但传感器给不出一个能直接标记边界的读数。
其一,指尖被工件挡死。夹爪的手指夹着一个纸箱去推货架上的另一个箱子,手指与纸箱之间始终有接触,但外接触点完全在相机视野之外,触觉阵列只贴在指尖正面,既看不到也摸不到侧面发生的接触。
其二,只有本体感受可用。机械臂只装了关节力矩传感器与腕部六维力传感器,没有触觉皮肤。工件与手指之间的接触力会在关节侧留下力矩签名,但这个签名是六路关节力矩的线性叠加,多个接触点可以产生同一个签名。更麻烦的是,从力矩签名反推接触位置与力矢量是一个欠定的逆问题:接触数、接触点位置、力矢量三者中,只要有一个不知道,剩下两个就不唯一。
其三,接触发生在封闭结构里。装配、插拔、拧螺丝这类任务里,手与工件的接触包在夹具内部,视觉被遮挡,触觉只装在少数几个位置,环境接触(工件与夹具、工件与孔壁)根本没有任何传感器覆盖。
这三类场景在文献里的名字不同,但都落在同一个技术问题上:部分可观测条件下的接触估计。2026 年发表在 IEEE Transactions on Robotics 上的 ContactFlowFilter(Han 与 Kim,题目为 Mixture of Flow Matching and Particle Filter for Proprioception-Based Online Contact Estimation)把这个问题总结成三个挑战,恰好就是这一篇要处理的三个难点。
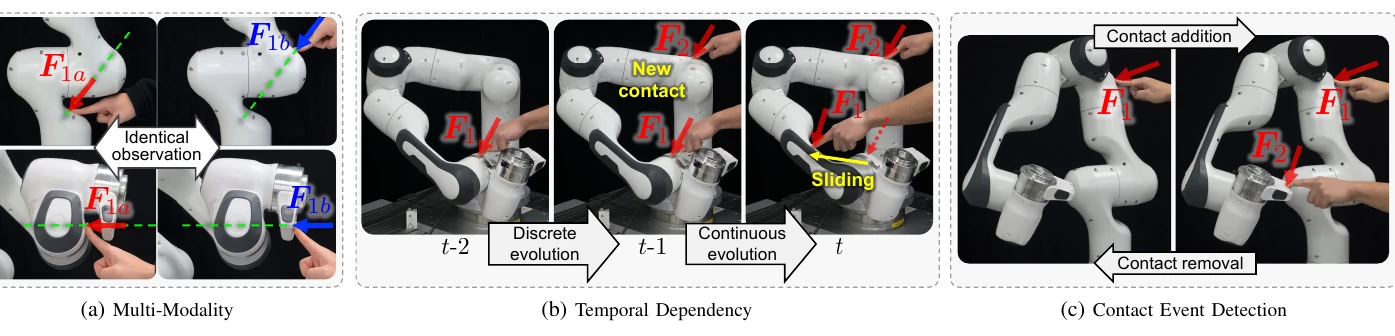
上图中,(a) 多模态说明两种不同的接触力可以产生完全相同的观测——这是逆问题欠定的直接后果;(b) 时间依赖说明接触状态是连续演化的,接触点可以滑动,力可以缓慢变化;(c) 接触事件检测要求判断「接触被加入/移除」的离散时刻,而这个时刻在观测里往往只表现为一个很弱的转折。这三点合在一起,正是这一篇要讨论的「边界不可观测」问题:不是边界没有时刻,而是时刻对应的证据太弱,弱到无法用一个读数把它钉死。
为什么「先看看像不像接触」的直觉会骗人
在进入数学形式之前,值得先把一个常见的工程直觉拆开。很多实现的第一版会这样写:每一帧计算一个「接触特征」,比如关节力矩的相对变化量、把滤波后的力矩序列与基线比较,把超过阈值的帧标为接触,然后取第一个超过阈值的帧作为边界时刻。这套流程简单、可解释、在实验室里往往能用。它在真实场景里失效的原因不是实现细节,而是它的三个隐含假设。
第一个假设是「接触特征有一个固定的基线」。基线在空载时是常值,但一旦工件被夹住、或者载荷发生变化,基线本身漂移了。漂移量与接触力同量级时,阈值检验就变成了在漂移的直线上找跳变,结果是把基线的缓慢移动误检为接触,或者把真实的接触淹没在漂移里。
第二个假设是「接触是加法扰动的」。真实系统的力矩签名为 ,接触力与模型误差、摩擦、惯性项混在一起。前三项都随姿态变化,用一个大样本训练的阈值来区分它们时,实际是把模型的不确定当成了接触的信号。
第三个假设是「一个读数决定一个时刻」。边界时刻是由一整个观测序列共同决定的,而不是由单帧决定的。单个读数没有足够的统计量来区分「刚刚接触」与「模型误差」,多个读数联合起来才能给出一个概率化的判断。这正是信念状态相对于阈值检验的根本优势:信念把整段历史压成一个分布,而阈值检验只保留最近一个读数。
把这三个假设放在时间序列上看会更清楚:真实模式在某一个时刻切换,但任何基于观测的推断给出的模式概率都是连续爬升的,没有哪一帧能用一个阈值把切换点精确切出来。后文 IMM 一节里的模式概率曲线正是这种形态;如果把曲线穿过 0.5 的时刻当作边界,边界就偏晚了。正确用法是读取整个过渡区间,把区间作为边界的区间,而不是取一个点。
信念状态:把「不知道」变成可以计算的量
从状态估计到信念
标准的状态估计只维护一个点估计 。当接触状态不可直接测量时,点估计会给出一个「最像」的值,但这个值掩盖了不确定性。比如力矩签名与「指腹接触力 3 牛」和「指侧接触力 2.5 牛且方向偏 15 度」都吻合,点估计会从中挑一个,下游的功率分配、误差账本、粒度调度全部按这一个假设推进,等到发现挑错了,整段预算都已经花掉。
正确的记账单位是信念(belief):给定到当前时刻的观测历史 与动作历史 ,所有可能世界状态的一个概率分布。
这里 是环境的真实状态, 是观测, 是动作。把它套到接触问题上,状态至少包含三部分:连续的运动状态(关节角、速度、工件位姿),离散的接触结构(有几个接触、分别在哪里),以及连续的被接触量(每个接触点的力矢量)。写作
其中 是关节构型, 是当前接触数, 是第 个接触点的位置与力矢量。 是离散量, 是连续量,二者耦合在一起——接触数变了,接触点位置的含义也变了。这是接触问题区别于普通状态估计的核心困难:状态空间本身的结构随离散量变化。本系列第一篇在 POMDP 形式化时已经建立了信念状态的概念,可回顾 (一):一个模型如何学会「想象」世界 中的形式化部分。
信念更新的两步
信念的演化遵循贝叶斯滤波的两步结构。预测步把上一时刻的信念推过动力学:
更新步用观测修正:
分母只依赖观测历史,对给定时刻是一个常数,所以真正的计算量集中在两件事上:预测步要对整个状态空间做积分,更新步要对积分结果做重加权。当状态空间是离散的有限集合时,积分退化为求和,可以用动态规划精确计算;当状态是连续变量时,积分没有闭式解,只能近似。
为什么一阶近似不够用
最简单的近似是扩展卡尔曼滤波(EKF):在每个时刻用当前点估计处的雅可比矩阵把非线性动力学线性化,然后用高斯分布近似信念。它在边界清晰、非线性不强的系统里足够用,但在接触问题里会失效,原因有三点。
第一点是多模态。EKF 的信念是单峰高斯,无法同时表示「指腹接触」与「指侧接触」两个都说得通的假设。ContactFlowFilter 论文 Fig. 2 (a) 给出的例子正是这一点:两种不同的接触力配置产生同样的观测,任何单峰近似都只能保留其中一个,并且把另一个当成不可见的偏差。
第二点是离散跳跃。接触数增加与减少是离散事件,动力学在事件前后是不同的两个系统。线性化需要对一个明确的、光滑的动力学做,而事件恰恰破坏了光滑性。前一篇讨论混合自动机时已经指出,discrete jump 需要 reset map 单独处理;在部分可观测条件下,连「有没有发生 jump」都不知道,reset map 就无处可用。
第三点是系统性的「过于自信」。当观测对边界几乎不敏感时,EKF 的协方差更新仍然会按观测信息量把方差缩小,于是信念变得很窄,但实际上误差可能更大。ContactFlowFilter 的论文在实验部分专门和 PF、学习方法做了对比,指出单纯的 PF 在接触数变化时会因为粒子集中在错误的模式里而失效,这正是单峰近似的同类问题——粒子足够多能表示多模态,但粒子怎么在高维接触空间里高效分布是另一回事。
三种滤波:从粒子到流匹配
这一篇不打算系统梳理滤波器谱系,只挑三个与「接触不可观测」直接相关的路线,逐个说明它们解决什么问题、留下什么。
粒子滤波:用样本表示信念
粒子滤波(particle filter)用一组加权样本来近似信念:
是第 个粒子, 是它的重要性权重,满足 , 是粒子数。它天然支持多模态:两个相距很远的粒子簇可以同时存在,权重反映哪个簇更符合观测。接触数变化也可以用不同的粒子簇来表示——有些粒子处在「一个接触」的模式,有些处在「两个接触」的模式。
但朴素粒子滤波在接触问题里有两个尖锐的困难。第一,粒子必须被放到高维的接触状态空间里,接触点位置与力矢量加起来是六维以上,要让粒子覆盖足够宽的范围,粒子数会呈指数增长。第二,当观测信息很弱时,重采样会把粒子集中到一个偶然更高的区域,多模态结构丢失,这就是所谓样本坍缩。ContactFlowFilter 的论文把这两个困难对应到「提案分布质量」上,并且给出了解决办法:在经典 PF 的提案分布之外,额外引入一个用生成模型构造的提案,专门负责把粒子放到多模态的区域。
交互多模型:离散模式先验
交互多模型(Interacting Multiple Model, IMM)是处理离散模式切换的经典方法,最早在机动目标跟踪中使用(Blom 与 Bar-Shalom 的 IMM 算法,1980 年代)。它的思想非常简洁:为每个离散模式各维持一个滤波器,在每个时刻先按转移概率混合各滤波器的状态与协方差,再用观测各自更新,最后按各模式的后验概率加权输出。
设模式集合为 ,模式的转移概率矩阵为 。混合步先计算每个模式的先验概率:
然后按归一化的混合权重把各模式的状态均值与协方差混合,再各自做预测与更新。更新之后用似然 修正模式概率:
最终的状态估计是各模式估计的加权和。IMM 的吸引力在于:它把「离散模式的切换」显式地放进模型结构里,而不是让一个混合滤波器去隐式地处理。对一个有「未接触 / 接触 / 滑动」三个模式的接触系统,IMM 结构天然给出了「我现在更相信哪个模式」的概率,这正是信念状态记账需要的东西。
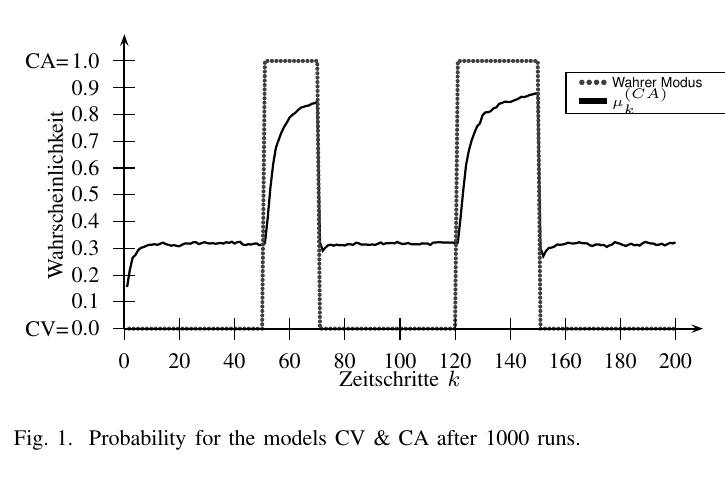
上图来自 Sebastian Dingler 的技术笔记 State estimation with the Interacting Multiple Model (IMM) method(2022 年发布在 arXiv),横轴是时间步,纵轴是匀加速模式的后验概率 。可以看到在真实模式切换的时刻,概率不是瞬间跳变,而是经过几步连续爬升才完成切换。这个形状本身很重要:它说明 IMM 给出的模式概率是一个连续变化的信念量,而不是一个硬切换标签。在接触问题里,这个连续量恰好可以充当「边界后验」的替代——虽然我们不知道接触发生的精确时刻,但模式概率从「未接触」主导到「接触」主导的这段过渡,给出了边界所在的一个区间。
IMM 的局限也很清楚:它假设每个模式内部的动力学可以用高斯型滤波器(如 EKF)很好地近似,模式之间的交叉混合也只混合一阶与二阶矩。当接触引起的非线性很强、或者模式内部本身就是多模态(接触点位置可以有两种可能)时,IMM 会退化成错误的高斯近似。论文 2024 年发表的 Differentiable IMM Particle Filtering(Brady 等,arXiv:2410.00620)正是为了把这个结构推广到粒子层面:每个模式维持一组粒子,模式之间的混合在粒子层面完成,并且整个参数可以通过梯度下降学习。
流匹配提案:让粒子一开始就在对的地方
ContactFlowFilter 的核心贡献是把生成模型放进粒子滤波的提案分布里。先解释流匹配(flow matching)是什么。流匹配是一类连续时间生成模型,学习一个概率路径,把简单分布(如高斯)在连续时间上变换成目标分布。设时间 ,目标是学习一个速度场 ,使得从一个基准分布采样的样本沿常微分方程
演化后,在 时的分布与目标分布匹配。生成时从基准分布采样、用数值积分求解这个 ODE,就能得到目标分布的样本。与扩散模型相比,流匹配的路径更直,生成需要的步数更少,推理更便宜——这一点对一个要在控制周期内运行的提案分布至关重要。
论文的做法是:用流匹配网络学习一个「给定当前观测与历史,接触状态可能出现在哪里」的条件分布,在每一步把它与 PF 的时间预测结合起来,两者的样本合并成新的粒子集。论文 Fig. 3 给出了完整的框架结构。
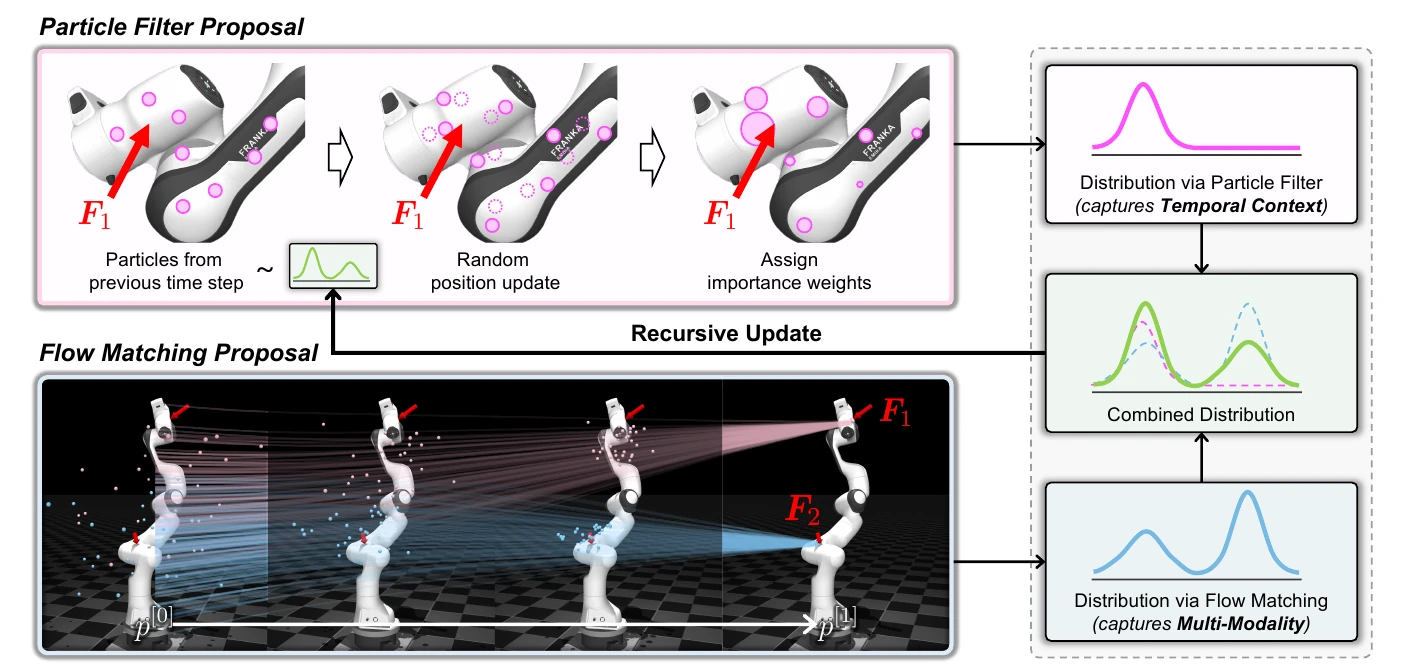
图中上半部分是粒子滤波提案:从上一时刻的粒子出发,做随机位置扰动,用重要性权重评估,捕获时间上下文。下半部分是流匹配提案:从生成模型直接采样,捕获多模态。两条提案的样本通过共同的权重分配合并成最终信念分布。这个结构的价值在于分工:PF 负责「联系前后两个时刻」,保证信念不会在时间上跳跃;流匹配负责「处理当前观测的歧义」,在多模态区域一次性生成足够多的样本。论文在仿真与实体机械臂上都做了实验,涵盖接触数估计、接触点位置与力矢量估计,以及接触事件的检测时刻。具体的数值结果这里不展开,重点是结构本身。
信念空间记账:每段还缺多少证据
前几篇的误差账本记录的是「某一段花了多少预算、带了多少误差」。边界不可观测时,账本的基本单位要从「一段」换成「一个信念假设」。这一节的记账结构沿用第三十五篇的版本列,但把段号换成信念簇编号,并增加一个证据计数。
账本的基本结构
把信念的支撑集聚类(PF 中就是按位置分簇,IMM 中就是按模式分组),每个簇记一条:
| 字段 | 含义 | 典型取值 |
|---|---|---|
hyp_id | 信念簇编号 | 随簇出现/消失分配 |
mass | 该簇的信念质量 | |
evidence | 支持该簇的证据量(对数似然累积) | 单调增,重采样不归零 |
posterior | 该簇代表的假设后验 | 即 mass 归一化 |
predicted_obs | 该簇预测的下一次观测(或其期望) | — |
parent | 从哪个簇分裂/合并而来 | 用于审计 |
born_t | 簇出现时刻 | — |
stale | 已连续多少步没有被证据支持 | 超过阈值即移除 |
证据计数:为什么不能用后验质量
一个看起来自然的做法是:后验质量低于某个阈值就丢弃这个簇。这在边界清晰时没问题,但在边界不可观测时是一个陷阱。原因在于观测对边界的敏感性本身就低。ContactFlowFilter 论文在介绍挑战时举过一个例子:多模态下两种接触配置给出同样的观测。在信息量少的时刻,一个与当前观测吻合的簇可能质量很高,而另一个同样合理的簇质量很低,因为它在那一两帧里恰好预测差了一点。如果直接按质量剪枝,正确假设会在证据还没积累起来的时候就被删掉。
证据计数用累积对数似然来度量,而不是瞬时质量:
它的含义是「这个假设累积解释了多少观测」。注意两点:第一,对数值可以很小、可以是负数,但累加之后差异会稳定;第二,重采样时这个累积量不随粒子权重被重置,它属于假设本身,而不是属于粒子。在实现上,这就是给每个簇一个独立的计数器,簇内粒子重采样不影响它。
置信度阈值与代价不对称
信念的记账最终要回答一个行动问题:什么时候可以接着做,什么时候必须停下来多看一秒。
把「停下来」建模为一个额外的观测动作,它的代价是时间与吞吐;继续执行则承担「假设选错」的代价。两种代价不对称:对接触状态的错误假设,在抓取任务里意味着物体掉落或者过度夹持;而多停一帧的代价只是几十毫秒的延迟。
沿用第三十六篇的代价语言,设错误代价为 、多看一帧的代价为 ,当前信念在领先假设上的质量为 (取 )。问题不是「置信度低于多少就停下来」这种单向阈值,而是「这一帧到底值不值 」。
把单帧观测建模成一个二值判别通道:它以概率 指向真实假设,以概率 指向错误假设, 就是这一帧的判别准确率。在当前信念下,如果直接按领先假设执行,错误概率是 ,期望代价 ;如果先看这一帧再决策,用贝叶斯更新后的后验做判断,可以算出一个很干净的结果:单帧决策的错误概率是 ,与先验 无关。原因是对称通道下,观测把信念「重置」到它的准确率水平——先验再强,一帧弱证据也带不来更多;先验再弱,一帧强证据也只能带到 。
于是「看这一帧」划算的条件是
也就是 。这个式子比任何固定置信阈值都更有解释力:一帧观测只有在它的判别准确率高于当前把握时,才值得为它多等一个周期。取 ,则要求 至少比 高两个百分点;如果当前已经 95% 确定接触发生,而这一帧的准确率只有 90%,那么看它不但不增加确定性,反而会把信念拉回 90%,正确的做法是直接执行并保留守卫带。
反过来,如果当前只有 60% 的把握,而这一帧的准确率有 90%,那么看它是划算的:花 把错误代价从 降到 ,收益是 ,是 的十几倍。
多帧累积与停止点
单帧不够时,连续看 帧可以累积判别力。若每帧独立、准确率同为 ,按证据累加后的等效准确率为
这正是对数似然比的 softmax 形式: 帧的证据总量是每帧对数似然比之和,等效准确率随 单调上升。以 为例, 分别给出 。要在 70% 单帧准确率下把把握推到 99%,需要 7 帧左右。
停止点由成本决定:再增加一帧的边际收益是 ,边际成本是 ,当
时停止。把上式代入 、 的例子, 到 的增益约 ,仍大于 ; 到 的增益约 ,小于 ,于是停止在 。这个计算给出一个可以直接写进调度器的规则:每多一帧,比较等效准确率的增量乘以错误代价与观测成本,增量低于成本就停。它自动适应了 与 的变化,不需要为每个任务手工调一个固定阈值。
段预算的信念版本
第三十四篇的混合粒度调度把预算分配按段进行:每段有误差预算、有单价、有 DP。边界不可观测时,段的先验长度与先验起止时刻本身是假设。把每个假设对应的「段划分」与它的后验质量相乘,得到的是期望预算:
其中 是假设 下的完整分段规格, 是假设的后验。这个式子看起来简单,其实说明一件事:调度器不应该按最可能的分段规格执行,而应该按期望预算执行。如果两个假设各占一半质量,一个认为抓取段从 0.5 秒开始、一个认为从 0.56 秒开始,那最优的粒度不是选一个,而是把 0.5 到 0.56 这 60 毫秒当成「必须用细粒度」的守卫带——第三十六篇的守卫带结论在这里重演:守卫带宽度由信念分布的尾部宽度决定,而不是由点估计的误差决定。
与误差账本的其他层如何接
信念空间的记账不是孤立的模块,它要与其他几层对接:误差账本按段记预算,抽象误差按粒度分解,在线更新按版本返还。这一节说明三条接口,以及每一处容易出错的对接点。
与抽象误差三项分解的对接
第三十三篇把抽象误差分成三项:结构误差(模型结构本身不足以描述系统)、参数误差(结构对但参数错)、以及观测误差(传感器噪声与延迟)。在边界不可观测的条件下,三项的解释需要调整。
结构误差在这里变成了「模式集合不完备」:如果真实的接触模式里包括滑动与卡滞,而模型的模式集合里只有「未接触 / 接触」两个,那么无论观测多充分,信念都会在错误的模式集合上收敛。这一项误差无法通过加粒子数或加观测来解决,只能扩充模式集合。识别它的方法是看残差分布:如果信念已经很有信心,但观测残差的分布仍然有一个结构化的偏置,那大概率是模式集合不对。
参数误差变成了「接触力学参数的误差」:刚度、阻尼、摩擦系数的不准确会让预测步系统性地偏,信念会逐渐向错误的一侧漂移。这一项可以通过在线标定减弱,但需要额外的激励数据。
观测误差则与前面提到的可观性条件直接相关:在某些方向上的零空间里,观测误差被完全掩盖,信念在这些方向上不更新,误差保持初始值。这一项只能通过改变传感器配置或探测动作来改善。
与在线更新版本列的对接
第三十五篇给账本加了一列版本,用来标记模型被改写后哪些条目需要重估。在信念空间里,版本列要扩展到信念簇上:每个簇带一个 model_version,记录它在产生时所用的接触模型、传感器标定版本与流匹配网络的权重版本。当其中任意一项被更新时,受影响簇的 evidence 不能简单继承——旧版本累积的证据是在旧模型下有效的,新模型下可能得出相反的判断。一个常见的做法是给证据加一个衰减:更新发生时,把 evidence 乘以一个小于 1 的因子,并标记为「需要重新积累」。这个因子通常取 0.3 到 0.5,既保留了一部分历史信息,又给新证据留出足够的权重。
与段预算的对接点
第三十四篇的动态规划按段分配粒度。信念空间的对接要处理一个微妙点:DP 的代价函数假设每段之间是确定的衔接,而在信念下,段与段之间的边界是弥散的。处理办法是把 DP 的状态扩展为「信念簇编号 + 时间」,转移代价按信念质量加权:
其中 是假设 下的部分最优值, 是在第 段时刻 处于假设 的后验。这样算出来的最优策略是信念下的期望最优,代价是状态空间变大了——从「段号 × 时间」变成「簇号 × 段号 × 时间」。在簇数不多(通常 3 到 8 个)时,这个扩展是可接受的;簇数多时需要先聚类合并,否则 DP 会爆。
部分可观测下的规划:信念树与场景
记账给了「哪里不确定」,规划要给「下一步做什么」。这正是 POMDP 规划的核心。2017 年在 Journal of Artificial Intelligence Research 发表的 DESPOT(Ye、Somani、Hsu 与 Lee,Online POMDP Planning with Regularization)给出了一个在计算上可行的结构。
从信念树到稀疏信念树
标准信念树把每个动作-观测历史作为一个节点,从根信念出发,每条路径就是一个完整的 action-observation history。
在节点内部,对每个可能的动作做 lookahead,然后在动作之后对每个可能的观测产生一个新的子信念节点,树的宽度是 ,深度 的树节点数是 ,这就是 POMDP 规划所谓的「历史维数灾难」。在接触规划里,观测空间至少包含力矩读数、位置读数等多个连续量,离散化后观测数也是几十到上百,这个规模完全不现实。
DESPOT 的做法是:不用整个信念树,而是采样一组场景(scenario),每个场景是环境状态序列的一个确定性实现,它的演化由固定的随机种子驱动;从根信念展开的树只保留这些场景经过的路径。这棵稀疏树是一棵真正被展开计算过的树,它的节点数随场景数和深度线性增长。
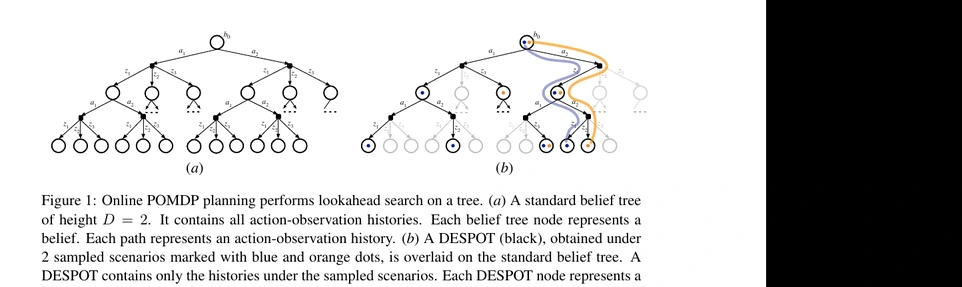
上图是论文 Fig. 1:左图 (a) 是深度 的标准信念树,每个节点对应一个信念,每条路径对应一个 action-observation history;右图 (b) 在标准树之上叠加了只保留两个采样场景的 DESPOT(黑色部分),蓝色与橙色分别代表两个场景经过的路径,每个 DESPOT 节点用一个粒子集来隐式地近似信念。DESPOT 的关键是:信念不需要显式表示,置信度在每个节点上由「经过这个节点的场景子集」隐式计算,这个子集就是节点的粒子集。规划时,每个节点只需要维护粒子集与累积奖励,而不需要维护一个完整的概率分布。
这里有一个联系值得说清楚:DESPOT 的粒子集就是「信念在规划里的另一种表示」——与前面接触估计中的粒子完全同构。接触估计负责回答「现在信念是什么」,DESPOT 负责回答「信念往前走几步会怎样」,两者共享同一套场景样本。在落地实现里,可以让接触估计的粒子直接充当 DESPOT 的场景起点,从而避免两套采样器各自维护粒子,减少一致性错误。
场景重采样的代价
DESPOT 在每个规划周期都会重新采样场景,这意味着每一步看到的是不同的未来实现。这个设计是为了避免「用同一批场景优化出对这批场景过拟合的策略」——类似蒙特卡洛树搜索(MCTS)中每轮重新展开的做法。代价是:每个步长的场景数要足够大,才能让基于场景的信念近似有统计意义。在接触规划里,场景本身需要模拟接触动力学,每个场景推演几步就可能比一个控制周期更长,这就把场景数压到很小,反过来削弱了信念近似的质量。2023 年发布的 CAR-DESPOT(Causally-Informed Online POMDP Planning for Robots in Confounded Environments,arXiv:2304.06848)则从因果结构的角度重写在线 POMDP 规划的形式,把环境中的混杂变量与机器人自身的观测分开建模,以减少因为「把环境的因果影响误当成动作效果」而产生的规划偏差。这类工作与场景采样的关系是间接的:如果场景本身没有正确反映因果结构,那么无论采样多少场景,规划都会系统性偏向错误的一侧。对接触规划而言,DESPOT 的场景数是这里最紧的约束,与其在场景数量上做文章,不如让每个场景的因果结构更接近真实。
滑窗滤波的预算账本
信念估计不是免费的。粒子数、流匹配的积分步数、IMM 的并行滤波器数、DESPOT 的场景数与深度,每一项都在消耗控制周期内的预算。这一节把各项成本写成可计算的式子,并给出常见的预算分配。
成本模型
设定滤波周期为 (例如 10 毫秒),处理链路必须在 内完成一次滤波更新。把耗时分为三块:时间预测、观测更新与提案生成。粒子数 的情况下,时间预测的耗时近似为
其中 是单个粒子推进一次动力学的成本(含接触力计算)。观测更新需要为每个粒子计算似然:
第一项是似然计算,第二项是重采样(通常用 的排序或系统重采样)。提案成本取决于方式:如果使用流匹配提案,每个生成步的耗时约为粒子数乘单步网络开销 ,步数为 :
总预算约束为
是留给滤波的比例,通常取 到 ,其余时间留给规划与控制。
数值上怎么分配
取一组典型数量级: 毫秒,,可用的滤波时间约 毫秒。若 微秒、 微秒, 时 毫秒、 的似然部分约 毫秒;重采样按 次操作、每次 微秒计,约 毫秒。三项合计约 毫秒,剩余约 毫秒可以给提案。若流匹配每粒子单步开销 微秒, 时每步约 毫秒,5 步约 毫秒,刚好进入预算;同样的单步开销下,20 步需要 毫秒,远超预算——这就是为什么流匹配的路径更短很重要。
滑窗:把历史压在一个固定窗口里
当观测不直接包含边界信息时,单步更新往往不够。一种补救是滑窗:保留最近 步的观测与粒子轨迹,在窗口内做联合更新或者回溯修正。滑窗的代价是内存与计算量都随 线性增长:
它的收益体现在两处:第一,对边界时刻的估计,窗口内的多个观测可以联合给出更紧的区间,而单步只能给一个瞬时概率;第二,对多模态的排除,某些假设在单步里说得通,但把窗口里连续几步连起来看就不成立了。窗口长度需要权衡: 太小,回溯修正没有足够证据; 太大,早期观测的信息逐渐被新的动力学吞掉,而且成本溢出。一个实用的选择是把 设为控制周期与任务段的比值,比如接近段持续 0.5 秒、控制周期 10 毫秒, 取 20 到 50。
论文里的工程细节
ContactFlowFilter 的论文在系统实现上处理了几个重要的工程问题,值得单独说明。第一是粒子集的异步执行:流匹配推理在 Python 侧运行,与粒子滤波的时间预测异步执行,让推理延迟不直接卡住控制周期,只在需要时用最新提案更新粒子集。论文 Fig. 12 展示了这种异步执行的结构。第二是粒子集的管理:在接触数变化时,簇的增删需要显式的合并与分裂规则,否则会出现「旧簇一直在,新簇永远进不来」的僵化现象。第三是硬件相关处理:由于接触估计依赖机器人连杆的运动学与关节力矩映射,不同的连杆几何与质量分布会影响力矩签名,论文在实验中使用了 Franka Emika Panda,并对连杆网格与动力学参数做了标定。
学习式与无传感器的替代路线
除了滤波器,近年还有一条直接走学习路线的分支:把接触估计当成监督学习任务,用视觉与本体感受直接预测接触。这一节介绍这条路线上的代表工作,并说明它们与信念记账的关系。
用伪触觉替代触觉
2026 年发表在 arXiv 的 NoContactNoWorries(Soham Patil 等,Estimating Contact through Vision and Proprioception for In-Hand Dexterous Manipulation,arXiv:2606.24450)提出:不需要触觉传感器,只用腕部相机(Intel RealSense D435/D455)的 RGB-D 与关节位置/指令,就能预测灵巧手每个指尖的接触二值信号。它的结构是一个因果 Transformer,把当前 RGB-D 与本体感受融合,配合交叉注意力使用当前与指令关节构型,输出逐指尖的接触估计。
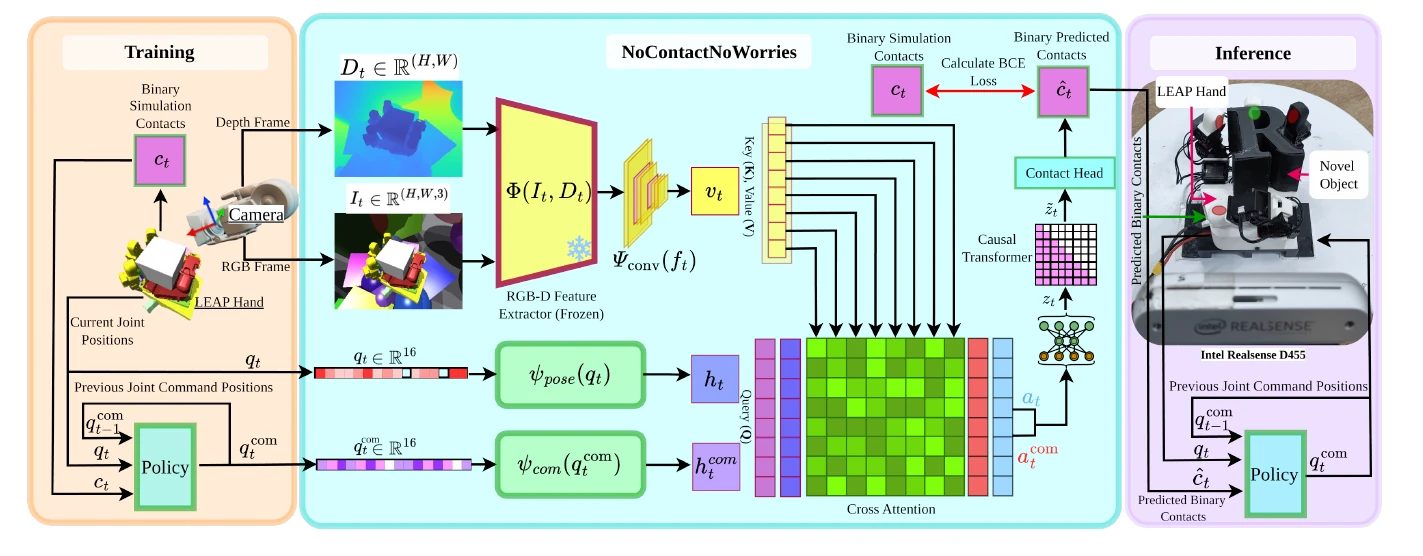
上图是论文 Fig. 1:训练阶段在仿真里用预训练的灵巧手旋转策略跑出同步的 RGB-D、本体感受与真值接触,计算二值交叉熵;推理阶段把相机与关节指令喂进冻结的特征提取器,经交叉注意力与因果注意力输出接触。这种方法的显著特点是:它完全不依赖接触传感器,因此适合「根本没有触觉」的场景;局限是它对遮挡敏感,腕部相机看不到的手指内侧的接触只能靠推断——这正是「边界不可观测」的另一面。论文在实验中专门讨论了视觉遮挡对手部内操作的影响(Fig. 5),并分析了遮挡条件下估计性能的变化。
学习方法与信念记账的关系
学习方法输出的是一个点估计(每帧的接触二值标签),与信念状态的关系是一个天然张力:学习模型本身是确定性映射,但它的输出误差在时间上不独立,可能连续几帧一致地错。把它当作信念的观测函数,而不是最终结果,是一个更稳妥的设计:学习模型的输出进入贝叶斯更新,被信念的累积证据修正,而不是直接当作控制器的输入。这样,模型的偶发错误可以被信念的动量压住,模型的系统性偏差则会在证据累积中显现出来。
视觉本体融合的工程边界
视觉本体的路线在工程上有几条硬边界。相机延迟通常比关节反馈大,二者需要时间同步;腕部相机在抓取姿态下常常被手指或工件挡住;环境接触(工件与外部)在相机视角之外。所以视觉本体方案更适合「手内接触」这样的场景,而不太适合夹具内部、工件外接触这类完全遮挡的场景。对后者,只有本体感受(关节力矩)能做,也恰恰是 IMM 与粒子滤波这类纯本体方法的用武之地。
端到端结构:感知、信念、规划、控制的闭环
到这里,各块组件已经齐了。把它们的连接关系列成一张表,就是接触不可观测条件下的完整闭环。
| 环节 | 输入 | 输出 | 对应组件 | 关键约束 |
|---|---|---|---|---|
| 感知 | 关节力矩、腕部力/力矩、视觉 | 观测 | 传感器与标定 | 可观性秩条件 |
| 信念 | 上一时刻信念、动作、观测 | 当前信念 | PF + IMM + 流匹配提案 | 多模态、时间依赖 |
| 记账 | 信念簇、累积证据 | 证据计数、置信度、期望预算 | 账本与阈值规则 | 离散事件 |
| 规划 | 信念、任务目标 | 动作(执行或探测) | DESPOT 式信念树 | 模式切换 |
| 执行 | 动作 | 新的观测 | 控制器 | 时间戳与延迟 |
三个挑战不是并列的三个问题,而是同一个闭环中的三种作用:多模态作用在感知与信念之间,决定信念必须有多峰;时间依赖作用在信念与预测之间,决定信念必须维护时间上下文;离散事件作用在信念与规划之间,决定规划必须处理模式切换。
闭环中最容易被忽视的是「规划与信念的一致性」。DESPOT 用粒子集表示节点信念,接触估计用粒子表示当前信念。如果两者各自采样、互不对齐,规划出最优动作所针对的「信念」可能与执行时真实更新出来的信念不同,策略就会在边界附近反复横跳。解决办法在结构上很简单:让接触估计的粒子集直接作为 DESPOT 各节点的起点,规划中增加一个「信念一致性」检查:如果当前实际信念的粒子与规划假设的粒子簇不重叠,就触发重新规划。这个检查的成本很低——按簇匹配粒子,每周期只做一次。
失效模式:信念滤波在哪里会崩溃
信念滤波能处理「看不见」,但它自身也有失效模式。把它们列出来,是为了知道在工程里应该关注什么。
| 失效模式 | 表现 | 根因 | 缓解 |
|---|---|---|---|
| 样本坍缩 | 多峰信念退化成单峰 | 重采样把少数簇的粒子清空,提案只从单峰采样 | 流匹配提案、簇保留、证据计数剪枝 |
| 模式概率饱和 | 模式概率在 0 或 1 附近卡住 | IMM 转移概率先验过窄,新模式出现时无质量 | 转移概率下限、强制探索粒子 |
| 学习模型饱和 | 接触估计连续多帧误判 | 视觉遮挡后模型输出偏置 | 用信念累积证据做后处理,不要直接信任单帧 |
| 观测延迟错位 | 信念比真实状态晚几毫秒 | 相机与关节反馈不同步 | 时间戳对齐、延迟补偿滤波 |
| 环境接触漏估 | 外部接触始终不被估计 | 传感器覆盖不到、逆问题欠定 | 本体感受优先,多点力矩签名联合估计 |
| 异步提案滞后 | 提案分布与当前信念不匹配 | 流匹配推理延迟 | 提案在空闲周期更新,加切换保护 |
这张表里最关键的一行是第一行与第三行。样本坍缩是粒子层面的失败,学习模型饱和是预测层面的失败,二者共同造成「信念在错误的地方变得过于自信」。第三十六篇里关于「模式漏检与误检的代价不对称」的结论在这里同样成立:信念滤波的「错误自信」比「迟疑」更危险,因为错误自信会让调度器提前结束守卫带。
该动手还是该多看一秒:停止规则与探测动作
前面关于置信度阈值的讨论只回答了「某个假设还要不要保留」,没有回答「当前该不该继续执行」。这一节补上这个决策问题,因为它是信念记账真正落地的地方。
两类动作:执行与探测
在部分可观测条件下,动作分两类。执行动作推进任务,例如继续合拢夹爪、继续下压;探测动作改变可观性,例如小幅抬升、左右微动、松开再轻碰。探测动作本身不完成任务,它的唯一目的是让原本不可观测的边界变得可观测。
两类动作的账要分开记。沿用前面的记号,设执行动作的期望代价为 ,探测动作的期望代价为 ,探测完成后信念的熵为 。一次探测值得执行,当且仅当它带来的信息收益大于它的成本:
左边是探测的成本,右边是探测前后执行动作期望代价的下降。这个式子的直觉很直白:探测是在用确定的几十毫秒,换掉一个不确定的错误代价。它只在「探测真的能改变信念」时成立。如果探测动作对边界不敏感——比如在一个已经被夹紧的工件上左右晃动,工件与手指一起动,力签名不变——那么右侧近似为零,任何探测都不划算,此时正确的行为是按当前最安全的假设执行并接受不确定性。
抬升探测的数值例子
考虑一个三秒抓取任务中的一段:夹爪已经合拢到预设位置,工件可能被夹住也可能只是挨着。继续抬升 2 厘米,如果工件被夹住就随夹爪一起上来;如果没夹住,工件留在桌面、夹爪空抬。这个「抬升 2 厘米」就是一个探测动作。
设探测耗时 0.4 秒,夹爪空抬不会造成损坏,代价主要是周期占用,约合 1 个单位;如果抬升后工件掉落,损失约合 100 个单位;如果根本不探测就继续搬运,物体在搬运中途滑落的损失约合 60 个单位。当前信念给出「夹住」的概率为 。
探测的价值在于把 变成 0 或 1。探测代价 ,执行(直接搬运)的期望代价 。探测后,若确认夹住,期望代价为 0;若确认没夹住,重新夹取的代价约为 20。于是探测的期望总代价近似为
与直接搬运比较,探测划算的条件是
化简得 ,即 。也就是说,只有当「已经夹住」的概率高到 97.5% 以上时,才值得跳过探测直接搬运;低于这个值,花 0.4 秒做一次抬升探测是更好的选择。这个结论与直觉一致,但它把直觉变成了一个可调的数:只要把损失估计换成实际的物体价值与产线节拍,阈值就能重算。
序贯概率比检验:最优停止的标准答案
对两类假设(接触 / 未接触)的情形,停止规则的理论最优解是序贯概率比检验(Sequential Probability Ratio Test, SPRT),由 Wald 在 1945 年提出。它的规则是:每一步累积对数似然比
当 超过上界 时接受 ,低于下界 时接受 ,介于两者之间则继续观测。两个边界由两类错误率 与 决定:
SPRT 的性质是:在所有满足同样错误率约束的检验中,它的期望样本数最小(Wald 与 Wolfowitz 证明了这一点)。这正好对应「在给定误判率下的最少观测步数」,也就是在控制周期固定时最少的额外等待时间。
把 SPRT 用到接触问题上有两个现实修正。第一,SPRT 要求两个假设下的观测分布已知,而接触模型里的刚度、噪声、接触位置都是估计量,分布本身有误差。用错分布时,SPRT 的边界不再保证错误率。第二,接触事件是重复发生的,不是一次性的二选一,多次 SPRT 串行会放大累计错误。
修正办法是把 SPRT 从「固定分布」换成「信念更新」:用当前信念预测的观测分布替换固定的 ,边界则用回放数据标定,而不是直接用理论值。这与第三十六篇里保形预测的做法是同一个思路:理论给出形式,数据给出阈值。工程上通常把上界 设得比理论值更保守(例如乘以 1.5),用额外的观测步数换取对模型误差的鲁棒性。
什么时候探测动作本身会改变边界
探测动作有一个反身问题:动作会改变系统状态,而边界正处在被估计的状态里。抬升探测会改变接触力,左右微动会改变接触点,松开再碰会真的改变接触数。探测在收集信息的同时,把「观测对象」变成了「被自己影响的对象」。
这个反身问题在部分可观测规划里有一个标准处理:把探测动作当成普通动作看待,纳入同一个 POMDP,让信念在动作后按真实动力学更新。区别只在于奖励函数:探测动作的即时奖励为负(时间成本),但它通过改变信念影响未来的期望回报。DESPOT 与 POMCP 这类在线规划器天然支持这种处理,因为它们在信念树上同时评估执行动作与探测动作。代价是规划树要包含探测分支,计算量增加;在控制周期约束下,通常的做法是只在信念熵高于阈值时展开探测分支,其余时间只展开执行分支。
观测设计:让边界变得可观测
信念滤波与探测动作都是在「现有传感器」的前提下做文章。还有一条更根本的路:改传感器配置,让边界从一开始就可观测。这一节给出判断「哪里该加传感器」的方法。
可观性的秩条件
考虑一个简化模型:刚体机械臂,接触力 作用在接触点 上,关节力矩观测为 ,其中 是接触点处的手臂雅可比矩阵, 是内部力、摩擦与惯性等模型项。接触可观测的必要条件是 落在 的列空间里;若 的秩小于 的维数,则至少有一个方向的力分量落在它的零空间里,对关节力矩没有贡献,因而不可观测。写成
就意味着存在不可观测的接触方向。这个条件解释了两类常见现象。第一类是指尖侧向接触:当手指与工件的接触方向恰好沿手指连杆的轴线时,该方向的力对关节几乎不产生力矩,力矩签名很弱。第二类是内部力:两个手指同时夹住一个工件,两侧的力大小相等方向相反,它们在腕部力传感器上相互抵消,而在关节力矩上也可能相互抵消。内部力是接触估计的天然盲区,这也是为什么纯本体感受的方法在夹持阶段往往只能估计「是否有接触」,难以估计「夹得多紧」。
传感器该加在哪里
秩条件给出的是一个可计算的指引:在 秩亏的方向上,补一个能直接测量该方向力的传感器。对夹持任务,最有效的位置是手指指尖的触觉阵列,因为它直接测量内部力;对推、拉、撬这类外部接触,腕部六维力传感器更有效,因为外部力不会被两侧对称抵消;对夹具内部的接触,则需要把触觉装到夹具内壁而不是手指外侧。
论文 ContactFlowFilter 讨论的传感器配置正是「关节力矩 + 基座六维力」的组合,并且明确指出这是一个有挑战的逆问题配置。它的价值不在于传感器多,而在于用算法弥补了配置的不足;如果任务允许,加一个指尖触觉就能把最难的那一部分从「不可观测」变成「可直接测量」。
标定的影响
可观性分析假设运动学与动力学参数已知。实际系统里,连杆质量、质心、摩擦、电机常数都有误差,这些误差会以系统偏差的形式进入力矩签名,被误当成接触力。工程上的做法是分层标定:先标定空载下的动力学参数(用激振轨迹),再标定接触模型的刚度与阻尼(用已知物体的按压实验),最后用回放数据校准阈值。三层标定的误差会累积,所以接触估计的置信区间必须把标定误差算进去,否则会出现「滤波器很自信但实际偏了几毫米」的情况,这正是失效模式表格里「学习模型饱和」之外的另一类系统性偏差。
小结
这一篇把分段边界从「有观测的随机变量」推进到「根本不可观测的隐状态」。结论可以压缩成六条。
第一,当接触没有可直接测量的观测时,正确的记账单位是信念状态,而不是点估计。信念状态至少包含连续运动状态、离散接触数、连续接触点与力三部分,离散量改变时状态空间的结构本身会变。
第二,一阶近似(EKF 类)在接触问题里失效的根源是三点:多模态、离散跳跃、以及观测弱时的系统性过度自信。粒子滤波能表示多模态,IMM 能显式建模离散模式,流匹配提案则能把粒子一开始就放在多模态的区域。
第三,信念记账不能只看瞬时的后验质量。证据计数(累积对数似然)是更稳的判据,它在重采样时不归零,能跨周期区分「暂时不吻合」与「根本不可能」。追加观测的判据不是固定置信阈值,而是增量判据:单帧准确率必须超过当前把握(),多帧时比较等效准确率的增量与观测成本,增量低于成本就停。
第四,规划与信念必须共享同一份样本。DESPOT 式的稀疏信念树在节点上用粒子集近似信念,如果这些粒子与接触估计的粒子是同一套,规划与执行之间的一致性就有了结构性保证;否则需要在规划周期里加一次簇匹配检查。
第五,决策分两层:执行还是探测、按当前信念行动还是多等几帧。探测动作划算当且仅当它能带来的期望代价下降超过探测成本,抬升探测的数值例子把这一点落成可算的阈值;多等几帧的判据用单帧判别准确率与等效准确率增量表达, 时才值得看下一帧,增量低于成本即停止。可观性的秩条件则指出了传感器配置的盲区:落在 零空间方向上的力,任何算法都补不回来。
第六,方法的选择由「能不能看见」决定,而不是由「哪种方法更先进」决定。视觉本体方案适合遮挡不严重的场景;纯本体感受的粒子滤波与 IMM 适合完全无触觉、接触在夹具内部或外部的场景;在有触觉但接触点不唯一时,用生成提案的滤波最稳妥。
把这一篇压缩成一句话:边界不可观测时,不再问「什么时候接触了」,而问「每个假设还缺多少证据」;账本单位从时间换成信念簇,调度从按时间分预算换成按信念求期望。
下一篇讨论这条路线往前的下一步:当假设不只来自接触事件,还来自「接触对象是谁」时,信念里装进的是「世界的哪种解释」。抓取一个外观与重量都不确定的物体,接触信号、力矩签名、视觉外观分别支持不同的物体假设,这些假设之间会彼此竞争、也会合并;任务规划必须在这个「解释信念」上做,而不是在「某个物体」上做。届时会用到对象级信念、假设树与主动信息收集,也会回到本系列第十六篇的动作空间与第(二十二)篇的多模态状态。
参考资料
- Mixture of Flow Matching and Particle Filter for Proprioception-Based Online Contact Estimation
- NoContactNoWorries: Estimating Contact through Vision and Proprioception for In-Hand Dexterous Manipulation
- DESPOT: Online POMDP Planning with Regularization
- State estimation with the Interacting Multiple Model (IMM) method
- Differentiable Interacting Multiple Model Particle Filtering
- Contact-Aided Invariant Extended Kalman Filtering for Robot State Estimation
- Proprioceptive Invariant Robot State Estimation
- Interacting Multiple Model Proprioceptive Odometry for Legged Robots
- UNIC: Learning Unified Multimodal Extrinsic Contact Estimation
- Sequential Monte Carlo Methods in Practice
- A Tutorial on Particle Filters for Online Nonlinear/Non-Gaussian Bayesian Tracking
- Planning and acting in partially observable stochastic domains
- Sequential Tests of Statistical Hypotheses
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



