


扩散模型从零讲起(十八):生成质量怎么量——FID、CLIPScore 与感知指标的失效边界
写在前面:这一篇在系列里的位置
前十七篇把扩散模型的机制从不同角度铺开:从 DDPM 的加噪去噪、DDIM 与 DPM-Solver 的采样器,到 SDE 视角、引导、潜空间、视频、音频、三维、文本条件与非吸收态离散扩散。这些工作的共同终点,是一个能把噪声变成样本的生成过程。
但生成过程做出来之后,马上会遇到一个更棘手的问题:怎么知道它做得好不好? 生成模型的评测与判别模型完全不同。分类模型的评测有唯一的正确答案,准确率是客观的;生成模型没有”标准答案”——同一段提示词可以生成无数张都说得通的图,同一句续写可以有无数种合理表达。质量、多样性、对提示词的遵循程度、人类偏好,这些维度互相拉扯,而且没有一个是直接可测的。
本系列把”评测”作为最后一块基础拼图单独讲一篇,原因不只是理论上完整。对工程师而言,扩散模型的评测直接决定了三件事:离线选型(两个模型差 0.3 个 FID,是不是真的更好)、训练决策(某个 checkpoint 是不是值得部署)、服务回退(上线后质量报警时,用什么指标判断是否退化)。这三件事如果建立在一个被误读的指标上,代价往往比多跑几遍前向大得多。
本篇覆盖:分布距离类指标(主要是 FID)的完整机制与它的数值陷阱;把”质量”和”覆盖”拆开的精确率/召回率;面向文本-图像对齐的 CLIPScore 及其被 GenEval 暴露的盲区;离散扩散与视频生成各自的评测口径问题;最后落到实践中”一次评测应该记录哪些量”。D3PM、SEDD 一类的离散扩散似然评测已经在 扩散模型从零讲起(十七):非吸收态离散扩散 里讨论过,本篇不重复。
一、为什么生成质量不能直接用”距离”量
1.1 从判别到生成:评测对象的改变
判别模型的输出是一个标签,评测就是”预测 vs 真值”的计数。生成模型的输出是一个分布(给定条件时的条件分布),我们要比较的是两个分布:真实数据分布 与模型分布 。如果能把这两个分布之间的距离精确算出来,评测问题就解决了。
现实是:
- 是高维(一张 的 RGB 图是 196608 维)且未知的,我们只有它的样本;
- 分布间的标准距离(总变差、KL 散度)在高维连续空间中无法从有限样本可靠估计——样本数随维度指数增长;
- KL 散度还要求两个分布有共同支撑,两个各占高维空间中极小流形的分布几乎互不相交,KL 会直接发散。
于是所有实用的图像生成指标走同一条路:先把高维图像映射到低维特征空间,再在这个低维分布上做比较或判断。FID 映射到 Inception 特征的均值/协方差,精确率/召回率映射到特征空间中的近邻球,CLIPScore 映射到图文共享嵌入空间。每种映射都在丢掉一些信息,而”丢掉哪些、剩下了什么”恰恰决定了指标能否回答我们想回答的问题。这是理解评测指标失效模式的根本线索。
1.2 三种”好”是不同的问题
即使抛开统计估计,扩散模型(及所有生成模型)的”好”本身就至少是三个正交维度:
- 保真度(fidelity):单个样本是否看起来像真实数据;
- 多样性/覆盖(diversity/coverage):模型是否覆盖了真实分布中足够多的模式;
- 条件遵循(faithfulness to condition):样本是否真的对应给定的提示词/条件。
任何单一标量都无法同时度量三者。FID 把 1 和 2 纠缠在一起(后面会看到它主要反映的是 1,且对 2 不敏感);CLIPScore 只度量 3 中的”全局语义对齐”一层;而”三者的取舍”本身受引导系数、采样步数、截断策略等推理配置的影响——这些配置我们在 扩散模型从零讲起(十三):引导完全拆解 中已经拆过。因此评测的第一条原则是:先问”我想评估哪个维度”,再问”哪个指标对应这个维度”,而不是”哪个指标数字低”。
二、FID:把一个无法计算的分布距离变成可计算的
2.1 指标定义
FID(Fréchet Inception Distance) 由 Heusel 等人于 2017 年在 NeurIPS 上提出(arXiv:1706.08500)。它把真实图像集合与生成图像集合分别送入一个固定的、预训练好的 Inception-v3 网络的某个中间层,取出每个样本的激活向量 ,然后把两组特征各自的分布近似为多元高斯:
FID 是这两个高斯之间的精确 Fréchet 距离(也叫 Wasserstein-2 距离):
符号含义: 是真实/生成特征向量的均值; 是它们的协方差矩阵(); 是迹; 是矩阵平方根。
为什么取高斯的假设? 因为两个高斯之间的 W2 距离有闭式解,而任意分布间没有。这个选择带来两个后果:它只需要每组的一阶与二阶矩(均值、协方差),因此在样本量足够时估计非常稳定;但它也意味着任何不体现在均值与协方差上的差异都看不见——多峰性、尾部形状、样本间的依赖结构全部被丢弃。后文的失效模式几乎都源于这一点。
为什么是 Fréchet/W2 而不是 KL? KL 在高维中两分布支撑不相交时会发散(前面说过),且 KL 不对称;W2 对两个分布的支撑不做要求,且 FID 的实测表现与人类判断在相对排序上较为一致。用 W2 而非总变差还有一层原因:总变差无法通过矩来估计。
为什么用 Inception 特征而不直接用像素? 像素空间的距离与人类感知无关——两张图整体平移 1 个像素,像素 L2 距离可能很大,但人看不出差别。Inception 网络在 ImageNet 上训练,其深层的激活被认为捕捉了”语义级”的视觉特征,从而让距离更接近感知。注意这是一个假设,而不是保障:特征提取器的训练分布与任务会影响该假设成立多少(后面 2.3 会具体看)。
2.2 实际计算:每个 FID 数字背后都有一条预处理流水线
这是 FID 最容易被忽略、也最常”背锅”的部分。Clean-FID 论文(Parmar 等,CVPR 2022,arXiv:2104.11222)系统性地指出:FID 的数值对图像预处理实现的细节高度敏感,而这些细节在各个库中并不统一。它的图 3 把 FID 计算涉及的预处理步骤全部画了出来:
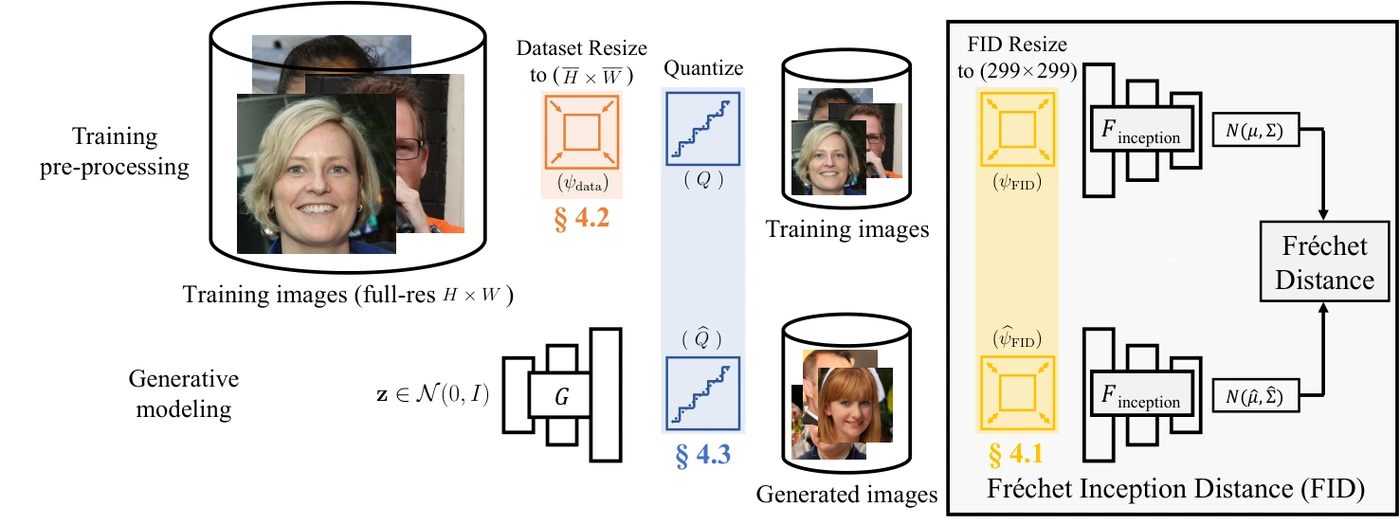
这张图需要逐条读。上方是真实图像一方:原始数据集(可能是 )在训练前会先被下采样到训练分辨率(如 ),这一步叫 ;计算 FID 时还要再缩放到 Inception 要求的 ,这叫 。下方是生成图像一方:模型以某个分辨率生成(可能与训练集不同,比如 StyleGAN2 被评估时生成 而训练集是 ),同样要先下采样再缩放到 ,这叫 。每一步的缩放都可能经过量化(8-bit 整数舍入)或压缩(JPEG)。三个重采样函数 、、 必须是同一个函数,否则真实与生成两侧会被施加不同的变换,FID 测到的就不只是模型质量,还包含了变换的不一致。
为什么”下采样”这件小事会改变 FID?原因是信号处理里的抗混叠。图像从 缩到 时比例约为 3.4 倍,高频成分如果直接抽取像素,就会混叠进低频、产生”摩尔纹”式的伪影;正确的做法是按缩放比例加宽插值核做预滤波。Clean-FID 的图 2 对比了不同库的插值核:
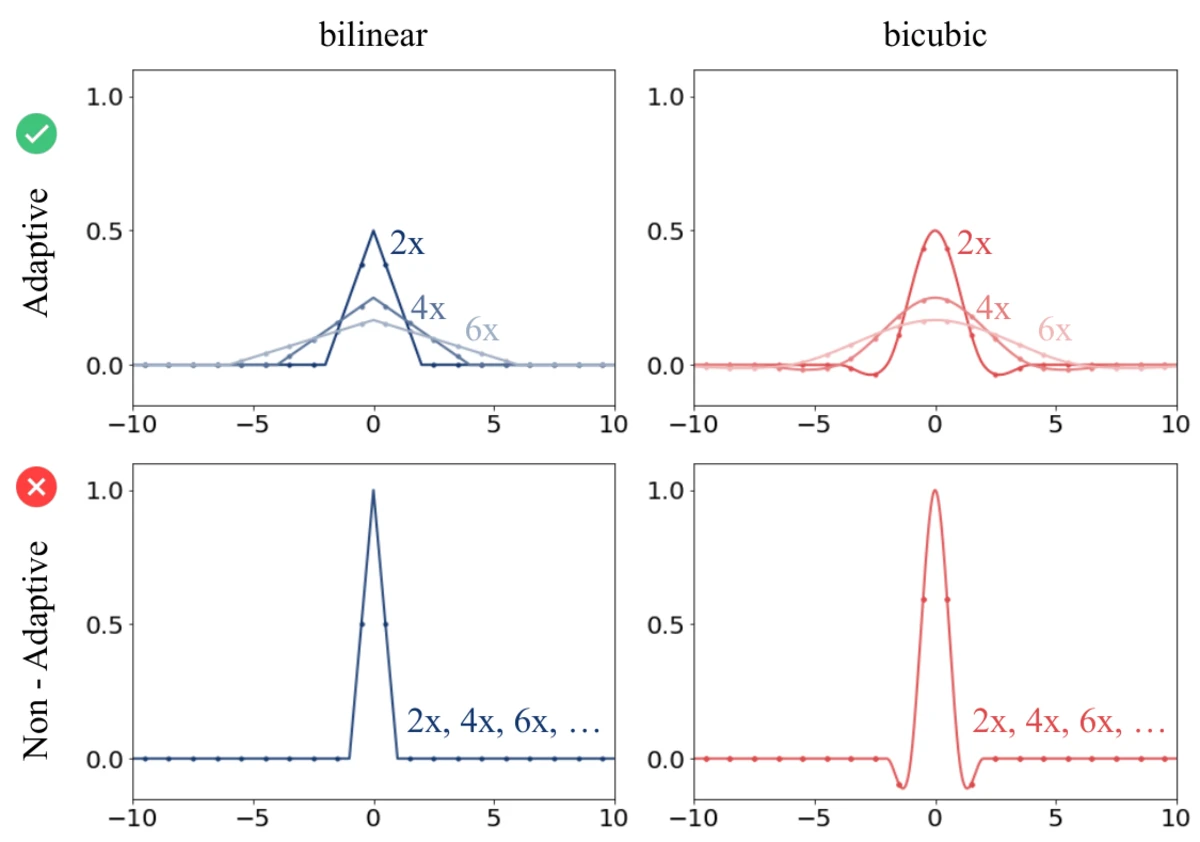
上图上半部分是 PIL 的插值核:缩得越狠(第一列),核越宽,也就越能把高频滤掉;下半部分是 PyTorch 的固定宽度双线性核,它与缩放比例无关,缩得狠时滤不干净,导致混叠。论文给出的实测是惊人的:在 FFHQ 上,把真实与生成两侧的缩放函数同时从 PIL-bicubic 换成 TensorFlow/PyTorch 的固定宽度双线性,FID 从 2.98 降到 2.75——同样的模型,仅仅换了缩放的实现,FID 就变了 0.23,而 0.23 在 2 开头的小数区已经是显著的排序变化。更反直觉的是:带混叠的”较差”缩放反而得到更低的 FID(Table 1 中 naive nearest 的得分最低),因为混叠破坏了分布中细粒度的差异,使两个高斯更”像”了。如果两个团队用不同的库算 FID,所谓”谁更好”可能只是谁用的缩放更”糊”。
Clean-FID 还给了数据集侧和压缩侧的量化结果:用不同插值核把 FFHQ 从 1024 下采样到 256 再训练同样的 StyleGAN2,FID 在 4.82 到 6.21 之间波动;用 JPEG 压缩图像,用 JPEG-75 训练时,把评估图像也做 JPEG 压缩会让 FID 从 4.00”改进”到 3.48——这里不是模型变好了,而是生成与真实的失真方式变得相像了。这说明一个更深层的问题:FID 度量的是”生成分布与真实分布在被评估时的相似度”,而不是”生成分布与真实数据本质的相似度”。任何作用于两侧的相同退化,都会让它觉得两者更像。
2.3 特征提取器带来的偏差
Inception-v3 是在 ImageNet 分类任务上训练的,其激活天然偏好”类别可判别的纹理与形状”。这带来几个后果:
- 生成域与 ImageNet 差距越大,FID 的语义可信度越低。人体、动漫、卫星图、医学影像等数据集中,“像不像”与 ImageNet 特征的距离未必同向;FFHQ 的人脸统计与 ImageNet 类别分布相差很远,这类数据上的 FID 数值之间只能内部横向比较,不能与 ImageNet 类数据集比。
- 文本渲染等细粒度能力被低估。图像中文字的清晰度对 Inception 特征几乎没有影响,所以 FID 对”能不能把文字画对”极不敏感,而后者恰恰是扩散模型的一大难点。
- 分布假设的失配。真实特征分布常常是多峰的(不同类别的图像聚成不同的簇),高斯拟合会把它压成一个椭球,两簇之间的差异被均值/协方差弱化了。这是 KID(Kernel Inception Distance)出现的原因之一:KID 不用高斯假设,用特征之间的 MMD 核距离估计,且是无偏估计,在样本量小时更稳定;代价是计算量 ,需要采样。实践中的经验是:小样本评测用 KID,大样本横向对比用 FID,两者同时看。
2.4 样本量:FID 的随机误差地板
即使是同一个模型,对样本集做不同的抽样(例如从相同的生成集合中随机抽 5 万张)也会得到略有不同的 FID,因为均值与协方差都是估计值。误差的量级与 同阶,同时与特征协方差的谱结构有关。这意味着:
- 样本量少于 1 万时,不同抽样之间的 FID 波动可以到个位数,两个模型相差 0.5 的 FID 在这种条件下毫无意义;
- 评测集的”种子”必须固定并公开,否则结果不可比较;
- 任何声称”N 倍的 FID 改进”的文章,都应给出样本量与重复实验的方差,否则无法判断改进是否超出噪声。这与 扩散模型从零讲起(八):推理加速工程 讨论的”加速倍数必须在同一评测口径下比较”是同一种纪律。
2.5 协方差与矩阵平方根:FID 为什么需要一次代价不低的矩阵运算
FID 表达式里的 是实际计算中最重的一项。先看它的数学来源。两个高斯均值的项 很直观;协方差项来自 W2 距离对”形状差异”的度量。对两个零均值高斯 与 ,可以证明它们之间的 W2 距离平方等于
这里出现的是 而不是 ,原因是 W2 距离要求”协方差矩阵乘积”可对称化—— 把两个协方差夹在中间,保证结果是对称半正定的,从而它的平方根有意义。如果协方差恰好是标量(一维时方差),这一项退化为 ,即两个标准差的差的平方,与一维 W2 距离的公式一致,这是检验上式的一个好办法。
计算上, 的协方差矩阵的平方根需要对它做特征分解,代价约 ( 时每次约十亿级浮点运算,用 GPU 上的 eigh 在一个毫秒量级内完成,用 CPU 则明显吃紧)。工程实现里的常见做法有两条:一是对两个协方差分别做特征分解,通过 与 构造对称矩阵再对角化;二是用 Cholesky 分解把问题化成两个三角矩阵的奇异值分解。一个容易写错的地方是把 错误地写成 一类的”逐项开方”形式——矩阵平方根不满足这种分配律,除非两个矩阵可交换。不同 FID 库(例如 pytorch-fid、clean-fid)的矩阵运算在数值精度、是否夹对称化、是否用 float64 上的差异,是不同库里同一模型 FID 小数位不一致的另一类原因。当两个 FID 只差 0.1 时,先检查是否用了不同实现。
2.6 特征层与池化:Inception 的哪一层
Inception-v3 的每个中间层都可以作为特征提取层,而广为人知的 FID 实现(pytorch-fid 等)通常使用最后一个 avgpool 之前的 2048 维池化特征。更换层会系统性地改变 FID 的量级和排序:浅层特征偏向纹理与边缘,深层偏向语义。因此,跨实现比较 FID 时,“取了哪一层”必须明确;论文报告 FID 时应注明”2048-d pooled features from Inception-v3”,而不是只写”FID”。这一条与 2.2 的预处理规则合起来,是 FID 复现性的两项基本前提。
2.7 何时 FID 是”够用的”
不是所有评测都需要精确率/召回率加 GenEval 的全套。当满足以下条件时,单一 FID(在同版本 clean-fid、固定样本集合下)是可以用于内部取舍的:
- 只有两个模型/两个配置在比较,且同一评测集;
- 比较的是同一主干、同一数据、同一任务(差异只在训练配方或推理配置上);
- 配合精确率/召回率看取舍方向;
- 不以 FID 做跨论文的绝对比较。
反过来说,以下场景里 FID 不应作为目标:新方法要宣称”比 Baseline 好 1.5 FID”,且双方的预处理实现不可考——这类结论在 Clean-FID 的视角下无法成立。
2.8 置信区间:一个 FID 数字应该带多大的误差棒
前面说过样本量会带来随机误差,但”误差有多大”不能凭感觉。标准做法是自助法(bootstrap):把真实集与生成集分别视为经验分布,反复有放回地重采样(例如 1000 次),每次重算 FID,取 2.5% 与 97.5% 分位数作为 95% 置信区间。两个模型的比较应当使用配对重采样——每次抽同一组真实样本、再分别抽两个模型的生成样本,得到 FID 差的分布;如果差的 95% 区间跨过 0,就不能声称”模型 A 更好”。
一个容易忽略的细节是:FID 的两个输入并不独立——真实侧的均值与协方差在两次比较中是同一组估计,误差只来自生成侧,配对可以显著降低比较的方差。很多论文只报一个点估计而不报区间,读者无法判断 0.2 的差距是否真实。把”均值 ± 标准差 + 样本量”作为报告 FID 的最低要求,比追求更多小数位有用得多。对 GenEval 这类准确率指标,论文报告其总分在随机种子间的标准差约为 0.01,这意味着小于 1 个百分点的差距同样可能只是抽样噪声。
三、精确率与召回率:把”好”拆成两个方向
3.1 问题:FID 分不清”假得漂亮”和”真得不够全”
如果模型只生成十种非常逼真的图像,FID 可能很小(均值接近真实、协方差偏小但惩罚有限);如果模型生成了大量模式但每张都粗糙,FID 也可能不小但原因完全不同。前者是多样性塌缩,后者是保真度不足——而单看 FID,既无法分辨也无法权衡。
Kynkäänniemi 等人于 2019 年在 NeurIPS 上提出把精确率/召回率推广到生成模型评测(Improved Precision and Recall Metric for Assessing Generative Models,arXiv:1904.06991)。其定义与分类中的”查准/查全”同构,把两者看成从生成分布到真实分布、从真实分布到生成分布的两个方向:
高精确率意味着生成样本整体上”看起来真实”(不会产出真实数据中不存在的怪异样本);高召回率意味着真实数据中常见的样子,模型都能生成出来(覆盖广)。
3.2 如何从有限样本估计”支持”
“支持”是理论概念,用有限样本要估计它。论文的做法是:对每个样本,在特征空间中找出它到同类样本(即真实样本只找真实近邻,生成样本只找生成近邻)的第 个近邻的距离 ,以它为半径画一个超球;一组样本的”支持”近似为这些球的并集。判定一个样本是否落在对方支持内,就是看它离对方任意一个样本的距离是否小于该样本的球半径。
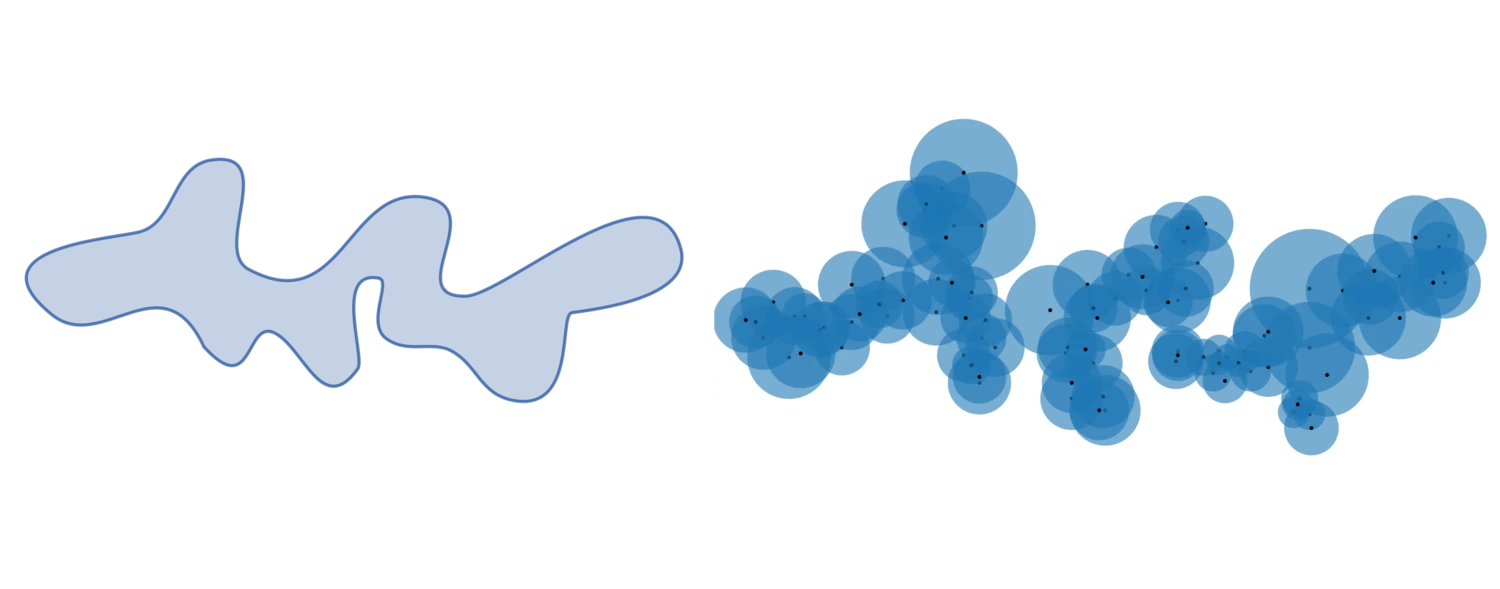
上图左是概念上的”真实流形”,右是有限样本用超球并集估计出来的近似流形:样本越密、 越小,估计越贴合局部形状;样本越稀,球越大,估计越”膨胀”。因此精确率和召回率的数值强烈依赖两个超参数:近邻数 与特征提取器(论文同时用了 Inception-v3 和 VGG-16)。论文的图 1 用三个小面板把定义画得更直观:真实分布 (蓝)与生成分布 (红)重叠时,精确率是红点落进蓝区的比例,召回率是蓝点落进红区的比例——两者都高,才是”既真又全”。
3.3 它对评测实践意味着什么
精确率/召回率最有价值的用途,是把模型的取舍暴露出来。例如:调高引导系数(CFG)会提高条件遵循但降低多样性——在精确率/召回率图上,这通常表现为精确率上升、召回率下降的曲线,而不是一个”更好”或”更差”的单点。评测时报告一对数字,能直接回答”这个配置是在拿多样性换保真度吗”。
必须注意的误区:
- 两者不可比成一个标量。加权的”F1”在分布评测里没有自然权重,报 F1 反而会掩盖取舍。
- 估计的支持对 敏感,对两个方法必须用同一个 和同一个特征提取器评估,否则比较的是不同的近似流形。
- 高召回率不等于模式全覆盖。“支持”是由有限样本构造的,真实分布中非常稀有的模式,在样本里可能根本没有出现,召回率自然无法统计到它们。它是”对给定评测集”的召回,而不是对真实分布的召回。
四、Inception Score:一个应被历史化的指标
在 FID 之前,生成图像质量的主流指标是 Inception Score(IS,Salimans 等人,2016 年,arXiv:1606.03498)。它用 Inception 模型对每张生成图像做分类,计算:
其中 是 Inception 对单张图的类别预测, 是生成集合上类别预测的平均。直觉是:单张图应当被判得”很自信”( 尖锐 → KL 大),同时整体上各类别要分布均匀( 平坦 → KL 大)。前者对应保真度,后者对应多样性。
IS 的问题在 2017 年后被 FID 的出现(以及多项后续研究)系统性地指出:
- 只依赖生成样本,完全不看真实数据。一个模型只要生成”在 Inception 眼中清楚且类别均衡”的图就能拿高分,哪怕这些图在真实数据中根本不存在。
- 与真实分布的相关性弱:在 ImageNet 类数据上表现尚可,在非 ImageNet 数据(如人脸)上基本失效,因为 Inception 的类别分布与数据分布不匹配。
- 对噪声不鲁棒:对抗性扰动可以在几乎不改变图像的情况下明显提高 IS。
- 不支持条件/可编辑生成:IS 衡量的是”整段提示词集合的类别分布”,无法评估单条提示词的遵循程度——而这恰恰是扩散模型时代最关心的能力。
结论很明确:IS 已经不适合作为现代扩散模型的横向指标。它仍偶尔出现在模型卡或论文的历史表格里,看到时应把它当作”那一代工作的历史口径”,不要与新工作直接比较。
五、文本-图像对齐:CLIPScore 与它的盲区
5.1 CLIPScore 的机制
CLIP(Radford 等,2021,arXiv:2103.00020)在大规模图文对上训练了图像编码器 与文本编码器 ,使匹配的图文对被拉近、不匹配的被推远。CLIPScore 利用这一点:把生成图像和提示词分别编码,取余弦相似度的加权形式:
其中 是生成图像, 是提示词, 是一个尺度常数(原论文取 2.5,使分布更接近 0–100)。它有几个工程上很受欢迎的特点:不需要参考图像(因此可以对任意提示词做评测),计算便宜(只需一次 CLIP 前向),而且跨数据集可比。
但 CLIPScore 度量的是全局语义相似度,不是”提示词的每个约束是否被满足”。一个提示词”红色气球在蓝色雨伞左侧”可以被一张”蓝色雨伞在红色气球左侧”的图拿到很高的 CLIPScore,因为两句话的整体语义(红色、蓝色、气球、雨伞)几乎一样。
5.2 GenEval:把”对齐”拆成可检验的子问题
GenEval(Ghosh 等,2023,arXiv:2310.11513)的思路是:不直接打分,而是用检测模型验证提示词中的每个元素。它的流程是先把提示词拆成结构化的子任务(单个物体、两个物体、计数、颜色、位置、属性绑定),生成图像后用预训练的目标检测器与分割模型识别出物体、颜色和空间关系,再逐项判定。
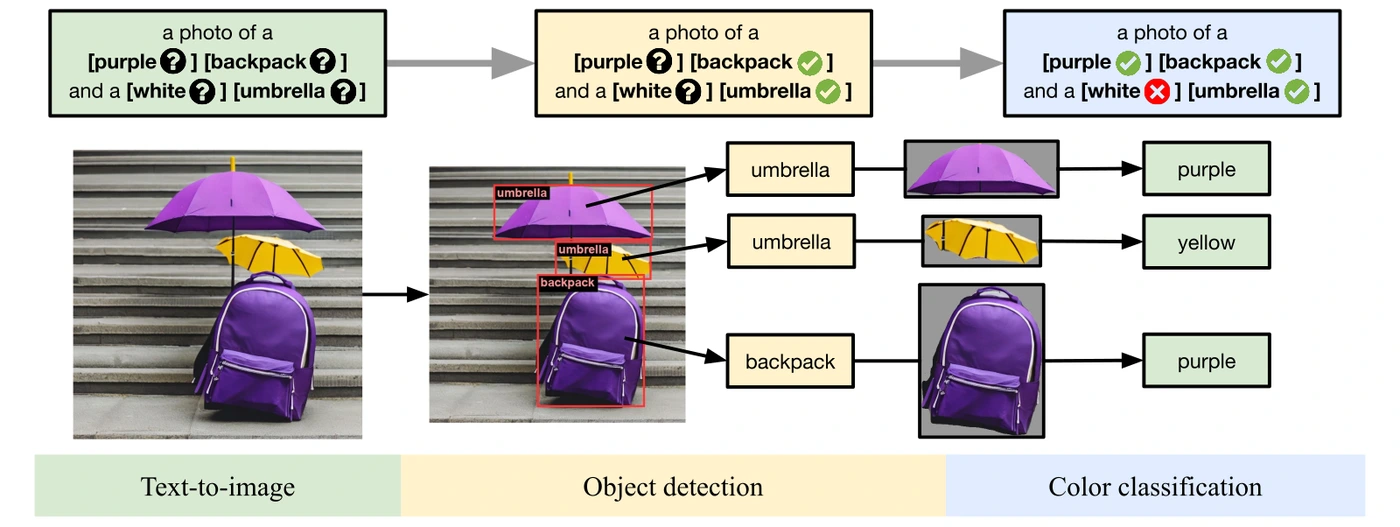
上图把流程拆得很清楚:提示词 “a photo of a [purple] [backpack] and a [white] [umbrella]” 先被结构化解析,生成的图像经过三个模块——目标检测得到框(判断物体是否存在、有两个还是只有一个)、分割与颜色分类判断框内物体的颜色、空间关系判断比较两个框的相对位置。任何一项不满足,该样本就判错;最终分数是各任务上的正确率。
GenEval 论文最关键的一张对比图,是它和 CLIPScore 在”发现问题”能力上的差异:
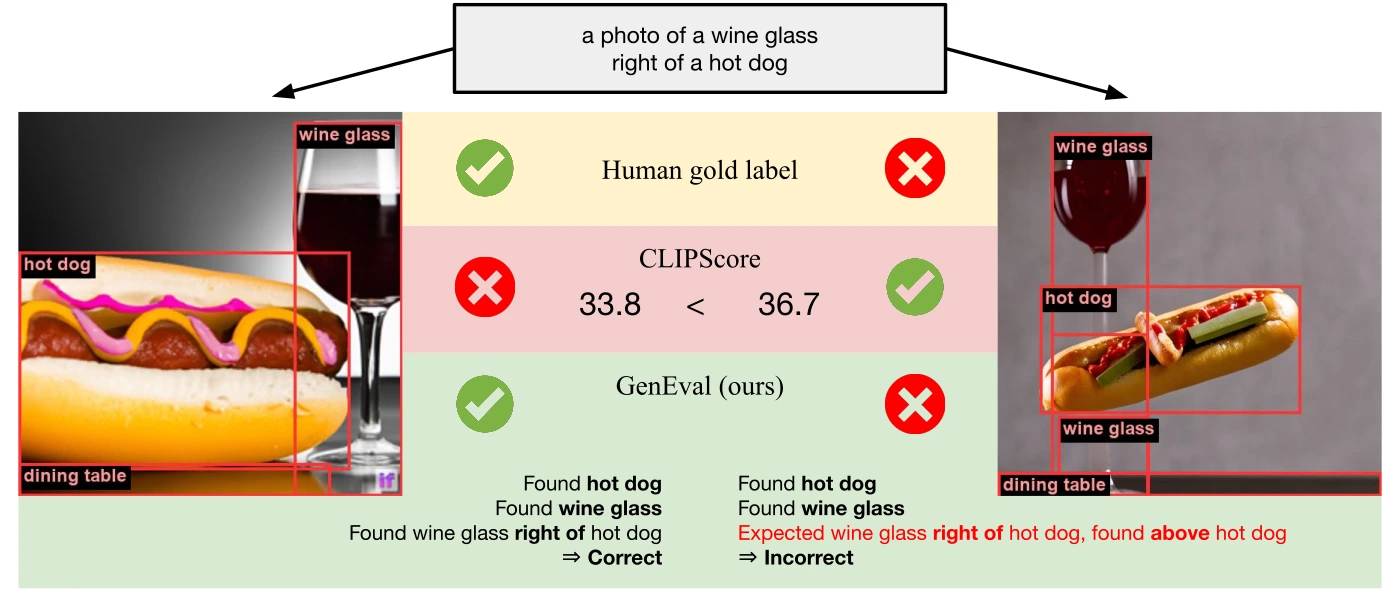
图中两张图:左边画面里有酒杯、也有餐桌,但酒杯并不在桌上;右边酒杯确实放在餐桌上。GenEval 用检测结果逐项判定,指出左边缺失”wine glass in [dining table]“,右边满足;而 CLIPScore 分别给出 33.8 与 36.7——两张图只差不到 3 分,远不足以区分”关系成立”与”关系缺失”。CLIPScore 的输出是一个无法解释来源的标量,GenEval 的输出则是一串”哪个元素正确、哪个元素错误”的验证记录,这也是后者更利于调试的原因。论文的人类研究(1200 张图、6000 条细粒度标注)给出了可直接引用的数字:GenEval 与人类标注者的整体一致率为 83%,人工标注者之间的一致率为 88%,而在标注者完全一致的子集上 GenEval 达到 91%;作为对照,CLIPScore 的整体一致率为 80%。分任务看,经过阈值调优的 CLIPScore 在”单物体”和”颜色”这类简单任务上反而略高,但 GenEval 在其余四个复杂任务上更高,计数任务上的领先达到 22 个百分点;在 Cohen’s kappa 上,CLIPScore 只在单物体与双物体任务上与人类强相关,位置、属性绑定等任务被 GenEval 反超。这说明 CLIPScore 在简单提示词上够用,在组合性提示词上失效。
值得一并记住的是 GenEval 自己也不完美。论文的图 4 列出了它的失败模式,例如:物体中空的部分被并入分割掩码,会让颜色分类误判;同类物体相互重叠时,检测器难以正确匹配”两个”的约束;检测器本身的类别与颜色词汇覆盖有限,提示词中出现它不认识的物体就直接失分。GenEval 的分数本质上是”检测器的能力 × 模型的能力”,换一套检测器,数值会变。
5.3 组合性评测的结论
把 5.1 和 5.2 放在一起,可以写出一条实用判断:
- 只关心”这张图大致是不是描述的那个主题”→ CLIPScore 足够,且便宜;
- 关心计数、空间关系、颜色绑定等组合性能力 → 必须用结构化验证(GenEval 类方法,或人工/AI 标注),CLIPScore 不能替代;
- 两者的数值不可互换,也不可直接相加成”综合分”。
5.4 学习出来的指标:从 CLIPScore 到偏好模型
CLIPScore 是”用对比学习得到的嵌入做相似度”,它没有直接学过”人更喜欢哪张图”。过去两年出现了一类新指标:直接用人类偏好数据训练一个打分器,把”评价”本身变成一个可学习的函数。
- ImageReward(Xu 等,2023,arXiv:2304.05977)构建了 13.7 万条专家比较(评分 + 排序),训练出一个通用的文生图偏好奖励模型;论文报告它在人类评测中优于已有的打分模型与指标。它的结构并不复杂:图像与文本先经过 BLIP 一类的多模态编码,再经 MLP 回归出一个标量。
- PickScore(Kirstain 等,2023,arXiv:2305.01569)从真实用户在网页应用中的选择里构建了 Pick-a-Pic 数据集,基于 CLIP 训练打分函数,论文称其在预测人类偏好上达到”超人类”水平,并在模型评测上与人类判断的相关性优于 CLIPScore。
- HPS v2(Wu 等,2023,arXiv:2306.09341)构建了 HPD v2:433760 对图像、798090 条人类偏好选择,并刻意控制提示词与图像来源的偏差;在它上面微调 CLIP 得到 HPS v2,作为评测打分器。
- VQAScore(Lin 等,2024,arXiv:2404.01291)换了一条路:不学偏好,而是用视觉问答模型计算”这张图是否展示了提示词描述的内容”的似然。它直接针对 CLIPScore 的组合性缺陷,论文明确指出 CLIP 的文本编码器会表现得像 bag of words,把 “the horse is eating the grass” 与 “the grass is eating the horse” 编码得几乎一样。
偏好模型的价值在于:它们把”人类觉得好”这个模糊目标变成了一个可批量计算的分数,且比 CLIPScore 更接近人类排序。但它们引入了新的、更隐蔽的失效模式:
- 偏好数据的选择偏差。标注者群体、提示词分布、候选图像的风格都会进入打分器。一个在 SD 系列输出上训练的偏好模型,给 Midjourney 风格或中国风插画的分数未必可靠;跨模型比较时,偏好模型可能偏向”与训练数据同源”的模型。
- 奖励黑客。一旦把偏好分数当作优化目标(例如用它做拒绝采样或微调),模型会学会提高分数的捷径——过度锐化、饱和、加装饰性细节、生成”打分器喜欢的构图”,而不是真正提升指令遵循。这与 RLHF 中的 reward hacking 是同一类问题,只不过发生在推理侧的筛选环节。
- 不可解释。CLIPScore 至少还能分解成图文嵌入的余弦;偏好模型是一个黑箱标量,无法告诉你”哪一部分扣了分”。当它和人类判断不一致时,排查成本很高。
- 组合性仍然不被保证。偏好模型评估的是整体观感,不是逐项约束;一张计数错误但画面精美的图仍可能得到高分。因此它不能替代 GenEval 类的结构化验证,两者是互补关系。
实践建议:偏好模型适合做候选排序与线上 A/B 的辅助指标,不适合做唯一验收标准;报告时要注明偏好模型的版本、训练数据来源与评测提示词集合。如果要用它做筛选,必须保留一个人工抽检通道,防止筛选器把模型的输出分布拉向打分器的偏好。
六、不同模态的评测口径
6.1 视频生成
视频在图像指标上叠加了两个新维度:时间一致性(相邻帧之间物体不闪烁、不漂移)与运动合理性(动作是否符合物理)。直接逐帧算 FID 会丢掉这两者;FVD(Fréchet Video Distance)把视频片段送入 I3D 等视频特征网络,再计算特征分布的 Fréchet 距离,是视频扩散最常用的分布级指标;它继承 FID 的全部假设(高斯、特征提取器偏差、预处理敏感性),并额外对帧间插值与裁剪方式敏感。另一类做法是”轨迹级”评测:对同一条轨迹跟踪同一物体或同一区域的稳定性做度量,再结合 VBench 一类的多维榜单。我们在 扩散模型从零讲起(五):视频扩散 与 世界模型从零讲起(六):怎么测一个世界模型 里分别从生成侧与”世界模型侧”讨论过,这里只需要记住:视频的分布指标只是起点,“帧间是否一致”必须单列。
6.2 音频
音频扩散的评测要看具体目标:语音合成的保真度常用 MCD(梅尔倒谱距离)、F0 相关性、可懂度指标(如 WER 经 ASR 回读),自然与相似度用 MOS/CMOS 人工评分;音乐与音效生成则常报告 FAD(Fréchet Audio Distance),结构与 FID 相同——用音频特征网络提取嵌入,再算高斯间距离。音频的”时间结构”同样被 FAD 丢掉,所以节奏、节拍、语音韵律的偏差需要单独的专项指标。
6.3 离散扩散 / dLLM
语言是离散的,没有”像素”也没有 Inception 特征,分布指标那一套整体不适用。dLLM 的评测退回语言模型的传统口径:似然下界(ELBO)、在标准语料上的生成困惑度、任务准确率,以及”每生成一个 token 需要多少次网络评估”这一效率指标。吸收态扩散的似然下界可以化简成掩码位置上交叉熵的加权期望,因此在 扩散模型从零讲起(二):掩码离散扩散 与第(十七)篇里它是可比较的量;均匀态扩散的似然则难以精确估计,只能报告下界。评测 dLLM 时报告”困惑度 + 评估次数”的配对,是比任何单一标量更有信息量的做法。
七、评测与推理配置的耦合:一个经常被忽略的失真源
评测扩散模型最容易犯的错误,是把评测结果当作”模型属性”。实际上大量指标的值取决于推理时的配置:
| 配置项 | 对 FID、精确率与召回率的影响 | 对条件指标的影响 |
|---|---|---|
| 采样步数 | 步数太少时样本普遍偏噪,FID 变差;步数到某个值后趋于饱和 | CLIPScore 轻微上升 |
| 引导系数 CFG | 过高时精确率上升、召回率下降(多样性塌缩) | CLIPScore 通常上升,但过饱和后下降 |
| 采样器(DDIM / DPM-Solver / SDE) | 同一模型、同一步数,分布会有可见差异 | 依赖步长与噪声调度 |
| 随机种子/随机采样 vs 确定性 | 随机采样在足够步数下更接近真实分布 | 稳定 |
| 潜空间分辨率 / VAE | 分辨率过低时细节丢失,对 FID 有系统性影响 | 与文本无关 |
| 输出量化与压缩 | 见 2.2,甚至可能”改善” FID | 轻微影响 |
因此,一篇声称”模型 A 的 FID 比 B 低”的结论,至少要同时公布上文所有配置、样本量、特征提取器版本和预处理实现(clean-fid 版本号),才能被复现和比较。没有这些信息的 FID 对比,只能当作”作者这样测了一下”,不能当作跨工作的结论。
八、一次评测应该记录什么
结合前面的分析,可以为扩散模型归纳一份最小评测清单(按用途分):
- 分布级:FID(并注明 clean-fid 版本、样本量、特征层、缩放实现)+ KID(小样本时更重要)+ 精确率/召回率(同一 与特征提取器),三者一起报,而不是只看 FID。
- 条件级:简单提示词上的 CLIPScore(标注 CLIP 模型版本与尺度);组合性提示词上的 GenEval 或同类结构化验证(标注所用检测器),并尽量给出人类/高能力模型一致性检验。
- 效率级:生成单样本的网络评估次数(NFE)、实际延迟、显存峰值。这与 扩散模型从零讲起(七):少步蒸馏 里”少步数但可能牺牲多样性”的讨论直接相关——质量指标与效率指标必须成对报告,才会暴露”用质量换步数”的真实取舍。
- 复现级:随机种子、样本集合版本、评测代码版本、生成时的完整配置表。缺了这些,任何一个数字都不具备跨团队可比性。
- 失败复读:定期抽看被指标判为”好”但没有代表性的样本。所有分布指标都对分布之外的问题不敏感,只有亲眼看过样本才能发现类别偏差、文字、手部、空间关系这类被均值与协方差吞掉的缺陷。
这套清单的背后是同一个原则:指标不是真值,是过滤器的行为摘要。FID 告诉你”在 Inception 特征的一二阶矩上,两个分布有多像”;CLIPScore 告诉你”全局语义有多近”;GenEval 告诉你”检测器能验证的元素满足了几个”。它们各自真实、各自有限。好的评测不是找一个”完美的指标”,而是知道每个指标在哪种失真下会撒谎,并用多个指标交叉覆盖彼此看不见的失效模式。
8.1 人工评测的最小协议
自动指标再完善,最终验收仍然需要人。人工评测的成本高,但协议可以标准化,至少应包含:
- 固定提示词集合:从目标任务分布中分层抽样,而不是只挑”好生成”的提示词;集合大小与抽样方法要公开。
- 固定每个提示词的样本数与随机种子,避免不同模型因采样数量不同带来的偏差。
- 成对强制选择(2AFC)优先于绝对打分:人对”哪张更好”的判别远比”打几分”稳定;允许”平局”选项,避免强迫选择引入噪声。
- 随机化左右顺序、隐藏模型身份,并对每个比较收集多名标注者,报告标注者间一致性(Cohen’s kappa 或 Krippendorff’s alpha)。
- 同时报告”偏好胜率”与”任务正确率”:前者反映观感,后者反映约束满足;两者可能背离,例如画面更美但计数错误。
- 保留失败样本的原始输出,因为指标聚合会掩盖长尾失败;审阅者需要能回看具体案例。
这套协议与 GenEval 论文的人类研究是同构的:1200 张图、6000 条细粒度标注、以 88% 的标注者间一致率作为上限参照,才能判断自动指标的 83% 一致率意味着什么。没有一致性基线的”人工评测 90% 满意”没有解释力。
8.2 指标被”优化”之后:Goodhart 效应
评测指标一旦成为优化目标,就会失效——这是 Goodhart 定律在生成模型上的具体版本。已经观察到的现象包括:
- 用 CLIPScore 做筛选或微调,模型会倾向于生成 CLIP 文本编码器容易匹配的”关键词堆叠”画面,而不是真正满足关系约束;
- 用偏好模型做拒绝采样,输出会向打分器偏好的高对比、高饱和、中心构图收缩,多样性下降;
- 在 FID 的参考集上过拟合(例如参考集与训练集重叠),FID 会异常低,但模型对新提示词的泛化没有提升;
- 通过 JPEG/缩放等预处理让两侧失真方式一致,FID 会”变好”(2.2 已给出实例)。
防御方式不是”不用指标”,而是把指标与优化目标隔离:用于优化的指标和用于验收的指标应当是不同来源、不同版本,验收集应当对优化过程不可见,并定期用新收集的提示词与人工抽检做”盲测”。这也是为什么评测一节必须放在系列最后——它约束的不是模型结构,而是整个研发流程的诚信。
九、案例:怎样读一张评测表
把前面的规则放进一个具体场景。假设有人给出如下三项对比(数值为示例,构造用来说明问题):
| 模型 | FID ↓ | 精确率 | 召回率 | CLIPScore | GenEval 总分 |
|---|---|---|---|---|---|
| A | 6.8 | 0.71 | 0.55 | 0.31 | 0.42 |
| B | 6.5 | 0.83 | 0.36 | 0.33 | 0.45 |
| C | 7.4 | 0.66 | 0.72 | 0.30 | 0.61 |
只看 FID 会选 B(6.5 最低),但把三个维度读出来完全是另一幅图:
- A 处于中间:保真度和覆盖都尚可,CLIPScore 居中,组合性中规中矩。它是”平均意义上较稳”的配置。
- B 的 FID 最低,但精确率 0.83 / 召回率 0.36 说明它收缩到了少数高质量模式——多样性塌缩的典型特征。CLIPScore 反而最高,因为样本都清晰,全局语义好判;但 GenEval 只比 A 高一点,说明它在组合性上也一般。如果只看 FID,B 会被误判为”最好的模型”。
- C 的 FID 最高,但召回率 0.72 和 GenEval 0.61 是三者中最好的——它更像是”覆盖面广、单样本质量稍差”的模型。对需要多元输出(如风格多样的素材生成)的应用,C 可能是更合适的选择;对要求每张都可直接交付的场景,B 更合适。
从这张表能读出的工程结论是:FID 最低的那个模型不一定是最适合上线的模型。上线决策应依据业务对”保真 vs 覆盖”的偏好,在精确率/召回率上选点,再结合条件指标确定是否需要更强的组合性能力。评测表如果只给 FID 一列,就无法支撑这个决策;这正是本文主张”多指标交叉报告”的直接原因。
小结
- FID 的本质是”预训练特征空间中的两步近似”:把分布压成高斯、把距离化成矩距离。这使它稳定、便宜,也让它对分布形状、多峰性、细粒度能力不可见。
- 预处理是 FID 的一部分:缩放插值、量化、压缩都会改变数值,甚至让”更糊”的处理得到”更好”的分数。同一实现的固定版本(clean-fid)是跨工作比较的前提。
- 精确率/召回率把保真度与覆盖分开,是判断”配置在拿多样性换质量”的工具;但它们是针对给定评测集的召回,对超参敏感,不能压成一个标量。
- Inception Score 只看生成侧,与现代扩散模型关心的条件能力无关,应作为历史口径看待;KID 在高斯假设失效或小样本时是 FID 的补充。
- CLIPScore 便宜且对简单提示词有效,但不能验证组合性约束;GenEval 类方法用检测器逐项验证,代价是它同时依赖检测器质量,且在复杂物体上仍有失败模式。
- 学习型指标(ImageReward、PickScore、HPS v2、VQAScore)把偏好或”内容是否出现”变成可计算分数,比 CLIPScore 更接近人类排序,但会引入标注群体偏差与奖励黑客风险,不能替代结构化验证。
- 不同模态口径不同:视频需要另加时间一致性,音频需要另加韵律与可懂度,离散扩散退回似然/困惑度与评估次数。
- 任何单点数字都要带误差棒与复现信息:自助法区间、配对比较、样本量、预处理实现缺一不可;指标一旦成为优化目标就会因 Goodhart 效应失真,验收集必须与优化集隔离。
- 评测必须与推理配置绑定报告,并用多指标交叉检查;单一数字的跨工作对比几乎总是不可信的。
- 一条方法论上的收尾:指标是在”我们关心的能力”与”能被稳定估计的量”之间做映射,任何映射都有盲区。理解盲区的位置,比记住任何具体数值都更重要。
至此,从连续扩散到离散扩散、从采样器到蒸馏、从架构、条件到评测,“扩散模型从零讲起”这条基础主线已经覆盖完整。下一篇不再沿”扩散”展开,而是转到扩散模型赖以运行的系统侧——把一张图从噪声变成图像的完整推理链路(前向次数、KV/缓存、显存与调度)如何组合成一个可服务的系统,与第(八)篇的工程视角互补。
参考资料
- GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium(FID,Heusel 等, NeurIPS 2017)
- On Aliased Resizing and Surprising Subtleties in GAN Evaluation(Clean-FID,Parmar 等, 2021)
- Clean-FID 官方代码库(GaParmar/clean-fid)
- Improved Precision and Recall Metric for Assessing Generative Models(Kynkäänniemi 等, NeurIPS 2019)
- Improved Techniques for Training GANs(Inception Score,Salimans 等, 2016)
- Learning Transferable Visual Models From Natural Language Supervision(CLIP,Radford 等, 2021)
- GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment(Ghosh 等, 2023)
- Demystifying MMD GANs(KID,Bińkowski 等, ICLR 2018)
- FVD: Towards Accurate Generative Models of Video(Unterthiner 等, 2018)
- ImageReward: Learning and Evaluating Human Preferences for Text-to-Image Generation(Xu 等, NeurIPS 2023)
- Pick-a-Pic: An Open Dataset of User Preferences for Text-to-Image Generation(Kirstain 等, NeurIPS 2023)
- Human Preference Score v2(HPS v2,Wu 等, 2023)
- Evaluating Text-to-Visual Generation with Image-to-Text Generation(VQAScore,Lin 等, 2024)
- VBench: Comprehensive Benchmark Suite for Video Generative Models(Huang 等, 2023)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



