


视频超分基础架构:EDVR 的形变对齐、BasicVSR 的双向传播与 VRT 的时间注意力
视频超分(video super-resolution,VSR)要解决的问题,比单张图像超分多了一个维度:输入是一段低分辨率、可能带噪、带压缩伪影的连续帧,输出是一段高分辨率、并且在时间上稳定的连续帧。只把每一帧单独拿去做图像超分,画面会闪烁:相邻帧的细节纹理、边缘甚至人脸的五官会在不同方向上来回跳。原因很直接——单帧模型每次看到的局部证据略有不同,重建出的是每一帧各自的最优解,而不是一段一致的视频。
多帧的价值也不止于「多了些像素」。同一场景在相邻帧中经过亚像素位移采样,天然构成对高分辨率网格的超采样;被噪声或压缩块破坏的细节,常常能在邻近帧里找到未被破坏的版本。问题在于如何把这些信息对齐到目标帧的坐标系上,并且在噪声、遮挡、大位移和重复纹理下保持可靠。
本文按三条基础技术路线拆解 VSR 的架构:以 EDVR 为代表的显式对齐后融合(可变形卷积把邻居搬到当前帧,再用注意力加权融合),以 BasicVSR 为代表的循环传播(把历史帧的信息压缩成一条隐状态逐帧向前传),以及以 VRT 为代表的时间注意力(把一段帧当作序列做 Transformer 注意力,用窗口化注意力同时完成对齐与融合)。最后回到工程视角:这些模型在真实流式场景里为什么常被改成单向、滑窗、或更轻的对齐形态,以及每一次前向的算力和显存账怎么估。
视频超分与单图超分的差别
退化模型里的时间维度
图像超分常用的退化假设是
其中 是高分辨率图像, 是模糊核, 表示 倍下采样, 是噪声。视频超分在这条链上多了两项:帧间运动和编码压缩。更接近实际视频的写法是
是第 帧的低清观测, 是对应的高清帧, 是退化算子, 是逐帧可能不同的模糊核, 表示压缩(如 H.264/H.265 的量化与块效应), 描述高清帧之间的真实运动。
真实视频中压缩伪影往往比模糊更刺眼:块边界、振铃、色带,这些是图像超分的合成退化(bicubic 下采样)很少覆盖的。图像超分一侧的应对办法是把退化链本身建模得更复杂——模糊、噪声、缩放、压缩依次叠加,并允许这些算子随机组合,Real-ESRGAN 就是沿这个方向做的,可参考 图像超分基础:从退化建模到 Real-ESRGAN。视频把这个问题又往前推了一步:同一段视频里,第 帧和第 帧的压缩块位置、运动模糊程度、噪声强度都可能不同,若模型把每帧当成独立的退化样本处理,输出的帧间差异就会变成可见的闪烁。也就是说,VSR 的退化建模不仅要回答「这一帧怎么坏的」,还要回答「相邻帧坏得不一样时,重建结果如何保持一致」。
为什么必须「对齐」
设目标帧为第 帧,邻居帧 的观测里包含了同一场景的不同采样。把这些观测融合之前,必须先把它们的像素坐标映射到第 帧的坐标系:
是像素坐标(可以是连续的,即亚像素位置), 是从 帧指向 帧的光流场。由于 通常落在像素格点之间,实际执行时进行双线性插值,这一步就叫 warping(特征/图像形变)。
对齐失败会直接污染融合结果:错位的邻居帧等于把别的纹理叠上来,比不融合更糟。VSR 文献里反复出现的难题都围绕这一点:大位移下光流估计不准;遮挡区域没有对应点;重复纹理让匹配产生歧义;压缩块效应让光流在块边界处抖动。
多帧为什么能提供单帧没有的信息
把退化模型写细一点:低清帧的每个像素是高分辨率场景经过模糊核与下采样算出来的局部平均。对第 帧的第 个低清像素有
是该像素对应的感受野区域。单帧超分要做的是从这些平均量里反解出 的分布,信息量本身不足,只能靠先验(自然图像的统计规律)补。若第 帧相对第 帧整体平移了 像素,那么 的像素对应的感受野 就与 错开半个像素,它提供的是同一片场景在另一组网格上的平均。把两帧对齐后联合起来看,相当于对同一区域做了更密的采样:
是位移的小数部分。位移越接近半像素,新增的有效采样越多;位移为整数像素时,,对齐后的信息几乎完全重叠,多帧只剩降噪价值。这解释了一个实践现象:静态场景或缓慢平移的视频,多帧收益明显;镜头完全静止、相邻帧内容几乎相同的片段,多帧网络与单帧网络的差距会缩小。
时间一致性如何度量
PSNR 只看逐帧的像素误差,对一致性几乎不敏感。衡量闪烁的常用指标是 warping error(tOF):先用光流把第 帧的高清真值与第 帧对齐,再计算对齐后的误差
为重建结果, 为下一帧真值。若模型各帧重建互相不一致,即使每帧 PSNR 都不低,warping error 也会明显偏高。感知质量研究里也常用 LPIPS(在深度特征比较)、NIQE(无参考自然度)等指标观察过度平滑与伪影。
这里有一个常被忽略的评测口径问题:大部分 VSR 论文的 PSNR 在 Y 通道上算,而 REDS4 等数据集上按 RGB 三通道算,不同论文的数字不能直接横比。运行时间也有类似陷阱:不少论文的毫秒数是在 的低清输入上测的,放到 时特征图面积增大 9 倍,卷积与注意力部分的耗时都要按面积放大,只有光流这类在固定低分辨率上跑的模块不会同比例增长。这两个口径差异,是很多「论文很轻、部署很慢」误判的来源。
上采样与重建算子
超分的最后一步是把特征图放大 倍。常见三种做法,差别不只在插值质量,还在它如何与前面的亚像素对齐配合:
- 转置卷积:先在最邻近位置插入零,再做卷积。实现简单,但当步长与卷积核尺寸不整除时,输出网格上会出现周期性强度不均,即棋盘格伪影(checkerboard)。在视频上这种伪影尤其糟:它固定在像素网格上,不随物体运动,观众会看到一层不动的纹理叠在画面上。
- PixelShuffle(亚像素卷积):先做一次普通卷积把通道数从 扩到 ,再按空间重排成 。整个过程没有零填充,棋盘格问题基本消失,而且重排是纯访存操作,没有额外乘加。BasicVSR 选择它,正是为了在简单结构里不引入重建伪影。
- Laplacian 金字塔重建(LAP):逐级放大,每级输出一个残差并加到下一级的上采样结果上。它在多个尺度上分别建模结构与细节,代价是额外的卷积与多级计算。EDVR 的重建主干是一串残差块加末端上采样,结构本身不复杂,正是 BasicVSR 论文批评的「零件堆得多、每个零件不一定必要」的典型;理解 LAP 是为了看清这个设计空间里还存在哪些重建方式。
三种算子对推理成本的影响远小于对齐与传播模块,但对观感的影响不小:一个固定纹理的棋盘格在静止画面里可以接受,在视频里会被运动对比出来,变成时间上不一致的伪影。
数据与评测口径
VSR 的数字离不开两组评测条件,离开这两组条件谈「谁更好」没有意义。
退化类型。基准里最常用两种合成退化:bicubic(BI)——低清帧由高清帧 bicubic 下采样得到;blur-down(BD)——先高斯模糊再下采样。多数表格同时给出 BI 和 BD 两列,同一模型在 BD 下通常略低,因为模糊核更偏离模型的隐含先验。真实退化(真实视频的压缩与采集)往往介于两者之间又不完全匹配,这也是 real-world VSR 单成一条线的原因。
数据集。REDS4 是 REDS 训练集中四个片段的固定测试子集,分辨率与内容都比较单一,被广泛用作比较基准;Vimeo-90K-T 是经典的高质量短片集合;Vid4 只有四个片段,但被沿用了很多年,适合看趋势而不适合做精细排名;UDM10 包含更多复杂运动与遮挡。数据集的规模与难度差异,决定了同一个模型在不同表格里的相对位置能变多少——原文里同一个 EDVR 在 Vid4 上只有 27.35 dB、在 UDM10 上能到 39.89 dB,差别来自数据本身而不是模型。
三条基础路线的共同骨架
几乎所有 VSR 网络都可以拆成四段功能块,这个拆法是 BasicVSR 论文提出的:
- 传播(Propagation):特征如何在时间上传递。滑窗只看局部若干帧,循环网络维护隐状态,Transformer 把一段帧当作序列。
- 对齐(Alignment):邻居信息如何映射到当前帧角度。显式光流 warp、可变形卷积、注意力本身都可以承担这个角色。
- 聚合(Aggregation):对齐后的多份特征如何合成。拼接、注意力加权、加性融合。
- 上采样(Upsampling):聚合特征如何变成高清图像。PixelShuffle、转置卷积、Laplacian 金字塔重建。
把网络拆成这四块后,三种主流架构的差别就很清楚了:滑窗网络(EDVR)对齐是显式且每次请求都重做,聚合依赖注意力;循环网络(BasicVSR)对齐仍是显式,但聚合被压成一条隐状态,计算从「一段帧一次」变成「逐帧」;Transformer 路线(VRT)把对齐与聚合都放进注意力里,代价是窗口内注意力的平方级计算与随帧数增长的显存。
路线一:显式对齐后融合
滑窗框架与早期光流方法
滑窗框架把一段固定长度的窗口(例如 帧)作为一次前向输入,输出其中一帧或整段的高清结果。VESPCN 用运动补偿把相邻低清帧 warp 到中心帧上,再把堆叠的帧送进一个卷积网络;TOFlow 则使用针对视频增强任务训练、专门优化过的光流模型(task-oriented flow),比通用光流更稳。这两条路线奠定了「先对齐、再融合」的范式,但它们的对齐都是图像级的 warp:插值发生在 倍下采样后的低清图像上,很多亚像素信息在下采样时已经丢失,warp 后留下的空洞也要靠额外网络补。
光流 warp 的局限
显式 warp 有三个结构性弱点:
- 精度被流场误差限制。经典光流在无纹理区域、重复纹理、遮挡边界处误差大,而 VSR 恰恰需要这些区域的亚像素精度。
- 只支持单一刚性映射。整块区域只能按一条全局映射搬移,无法为不同位置学习不同的局部调整。
- 参数固定。光流网络一旦训练完,warp 方式就固定了,下游网络无法根据复原目标微调对齐行为。
可变形卷积(deformable convolution,DCN)提供了一个更灵活的对齐算子:每个卷积采样点都带一个可学习偏移。记标准 3×3 卷积的采样网格偏移为 ,DCN 把它扩展为
是采样点数(通常 9), 是固定的网格位置, 是由另一个小卷积从输入特征预测出来的偏移量, 是可学习权重。偏移是连续值,采样点落在格点之间时用双线性插值。这样对齐就不再是「搬一整个块」,而是逐位置、可学习地挑选邻居的位置。相比光流 warp,DCN 的偏移由特征预测、随任务端到端训练,可以直接优化复原误差,而不必先拟合一个视觉上正确的光流。
DCN 的代价是它要预测 个偏移通道,训练初期容易陷入局部最优;偏移的预测质量本身也依赖特征质量,所以 EDVR 选择了「多级级联」的方式来保证鲁棒性。
在 GPU 上,DCN 的效率也远不如普通卷积。可变形卷积的每个采样点位置都随输入变化,输出网格上的每个位置都要先做「偏移 → 双线性插值四邻域」的访存,再乘权重累加。这组映射关系在编译期无法预先成批算好,主流实现(如基于 im2col 的 CUDA kernel)需要先把偏移落到 im2col 布局,或者逐个采样点做 gather,访存模式不规则、容易 split-k 过细导致算力利用率低。因此在吞吐敏感的服务里,DCN 对齐常常成为比卷积主干更贵的一段——这也间接影响了后来的设计取向:能用光流 warp 加普通卷积解决的,就尽量不用 DCN。
EDVR:金字塔、级联、可变形(PCD)
EDVR 是为 NTIRE 2019 视频复原与增强挑战赛提出的统一框架,参赛的四个赛道分别是视频超分(clean/blur)与视频去模糊(clean/compression)。它的结构和问题一一对应:大位移 → 金字塔多尺度对齐;融合不均 → 时空注意力。
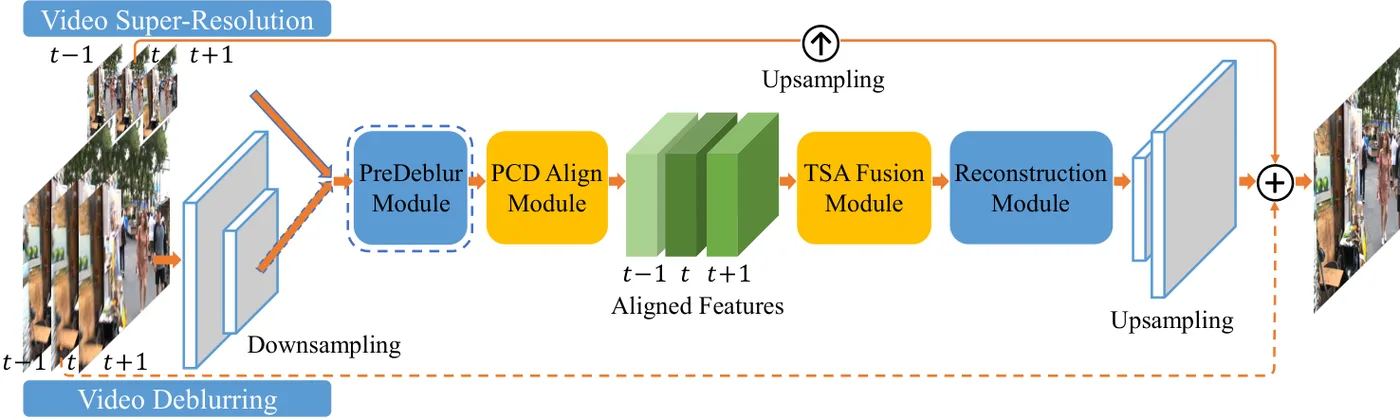
上图是 EDVR 的总框图(原文 Figure 2)。左侧 、、 参考帧先经过特征提取得到特征 ;PCD 对齐模块把邻居帧特征按金字塔方式对齐到参考帧;TSA 模块对对齐后的特征做时空注意力融合;最后重建模块上采样输出高清帧。多帧输入、预对齐、融合、重建这几步与滑窗框架一致,差别都在 PCD 与 TSA 的内部实现。
PCD 对齐:由粗到细的三级级联
PCD 模块(Pyramid, Cascading, Deformable)做三件事:
- 金字塔:特征 被逐级下采样成 级金字塔,每级分辨率减半。对齐从最低分辨率开始:那里同一物理位移对应的像素数小,大位移在数值上更容易估计;粗层的偏移与对齐特征再传给细层。
- 级联可变形:每一级用「当前层特征 + 上采样后的上一层偏移」共同预测本级偏移,再做可变形卷积得到对齐特征;本级对齐特征还会与上采样后的粗层对齐特征融合。这样粗层的对齐结果不是只以上下文的形式参与,而是作为一版可用的特征直接进入细层。
- 细化卷积:金字塔对齐结束后,再级联一个 refinement DConv,用最终偏移对对齐特征做一次修正,补掉级联过程中残留的偏差。
这三步可以写成两个递推式。设第 级特征分辨率为第 级的两倍,偏移从粗层向细层传递时,先上采样再与当前层特征拼接,由一个小卷积预测当前层的偏移:
是邻居帧特征, 是参考帧特征, 表示 2 倍双线性上采样, 是若干卷积层。注意这里不是把粗层偏移直接当成初值,而是把「上采样后的偏移 + 当前层特征」一起送进网络——网络可以据此判断粗层估计在哪些位置可信、哪些位置需要改写。位移以像素为单位,分辨率翻倍后同一物理位移对应两倍像素数,所以上采样时必须同步放大数值;若忘了这一步,细层学到的偏移会系统性地偏小。
对齐结果同样逐级级联:
是第 级的对齐特征, 用当前层偏移做可变形卷积, 负责把「本级对齐结果」与「粗层上采样后的对齐结果」融合。这一步是 PCD 与普通金字塔对齐的关键差别:粗层的对齐不是只贡献偏移,还贡献了一版已经对齐的特征,细层不必从零重建。最后,在金字塔对齐之后 EDVR 再级联一个 refinement DConv,用最终偏移做一次修正。
由此也能看出级联的计算量:三级金字塔每级都要做对齐 DConv,再加若干细化 DConv;原文的简化版在消融里用「4 个 DConv、无金字塔」做对照,仅这一项就已经比 1 个 DConv 多出约 0.2 dB。与完整 PCD 的差距则到 0.4 dB 以上,说明多级传递的信息不只是「更深的网络」——粗层对齐结果被显式喂回细层,等效于给细层提供了一组已经稳定的对应关系,细层只需修正残差。
另外要说明一点:PCD 的偏移是在特征空间预测的。邻居帧特征 与参考帧特征 已分别经过特征提取,偏移网络看到的是「特征间的对应关系」,而不是原始像素间的对应关系。好处是特征层包含语义上下文,能帮助区分遮挡与真实位移;坏处是偏移的可解释性下降——它不再等于光流,只是「让后续融合效果最好」的一组采样位置。
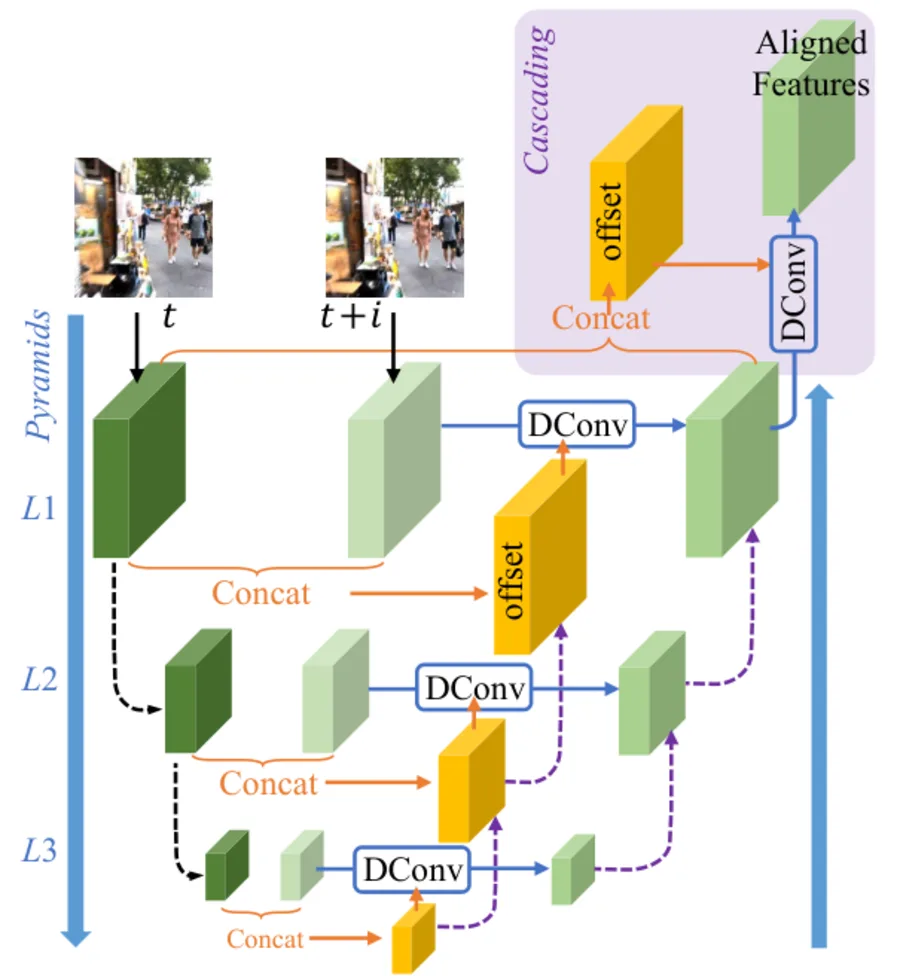
上图是 PCD 模块(原文 Figure 3)。图中 L1、L2、L3 对应三层金字塔级,层间的 Concat 把偏移、当前层特征与上采样特征拼接起来,虚线框标出的是级联的对齐/细化部分。这种设计的核心思想是把「对齐精度」放进多尺度里去解决:粗层负责大位移和结构级对齐,细层只负责残差和细节级微调,避免让单层 DCN 一次性承担从几十像素位移到亚像素细节的全部工作量。
TSA 融合:时空注意力
对齐后的特征 共有多个,如何合成?简单拼接或相加会让所有帧等权,但实际中不同区域的帧质量差异很大:流动量小、与参考帧更对齐的区域应该贡献更多。
TSA(Temporal-Spatial Attention)模块把融合拆成时间注意力和空间注意力两级:
- 时间注意力:用卷积把多帧特征在通道维上聚合,经 sigmoid 得到逐帧、逐通道的权重,相当于对「哪些帧的这组特征更可信」做加权。
- 空间注意力:对融合后的特征做一次卷积式注意力,按空间位置生成权重图,进一步重组信息。TSA 的整体输出还会与输入特征相加,得到类似
TSA_out = F_fusion + F_aligned的融合结构。
(下图原文 Figure 4 展示了 TSA 的模块结构:时间注意力对邻居帧特征加权求和后与参考特征相加,空间注意力生成一张与特征同尺寸的权重图。)
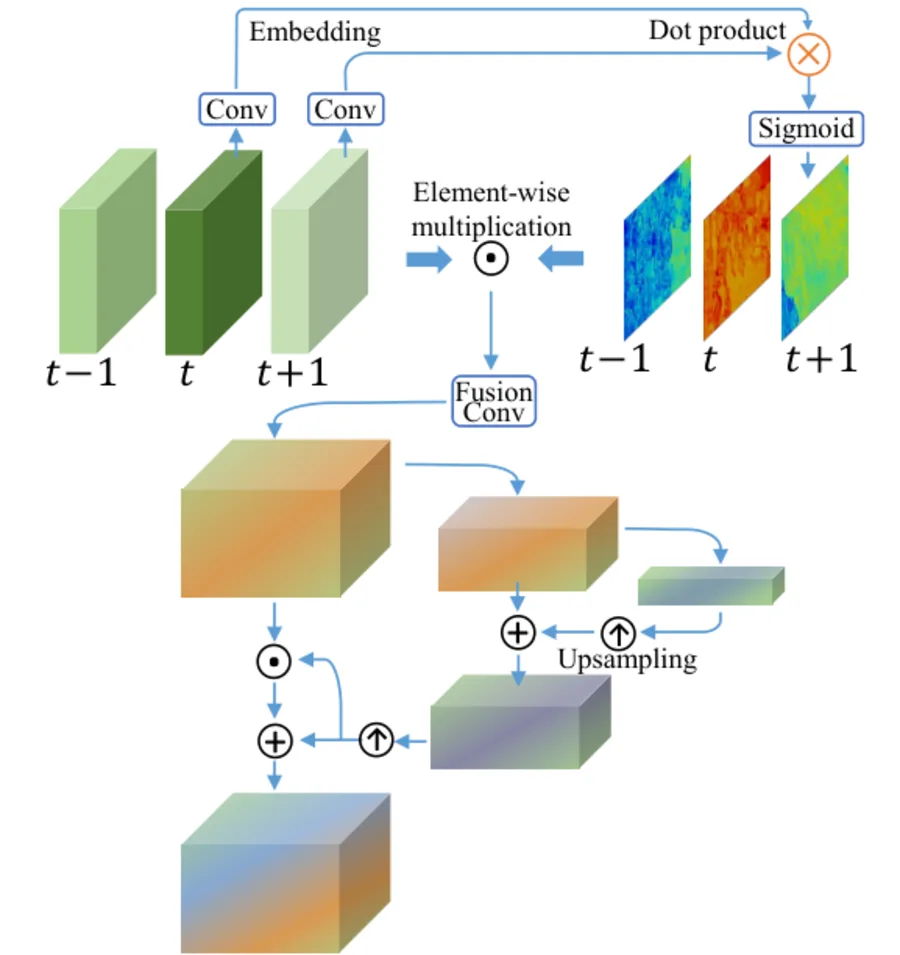
TSA 的两个注意力都可以写成「权重 × 特征」的形式。时间注意力先在通道维聚合邻居帧信息,再对每帧每个通道给一个权重:
是 sigmoid, 是逐元素乘, 与特征同形状(逐通道、逐位置)。空间注意力则在同一帧内部做一次卷积,得到一个空间权重图:
时间注意力回答「哪一帧的这组特征更可信」,空间注意力回答「帧内哪些位置更重要」。两个权重都来自卷积而不是全连接,因此在任意分辨率上都能用,不需要固定输入尺寸——这一点在部署时很重要,服务端可以直接按实际分辨率分块推理,而不必像某些 Transformer 结构那样依赖固定窗口。
原文表 1 的四档消融把 PCD 与 TSA 的贡献拆得很清楚:无 PCD、无 TSA 是 29.78 dB;用 4 个 DConv 但无金字塔是 29.98 dB;完整 PCD、无 TSA 是 30.39 dB;再加 TSA 是 30.53 dB。对齐模块(PCD)带来约 0.61 dB,融合模块(TSA)只带来约 0.14 dB。这意味着「对齐」本身比「融合」带来的增益大得多,也解释了为什么后续工作大多把精力放在改进对齐与传播方式上,而不是简单地堆叠融合模块。
两阶段重建
EDVR 的「两阶段」不是指重建头内部的金字塔,而是两个完整网络的串联:第一阶段的 EDVR 先输出一版粗复原结果,第二阶段的浅层 EDVR 再以这份结果为基础做 refinement。原文报告的两阶段收益约 0.5 dB PSNR;更关键的是它的第二个动机——第一阶段的输出帧彼此已经比较一致,第二阶段在不改变帧间关系的条件下补细节,从而缓解输出序列的不一致。
理解这个设计的要点在于:严重的运动模糊会同时破坏对齐与融合,第一阶段即使无法完全去模糊,也能给第二阶段提供「更好对齐的输入」。所以它不是简单地「把网络堆深」,而是用一次粗复原把问题的难度降下来,再把省下来的对齐误差预算花在细节上。对推理系统来说,两阶段意味着单帧的算力近似翻倍,这也是它在比赛里可用、在流媒体里通常不划算的原因。
此外,EDVR 的输出采用的是残差式重建:上采样后的直接插值图像加上网络预测的残差,而不是让网络从零生成高清图。这一步在视频里很实用——直接插值部分天然在帧间一致,网络只需要学「缺掉的高频到哪里去」,输出的时间稳定性比从零生成更好。
EDVR 的成本结构
EDVR 的算力主要集中在 PCD 的多级 DConv、TSA 融合与 40 个残差块的重建主干上。原文表 1 在 的高清尺寸下给出了消融:完整 PCD + TSA 是 30.53 dB / 936.5 GFLOPs,去掉 PCD 与 TSA 的基线是 29.78 dB / 640.2 GFLOPs。也就是说,多花的约 46% 算力换来了 0.75 dB。这个交换比例在离线修复任务里很划算,在实时系统里则必须先问「每帧的预算允许多少 GFLOPs」。
更要命的是滑窗结构的重复计算:若对每一帧都用自己前后各 2 帧做一次完整推理,相邻窗口重叠 4 帧,同一帧会被重复对齐、重复融合四五次。工程上的标准做法是缓存每个窗口的对齐结果与融合前的中间特征,滑窗前移时只补算新进入的帧;但 TSA 的权重与融合仍要按窗口重算,因为参考帧变了。这就是滑窗与循环传播的根本差别:滑窗的「历史」是显存里的特征缓存,循环的「历史」是网络状态本身。
路线二:循环传播
从窗口到隐状态
循环网络的做法是维护一个隐状态 ,逐帧更新
是传播模块(通常包含对齐 + 卷积 + 残差), 是当前帧特征, 是上采样头。这样每帧只前向一次,所有历史帧信息被「压缩」进了一条特征张量中。代价是历史信息会在传播过程中被不断稀释,早期帧的贡献逐帧衰减,形成长距离信息丢失——这正是 BasicVSR 论文分析的核心问题。
BasicVSR:四个组件的最小可行组合
BasicVSR 论文的贡献在于「去繁就简」:它用几乎现成的模块搭出一条极简管线,并在 REDS4、Vimeo-90K-T、UDM10、Vid4 等数据集上超过当时更复杂的滑窗与循环方法,同时推理速度更快。具体到四个功能:
- 传播:双向传播。前向传一遍得到 ,后向传一遍得到 ,拼接后再上采样。实验显示双向相比单向对早期帧的收益更大,因为后向传播能把序列末尾的信息带到早期帧。
- 对齐:使用预训练的 SPyNet 估计光流,做 feature-level 的 warp。SPyNet 本身是一个空间金字塔光流网络:在低分辨率层估计粗光流,逐级上采样到高分辨率层再 refine 残差,参数量只有约 1.4M;光流在低清帧上估计,也意味着它的计算与输入面积成正比,而不是与输出面积成正比。BasicVSR 不在网络上做复杂改动,而是复用一个轻量光流网络。
- 聚合:对齐特征与隐状态拼接后过卷积残差块,没有额外的注意力融合模块。
- 上采样:PixelShuffle,不堆叠复杂的多尺度重建。
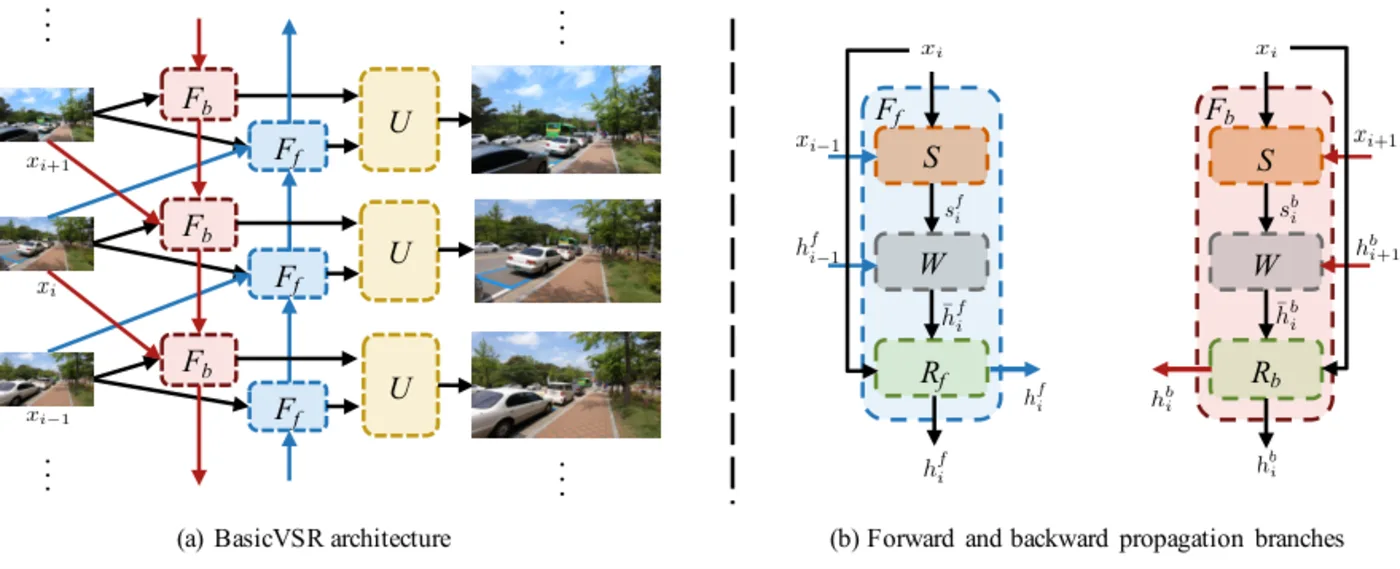
上图是 BasicVSR 总览(原文 Figure 2)。中间是主干 F,上下两条是前向(forward)与后向(backward)传播链;每步都先把邻居帧特征 warp 到当前帧角度,与隐状态拼接后送入残差块。注意前向与后向两条链是独立的,只在最终输出处拼接。
这个结构之所以简单且有效,很大程度上来自双向传播:单向前向传播时,第 帧只能看到 的信息;后向补上之后,每帧都能利用整段序列两端的信息。论文里的 segment 实验也说明,若把序列切成 段独立处理以降低内存, 越大 PSNR 越差——因为传播链被打断,长距离信息无法到达。
BasicVSR 的传播为什么能工作
传播模块本质上是一个以隐状态为输入的残差卷积块:
表示对齐(warp), 用若干残差块实现。两点决定了它能稳定传播:
- 对齐在特征域完成,且每次只对齐相邻帧。相邻帧之间的光流通常比远处的帧更容易估计,误差不会被累积放大。
- 残差结构让传播主要承载「增量」信息。隐状态 直接跳过卷积,避免每步都要从零重建全部历史内容。
BasicVSR 的一个结构性弱点是每条链路只从相邻一帧接收信息:隐状态里的误差会沿链单调累积,光流 warp 在遮挡处仍会产生空洞。这两点由 BasicVSR++ 专门处理,下一节展开。这里的结论是:循环框架的瓶颈不在传播带宽,而在「信息沿链的传递方式」——同一个隐状态结构,换一种接法就能额外拿到可观的质量。
IconVSR:关键帧与信息补充
IconVSR 是 BasicVSR 的扩展,解决两个问题:传播链过长导致的信息衰减、以及传播带来的伪影累积。它增加两个机制:
- 信息补充(information-refill):每 帧选一帧作为关键帧(实验中 ),用额外的特征提取器为关键帧提取特征,再把这些特征注入传播链的对应位置做 refinement。关键帧只有 1/K 的帧需要额外计算,所以开销可以接受。
- 耦合传播(coupled propagation):两条传播链在估计光流时互相利用对方分支的特征,并把耦合后的信息注入各自的传播模块,缓解单向链对早期或晚期帧覆盖不足的问题。
原文实验显示这两项合计带来最多约 0.31 dB 的提升(31.42→31.67 dB on REDS4)。图 10 还给出了关键帧数量的取舍:关键帧越多、PSNR 越高,但额外计算越多——这条曲线本身就是「效果与成本」的直接映射,也再次说明循环框架的精度上限与信息传递效率强相关。
BasicVSR++:二阶传播与光流引导的形变对齐
BasicVSR++ 把 BasicVSR 的两处设计改掉,仍保持循环框架与相近参数量:
二阶网格传播(second-order grid propagation)。原来的每一步只从前一步的隐状态接收信息:
改成同时接收前两步的隐状态,并把「网格」理解为前向、后向两条链在时空上的交错:
多出的 让信息有两条路径到达同一帧,一条经过 、一条跳过 直接来自更早的帧。这样做并没有把感受野简单地拉长,而是给传播网络提供了「跨步」的捷径:当 帧本身退化严重、隐状态被污染时, 的信息还能绕开它。论文将其描述为把「单向链」变成「网格」,本质上是在时间轴上做残差连接。
光流引导的可变形对齐(flow-guided deformable alignment)。先用 SPyNet 得到光流,把邻居特征 warp 到当前帧,再用可变形卷积在 warp 结果上学习残差偏移;同时把光流上采样后作为 DCN 的初始偏移。这样 DCN 不必从零预测位移,只需要修正光流的误差,训练稳定性与遮挡处的鲁棒性都更好。这实际上是把 EDVR 的「DCN 对齐」与 BasicVSR 的「光流 warp」合并:光流给粗对齐,DCN 给残差。
效果上,BasicVSR++ 在参数量相近的情况下比 BasicVSR 高约 0.82 dB PSNR,并在 NTIRE 2021 的视频超分与压缩视频增强赛道上拿到多个冠军。它的意义不只是分数:它证明了循环框架的两个瓶颈——传播链的误差累积、对齐算子的表达力——都可以在不改变整体结构的前提下单独改进,这对部署很关键,因为可以只替换其中一段而保持服务接口不变。
对齐误差为什么会在传播链上累积
循环框架一旦用于长视频,最需要关心的问题不是「如何对齐」,而是「对齐误差会怎样被传播」。在 里, 来自 到 的对齐,而 又携带了更早的对齐误差。把误差记为 ,若传播环节近似线性,有
是传播环节对隐状态的雅可比, 是本帧对齐引入的新误差。若 的谱半径小于 1,误差会衰减,这是残差结构带来的好处;若接近 1,误差会长时间累积,表现为长视频中的累积伪影(细节被逐渐抹平或在错误位置反复叠加)。BasicVSR++ 的二阶传播相当于把 与 同时引入,并让 的路径提供一条「绕过被污染隐状态」的通道;IconVSR 的关键帧补充则相当于周期性地用干净特征把累积误差「重置」一次。这两种做法都说明:循环 VSR 的长期质量,本质上是一个误差传播稳定性问题,而不是单帧复原精度问题。
双向传播的因果性问题
BasicVSR 的双向传播在离线处理(整段视频可一次读入)时是优势,在直播、实时通话这类流式场景里却是硬约束:第 帧输出必须依赖未来的第 帧,那就不可能只延迟 1 帧输出。
把它改成流式,有两条路:
- 单向循环:只保留前向链。隐状态里只有过去的帧,第 帧可以在第 帧到达后立刻输出。代价是早期帧只能依赖更早的帧,靠近序列开头的几帧没有足够的邻居信息,画质通常明显偏弱——这就是 BasicVSR 实验里单向传播对早期帧收益大的反面。
- 滑窗:保留前后对称的邻域,但引入固定的 帧延迟。好处是第 帧用到的邻居都是「已经到达的 帧」,延迟是确定的 帧采集时间;坏处是每帧都要重新做一次窗口内的对齐与融合,计算量是单向循环的数倍。
工程上常见的折中是单向传播 + 小窗口交叉检查:主干用单向循环保证延迟可控,再在关键帧上用滑窗特征做一次补救(类似 IconVSR 的关键帧补充,但只用于一致性校验而非重建主干)。很多实际部署也直接采用「滑窗 + 轻对齐」而不是论文里 PSNR 最优的双向循环模型——后者在离线视频修复里仍是首选,在实时链路上则往往只取其对齐与传播模块的单向版本。
路线三:时间注意力
从滑窗到 Transformer:VRT 的问题设定
滑窗与循环都以局部对齐作为核心,两者的共同假设是「用显式对应关系把邻居帧搬到当前帧」。VRT 的出发点是:这一步本身的表达能力受限,尤其当遮挡与重复纹理让对应关系不确定时,显式 warp 只能给出一个近似答案。与其先估对应再融合,不如让网络在同一组注意力权重里同时学习「对应在哪」与「哪里的信息可信」,让对齐和融合合并成一次操作。
VRT 的结构
VRT 把视频复原改成「对一段帧做 Transformer」的形式,每一层包含两类模块:
- 时间互自注意力(temporal mutual self attention,TMSA):在相邻两帧之间做互注意力,用来在注意力计算里同时完成运动估计、特征对齐与特征融合;在同一帧内部做自注意力,用来做特征提取。
- 并行形变(parallel warping):在每个尺度末尾,把邻居帧特征并行 warp 后融合进当前帧特征,作为注意力融合之外的补充通路。
互注意力的形式可以写成
来自当前帧,、 来自邻居帧, 是位置偏置, 是通道维度。传统做法先估光流再 warp;互注意力让当前帧的每个 token 直接「查询」邻居帧的所有 token,把对齐变成注意力权重的一部分,不需要显式 warp。
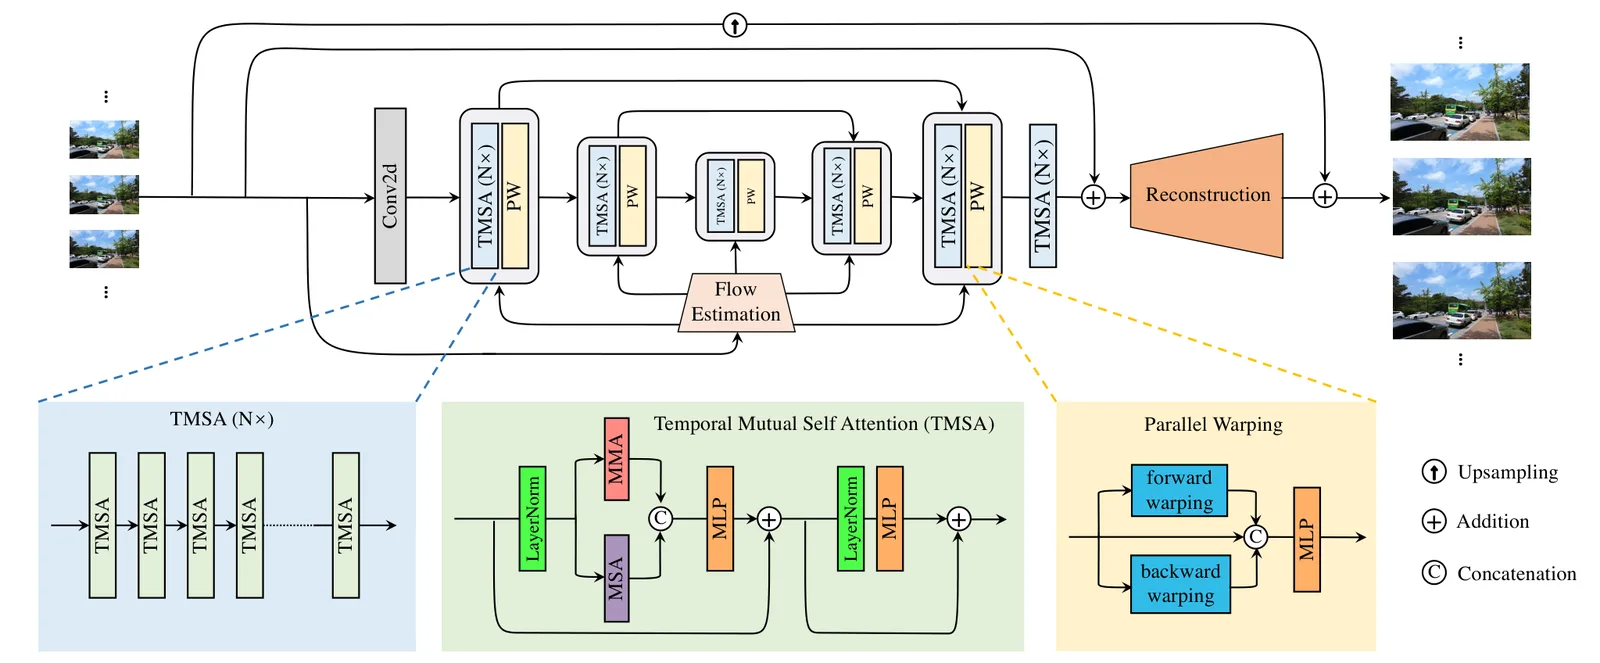
上图是 VRT 的总体框架(原文 Figure 2)。序列被分成多个 clip,每个尺度由若干 TMSA 模块加并行形变组成;每隔一层,clip 切分的位置偏移半个窗口,让跨 clip 的信息在相邻层间流动。这种「滑动窗口式的注意力」在自然语言长序列与视频 Transformer 里都很常见:窗口内注意力负责精细建模,窗口交错负责长距离信息。
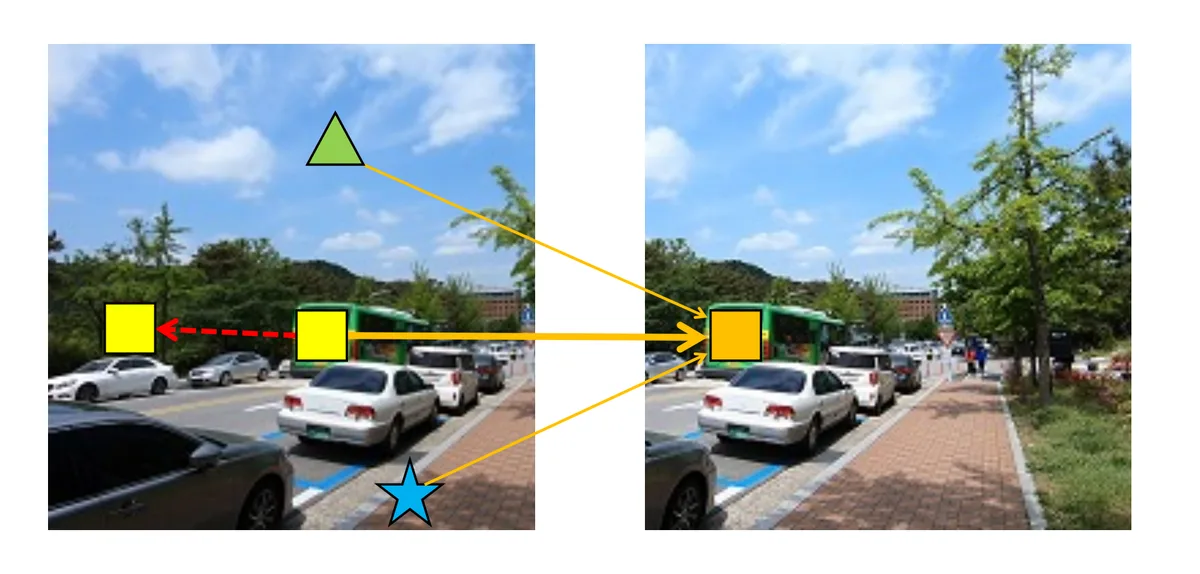
上图(原文 Figure 3)画的是互注意力的内部机制:图中标出支持帧(supporting frame)与参考帧(reference frame),以及注意力权重 、、,说明参考帧的每个 token 同时从多帧的多个窗口取信息,权重本身承担了「往哪里对齐」的职责。并行形变则在每个尺度末尾把邻居帧特征并行 warp 后融合进当前帧,作为注意力之外的一条补充通路。这种设计和 EDVR 的差别在于:EDVR 用 DCN 一次性学习固定大小的偏移做局部对齐,VRT 用注意力在全窗口内寻找对应,表达力更强;代价是每个窗口内部要计算 的注意力,显存与计算随帧数增长。
时间注意力的成本
VRT 的优势是并行性:整段序列可以一次前向,没有循环依赖,同一批帧可以同时输出,适合离线修复与批处理;劣势则集中在两点。
第一是注意力本身的二次复杂度。把序列分成 的窗口后,每帧有 个窗口( 为该尺度下的 token 数)。TMSA 在每个窗口内让参考帧窗口( 个 query)去查询邻居帧窗口( 个 key/value),单个窗口对的注意力代价是 ,整段序列一层约
如果改成对 个 token 做全局时空注意力,代价是 ;两者的比值约为 。取 ( 特征图)、、,窗口化的代价约为全局注意力的 。这解释了 VRT 为什么必须分窗口:不是设计偏好,而是全局注意力在这个规模上根本放不下。
第二是显存。VRT 并行重建全部 帧,每一层的中间激活都要为整段序列保留(除非使用梯度检查点或分块推理),显存随 线性增长,而循环网络只需要一份隐状态。对在线服务来说,这意味着显存预算决定了可用的窗口长度,进而决定了质量上限——这是一个由硬件容量而非算法决定的硬约束。
从实验看,VRT 相对 EDVR 在多个数据集上有约 0.5 到 1.5 dB 的 PSNR 提升,但这部分收益需要以更长窗口的注意力计算与更大显存占用为代价。部署时还要考虑一个隐性的时间成本:流式场景必须至少缓冲 帧才能组成一个窗口,VRT 的并行重建并不会缩短这个等待,只是把重建算力摊到多个帧上。
真实场景与流式推理
RealBasicVSR:先清再传
真实世界视频的退化比合成退化复杂得多,BasicVSR 的「传播」在这里会遭遇一个典型失败:长视频的传播链会把伪影也一路传下去并放大。RealBasicVSR 的方案是在传播前加一个图像清洗模块(cleaning module),逐帧独立地去除噪声与压缩伪影,再把清洗后的序列送入 BasicVSR 传播。清洗模块的训练目标在概念上只约束一件事:把低分辨率尺度上可见的噪声与压缩伪影去掉,而不要求它生成高清细节。这样职责被切开——清洗模块负责「去伪影」,传播网络负责「补细节」,两者串联时不会互相争夺同一份监督信号。对推理来说,这个分工还带来一个好处:清洗是逐帧独立的,可以并行、可以提前批量执行,真正的时序建模只发生在后面的传播链里。
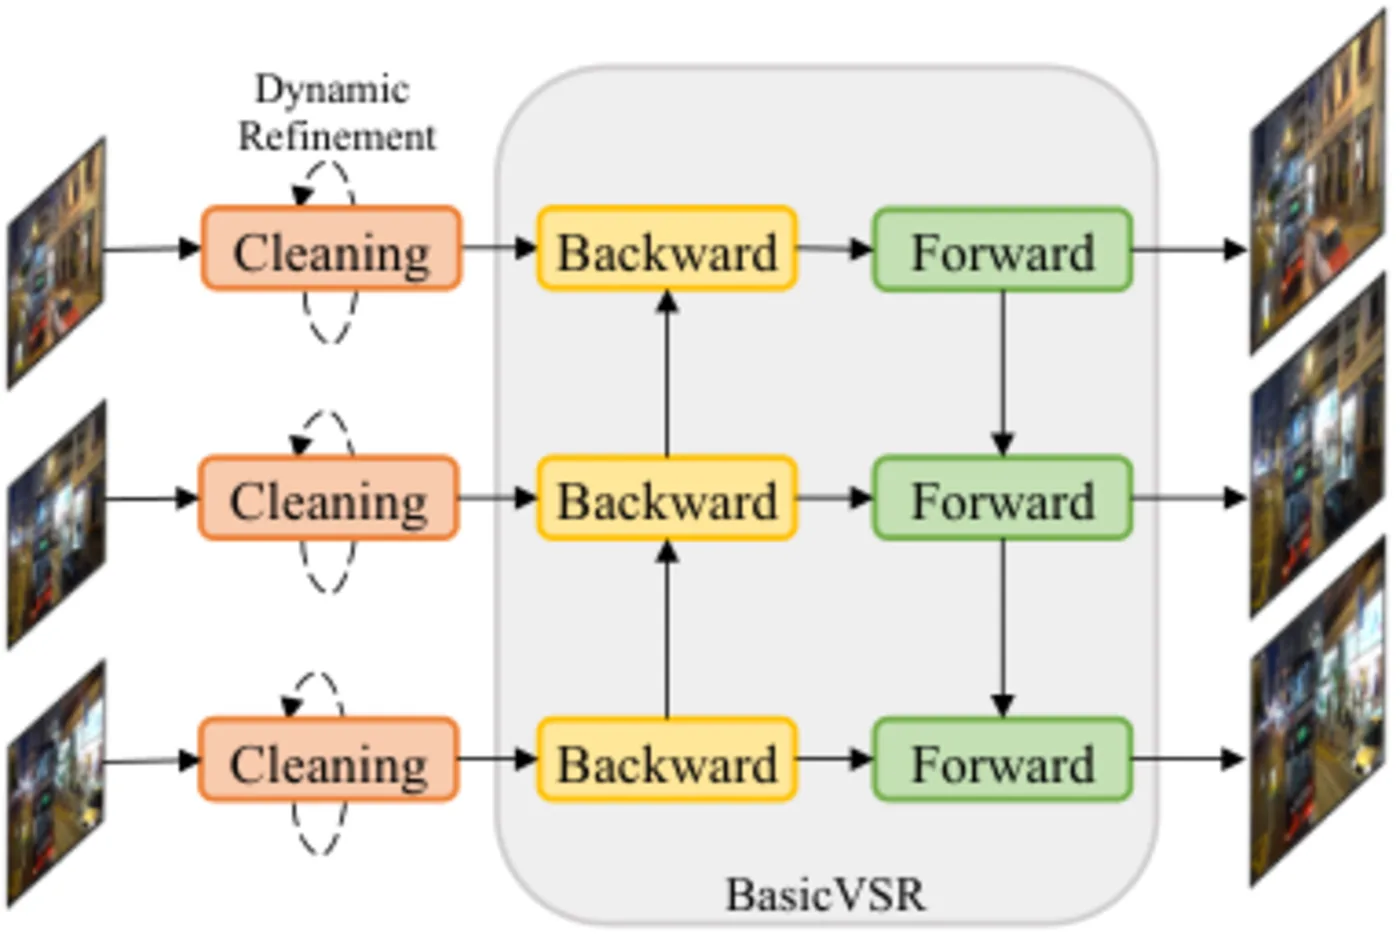
上图是 RealBasicVSR 的整体结构(原文 Figure 3)。输入帧先独立经过清洗模块(可迭代执行,称为动态细化),清洗后的序列再交给 BasicVSR。动态细化会重复执行清洗模块直到图像自然度指标(NIQE)低于阈值——这相当于在推理时用「多跑几次清洗」换「更干净但可能更平滑」的结果,用户可以在平滑度与细节之间自行选点。
这类「先清洗再传播」的设计揭示了真实 VSR 服务的一个关键事实:退化未知且复杂时,模型链路的重点常常不在对齐,而在退化抑制。
从论文到服务:延迟与显存账
把上述模型放进真实服务时,需要算三笔账:
- 延迟:滑窗模型需要前后 帧才能处理中心帧,固定延迟约 帧的采集时间;双向循环模型离线才有最优质量,流式只能退化为单向;注意力模型窗口越大质量越好,延迟也越大。
- 显存:循环模型每帧维护隐状态(与 通道数成正比的张量),序列越长内存占用稳定;滑窗模型每次处理 帧特征,显存随 增长;注意力模型显存随窗口长度平方级增长。
- 吞吐:循环模型逐帧串行,单流吞吐受串行依赖限制,通常靠多流并发提高 GPU 利用率;滑窗与注意力模型可以批处理多段,利用率更高但延迟更大。
把论文里的公开数字放在同一口径下,可以更直观地看到三者的成本差异(均为 4× 视频超分,运行时测于 的低清输入):
| 模型 | 参数量 | 运行时 | REDS4 PSNR | 结构特征 |
|---|---|---|---|---|
| EDVR | 20.6M | 378 ms | 31.09 dB | 5 帧滑窗、PCD + TSA、两阶段可选 |
| EDVR-M | 3.3M | 118 ms | 30.53 dB | EDVR 的轻量变体 |
| BasicVSR | 6.3M | 63 ms | 31.42 dB | 双向循环,含 SPyNet 参数 |
| IconVSR | 8.7M | 70 ms | 31.67 dB | BasicVSR + 关键帧补充 |
这组数字最有意思的地方是 BasicVSR 与 EDVR 的对比:参数量不到三分之一、运行时约为六分之一,PSNR 反而更高。原因不是 BasicVSR 的算子更省,而是它把「每帧重复做窗口内对齐与融合」换成了「每帧只更新一次隐状态」——同样的像素预算,花在了更有效的信息传递上。
把运行时换算到实际分辨率时,记住前面提到的面积缩放。 到 (后者正是 4K 输出的 4× 低清输入,面积约为 1080p 的四分之一)面积增大 9 倍,卷积主干与注意力的耗时大致按 9 倍放大:BasicVSR 的 63 ms 会变成约 0.57 s/帧,远高于 30 fps 的 33 ms 预算。这就是为什么实时 VSR 不能直接照搬论文模型:要么在更小的分辨率上推理后再上采样,要么换成参数量与感受野都更小的专用网络,要么把 4K 画面切块并行处理。反过来,这也解释了「为什么离线修复用大模型、实时增强用小模型」这条工程惯例——两者优化的根本不是同一个目标函数。
一个常见的服务形态是「单向循环 + 小隐状态 + 轻量光流」,例如在移动端或端侧设备上,用简化光流网络(或完全去掉光流、仅用可变形对齐的轻量版本)、单向上采样头,做到每帧几毫秒的预算。这与论文追求的最高 PSNR 是不同的优化目标:服务里的目标是「可接受的画质 + 低延迟 + 低功耗」。
需要强调的是,VSR 是像素空间的直接重建,和视频生成模型是两件不同的事。生成式的视频模型(例如视频分词器加自回归或扩散解码)通常先把视频压到离散 token 再生成,压缩比高、但会引入重新生成的不确定性;VSR 输入输出严格同构(帧数、时长不变,只放大分辨率),更适合有质量下限要求的业务,比如老片修复、监控放大、直播提清晰度。两条路线在长视频上都会面对同一类系统问题——如何把时间维度当成序列来管理显存与带宽,可参考 视频分词器完全拆解 里关于时间压缩与序列长度的讨论。
长视频的分段与状态管理
真实的 VSR 服务很少把一整段视频一次读进显存。常见做法是分段处理:按固定长度(例如 100 帧)切段,段内做完整的传播,段与段之间传递一小段「重叠区」的状态做衔接。重叠区的长度就是传播可以跨越的段边界范围——重叠太短,段交界处会出现可见的亮度或细节跳变(因为新段没有足够历史把隐状态「热」起来);重叠太长,重复计算增多。
在循环框架里,衔接的代价最低:只要把上一段的末尾隐状态原样交给下一段,热启动就完成了;代价是隐状态与段边界强绑定,换段时的对齐误差会留在状态里。在滑窗框架里,衔接需要在段边界处额外保留几帧已对齐特征做缓存,开销更大但状态更「干净」——缓存可以按需丢弃,不会像隐状态那样持续污染后续帧。这个差别在长视频修复(几十分钟的旧片)里尤其明显:循环模型的隐状态污染会累积到整段,工程上通常要每隔一段时间插入关键帧(IconVSR 式信息补充)把状态「重置」一下。
滑窗与循环在批处理上的差别
离线修复服务里除了精度,还要看吞吐。滑窗模型天然适合批处理:每个窗口是一次独立的前向,一段 100 帧的视频可以拆成几十个相互重叠的窗口一起送进 GPU;循环模型有严格的帧间依赖,只能沿时间串行,单条视频的延迟随帧数线性增长。但这一点可以通过「多视频并发」弥补——同时处理几十条视频,每条一个隐状态,GPU 的批维恰好填满。换言之,滑窗用「批次」填满算力,循环用「并发流」填满算力;哪种更划算取决于业务形态:批量转码适合滑窗,在线逐条提交适合循环并发。
对齐方式的选择
把三条路线放在一起看,对齐方式的选择可以按退化类型与硬件条件来判断:
| 场景 | 对齐方式 | 理由 |
|---|---|---|
| 合成退化、大位移 | PCD 多级 DCN | 金字塔级联能覆盖大位移到亚像素的跨度 |
| 高质量光流可得、长序列离线 | feature-level 光流 warp | 实现简单,误差只在相邻帧累积,双向传播抵消 |
| 遮挡严重、对齐误差敏感 | 光流引导的 DCN / 互注意力 | 注意力能处理无显式对应的情况,DCN 能吸收光流残差 |
| 实时、算力受限 | 单向传播 + 轻量对齐 | 去掉后向链,控制窗口长度 |
实时链路里的取舍清单
把前面的分析收成一张工程决策清单,按顺序问四个问题:
- 延迟预算允许几帧的历史? 只允许 0 帧(当前帧可用、未来帧未知)时只能做单帧超分或因果极浅的卷积;允许 1-2 帧时用单向循环;允许 5-10 帧时滑窗或小窗口注意力才可行。
- 退化是合成的还是真实的? 合成退化(干净的低清视频)可以直接用 EDVR/BasicVSR 类结构;真实退化(压缩、噪声、模糊混合)必须先决定是否加入逐帧清洗,否则传播会把伪影放大。
- 分辨率与算力比是多少? 输入下的卷积成本是 的 9 倍,实时预算要求更小的模型、更小的中间通道,或者分块推理。切块会引入块边界不一致,需要用重叠区与边界融合补偿。
- 一致性有硬性要求吗? 有(例如监控、医疗影像的时序对比)时优先保证帧间一致:宁可牺牲单帧细节,也要选输出稳定的结构,并在评测里同时看 warping error 与 PSNR。
这四问没有统一答案,但它们决定了模型选型的大方向:延迟与一致性优先的链路会走向「单向循环 + 轻对齐 + 清洗前处理」;质量优先的离线修复则走向「双向传播 + 更深的对齐/注意力模块 + 两阶段 refine」。
小结
视频超分的基础架构可以归结为一个问题的三种回答:如何让邻居帧的信息以正确的坐标参与当前帧的重建。
EDVR 把对齐显式地交给多级级联的可变形卷积,用金字塔处理大位移,用时空注意力加权融合,是滑窗路线的代表;BasicVSR 把对齐保持在光流 warp 这种简单形式上,但用双向循环传播把信息压缩进隐状态,证明了「传播方式」本身就能带来可观的收益;VRT 把对齐与聚合统一进时间注意力,用窗口交错换取长距离建模,代价是窗口内注意力的平方级计算与更大的显存占用。
它们的取舍最终落到同一个账本上:质量、延迟、显存。论文里 PSNR 的每一次提升,要么来自更好的对齐(PCD、DCN),要么来自更有效的信息传递(双向、关键帧补充),要么来自表达力更强的建模(注意力)。真实服务需要的版本,往往是这三者的轻量化组合,而不是某一篇论文的完整形态。
参考资料
- EDVR: Video Restoration with Enhanced Deformable Convolutional Networks
- BasicVSR: The Search for Essential Components in Video Super-Resolution and Beyond
- BasicVSR++: Improving Video Super-Resolution with Enhanced Propagation and Alignment
- VRT: A Video Restoration Transformer
- Investigating Tradeoffs in Real-World Video Super-Resolution
- Real-Time Video Super-Resolution with Spatio-Temporal Networks and Motion Compensation
- Video Enhancement with Task-Oriented Flow
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



