


脑电多模态模型架构基础:从卷积编码器到神经 Transformer,非图像信号怎么变成 token
为什么把脑电单独拿出来讲
文生图、视频生成、语音合成与识别、统一多模态生成这些分支有一个共同的起点:原始信号最终都会被整理成一个二维或三维的规则网格,像素、频谱帧或 Mel 频带都可以排成矩阵塞进卷积或 ViT。脑电(Electroencephalogram,EEG)不同。它同样是多通道高采样率的时间序列,却没有「行」和「列」这种天然的空间次序:十来个电极贴在头皮上的位置是任意的几何分布,每个电极每秒采集几百到上千个电压值,语义藏在毫秒级的节律变化里,而且信号幅度只有几十微伏,被眼动、肌电、工频干扰层层淹没。
正是这些差别,决定了 EEG 模型在架构上要走一条和图像模型不同的路。本文只讲基础结构:编码器怎么把多通道时序变成 token、预训练目标为什么常常不是语言建模、不同模态在什么阶段汇合、以及推理时这套结构的延迟由什么决定。具体下游任务的效果对比不在讨论范围内,重点是机制。
数据形状:一个 的矩阵
EEG 记录通常写成一个二维实数矩阵 : 是通道数, 是以采样点计数的时间长度。消费级设备常见 4、8、16 通道,科研用的 10-20 系统是 19 通道,高密度配置会到 32、64 甚至 128 通道。采样率 常见 200 Hz、250 Hz、256 Hz 或 1000 Hz,所以「记录 1 秒」对应 个数值。
和图像相比,这个数组有三个特殊性质。
通道之间没有像素邻接关系,只有头皮上的几何位置关系。10-20 系统里 Fp1、Fp2 位于额极,C3、Cz、C4 沿中央线排列,P3、Pz、P4 在顶区,O1、O2 在枕区,T7、T8 在颞区。这些位置关系有明确的生理含义——枕区对视觉刺激响应强,中央区与运动想象相关——但它不像卷积核那样可以靠「相邻像素」直接建模。
时间轴上存在多尺度结构。事件相关电位(Event-Related Potential,ERP)成分持续几十到几百毫秒;睡眠纺锤波在 11–16 Hz 上持续 0.5–2 秒;慢波睡眠的 节律周期接近 1 秒。只看某个固定窗口会漏掉部分结构,而窗口拉长又会让 token 数迅速膨胀。
记录本身是连续流,任务时刻只是其中的一个点。这决定了预训练更像「补全」和「判别」,而不是「生成一句话」。
按频率分解来看,EEG 的可用信息集中在几个经典频带:(1–4 Hz)、(4–8 Hz)、(8–13 Hz)、(13–30 Hz)、(30 Hz 以上)。这个分解非常实用,因为它把「看不见的波形」翻译成了「若干条窄带包络」,而窄带信号恰好是卷积核最容易捕捉的东西——后文讲卷积编码器时会回到这一点。
空间信息进入模型的三条路
电极位置怎么进入模型,是 EEG 架构第一个必须回答的问题。工程上有三条成熟路线。
空间嵌入表。给 10-20 系统里的每个电极名分配一个可学习向量,序列里属于该电极的 token 加上对应的向量。这个做法的好处是彻底解耦:权重里不含「通道数」这个维度,任意通道子集都能跑,缺失通道直接跳过。代价是空间关系只以「查表」的形式存在,模型得自己从数据里学出 Fz 与 Cz 的相关性。
空间卷积。用一层深度卷积或全连接,把 个通道的同一时刻混合成 个空间分量,学到的权重矩阵近似一个空间滤波器。这是 EEGNet 一类模型的做法,参数少、对小样本友好,但通道数被写死进权重形状,换设备就得改结构。
图结构。把电极当作节点、按头皮距离或 10-20 邻接关系连边,用图神经网络或图注意力做消息传递。它显式编码了拓扑,缺点是图构建本身带有先验假设,跨数据集迁移时邻接矩阵常常对不上。
三条路可以叠加。实践中常见的是「空间嵌入 + 注意力」的组合:空间嵌入负责注入位置身份,注意力负责学习远距离耦合。这样既保留了任意通道数的灵活性,又不需要手工设计邻接矩阵。
通道不一致是真实存在的麻烦。同一个模型要跑 8 通道的消费级头环和 64 通道的科研帽,最直接的处理是把输入对齐到 10-20 的规范子集,缺失的通道用零填充并附加一个「缺失」标记,让注意力知道这个位置没有信息。这和多模态语言模型里处理可变图像数量是同一类问题:结构上留出槽位,用掩码告诉模型哪些槽位有效。
卷积编码器:EEGNet 的三段结构
EEGNet 是卷积路线的代表,2016 年公开预印本、2018 年正式发表,作者是 Vernon Lawhern 等人,目标是在极小的参数量下跨多种 BCI 范式工作。它的结构不复杂,但每一层都对应一个明确的生理动机,值得逐层拆开。
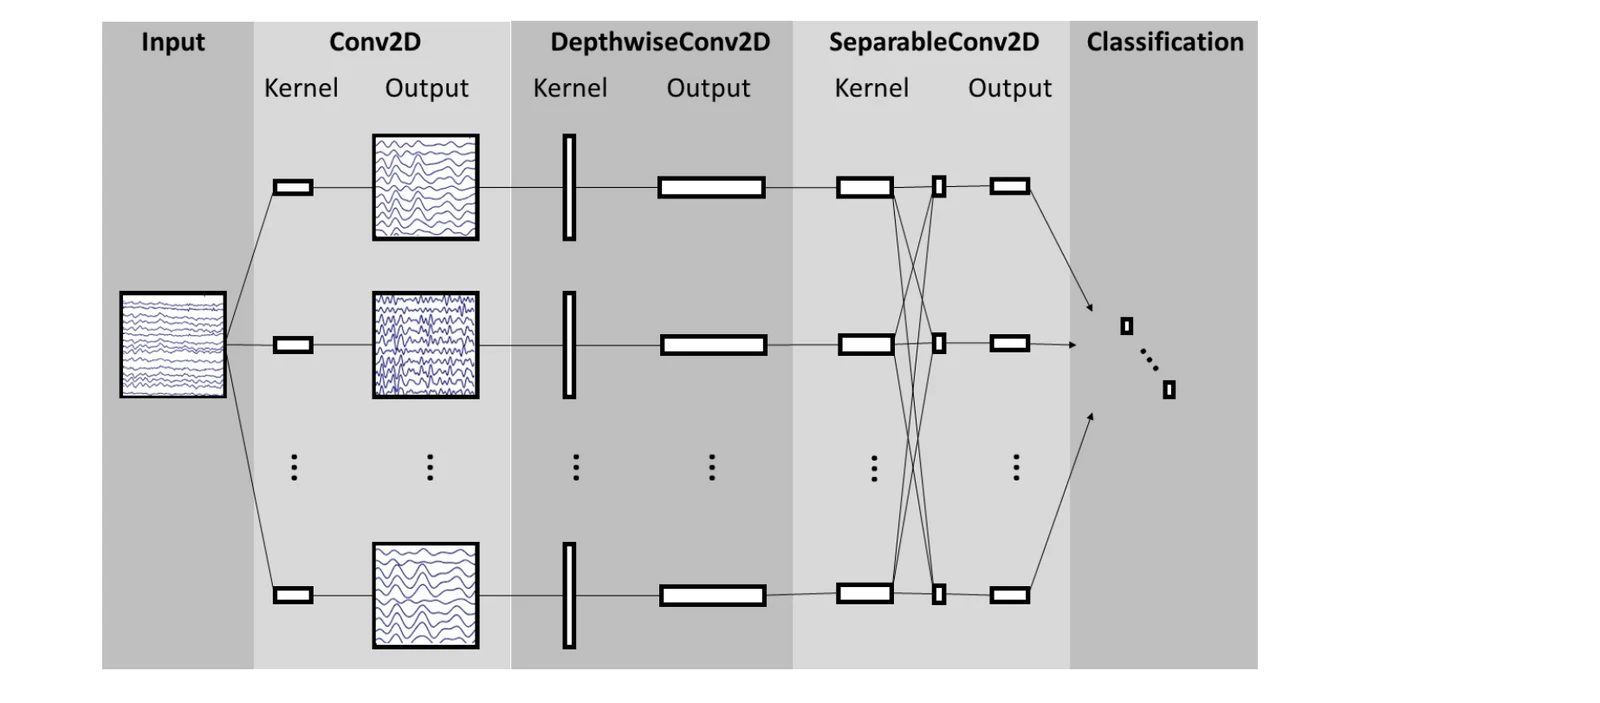
上图是论文给出的 EEGNet 结构示意,四列分别对应输入、时间卷积、深度空间卷积与可分离卷积。图的读法是从左到右:输入是一张 的单通道「图像」,每一列卷积都在改变它的形状。
第一段做时间卷积,卷积核形状是 ,只沿时间轴滑动。这里有一个值得注意的参数选择: 取采样率的一半。以 128 Hz 采样为例,,覆盖 0.5 秒,恰好能分辨 2 Hz 以上的频率成分。换句话说,这层卷积的输出近似一组带通滤波后的包络,把原始波形转换成「哪些频带在什么时刻活跃」。
第二段做深度卷积,卷积核形状是 ,只沿通道轴滑动,每个输出特征图只看一个时间滤波结果、跨全部电极混合。这正好对应 EEG 里经典的空间滤波(Common Spatial Pattern)思路:寻找一组电极权重,让两类状态的方差差异最大化。深度卷积把这个过程变成可学习的,参数量与通道数成正比,而不是像全连接混合那样按 增长。
第三段是可分离卷积,先做 的深度时间卷积,再做 的逐点卷积把特征图混合。逐点卷积的作用是让不同频带的特征重新组合,相当于在网络内部做一次「频带加权」。
整段结构后面接平均池化与分类头,中间穿插批量归一化、ELU 激活和 dropout。典型配置下可训练参数只有几千个,这让它在数据量只有几百个试次的任务上仍然能收敛。
卷积路线的局限也很清楚:感受野由层数和池化倍率决定,要覆盖几秒的上下文就得堆很多层,而每堆一层都会损失时间分辨率。跨电极的远距离关系只能通过深度卷积的全局混合间接建立,模型学不到「哪些电极在什么时刻互相关联」这种依赖时间的关系。这恰好是 Transformer 路线要解决的问题。
Transformer 编码器:把通道拍成 patch
LaBraM 是这条路线上一份结构清晰的参考实现,2024 年发表于 ICLR,作者来自上海交通大学。它把 EEG 当作「一个通道数可变、时间长度可变的 patch 集合」,用一套统一的编码器处理,从而支持跨数据集预训练。
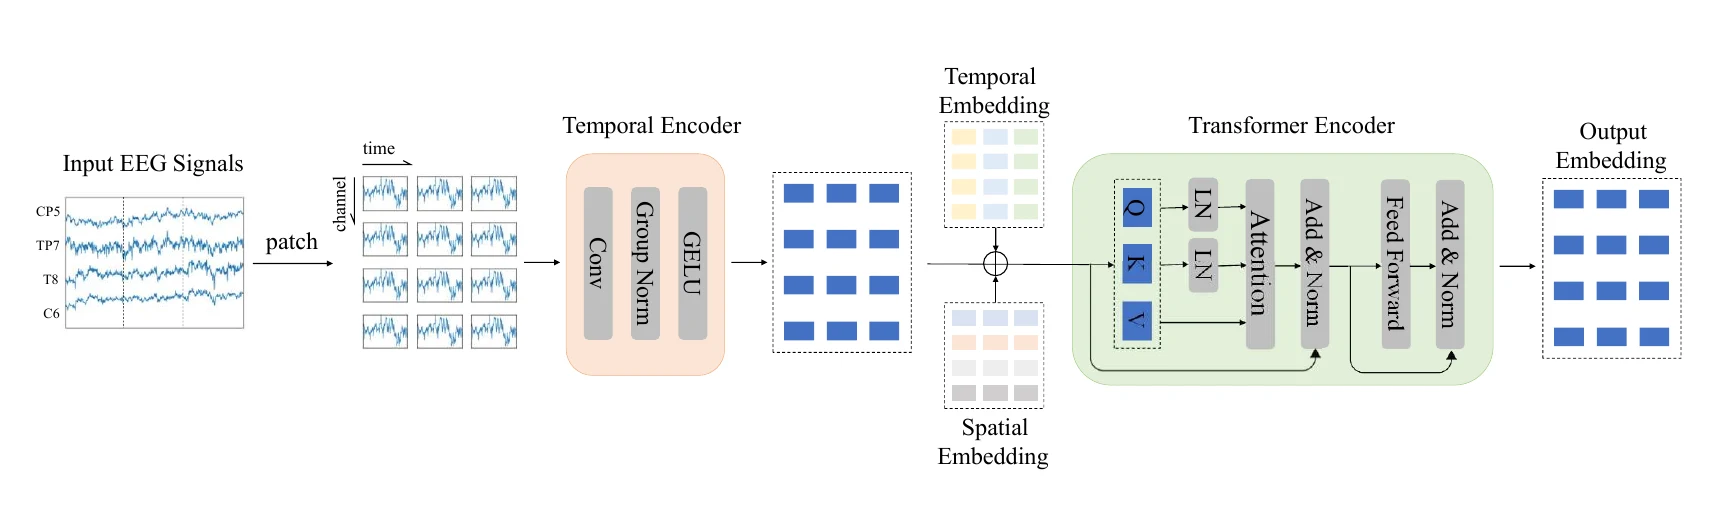
上图是 LaBraM 的整体结构。左侧是输入的多通道 EEG 波形;中间每个通道被切成若干等长小段,每段经过时间编码器(若干时间卷积块)变成一个 维向量;右侧这些向量加上时间嵌入与空间嵌入后进入 Transformer 编码器。
切分规则可以用公式写清楚。设记录长度为 个采样点、每个 patch 长 个采样点、不重叠切分,则单通道得到 个 patch,总数为
论文里还额外区分了两级切分:先用长度 、步长 把记录切成样本, 可切成 个样本,每个样本再按 不重叠分成 patch。推理时通常令样本长度 与样本步长 相等、样本内部不再重叠,两级切分就退化成一个参数。以 1 秒窗、200 Hz 采样计算,;论文把序列长度上限设为 256 个 patch,这意味着 64 通道的输入大约对应 4 秒记录,32 通道对应 8 秒。这个约束是显式写进实现里的——一旦序列超长,注意力的二次复杂度会直接吃掉显存。
时间编码器不是恒等映射,而是若干「一维卷积 + 组归一化 + GELU」的堆叠。为什么要先卷积再进 Transformer?因为一个 patch 内含 个原始采样点,直接线性投影到 维等于让模型自己从 200 个点里学波形特征;先用小卷积抽出局部节律,再把结果压成一个向量,能在同样 token 预算下保留更多高频信息。这一步等价于图像 ViT 之前的 patch embedding,只是这里的 patch 是一维的。
位置信息分成两路叠加:时间嵌入告诉模型「这是第几个时间窗」,空间嵌入告诉模型「这来自哪个电极」。两者都是可学习的向量表。这个设计是 LaBraM 能跨数据集工作的关键——不同数据集的通道数、通道顺序、时间长度都不一样,但只要电极名来自 10-20 系统,就能查到同一个空间嵌入,而时间嵌入按窗索引自然对齐。
序列进入 Transformer 后做的是 patch 级自注意力:任意两个 patch 之间都能建立依赖,包括同一电极的不同时刻、不同电极的同一时刻。这正是卷积编码器缺的能力。代价是复杂度: 个 token 的注意力开销是 。上面的例子里,30 秒、256 Hz、16 通道、 的输入会得到约 个 token,注意力矩阵是 ;如果把通道数提到 64、时长提到 5 分钟, 会到六位数,必须靠分块、稀疏注意力或层次化编码来处理。
为什么 在长记录里会成为硬约束
把 patch 数算出来之后,就能看清注意力成本的量级。LaBraM 的序列预算是 256 个 patch,在 64 通道、1 秒窗的配置下只覆盖 4 秒记录;这在分类任务里够用,但对连续监测不够。以一段 3 分钟、按 200 Hz 重采样的睡眠记录为例,,按 200 点窗(即 1 秒窗)切分得 180 个时间窗,乘 19 通道是 3420 个 patch。注意力矩阵是 ,元素数约 ,单头、单层就要这么多访存;十二层、多头叠加之后,显存与带宽都吃紧。
工程上有三种降复杂度的方式,和语言模型长上下文的手段一一对应:
- 窗口分段加段间摘要。相邻时间窗先用注意力编码成段内表示,再用段级 token 做第二层注意力。这把 拆成 的两级结构,段内保持局部细节,段间只传摘要。
- 时间轴上的稀疏注意力。只允许每个 patch 关注邻域窗口和少数全局锚点(如记录开头、事件标记附近),把注意力边数压到线性。
- 通道分组。把 64 通道按区域(额、中央、顶、枕、颞)分成若干组,先在组内做注意力,再做组间汇总。这对 EEG 特别自然,因为区域内的电极确实高度相关。
需要强调的一点是:在 EEG 上做稀疏化不会像语言模型那样损失「精确检索」能力,因为 EEG 里不存在需要被精确复述的文本片段,更多的是统计意义上的节律匹配。这使稀疏注意力在这类模态上的代价比在文本上低得多。
一个小例子:从 19 通道 5 秒试次到 token 序列
把前面所有数字放进一个具体例子。取 10-20 系统的 19 通道、250 Hz 采样、5 秒试次,按 LaBraM 的做法重采样到 200 Hz,则 。每通道切成 200 点不重叠窗口,得到 5 个 patch,总 patch 数为 。这远低于 256 的序列上限,所以一次前向就能处理整个试次。
如果换成 64 通道、整段 30 秒的记录,,每通道 30 个 patch,总数 ,已经超过上限,必须截断、分段或降采样窗口数量。这解释了为什么各类 EEG 基础模型在评测里都按 5–10 秒的试次切分,而不是按整段记录处理。
再换一个尺度:睡眠分期常用 30 秒一帧的标注,如果按 1 秒窗处理,64 通道一帧就是 1920 个 patch,相对 19 通道 5 秒试次的 95 个 patch 约 20 倍,注意力开销约 400 倍。这是为什么睡眠、癫痫这类长记录任务更依赖卷积编码器或分块注意力,而不是直接套用短试次配置的 Transformer。
空间嵌入的维度与共享
时间嵌入表的行数是序列上限(如 256),空间嵌入表的行数是 10-20 系统的电极总数(标准配置 19 个,加上中间位置与扩展位置通常到 64 个以上)。两张表都很小,加起来不到几十万参数,但它们在推理时的作用不是「省参数」,而是「让权重脱离通道数」。
一个容易忽略的细节是:空间嵌入需要与时间嵌入做同一种加法,而不是拼接。拼接会让每个 patch 的维度翻倍,注意力开销随之线性上升;加法只要求两者在同一 维空间里可加,训练时模型自己会把两路信息编码到不冲突的子空间里。代价是不能在事后单独拆出「时间成分」和「空间成分」,但这在推理里通常无所谓。
论文在 3.6 节专门做了预训练数据规模的扩展实验,试图回答「不同大小的模型各需要多少小时 EEG 数据」。这个问题的实际含义是:EEG 基础模型的规模选择不能只看参数量,还要看手上有多少小时的多通道记录——数据量不够时,把模型做大只会增加推理成本。
神经分词器:把连续信号压成离散码
LaBraM 的预训练不是在原始波形上做回归,而是先在离散码本上做预测。这需要一个分词器,把每个 patch 映射成一个码字索引。
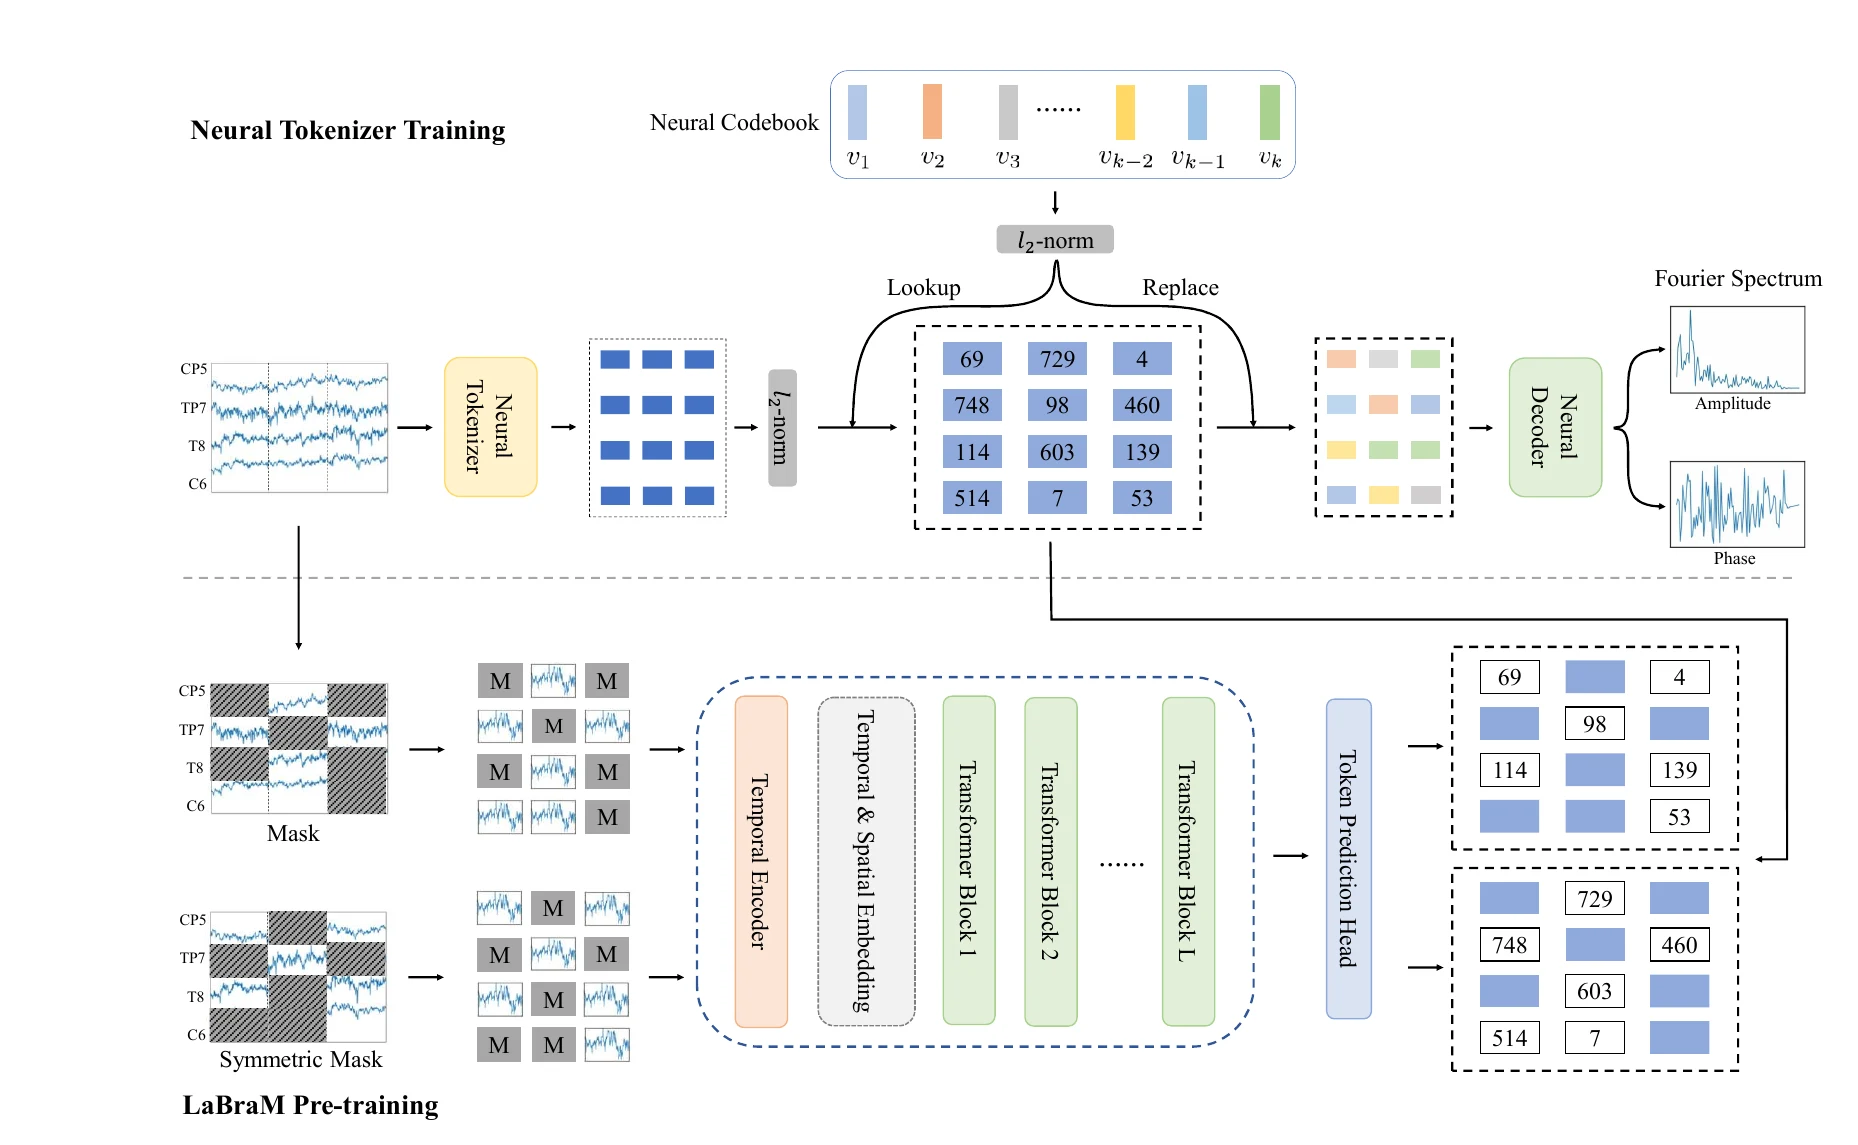
上图把两个阶段放在一起:上半部分是分词器训练,连续 patch 经编码器得到嵌入,量化器在码本里查找最近邻,解码器从量化后的向量重建傅里叶谱;下半部分是预训练,部分 patch 被替换成掩码 token,Transformer 需要输出被遮住位置的码字索引。
分词器的训练目标值得单独解释。论文里明确记录了一个失败经验:直接把原始波形作为重建目标时,损失无法收敛。原因是 EEG 信噪比低、随机性强、非平稳,逐点回归等于在拟合噪声。改成重建傅里叶谱之后才稳定,因为谱的幅度与相位刻画的是节律结构,对小幅随机扰动不敏感。
对一个 patch 做离散傅里叶变换:
幅度与相位分别是
解码器有两个预测头,分别回归 与 ,损失用均方误差。注意 与 在样本内做了 z-score 归一化,这一步对收敛很关键:不同记录的绝对幅度可能差一个数量级,不归一化的话回归目标会被大幅值样本主导。
量化部分沿用 VQ-VAE 的形式:码本是一个可学习矩阵 ,编码器输出 归一化后,用量化器找余弦相似度最大的码字,再把该码字的嵌入送入解码器。总损失包含四项:幅度重建、相位重建、以及两项码本对齐项(一项把码字拉向编码器输出,一项把编码器输出拉向码字,各自带 stop-gradient)。码本用指数移动平均更新,避免梯度直接冲击码字导致坍缩。
这一整套设计和图像侧的 VQ-GAN、VQ-VAE 是同一个思路,区别在于重建目标换成了谱而不是像素。可参考 图像离散分词器完全拆解 里对直通估计与码本坍缩的推导,两者的失败模式几乎一样:码字利用率低、少数码字吃掉大部分 patch、重建质量停滞。
顺带说明为什么这里需要离散化。掩码预训练的预测目标必须稳定——如果目标是连续向量,模型可以靠预测均值把损失压低却学不到结构;如果目标是码字索引,交叉熵会强迫模型在有限候选里做出选择,而码字本身又承载了谱形状信息。这是「离散瓶颈」带来的正则化效果。
分词器的码本与训练顺序
码本大小 与向量维度 是两个直接影响分词质量的超参。 太小(几百)会让不同的节律被压到同一个码字,重建出的谱偏向平均形态; 太大(上万)则码本利用率下降,大部分码字只有极少数样本命中,相当于浪费了容量。图像侧的 VQ-GAN 常用几千到一万多,EEG 侧因为单 patch 信息量更小,通常取中间值并配合 归一化提升利用率——LaBraM 明确指出归一化是为了提高码本利用率。
分词器必须先在大量无标注数据上单独训练,然后冻结,再进入 Transformer 预训练。这个顺序不能反:如果分词器还在变,预训练阶段的码字标签就是移动靶,交叉熵目标会互相打架。冻结还有一个好处——码字索引可以在离线阶段一次性算出并缓存,预训练时只需读索引,不必每次重跑编码器。
同样的「先训 tokenizer、再训主干」结构在视觉自回归与音频生成里都出现过。可参考 Visual Autoregressive Modeling 完全拆解 里对多尺度码本的讨论:那里的码本按分辨率分层,而 EEG 这边按时间窗分层的能力目前还比较弱,多数实现只用一个码本覆盖所有频率。
预训练目标:掩码、对比与判别
语言模型的下一个 token 预测之所以成立,前提是 token 序列有确定的因果次序。EEG 没有这种次序:一个时间窗的后文和上文并不存在谁决定谁,整体是分段平稳的随机过程,时间方向在物理上也没有特权。因此 EEG 基础模型的预训练目标集中在三类。
掩码建模。随机选比例 的 patch 替换成可学习的掩码向量,让 Transformer 在这些位置输出码字分布,用交叉熵监督。LaBraM 的实现里还加了一个对称掩码技巧:同一次前向里,用掩码 和它的补集 各做一次预测,总损失是两者之和。这样做有两个好处:分词器对每个样本只跑一次前向,离散表示可以复用;一个 batch 里相当于看到了两种掩码视角,数据多样性更高。
写成公式,设 是 patch 嵌入序列, 是掩码指示,掩码建模损失为
其中 是第 个 patch 的真实码字, 是掩码后的序列。总预训练目标是 。
对比学习。BENDR 是这条路线上的代表工作,2021 年发表,结构借用 wav2vec 2.0:先用多层一维卷积把原始波形降采样成潜在序列,再在潜在序列上随机遮蔽若干段,让模型从被遮蔽位置的上下文里识别出正确的量化目标,用对比损失训练。与掩码重建的区别是:目标不是还原具体数值,而是把「这一段和它的上下文是否匹配」区分开。这类目标对噪声更宽容,但需要精心设计负采样与量化。
判别式前置任务。在信号上叠加已知扰动(加噪、通道丢弃、时间反转),让模型判断哪一段被扰动、扰动类型是什么。它的好处是标签自动生成、任务明确,缺点是模型可能学到与扰动无关的捷径,迁移到下游时收益有限。
三种目标可以组合,但工程上更常见的组合是「掩码 + 对比」:掩码负责学局部结构,对比负责学全局不变性。微调阶段则通常只保留编码器,接一个轻量分类头,或在冻结编码器的前提下做线性探测,以检验表征本身的质量。
掩码位置与对称掩码的实现细节
掩码建模的一个实现问题是:掩码比例 是全局统一随机,还是按通道随机。如果按全局随机,某些时间窗可能整窗都被遮住,剩下同位置的其他通道还能提供一点线索;如果按通道随机,同一时刻总会有部分通道可见,模型更容易通过「通道间强相关」走捷径。论文的做法是全局随机,保证两种情形都会出现。
对称掩码的实现上,每次前向需要执行两次分类头、两次损失、但只做一次编码器前向。分词器输出的码字索引对两个掩码是同一份,所以交叉熵的标签也是同一份——这也是它能省算力的根本原因。
多模态融合的三种位置
EEG 多模态模型里的「多模态」,通常指与文本、图像、视频或音频的配对。按融合发生的阶段,可以分成三类。
输入级融合。把各模态编码后的 token 拼成一个序列,送进同一个 Transformer。EEG 片段很短,编码后只有几十到几百个 token,和一段短文本拼在一起开销可以接受。这种做法的好处是跨模态注意力从第一层就开始起作用;坏处是 token 预算被抢占,长文本场景下 EEG token 会被稀释。它和多模态语言模型处理图像输入的链路很像:图像经视觉编码器变成一串 embedding,再插到文本 token 流里。vLLM 的这条链路在 vLLM 源码完全拆解(十三):多模态输入 里有逐层拆解,差异只在于 EEG 没有「图像预处理」这一步,取而代之的是重采样与分块。
交叉注意力融合。各模态各自编码,再用一层交叉注意力让 EEG 查询文本或图像特征。它的表达力更强,因为每个模态保留自己的编码器与归一化方式,融合发生在语义层而不是 token 层。代价是多一次注意力的计算,且需要设计查询方向——是 EEG 查询文本,还是文本查询 EEG,会显著影响模型学到的东西。
决策级融合。各模态分别出结果,在输出层做加权或投票。最轻,也最不依赖对齐数据,但它学不到跨模态的细粒度对应,通常只作为兜底方案。
EEG 与文本的对齐还有一层额外困难:配对数据规模很小。图像-文本对可以到亿级,EEG-文本对通常只有几千到几万条,而且采集成本高、任务设计受限。这直接限制了对比学习的效果——负样本不够多样,模型容易学到「按受试者区分」而不是「按语义区分」。所以这条路线上的工作往往先在大量无配对 EEG 上做自监督预训练,再用小规模配对数据做对齐,而不是从零开始联合训练。
推理账本:延迟由什么构成
把上面这套结构放到实际推理里,延迟大致由四项构成。
- 窗口长度与步长。窗口越长,patch 数越多,注意力开销按平方增长;步长越短,单位时间内的前向次数越多。实时场景通常取 0.5–2 秒窗,步长等于窗长的一半,用重叠换取边界处的稳定性。
- 通道数。通道数直接乘进 token 数。64 通道相对 16 通道是 4 倍 token,注意力开销是 16 倍。
- 编码器规模。基础模型常见十几到二十几层、 在 256–768 之间;推理时可以用蒸馏版或只保留前半部分层。
- 融合开销。输入级融合要多跑一次其他模态的编码器,交叉注意力融合要多一层注意力。
给一个可以手算的估算。取 、12 层、320 个 token 的配置,单层前向的主要开销是注意力与 FFN:注意力约 FLOPs,FFN(扩张比 4)约 FLOPs。单层合计不到 ,12 层约 FLOPs,也就是 11 GFLOP 量级。在中端 GPU 上按有效 20–30 TFLOPS 估计,单次前向在毫秒量级;瓶颈往往不在算力,而在数据搬运与预处理(滤波、重采样、归一化),这部分如果放在 CPU 上做,很容易比模型本身还慢。
流式场景还有一个结构性的优化点:patch 级注意力的键值对可以缓存。历史 patch 的 不随时间改变,新窗口只需要计算自己的 query 并 attend 到缓存上,这与自回归语言模型的 KV 缓存是同一种机制,只是这里的「历史」是过去的时间窗而不是过去的 token。缓存带来的收益在长记录(睡眠监测、癫痫长程监测)上非常明显,但要注意窗口重叠时的重复计算——步长小于窗长时,重叠部分的 patch 会被重复编码,通常用「只对新进入的采样点做编码」来消除。
一个完整的前向流程
把前面的部件串起来,一次 EEG 推理的调用链是这样的:
raw record (C x T) -> 带通滤波 + 工频陷波 + 重采样到 200 Hz -> 按通道 z-score 归一化 -> 每通道切 200 点不重叠窗口,得到 N = C * floor(T/200) 个 patch -> 时间编码器(卷积块)把每个 patch 压成 d 维向量 -> 加时间嵌入(窗口序号)+ 空间嵌入(电极名查表) -> Transformer 编码器 (L 层, d 维) -> 分类头 / 事件检测头 / 或与文本 token 拼接后的解码头每一步都有可以截断的地方。实时场景可以在「滤波与重采样」之后只保留最新窗口的 patch,把历史 patch 的 缓存下来;离线场景可以一次性算完所有 patch,再按任务头输出。
批处理与变长序列
同一批请求的 EEG 记录长度往往不同:有的是 5 秒试次,有的是 4 小时整夜记录。如果按最长序列 padding,短样本会浪费大量算力在掩码位置上。所以推理框架上通常先按窗长排序、再按 token 数分桶,桶内 padding 到桶的最大长度。这和 LLM 推理里按序列长度分桶是同一个问题,只是这里「长度」的单位是 patch 数而不是 token 数。
分桶带来的另一个考虑是 CUDA Graph 的适用性:如果桶宽固定,就可以像 LLM 解码一样把整个前向捕获成静态图;但滤波、重采样这类预处理通常在 CPU 侧,图里放不进去,需要单独优化。可参考 CUDA Graph 完全拆解 的捕获条件,EEG 模型的解码部分同样可以受益。
流式推理的接口设计
实时 EEG 应用(如闭环脑机接口)和离线分析共享同一套编码器,但调用形态完全不同。离线是一批完整记录,一次性算出所有 patch;实时是持续到达的采样点流,要按固定步长切窗、重复调用。
接口上通常拆成三个组件:缓冲、编码、判定。缓冲负责维护一个滑动窗口,按步长输出新的 patch;编码负责对 patch 做卷积编码与嵌入,并把历史 patch 的键值缓存起来;判定负责在最新窗口上跑分类头或事件检测头,输出是否触发。这三层分开的好处是可以独立扩缩——缓冲和判定是轻量逻辑,编码是计算密集部分,可以单独放在 GPU 上并做请求合并。
缓存策略需要决定「保留多少历史」。理论上整段记录都可以缓存,但显存有限,而且越早的上下文对当前判定的贡献越小。实践中常按固定长度(例如最近 30 秒)截断,或者按事件边界切分——一次完整的试次结束后清空缓存,避免上一试次的状态污染下一试次。
推理延迟的分解也和语言模型相似:排队时间(多请求共享 GPU)、预处理时间(滤波与重采样)、模型前向时间、后处理时间(阈值判定与去抖动)。其中预处理往往是最大项,尤其是在 CPU 上做带通滤波时。把滤波移到 GPU 或用查表式 FIR 可以显著缩短这部分。
与图像、音频模型的结构对照
把 EEG 的结构按维度对照,可以看清它在多模态家族里的位置:
| 维度 | 图像(ViT 类) | 音频(codec / 扩散类) | EEG |
|---|---|---|---|
| 基本单元 | 二维像素块 patch | 帧级频谱或离散码字 | 时间窗 × 单通道 patch |
| 位置编码 | 二维网格或可学习 | 帧序号 | 时间窗索引 + 电极身份 |
| 典型通道数 | 3 | 1–2(立体声) | 8–128 |
| 采样时钟 | 无 | 16–48 kHz | 200–1000 Hz |
| 典型预训练目标 | 对比 / 掩码重建 | 码本预测 / 扩散去噪 | 掩码码字预测 + 对比 |
| 下游输出 | 分类、分割、生成 | 转写、合成 | 事件检测、片段分类、回归 |
| 主要噪声源 | 压缩伪影、遮挡 | 背景噪声、混响 | 眼动、肌电、工频、电极接触 |
这张表最有用的地方是第四行和最后一行:EEG 的采样率高、通道多、噪声源特殊,这三点共同决定了它的 token 化方式必须比图像更节省,预处理必须比音频更谨慎。
工程上的六个坑
归一化必须按记录做。EEG 的绝对幅度受电极阻抗、皮肤状态影响,同一受试者不同时段的记录可能差几倍。按通道做 z-score 是标准做法,但要避免用整个数据集统计量——那会把个体差异抹平成伪信号。
训练集与测试集要按受试者切分。同一段记录切出的相邻窗口高度相关,如果随机切分,测试集里会混入训练集受试者的近邻窗口,指标虚高。按受试者划分是这类任务的底线。
滤波与工频抑制要前置。0.1–75 Hz 带通加 50 Hz 或 60 Hz 陷波是常见配置,LaBraM 的预处理就是这样做的,随后重采样到 200 Hz。重采样不只是省算力,也统一了不同设备的 token 尺度。
通道顺序不能当身份。如果空间嵌入按数组下标索引,换个数据集的通道排列就会全错位。正确做法是按电极名查表,缺失的通道显式标记。
掩码比例要按任务调。比例太低学不到结构,太高则上下文不足;EEG 上的常见取值在 40%–60%,比图像掩码自编码器的 75% 低,因为 EEG patch 之间的冗余远小于图像。
伪迹要单独处理。眼动伪迹的幅度常常是脑电信号的数倍,直接进模型会主导表征。工程上有两条路:一是预处理阶段用独立成分分析剔除,二是在训练时把伪迹当作一种数据增强,让模型学会忽略它。第二种更省事,但要求伪迹标注足够多。
与相关方向的衔接
EEG 的这些结构部件,单看每一个都不新:patch 化来自 ViT,码本预训练来自 VQ-VAE 与 BEiT,掩码预测在图像与语音上都已成熟。EEG 的贡献在于把这些部件装配成一套能处理「通道不定、长度不定、信噪比低」的信号管线。理解这套装配关系,比记住某个模型的分数更有用。
在更大范围里,EEG 只是「非视觉生理信号」的一个代表。同一套方法论可以直接搬到 EMG(肌电)、ECG(心电)、fNIRS(近红外)上:都是多通道、低信噪比、通道数可变的时序信号,都需要空间嵌入与时间编码器分离,也都需要离散瓶颈来稳定预训练。
小结
EEG 模型的架构分歧,本质上是对「这个信号到底是什么」的不同回答。把它当作低频图像,就得到 EEGNet 那样的多尺度卷积;把它当作可变长 token 序列,就得到 LaBraM 那样的 patch 化 Transformer;把它当作需要离散瓶颈的生理过程,就得到码本加掩码预测的两阶段流程。三条路线并不互斥,实际系统常常是「卷积前端 + Transformer 主干 + 离散预训练目标」的组合。
真正决定成败的往往不是主干选型,而是预处理、通道对齐、受试者划分这些看起来不性感的工程细节。这一点和推理系统的调优很像:模型结构决定上限,数据管道决定能不能跑到上限。
参考资料
- EEGNet: A Compact Convolutional Network for EEG-based Brain-Computer Interfaces
- Large Brain Model for Learning Generic Representations with Tremendous EEG Data in BCI
- LaBraM 官方代码仓库
- BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data
- Brant-X: A Unified Physiological Signal Alignment Framework
- NeuroLM: A Universal Multi-task Foundation Model for Bridging the Gap between Language and EEG Signals
- Are EEG-to-Text Models Working?
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



