


Hadamard 变换完全拆解:一个只有加减法的矩阵,如何成为 LLM 量化推理的通用工具
背景:量化的一切麻烦,都是”分布不均”
把一个浮点张量压成整数,最朴素的方式是均匀量化:找一组 scale(和可选的 zero-point),把浮点值映射到整数格点上。这条路在 8-bit 上几乎总是成立的,往下走就开始出问题。原因不在量化器本身,而在被量化的数据:LLM 的权重和激活里存在少量幅值极大的”离群通道”(outlier channel),它们把动态范围撑得很大,剩下的绝大多数元素只能挤在格点的少数几个上。
先把这个”挤”字写成公式。对称均匀量化用 个比特表示一个张量,元素范围是 ,量化步长为
舍入到最近格点的误差满足 。若误差在区间内近似均匀分布,单元素均方误差为 ,代入 得
这个式子说明一件很直接的事:在比特数固定时,量化误差与最大值 的平方成正比。 减半,误差降到四分之一,相当于白赚一个比特; 缩小到 ,误差降到 ,对 的隐藏维来说相当于白赚 12 个比特。当然这只是理想上界,但它给出了一个明确的优化方向:不要改量化器,改被量化数据的分布。
LLM 恰好把分布做得非常糟糕。LLM.int8() 在 175B 模型中发现,约 0.01% 的特征维度幅值是其余维度的几十倍,正是这些维度让 8-bit 激活量化失效;SmoothQuant 的测量也给出类似量级,激活中的离群值可以比中位数大两个数量级。这些现象在站内两篇文章里有完整的数据与机制拆解,可参考 LLM.int8() 完全拆解 与 SmoothQuant 完全拆解。KV Cache 侧同样如此,KIVI 需要按通道给 Key 单独量化,才能把缓存压到 2-bit,见 KIVI 完全拆解。
所以量化研究的很大一部分精力,都花在”如何让张量变得更均匀”上。主流路线有三条:
- 缩放类:SmoothQuant、AWQ 用逐通道缩放把激活的离群值”搬”一部分到权重上,数学上等价,但依赖通道结构;
- 分组类:把张量切成小组,每组一个 scale,把离群值关在小范围里,代价是 scale 开销与组内粒度;
- 旋转类:用一个正交矩阵把整个坐标系转一下,把集中在少数坐标上的能量摊到所有坐标上,再用普通均匀量化。Hadamard 变换就是这条路线上最便宜、最常用的那个旋转。
第三条路线与前两条有一个本质区别:缩放和分组是局部修补,旋转是全局换基。换基不改变向量长度、不改变内积、不改变线性层的输出,却能把”某些通道特别大”这个坐标系依赖的性质彻底打散。代价是变换本身要算,而且必须算得足够快,否则省下的量化收益会被变换开销吃掉。这篇文章的主题,就是这个”换基”操作的数学、算法、kernel 实现,以及它在权重、激活、KV Cache 三类量化对象上的具体用法。
一个正交变换能改变什么,不能改变什么
设 , 是正交矩阵,。变换后的向量 满足
也就是说,总能量守恒。旋转不可能把”大值”消灭,只能重新分配。量化的误差恰恰由分布的最大值决定,所以旋转能在总能量不变的前提下,把最大值压下来,这就是全部收益的来源。
那最大能压到多少?对 Hadamard 矩阵有一个非常干净的上界。归一化 Hadamard 的每个元素是 ,于是
这个不等式把”旋转后的最大元素”与”旋转前的 L1 范数”联系起来。考虑两种极端分布:
- 单点尖峰:。变换前最大元素是 ,变换后每个元素都是 ,最大值下降 倍。 时下降 64 倍。
- 均匀分布:所有元素都是 。此时 ,上界退化为 ,旋转没有任何收益。但这种情况本来就不需要旋转,因为分布已经是平的。
现实中的 LLM 激活介于两者之间:少数通道幅值很大,其余通道接近零。旋转把这些”尖峰”打散成所有通道上的小波纹,同时不改变向量的总长度。用 L1 与 L2 的比值可以刻画尖峰程度,定义峰均比
均匀向量的峰均比约为 1,单点尖峰的峰均比是 。Hadamard 旋转后的峰均比上界变成 ,对 个等幅尖峰的情形约为 。所以旋转能把峰均比从 量级压到 量级, 越小收益越大。这也解释了为什么”旋转”对激活特别有效:激活的离群值往往集中在极少数固定通道上, 很小;而权重矩阵通常更接近稠密高斯,旋转的收益就小得多。
Hadamard 矩阵:一个只有 ±1 的旋转
Hadamard 矩阵 满足
归一化之后 就是正交矩阵。这类矩阵最早出现在 1867 年 Sylvester 的一篇关于正交矩阵与”双色拼贴问题”的文章里,Sylvester 给出了递归构造,也就是所谓的 Sylvester 构造;Hadamard 本人后来证明了行列式上界 ,并把达到上界的矩阵称为 Hadamard 矩阵。Hadamard 猜想(对任意 的倍数 都存在 阶 Hadamard 矩阵)至今仍未完全解决,但实际用到的阶数几乎都有已知构造。
Sylvester 构造与 Kronecker 积
Sylvester 构造从 出发递归:
其中 是 Kronecker 积,。展开第一行可以看到典型的 Walsh 函数结构: 的第一行全是 ,第二行是 ,第三行是 。这种”方波”结构有一个直接后果:矩阵乘 可以完全不用乘法完成。
为什么是”Fast”:Walsh–Hadamard 变换
直接算 需要 次乘加。但对 Sylvester 矩阵,可以利用 做分治。把向量 的前后两半分别记为 :
每一步把问题规模减半,代价是一半的加法与一半的减法,没有任何乘法。递归下去复杂度是
这就是快速 Walsh–Hadamard 变换(Fast Walsh–Hadamard Transform, FWHT)。对 的激活矩阵按行做变换,复杂度是 ,而通用 GEMM 是 。这个差距在 时是 12 倍,更关键的是,FWHT 只需要加法和减法,不需要浮点乘法,也不需要把 存进显存。QuIP# 用它替代 QuIP 的两因子 Kronecker 正交矩阵,把变换代价从 降到 ,而且常数更小。
下面是一份在 CPU 上可直接运行的原地实现,每层循环处理跨度 的元素对,复杂度自底向上累积到 :
import numpy as np
def fwht(a): """In-place normalized Fast Walsh-Hadamard transform along the last axis.""" n = a.shape[-1] assert n & (n - 1) == 0, "size must be a power of 2" h = 1 while h < n: # reshape so that pairs at distance h become adjacent b = a.reshape(*a.shape[:-1], -1, 2 * h) u, v = b[..., :h], b[..., h:] a[...] = np.concatenate([u + v, u - v], axis=-1).reshape(a.shape) a[...] /= np.sqrt(2) h *= 2 return a注意归一化放在每一层:如果只在最后除以 ,中间层的数值会快速膨胀,在 FP16 下直接溢出。把 分摊到每一层,数值范围和输入保持一致,这对后面要在 FP16 / BF16 下跑的 kernel 尤其重要。HadaCore 的 MMLU 验证部分专门检查了这一点:数值精度不损失,因为每层的加减运算本身没有舍入误差(在 FP16 下两个相近数相加仍可能舍入,但误差不随层数累加放大)。
真正的快在于并行结构
FWHT 的每一层都是对”距离为 的元素对”做一次蝴蝶运算(butterfly)。层与层之间有数据依赖,层内没有。所以:
- 层内可以完全并行,GPU 线程之间只要拿到对方的元素即可;
- 层间必须同步,因为第 层的数据分布在不同的线程手里。
在 GPU 上, 时一对元素在同一线程的寄存器内; 到 时一个 warp 内的 32 个线程正好覆盖,可以用 warp shuffle 交换数据;再往上就需要跨 warp、跨 threadblock,要用 shared memory 或全局内存同步。传统 FWHT kernel 把每线程负责的元素数固定为 8,用两层 threadblock 同步覆盖最多 的变换。HadaCore 的改动,就是把”层”从一对一的蝴蝶换成 16 阶的 Tensor Core 矩阵乘,从而把层数减少 4 倍。
随机化 Hadamard 变换:为什么还要”随机”
纯 Sylvester 结构有一个弱点:它有固定的”方向”。如果激活的离群通道恰好与 的某个特征方向对齐,旋转可能把尖峰分配到少数几个输出通道上,而不是均匀摊开。一个很小的改动就能解决:在变换前后各乘一个随机符号对角矩阵 , 独立均匀抽取。
这仍然是一个 Hadamard 矩阵,不过列被随机翻了个方向。每个元素的幅值还是 ,所以非相干性的理论上界不变;但离群通道落在哪个输出坐标上变得不确定,多个离群通道同时”撞”到同一个输出通道的概率极低。这个组合叫 Randomized Hadamard Transform(RHT),是 QuIP#、QuaRot、SpinQuant 默认使用的形式。QuaRot 论文的附录 A.5 做了对照:把随机 Hadamard 换成通用随机正交矩阵(QR 分解得到),LLaMA2-7B 的 4-bit 困惑度是 7.45 对 6.10,差 1.35;模型越大差距越小(70B 上 0.28)。这说明”摊匀”效果与矩阵结构有关, 结构在有限维上比”随机高斯”更彻底,具体原因论文没有深究,但实验重复过多次。
非相干性(incoherence)的定量刻画
QuIP 系列把”分布是否均匀”写成了一个可证明的指标。定义很简洁,设 ,若
则称 是 -非相干的。 是下界(所有元素幅值相同), 越大说明能量越集中在少数坐标上。对 Hessian 同理,定义 时 。
QuIP# 的 Lemma 3.1 给出了 RHT 后的上界:对任意 ,经过 RHT 的权重以 的概率满足
以 、 代入估算,,。这个数值与 只是根号对数关系:矩阵规模放大 100 倍, 项只增加约 9, 从 8 变到约 9.4;放大到一万倍也只到约 10.4。相比之下,QuIP 的两因子 Kronecker 矩阵的上界是 ,是 ;RHT 是 。这是 QuIP# 改用 RHT 的首要理由:非相干性更强,而且随规模增长更慢。同时,RHT 的代价是 ,Kronecker 是 ,两者相差一个 的因子,在 4096 维上约 30 倍。
变换前后的存储开销
一个容易被忽略的细节是符号向量。RHT 需要保存 ,也就是 个 。QuaRot、QuIP# 都按”每层一组符号向量”处理, 都在数千量级, 与 加起来每权重不到 0.01 bit(QuIP# 论文的估计),可以直接当作元数据随权重一起存下来。
那能不能不存?可以,只要符号是确定性的,例如用固定种子在运行时生成。但生成符号后还要逐元素乘上去再做变换,这层乘法发生在推理的每一步,成本比存这点元数据高得多。所以实际实现都选择存符号,并且在 kernel 里把符号乘法与变换的第一步蝴蝶运算融合,避免多读一遍数据。
用法一:QuaRot 的残差流换基与权重侧融合
Hadamard 变换第一次大规模进入 LLM 量化,是 2024 年的 QuaRot(Ashkboos 等,arXiv 2404.00456)。它的核心观察是:Transformer 里每个矩阵乘的前后都有 Norm 层,而 RMSNorm 里那只作用于逐元素的缩放 可以”穿过”线性层,被吸收进相邻权重。一旦缩放被吸收,矩阵乘的入口就变成”残差流”这样一个全局的、所有模块共享的向量,于是可以给整个残差流换一次基,代价是所有读写残差流的权重都跟着换一次基。
具体推导如下。线性层计算 ,其中 是输入行向量。插入一对互逆的正交矩阵 :
令 为”旋转后的输入”, 为”旋转后的权重”,那么 与原来完全相等。关键是 可以融进权重: 在量化之前算好,存储的是 的量化版本,推理时只有输入需要在线旋转。如果一个模块是”读残差流—算—写残差流”,那么输入侧旋转与输出侧的逆旋转可以互相抵消,权重侧的融合让在线变换次数降到每层约 1.5 次(QuaRot 论文的统计口径)。
QuaRot 的 Figure 1 把每个 Transformer 块里哪些旋转是”离线融合”(蓝色)、哪些是”在线插入”(红色)画得很清楚:
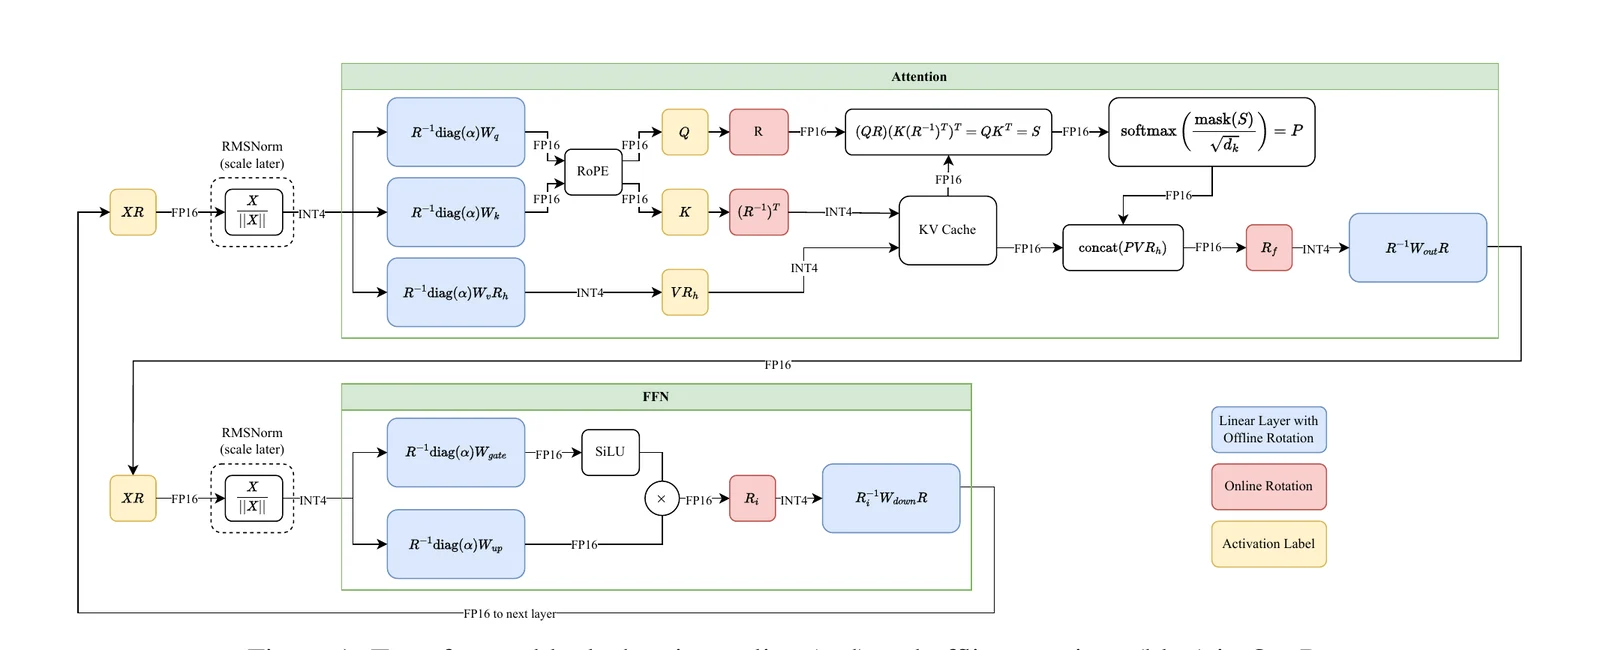
图中 表示旋转;蓝色标注的”Linear Layer with Offline Rotation”表示旋转已经吸收进权重,运行时不需要额外计算;红色标注的是必须在前向里实时做的旋转。注意图中 KV Cache 那一格标了 INT4,value 被头维 Hadamard 旋转之后才写入缓存,这是缓存侧量化的前提。对这套”四把钥匙”(残差流换基、head 维换基、query/key 共享旋转、下投影前在线旋转)的完整推导、张量并行下的 Kronecker 结构问题,以及论文给出的 kernel 数据,站内 QuaRot 完全拆解 已经逐段讲过,这里不再重复。
真正值得在这里展开的是为什么是 Hadamard,而不是别的正交矩阵。QuaRot 给了三个理由,每一个都能用上文的定义直接验证:
- 变换快:FWHT 是 次加减;通用正交矩阵的矩阵向量乘是 。在 4096 维上相差约三个数量级,在线插入的旋转就不能用通用矩阵。
- 非相干性最优:归一化 Hadamard 的每个元素幅值 是所有正交矩阵里的最小值,由上文的不等式,旋转后最大元素的上界 已经被压到极限。
- 自逆且对称:归一化 Walsh–Hadamard 满足 。这条性质让”旋转”和”反旋转”用同一个矩阵,融合在权重两侧时不需要维护两套矩阵;残差流的旋转在输入侧与输出侧成对抵消时,也就只需要一个 。
还有一层工程上的”随机化”: 的符号向量本身可以融进相邻的权重。例如对 ,符号 与 逐行相乘,等价于把 的行翻转一遍,不改变矩阵乘的代价。
维度不是 2 的幂怎么办
Hadamard 矩阵只对一部分阶数存在(Sylvester 构造只覆盖 2 的幂)。真实模型的隐藏维不总是 2 的幂:LLaMA2-70B 的中间维是 28672,不是 2 的幂,但可以分解为 ,1024 是 2 的幂,28 阶 Hadamard 矩阵的构造是已知的(28 是 4 的倍数,属于 Paley 构造覆盖的范围)。于是用
构造 阶 Hadamard。因为 是固定的, 用 FWHT 算, 作为一个小稠密矩阵乘上,整体代价是 ,比 QuIP 的两因子 Kronecker 方案在 时明显便宜。
另一种做法是不用 Hadamard,而用随机快速傅里叶变换(Randomized FFT)。FFT 只需要 是偶数,限制比 Hadamard 宽得多,代价是变换在复数域,需要浮点乘法和实部虚部分离。QuIP# 把它作为”找不到合适阶数”时的兜底方案。
如果阶数连 Hadamard 分解的最弱条件都满足不了(例如奇数维),最后的手段是补齐:把输入补零到最近的可用阶数再变换,最后截断。补零的代价是变换开销变大,但非相干性不受影响。
用法二:随机化 Hadamard 与码本量化
QuIP 系列(Chee 等,2023)是 Hadamard 路线的前一支:它不针对 Transformer 的 Norm 结构,而是把整个权重矩阵当成一个需要”被量化得尽可能好”的对象。它提出的思路很直接:在量化之前,用结构化随机正交矩阵把权重 和 Hessian 同时变换到一个非相干坐标系里,然后在这个坐标系里做码本量化。
QuIP#(Tseng 等,ICML 2024,arXiv 2402.04396)把 QuIP 的 Kronecker 正交矩阵换成 RHT,并把标量量化换成 格码本。它的整体流程和推理路径如下:
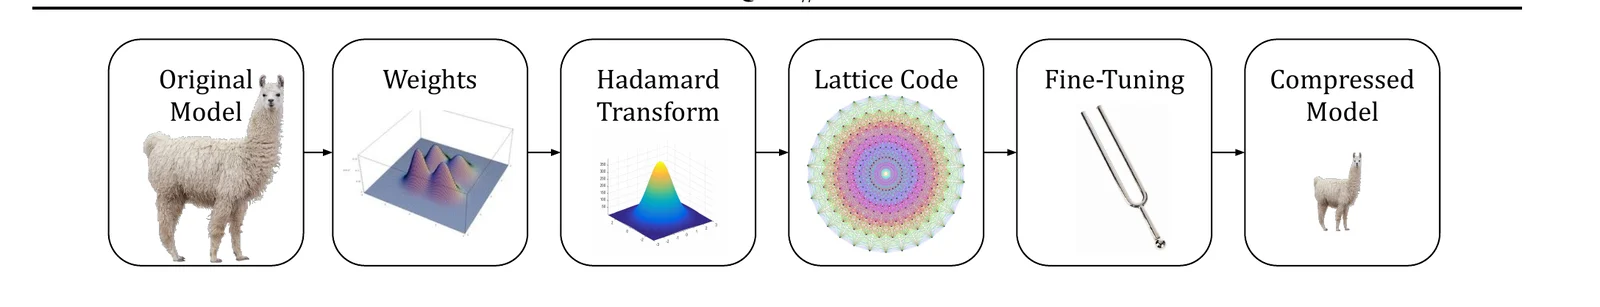
图中从左到右是 QuIP# 的五个步骤:原始权重、Hadamard 变换、格码本量化、微调、压缩模型。前两步是本文的主题,后三步是码本设计与舍入优化,站内 SpinQuant 完全拆解 对旋转矩阵的参数化有完整讨论,这里只补 QuIP# 特有的部分。
非相干性的数学保证
QuIP 的核心定理(在 QuIP# 中被改写)是:设 是缩放的 Hadamard 矩阵, 是随机符号对角矩阵,则 和 以概率 是 -非相干的, 只与 有关。这个结果的意义在于,它把”旋转能不能把离群值压下去”从一个经验观察变成了有概率保证的结论。上一节公式里的 就来自这里。
更重要的是,这个保证直接传到量化误差上。QuIP 的误差分析表明,对非相干矩阵做码本量化,每个元素的误差由码本本身的最小距离决定,而不由原始矩阵的最大元素决定。这正是”换基”带来的全部收益:量化器还是那个量化器,但它的输入分布被固定在了一个可控的范围里。
推理时的两次变换怎么摊薄
QuIP# 的量化对象是权重,推理时激活 需要先做 ,乘完量化后的权重后再做 。看起来每个线性层要加两次在线变换,但每次变换是 ,相对矩阵乘的 只是一个小常数项,而且码本解码本身已经要逐元素查表,变换可以和解码的循环合并。真正的成本仍然在权重读取上:在 2-bit、3-bit 这种极低比特下,每层要读的字节数被压到 FP16 的六分之一甚至更少,变换和反量化的算术开销相对带宽可以忽略。QuIP# 的 CUDA 概念验证实现跑到 RTX 4090 上超过 50% 的峰值带宽,说明瓶颈确实在权重读取而不是变换。
QuIP# 的另一个重要贡献是它证明了 3-bit 模型的缩放性优于 4-bit:在相同参数量下,3-bit 的 QuIP# 比”理论无损”的 4-bit 基线还更好。这个结论的前提是权重的分布近似高斯,只有做了非相干处理,码本才能按照球体的等体积分布来设计而几乎不掉精度。站内 BitDecoding-FP4 完全拆解 讨论的 KV 侧 FP4 原生解码,走的也是”先在非相干坐标里量化、再在解码 kernel 里处理误差”的类似思路。
用法三:激活量化与 KV Cache,在线旋转的取舍
权重侧的旋转可以离线融合,激活侧不行:每一层的输入都不同,旋转必须在运行时算。QuaRot 的做法是把激活旋转限制在”每层一次”(FFN 下投影前的在线 Hadamard),其余都通过权重吸收。代价是每层多一次变换,收益是激活和 KV Cache 可以进 4-bit。
这里有一个容易被忽略但很关键的事实:Hadamard 旋转与 RoPE 不交换。RoPE 在每个头内按频率对做二维旋转,是一种高度结构化的正交变换;Hadamard 则把所有通道混在一起。两者复合时, 与 一般不相同。这意味着:
- 不能把 KV Cache 的 Hadamard 旋转提前融进 、,因为 RoPE 在投影之后、写缓存之前,顺序上绕不过去;
- 要量化 key,只能在 RoPE 之后再对每个头做一次在线 Hadamard,并且 query 必须在同一坐标里做同样的旋转,否则点积改变;
- 由于每个位置的 RoPE 角度不同,这个旋转无法在位置之间复用,只能按 token 做。
这也是为什么 QuaRot 把 query/key 的 Hadamard 放在注意力内部、作为”在线块”插在 RoPE 之后,而 value 的旋转则融进 与 的成对变换里。对 KV Cache 量化的更多细节,站内 KVQuant 完全拆解 讲的是另一条路线:它选择在 RoPE 之前量化 key,用逐通道 scale 来保留通道结构;两条路线的取舍正在于”保留通道结构”还是”把通道结构打散”。
DuQuant:全局 Hadamard 不是唯一答案
2024 年的 DuQuant(arXiv 2406.01721)对”一个全局 Hadamard 解决一切”提出了反例。它的观察是:LLM 的激活里有两类离群值,一类是”普通离群值”(normal outliers),在 token 之间稳定出现;另一类是”巨幅离群值”(massive outliers),只在少数通道、少数 token 上出现。全局 Hadamard 对第一类有效,但会把第二类的能量摊到整块矩阵上,而均匀化之后仍可能留下块与块之间的不均衡,导致按块量化的 scale 差异很大。
DuQuant 的方案是三步变换:先按离群通道的位置构造分块对角旋转矩阵,把每个块内的离群值”摊平”;再用”之字形”(zigzag)置换把高幅值通道轮流分配到不同的块里,保证块间幅值均衡;最后再做一次旋转进一步平滑。整个过程不依赖全局稠密矩阵,量化时间从 QuaRot 的 20 分钟量级降到 50 秒量级(LLaMA2-7B,单卡 A100)。下面是论文里的激活矩阵变换示意:
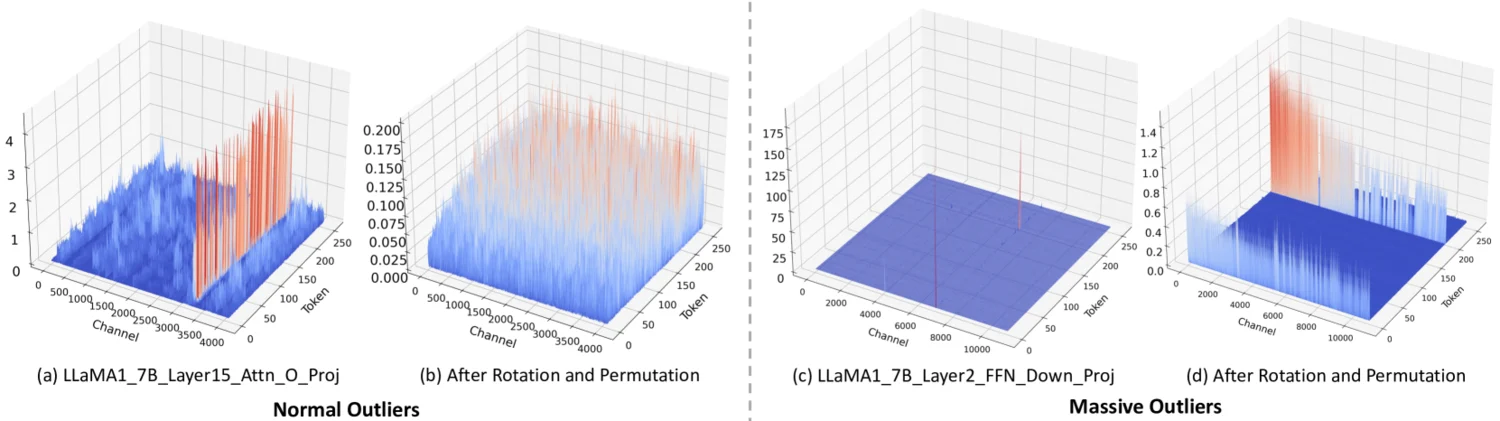
三个面板分别是原始激活、旋转加置换之后、再做一次旋转之后。可以看到原始矩阵里少数行/列的幅值明显偏高(颜色更亮),旋转后能量被均匀铺开,而置换让高幅值不再集中在某个块。这里的”旋转”是分块小矩阵,不是 ;分块的好处是每个块只混合局部通道,量化时的 scale 可以按块设置。
论文给出的对比数据也支持这个设计。在 LLaMA2-7B 的 W4A4 设置下,QuaRot-RTN 的 WikiText2 困惑度是 9.66,DuQuant 是 6.28;LLaMA1-7B 上分别是 7.08 与 6.40。同一个模型、同一个 bit 宽度,差别全部来自旋转矩阵的结构和置换。下面的热力图是另一组直接对比,左侧是全局 Hadamard 处理后的激活,右侧是 DuQuant 的分块方案:
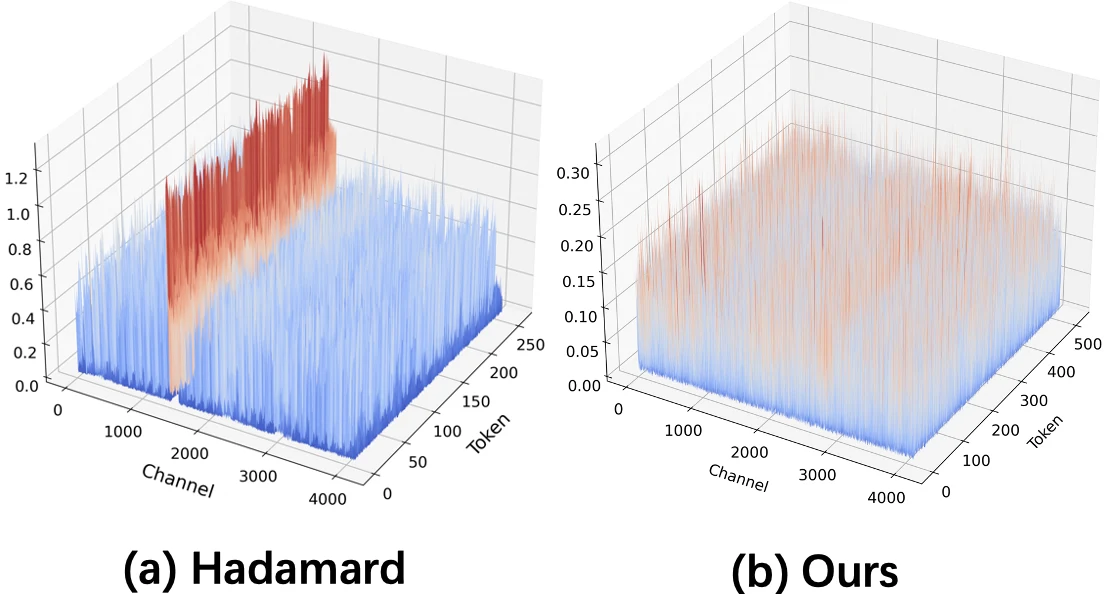
图注为 LLaMA2-7B 的 key_proj 激活;左图 (a) 是全局 Hadamard,右图 (b) 是 DuQuant 的分块旋转加置换。两侧的颜色标尺一致,可以直接比较:全局 Hadamard 之后仍有局部亮斑,分块方案把亮斑进一步抹平。这个对比说明”Hadamard 好不好”不是一个二值问题,而要问”用多大的块、配什么置换、跟哪种量化粒度搭配”。
KV Cache 侧的 TurboQuant
vLLM 的 TurboQuant 把 Hadamard 用在 KV Cache 的向量量化上:先把每个头维的 key/value 做随机 Hadamard 旋转,再用 Lloyd–Max 标量量化器拟合旋转后的分布,最后把 3-bit 码字写进分页缓存。旋转在这里的作用与权重侧一致,但多了一层动机:TurboQuant 的量化器是按高斯分布设计的 Lloyd–Max,而旋转后的分布更接近高斯,量化器的最优性假设才成立。站内 vLLM TurboQuant 源码拆解 给出了 kernel 的逐段分析,这里只需要记住一点:旋转把”任意分布”变成”近似高斯”,从而让固定量化器的失真接近理论下界。
融合 kernel:旋转不能单独存在
在真实推理系统里,一次 Hadamard 变换如果单独作为一个 kernel 发布,意味着一次额外的显存往返:读激活、写旋转结果、再读回来做量化。对 decode 这种每个 token 只有几 MB 激活的场景,这次往返可能比变换本身还贵。所以生产实现倾向于把”Norm→RoPE→Hadamard→量化→写 KV”融进同一个 kernel。站内 DeepInfer 的 fused_transform 拆解 就是一个完整例子:RMSNorm、RoPE、Hadamard、分块量化与分页 KV 写入被组织成一个五段流水,Hadamard 只是其中一段,但它的存在决定了整条流水不能按算子边界切开。
GPU 上的 FWHT:从 warp shuffle 到 Tensor Core
理论上的 只说明渐近复杂度,真正决定”旋转能不能用”的是常数。一个 4096 维、batch 为 1 的激活矩阵只有 8 KB 数据,如果 kernel 写得好,变换时间在微秒级;写得不好,光是线程同步和 shared memory 转置就能把它拖到几十微秒,抵掉整个量化层的收益。这一节按”数据怎么放、层怎么分、同步怎么做”拆开讲。
参考实现:Dao AI Lab 的 fast-hadamard-transform
目前大多数量化工作(QuIP#、QuaRot、SpinQuant)用的是 Dao AI Lab 的 fast-hadamard-transform。它的并行方案可以概括为一个 threadblock 处理一行,行内按如下布局切分:
row of length n -> [ n_chunk ][ warps_per_block ][ 32 lanes ][ 8 elements ]每个线程持有一个 连续元素的 chunk,所有线程的第 0 个 chunk 在内存里连续,然后是第 1 个 chunk,依此类推。这样做的目的不是好看,而是让每一阶段的”配对元素”尽量落在同一个线程、同一个 warp 里:
- 阶段 :配对元素在同一个线程的 8 个寄存器里,纯寄存器操作,不需要任何通信;
- 阶段 :配对元素在同一个 warp 的不同 lane 上,用一次
__shfl_xor_sync交换即可,符号由 lane 的奇偶决定; - 阶段 以及更大:配对元素跨 chunk,先把数据写回 shared memory 并做一次转置,让原本”跨 chunk”的维度变成”chunk 内”的维度,再重复上面的寄存器与 warp 流程;
- 如果 超过一个 threadblock 能覆盖的范围(该库支持到 ),最后再把每个线程的 8 个 chunk 转置成 8 段长度为 的连续数据,在寄存器里完成高位维度的变换。
这个布局的聪明之处在于,它把 层里的前 8 层()全部留在了寄存器与 warp 内,只剩最后几层需要 shared memory。按 HadaCore 对 Dao 库实现的拆解,整个流程在 15 层()里只需要 2 次 threadblock 级同步,这是它能把变换压在带宽上限附近的前提。
下面是一段只保留骨架的 CUDA 片段,展示 warp 内阶段如何用 shuffle 完成,省略了 shared memory 转置与归一化:
// 每个 lane 持有 8 个连续元素,元素全局下标 = lane * 8 + j// 阶段 h = 1, 2, 4 在寄存器内完成;h = 8..128 用 warp shuffle。for (int h = 8; h <= 128; h <<= 1) { const int lane_mask = h / 8; // 配对 lane 的异或掩码 const bool high = (lane & lane_mask); // 本 lane 属于对的高半还是低半 #pragma unroll for (int j = 0; j < 8; ++j) { float other = __shfl_xor_sync(0xffffffffu, x[j], lane_mask); x[j] = high ? (other - x[j]) : (x[j] + other); }}这里有一个实现细节值得注意:__shfl_xor_sync 要求同一个 warp 内所有参与线程都执行同一条指令,因此循环边界和掩码必须统一。如果某个 lane 因为分支提前退出,shuffle 的结果就是未定义的。这也是为什么这类 kernel 通常把边界条件放在外层,而不是在蝴蝶运算内部做 if (idx < n)。
HadaCore:把 16 阶旋转交给 Tensor Core
HadaCore(arXiv 2412.08832,IBM 与 Meta 合作)换了一个角度:既然 GPU 上最快的是 Tensor Core,而 Hadamard 变换本来是为了避免矩阵乘,那能不能把”若干层蝴蝶”重新组织成一个小矩阵乘,让 Tensor Core 来算?
答案是肯定的。 阶 Hadamard 变换可以写成 ,其中 是一个 的数据块。Hopper 之前的 mma.m16n8k16 指令可以做 的乘加,两次 mma 就能完成一次 的矩阵乘。于是 HadaCore 把传统 FWHT 的基例从”2 阶蝴蝶”换成”16 阶矩阵乘”:
- 把 的行向量 reshape 成 ;
- 对每一行做 (等价于左乘 );
- 转置,再对每一行做 ,再转置回来。
这三步合起来正好是 。由 Kronecker 积与矩阵化的关系,
取 就得到 的完整变换。也就是说,一次 16 阶 Tensor Core 变换 + 一次转置 + 再一次 16 阶变换 = 256 阶 Hadamard。对于 ,把 看成 的矩阵,先按行做 256 阶变换,再转置成 ,此时”高位维度”变成了连续的列,用同样的 256 阶流程处理,再转置回来。
这个方案在 FLOPs 上其实更贵:传统 radix-2 需要 次浮点运算,HadaCore 的 16 阶基例需要 ,多了一倍。但 Tensor Core 的峰值是 CUDA core 的约 8 倍,而且层数从 降到 ,同步次数与地址计算量都大幅下降,所以实测仍然更快。论文的原话是:用 Tensor Core 做 16 阶基例,“多花的 FLOPs 换来的是少得多的数据搬运和同步”。
对于不是 16 的幂的尺寸,HadaCore 把 分解成 (),前面的 用 Tensor Core 流程,最后一步用一个”对角拼接”的 矩阵把剩下的 维处理掉。例如 时最后一层是 Hadamard 沿对角线重复 8 次,仍然走一次 mma,只是矩阵更稀疏。
实测:快了多少
HadaCore 与 Dao 库在 A100、H100 上逐尺寸对比,结论是:A100 上平均提升 1.1 到 1.4 倍,个别尺寸峰值 3.5 倍;H100 上平均 1.0 到 1.3 倍,峰值 3.6 倍。A100 的加速曲线如下:
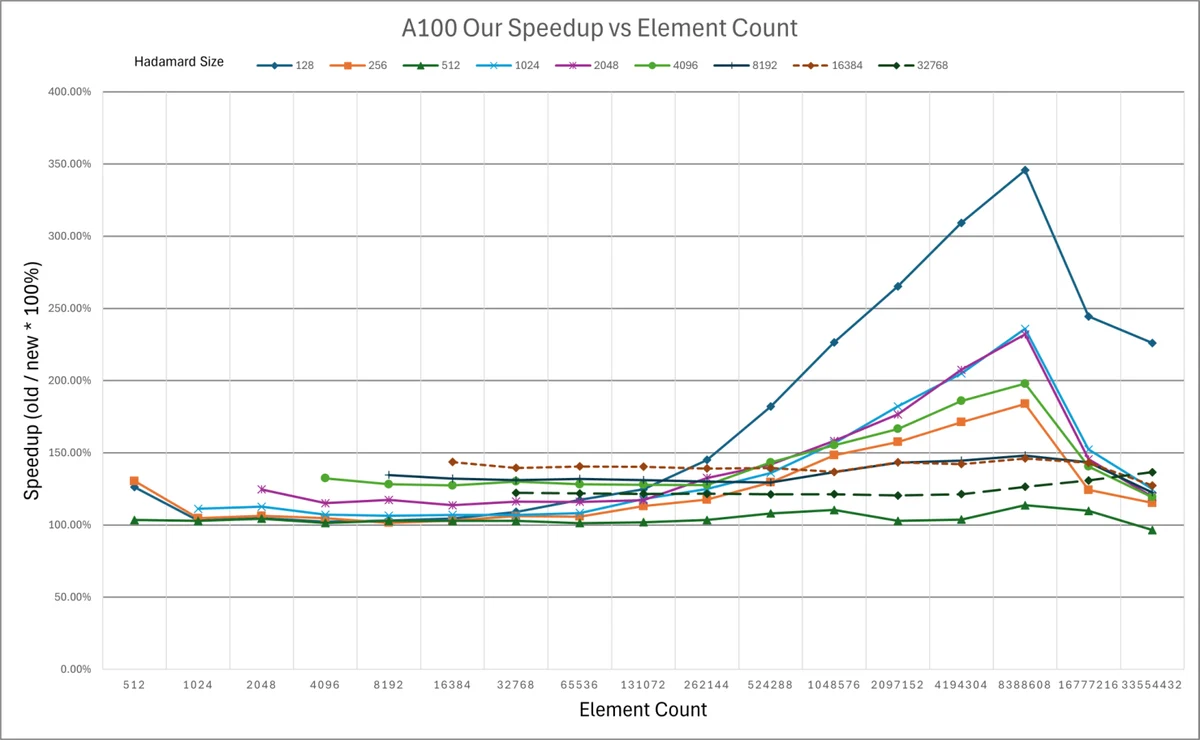
横轴是 Hadamard 阶数(从 128 到 32768),纵轴是相对加速比。曲线不是单调的:小尺寸上固定开销占比高,加速比波动较大;512 附近因为第一次跨过 256 边界,shared memory 转置的开销开始出现,形成一个相对低谷;再往上 Tensor Core 的吞吐优势逐渐占主导,多数尺寸落在 1.1 到 1.4 倍之间,个别尺寸达到数倍。论文自己也解释了 8K 附近的回落:从 4K 到 8K 需要完整的 4 次 迭代,而 4K 只需要 3 次,多出来的一次迭代让 8K 的收益被摊薄。这个形状很符合”固定开销 + 吞吐收益”的模型:尺寸越大,Tensor Core 的吞吐优势越能摊薄固定开销。
真正让这条路线有说服力的不是 kernel 加速比,而是端到端精度。论文用 LLaMA-3.1-8B 做 5-shot MMLU,在 FP8 注意力的设置下比较”不旋转、Dao 旋转、HadaCore 旋转”三种实现:
| 实现 | 平均 5-shot MMLU 准确率 |
|---|---|
| FP16 基线 | 65.38 |
| FP8 注意力,不旋转 | 64.40 |
| FP8 注意力 + Dao Hadamard | 65.45 |
| FP8 注意力 + HadaCore | 65.09 |
不旋转时 FP8 掉了将近 1 分;加旋转后不但补回来,还略高于 FP16 基线(这部分差异可以理解为旋转与 FP8 缩放的交互,不能简单归因于”旋转提升了模型能力”)。HadaCore 的 65.09 与 Dao 的 65.45 在 MMLU 的统计噪声范围内,说明 FP16/BF16 下的 Hadamard 变换没有引入额外的精度损失。
把变换、量化与存储串成一条链
单个 kernel 快,不等于整条链路快。Hadamard 变换在推理系统里通常夹在”归一化 → 量化 → 写入”和”读取 → 反量化 → 矩阵乘”之间,任何一环留下一次显存往返,都会把理论收益吃掉。这一节把”变换在哪里发生”分成四种情形,逐一说明数据流。
情形一:权重侧,离线融合
只影响模型权重的旋转(例如 QuIP# 的 ,或 QuaRot 的 头维旋转),量化时就地计算即可:读原始权重、变换、量化、写回新权重文件。推理时零额外开销,因为量化后的权重已经是旋转后的版本,运行时只需要对激活做一次旋转。这类旋转的代价完全落在”离线量化”这一步上,对推理延迟没有影响。代价是量化流程变复杂:必须在 GPTQ/AWQ 这样的逐层量化之前插入变换,变换所用的符号向量要随权重一起保存。
情形二:激活侧,在线但按层摊销
必须在前向里做的旋转(QuaRot 的残差流旋转、FFN 下投影前的旋转、query/key 的头维旋转),每次前向都执行一次。以一层 7B 模型、 为例,每层一次变换的代价大致是 次浮点运算,相对该层几亿次的 GEMM 来说微不足道,它真正影响的是 kernel 调度的复杂度:每个变换都要独占一个 kernel,意味着一次 launch、一次全局内存读写。在 decode 阶段每步只有几十微秒的情况下,一次额外的 5 微秒 kernel 就是 10% 的延迟。真实实现因此会把它和相邻的算子融合,例如和 RMSNorm 融合、和量化融合。
情形三:KV Cache 侧,按 token 在线
写缓存时对每个 token 做一次变换,之后缓存里存的都是旋转后的坐标。这条链路的关键是”读写坐标必须一致”:读缓存做 attention 时,query 也必须在同一个坐标里,才能让点积不变。由于 RoPE 的角度随位置变化,这一步的旋转必须在 RoPE 之后、写缓存之前完成,且 query 的旋转要和 key 完全同步。这就排除了”把 key 提前在 prefill 阶段一次性旋转好”的捷径:同一个 token 在不同层、不同位置下对应的 RoPE 角度不同,缓存里存的是已经旋转过的 key 值,本身已经包含了位置信息,不能再旋转第二次。
一个实用的工程约束是:key 的头维旋转必须按头进行,不能跨头混合。不同头对应不同的 key 子空间,跨头做 Hadamard 会把它们混在一起,query 侧无法用同样的方式还原;除非对 query 也做完全相同的跨头混合,但那会把不同头的注意力分数耦合起来,代价远大于收益。QuaRot 的头维方案是 :块对角结构,每块是一个头内的 Hadamard,头与头之间不混合。这个结构之所以重要,是因为它保证旋转后的 key 仍然可以按头独立反变换,缓存里每个头的向量都还是原来那个头的坐标系,只是换了一组基。SpinQuant 后来改用只旋转头维的 ,并把它完全融进 与 ,正是为了避开 这类跨头结构在张量并行下的划分难题。
情形四:权重与激活同时旋转
QuIP# 对权重和 Hessian 同时旋转,QuaRot 对权重与残差流同时旋转。这种情况的数据流是”右侧激活 变换 → 与量化权重相乘 → 变换 → 下一层”。每一层两端各一次变换,看起来开销翻倍,但两次变换都可以与相邻的 Norm 或 GEMM 的 epilogue 融合。站内 GEMM Epilogue 完全拆解 讨论过 epilogue 里写回数据时可以顺便完成布局重排,Hadamard 的输出变换正是这类重排的一个特例。
一个容易踩的坑:量化粒度与块边界
Hadamard 的块越大,摊平效果越好,但量化时通常按”组”(group,常见 64 或 128 个元素一组)设一个 scale。如果变换的块和量化的组边界不对齐,就会出现”一个组里跨了两个变换块”的情况,两个块的分布不同却共用一个 scale,摊平效果被削弱。实践中的经验是让块大小 ≥ 组大小,并且对齐到组大小的整数倍,例如 4096 维的变换配 128 的组大小,正好 32 个组。DuQuant 的分块方案则反过来,把块大小直接与量化组绑定,以块为旋转单位、以组为量化单位,两者一一对应。
数值精度:旋转是精确的,实现不是
从线性代数看,Hadamard 是正交变换,,做多少次都不损失信息,反变换就是自己。但从浮点实现看,有三处会引入误差,而且这三处恰好都在量化最敏感的区段。
误差一:蝴蝶运算的舍入累积
一次 的变换有 12 层,每层一次加法或减法。若每层的相对误差是 (FP16 约 ,BF16 约 ),最坏情况下误差按层数线性累积,达到 ;按随机游走估计则是 。相对向量的 L2 范数,这个误差与变换本身是同一个量级的小量,对 8-bit 量化完全可以忽略;但对 FP4 这种只有 16 个格点的量化, 的扰动就可能跨过格点边界。所以低比特量化前的 Hadamard 通常在 FP32 下做,或者至少用 BF16 输入、FP32 累加的混合精度。
误差二:中间值的动态范围
未归一化的 在每一层的中间结果是”部分和”,最大值可以到 。如果输入里有 32768 量级的离群值(FP16 最大 65504),两个这样的值相加就已经溢出。归一化版本把每层缩放 ,中间结果的 L2 范数保持不变,但缩放本身也有舍入。工程上的做法有三种:
- 全部在 FP32 下算,代价是带宽翻倍;
- 输入先乘一个 2 的幂做预缩放,算完再乘回来,用精确的 2 的幂缩放避免额外误差;
- 每层的归一化因子不用 ,改用精确的 。这样总缩放是 ,比标准的 多出一个 的常数因子,但因为它对整层是常数,可以在量化 scale 里吸收掉,不影响输出。
第三种做法在实现上最省事: 是二进制精确可表示的,不会在每一层引入舍入。代价是整体幅值随层数缩小 倍,例如 时缩小 64 倍,4096 维上一百万量级的输入在最后一层只剩一万多;如果输入本身就已经很小,中间值可能进入 FP16 的次正规数区间。因此需要先把输入整体放大一个 2 的幂作为补偿,具体倍数由校验过的最大值范围决定。
误差三:变换后分布变”稠密”,量化器反而更难
旋转把离群值摊平,代价是每个元素都变成非零。这对稀疏化、剪枝、2:4 结构化稀疏是灾难性的:旋转前一个权重矩阵可能有 70% 的元素接近零,可以安全剪掉;旋转后没有一个元素是零,剪枝率立刻掉到 0。Hadamard 与稀疏化是互斥的两种压缩手段,不能指望同一套流程同时拿到两者的收益。
对逐通道量化的影响更微妙。以 AWQ 为例,它的核心是”按输入通道给权重乘一个 scale,把激活的离群值转移到权重上”,这个操作依赖”每个输入通道有独立的 scale”这一结构。如果在已经做过的逐通道缩放之上再套一个全局 Hadamard,scale 会被混进所有通道,AWQ 精心构造的逐通道差异被抹平,收益会大打折扣;反过来,如果先旋转再在旋转后的坐标里做逐通道缩放,那只是把同一件事换了个坐标系做。两者的取舍在于:AWQ 依赖”离群值固定在少数输入通道”这个经验事实,旋转则假设”离群值的位置不必保留”,后者的泛化更强但丢掉了通道局部性。
GPTQ 的情况类似但不完全相同。GPTQ 沿输入维度逐列更新,利用 Hessian 的逆给出”每列的量化误差会如何影响后续列”的修正量,它的计算量大致与”每列需要修正的后续列数”成正比。旋转后 Hessian 变成非相干的稠密矩阵,每个量化误差都会影响到几乎所有后续列,逐列更新的工作量上升一个量级。这正是 QuIP# 用块级 LDLQ 替代 GPTQ 的原因:在非相干坐标里,把”列”换成”块”,只在块内做线性反馈修正,块间不传播误差,计算量回到可控范围。代价是块间误差不再被校正,靠码本的最小距离来兜底。
SpinQuant 的消融给出了一个侧面的证据:它随机抽了多组 Hadamard 旋转,不同组的零样本平均分差可以达到 13 个点。这说明”旋转矩阵的选择”本身是一个需要优化的变量,而不是”随便一个 Hadamard 都行”。SpinQuant 的解法是把旋转矩阵参数化在 Stiefel 流形上,用 Cayley 变换保证正交性,再用少量校准数据做端到端优化。代价是校准时间(8 卡、7B 约 1.25 小时),收益是 LLaMA2-7B 的 W4A4KV4 与全精度的零样本差距收窄到 2.9 分,并且在 LLaMA3-8B 这种”难量化”的模型上把 QuaRot 的剩余差距再缩小 45.1%。站内 SpinQuant 完全拆解 有 Cayley 参数化与四类旋转位置的完整推导。
一个必须澄清的误解:旋转不”消除”离群值
“Hadamard 能消除离群值”是一个流传很广但不准确的表述。旋转是正交变换,向量的 L2 范数不变,离群值包含的能量一个比特都没有减少。它改变的只是”能量在坐标上的分布”:从集中在几个坐标,变成分散在所有坐标。对于均匀量化,这等价于把动态范围压小;对于基于 L2 误差的码本量化,这等价于把误差在各维之间平均;但对于需要保留坐标结构的量化(逐通道、分组、稀疏),旋转反而可能有害。判断一次旋转值不值得,不能看”最大元素降了多少”,而要看”量化器是否只需要总能量和近似高斯这两个统计量”。QuIP# 的码本、TurboQuant 的 Lloyd–Max、QuaRot 的 per-token 量化都属于后者;AWQ 的逐通道缩放、KIVI 的 per-channel Key 属于前者,它们和旋转是竞争关系而不是叠加关系。
什么时候不该用 Hadamard
把前面的讨论收拢成一个判断表,比一条条记结论更实用。选不选 Hadamard,取决于四个变量:量化粒度、是否依赖通道结构、比特宽度、变换能否融合。
| 场景 | 建议 | 理由 |
|---|---|---|
| 权重 W4A16,激活保持 FP16 | 可以用,但收益有限 | 权重本身接近高斯,旋转后分布变化不大;且不需要激活变换,只有离线一步 |
| 权重 + 激活 W4A4 | 强烈建议 | 激活的离群通道是主要瓶颈,旋转是唯一不改量化器就能解决的手段 |
| KV Cache 4-bit 以上 | 可用作辅助 | 配合 per-token/per-head 量化,旋转主要用来修正分布尾部 |
| KV Cache 2-bit 附近 | 要与码本/Lloyd–Max 配合 | 均匀量化在 2-bit 下格点太少,旋转只能把误差摊匀,不能提高分辨率 |
| 2:4 结构化稀疏 | 不应使用 | 旋转后不再有可剪的零元素 |
| 逐通道量化(AWQ/KIVI 类) | 慎用或代替使用 | 旋转与通道局部性是竞争关系 |
| 端侧 CPU 推理 | 谨慎 | 变换需要 CPU SIMD 实现,llama.cpp 这类框架的 k-quants 已经有成熟的块量化,额外旋转不一定划算 |
| 张量并行、头数跨卡切分 | 要注意结构 | Kronecker 因子必须在切分边界上对齐,否则需要在通信之后再做变换 |
最后一行值得再解释一下。在张量并行下, 要按列、按行分别融入两侧权重。如果 的划分恰好与 TP 的切分边界对齐,那么每张卡拿到的都是同一个 Hadamard 的一个完整分块,旋转可以本地做,不需要通信。如果不对齐,每张卡拿到的是一组”跨块”的列,旋转就必须在 AllReduce 之后、完整的隐藏维上做一次,额外付出一次通信同步的代价。这也是为什么实际实现倾向于把隐藏维切成 2 的幂的块,再在外层用小的 处理余数。
从 Hadamard 看量化路线
把上面几篇论文的时间线串起来,可以看到一个清晰的演进:
- 2023 年,QuIP 提出非相干性作为量化的理论基础,用两因子 Kronecker 正交矩阵做变换,证明”先摊平再量化”可以把误差和模型规模解耦;
- 2024 年初,QuIP# 把变换换成 RHT,把标量量化换成 格码本,非相干性从 改进到 ,同时第一次展示 3-bit 优于 4-bit;
- 2024 年中,QuaRot 发现 RMSNorm 的逐元素缩放可以吸收进权重,于是把 Hadamard 从”权重离线变换”扩展到”整个前向的坐标换基”,让 W4A4KV4 在 LLaMA 上落地;
- 2024 年底,SpinQuant 把旋转矩阵参数化为可学习变量,用 Cayley 变换在 Stiefel 流形上优化,并把 LLaMA3 这种难量化的模型的精度差距进一步收窄;
- 2024 年底,DuQuant 反思全局 Hadamard 的局限,提出分块旋转加之字形置换,用更小的块和更聪明的排列获得更好的块内均衡;
- 2024 年底到 2025 年,HadaCore 把变换本身从”蝴蝶算法”重构成”Tensor Core 小矩阵乘”,证明变换的 kernel 设计还有一到数倍的提升空间。
这条演进线背后是一条越来越清晰的共识:低比特量化的瓶颈已经从”量化器怎么设计”转移到”被量化数据的坐标系怎么选”。而 Hadamard 之所以成为这条路线的主角,是因为它同时满足了三个条件:正交(不改变信息)、元素只有 (不需要乘法)、有快速算法()。三者缺一不可:少了正交性就没有数学等价,少了 就必须做浮点乘法,少了快速算法在线变换的成本就会吃掉所有收益。
对想要进一步深入的读者,接下来值得关注的方向有三个。其一,旋转矩阵的”最优性”到底如何刻画:SpinQuant 用梯度搜索,DuQuant 用启发式构造,HadaCore 只改 kernel 不改数学,三者之间还缺少一个有统一代价函数的框架。其二,旋转与低精度硬件原语的配合:Blackwell 之后的 Tensor Core 支持 FP4 与混合精度,Hadamard 的 结构能否直接用整数 MMA 指令表达,已经有人在尝试。其三,旋转与稀疏/量化的联合:前面提到的”旋转破坏稀疏性”,反过来也意味着”稀疏化的前提是不做旋转”,两条压缩路线的组合最优解还没有定论。
小结
Hadamard 变换在量化里的地位,可以归纳成一句话:它是一个免费的正交换基。说”正交”,是因为它不改变向量的长度、内积和线性层输出,量化前后的数学等价关系是严格的;说”免费”,是因为它的每个元素只有 ,做一次变换只需要加法和减法, 的蝴蝶算法让 4096 维的变换在 GPU 上只需要一次 kernel launch 的时间量级,而且还自逆,同一个矩阵可以同时当正向和反向用。
它的收益来自一个简单的观察:均匀量化的误差与数据最大值的平方成正比,而 Hadamard 旋转把”最大值”从 压到不超过 ,在数据有少数尖峰时能压几个数量级。它的代价同样明确:必须存随机符号、必须在正确的位置做变换、必须把变换融进相邻的 kernel、而且它和依赖通道结构的量化方法与稀疏化在原理上不兼容。
QuIP#、QuaRot、SpinQuant、DuQuant、HadaCore 这几项工作,分别从”变换的理论性质”、“变换的融合位置”、“变换矩阵的学习”、“变换的块结构”和”变换的实现”五个角度把这个工具打磨到了生产可用的状态。理解了这五个角度,就能在看到一个具体的量化方案时,判断它为什么这样选旋转、为什么不那样选。
参考资料
- QuIP: 2-Bit Quantization of Large Language Models With Guarantees
- QuIP#: Even Better LLM Quantization with Hadamard Incoherence and Lattice Codebooks
- QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs
- SpinQuant: LLM quantization with learned rotations
- DuQuant: Distributing Outliers via Dual Transformation Makes Stronger Quantized LLMs
- HadaCore: Tensor Core Accelerated Hadamard Transform Kernel
- Dao-AILab/fast-hadamard-transform
- DuQuant 官方代码仓库
- HadaCore 内核源码(pytorch-labs/applied-ai)
- Fino and Algazi, Unified Matrix Treatment of the Fast Walsh-Hadamard Transform (IEEE Trans. Computers, 1976)
文中插图来源:QuaRot 论文 Figure 1(图 1)、QuIP# 论文 Figure 2(图 2)、DuQuant 论文 Figure 2 与 Figure 4(图 3、图 4)、HadaCore 论文附录 A 的 A100 加速比曲线(图 5)。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



