


SpinQuant 完全拆解:学出来的旋转矩阵如何把 LLM 压进 W4A4KV4
背景:旋转已经能消除离群值,但它还缺一步
把权重、激活、KV 缓存一起压到 4-bit(W4A4KV4)是端侧推理和长上下文服务共同盯着的目标。解码阶段受显存带宽限制,权重位数减半,单 token 要读的字节就减半;KV 缓存从 FP16 降到 4-bit 省下 4 倍显存,同一张卡能多撑 4 条长序列。难点不在权重:二阶方法早已把 4-bit 权重做到几乎无损,GPTQ 用 Hessian 信息逐列补偿,AWQ 只保护约 1% 的显著通道。难点在激活。
LLM 的隐藏状态里存在系统性的离群通道(outlier channel),幅值比普通通道大一个量级以上,并且跨 token、跨层稳定出现。LLM.int8() 是最早系统记录这一现象的论文之一,它把这些通道单独拎出来用 FP16 计算;SmoothQuant 则用按通道缩放把激活的量化难度等价迁移到权重上,从而做到 W8A8 无损。一旦目标从 8-bit 压到 4-bit,这两条路都走不通:4-bit 对称量化只有 16 个格点,残留下来的动态范围仍然远大于 16 个格子能表达的范围。
2024 年春季出现了另一条路线:旋转。QuaRot 把权重与激活用正交矩阵(通常是 Hadamard 矩阵)做等价变换,在坐标系里把离群值摊平。正交变换不改变向量长度,原本集中在少数坐标轴上的大分量被均匀摊到所有轴上,量化网格不再被极端值独占。我们在 QuaRot 拆解 里讲过完整构造:RMSNorm 的缩放可以折进下游权重,输出投影的旋转可以折回残差流,于是端到端 4-bit 第一次变得可行。
QuaRot 的经验里有一个容易被忽略的细节:它用的是随机旋转。随机抽一个带符号的 Hadamard 矩阵,量化完直接交付,不做任何筛选。统计上这”大概率不差”,但 Meta 的研究者在后续工作中发现了一个不稳定现象:同一套流程、换一个随机种子生成旋转矩阵,量化后 LLaMA-2 7B 在 8 项零样本常识推理任务上的平均准确率能相差十几分。换句话讲,旋转矩阵本身是一个可优化变量,而此前没有人认真优化过它。
SpinQuant 就是针对这一步提出的。Meta 的 Zechun Liu、Changsheng Zhao、Igor Fedorov、Bilge Soran、Dhruv Choudhary、Raghuraman Krishnamoorthi、Vikas Chandra、Yuandong Tian、Tijmen Blankevoort 在 2024 年 5 月挂出预印本(arXiv 2405.16406),同年被 NeurIPS 2024 接收,代码与优化后的旋转矩阵开源在 facebookresearch/SpinQuant。它的核心主张一句话可以说清:在保持全精度网络输出不变的前提下,把可吸收进权重的旋转矩阵变成可学习参数,用 Cayley SGD 在正交矩阵集合(Stiefel 流形)上直接最小化量化后网络的损失。
先看一组数据建立直觉。论文 Figure 3 测量了 LLaMA-2 7B 中 Q/K/V/Up/Gate 五个投影层输入激活的峰度(kurtosis,衡量分布尾部厚度的统计量):旋转前很多层的 超过 200,而高斯分布的 约等于 3;用一个随机旋转后,所有层的 都回落到 3 附近。峰度从 200 降到 3,意味着”极端值把量化范围撑爆”这个根因被拆掉了。
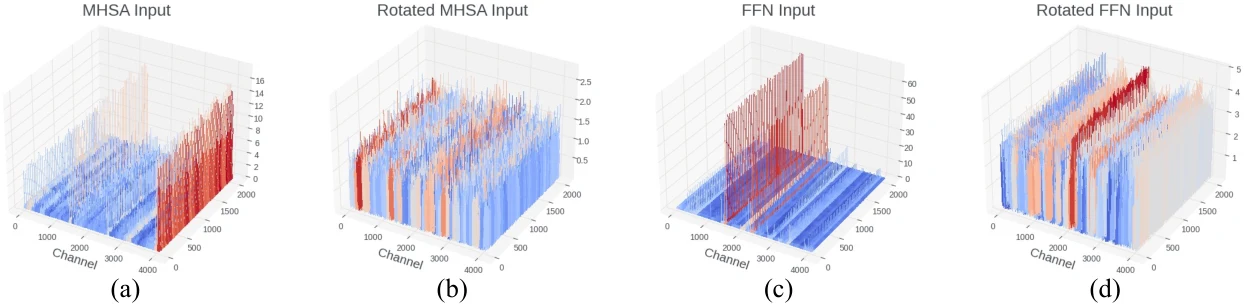
图 1 的读法很直接:旋转前每个子图都竖着一两根”刺”,那是对应的离群通道;对整条 token 做对称量化时,scale 由最高的刺决定,底部绝大多数通道只能分到一两个量化格。旋转后刺被磨平,通道幅值趋于一致,scale 变小,每个通道分到的有效格数变多。这就是”旋转改善量化”的全部直觉,后面所有机制都是围绕它做工程化。
拿一个四维向量把这个过程算一遍。设某个 token 的隐藏状态是 ,做 4-bit 对称量化。对称量化的缩放因子是
于是四个分量被映射成 、、、,四舍五入后分别是 、、、——除了离群通道,其余三个分量全被抹成零,反量化回浮点后它们的信息彻底丢失。这就是”一根刺吃掉所有有效位”的具体样子。
现在用一个归一化 Hadamard 矩阵旋转这个向量(,):
四个分量几乎相等,,。这次量化后的整数是 ,反量化回来是 ,绝对误差最大约 ;作为对比,旋转前三个小分量的绝对误差是它们的全部幅值(、、,量化后直接变成 ),相对误差 100%。旋转后用绝对误差换掉了相对误差的灾难——更重要的是信息没有丢:小分量被均匀编码进了每个坐标,而不是被一个 scale 挤成零。这就是正交变换保持范数、同时把”量化网格利用率”最大化的机制。
真实模型里 ,离群通道不是一个而是几十上百个,旋转后每个分量的幅值约等于 ,从而 从”离群值 / 7”降为"",每个普通通道分到的格数提升一到两个数量级。这就是为什么同一套量化规则,旋转前后会有 30 分的差距。
旋转为什么等价:RMSNorm 与线性层的吸收点
要理解 SpinQuant 为什么”不改变全精度网络”,必须先看清旋转矩阵在 Transformer 的哪些位置可以被无损吸收。这套等价性在 QuaRot 里已经建立,SpinQuant 沿用它,并把其中两处吸收点变成可学习参数。
统一记号:隐藏维度 ,注意头数 ,每头维度 ,MLP 中间维度 。全部使用列向量约定,即隐藏状态 是一个列向量。旋转方式统一定义为
也就是”残差流被 旋转”,其中 是正交矩阵,满足 。这样约定之后,权重吸收的形式会非常对称:读残差流的权重在右边乘 ,写回残差流的权重在左边乘 ,旋转被”夹”在中间。
第一处:RMSNorm 之后的读投影
RMSNorm 对每个 token 计算
其中 是逐通道的可学习缩放, 是逐元素乘。因为行向量范数在正交变换下不变,所以
注意右边只剩 这一项, 不见了——逐通道缩放只对固定的坐标轴有意义,在旋转后的坐标系里它不再是逐通道的。QuaRot 的技巧是把 折进右侧的权重:任何读取残差流的线性层(、、、、 投影)原本计算 ,改成
验算一步就够:
把旋转吃掉,输出与原网络逐位相同(忽略浮点舍入)。代价是 不再等于原权重:它先乘了 、又右乘了 ,这一步在离线量化阶段完成,推理时只加载 。
第二处:写回残差流的输出投影
残差流是被所有层共享的”公共总线”。旋转后残差变成 ,那么每一层写回残差的内容也必须是旋转坐标系下的表示,否则加法会混用两套坐标。令某个写回项原本为 (列向量),它需要以 的形式加进残差。对输出投影 ( 是注意力输出),只需把权重改成
于是 ,正好落在旋转后的坐标系里。 同理:MLP 的输出本来就是原坐标系下的向量,写回前必须再转一次,所以 。最终输出头的 读的是最后一层残差(旋转坐标系),并且前面有最终的 RMSNorm,因此它同时吃 与 :。
为什么必须成对,以及为什么不能越过非线性
等价性的关键在于”旋转在路径上成对出现”。读投影右乘 、写投影左乘 ,两者在残差加法处相遇并互相抵消。如果只做一半——比如只在 embedding 处旋转、不在写回处旋转——残差流就会混进两套坐标系,模型直接崩掉。
同样重要的是不能越过非线性。残差流经过 RMSNorm、矩阵乘、softmax、SiLU 都是非线性的, 只能”包住”残差加法,不能穿过它们进到模块内部。这解释了为什么残差旋转之后,模块内部还需要另外两类旋转: 处理注意力块内部的 空档, 处理 MLP 内部的元素乘与非线性的空档。
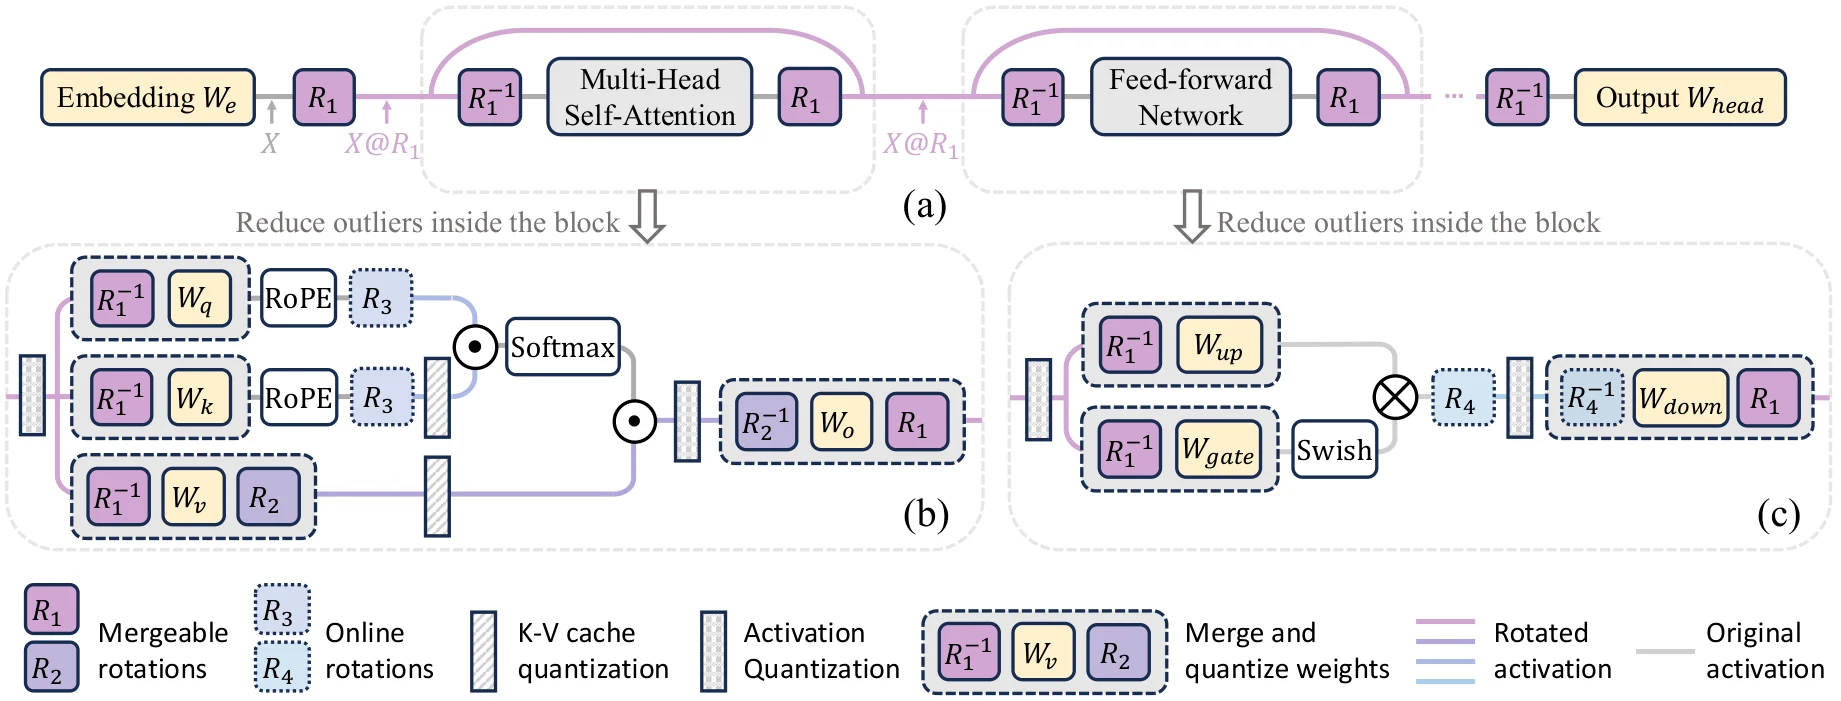
图 2 是整篇文章的总图,把四类旋转的位置一次画全。读图时注意两点:其一,、 画在权重旁边,表示它们可以被吸收;、 画在激活路径上,表示必须在推理时在线执行。其二, 的箭头同时指向残差流的入口和每个模块的输出投影,这正是”成对”的视觉表达。
第三处:注意力块内部的 空档
注意力块内部还有一处没有非线性的空档: 投影输出 ,之后经过对 行的凸组合得到注意力输出 ,再乘 回到残差流。加权求和对 是线性的(组合系数由 softmax 给出,非负且和为 1),所以可以在每个头内插入一个正交矩阵 :
验算: 投影的输出变成 旋转过的版本,注意力输出因此是 ;乘以 时 与 抵消,得到 。与 相比,这里的方向正好是反的—— 作用在输出维度上,所以 左乘 、 右乘 。
这样安排有两个直接收益:第一, 缓存(value cache)的分布被摊平,如果 KV 缓存中的 要量化到 4-bit,旋转后的分布更接近高斯,量化误差更小;第二, 的输入激活(注意力输出)被旋转, 这一层的激活量化因此更容易。两个收益都不需要推理端新增参数: 已经在 、 里了。
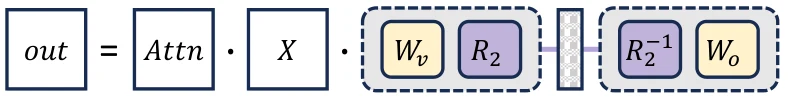
图 3 是一张很窄的流程图,信息量集中在”配对”二字:左侧 投影后接 ,右侧输出投影前接 ,中间是注意力合并。只要中间没有任何非线性,这对矩阵就可以任意选择并且互相抵消。
第三、四处的命名与官方实现
论文把四个旋转矩阵的顺序定得很清楚:
- :残差旋转,,全模型共享一份,可吸收;
- :注意力头内旋转,,每层每头独立,可吸收;
- :KV 缓存写入点的在线 Hadamard,作用在每个头的 上,不可吸收;
- :MLP 下投影输入侧的在线 Hadamard,作用在 之后,不可吸收。
官方代码里这套结构可以直接对上:QuantizeLinear.forward 接一个可选参数 R1,读残差流的层(q_proj、k_proj、v_proj、gate_proj、up_proj)传入 R1,把输入先旋转再量化;写回残差流的层(o_proj、down_proj)传入 R1, transpose=True,表示用转置形式作用在输出侧。MLP 的调用最能说明问题:
down_proj = self.down_proj( self.act_fn(self.gate_proj(x, R1)) * self.up_proj(x, R1), R1, transpose=True,)gate_proj 与 up_proj 都吃旋转后的残差,算完之后做 SiLU 与元素乘——这段仍然在原坐标系;down_proj 在输出侧转回去,把结果写进旋转后的残差。 则通过 self.R2 挂在注意力块上,v_proj 与 o_proj 各取一侧。这段代码与我们上面的公式一一对应,读源码时可以拿公式当注释。
Hadamard 为什么是旋转的首选
可吸收的 、 可以是任意正交矩阵,但不可吸收的 、 必须便宜。这就是 Hadamard 矩阵的用武之地。Hadamard 矩阵 是一个 的矩阵,元素只取 ,并满足
因此归一化后 是正交矩阵,正好可以当旋转用。它有三个性质对推理特别友好。
第一,把最大值压得最低。 对任意正交矩阵 , 至少是 (因为每行范数为 1, 个元素的平方和为 1)。Hadamard 矩阵恰好取到这个下界:所有元素都等于 。QuIP# 论文正是利用这一点给出权重量化误差的紧界——Hadamard 是”最不偏袒任何坐标轴”的旋转。这也解释了为什么随机 Hadamard 比随机正交矩阵的量化结果更好、方差更小:后者的元素幅值分布不均,某些坐标轴会被”转出”更大的分量。
第二,有快速算法。 归一化 Hadamard 变换可以用快速 Hadamard 变换(fast Hadamard transform,FHT)在 时间内完成,而不是 的矩阵乘。对 的头维度,这意味着每层每头只需 次加减法就能完成一次旋转,相对一次 GEMM 可以忽略。官方实现依赖 Dao-AILab 的 fast-hadamard-transform 提供的 CUDA kernel,SpinQuant 的 requirements 里明确要求先安装它。
第三,随机化空间足够大。 给定一个 ,乘以对角矩阵 、,得到的 仍然是 Hadamard 矩阵(只是行符号翻转),一共有 种不同选择。这就是”随机 Hadamard 旋转”的标准做法:随机抽一组符号,得到一个随机但性质优良的旋转。论文也正是用这种随机 Hadamard 矩阵作为 、 的初始化。
对不可学习的 、,Hadamard 还有两个工程上的额外好处。其一是无需存储: 点的归一化 Hadamard 完全由结构确定,推理端不需要为 、 准备权重文件,只需知道维度就能在 kernel 里生成。其二是尺寸可以因子分解:MLP 中间维度经常不是 2 的幂,比如 Llama-2 7B 的 ,而 。官方 utils/hadamard_utils.py 的 get_hadK 对这类维度先按已知的小阶 Hadamard(172、140、108、60、52、36、28……)取一个因子,剩下的幂次部分再用 FHT 处理:
def get_hadK(n, transpose=False): hadK, K = None, None if n % 172 == 0: # llama-2-7b up projection assert is_pow2(n // 172) K = 172 hadK = get_had172().T if transpose else get_had172() elif n % 156 == 0: # llama-1-30b 3x hidden ... elif n % 12 == 0: assert is_pow2(n // 12) K = 12 hadK = get_had12().T if transpose else get_had12() else: assert is_pow2(n) # 其余情况必须是 2 的幂 K = 1 return hadK, K 正好是 2 的幂,所以 可以分解成”172 阶稠密 Hadamard × 64 点 FHT”,而不是硬算 的矩阵乘。matmul_hadU 的实现顺序也印证了这一点:先做 while input.shape[1] > K 的蝶形 FHT 循环,再把结果与 的 hadK 做块乘,最后除以 完成归一化。这个细节决定了 能否真正”边际开销”,因为如果每次在线旋转都要做 的矩阵乘,MLP 的推理时间会被直接拖垮。
可吸收的 、 不需要是 Hadamard。 它们被折进权重,推理时根本不做旋转运算,所以可以是任意正交矩阵——这正是 SpinQuant 能把它们变成学习变量的前提。如果坚持用 Hadamard,就只能在 个离散候选中挑选,无法针对实际分布做连续优化。论文的消融(Table 4)也验证了这一点:优化之后,用随机浮点正交矩阵初始化与用 Hadamard 初始化,最终性能几乎相同;而在优化之前,Hadamard 初始化明显更好。这说明优化过程会自己找到好的旋转,初始化的差异只影响起点。
随机旋转的方差:13 分与 6 分之间的差距
既然任意正交矩阵都能吸收,为什么不直接随机抽一个?论文给出了两组证据。
第一组是方差实验。在 LLaMA-2 7B 上做 W4A4(权重 4-bit、激活 4-bit,KV 保持 16-bit),用 100 个随机种子生成旋转矩阵,测 8 项零样本常识推理的平均准确率:
- 随机正交浮点矩阵:最好与最差之间相差约 13 分;
- 随机带符号 Hadamard 矩阵:分布更集中,但最好与最差之间仍相差约 6 分。
随机 Hadamard 更好是可以预期的:它的元素幅值取到下界,任何坐标轴都不会被”转出”特别大的分量。但”均匀”不等于”针对分布最优”。13 分的差距意味着:在同样的量化位宽、同样的校准数据下,模型能否可用取决于抽到了哪一组随机符号——这在工程上是不可接受的随机性,尤其对大模型,一次坏抽奖可能直接让模型报废。
第二组是几何示例。论文 4.4 节用一个二维、一个三维的例子说明”均匀旋转”与”最优旋转”的差别。二维情形:向量总是沿 轴大、 轴小,旋转 45° 后两个方向的量化范围相当,这是 Hadamard 在二维能做到的最优。三维情形: 的幅值是 的四倍,沿 – 各转 45° 可以把最大幅值从 分出去,但最优解未必是 45°,更不一定能写成三个坐标轴上的均匀旋转。维度越高、离群结构越偏,“均匀旋转”距离最优就越远。
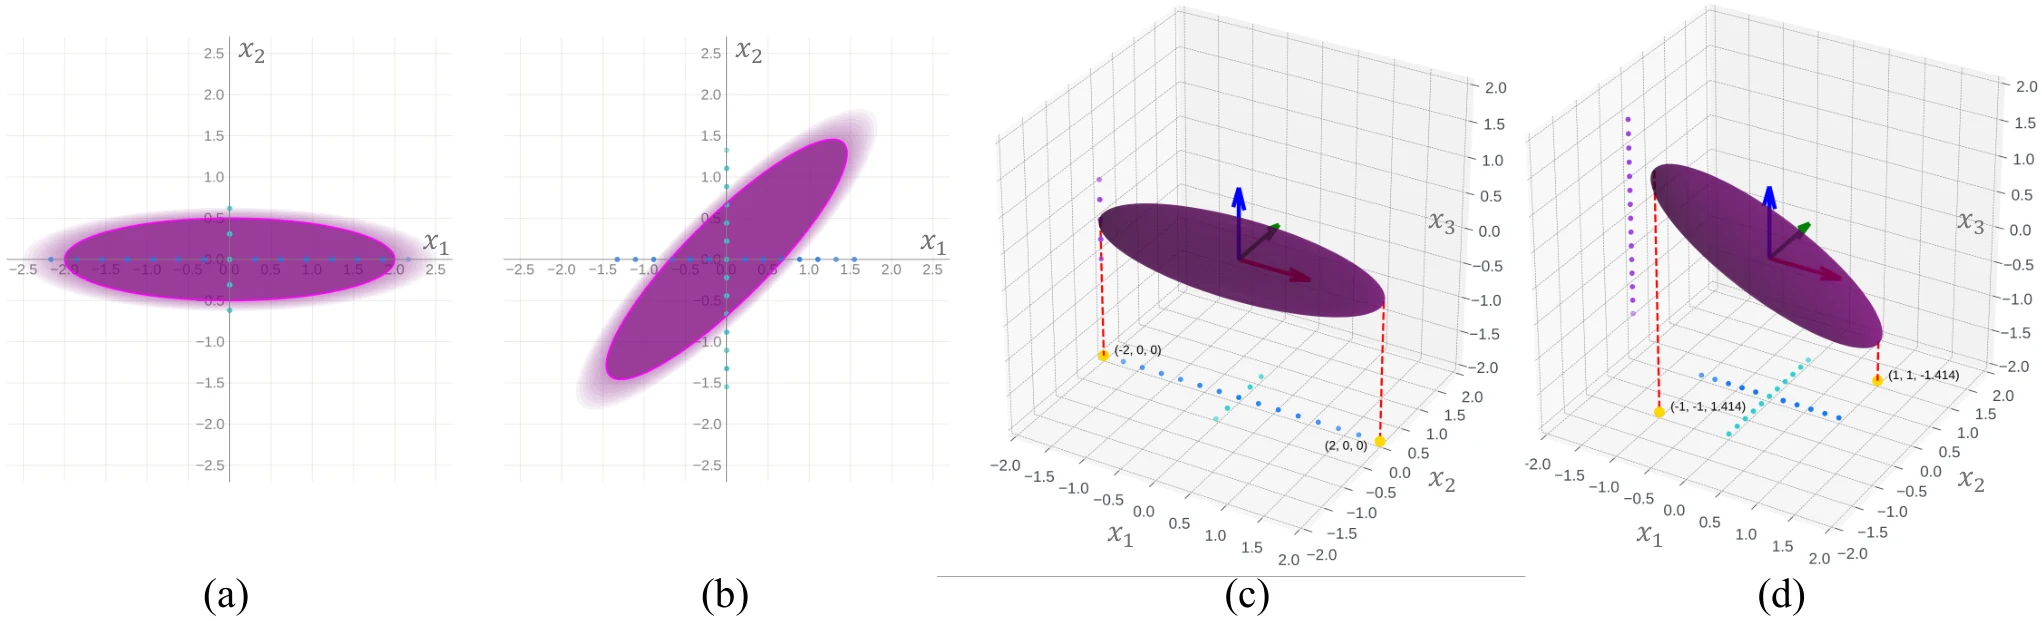
图 4 的四个子图都画在二维/三维坐标系里,横纵轴是分量幅值。信息量不在具体角度,而在一个结论:当分布已知时,理论上存在比 Hadamard 更优的旋转。论文也把”是否存在闭式解”留成了开放问题——给定离群轴与幅值,能否直接算出让各轴幅值最均匀的旋转矩阵?如果能,也许就不需要优化了;但在那之前,学习是可行的工程答案。
于是目标清晰了:在一个固定的预训练权重 与校准集输入 下,寻找正交矩阵 ,使”带量化函数的网络”的损失最小。
优化目标与 Stiefel 流形
形式化地,论文定义优化问题
符号逐个解释:
- 是 Stiefel 流形,即所有满足 的矩阵的集合。它不是一个线性空间:两个正交矩阵相加通常不再正交,所以不能直接做欧氏梯度下降,必须用保正交的更新规则。
- 是带量化的任务损失,论文用交叉熵,在 WikiText-2 校准集上计算。下标 表示”模拟量化”(fake quantization):每次前向时对权重和/或激活先量化、再反量化回浮点,用这个带噪声的算子替代原算子,从而让损失真实反映量化误差。
- 是冻结的预训练权重, 是校准样本。优化过程不更新任何模型参数,只更新两个旋转矩阵。
参数量值得算一遍。 是 ,Llama-2 7B 的 ,一份约 1678 万个参数; 每层每头一个 ,、32 层、32 头,合计 万,两者加起来约 3355 万。论文给出的量级是旋转参数约占权重规模的 0.26%(比例随模型尺寸与结构变化)。它们只存在于优化阶段,推理时已折进权重,不增加任何部署负担。
为什么不能直接对 做梯度下降
约束 意味着 的更新必须留在流形上。设当前点为 ,考虑一个一阶扰动 ,要求它仍然正交:
因此合法的切方向 必须满足
即 是斜对称矩阵。等价地,任何切向量都可以写成 ,其中 。这就是 Stiefel 流形的切空间。
欧氏梯度 一般不在切空间里,需要投影:
验证它落在切空间:,是斜对称矩阵。这里 。
Cayley 变换:从切空间走一步而不离开流形
知道了方向,还需要一个”走一步后仍在流形上”的更新规则。指数映射 精确但昂贵(每步要算矩阵指数)。Cayley 变换是更便宜的替代:
其中 , 是步长。可以证明 恒为正交:记 ,则 ,于是 、。计算
与 都是 的多项式,因此彼此可交换,它们的逆也可交换,把 移到 左侧:
所以只要 正交, 就正交,不需要任何事后重新正交化。这正是 Cayley 变换比”先做欧氏更新再 QR 拉回”更受欢迎的原因:它在参数化层面就保证了约束。
论文使用梯度投影构造 :
把它化成我们上面的语言。对于方阵 ,,于是 ,从而
这正是左乘更新 所需的斜对称生成元。更一般地( 只有正交列、 是投影算子时), 里的第二项承担了”把梯度投影到列空间”的作用,保证公式在非方阵情形也成立。对 SpinQuant 的 、 都是方阵,所以只需记住结论: 就是 的斜对称部分。
论文还给出了梯度投影的另一种等价视角:。这不是巧合,而是”欧氏梯度投影到切空间后再转到生成元坐标”的必然结果——前面 的验算已经得到同样形式。
计算代价:没有矩阵求逆
Cayley 变换表面上要算 ,看起来每步一次矩阵求逆。论文指出可以用不动点迭代避开:
其中 、 是斜对称生成元。迭代 5 次即可收敛到足够精度,单步只做矩阵乘,没有求逆。论文给出的总代价是普通 SGD 单步的约 2 倍。对 7B 模型 25 分钟的优化时间来说,这个常数完全可以接受。
对照官方实现:SGDG.step 逐行读
论文公式到这里已经完整,但第一次读代码仍容易迷路,因为代码里变量名与论文不同、矩阵转置方向也不同。官方 train_utils/optimizer.py 的 SGDG 类来自 Jun-Li 的 Stiefel 优化器实现,核心是 step 里的一段:
unity, _ = unit(p.data.view(p.size()[0], -1))if stiefel and unity.size()[0] <= unity.size()[1]: # 每步以 1/101 的概率做一次 QR 重新正交化,防止数值漂移 if random.randint(1, 101) == 1: unity = qr_retraction(unity)
g = p.grad.data.view(p.size()[0], -1) V = momentum * V - g.t() # 带上负号的“动量”,注意转置 MX = torch.mm(V, unity) # 对应 G R^T 一侧 XMX = torch.mm(unity, MX) XXMX = torch.mm(unity.t(), XMX) W_hat = MX - 0.5 * XXMX # 流形切空间投影 W = W_hat - W_hat.t() # 斜对称化:Y = G_hat - G_hat^T t = 0.5 * 2 / (matrix_norm_one(W) + eps) alpha = min(t, lr) # 步长上界与学习率取小 p_new = Cayley_loop(unity.t(), W, V, alpha) V_new = torch.mm(W, unity.t()) p.data.copy_(p_new.view(p.size())) V.copy_(V_new)逐行对应论文公式:
V = momentum * V - g.t():这里的V是动量,不是论文里的 。负号来自”参数更新方向是梯度反方向”,.t()来自参数存储约定——代码把旋转矩阵按转置形式参与运算,所以后面反复出现.t()。MX = V @ unity、XMX = unity @ MX、XXMX = unity.t() @ XMX:三项组合出 的等价形式。对正交方阵,这些乘积会退化成 ,与上一节推出的 完全一致。W = W_hat - W_hat.t():就是 ,即斜对称化。t = 1 / ||Y||_1(代码里写成0.5*2/...):用矩阵 1-范数给出 Cayley 不动点迭代的收敛上界;alpha=min(t,lr)再与学习率取小,保证步长不会越过不动点迭代的稳定域。Cayley_loop:5 次不动点迭代 ,返回后再转置回参数存储形式。论文里”没有求逆”的实现细节就落在这里。qr_retraction:用 QR 分解取正交因子,把矩阵拉回流形。代码以 1/101 的概率触发,平均每 100 步一次,用来清掉浮点累积误差。
关于转置方向还有一个值得说清的点。论文把更新写成左乘 、;代码里 Cayley_loop(unity.t(), W, ...) 取的第一个参数是 unity.t()、最后又返回 .t(),等价于右乘 、。两者是同一条更新,因为对正交 有
(正交相似变换保持斜对称性),而 Cayley 变换满足 。于是 ,两个写法逐项一致。读论文时按左乘理解,读代码时按”对转置做更新”理解即可。
这段代码还给了一个工程提醒:if stiefel and unity.size()[0] <= unity.size()[1] 这个条件说明 Stiefel 分支只在”行数不大于列数”时启用。SpinQuant 的 是方阵,条件成立;如果未来要对更扁的矩阵做旋转优化,得注意这个判断。
优化流程:800 条样本、100 次迭代、与 GPTQ 的分工
论文的优化配置非常克制:800 条 WikiText-2 校准样本、100 次 Cayley 迭代、学习率从 1.5 线性衰减到 0。所有 7 个模型用同一套配置。
为什么是 100 次而不是 1000 次?附录 Table 11 给了消融:LLaMA-2 7B、W4A4KV4 下,迭代数取 10/25/50/100/200,WikiText-2 困惑度依次是 6.6、6.4、6.3、6.2、6.2。结论有两条:25 次迭代已经吃掉绝大部分收益(6.6 → 6.4),50 次之后只剩 0.1 的量级,100 次是留余量;样本数从 128 增到 800 的差异在 0.1 以内,说明优化目标很平滑,需要的是把 的旋转调到局部最优,而不是拟合训练集。
学习率 1.5 看起来大得离谱,但在 Cayley 参数化下它只是步长的上界候选:实际步长取 , 会随梯度自动缩放,所以 1.5 更像是”允许走满”,而不是”每步走 1.5”。线性衰减到 0 则保证后期收敛。
耗时上,论文与附录 Table 15 给出(括号内为同规模 GPTQ 的量化时间作对比):
| 模型 | SpinQuant 旋转优化 | GPTQ 量化 |
|---|---|---|
| LLaMA-3.2 1B | 13 min | 8 min |
| LLaMA-3.2 3B | 18 min | 13 min |
| LLaMA-3 8B | 30 min | 20 min |
| LLaMA-2 7B | 25 min | 18 min |
| LLaMA-2 13B | 30 min | 25 min |
| Mistral-7B | 16 min | 12 min |
| LLaMA-2 70B | 约 3.5 h(FSDP 多卡) | 未列 |
相对 GPTQ 多 30%–50% 的时间,量级相当。对”一次量化、多次部署”的流程,这笔开销换来的精度提升是划算的,尤其当差距是从”不可用”变成”可用”时。
与 GPTQ 的分工:只对激活建图,再让 GPTQ 补权重
论文 4.3.2 节给出一个很重要的分工原则:旋转优化的目标网络里,权重保持 16-bit,只量化激活;旋转学完之后,再用 GPTQ 对旋转后的权重做 4-bit 量化。理由是:
- 旋转矩阵对激活分布的作用是直接的,对权重分布的作用是间接的;
- GPTQ 有 Hessian 信息,能把权重侧的量化误差压得更低(GPTQ 拆解 里讲过它的逐列补偿);
- 如果让旋转同时补偿权重误差,它会”分心”,反而在激活侧学得不够好。
Table 3 的消融验证了这一点:LLaMA-2 7B、W4A4KV16,旋转在”权重 4-bit、激活 4-bit”的网络里优化,准确率 61.0;旋转在”权重 16-bit、激活 4-bit”的网络里优化,准确率 64.1。W4A4KV4 下分别是 60.9 与 64.0。差约 3 分,来源正是”旋转不必替 GPTQ 干活”。
官方 README 把这条写成了一个容易踩坑的提示:如果第二步用 GPTQ,第一步应该用 w_bits=16, a_bits=4 跑 10_optimize_rotation.sh,再用 w_bits=4, a_bits=4 跑 2_eval_ptq.sh。搞反了不会报错,但精度会掉。
另一条消融(Table 16)区分了”旋转”与”GPTQ”各自的贡献:W4A4KV16 下,仅旋转加 RTN 就能比 SmoothQuant 高出 6.5–20.9 分,之后叠加 GPTQ 最多再涨 2.3 分。旋转是主要收益来源,GPTQ 是锦上添花。这个结论对部署很实用:如果推理框架没有 GPTQ 的复杂反量化内核,只做旋转加简单 RTN,也能拿到大部分收益。
校准数据与量化选项
校准数据的选择在附录 Table 13 里也有消融:LLaMA-2 7B、W4A4KV16,用 WikiText-2 校准得到 64.1 / 困惑度 5.9,用 C4 校准得到 64.3 / 5.9;W4A4KV4 下分别是 64.0 / 5.9 与 64.3 / 6.0。差异在 0.3 分以内,说明旋转优化对校准语料不敏感——这与”旋转只调分布形状、不拟合具体 token”的解释一致。相比之下,GPTQ 对校准集更敏感,因为它要逐层解一个最小二乘问题。
量化选项的消融(Table 12)显示:在 W4A4KV16 下,把激活从对称改成非对称,零样本平均从 61.2 升到 61.8,再把激活范围裁剪(clip)打开,升到 62.1;GPTQ 权重下则从 63.3 升到 64.0。KV 侧的对称/非对称与裁剪在 W4A4KV4 下几乎没有差别(61.4 → 61.5)。结论是:激活侧的非对称与裁剪有稳定的小幅收益,KV 侧不值得为此增加内核复杂度。
Llama 3.2 的绑定词嵌入与 70B 的 FSDP
两个实现细节在论文正文里没有、但在代码里必须处理:
- 绑定词嵌入。Llama 3.2 的 1B/3B 模型把
lm_head.weight与embed_tokens.weight绑定(tie_word_embeddings=True)。旋转要分别处理”嵌入输出”与”输出头输入”,两者若共享同一块权重就无法同时满足。官方代码直接强制解绑并克隆一份:
if config.tie_word_embeddings: config.tie_word_embeddings = False process_word_embeddings = True...if process_word_embeddings: model.lm_head.weight.data = model.model.embed_tokens.weight.data.clone()- 70B 的显存。旋转优化要对每层每头一个 的 与一份 的 求梯度,同时前向要跑完整的 70B 模型。单卡放不下,官方提供
11_optimize_rotation_fsdp.sh,用 FSDP 分片参数与梯度,对应FSDPTrainer。论文给出的 70B 优化时间约 3.5 小时,就是这套配置下的数字。
这两点看起来是工程琐事,但它们决定了这套方法能不能”跑起来”。复现时如果忽略绑定词嵌入,Llama 3.2 上的精度会莫名其妙地差;如果忽略 FSDP,70B 直接 OOM。
精度:LLaMA-2 7B 的四档位宽与跨模型对比
论文主表(Table 1)覆盖 7 个模型、4 档位宽。抽出 LLaMA-2 7B 这一列,可以一次看清各方法的相对位置:
| 配置 | 方法 | 零样本 8 任务均值 | WikiText-2 ppl |
|---|---|---|---|
| 16-16-16 | 全精度 | 66.9 | 5.5 |
| 4-8-16 | RTN | 62.4 | 7.9 |
| 4-8-16 | SmoothQuant | 58.9 | 7.5 |
| 4-8-16 | LLM-QAT | 64.8 | 11.4 |
| 4-8-16 | GPTQ | 64.9 | 20.2 |
| 4-8-16 | SpinQuant_no-had | 65.7 | 5.8 |
| 4-8-16 | SpinQuant_had | 65.7 | 5.7 |
| 4-8-8 | RTN | 62.5 | 7.9 |
| 4-8-8 | SmoothQuant | 58.8 | 7.5 |
| 4-8-8 | GPTQ | 64.8 | 20.2 |
| 4-8-8 | SpinQuant_no-had | 65.8 | 5.8 |
| 4-8-8 | SpinQuant_had | 65.8 | 5.7 |
| 4-4-16 | RTN | 35.6 | 2e3 |
| 4-4-16 | SmoothQuant | 41.8 | 3e2 |
| 4-4-16 | LLM-QAT | 47.8 | 12.9 |
| 4-4-16 | GPTQ | 36.8 | 9e3 |
| 4-4-16 | SpinQuant_no-had | 57.0 | 9.2 |
| 4-4-16 | SpinQuant_had | 64.1 | 5.9 |
| 4-4-4 | RTN | 37.1 | 2e3 |
| 4-4-4 | SmoothQuant | 39.0 | 7e2 |
| 4-4-4 | LLM-QAT | 44.9 | 14.9 |
| 4-4-4 | GPTQ | 36.8 | 9e3 |
| 4-4-4 | SpinQuant_no-had | 56.0 | 9.2 |
| 4-4-4 | SpinQuant_had | 64.0 | 5.9 |
逐档读这张表:
W4A8KV16 / W4A8KV8(第 2–4 行组)。这是端侧部署最常见的配置。SpinQuant_no-had 在两档下都达到 65.7–65.8,与全精度 66.9 只差 1.1–1.2 分;而 GPTQ 的困惑度是 20.2,SmoothQuant 直接掉到 58.9。这里有个有意思的对比:GPTQ 的零样本均值(64.9)看起来不差,但困惑度 20.2 说明分布匹配已经很糟——只看零样本准确率会低估它的退化。SpinQuant 在两个指标上都接近全精度,说明它不是”碰巧答对选择题”,而是分布真的保住了。
W4A4KV16(第 5 行组)。激活压到 4-bit 后,RTN 与 GPTQ 双双崩溃(35.6 / 36.8,困惑度以千计),SmoothQuant 也只有 41.8。SpinQuant_no-had 到 57.0,SpinQuant_had 到 64.1,与全精度只差 2.8 分。这一档清楚显示了 的作用:没有 MLP 在线 Hadamard,光靠吸收进权重的 、 还不足以支撑 4-bit 激活;加上 之后差距被抹平。
W4A4KV4(最后一行组)。这是论文摘要里的核心数字:SpinQuant_had 达到 64.0,与全精度 66.9 相差 2.9 分;比 LLM-QAT(44.9)高 19.1 分,比 SmoothQuant(39.0)高 25.0 分。这两个差值正是摘要里反复出现的数字。
跨模型看,差距随规模缩小:
| 模型 | 全精度 | SpinQuant_had (W4A4KV4) | 差距 |
|---|---|---|---|
| LLaMA-2 7B | 66.9 | 64.0 | 2.9 |
| LLaMA-2 13B | 68.3 | 66.9 | 1.4 |
| LLaMA-2 70B | 72.9 | 71.2 | 1.7 |
| LLaMA-3.2 1B | 56.9 | 53.4 | 3.5 |
| LLaMA-3.2 3B | 63.9 | 60.5 | 3.4 |
| LLaMA-3 8B | 69.6 | 65.5 | 4.1 |
| Mistral-7B | 71.0 | 68.6 | 2.4 |
小模型(1B/3B)的绝对差距更大(3.4–3.5 分),符合经验规律:小模型的容量小,量化噪声对最终输出的影响更直接;而 13B/70B 的差距都在 2 分以内。这也解释了为什么 Meta 在端侧先公开 1B/3B 的 W4A8 模型——那一档的差距压到 1–2.5 分,而且不需要在线 Hadamard。
与 QuaRot 的正面对比:随机旋转的代价
论文 Table 5 直接对比了 SpinQuant_had 与 QuaRot。以 LLaMA-3 70B 为例:
| 方法 | 位宽 | 零样本均值 | WikiText-2 ppl |
|---|---|---|---|
| 全精度 | 16-16-16 | 74.5 | 2.8 |
| QuaRot + RTN | 4-4-16 | 41.5 | 91.2 |
| SpinQuant_had + RTN | 4-4-16 | 70.1 | 4.1 |
| QuaRot + GPTQ | 4-4-4 | 65.1 | 20.2 |
| SpinQuant_had + GPTQ | 4-4-4 | 69.3 | 5.5 |
QuaRot 在 70B 上用 RTN 掉到 41.5,距离全精度 33 分——这个数字比 7B 上 QuaRot 的表现差得多,原因是随机旋转的方差在大模型上被放大:层数更多、每层的离群结构更复杂,一次”抽到坏旋转”会在 80 层里逐层累积。SpinQuant 通过优化把旋转从”抽奖”变成”求解”,在 70B、W4A4 下把差距从 33 分压到 4.4 分(70.1 对 74.5),相当于比 QuaRot 高 28.6 分。论文说的”比 QuaRot 提升 2.0 到 28.6 分”,上限就来自这个配置。
LLaMA-3 8B 上的对比更能说明”随机”的问题:
| 方法 | 4-4-16 均值 / ppl | 4-4-4 均值 / ppl |
|---|---|---|
| QuaRot + RTN | 59.5 / 10.4 | 58.6 / 10.9 |
| SpinQuant_had + RTN | 64.6 / 7.7 | 64.1 / 7.8 |
| QuaRot + GPTQ | 63.8 / 7.9 | 63.3 / 8.0 |
| SpinQuant_had + GPTQ | 65.8 / 7.1 | 65.5 / 7.3 |
SpinQuant_had 比 QuaRot 高 2.0–5.5 分,且每层在线 Hadamard 从 QuaRot 的最多 4 个减到 2 个( 上一次、MLP 下一次)——这正是 被吸收进 / 后省下来的。更少的在线算子意味着更低的延迟与更简单的 kernel 集成,这是 SpinQuant 在工程上的一个隐性优势。
权重 4-bit、激活 16-bit:与纯权重量化方法打平
论文附录 Table 17 单独列了 W4A16 档位。LLaMA-2 7B/13B/70B 上,SpinQuant_had 的零样本均值是 65.9 / 68.5 / 72.6,GPTQ 是 64.5 / 64.7 / 71.9,AWQ 只报了困惑度(6.2 / 5.1),QuIP# 与 OmniQuant 的 4-bit 权重困惑度分别为 5.6 / 5.7 / 3.4 与 5.6 / 5.0 / 3.5。SpinQuant 的困惑度是 5.6 / 5.0 / 3.5,与它们基本持平或更好。
这个结果符合直觉:纯权重量化方法的核心工具(AWQ 的显著性缩放、GPTQ 的二阶重建、QuIP# 的非相干处理)本来就把权重误差压得很低,旋转的额外收益主要是”让权重分布更均匀”,在 16-bit 激活下这点收益不显著,但也不会拖后腿。SpinQuant 的价值区间在激活与 KV 一起降到 4-bit 的地方。
指令微调模型上的表现
论文附录还对指令微调的 LLaMA-3.2 1B/3B 报告了结果。以 1B 为例:MMLU 5-shot 从全精度 49.3 降到 RTN 的 43.4,SpinQuant 是 47.3;TLDR9+ 的 ROUGE-L 从 16.8 降到 RTN 的 14.9,SpinQuant 是 16.7。3B 上分别是 63.4 → 60.5 → 62.0 与 19.0 → 19.1 → 19.2。MMLU 这类知识型任务对量化噪声最敏感,SpinQuant 保住了大部分;摘要型任务几乎无损。这组数据说明旋转类量化不只是”保住预训练困惑度”,在下游指令任务上也成立。
推理侧的实际表现与代价
端到端速度
论文 4.5 节在 MacBook M1 Pro CPU 上测了 LLaMA-3 8B 的实时解码速度:
| 配置 | 位宽 | 解码速度 |
|---|---|---|
| 全精度 | 16-16 | 177.15 ms/token |
| SpinQuant_no-had | 4-8 | 58.88 ms/token |
| SpinQuant_had | 4-8 | 63.90 ms/token |
4-bit 权重带来约 3 倍加速(177.15 → 58.88,理想上限是 4 倍,差额来自 W4A8 的激活仍是 8-bit、以及 CPU kernel 的效率);在线 Hadamard 带来约 8% 的额外延迟(58.88 → 63.90)。考虑到 的尺寸是 11008,这个 8% 已经相当克制,靠的就是前面讲的 FHT 分解。
GPU 侧的测量更有参考价值。附录 Table 14 在 H100 上用 LLaMA-3 70B 测 TTFT(首 token 时间,反映 prefill)与 TTIT(逐 token 时间,反映 decode):
| 配置 | TTFT (ms) | TTIT (ms) |
|---|---|---|
| no-had,BS=1,T=4096 | 153.58 | 9.85 |
| had,BS=1,T=4096 | 158.25 | 10.15 |
| no-had,BS=8,T=4096 | 1205.47 | 10.60 |
| had,BS=8,T=4096 | 1243.48 | 10.94 |
| no-had,BS=32,T=4096 | 5008.25 | 13.83 |
| had,BS=32,T=4096 | 5147.59 | 14.20 |
在线 Hadamard 的解码损失约 3%(9.85 → 10.15),prefill 损失约 3%(153.58 → 158.25);batch 越大,开销占比越小(BS=32 时 TTIT 只多 0.37 ms)。这个量级对”要不要为了 4-bit KV 缓存多付 3% 延迟”的回答基本是肯定的。
两种部署形态:零侵入与需要内核
SpinQuant 的两个变体对应两条完全不同的工程路径:
SpinQuant_no-had(、 被吸收)。量化后的模型文件里, 已经包含了旋转,推理端读到的就是普通的 4-bit 权重加激活量化参数,任何支持标准 W4A16 或 W4A8 kernel 的框架都能直接跑。不需要新算子、不需要改架构、不需要特殊的反量化 kernel。Meta 公开的 Llama-3.2-1B-Instruct-SpinQuant_INT4_EO8 就是走这条路:用 ExecuTorch 导出,运行时只跑标准的 4-bit 权重 + 8-bit 动态激活 kernel。我们在 Marlin 拆解 与 BitBLAS 拆解 里讲过 W4A16 低比特 GEMM 的 kernel 复杂度——no-had 恰好把”旋转”这件事全部留在离线阶段,避开了在推理侧加新 kernel 的需求。
SpinQuant_had(、 吸收 + 、 在线)。推理端需要两个小算子:RoPE 之后、写 KV 之前对 做在线 Hadamard;MLP 元素乘之后、down_proj 之前做在线 Hadamard。前者是 4-bit KV 缓存的关键,后者是 4-bit MLP 激活的关键。两个算子都是 的 FHT,实现成本不高,但需要推理框架提供挂载点。若目标是 W4A4KV4,还需要 W4A4 GEMM 与 4-bit KV 缓存读写内核——这与我们在 KVQuant 拆解、KIVI 拆解 里讨论的 KV 量化内核是同一类工程量。
判断表:
| 目标位宽 | 推荐变体 | 推理侧要求 |
|---|---|---|
| W4A16 / W4A8KV16 / W4A8KV8 | SpinQuant_no-had | 标准 W4A16 或 W4A8 kernel,零新算子 |
| W4A4(KV 16-bit) | SpinQuant_had | 加 MLP 在线 Hadamard()与 W4A4 GEMM |
| W4A4KV4 | SpinQuant_had | 再加 在线 Hadamard()与 4-bit KV 缓存内核 |
这张表的实用价值在于:大部分团队应该从 no-had 开始。它在 W4A8 下就能把差距压到 0.1–2.5 分,而且不动推理栈一行代码;等 4-bit 激活的 kernel 生态成熟,再切到 had 版本拿 W4A4KV4 的带宽收益。
与 QAT、SmoothQuant 的定位差异
从”代价”看,SpinQuant 属于 PTQ:不更新模型权重、不需要训练流水线,只要一段校准优化。LLM-QAT 走的量化感知训练需要完整训练流程,每换一个位宽都要重训,成本高一个量级。论文主表的 LLaMA-2 13B 一列里,LLM-QAT 的结果是空缺(–),这类方法在大规模部署时往往受限于训练成本。
相对 SmoothQuant 路线,差异在于”搬离群值”还是”摊平离群值”:SmoothQuant 在同一坐标系内做按通道缩放,把量化难度在权重与激活之间转移,离群值仍然存在;SpinQuant 换坐标系把它拆散,从根上改变了分布尾部形状。这就是 W8A8 上 SmoothQuant 成功、W4A4 上它崩溃的原因。
从零实现一个最小版本
把上面的机制落成代码,一个最小可用的 SpinQuant 流程分四步:折叠 RMSNorm、插入可学习旋转、写模拟量化、跑 Cayley 优化。下面是一段示意实现(省略 FSDP 与分布式,仅表达数据流):
import torch
def fold_rmsnorm(model): """把 RMSNorm 的 alpha 折进它下游读残差流的权重。""" for layer in model.model.layers: a_in = layer.input_layernorm.weight.data # (d,) 只喂 Q/K/V for proj in (layer.self_attn.q_proj, layer.self_attn.k_proj, layer.self_attn.v_proj): proj.weight.data.mul_(a_in) # W <- W diag(alpha) a_post = layer.post_attention_layernorm.weight.data # 只喂 gate/up for proj in (layer.mlp.gate_proj, layer.mlp.up_proj): proj.weight.data.mul_(a_post) # 折叠后把 alpha 置 1,norm 只剩逐 token 的 RMS 归一化 layer.input_layernorm.weight.data.fill_(1.0) layer.post_attention_layernorm.weight.data.fill_(1.0)
def fake_quant_sym(x, bits, dim=-1): """对称 per-token 模拟量化:量化再反量化。""" qmax = 2 ** (bits - 1) - 1 scale = x.abs().amax(dim=dim, keepdim=True).clamp_min(1e-8) / qmax return (x / scale).round().clamp(-qmax - 1, qmax) * scale
def blockdiag(R, n): return torch.block_diag(*([R] * n))
def absorb_rotations(model, R1, R2s, n_q_heads, n_kv_heads): """把学好的 R1、R2 写回权重,推理时不再需要任何旋转算子。""" model.embed_tokens.weight.data = model.embed_tokens.weight.data @ R1
for i, layer in enumerate(model.model.layers): R2 = R2s[i] # (d_h, d_h) # 读残差流的层:W <- W R1(alpha 已在 fold_rmsnorm 中折入) for proj in (layer.self_attn.q_proj, layer.self_attn.k_proj, layer.self_attn.v_proj, layer.mlp.gate_proj, layer.mlp.up_proj): proj.weight.data = proj.weight.data @ R1 # 写回残差流的层:W <- R1^T W layer.self_attn.o_proj.weight.data = ( R1.t() @ layer.self_attn.o_proj.weight.data) layer.mlp.down_proj.weight.data = ( R1.t() @ layer.mlp.down_proj.weight.data) # R2:V 左乘 blockdiag(R2^T),O 右乘 blockdiag(R2) v_w = layer.self_attn.v_proj.weight.data layer.self_attn.v_proj.weight.data = blockdiag(R2.t(), n_kv_heads) @ v_w o_w = layer.self_attn.o_proj.weight.data layer.self_attn.o_proj.weight.data = o_w @ blockdiag(R2, n_q_heads)
# 输出头读最后一层残差,并且前面有最终 RMSNorm:alpha 需先折进 lm_head model.lm_head.weight.data = model.lm_head.weight.data @ R1这段代码刻意保留了与前面公式一一对应的结构,但有几处必须说明,否则直接照抄会错:
fold_rmsnorm的范围。Llama 的input_layernorm同时喂 Q/K/V 三个投影,post_attention_layernorm只喂 MLP 的gate_proj、up_proj;只有”下游读残差流的线性层”才需要乘 。折叠之后要把 alpha 置 1,否则会重复缩放。最终的lm_head前面还有一次 RMSNorm,它的 也要单独乘进lm_head,这是最容易漏的一步。blockdiag的头数。 的输出维度是 ,块对角要按 KV 头数 复制; 的输入维度是 ,块数按 Q 头数。Llama 2 的 MHA 下两者相等,但 GQA/MQA 模型(GQA 拆解 讲过其结构)里必须区分,否则要么形状不匹配,要么旋转错位。embed_tokens也要旋转。残差流入口是 embedding 输出, 作用在它上面;若不预先乘进 embedding 权重,第 0 层的输入就还是原坐标系。官方代码里QuantizeLinear的R1参数正是为此存在。- 模拟量化的位置。优化阶段要把
fake_quant_sym挂到每个读残差流的线性层输入端,权重保持 16-bit(上一节讲的分工);量化权重留给 GPTQ。官方代码用ActQuantWrapper包装每个QuantizeLinear实现这一点。
把 R1、每层 R2 设为可训练参数、其余全部冻结,优化循环本身很短:
from train_utils.optimizer import SGDGfrom utils.hadamard_utils import random_hadamard_matrix
d, d_h = model.config.hidden_size, model.config.head_dimmodel.R1 = RotateModule(random_hadamard_matrix(d, device="cuda"))for layer in model.model.layers: layer.self_attn.R2 = RotateModule(random_hadamard_matrix(d_h, device="cuda"))
for p in model.parameters(): p.requires_grad = Falsetrainable = [model.R1.weight] + [ layer.self_attn.R2.weight for layer in model.model.layers]optimizer = SGDG(trainable, lr=1.5, stiefel=True) # 学习率线性衰减到 0
for step in range(100): # 800 条 WikiText-2 校准样本 for batch in calib_loader: loss = model(**batch, R1=model.R1.weight).loss # 前向内已插入 fake quant loss.backward() optimizer.step() optimizer.zero_grad()关键在 RotateModule(官方实现里就这么叫):它的 weight 是 nn.Parameter,前向按 weight @ x 或 x @ weight 两种方向使用,取决于 transpose 标志。R1 以参数形式传给每个 QuantizeLinear,R2 由注意力块自己取用。真实实现还要叠加 FSDP(70B)、bf16 混合精度、梯度裁剪与 LR 调度,但数据流就是这两段代码。
这段代码也解释了为什么 no-had 版本”零侵入”:absorb_rotations 跑完之后,模型里已经没有任何 ,只剩改过的权重。推理框架看到的就是一个普通的 4-bit 量化模型。R_3、R_4 则不在这一步里——它们是固定的 Hadamard,推理端用 HadamardTransform 在线计算,官方实现把 挂在 apply_rotary_pos_emb 之后、把 挂在 down_proj 的输入量化器上。
局限与未解决的问题
SpinQuant 消掉了随机旋转的方差,但它的目标函数里有几处明确的假设,认识它们对真正落地很重要:
- 旋转只覆盖线性层与 KV 缓存,不覆盖注意力内部的非线性。softmax、SiLU 不可吸收,这就是 、 必须在线的原因。若未来要在 softmax 输入、注意力分数这类位置做量化,现有插入点不够用,需要新的旋转位置与对应的等价性证明。
- 优化依赖校准集与代理损失。论文用 WikiText-2 的交叉熵,C4 校准的消融显示差异在 0.3 分以内,但这只覆盖了两个通用语料。对代码、长文档、多语言等域偏移严重的场景,最优旋转是否会漂移,论文没有给出系统实验。
- 激活 4-bit 的硬件支持仍是瓶颈。精度上 W4A4KV4 已被证明可行,但推理框架能否提供高吞吐的 4-bit 激活 GEMM 是另一回事。W4A8 是更现实的落点,而那条线上 no-had 的”零侵入”恰好把采用成本降到最低。
- 全模型共享是简化。一张 的 作用于所有层,但每层的离群模式并不相同。逐层学一个 可能有更大收益,代价是优化参数量与存储的线性增长,论文没有展开逐层版本。
- 与更细粒度量化的兼容性未知。KV 侧 2-bit 量化(KIVI 的非对称 2-bit、KVQuant 的 3-bit 非均匀码本)对分布的要求比 4-bit 更苛刻, 是否够用、是否需要更适配的旋转,是论文之外的开放方向。
- 旋转与量化粒度的耦合。论文的激活量化是 per-token 对称(某些层 group size 为 ),旋转把离群值摊到所有通道后,per-token 的 scale 才能压下来。如果硬件只支持 per-tensor 量化,旋转的收益会打折——因为 per-tensor 的 scale 仍然由整个张量的最大值决定,旋转只能降低”最大值的期望”,不能改变”存在一个全局最大值”这件事。
还有几个常见误解值得澄清:
- “旋转等于微调”:不是。权重完全冻结, 只改变坐标表示,全精度输出逐位不变;它优化的是”量化后”的损失,而不是模型本身的能力。
- “学出来的旋转会过拟合校准集”:从 128 到 800 条样本结果几乎不变(Table 11)、Wiki2 与 C4 校准差异 0.3 分以内(Table 13),说明它学的是分布形状而不是样本内容。
- “必须在 RoPE 之前旋转 K”:不行。RoPE 按固定维度配对做位置相关的二维旋转,任意正交变换会破坏配对结构; 必须在 RoPE 之后、写缓存之前施加,这也是它无法被吸收的根本原因。
- “no-had 版本不如 had 版本”:分档位。W4A8 下两者几乎相同(LLaMA-2 7B 都是 65.7/65.8),no-had 还省掉在线算子;只有到 W4A4 及以下,、 才变得不可替代。
小结
SpinQuant 的贡献可以压缩成四步:
- 确认旋转等价性:残差流入口的 、注意力块内 到 之间的 可被吸收进权重,全精度输出不变;RoPE 之后的 旋转 与 MLP 下投影前的 不可吸收,必须在推理端在线执行,因此固定为快速 Hadamard。
- 承认随机旋转不够:LLaMA-2 7B、W4A4 下,100 个随机种子的旋转让准确率相差 13 分,随机 Hadamard 之间也差 6 分;模型越大,坏抽奖的后果越严重(QuaRot 在 70B 上用 RTN 掉 33 分)。
- 把旋转变成学习问题:在冻结权重上,用校准集的交叉熵最小化”带量化函数的网络”损失;可训练参数是 与每层每头一个 ,合计约 0.26% 的权重规模。
- 用 Cayley SGD 保正交更新:斜对称生成元加 Cayley 变换,配 5 次不动点迭代,单步只有几次矩阵乘;800 条样本、100 次迭代即可,优化时间与 GPTQ 同量级。
效果上,LLaMA-2 7B 在 W4A4KV4 下达到 64.0 零样本均值,与全精度 66.9 差 2.9 分,比 LLM-QAT 高 19.1 分、比 SmoothQuant 高 25.0 分;LLaMA-3 70B 的 W4A4 下,QuaRot 的 RTN 版本只有 41.5,SpinQuant_had 是 70.1,差距从 33 分压到 4.4 分。W4A8 的 no-had 版本在所有报告模型上与全精度的差距在 0.1–2.5 分,且推理端零改动。
代价上,had 版本每层 2 个在线 Hadamard(QuaRot 是 4 个),H100 上 prefill 与 decode 各增加约 3% 延迟;真正的门槛不在 Hadamard,而在 W4A4 GEMM 与 4-bit KV 缓存的推理内核。对追求”不改架构、不改 kernel、直接换权重文件”的部署场景,SpinQuant_no-had 是目前旋转类量化里最省事的路线;对追求极限带宽收益的长上下文服务,SpinQuant_had + W4A4KV4 是目前公开方法里精度与开销平衡得最好的一档。
参考资料
- SpinQuant: LLM quantization with learned rotations(arXiv 2405.16406)
- SpinQuant 官方 GitHub 仓库(facebookresearch/SpinQuant)
- SpinQuant 旋转优化入口
optimize_rotation.py - SpinQuant Cayley SGD 优化器
train_utils/optimizer.py - SpinQuant 模型改造
train_utils/main.py - SpinQuant 在线 R3/R4 实现
train_utils/apply_r3_r4.py - QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs(arXiv 2404.00456)
- QuaRot 官方 GitHub 仓库(spcl/QuaRot)
- Stiefel 流形 Cayley 变换优化器原始实现(JunLi-Galios)
- Meta Llama 量化轻量模型介绍(含 SpinQuant 4-bit 模型)
- Llama-3.2-1B-Instruct-SpinQuant_INT4_EO8 模型卡
- ExecuTorch 中的 Llama 与 SpinQuant 导出支持
- fast-hadamard-transform(Dao-AILab)
- QuIP#: Even Better LLM Quantization with Hadamard Incoherence and Lattice Codebooks(arXiv 2402.04396)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



