


Jalapeño 系统协同设计完全拆解:为什么推理芯片不该拆成三种专用加速器
从课程材料到系统问题
OpenAI 在 2026 年 8 月 25 日的 Hot Chips 2026 大会上公布了首颗自研推理 ASIC Jalapeño(墨西哥辣椒),一颗与博通(Broadcom)合作、台积电代工、只做推理不做训练的专用芯片。围绕它的规格、实测数字与产业影响,本站已有 OpenAI Jalapeño 完全拆解 做了完整梳理,本文不重复那份材料。
这篇文章处理的是另一组问题。一份在 2026 年流传的技术讲座材料(《OpenAI’s Jalapeño chip》,共 27 页)把重心放在协同设计(co-design)上:它几乎没有铺陈市场规模和产业格局,而是反复追问同一类问题——
- 一次推理请求会依次经过 prefill、draft、verify 三种完全不同的硬件状态,它们的瓶颈分别是计算、网络延迟和显存带宽,那芯片应该做成「每种状态一个专用加速器」,还是做成「一颗芯片切换资源配比」?
- 假设一颗芯片的内存带宽已经高到理论极限,用户能拿到多少 token/s?如果实测远低于这个上限,说明瓶颈不在带宽——那瓶颈到底在哪?
- 把计算核心和 HBM 切成一一对应的 64 份,让权重和 KV 缓存待在离计算最近的切片里,这个决策换来了什么,代价又是什么?
这些问题共同指向一个更一般的命题:当推理负载的阶段配比随时在变,芯片的优化目标应该从「峰值算力」转向「在负载漂移下保持平衡」。本文按这个线索展开,覆盖讲座材料的全部技术要点(阶段拆解、系统选择、带宽上限反推、切片架构、机架与网络、设计与验证流程、多代路线图),并补齐它省略的前置机理与工程含义。文中所有引用材料之外的推导与数据来源都在图注或参考资料里标明。
一个请求穿过三种「硬件性格」
要理解 Jalapeño 的架构选择,必须先接受一个事实:一次推理请求在时间上并不均匀,它在不同阶段对硬件的要求几乎是相反的。讲座材料开篇就把这条线索摆了出来,把请求拆成三段。
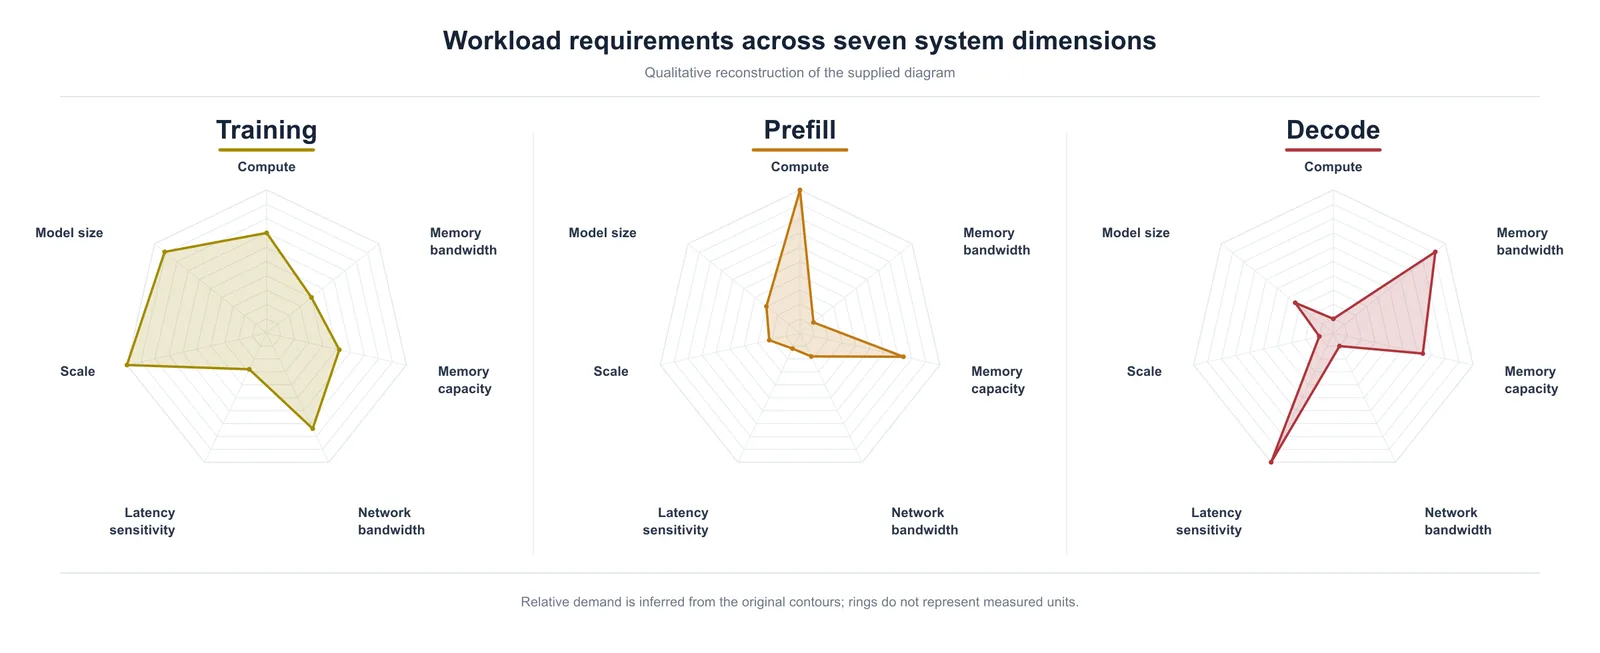
图:一个请求跨越的三个硬件阶段及其瓶颈归属(来源:讲座材料《OpenAI’s Jalapeño chip》第 10 页)
阶段一:Prefill —— 计算密集,形状规整
Prefill(预填充)要一次处理整段输入:把提示词的所有 token 并行送进 attention 与 MLP 层,为每个位置算出 K/V 并写入缓存。
它的硬件性格是:FLOPs 密集、attention 占比高、基本是 compute-bound。因为输入序列是一次性进来的,矩阵乘的形状是「大矩阵 × 大矩阵」,batch 维度天然大,访存带宽需求相对低。
更关键的是通信是可平滑调度的。每层之间的张量并行 all-reduce 有稳定的节拍,可以和计算重叠,不容易突然抖动。
阶段二:Draft —— 延迟敏感到极致,模型却很小
投机解码(speculative decoding)的草稿阶段是另一种极端。
它跑的是一个小模型——参数量可能只有主模型的几十分之一;为了延迟,batch 被压到极低(低延迟服务时甚至是 1)。于是:模型小、batch 小,两层叠起来意味着这个阶段既不吃算力也不吃显存带宽,它的瓶颈是网络延迟。
材料对这一段的描述是「低网络带宽,但极端延迟敏感」。注意这里的重点:不是「网络快不快」,而是「网络一次往返要多久」。跨机架一次通信的固定开销可能是微秒级,而这个阶段本身的可用时间预算是毫秒级,固定开销占比被放到最大。
顺带说明一个术语重复问题:这里的 draft 指的正是 MTP 与 EAGLE 系列讲的草稿模型,机制不重复展开。只需要记住一点:草稿模型的输出不是最终答案,它必须马上交给下一段去验证,所以它的产物有严格的时效性。
阶段三:Spec-verify —— 显存带宽当家,通信还会突发
验证解码阶段是三个里最复杂的。主模型要并行验证草稿给出的若干候选 token:从 KV 缓存里读历史状态,逐层算出 logits,再判断接受哪些候选。
材料把这一段的瓶颈写得更细:
- Attention 的带宽压力被 GQA 和投机 token 缓解。分组查询注意力(Grouped Query Attention,GQA)让多个 query 头共享一份 KV,KV 读取量按分组数下降;而投机解码一次验证多个 token,又把这批读取摊薄在多个 token 上。两者叠加,attention 不再是最凶的带宽消耗方;
- MoE 是真正的带宽饿汉。混合专家模型在低延迟、低 batch 下,需要把被路由到的专家权重从显存读进来,而每次激活的专家又少,权重的复用率低。这部分的显存带宽消耗无法像 dense 层那样被 batch 摊薄;
- 通信是突发式的(bursty)。专家并行的 all-to-all 通信在每层末尾集中爆发,而不是均匀铺开。它无法被简单地和计算重叠,因为计算必须先算出路由结果,通信才能开始。
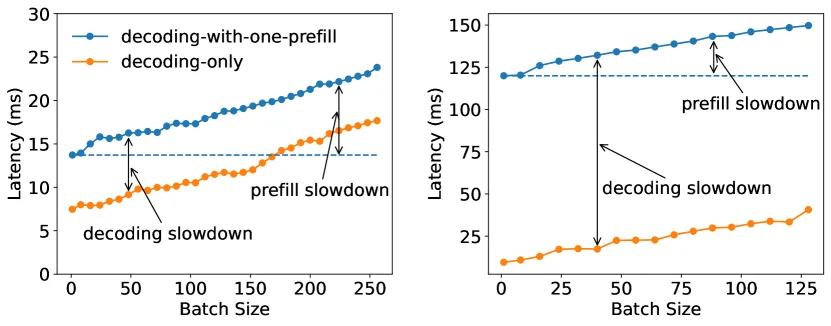
图:三阶段瓶颈的量化对比(来源:DistServe 论文 Figure 2,arXiv:2401.09670。原图对比的是一个 decode-only 批次与「额外加入一个 prefill」的批次执行时间,差异说明 prefill 与 decode 对同一批 GPU 的干扰强度完全不同)
一个必须澄清的常见误解
材料在讲完三段后给了一句总结:「每个阶段撞在不同的瓶颈上,而真正重要的是端到端延迟」。
这句话值得展开。它包含两层意思。
第一层是阶段不同构。Prefill 要算力、Draft 要低延迟、Verify 要带宽,任何一个只优化单一维度的硬件都会在另外两段浪费。如果芯片只堆矩阵算力,Verify 阶段的算力单元在等 HBM;如果芯片只堆带宽,Prefill 的算力又会成为瓶颈。
第二层更微妙:「重要的是端到端延迟」不等于「每个阶段都要最快」。因为三个阶段是串行的,用户感知的是三者之和。一个阶段省 10 毫秒,如果另一个阶段多花 30 毫秒,整体仍然是退步的。这与吞吐导向的批处理系统逻辑完全不同——在吞吐导向下,各阶段可以独立优化再拼接;在延迟导向下,必须把三段放在同一个预算里统一分配。
这一点决定了后面所有的架构讨论:优化的对象不是某个阶段的效率,而是三段合起来的端到端时间。
系统级岔路:让 KV 跑,还是让硅片的活跃配比变
理解了三个阶段,第一个真正需要决策的问题是系统形态。摆在面前的路只有两条:把 KV 状态在网络里搬,或者让芯片自己改变活跃的资源配比。前者有成熟的研究与工程基础——Splitwise(2023 年由微软与 UC Berkeley 等团队提出,arXiv:2311.18677)就是这条路线早期的系统化工作,它把生成过程拆成 prompt 阶段与 token 阶段分别部署;后者是 Jalapeño 的选择。
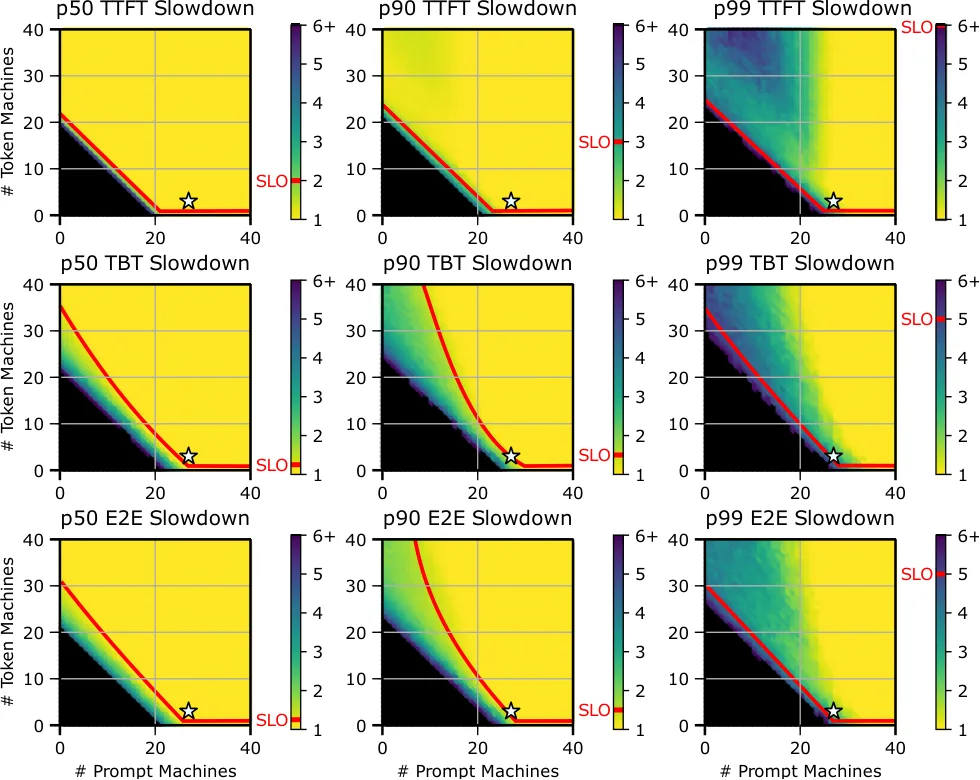
图:Splitwise 论文在 BLOOM-176B 上的阶段分离实验。这条路线在吞吐导向的服务里被广泛采用,讲座材料反对的是把它固化到硬件层(来源:Splitwise 论文,arXiv:2311.18677)
路线 A:分离式专用化(disaggregated specialization)
这条路的逻辑非常直白:既然三个阶段瓶颈不同,那就为每种阶段造对应的专用硬件——一个 prefill 集群、一个 draft 集群、一个 verify 集群,各自按自己的瓶颈调优。
它的问题材料只用了半句话概括:「专用硬件,但 KV 状态必须在系统之间搬来搬去」。这半句话背后有三层代价。
第一层是数据的物理迁移。 Prefill 阶段产出的 KV 缓存,是 Verify 阶段必须读取的输入。它们天然产生在不同的硬件上,于是这些状态必须在每个阶段边界上跨网络搬运一次。KV 缓存的体积不是「小数据」:一个 70B 级模型在 8K 上下文下的 KV,随 batch 增长可以轻松到几十 GB 量级,跨机架搬运它需要占用本来用于张量并行的网络带宽。
第二层是每个阶段边界都要求一次网络加同步。 材料在图注里点了出来:「每个阶段边界都要网络与同步」。串行三阶段意味着至少两个边界,每次都是一次全集群级别的同步点。同步点的开销不只来自传输时间,还来自「等待最慢的那一个」——流水线里任何一次抖动都会被后端放大。
第三层是故障面的扩大。 状态在网络里旅行,就意味着网络故障会直接变成请求失败,而不只是性能下降。这一点是系统工程中容易被低估的。
路线 B:统一但内部异构的芯片
另一条路的出发点完全不同:不移动 KV,而是移动「资源配比」。
材料把它描述为「统一、内部异构」,并给了两句关键判断:
- 「按阶段激活正确的比例;未使用的单元直接变暗」;
- 「异构性搬进了芯片内部,而不是穿过一张搬运 KV 的网络」。
换句话说:同一颗芯片同时具备算力单元、内存带宽与网络能力,处理 prefill 时把算力与通用网络打开、把大份额的 HBM 带宽通道门控住;处理 draft 时压低算力、让网络控制路径保持最低延迟;处理 verify 时反过来把 HBM 带宽全部打开。没有被用到的单元门控(gate)掉,不产生动态功耗,也不参与竞争。
讲座材料在这里给出了一个很有分量的判断句:「Locality is king」——把 KV 留在本地,按需打开正确的资源。
为什么「局部性」是这条路的全部赌注
这句话值得停下来想清楚,因为它把整个设计押在了同一个前提上:推理的访存模式是可预测的。
对照一下 GPU 的做法:GPU 的内存系统(多级 L2、复杂的交叉开关与一致性协议)是为「任意访问模式」设计的。它必须假设程序员会以任何顺序、任何粒度访问任何地址,因此它的延迟高且不可预测,只能靠大 batch 或大形状来摊薄。
而推理不是任意访问模式:权重按层读取,KV 按 token 位置追加与读取。只要芯片能保证「用这块权重的计算单元」和「存这块权重的显存」挨在一起,大部分访问就落在本地。芯片设计要做的事情因此变成一句话:把访存模式的规律固化进物理布局。
代价立刻出现:软件必须承担「数据放在哪、什么时候在切片之间移动」的规划责任。这一点在讲核心切片时还会展开。
两种路线的取舍账
把两条路线放在一起,差异可以列成一张对照表。
| 维度 | 分离式专用化 | 统一内部异构 |
|---|---|---|
| KV 状态位置 | 跨系统迁移 | 本地常驻 |
| 阶段边界 | 网络 + 同步点 | 芯片内资源门控,无跨系统同步 |
| 峰值效率 | 每阶段可单独调优,理论峰值更高 | 每阶段都会有一部分单元闲置,峰值受限 |
| 负载漂移时的利用率 | 比例偏差即产生空转 | 比例由内部资源切换跟随 |
| 软件责任 | 调度器负责 KV 路由 | 软件负责数据放置与切片间移动 |
| 故障面 | 状态在网络中旅行,网络故障即请求失败 | 故障域收缩到单芯片/单机架内 |
材料没有说「分离式是错的」。它说的是:在生产负载的比例永远在变的前提下,理论峰值换不到实际利用率。下一节就把这个「比例永远在变」定量化。
比例漂移:为什么「按阶段配硬件」的账算不平
三段占比由三组变量同时决定
讲座材料用一页专门讲「比例为什么会变」,并且点出三组相互独立的驱动变量:模型架构、token 效率、上下文长度 影响输入输出的比例;注意力算法、投机接受率、延迟与吞吐取向 影响每段的工作量权重。
用符号把它写清楚。设一个批次的请求集合有 个请求,第 个请求的输入长度为 、输出长度为 、投机接受率为 (每个 draft 步平均被接受的 token 数),则三段的相对工作量可以写成:
三个式子里每个符号的含义:
- 里的平方来自 attention 本身的复杂度——预填充是「一次算完整个输入」,注意力矩阵是 量级,因此输入长度对预填充是平方级影响;
- 里的 是该请求的平均上下文长度:每个输出 token 都要读一遍历史 KV,上下文越长,单步读取量越大;它随输出长度线性累加;
- 与接受率 成反比: 越接近 1,草稿效率越高,需要跑的 draft 步数越少。 从 2.5 掉到 1.2,草稿段的步数就翻了超过一倍。
把这三条放在一起看,结论很清楚:没有一个变量是常量。上下文在几千到几十万之间浮动,接受率随模型与任务从 1 附近到 2 到 4 变化,输入输出比例更是随应用形态彻底改变。三者相乘,三段占比可以在一天之内移动一个数量级。
分离式集群在比例漂移下的真实代价
一旦硬件被物理切成三段专用的池子,比例漂移就变成了两头落空:
- 比例向 prefill 倾斜时,verify 池闲置;
- 比例向长上下文 decode 倾斜时,prefill 池闲置。
闲置的芯片不产出 token,但仍然占着机位、耗着基础功耗、吃着一份散热预算。这就是材料那页最重要的那句话:「暗掉的硅比闲置的加速器便宜」。
把这句判断拆开会更容易看清它的分量。「暗掉的硅」(dark silicon)指的是同一颗芯片里被门控掉的单元——它不产出、但也不耗动态功耗,而且不占用额外机架空间、不需要额外的电源模块、不需要额外的一份散热能力。而被闲置的加速器是一整台设备:它的静态功耗、供电冗余、机架空间已经花掉了,只是没干活。
这个区别在电力受限的数据中心里会被放大成真实的成本差:电力预算是最稀缺的资源,一台闲着但不产出 token 的加速器,等于把最稀缺的资源锁在柜子里。
一个数值化的直觉
材料用一个例子把比例漂移的后果说得很直观,这里补上算式。
假设一个统一机架要同时供给三类工作,材料给出的整机架规模是 128 颗芯片 / 约 1.7 EFLOPS(MXFP4)、27.5 TB HBM4。把算力与容量按三种混合比例摊开:
| 混合比例(prefill : draft : verify) | 该比例下可分配给 prefill 的算力 | 该比例下可分配给 verify 的显存带宽占比 |
|---|---|---|
| 2 : 1 : 1 | 约 50% | 约 25% |
| 1 : 1 : 2 | 约 25% | 约 50% |
| 1 : 1 : 4 | 约 17% | 约 67% |
分离式方案必须提前把 128 颗芯片切成三堆来覆盖最坏情形;而配比一旦选错,被切出去的那一堆就整夜闲置。统一方案的应对方式完全不同:它不预先分配芯片,而是在每颗芯片内部按当前阶段切换哪一部分硅片处于活跃状态。
顺带说明:这不是在否定 P/D 分离
需要把这条判断的范围划清楚,否则很容易被误读成「P/D 分离是错的」。
在吞吐导向的服务里,P/D 分离(把 prefill 与 decode 放到不同 GPU 池)是有效的手段:它让两个阶段各自用最适合的并行策略与批处理参数,代价是 KV 要跨网络传输。业界大量生产系统这么做是有理由的,原理细节可参考本站 DistServe 完全拆解 与 Sarathi-Serve 完全拆解。
讲座材料反对的是把这种分离固化到硬件里。软件层面的池子划分可以随时调整比例、可以动态迁移;硬件层面的池子一旦流片完成就再也改不动了。当负载比例在一年的尺度上移动一个数量级时,灵活性本身的价值就超过了「每阶段单独调优」带来的峰值增益。
这就是那句「统一芯片能在负载变化时让系统保持平衡」的完整含义。
反推设计目标:先算带宽上限,再问为什么达不到
把纸面带宽换算成 token 速率
讲座材料里最值得学的一页,是一次纯粹用带宽算出的上限反推。它不问「这颗芯片的实测性能如何」,而是先问:假定只受 HBM 带宽限制,用户最多能拿到多少 token/s?
先把算式列清楚。生成一个 token,模型必须做的事是「把生成这个 token 需要读的数据读完」。因此:
符号含义: 是可用聚合内存带宽(B/s), 是每生成一个 token 必须从内存读取的字节数。右侧给出的是带宽能支撑的 token 速率上界。
现在代入材料给出的数字。材料写的是:128 颗芯片的聚合 HBM4 带宽为 1+ PB/s(即 B/s 量级),1T 参数模型按 4 位权重读一遍整模型需要 0.5 TB( 参数 × 4 bit = bit = B)。于是:
也就是说:理论上每秒可以把万亿参数模型完整读两千多遍。若假设每次完整读取能推进一个 token(这是最乐观的假设),单用户 token 速率上限就是 2000 token/s 量级。
这里必须先讲清这个「最乐观假设」为什么乐观。真实解码时,一个 token 的生成不是「读一遍模型」——它是逐层读取:读第 1 层权重、算完、写 KV;再读第 2 层……这些读取是串行的,中间还夹着无法被带宽掩盖的依赖。所以「读一遍模型 ≈ 一个 token」本身就已经把流水线理想化成了一根没有气泡的管子。
一个必须诚实面对的细节:这是理论天花板
材料自己在图注上就标了 「THEORETICAL BANDWIDTH-ONLY CEILING · NOT ACHIEVED」——理论带宽天花板,未达成。
把「一个 token 读一遍模型」这个简化拆开,可以看清天花板被夸大了多少:
- :一个 token 只推进一层,所以单步只需读那一层的权重;但整模型要读一遍是逐层累积的,层与层之间的依赖让这些读取无法完全并行;
- KV read:每步都要把当前请求的历史 KV 读一遍。这一项随上下文线性增长,且不会因为「读一遍权重就够」的简化而消失。在长上下文场景里,它甚至可能超过权重读取量,这也是后面 HBF 容量层设计动机的直接来源;
- activation traffic:层与层之间,中间激活要在片上存储与 HBM 之间往返。这项在理想估算里常被忽略,但它真实占用带宽。
再叠加上一个更根本的约束:HBM 带宽不可能 100% 用于「读下一层权重」。KV 写入、通信缓冲、控制数据都在同一根带宽上竞争。实际可用的有效带宽通常只有峰值的一部分。
天花板与实测之间的差距说明了什么
材料给出的两条速率区间是:不开投机解码 1000–2000 token/s 每用户;开投机解码 5000–10000 token/s 每用户。而实测的现实是「远未接近其中任何一个」。
这里出现了一个很有价值的推理:既然实测远低于带宽天花板,那带宽就不是唯一的限制资源。 这句话是整个架构设计的转轴——它把优化目标从「堆更多带宽」变成了「找出还差在哪」。
那还差在哪?材料没有直接列清单,但从前面的三阶段分析可以推出来:
- 固定延迟。长延迟路径、共享内存子系统的争用、昂贵的全局栅栏,都会让计算单元等数据。带宽再高,数据晚到就没有意义;
- 同步。每个阶段边界、每次集合同步都会产生一段「谁也不能干活」的时间,这段空白靠带宽补不回来;
- 软件成熟度。材料在讲下一代路线图时,把「更成熟的服务软件」列为三大改进方向之一,承认当前调度与编排还没有把硬件潜力吃干。
这三条正好构成了后面架构设计的全部动机。换句话说,带宽上限的计算不是为了宣传性能,而是为了定位瓶颈。这正是「协同设计」这个说法的真正含义:先用量级估算划定上界,再用实测与上界的差距决定该优化什么。
一个实用的方法论
把这一页的方法论抽象出来,它是一个可以反复套用的流程:
- 选定一个物理资源,写出它的理论上限公式(这里是带宽 → token 速率);
- 代入你手上最好的硬件参数,算出上界;
- 把上界与实测值对比;
- 若差距巨大,说明该资源不是瓶颈,把优化预算投到别处;若差距很小,说明该资源确实卡住了,值得投入。
第 4 步是最容易做错的一步。绝大多数性能讨论都停在第 1 步:算出带宽上限很惊人,于是得出结论「应该堆带宽」。而材料做的事情是把第 3、4 步也做完,于是得出结论「带宽不是唯一瓶颈,应该消除固定开销」。这两条路线的架构结果截然不同:前者会走向更多 HBM 堆叠,后者走向切片与低延迟网络。
与站内内存墙讨论的衔接
这里的结论和同一批讲座材料里关于 HBF(高带宽闪存)的部分是同一条线索的两端。Jalapeño 用定制 ASIC + HBM4 + 低延迟网络把热路径做到极致;当上下文、专家数和并发继续扩大时,容量层会变成另一个必须解决的问题。这条线的完整展开见本站 HotChip/FMS 内存墙(一):HBM scaling、3D-DRAM、PIM 与 CXL-PNM 与 HotChip/FMS 内存墙(二):HBF、OCP HBF Spec 与 HBF-Compass。
带宽账本身也有一个工程背景需要交代:为什么带宽会成为推理的第一瓶颈。这来自自回归解码的本质——每生成一个 token 都要把整层权重读一遍,而算力只用到矩阵乘的极小一部分(batch 小时,矩阵乘的算术强度极低)。这部分机理在 GPU GEMM 优化系列 与 连续批处理完全拆解 里有完整推导,此处不重复。
切片架构:把访存局部性固化成物理布局
既然结论是「不该只堆带宽,该消除固定开销」,接下来的问题就是:怎么在硅片上消除固定开销。讲座材料给的答案是切片。
三条并行的设计原则
材料的第 19 页把架构决策并列成三条,它们是同一个想法的三个侧面。
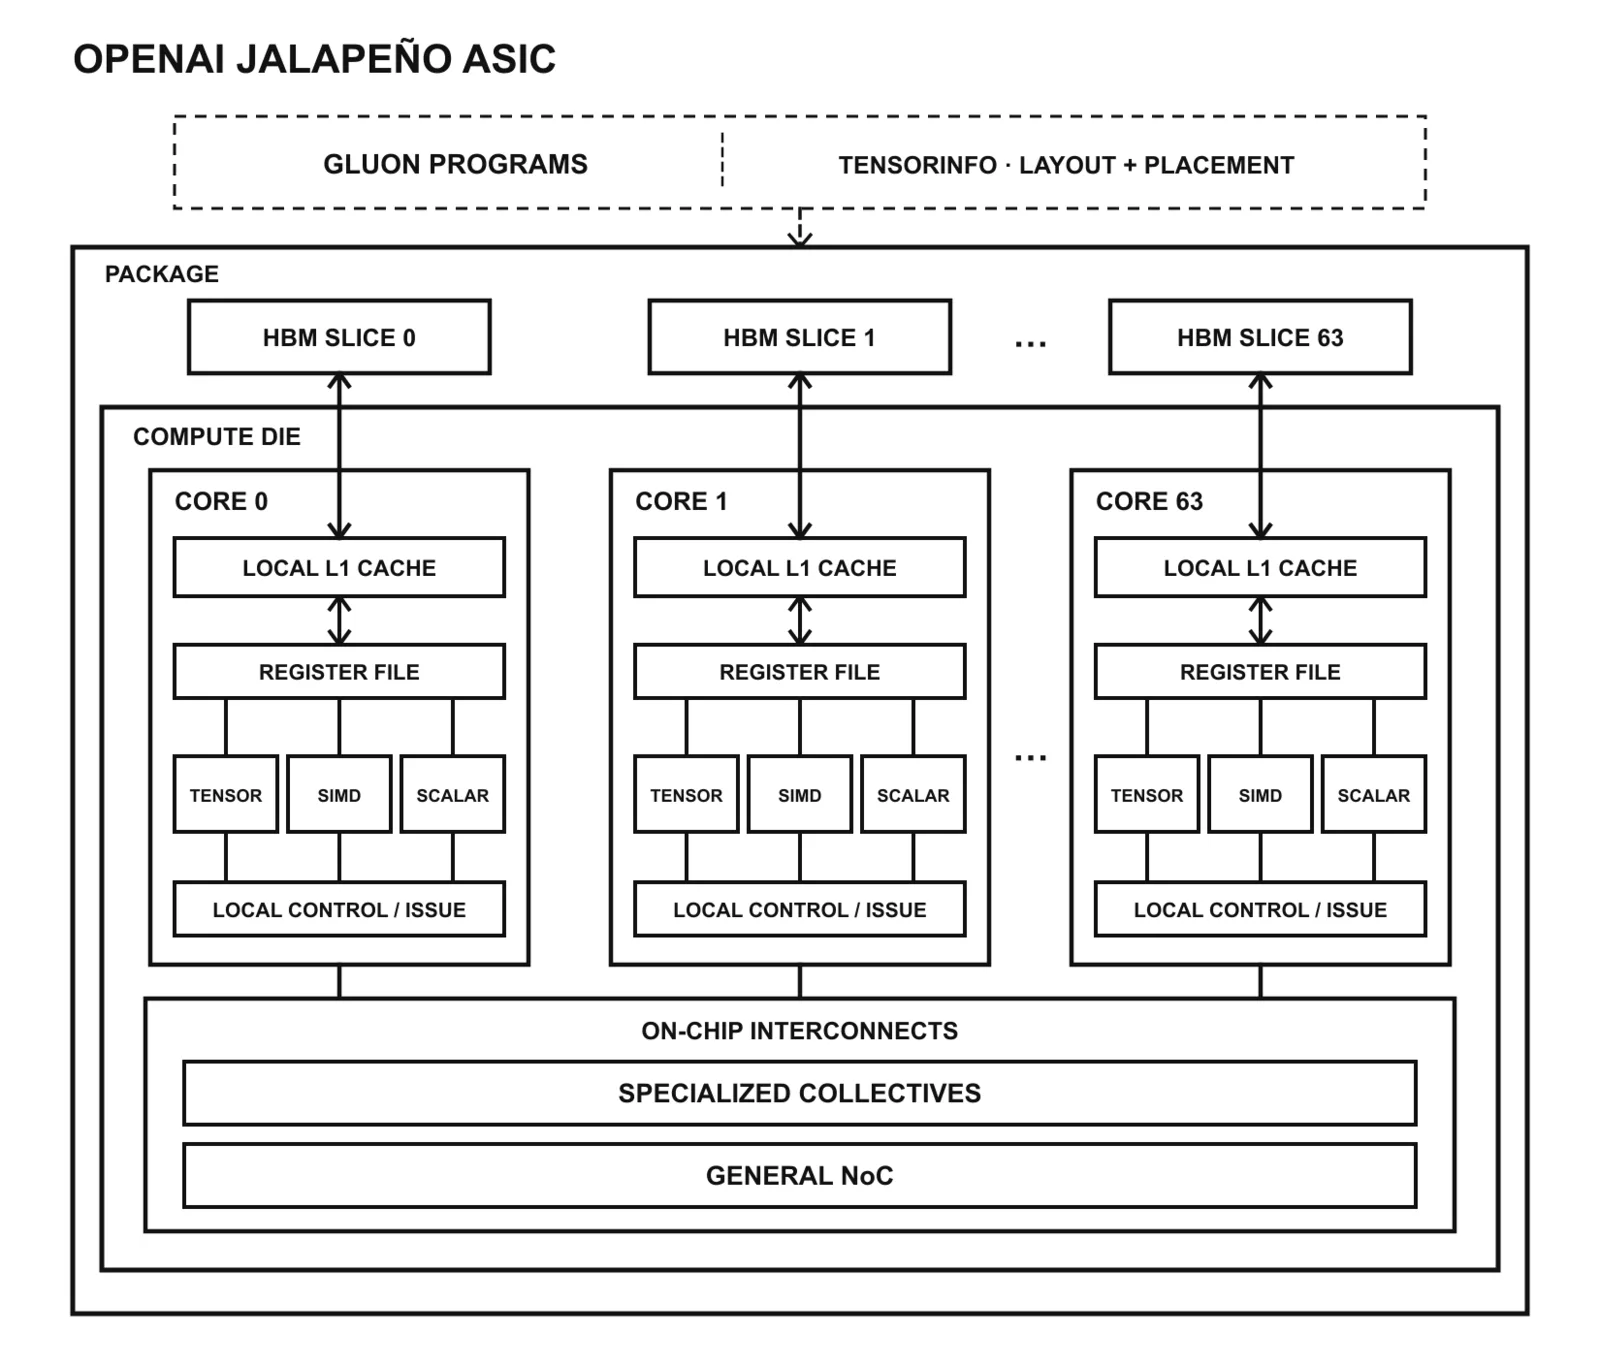
图:芯片架构的对比视角——每个核心切片与一份 HBM 切片配对,形成低延迟本地视图;跨切片通信走专用集合网络,通用通信与 scale-up 接入走保留灵活性的共享 NoC(来源:讲座材料第 19—20 页)
原则一:最快的本地路径——每个核心切片配一个 HBM 切片。 芯片被切成 64 份,每份包含一组计算核心与一份 HBM。这一对构成一个「本地视图」:这片核心访问自己的 HBM 切片时,走的是最短、最宽、延迟最低的路径,不需要穿过任何全局交换结构。
原则二:专用的跨核网络。 跨切片通信不是没有,而是被收敛到一条专用的集合通信网络(collective network)。它的带宽与延迟按「常见的通信模式」优化——具体说就是张量并行的 all-reduce 这类有规律、可预测的集合操作。
原则三:保留通用性的共享 NoC。 除了专用路径,还有一条普通的片上网络(NoC),它的带宽更低、延迟更高,但更灵活,并且承担接入 scale-up 网络的桥接。材料对它的定位是「通用通信与接入 scale-up 网络」。
三条原则合起来,落成一句设计原则:把常见操作数留在本地;只在必要时才走共享路径。
为什么「本地视图」能省下功耗和延迟
这条设计值得从机理上拆一遍,因为它是整颗芯片能效优势的主要来源。
GPU 的内存访问路径大致是:计算单元 → 寄存器/共享内存 →(可能经过 L1)→ L2 切片 → 交叉开关 → 内存控制器 → HBM。这条路径上有几个特征:
- L2 与交叉开关是为「任意访问」设计的,它们必须处理任何地址、任何模式,因此电路复杂、延迟高、功耗大;
- 延迟不可预测,取决于命中率和争用,程序员只能靠「数据量大到足以摊薄」来掩盖;
- 每一个字节都要走完整条路径,包括那些本来就在同一片区域的数据。
切片化之后,本地访问的路径被压缩成「核心切片 → 本地 HBM 切片」。省掉的不只是延迟,还有整条共享结构上的动态功耗。在 700 W 量级的芯片上,内存子系统(L2、互连、控制器)的功耗占比相当可观,把它按访问局部性切掉一部分,是能效提升的直接来源。
另一个收益是延迟可预测。本地路径的延迟是一个接近常数的小值,这让软件可以做精确的流水线规划——不需要为最坏情况留余量。
代价:软件必须规划数据的位置
这条路的代价,材料在同一页的后半说得非常直接:
在数据放置上的权衡发生了转移:Jalapeño 可以缩短常见数据路径,但软件必须决定数据住在哪里、以及何时在切片之间移动。
这句话需要认真对待,它是「协同设计」中「设计」那一半的真实含义。在 GPU 上,程序员不需要关心「这块权重放在哪个 L2 切片」——硬件自动路由。而在切片架构上,「权重放在哪个 HBM 切片」变成了一个显式的、必须回答的问题。
这带来一串工程后果:
- 放置决策要跟着模型结构走。权重按层切分、按张量并行的分片方式分配,要让「使用这块权重的核心」和「存这块权重的 HBM」是同一对切片;
- KV 缓存也要按同样逻辑放置。KV 要跟产出它的请求所在的核心走,否则跨切片读 KV 会把优势吃掉;
- 数据移动要显式调度。当某个张量并行组的排布需要跨切片时,软件要决定什么时候搬、搬多少、走哪条网络(专用集合网络还是通用 NoC);
- 放置错了会退化。如果放置与访存模式不匹配,大部分访问都会被推进共享 NoC,此时切片架构相比普通 GPU 反而可能更差——因为它把硬件复杂度和软件负担都加上了,却没换来局部性收益。
第 1 到 3 条恰好解释了后面为什么需要一个能「翻看详细 trace、搜索放置方案」的自动化优化主体。人工规划 840 mm² 芯片上 64 个切片的权重与 KV 放置,在模型每几周就变一次的现实下是不可能完成的任务。
计算单元:为什么乱序核是反惯例的选择
材料在第 20 页对比 Jalapeño 与 Blackwell 的架构时,把一个与行业惯例相反的决策讲了出来。
行业惯例是「软件管理 scratchpad + 异步 DMA」。在典型的加速器与 GPU 编程模型中,片上存储(shared memory / scratchpad)由程序员显式管理:什么时候把哪块数据搬进来、搬多少、什么时候释放。这样做的好处是确定性极强、没有硬件猜测、效率可控。
Jalapeño 的选择是 64 位乱序标量核,带 L1 缓存。 换来的东西材料讲得很清楚:没有 barrier 这类固定延迟。
这条对比可以从一个具体场景理解。考虑一个小形状负载:矩阵只有几十行,计算本身可能只花几微秒。如果是「scratchpad + DMA」模型,那么典型流程是「发起 DMA → 等 DMA 完成信号 → 开始计算」,这个「等」是硬性的同步点,哪怕数据其实早就到了。乱序执行把这个硬等变成了「等数据的时候去做别的事」——只要还有独立的工作可做,执行单元就不会空转。
而这个选择的代价也很明确:它把「不要等」的责任转移到了依赖预取(prefetching)的及时性上。乱序执行要发挥效果,前提是「需要的数据已经在路上」。人类程序员很难手工安排几十上百条预取指令的时序,但一个能反复读取详细执行 trace、反复搜索参数的自动化优化主体可以做这件事。这正好呼应了后面的「AI 写内核」那一段。
材料在对比 Blackwell 时的措辞值得引用:「Blackwell 有更好的灵活性:GPU 的 SM 用硬件调度和共享内存层次」。这句话并不是在贬低 Jalapeño,而是在陈述一个真实的取舍:
| 维度 | GPU SM(Blackwell) | Jalapeño 核心切片 |
|---|---|---|
| 调度 | 硬件调度,对程序员透明 | 显式放置 + 分布式控制 |
| 内存层次 | 共享的、统一的 | 切片本地视图 |
| 编程负担 | 低(硬件自动路由) | 高(软件决定数据住哪、何时搬) |
| 常见数据路径长度 | 长(穿过共享结构) | 短(本地路径) |
| 灵活性 | 任意访问模式都支持 | 适合可预测的访存模式 |
材料的判断是:GPU 的灵活性更强,Jalapeño 的定制优化更强,取舍点从「硬件自动处理」转移到「软件规划放置」。这个转移不是免费的、也不是普遍适用的——它成立的前提是「访存模式可预测」,而推理恰好满足这个前提。
顺带说明这颗芯片的整体规格定位,方便后面讨论网络时对照。
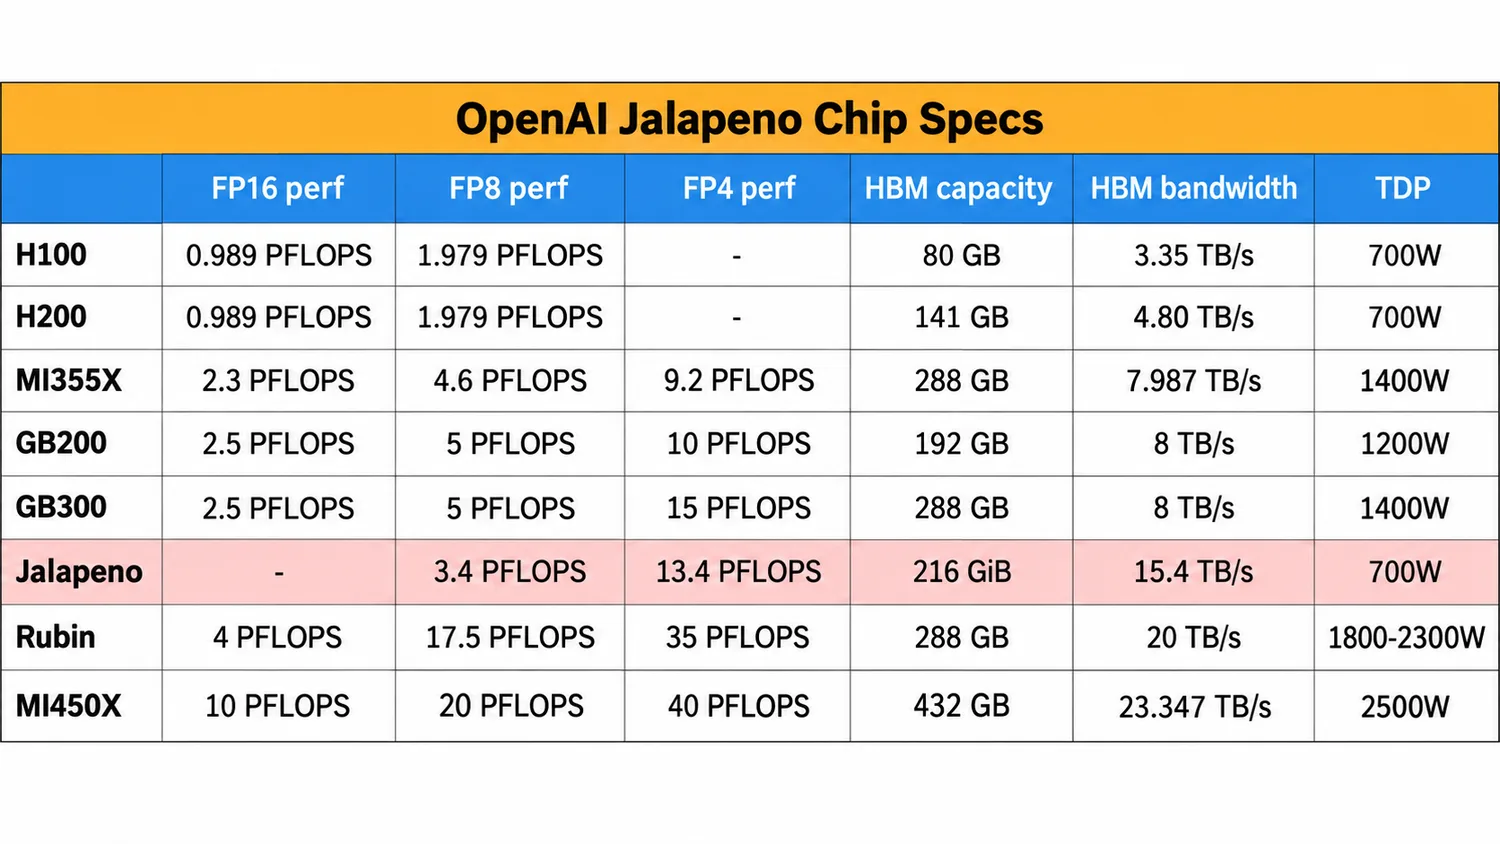
图:Jalapeño 规格与对比对象。材料原话:Jalapeño 达到可比的 FP4 性能,但 TDP 只有一半;六组 HBM4 提供 216 GB 与 15.4 TB/s,约为 H100 的 3 倍容量与 5 倍带宽(来源:讲座材料第 16 页,数据原始出处为 SemiAnalysis)
材料用三个问题定义了「规格该怎么读」,这三个问题可以当作读任何推理芯片规格表的方法论:
- FPX 性能 → 决定算力上限,对应 prefill 与 compute-bound 场景;
- HBM 容量 → 决定能装下多大的模型权重 + 多大的 KV 缓存,对应「模型放得下吗」;
- HBM 带宽 → 决定从 HBM 读数据有多快,对应 decode 的 token 速率。
三项里任何一项落后,都会在某个阶段变成硬墙。这也是为什么「按峰值算力排芯片」在推理语境下意义有限。
机架与网络:把局部性从芯片扩展到整机
芯片内部的切片解决的是「核心与它自己那块 HBM 的距离」。但万亿参数模型装不进一颗芯片,规模问题必须在机架层面再解决一次。讲座材料用三页讲了这件事,并把它与英伟达的方案做了对照。
Katsu 与 Vindaloo:把「本地性」推到机架级
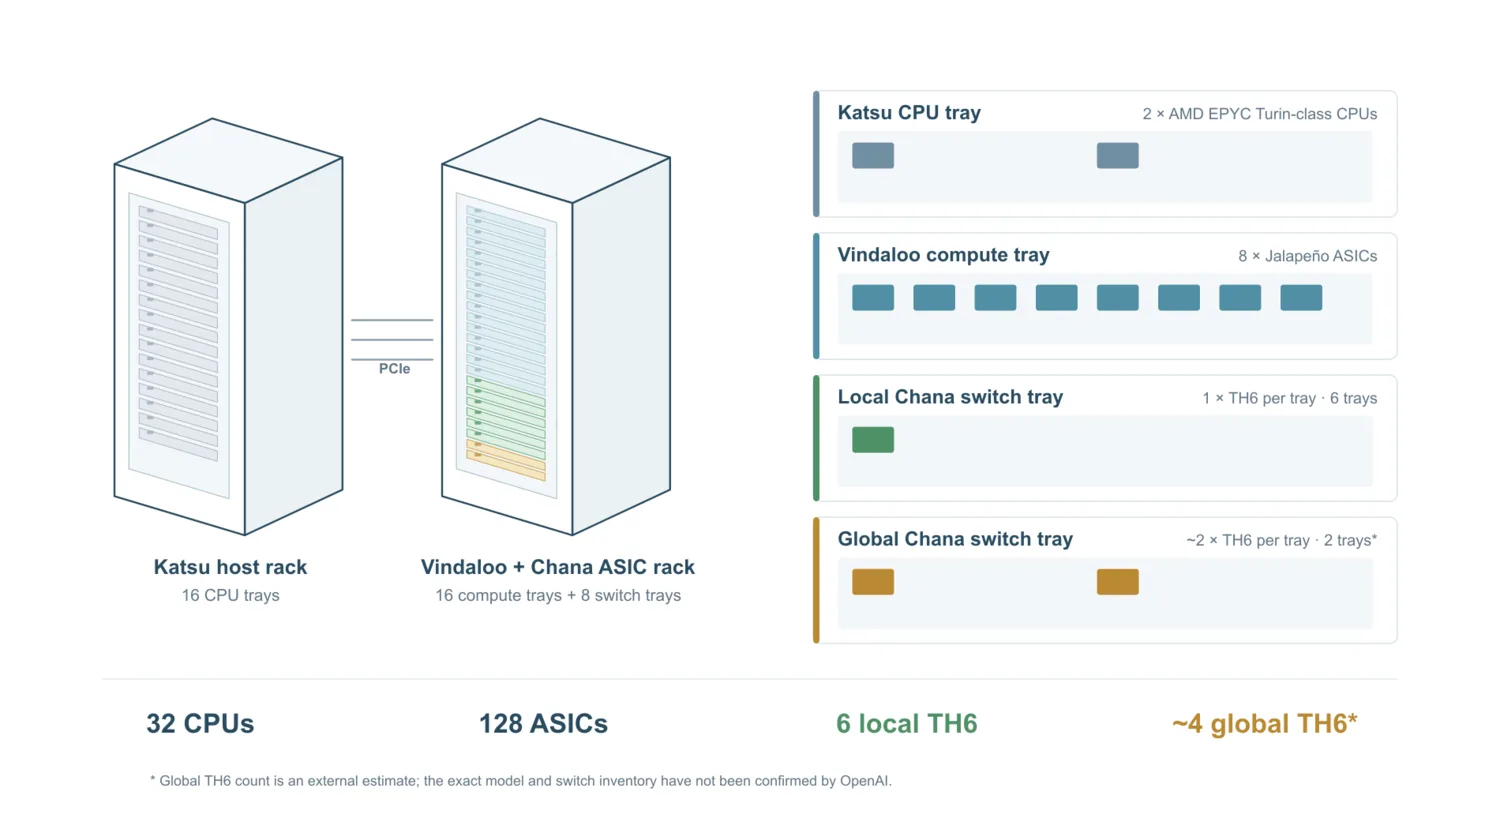
图:Katsu 宿主机架 + Vindaloo 加速器机架的层级结构(来源:讲座材料第 21 页)
材料给出的结构是:
- Katsu 宿主机架里有 32 颗 CPU,它们通过 PCIe 连接到 Vindaloo 加速器机架里的 128 颗 ASIC;
- 本地交换机负责机架内 ASIC 之间的互连;
- 全局交换机把网络延伸到跨机架的范围。
这个层次结构与芯片内部的切片是同一思想的放大版:先解决「近距离」,再解决「远距离」。机架内的互连短而宽,跨机架的网络长而窄,两者承担不同的通信模式。
全局域:八条平行轨连接 2048 颗芯片
第二层扩展把范围推到整机群。
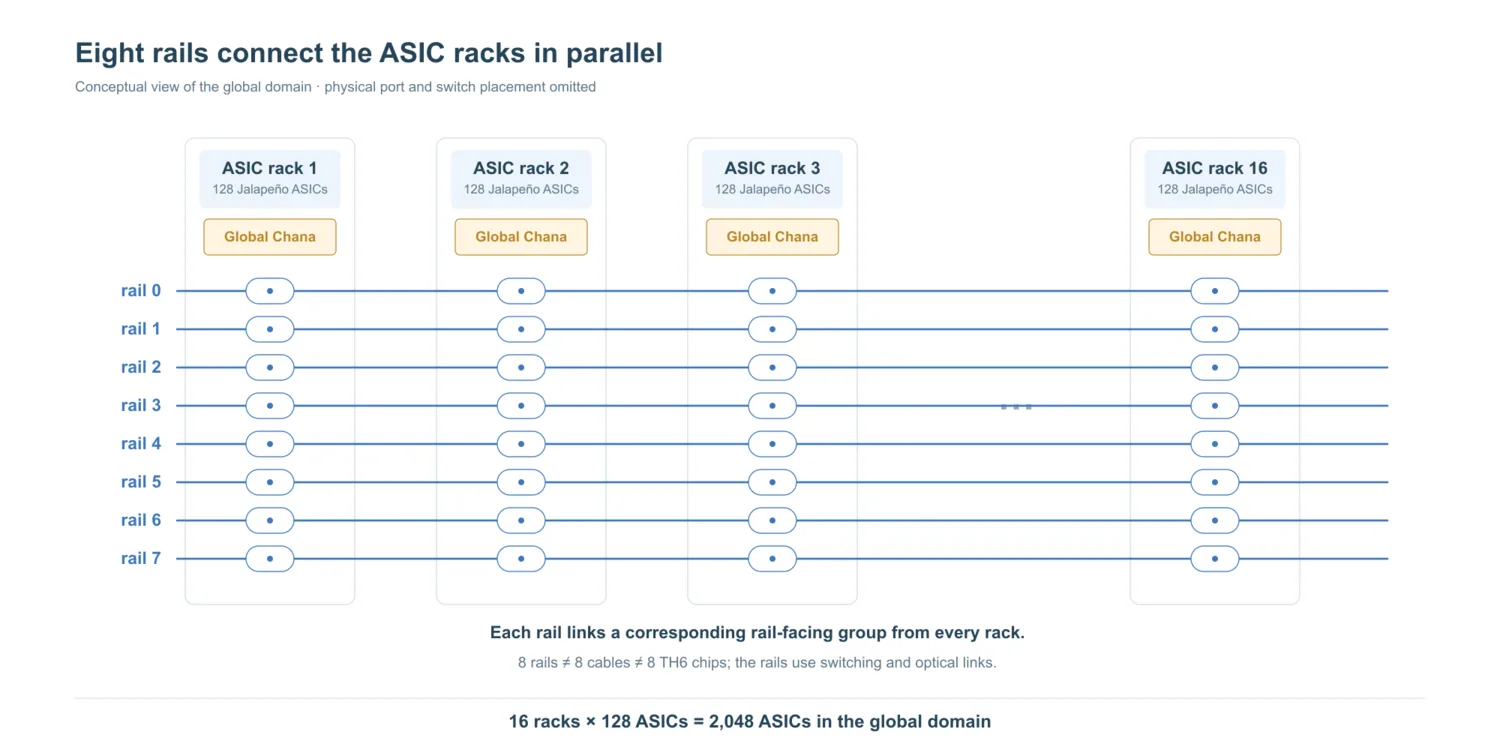
图:全局域拓扑——8 条平行轨连接 16 个 ASIC 机架,全局域共 2048 颗 ASIC(来源:讲座材料第 22 页)
材料的描述是:八条平行轨(rail)连接 16 个 ASIC 机架,全局域共 2048 颗 ASIC。
「轨」(rail)这个拓扑选择需要解释一下。在 rail-only 架构里,机架里每颗芯片只连到一条全局轨,同一轨上的芯片来自不同机架。这样做的效果是:跨机架的通信只需一跳交换,而不是先汇聚到机架内再统一出去。对 all-to-all 类的专家并行通信来说,这能显著减少跳数和缓冲层级。
2048 颗芯片的规模意味着:按 128 颗/1.7 EFLOPS 推算,全局域约有 27 EFLOPS、432 TiB 的 HBM4 容量。这个规模是为下一代模型留的余地——十万亿参数级模型、百万 token 级上下文,都需要这个量级的单一互连域。
与 GB200 NVL72 的对照
材料专门用一页讲英伟达的对照方案。
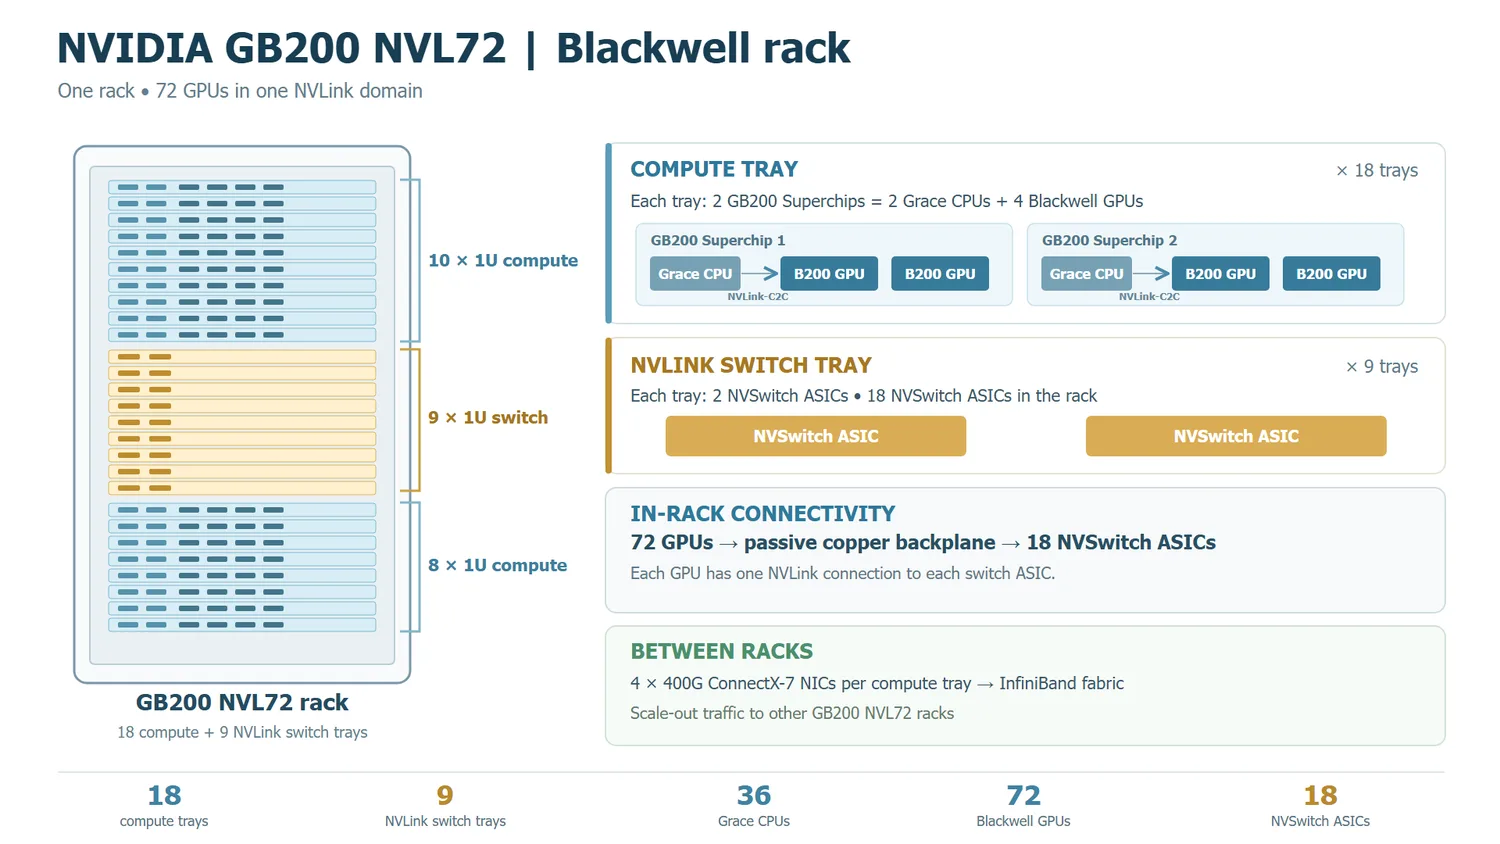
图:NVIDIA GB200 NVL72 的机架构成(来源:讲座材料第 23 页,原始出处为 NVIDIA GB200 NVL Partition User Guide)
材料给出的事实是:18 个计算托盘承载 36 颗 Grace CPU 与 72 颗 Blackwell GPU;18 颗 NVSwitch ASIC 负责机架内通信,机架之间用 InfiniBand 连接。
两者的结构差异可以列成对照:
| 维度 | GB200 NVL72 | Jalapeño |
|---|---|---|
| 机架内加速器数量 | 72 颗 GPU | 128 颗 ASIC |
| 机架内互连 | 18 颗 NVSwitch | 本地交换机(机架内全互连) |
| 跨机架网络 | InfiniBand | 全局交换机 + 8 条 rail |
| 全局域规模 | — | 16 机架 / 2048 ASIC |
| 内存容量的组织 | 统一共享,硬件处理 | 切片本地视图,软件放置 |
差异的根源不在数字,而在设计前提不同。GB200 NVL72 的设计前提是「通用性」:任何模型、任何并行策略、任何访问模式都要能跑,因此需要一套通用的交换结构与统一内存模型。Jalapeño 的设计前提是「推理的访存模式可预测」,因此可以把通信模式收敛为少数几种已知形态,用专用网络承担它们。
这也是材料在讲「局部性是王道」时真正的含义:局部性的收益不是一次性的,它可以沿着「芯片内切片 → 机架内互连 → 全局轨」层层复制。
规模背后的真实约束:功率
材料没有把机架规模说成纯粹的优点。一个隐含事实是:128 颗 ASIC 的机架,功耗是硬约束。第 16 页给出的对照数字是 Jalapeño 的 700 W 封装 TDP,对应 GB200 的 1200 W——注意材料的措辞是「可比的 FP4 性能,但 TDP 只有一半」。
这句话解释了为什么机架能塞进 128 颗:不是因为芯片更小,而是因为它每颗更省电。在机架功耗预算固定的前提下,单芯片 TDP 减半意味着机架内的芯片数量可以翻倍,而机架级聚合带宽与算力因此也翻倍。
这条关系值得单独记下来,因为它把「能效」和「规模」两个看似独立的指标绑在了一起:
在 不变的情况下, 越低的芯片,能在同一机架里塞进越多颗。这就是为什么「每瓦性能」在推理场景里不只是电费问题——它直接决定了单机架的规模上限。
规格是这样收敛出来的,而不是先写好的
一个反直觉的流程主张
讲座材料在讲设计流程时给了一句相当硬的主张:规格是在循环中变得精确的,而不是在此之前。
这句话和大多数硬件课程的讲法相反。教科书里的流程是「先写死规格 → 再实现 → 再验证」,规格是输入。而材料把它当成了输出。
一个佐证是:重大改动一直持续到 RTL 冻结的那一天。这意味着在冻结之前,架构仍在被修改——如果规格早就写死,这些改动不可能发生。
把这条主张翻译成工程语言,它是这个意思:在复杂 SoC 设计中,「正确的规格」本身是一个搜索问题,而不是一个可以先验确定的常量。因为你无法在设计开始前就知道「哪个微架构决策会在最终 PPA 上产生多大收益」——那需要先实现、先综合、先度量。
收敛循环的五个环节
材料把流程画成一个环:Vision → Workload → Simulate → RTL + QoR → Convergence,并配了一句口号:MEASURE → VERIFY → LEARN → CHANGE → REPEAT。逐个看这五个环节在做什么。
01 Vision(愿景):材料写的是「在细节全部清楚之前就出发」。这不是鲁莽,而是承认「细节要靠循环获取」。愿景提供的是搜索的方向,不是终点的坐标。
02 Workload(工作负载):「跑真实工作负载的程序」。这一环是整个流程里最容易被低估的。
为什么真实负载是必需品而不是加分项?因为芯片的优化目标(前面几节建立起来的「三阶段端到端延迟 + 每焦耳 token」)只在真实负载分布下才有意义。若用合成 benchmark,你优化的是一个不存在的工作点:真实的输入输出长度分布、真实的投机接受率、真实的长上下文占比,这三项共同决定了三段的比例——而合成负载里这些参数往往是拍脑袋定的。
更实际的一点是:真实负载才能暴露「固定开销」。前面反推带宽上限时得出的结论是「带宽不是唯一瓶颈,固定延迟才是」——而固定延迟只有在真实负载的低 batch、小形状、突发通信场景下才会显现。合成 benchmark 里小形状往往被有意避开。
03 Simulate(仿真):「全架构仿真提前验证性能」。这一环是把「Vision」变成可度量对象的工具。材料后面提到仿真器与实测硬件的误差在 5% 以内,这个精度是流程能高速迭代的前提——如果仿真器误差是 50%,那基于仿真做的架构决策就毫无意义。
04 RTL + QoR(实现与质量度量):「实现、综合、快速反馈」。这一环的关键词是快速。QoR(Quality of Results,结果质量)是 EDA 流程里对综合结果质量的统称,包括时序、面积、功耗。它的反馈速度决定了循环能转多快——而循环速度决定了在固定时间内能搜索多少个微架构变体。
05 Convergence(收敛):「把 DV、PD 与性能放在一起追踪」。DV 是 design verification(设计验证),PD 是 physical design(物理设计)。这一环的要求是「三者同步追踪」——因为性能、正确性、可制造性是相互牵制的:为了性能加的流水线级数会让时序收敛变难;为了改善物理布局改的模块划分可能引入新的功能风险。分开追踪就会在最后阶段爆发冲突。
材料的总结句是:「通过缩短循环并不断重复来取胜」。这句话把流程主张的实质点出来了——核心变量不是某个环节的绝对效率,而是整个循环的周期。
循环周期为什么直接决定 PPA
这里可以给出一个粗略但有用的量化直觉。设:
- 一个架构决策的收益分布是未知的,需要实测才能知道;
- 单次循环耗时 ;
- 项目从概念到流片的可用时间 。
那么能评估的变体数量大约是:
越大,从设计空间里找到的极值越靠近真实最优。这就是为什么「缩短循环」比「提高单次循环质量」往往更划算:把 从 4 周压到 1 周,等于把搜索次数翻四倍;而在 4 周周期里把仿真精度从 90% 提到 95%,并不会让搜索结果好四倍。
材料给出的项目时间线也印证了这个逻辑:从 2024 年 10 月的架构概念,到 2025 年 2 月的初始 RTL,到 2025 年 11 月流片。中间的 RTL 冻结发生在 2025 年 7 月,也就是说从初始 RTL 到冻结有 5 个月的时间窗口,在这段窗口里持续做架构改动——这正是「快速循环」的用武之地。
QoR 反馈为什么必须「快」
QoR 这一环值得再展开一点,因为它涉及一个大多数人不熟悉的工程约束。
综合(synthesis)与布局布线(place and route)的完整流程通常以小时到天计。如果每次架构修改都要等完整流程跑完才知道 QoR,循环周期就被物理限制死了。
于是设计流程里普遍采用快速 QoR 估算——用一个简化但快得多的模型给出 PPA 的近似值,让架构探索的循环以分钟到小时为单位转起来。材料把这一条明确列为流程的一个环节(「Implement, synthesize, rapid feedback」),说明它被视为流程的关键组成部分而非附属工具。
这也解释了材料为什么强调 XLS:XLS 是一个 HLS(High-Level Synthesis,高层次综合)工具链,它的价值在于「可控的优化面」——材料列为四个要点:
- 清晰的语义(Clear semantics);
- 足够的优化控制(Enough control to optimize);
- 快速的 QoR 反馈(Fast QoR feedback);
- 稳健的验证(Robust verification)。
这四条合起来描述的是一个「能被自动化搜索的硬件描述层」:语义清晰意味着搜索的主体能推理代码行为;足够控制意味着可以表达微架构决策;快速 QoR 意味着每次搜索有即时反馈;稳健验证意味着搜索结果可以被自动判断正确性。
而流程的实际形态是 「AI + DESIGNER: propose → measure → optimize」——人(或自动化主体)提出候选,度量结果,再优化。这是一个典型的闭环搜索,而不是一次性的「写代码」。
影响一:晚阶段的改动能力
材料把 AI 参与设计的影响分成两条。第一条是晚阶段的改动能力(LATE-STAGE VELOCITY)。
支撑这条的一句话是:「重大改动一直落地到 RTL 冻结当天」。在传统流程里,越接近冻结,改动的成本越高、风险越大;而在快速循环的流程里,晚阶段的改动仍然是可评估、可验证的——因为评估和验证的周期都很短。
这条能力的意义不只是「快」,而是它改变了设计空间的可达范围。如果只有前 20% 的时间能做架构决策,那么你只能探索那些「一开始就能想到」的方案;如果决策窗口一直开到冻结日,那么设计空间里那些「需要先实现才能发现」的方案也进入了可达范围。
影响二:可度量的 PPA 收益
第二条影响是相对优化过的人类基线的 PPA 提升(MEASURED PPA WINS VS OPTIMIZED HUMAN BASELINE)。
注意材料对比的基线措辞:不是「人类初版」,而是「优化过的人类基线」。这个区别很重要——如果对比的是未经优化的初版,收益数字会好看得多但没有意义。
材料给出的具体数字是:矩阵单元面积减少 10%,SIMD 单元面积减少 8%,来源标注为 block-level PPA improvements。
这两个数字的量级需要放在上下文里理解。在先进工艺节点上,一个重复性高的计算单元(矩阵单元、SIMD 单元)是面积的主要贡献者之一,它们在整个 die 里会复制几十份。单个单元面积减少 10%,在整颗 die 上意味着可观的总面积节省——而面积在巨 die(接近光罩极限)上直接关系到良率与成本。
更重要的是,这个收益的来源不是「AI 比人聪明」,而是「搜索次数多」。微架构参数(流水线级数、寄存器数量、功能单元复用方式、数据通路宽度)构成一个巨大的离散空间,人类设计者只能凭经验试少数几个点;自动化的「生成 → 验证 → 度量 PPA」循环可以试得更多。这解释了为什么收益出现在重复性高、参数化程度高的模块上——这类模块的搜索空间大而收益可度量,正好适合自动化。
这一段与 Jalapeño 主文的分工
需要说明一下与站内已有内容的关系。「AI 参与设计」这件事本身——Codex 如何写内核、Gluon 语言、Linear Layouts 布局代数、芯片模拟器误差 5% 以内的具体细节——已经在 OpenAI Jalapeño 完全拆解 的「软件栈」与「为什么这么快」两节里做过完整梳理,本文不重复。
这里要补的是讲座材料独有的角度:它没有停留在「AI 帮忙了」这个结论上,而是说明 AI 帮忙的具体形式是「缩短收敛循环」。
这个区分不是文字游戏。如果 AI 的作用是「代替人写 RTL」,那么流程的主体仍然是线性的,只是实现环节变快了;而如果 AI 的作用是「让收敛循环转得更快」,那么流程本身变成了一个搜索过程,架构决策可以在循环中被反复修正。后者对设计方法的改变是结构性的,也是「规范在循环中变精确」这句话能成立的原因。
一个不能省略的前提:验证
材料在讲流程时提到「DV、PD 与性能同步追踪」,这一条不能当作套话略过。
快速循环有一个天然的风险:改动越多,未验证的状态就越多。如果把循环周期压缩到极致却放松了验证,那么流程会把「未被发现的功能错误」快速累积到最后阶段,那时的修复成本是整个项目最贵的一笔。
因此「快速循环」在工程上必须配一个条件才能成立:验证也必须被加速,并且与性能评估同频。材料把它写进收敛环节(DV/PD/performance 一起追踪),正是这个原因。这也解释了为什么「稳健的验证」被列为 XLS 的四个要点之一——没有它,快速循环只是把风险提前埋下。
这一点在软件侧的对应物是内核的正确性检查与自定义 sanitizer:快速生成的高性能内核必须有等强度的正确性验证配套,否则性能提升会被偶发的正确性故障吞掉。这一条在主文里有具体描述。
多代路线图:架构解锁的是什么
讲座材料结尾给了一张三代路线图。它的价值不在于描述产品计划,而在于它把「这一代没解决什么、下一代要解决什么」写清楚了。
图:Jalapeño 的多代路线图(来源:讲座材料第 26 页)。材料给出的三条主张:Gen 3 让前沿模型在交互式 SLA 延迟下变得经济可行;Gen 2 把优势扩展到非交互式推理;架构解锁的关键是 HBM——主要瓶颈在于把聚合 HBM 带宽暴露出来,而不是增加原始带宽
三代的分工可以这样读:
- Gen 1(Jalapeño):材料标注为「接近流片」。它验证的是架构方向——切片本地性、统一异构芯片、不做硬件级 P/D 分离,这一整套前提能不能成立;
- Gen 2:材料写的是「更好的每瓦性能」,并且明确说「优势延伸到非交互式推理」。这句话含义很具体:Gen 1 的优势集中在低延迟、低 batch 的交互场景(因为它的架构收益来自消除固定开销与本地化访存);而吞吐导向的高 batch 场景里,固定开销的占比会下降,本地性的收益也会被摊薄。Gen 2 要解决的是把这套架构的收益扩展到批处理场景;
- Gen 3:材料写的是「经济可行的低延迟服务——前沿模型在交互式 SLA 延迟下变得实用」。
「架构解锁 HBM」这句话该怎么读
三代路线图里最值得琢磨的是第三条主张:「架构解锁 HBM——主要瓶颈是把聚合 HBM 带宽暴露出来,而不是增加更多原始带宽」。
这句话与前面「带宽上限反推」那节形成了闭环。回忆那节的结论:实测 token 速率远低于带宽天花板,所以带宽不是唯一瓶颈。既然如此,正确的做法就不是「再叠几层 HBM」——那只会把天花板抬得更高,而你依然够不到;正确的做法是把已有的聚合带宽真正暴露给计算单元。
「暴露聚合带宽」是什么意思?它指的是让芯片间与机架间的聚合带宽能像访问本地 HBM 一样被有效利用。在 Jalapeño 的架构里,有两条路径支撑这件事:
- 芯片内的切片本地视图:核心访问自己的 HBM 切片走最短路径,这一部分带宽是「已经暴露」的;
- 机架与全局域的互连:128 颗芯片的聚合带宽要通过本地交换机与全局 rail 网络才能真正被用起来。
而「暴露」失败的地方,正是前面提到的三类开销:长延迟路径、同步、软件调度。所以这句话的完整含义是:下一代的关键不在于把 HBM 堆得更多,而在于把已经堆上去的带宽从各种开销里解放出来。
当前这一代的明确短板
讲座材料的结论页把 Jalapeño 的下一批挑战列了出来。这些不是模糊的展望,而是具体的技术落差:
- 峰值 FP8 算力落后于 GB300:材料给的数字是 3.4 对 5 PFLOPS。这解释了「每瓦赢了、算力没赢」——Jalapeño 的设计取向是能效与延迟,不是峰值算力。而在高 batch、compute-bound 的场景(例如大批量 prefill),峰值算力的落差会变成实际差距;
- 实测 token 速率仍低于带宽估算:也就是前面那节讲的「天花板与实测之间的差距没有被填平」;
- 明确的三个改进方向:材料写的是「更好地利用聚合 HBM 带宽、更少的同步、更成熟的服务软件」。
这三条改进方向恰好是本文前面三节各自得出的结论:
| 改进方向 | 对应的本文分析 |
|---|---|
| 更好地利用聚合 HBM 带宽 | 带宽上限反推:天花板够高但够不到 |
| 更少的同步 | 三阶段分析:阶段边界与集合通信是固定开销来源 |
| 更成熟的服务软件 | 切片架构:放置规划的责任转移到软件侧 |
一个值得记下的观察:架构结论先于工艺结论
把讲座材料的结构再看一遍,会发现它的论证顺序很特别:先建立「三阶段异构」这个负载事实,再据此推出「不该按阶段切硬件」这个系统结论,最后才讨论芯片细节。
这个顺序的意义是:架构结论的成立与否,取决于负载特性的稳定性,而不是工艺的先进性。
只要推理请求仍然是「prefill + draft + verify 三段串行」,只要三段比例仍然随模型、上下文、接受率漂移,那么「统一异构、局部性优先」这条结论就成立——它与用 3nm 还是 2nm、用 HBM4 还是 HBM5 无关。反过来,如果未来某一天推理负载的结构变了(例如某类模型彻底取消了 prefill 与 decode 的区分,或者投机解码被完全内化到模型本身),这条结论的前提就会动摇。
这是本文标题里「为什么推理芯片不该拆成三种专用加速器」的完整含义:这个判断是一个负载判断,不是一个工艺判断。
小结
把整篇的推理链压缩一遍:
- 推理请求不是均匀负载。Prefill 是 compute-bound、Draft 是 latency-bound(小模型 + 极低 batch)、Spec-verify 是 HBM-bandwidth-bound 且通信突发。三段撞在不同瓶颈上,而用户感知的是端到端延迟之和;
- 系统形态的岔路是「搬 KV」还是「改活跃配比」。分离式专用化把异构性放到机架之间,代价是每个阶段边界都要跨网络搬运 KV 并同步;统一内部异构把异构性收进芯片,按阶段改变活跃的计算/内存/网络比例,未用单元门控(dark silicon 比闲置加速器便宜);
- 支持统一路线的关键事实是比例漂移。三段占比由模型架构、token 效率、上下文长度、注意力算法、投机接受率、延迟/吞吐取向共同决定,没有一个是常量。硬件级的分池一旦比例失配就永久空转,软件级的分池可以随时调整;
- 带宽上限反推给出了方向。128 芯片聚合 1+ PB/s 带宽、1T 参数按 4-bit 读一遍需 0.5 TB,理论上是 2000+ 次/秒的整模型读取——材料明确标注「未达成」。实测远低于天花板说明带宽不是唯一瓶颈,真正的差距来自长延迟路径、同步与软件成熟度;
- 切片架构把「访存局部性」固化成物理布局。64 对「核心切片 + HBM 切片」各自构成低延迟本地视图,跨切片通信走专用集合网络,通用通信走保留灵活性的共享 NoC。代价是软件必须负责数据放置与切片间移动——这是整颗芯片最重的软件负担;
- 乱序核是反行业惯例的选择。用 64 位乱序标量核 + L1 替代「scratchpad + 异步 DMA」,换来的是「等数据时可以做别的事」而非硬性 barrier;代价是把责任压到依赖预取的及时性上,而这个恰好是自动化优化主体擅长的搜索空间;
- 局部性可以从芯片复制到机架。Katsu(32 CPU)+ Vindaloo(128 ASIC)→ 本地交换机 → 8 条 rail 的全局域(16 机架 / 2048 ASIC)。128 颗/机架可行的前提是每颗 TDP 只有 700 W——在同一机架功耗预算下,单芯片更省电直接换来更大的机架规模;
- 规格是在收敛循环里长出来的。Vision → Workload → Simulate → RTL+QoR → Convergence,配合 MEASURE → VERIFY → LEARN → CHANGE → REPEAT。核心变量是循环周期而非单环节效率;可度量的收益(矩阵单元面积 10%、SIMD 单元面积 8%,对比的是「优化过的人类基线」)来自搜索次数,而不是「AI 比人聪明」;
- 下一代的短板是具体的:FP8 峰值 3.4 vs GB300 的 5 PFLOPS、实测 token 速率低于带宽估算,改进方向是「更好地利用聚合 HBM 带宽、更少同步、更成熟的服务软件」——正好对应本文的三条主线。
最后留一个观察:讲座材料通篇没有把「AI 造芯片」当成宣传点,而是把它当成缩短收敛循环的一种手段。这个定位比「AI 能写 RTL」要准确得多,也更难被复制——因为缩短循环的前提是「度量足够快、验证足够强」,这两件事本身才是工程难点。
参考资料
- OpenAI Jalapeño: Better Than Nvidia Blackwell(SemiAnalysis)
- OpenAI Jalapeno Custom AI ASIC at Hot Chips 2026(ServeTheHome,含官方幻灯片逐张解读)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving(arXiv:2401.09670)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting(arXiv:2311.18677)
- NVIDIA GB200 NVL72 Partition User Guide(NVIDIA)
- Google XLS: Accelerated HW Synthesis(GitHub)
- 本站:OpenAI Jalapeño 完全拆解:9 个月从零到流片,凭什么超越英伟达 Blackwell
- 本站:HotChip/FMS 内存墙(一):HBM scaling、3D-DRAM、PIM 与 CXL-PNM,推理芯片为什么不能只堆带宽
- 本站:HotChip/FMS 内存墙(二):HBF、OCP HBF Spec 与 HBF-Compass,长上下文推理的容量层怎么设计
- 本站:DistServe 完全拆解:拆开 Prefill 与 Decode,按 Goodput 调度大模型推理
- 本站:Sarathi-Serve 完全拆解:分块 Prefill 与无停顿批处理如何兼顾吞吐和尾延迟
- 本站:MTP 完全拆解:多 token 预测如何让 DeepSeek 自带草稿模型
- 本站:EAGLE 完全拆解:特征级草稿模型如何把投机解码推到 3 倍以上
- 本站:GQA 完全拆解:分组查询注意力,用 1/8 的 KV 缓存保住 MHA 的质量
- 本站:TPU v1 完全拆解(二):脉动阵列、weight-stationary 数据流与 Roofline 性能归因
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



