


VFlash 完全拆解:把视觉基元当作预测块,让机器人视觉规划快 5 倍还更准
一个自动驾驶模型为什么生成得这么慢
从”用语言推理”到”用视觉规划”
视觉语言模型(VLM, Vision-Language Model)在物理 AI 系统里越来越像一个”高层大脑”:机器人拿到摄像头画面和一句任务指令,自动驾驶系统拿到环视图像和导航意图,由 VLM 理解场景、做出决策。但理解之后,决策并不一定要用文字表达。机器人需要知道的是”左边夹爪要在哪个点抓、然后沿哪条曲线移到什么位置”,自动驾驶需要知道的是”未来 5 秒这辆车要走哪条轨迹”——这些都可以写成视觉规划(visual plan):点、边界框、轨迹。
以 2D/3D 机器人轨迹为例,一段规划是这样被模型吐出来的:
<robot_single_2d>u1 v1 u2 v2 ... u10 v10 # 左臂 10 个关键点在图像上的投影<robot_single>x1 y1 z1 x2 y2 z2 ... x10 y10 z10 # 同一批关键点的主相机坐标系 3D 坐标</robot>上面每一对或每三个数字,都是一个坐标。以站内已经拆解过的典型 VLM 为例,图像坐标会被归一化到 0–1000 再用普通数字 token 表示,3D 坐标则可能用专门的 <0>…<1000> 特殊 token 表示。无论哪种,一个坐标就是一个 token,而自回归模型只能一次吐一个。上面这段 54 个 token 的基元,就是 54 次前向。
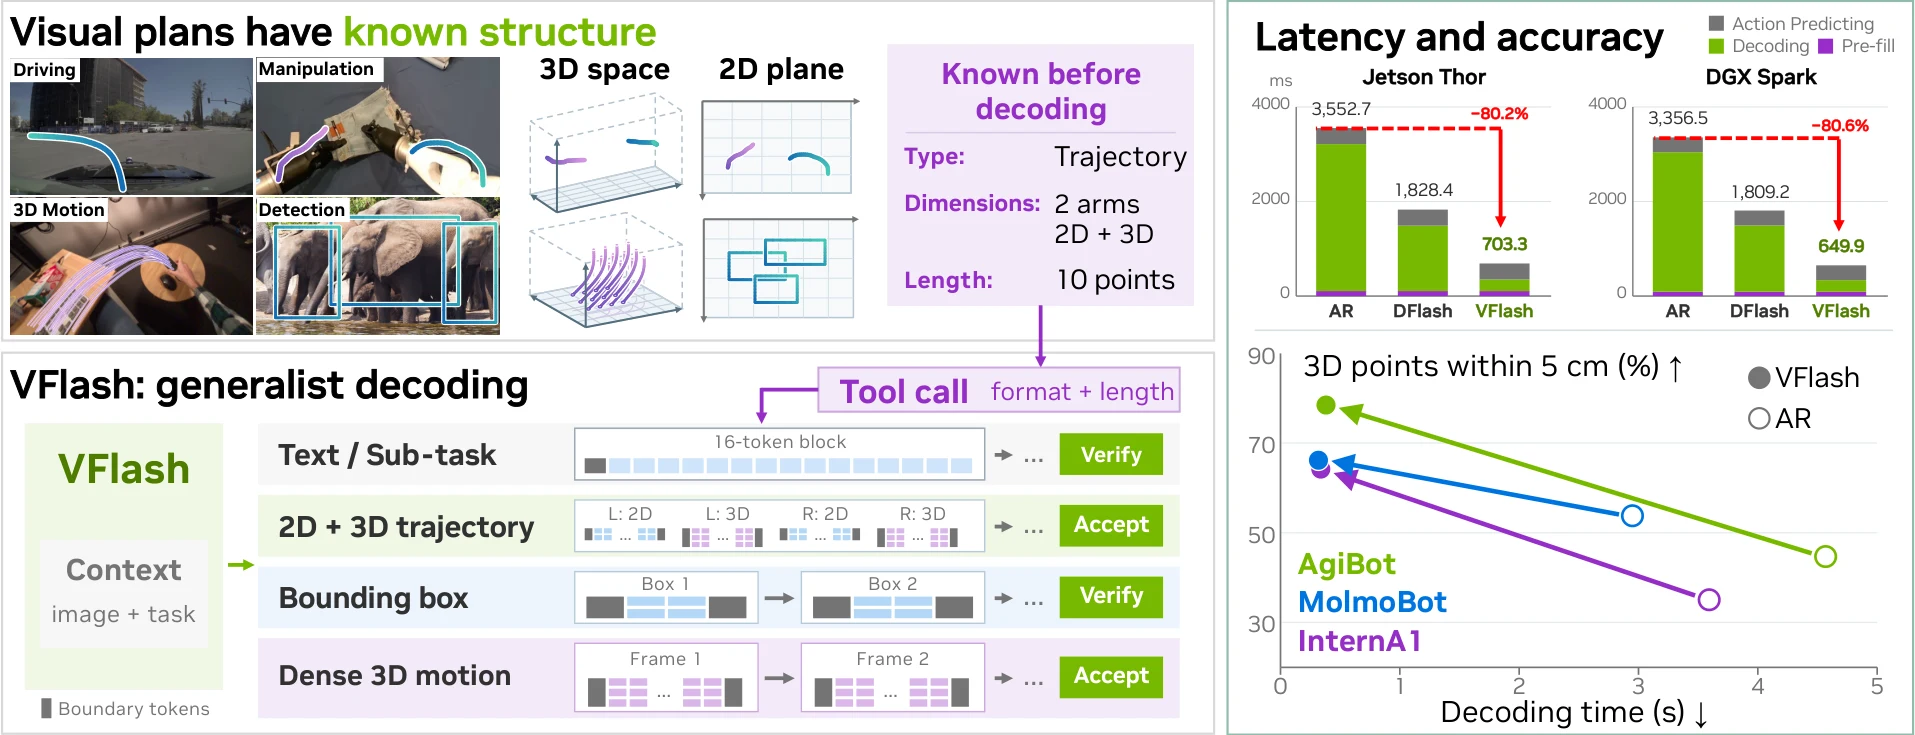
图 1(来源:VFlash 论文 Figure 1,NVIDIA)左侧是这个论点最直观的呈现——驾驶、操作、3D 空间、2D 平面上的各类视觉规划,都有”类型 / 维度 / 长度”三者共同决定的已知结构;右侧是在 Jetson Thor 与 DGX Spark 上,自回归、DFlash 与 VFlash 三种解码方式的端到端延迟对比,以及 3D 轨迹 5 cm 命中率随解码时间的变化。
一次坐标 token 的代价有多高
物理 AI 的推理有一个很硬的约束:batch size 为 1,且延迟直接决定智能体的反应频率。机器人每收到一张新图像就要重算规划,规划越细(轨迹点越多、要多臂同时预测、要同时输出 2D 与 3D),token 越多,顺序解码的时间就越长。在固定延迟预算下,这形成一对矛盾:
- 想要更细的空间规划 → 需要更多坐标 token;
- 坐标 token 只能串行解码 → 延迟随 token 数线性增长;
- 要想在延迟内反馈 → 只能减少轨迹点、放弃 3D、或降低重新规划的频率。
假设一个 4B 的 VLM 在 Jetson Thor 上每 token 前向耗时约 35–39 ms,一个 84 token 的基元就要接近 3 秒。论文测得在 MolmoSpaces 操作任务的一个推理步里,自回归解码占到了整步延迟的 75%–87%。瓶颈非常集中地落在解码阶段,而不是视觉编码或动作模型。
并行解码的两条既有路线,都不太合适
降低顺序解码代价,业界已有两条成熟路线,本文随后会逐一对照:
- 投机解码(speculative decoding):用轻量草稿模型一次猜若干个 token,再由目标模型一次并行验证,按前缀匹配接受。标准做法保证输出分布与目标模型完全一致(lossless)。
- 扩散语言模型(diffusion LLM):用并行去噪一次生成整块 token。但它往往需要用质量换速度。
DFlash(Block Diffusion for Flash Speculative Decoding)把两者结合起来:用一个轻量的块扩散草稿器一次前向预测整块 token,再由目标模型验证。站内已有一篇 DFlash 块扩散解码:以并行扩散替代自回归草稿 做过完整拆解,其机制是 VFlash 的直接基础。
问题出在验证这一步。投机解码按贪心前缀验证时,接受的 token 数 是”与目标模型贪心结果一致的最长前缀长度加一”:
它常常远低于块长 。对文本这是合理的——文本错一个 token 就错了;但对坐标,一个 token 的”不一致”可能只是 1 cm 的量化误差:
- DFlash 在 MolmoSpaces 的子任务文本上,每次验证平均提交 5.5 个 token;
- 可一旦进入轨迹块内部,每次只提交 2.2 个 token。
论文给出的解释很直接:一个坐标与目标模型选中的 bin 差了 1,几何误差可能完全可以忽略,但它已经违反了上式的前缀匹配条件。对空间预测而言,“token 级一致”不是一个有意义的正确性标准。 VFlash 的全部设计都从这个判断出发。
本文的组织
接下来先把”视觉基元”这个概念讲清楚,给出 FPD 的块布局、坐标量化与训练目标;再一步步对照投机解码的延迟公式,解释 VFlash 为什么能把”每个基元一次草稿 + 一次目标前向”的代价摊薄;然后看它在 2D 轨迹、边界框、3D 机器人轨迹、稠密 3D 运动上的实验,以及在 MolmoSpaces、LIBERO、NAVSIM、Waymo 下游任务上的表现;再把每步延迟分解到各阶段,看增益究竟来自哪里;最后讨论这套设计的适用边界——它什么时候会比 DFlash 更好,什么时候不能这么用。
视觉基元:把”已知结构”变成可计算的布局
一个基元由什么决定
论文把每一类空间预测称为一个视觉基元(visual primitive),并用一个 schema 描述它,schema 包含三件事:
| 字段 | 含义 | 由谁给出 |
|---|---|---|
| 类型 | 边界框、机器人轨迹、驾驶轨迹、稠密运动、普通文本 | 目标模型在选择生成的起点 token 时决定 |
| 维度 | 2D 图像坐标、3D 度量坐标,或两者兼有 | 同上 |
| 长度 | 点/框的个数 | 前置的工具调用声明 |
这里最关键的观察是:类型、维度和长度在预测坐标之前就已经确定。剩下的只是每个位置上的具体数值,而这个数值必须从图像和任务指令里推断。换句话讲,“每个位置要预测什么角色”是已知的,“每个位置的值是多少”是未知的。自回归模型把这两件事混在一起处理,逐位置串行;VFlash 则把”已知的结构”拿去组织预测块。
工具调用声明块长
VFlash 要求目标模型在生成基元之前先输出一条工具调用,用普通文本形式声明块长:
<tool_call>{"name":"atomic_decoding","arguments":{"block_size":54}}</tool_call>block_size 统计的是完整基元块的 token 总数(含起始 token)。紧随其后的起始 token 标识布局,二者一起固定每一个块内位置的角色。这张布局表决定了”谁和谁一起被预测”:
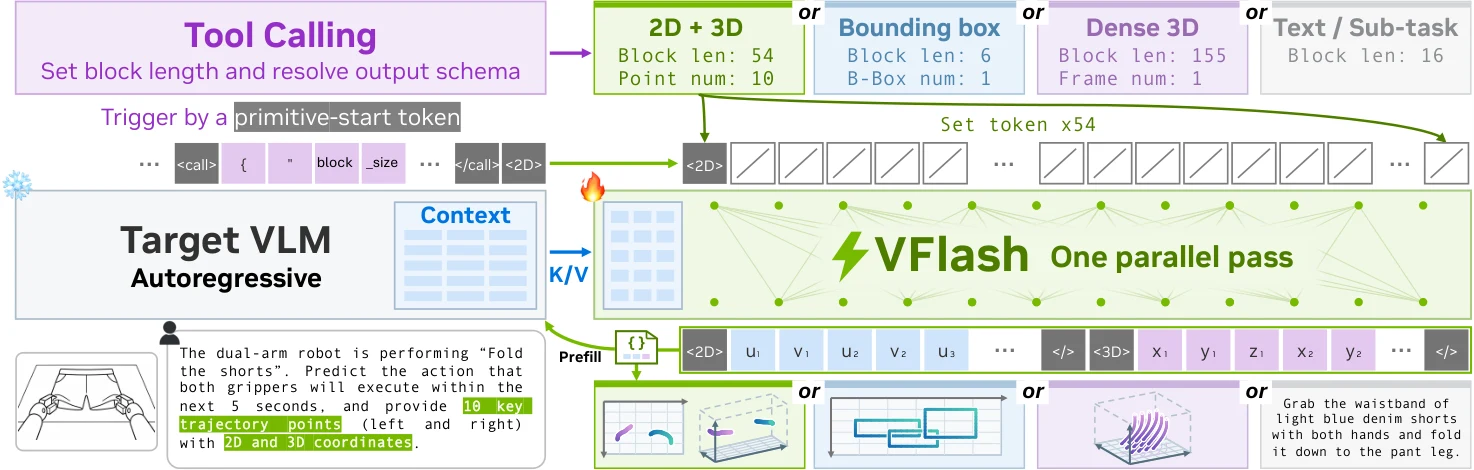
图 2(来源:VFlash 论文 Figure 2,NVIDIA)是 FPD 的完整框图。左边是工具调用与 schema 解析:用户请求”双机械臂折短裤,预测左右夹爪未来 5 秒的执行动作,并给出 10 个关键点的 2D 与 3D 坐标”;目标 VLM 先以自回归方式写出工具调用和 2D 起始 token;右侧四条虚线是四种可能的块布局(2D+3D 轨迹、边界框、稠密 3D、文本/子任务),块长分别是 54、6、155、16。中间则画出了 VFlash 的核心动作:目标 VLM 冻结,把上下文与 K/V 交给草稿器;草稿器一次并行前向填满整块——<2D> 之后的 、</>、<3D> 之后的 ——然后一次验证,接受整块。右下角的提示很重要:如果这不是一个空间基元,而是普通文本或子任务规划,块长退回 16 的 DFlash 文本块。
具体的布局与块长如表 1,其中 是每只臂或每辆车的路点数:
| 基元 | 布局 | 块长 |
|---|---|---|
| 边界框 | <box> u1 v1 u2 v2 </box> | 6 |
| 机器人 3D | <robot_single> (x y z)×P </robot> | |
| 机器人 2D+3D | <robot_single_2d> (u v)×P </robot> <robot_single> (x y z)×P </robot> | |
| 双臂 3D / 2D+3D | 先左臂块,再右臂块 | / |
| 驾驶 3D | <drive> (x y)×P </drive> | |
| 驾驶 2D+3D | <drive_2d> (u v)×P </drive> <drive> (x y)×P </drive> |
以 的双臂 2D+3D 为例,块长 ,一次前向就能吐出两个夹爪的全部 2D 与 3D 关键点。对比自回归:这 108 个 token 要 108 次前向。
两条原则:边界对齐与位置对齐
论文把设计总结为两条原则,它们也解释了为什么块布局要这样设计:
- 边界对齐(boundary alignment)决定”一起预测什么”。每个草稿块覆盖一个完整基元,块长由请求给出,而不是固定的 窗口。固定窗口会把一个基元切成两半,例如一个块覆盖了前 16 个 token 而剩下的点落在下一个块——每一块都要单独验证,一半的坐标会在验证中被拒。
- 位置对齐(position alignment)决定”每个位置预测什么”。解码之前,每个槽位的角色(某个路点的某个轴、某个分隔符)已知。这带来两个直接好处:一是可以按位置做约束(分隔符位置只能填分隔符,坐标位置只能填数字 token),二是可以在训练时对每个位置独立监督。
坐标系与量化
为了”每个坐标严格占一个位置”,VFlash 必须让坐标 token 化是定长的。不同 VLM 的坐标表示方式不同,VFlash 两种都支持:
特殊 token 表示(本文基座模型使用)。每个坐标用 1001 个特殊数字 token <0> … <1000> 之一表示。量化规则是:
其中 是原始坐标,区间 是该坐标的合法范围, 是落在 <k> 的数字(四舍五入、向下取整), 是反量化回来的值。各任务的范围:
- 机器人 XYZ 分别取 、、 米(主相机 OpenCV 坐标系,X 右、Y 下、Z 前),量化分辨率约 1 cm;
- 驾驶用自车坐标系,X 前向 米、Y 左向 米,高度省略交给动作头;
- 图像坐标归一化到 ,机器人投影除以”图像宽度−1”,边界框除以宽高。
区间外还有两类特殊 token:<oof> 表示某个 2D 投影落在图像框外(此时 3D 度量坐标照常保留),<text_mask> 表示草稿器尚未预测的位置。由于数字 token 只有 1000 个候选,每个坐标位置的合法词表被压缩到千分之一级别,草稿器犯错的空间本身就很小。
文本 token 表示。MolmoMotion 这类目标模型把坐标写成普通文本(比如 -1234),token 化后长度随数值变化,直接破坏位置对齐。VFlash 的做法是给每个坐标一个符号位加五个数字位,-0012 这样不足的位数用 mask token 填充。固定宽度的格子保证了每个位置的角色稳定;解码完成后再按目标的原始文本格式(符号、分隔符)渲染回去,目标模型的词表不需要任何修改。
这条设计对稠密运动的布局尤其重要。稠密运动块(一个未来帧)的长度是 :一个帧分隔符(同时充当起始 token)、两个时间戳位置、每个路点一个索引位置加三个坐标(每个坐标 = 1 个符号 + 5 个数字), 时正好 155 个 token。目标模型本应省略的路点,用”被 mask 的索引位置”来表示,而不是缩短帧——这样每一帧的块长都固定,草稿器可以用同一个布局处理所有帧。
Flash Primitive Decoding:直接接受,而不是逐 token 对齐
数学形式:从自回归分解到条件独立分解
设基元的块长为 :一个已知的起始 token ,后面 个待预测位置。自回归目标模型按链式法则分解:
需要 次前向。VFlash 的草稿器 则给定目标模型的中间特征 、起始 token 和掩码,把每个位置按条件独立分解:
因为所有位置都在一个掩码上下文里、彼此之间不做因果依赖, 个 logits 可以在一次前向里全部算出来。这里 的 下标是刻意的:每个位置有自己独立的分类头输出,而不是共享一个”下一个 token”的分布。
这与块扩散草稿(DFlash)的架构是同一套,区别在于训练标签与接受规则。
损失:监督空间准确率,而不是对齐目标模型
VFlash 的训练目标是加权交叉熵:
关键在于 的来源:它来自标注数据或渲染后的固定宽度格子,而不是目标模型的自回归续写。这一步直接决定了 VFlash 的性质:
- 如果标签取自目标模型续写,草稿器学到的是”模仿目标”,接受率取决于相似度;
- 如果标签取自真实标注,草稿器学到的是”直接预测正确的空间结果”,接受率取决于它是否预测准确,而目标模型自身的错误不会被复制进草稿。
权重 在基元内部取等权(),这与标准投机解码训练中”衰减权重偏好靠前位置”的做法不同。原因仍然来自接受规则:VFlash 对基元是整块接受或整块拒绝,不存在”前缀匹配越长越好”的结构,靠前位置并不天然更重要;整块一起被接受才会产生收益。对普通文本路径,VFlash 沿用 DFlash:从锚点起按距离衰减 。帧外标签(<oof>)在目标微调和草稿训练里都以 0.1 权重计算,锚点与 padding 不计入损失。没有使用软 logit 蒸馏或隐状态回归。
草稿器架构
草稿器是一个浅层、非因果的块扩散 transformer:
- 五层全宽 Qwen3 层,32 个查询头、8 个 KV 头(GQA 比例 4),头维 128,FFN 宽 9728;
- 目标模型第 1、9、17、25、33 层(零基)的隐状态拼接成 12800 维,投影到 2560 维并做 RMS 归一化,作为 Key/Value 上下文注入各草稿层——这是 DFlash 的”特征级 KV 注入”机制;
- 草稿器共享目标模型冻结的输入嵌入与输出投影,因此可训练参数只有 5.37 亿;
- 块内位置彼此可见,并且可以看到锚点之前的上下文,但看不到锚点之后的任何位置——这样在一次前向里整块都只依赖”前面已知的东西”。
如果对 GQA、KV 注入这些机制还不熟,站内 DFlash 块扩散解码 里有逐层的拆解,这里不再重复推导。
推理:一条流水线同时服务文本和基元
算法 1 把一整次生成写成了伪代码,核心是根据下一个 token 是普通文本还是基元起始 token,切换两条路径:
Algorithm 1 Flash primitive decoding for one responseRequire: prompt x, target θ, drafter φ, block size K = 16, budget N1: prefill θ on x; y ← []2: while |y| < N and y does not end with EOS:3: if y ends with a primitive-start token a0 of schema s:4: B ← block length declared by the preceding tool call5: â ← φ(Hθ, a0, MASK_{B−1}), one pass, each position restricted to legal tokens6: if A_s(â) == 1: # schema valid; boxes also pass the confidence guard7: append â to y; one target pass over â updates the cache and emits the next token8: else:9: keep the first r positions; regenerate the rest with constrained target AR10: else:11: â ← φ(Hθ, y[end], MASK_{K−1}) # ordinary text12: one target pass over â; accept longest agreeing prefix plus target correction13: truncate after a primitive-start token if one was accepted14: end while几个细节值得展开:
文本路径。 多模态 prefill 之后,普通文本按 16 位长度的 DFlash 块生成:一个锚点加最多 15 个预测。目标模型一次验证整块,保留最长匹配前缀再加它自己的下一个 token。工具调用本身就是走这条路生成的。如果某个被接受的前缀在某处碰上了基元起始 token,之后的投机 token 全部丢弃,改由声明好的 schema 和块长接管——否则”文本块的”与”基元块的”两套布局会互相冲突。
基元路径。 草稿器处理起始 token 与全部掩码位置,一次前向。位置约束有两类:
- 位置内约束:分隔符位置只能选分隔符;坐标位置只能在 1001 个数字 token 里选;边界框要求 、。
- 跨位置约束:图像框外的 2D 投影必须是成对的
<oof>;这些约束通过对已经算好的 logits 做一个小型选择循环来满足,不增加任何网络计算。
随后目标模型对整块做一次前向,目的有三个:更新 KV 缓存、为本块提供下一次草稿需要的上下文特征、并预测后续续写用的下一个 token。
接受门。 这是 VFlash 与投机解码最本质的差异。接受测试 由 schema 校验器组成,对边界框额外叠加 LocateAnything 的空间置信度守卫。取代式 (2) 的规则是:
即:结构合法就整块提交,不管它是否与目标模型的贪心 token 序列逐个相同;不合法时,保留前 个草稿位置(轨迹取 ,边界框保留到第一个不确定坐标之前),其余由受约束的目标自回归从第一个非法位置重新生成,草稿缓存随后重置。目标缓存回滚到锚点再续算。
为什么可以把”不一致”当作合法。 传统投机解码要求无损,是因为文本生成中”哪个 token”直接就是输出。VFlash 的下游消费者是动作模型或规划器,它们读取的是VLM 对这段规划编码后的隐状态,而不是逐 token 比对。一段轨迹只要结构合法、几何准确,就能作为有效条件输入使用。这与 LocateAnything 的盒子并行解码、Spec-VLA 的松弛接受是同一个思路;VFlash 把松弛接受从”逐个动作 token 的 bin 相近”推广到了”整个视觉基元的结构合法性”。
延迟模型:为什么”每个基元两次前向”就足够
把式 (5) 代回投机解码的平均每 token 延迟分解(式 1),一个合法基元块的延迟是
其中 是一次草稿器前向(整块), 是目标模型对整块的一次前向。与自回归的 相比:
- 自回归需要 次目标前向,;
- 关键性质是两个前向的次数不随 变化。总时间随块长只是温和增长(注意力与 FFN 矩阵乘在 内会变大,但仍是次线性的),于是每次提交的 token 数涨了 ,平均每 token 时间被摊薄了接近 倍。
这正是 VFlash 与 DFlash 的分水岭。DFlash 的块长固定 16,而在轨迹块内部每次只提交 2.2 个 token——因为每个坐标都存在”与目标贪心差 1 个 bin”的风险,最长前缀往往在第一两个坐标就断了。VFlash 的块长直接等于整段基元的长度(54、108、155……),并且不需要逐坐标匹配,于是块越大,优势越明显。论文的实测也印证了这一点:在 Thor 上,当驾驶基元从 36 个 token 增长到 84 个 token 时,解码时间只从 72 ms 涨到 78 ms——“更密的规划几乎不额外付代价”。
需要说明的是,这个式子对 DFlash 也成立,但它的 里是同一块一次前向、 也是 16 位置一次前向——问题不在前向次数,而在 。VFlash 的收益来自把 从”与目标匹配的前缀长度”提高到”整块长度”。
训练配方
- 适配目标模型。 先把自回归目标 VLM 在任务的特定数据上做长微调,让它学会输出特殊 token 的空间响应格式(工具调用 + 起始 token + 定宽坐标)。
- 冻结目标,训练草稿器。 目标不参与草稿训练,仅在线计算其隐状态(关闭梯度)。每个标注基元贡献一个完整块;如果响应里还有文本,再采样最多 512 个普通文本锚点,使同一个草稿器也能服务文本路径。3D-only 与边界框草稿器只训练基元块。
- 打包注意力。 打包的样本保持独立的位置编号与注意力掩码:一个块只能看到自己块内的位置,以及自己样本中锚点之前的目标位置。这样不同 schema 与长度的块可以在同一 batch 里混合,不会互相泄漏标签。
表 10 列出了各任务的训练预算。2D 轨迹的目标微调 10,800 步、峰值学习率 ,草稿器 7,142 步、;机器人 3D-only 与 2D+3D 的目标微调约 1 万步,草稿器 30,562 步;驾驶基元草稿器只需 4,028 步。所有训练使用 AdamW、BF16、零权重衰减、梯度裁剪 1.0、余弦衰减,目标预热 200–500 步,草稿预热为预算的 4%。草稿器的学习率比目标高两个数量级、步数更多,这是浅层草稿器在冻结特征上需要更多更新才能拟合整块分布的正常现象。
实验:更快,而且更准
基座模型
主实验的目标模型是一个定制的具身 VLM:Qwen3-4B 作为语言主干(36 层,宽 2560),MoonViT-SO-400M 作为原生分辨率视觉编码器(27 层,宽 1152,14 像素 patch,2×2 空间合并),两层 MLP 连接。它在通用视觉语言任务、指代定位、具身空间理解与联合 2D/3D 轨迹预测上渐进训练,并从该检查点全参微调出每个任务专用的目标模型。稠密运动预测直接使用公开的 MolmoMotion-4B-H3-F30,只训练草稿器。
有一处实验设计值得留意:为了做干净的消融,每个任务的基线(AR)与 VFlash 共用同一个目标模型,只替换解码器。因而后续所有”VFlash 比 AR 更准”的结论,只能来自草稿器 + 接受规则,而不是目标模型的差异。
2D 轨迹
在 ShareRobot-Bench 与 VABench-V 上,评价指标是离散 Fréchet 距离(DFD)、对称 Hausdorff 距离(HD)与 RMSE(均在 0–1000 的图像坐标系下,除以 1000):
| 方法 | 参数 | ShareRobot DFD | ShareRobot HD | VABench-V DFD | VABench-V HD | VABench-V RMSE |
|---|---|---|---|---|---|---|
| Qwen3-VL | 4B | 0.381 | 0.329 | 0.279 | 0.253 | 0.204 |
| RoboBrain-2.0 | 7B | 0.167 | 0.158 | 0.329 | 0.260 | 0.224 |
| LoHo-Manip | 4B | 0.231 | 0.206 | 0.212 | 0.182 | 0.147 |
| 基线(AR) | 4B | 0.202 | 0.175 | 0.130 | 0.125 | 0.093 |
| VFlash | 4B | 0.194 | 0.162 | 0.126 | 0.116 | 0.089 |
VFlash 把自身 AR 目标的六项误差全部降下来,HD 降约 7%、DFD 与 RMSE 降 3%–6%。在 VABench-V 上 VFlash 比最好的公开模型 LoHo-Manip 每一项误差都低约 40%,而它自己的 AR 目标已经优于表中所有基线;在 ShareRobot-Bench 上它仅次于 7B 的 RoboBrain-2.0。
“更准”这一点需要一点直觉。轨迹是一组在空间上相关的点,2D+3D 共享路点编号。自回归模型逐个坐标生成,前一个坐标的采样/量化误差会影响后续条件,误差可能累积;而草稿器对整段基元做一次联合推断,每个位置都直接看到同一份目标特征与完整布局,点位之间的空间一致性从结构上就得到了保持。论文的 3D 轨迹实验把这一点表现得更明显(见后文)。
边界框生成
边界框是固定大小的 2D 基元(6 token)。与轨迹不同,VFlash 为边界框保留了一条回退路径:直接接受结构合法的框,但若某个坐标被 LocateAnything 的空间置信度守卫认定为”不确定”,则保留不确定坐标之前的部分,其余用受约束 AR 重算——这就是式 (5) 中 的情形。
| 方法 | 数据集 | 平均 F1 | F1@IoU 0.50 | F1@IoU 0.95 | 每秒框数(BPS) |
|---|---|---|---|---|---|
| 基线(AR) | COCO | 48.68 | 65.29 | 16.09 | 3.15 |
| 基线(AR) | Dense200 | 60.10 | 76.70 | 16.95 | 6.73 |
| VFlash(直接接受) | COCO | 41.32 | 59.64 | 10.76 | 5.96 |
| VFlash(直接接受) | Dense200 | 39.09 | 55.06 | 6.59 | 22.66 |
| VFlash(AR 回退) | COCO | 47.79 | 66.38 | 13.48 | 8.76 |
| VFlash(AR 回退) | Dense200 | 61.78 | 82.64 | 12.11 | 17.46 |
这张表的信息量比看起来大,它划出了”松弛接受”的适用边界:
- 带 AR 回退时,VFlash 在 COCO 上的平均 F1 为 47.79,基本追平基线的 48.68;在拥挤的 Dense200 上反而更高(61.78 对 60.10),且 F1@0.5 提升 5.9 个点。解码速度提升 2.6–2.8 倍。
- 完全不做回退、直接接受时,Dense200 的平均 F1 掉了约 20 个点(39.09)。原因不难理解:密集场景里一个类别可能有几十个框,任何坐标的严重偏差都会让 IoU 直接掉到 0.95 以下甚至完全不匹配;而”结构合法”( 等)并不能保证”几何正确”。
- F1@0.95 始终低于 AR。VFlash 的收益集中在较宽松的 IoU 阈值上——它预测的框更”有用”(能定位、能触发抓取),但不是逐像素精确复刻。
这解释了为什么边界框需要置信度守卫,而机器人轨迹不需要:轨迹的消费端是动作模型,5 cm 的误差可以接受;检测框的消费端是定位与计数,错位一个物体就会改变下游语义。同一个”结构合法即接受”的原则,在不同基元上要配不同的验证强度。
3D 机器人轨迹:最核心的结果
3D 轨迹是 VFlash 主打的场景,也是”并行解码更准”这一反直觉结论最集中的地方。数据来自 InternA1(1,000 条)、AgiBot(999 条)、MolmoBot(4,221 条);指标是 ADE(平均路点误差,米)、FDE(终点误差)、SR@5 与 SR@10(误差小于 5 cm / 10 cm 的路点比例)。每个记录只给主相机,包含视频的记录从过去三秒采六帧;参考轨迹是沿 3D 弧长均匀重采样的十个路点,描述路径几何而非固定时间控制点。
表 4 有三组训练变体,区别在于”目标模型生成什么”(仅 3D / 2D+3D)与”训练时是否加入腕部相机视角”(评测仍只用主相机):
| 训练变体 | 解码器 | InternA1 ADE | InternA1 SR@5 | AgiBot ADE | AgiBot SR@5 | MolmoBot ADE | MolmoBot SR@5 |
|---|---|---|---|---|---|---|---|
| 仅 3D | AR | 0.101 | 41.2% | 0.083 | 50.3% | 0.066 | 52.6% |
| 仅 3D | VFlash | 0.065 | 63.8% | 0.042 | 73.1% | 0.054 | 65.3% |
| 2D+3D | AR | 0.153 | 27.3% | 0.105 | 39.8% | 0.076 | 46.7% |
| 2D+3D | VFlash | 0.062 | 64.0% | 0.041 | 73.9% | 0.055 | 64.0% |
| 2D+3D + 腕部相机 | VFlash | 0.060 | 65.1% | 0.036 | 79.4% | 0.052 | 67.1% |
逐列看,有三件事值得拆开讲:
第一,所有指标、所有数据集都一致改善。 仅 3D 变体下,ADE 降 18%–49%;2D+3D 变体下,ADE 降 28%–61%。AgiBot 的 SR@5 从 50.3% 升到 73.1%,从 39.8% 升到 73.9%。这不是”某个数据集调参调得好”,而是同一个解码器替换在三个数据源上都成立。
第二,联合 2D+3D 输出暴露了自回归的结构性缺陷。 当目标模型需要同时生成 2D 投影与 3D 度量坐标时,AR 的 3D ADE 比”仅 3D”高出 15%–51%(InternA1 从 0.101 到 0.153,AgiBot 从 0.083 到 0.105)。信息并没有变少——2D 投影本应约束 3D 位置——但自回归先生成 2D 段、再生成 3D 段,两段之间的几何一致性只能靠模型隐式维持,误差在长序列中累积。VFlash 则把两段放在同一个块里一次推断:2D 与 3D 的对应路点共享位置编号、共享同一份上下文特征,联合预测反而把 ADE 压到 0.062,比”仅 3D 的 AR”还低。这是一个很干净的对照:同样的目标模型,仅因为解码布局不同,联合预测从”负担”变成”约束”。
第三,腕部相机训练带来的额外收益是真实的,但幅度有限。 VFlash 的 ADE 再降 3%–12%,说明多视角数据能改善空间理解;而评测严格只用主相机,排除了”评测时多给输入”的嫌疑。
为什么一次并行预测会比逐 token 自回归更准?论文没有把它归因于”扩散模型更强”,而是回到结构:草稿器在训练时见到的标签是标注坐标本身,而目标模型在自回归生成时,后一个坐标要以自己前面生成的坐标为条件。一旦前面某个坐标出现偏差,后续位置就被带偏;草稿器则对整段基元做条件独立预测,每个位置都由完整上下文直接决定,不存在”自己带偏自己”的链式误差。再叠加整块联合布局带来的 2D/3D 相互约束,就得到了表中”并行反而更准”的结果。
稠密 3D 运动预测:优势与短板都出现的地方
稠密运动预测(dense 3D motion)要求模型在给定三帧观测、八个查询点和一句描述后,预测未来最多 30 帧中这些点的 3D 位置。这里的目标模型是 MolmoMotion-AR,坐标是文本 token 化的有符号毫米整数,块布局是固定宽度的数字格。VFlash 冻结它的主干,只训练草稿器。
| 方法 | 数据集 | ADE | FDE | PWT |
|---|---|---|---|---|
| MolmoMotion-AR | HOT3D | 0.109 | 0.217 | 0.444 |
| VFlash | HOT3D | 0.122 | 0.200 | 0.391 |
| MolmoMotion-AR | WorldTrack | 0.143 | 0.261 | 0.445 |
| VFlash | WorldTrack | 0.145 | 0.300 | 0.408 |
| MolmoMotion-AR | DAVIS | 1.227 | 2.108 | 0.153 |
| VFlash | DAVIS | 0.893 | 1.716 | 0.143 |
结果比机器人轨迹复杂得多:
- DAVIS 上 ADE 降 27%、FDE 降 19%,提升明显;
- HOT3D 上 FDE 降 8%,但 ADE 略升(0.109 → 0.122),PWT 降 12%;
- WorldTrack 上 ADE 基本持平,FDE 反而升 15%,PWT 低 7%。
论文对此的解释是,稠密运动的”帧”仍然必须顺序生成:一帧的 155 token 块可以并行,但下一帧要以这一帧的结果为条件,最多 30 帧就是 30 次串行块。并行只发生在一帧内的点与坐标上,无法跨帧摊薄。此外,文本 token 化的坐标格(符号 + 5 位数字)比特殊 token 表示更难约束——高位数字的合法词表、前导零的语义、时间戳的单调性都需要额外规则修补。这使得”结构合法”的判定更松,直接接受带来的误差也更容易累积。
尽管如此,速度收益在这一任务上最大:单次 rollout 在 H100、batch size 1 下,VFlash 为 3.21 / 3.86 / 3.78 秒,AR 为 79.8 / 90.6 / 99.6 秒,约 23.5–26.4 倍加速(论文概括为约 25 倍)。“更快”与”更准”在这里并不总是同时成立——稠密运动是一个用部分精度换数量级延迟的案例。
下游任务:规划变成动作模型的条件
空间预测本身不是终点。VFlash 的价值要在”动作模型拿到规划后能不能把事做成”上验证。论文在四类下游系统上做了受控实验,共同的设计是:VLM 全程冻结,动作模型只通过交叉注意力读取 VLM 对生成规划的隐状态;同一应用内动作模型架构固定,只改变条件输入。
MolmoSpaces 机器人操作
MolmoSpaces 的策略是一个由 Cosmos-Predict2.5 后训练得到的世界动作模型(WAM, World Action Model)。基线保留 WAM 原有的文本编码器;VFlash 把文本编码器换成冻结的 4B 规划 VLM,条件化在问题、子任务与 2D+3D 十路点轨迹的隐状态上,经线性投影送入 WAM 原有的文本交叉注意力路径(512 个上下文位置)。WAM 每 20 步执行一个动作块,每三个块(60 个控制步)同步请求一次新规划。
| 方法 | 平均成功率 | Pick | Pick & Place | Open | Close |
|---|---|---|---|---|---|
| 基线(原文本编码器) | 62.6% | 81.1% | 55.7% | 49.3% | 64.2% |
| VFlash | 70.2% | 83.6% | 67.3% | 52.8% | 77.0% |
平均成功率提高 7.6 个百分点,超过表中公开模型 PrimeR0 的 60.3%。增益分布很不均匀:Pick 只涨 2.5 个点,Pick & Place 涨 11.6 个点,Close 涨 12.8 个点。论文的判断是,涉及多个相互依赖动作的任务从显式空间规划中受益更大——单点抓取只需要一个位置,而”抓起来再放到某处”需要一串有空间关系的中间目标。
更关键的消融在表 7:同一 WAM、同一 VLM,只改变”用什么规划”和”条件化在哪些特征上”:
| 变体 | 解码方式 | 基元类型 | 条件特征 | 平均成功率 |
|---|---|---|---|---|
| 基线 | — | — | 原生文本 | 62.6% |
| AR 生成规划 | AR | 2D+3D | 问题+子任务+轨迹 | 61.0% |
| 仅 3D 规划 | VFlash | 3D | 问题+子任务+轨迹 | 69.3% |
| 仅图像上下文 | VFlash | — | 问题+子任务+图像 | 63.7% |
| VFlash | VFlash | 2D+3D | 问题+子任务+轨迹 | 70.2% |
这组数字把收益来源拆得很清楚:
- 用 AR 生成的 2D+3D 规划替代 VFlash 规划,成功率从 70.2% 掉到 61.0%,甚至低于基线。说明”有规划”不等于”有好规划”;AR 在联合 2D+3D 上的几何误差(前文 ADE 高 15%–51%)会直接传给动作模型。
- 把轨迹隐状态换成图像隐状态,成功率掉 6.5 个点,说明增益来自”轨迹”这一结构化空间信息,而不是”多接了一个 VLM”。
- 仅 3D 规划达到 69.3%,联合 2D+3D 再多 0.9 个点,与轨迹实验的结论一致:2D 投影提供了额外的几何约束。
LIBERO:扰动越大,规划越值钱
LIBERO 系列用 StarVLA 的 PIv3 流匹配动作头,逐层交叉注意力到冻结 VLM 的隐状态。VLM 在每个 8 动作块之前生成子任务和十路点 2D+3D 轨迹。三档难度分别是原始 LIBERO、加入视觉/语言扰动的 LIBERO-Plus、以及更强调空间与目标泛化的 LIBERO-PRO。
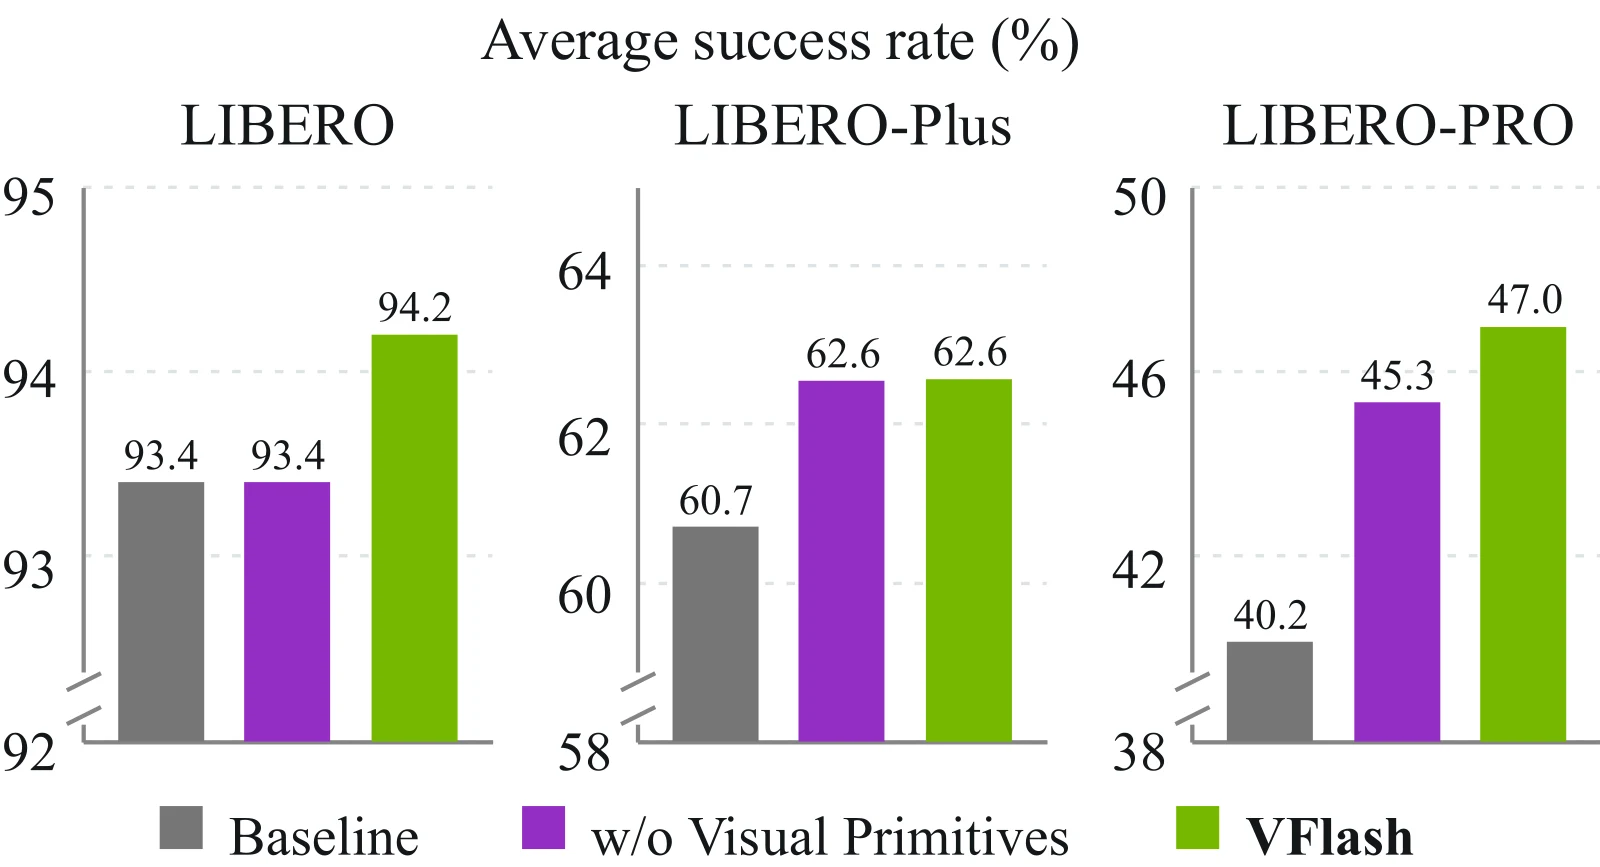
图 3(来源:VFlash 论文 Figure 3,NVIDIA)对比了三种条件:冻结 Qwen3-VL-4B 的基线、只条件化到”生成子任务为止”的 VLM 状态(w/o Visual Primitives)、以及条件化到完整视觉规划的 VFlash。相对基线的提升从 LIBERO 的 0.8 个百分点,扩大到 LIBERO-Plus 的 1.9 个点、LIBERO-PRO 的 6.8 个点。在 LIBERO-PRO 上,视觉规划让 Spatial、Object、Goal 三类任务分别提升 11.1、9.4、6.9 个点;相对”仅子任务”条件化,轨迹还在 Spatial 上多给 2.6 个点、Goal 多 1.2 个点、Long 多 2.0 个点。
这组结果的工程含义是:在分布内任务上,语言子任务已经足够;一旦环境有扰动,显式的空间轨迹才成为不可替代的信息。这也解释了为什么 VFlash 把”文本子任务”和”视觉基元”放在同一条解码流水线里,而不是二选一——子任务负责语义,轨迹负责几何。
自动驾驶:NAVSIM 与 Waymo
自动驾驶的动作策略是一个由 ReCogDrive 衍生的扩散 transformer,读取 VLM 最后一层对提示与生成规划的隐状态,连同自车历史与车辆状态,输出连续轨迹。VLM 冻结,在每个数据集的原生栅格上生成 2D+3D 轨迹;Waymo、NAVSIM 与 Alpamayo 派生数据分别训练动作头。
| 设置 | NAVSIM PDMS | Waymo ADE 3s | Waymo ADE 5s | Waymo RFS |
|---|---|---|---|---|
| VFlash-SFT | 87.1 | 1.23 | 2.71 | 7.79 |
| VFlash-RL | 90.7 | 1.22 | 2.70 | 7.86 |
| Qwen-Drive-1.0-SFT | 88.2 | 1.19 | 2.65 | 7.78 |
| Qwen-Drive-1.0-RL | 90.7 | 1.19 | 2.67 | 7.91 |
在监督训练下,VFlash 的 NAVSIM PDMS 为 87.1,高于 ReCogDrive 的 86.8;用 PDMS 与 RFS 作为奖励只对动作头做强化学习后,升到 90.7,与 Qwen-Drive-1.0-RL 持平。Waymo 上的 RFS 为 7.79 / 7.86,与 Qwen-Drive 的 7.78 / 7.91 接近,而 ADE 略高(1.23 对 1.19)。这里要如实指出:VFlash 的驾驶精度不是全面领先,它用冻结的规划 VLM 加一个较小的动作头达到了有竞争力的水平,真正的卖点是同一套规划在端侧能把延迟压下一个数量级。RFS 这类指标对轨迹的细微几何误差不如 ADE 敏感,这也与 VFlash”结构合法 + 空间大致正确”的定位吻合。
延迟解析:增益全部来自解码阶段
分阶段延迟
论文在 Jetson Thor、DGX Spark 与 H100 上以 batch size 1 测量每个推理步的四个阶段:预处理 + ViT 视觉编码、prefill、解码、动作模型(MolmoSpaces 是 WAN 编码器 + DiT,驾驶是 ReCogDrive DiT 的十步 DDIM 或 Qwen-Drive 规划器)。FP16 引擎,CUDA 事件分段计时,包含主机启动间隙,不是纯 kernel 时间。
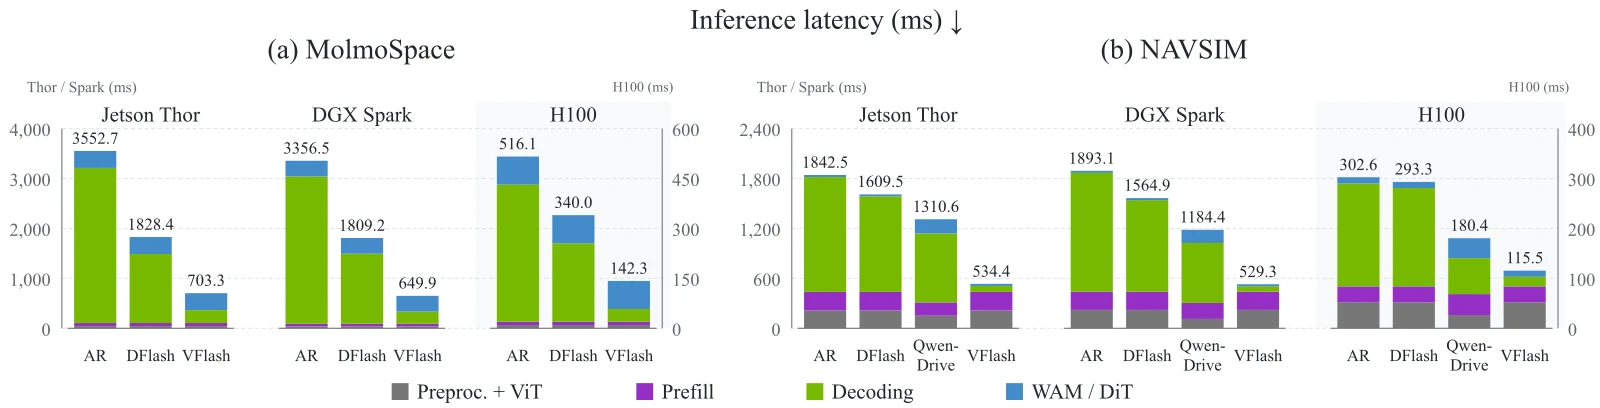
图 4(来源:VFlash 论文 Figure 4,NVIDIA)把三个平台的 MolmoSpaces 与 NAVSIM 延迟按阶段堆叠。视觉部分与 prefill 在三种解码器之间几乎不变,差异全部集中在深色的 decoding 段。具体数字:
| 任务 | 设备 | AR 总延迟 | DFlash 总延迟 | VFlash 总延迟 | 相对 AR |
|---|---|---|---|---|---|
| MolmoSpaces | Jetson Thor | 3552.7 ms | 1828.4 ms | 703.3 ms | 5.05× |
| MolmoSpaces | DGX Spark | 3356.5 ms | 1809.2 ms | 649.9 ms | 5.16× |
| MolmoSpaces | H100 | 516.1 ms | 340.0 ms | 142.3 ms | 3.63× |
| NAVSIM | Jetson Thor | 1842.5 ms | 1609.5 ms | 534.4 ms | 3.45× |
| NAVSIM | DGX Spark | 1893.1 ms | 1564.9 ms | 529.3 ms | 3.58× |
| NAVSIM | H100 | 302.6 ms | 293.3 ms | 115.5 ms | 2.62× |
解码阶段本身被压缩了 12–42 倍:MolmoSpaces 在 Thor 上从 3107.6 ms 降到 258.2 ms(12 倍),NAVSIM 在 Thor 上从 1380.0 ms 降到 71.9 ms(19 倍),Waymo 在 H100 上从 501.8 ms 降到 21.1 ms(24 倍)。端到端加速比之所以只有 2.6–5.2 倍,是因为视觉编码、prefill 与动作模型的时间没有变,它们成了新的下限。在 Thor 上自回归解码占整步的 75%–87%,因此解码的 12 倍压缩能换来整步 3–5 倍的改善;在 H100 上解码占比更低,端到端加速比也随之下降。
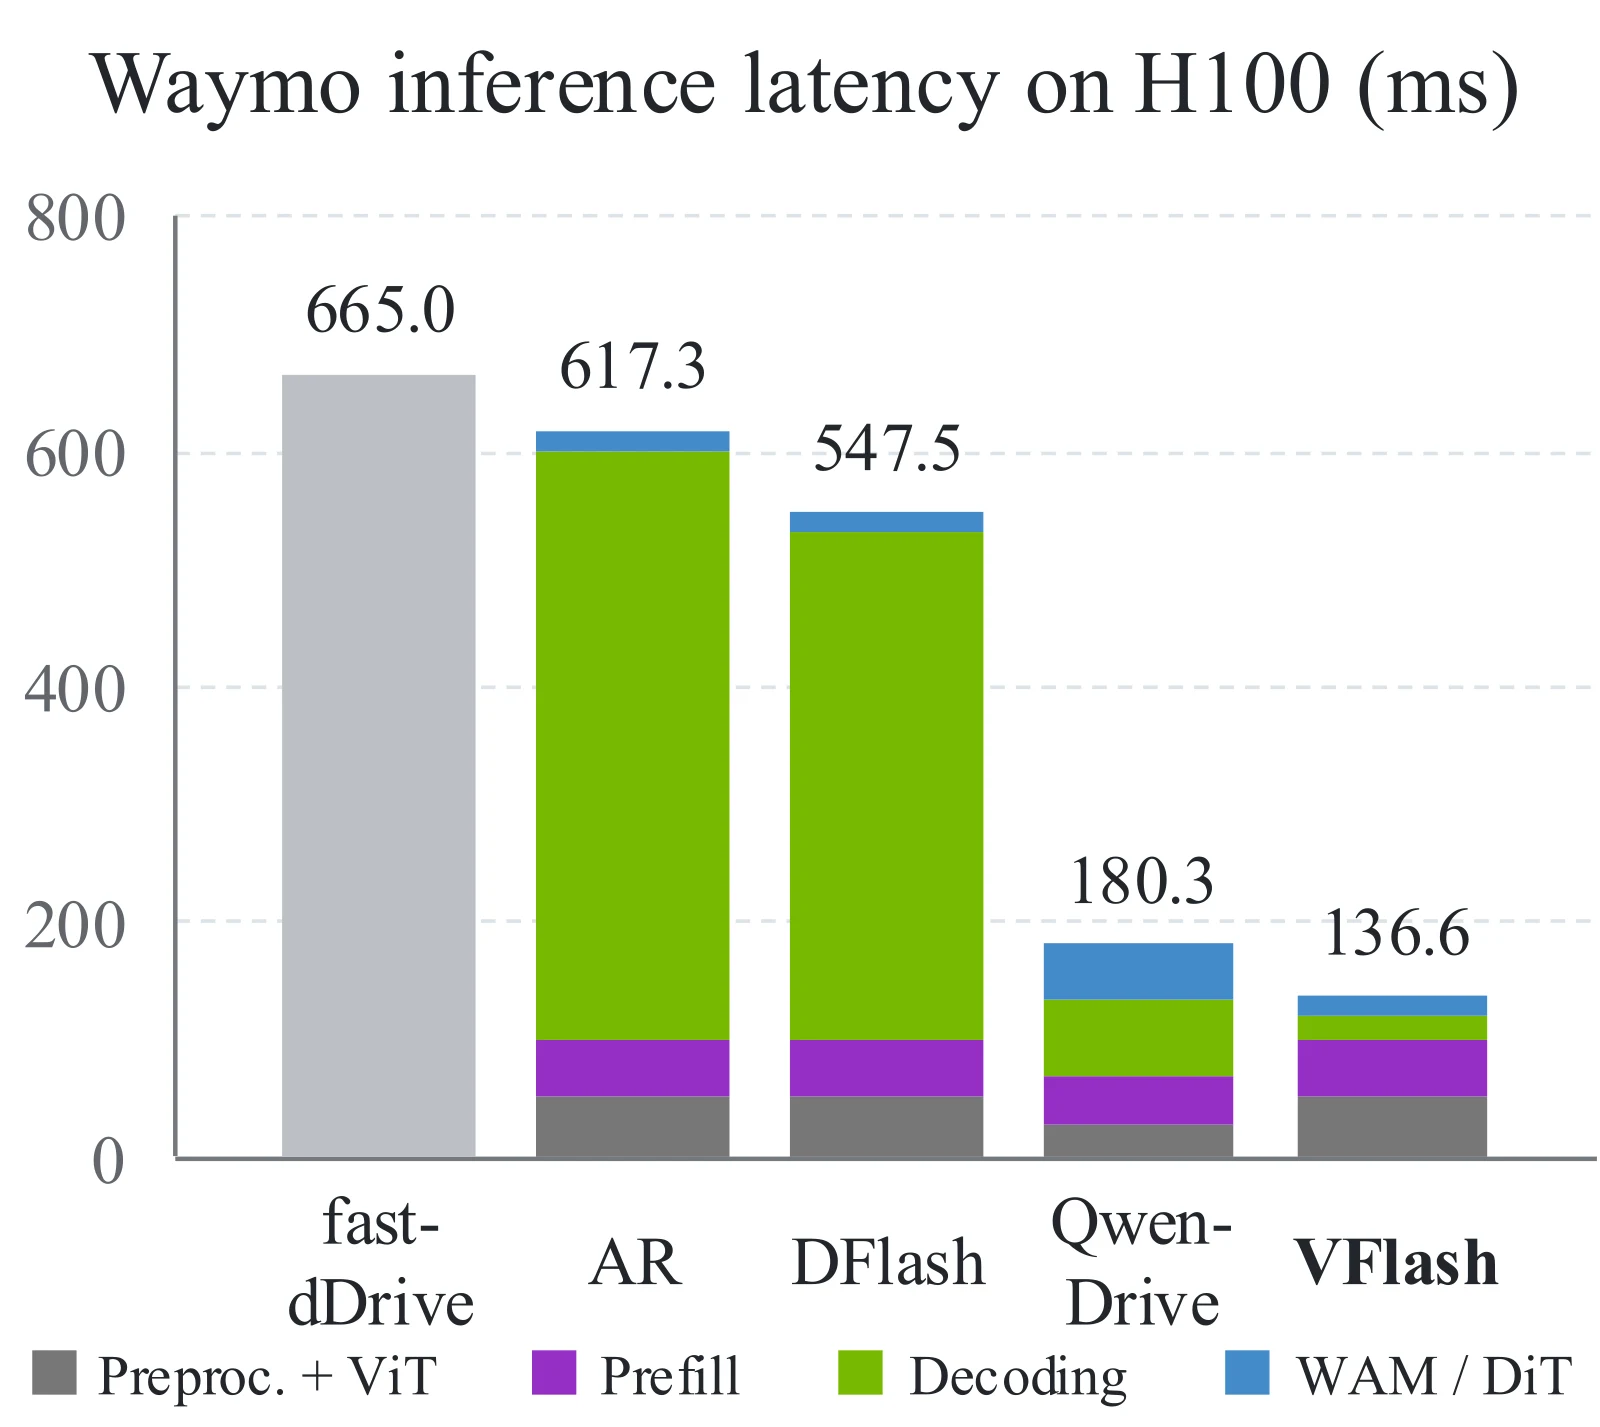
图 5(来源:VFlash 论文 Figure 5,NVIDIA)单列了 Waymo 在 H100 上的端到端规划延迟:AR 为 617.3 ms,VFlash 为 136.6 ms,约 4.5 倍加速。这一项对部署更有参考价值,因为 Waymo 的基元更长(更密的轨迹),而服务器端视觉与动作模型占比更小,解码优化能更充分地体现出来。
每次前向提交了多少 token
表 12 给出了 MolmoSpaces 在 Thor 上的解码统计。一次请求平均输出 88.75 个 token:约 36 个文本(含工具调用)加一个 54 token 的基元。
| 解码器 | 段 | 每次目标前向提交 token | 目标前向次数 | 草稿耗时 | 目标耗时 |
|---|---|---|---|---|---|
| AR | 全部 | 1.0 | 88.75 | — | 35.0 ms |
| DFlash | 全部 | 3.0 | 29.5 | 9.1 ms | 35.7 ms |
| VFlash | 文本 | 5.5 | 3.25 | 11.8 ms | 42.5 ms |
| VFlash | 基元 | 53 | 1 | 12.9 ms | 68.4 ms |
这张表回答了一个容易被误解的问题:VFlash 并没有减少”目标模型前向”的总次数到 1 次。文本段仍然走 3.25 次 DFlash 验证(每次提交 5.5 个 token),基元段才是 1 次草稿 + 1 次目标前向提交 53 个 token。基元的目标前向耗时 68.4 ms,明显高于文本的 42.5 ms,因为它要 prefill 整段被接受的基元、更新 KV 缓存,并为动作模型补齐全部层的特征。但这一切被 53 个 token 摊薄后,每 token 成本约为文本验证路径的几分之一。
还要注意 DFlash 的对比口径:DFlash 的 1828.4 ms 里包含一次额外的 padding 前向(Thor 上 58.5 ms)来补齐特征序列;VFlash 把这项工作折进了基元的目标 prefill,没有单独计。即便把这个差异考虑进去,VFlash 的 703.3 ms 仍是数量级上的改善。
为什么端侧比服务器端收益更大
三个平台的对比揭示了一个部署规律:
- Thor / Spark 上解码是绝对瓶颈,因为 4B 模型每 token 前向要 33–40 ms,而一次基元要几十上百个 token;把解码从”每 token 一次”变成”每基元两次”,收益最大。
- H100 上解码只占一小部分,4B 模型每 token 前向 4.7–6.0 ms,视觉与动作模型占比上升;即使解码快了 12–42 倍,端到端也只快 2.6–3.6 倍。
- 对物理 AI 来说,端侧才是主战场:机器人、车辆上的算力预算决定了只能跑小模型、低 batch,而这正是顺序解码代价最突出、VFlash 收益最大的场景。
这也解释了论文为什么把 Jetson Thor 与 DGX Spark 放在与 H100 并列的位置,而不是只报服务器数据。物理 AI 的推理优化不能只看数据中心吞吐,必须看”单条规划在端侧多久能出来”。
与相近工作的边界:松弛接受谱系
VFlash 不是第一个”不走 token 级一致”的工作。把它放进已有的谱系里,才能看清它到底新在哪里。
逐 token 无损验证:Speculative Decoding 与 DFlash
Leviathan 等人 2023 年的投机解码(见 Fast Inference from Transformers via Speculative Decoding)定义了无损投机解码的基本形式:草稿 token 被逐一验证,用拒绝采样保证输出分布不变。此后 Medusa、EAGLE、DFlash 等工作的差异主要在”怎么产生草稿”(多解码头、特征级草稿模型、块扩散草稿器)。站内 EAGLE 完全拆解 与 DFlash 块扩散解码 分别拆解了这两条草稿路线。
这条路线在文本上非常成功,但把它直接搬到空间坐标上就会遇到前文提到的 崩塌问题:坐标差一个 bin 就断前缀。VFlash 保留了这整套草稿架构,只换了接受规则。
逐 token 松弛接受:Spec-VLA
Spec-VLA(EMNLP 2025,arXiv:2507.22424)是论文自己指出的最接近的工作。它针对 OpenVLA 的动作 token:如果草稿动作 token 与目标的 bin 足够接近,就接受——而不是要求完全一致。这是对”无损”要求的第一次实质放松。
但它的松弛仍然发生在每个动作 token 的粒度上,并且每次验证之后提交的 token 数只有 2.10–2.94 个。也就是说,它放松了”接不接受”的判据,却没有改变”一次被接受多少”的结构——仍然要逐位置对目标做验证。
VFlash 的松弛发生在整个基元的粒度上:不是”这个坐标够不够接近”,而是”这段几何整体结构是否合法”。于是接受单位从”一个位置”变成了”整个视觉基元”, 可以直接跳到 。
固定大小的并行视觉输出:LocateAnything
LocateAnything(arXiv:2605.27365)用并行盒子解码来加速指代定位——一个盒子四个坐标一次出。它的边界框 F1@0.5 甚至能比逐 token 基线更高,这与 VFlash 的边界框结果(F1@0.5 从 65.29 提升到 66.38)方向一致。
它的局限是固定的:只覆盖 2D、固定大小的基元(一个盒子 4 个坐标)。VFlash 把它推广到可变长度的轨迹、3D 坐标、稠密点云,并引入工具调用来声明块长。这也是 VFlash 在边界框上直接复用 LocateAnything 置信度守卫的原因——两者共享同一个”空间不确定性由置信度决定”的前提。
| 工作 | 草稿单位 | 接受判据 | 最大并行单位 |
|---|---|---|---|
| 投机解码 / DFlash | 固定块(16) | 与目标贪心一致的最长前缀 | 前缀长度(通常几个 token) |
| Spec-VLA | 单个动作 token | bin 距离在阈值内 | 单个 token |
| LocateAnything | 一个边界框 | 结构合法(固定 4 坐标) | 一个 2D 盒子 |
| VFlash | 完整基元块 | schema 合法 + 可选置信度守卫 | 整段轨迹 / 盒子 / 一帧稠密运动 |
System-1 与 System-2 的视角
论文还引用了 Kahneman 的快/慢思维框架,把 VFlash 定位成 VLM 视觉规划的 System-1 模式:快速、类型化、结构化的空间决策,像反射一样每秒更新;而复杂语言推理仍走 System-2 的慢路径。站内 NeuroVLA 完全拆解 从另一条路线讨论了具身智能为什么需要低延迟的反射回路——那里用的是 SNN 动力学与分级控制,这里用的是解码结构本身。两者面对的约束是同一个:智能体的每个”看到→行动”循环里,留给大模型的时间只有几十到几百毫秒。
训练与解码中的工程细节
工具调用如何与受限解码衔接
工具调用本身由普通文本路径生成,这意味着它走的是 DFlash 的 16 位块无损验证。当工具调用被接受后,目标模型写出基元起始 token。这里有两个容易踩坑的工程点:
- 声明块长必须与布局匹配。 如果 不等于任何布局算出的长度,或者超过剩余输出预算,块会在开始草稿之前被拒绝。这避免了草稿器在一个注定非法的 schema 上浪费一次前向。判断”剩余预算”必须把起止分隔符与预留的续写 token 算进去。
- 起始 token 之后的投机 token 必须丢弃。 如果文本块的验证在起始 token 之后还接受了若干个后续 token(它们在 DFlash 的视图里只是普通文本),这些 token 与新的布局冲突。算法 1 第 13 行显式截断到起始 token 之后。
这两点体现了”文本路径”与”基元路径”共享同一条生成流的设计:切换发生在流内,而不是在两个独立的解码器之间做路由。
位置约束只用已算好的 logits
位置约束的实现方式值得单独看。块内每个位置的 logits 在一次前向里已全部产生,后续的约束不是在采样时一步步施加的语法引擎,而是在这些 logits 上做”掩码 + 选择”:
- 分隔符位置:只保留对应分隔符 token,其它位置一律屏蔽;
- 坐标位置:只保留
<0>…<1000>共 1001 个数字 token; - 成对规则:如果某个路点的 2D 投影用了
<oof>,那么对应的第二个 2D 位置也必须是<oof>(或两个数字 token); - 边界框:、,通过”候选集交集”式的小循环满足。
这与站内拆过的 vLLM 结构化输出:FSM 编译、语法 bitmask 与受限采样 在算法层面有相似之处——都是”把合法词表编译成每个位置的掩码”——但执行位置不同:vLLM 是逐位置推进的有限状态机,VFlash 是同一块内所有位置同时掩码。后者正是并行解码的必要条件:如果某个位置的合法集合依赖前面位置的状态,就不可能并行。
拒绝时的回退策略
接受门失败时,回退也有讲究:
- 轨迹取 :基元的前缀(前几个路点)并不比后面更”可靠”。布局是均匀重复的,如果整体合法失败,直接让目标模型从锚点重算整段没有意义上的优势;实际上此时 VFlash 会从锚点开始受约束 AR,并且草稿缓存被重置,因为草稿器下一块的条件特征已不成立。
- 边界框取 :前几个坐标可能是确定的(置信度守卫只标记某一段),于是保留确定部分,后续坐标由目标模型重算。这与边界框”每个框独立”的语义一致,也能在拥挤场景里回收一部分草稿收益。
回退发生后,目标模型的 KV 缓存回滚到块前状态。这一步在很多推理框架里有现成机制,投机解码的回滚路径可以复用;站内 vLLM 源码完全拆解(十):投机解码 里有完整的批次扩展与回滚流程,VFlash 只是把”按 token 回滚”换成了”按块回退”。
打包训练与跨样本隔离
训练时把多个基元块打包进同一个序列,是一个容易被低估的细节。如果简单地把所有块首尾拼接,块 A 的位置就能看到块 B 的坐标,草稿器会学会”抄邻居”,而推理时邻居并不存在。VFlash 的做法是为每个块保留独立的位置编号与注意力掩码:块内位置彼此可见;块外只能看到自己样本在锚点之前的目标 token。这确保了不同 schema、不同长度的块可以在一个 batch 里混合训练,而不会互相污染。稠密运动的草稿器则按”每个未来帧一个块”组织, 个预测位置(含 mask token)统一等权监督。
适用边界:什么时候该用,什么时候不该用
收益依赖的三件事
把论文的结论归纳一下,VFlash 的收益取决于三个条件:
一、输出是结构化的。 如果输出是自由文本(比如子任务描述、思考链),没有可辨识的边界,也没有”整段一起正确”的判据,就只能退回 DFlash 那套无损前缀验证。VFlash 对文本的处理正好如此。
二、消费端对 token 级一致性不敏感。 轨迹的消费者是动作模型,读取的是隐状态;边界框的消费者是几何匹配与置信度。只要这两类下游更关心”几何是否可用”,松弛接受就是安全的。反例是那些需要精确复现目标模型输出的下游——如可验证的逻辑推理、严格格式的 JSON、代码生成——一旦接受”结构合法但不是目标选择”,就破坏了可复现性。
三、验证代价能被分摊。 收益公式里 是每个被接受块必须付出的一次目标前向(更新缓存与特征)。如果目标前向本身很贵,或块很短,那分摊效果就小;这也是 4-token 边界框的端到端加速(2.6–2.8 倍)明显小于 54/108 token 轨迹(5 倍)的原因。
与 DFlash 的对照
| 维度 | DFlash | VFlash |
|---|---|---|
| 草稿单位 | 固定 16 位置 | 由工具调用声明的整基元 |
| 接受判据 | 最长匹配前缀 + 目标校正 | schema 合法整块接受 |
| 训练标签 | 目标续写 | 标注坐标 |
| 块内提交 token(MolmoSpaces) | 3.0(轨迹块内只有 2.2) | 53(基元),5.5(文本) |
| 适用输出 | 任意文本 | 已知结构的空间基元 + 文本 |
| 精度 | 与目标分布一致 | 可能优于或劣于目标 |
两者的关系不是替代,而是分工:VFlash 的流水线里,文本仍由 DFlash 的验证块处理,基元才走直接接受。这也意味着任何已经部署 DFlash 的系统,增加 FPD 是一条增量路径,而不是重写。
已知局限
论文本身也指出了几处需要如实对待的地方:
- 稠密运动的跨帧串行。 一帧的 155 token 可以并行,但最多 30 帧只能串行,且大数字格的合法约束更复杂,部分指标(WorldTrack FDE、PWT)没有超过 AR。约 25 倍的提速在”密度很高、帧数很多”的场景下是否仍然优于逐 token AR,取决于目标模型每 token 的成本与每帧基元的长度。
- 边界框在密集场景需要回退。 完全不做回退时 F1 掉约 20 个点,说明”结构合法”对检测任务不够;置信度守卫是必要的,而它的阈值本身就是一个新的超参数。
- 驾驶精度并非全面领先。 ADE 略高于 Qwen-Drive,说明”更快的规划”不自动等于”更好的规划”;下游策略的架构(交叉注意力到隐状态的具体方式)也会显著影响最终得分。
- 工具调用的长度声明是新的失败面。 目标模型可能在工具调用里写错
block_size,或与实际点数不一致。这类错误发生在草稿器之前,需要 schema 层面的校验。
对推理系统设计的启发
这套设计的外推价值,可能比它解决的具体任务更大。以下几条是从 VFlash 里能直接提炼出来的工程原则。
结构化输出应当被当成”解码单位”
主流的推理框架与投机解码实现,几乎都把”解码单位”定义成”token”或”固定长度的 token 块”。VFlash 提示了一个更一般的视角:如果输出有可计算的结构,解码单位就应该由结构决定,而不是由引擎决定。 在服务端,这意味着调度与验证逻辑需要知道”这一段的边界在哪里”——可以通过 schema、工具调用或语法来传递。这与结构化输出系统已经在做的事情天然衔接:既然语法引擎知道输出是数组、对象还是数字,它同样可以知道”一个完整的数组元素从哪到哪”。
验证强度要与下游语义匹配
“无损”是一个昂贵的要求,它的价值取决于下游消费者有多在乎 token 级一致。VFlash 在同一个框架里对不同基元给了不同的验证强度:轨迹直接接受、边界框加置信度守卫、文本仍要前缀验证。这种分级验证的思路可以直接用于其他推理场景,比如:
- 检索结果里的结构化字段(引用编号、文档 ID)可以按 schema 直接接受;
- 工具调用的 JSON 参数可以按类型合法性接受;
- 但生成给用户看的自然语言仍应保留验证。
端侧物理 AI 的优化优先级
三个平台的延迟拆分说明,端侧的优化空间集中在哪里:视觉编码、prefill、动作模型的时间是”下限”,解码是”可压缩量”。在这个意义上,VFlash 与站内拆过的 PhysisServe 完全拆解:百亿世界模型如何输出千赫兹物理控制信号 关注的是同一类问题——物理 AI 的推理时延预算该如何分给感知、规划与动作。PhysisServe 从流水线与调度入手,VFlash 从解码结构入手,两条路可以叠加:调度层把多个请求交错,解码层把单个请求的串行长度压下去。
与动作模型接口的耦合
VFlash 的接受门之所以能放宽到”结构合法”,与它向下游传递信息的方式直接相关:动作模型通过交叉注意力读取 VLM 对整段规划的隐状态,而不是直接消费坐标 token。这意味着”目标模型对规划的一次前向”本身就是下游要的产物——它既更新了缓存,又生成了动作条件特征。反过来,如果下游真的按 token 序列精确解析坐标,这套松弛就会失去前提。在部署时,先厘清”动作模型读的是什么”往往比调草稿模型更重要。
小结
VFlash 于 2026 年 11 月由 NVIDIA 研究团队发布在 arXiv(编号 2611.08449),并于 NVIDIA 物理 AI 研究页公开项目。它的核心是一句话:视觉规划的结构在预测坐标之前就已经知道,因此可以把整段结构当成一个预测单位并行生成,并按结构合法性直接接受。
具体而言:
- 基元是最小预测单位。 工具调用声明长度,起始 token 声明布局,每个位置的角色提前固定;这与固定 16 位置窗口的投机解码形成对比。
- 草稿器监督的是几何,而不是目标模型的续写。 五层非因果草稿器、共享冻结目标的嵌入与输出层、从目标中间层注入特征、5.37 亿可训练参数。
- 接受门从”最长匹配前缀”换成”schema 合法整块接受”。 轨迹直接接受,边界框叠加空间置信度守卫,文本仍走无损验证。
- 延迟公式的收益来自 而非前向次数。 每个基元两次前向(草稿一次、目标一次),提交 53 个 token,端到端在 Thor 与 Spark 上 5 倍、在 H100 上 3.6 倍、Waymo 上 4.5 倍。
- 更准不是意外的副作用,而是训练标签与联合布局带来的结果。 三个机器人数据集上 ADE 普遍下降 18%–61%,联合 2D+3D 在 AR 下反而更差、在 VFlash 下反而更好。
- 下游收益依赖规划质量。 MolmoSpaces 上从 62.6% 到 70.2%;把 VFlash 规划换成 AR 规划,成功率掉回 61.0%。
它也有清楚的边界:自由文本、需要精确复现的输出、跨帧稠密运动、密集场景的检测框,都不是它能”无损”覆盖的地方。把它当成”投机解码的一种结构化变体”而不是”更快的解码器”,更容易在实际系统里找到正确的位置。
如果对它的底层草稿机制还陌生,DFlash 块扩散解码 讲的是同一个五层草稿器与特征注入的设计,而 EAGLE 完全拆解 则是从特征级草稿的另一种路线讲投机解码,两篇对照看能把”草稿怎么来、验证怎么改”这条主线串起来。
参考资料
- VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding (arXiv:2611.08449)
- NVIDIA VFlash 项目页:Enabling System-1 VLMs for Physical AI
- DFlash: Block Diffusion for Flash Speculative Decoding (arXiv:2602.06036)
- LocateAnything: Fast and High-Quality Vision-Language Grounding with Parallel Box Decoding (arXiv:2605.27365)
- Spec-VLA: Speculative Decoding for Vision-Language-Action Models with Relaxed Acceptance (arXiv:2507.22424)
- Fast Inference from Transformers via Speculative Decoding (arXiv:2211.17192)
- MolmoMotion: Forecasting Point Trajectories in 3D with Language Instruction (arXiv:2606.18558)
- MolmoSpaces: A Large-Scale Open Ecosystem for Robot Navigation and Manipulation (arXiv:2602.11337)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



