


DAMP 完全拆解:循环状态为什么不能用统一 INT8——衰减感知的混合精度如何稳住长上下文推理
问题:长上下文推理里,循环状态成了第二本显存账
长上下文推理的成本结构在过去两年发生了一次不太显眼的迁移。标准 Transformer 的显存账本几乎全部记在 KV Cache 上:上下文越长,缓存按 token 线性增长,服务系统只好用分页、前缀复用、驱逐与量化去压缩它。以 Gated DeltaNet(GDN)和 Kimi Delta Attention(KDA)为代表的线性注意力层,把这份账本换成了另一种形式——每个头维护一个固定尺寸的状态矩阵,无论上下文多长,状态大小都不变。
这类层并不是单独使用的。近期的混合模型把少量全注意力层或稀疏注意力层与大量线性注意力层交错堆叠:Qwen3.6-35B-A3B 用了 30 层 GDN 加 10 层全注意力,Kimi-Linear-48B-A3B 用了 20 层 KDA 加 7 层 MLA,Kimi-K3 则是 69 层 KDA 配 24 层门控 MLA。全注意力层保留精确的 token 级检索能力,线性层负责把历史压进固定状态,二者分工。问题在于,固定状态并不等于免费:它虽然不随上下文增长,却在每个解码步都要被读取、更新、再写回,而且为了前缀缓存,服务系统还要为每条序列保留若干历史检查点。
论文给出的一个具体数字很能说明量级:用 SGLang 服务 Qwen3.6-35B、批大小为 256 时,仅 FP32 循环状态就需要约 80 GB 显存,这里面既包括活跃状态,也包括前缀缓存保留的检查点。与此同时,循环状态更新受显存带宽限制,占解码延迟的 24.3%。这两件事指向同一个优化方向:把状态从 FP32 压到更低比特,既省显存,又减少每次更新的读写流量。
但循环状态是一种很难量化的对象。DAMP 的作者发现,统一 INT8 和 FP8 已经会让复杂推理精度明显下降,INT4 与 NVFP4 则几乎把数学推理和代码生成的成绩打到零。这不是常见的「权重量化掉一点」问题,而是误差会进入递推:状态每一步都被重新量化,量化误差留在状态里,下一步又被衰减和 delta 规则改写,继续传下去。本文围绕 DAMP(Decay-Aware Mixed-Precision Recurrent-State Quantization,衰减感知的循环状态混合精度量化)拆解这条误差链,以及它如何用离线校准选出少数「高风险关键通道」保留 FP16、其余压到 INT8,在平均 9.9 bit/值的预算下把精度拉回 FP32 附近。
前置:GDN 与 KDA 的状态更新在算什么
要理解量化误差为什么特殊,先把状态更新的数学形式写清楚。
对每个头,循环状态是一个矩阵 , 是 key 维度, 是 value 维度。矩阵的第 行记作 ,对应第 个 key channel。第 步的 query、key、value 分别为 、,两种架构都在头内对 query 和 key 做 归一化。
query 读取更新后的状态得到输出:
状态更新则由「衰减」和「delta 规则修正」两部分组成:
逐项解释:
- 是对上一步状态施加的学习衰减。GDN 在一个头内共享一个标量衰减因子 ,因此 ;KDA 做逐通道衰减,, 由当前隐状态投影得到。KDA 的粒度更细,不同 key channel 可以有不同的遗忘速度。
- 沿着当前 key 方向 擦除一部分旧关联。因为 已归一化, 是一个秩一投影, 控制擦除强度。
- 沿同一方向写入当前 value。
可以把这三步理解成一次带遗忘的在线最小二乘更新。若只看「读」这一侧,状态希望满足 。对损失 做一步梯度下降,梯度是 ,更新量正是 ,与上式中的 delta 部分同形。差别在于这里的「学习率」 和数据相关,且前面多了一个衰减矩阵。这也解释了为什么它被称为 delta rule:每一步不是简单累加,而是先把旧状态沿当前 key 方向修正到新 value 上。
把作用在旧状态上的所有操作合并成转移矩阵:
更新式就可以写成紧凑的线性递推:
这个形式是后文的全部起点。它说明状态不是一份只写一次的缓存,而是一个每步都被重新线性组合的动力学系统。对量化而言,关键差别也在这里:KV Cache 里的一个 token 向量写入后基本不变,量化误差只影响那一个位置;循环状态每一步都要「先反量化、再计算、再量化」,误差会作为下一步的输入继续参与运算。
衰减强度的实际分布非常宽。论文统计了 Qwen3.6-35B 的 30 个 GDN 层共 960 个头,有效衰减因子的 10%、50%、90% 分位分别是 0.376、0.967、0.9996。也就是说,有的头几乎把历史全部忘掉,有的头几乎完整保留。KDA 的逐通道衰减在通道之间同样拉开很大差距。后文会看到,这个分布正是混合精度分配的依据。
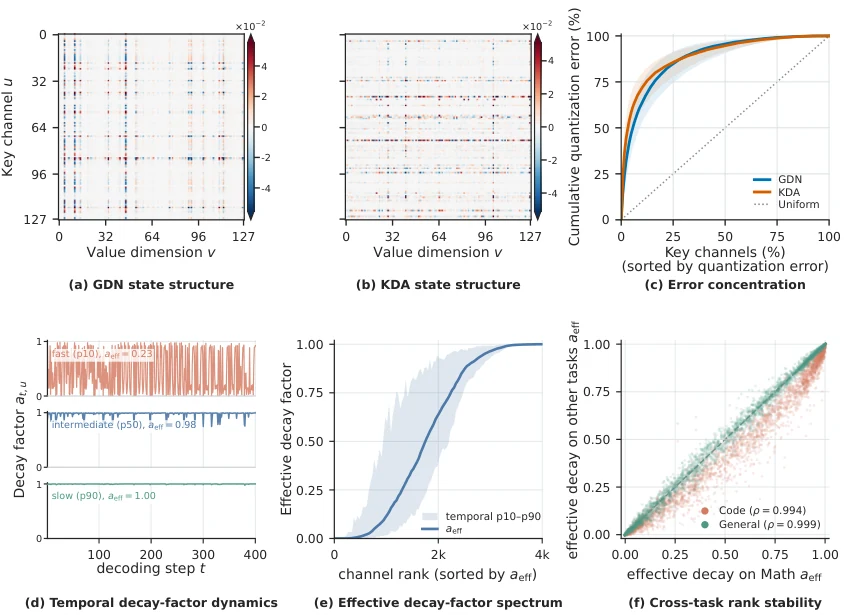
上图是论文的图 2,四组子图对应后文逐步展开的四个事实:(a)(b) 状态幅值在 key 通道和 value 维度两个方向上都存在明显离群;(c) 沿 value 维度做缩放与重排后,剩余 INT8 量化误差仍然集中在少数 key 通道;(d)(e) KDA 的逐通道衰减在解码步与通道之间差异很大;(f) 按有效衰减因子排序,不同任务得到的通道名次高度一致。理解这张图,基本就理解了 DAMP 的动机。
量化对象:每一步都要反量化、更新、再量化
DAMP 量化的是存储中的循环状态 。解码时,系统先从压缩存储里重建上一步状态,用它做递推更新,再把更新后的状态量化后写回显存。这个「重建—更新—再量化」的循环是理解全部误差分析的框架。
量化器采用对称 -bit 整数量化,逐 key channel 独立处理。设 是状态矩阵的某一行(固定 key channel,沿 value 维度展开),缩放因子为
重建值为
工程实现上还有两个细节。第一,value 维度按每 32 个元素分组,每组共享一个 FP32 缩放因子;INT8 不存零点,INT4 额外存一个 FP32 零点。第二,缩放因子在每次写状态时重新计算,因为状态本身每步都在变。这两点后面还会用到:分组让同一组内的幅值尽量接近,逐通道则避免一个通道的离群值抬高其他通道的量化步长。
现在把量化操作嵌入递推。设 是从量化存储中重建出来的状态:
这里有一个容易忽略但很重要的细节:量化器作用在「用重建状态算出的新状态」上,而不是作用在真实状态上。服务系统没有真实状态可参考,它只有压缩存储,因此误差一定进入闭环。
定义累积状态误差为重建状态与无量化参考状态之差:
并定义第 步的局部量化误差为量化器的输入输出之差:
利用 ,把累积误差写成
从 开始展开:
这条式子把问题说透了:第 步产生的局部误差 ,要经过从 到 的全部转移矩阵才到达当前状态。转移矩阵里既有学习衰减 ,也有沿着 key 方向的擦除项。衰减强,旧误差被压得快;衰减弱,误差长期留在状态里,还会被后续的读出放大。
这条展开式还可以换一个角度看。在训练语境里,带衰减的线性递推求梯度时误差要沿时间反向传播(backpropagation through time),梯度同样经过每一步转移矩阵的乘积;推理时的量化误差传播在数学上就是同一个结构,只不过「误差」变成了舍入噪声,方向是从早到晚正着传。实践上有一个经验:RNN 类模型容易出现梯度消失,正是因为转移矩阵的乘积长期小于 1;换到量化误差,衰减强恰恰是好事,它会主动把旧噪声压掉。真正危险的是乘积长期接近单位矩阵的情形,也就是那些几乎不衰减的通道。
这也解释了为什么「统一 INT8 应该够用」的直觉在这里失效。权重和 KV 量化通常只经历一次舍入,误差不会反复回灌;循环状态的误差是每步注入、按转移矩阵累积的。更麻烦的是,状态本身就是模型记住历史的唯一载体,一旦某个 key channel 的关联被量化噪声污染,后续 query 读到的就是被污染的历史,错误会继续影响生成,再通过新 token 的 key/value 反馈回状态。
论文的实验结果印证了这一点。在 Qwen3.6-35B 上,FP32 状态的 AIME 2026 成绩是 85.46,FP16 是 84.58,BF16 掉到 79.71;FP8(E4M3)只有 29.27,统一 INT8 只有 18.48,NVFP4 和 INT4 几乎归零。这里有个容易读错的细节:FP8 的 29.27 反而高于未做 SR 的 INT8 的 18.48,说明同为 8 bit 量级,格式与量化器的组合会显著改变结果;而 INT8 加 SR 后能回到 63.98,又说明分组和重排比「选哪种 8 bit 格式」更关键。另一个信号来自 FP16 与 BF16 的对比:同样 16 bit,FP16 的 10 位尾数比 BF16 的 7 位尾数更契合这类状态,论文据此认为循环状态更需要细粒度的数值分辨率,而不是更宽的指数范围。Kimi-K3 对 BF16 不那么敏感,论文推测训练阶段针对 BF16 状态存储做过量化感知训练,因此对该格式更鲁棒;这属于模型侧的差异,不影响「细粒度分辨率优先」这个观察。
误差为什么集中在少数 key channel
既然统一低比特不行,下一步要问的是:误差在状态矩阵里是均匀分布的吗?答案是否定的,而且不均匀得很厉害。
状态的幅值在两个方向上都存在离群值:某些 key channel 整体偏大,某些 value 维度整体偏大。如果对整行只用一个缩放因子,一个特别大的元素会把 抬高,同行里大量小幅值元素就被压进很少几个量化格,误差迅速变大。DAMP 的第一层处理是逐 key channel 独立量化,让不同通道各自拥有缩放因子,互不牵连。
第二层处理针对 value 维度,称为缩放与重排(scaling and reordering,SR)。具体做法是:先为每个 value 维度估一个缩放系数,把幅值差异拉平;再按缩放后的 RMS 幅值排序,把幅值相近的维度排在一起;最后沿排序后的 value 维度按每 32 个元素分组,每组共用一个缩放因子。缩放系数和维度顺序在离线校准时确定,推理时固定;组内缩放因子则在每次写状态时重算。这样做的目的是让同一组里的元素幅值接近,减少「大值定步长、小值被牺牲」的情况。
为什么「重排」会改善量化?分组的目的是让同一组内元素幅值相近。若一组里混着幅值 0.01 和 10 的元素,缩放因子被 10 决定,量化步长约 ,幅值 0.01 的元素只会落到 0 或 个量化格,几乎等于全部丢失。把幅值相近的维度排到一起后,每个组的步长与其内部元素匹配,小幅值元素也能用满量化范围。缩放则进一步把不同 value 维度的整体尺度拉平,避免某些维度天生数值大、天生占少数格。两者合起来,本质上是把「全局一套步长」换成「局部自适应步长」的结构化版本,而且这份结构可以离线确定后固定,不需要在线估计。
SR 的收益可以从数据上直接看到。Qwen3.6-35B 的 AIME 2026 成绩,统一 INT8 是 18.48,加上 SR 后升到 63.98,提升超过 45 个百分点。但 63.98 仍比 FP32 的 85.46 低 21 个百分点以上,说明 SR 只解决了 value 方向上的幅值失衡,剩下的误差还有别的结构性来源。
论文的图 2(c) 给出了答案:把 value 维度处理好之后,剩余的平方误差高度集中在少数 key channel 上。按通道统计,误差最大的 12.5% key channel 贡献了 GDN 总平方误差的约 69%、KDA 的约 76%。换句话说,绝大多数通道即使压到 INT8 也问题不大,真正拖垮精度的是那一小撮「又敏感又难量化」的通道。
这个观察自然导向一个非均匀方案:既然误差集中在少数通道,就把这些通道单独留在更高精度,其余通道继续用 INT8。问题的难点不在于「要不要混合精度」,而在于「凭什么判断哪些通道该留」。只看当前这一步的量化误差还不够,因为误差能留多久取决于后续衰减——一个当前误差很大但下一步就被强烈衰减的通道,未必比一个误差中等但几乎不衰减的通道更危险。DAMP 的核心贡献,就是把这两个因素合成一个可离线计算的风险分数。
衰减结构:误差能留多久,主要由它决定
回到误差展开式。局部误差 经过的转移矩阵乘积里,衰减矩阵 是逐通道对角的;delta 规则中的擦除项也会改变误差,但它沿着当前 key 方向作用,方向和强度随 token 变化,不如衰减那样有稳定的通道结构。论文因此把衰减作为误差留存的主要可建模信号。
对 KDA 的某个 key channel ,第 步的衰减因子记为 。多步累积时衰减因子是连乘的,所以衡量一个通道「整体忘得多快」应该用几何平均,而不是算术平均:
这个定义不是随手选的。若每一步衰减为 ,经过 步后保留比例是 ,取对数后变成 ,几何平均正好对应「平均每步的对数衰减率」。 接近 1 意味着通道几乎不遗忘,历史状态和其中的量化误差都会长期保留;接近 0 则意味着通道很快被新信息覆盖,旧误差没有机会累积。
论文的图 2(d) 选了三条 KDA 通道做对照:快衰减通道的 在解码过程中大幅波动,慢衰减通道则长期贴近 1。图 2(e) 统计了全部通道的有效衰减因子,范围从强抑制一直覆盖到近乎完全不衰减。GDN 在头级别上也有类似的宽分布,图 6(b) 给出的 960 个头中,10%、50%、90% 分位分别是 0.376、0.967、0.9996。
更关键的是稳定性。衰减因子本身随解码步波动,但「哪些头或通道衰减慢」这件事在不同任务之间高度一致。以 Math 为基准,KDA 通道排序在 Code 和 General 上的 Spearman 秩相关分别是 0.994 和 0.999;GDN 在头级别上的对应值是 0.998 和 0.999。甚至把校准语料切成两个不相交的子集分别校准,选出的 top-16 通道重叠率仍有 92.0%(KDA)和 93.2%(GDN),而随机选择的期望重叠率只有 12.5%。
这组稳定性数据是 DAMP 能做成离线方法的前提。如果慢衰减通道随任务剧烈变化,任何静态的通道选择都没有意义,只能在线动态判断,而在线判断又要额外读取统计量,抵消压缩收益。跨任务稳定意味着校准阶段观察到的衰减结构可以冻结下来,推理时按固定布局读写。
DAMP 的风险分数:把「误差大小」和「误差留存」乘起来
有了误差集中和衰减稳定这两个事实,剩下的问题可以写成资源分配问题:每个层、每个头有 个 key channel,高精度预算只允许其中 个用 FP16,其余用 INT8,应该选哪 个?
DAMP 的答案是给每个通道算一个累积误差风险分数,然后取分数最高的若干个。分数由两部分构成。
第一部分是局部量化误差。对校准轨迹中采样的状态 ,在给定量化器下计算每个 key channel 的平方误差:
这里 取状态矩阵的第 行,范数是沿 value 维度的 范数平方。之所以用平方误差,是为了和后面的能量累积保持一致:误差经过线性转移后,平方量级的衰减因子是 。
第二部分是衰减加权。由展开式,第 步的局部误差在 步之后对状态的贡献按 衰减,平方误差则按衰减因子的平方衰减。把初始误差和未来 步的贡献加起来,再对校准样本取平均,得到通道 的风险分数:
括号里的 是当前这一步的误差本身,求和项是它在后续 步里的残留。 取 256:校准轨迹里每个锚点之后恰好保留 256 步的衰减序列,足够覆盖大部分误差留存;更长的窗口收益递减,而且会减少可用锚点数量。这个窗口长度的选择不是理论最优,而是校准数据长度和统计稳定性之间的折中。
窗口取 256 还有一个物理含义上的理由。衰减因子接近 1 的通道,误差留存几乎不随时间衰减, 再大也只是把同一份误差反复计入;衰减很快的通道,求和项在几十步内就收敛。在慢衰减头(有效衰减因子 0.9996 分位)与快衰减头(0.376 分位)的对数衰减率之比约为 的语境下,256 步窗口足以把两类通道区分开,而不需要覆盖到理论上才能真正饱和的步数。
这个分数有两个性质值得注意。
第一,它同时惩罚「误差大」和「忘得慢」。一个通道如果当前量化误差很大,但衰减因子很小,求和项很快收敛,分数主要由 决定;一个通道如果误差中等但衰减因子接近 1,求和项接近 ,分数会被放大几百倍。后者正是统一 INT8 方案里最容易被忽略的隐性风险。
第二,它用的是「平方误差 + 平方衰减」。严格来说,转移矩阵 还包含 delta 规则的擦除项,误差的实际传播并不只是逐通道乘以 ;但论文把衰减当作主要可离线估计的成分,擦除项作为次要因素交给了校准数据中的实际状态轨迹去体现。这个近似是否成立,最终要靠消融实验回答:只按局部误差选(error-only)和只按衰减留存选(retention-only)都不如两者相乘,说明两个信号确实互补。
选择规则本身很直接。对每个层 、每个头 ,按 排序,取前 个通道放进高精度集合 。所有层和头使用相同的 ,不是为了理论最优,而是为了内存布局统一:固定数量的 FP16 行让打包、向量化读写和融合 kernel 的实现简单很多。如果逐头分配不同数量,理论上能更精细地利用预算,但布局会变成变长结构,kernel 复杂度和访存效率都会付出代价。
在固定通道数的约束下,选分数最高的 个等价于最小化留在低精度通道的总风险,这是一个直接的贪心最优性结论:把高精度名额给边际风险最大的通道。
校准流程:SR 候选、风险打分与选择集验证
DAMP 的离线校准不止是算一次分数。SR 的缩放系数和 value 维度排序本身也有设计空间,不同选择会改变量化误差的分布,从而改变哪些 key channel 风险最高。论文把这件事处理成一个「候选生成 + 选择集验证」的流程。
校准数据是 36 条 prompt:12 条来自 MATH 训练集,12 条来自 APPS 训练集,12 条来自 ARC-Challenge 训练集,平均分成拟合、参数选择、验证三个不相交的 split,每个 split 里数学、代码、通用各 4 条。每条输入 1024 token,模型以 FP32 状态生成 4096 token,并抑制提前终止以保证长度固定。每条序列记录两个窗口,分别从解码更新位置 0 和 2048 开始,各覆盖 1024 次更新;每个窗口内第 256、512、768 次更新后的状态作为打分锚点,每个锚点后面正好有 256 步衰减序列可用。这样每条序列有 6 个锚点,每个 split 有 72 个锚点。
流程分三步:
- 在拟合 split 上,用状态 RMS 统计构造若干组 SR 候选,包括 value 缩放系数和维度排序。
- 对每个候选,在拟合锚点上模拟 INT8 量化,按式 (14) 和式 (15) 计算风险分数,取 top- 形成受保护通道集合 。
- 冻结 ,在参数选择 split 上计算完整混合精度配置的目标函数
其中 和 分别是 INT8 与 FP16 存储在原始状态坐标下测得的平方误差, 是式 (15) 里的衰减留存权重。选择 最小的候选,冻结其受保护集合与 key 排列,最后在独立的验证 split 上评估。
三个 split 的分工值得单独说明,因为这是量化校准里很容易被忽视的环节。拟合 split 用来构造 SR 候选和统计状态幅值,它决定「有哪些候选可试」;参数选择 split 用来在候选之间做取舍,它决定「用哪个候选」;验证 split 只负责最后确认,不参与任何选择。把「选择」和「验证」分开的意义在于避免选择偏差:如果拿同一批数据既选候选又报精度,结果会系统性偏乐观,迁移到线上时精度回落。很多量化工作只用一个校准集,线上掉点往往就出在这一点上。论文对每个候选都重新做一遍完整混合精度配置的误差评估,而不是只看拟合集上的打分,这也是一种防过拟合处理。
这个流程有一个容易忽略的细节:误差是在原始状态坐标下测量的。SR 会改变数值坐标,如果直接在缩放后的坐标里比较误差,会高估或低估某些通道的真实影响;先还原缩放和通道顺序再统计,才能让不同候选之间可比。
校准成本并不高:Qwen3.6-35B 约 7 分钟,Kimi-Linear-48B 约 9 分钟,Kimi-K3 约 78.75 分钟。相对于一次完整的量化部署流程,这个开销可以接受,而且只做一次,之后推理全程使用静态配置。
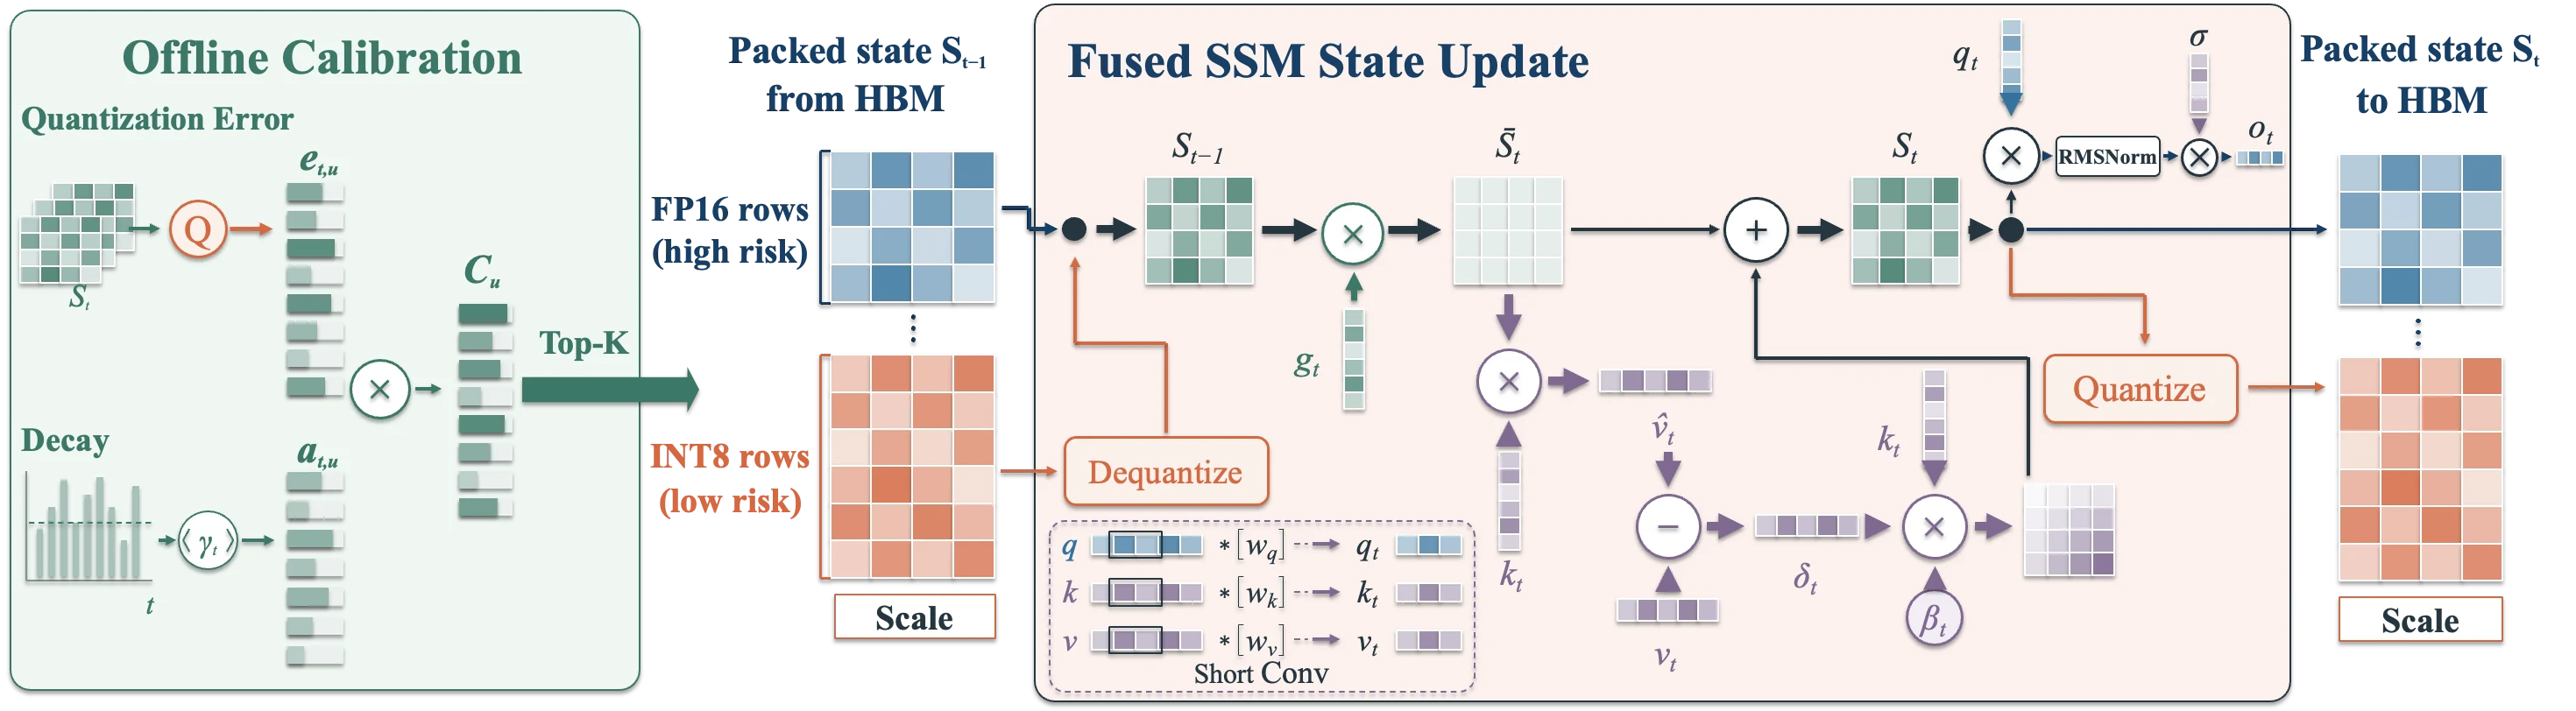
上图是论文的图 3,把方法分成两半:左半部分是离线校准,从校准轨迹中统计每个通道的量化误差和后续衰减,选出高精度通道并确定打包布局;右半部分是推理时的融合状态更新,在一个 kernel 内完成反量化、递推计算、读出与再量化。两条链路共享同一套通道排列,因此推理路径上不需要任何动态重排。
打包布局:让通道排列免费,让 kernel 只跑一趟
选出了高精度通道之后,下一个问题是工程上怎么摆放。如果每次解码都要先按索引把 FP16 行和 INT8 行拼起来,或者把状态重排成统一布局,省下来的带宽会被重排开销吃掉。DAMP 的做法是把排列吸收进权重,让模型直接产出所需顺序。
具体来说,把选中的 个 key channel 排到状态矩阵的前 行,其余通道排在后面。这个 key 排列通过重排 query 投影和 key 投影的权重实现:投影层直接输出新顺序的 、。value 维度的 SR 也类似,重排 value 投影的行和输出投影的列,并把卷积、门控、归一化的逐通道参数按同一顺序调整。推理时模型自然产出目标顺序,解码路径上没有显式的重排操作。
用置换矩阵写出来更清楚。设 和 分别是 key 通道与 value 维度的固定置换, 是 value 缩放系数。变换后的状态与输入为
衰减矩阵和转移矩阵同步变换为 、,value 缩放矩阵变为 。代入原更新式后得到
在没有量化的前提下,这个变换与原始计算严格等价:置换和缩放只是换了坐标,读出时再乘回去。输出投影的权重同步改为 ,把 value 置换也吸收掉。于是推理时状态始终以「前 行 FP16、其余行 INT8」的打包形式存在,读出的数值尺度由融合在 kernel 里的缩放恢复。
存储布局是两块连续区域:前 行存 FP16,其余行存 INT8 码;每 32 个 INT8 值配一个 FP32 组缩放因子,也放在缓存里。连续区域的意义在于向量化加载和存储——GPU 上最怕的是细粒度交错布局,一次 128 字节事务里混着不同精度的数据,会浪费带宽并增加指令数。
推理时的融合 kernel 做四件事:加载打包状态并反量化 INT8 部分;用 FP32 算术执行变换后的递推与读出;对低精度通道按新组缩放因子重新量化;把 FP16 值、INT8 码和 FP32 缩放写回。状态分块在寄存器中跨阶段复用,避免「反量化写回临时缓冲、再读出来算」的中间流量。prefill 路径则不同:每个 chunk 内部用 FP32 算术,算完后把最终状态写入同一个打包缓存;后续 chunk 和解码步读取的都是压缩状态。
可以把一次解码步的访存账粗略算一遍,看看 2.59 倍从哪来。设一个头的状态是 ,所有头合计每个层每个 token 要读写若干 MB 级的数据。FP32 存储时,一步更新至少要读一次旧状态、写一次新状态;DAMP 的打包布局下,FP16 区按 16 bit 读写,INT8 区按 8 bit 读写再加每 32 个值一个 FP32 缩放。粗看起来位宽比是 ,理论字节数约降到 31%,对应最多约 3.2 倍的带宽节省上限;实测 2.59 倍低于这个上限,原因包括缩放因子的额外读取、打包区域边界处的非对齐访问、以及反量化与再量化的额外计算。另一个容易被低估的收益来自 16 bit 方案:FP16/BF16 存储相对 FP32 只省一半字节,而 DAMP 比它们还少 39% 左右,所以在同样的带宽约束下,DAMP 的更新速度还超过了 BF16/FP16 状态——论文的图 4 正是把这两者也放进了对比。
这里有一个设计取舍值得说明。递推本身是逐通道的向量运算,不是矩阵乘,无法直接塞进 Tensor Core 的 INT8 通路;如果为了用整数矩阵乘而把整个更新改成整数算术,会引入大量缩放和移位,反而增加复杂度。DAMP 选择「压缩存储 + FP32 计算」:计算仍在 FP32 做,省的是状态读写流量,而不是计算精度。这个选择与循环状态更新的瓶颈吻合——论文统计它占解码延迟的 24.3%,且受带宽限制,减少字节数就是减少时间。
精度与效率:混合精度到底补回了多少
先看主结果。表 1 给出了 Qwen3.6-35B 和 Kimi-Linear-48B 在数学、通用推理、代码三类基准上的成绩。这里不逐项罗列分数,只抓几组能说明机制的对比。
Qwen3.6-35B 上,FP32 的 AIME 2026 是 85.46,统一 INT8+SR 是 63.98,DAMP 在 9.9 bit/值时是 83.82。也就是说,只比 INT8+SR 多 0.9 bit,就把 19.84 个百分点的差距补回了大部分。HMMT 从 50.09 回到 55.11(FP32 为 57.57),IMO-Ans 从 39.31 回到 48.89(FP32 为 50.29),LiveCodeBench-v6 从 64.51 回到 85.67(FP32 为 86.95)。通用推理两项本来就对量化不敏感,INT8+SR 已接近 FP32,DAMP 保持在 82.05 和 84.57。
Kimi-Linear-48B 上的趋势类似,但有一个值得注意的现象:DAMP 的 AIME 2026 是 62.94,略高于 FP32 的 62.34;HMMT 38.54 对 38.02,GPQA-D 64.56 对 64.17。这种小幅超出不应当解读为「量化提升了模型能力」,更合理的解释是基准样本量有限、生成温度较高,几个点的波动落在噪声范围内。论文的口径是「接近 FP32」,这个表述更稳妥。
Kimi-K3 的结果更能说明方法在超大模型上的可迁移性。这个 2.8T 总参数、104B 激活参数的模型有 69 层 KDA 和 24 层门控 MLA,FP32 状态的 AIME 2026 是 96.88、HMMT 是 97.92;DAMP 在 9.9 bit/值下是 97.50 和 97.35。统一 INT8 是 89.17 和 82.58,FP8 只有 59.83 和 40.91。规模越大,状态通道越多,少数高风险通道被保护起来的效果越明显。
长上下文方面,论文在 RULER 上测了 4K 到 128K 的宏平均准确率。Qwen3.6-35B 的 FP32 从 96.96 缓降到 96.13,DAMP 是 97.00 到 96.10;Kimi-Linear 的 FP32 从 95.27 降到 88.02,DAMP 是 95.27 到 88.02。与 FP32 的最大绝对差分别是 0.04 和 0.02 个百分点,统一 INT8+SR 则是 0.13 和 0.15。长上下文没有出现「越远越崩」的现象,说明误差没有被长序列累积放大到失控。
效率数据分三层。第一层是状态存储:9.9 bit 对 32 bit,理论压缩率是 ,与论文报告一致。第二层是循环状态更新 kernel:相对 FP32 最多加速 2.59 倍。第三层是全模型 TPOT:批大小 256 时,Qwen3.6 降低 19.0%,Kimi-Linear 降低 14.5%,Kimi-K3 降低 7.3%。Kimi-K3 的增益较小,论文归因于 TP8 配置下跨设备通信开销占比更高,状态更新的本地收益被通信摊薄。
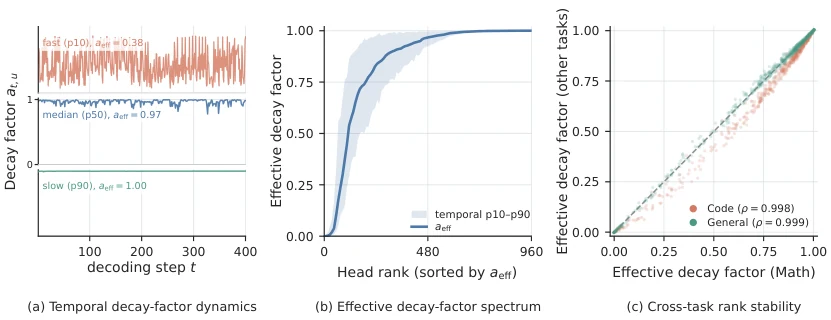
上图是论文的图 6,展示 GDN 头级别的衰减结构。(a) 三条曲线分别是有效衰减因子在 10%、50%、90% 分位的头,快衰减头的衰减因子在步间剧烈波动,慢衰减头长期贴近 1;(b) 960 个头的有效衰减因子分布,阴影是步间分位范围;(c) Code 与 General 上的排序对 Math 的散点,Spearman 相关分别为 0.998 和 0.999。这张图是「离线选择可行」的直接证据:衰减的绝对数值会变,但谁慢谁快的名次几乎不变。
多轮服务场景还有一组结果,解释了压缩对前缀缓存的实际价值。在 Kimi-K3 上,固定循环状态与 KV Cache 的总显存预算,处理 256 条四轮 WildChat 对话。FP32 状态的平均 TTFT 是 38.427 秒,BF16 是 35.646 秒,DAMP 是 30.464 秒;平均缓存命中率从 FP32 的 47.20%、BF16 的 56.96% 提升到 65.29%。原因很直接:同样的显存预算下,状态压得越小,能保留的历史检查点越多,多轮对话里可复用的前缀就越多。TTFT 的改善不只来自状态更新变快,更来自缓存命中率上升。
消融:为什么必须是「误差 × 衰减」
DAMP 的选择器可以拆成几个变体:随机选通道、按状态能量选、只按局部量化误差选、只按衰减留存选,以及两者相乘的完整分数。表 4 在 Kimi-Linear 上做了等预算对比,Kimi-Linear 的 AIME 从随机选择的 59.06、状态能量的 60.36、error-only 的 61.40、retention-only 的 61.22,提升到完整 DAMP 的 62.94;GPQA 和 LCB 也呈现同样顺序。
这组数字说明两件事。第一,状态能量不是一个好指标:幅值大的通道未必量化误差大,也未必衰减慢,按能量选只比随机好一点。第二,单独用误差或单独用衰减都不够:error-only 忽略了「误差能留多久」,retention-only 忽略了「当前误差有多大」,两者相乘才把风险排序做对。
GDN 上的消融还有一个结构性的细节。GDN 一个头内共享标量衰减,因此 retention-only 分数在头内所有通道上相同,无法区分通道;但 DAMP 的分数里,共享的衰减权重会随解码步变化,并对各通道的局部误差加权后再平均,所以仍能产生有意义的通道排序。这解释了为什么 GDN 上 DAMP 与 error-only 的排序不完全相同,也解释了为什么在 GDN 上完整方法的优势主要来自「用衰减权重对误差加权」,而不是「头内区分衰减」。
预算消融给出了另一个工程参数。把每个头保留在 FP16 的通道数 从较小值往上加,AIME 成绩整体上升,但超过 16 之后收益明显变小。论文因此在主实验里取 。这个数字与 9.9 bit 的预算直接相关:若 ,16 个 FP16 通道加 112 个 INT8 通道,再算上每 32 个 INT8 值一个 FP32 缩放因子(折合每值 1 bit),平均位宽是
这也解释了为什么「只多 0.9 bit」:相对纯 INT8+SR 的 9 bit,混合方案只增加了 0.875 bit,却把大部分高风险误差挡在了 FP16 里。收益来自分配,而不是来自整体提高位宽。
和其他状态/缓存量化方案的对照
把 DAMP 放进既有的量化谱系里,它的特殊性会更清楚。
与 KV Cache 量化相比,差别在「量化对象有没有动力学」。KV Cache 里的键值向量一旦写入就固定,量化一次、读取多次,误差不会回写;量化方案可以按 token 分块、按通道分尺度、按重要性做 token 驱逐,所有这些都在静态集合上操作。循环状态每一步都被重写,量化是「读—算—写」闭环的一部分,误差的留存时间由转移矩阵决定。因此 KV Cache 量化中常见的「保护离群通道」在 DAMP 里还要再乘以一个衰减权重——同样的离群通道,如果它很快就忘掉,就没必要保护。
与 Mamba 状态的量化相比,差别在衰减结构。Quamba2 用分组量化处理缓存的循环状态,Q-Mamba 用沿两个状态维度分别的缩放因子缓解幅值不平衡;它们主要处理「状态幅值布局」问题,误差传播的建模较少。DAMP 明确把衰减后的误差留存写进打分,而且利用的是 GDN/KDA 这类带门控与 delta 修正的架构中「衰减跨任务稳定」这一特性。
与权重量化相比,差别在误差累积方式。权重量化误差只经过一次矩阵乘,静态且不随时间叠加;状态是动态且唯一的记忆载体,量化误差进入历史,并在每一步被新的 key 和 value 改写。这就是为什么 FP16 状态几乎无损,而统一 INT8 会让 Qwen3.6-35B 的 AIME 从 85.46 掉到 18.48:单看位宽,8 bit 足以承载训练好的权重,但循环状态里误差没有「只错一次」的机会。
三种方案在服务系统里是叠加使用的,而不是互相替代:权重可以量化,KV Cache 可以量化,循环状态也需要单独的方案。DAMP 补的正是最后这块长期缺失的拼图——此前针对 GDN/KDA 状态的训练后量化基本是空白,论文自称是首项此类研究。
边界与可迁移的思路
DAMP 的适用边界在论文的局限性一节里写得很清楚,结合方法本身可以归纳成几点。
第一,它是训练后量化,不改变模型,也不做量化感知训练。好处是部署成本低、可直接套到已发布 checkpoint 上;代价是精度上限受限于「状态表示本身是否容忍低精度」。Kimi-K3 对 BF16 状态不敏感,论文推测训练阶段针对 BF16 状态存储做过量化感知训练,这提示模型训练阶段的数值习惯会影响 PTQ 的可行空间。
第二,低精度格式目前是 INT8,INT4 与 NVFP4 还补不回 FP32 精度。原因不只是位宽:4 bit 下组内缩放因子的相对开销更大,误差分布也更难用「少数通道保护」解决。把低精度端推到 4 bit,需要重新设计量化器和通道分配,而不是简单把 8 换成 4。
第三,通道选择是静态的,且所有层头共用同一个 。这换来了统一布局和简单 kernel,但也意味着无法针对个别层头做更细的预算倾斜。更丰富的循环动力学(例如把 delta 擦除项也建模进风险分数)是论文列出的后续方向。
第四,评测覆盖的是三个已发布的 GDN/KDA checkpoint 和 SGLang 的一种服务配置。换模型家族、换硬件、换并行策略,收益会变。Kimi-K3 的 TPOT 增益明显小于另外两个模型,就是通信占比改变结果的例子。
从更一般的角度看,这套方法提供了三个可迁移的思路。
其一是「状态量化要按动力学算账」。KV Cache 量化的经验是「按 token 或按通道分组、保护离群值」,循环状态多了一层时间维度:同一个通道的误差会沿递推留存,风险等于局部误差乘以留存时间。任何针对 RNN 式状态、SSM 状态或线性注意力状态的量化方案,都应该把转移矩阵的衰减结构纳入分配依据。
其二是「离线结构稳定性换在线简单性」。慢衰减通道跨任务稳定,才使得静态 top- 选择成立。这个前提不是所有循环模型都天然满足,部署前需要用校准数据验证通道排序的跨域一致性;如果排序不稳,静态方案就会退化成随机保护。
其三是「布局吸收进权重」。把通道置换和 value 缩放折进投影权重,是让混合精度不产生运行时重排开销的关键。很多混合精度方案在算法上成立,却在工程上被「每步重排」拖垮;DAMP 的融合 kernel 能跑到 2.59 倍,靠的不只是少读字节,也靠这条路径上没有额外的数据搬运。
如果把视野放到整个混合模型推理栈,DAMP 处理的是循环状态这一半的账本,另外两半分别是全注意力层的 KV Cache 和前缀缓存的检查点管理。站内对 KDA 的机制拆解可参考 Kimi Delta Attention 完全拆解,对线性注意力的整体脉络可参考 线性注意力完全拆解,混合模型状态在服务系统里如何分页与打包可参考 混合注意力模型的推理内存怎么排,KV Cache 侧的低比特量化可参考 QuantMLA 完全拆解。把这几篇放在一起看,才能拼出长上下文推理的完整内存账本。
小结
DAMP 要解决的问题可以压缩成一句话:混合线性注意力模型把 KV Cache 换成了固定大小的循环状态,但状态每步都要重写,量化误差会进入递推,统一低比特因此比常规权重量化更容易失效。
它的分析路径是三步。第一步,把状态更新写成带衰减和 delta 修正的线性递推,推出累积误差等于局部误差按转移矩阵乘积的求和,说明误差留存时间由衰减主导。第二步,用实验观察两个结构:量化误差在 value 维度平衡后仍集中在少数 key channel(12.5% 的通道贡献约 69%–76% 的平方误差),慢衰减的头和通道在不同任务间排序高度稳定(Spearman 0.994–0.999)。第三步,把局部平方误差与未来 256 步的平方衰减留存相乘,得到每个通道的累积风险分数,在固定预算下把分数最高的 16 个通道留在 FP16,其余压到 INT8。
工程实现上,通道置换和 value 缩放被吸收进投影权重,状态以「FP16 区 + INT8 区 + 组缩放」的打包形式存储,单个融合 kernel 完成反量化、递推、读出与再量化。结果是平均 9.9 bit/值、状态存储减少 69.1%、更新 kernel 最多加速 2.59 倍、TPOT 最多降低 19.0%,同时在数学、代码、通用推理和长上下文基准上保持接近 FP32 的精度。
最值得记住的不是某个分数,而是那条误差展开式。它把「量化一个状态」从静态的数值近似问题,变成了「在动力学系统里分配精度」的问题:误差大不大只是一半,留得久不久是另一半。DAMP 的混合精度分配,本质上是在这两者之间做乘法的预算决策。
参考资料
- DAMP: Decay-Aware Mixed-Precision Recurrent-State Quantization
- Kimi Linear: An Expressive, Efficient Attention Architecture
- Gated Delta Networks: Improving Mamba2 with Delta Rule
- Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
- SGLang: Efficient Execution of Structured Language Model Programs
- Quamba2: A Robust and Scalable Post-training Quantization Framework for Selective State Space Models
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



