


EAQuant 完全拆解:MoE 量化的三处专家感知——平滑聚合、路由一致性对齐与校准数据均衡
背景:MoE 为什么比稠密模型更难量化
MoE(Mixture-of-Experts,混合专家)架构的吸引力在于参数与计算解耦:模型可以拥有比稠密模型多得多的参数,但每个 token 只经过其中一小部分。以一个典型的稀疏 MoE 层为例,若一层有 个路由专家、top-,那么每个 token 只调用 8 个专家,理论上计算量只有”全激活”的 1/8。代价落在两处:一是所有专家权重都必须常驻显存,即使此刻没用上;二是路由决策本身引入了稠密模型没有的一条脆弱链路。
低比特量化是缓解显存压力的直接手段。把权重从 BF16 压到 4-bit,模型体积降到约四分之一,这在稠密模型上已经相当成熟:SmoothQuant 处理激活离群值,GPTQ、AWQ 处理权重误差,QuaRot、SpinQuant 用旋转把激活分布变得规整,DuQuant 则把旋转与置换结合起来把 W4A4 推到实用水平。这些方法在 MoE 上并非完全失效,但在激进比特下(W4A4、W3A4、W3A3、W2A4)会迅速溃败:论文报告 DuQuant 在 Mixtral-8x7B 的 W2A4 下 WikiText2 困惑度达到 7626,而全精度只有 3.84。困惑度几千意味着输出已经退化到近乎乱码。
EAQuant 是华为诺亚方舟实验室(Huawei Noah’s Ark Lab)在 2025 年提出、后于 2026 年 2 月更新到 v3 的训练后量化(Post-Training Quantization,PTQ)框架,专门针对 MoE 结构的三处独有难点做改造。它不是又一个旋转量化变体,而是选择绕开旋转法的复杂堆叠,直接从 MoE 的”专家”这一结构单元入手,把三项改造都做成”专家感知”(Expert-Aware)的形式:
- 专家感知平滑聚合(Expert-Aware Smoothing Aggregation,EA-SA):把各个专家的平滑尺度聚合为一个可以并入前置归一化层的统一向量,既压住激活离群值,又不引入运行时额外计算;
- 专家感知路由一致性对齐(Expert-Aware Routing Consistency Alignment,EA-RCA):在量化路由权重时同时约束 logit 重构误差与路由概率分布,防止 top- 选错专家;
- 专家感知校准数据均衡(Expert-Aware Calibration Data Balance,EA-CDB):让低频专家在校准阶段获得足够的样本,避免其量化参数被少量噪声样本带偏。
三项改造合在一起,几乎不改变推理时的图结构,也不需要量化感知训练(QAT),因此对推理部署友好的程度很高。下面先逐个讲清三处痛点,再逐一项讲机制、推导、源码实现与实验证据。
三处痛点:先看清问题,再谈方法
MoE 量化之所以比稠密模型难,不是一个原因,而是三个互相纠缠的原因。EAQuant 的论文用一组实证观察图把它们分别量化出来,理解这些图是理解后续所有设计的前提。
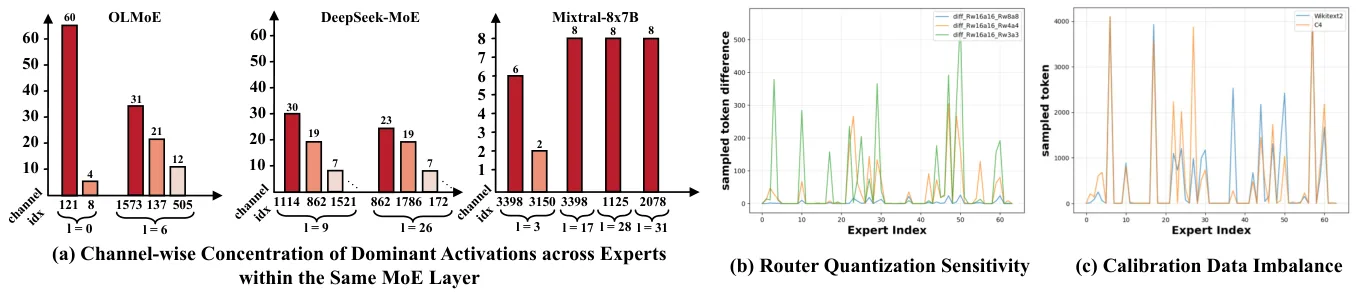
上图来自论文图 2,三个子图分别是三项改造的实验依据:(a) 不同专家的主导激活集中在同一小批通道上,跨专家高度一致;(b) 路由 logit 在低比特下扰动会显著改变专家负载分布;(c) 同一 MoE 层内各专家收到的校准 token 数严重不均。下面按顺序拆开。
痛点一:激活离群值在专家间呈现”同构”
SmoothQuant 一类方法的前提是:激活张量里有少数通道数值特别大(离群值),于是用一个逐通道的平滑向量 把激活”按比例压平”,同时把 的逆作用到对应权重上,数学上完全等价:
平滑向量 的标准算法是
其中 是通道下标, 控制”把量化难度从激活搬多少到权重”—— 越大,激活被压得越狠、权重动态范围越大。这个向量可以预先乘进前置的 RMSNorm/LayerNorm 的 参数里,所以推理时没有任何额外操作。
MoE 的问题在于:一个 token 会被路由到不同专家,而每个专家看到的输入激活分布不同,对应的最优 也不同。如果给每个专家单独算一个 ,那么 只有在路由确定之后才能知道该用哪个,前置归一化层只能吸收一个向量,于是 的逐 token 缩放就必须在运行时做——平滑的”零开销”优点直接消失。
另一个方向是把所有专家拼成一个大权重矩阵,用全局统计量算一个 。这在实现上兼容稠密模型的代码路径,但全局最大值会被最难的专家主导,对不需要那么多平滑的专家来说过平滑了:权重动态范围被放大、量化更粗糙。这正是 DuQuant 这类基线在 MoE 上表现受限的原因之一。
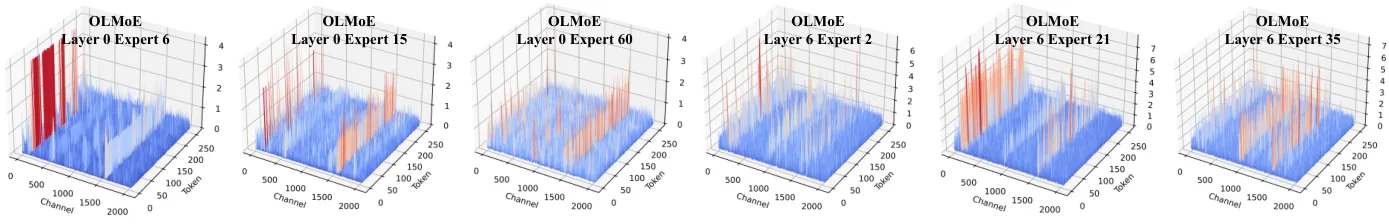
上图是论文图 1:在 OLMoE 的不同层里,各专家的激活最大值都集中在同一批通道上。换句话说,离群通道的位置在专家之间是”同构”的——第 7 个通道在专家 3 和专家 17 里都是大值。这个观察是 EA-SA 设计的直接依据:既然离群结构共享,就可以用一个统一的聚合向量覆盖所有专家的需求,而不必给每个专家单独保留一个尺度。
痛点二:路由 logit 对量化极其敏感
MoE 的路由层是一个很小的线性层 :输入是同一层的激活,输出 个专家分数,再过 softmax,取 top- 作为激活的专家集合,并用 softmax 概率作为各专家输出的加权系数。
这个小层却承受着”结构性后果”:logit 的一点偏差,只要发生在 top- 边界附近,就会改变哪个专家入选;入选集合一变,输出就来自完全不同的参数子空间。而且 top- 选择是一个硬阈值操作,不连续、不可微,误差不会被平滑掉。论文观察到的现象是:低比特下不同专家收到的 token 数分布明显更散,有些专家 token 过少、有些过载。这既是精度问题,也是负载均衡问题——MoE 的服务效率依赖专家之间负载大致均衡,路由一旦坍缩到少数专家,MoE”稀疏高效”的前提就没了。
现有 MoE 量化方法大多把路由层当作普通线性层,和其他权重一起量化、一起校准,完全没有针对它的双目标设计。
痛点三:校准数据严重不均
PTQ 依赖少量校准数据估计量化参数(激活的 scale、zero-point 等)。MoE 的专家激活服从幂律分布:少数核心专家处理大部分 token,边缘专家很少被路由到。用一批固定长度的校准序列跑前向,低频专家可能只收到几十个 token,其激活 的最大值估计极不稳定,容易恰好被一两个噪声样本抬起来,导致该专家的激活 scale 被严重高估——量化区间变宽、有效精度下降。
MoEQuant 采用”专家均衡自采样”来缓解,但它的做法是生成新的校准数据。生成数据引入的分布偏差会让与基线方法的比较失去公平性,而且生成本身有成本。EAQuant 的做法更克制:只用真实训练数据,通过”过采样”把低频专家的校准 token 数补到与计算预期相当。
三处痛点分别对应三项改造,下图是论文图 3 的总体框架:三块改造分别作用在平滑尺度、路由权重与校准数据三个平面上,最终只有一个合并后的平滑向量写回网络。
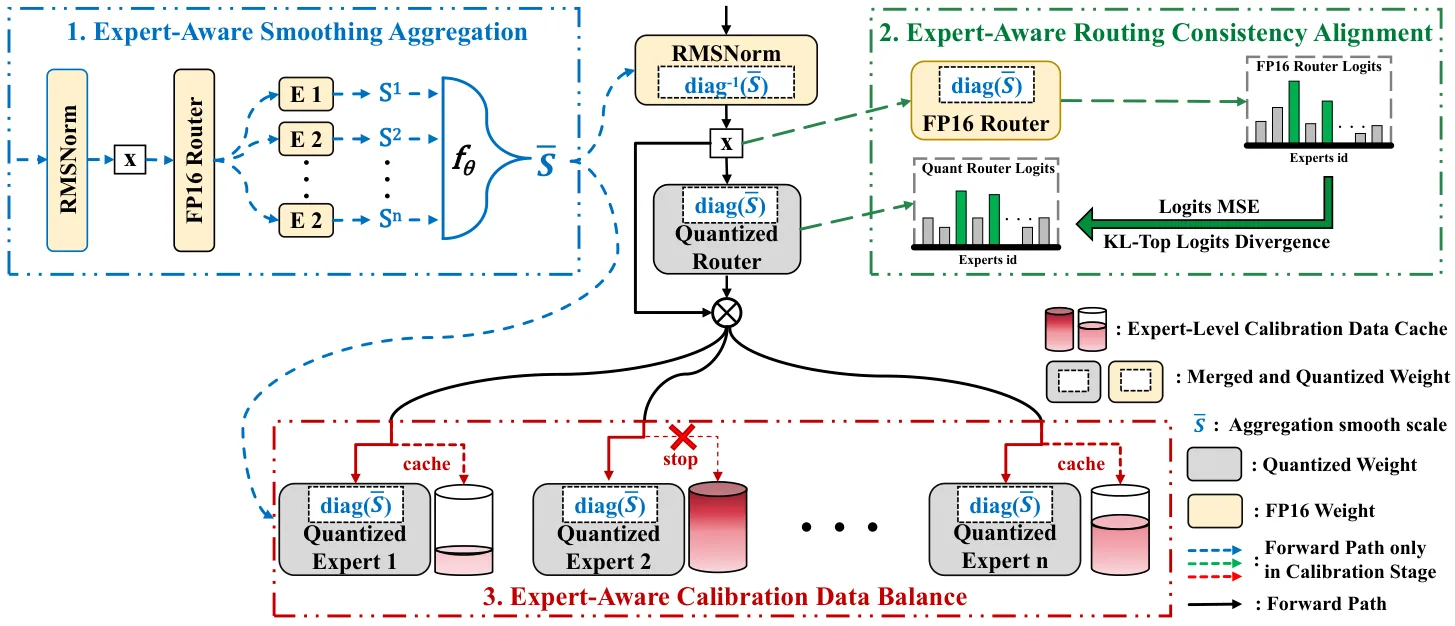
图中上半部分展示前向路径只走”已合并并量化的权重”;下半部分是三个改造在离线校准阶段各自的操作平面。接下来逐项拆解。
专家感知平滑聚合(EA-SA)
问题的数学形式
设一个 token 的层输入为 ,MoE 层有 个本地专家,路由给出的 top- 集合为 ,门控概率为 。层的输出是入选专家输出的加权和:
是第 个专家的前馈网络,内部第一个矩阵是 。每个专家实际收到的输入 是 的一个子集——在多数实现里是完整的 维向量,只是来自不同的 token 组合;不论形式如何,它与专家 的权重配对。
如果照搬稠密模型的逐专家平滑,每个专家都有自己的尺度
那么对每个被选中的专家,都要在路由之后计算 。每 token 有 个专家、每个做 次乘法,总代价 。在解码阶段每个层每步都这么干,累加起来并不便宜;更重要的是,它把平滑操作从”编译期吸收”变成了”运行时算子”,这正是 EA-SA 要消灭的东西。
统一尺度:聚合算子
EA-SA 的核心是一个不等式构造。定义统一平滑向量 ,要求它对每个通道、每个专家都”不小于”该专家的需求:
这里用 而不是 ,是因为实际实现里还要叠加离群值处理的细节(见后文), 可能略大于逐专家的需求。只要 ,就有
( 表示逐元素不等式),即统一平滑对激活的压缩力度不小于任何单个专家的需求,因此用它量化激活时不会因为”压得不够”而让离群通道溢出量化区间。反过来,为什么不做逐专家精确的 ?因为一个向量要写回前置归一化层,只能吸收一个——这就是不等式方向的来源:宁可多压一点,也不能少压。
用一般化的逐通道聚合算子 表达:
论文里 取最大值 ,但框架允许其他聚合。后面第四节的消融会看到, 之外的几种”加权聚合”,例如按专家激活频率、按权重分布、按路由概率加权再求和,也各有长处,但整体上 最稳。
把路由层也纳入聚合
容易漏掉的一点:路由权重 作用在原始输入 上,而不是某个专家收到的 。它也有自己的平滑需求:
如果把路由层排除在聚合之外,那么路由路径用的激活就没有被压平,路由 logit 的量化精度会单独变差——而下一节会看到,路由恰是最敏感的部分。所以 EA-SA 把两路需求放在一起取最大值:
于是 得到保证。
等价性成立的条件
有了统一尺度,路由与专家两条计算路径都可以做等价变换:
关键在第二式:这里 用的尺度是统一的 ,而不是该专家自己的 。数学上这当然成立(先乘后除同一对角矩阵,结果不变),但实际上损失了逐专家最优性:专家 的激活被按 的比例额外压缩了。所以 EA-SA 并不是”免费的逐专家最优解”,而是一个工程取舍:
- 收益:平滑尺度可以并入前置归一化层,运行时零开销,且所有专家共用一条量化路径,与稠密模型的实现完全兼容;
- 代价:对需求较小的专家,权重一侧被放大了 倍,其权重的动态范围会略微变大。论文判断这个代价远小于”运行时多一个 算子”和”全局统计量过平滑”这两个替代方案的代价,消融实验(后文实验一节)支持这个判断。
并入 RMSNorm 的参数融合
统一尺度写回前置的 RMSNorm 层,具体做法是把 逐元素除进缩放参数 :
其中 为逐元素除法, 为逐元素乘法。这个等式说明:平滑后的归一化输出恰好等于”原始归一化输出 乘以 “。由于 是静态参数,离线阶段改完之后,推理图与普通 RMSNorm 完全相同——这也是 EA-SA 说”无额计算开销”的确切含义。LayerNorm 同理,把 与 (偏置)都除以 即可。
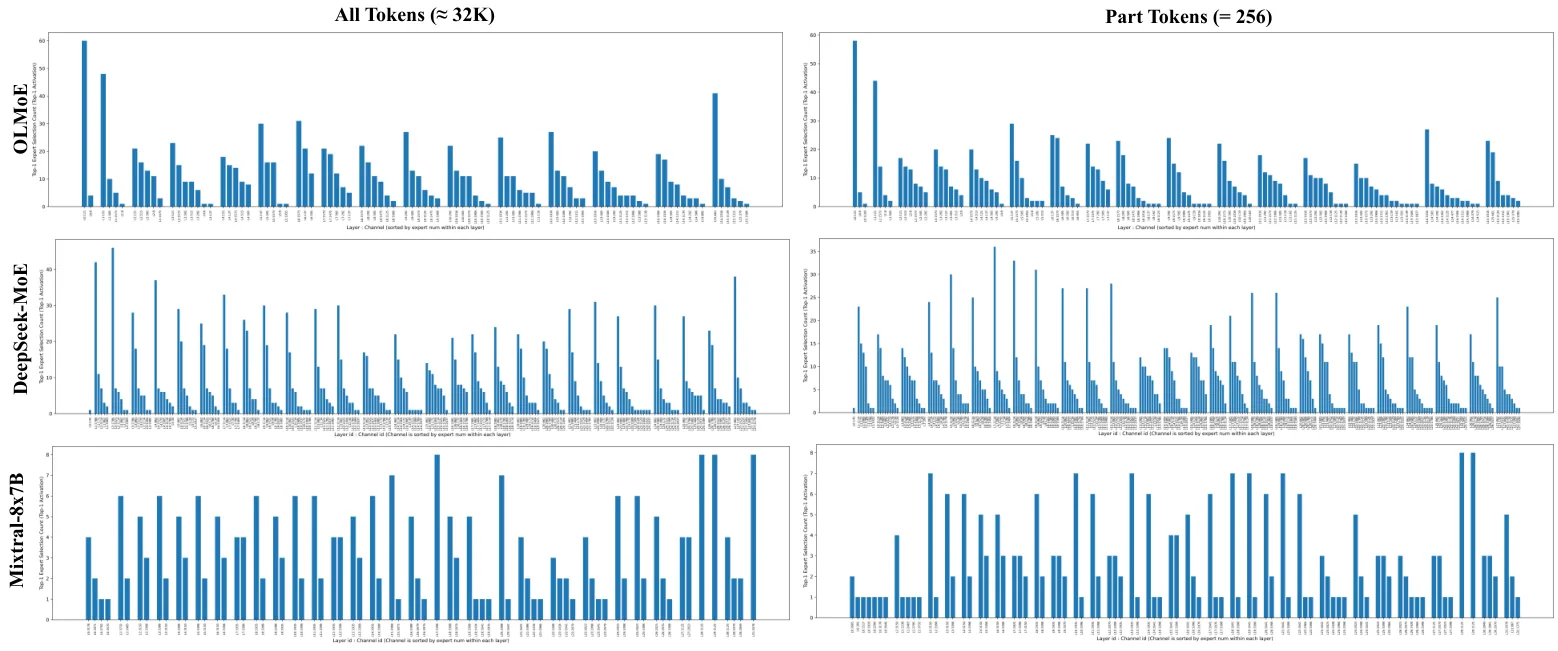
上图是论文附录 C.2 的补充可视化:对比用全部 token(约 32K)与抽样部分 token(约 256)统计出的通道特征,两者高度相似。它支撑 EA-SA 的隐含假设——统一平滑向量基于采样得到的批量统计量,只要采样足够代表全体 token,聚合出的尺度就能覆盖所有专家的实际分布。换言之,EA-SA 的安全性依赖于”离群通道位置跨专家一致、且采样统计稳定”这两点,而论文图 1 与这张补充图分别验证了它们。
源码里多出来的两步:离群掩码与 Otsu
论文正文的公式是简化版。官方仓库 quantize/smooth.py 的实际流程比公式多了两个步骤,而这两步对理解” 为什么不是 “很关键。
第一步是离群通道掩码。按公式直接算 会被少数极端值主导。仓库里的 calcu_outlier_mask 用四分位距(IQR)先找出离群通道:对逐通道最大值取 35% 与 65% 分位(默认 ratio=0.65,即 1-ratio 到 ratio 的分位),得到 ,超出 的通道判为离群;对最小值同理用 。落在离群区间的值还会用 Otsu 阈值再过一遍,把”大值”与”真正离群”分开。
# quantize/smooth.py(节选,变量名保持不变)q1_pos = torch.quantile(per_channel_max, 1 - ratio) # ratio = 0.65q3_pos = torch.quantile(per_channel_max, ratio)IQR_pos = q3_pos - q1_posoutlier_pos = q3_pos + alpha * IQR_pos # alpha = 1.5_, _, outlier_pos = otsu(per_channel_max[per_channel_max > outlier_pos])
outlier_mask_pos[per_channel_max > outlier_pos] = 0 # 0 表示离群max_value = torch.max(per_channel_max[outlier_mask_pos == 1])outlier_mask_pos[outlier_mask_pos == 0] = ( per_channel_max[outlier_mask_pos == 0] / max_value) ** smooth_rate # 0.7第二步是平滑尺度只对普通通道生效。对一个被掩码判为离群的通道,它的平滑系数被设为 形式,而不是按通用公式算出的值。直觉上:普通通道之间按比例做平滑最安全,而离群通道需要的压平力度更大、且各个专家的离群幅度不同,逐专家分别处理更能保住精度。于是最终写回的 是在”普通通道的聚合值”与”离群通道的逐专家处理值”之间拼起来的,这解释了为什么正文用 来表述不等式——它并不是严格的逐通道 。
smooth_lm 的其余逻辑与公式一致:对每个专家的 与路由 分别算尺度,经 merge_scale 聚合,再把合并尺度写回归一化层、同时缩放对应权重。默认超参是 (比 SmoothQuant 常用的 0.5 更偏向压激活)、otsu_ratio=0.65、otsu_smooth_rate=0.7,聚合方式 --fc1_scale_merge=max。
聚合算子的可选项与它们的含义
merge_scale 支持的不只是”逐通道取最大”。按仓库实现,几种可选的聚合方式可以理解为对该通道”主导专家”的不同估计:
| 聚合方式 | 算式 | 含义 |
|---|---|---|
max | 与 取大 | 以最难量化的专家为准,保守 |
sum1 | , 为专家 在总 token 中的占比 | 按激活频率加权,重视常用专家 |
sum2 | , 为专家权重范数经 softmax 或归一化后的值 | 按权重分布加权,重视”重”专家 |
sum3 | , 为路由概率归一化 | 按路由分布加权,重视当前路由倾向 |
all | 以上四者再取最大 | 四种口径的并集,最保守 |
每种加权聚合都与 取最大值,确保路由路径一定被覆盖。消融实验(后文实验一节)的结果是:在 OLMoE 上 max 平均 +1.20,expert_frequency +0.83,router_logits +0.71;在 Mixtral 上 expert_frequency 反而最高(+0.92)。这说明”最保守”不是在所有模型上都最优,但 max 的方差最小、实现最简单,因此作为默认值。这是一个可以按模型调参的口子,而非理论必然。
专家感知路由一致性对齐(EA-RCA)
路由为什么是 MoE 里最脆弱的量化对象
把路由层单独拿出来看:它是一个 的线性层,输出 个 logit,softmax 之后取 top-。它的参数量相对整层可以忽略不计(在 OLMoE 里约占 0.1% 量级),但它的输出决定后续计算走向哪条分支。量化误差在普通线性层里表现为数值偏差,会与后续的非线性、残差混合后部分抵消;在路由层里,偏差直接作用在一个离散选择上。
形式化地,设全精度路由概率为
量化后的路由权重为 ,得到
其中 是均匀仿射量化:
是 scale, 是 zero-point, 是量化范围端点。按通道量化时, 与 对每个输出通道(即每个专家)各有一组。
问题出在 与 可能不同。只要两个 logit 在边界处足够接近,一个量化台阶就能把它们换位。换位不仅让某个 token 走错专家,还会改变 softmax 的归一化分母:被选中的专家权重之和恒为 1(很多实现会对 top- 概率重新归一化),所以一个专家入选与否会重新分配全部 个权重。误差呈现两级放大:选错分支 + 权重错配。
论文的实证(前文图 2b)显示,比特数下降时专家负载分布显著变散。这有两重后果:精度下降,以及推理系统的负载均衡被破坏。MoE 服务通常按专家并行切分,某个专家突然堆满 token 会直接拖慢整个 batch 的完成时间。
双目标校准
EA-RCA 的思路是:既然量化的路由权重只需要一组 scale/zero-point,那就在校准阶段直接选一组”让路由行为尽量不变”的参数。目标函数有两项:
是待校准的量化参数(每通道的 与 )。
为什么需要两项而不是一项?
- 只用 MSE:MSE 在 logit 空间中是”所有专家一视同仁”的。它会让数值大的 logit 主导误差,而 top- 的边界往往发生在数值接近的 logit 之间。换句话说,MSE 优化的是”数值像不像”,不是”选择对不对”。此外 MSE 对 softmax 之后的概率分布没有约束,logit 上 0.1 的偏差在经过 softmax 后可能被放大成可观的概率偏移。
- 只用 KL:KL 直接对齐概率分布,但不约束 logit 的绝对尺度。KL 对整体 logit 的平移不敏感(softmax 有平移不变性),而量化误差不仅是平移,还包括缩放与舍入。缺了 MSE,校准可能找到”概率分布对、但 logit 数值全偏”的解,对下游的负载均衡反而不利。
两项合在一起:MSE 管数值保真,KL 管选择边界。论文的说法是”combined objective enforces both numerical fidelity and distributional alignment”。
KL-Top:只对齐”会改变选择”的那部分
朴素的 KL 是对全部 个专家求散度。EAQuant 采用了 KL-Top:对每个 token,只取参考 logit 中排名前 的专家子集,在这个子集上重新 softmax 后算 KL,其中
是 top- 的 , 控制”往下多看几个专家”。 时只看 top-; 时退化为全专家 KL。
这个设计的动机很直接:路由决策只由 top- 及其紧邻的竞争者决定。排名第 40 的专家即使概率估计有 30% 的相对误差,也不会影响这个 token 的选择——它的概率本来就接近 0,对 KL 的贡献也接近 0,却会给梯度/搜索目标引入噪声。更重要的是,对低置信专家施加分布约束,可能反过来把量化参数往”照顾这些小概率”的方向拉,牺牲了边界处的精度。附录的消融支持这一点: 时平均准确率 67.97(比基线 +1.28), 时为 67.59(+0.90), 时降到 67.19(+0.50)。看得越宽,收益越小,这与”只对齐决策边界”的假设一致。
附录给出的完整数为: 时 67.47(+0.78)。也就是说 从 0 增加到 0.25 就丢掉一半收益。这一现象值得记住——它说明量化校准目标不是”拟合得越全面越好”,而是”把容量花在真正影响输出的自由度上”。
实现:没有梯度,只有逐通道的比例搜索
论文把它写成优化问题,但实现上并不做反向传播。官方仓库里,路由权重的量化参数由一个逐通道的截断比例搜索得到:
# quantize/quantizer.py(节选,变量名保持不变)loop_times, bottom_bound = 100, 0.35for i in range(loop_times + 1): temp_ratio = bottom_bound + i * (1 - bottom_bound) / loop_times xmax = temp_ratio * xmax_ori xmin = temp_ratio * xmin_ori # 由 xmax/xmin 推出 scale 与 zero-point,做 fake quant x_q = fake_quant(x, scale, round_zero_point) # 只对路由层:在 top-k 子集上算 KL scores += cali_kld_top_batch(F.linear(act, x, None), F.linear(act, x_q, None), top_k=top_k)几个实现细节值得点出:
- 搜索的是截断比例,而不是任意 scale。对每通道,把观测到的 乘以一个统一的 ,再据此算 scale/zero-point。100 步搜索等价于在这条一维路径上取 101 个候选。这比直接优化两个连续变量简单得多,也避开了不可微的
round。 - 截断下界是 0.35 而不是 0。如果允许截断到 0,某些通道会被压成常数,路由 logit 直接失去分辨力。0.35 是经验下界,保证至少保留约三分之一的动态范围。
- 默认只用 KL,不用 MSE。
--router_w_dynamic_method默认值为per_channel_kl_top0,走的是只累加 KL 的分支;仓库同时提供per_channel_linear_kl_top0,会额外累加线性输出的 MSE。论文描述的是两者之和,而发布的默认配置是”纯 KL-Top”。两者并不矛盾——KL 本身建立在量化前后的 logit 上,已经隐含了对 logit 的约束;但读者如果复现实验,需要注意这个默认值差异。 - top- 的定义随模型写死。仓库里按专家总数分支:64 专家时取 8,8 专家时取 2;再按
ratio扩展为 ,对应上面的 。这说明该实现只覆盖了 OLMoE/DeepSeek-MoE(64 专家)与 Mixtral(8 专家)这两类配置。
还有一点容易被忽略:EA-RCA 只校准路由权重的量化参数,不改变专家权重的量化方式。专家的 W4 量化仍然沿用基线(DuQuant 的旋转与裁剪)。所以 EA-RCA 的收益与专家量化方法是正交的,这也解释了为什么它能叠加在 DuQuant 上继续涨点。
为什么路由保持 W8A8 仍然能涨点
主实验里路由层用 W8A8,而 EA-RCA 依然带来约 1.2 的平均准确率提升(后文表 4 的 w4a4_Rw8a8 一栏)。直觉上 8-bit 已经很精确,为什么还有空间?
原因是 8-bit 的误差虽小,却集中在最需要精确的地方:路由 logit 的分布范围很宽(不同专家的 logit 可能相差几十),per-channel 的对称/非对称量化在 8-bit 下仍有约 1/256 的相对步长;而 top- 的边界处 logit 差距可能小于一个步长。更关键的是,量化参数的默认选择(如 min-max)往往被极端 logit 拉宽,使有效步长变大。EA-RCA 通过逐通道截断搜索 + KL 目标,把量化区间收窄到”决策相关”的范围,等效于提高了边界处的分辨率。它不是在增加比特,而是在重新分配比特。
当路由层被压到 W3A4 时(后文表 4 的 w3a4_Rw3a4),EA-RCA 的收益更大(+1.30),因为此时误差已经足以直接改变专家选择。这说明 EA-RCA 的价值随路由量化激进程度上升,是”越难越有用”的类型。
专家感知校准数据均衡(EA-CDB)
为什么低频专家会被”校准坏”
PTQ 的激活量化参数(每 token 的动态 scale,或静态的逐通道 scale)依赖于在校准集上观测到的激活范围。对专家 来说,它能”看见”的样本数就是校准阶段被路由到它的 token 数 。MoE 的专家激活呈幂律分布:少数核心专家收到大量 token,边缘专家只收到很少。
小意味着统计量不稳定。具体地,如果该专家的激活近似高斯,那么用 估计量化的动态范围时,估计值的方差随样本数增加而下降;样本只有几十个时,一次偶然的较大激活就可能把 抬高一个台阶。量化 scale 一旦被高估,正常激活的步长就变粗,有效精度下降——这与稠密模型中”离群值毁掉量化”是同一个机制,只不过这里是”采样噪声变成假离群值”,而且只在低频专家上出现。
这种误差还有个不对称性:核心专家样本多、估计准;边缘专家样本少、估计糟。若只看平均精度,边缘专家的退化可能被稀释;但边缘专家恰恰承担了长尾 token 的区分能力,丢掉它们会让模型在特定输入上突然崩。
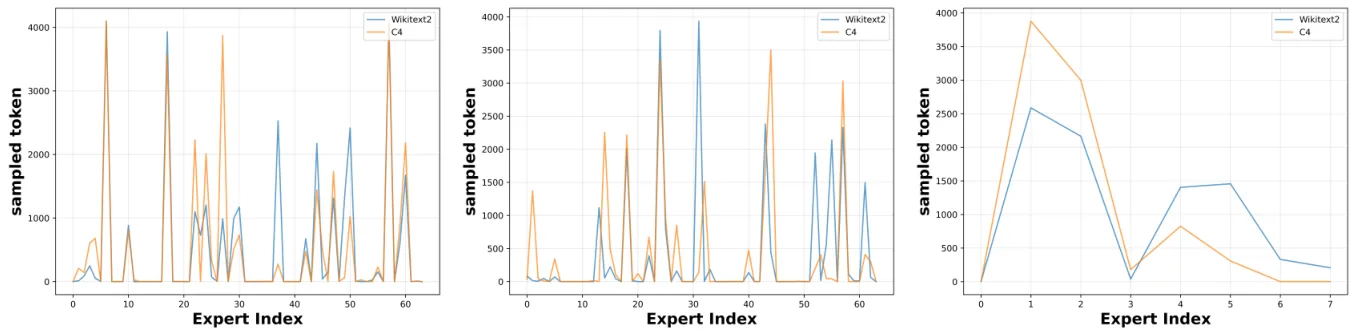
上图对应论文附录 C.4,画的是三种 MoE 模型同一专家层内各专家接收的校准 token 数。可以看到分布有很长的尾巴:排在前面的专家有几千 token,末尾的专家只有几百甚至几十 token。尾部的这部分专家,正是 EA-CDB 要单独照顾的对象。
期望激活量与放大系数
EA-CDB 需要一个”每个专家应该收到多少 token”的基准。在均匀路由的假设下,总 token 数为 (校准集按 128 条、每条 4096 token 计,即 ),每个 token 选 个专家,共 个专家,则每个专家平均收到
EAQuant 用一个放大系数 把目标阈值提高到 ,默认 。对 的专家,从未均衡的训练数据池中继续采样新批次,直到其路由 token 数超过 ,把这些额外样本记为 。最终的校准集:
注意一个关键细节: 用于校准非专家组件(QKV 层、路由层),而专家权重的量化参数则用合并后的 校准。也就是说过采样只发生在”专家内部”的校准阶段,不会影响路由层的校准分布——如果路由层也用均衡后的数据校准,它看到的专家使用模式就被改变了,这与 EA-RCA 的”保持路由真实分布”目标相悖。
为什么默认 而不是越大越好
越大,低频专家能看到的样本越多,估计越稳定;但代价有三:
- 过采样数据与前向分布不一致。被补进来的 token 是从训练数据里”凑”到该专家上的,它们并不是该专家在自然路由下应处理的 token。 太大时,这些人工凑来的样本会改变该专家激活的统计特征,量化参数反而偏离真实推理分布。
- 均匀假设不成立。 假设路由在专家间均匀。真实的 MoE 训练有负载均衡损失,但均衡程度有限;过采样目标一旦超过自然分布太多,就会把”本来该被边缘化的专家”强行拉到核心位置,等于在量化阶段否定了模型的真实偏好。
- 校准成本线性增长。每多一分过采样,就多一分前向。
消融结果正好画出这条曲线的形状(后文表 5):(即不做均衡)平均 66.69; 时 67.10; 时 67.78 最好; 时降到 67.47; 时 67.32。峰值在 ,两侧都下降。这与上面的分析一致:均衡太少则统计不稳定,均衡太多则引入分布偏移与成本。
误差下降的分布:为什么看”有多少专家变好”
只看平均指标无法判断 EA-CDB 是否真的在”全面”改善专家。论文用 OLMoE 第 15 层 down-projection 权重的逐专家量化误差(QE)做了统计:启用 EA-CDB 后,平均 QE 从 0.0144 降到 0.0116(下降 19.4%),中位数下降 15.5%,最大值下降 5.2%,最小值下降 53.6%,标准差下降 8.6%;64 个专家中有 56 个的误差下降(87.5%)。
这组数字说明了 EA-CDB 的价值形状:
- 最小值下降最多(53.6%)——改善最大的正是原本最差的专家,符合”照顾长尾”的直觉;
- 56/64 改善,而不是只有少数专家——说明过采样并没有以牺牲核心专家为代价,核心专家本来就在 里有充足样本;
- 平均值与中位数同步下降——改善不是被个别极端值拉动的统计假象。
附录还给出了完整的逐专家 QE 表( 为”启用后减去启用前”,负值表示改善),用来核对”哪些专家没被改善”。这类逐专家误差表的工程意义在于:如果部署时只关心少数关键专家,可以用它判断 EA-CDB 是否会误伤。
与 MoEQuant 的差别
MoEQuant 同样解决校准不均,但走的是”生成式自采样”:按专家的需求合成新校准数据,使每个专家都能分到均衡样本。那篇文章在站内已有拆解(可参考 MoEQuant 完全拆解:MoE 模型 PTQ 为何掉点——专家均衡自采样与亲和度引导量化),两者的差别值得对照:
| 维度 | MoEQuant | EAQuant 的 EA-CDB |
|---|---|---|
| 数据来源 | 按需生成的配比校准数据 | 只用真实训练数据过采样 |
| 目标 | 专家间与专家内两重均衡 | 只做专家间激活数量均衡 |
| 公平性 | 生成数据可能让与其他基线的对比失真 | 不生成数据,与基线的数据口径一致 |
| 成本 | 生成 + 校准 | 仅额外前向 |
EAQuant 论文在动机部分明确把”MoEQuant 的生成式校准可能影响与基线比较的公平性”列为采用过采样路线的原因之一。这是一个方法论层面的取舍:用更克制的手段换来更干净的可比性。
三块改造如何叠加
三块改造落在不同的校准平面:
- EA-SA 改的是归一化层参数与权重(把 吸收进 ,把 、 乘进权重),发生在任何量化搜索之前;
- EA-RCA 改的是路由权重的量化参数(每通道 scale/zero-point),发生在专家权重校准之后;
- EA-CDB 改的是专家校准所用的数据集合,作用于专家权重的量化参数估计。
它们的交互在实现里有一个值得注意的顺序。核心例程 eaquant() 对每个解码层分三步:
- stage 1:用校准输入特征的均值跑一次前向,校准 QKV 与路由等非专家层(此时专家保持 FP 前向);若
expert_token_num > 0,再遍历全部校准样本,通过挂在各专家线性层上的 hook 收集每个专家的输入缓存,直到某个专家的缓存数达到阈值; - stage 2:把收集到的专家输入(每个专家最多
expert_token_num个 token)喂给对应专家,完成其权重与激活的量化参数校准; - stage 3:对 stage 2 中没被校准到的专家(缓存为空,通常是极端低频专家),用整层的 gate 输入再校准一次(
recalibration the left experts with the whole tokens)。
阈值由 main.py 按论文公式算出:
args.expert_ratio = 8 / 64.0 # k / n,针对 OLMoEargs.expert_token_num = int( args.expert_ratio * args.seq_length * args.expert_token_num_ratio) # 1024以 OLMoE 的 k/n = 8/64、序列长度 4096、 代入,阈值是 1024 个 token/专家。也就是说,实现里的”过采样”不是为每个专家单独合成数据,而是在一次校准遍历中把落到该专家上的 token 都缓存下来,凑够阈值再校准;凑不够的走 stage 3 的兜底。这与论文描述的”迭代采样直到超过 “在效果上等价,但工程上更省——不需要为每个专家重新设计采样分布。
换句话说,论文描述的 过采样,在发布实现里落成了”按阈值缓存专家输入 + 用整层输入兜底”两段逻辑:前者负责把高频与中频专家撑到 ,后者保证极端低频专家也拿到非空的校准样本。
这也解释了消融中为什么三块是”互补”而非”冗余”:EA-SA 降低激活量化的难度,EA-RCA 守住选择边界,EA-CDB 让参数估计对所有专家都可靠。三者作用于不同的误差来源,单块提升有限,合起来才达到最佳。
实验
设置
模型选择三个代表不同规模与专家配置的 MoE:
| 模型 | 参数量 | 专家数 / top- | 机构 |
|---|---|---|---|
| OLMoE-1B-7B-0924 | 7B | 64 / 8 | AllenAI |
| DeepSeek-MoE-16B-base | 16B | 64 / 6 | 深度求索 |
| Mixtral-8x7B-v0.1 | 46.7B | 8 / 2 | Mistral AI |
评估分两类:WikiText2 与 C4 上的困惑度(PPL,越低越好),以及零样本常识推理准确率——ARC-Challenge、ARC-Easy、BoolQ、PIQA、WinoGrande 五项取平均。校准集取 WikiText2 的 128 条片段;量化采用非对称、逐通道权重与逐 token 激活,不使用分组量化(group_size=None)。基线是 DuQuant(旋转 + 裁剪的 PTQ 方法,在 MoE 量化上已属最强基线之一),复现时把其官方仓库适配到三种 MoE 上。
论文正文给出的校准规模是”128 条、每条 4096 token”,而实验设置段落写”评估序列长 2048”,实现里 --seq_length 默认 4096、评估用 2048。两处并不冲突,但也没有逐处说明,因此比较数字时以同一张表内的相对差异为准,不宜跨表拼绝对值的趋势。
主结果:W4A4 到 W2A4
下表摘自论文表 1,每对都是 DuQuant 与 EAQuant 在同一比特配置下的对比。
| 模型 | 比特 (W-A) | 方法 | WikiText2 PPL | C4 PPL | 平均准确率 |
|---|---|---|---|---|---|
| OLMoE-7B | FP16 | 全精度 | 7.49 | 10.52 | 70.28 |
| 4-4 | DuQuant | 8.64 | 11.51 | 66.69 | |
| 4-4 | EAQuant | 8.52 | 11.41 | 68.06 (+1.37) | |
| 3-4 | DuQuant | 10.77 | 13.59 | 63.30 | |
| 3-4 | EAQuant | 10.41 | 13.20 | 65.58 (+2.28) | |
| 3-3 | DuQuant | 16.88 | 19.23 | 55.39 | |
| 3-3 | EAQuant | 14.14 | 16.68 | 58.36 (+2.97) | |
| 2-4 | DuQuant | 8279.52 | 5508.23 | 41.22 | |
| 2-4 | EAQuant | 78.57 | 62.56 | 50.88 (+9.66) | |
| DeepSeek-MoE-16B | 4-4 | DuQuant | 7.10 | 9.85 | 65.87 |
| 4-4 | EAQuant | 7.06 | 9.78 | 67.02 (+1.15) | |
| 3-3 | DuQuant | 14.02 | 18.63 | 55.20 | |
| 3-3 | EAQuant | 11.62 | 15.31 | 57.34 (+2.14) | |
| 2-4 | DuQuant | 10006.75 | 4114.85 | 39.40 | |
| 2-4 | EAQuant | 138.27 | 82.51 | 49.25 (+9.85) | |
| Mixtral-8x7B | 4-4 | DuQuant | 4.47 | 7.47 | 73.06 |
| 4-4 | EAQuant | 4.44 | 7.42 | 74.21 (+1.15) | |
| 3-3 | DuQuant | 11.18 | 16.47 | 53.05 | |
| 3-3 | EAQuant | 7.46 | 10.98 | 62.46 (+9.41) | |
| 2-4 | DuQuant | 7626.38 | 6822.75 | 39.59 | |
| 2-4 | EAQuant | 21.94 | 25.24 | 53.40 (+13.81) |
读这张表要注意三件事。
第一,收益随比特下降而放大。W4A4 时提升 1.15–1.37,属于锦上添花;W2A4 时提升 9.66–13.81,属于从崩溃边缘拉回来。原因不难理解:三块改造分别针对激活离群、路由脆弱、校准不均,这些误差在 8-bit 下都可忽略,在 2-bit 下则成为主导误差源。EAQuant 的优势区间正是激进量化。
第二,W2A4 下”不崩”本身比”涨点”更重要。DuQuant 在三个模型的 W2A4 上都出现 PPL 数千的数值坍缩;EAQuant 虽然仍从全精度的 3.84/6.51/7.49 退化到 21.94/138.27/78.57,但输出至少是可读的。论文把这点描述为”maintains stable perplexity”,其”stable”是相对基线而言,不是接近全精度。
第三,推理类任务的收益更明显。论文特别指出 Mixtral-8x7B 在 W4A4 下 ARC-Easy 提升 2.52 个百分点(79.21 → 81.73)。ARC 属于需要多步选择的问题,对路由的稳定性更敏感,这与 EA-RCA 的机理预测一致。反过来,PIQA 在部分配置下提升很小甚至持平(如 DeepSeek-MoE 的 W3A4 下 76.22 → 75.35),说明收益集中在”选择敏感”的任务上,而非平均分布在所有评测。
与既有 MoE 量化方法的横向对比
论文表 7 把专家权重压到 3-bit、路由与激活保持 FP16 的场景与其他 MoE PTQ 方法对比:
| 模型 | 方法 | W-A | WikiText2 | C4 |
|---|---|---|---|---|
| OLMoE-7B | GPTQ | 3-16 | 11.65 | 18.86 |
| MoEPTQ | 3.26-16 | 15.44 | 26.04 | |
| MoQa | 2.95-16 | 10.59 | 18.42 | |
| EAQuant | 3-16 | 9.60 | 12.38 | |
| DeepSeek-MoE-16B | MoEQuant-AWQ | 3-16 | 5100 | 4924 |
| MoEQuant-GPTQ | 3-16 | 7.55 | 10.88 | |
| EAQuant | 3-16 | 7.27 | 10.04 | |
| Mixtral-8x7B | MoEQuant-AWQ | 3-16 | 8.77 | 11.44 |
| MoEQuant-GPTQ | 3-16 | 4.90 | 8.24 | |
| EAQuant | 3-16 | 4.49 | 7.47 |
有两点值得留意。其一,EAQuant 的 W3 权重优于 MoEQuant,其 AWQ 路线在 DeepSeek-MoE 的 3-16 下直接发散到 PPL 5100。其二,MoQa 用约 2.95 bit 就达到 10.59,而 EAQuant 的 3 bit 是 9.60——位宽上吃亏、数值上仍领先,但差距远小于它与 4-bit 基线之间的差距。在更低比特的对手面前,优势是”仍占优”而非”大幅占优”。
论文附录还报告了 Mixtral-8x22B 的 W4A4:WikiText2 困惑度从 DuQuant 的 3.40 降到 3.31,C4 从 6.72 降到 6.65;W3A3 配置下也有同方向的更低困惑度。这说明方法能扩展到更大的 MoE 与更多的专家。
消融:三块各自的贡献
W3A4 配置下的逐模块消融(论文表 2,路由层 W8A8):
| EA-SA | EA-RCA | EA-CDB | OLMoE 平均 | OLMoE 增量 | DeepSeek-MoE 平均 | DeepSeek 增量 |
|---|---|---|---|---|---|---|
| 63.30 | — | 62.75 | — | |||
| ✓ | 65.42 | +2.12 | 63.67 | +0.92 | ||
| ✓ | 64.20 | +1.90 | 63.15 | +0.40 | ||
| ✓ | 63.65 | +0.35 | 62.86 | +0.11 | ||
| ✓ | ✓ | 65.49 | +2.19 | 63.81 | +1.06 | |
| ✓ | ✓ | ✓ | 65.58 | +2.28 | 64.08 | +1.33 |
首行即 DuQuant 基线。几个读法:
- EA-SA 单项贡献最大(OLMoE +2.12),因为它直接降低激活量化的难度,是其他两块的基础——离群值没被压住时,路由与专家都更易被误量化;
- EA-RCA 单独使用也接近 EA-SA 的一半(+1.90),而路由层参数量只占整层的极小一部分,这个投入产出比相当可观;
- EA-CDB 单项最小(+0.35),但它作用于”参数估计质量”,与另两块几乎不重叠;
- 三块齐用时 OLMoE +2.28,比 EA-SA+EA-RCA 的 +2.19 只多 0.09,说明 EA-CDB 的边际收益在另两块已启用时会缩小——合理的解释是 EA-SA 让激活更易量化后,低频专家对样本量的敏感度本身下降了。
路由配置的敏感性
论文表 4 在 OLMoE 上固定主体权重/激活为 W3A4,只改变路由层量化配置:
| 主体配置 / 路由配置 | 基线平均 | + EA-RCA | 增量 |
|---|---|---|---|
| W3A4 / Rw3a4 | 62.33 | 63.63 | +1.30 |
| W3A4 / Rw4a4 | 63.00 | 63.99 | +0.99 |
| W3A4 / Rw8a8 | 63.30 | 64.20 | +0.90 |
| W4A4 / Rw8a8(表 8) | 66.69 | 67.97 | +1.28 |
路由量化越激进,EA-RCA 的相对收益越大(+1.30 对 +0.90),符合”越难越有用”的判断;即使在 W4A4 主体更宽松的设置下,增量也有 +1.28,说明收益并非只在极端配置下才存在。
校准放大系数与聚合方式
放大系数 (论文表 5、附录表 9,OLMoE,W4A4,路由 W8A8):,,,,。逐任务细分里, 时 ARC-Easy 76.01、BoolQ 72.26、WinoGrande 65.90 均为各档最好;而 的 ARC-Challenge(44.97)反而低于 (46.25),说明过采样不足时某些任务的估计仍不稳定。
聚合方式(论文表 3,OLMoE,W4A4):DuQuant 基线 66.69;maximum 67.89(+1.20);expert_frequency 67.52(+0.83);router_logits 67.40(+0.71)。Mixtral 上排序不同,expert_frequency(73.98,+0.92)高于 maximum(73.52,+0.46)。这说明聚合口径的选择应随模型路由分布调整,maximum 只是默认的稳健选择。
局限与适用边界
比特下限
论文自己承认:在 W1A4 等更极端的配置下,EAQuant 因”粒度-稀疏度”的权衡而退化,需要 QAT 才能恢复精度。这是纯 PTQ 方法的结构性限制——当权重只有 1 bit,逐通道 scale 本身已经不够表达信息,靠校准层的改动补不回来。实际的可用区间大致在 W4A4 到 W2A4,W3A3 已属边缘。
零运行时开销,但部署流程变复杂
EAQuant 运行时开销为零是其最吸引人的地方:平滑尺度已并进 RMSNorm,路由与专家权重都合并成了普通量化权重。但代价转移到了离线部署流程:
- 需要能跑多阶段校准的脚本,涉及逐层前向、hook 收集、逐通道的 101 点搜索;
- 搜索按层、按路由通道进行,层数与专家数一多就要跑相当一段时间;
- 校准集、、、聚合方式都是超参;实现里 按模型写死(
expert_ratio = 8/64),换新模型要改代码。
这与”只做一次离线旋转、生成权重量化”的 QuaRot 类方法体验不同:后者换模型成本低,前者一次校准收益更高但流程重。
与旋转类方法的关系
EAQuant 的基线 DuQuant 本身已含旋转与置换,EAQuant 是叠加在它之上的,说明收益是在”已经很强的基线”上再加一层。若部署方已使用 QuaRot 或 SpinQuant,EA-SA 的平滑与旋转兼容(都作用于激活分布,可先后进行),EA-RCA 与 EA-CDB 与旋转无关、可照常叠加。代价是两套方法的离线校准成本相加。
校准公平性
论文以”MoEQuant 的自采样可能影响与基线比较的公平性”为由选择只用真实数据过采样。不过 EA-CDB 用训练数据过采样,同样会让校准集偏离自然推理分布,只是偏离程度由 控制且可解释。比较时应把 视为工程取值,而不是”零偏离”。
小结
EAQuant 没有发明新的量化算子,而是把 MoE 结构中三个被忽略的”专家相关”环节,各对应到一项可离线完成、运行时零开销的改造:
- EA-SA:用统一聚合尺度把逐专家的平滑需求压成一个可并入 RMSNorm 的向量,以”多压一点”的保守性换掉 运行时缩放与全局统计量过平滑两个缺陷。实现上的离群通道掩码(IQR + Otsu)解释了正文为何用 。
- EA-RCA:把路由层的量化参数当作”选择边界保真”问题校准,logit MSE 与 KL-Top 分别管数值与分布;消融显示对齐范围越窄越好( 最佳),实现上用逐通道截断比例的 101 点搜索代替梯度。
- EA-CDB:用真实数据过采样加整层兜底,把低频专家的校准样本补到 ,默认 ;逐专家量化误差显示 87.5% 的专家改善、原本最差的专家改善最多。
三块叠加在 DuQuant 上,把 W4A4 的平均准确率提升 1.15–1.37,在会令基线崩溃的 W2A4 下提升 9.66–13.81。它的边界同样清楚:只在激进比特下才有明显价值,W1 级别需要 QAT,部署复杂度从”加载权重”移到了”离线校准脚本”。
对推理系统而言,它指向一个更一般的原则:稀疏模型的结构单元(路由、专家、激活频率)本身就是量化误差的来源,量化的目标函数必须把这些结构特征纳入进来,而不能只套用稠密模型的平滑与旋转。
参考资料
- EAQuant: Enhancing Post-Training Quantization for MoE Models via Expert-Aware Optimization(arXiv:2506.13329)
- EAQuant 官方代码仓库
- DuQuant: Distributing Outliers via Dual Transformation Makes Stronger Quantized LLMs(NeurIPS 2024)
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models(ICML 2023)
- OLMoE: Open Mixture-of-Experts Language Models
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- Mixtral of Experts
- MoEQuant: Enhancing Quantization for Mixture-of-Experts Large Language Models via Expert-Balanced Sampling and Affinity Guidance
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



