


NeuroVLA 完全拆解:皮层-小脑-脊髓三级架构,为什么 VLA 需要低延迟反射回路
NeuroVLA 是 2026 年 1 月由港科大广州、港科大、深圳先进院和 AI² Robotics 团队发布的类脑 VLA 框架,全称是 Neuromorphic Vision-Language-Action。它想解决的问题很具体:现在的 VLA 模型越来越会理解语言、识别物体、规划动作,但一旦真的放到物理机器人上,仍然容易抖、慢、怕碰撞、缺少节奏记忆,而且每一个小动作都让大模型重新参与,成本很高。
这篇论文的核心不是再堆一个更大的视觉语言模型,而是把机器人控制拆成三个时间尺度:上层“皮层”负责低频语义规划,中层“小脑”负责高频状态调制和轨迹稳定,下层“脊髓”用脉冲神经网络执行动作和快速反射。这个思路和常见端到端 VLA 很不一样。端到端 VLA 往往把“看见图像 + 理解指令 + 输出动作”塞进一个统一网络;NeuroVLA 则认为,物理世界的碰撞、惯性、液体晃动、夹爪接触、关节速度变化,都发生在比视觉语言推理快得多的时间尺度上,不能全部等上层模型来处理。
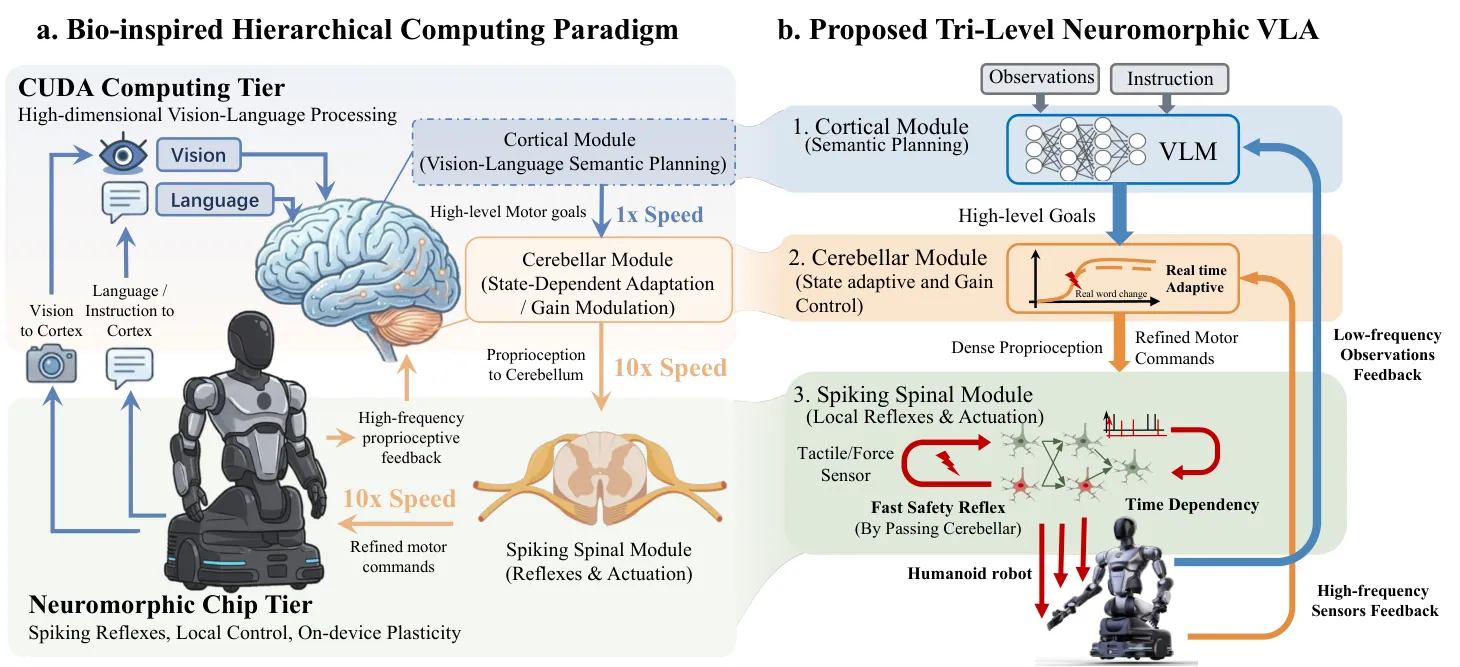
从站内已有内容看,可以把 NeuroVLA 放在 具身智能完全入门 的后续细化位置:前者回答“什么是具身智能、VLA 为什么重要”,NeuroVLA 回答“VLA 真正接上机器人以后,为什么不能只靠一个大模型逐步吐动作”。如果再联系 人形机器人必答题 里讨论的全身控制问题,NeuroVLA 的意义会更清楚:机器人身体越复杂,低层控制越不能只靠慢速语义模型。
传统 VLA 的瓶颈:语义理解强,不等于身体控制稳
VLA 的基本形式是输入视觉观测 、语言指令 ,输出机器人动作 :
这里 是策略模型, 可以是相机图像、腕部相机图像、机器人状态, 是“把杯子放到柜子上”“打开中间抽屉”这类自然语言指令, 则是末端位姿增量、关节增量或夹爪开合等控制量。RT-2 把动作编码成类似文本 token 的形式,让模型像生成语言一样生成动作;OpenVLA 使用开源 VLM backbone 和机器人演示数据; 这类方法把动作解码换成 flow matching,以连续轨迹形式输出更细腻的控制。这些路线都在推动 VLA 从“会理解任务”走向“会执行任务”。
但真实机器人面对的不是离散 token 世界,而是连续物理世界。这里有三个矛盾。
第一个矛盾是时间尺度不匹配。视觉语言模型的推理通常是几十到几百毫秒级,尤其当模型较大、输入多视角图像、还要处理复杂语言时,延迟更高。可是碰撞、滑动、液体倾斜、夹爪接触力变化,可能在几毫秒到十几毫秒内就需要响应。论文里把常规 cortical loop 的延迟写成大于 200 ms,而 NeuroVLA 的反射路径能做到 20 ms 内触发。这个数量级差异决定了“等大模型想明白再退开”往往已经太晚。
第二个矛盾是感知通道不完整。许多 VLA 主要依赖图像,最多再加低频机器人状态。图像擅长告诉模型“杯子在哪里、抽屉在哪里、目标语义是什么”,但不擅长告诉模型“手腕刚刚受到一股横向冲击”“液体重心正在改变”“末端执行器出现微小震荡”。这些信息更自然地来自本体感知和力/力矩传感器,比如关节角、关节速度、6D wrench。NeuroVLA 论文强调这些高频信号可以超过 200 Hz,比视觉帧率高得多。
第三个矛盾是动作连续性。语言模型天然擅长序列预测,但机器人控制需要非常平滑的连续轨迹。如果相邻时间步动作抖动很大,机械臂会出现 jerk,也就是加速度变化率过高。jerk 不只是“不好看”,还会带来能耗、机械磨损、抓取不稳、液体泼洒和碰撞风险。论文把没有小脑模块的基线称为类似“intention tremor”的高频抖动,而加入小脑模块后平均 jerk 降低超过 75%。
所以 NeuroVLA 的判断是:VLA 的问题不能只靠“更大模型 + 更多机器人数据”解决。大模型仍然重要,但它应该做语义层面的低频决策;真正贴着物理世界运行的高频闭环,要交给更轻、更快、更贴近传感器的模块。
整体模型架构:从相机、语言、关节状态到连续动作
如果只看 Figure 1,NeuroVLA 容易被误读成一个“VLM 后面接 SNN”的简单拼装。实际架构更像一条多速率控制流水线:视觉和语言走慢速语义通路,本体感知和力反馈走快速状态通路,最终动作由脉冲脊髓层连续积分输出。它的输入、状态和输出至少包含四类信息。
第一类是外感知输入,也就是来自第三视角相机、腕部相机或任务相机的图像 。这部分负责提供目标物体、空间关系、容器姿态、障碍物等视觉信息。第二类是语言输入 ,描述任务目标和阶段性语义,例如“把酒瓶放到柜子上”或“打开中间抽屉”。第三类是本体感知 ,包括关节角、关节速度、末端位姿、夹爪状态,以及力/力矩传感器读数。第四类是低层神经动态状态 ,也就是 SNN 内部的膜电位、脉冲历史和输出积分状态。
把这些变量放到一张推理图里,NeuroVLA 的数据流是这样的:
图像 I_t + 指令 l │ ▼视觉语言 backbone:理解场景和任务语义 │ ▼Q-Former / layer-wise distillation:抽取任务相关空间原语 z_t │ ├──────────────┐ │ │ ▼ ▼本体感知 p_t ──► GRU 状态估计 h_t ──► FiLM / gating 调制 │ │ ▼ ▼ 小脑式 forward model 产生修正后的意图 z̃_t │ ▼ Spiking ResNet / LIF 脊髓层 │ 连续积分输出动作 a_t │ ▼ 机器人控制器执行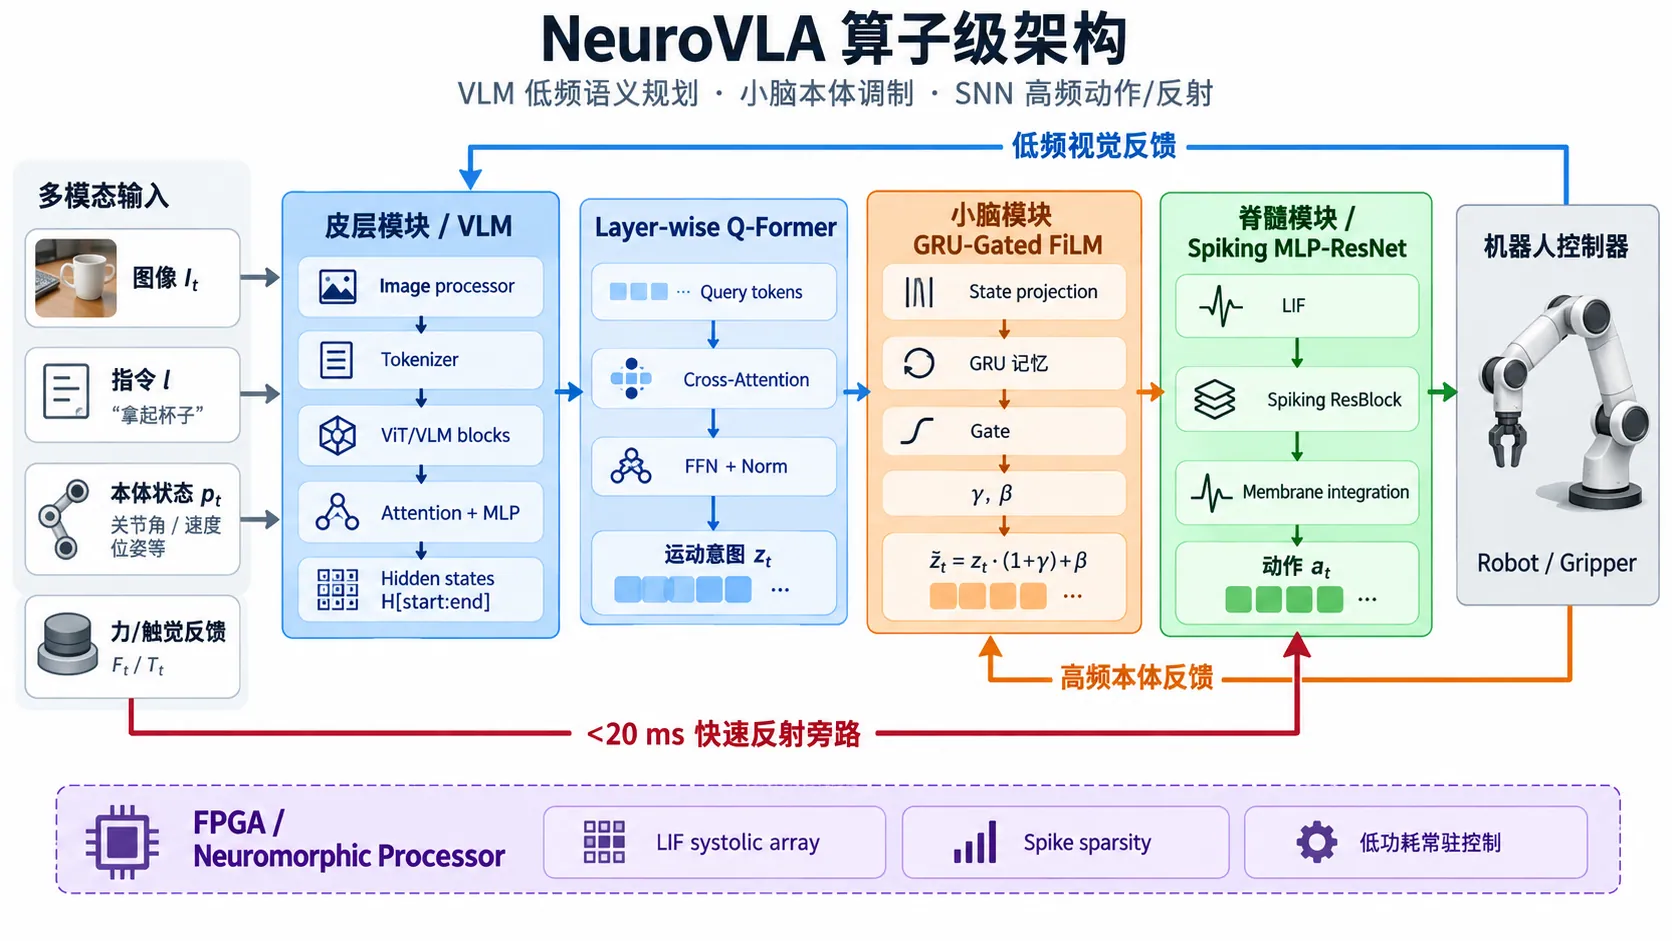
上面这张图是按论文描述与官方代码整理后生成的算子级示意图,用来帮助读者建立整体空间感。由于它是生成式位图,个别小字和符号不作为源码级依据;精确模块边界、算子顺序和训练/部署细节以正文拆解为准。
这条链路里有两个旁路很关键。第一个旁路是本体感知不必等视觉语言 backbone 重新推理,就能持续进入小脑模块更新 。这让机器人能在视觉帧没有明显变化时,仍然根据关节、速度和接触力修正动作。第二个旁路是 fast safety reflex:当力/力矩信号出现异常尖峰时,脊髓层和小脑层可以先触发回撤或局部避障,再把新的状态交还给上层语义计划。也就是说,NeuroVLA 的动作不是单次 输出后开环执行,而是“慢语义 + 快反馈 + 局部反射”的闭环。
从模块接口看,皮层输出不是直接动作,而是低维语义潜变量 ;小脑输出也不是最终动作,而是状态调制后的意图 ;脊髓层才把 和自身动态状态转成动作 。这种接口设计避免了两种极端:如果皮层直接输出动作,系统会受大模型延迟和视觉噪声影响;如果脊髓层直接接收原始视觉语言 token,它又要承担过多语义理解负担,无法保持低延迟。
更具体地说,NeuroVLA 把控制问题拆成三个表征空间。语义空间回答“任务相关的物体和目标是什么”,由 VLM 与 Q-Former 处理;状态空间回答“当前身体处在什么运动阶段、是否受到扰动”,由 GRU 和本体感知处理;动作空间回答“下一小段连续控制量如何生成”,由 SNN 和输出积分器处理。三级空间之间通过瓶颈连接,而不是把所有信息拼成一个大向量交给单一 MLP。
这个架构还有一个容易忽略的点:它不是纯软件分层。论文把上层视觉语言模块放在 CUDA computing tier,把小脑/脊髓相关低层回路放到 neuromorphic chip tier。也就是说,计算设备本身也被分层了。GPU 处理高维视觉语言推理,神经形态处理器处理毫秒级本体反馈和脉冲动作。这比“一个 GPU 跑完整 VLA”更接近真实机器人部署,因为移动平台通常同时受到功耗、散热、实时性和安全约束。
用控制系统的语言说,传统 VLA 更像一个低频策略网络;NeuroVLA 更像一个分层闭环控制器。上层策略给 reference,中层估计身体状态并调增益,下层产生连续控制并处理安全中断。论文使用“皮层、小脑、脊髓”三个词,本质上对应的是这三个工程角色,而不是为了套生物概念。
一句话看懂 NeuroVLA:把 VLA 从单脑模型改成三级神经系统
NeuroVLA 的整体策略可以写成一个分层控制关系:
这三个公式分别对应皮层、小脑、脊髓。
第一行里, 是图像观测, 是语言指令, 是视觉语言推理模块,输出 这样的低频语义意图。它不直接承担所有低层控制,而是负责回答“现在任务关心哪个物体、哪个位置、下一阶段大致往哪里动”。
第二行里, 是本体感知状态,例如关节角、关节速度、末端状态、力/力矩信号; 是递归模块保留的历史状态; 对上层语义意图做状态相关调制,输出更适合当前身体状态的 。这一步像一个自适应滤波器:同样是“向杯口倾斜”,如果传感器发现液体惯性正在变大,就要减小某些方向的增益;如果手腕受到外力,就要把动作从原路径改成绕开障碍的路径。
第三行里, 表示脉冲神经网络内部的膜电位等动态状态, 是低层执行模块。它把调制后的意图转成连续动作,并且可以处理局部反射。与普通 MLP action head 不同,脊髓层不是每一步独立回归动作,而是有内部动力学:膜电位会泄漏、累积、触发脉冲,再通过连续积分变成平滑动作。
这个分工背后有一个很重要的工程原则:把语义复杂度和控制频率解耦。语义理解需要大模型,低层反射需要小延迟;把两者捆在一个模型里,会让高频控制被大模型延迟拖慢,也会让大模型反复处理大量低层细节。NeuroVLA 的三级架构就是为了让慢的部分做慢任务,快的部分做快任务。
皮层模块:VLM 不直接控手,而是蒸馏“下降运动意图”
NeuroVLA 的上层是 cortical module,也就是论文类比的“皮层”。它接收视觉和语言输入,负责生成低频的语义运动目标。这里的关键不是“用了哪个 VLM”本身,而是 VLM 表示怎样传给低层控制模块。
论文方法部分写到,皮层模块包含 vision-language reasoning backbone,并通过 Q-Former 做语义潜变量生成。Q-Former 最初来自 BLIP-2,用一组可学习 query 从高维视觉表示里抽取任务相关信息。把它放到 NeuroVLA 里,可以理解成:VLM 的视觉语言表示很大、很杂,里面既有目标物体、背景、无关物体,也有语言任务需要的空间关系;低层控制不应该吞下全部表示,而应该得到一个压缩后的“动作相关摘要”。
用注意力形式表达,Q-Former 可以被写成:
这里 是可学习的查询向量, 和 来自视觉语言 backbone 的 token 表示, 是每个注意力头的维度。这个公式的含义不是简单“看图”,而是让 query 主动从场景中筛出对任务有用的空间原语。例如同一个画面里有酒瓶和抽屉:当指令是“把酒瓶放到柜子上”,query 先关注酒瓶,再随着任务阶段转向柜子表面;当指令改成“打开中间抽屉”,注意力热点会转向抽屉把手,旁边显眼的酒瓶反而被抑制。
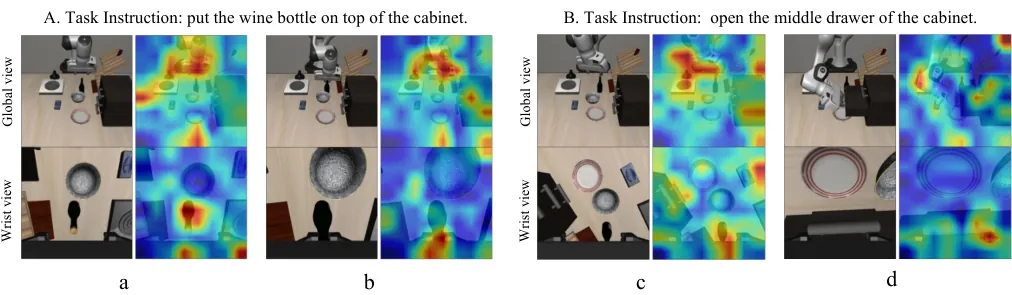
这个机制解决的是端到端 VLA 的一个隐藏问题:如果把整幅图像特征都交给 action head,低层模块既要理解语义,又要做控制,还要过滤干扰;如果上层先用语言任务做注意力门控,低层得到的是“经过任务过滤的空间原语”,控制问题会小很多。
论文还使用 layer-wise semantic distillation,把 VLM 多层语义特征逐层转成低维意图表示。多层蒸馏的意义在于,VLM 的浅层更偏视觉纹理和局部几何,深层更偏语言语义和任务关系;动作控制同时需要这两类信息。只取最后层可能太抽象,只取浅层又不懂任务。逐层蒸馏相当于把“看见什么”和“要做什么”一起压缩成下降控制信号。
这和站内很多推理文章里讲的“瓶颈”思想很像。比如 MLA 完全拆解 关注的是把 KV 表示压缩到低秩潜空间,减少解码时的内存读取;NeuroVLA 的 Q-Former 则是把高维视觉语言表示压缩到任务相关意图空间,减少低层控制需要处理的语义噪声。两者场景不同,但都在做一件事:不要把所有中间信息原封不动传到下游,只传下游真正需要的信息。
小脑模块:用本体感知修正上层意图
皮层模块能告诉机器人“目标在哪里、下一步大致应该做什么”,但它不知道身体正在经历什么。小脑模块接手的就是这个差距。NeuroVLA 的 cerebellar module 使用 recurrent dynamics 做本体状态估计,再用 gated FiLM 调制皮层意图,最后通过迭代 refinement 逼近一种 forward internal model。
先看状态估计。机器人在时间 的本体感知可以写成 ,包括关节角、关节速度、末端位姿、夹爪状态、力/力矩等。小脑模块用递归结构维护历史状态:
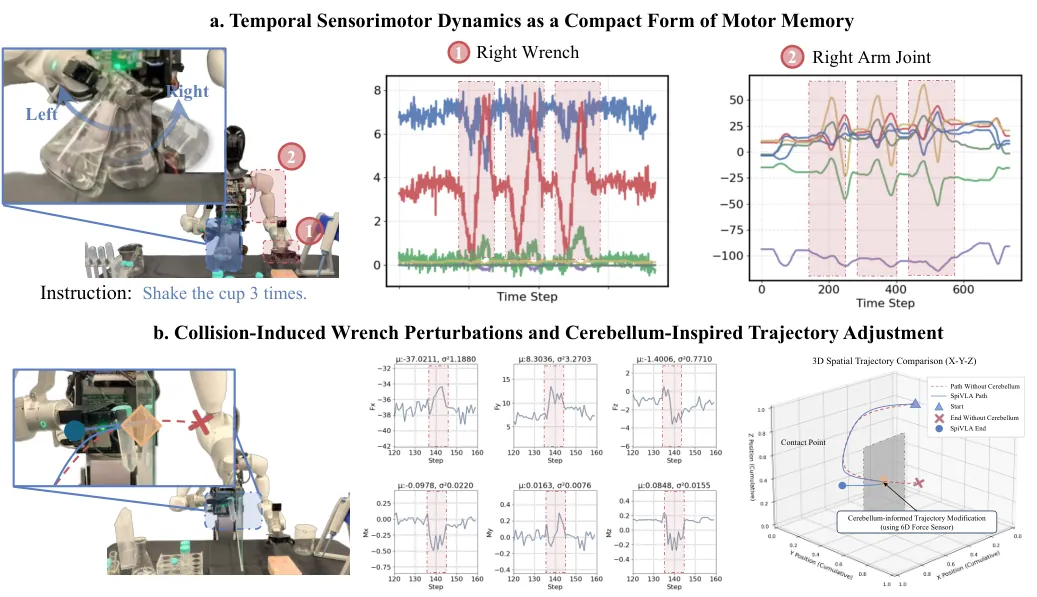
这里 是隐藏状态,保留了过去一段时间的运动上下文。为什么要递归?因为很多控制信息不是单帧可见的。比如“正在摇晃烧杯”需要相位记忆,当前一帧的图像可能几乎不变,但关节和力矩的周期变化能告诉模型现在处于第几次摆动、该往哪个方向继续。论文 Figure 3 展示的“Shake the cup”任务里,力/力矩和关节状态形成同步周期轨迹,说明节奏不是靠重复看视觉帧维持的,而是靠本体感知动态维持的。
然后是 FiLM 调制。FiLM 的全称是 Feature-wise Linear Modulation,本质是对特征做逐通道缩放和平移:
这里 是皮层输出的语义意图, 是小脑从本体感知中得到的状态, 和 分别是根据身体状态生成的缩放和平移参数, 表示逐元素乘法。直觉上,皮层说“向前移动”,小脑根据当前身体状态决定这个“向前”该放大、减小、偏移还是阻尼。
这个公式很简单,但控制意义很强。它不是把本体感知当成另一个输入拼接进去,而是让本体感知直接改变语义意图的增益。比如末端已经靠近障碍物,某个方向的移动增益应该下降;手腕受力突然增大,避障方向的增益应该上升;液体晃动导致系统不稳定,旋转动作应该被平滑。FiLM 的好处是轻量、可解释、易于插入,它对上层表示做调制,而不是重新生成整套语义计划。
论文把小脑模块对应到三个生物小脑功能环路:spinocerebellar loop、vestibulocerebellar loop、cerebrocerebellar loop。翻译到工程语言,分别对应三类能力。
第一类是抑制动作抖动。论文用 mean absolute commanded jerk 和 mean absolute commanded acceleration 评估动作稳定性。加入小脑模块后,平均 jerk 降低 75.6%,其中 降低峰值 80.2%, 降低 80.0%;平均加速度在不同轴上降低 32.8% 到 58.0%。这说明小脑不只是让结果“看起来平滑”,而是在动作导数层面压掉了高频噪声。
第二类是碰撞后的快速恢复。碰撞会在 6D wrench 信号里表现为尖峰。视觉模型需要等待图像变化和下一次推理,小脑-脊髓路径可以直接依据力反馈调整轨迹。论文报告碰撞时 均值约 , 均值约 , 方差约 ,这些数值说明扰动不是微小噪声,而是明显外力事件。
第三类是节奏记忆。在摇晃这类任务中,任务成功不是只靠“识别烧杯”,而要保持周期性动作。小脑模块把高频本体感知编码成动作相位,从而在视觉受噪声、遮挡或静态画面影响时仍能保持节奏。
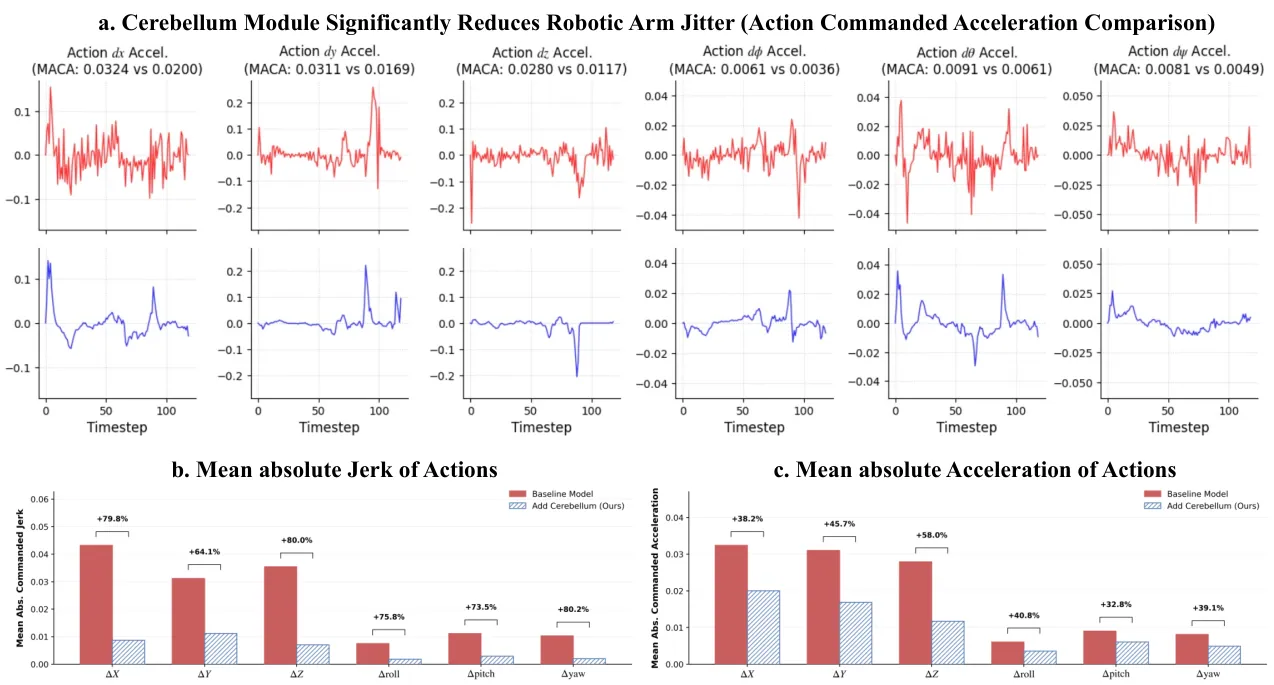
这部分是 NeuroVLA 最值得关注的地方。很多 VLA 文章会强调“模型会推理、会泛化”,但机器人落地时真正容易坏的地方,往往是执行过程中的连续控制质量。NeuroVLA 把执行稳定性单独拿出来建模,等于承认语义智能和运动智能不是同一个问题。
脊髓模块:为什么用 SNN,而不是普通 MLP action head
在许多 VLA 系统里,视觉语言 backbone 后面接一个 action head。这个 head 可能是 MLP、Transformer decoder、diffusion/flow decoder。NeuroVLA 的特别之处是把底层 action head 换成 spiking spinal module,也就是脉冲神经网络形式的“脊髓”。
SNN 的核心单元是 LIF neuron,Leaky Integrate-and-Fire。论文方法部分给出的膜电位更新公式是:
这里 是第 层第 个神经元在内部时间步 的膜电位, 是膜电位衰减因子, 是突触权重, 是上一层传来的脉冲, 是触发阈值。最后一项表示上一时刻如果发放了脉冲,就要从膜电位里扣掉阈值,模拟复位。
这个公式比普通 MLP 多了一个关键状态:。普通 MLP 的一次前向大致是 ,输入相同输出就相同,没有内部时间记忆。LIF 神经元会把过去的输入残留在膜电位里,再随着 衰减。于是它天然形成短期时间上下文:连续几次小输入可以积累到阈值触发,静止阶段没有输入就逐渐安静。
这解释了论文强调的 temporal sparsity。机器人静止保持姿态时,大部分低层神经元不需要高频活动;只有夹爪开合、末端位姿变化等具体 primitive 发生时,对应神经元才发放脉冲。论文 Figure 5 展示了“Static Pose & Dynamic Gripper”阶段:gripper control neurons 高频发放,而 end-effector pose control neurons 接近静默。换句话说,网络活动和动作需求绑定,而不是每个时间步都做同样密集计算。
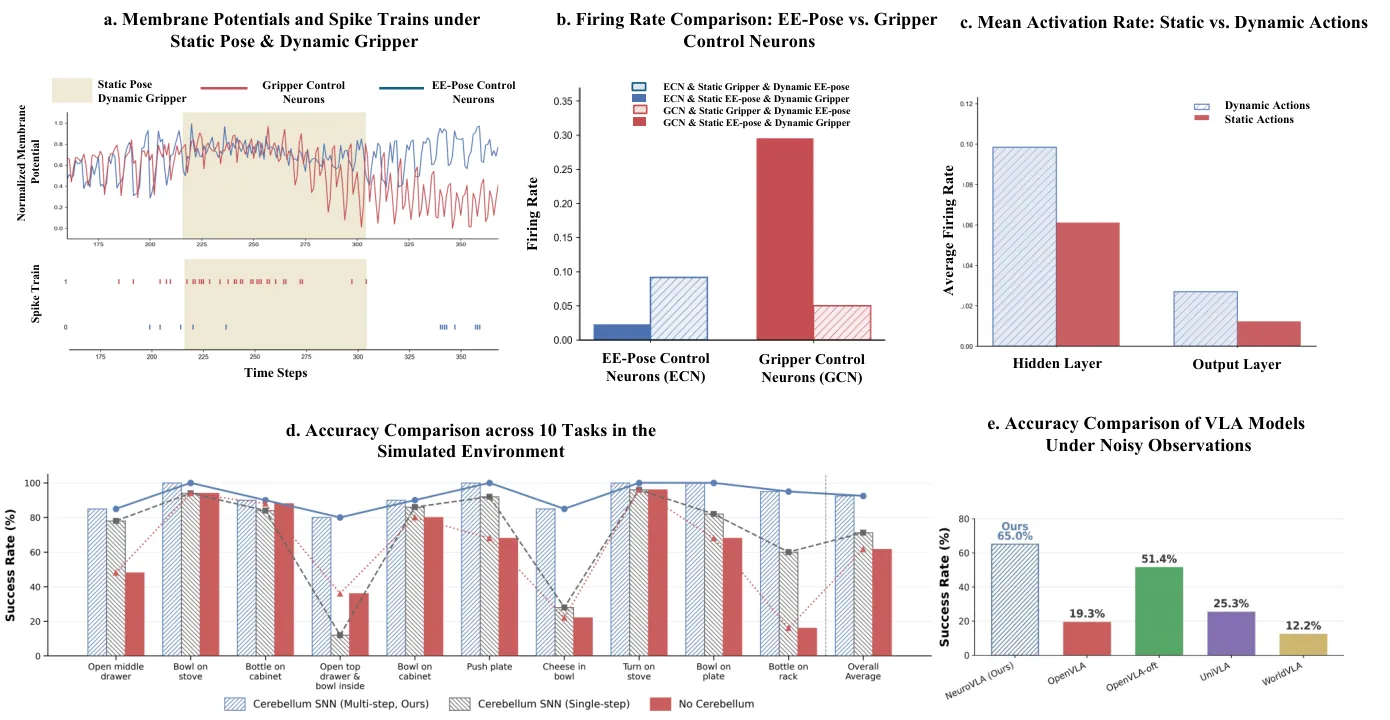
为了让脉冲网络能表达复杂传感器到动作的映射,NeuroVLA 使用 deep spiking residual architecture。论文给出的残差形式是:
这里 是第 层输入,Linear 做线性变换,LIF 做脉冲动态更新。残差连接的作用和 ResNet 类似:让深层网络更容易传播信号和梯度,避免层数增加后信息衰减。对 SNN 来说这更重要,因为脉冲发放是离散事件,深层传播更容易稀疏到“没信号”。残差路径让上层调制信号能稳定传到低层动作输出。
但机器人动作不是 0/1 脉冲,而是连续控制量。NeuroVLA 用 continuous integration protocol 在输出层把离散脉冲转成连续动作:
这里 是输出神经元累积的膜电位, 是输出映射矩阵, 是动作。隐藏层神经元发放后会复位,输出层则采用不复位积分器,连续积累输入。这样做有两个效果:一是低通滤波,把高频脉冲变成平滑动作;二是保持运动一致性,避免每个时间步独立跳变。
训练上,SNN 最大的问题是脉冲函数不可导。脉冲触发可以写成:
是 Heaviside step function,低于阈值输出 0,高于阈值输出 1。它几乎处处梯度为 0,在阈值处不可导,直接反传会断掉。论文采用 surrogate gradient,在反向传播中用快速 sigmoid 近似梯度:
这并不是说前向时神经元变成普通连续激活;前向仍然按脉冲发放,反向只用一个平滑近似来传梯度。这样既保留事件驱动稀疏性,又能用深度学习训练工具优化参数。
SNN 的“自组织”现象:不是只省电,还形成动作原语分区
NeuroVLA 论文中一个很有意思的观察是,脊髓 SNN 在没有显式监督“哪个神经元负责哪个自由度”的情况下,出现了空间功能分化。Figure 6 把第一层隐藏脉冲神经元的平均 firing rate 重排成热力图,发现不同运动维度会激活不同区域:例如 和 对应不同神经元群。
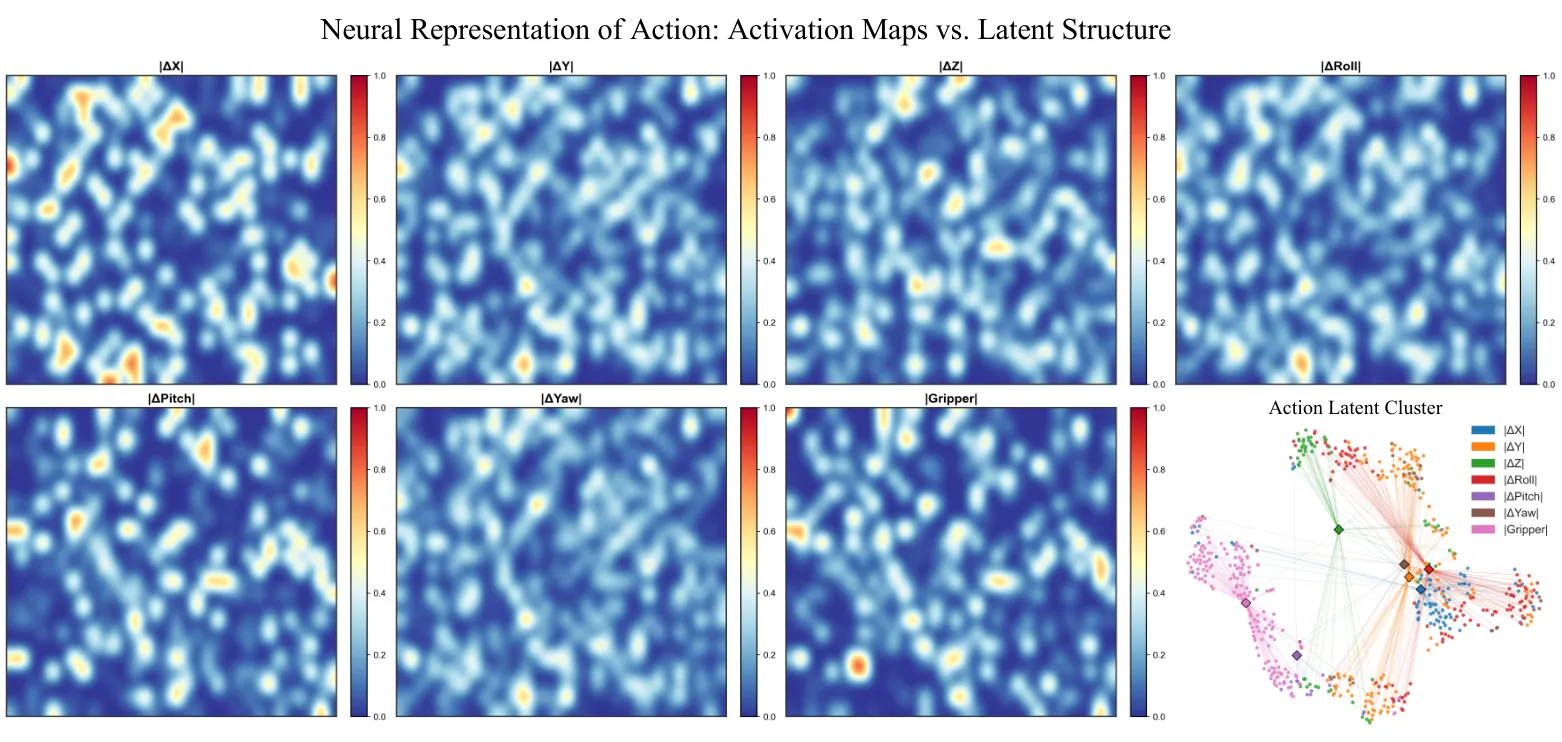
这件事可以从表示学习角度理解。普通 action head 学的是一个高维连续函数,把状态映射到动作;SNN action head 因为脉冲稀疏和膜电位动态,会鼓励网络把不同动作模式分配给不同事件子群。对于机器人控制,这种分化有两个潜在好处。
第一,它减少互相干扰。如果夹爪开合和末端姿态控制总是共享同一批神经元,小的夹爪动作可能扰动末端位姿,末端移动也可能影响夹爪稳定。功能分区让不同 primitive 的表示更可分。
第二,它让局部反射更可实现。碰撞时不一定需要重算完整动作序列,而是让和避障、回撤相关的子群快速激活。生物脊髓反射不是先做完整语义推理再行动,而是局部回路先保护身体,之后高层再接管。NeuroVLA 想复制的正是这种分层响应。
论文还用 t-SNE 展示 spinal hidden states 的低维聚类,不同动作 primitive 在潜空间里形成分离簇。这说明 SNN 不是一个黑盒压缩器,而是在内部把高维控制信号组织成若干行为模式。需要谨慎的是,t-SNE 只能说明表示可视化上的分离,不等于证明每个簇都有稳定可解释的因果功能;但结合 firing rate 热力图和消融实验,它至少说明 SNN 动力学对控制任务不只是“换了个激活函数”。
快速反射路径:为什么 20 ms 级响应必须绕开大模型
NeuroVLA 最有机器人味的一点是 fast safety reflex。论文做了一个“Recover to Safe Area”压力测试:机器人拿着易碎试管时遇到未知物理阻挡,传统基线由于缺少低层反射路径,成功率是 0.0%;NeuroVLA 能检测接触力、快速回撤,并在小脑模块帮助下重新规划局部轨迹,恢复成功率达到 54.8%。
这个实验的关键不是 54.8% 这个数字本身,而是失败模式的差异。常规 VLA 的控制链路大致是:相机看到变化,图像编码进入 VLM,模型输出下一步动作,再由控制器执行。碰撞发生时,视觉帧可能还没明显变化,即使变化了也要等下一次大模型推理。论文中把这条路径的延迟描述为大于 200 ms。对于碰撞,这个时间已经足够让末端继续挤压障碍物、打碎物体或进入机械失稳。
NeuroVLA 的反射链路是:6D wrench 检测到力尖峰,低层脊髓模块触发撤离动作,小脑模块用本体状态调制局部轨迹,皮层语义规划随后恢复。它不是让大模型“更快一点”,而是让生存性动作不经过大模型。这和操作系统里的中断有点像:普通任务可以走完整调度流程,但硬件中断不能排队等慢路径。
这个思想对于具身智能很关键。很多机器人任务不是“做对一道题”,而是“在连续物理交互中不要把系统搞坏”。拿试管、倒水、插拔、开抽屉、双臂协作,都要求控制系统对意外接触有局部处理能力。没有反射路径的 VLA 即使语义正确,也可能物理执行失败。
神经形态处理器:低层控制为什么适合事件驱动硬件
NeuroVLA 不只提出模型结构,还把 spiking spinal module 部署到定制神经形态处理器上。论文 Figure 7 显示,该处理器在 FPGA 平台实现,采用 LIF systolic-array architecture,并加入 spike-sparsity-aware computation。硬件结果是:20 MHz 下推理延迟 2.19 ms,单次推理能耗 0.87 mJ;资源使用为 51,953 LUT、27,880 FF、169 BRAM。摘要中还强调神经形态处理器功耗约 0.4 W。
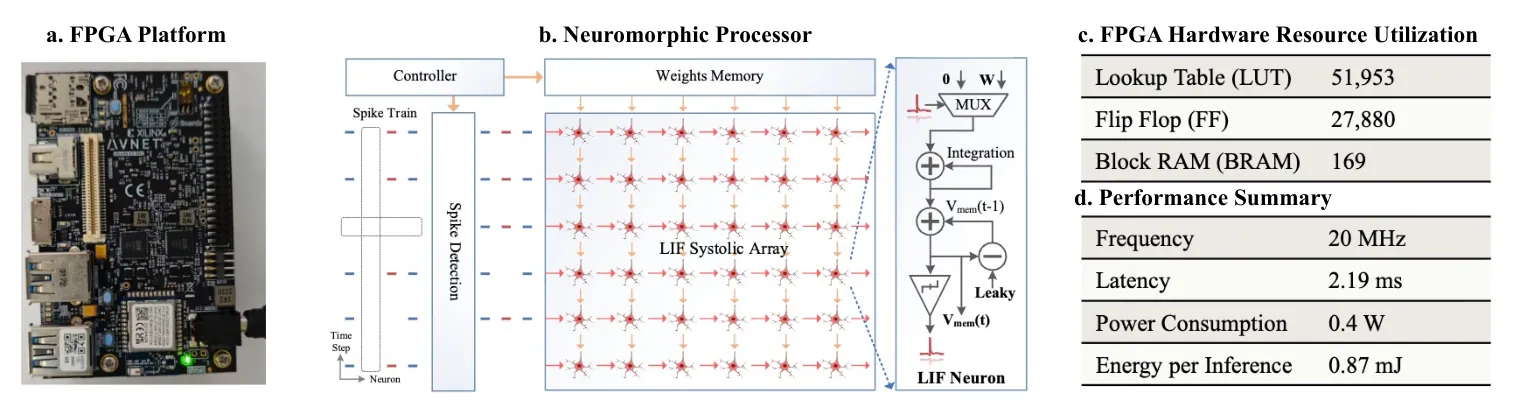
为什么 SNN 和这种硬件匹配?因为 SNN 的计算负载由事件驱动。普通矩阵计算通常每一步都要处理完整激活,即使大部分维度没有实际动作变化,也要参与乘加;SNN 只在 spike 发生时更新相关路径。硬件如果能检测 inactive spike 并跳过,就能把算法稀疏性变成能耗收益。
论文中的 LIF 脉动阵列可以从两个角度理解。空间并行方面,多列同时更新多个 LIF 神经元,并复用输入 spike;时间并行方面,多行并行累加权重贡献,并复用权重。这个思路和传统 AI 芯片里的脉动阵列有相通之处,站内 TPU v1 完全拆解(二) 里讲过 weight-stationary 数据流如何通过局部复用减少数据搬运。NeuroVLA 的处理器面对的是脉冲事件和 LIF 状态更新,但底层目标仍然类似:让数据在阵列里复用,而不是频繁访问外部存储。
和站内 FPGA 加速器完全拆解(一) 里提到的可重构硬件思想也能接上:FPGA 不一定追求像 GPU 那样跑大规模 dense GEMM,而是适合把特定控制环路做成低延迟、低功耗、靠近传感器的专用数据通路。NeuroVLA 的脊髓层就是这种场景。上层 VLM 仍然需要 CUDA/GPU,低层反射则适合放到事件驱动硬件或 FPGA 这类边缘侧处理单元。
这里要区分两个延迟:2.19 ms 是脊髓 SNN 硬件推理延迟,20 ms 内是系统级反射触发时间。前者是单模块计算,后者包含传感器读取、检测、控制链路和执行响应。论文用这两个数字分别说明硬件计算足够快、系统反射路径也足够快。
训练与部署流程:哪些部分离线学,哪些部分在线跑
虽然这篇文章重点讲推理和控制,但 NeuroVLA 的训练/部署边界也要说清楚,否则很难理解它为什么能在物理机器人上形成快反射。官方 AlphaBrain quickstart 把流程拆成三步:先预训练 NeuroVLA,再用 R-STDP 做细调,最后在 LIBERO 等环境中评估,并可开启 online STDP test-time adaptation。默认硬件说明是 4 张 A800 80 GB,但文档也说明可以用 --gpus N 在更小配置上运行。
离线阶段主要学三件事。第一,视觉语言 backbone 与 Q-Former 学会从图像和语言中抽取任务相关意图。第二,小脑模块学会把本体感知历史映射成调制参数,抑制抖动、调整轨迹、保持动作相位。第三,脊髓 SNN action head 学会把调制后的意图转成动作,并通过 surrogate gradient 解决脉冲不可导问题。这里的训练仍然可以用常规深度学习工具完成,SNN 不是完全脱离反向传播。
在线阶段则有不同目标:不是重新训练整个 VLM,而是让低层回路快速适应当前物理状态。R-STDP 的名字来自 reward-modulated spike-timing-dependent plasticity,可以理解成带奖励信号的脉冲时序可塑性。普通反向传播需要存储计算图、等待 loss、反传更新;R-STDP 更接近局部学习规则:前后脉冲时序形成 eligibility trace,再由奖励或成功信号调制权重变化。官方 README 强调它可以在部署时对 SNN head 做 test-time adaptation,并且不需要 backward pass。
为什么这对机器人重要?因为真实机器人和训练环境总有偏差:桌面摩擦、夹爪磨损、液体重量、传感器噪声、关节响应延迟都会变化。如果每次变化都要重新微调整个 VLA,成本太高;如果只让低层 SNN 根据本体反馈做局部适应,就更像生物运动学习里“身体自己调一调”。这也是 NeuroVLA 与普通 VLA 微调不同的地方:它不是只问“新任务成功率能不能提高”,而是问“低层控制回路能不能在部署时继续适应”。
部署时,NeuroVLA 的频率安排可以这样理解:
| 层级 | 主要输入 | 主要输出 | 典型职责 | 对实时性的要求 |
|---|---|---|---|---|
| 皮层模块 | 图像、语言 | 语义意图 | 目标识别、任务阶段、空间关系 | 低频,可接受较高延迟 |
| 小脑模块 | 、关节/力反馈、历史状态 | 调制后意图 | 平滑、阻尼、相位记忆、误差修正 | 中高频,需要持续更新 |
| 脊髓模块 | 、脉冲状态、局部传感器事件 | 连续动作 | 动作生成、输出积分、快速反射 | 毫秒级,不能等待大模型 |
这张表比“三级类脑架构”四个字更能说明 NeuroVLA 的工程实质。它把每层能承受的延迟、应该处理的信息和输出接口都区分开。只要这个边界成立,上层 VLM 未来可以替换成更强模型,下层 SNN 也可以换成不同神经形态硬件;架构思想仍然成立。
实验结果:NeuroVLA 到底赢在哪里
NeuroVLA 的实验分成仿真、消融和真实机器人三类。
仿真方面,论文使用 LIBERO / LIBERO-Plus 这类机器人操作 benchmark。官方 GitHub README 中还列出了 AlphaBrain NeuroVLA pipeline 的 LIBERO 表格:在 Goal、Spatial、Object、Long-horizon 四个 suite 上,PLIF action head 平均 95.0%,其中 long-horizon 达到 95%;ALIF 平均 94.5%;LIF 平均 94.0%。同一 README 还给出 local e-prop 与 surrogate-gradient BPTT 的对比,在 batch 32、50k steps 预算下,e-prop 平均 95.5%,BPTT 平均 93.75%。这些数字来自官方开源流水线说明,和论文主文侧重不完全一样,但能说明团队把 NeuroVLA 放进了可复现实验栈。
消融方面,论文关心三个问题。
第一,小脑模块是不是必要?去掉小脑以后,动作抖动显著增加,碰撞响应和视觉噪声下的稳定性下降。这个消融说明本体感知调制不是装饰,而是在物理控制里承担阻尼和状态估计。
第二,多步 SNN 是不是必要?论文比较 Multi-step SNN、Single-step SNN 和 No-Cerebellum baseline。Multi-step SNN 在长时程任务上更强,说明膜电位动态带来的时间积分对任务阶段切换有帮助。Single-step SNN 去掉时间上下文后,就更像普通逐步回归器,无法充分利用动作历史。
第三,神经元模型的丰富度是否有影响?官方 README 给出的 LIF、PLIF、ALIF 对比说明,可学习膜衰减和阈值在长时程任务上有收益。PLIF 在 long-horizon suite 上达到 95%,比 LIF 的 85% 高出 10 个百分点。直觉上,长任务更依赖时间常数选择:膜电位衰减太快会忘记相位,太慢会保留过时信息,可学习动态更容易适配任务。
真实机器人方面,论文在双臂人形平台上做了生化实验场景,包括移动试管、倒液体、整理物品、摇晃烧瓶、丢弃废弃物和碰撞恢复。对比基线包括 OpenVLA、OpenVLA-OFT、UniVLA、WorldVLA。NeuroVLA 在多个任务上领先,尤其是在需要空间精度、动态轨迹平滑和节奏记忆的任务上更明显。
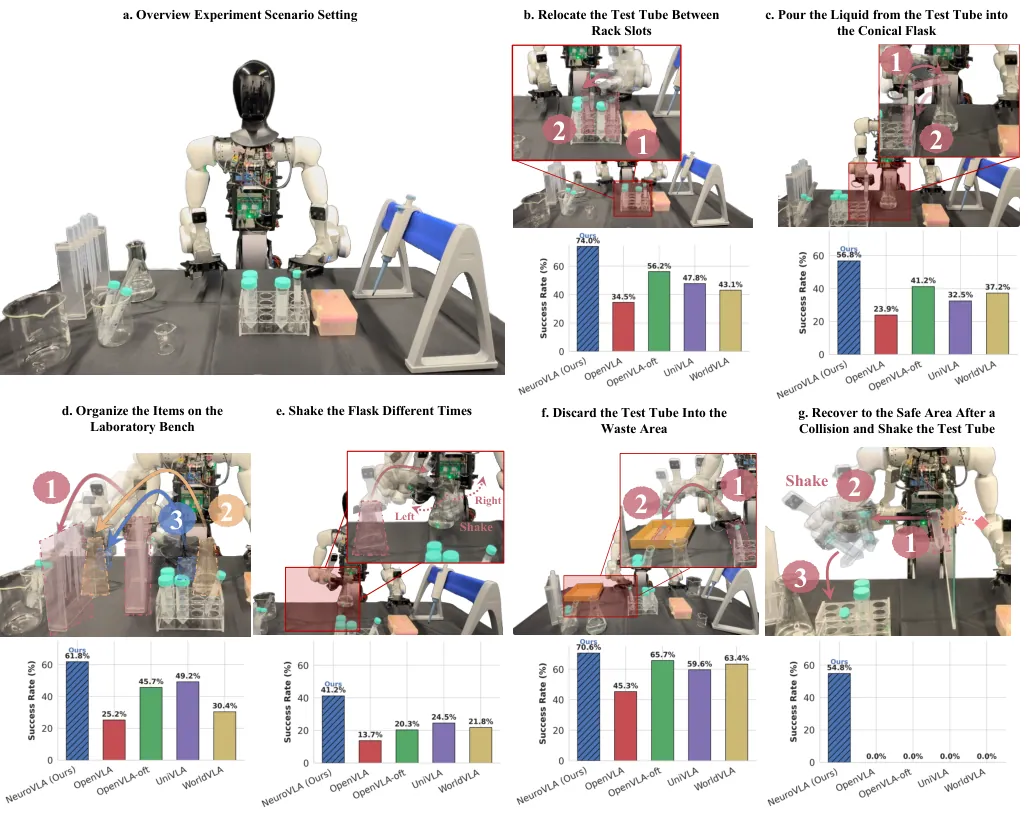
倒液体任务能体现小脑模块的价值。液体重心会随倾斜角和流动状态改变,视觉可能被容器遮挡,单靠图像很难稳定估计。NeuroVLA 利用高频本体感知和力反馈调整腕部增益,减少过冲和泼洒。
摇晃任务能体现脊髓动态记忆。摇晃不是简单把手从 A 点移到 B 点,而是保持周期相位。如果每一步都重新从图像推断动作,容易出现不稳定节奏;膜电位积分和递归状态能维持短时运动历史。
碰撞恢复任务则直接体现反射路径。基线模型没有低层安全回路时,遇到未知障碍会继续执行原计划;NeuroVLA 先撤离再局部改道,虽然不是 100% 成功,但把 0.0% 的恢复能力提升到 54.8%,这说明架构分工带来了 qualitatively different behavior,也就是能力类型发生了变化。
和 OpenVLA、RT-2、、UniVLA、WorldVLA 的关系
NeuroVLA 不是要否定 VLA 基础模型路线。相反,它依赖 VLM/VLA 的语义能力,只是认为语义能力不该直接承担全部身体控制。
RT-2 的贡献是把机器人动作变成 token,让互联网规模视觉语言知识迁移到机器人控制中。它回答的是“怎样让 VLM 会输出动作”。OpenVLA 的贡献是开源 7B VLA,并在 970k 真实机器人示范上训练,让研究者能复现和微调。 的贡献是用 flow matching 输出连续动作,缓解动作离散化带来的精度问题。UniVLA 和 WorldVLA 则进一步关注视觉观测中的时序/因果结构和动作世界模型。
NeuroVLA 的切入点不同:它不是单纯提高动作 decoder 表达能力,而是把动作 decoder 放进一个分层神经系统里。上层仍然可以换成更强 VLM,下层仍然可以接不同机器人控制接口;关键是让高频本体反馈、低延迟反射和事件驱动执行成为架构的一等公民。
可以用下面这张对比表抓住差异:
| 路线 | 主要回答的问题 | 动作表示/控制特点 | NeuroVLA 视角下的不足 |
|---|---|---|---|
| RT-2 | 如何把 Web 语义知识迁移到机器人动作 | 动作 token 化,和语言 token 一起建模 | 低层控制仍受大模型链路延迟影响 |
| OpenVLA | 如何开源可微调的通用 VLA | 开源 7B VLA,面向多任务操控 | action head 对高频本体反馈和反射建模不足 |
| 如何输出更连续、更灵巧的动作 | flow matching 连续动作 decoder | 连续动作更细腻,但低层反射仍需额外结构 | |
| UniVLA / WorldVLA | 如何显式建模时序、因果或世界动态 | 强调视觉时间结构和动作世界模型 | 仍偏上层策略建模,未必解决毫秒级局部闭环 |
| NeuroVLA | 如何让 VLA 拥有身体级稳定性和反射 | 皮层-小脑-脊髓三级架构,SNN 低层控制 | 需要额外传感器、硬件和分层系统工程 |
这个对比也说明 NeuroVLA 的创新点不是“VLA 加一个 SNN”这么简单。SNN 只是脊髓层的实现形式,真正的架构主张是多时间尺度分工:语义规划、状态调制、反射执行分别放在不同层。
推理部署视角:NeuroVLA 是一种 P/D 分离式具身控制
如果从大模型推理系统角度看,NeuroVLA 很像一种具身控制版的“冷热路径拆分”。站内很多推理系统文章讨论过类似思想:把昂贵、低频、全局的工作和便宜、高频、局部的工作拆开。例如 DualPath 让不同推理阶段走不同数据路径,Blink 把 CPU 从高频调度路径中拿掉,TileRT 则用常驻执行减少每一步调度开销。NeuroVLA 面对的不是 LLM token 服务,而是机器人控制,但原则相同:高频路径不能被慢组件卡住。
对于机器人在线控制,可以把请求路径分成三层频率。
低频路径是 VLM/VLA 推理,可能几十到几百毫秒更新一次,适合做任务阶段判断、目标对象选择、语义纠错。它吃图像和语言,输出抽象目标。
中频路径是小脑状态调制,跟随本体感知和局部运动状态更新,适合做平滑、阻尼、轨迹微调和相位保持。它不需要重新理解完整语义,但要持续读高频传感器。
高频路径是脊髓反射和动作积分,延迟目标是毫秒级,适合处理碰撞、夹爪接触、局部撤离、姿态保持。它必须靠近硬件,最好能事件驱动。
这样的拆分有一个现实收益:算力预算更合理。大 VLM 不需要为每个微小控制周期重新运行,低层模块也不需要携带全部语义知识。对移动机器人、人形机器人、双臂操作这类边缘部署场景,这种分工比单一大模型更接近工程现实。
从官方代码反推 NeuroVLA 的真实模块边界
如果只读论文摘要,很容易把 NeuroVLA 理解成“VLA 加了一个 SNN 头”。这个理解太粗。更准确地说,NeuroVLA 是把原来单条 action head 路径拆成了四段:VLM 语义编码、Layer-wise Q-Former 意图压缩、本体感知调制、SNN 残差动作生成。四段的输入、输出和时间尺度都不同。
官方代码里的主框架注册名就是 NeuroVLA。它会先构造 qwen_vl_interface 作为视觉语言 backbone,再构造 layer_qformer 把多层 hidden states 压缩成动作相关 latent,然后构造 edit_model 处理机器人状态,最后由 action_model 输出动作。训练样本里至少包含图像、语言、动作和状态四类信息:图像给 VLM,语言给 tokenizer,动作张量形状接近 ,状态张量形状接近 。这里的 7 维动作通常对应末端位姿增量加夹爪控制,8 维状态则在代码注释里对应位置、姿态、夹爪等机器人本体变量。
这件事很关键:NeuroVLA 不是把机器人状态随便拼到文本 prompt 里,而是把状态作为一条单独的连续控制信号处理。语言和图像负责“任务是什么”,状态负责“身体现在处在什么动力学条件下”,动作头负责“下一段连续控制应该怎么走”。这比简单的 image-language-action mapping 更接近控制系统。
官方实现还有一个容易被忽略的细节:推理时存在迭代式 refinement。代码里会在一个循环中生成 action chunk,然后用预测动作更新一份 predicted states,再把更新后的状态送回调制模块继续预测下一轮。直观地说,这相当于让模型先想象“如果我执行了刚才这段动作,身体状态会怎样变化”,再根据这个新状态修正后续动作。它不是完整物理仿真器,但已经带有 forward internal model 的味道。
这也解释了论文为什么把中间层叫“小脑”。小脑在生物运动控制里并不负责理解语言,而是负责预测运动后果、修正误差、保持运动平滑。NeuroVLA 的 GRU/FiLM 模块正是把上层语义意图和本体状态合在一起,形成对动作 latent 的动态调制。
Layer-wise Q-Former:为什么不是只取 VLM 最后一层
普通多模态模型经常拿最后一层 hidden state 做下游任务,但机器人控制不是纯语义任务。最后一层更偏向回答、抽象语义和任务完成形式;中间层则可能保留更多局部视觉、空间关系、对象边界和动作相关线索。NeuroVLA 使用 Layer-wise Q-Former 的意义,就是从多层 VLM hidden states 里用可学习 query token 抽取控制需要的信息。
可以把 Q-Former 想成一个“运动意图读出器”。它不需要保留整段视觉语言序列的全部 token,而是用少量 query 去问:当前任务中哪些对象重要?目标区域在哪里?下一步动作应该朝哪个方向?夹爪应该接近、张开还是闭合?这些答案最后被压成固定维度的 latent,供下层控制模块使用。
这一层的价值有三点。
第一,它减少了语义到动作之间的接口宽度。VLM hidden states 很长,直接送给动作头既慢又容易过拟合。Q-Former 把信息压缩成较短 latent,相当于把大模型输出变成控制友好的状态表示。
第二,它允许动作头不依赖完整大模型上下文。动作头只要消费 Q-Former latent 和机器人状态,就能在高频闭环里运行。VLM 可以低频更新语义意图,不必每个控制周期都重跑完整推理。
第三,它缓冲了 backbone 替换成本。将来如果把 Qwen-VL 换成别的 VLM,只要 Q-Former 输出接口稳定,下层小脑和脊髓模块可以少改。这是分层架构的重要工程收益。
与 InternVLA-M1 这样的基线相比,这里还有一个路线差异。M1 里有更重的视觉 token 融合和 diffusion action head,它更像“用强视觉表示和生成式动作建模提高泛化”。NeuroVLA 则更关注“低层动作动力学和实时反馈”。二者并不是谁完全替代谁,而是把算力花在不同位置:M1 更重感知和生成,NeuroVLA 更重闭环稳定和低延迟反射。
GRU-Gated FiLM:小脑模块到底怎么调制动作意图
FiLM 的基本形式很简单:给定一个特征 ,用条件信号生成缩放 和偏置 ,再计算 。这相当于根据当前身体状态动态调整动作 latent 的每个通道。某些通道被放大,某些通道被压低,某些通道被整体平移。
NeuroVLA 的小脑模块不是只看当前一帧状态。官方代码里有 GRU-Gated FiLM 版本,它用两层单向 GRU 读取机器人状态历史,再用状态投影生成 gate,对动作投影进行门控,最后生成 FiLM 的 和 。这一步给模型带来短时记忆:它能区分“手臂正向目标接近”“手臂刚刚被碰撞”“夹爪刚夹住物体但仍在滑动”“液体倾倒时腕部角速度正在变大”等状态。
为什么需要 gate?因为不是所有本体状态都应该同等影响语义意图。如果任务是“把红色杯子放进盒子”,上层语义意图需要保持稳定,不能被传感器噪声随便改写;但如果力传感器突然出现异常,低层回路又必须迅速压过原来的轨迹计划。门控机制让状态信息以可学习的方式决定“这次应该调多大”。
这就是小脑模块和普通状态拼接的区别。普通拼接只是告诉模型“这里还有一些数字”;FiLM 调制则是在特征空间里直接改变动作通道的增益和偏置。对控制来说,增益本身就是很重要的量:同样的目标方向,在空载、夹重物、接触桌面、接近奇异位形时,应该对应不同的速度、阻尼和安全裕度。
Spiking MLP-ResNet:动作头的逐时间步计算
NeuroVLA 的脊髓模块使用 Spiking MLP-ResNet action head。它不是一个只有一次前向的普通 MLP,而是带有膜电位状态的多步网络。代码路径可以概括为:先重置 SNN 内部状态,再把序列维度放到最前面,逐时间步送入输入 LIF 层、若干残差脉冲块、输出 LIF 层,最后用线性层从输出膜电位回归连续动作。
这里的核心不是“输出必须是离散脉冲”。实际机器人需要的是连续动作,所以 NeuroVLA 让中间神经元用脉冲通信和膜电位积分,最终仍然用 membrane potential 映射到连续 。这保留了 SNN 的时间积分、稀疏激活和低功耗潜力,同时不会把控制接口变成离散分类问题。
残差结构也很重要。没有残差时,深层 SNN 容易出现梯度传播困难、脉冲过稀或过密的问题;加入 MLP-ResNet 结构后,每一层都只需要学习对当前动态的增量修正。对机器人动作来说,这种“增量修正”也更自然:手臂的控制信号通常是连续变化的,下一步动作往往是在上一阶段基础上的小调整。
输出层使用无重置或弱重置的膜电位积分,能让网络保留一段时间内的动作趋势。举例来说,摇晃烧瓶时,系统不应该每一帧都忘记相位;倒液体时,也不应该在视觉短暂遮挡时立刻失去倾倒趋势。膜电位相当于短时控制记忆,和小脑 GRU 的状态记忆互补:GRU 更像显式连续状态记忆,SNN 膜电位更像事件驱动的局部动态记忆。
从计算角度看,SNN 的收益来自稀疏事件。普通 dense MLP 每一步都激活所有通道;SNN 只有膜电位超过阈值时才发放脉冲。如果动作处于稳定阶段,很多神经元可以保持沉默。这正是论文报告低功耗神经形态处理器结果的原因:在低层高频控制里,很多周期只需要小修正,不需要每次都跑满 dense compute。
LIF、PLIF、ALIF:脉冲神经元差在哪里
LIF 是最基本的 leaky integrate-and-fire 模型。它把输入电流积到膜电位里,同时按衰减系数遗忘旧状态;超过阈值就发放脉冲,并按规则重置。LIF 的优点是简单、硬件友好、容易映射到 FPGA 或神经形态芯片。缺点是时间常数固定时,所有神经元的记忆长度近似由同一类参数控制,对复杂任务可能不够灵活。
PLIF 可以把膜电位衰减等参数变成可学习量。这样不同神经元可以学出不同时间尺度:有的神经元负责毫秒级接触反射,有的负责几百毫秒的轨迹趋势,有的负责更长的动作阶段。官方 README 表格里 PLIF 在 long-horizon suite 上比普通 LIF 更强,这个结果符合直觉:长任务更需要合适的时间常数。
ALIF 进一步引入 adaptive threshold。它的阈值会随神经元历史活动变化,类似一种疲劳或适应机制。如果某个神经元持续发放,阈值提高后会抑制过度激活;如果长期沉默,阈值又可以回落。对控制系统来说,这能帮助避免某些通道长期占主导,也能让网络在不同任务阶段切换激活模式。
所以,LIF/PLIF/ALIF 的区别不是名词差异,而是时间动态的可塑性差异。NeuroVLA 选择比较这些变体,说明它关心的不是“有没有脉冲”这个形式,而是“低层控制是否能学到合适的时间尺度”。
训练目标:L1、surrogate gradient、R-STDP、e-prop 各自管什么
NeuroVLA 容易让人混淆的地方是,它同时出现了普通监督学习、surrogate gradient、R-STDP 和 e-prop。它们不是同一层面的概念。
L1 动作回归是最直接的 imitation learning 目标。给定图像、语言、状态和专家动作,模型预测动作序列,然后用预测动作和真实动作之间的绝对误差训练。这对应官方代码中对 predicted action 和 action label 的 L1 loss。它回答的问题是:模型能否模仿数据里的专家轨迹。
surrogate gradient 解决的是 SNN 不可导问题。脉冲发放函数本身像阶跃函数,导数几乎处处为零,直接反传很难训练。surrogate gradient 在反向传播时用一个平滑近似函数替代真实阶跃导数,让 SNN 可以接入常规深度学习训练流程。它回答的问题是:带脉冲的网络如何用梯度法训练。
R-STDP 解决的是部署适应问题。STDP 根据前后神经元脉冲的时间关系调整连接,reward-modulated STDP 再用奖励信号调制这个局部更新。它更像在线局部可塑性规则,不需要完整反向传播图。它回答的问题是:低层动作回路能否在测试时根据成功/失败反馈快速微调。
e-prop 解决的是循环/脉冲网络训练的 credit assignment 成本问题。它通过 eligibility trace 近似时间信用分配,减少完整 BPTT 对历史状态和计算图的依赖。官方 README 给出 e-prop 与 BPTT 的对比,说明团队尝试把 SNN 训练从传统长反传推向更在线、更局部的更新形式。它回答的问题是:有时间状态的网络能否更高效地学习长时程依赖。
把这四者放在一起,可以得到更清楚的训练图景:先用监督数据把系统训练到会做任务,再用 surrogate gradient 让 SNN action head 可训练,再用 R-STDP 或 e-prop 这类局部学习规则提高低层适应性。NeuroVLA 的贡献不只是某个 loss,而是把这些学习方式放到了三级控制架构里。
数据、评测与真实机器人:NeuroVLA 到底验证了哪些能力
NeuroVLA 的评测不能只看平均成功率。具身控制里,成功率、平滑度、恢复能力、能耗和延迟分别对应不同能力。
仿真数据方面,LIBERO 系列任务大致覆盖空间关系、物体识别、目标条件和长时程组合。Spatial 更看空间定位和姿态,Object 更看对象区分,Goal 更看目标理解,Long-horizon 更看多阶段记忆和动作衔接。NeuroVLA 在这些 suite 上表现高,说明它没有为了低层动态牺牲基本语义控制能力。
LIBERO-Plus 和真实任务则更接近 NeuroVLA 的主战场。标准桌面任务有时动作很短、接触很少,普通 VLA 已经能做得不错;一旦加入液体、碰撞、柔顺接触、多阶段节奏动作,纯语义模型的短板就更明显。NeuroVLA 把重心放在这些物理动态场景上,评测重点自然不只是“拿起放下”。
论文中的真实双臂生化任务尤其值得看。比如倒液体要求腕部姿态连续变化,容器重量和液体重心不断变;摇晃烧瓶要求稳定周期和相位;碰撞恢复要求在任务轨迹之外立即触发安全动作;废弃物丢弃要求动作结束条件和空间容错。这些任务都不适合用“每隔一段时间让大模型重新看图然后输出下一步”来解决。
平滑度指标也很重要。论文报告 jerk 大幅下降,平均加速度降低,说明 NeuroVLA 的优势不是只体现在最终成功,而是体现在运动质量。机器人手臂抖动越小,越不容易打翻容器、损伤物体、触发安全停机,也更接近人类能接受的协作机器人行为。
碰撞恢复指标则说明系统出现了新行为类别。普通 VLA 也许能在训练分布内完成任务,但遇到未见障碍时可能继续执行原计划。NeuroVLA 的反射路径让系统先退让、再恢复任务。即使恢复率还不完美,这种“被扰动后主动回到安全区”的能力,本身就是从 open-loop action prediction 走向 closed-loop embodied control 的标志。
低延迟部署:到底哪部分需要快,哪部分可以慢
讨论 NeuroVLA 的延迟时,必须把全链路拆开。VLM 理解图像和语言可以慢一些;Q-Former 读出动作 latent 应该比完整 VLM 轻;小脑模块需要跟随本体传感器频率更新;脊髓模块和反射路径需要在毫秒级响应。把这些混在一起,就会误读论文里的 <20 ms 和 0.4 W。
<20 ms 更适合理解为低层反射路径的响应目标,而不是完整 VLM 从图像编码到语言推理再到动作输出的端到端耗时。完整 VLM 每步都跑到 20 ms 以内并不现实,也没有必要。真实系统可以让 VLM 低频产生目标 latent,让下层模块高频执行和修正。
0.4 W 也应理解为神经形态处理器侧的低层推理功耗,不是整个机器人、相机、主机 GPU 和控制柜的总功耗。这个区分很重要,因为 NeuroVLA 的工程价值恰恰在于“把高频低层控制从大模型算力里剥离出来”。上层仍然可能很耗电,但下层每秒运行上百次或上千次的控制回路可以变得很轻。
如果真正部署到机器人上,可以把延迟账本拆成这些项:相机曝光和传输、图像预处理、VLM 编码、Q-Former latent 读出、状态采样、GRU/FiLM 调制、SNN 动作生成、控制指令发送、执行器响应、传感器反馈返回。NeuroVLA 主要优化的是后半段,尤其是状态采样到动作生成之间的低层闭环。
这也意味着实际工程里需要异步系统。上层 VLM 不应该阻塞低层控制循环。更合理的实现是:VLM 在后台周期性更新任务 latent;小脑/脊髓模块以更高频率读取最新 latent 和传感器状态;如果传感器检测到碰撞或异常力,反射路径可以立刻覆盖当前动作。这样才能让机器人既听懂语言,又不因为等大模型而反应迟钝。
硬件映射:为什么 NeuroVLA 适合 FPGA / 神经形态处理器
NeuroVLA 的低层 SNN 与 FPGA/神经形态处理器之间有天然匹配。原因不是“FPGA 很快”这么简单,而是 SNN 的计算模式适合事件驱动硬件。
第一,脉冲稀疏意味着可以跳过很多无效计算。Dense MLP 不管输入是否变化,都要做完整矩阵乘法;SNN 在没有脉冲时,很多连接不需要触发乘加。这对稳定控制阶段尤其有利。
第二,LIF 状态更新结构简单。膜电位更新主要是衰减、加权输入、阈值比较和重置,硬件数据通路规则,适合流水线化。论文中的 FPGA 设计使用 LIF systolic array 和 spike-sparsity aware 调度,本质上就是把这些规律变成专用数据通路。
第三,低层控制模型规模远小于 VLM。把完整 VLA 放到极低功耗芯片上很难,但只把脊髓 action head 和部分小脑模块放进去就现实得多。NeuroVLA 的分层让硬件部署对象变小:GPU/主机跑语义模型,边缘低功耗芯片跑高频控制。
第四,机器人控制的输入输出带宽相对可控。低层模块主要消费本体状态、力传感器、少量语义 latent,输出几维连续动作。相比大语言模型的长上下文和巨大 KV Cache,这个数据流更适合片上缓存和固定接口。
但硬件映射也有代价。SNN 的时间步展开、阈值选择、定点量化、膜电位精度、输出积分方式都会影响控制稳定性。如果用 FPGA 部署,还要处理主机和 PL 之间的数据同步、控制周期抖动、异常状态回退。论文展示的是很有价值的原型,不等于所有机器人场景都能直接复制。
与普通 VLA、diffusion policy、分层控制的关系
NeuroVLA 不是凭空出现的。它可以看作三条路线的交汇:VLA 的语义泛化、机器人分层控制的实时闭环、SNN/神经形态计算的低功耗动态系统。
和 RT-2、OpenVLA 这类 VLA 相比,NeuroVLA 仍然承认大模型的价值。没有视觉语言 backbone,机器人很难理解开放词汇指令,也很难处理多物体、多目标、多步骤任务。NeuroVLA 并不是反对 VLM,而是认为 VLM 不应该直接承担所有低层控制职责。
和 diffusion policy 或 这类连续动作生成模型相比,NeuroVLA 更强调反馈和反射。Diffusion/flow action head 擅长生成平滑动作 chunk,但通常仍然是较重的迭代生成过程。NeuroVLA 的 SNN head 更像低层动态控制器,强调在线状态、膜电位记忆和快速响应。
和传统分层控制相比,NeuroVLA 的新意在于上层不是手写状态机,而是开放语义模型;下层也不是固定 PID 或 MPC,而是可学习的脉冲动态网络。传统控制强在稳定性证明和可解释约束,VLA 强在语义泛化;NeuroVLA 试图把两者中间缺失的“身体反射层”补上。
和 UniVLA、WorldVLA 这类新 VLA 方向相比,NeuroVLA 的关注点也不同。UniVLA 更强调统一建模和跨任务/跨形态泛化,WorldVLA 更强调动作世界模型和自回归预测。NeuroVLA 则把“真实机器人执行时的抖动、碰撞、功耗、响应速度”放到核心位置。它不是只追求 benchmark 平均分,而是把物理交互质量纳入模型设计。
什么时候 NeuroVLA 会占优,什么时候未必值得
NeuroVLA 最适合的场景是:任务有明确语义目标,同时执行过程高度依赖身体反馈。比如液体倾倒、柔顺接触、双臂协作、工具使用、碰撞恢复、节奏性操作、动态物体跟踪、需要长时间保持稳定姿态的精细操作。这些场景里,上层规划和低层反射都重要。
如果任务只是静态桌面 pick-and-place,物体刚性强,接触少,动作短,传感器简单,普通 VLA 或 diffusion action head 可能已经足够。此时引入 SNN、小脑调制、神经形态硬件,系统复杂度可能大于收益。
如果机器人平台没有高频本体或力反馈,NeuroVLA 的优势也会被削弱。它的核心不是换一个 action head,而是让 action head 消费高频身体信号。没有这些信号,小脑和脊髓模块很难发挥出论文里展示的稳定化和反射能力。
如果部署环境需要严格安全认证,NeuroVLA 也不能直接替代传统 safety controller。学习型反射可以提高恢复能力,但安全停机、力限制、工作空间约束、碰撞检测冗余仍然需要工程安全系统兜底。最现实的方案是把 NeuroVLA 放在任务控制层,把硬实时安全约束放在更底层。
读这篇论文最容易误解的几个点
第一个误解是把“类脑”当成性能保证。皮层、小脑、脊髓只是帮助理解分工的类比,真正有用的是时间尺度分层、本体反馈、脉冲动态和低层反射。没有严谨实验,类脑名词本身没有意义。
第二个误解是认为 NeuroVLA 完全摆脱大模型。它仍然依赖 VLM 做高层语义理解。更准确的说法是,它减少了大模型在高频控制中的负担,而不是取消大模型。
第三个误解是把 <20 ms 理解成完整端到端 VLA 推理。低层反射可以做到毫秒级,但完整视觉语言推理通常更慢。NeuroVLA 的架构价值正是允许二者以不同频率运行。
第四个误解是把 0.4 W 理解成整机功耗。这个数字对应低层神经形态处理器侧,不能代表相机、主机、执行器和整台机器人。
第五个误解是认为 SNN 只为省电。省电是重要收益,但在 NeuroVLA 里,SNN 更重要的作用是时间记忆、事件驱动响应和动作原语分区。论文展示的 emergent modularity 说明 SNN 的动态结构可能改变了动作表示方式。
第六个误解是认为开源代码完全等同论文实验系统。官方仓库给出了重要实现线索和可复现实验入口,但论文中的真实机器人平台、硬件部署和部分工程细节仍然需要结合论文描述理解。写技术解读时应该区分“论文报告”“官方 README 说明”“代码中可以看到的实现”。
如果要自己复现,应该按什么顺序理解
第一步先跑通普通 VLA baseline。只有先理解 OpenVLA/OFT 或类似模型如何从图像语言输出动作,才能看出 NeuroVLA 改在哪里。否则很容易把所有复杂度都归因于 SNN。
第二步只替换 action head。保持相同 VLM 和数据,让普通 MLP/DiT action head 与 SNN action head 对比,观察成功率、平滑度、推理耗时和动作频谱。这个阶段不要急着上神经形态硬件。
第三步加入本体感知调制。把 robot state 通过简单拼接、普通 FiLM、GRU-Gated FiLM 三种方式比较,观察抖动、接触恢复和长时程任务。这样能验证小脑模块到底贡献多少。
第四步测试反射路径。人为加入碰撞、推拉、目标短暂遮挡、夹爪滑动等扰动,单独测恢复时间和失败类型。成功率只是结果,恢复过程更能暴露低层控制是否真的有效。
第五步再做硬件映射。先确认模型在 GPU/CPU 上有稳定收益,再考虑 SNN 定点化、时间步裁剪、膜电位精度、AXI/PCIe/以太网通信和控制周期同步。否则很可能把算法问题误判成硬件问题。
对具身智能研究的更大启发
NeuroVLA 最值得重视的地方,是它把“身体”重新放回 VLA 的中心。过去很多 VLA 工作强调图像、语言、动作三元组,但动作往往只是数据集里的输出标签;机器人真实执行时的惯性、摩擦、碰撞、柔顺性、传感器噪声和控制频率,并没有进入模型结构的核心。
NeuroVLA 的三级架构提醒我们:具身智能不是把语言模型接到机械臂上就结束。一个能长期运行的机器人,必须同时具备慢速语义推理、中速状态估计、快速局部反射和低功耗常驻控制。人类运动系统不是每一次手指微调都回到大脑皮层重新推理,机器人也不应该每个微动作都依赖大型 VLM。
这条路线未来可能会继续分化。一类工作会强化上层世界模型,让机器人更会规划;一类工作会强化跨机器人泛化,让同一个 VLA 适应不同形态;还有一类工作会像 NeuroVLA 一样,把重点放在低层动态、反射、安全和硬件效率。真正可用的机器人系统大概率需要这三类技术同时存在。
局限与风险:类脑不是免检通行证
NeuroVLA 的方向很有启发,但也需要清楚它还没有解决所有问题。
第一,论文目前是 arXiv v1,部分结果需要更多独立复现。官方 GitHub 已开源代码,并把 NeuroVLA 纳入 AlphaBrain 框架,但真实机器人实验的数据和硬件条件仍然比较特定。54.8% 碰撞恢复率说明有新能力,但距离可靠安全系统还远。
第二,三级架构提高了系统复杂度。单体 VLA 的好处是接口简单:输入图像和语言,输出动作。NeuroVLA 需要本体传感器、力/力矩传感器、递归状态、小脑调制、SNN 训练、神经形态硬件或 FPGA 部署。每多一层就多一组同步、校准、延迟和故障诊断问题。
第三,SNN 的训练和调试门槛更高。surrogate gradient 可以让 SNN 接入反传,但脉冲动态的时间常数、阈值、模拟窗口、输出积分方式都会影响稳定性。PLIF/ALIF 的结果说明可学习动态有收益,也说明固定动态可能不够鲁棒。
第四,反射路径需要安全验证。低延迟反射是好事,但错误反射也可能危险。真实机器人部署中,力阈值、撤离方向、局部轨迹重规划都要和控制安全约束结合,否则可能从“碰撞不退”变成“误判乱退”。论文展示了原型能力,还不能替代工业级安全控制器。
第五,类脑类比要适度。皮层、小脑、脊髓的命名能帮助理解分工,但工程系统不是生物系统。真正值得学习的是时间尺度分层、本体反馈、局部反射和事件稀疏计算,而不是把生物术语当成性能保证。
NeuroVLA 留下的启发
NeuroVLA 最重要的启发是:具身智能里的“智能”不只存在于语言推理和视觉识别里,也存在于低层控制回路里。一个机器人能不能稳定倒水、被碰撞后能不能迅速退开、能不能保持摇晃节奏、静止时能不能低功耗待命,这些都是智能的一部分。
对 VLA 研究来说,NeuroVLA 把问题从“怎样让大模型输出动作”推进到“怎样让大模型、身体状态和低层反射共同组成控制系统”。这可能比继续单纯扩大 VLA backbone 更接近真实机器人落地。语义模型擅长理解“我要做什么”,小脑式模块擅长调整“现在身体应该怎样做”,脊髓式模块擅长在毫秒级完成“先保护自己再说”。三者合起来,才像一个能在物理世界里持续运行的系统。
对推理系统和硬件方向来说,NeuroVLA 也提示了一个新场景:未来机器人不会只需要云端大模型和边缘 GPU,还会需要贴近传感器的低功耗事件驱动处理器。上层 VLM 负责慢思考,下层 SNN/FPGA/神经形态芯片负责快反射。这种分层会让“模型架构、控制算法、硬件数据通路”真正绑在一起。
参考资料
- A Brain-inspired Embodied Intelligence for Fluid and Fast Reflexive Robotics Control
- NeuroVLA 官方 GitHub 仓库
- AlphaBrain NeuroVLA Quickstart
- AlphaBrain Documentation
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
- OpenVLA: An Open-Source Vision-Language-Action Model
- : A Vision-Language-Action Flow Model for General Robot Control
- Unified Vision-Language-Action Model
- WorldVLA: Towards Autoregressive Action World Model
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


