


DFlow 完全拆解:让验证器信息流穿过拒绝边界的块扩散投机解码
DFlow 是北京大学、上海交通大学等团队在 2026 年 9 月提交到 arXiv 的块扩散投机解码方法,全名是 DFlow: Enabling Verifier Information Flow in Block Diffusion Speculative Decoding。它要解决的问题很具体:DFlash 这类块扩散草稿器一次并行猜一整块 token,目标模型验证后只提交连续命中的前缀,剩下的后缀会被丢掉;但目标模型其实已经为这些被丢掉的位置算出了 hidden states,DFlow 认为这些连续表示不该一起报废。
这篇文章只讲推理侧主线:DFlow 怎样把验证器在 rejected suffix 上已经产生的 hidden states 传给下一轮草稿,为什么要做位置对齐,为什么还要用拒绝边界两侧的 token 做一次修正,以及这套 relay 在系统吞吐上值不值。DFlash 的块扩散草稿背景可参考站内已有的 DFlash 块扩散解码。
问题不在拒绝,而在信息断流
投机解码的基本套路是“便宜模型先猜,昂贵模型一次验证”。给定已经提交的上下文,草稿器提出未来 个 token:
这里 表示第 轮投机, 是草稿块长度, 是本轮草稿器并行给出的候选块。目标模型随后做一次前向,把这些候选 token 按从左到右的顺序与自己的预测结果对齐检查。假设前 个 token 连续命中,第 个 token 首次失败,那么本轮候选块可以拆成三段:
accepted prefix 会被提交;first rejection 不会被提交,而是替换成目标模型在这个位置给出的正确 token,论文把它叫 bonus token,记为 ;rejected suffix 按传统做法直接丢弃。
这个规则保证了投机解码的无损性:最终输出与目标模型自己逐 token 解码一致。问题在于,它把“token 是否可提交”和“这个位置上算出的连续表示是否有用”混在了一起。
离散 token 被拒绝,只能说明从第一个错误 token 开始,这条离散路径不能作为最终输出继续走下去;它并不说明目标模型在这些位置产生的 hidden states 没有预测价值。验证阶段的目标模型不是只给一个对错标志,它完整跑过了候选块,每个位置都参与了因果注意力、MLP、归一化和 logits 计算。换句话说,rejected suffix 里的 hidden states 是目标模型在“旧猜测路径”上做过的一次连续空间探测。
DFlow 的切入点就在这里:拒绝边界应该是提交边界,不应该顺手变成信息边界。
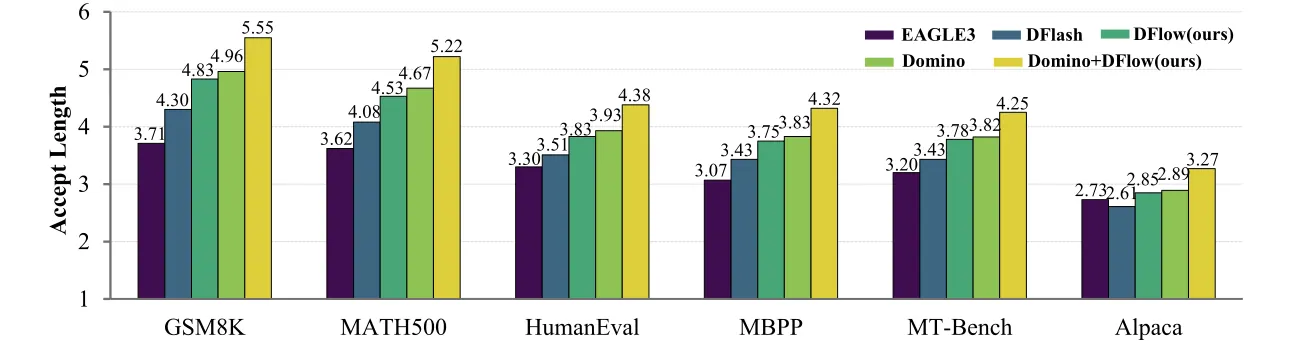
图源:DFlow 论文 Figure 1。图中比较了 EAGLE-3、DFlash 与 DFlow 在 Qwen3-1.7B 上的平均接受长度。纵轴不是最终任务分数,而是每轮投机平均能接受多少 token。这个指标很适合观察草稿质量,因为一次目标模型验证能多提交几个 token,解码循环就能少跑几轮。
DFlash 留下的“重算窗口”
理解 DFlow 前,需要先把 DFlash 的状态流捋清楚。DFlash 不是传统小模型自回归草稿器,而是块扩散草稿器:未来 个位置先放 mask embedding,然后草稿器一次并行预测整块 token。为了让草稿器不是凭空猜,它会使用目标模型若干层的上下文 hidden states。
论文把第 轮目标模型若干层的 hidden states 写成 ,其中 是层号。选出的层集合是 。DFlash 先把这些层的表示拼接,再用投影矩阵压回草稿器可用的空间,并做 RMSNorm:
这里 是上下文特征投影矩阵,方括号表示沿特征维拼接, 是融合后的目标上下文表示。DFlash 会把它注入草稿层的 Key 和 Value 投影,让草稿器知道已经提交的上下文里有哪些目标模型特征。
然后,草稿器用 mask embedding 表示未来位置:
是块扩散草稿器, 是本轮 个未来位置的 mask 输入。DFlash 的优势是 drafting latency 低,因为 个 token 不再串行生成;短板也在这里,块内 token 之间的因果依赖被弱化,后面位置的预测质量通常更脆。
DFlow 观察到一个更细的浪费:假设第 轮猜了 16 个 token,只接受了 4 个 token,加上 bonus token 后下一轮会从第 6 个位置继续猜。上一轮被拒绝后缀里的很多位置,其绝对位置会和下一轮草稿窗口重叠。传统 DFlash 会把这些重叠位置重新初始化为 mask embedding,相当于让草稿器从零恢复它上一轮和目标模型已经共同计算过的信息。
这种浪费不只是多做了一点草稿器计算。更关键的是,目标模型验证时产生的 hidden states 比草稿器自己的中间状态更贵、更准,也更接近真实目标模型分布。把它们扔掉,等于把一次昂贵 verifier pass 中最有信息量的副产品扔掉。
DFlow 的核心:把 rejected suffix 变成下一轮提示
DFlow 的推理流程可以概括成一句话:目标模型验证后,不只保留 accepted prefix 和 bonus token,还缓存 rejected suffix 对应的 verifier hidden states;下一轮草稿时,把这些 hidden states 对齐、修正后加到对应位置的 mask embedding 上。
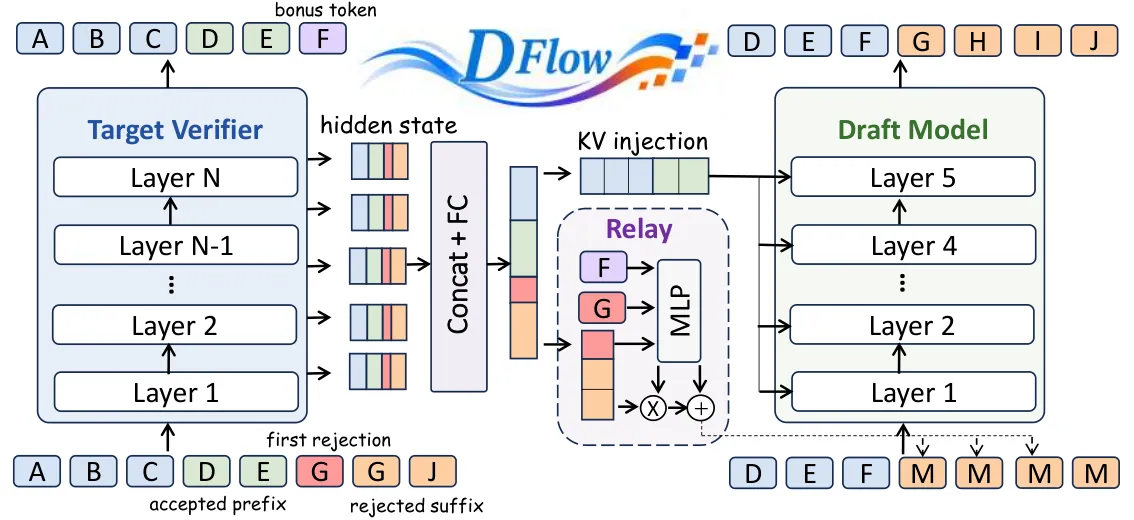
图源:DFlow 论文 Figure 2。这张图是全文最重要的架构图。左侧是上一轮 drafting 与 verification:草稿器给出一块 token,目标模型完成验证,连续命中的前缀被提交,第一个错误位置由目标模型 token 修正。右侧是下一轮 drafting:DFlow 没有把 rejected suffix 的目标模型 hidden states 丢掉,而是经过 relay module 注入下一轮对应 mask 位置。
图里有三个容易误解的细节。
第一,DFlow 复用的是 hidden states,不是复用被拒绝的离散 token。被拒绝 token 仍然不能提交,因此最终输出仍由目标模型验证约束,投机解码的无损性不被破坏。
第二,DFlow 不需要额外跑一次目标模型。rejected suffix 的 hidden states 来自原本就必须执行的 verifier forward。新增开销主要是对这些表示做投影、归一化、MLP 调制和加法注入。
第三,DFlow 只在有重叠且有可复用表示的位置启用 relay。第一轮没有历史信息,或者上一轮几乎全接受、没有 rejected suffix 可用时,输入仍然退化为普通 mask embedding。
第一步:把验证器表示投到草稿器空间
目标模型和草稿器不一定有相同隐藏维度,也不一定用同一种特征分布。直接把目标模型 hidden states 加到草稿器输入上,通常是不合理的:尺度不对、语义不对、层深也不对。DFlow 采用了一个很朴素但工程上舒服的做法:复用 DFlash 已经存在的 投影。
对于 rejected suffix 上某个可复用位置 ,DFlow 同样从目标模型选定层取 hidden states,拼接后过 和 RMSNorm,得到可被草稿器消费的表示 :
表示第 轮验证时,目标模型第 层在位置 的 hidden state; 是投影后的 verifier representation。复用 有两个好处:一是不用再引入一套大的跨模型适配器;二是 DFlash 草稿器本来就学过怎样消费这个投影空间中的目标特征,DFlow 只是在未来位置上多送一些同分布信息。
这里的“同分布”不是严格数学保证,而是工程假设:既然 已经负责把目标模型上下文层表示变成草稿器可用条件,那么 rejected suffix 的目标层表示也走同一个接口,最容易和已有草稿器结构对齐。
第二步:解决 next-token 与 mask-token 的错位
DFlow 不能把 原封不动塞回位置 ,因为目标模型和块扩散草稿器的预测语义不同。
目标模型是因果 next-token predictor:位置 的 hidden state 用来预测位置 的 token。块扩散草稿器更像 mask-token predictor:第 个 mask 位置的表示直接预测第 个 token。
这个差别会带来一格位置错位。若不处理,DFlow 注入的 verifier representation 会指向错误的预测目标。于是论文要求在注入草稿器前对 verifier representation 做 shift,让“这个表示服务于哪个 token”的对应关系和草稿器一致。
可以用一个小例子理解。假设上一轮 rejected suffix 覆盖绝对位置 10、11、12。目标模型在位置 10 的 hidden state 更直接服务于位置 11 的预测;如果下一轮草稿器要预测位置 11,就应该接收从目标位置 10 来的表示,而不是位置 11 自己的表示。shift 的本质不是技巧,而是把两类模型的输出契约对齐。
第三步:用拒绝边界修正旧路径信息
只做投影和 shift 还不够。rejected suffix 的 verifier hidden states 是在“错误分支”上算出来的。
第 轮验证时,目标模型处理 rejected suffix 的上下文包含草稿器给出的 first rejection:
但第 轮真正继续解码时,这个位置已经被替换成目标模型给出的 bonus token:
也就是说,旧 verifier representation 有价值,但它的前缀条件里夹着一个错误 token。DFlow 的 relay module 要做的不是盲目相信旧信息,而是根据“错误 token”和“修正 token”的差异,判断每个通道该保留多少、该补偿多少。
论文把这个调制写成:
这里 是 token embedding; 表示目标模型修正后的 token; 表示草稿器第一次猜错的 token; 是待复用的 verifier representation; 是轻量 MLP;输出被拆成两个向量 和 。
是逐通道缩放系数,负责决定 verifier representation 哪些维度该保留、弱化或放大; 是逐通道加性修正,负责补上从错误边界切到正确边界后的表示偏移。用两个 token embedding 作为条件,是因为它们直接描述了上下文分支的变化:上一轮 verifier hidden state 的前缀里是 ,下一轮真实前缀里是 。
最后,DFlow 把调制后的 verifier representation 加到下一轮 mask embedding 上:
是下一轮草稿器在位置 的实际输入; 是原始 mask embedding; 是 LayerNorm; 是逐元素乘法。这个公式的直觉很清楚:mask embedding 提供默认的“未知未来位置”输入,旧 verifier representation 提供上一轮目标模型算过的连续提示, 和 负责把旧提示改造成适合新前缀的提示。
这类形式有点像条件归一化或 FiLM 调制:不是把外部信息粗暴拼接,而是让条件生成一组通道级控制量。这样做比直接加法更稳,因为 rejected suffix 的信息质量并不均匀。有些维度可能主要承载局部语法,可大量保留;有些维度可能强依赖那个错误 token,需要压低;还有些维度需要补偿到修正后的语义方向。
推理循环可以怎么实现
把论文机制翻译成服务系统里的状态机,大致是下面这条路径:
committed context -> block drafter proposes K tokens -> target verifier runs one forward pass -> exact-match verification finds accepted prefix length a_r -> commit accepted prefix and bonus token -> extract verifier hidden states for reusable rejected suffix -> align by one-position shift -> build relay states keyed by absolute token position -> next drafting round consumes relay states at overlapping positions这里最重要的数据结构不是 token 序列,而是“按绝对位置索引的 relay states”。服务端需要知道:第 轮 rejected suffix 的某个 hidden state 对应哪一个未来 token,下一轮窗口是否还覆盖这个绝对位置,如果覆盖,就把它拿出来调制 mask embedding;如果不覆盖,就直接丢弃。
一个简化伪代码如下:
def dflow_decode(context, max_new_tokens, block_size): relay_cache = {}
while not finished(context, max_new_tokens): anchor = len(context) draft_inputs = []
for offset in range(block_size): pos = anchor + offset if pos in relay_cache: draft_inputs.append(apply_relay(mask_embedding(), relay_cache[pos])) else: draft_inputs.append(mask_embedding())
draft_tokens = block_drafter(context, draft_inputs) verifier_outputs = target_verify(context, draft_tokens)
accepted_len, bonus_token = exact_match(verifier_outputs, draft_tokens) context.extend(draft_tokens[:accepted_len]) context.append(bonus_token)
relay_cache.clear() rejected_start = accepted_len + 1 for offset in range(rejected_start, block_size): old_pos = anchor + offset new_pred_pos = old_pos + 1 relay_cache[new_pred_pos] = { "hidden": project_and_shift(verifier_outputs.hidden_states, offset), "draft_boundary": draft_tokens[accepted_len], "bonus_boundary": bonus_token, }这段伪代码省略了批处理、KV cache、采样验证等生产细节,但能说明 DFlow 的系统性质:它不是替换目标模型,也不是改变最终采样分布,而是在两轮 speculative round 之间多传一份 verifier side metadata。
工程实现里需要额外注意三件事。
第一,relay state 的生命周期很短。它只服务于下一轮或少数后续轮的重叠未来位置,不能像 KV Cache 那样长期保留,否则显存管理会复杂化,也会把过时分支信息带得太远。
第二,relay state 应与请求绑定,而不是与 batch 绑定。连续批处理下,不同请求的接受长度不同,下一轮 anchor 不同,可复用位置也不同。把 relay 做成 per-request metadata,调度器才能在动态 batch 中正确拼装草稿输入。
第三,relay 不应进入目标模型的因果状态。目标模型验证仍然只看已提交上下文和本轮候选 token;relay 只影响草稿器。这个边界守住后,DFlow 才能保持投机解码“验证后无损”的性质。
为什么平均接受长度能涨
投机解码的收益可以用一个粗略账本理解。假设目标模型一次 verifier pass 可以验证 个候选 token,平均接受长度是 。每轮实际推进的大致 token 数约为 ,其中 来自 first rejection 位置的 bonus token。目标模型 forward 的轮数近似从逐 token 解码的 次降到:
是需要生成的新 token 数。这个公式没有计入草稿器开销、batch 效率、KV 读取和采样细节,但它说明了为什么 很关键:当 从 3.56 增加到 3.93 时,单看 verifier 轮数,分母从 4.56 增加到 4.93,理论上就是一段可观的循环次数下降。
DFlow 的实验正是围绕 展开。论文在 Qwen3-1.7B、Qwen3-4B、Qwen3-8B 上评估了数学推理、代码生成和对话任务,基准包括 GSM8K、MATH-500、HumanEval、MBPP、MT-Bench、Alpaca;对比对象包括 EAGLE-3 和 DFlash。所有实验在单节点 8 张 NVIDIA A800 上完成,DFlash 与 DFlow 使用 5 层草稿器、草稿块长度 16。
低并发下,DFlow 的平均接受长度相对 DFlash 的提升如下:
| 目标模型 | 解码设置 | DFlash 平均接受长度 | DFlow 平均接受长度 | 相对提升 |
|---|---|---|---|---|
| Qwen3-1.7B | 3.56 | 3.93 | 10.4% | |
| Qwen3-4B | 3.71 | 4.20 | 13.2% | |
| Qwen3-8B | 3.66 | 4.15 | 13.4% | |
| Qwen3-1.7B | 2.99 | 3.26 | 9.0% | |
| Qwen3-4B | 3.15 | 3.54 | 12.4% | |
| Qwen3-8B | 3.10 | 3.45 | 11.3% |
这里 是 greedy decoding, 是采样解码。采样更难,因为目标 token 本身带随机性,草稿器命中连续前缀的概率会下降;DFlow 在采样下仍然提升,说明 relay 不是只在确定性路径上捡便宜。
开销为什么只有 1.2%
DFlow 增加了 relay module,直觉上似乎会拖慢每轮投机。论文的开销分解显示,DFlow 的额外 relay latency 是 0.51 ms,相对 DFlash 只有 1.2% overhead。
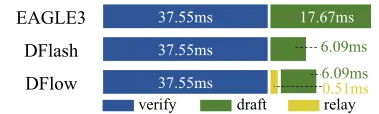
图源:DFlow 论文 Figure 3。图里主要耗时仍然来自 draft model execution 和 target verification;relay 只是一小段额外开销。原因很直接:DFlow 没有新增目标模型 forward,也没有让草稿器变成串行自回归。它只是复用已有 verifier pass 的 hidden states,对少量 rejected suffix 位置做轻量 MLP 调制。
这个开销结构决定了 DFlow 的收益条件:只要 relay 带来的接受长度增长能减少足够多的后续 verifier rounds,它就很容易覆盖 0.51 ms 的本轮额外成本。反过来,如果某些任务上 rejected suffix 几乎没有可复用信息,或者接受长度本来已经接近 block size,DFlow 的边际收益会变小。
高并发结果也支持这个判断。论文用 SGLang 评估 Qwen3-4B 和 Qwen3-8B,在并发 1、2、4、8、16、32 下统计 throughput。以 Qwen3-8B 的 GSM8K 为例,baseline 自回归在并发 32 下是 1630.10 TPS,DFlash 是 1891.10 TPS,DFlow 提升到 2198.17 TPS;在并发 16 下,DFlash 是 1835.42 TPS,DFlow 是 2023.22 TPS。
更有意思的是 EAGLE-3 在高并发下会出现小于 baseline 的情况。例如 Qwen3-4B GSM8K 并发 32 时,EAGLE-3 是 1942.57 TPS,仅为 baseline 的 0.68 倍;DFlash 是 2672.69 TPS,为 baseline 的 0.94 倍;DFlow 是 3208.95 TPS,达到 1.13 倍。原因不是 EAGLE-3 不会投机,而是高并发下目标模型批处理已经把 GPU 利用率抬高,额外草稿开销更容易吃掉收益。块扩散草稿器的优势在于 drafting 本身更并行,DFlow 又进一步提高了每轮可提交 token 数。
消融实验说明 relay 才是主贡献
DFlow 还有一个容易被误读的地方:论文同时提出了 multi-round self-conditioned training。这个名字看起来像主要贡献在训练策略,但从消融看,真正拉开差距的是推理时使用 verifier information relay。
论文给出的消融表如下:
| 方法 | 推理时只用 mask | 推理时启用 relay |
|---|---|---|
| DFlash | 3.56 | - |
| DFlash + Self-Conditioning | 3.67 | - |
| DFlow | 3.66 | 3.93 |
只做多轮自条件学习、但推理时仍然每轮从 mask embedding 开始,平均接受长度从 3.56 到 3.67,提升很小。DFlow 模型如果关闭 relay,也只有 3.66。真正启用 relay 后才到 3.93。
这说明 multi-round self-conditioned training 更像是为推理态铺轨:草稿器必须在训练时见过“mask embedding 加上 verifier representation”的输入形态,否则上线后突然喂给它旧 verifier states,很可能分布错位。训练策略本身不是本文的推理加速主角,主角是跨轮次的验证器信息流。
论文里 rollout depth 取 ,也就是初始 mask prediction 后再展开两个 reject-conditioned rounds。这个选择可以理解为折中:展开太浅,草稿器见不到足够多的 relay 输入;展开太深,训练成本和轨迹偏差都会增加,而且很久以前的 rejected suffix 对当前未来位置的条件相关性也会变弱。
与 Domino 的关系:块内因果和跨轮信息不是一回事
DFlow 论文还专门检查了它与 Domino 的兼容性。Domino 解决的是另一个问题:块扩散草稿一次并行预测 个 token,块内后续 token 缺少前面 draft token 的因果依赖;Domino 加一个轻量 causal head,在不恢复昂贵自回归草稿的前提下补块内因果信息。
DFlow 解决的是跨轮问题:上一轮 verifier 已经在 rejected suffix 上算出连续表示,下一轮不要从纯 mask 开始。一个是 block 内部,一个是 speculative rounds 之间,所以理论上可以叠加。
论文在 Qwen3-1.7B、 上的结果是:
| 方法 | 平均接受长度 |
|---|---|
| DFlash | 3.56 |
| Domino | 4.02 |
| Domino + DFlow,不做 online rollout | 2.22 |
| Domino + DFlow,做 online rollout | 4.50 |
这里最刺眼的是 2.22。它说明 DFlow 不是一个可以随便外挂的后处理模块:如果 Domino 训练时用 teacher forcing 产生过于理想的后缀,再拿这些后缀构造 relay,训练时看到的 rejected suffix 会比推理时真实草稿路径乐观得多。上线后 relay 输入分布崩掉,接受长度反而大幅下降。
加入 online rollout 后,DFlow 用实际预测轨迹确定拒绝边界和 rejected suffix,训练态更接近推理态,Domino + DFlow 才能从 4.02 增加到 4.50。这一组结果给出的工程教训很实用:凡是复用 speculative artifacts 的方法,都必须认真处理 train-inference mismatch。投机执行产生的信息很香,但它来自一条可能错误的预测路径,不能用 teacher-forced 的理想路径来假装真实路径。
DFlow 适合放在推理栈的哪一层
从系统分层看,DFlow 位于草稿器和验证器之间,靠近 speculative decoding runtime,而不是底层 kernel 优化。
它不直接改变 FlashAttention、PagedAttention 或 KV Cache 分配方式,也不要求目标模型结构发生变化。它需要推理框架暴露目标模型验证阶段的中间层 hidden states,并允许草稿器下一轮输入不只是固定 mask embedding,而是按位置带一份额外条件表示。因此,DFlow 对框架的要求主要有三类:
| 需求 | 为什么需要 |
|---|---|
| verifier hidden states extraction | 从目标模型选定层取 rejected suffix 表示 |
| per-request relay metadata | 不同请求接受长度不同,重叠位置不同 |
| draft input customization | 下一轮对应位置要用 relay-enhanced mask input |
这解释了为什么论文要用 SGLang 做并发吞吐实验。投机解码方法最终不是只看单条样本的接受长度,还要放进连续批处理、动态请求到达、KV cache 管理和高并发调度里。DFlow 的 relay state 生命周期短、数据量小,天然比长期 KV 压缩或跨请求缓存更容易接入 serving runtime;但它依然要求框架在 verifier pass 后保留并传递一部分中间状态,不能把目标模型 forward 当作只返回 logits 的黑盒。
局限与适用边界
DFlow 的核心假设是:rejected suffix 的 verifier hidden states 即便来自错误分支,也仍然携带对未来 token 有用的连续信息。这个假设在论文实验中成立,但它不是无条件成立。
第一,任务越开放、采样温度越高,未来路径的不确定性越强,旧分支 hidden states 的可复用性越弱。论文中 仍有收益,但提升略低于 greedy decoding,这是符合直觉的。
第二,relay 的收益依赖 rejected suffix 与下一轮窗口的重叠。如果草稿器本身极强,经常一次接受接近 个 token,那么可复用的 rejected suffix 变短,DFlow 的额外信息来源自然减少。
第三,DFlow 要求拿到目标模型中间层 hidden states。很多高性能推理后端默认只保留最后 logits 和 KV Cache;为了 DFlow,需要在 verifier pass 中导出若干层、若干位置的表示。虽然论文报告 relay overhead 很低,但具体框架里 hidden state materialization、跨 kernel 数据布局和 batch 内 ragged positions 处理都可能带来额外工程成本。
第四,DFlow 主要改善 draft quality,不直接减少单次目标模型验证的计算量。它与稀疏注意力、KV Cache 量化、PagedAttention 这类技术互补:后者降低一次 forward 的内存或计算成本,DFlow 减少需要多少轮 forward。
小结
DFlow 最值得记住的不是“又一个投机解码方法”,而是它把投机解码里的 verifier pass 重新看了一遍。
传统流程里,目标模型验证完一块候选 token 后,只把 accepted prefix 和 bonus token 留下,其他都丢掉。DFlow 指出,被拒绝的离散 token 不能提交,但目标模型在 rejected suffix 上算出的 hidden states 仍然是有价值的连续表示。于是它把这些表示经过投影、shift、拒绝边界调制后,注入下一轮草稿器的 mask 输入,让下一轮不再从零恢复重叠未来位置。
实验结果也把贡献拆得很干净:多轮自条件学习本身只把平均接受长度从 3.56 拉到 3.67 左右;真正启用 verifier relay 后达到 3.93。额外开销只有 0.51 ms,约为 DFlash 的 1.2%,但在 Qwen3-1.7B、4B、8B 上分别带来 10.4%、13.2%、13.4% 的 greedy 平均接受长度提升。
它给推理系统设计的一条启发很明确:投机执行的中间产物不只是候选答案,也是对未来计算路径的一次探测。只要能保证最终 token 仍由目标模型验证,很多“被拒绝”的计算其实还可以继续流动。
参考资料
- DFlow: Enabling Verifier Information Flow in Block Diffusion Speculative Decoding
- DFlow arXiv HTML version
- DFlash: Block Diffusion for Flash Speculative Decoding
- Fast Inference from Transformers via Speculative Decoding
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
- Domino: Decoupling Causal Modeling from Autoregressive Drafting in Speculative Decoding
- SGLang: Efficient Execution of Structured Language Model Programs
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


