


S²-MoE 完全拆解:路由感知自适应扩展与复用感知门控,端侧 MoE 自投机解码提速最高 5.3 倍
投机解码(speculative decoding)把「一个 token 一步」变成「一串 token 一步」,混合专家(Mixture-of-Experts,MoE)模型把「每步算全部参数」变成「每步算几个专家」,两条路线各自都能在边缘设备上加速大模型推理。但把两者直接拼在一起,在内存带宽受限的边缘场景里却常常互相拖后腿:草稿 token 各自激活不同的专家,验证(verification)时专家参数被反复从显存外搬进搬出,拒绝掉的草稿更是白付了整组专家的传输代价——用论文里的一句原话,naïve 组合「可能抵消甚至逆转单独使用任一种技术带来的收益」。
S²-MoE(论文全名 “Enabling Efficient Self-Speculative Decoding for Mixture-of-Experts on Edge Devices”,缩写里的上标 2 即 Self-Speculative 一词首字母的双写)正是冲着这个矛盾去的。它由北京大学人工智能研究院与集成电路学院的研究者 Haochen Huang、Shengxuan Qiu、Meng Li 提出,2026 年 8 月 15 日投至 arXiv(编号 2608.15018,8 月 19 日更新 v2),代码以 MIT 协议开源在 GitHub,并完整集成进 llama.cpp。论文报告:在 NVIDIA Jetson Orin 上相比标准自回归解码(autoregressive decoding)取得 1.3 到 5.3 倍端到端加速(平均约 2.0 倍),在 RTX 4090 上取得 1.2 到 2.9 倍,覆盖 DeepSeek-V2-Lite、OLMoE、Qwen3-30B-A3B、GPT-OSS-120B 四个 MoE 模型家族。
这篇文章按「问题 → 动机观察 → 三大机制 → 系统实现 → 实验」的顺序把 S²-MoE 完整拆开:吞吐公式的两条杠杆、路由感知的自适应投机扩展(routing-aware adaptive speculative expansion)、复用感知的专家门控(reuse-aware expert gating)、上下文对齐的自投机解码(context-aligned self-speculative decoding),以及 llama.cpp 里的专家级卸载(expert-level offloading)是怎么落地的。
背景:边缘推理的两条加速杠杆为什么互相打架
先建立度量框架。边缘设备(Jetson Orin、单张 RTX 4090 这类)上推理的典型形态是单用户、小批量(batch 1 到 2),算力往往不是瓶颈——批量太小,GPU 的 FLOPS 根本喂不饱。真正的瓶颈是内存带宽(memory bandwidth):每个生成步都要把模型权重从 DRAM(统一内存设备的系统内存或 SSD 更下层)搬到计算单元,搬多少、多久搬一次,决定了吞吐的上限。
论文把每步吞吐写成如下分解(式 1):
其中 Output Density(输出密度)是每个迭代产出的 token 数,Parameter Density(参数密度)是每个迭代访问的模型参数字节数,BW 是内存带宽。两边都除以单位时间后,这其实就是一个恒等式:单位时间产出的 token 数 = 单位时间内能搬的字节数 ÷ 每个 token 平均要搬的字节数。它把两条优化路线说得非常清楚:
- 投机解码提升分子(Output Density)。用一个轻量草稿模型(draft model)先快速生成 k 个候选 token,再用目标模型(target model)并行验证、一次性确认其中尽可能长的一段,让一个迭代产出多个 token。对稠密模型来说这几乎稳赚:验证时所有草稿 token 共享同一套权重,参数搬运量不随 token 数增长,等于用一份带宽换了多个 token。
- MoE 缩小分母(Parameter Density)。MoE 每层放着 E 个并行的专家 FFN,每个 token 只经过路由器(router/gate)选出的 top-k 个专家,参数访问量因此从「全层」降到「每层 k 个专家」。模型总参数量可以很大,但每个 token 实际读的权重只有一小部分。
问题出在二者叠加时,分母悄悄变大。投机解码的收益前提是「验证阶段的参数复用」(parameter reuse):一批草稿 token 同时过目标模型时,它们消费的是同一份权重。稠密模型天然满足这一点(图 1a、1b),MoE 模型却不满足:一批草稿 token 的 top-k 专家集合彼此错开,验证这批 token 需要把各组专家全部搬进来,被拒绝的草稿 token 触发的那些专家搬运与计算就完全浪费了。
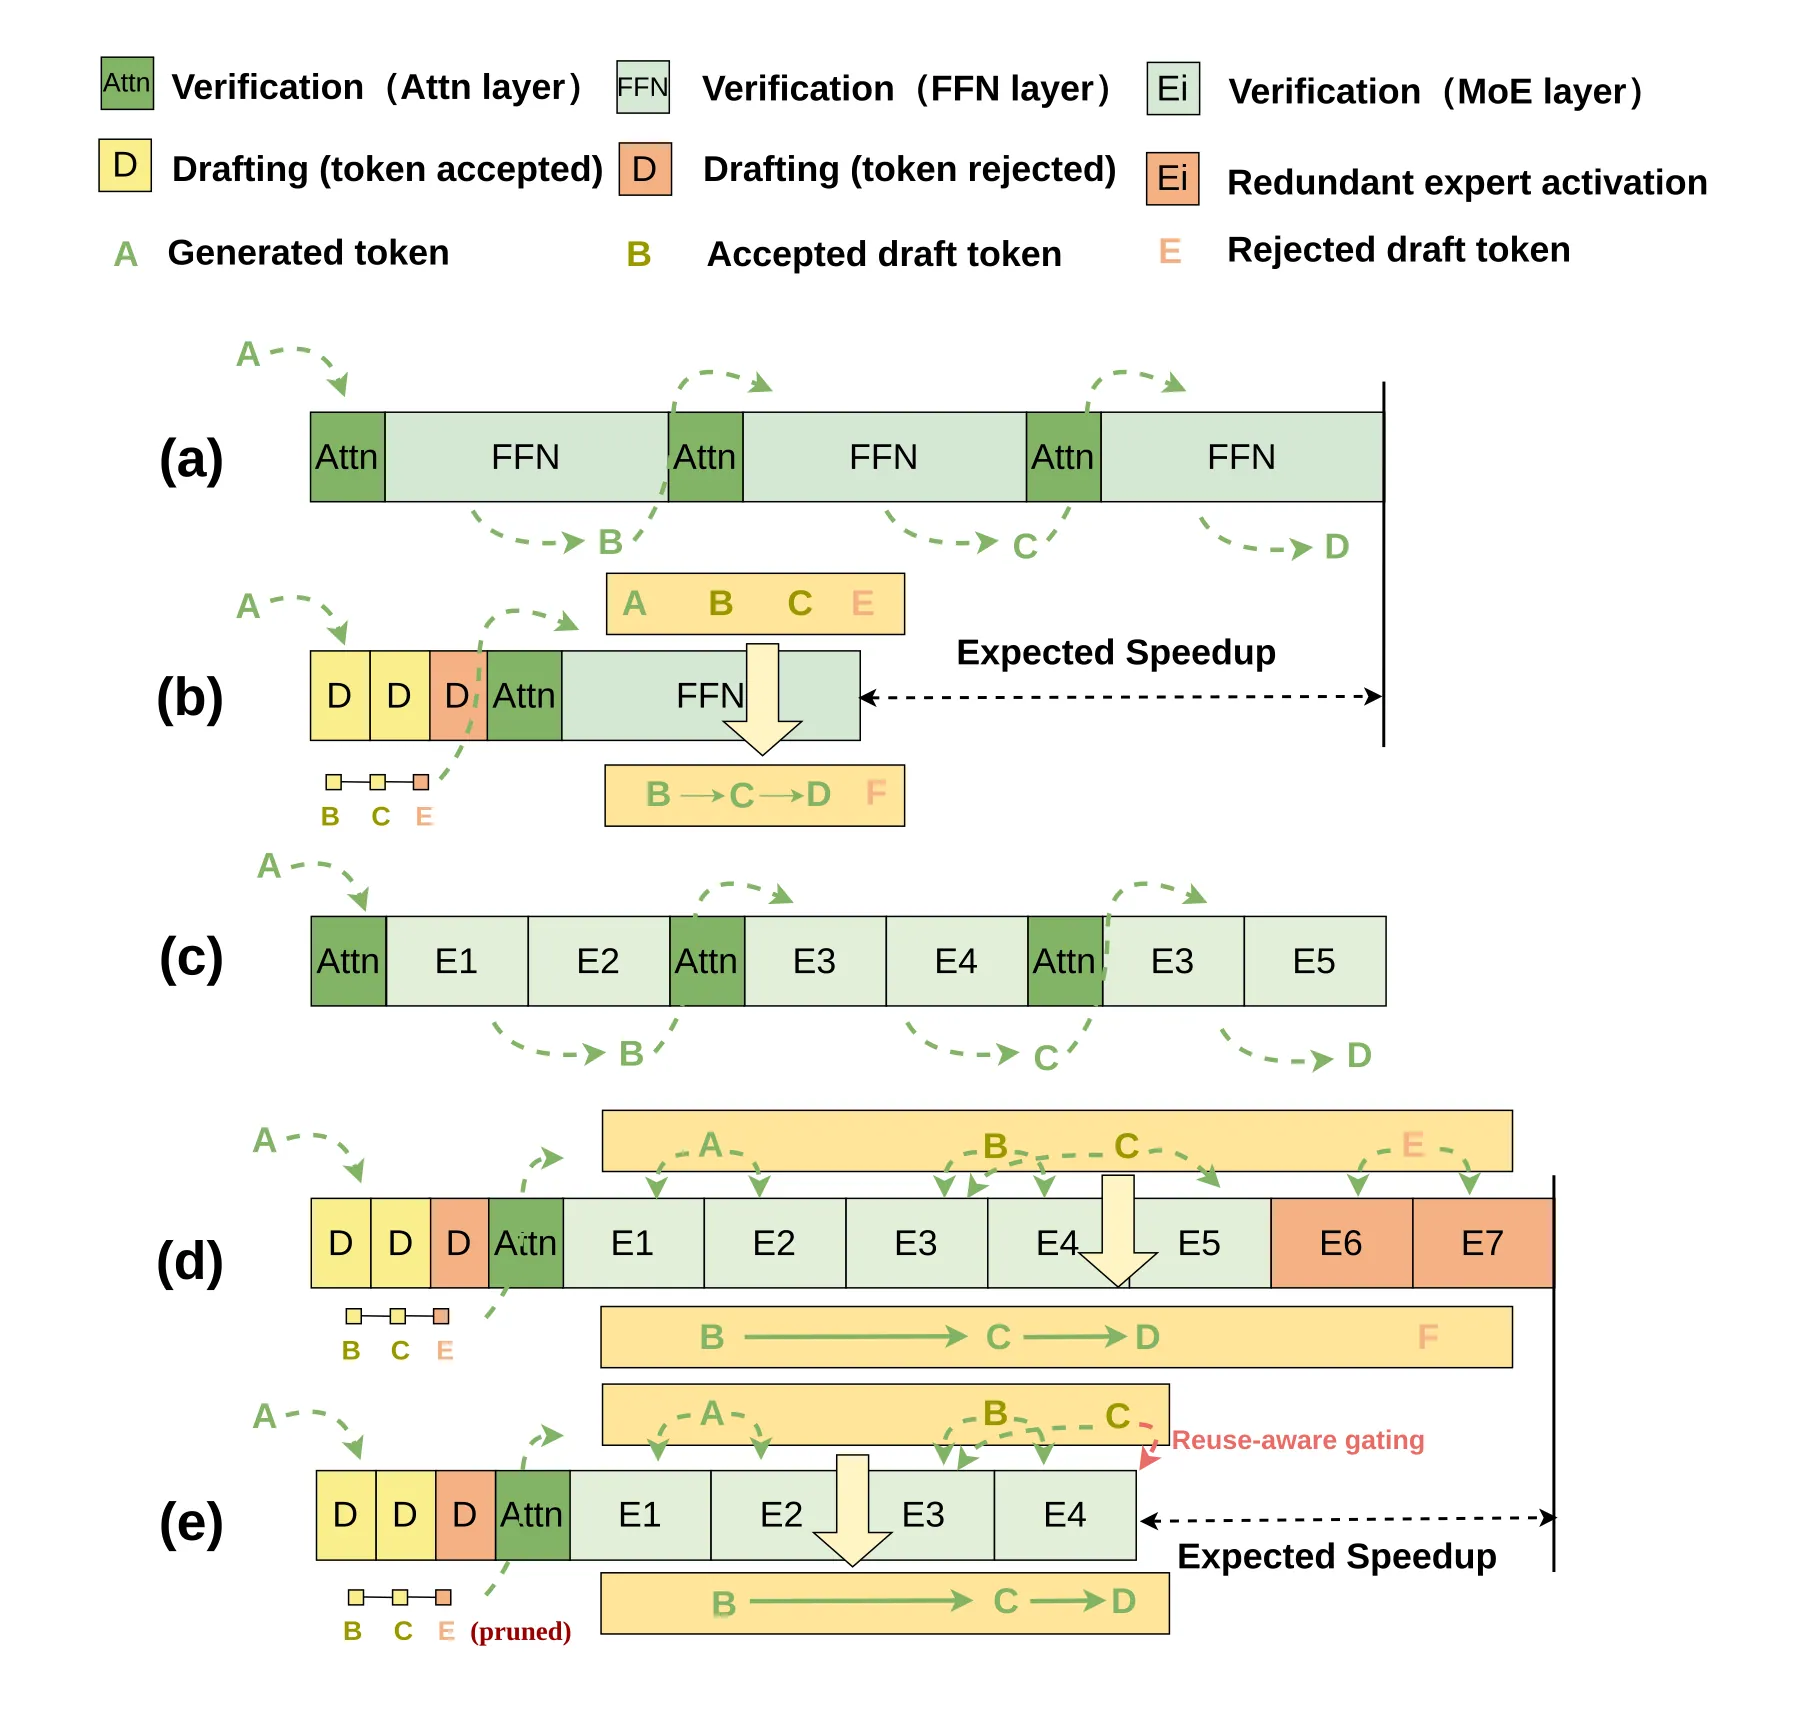
图 1 把四种情形画在一起:(a) 稠密模型自回归——每步一个 token、全量权重;(b) 稠密模型上做投机解码——草稿 token 可以高效并行验证,因为参数在 token 之间完全复用;(c) MoE 模型自回归——每 token 只碰一组专家,参数密度低;(d) MoE 模型上朴素投机解码——草稿 token 激活了互不相同的专家,验证时参数复用差、成本高;(e) S²-MoE 想达到的状态——既保留投机解码的多 token 并行,又把冗余验证和专家搬运压下去。
既有路线为什么在 MoE 上不好用
为了说清 S²-MoE 的位置,把现有的「SD × MoE」尝试按草稿来源分成三类:
第一类:外置草稿模型(external draft model),典型代表是 EAGLE-3。它给目标模型额外训练一个轻量自回归头/编码器来生成草稿。问题是 MoE 每 token 本来只激活少量参数,留给「再砍出一个更轻的草稿」的空间很小,外置草稿很难同时做到轻量又和目标行为对齐;而且 EAGLE-3 类方法必须针对每个模型家族训练草稿模块(论文实验里用的是各自官方发布或社区训练的 EAGLE-3 checkpoint),预测质量高度依赖训练数据与目标模型家族的匹配度,在 MoE 上效果很不稳定。
第二类:自投机解码(self-speculative decoding),不引入外部草稿,直接从目标模型自身「简化」出一个草稿。常见简化手段有三:量化(quantization)、专家稀疏(expert sparsity,每 token 只激活比目标更少的专家)、层稀疏(layer sparsity,跳过一部分层或提前退出)。这构成一条权衡谱系:简化得越狠,草稿执行越便宜,但预测保真度(fidelity)越差、接受率(acceptance rate)越低。S²-MoE 属于这一类,草稿取「专家稀疏」,必要时再叠加量化。
第三类:面向 MoE 的投机策略调度,代表是 Cascade(论文全名 “Utility-Driven Speculative Decoding for Mixture-of-Experts”)。这类方法观察到投机解码在 MoE 上并非总是划算,于是用历史效用信号(utility signal)决定「这次要不要投机、投机多长」。它们的判断依据是过去的收益统计,而 MoE 的路由本身高度不稳定,历史信号容易失真,无法稳定地改善投机效率。另有大量工作在系统层面用投机预测专家激活来做专家预取(prefetching)与卸载调度,但论文指出这些工作不触及验证本身「专家激活发散」的内在低效。
S²-MoE 的主张是:自投机解码提供的行为对齐(草稿与目标同源,预测天然更接近)是正确起点,但只有同时解决三个具体问题,这条路在 MoE 上才真正走得通——论文把这三点称为三个挑战,每一条都配有数据观察。
动机剖析:三个挑战与三个机会
挑战一:低保真草稿下的冗余验证(redundant verification)。在 MoE 里,验证每个草稿 token 都可能激活额外的专家,产生不可忽视的参数访问。当草稿 token 最终被拒绝时,这些激活就变成纯浪费。论文在 DeepSeekMoE(Natural Questions 任务)上按层统计验证成本,图 2(a) 显示相当大的成本花在「被拒绝 token 触发的专家」上。更麻烦的是,仅凭置信度剪枝很难剔除这些浪费:图 2(b) 显示保留下来的草稿 token 置信度高度集中在 1.0 附近,几乎失去区分度;而图 2(c) 显示,即使置信度相近的 token,由于专家激活模式不同,验证成本也可以差出好几个量级——两个候选「看起来都很有把握」,一个激活的是已在显存里的专家,另一个要把一整套新专家搬进来。
机会一恰恰藏在路由信号里:图 2(d) 显示,草稿阶段的门控路由对目标阶段路由的预测准确率在多数层都很高(横轴是不同草稿深度)。也就是说验证成本在验证发生之前就能以相当高的精度预估——这为「按成本做自适应决策」提供了依据。
挑战二:专家激活发散导致的参数复用不足。稠密模型里相邻 token 消费同一份参数;MoE 里相邻 token 常被路由到不同专家。论文定义了复用率(reuse ratio):对一个长度为 s 的 token 区间,记区间内并行验证时实际激活的不同专家数为 ,除以同一区间自回归解码的专家激活次数(s 个 token 各激活 k 个,即 ):
复用率越小代表跨 token 专家复用越强;理想情况下区间内所有 token 共用同一组 k 个专家,比率趋近 ,退化成稠密式的参数复用。图 2(e) 显示在不同区间长度下、各层的复用率都居高不下;图 2(f) 则揭示了一个可以利用的结构:MoE 的专家重要性高度偏斜,头部少数专家拿走了绝大部分门控分数,而 top-1 之外的大量候选专家分数彼此接近——它们功能上是冗余的。这意味着一件事:把某些 token 从「略低分的冷专家」改选到「已被其他草稿 token 激活的热专家」上,代价只是微小的门控分数损失。
挑战三:轻量草稿的保真度在长生成中衰减。即使自投机草稿与目标同源,专家稀疏截断仍会引入预测误差。如果草稿维护一份独立上下文(用自己的历史 hidden state 继续推),误差会随解码步累积、逐步漂移。图 2(g) 画出了草稿与目标分布之间的 KL 散度随解码步的变化:独立上下文时 KL 快速上升,共享上下文后发散被显著压制——长上下文生成中,接受率崩掉的根源在这里。
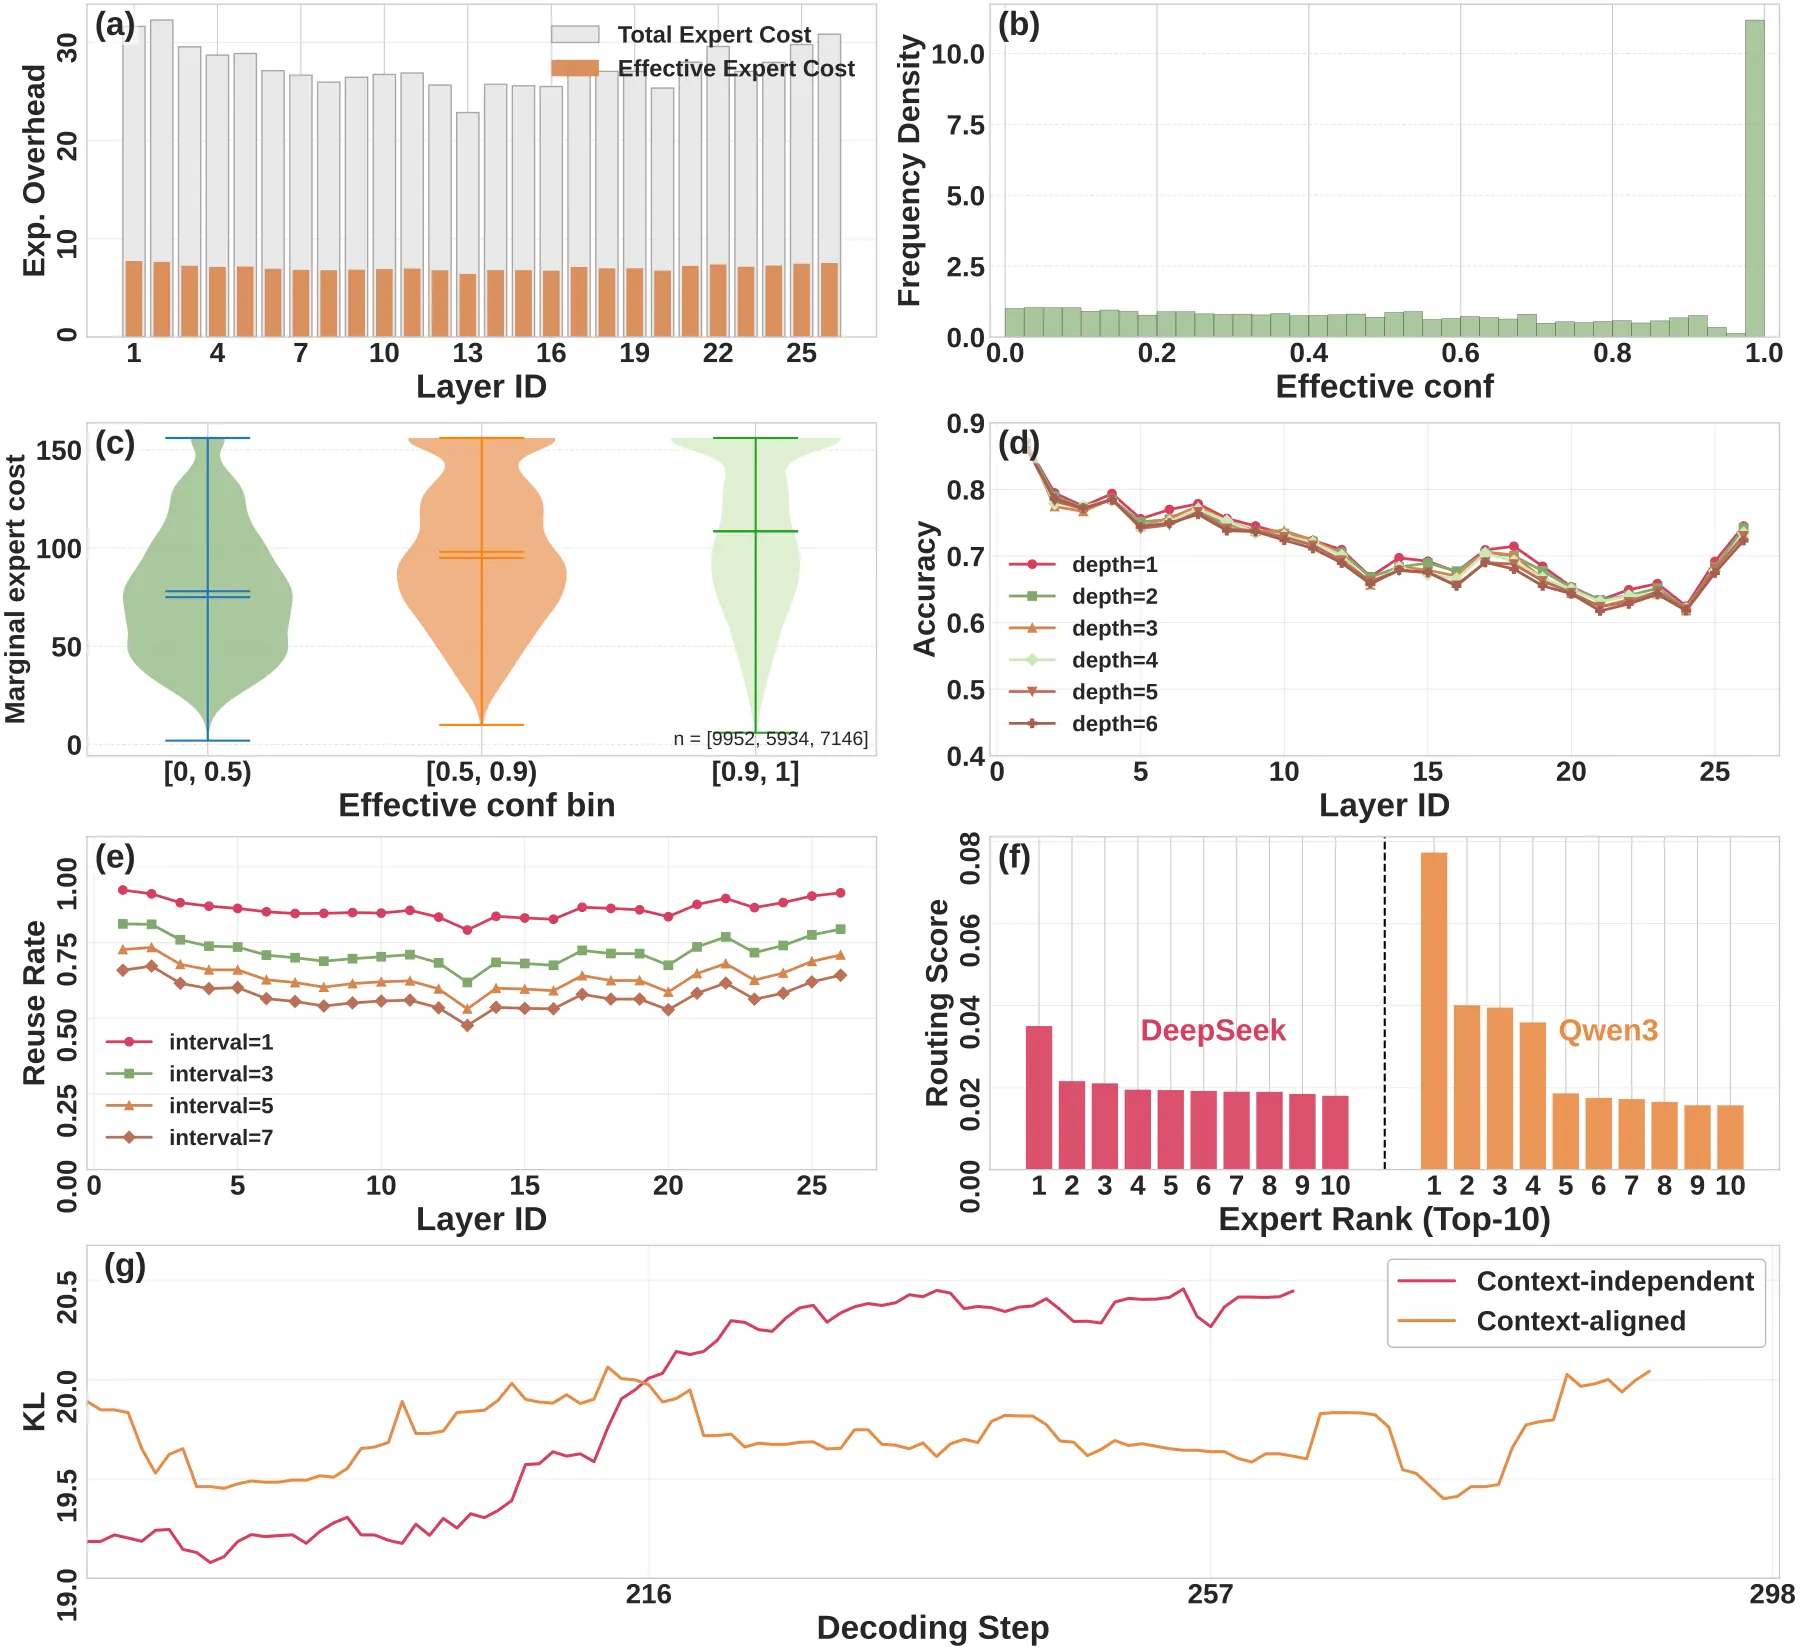
图 2 的七个面板就是全文的论证骨架:(a)-(c) 论证「验证成本必须进决策」,(d) 论证「成本确实可预估」,(e)(f) 论证「专家集合可以被引导」,(g) 论证「草稿上下文必须与目标对齐」。S²-MoE 的三个组件逐一对应这三个挑战。
系统总览:三个组件如何咬合
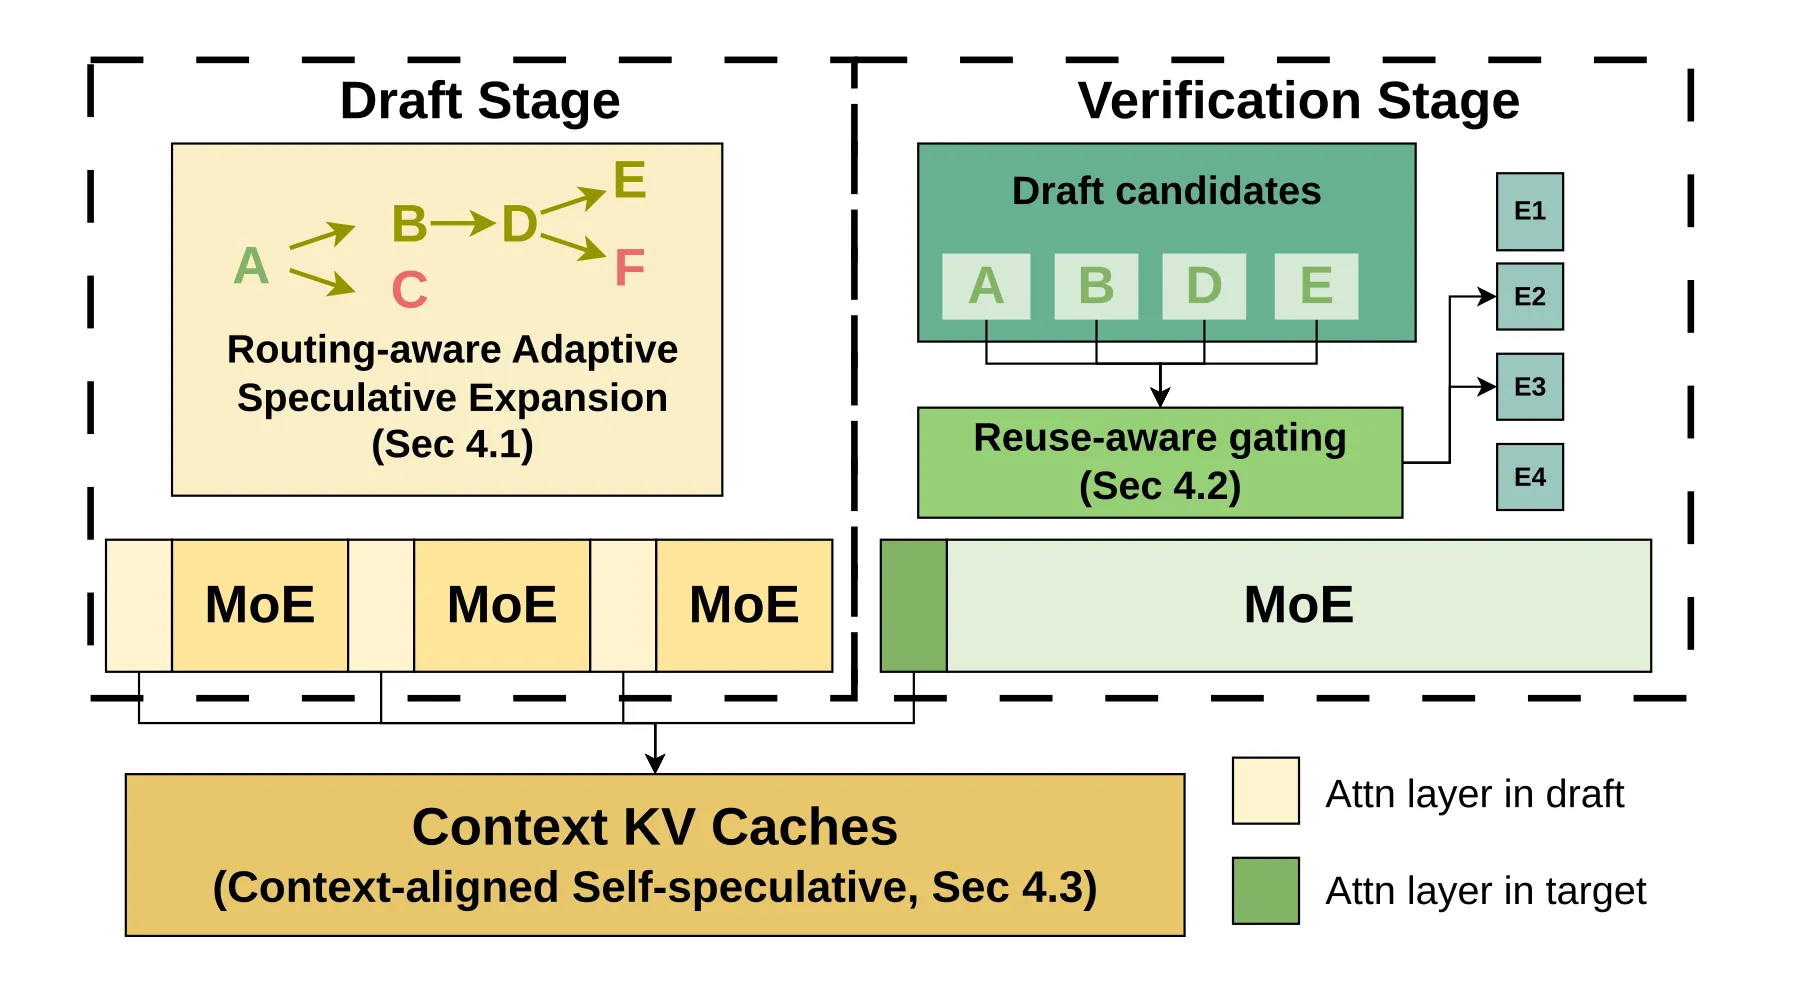
图 3 是全文最核心的一张图,把解码循环画成了一条流水线,自上而下可以这样读:
- 目标模型以标准自回归方式推进,维护权威 KV Cache(键值缓存);
- 每个迭代末尾,从当前上下文出发,用目标模型的专家稀疏版本充当草稿(draft),多步生成候选 token;
- 每产生一个候选,路由感知的自适应扩展机制用「期望收益 ÷ 边际验证成本」的效用分数(utility score)决定要不要继续扩展——这是对「草稿多长」的运行时决策;
- 候选集确定后,目标模型做一次并行验证;验证前,复用感知的专家门控对这批 token 的门控 logits 施加一个受控的软偏置(soft bias),把各 token 的专家选择往「已被高频激活的专家」上拢;
- 验证只接受与目标分布一致的 token,被接受 token 的 KV 才提交进共享缓存,草稿阶段产生的临时 KV 一律回滚。
三个组件分别回答:扩展几个候选(路由感知扩展)、验证时激活哪些专家(复用感知门控)、草稿基于什么上下文(上下文对齐共享 KV)。下面逐一把机制和公式拆开。
组件一:路由感知的自适应投机扩展
投机解码的传统做法是固定草稿长度,或用置信度(confidence)剪枝决定草稿树扩展到哪。EAGLE-3 就是置信度驱动的代表:展开候选分支时,只要分支的预测置信度够高就继续。论文指出这套规则在稠密模型上合理,在 MoE 上却错位了——置信度衡量的是「接受的可能性」,而 MoE 的验证成本取决于「激活哪些专家」。两个置信度几乎相同的候选,验证成本可能天差地别。于是他们把决策变量从「置信度」换成「效用」:期望收益对期望成本之比。
期望收益:前缀置信度 × 单步自回归延迟
对深度 k 处的候选 token i,它要被接受,前提是路径上所有祖先 token 都被接受。沿用投机解码的惯例,用前缀置信度(prefix confidence)估计其接受概率:
即路径上每个 token 置信度的连乘。若 token i 被接受,它为主模型省下了一步自回归解码,期望收益就是接受概率乘以一步自回归的平均延迟 :
可以通过轻量运行时测量或离线 profiling 得到,对目标模型是常数。
路由感知的成本估计:新引入几个专家是关键
扩展 token i 的成本分两部分:草稿侧生成其后代的成本 ,以及目标模型验证它带来的验证成本。稠密模型的验证成本几乎不随草稿 token 数增长(权重只搬一遍),MoE 却随 token 数显著增长——每多一个待验证 token,就可能多激活一组新专家。记 为草稿阶段预测的 token i 的专家集合,S 为已经选入扩展的草稿 token 集合,则加入 token i 的边际验证成本为:
其中 是「多引入一个专家」对应的延迟——它把专家搬运与执行合并成一个硬件校准过的延迟单位,通过轻量运行时测量或离线 profiling 获得。直觉上这个式子就是数「新面孔」:token i 的专家集合里,有多少个是前面已经选中的 token 没有激活过的,每一个新专家按 计价。于是总扩展成本:
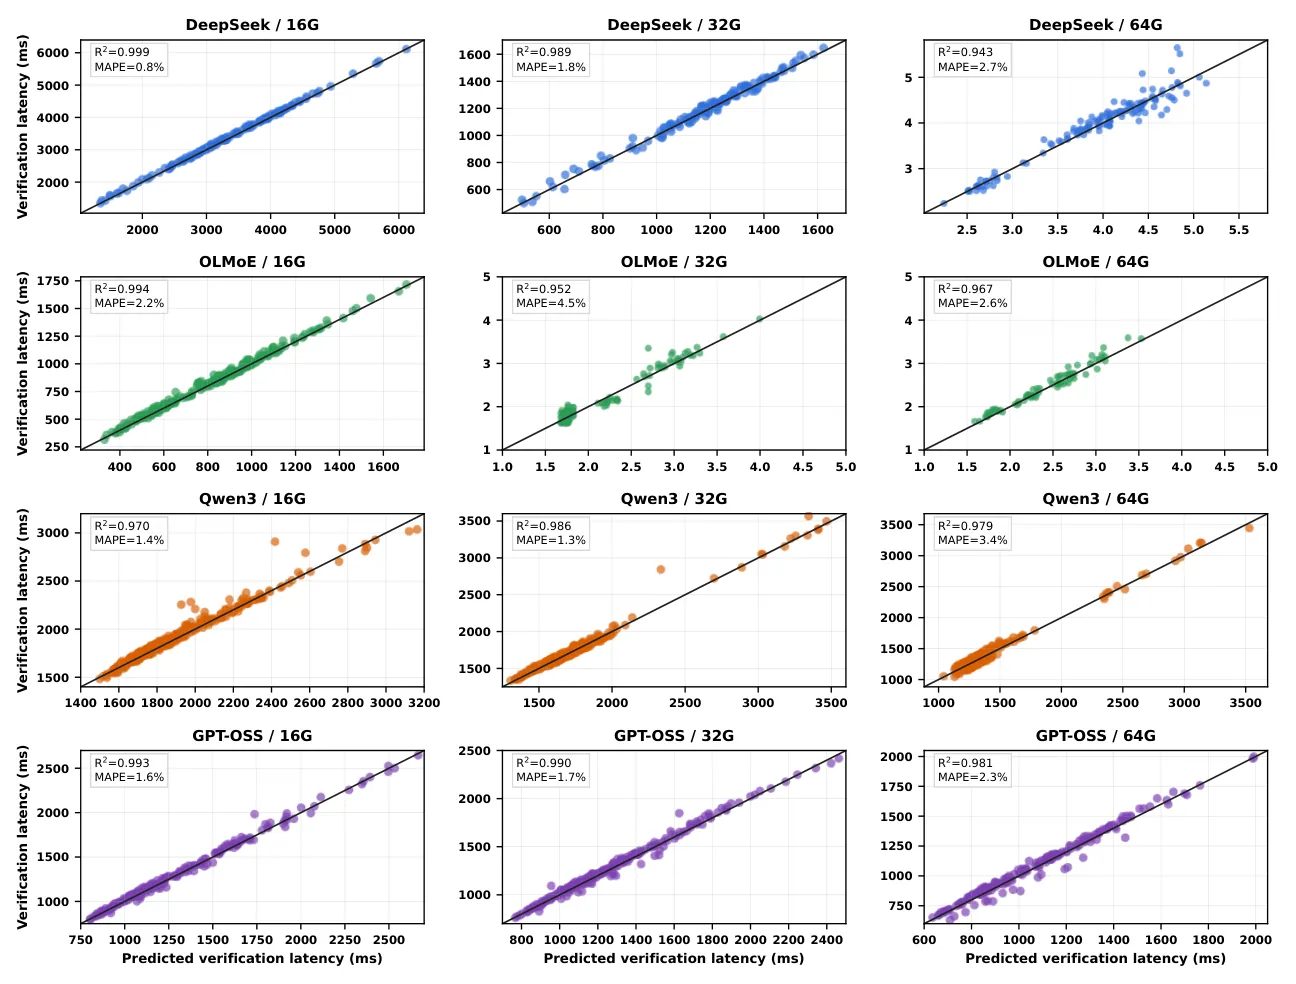
这个估计完全建立在草稿阶段的路由信号上——它在验证之前就可获得,且与目标路由高度相关(图 2(d) 的机会一)。论文把成本模型与实测验证延迟做了对照(图 6):跨模型、跨显存预算,拟合优度 达到 0.943–0.999,平均绝对百分比误差(MAPE)只有 0.8%–4.5%,说明这套「数新专家」的模型确实抓住了 MoE 验证开销的主项。
自适应扩展:效用 ≥ 1 才继续
把收益和成本合起来,候选 token 的效用定义为:
投机扩展按贪心进行:按草稿生成顺序逐个考察候选,只要 (期望收益不低于期望成本)就把它选入扩展集,直到没有候选满足条件为止。效用低于 1 的候选要么接受概率太低,要么会引入太多新专家——两种情况都会让「多走这一步」得不偿失,直接剪掉。
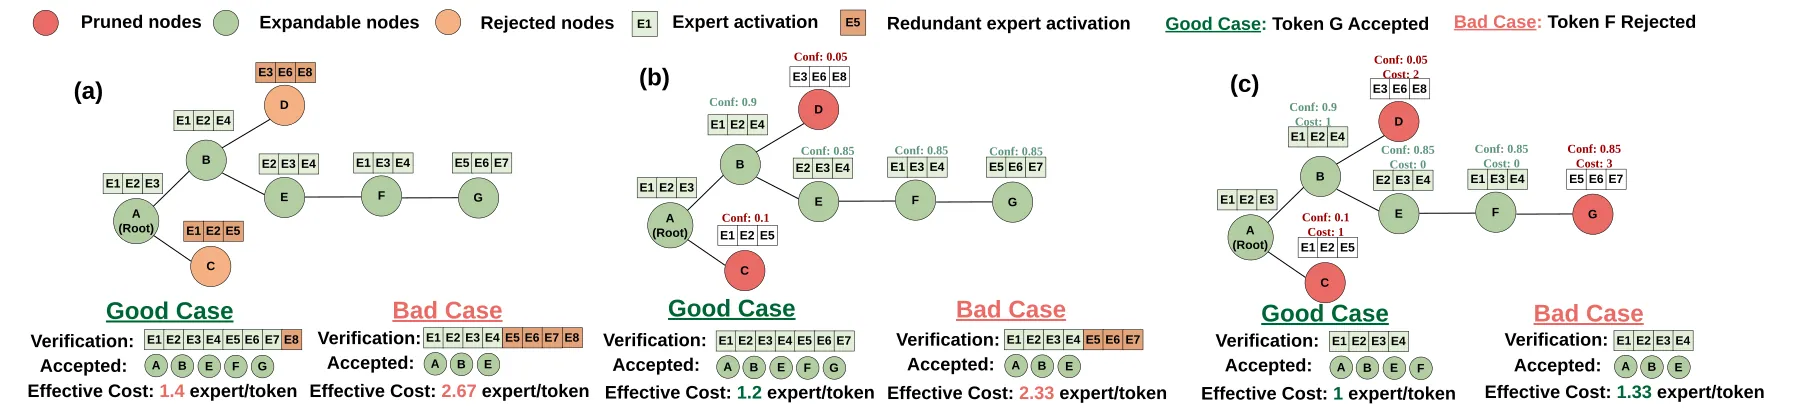
图 4 对比了三种策略在两类验收结果下的表现:(a) 无剪枝扩展把所有候选都送进验证,大量专家激活是冗余的;(b) 置信度剪枝能砍掉明显低质的分支,但它对「专家级验证成本」是盲的,仍可能留下高成本候选;(c) S²-MoE 的效用扩展同时权衡接受概率与边际专家成本,优先保留「接受-成本比」好的候选。图右半的「坏情况」(Bad Case,接受结果不利)尤其能说明问题:效用分数同时惩罚「低置信」与「高成本」两类候选,即使前面的 token 被拒、后续候选连带作废,冗余专家激活也被限制在较低水平——这是纯置信度方法做不到的。
这里有个 MoE 特有的精细点值得展开:为什么置信度剪枝的阈值很难调?在图 2(b) 中,被保留的高置信 token 全都挤在 1.0 附近,剪枝阈值稍微一动,要么放进来一堆高风险候选,要么把好候选也误杀了;而效用分数把「风险」替换成了可校准的「专家搬运延迟」,两种候选即使置信度相同,只要一个复用已激活专家、一个引入新专家,效用就会拉开差距,决策边界自动落在「收益恰好覆盖成本」的位置。论文实验(图 9,见实验节)进一步显示:与置信度剪枝相比,效用扩展在「接受长度 × 验证效率」的权衡平面上严格更优——同样的接受长度下验证成本更低,或同样的验证成本下接受更长。
组件二:复用感知的专家门控
自适应扩展控制了「验证哪些候选」,但没解决「验证时激活哪些专家」——即使候选集已经收敛,各 token 的 top-k 专家依然可能互相错开。组件二从路由本身下手:既然图 2(f) 表明 top-1 之外存在大量分数相近、功能冗余的专家,那就允许验证阶段的门控「小幅改选」,把一批草稿 token 的专家选择往共同集合上引导。
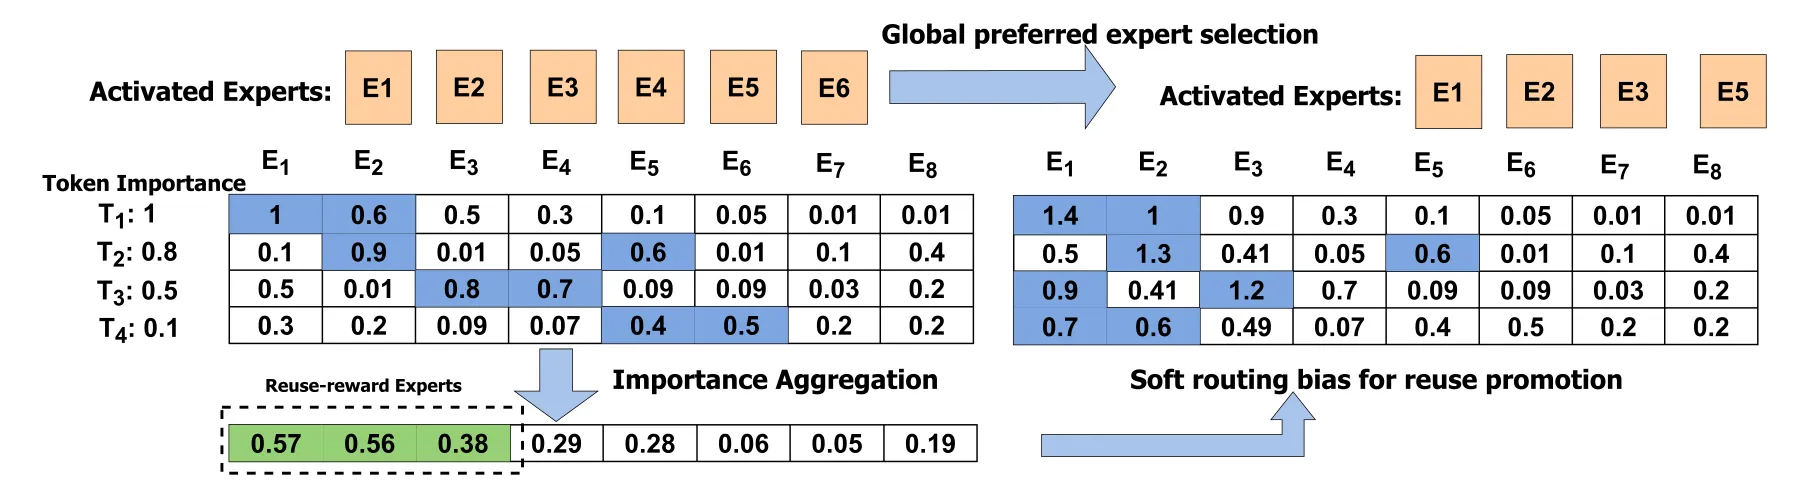
图 5 是论文给的一个 top-2 路由的小例子,先看它再读公式:8 个专家、4 个草稿 token(T1–T4,置信度不同,各自要选 2 个专家)。朴素验证下这 4 个 token 一共激活 6 个不同专家;S²-MoE 先按 token 置信度加权聚合出专家重要性,挑出 E1–E3 这组「复用奖励专家」,再对每个 token 的门控 logits 加一个小偏置。结果是验证阶段实际激活的不同专家从 6 个降到 4 个,而高置信的 T1、T2 几乎保持原选择(它们最可能被接受,要保住质量),低置信的 T4 被推向复用集合(它大概率被拒绝,省下它的冷专家搬运最划算)。
门控机制分三步,与图 5 一一对应:
第一步:跨 token 的专家重要性聚合。 草稿 token 被接受的概率不同:高置信 token 大概率通过验证,应尽量保留其原始专家偏好;低置信 token 大概率被拒,它们的激活主要构成冗余计算。为此给每个 token 一个非负的置信权重 (由其 token 级置信度导出)。对候选集合 ,设 token b 的目标门控 logits(验证时由目标模型门控产生,是现成的)为 ,则专家 e 的跨 token 重要性为:
度量的是「专家 e 被『更可能被接受』的草稿 token 偏好的强度」——置信度高的 token 在聚合里说话更响。
第二步:全局优选专家集合。 为避免过度集中、破坏原始 top-k 路由结构,偏置只施加在一个有界集合上:
即按 取前 cap 个专家作为全局优选集合,cap 不小于 k——所有原本够格进 top-k 的专家仍然可选,偏置的「势力范围」被限制住。
第三步:软路由偏置。 对每个草稿 token b,向门控 logits 注入加性偏置:
不是常数,它按 token b 的分数分布自适应设定:正比于「top-1 专家分数与第 k+1 名专家分数的差」。这个差本质上是「挤进 top-k 需要跨过的门槛余量」——门槛余量大的 token,其路由决策很稳,给多大的偏置都不会改写它的选择;余量小的 token 处于边缘地带,一点偏置就足以把它从冷专家挪到复用集合。于是偏置自动获得两个性质:强偏好的专家相对排序几乎不变(图 5 中 T1、T2 原封不动),只有 top-k 边界附近的专家可能被改写(T4 被推过去)。门控分数在推理时本来就要算,全部信号现成可得,不需要任何训练。
论文点出了这个设计在系统层面的一条推论:偏置只可能把 token 改选到「其他 token 已经选中的专家」上,因此实际发生的验证成本不会超过组件一中按原始草稿路由估计的成本——成本模型给出的估计是保守的(conservative),自适应扩展的剪枝决策不会被门控改动悄悄破坏。
三个细节值得补充:
- 为什么是软偏置而不是硬重路由? 硬性把低置信 token 的专家改成 E*,会引入门控分数之外的不可控偏差;软偏置保留了「如果 E* 专家的原始分数实在太低就仍不选」的可能,偏差幅度有界、可度量。论文把这种状态准确地称为「受控的目标路由近似」而非无损变换——正因为不是严格无损,质量影响才需要单独实验验证(见实验节)。
- 实现开销:聚合、选 TopCap、加偏置合成一个轻量融合 CUDA kernel(fused kernel),在投机解码流程里开销可忽略。
- 与草稿的关系:门控作用在目标验证阶段,草稿阶段不需要这套偏置——草稿仍按自己的门控选专家,保持探索的多样性。
论文在 DeepSeek 上测了门控对复用率的影响:HumanEval 上复用率从 0.6017 降到 0.4453(改善约 26%),GSM8K 上从 0.5893 降到 0.3943(改善约 33%),验证了「把专家选择往一起拢」确实降低了参数搬运(数据见论文表 4)。
组件三:上下文对齐的自投机解码
第三个组件处理的是自投机解码特有的慢性病:误差累积。草稿是目标模型的专家稀疏截断版,每步预测都有小误差;如果草稿像独立模型一样维护自己的上下文历史,它下一步是在「自己犯过错的状态」上继续推,误差逐迭代滚雪球。图 2(g) 里独立上下文的 KL 散度曲线就是雪球的样子。
上下文对齐的设计极简:草稿与目标共享同一个 KV Cache。流程是:
- 目标模型先处理 prompt,建立 KV Cache(权威上下文);
- 投机迭代中,草稿直接读这份共享上下文,不另开一份历史;
- 草稿向前扩展时产生的新 token 会临时写入 KV,但这些写入被标记为临时;
- 目标模型做验证前,草稿的临时 KV 全部回滚;
- 验证通过、被正式接受的 token,其 KV(由目标模型计算)才提交进共享缓存,成为下一轮草稿的上下文。
关键在语义上:草稿每一轮看到的都是「上一轮验证确认过的真实上下文」,而不是自己虚构的历史;误差被限制在单次投机迭代内部,跨迭代不累积。同时正确性不受影响——验证用的是目标自己算的 KV,草稿的近似 KV 从未污染权威状态。
论文量化了这个组件的价值(表 3):DeepSeek 上 HumanEval 接受率从 43.01% 提到 52.91%(+23.0%),GSM8K 从 36.08% 提到 48.71%(+35.0%);OLMoE 上 HumanEval 从 32.46% 提到 40.31%(+24.2%),GSM8K 从 33.01% 提到 59.09%(+79.0%)。推理类任务(GSM8K)提升尤其显著,符合直觉——长链条推理正是逐迭代误差累积的重灾区。
系统实现:llama.cpp 里的专家级卸载
S²-MoE 选择在 llama.cpp 上落地而不是自己写推理引擎,理由很实际:边缘部署的生态、GGUF 模型格式、CUDA 后端都在这里,且仓库要提供可直接复现的评测路径。真正的工程改造点在内存管理。
为什么 llama.cpp 原生卸载粒度不够。 llama.cpp 原生支持按层(layer-level)的参数卸载,但这个粒度对 MoE 是错配的:推理时每一层都会被访问(attention、路由都在层里),每层里却只有少数专家被激活;按层卸载意味着「整层搬进来、只用几个专家」,白白搬运非激活专家的权重。S²-MoE 实现了专家级卸载(expert-level offloading):
- 非专家参数(embedding、attention、门控、shared expert)与常用专家常驻显存;
- 单个专家参数按需动态取回(on demand);
- 显存有余量时,用离线 profiling 统计出高频激活专家列表(hot experts),优先让它们常驻;
- 两种平台分别适配:Jetson Orin 是 CPU/GPU 统一内存架构,超出的参数卸载到 SSD 这类下层存储;RTX 4090 是分离的 CPU/GPU 内存,冷专家卸载到 CPU 内存、按需拷贝上卡。
论文说明这套卸载与既有的「专家预取/缓存」类工作是正交关系:预取类方法的最优工作区间是缓存命中率高的场景,等价于显存宽松配置,论文显式评测了这类配置(如 64 GB 预算);而 S²-MoE 的贡献在投机解码本身。
草稿配置。 草稿用专家稀疏构造:每 token 激活的专家数远少于目标(四模型配置见表 1),必要时再叠加量化以进一步压缩草稿的权重搬运。基线方法的草稿长度固定为 8、宽度(每层候选数)固定为 2;S²-MoE 不设固定宽度,扩展完全由效用分数在运行时决定(仓库运行示例里的草稿预算同样配置为 8)。
仓库提供了 Jetson(orin 分支,CUDA arch 87)与 RTX 4090(4090 分支,arch 89)两条可复现路径,典型的 SSD 卸载运行长这样(示意,完整参数见仓库):
./build/bin/llama-speculative \ -m "$TARGET" --model-draft "$TARGET" \ # 自草稿:目标模型本身 --ssd-moe --hot-experts "$HOT" \ # 专家级 SSD 卸载 + 常驻专家列表 --draft-share-kv \ # 共享 KV(组件三) --draft-expert-topk 2 \ # 草稿每 token 激活 2 个专家 --moe-reuse-strength 0 --moe-reuse-expert-cap 18 \ # 复用门控(组件二) --prune-score-thresh 1 \ # 效用阈值:U >= 1 才扩展(组件一) --prune-beta 0.8 --prune-gamma 2 --prune-lambda 1 \ --prune-tpot 100 --prune-eps 7.5 \ --prune-expert-bytes 0.571875 --prune-bandwidth 3.66参数里能直接看到三个组件的影子:--draft-expert-topk 控制草稿稀疏度,--moe-reuse-expert-cap 是门控的 cap,--prune-score-thresh 1 正是效用分数 ≥ 1 的扩展判据;--prune-expert-bytes、--prune-bandwidth 则是成本模型里专家字节数与搬运带宽的标定值(上例是按 OLMoE/Orin profiling 出的代表配置,换硬件需重新标定)。
实验评估
设置
模型覆盖四个跨代际的 MoE 家族,从轻量到大规模:
| 模型 | 总参数 (B) | 激活参数 (B) | 专家总数 | 每 token 专家 | 门控 cap | 草稿 top-k |
|---|---|---|---|---|---|---|
| OLMoE-1B-7B | 6.7 | 1.1 | 64 | 8 | 18 | 2 |
| DeepSeek-V2-Lite | 15.3 | 1.35 | 64 | 6 | 16 | 1 |
| Qwen3-30B-A3B | 30.5 | 3.3 | 128 | 8 | 14 | 3 |
| GPT-OSS-120B | 116.8 | 5.7 | 128 | 4 | 6 | 1 |
(参数量为论文表 1 口径。)可以看到草稿 top-k 只有目标的 1/4 到 1/6:DeepSeek 每 token 只激活 1 个专家当草稿,GPT-OSS 也是 1 对 4。cap 取在 1.5 到 2.5 倍 top-k 的中等区间(OLMoE 2.25 倍、DeepSeek 2.7 倍、Qwen3 1.75 倍、GPT-OSS 1.5 倍),与敏感性实验的结论一致。
任务沿用 Spec-Bench 与 EAGLE-3 评测体系:多轮对话(MT)、检索增强生成(RG)、摘要(SU)、翻译(TR)、问答(QA)、数学推理(MA)、代码生成(HumanEval,HE)七类,所有方法用相同投机超参数保证公平。硬件是 Jetson Orin NX 16GB、AGX Orin 32GB/64GB 与 RTX 4090(冷专家进 CPU 内存)。基线五条:标准自回归(Auto)、专家稀疏自投机(ES)、层稀疏自投机(LS,用贝叶斯优化选跳层,只在 DeepSeek/OLMoE 上正式评估)、EAGLE-3(官方 checkpoint)、Cascade(其实例化在 EAGLE-3 之上)。
端到端效率:宽内存预算扫描下的全面领先
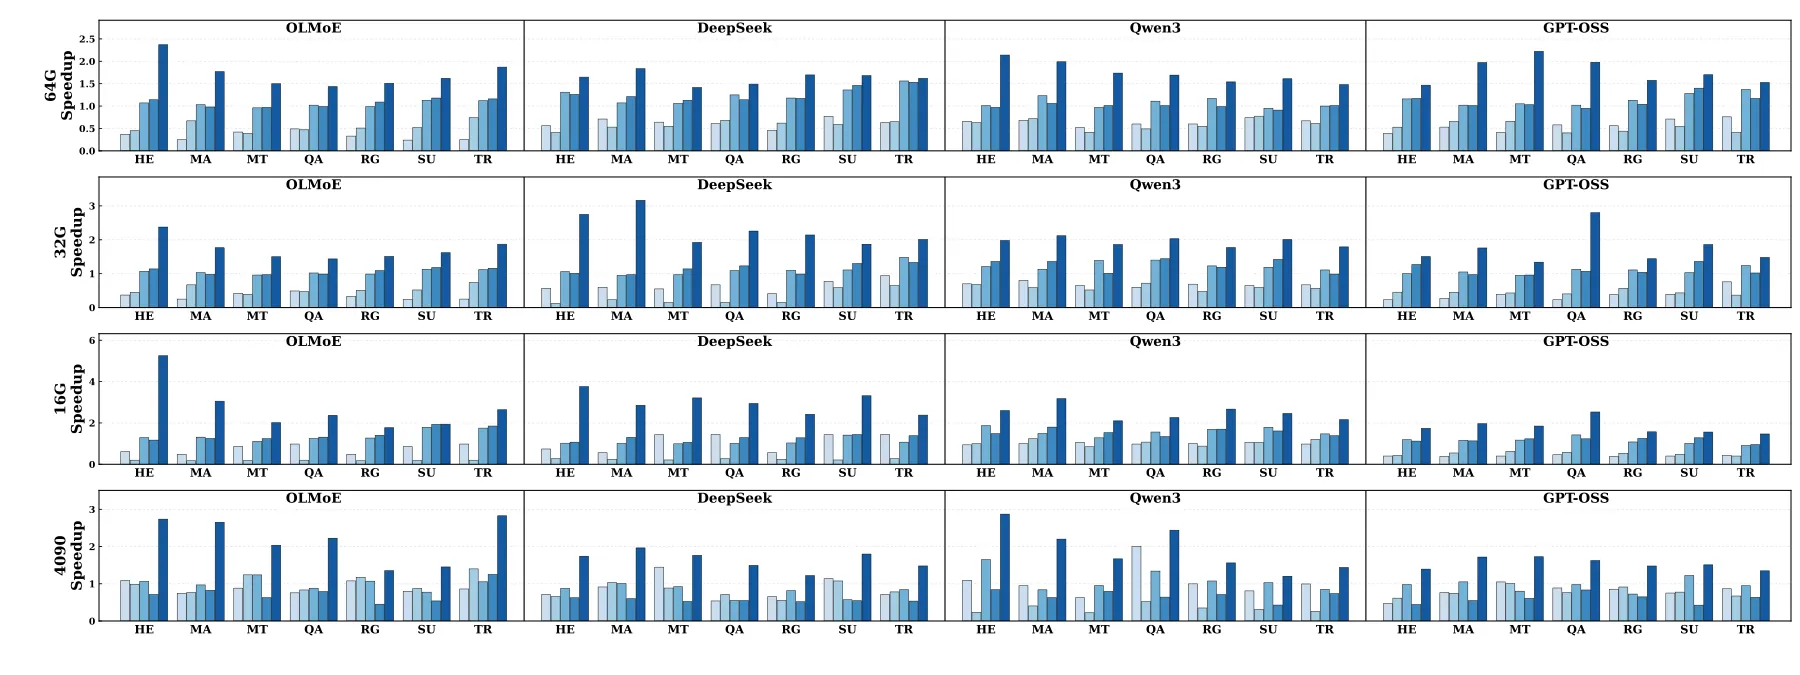
图 7 是完整的结果矩阵:四模型 × 七任务 × 三种 Jetson 内存预算(16G/32G/64G)加 RTX 4090 的每个组合都画了一组方法对比柱,柱高是相对自回归解码的加速比(Auto 归一化为 1.0)。读图要点有三:
第一,朴素自投机基线在紧内存下常常跑不过自回归。ES/LS 的柱子大量低于 1.0 线——自投机虽然对齐了草稿与目标,但专家复用差 + 冗余验证把收益吃光了。例如 16 GB 预算的 HumanEval 上,ES 在四个模型上只有 0.74/0.61/0.94/0.40 倍,LS 更低(DeepSeek 0.27 倍、OLMoE 0.20 倍)。注意 ES 的接受长度并不短(OLMoE 上 3.08),速度却只有 0.61 倍——这是全文最重要的一个反直觉点:接受长度不等于端到端加速,在卸载场景里专家搬运成本才是主导。
第二,S²-MoE 在所有组合里都明显领先。16 GB 的 HumanEval 上:DeepSeek 3.76 倍、OLMoE 5.25 倍(全文最大加速比)、Qwen3 2.60 倍、GPT-OSS 1.74 倍。整个评测矩阵上,Jetson 端 1.3–5.3 倍、平均约 2.0 倍,RTX 4090 上 1.2–2.9 倍。
第三,越紧的内存预算,优势越大。64 GB 预算下专家基本常驻,冗余验证的代价相对小;压到 16 GB 时大部分专家要现取现用,每次多余的专家激活都直接乘以 SSD 搬运延迟,S²-MoE 的「少验证 + 高复用」就转化为更大的倍率差——论文报告这些优势在更紧的显存预算下更明显,与机制分析的方向完全一致。
与 EAGLE-3、Cascade 的对比同样值得单独说。EAGLE-3 在部分模型家族(如 Llama 系)表现很好,但跨 MoE 家族波动大——DeepSeek 16 GB HumanEval 上只有 1.02 倍(草稿质量与目标对齐不足),Qwen3 上 1.87 倍;它的草稿头是训练出来的,质量绑死在训练数据与目标模型的匹配度上。S²-MoE 免训练,反而在每个模型上都拿到稳定增益。Cascade 用历史效用信号做「投机开关」,粒度是整轮决策,存在在线试错开销与滞后;S²-MoE 用当前步的路由信号做 token 级成本估计,决策更直接。16 GB HumanEval 上 Cascade 为 1.07/1.17/1.48/1.12 倍,显著低于 S²-MoE。
质量:有界扰动,未见可观测退化
复用感知门控是全文唯一「故意改变目标行为」的组件,它的质量代价必须单独量化。论文用三组指标:任务准确率、LongBench 长上下文分数、以及与未修改原模型的输出分布一致性(WikiText-2 上的 KL、logit 位移、Top-1 一致率、PPL 比值):
| 模型 | 方法 | 任务平均准确率 | Mean KL ↓ | Top-1 一致率 ↑ | PPL 比值 ↓ |
|---|---|---|---|---|---|
| OLMoE | Original / S²-MoE | 39.38 / 39.61 | 0.048 | 89.89% | 1.012 |
| DeepSeek | Original / S²-MoE | 58.68 / 60.74 | 0.065 | 89.13% | 1.013 |
| Qwen3 | Original / S²-MoE | 59.76 / 60.75 | 0.026 | 93.04% | 1.012 |
| GPT-OSS | Original / S²-MoE | 62.80 / 63.14 | — | — | — |
(GPT-OSS 以 Harmony 聊天格式与 CoT/RL 目标训练,原始语料上的 next-token 似然不是可靠的质量信号,论文因此省略其 PPL/KL 指标。)四个模型的任务准确率差异都很小且无系统性方向,有的还略升;LongBench 长上下文分数与原始模型基本持平(部分任务小幅上升,如 DeepSeek 的 Qasper 从 27.40 到 32.72、GPT-OSS 的 NarrativeQA 从 13.34 到 16.71)。分布一致性指标把扰动定量化了:PPL 比值 1.012–1.013(很接近 1.0),Top-1 一致率 89%–93%,Mean KL 只有 0.03–0.07。换句话说,门控偏置造成的输出扰动是「有界且稀罕」的——绝大多数 token 的 top-1 选择根本没变,变的只是边缘专家的那几次选择。
消融:三个组件各司其职且互补
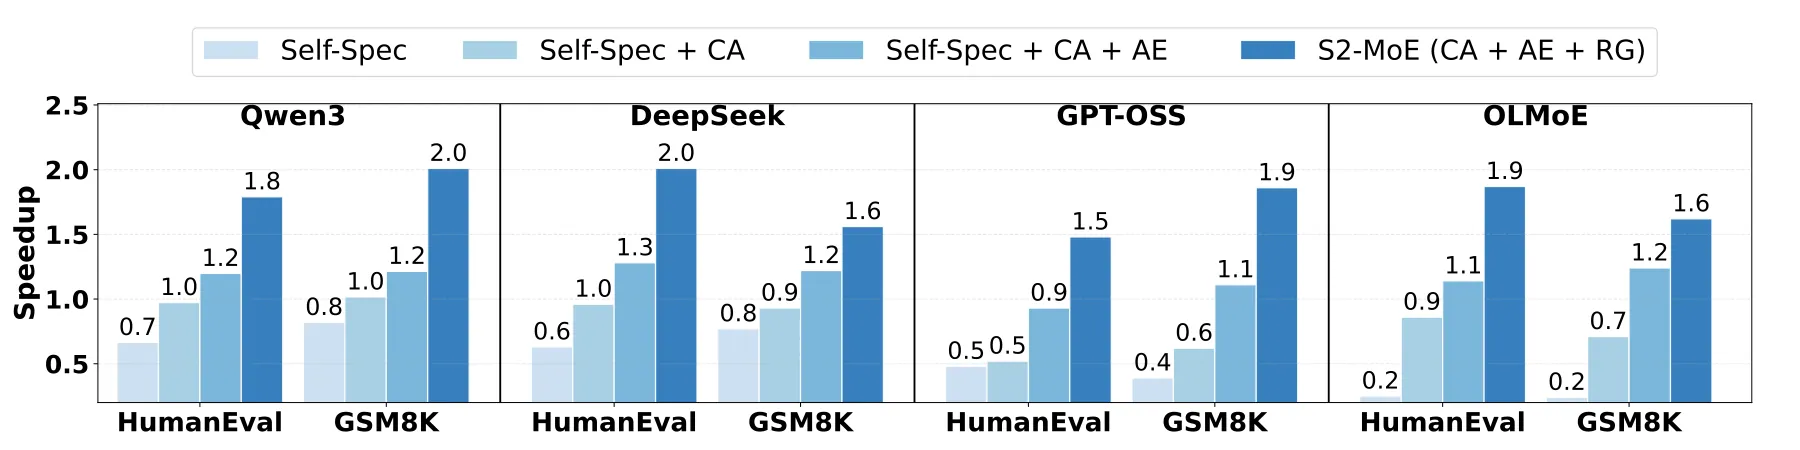
图 8 的渐进消融回答了「三个组件是否冗余」:在 Qwen3 和 DeepSeek 上,从裸自投机基线出发,逐个叠加上下文对齐(CA)、自适应扩展(AE)、复用感知门控(RG),每一步都有正向增益,三者叠加取得最高加速——组件各自打击不同瓶颈,互不重复。
三个组件的独立效果论文分别给了证据:上下文对齐对接受率的提升已在组件三一节引用(论文表 3);自适应扩展的效果见图 9——比较不同扩展策略在各数据集上的「接受长度」与「有效验证成本」(定义为最终被接受 token 贡献的专家激活占比):
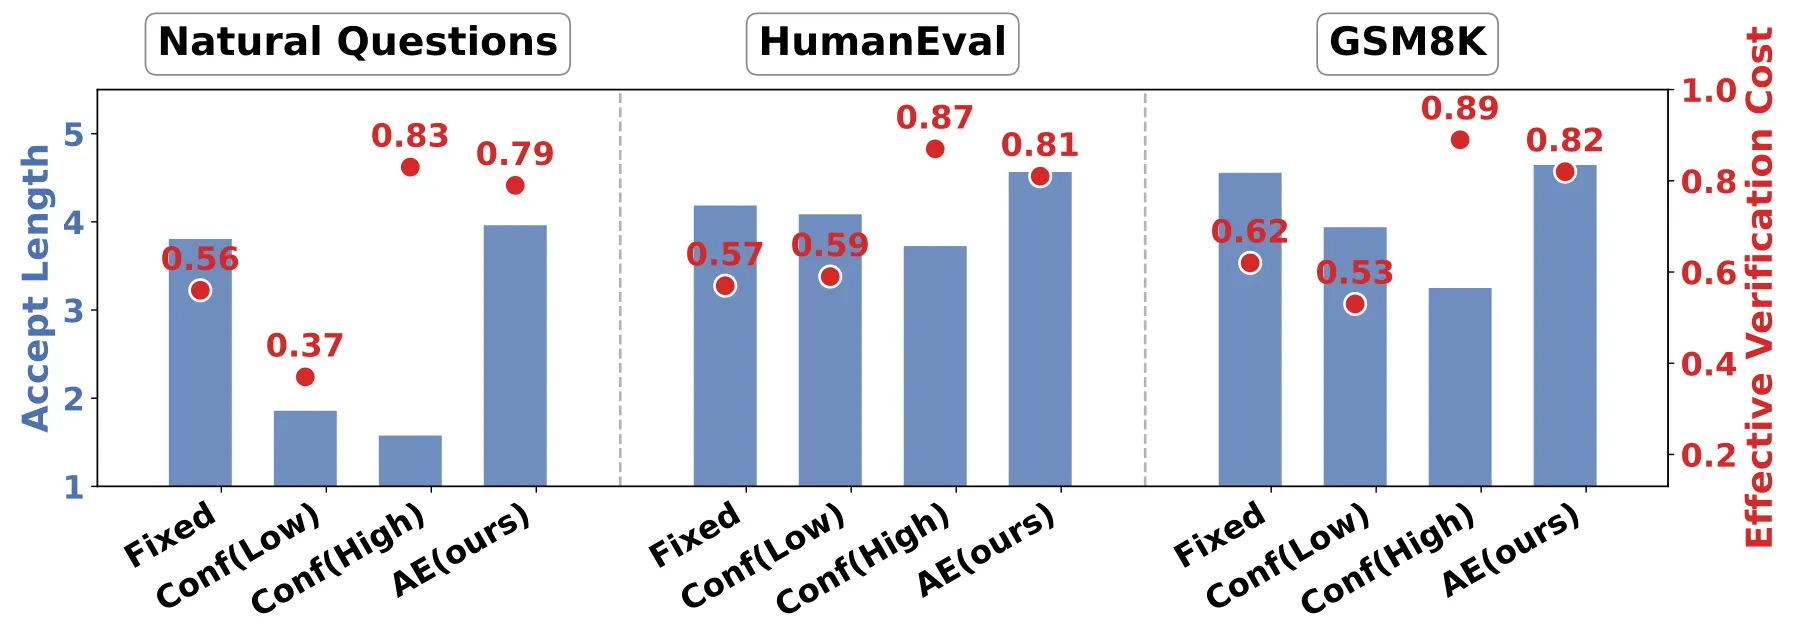
图 9 的信息是:固定宽度扩展的接受长度不错,但冗余验证成本很高;置信度剪枝则是一条明显的权衡曲线——阈值低保留了接受长度但冗余验证重,阈值高把验证成本压下去了却严重牺牲接受长度。效用扩展的落点同时具备「接近固定宽度甚至更长的接受长度」与「接近激进剪枝的验证效率」,把权衡平面上的帕累托前沿往外推了一截。
复用感知门控的效果前文已给出(DeepSeek 复用率降低 26%–33%)。敏感性实验还标定了两个超参数的取值逻辑:草稿 top-k 越大接受越长但草稿开销越大(top-k 与收益呈倒 U 关系,取适中值);门控 cap 太小则复用改善不足,太大则奖励面过宽、偏置信号被稀释——1.5 到 2.5 倍 top-k 是经验甜区。
开源仓库里的额外对照:DFlash 与 Domino
论文之外,开源仓库还顺带集成了两条更激进的投机路线作为附加对照:DFlash(扩散草稿的块扩散解码)与 Domino,二者都需要独立草稿模型。在同样的边缘/卸载设定下,它们的收益普遍更小且不稳定——例如 DeepSeek/64 GB 上 DFlash 1.32 倍、Domino 0.87 倍,而 S²-MoE 1.60 倍;OLMoE/32 GB 上 DFlash 1.23 倍、Domino 0.82 倍,S²-MoE 1.87 倍。仓库给出的解释很能说明边缘场景的特殊性:DFlash/Domino 用块大小 16(最多 15 个草稿 token),实测有效接受长度却只有 3.08–3.71——绝大多数草稿被丢弃,而草稿生成与验证的冗余工作照样发生,测量的接受长度转化不成端到端加速。这与 ES 基线在 16 GB 上的表现互为印证:边缘 MoE 场景里,草稿的「产量」远不如它的「成本结构」重要。
局限与适用边界
把论文的边界条件摊开,有几点值得读者留意的判断:
- 不是严格无损的方法。上下文对齐与自适应扩展都不改变目标行为,但复用感知门控在验证时轻微改写路由。论文用全套质量指标证明扰动有界(PPL 比值 1.012–1.013、Top-1 一致率 >89%),但「有界近似」不等于「无偏」——对分布质量极其敏感的下游应用仍应自行验证。
- 机制依赖路由可预测性。成本估计与门控引导都建立在「草稿路由高精度预示目标路由」(图 2d)之上。这个性质在四个被测家族上都成立,但它本质上是模型行为的经验性质,路由更不稳定或门控更随意的模型上,成本模型的保守性可能变差。
- 成本模型需要标定。、、专家字节数、搬运带宽都要按具体硬件与模型离线标定(仓库给出 Orin 的示例值),迁移平台需要重做 profiling。
- 评测面向单用户边缘场景。batch 1–2、带宽受限的前提贯穿全文;论文引用既有工作说明,MoE 上投机解码在中等批量、能摊薄验证开销的服务器场景里另有最优解,S²-MoE 的设计目标不在那里。
- 草稿形态的选择。论文选专家稀疏而非量化/层稀疏作为草稿主体,理由是其保真/开销比最好,但这意味着草稿前向仍要走全部层——对层数深、每层专家极少的大模型,这一前提需要重新审视(GPT-OSS 每 token 只激活 4 个专家时 S²-MoE 仍有 1.74 倍,说明余量还在)。
小结
S²-MoE 的贡献可以浓缩成一句话:在边缘 MoE 推理里,投机解码的决策单位从「token 置信度」换成了「专家搬运成本」。沿着这条主线,三个组件各管一段:自适应扩展决定「验证什么」(按效用剪掉收益低于成本的候选,拒绝的 token 不再白搬专家);复用感知门控决定「用什么专家验证」(用受控软偏置把边缘专家的选择拢向复用集合,压低单次验证的参数密度);上下文对齐决定「草稿站在什么历史上」(共享 KV 让草稿误差只在单次迭代内存在,保住长生成的接受率)。配上 llama.cpp 里的专家级卸载,四件事合起来把「tokens per GB」这个边缘推理的核心指标系统性抬高了——Jetson Orin 上最高 5.3 倍、平均约 2.0 倍,且免训练、即插即用。
这篇文章的参考价值不只在加速比数字,更在于方法论层面:把「接受长度」这个投机解码的通用 KPI,替换成与硬件成本直接挂钩的效用度量。同样的思路可以迁移到其他资源受限场景(CPU 推理、混合显存、稀疏注意力验证)里复用。
参考资料
- S²-MoE: Enabling Efficient Self-Speculative Decoding for Mixture-of-Experts on Edge Devices(arXiv 2608.15018)
- S²-MoE 开源仓库(angerybob/S2-MoE,llama.cpp 集成、orin/4090 分支)
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test(arXiv 2503.01840)
- Utility-Driven Speculative Decoding for Mixture-of-Experts(arXiv 2506.20675,即 Cascade)
- Fast Inference from Transformers via Speculative Decoding(arXiv 2211.17192)
- Accelerating Large Language Model Decoding with Speculative Sampling(arXiv 2302.01318)
- LayerSkip: Enabling Early Exit Inference and Self-Speculative Decoding(arXiv 2404.16710)
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(arXiv 2405.04434)
- OLMoE: Open Mixture-of-Experts Language Models(arXiv 2409.02060)
- Qwen3 Technical Report(arXiv 2505.09388)
- GPT-OSS-120B(Hugging Face 模型页)
- llama.cpp(ggml-org/llama.cpp)
- Spec-Bench: A Comprehensive Benchmark and Toolkit for Speculative Decoding
- 社区解读:Jetson Orin 上推理加速最高 5.3 倍!北大开源端侧 MoE 自推测解码方案
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


