


大模型推理框架开发工程师:岗位地图、开发工作流与硬核知识体系
这份岗位在解决什么问题
先看一组很容易被忽略的数字。一个 80 亿参数、fp16 权重的对话模型,权重约占 16GB 显存,一张 80GB 的 GPU 装得下,单用户 demo 跑得很流畅。但把它变成生产服务时,事情开始失控:假设它每层 8 个 KV 头、128 维、共 32 层,那么每个 token 的 KV Cache 约占 128KB(fp16),8k 上下文的一个请求就要吃掉约 1GB,128k 上下文约 16GB。权重 16GB + 64 个并发长上下文请求的 KV,一块 80GB 的卡就已经放不下;请求长短不一、来得有早有晚,GPU 利用率还会被“等别人算完”这类调度问题打成个位数。
模型本身不会变,变化的是同时服务几百上千个请求这件事。谁把“一个模型会算”变成“一个模型能规模化地、稳定地、便宜地算”?这就是推理框架(Inference Engine / Serving Framework)以及它背后的开发工程师在做的事。vLLM、SGLang、TensorRT-LLM、TGI、以及各家自研引擎,都属于这一类系统软件。
这份工作的产出不是模型指标,而是三类系统指标:
- 延迟:首 token 延迟(TTFT)、每 token 间隔(TPOT)的 P50/P99 达标;
- 吞吐与成本:单卡每秒生成 token 数、每 token 成本、单位显存支撑的并发数;
- 稳定性:长尾请求不超时、不 OOM、故障可恢复、新硬件可接入。
支撑这三类指标的知识横跨四个层面:调度与内存管理(引擎核心)、算子与 Kernel(单次前向算多快)、并行与通信(多卡多机怎么协同)、工程化(怎么把代码稳定送到线上)。岗位日常就是在这四层里反复做“测量 → 定位 → 修改 → 验证”的循环。
与相邻岗位的分界大致如下:
| 相邻岗位 | 主战场 | 与推理框架工程师的关系 |
|---|---|---|
| 算法工程师 | 模型结构、训练效果 | 提供模型;框架工程师关心同一结构在推理时的资源画像 |
| 训练系统工程师 | 预训练/后训练的并行与集群 | 方法论相通(并行、通信、调度),但目标函数不同 |
| 算子库工程师 | 把单个 Kernel 压到硬件极限 | 框架工程师是算子的集成者与用户,负责把算子放进正确的位置 |
| 芯片/编译器团队 | 新硬件的指令集与工具链 | 新卡落地时,框架的适配层是它和用户的桥梁 |
推理框架工程师的独特之处在于“横跨”:他不需要把单个 GEMM 写到比 cuBLAS 更快,但必须知道 GEMM 什么时候是瓶颈、换什么算法能绕开它;不需要设计模型,但必须把一个模型的显存账单算到每个字节。
先看懂战场:一个请求在推理引擎里的完整旅程
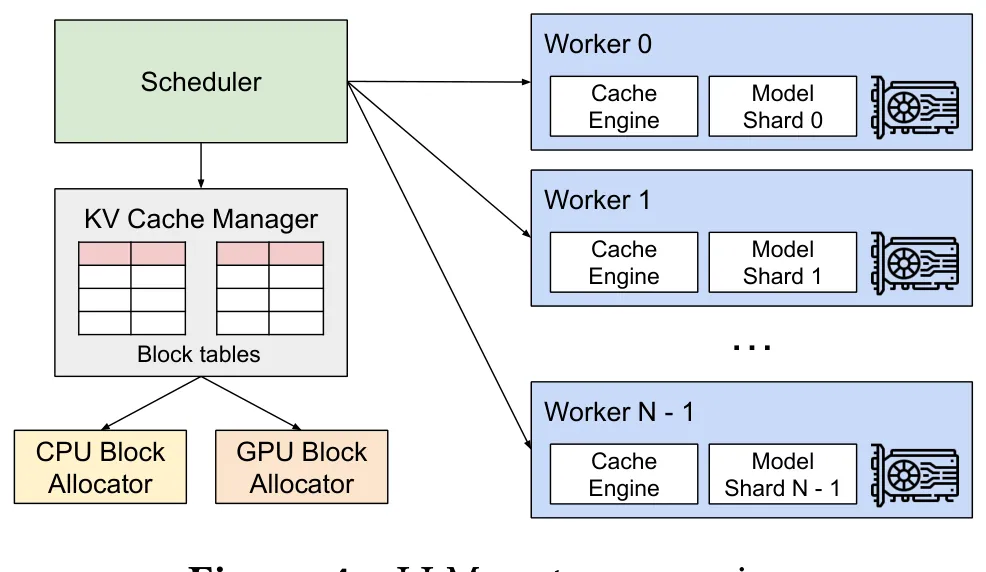
理解这份岗位最快的方式,是跟着一个请求走一遍现代引擎(以 vLLM 为蓝本,SGLang 同构)的内部流程。vLLM 论文(SOSP 2023)给出的系统总览如图 1:上层是集中式调度器与 KV Cache 管理器(含 CPU/GPU 两套块分配器与块表),下层是一组 Worker,每个 Worker 持有模型分片(张量并行时)与对应的 Cache Engine。
请求的旅程大致分七步:
第一步:接入与排队。 请求经 HTTP/gRPC 网关进入引擎,转成引擎内部的 Sequence 对象,挂进调度器的等待队列。这一步的工程点在于协议转换开销、请求优先级与多租户配额,但真正的复杂度在下一步。
第二步:迭代级调度(连续批处理)。 早期系统按“请求”为单位组 batch:一批一起跑、一起结束。问题有两个:padding 浪费(不等长的输入要补齐)与“木桶效应”(快的请求必须等慢的算完,新请求插不进来)。Orca(OSDI 2022)提出的迭代级调度把调度粒度从“请求”降到“一次模型前向(iteration)”:每个 iteration 结束都重新组 batch,完成的请求立刻退出、新请求立刻补入。论文报告相比当时 NVIDIA FasterTransformer 的基线,在同等延迟下吞吐最高提升 36.9 倍。这个机制后来被称为 continuous batching,是今天所有主流引擎的地基。
第三步:分配 KV 空间。 一个请求首次被调度时,引擎要给它预占存放 K/V 的显存。传统做法是按最大可能长度一次性预留,这直接导致后面要讲的显存灾难。现代引擎的做法是分块(block)分配,按需增长,详见下一节。
第四步:前缀复用。 如果新请求的 prompt 前缀与某个算过的请求一致(多轮对话历史、相同的系统提示词、few-shot 模板),引擎可以直接复用那段前缀算好的 KV Cache,跳过对应的 prefill 计算。SGLang 的 RadixAttention 把这套逻辑自动化,见后文第四张图。
第五步:Prefill。 模型第一次看到整段 prompt,一次性前向算出所有输入 token 的 K/V 与首个输出 token。这段计算量大、矩阵形状大,是“计算密集型”的:一个 4096 token 的 prompt 在 8B 模型上前向约有 2 × 8e9 × 4096 ≈ 6.6e13 FLOPs,在 H100 的 fp16 稠密峰值(约 989 TFLOPS)下理论下限就有 60-70 毫秒。prefill 期间 GPU 被这个请求独占算力,如果它很长,后面所有 decode 请求都被堵住——这是后面讲 chunked prefill 与 P/D 分离的动机。
第六步:Decode 循环。 模型每步只生成一个 token,把新 token 拼进序列再算一次。每个 decode 步的计算量极小,但要读取整条历史的 KV:上下文越长,每步要从 HBM 搬的字节越多。这使它成为“内存带宽密集型”的。8k 上下文时每步约读 1GB KV,加上每步都要把全部权重(16GB)读一遍,单流 decode 的理论下限就按这个算,见知识体系(二)的公式。
第七步:采样与终止。 decode 每步产出 logits,经温度/top-k/top-p 采样得到下一个 token,判断是否命中结束符;流式返回给客户端。这里还有并行采样(一个请求同时生成多条候选)与 beam search 等模式,它们带来“多个输出序列共享前缀 KV”的需求,也就引出 KV 块的写时复制(copy-on-write)机制:同一段物理 KV 块被多个输出序列引用,只在某个序列真正写入时才复制。vLLM 论文专门用一节讲它,因为它能把并行采样的显存占用砍掉一个数量级。
走完这七步就会明白:框架工程师写的代码,绝大多数不在“模型前向”本身,而在围绕这个循环的调度、内存、批处理与资源管理。模型的前向是固定的数学,循环外的状态机才是系统软件的战场。“服务慢”的根因,通常也在这里。
KV 内存管理:为什么操作系统的分页思想会出现在 GPU 上
vLLM 论文指出,KV Cache 是推理服务里最大的动态内存消费者,而旧系统管理它的方式极其浪费。图 2 展示了论文归纳的三类浪费:预留(reserved,为未来生成 token 提前占位)、内部碎片(internal fragmentation,如 prompt 尾部大量槽位永远不会被填满)、外部碎片(external fragmentation,多个请求的交错生命周期在显存里留下无法再分配的“洞”)。
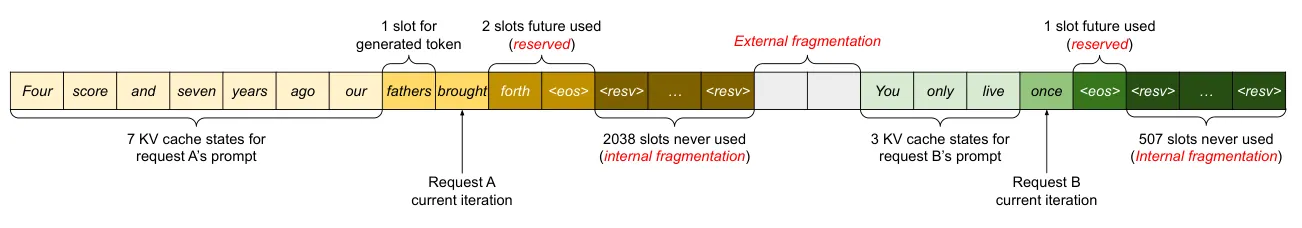
论文实测:在典型负载下,此前系统的有效显存利用率最低只有 20.4%——八成显存被浪费,等于并发能力直接打两折。浪费的显存不能直接“换一块更大的卡”解决,因为根源是“预分配 + 连续存储”这个前提:请求长度动态增长,又要求 KV 连续存放,就只能预留上限。
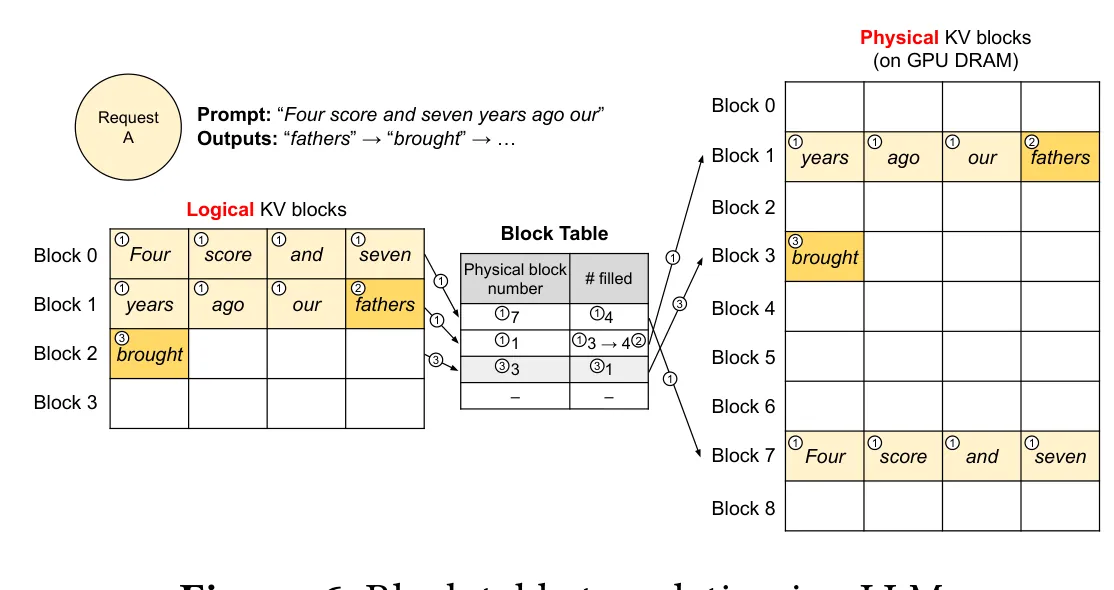
PagedAttention 的解法与操作系统的虚拟内存如出一辙:放弃连续性。KV 按固定大小分块(vLLM 取每块 16 个 token,论文认为 16 足够小以控制内部碎片、又足够大以保证 GPU 访存效率),序列持有的是“逻辑块序列 + 块表(block table)”,块表把逻辑块映射到物理块,物理块可以散布在显存任意空闲位置,按需逐个追加。图 3 展示了这种翻译:请求 A 的 4 个逻辑块映射到物理块 0/4/3/1,块表记录每个逻辑块对应的物理块号与已填充位置数,最后一个块留空位给未来生成的 token。KV 不再是“一大段预留”,而是“一页一页随时可申请的物理页”。
这个设计的连锁收益解释了为什么它是现代引擎的基石:
- 近零浪费:不再预分配,内存只按实际生成量增长;
- 细粒度共享:前缀命中、并行采样共享的都是物理块,配合引用计数实现写时复制;
- 换出与重算可选:显存紧张时,可以把旧请求的块换到 CPU 内存(swap)或干脆丢弃重算(recompute),两者都由调度策略决定;
- 更大的 batch:省下的显存直接转化为可并发的请求数,而并发数又是吞吐的核心(见知识体系(二)的带宽公式)。
框架工程师必须把这块“内存账本”算得清清楚楚:每个模型每 token 的 KV 字节数、每种并行方式下 KV 在卡间的分布、块大小的取舍、碎片率的实时监控。KV Cache 的后续演进——量化(KIVI、KVQuant)、驱逐(H2O、StreamingLLM)、压缩与跨层复用——全部建立在这张块表之上。
前缀缓存:让重复计算直接消失
生产负载里充满了重复:多轮对话里每轮都带着前面全部历史;同一产品的所有请求都共享系统提示词;agent 在循环里反复调用同一批工具定义。这些重复的 prompt 前缀,每次请求都重新算一遍 prefill 是纯粹的浪费。
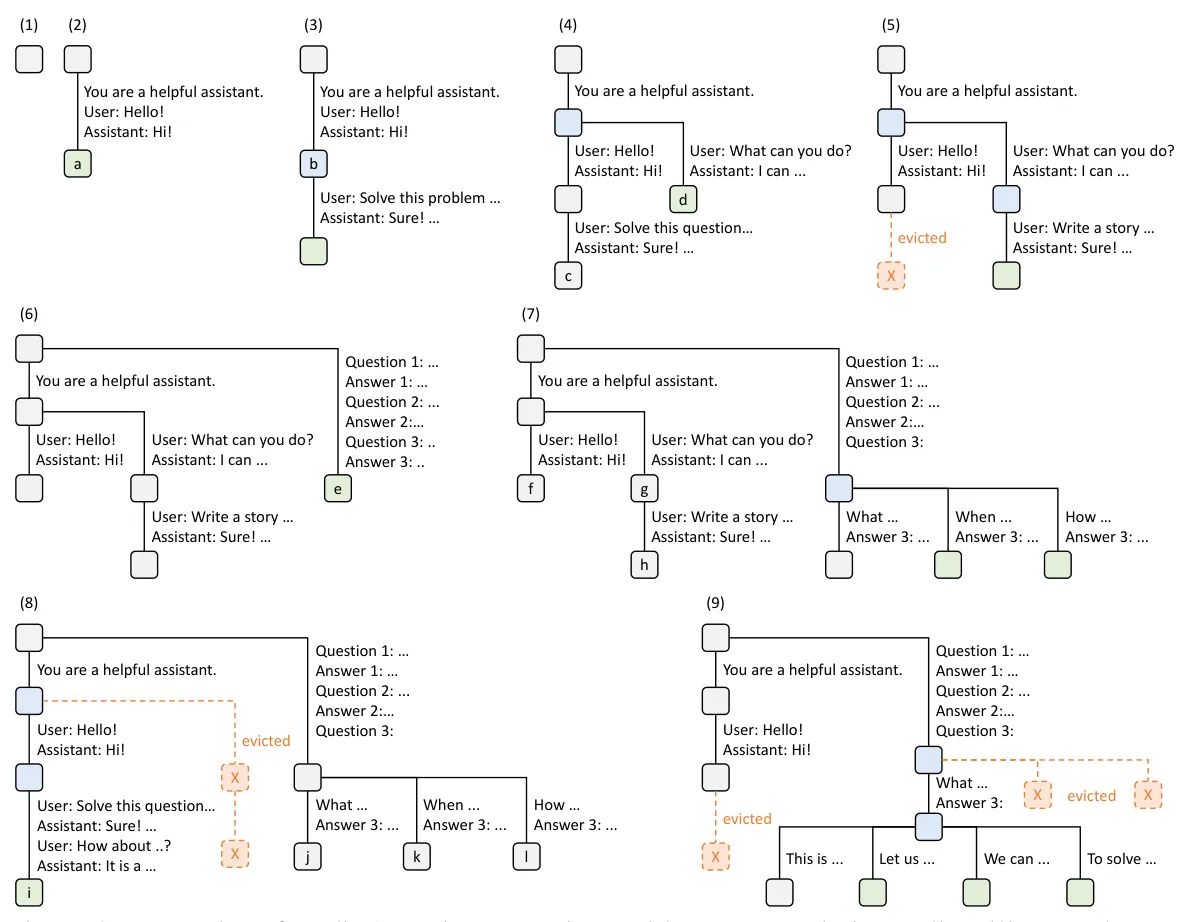
SGLang 的 RadixAttention(2024)把 KV Cache 组织成一棵前缀树(radix tree):树的每条边是一段 token 序列,共享前缀的请求在树上合并路径,树的节点直接持有算好的 KV 物理块。新请求到达时做最长前缀匹配,命中的路径直接引用已有 KV 块、跳过对应计算,只有未命中的尾巴才重新 prefill。图 4 展示了这棵前缀树在带 LRU 驱逐策略下、九个时刻的动态演化:新序列插入、共享路径复用、以及缓存压力下的驱逐。
工程上有几个反直觉的点:
- 正确性靠哈希而非语义:能否复用只看 token 前缀逐块相同,引擎对每个 KV 块的内容做哈希(块哈希可增量计算),哈希相同即视为可复用——不需要任何“语义相似”判断;
- 驱逐策略直接决定命中率:LRU 在长上下文场景会出问题(一个 128k 的请求就能把缓存塞满),实践中要结合请求长度分布设计预算;
- 与调度器耦合:缓存感知调度把“能命中同一前缀”的请求聚到一起处理,能显著提高命中率——这是 SGLang 把前缀缓存做进调度器而不是做成独立缓存层的原因。
论文在包含多轮对话、agent、并行分支等负载的端到端对比中报告 SGLang 吞吐最高达对比系统的 6.4 倍,RadixAttention 是其中最主要的贡献之一。前缀缓存如今已成为主流引擎的标准功能:vLLM 的 automatic prefix caching、TensorRT-LLM 的 KV cache reuse 都是同一思想的实现。
推理框架工程师的开发工作流
岗位的日常不是“写算子”,而是一轮轮可复现的性能工程。一套成熟的工作流通常包含五个环节,每个环节都有明确的产物。
第一步:定义问题,建立可复现的基线
性能优化前先回答:慢在哪里、对谁慢、多慢算慢。指标口径必须先统一,否则后续所有对比都无意义:
| 指标 | 口径 | 主要反映 |
|---|---|---|
| TTFT | 请求发出到首个 token 返回 | 排队 + prefill 的效率 |
| TPOT / ITL | 相邻输出 token 的间隔 | decode 步长与流式体感 |
| E2E 延迟 | 整请求耗时 | 综合体验 |
| 吞吐 | tokens/s(区分单流/总吞吐) | 资源利用率与成本 |
| 显存峰值 / KV 命中率 | 引擎内部统计 | 容量规划与复用效果 |
| SLO 达标率 | 如 P99 TTFT < 5s 的请求占比 | 稳定性 |
基线必须写清楚复现条件:模型与量化位宽、输入长度分布、并发数、请求到达率、GPU 型号与驱动、采样参数。数字脱离这些条件就没有意义——这也是性能报告里最容易造假、也最容易自欺的地方。
第二步:分层剖析,把“慢”定位到证据链
剖析工具按粒度分层,每一层回答不同问题:
- 系统层(perf、py-spy、火焰图):时间花在 CPU 的哪个函数——调度决策、tokenization、采样、还是数据搬运;
- 时间线层(Nsight Systems):GPU 时间轴上 kernel 之间的空隙从哪来——CPU 来不及喂活、同步等待、通信等待、还是压根没有足够请求;
- Kernel 内层(Nsight Compute / ncu):单个 kernel 为什么没跑满——occupancy 不足、显存吞吐没打满、warp 在等什么(stall 原因)、指令混合是否合理、在 Roofline 上处于什么位置;
- 正确性辅助(compute-sanitizer、cuda-gdb):越界、未初始化、竞态。
ncu 报告里值得盯的字段大致是这些:
GPU Speed Of Light: SM busy / memory throughput 占比Launch Statistics: occupancy、blocks 数、wave 数Scheduler Statistics: warp 级 stall 的主要原因分布Warp State Statistics: active warps、eligible warpsMemory Workload Analysis: L1/L2/HBM 吞吐与 hit rate一个常被误读的数字是“GPU 利用率 30%”:它可能是 kernel 效率低,也可能只是请求不够多、调度器在等数据,甚至可能是 CPU 端排队。必须沿着“利用率低 → 谁在等 → 等什么”的链条把证据找全,才能进入下一步。
第三步:把瓶颈映射到优化杠杆
瓶颈特征与优化手段之间存在一张相对固定的映射表,框架工程师的“内功”就是这张表:
| 瓶颈特征 | 典型手段(举例) | 对应知识块 |
|---|---|---|
| 计算受限(prefill、大 batch GEMM) | 用 Tensor Core、FP8、更好的 tile 与流水线 | Kernel 优化、量化 |
| 带宽受限(decode 读权重) | 增大 batch、权重量化、投机解码摊薄读取 | 批处理、量化、投机解码 |
| 带宽受限(读 KV) | KV 量化、GQA/MLA、稀疏注意力、缓存驱逐 | KV Cache 优化 |
| 显存容量受限 | 分块管理、前缀复用、PD 分离、换出/重算 | 内存管理 |
| 通信受限(多卡 MoE/TP) | 通信计算重叠、拓扑感知、all-to-all 优化 | 并行与网络 |
| 调度低效(排队/碎片化) | 迭代级调度、缓存感知调度、抢占策略 | 引擎核心 |
第四步:实现、验证、回归
优化落地到代码后,验证分三层:正确性(logits 相对误差或采样分布一致性,注意在线 softmax、原子累加、FP8 缩放都会带来可接受的数值差异,不能要求逐位相等)、性能(固定机器、锁频、多次运行取稳健统计,防止 benchmark 漂移)、稳定性(长上下文、并发冲击、OOM 边界)。性能敏感代码的评审要额外盯:显存生命周期、无意义的 kernel 启动、锁与同步、错误路径是否会泄漏资源。
第五步:上线、监控、回流
特性上线走灰度与 A/B,线上看两组指标:引擎内部(队列长度、抢占次数、KV 命中率、每请求 token 数分布)与用户体验(TTFT/TPOT 分位数、错误率)。线上数据往往推翻线下结论——比如“命中率上去了但 TTFT 没降”,因为瓶颈转移到了别处。于是开启下一轮循环。
一个贯穿案例:把「长上下文 TTFT 高」查到底
把工作流串起来看一个典型问题。某知识库问答服务,prompt 平均 2 万 token,报障“P99 TTFT 8 秒,SLO 是 5 秒”。注意以下数字是方法论演示用的示意值,真实场景必须自己测。
第一轮先拆时间:TTFT = 排队时间 + prefill 时间 + 少量传输。取样发现 P99 里约 5 秒是排队、3 秒是 prefill,而同样负载下短 prompt 服务的排队只有 0.5 秒。假设生成:长 prefill 把 GPU 算力独占太久,decode 请求被集体堵在队列里。这个假设能解释“为什么长请求的 TTFT 特别差”。
第二轮验证假设并找第二现场:打开引擎的请求级 trace,确认 TTFT 高的请求确实卡在“等 GPU 空闲”;同时检查前缀命中率,发现只有 12%——大量请求共享同一份系统提示与文档前缀,却各自重算。命中率低意味着 prefill 计算量本可以砍掉一大半。
第三轮定方案,按“改动小、收益确定”排序:
- 开启并调优前缀缓存(把公共前缀整理到 prompt 开头,让最长前缀匹配能命中);
- 对超长 prefill 启用 chunked prefill(把 prefill 切成小块混进 decode 迭代,避免单个长请求独占 GPU);
- 若仍不达标,再上 P/D 分离(prefill 与 decode 用不同机器池,见下一节)。
第四轮回归与上线:命中率从 12% 提到约 74%,prefill 计算量减半以上;chunked prefill 把“长请求独占”变成“长请求与 decode 交错”,排队时间显著下降;P99 TTFT 从 8 秒降到 2 秒左右(示意值)。监控面板加上“KV 命中率”“prefill 阻塞时长”两个指标,防止回归。
这个案例的要点不是结论,而是方法:每一步都有可复现的数据支撑,改动按收益排序,效果按同一口径对比。一次这样的闭环通常一到两周,产出是“一组可解释的数字 + 一个合进引擎的特性”。
知识体系(一):引擎与调度内核——把“为什么”补齐
要真正胜任这份岗位,下面几块机制不能只会用,要能讲清设计取舍。
连续批处理与抢占
迭代级调度让批处理从“请求粒度”变成“迭代粒度”,但显存总有不够的时候。此时调度器要决定牺牲谁:抢占(把某请求的 KV 换到 CPU 或丢弃,之后 swap 回来或重算)还是限制新请求。换出(swap)省算力费带宽,重算(recompute)反之;现代引擎通常保留换出路径,但默认在负载高时倾向重算或直接拒绝(配合排队)。读源码时,调度器的状态机(running / waiting / swapped 三队列)就是整套策略的载体。
PagedAttention 与内存分层
块大小为什么是 16 而不是 1 或 128?太小则块表膨胀、GPU 访存不连续,太大则内部碎片回升——vLLM 论文实测 16 是兼顾两者的点。还要理解它和 kernel 的关系:分块后的 K/V 在显存里不连续,attention kernel 必须按块表间接寻址,这也是为什么 FlashAttention 这类库要专门为分页内存写“page 版本”。引擎里的 attention backend 因此天然是多套实现并存的(FlashAttention、FlashInfer、Triton 自研、xformers),框架工程师的工作之一就是让它们可插拔、可对比。
前缀复用与哈希缓存
RadixAttention 的哈希按“块”而非“token”计算:块哈希可增量滚动(新 token 只重算最后一个块的哈希),匹配粒度又足够细。驱逐策略(LRU 及其变体)决定了缓存的有效容量;vLLM 的 automatic prefix caching 还允许按块级哈希在请求间共享任意长度前缀,而不只限于整段 prompt。
为什么 Prefill 与 Decode 要拆开(P/D 分离)
prefill 计算密集、喜欢大矩阵与大批量;decode 带宽密集、喜欢小而多的并发。两者挤在同一批 GPU 上时互相拖累:prefill 抢算力让 decode 步长变长,decode 占着显存让 prefill 的 batch 大不起来。行业解法是P/D 分离:prefill 池与 decode 池使用不同的并行度与批处理策略,中间用高速网络把算好的 KV 从 prefill 节点搬到 decode 节点。
Mooncake(2024,Moonshot AI 与清华等合作,服务于 Kimi 的平台)把这条路线推到了“以 KV Cache 为中心”的极致,其架构如图 5:Conductor 全局调度器为每个请求选择一对 prefill 实例与 decode 实例;GPU 集群里未被充分利用的 CPU、DRAM 甚至 SSD 被组织成一个分布式 KV Cache 池,KV 块带前缀哈希、按需在池与实例间经 RDMA 搬运;调度还做缓存感知的路由(把请求导向缓存命中最多的节点)、负载均衡与过载时的预测性提前拒绝。论文报告:真实负载下让 Kimi 在同等 SLO 内多处理约 75% 的请求,部分模拟的长上下文场景吞吐最高提升 525%。
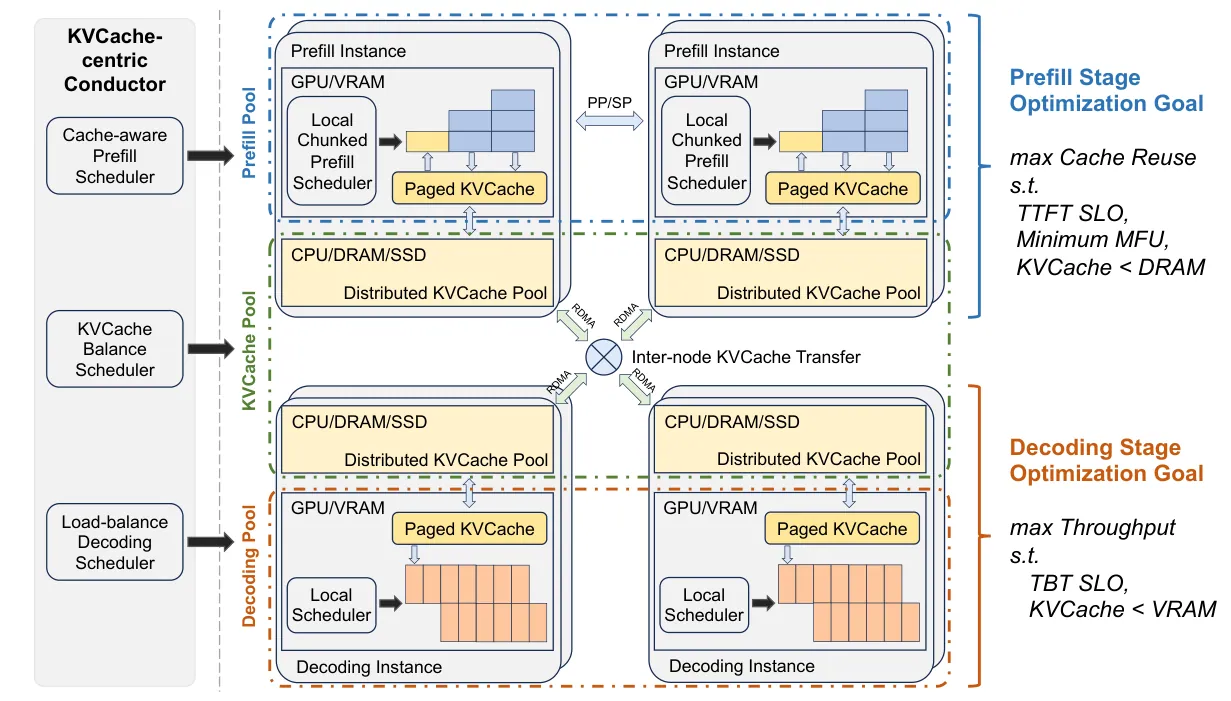
P/D 分离的代价是把“单机内的显存管理”升级成“跨机的 KV 传输调度”:KV 何时传、传多少、缓存放哪一级、节点挂了缓存怎么恢复。vLLM/SGLang 如今都以“KV Connector”的形式把 Mooncake 这类存储接进来,框架工程师的职责边界也随之扩展到分布式存储与调度。
MoE 推理:把“通信”变成一等公民
稀疏 MoE 模型(如 DeepSeek 系列)每层只激活少数专家,单卡放不下全部专家,于是专家被打散到多卡(专家并行 EP)。每个 token 每层都要把自己的 hidden 发给目标专家所在的卡,等专家算完再把结果收回来——这就是 all-to-all 通信,频率高达“每 token 每 MoE 层一次”。通信量随 hidden 维度和专家数量线性增长,通信耗时经常和计算同量级。DeepEP(DeepSeek 开源通信库)为此提供高吞吐(大 batch 用)与低延迟(小 batch 用)两类内核,并把 dispatch/combine 与计算重叠起来;引擎侧还要有专家负载均衡(热门专家排队、冷门专家空转的应对)与批处理策略。MoE 推理让“通信工程师”和“推理框架工程师”的角色在事实上合并了。
投机解码:把“串行等待”换成“并行试错”
自回归每步只出一个 token、每步都要等前一步,GPU 在 decode 时大量算力闲置。投机解码用一个小草稿模型(或共享主干的 MTP 模块)一次猜多个 token,再用目标模型并行验证,猜对了就一次前进多步。它不改变采样分布(有专门的拒绝采样保证),但要求引擎在内存管理(草稿 token 也要占 KV 块)、批处理(草稿与验证的长度不同)上做专门配合。DSpark、EAGLE、Medusa 等是这条线的代表,收益通常在 2-3 倍之间浮动,取决于接受率。
知识体系(二):算子、Kernel 与多芯片适配
引擎再聪明,最终都要落到“一次前向算多快”。这一层的知识起点是硬件的资源画像:
| GPU | 显存 | HBM 带宽 | fp16 稠密算力(约) | NVLink(双向,每卡) |
|---|---|---|---|---|
| A100 80GB | 80GB | 约 2TB/s | 312 TFLOPS | 600GB/s |
| H100 SXM | 80GB | 3.35TB/s | 989 TFLOPS | 900GB/s |
| B200 | 192GB | 约 8TB/s | 更高(引入 FP4) | 1.8TB/s |
算力与带宽的比值决定了每种计算形态的天花板。把“每算一个结果要搬多少字节”定义为算术强度 I,Roofline 模型指出:I 低于硬件拐点(H100 fp16 约 989e12/3.35e12 ≈ 295 FLOP/Byte)时,性能由带宽决定:
decode 正是典型的带宽受限形态。单流 decode 每步要读一遍全部权重,理论下限是:
8B 模型 fp16 是 16GB,除以 3.35TB/s 约 4.8 毫秒,即单流上限约 200 token/s;换成 INT8 翻倍到约 400 token/s,INT4 再翻倍。上下文很长时还要加上读自身 KV 的带宽(128k 上下文每步约 16GB,同样接近 5 毫秒)——这就是为什么长上下文服务一定要做 KV 量化、压缩或稀疏。批量增大后权重读取被摊薄到多个请求上,吞吐上限随之上升,直到算力或显存容量重新成为瓶颈。这套“带宽账”是框架工程师判断一切 decode 优化的第一性工具:任何声称加速 decode 的方案,都可以先用“它每 token 少读了多少字节”来粗验。
算子层的知识按形态分:
- PreFill 形态:长序列 GEMM 与注意力,计算受限,追求 Tensor Core 利用率与异步流水(cp.async/TMA 双缓冲),FlashAttention 系列是注意力算子的范本;
- Decode 形态:Q 很少而 K/V 很长,FlashDecoding 的思路是把 KV 沿序列维拆给多个 SM 并行算部分和、再归约,把“读带宽”用满;
- MoE 形态:专家矩阵行数随请求动态变化,需要 grouped GEMM 与变长 batch 处理;
- 小算子:采样、softmax、RMSNorm、RoPE 等,单独启动 kernel 的固定开销占比高,惯用手法是融合(fuse)进相邻大算子。
CUDA 与 Triton 的分工
写 Kernel 有两条路线,岗位通常两条都要。CUDA 路线追求极限:手动管 tile、共享内存、寄存器分块、向量化访存、warp 级同步,能用到 Tensor Core 的 mma/wgmma 指令与 TMA 异步拷贝;代价是开发慢、且绑定 NVIDIA 生态。Triton 路线(2019 年由 Tillet 等人提出)把“tile 级计算”作为语言抽象,让编译器负责共享内存分配、同步插入、指令选择与向量化,代码可以跨后端编译。一段 Triton 实现的行 softmax 长这样:
import tritonimport triton.language as tl
@triton.jitdef softmax_kernel(x_ptr, y_ptr, BLOCK: tl.constexpr): pid = tl.program_id(axis=0) # 处理第几行 cols = tl.arange(0, BLOCK) # 块内列索引 x = tl.load(x_ptr + pid * BLOCK + cols) # 整块一次加载 m = tl.max(x, axis=0) # 行内最大值 p = tl.exp(x - m) # 数值稳定的指数 s = tl.sum(p, axis=0) # 归一化分母 tl.store(y_ptr + pid * BLOCK + cols, p / s)用 CUDA 写同样的东西要自己处理块索引、共享内存、线程内归约与同步;Triton 把这些全部交给编译器,而编译器生成的代码仍能达到接近手写的效率——这是它成为“跨芯片算子语言”的原因:当引擎需要适配多种 GPU(甚至非 NVIDIA 芯片)时,用 Triton 写一套 kernel,由各家后端编译到各自指令集,比给每种硬件维护一套 CUDA 成本低得多。官方 Triton 后端覆盖 NVIDIA 与 AMD 等主流平台,多家国产芯片工具链也以兼容 Triton 方言为接入点。
什么时候必须回到 CUDA?Triton 表达不了的场景:需要精确控制同步、使用新硬件独有的指令、做 kernel 级 profiler 深度调优、或对接 CUTLASS/cuDNN 这类库的私有接口。成熟的引擎团队通常是“能 Triton 则 Triton,热点 CUDA 手写”,并维护一个 kernel 评测矩阵防止“换了后端悄悄变慢”。
多芯片适配的现实
岗位要求里的“多种芯片”意味着引擎需要一层 backend 抽象:同一功能(如注意力)有多套实现,按硬件与场景选择。工程上的现实是:每款芯片的算力/带宽比、内存层级、量化支持(如 FP8 从 Hopper 起、FP4 从 Blackwell 起)都不同,同一份优化在不同卡上的收益可能相反。框架工程师要做的不是把某个 kernel 优化到极致,而是建立一套让优化可评估、可移植、可回退的机制——这比单个 kernel 的微优化更难,也更重要。
知识体系(三):多卡、多机与通信
模型超过单卡显存(如 70B fp16 权重 140GB),或单卡带宽撑不起吞吐目标时,就要上并行。三种切法对应三种通信形态:
| 并行方式 | 切什么 | 每步通信 | 适用 |
|---|---|---|---|
| 张量并行(TP) | 每层的矩阵按维切 | 每层一次 AllReduce,量与 hidden 成正比 | 卡间 NVLink 域内,延迟敏感 |
| 流水线并行(PP) | 按层切 | 层间传递激活,有气泡 | 推理场景少用,主要服务于放不下的超大模型 |
| 专家并行(EP) | MoE 的专家按卡切 | 每 token 每层 All-to-All | MoE 模型,配合路由稀疏性 |
通信基础设施的分层是:卡间走 NVLink/NVSwitch(H100 每卡 900GB/s 双向,B200 的 NVLink 5 翻倍到 1.8TB/s,NVSwitch 可以把一个 NVLink 域扩到几十张卡);机间走 RDMA 网络(InfiniBand 或 RoCE,400Gbps 端口约 50GB/s、800Gbps 约 100GB/s);PCIe 只是兜底。NCCL 等库把这些抽象成集合通信原语。
框架工程师要对“通信量 × 频率”有数量级直觉。举 MoE 的例子:hidden 7168 维、fp8 时,单个 token 一次 all-to-all 的 payload 约 14KB,而它每层都要发生——深层模型每个 token 在卡间搬运的总量可以达到权重读取量的同一数量级。当通信时间接近计算时间,优化手段就只剩三类:减少通信(拓扑感知的专家放置、负载均衡)、隐藏通信(把 dispatch/combine 与计算双缓冲重叠)、以及选对通信内核(高吞吐 vs 低延迟)。DeepSeek 官方对其 V3/R1 推理系统的介绍里,跨节点专家并行、计算通信重叠与三级负载均衡正是整套系统能支撑大规模线上服务的三个支柱。
再往上是集群视角(图 5 的 Mooncake 已展示):PD 分离后 KV 在节点间流动,缓存池、调度路由、副本放置与故障转移构成一张新的资源编排问题。这一层技能把岗位从“单机性能工程师”推向“数据中心推理工程师”——也是推理框架与 AI Infra 的汇合处。
知识体系(四):工程化能力——把代码稳定送到线上
硬核技术之外,这份岗位的工程基线同样硬:
- 语言:C++ 写性能敏感路径(并发、内存模型、零拷贝),Python 写策略与编排(pybind11 绑定),两类代码的测试策略完全不同;
- 构建与运行环境:CMake、CUDA 版本与驱动矩阵、容器化(GPU 容器需要把驱动/工具链正确注入)、多卡 CI 的稀缺资源管理;
- 正确性回归:logits 相对误差阈值、采样分布一致性、端到端任务集、长上下文专项;要接受浮点非确定性(累加顺序、原子操作、FP8 缩放),设定容差而不是追求相等;
- 性能回归:固定机器、锁频、多次取中位数;基准要防“版本漂移”与“针对基准过拟合”;
- 协作与上游:会写最小复现(区分框架 bug、驱动 bug 与硬件 bug),能给 vLLM/SGLang/Triton 等上游仓库提交有质量的 issue 与 PR,以社区评审的标准校准自己的实现品位;
- 文档与沟通:性能报告要写清机器、模型、负载、方法与口径;设计文档要能讲清取舍与回退方案。
建立这套知识体系的路径
最后给一条可执行的路线,每一步都有独立产出物,不依赖“等一个项目机会”:
- 部署与压测:把 vLLM 与 SGLang 各部署一遍,同一模型同一负载跑 benchmark,能解释每一个指标差异的来源(后端实现、默认开关、内存策略)。产出:一份自己写的对比报告;
- 精读一条链路:从请求进引擎到 token 返回,把调度器状态机、块管理器、attention backend 的选择逻辑读通,画出自己的状态图。产出:一张能给别人讲 30 分钟的架构图;
- 写 Kernel:用 Triton 依次实现 softmax、GEMM、attention 前向,用 ncu 观察每个版本在 Roofline 上的移动。产出:三个能讲清“为什么这个写法更快”的 kernel;
- 剖析练习:找一台机器与一个陌生负载,按本文的工作流产出“瓶颈定位报告 + 优化建议”,并验证至少一条建议。产出:一份完整的性能分析样例,这是面试与实战通用的代表作;
- 向上游贡献:从复现 issue、补测试、修文档开始,到提交小 PR。产出:被社区评审过的代码与 review 品味。
配套的阅读材料按优先级:引擎源码(vLLM、SGLang)> 经典系统论文(Orca、PagedAttention/vLLM、RadixAttention、Mooncake)> 官方文档与工具手册(Nsight、CUDA、Triton)> 一线团队的技术博客(DeepSeek 推理系统介绍等)。读论文时带着问题读:这篇解决了哪一类瓶颈?它的假设在什么场景下失效?如果由我实现,最难的部分在哪?
小结
推理框架开发工程师的本质,是把“模型会算”变成“模型能规模化地算”的系统工程师。日常工作围绕一个循环:定义指标、分层剖析、映射优化杠杆、实现验证、上线回流;知识体系分四块:引擎的调度与内存内核、算子与 Kernel 与多芯片、多卡通信与集群编排、以及把这一切稳定送上网的工程能力。四块知识都服务于同一个账本——延迟、吞吐、显存与带宽之间如何换算、如何取舍。
这套知识体系的另一个特点是不怕旧:PagedAttention 与连续批处理诞生于 2022-2023 年,至今仍是每个新引擎的地基;调度、内存、带宽三条主线上的经典机制,远比任何单点新特性值得花时间。能把这套账本算清楚、并把结论翻译成稳定的系统代码,就是这份岗位最核心的竞争力。
延伸阅读
站内已有多篇与本文知识块对应的深度拆解,可按需选读:
- 连续批处理完全拆解(对应“迭代级调度与选择性批处理”)
- PagedAttention 完全拆解(对应“KV 内存管理与块表”)
- RadixAttention 完全拆解(对应“前缀树与缓存感知调度”)
- DeepSeek-V3/R1 推理系统完全拆解(对应“专家并行、双批重叠与负载均衡”)
- GPU GEMM 优化完全拆解(一)(对应“Kernel 优化的入门路线”)
参考资料
- vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023)
- Orca: A Distributed Serving System for Transformer-Based Generative Models(OSDI 2022)
- SGLang: Efficient Execution of Structured Language Model Programs(NeurIPS 2024,含 RadixAttention)
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
- Mooncake 开源仓库(kvcache-ai/Mooncake)
- Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations(MAPL 2019)
- Triton 官方仓库(triton-lang/triton)
- DeepEP: 面向 MoE 的通信库(deepseek-ai/DeepEP)
- DeepSeek-V3/R1 推理系统介绍(DeepSeek 官方博客)
- vLLM 官方文档(chunked prefill 等特性说明)
- NVIDIA Nsight Compute 文档
- NVIDIA NVLink 产品页
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


