


Epoch 完全拆解:把扩散块编译成稀疏 MoE 服务单元
Epoch 这篇论文的完整标题是 Epoch: Compiling Diffusion Blocks for Sparse MoE Serving,由华中科技大学、西安电子科技大学、启元实验室、清华大学的研究者在 2026 年 9 月提交到 arXiv,并标注为 EuroSys 2027 论文。它要解决的问题非常具体:扩散语言模型每生成一个 token 块,往往要对同一组位置做多轮去噪;如果模型又是稀疏 MoE,那么每一轮都重新路由、重新 dispatch、重新算专家、重新 combine,很多工作其实发生在已经稳定的位置上。
这不是一个“再造模型结构”的工作。Epoch 的核心是服务系统:把一个 diffusion block 当成运行时编译单元,生成一个很小的 block plan,然后在每轮 refinement 中只刷新会影响当前解码决策的值。换句话说,模型仍然是原来的 block-diffusion MoE,推理系统开始理解“这个块已经走到第几轮、哪些位置还活着、哪些专家集合在块内大体稳定”。
论文里有一句很关键的执行契约:
Cache stable block structure. Recompute every value that feeds a live decode decision.
翻成系统语言就是:可以缓存块级结构,但不能缓存会直接决定活跃位置输出的数值。Epoch 的三个模块正好对应 MoE 推理里的三条密集路径:Expert Atlas 缓存专家支持集合,Liveness-Shard Parallelism 跳过稳定 decoded 位置的 routed-expert 计算,FreshLane Dispatch 让通信 payload 也真的变稀疏。
扩散语言模型为什么会把服务系统卡住
自回归模型的服务系统建立在一个朴素假设上:每次 forward 追加一个 token。新的 token 只看过去的 prefix,KV Cache 是 append-only 的,调度器以“每个请求下一步生成一个 token”为节拍运行。vLLM 的 PagedAttention、SGLang 的 RadixAttention、连续批处理,都围绕这个假设展开。相关机制可参考站内的 PagedAttention 完全拆解 与 RadixAttention 完全拆解。
扩散语言模型的生成循环不同。以 block diffusion 为例,系统先拿到一个固定大小的 block,把待生成位置初始化成 Mask,然后执行一次完整 Transformer forward,挑出高置信位置提交成具体 token,剩下的位置继续保持 Mask。下一轮不是在末尾追加一个 token,而是对同一块位置再跑一遍模型,直到这个 block 全部完成。
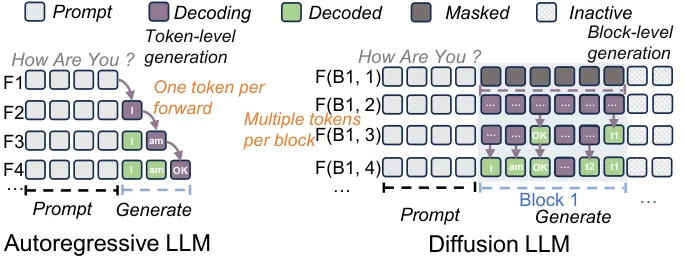
图源:Epoch 论文 Figure 1。左侧的自回归路径每轮追加一个位置;右侧的 diffusion block 在同一组位置上反复 refine,并且一轮可能提交多个 token。这个“同一组位置被完整模型处理很多遍”的事实,是 Epoch 能做优化的根源。
这里要抓住两个概念:
- live position:仍然是 Mask,下一轮 logits 还会被 decoder 用来决定是否提交。
- decoded position:已经提交成具体 token,当前 block 内 token 身份固定。
decoded position 的 logits 不再需要被 decoder 消费,但它不能直接从模型里删掉。原因是 block-diffusion 模型通常在块内使用双向注意力。live position 可以 attend 到 decoded position,decoded position 也可以参与后续层的上下文混合。所以 decoded 位置的“输出决策”死了,但它的 hidden state 仍然是模型状态。
这和自回归 KV Cache 有本质差别。AR KV Cache 缓存的是 prefix 的精确 K/V,它的语义是“过去不会变”。扩散块里的 decoded token 虽然 token id 固定,但周围 live token 还在变化,双向注意力会让层内状态继续受到影响。因此 Epoch 不能说“decoded 位置永远不用算”,只能说“某些 decoded 位置的 routed-expert 输出在有限轮次内足够稳定,可以用有界 staleness 缓存”。
MoE 路径为什么成为瓶颈
Epoch 关注的是稀疏 MoE diffusion language model。标准 MoE 层可以写成:
这里 是 token 位置 的 hidden state, 是 router, 是第 个专家, 是 router 给这个 token-专家边分配的权重。稀疏 MoE 的好处是每个 token 只激活少量专家;代价是服务系统必须执行 route、dispatch、expert compute、combine 这条复杂链路。
在多卡 expert parallel 部署中,一次 MoE forward 通常包含这些阶段:
- 本地 router 计算每个 token 的 top-k expert。
- 根据 expert 所在 GPU,把 token hidden state dispatch 到对应 rank。
- 每个 rank 上的本地专家执行 MLP。
- combine 把专家输出按 token 聚合回 owner rank。
- 后续残差、归一化、注意力、LM head 继续看到完整序列张量。
对自回归解码来说,每轮新增 token 较少,工程重心常常是 KV Cache 和 batch 调度。对 diffusion block 来说,系统会在同一块位置上多次执行 MoE forward。如果服务系统以“单次 forward”为运行单位,它看不到 block 内位置逐步死亡的过程,于是每一轮都会为所有位置重建路由结构、发送所有 token、计算所有专家输出。
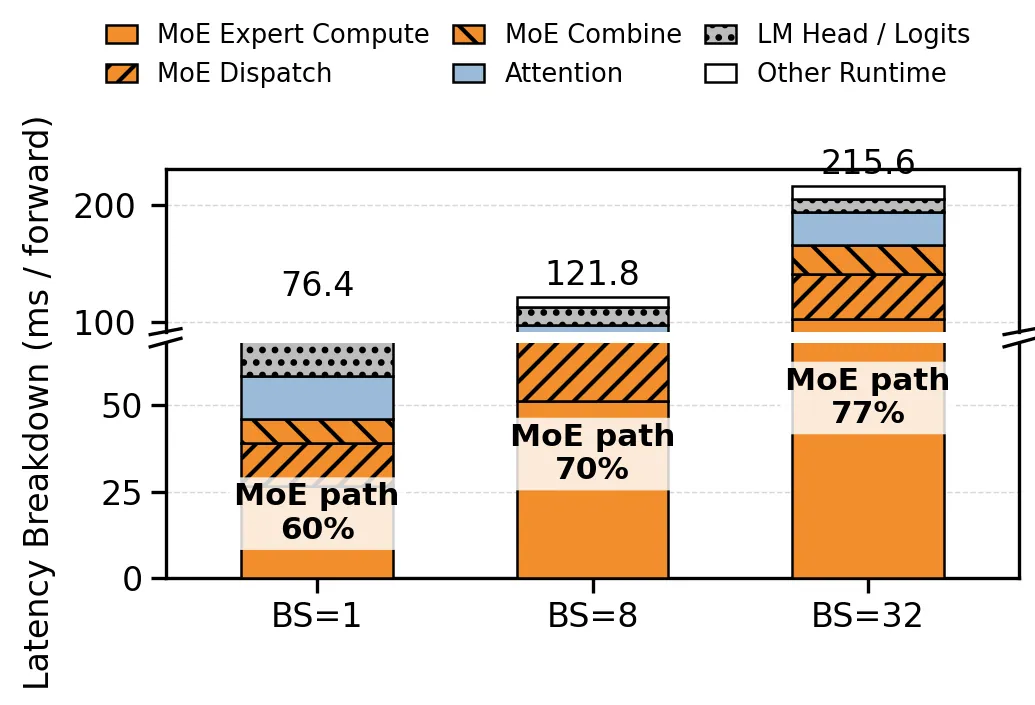
图源:Epoch 论文 Figure 2。作者在优化过的 LLaDA2.0-mini baseline 上拆解 forward 延迟:batch size 为 1 时,单个 forward 为 76.4 ms,MoE 路径已经占 60%;batch size 到 32 时,MoE 路径占比升到 77%。论文强调这个 baseline 已经使用 fused MoE kernel、fused RMSNorm、FlashAttention 和调优过的 collective parallelism,因此问题不是 kernel 太粗糙,而是运行时没有表达“哪些工作在 block 内重复了”。
这也是 Epoch 与普通稀疏 kernel 优化的区别。只把 expert kernel 做快,还不能解决 dense dispatch 和 dense combine;只跳过一些 token 的计算,也不能解决后续层要求完整序列张量的问题。Epoch 的设计目标是让稀疏性穿过整条 MoE 通路:从专家集合、token fresh set,到通信 payload。
Two Clocks:一个 block 有两套时钟
Epoch 的总设计可以用 two-clock rule 概括。diffusion block 内有两类状态:
- iteration clock:每轮 refinement 都变化,包括 hidden state、router logits、top-k 权重、fresh token 的 expert output、live 位置 logits 和 commit decision。
- block clock:只在新 block 开始时变化,或在少数 refresh/update 点变化,包括 active expert support、sequence shard ownership、cache descriptor、compact buffer layout、collective size 等结构信息。
传统 dense MoE runtime 把所有东西都绑在 iteration clock 上。结果是每轮都把专家候选、token 布局、通信 payload 当成全新对象处理。Epoch 做的事情,是把 block-clock 结构抽出来,在 block 开始时编译成一个小 plan;每轮执行时仍然重算会影响 live 解码决策的数值。
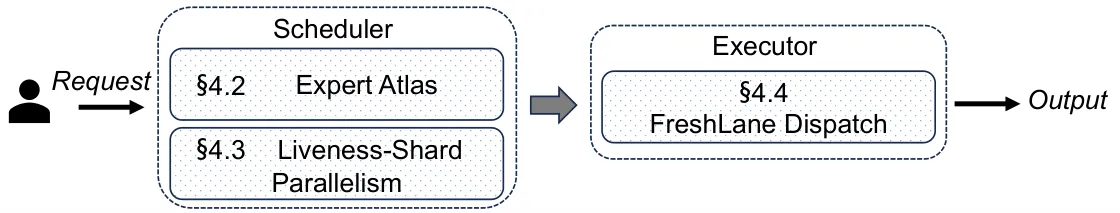
图源:Epoch 论文 Figure 6。Scheduler 在 block 开始时编译 block plan,包含 Expert Atlas 和 Liveness-Shard Parallelism 需要的块级结构;Executor 在每轮 refinement 中执行 FreshLane Dispatch,并产出新的输出决策。
block plan 的内容很克制。它不保存 live hidden state,不保存 live router logits,不保存 live 输出 logits,也不保存专家权重。它保存的是标识符、版本号和映射关系:
- 每一层当前 block 可用的 expert support 。
- token 到 sequence-parallel rank 的 ownership。
- 每层 decoded-output cache 的 descriptor 和 version。
- compact fresh buffer 如何映射回完整逻辑 shard。
- cold、hot-update、hot-skip、refresh 这几条路径的计数器。
当 block 结束,Epoch 会销毁 support、compact index、live mask 和 decoded-token cache。即使下一个 block 的 shape 一样,也不会复用前一个 block 的 plan,因为 token identity 和双向上下文已经变了。
这个边界非常重要。Epoch 不是把 MoE 变成另一种数学层,而是在同一个 executor 里提供一个可退回 dense path 的优化配置:如果 support 不够、cache miss、shape/version mismatch、liveness 迁移异常、refresh counter 到期,相关层或相关 block 就回到 full fresh path。
Expert Atlas:缓存专家支持集合,不缓存路由结果
Expert Atlas 对应 expert axis。它观察到的现象是:在同一个 diffusion block 内,具体 router logits 每轮会变,但覆盖大部分 routing mass 的专家集合往往相对稳定。于是运行时可以缓存“哪些专家是这个 block 这一层的可选目的地”,但不能缓存 token 的 top-k 路由结果。
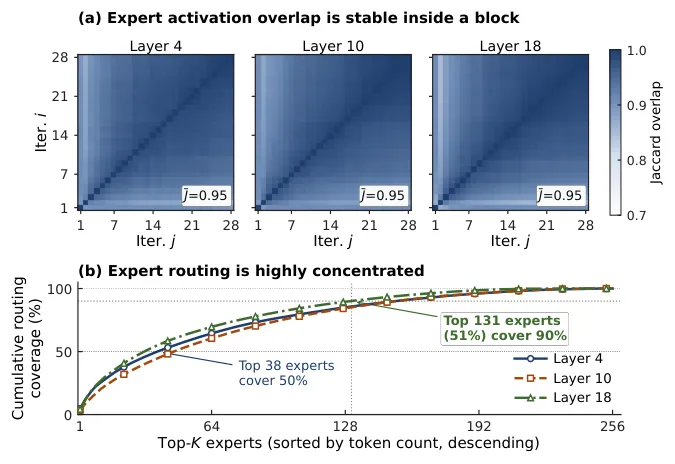
图源:Epoch 论文 Figure 3。热力图展示跨 iteration 的 active expert support Jaccard overlap;覆盖曲线说明 routing mass 集中在较小专家子集上。这个图支持的是缓存 expert support,而不是缓存 expert output。
设某一层有 个专家,一个 block 当前有 个 token。router logits 可以写成:
普通 MoE 会对每个 token 从 中选 top-k。Expert Atlas 在构建 support 时先扩展候选集合:
这里 是模型正常路由的 top-k, 是额外观察的候选专家数。扩展候选不是为了真的激活更多专家,而是为了让 planner 看到“如果当前 top-k 之外的某些专家稍后变得重要,它们是否值得提前纳入 support”。
对 token ,设扩展候选权重为 ,候选专家 id 为 。算法先定义一个目标覆盖质量:
是 token 希望被 support 覆盖到的 routing mass 下限, 是 coverage floor。注意这里用的是正常 top-k 的质量作为基准,而不是扩展候选的总质量;因为目标是不要偏离原模型正常 top-k 决策太远。
给定某层 support ,token 被覆盖的质量是:
Expert Atlas 希望大部分 token 都满足:
表示 dense router 对 token 的 top-k routing mass。论文把目标写成:至少 比例的 token 达到覆盖下限。如果 under-covered token 集合为:
那么 planner 成功时有:
这个 bound 的意义不要夸大。它不是“输出文本一定相同”的证明,而是一个 routing-mass 层面的工程约束:support 至少覆盖大部分 token 的大部分路由质量。真正的 live router logits、top-k 权重和 fresh expert output 仍然每轮从当前 hidden state 重算。
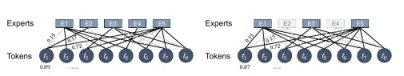
图源:Epoch 论文 Figure 7。左侧是 cold 或 hot-update 阶段看到的 token-expert 候选边;右侧是 hot-skip 阶段复用的 support mask。灰掉的专家只是不可选目的地,不代表复用了旧输出。
Expert Atlas 的执行可以分成三步。
第一步,初始 support 由专家 popularity 决定。对专家 ,累加它在扩展候选图中的权重:
取 最大的 个专家作为初始 。这相当于先把“被很多 token 高权重指向”的专家放进 support。
第二步,修复 under-covered token。对每个尚未在 中的专家 ,算法计算两个量。一个是它能补上的 uncovered mass:
另一个是它能直接满足多少 under-covered token:
最后用一个混合分数挑专家:
偏向“多救几个 token”, 偏向“补上更多质量”。每轮只加入最多 个 positive-score expert,避免 support construction 自己变成重负载。
第三步,在 hot path 中复用 support mask,但不复用 routing table。每轮 fused routing kernel 仍然加载当前 logits 和 router bias,执行模型的 group-limited top-k 规则,只是把可选专家限制在 内。token 的专家 id、专家顺序、routing weight 都可以逐轮变化。
这就是 Expert Atlas 最容易被误解的地方:它不是把 top-k ids 缓存下来,也不是把某个 token 的专家输出缓存下来。它只是在当前 block 和当前 layer 中,把“专家宇宙”从全量专家收缩到一个 coverage-driven support。
Liveness-Shard Parallelism:decoded 位置不出 fresh MoE 路径
Expert Atlas 解决的是“去哪些专家”的问题,Liveness-Shard Parallelism 解决的是“哪些位置需要 fresh routed-expert 计算”的问题。
在 diffusion block 里,live 位置仍然需要 logits 做 commit decision,所以它们必须走 fresh MoE。刚刚从 Mask 变成 committed token 的位置也必须 fresh 一次,因为它的 token identity 刚变,不能立刻用旧缓存。只有已经连续至少一轮保持 decoded 的位置,才有资格读 decoded-output cache。
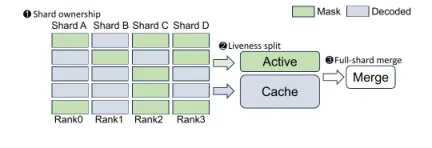
图源:Epoch 论文 Figure 8。sequence shard ownership 保持完整序列分片;liveness split 把 live 和 newly decoded 位置送入 fresh MoE;full-shard merge 在层边界恢复完整逻辑 shard。
设第 轮的 decoded 位置集合为 ,上一轮模型 forward 看到的 decoded 集合为 。稳定 decoded 位置是:
新 decoded 位置是:
live 位置是当前仍为 Mask 的位置。Epoch 的 fresh set 可以理解为:
也就是说,在正常 hot iteration 里,除了稳定 decoded 位置,其余都 fresh:live 位置 fresh,newly decoded 位置 fresh,refresh-required 位置 fresh。
论文给出的 hot iteration 状态机有几个细节很关键:
- 每个 MoE layer 都有自己的 decoded-output cache 。
- cache 存的是 routed-expert output,不是整层输出,也不是 hidden state。
- fresh token 会被 compact 成稠密小 buffer,然后进入 routing、dispatch、expert kernel、combine。
- fresh output 返回后 scatter 回完整 shard,stable decoded 位置从 cache 填充。
- layer epilogue 看到的仍然是完整 ,后面的 residual、norm、attention 不需要理解 ragged tensor。
用更接近实现的形式,可以把每层 MoE 路径写成:
这里 是当前 rank 持有的 sequence-parallel hidden shard, 是 fresh positions 的 compact buffer, 是 fresh routed-expert 输出, 是恢复后的完整本地 shard。
为什么不直接把 decoded position 从整个模型删掉?因为 attention 仍然需要完整上下文。LSP 只在 routed-expert 分支上做跳过,并在层边界恢复完整 shard。它没有改变注意力、残差连接、归一化、shared expert 和 live-token decode decision 的语义路径。
论文还特别强调 newly decoded 位置必须 fresh 一次。假设某个位置在第 轮刚从 Mask 变成 token id ,它上一轮缓存如果存在,也是 Mask 身份或旧状态下的 routed-expert output。直接缓存复用会把一个未提交位置的专家输出错当成 committed token 的专家输出。因此 newly decoded 位置先 fresh,更新 cache;下一轮如果仍然 decoded,才进入 stable decoded 集合。
decoded-cache 的刷新周期为什么默认取 5
LSP 的缓存不是精确缓存,而是 bounded-age approximation。论文用相邻 iteration 的 routed expert output cosine similarity 来解释这一点:decoded token 的 expert output 比 live Mask token 更稳定,但 staleness 继续增长后相似度仍会下降。
作者在论文中报告:当 refresh period 时,平均 cosine similarity 仍高于 0.95,方差带也较窄。因此默认使用 。如果 ,decoded branch 每轮都 fresh,等价于 decoded-cache 不引入数值 staleness;如果 更大,latency 继续下降,但质量风险上升。
对一个 stable decoded cache entry,Epoch 约束它的 age:
cache key 绑定当前 block、layer、rank-local position 和 version。block 边界会清空 cache;version mismatch、shape mismatch、mask transition 异常都会触发 full fresh path。
判断这个近似是否影响输出,论文给了一个局部 sufficient condition。对 live 位置,设 dense executor 的 logits 为 ,Epoch 的 logits 为 。设 是局部 decision margin,它取 top-1/top-2 gap 与 threshold decoder slack 中更保守的部分。如果:
那么 Epoch 和 dense executor 会选择相同 top token,并做出相同 commit/no-commit decision。这个公式的含义很直观:只要近似扰动没有越过解码边界,文本决策就不变。它不是全局质量保证,但给出了为什么“缓存 decoded routed-expert output”可以在工程上可控。
FreshLane Dispatch:只稀疏计算不够,通信也要稀疏
如果 LSP 只是在 expert kernel 内跳过 decoded 位置,但 dispatch/combine 仍然移动全块张量,那么收益会被通信壳吃掉。FreshLane Dispatch 的目标是让 fresh token-expert worklist 成为 expert-parallel payload 本身。
论文 HTML 里 FreshLane 的 Figure 9 是 SVG,这里不额外转换为 PNG;它描述的是一条非常直接的通信协议:
- pack:每个 rank 根据 fresh mask,把 fresh hidden state、owner position、routing metadata 写入 contiguous compact buffer。
- count exchange:expert-parallel group 内交换每个 rank 的 fresh row count,计算 offset 和 dispatch size。
- sparse dispatch:只移动 valid fresh rows。若后端必须使用静态 shape,可以 padding,但 invalid slot 不加载专家权重、不参与 reduce。
- light-traffic expert kernel:同一个 fused expert computation 作用于更小 worklist。
- combine:按 compact offset 反向返回 fresh output。
- scatter/merge:把 fresh output 写回完整 shard,stable decoded 位置从 cache 补齐。
FreshLane 有两个边界条件。
第一,它不是新 MoE 数学算子。对 valid fresh pair ,它执行的 expert computation 与 dense path 相同,只是 worklist 更短,eligible support 可能被 Expert Atlas 限制。
第二,compact layout 只存在于 MoE communication region 内部。attention、RMSNorm、residual 和后续 layer 仍然看到完整逻辑 shard。这样做避免了“稀疏 tensor 泄漏”问题:如果后面的通用算子都要理解 ragged layout,整个推理框架会被迫重写。
FreshLane 也是 Epoch 三个模块里最系统化的一环。Expert Atlas 降低了“可能去哪些专家”;LSP 降低了“哪些位置要 fresh”;FreshLane 把这两个结果落实到网络和 kernel payload 上。如果没有 FreshLane,前两个模块可能只是把瓶颈从计算转移到内存访问和 interconnect。
cold、hot-update、hot-skip:block plan 的生命周期
Epoch 把一个 diffusion block 当成短生命周期 execution epoch。它的运行路径可以拆成四类。
cold path 在 block 开始时执行一次。它清空 per-block cache,初始化 live set,记录 sequence-shard ownership,为每个 MoE layer 构建初始 Expert Atlas support,并准备 LSP 所需的 metadata。
hot-update path 仍然属于 block 内 hot iteration,但会用当前 router logits 重新构建 support。它适合 support 可能漂移、或者 update counter 到期的场景。
hot-skip path 是最常见的复用路径。它复用上一轮 support mask,但仍然重算当前 gate logits、top-k weights、fresh expert outputs、live logits 和 decode decisions。
refresh path 会把所有位置重新送入 fresh routed-expert 路径,刷新 decoded-output cache 的 age。默认 意味着 stable decoded cache 最多跨过 4 次 intervening hot iteration。
这套生命周期使得 Epoch 的失败模式偏保守。任何缓存缺失、support coverage 不足、版本不匹配、liveness 迁移异常,都退回 full fresh,而不是继续使用可疑状态。
实验设置:8 张 H100 上的 block-diffusion MoE 服务
论文的实验平台是一台 8×NVIDIA H100-80GB SXM5 节点,GPU 间通过 NVLink/NVSwitch 连接,peer bandwidth 为 900 GB/s;CPU 是 2×AMD EPYC 9654,内存 1.5 TB DDR5。软件栈为 CUDA 12.4、PyTorch 2.4、NCCL 2.22、Triton 3.0。Epoch 构建在 vLLM-style fused-MoE runtime 上。
模型覆盖三个 open-weight block-diffusion MoE:
| 模型 | active 参数 | total 参数 | context | block size |
|---|---|---|---|---|
| LLaDA-MoE | 1B | 7B | 4096 | 32 |
| LLaDA2.0-mini | 1.4B | 16B | 4096 | 32 |
| LLaDA2.0-Flash | 6.1B | 100B | 4096 | 32 |
workload 包括 GSM8K、HumanEval、MGSM 和 MT-Bench。解码策略是 greedy threshold decoding,commit threshold ,每个 block 最多 64 个 refinement steps,如果 block 内位置提前全部 decoded 就 early exit。
baseline 包括:
- dInfer without cache:公共 dInfer release,不启用 KV/MoE cache,代表 dense dLLM serving path。
- dInfer cache:启用 dInfer 的 per-position cache,是较激进的已发表 cache baseline。
- SGLang:使用其 block-diffusion support,代表把通用 LLM serving runtime 扩展到 dLLM 的路径。
- Epoch full compute:Epoch runtime 但关闭两个近似 relaxations。
- w/o Expert Atlas:保留 token-side skipping,但不缩小 expert universe。
- w/o Liveness-Shard Parallelism:保留 support restriction,但所有位置仍走 fresh MoE。
分布式放置固定为一份 8-GPU replica:DP=1、TP=8、EP=8、SP=8。这里 TP 与 EP 是对齐的 parallel groups,不是相乘的 64 卡;EP 定义 expert ownership 和 dispatch/combine group,TP 定义 dense tensor parallelism,SP 与 TP 对齐。
端到端结果:batch 越大,block-plan 越有价值
论文最重要的 end-to-end 结论是:Epoch 的收益随 batch size 和模型规模扩大而增加。batch size 32 时,所有系统都能跑,最强 cache baseline 往往接近 Epoch,因为早期 block iteration 仍有很多 live positions,block-plan bookkeeping 还没有被充分摊销。
batch size 增大后,forward-scoped runtime 继续移动和计算 dense token payload;Epoch 则让 stable decoded positions 留在 cache path,只让 live、newly decoded、refresh-required 位置进入 expert dispatch、expert kernels、combine 和 live-position output decoding。
论文报告的速度区间如下:
| batch size | Epoch 相对最强 surviving baseline |
|---|---|
| 128 | 约 1.1× 到 1.3× |
| 256 | 7B 上约 1.3× 到 1.4×;16B 上约 1.6× 到 1.7×;100B 上约 1.5× |
| 512 | 7B 上 surviving baseline 仍慢 1.7×;16B 上慢 1.8× 到 1.9×;100B 上慢 2.6× 到 2.7× |
另一个关键点是 OOM。batch size 512 时,Epoch 在三个模型和四个 workload 上都保持可行,而多个 baseline 已经因为 materialize dense MoE activations 而失败。这里的收益不是“某个单 forward 快一点”,而是 block-plan execution 改变了高 batch 服务下的内存和通信形态。
在线服务实验也能看到类似趋势。论文在 LLaDA2.0-mini 上比较 Epoch 与 SGLang,在 6 到 26 req/s 的 Poisson 请求流下观察 P95 equivalent inter-token latency。轻负载时 SGLang 略低,因为 Epoch 的 block-plan bookkeeping 是固定成本;当请求率升高,SGLang 的尾延迟升到 100 到 110 ms,而 Epoch 基本保持在 55 到 60 ms。曲线大约在 16 req/s 交叉,之后 Epoch 的 P95 ITL 低 1.7× 到 1.8×。
这个现象说明 Epoch 更像“高并发下维持尾延迟”的系统优化,而不是单请求 latency hack。并发越高,dense MoE payload 越容易把队列推爆;fresh-token worklist 越紧凑,cache path 越能吸收额外负载。
消融:三个模块各自拿掉什么瓶颈
论文的 quality-latency tradeoff 图有两个结论。
第一,Expert Atlas 和 Liveness-Shard Parallelism 是互补的。去掉 Expert Atlas,系统仍然可以跳过 stable decoded token,但 expert universe 变大,MoE kernel 和 dispatch 目的地更多。去掉 LSP,系统仍然可以限制专家集合,但稳定 decoded 位置继续消耗 fresh MoE。完整 Epoch 能把 iteration time 往左推,同时保持在 dense-quality plateau 上。
第二, 是刷新周期的 knee point。 是 decoded branch 的 exact envelope,但几乎没有 cache staleness 带来的收益。增大 会减少 iteration time,直到 attention、live-token MoE、live logits 和 sparse-runtime overhead 成为新的瓶颈。超过 knee 之后,速度收益变小,但 cache staleness 穿过 decision margin 的风险更高。
论文还从硬件 counter 拆解收益来源。Expert Atlas 单独加入时,计算量大约减半,同时 memory access 也下降。再加入 LSP 后,计算进一步从 0.56 降到 0.34,但 memory access 会回升,因为 live/decoded split 仍然触碰 cache row 和 bookkeeping tensor。FreshLane 加入后,把 memory access 压到 0.29,communication 压到 0.60。这个结果解释了为什么只做 token skip 或只做 expert restriction 都不够:稀疏性必须穿过 dispatch、kernel、combine、cache merge 的完整链路。
Epoch 与 KV Cache、PagedAttention、投机解码的关系
Epoch 很容易被误读成“扩散语言模型版 KV Cache”。这个类比有帮助,但不能过度使用。
PagedAttention 解决的是自回归请求里 KV Cache 如何分页管理、共享前缀和避免显存碎片。它的缓存对象是 prefix K/V,语义上精确且 append-only。Epoch 的 decoded-output cache 是 block-scoped、有 age bound 的近似缓存;cache entry 只在当前 block、当前 layer、当前 rank-local position 和当前 version 下有效。
投机解码则是“先用便宜路径猜 token,再用目标模型验证”。Epoch 不是 draft-verify 框架,它没有引入草稿模型,也没有改变目标模型的解码接受规则。它只是观察 diffusion block 内部的生命周期,把不会影响 live decode decision 的重复 MoE 工作裁掉。投机解码相关机制可参考站内的 MTP 完全拆解 与 DFlow 完全拆解。
SGLang/RadixAttention 的前缀复用也不同。RadixAttention 的复用粒度是跨请求共享 prefix;Epoch 的复用粒度是单个 diffusion block 内的结构和 stable decoded routed-output。一个是跨请求 prefix tree,一个是块内 two-clock execution。
部署价值与边界
Epoch 的价值建立在几个条件上。
第一,模型必须有足够长的 block 内 refinement 生命周期。如果 block 很小,或者一两轮就全部 decoded,block plan 的 fixed overhead 不一定能摊销。
第二,MoE 路径必须是主要瓶颈。论文 Figure 2 显示 MoE 在优化 baseline 中占 60% 到 77% forward latency,所以裁剪 MoE payload 才会转化成端到端收益。如果模型主要瓶颈在 attention 或 LM head,收益会被上限限制。
第三,expert support 和 decoded-output 必须在 block 内足够稳定。如果路由集合每轮剧烈变化,Expert Atlas 要么频繁 hot-update,要么 support 变大接近 full expert set;如果 decoded-output staleness 经常跨过 decision margin,就必须缩短 ,LSP 收益也会下降。
第四,通信后端要能受益于 compact payload。FreshLane 的 count exchange、variable-size dispatch、compact combine 对 backend 要求更高。若 collective 接口只能接受大矩形 buffer,虽然可以 padding shadow rows,但实现必须保证 invalid slot 不加载专家权重、不参与 reduce,否则通信壳仍会吞掉收益。
第五,在线服务还需要关注尾延迟和缓存维护成本。论文已经给出 Poisson request stream 下的 P95 ITL,但真实生产环境可能还有 prompt 长度分布、block size 分布、专家负载偏斜、跨节点 RDMA 拓扑、不同 workload 混部等变量。Epoch 的方向很清楚,但部署价值仍要用真实并发负载来验证。
小结
Epoch 的关键贡献不是“发现扩散语言模型有并行性”,而是把这种并行性落到服务系统可执行的对象上。它给 diffusion block 定义了两套时钟:block clock 上的结构可以计划和复用,iteration clock 上影响 live decode decision 的数值必须重算。
围绕这条边界,Expert Atlas 缓存专家支持集合,Liveness-Shard Parallelism 让 stable decoded 位置读取有界缓存,FreshLane Dispatch 让 fresh worklist 真正成为专家并行通信 payload。三者合起来,才把“算法上有些位置已经稳定”变成“硬件上真的少算、少搬、少通信”。
对推理系统来说,Epoch 最有启发的地方是执行粒度的改变。自回归服务系统把 forward/token 当成核心单位,扩散语言模型则需要 block-aware runtime。未来如果 diffusion language model、MoE、长上下文和高并发服务继续交汇,类似 Epoch 这样的 block-plan 思路很可能会成为系统栈里的基础抽象。
参考资料
- Epoch: Compiling Diffusion Blocks for Sparse MoE Serving
- Epoch arXiv HTML version
- Block Diffusion: Interpolating Between Autoregressive and Diffusion Language Models
- Large Language Diffusion Models
- LLaDA-MoE: A Sparse MoE Diffusion Language Model
- dInfer: An Efficient Inference Framework for Diffusion Language Models
- dInfer GitHub repository
- SGLang: Efficient Execution of Structured Language Model Programs
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


