


世界模型从零讲起(三十四):同一任务里哪里该粗、哪里该细——混合粒度调度与切分点
从上一篇的结尾说起
上一篇讨论的是多粒度结构管理:同一套动力学换一层粒度还成不成立。那里把粒度拆成三个成分(变量选择、时间步长、动作空间),讲了粗化的数学(状态聚合、双模拟),讲了因果抽象的精确与近似两种形式,讲了世界模型里的四个粒度层次,最后把抽象误差分解成投影、动力学、读回三项,并给出 rollout 中的复合误差估计 。那一篇的第九节把”该用哪一层”写成了一个带预算约束的调度问题,最后留了一句:更精细的做法是混合粒度调度,不是整段用一个粒度,而是根据任务状态选择粒度;同一任务里怎么切,下一篇专门讲。
这一篇接着做这件事。前提先摆清楚:上一篇给出的是一个”整段选一层”的规划,这一篇要解决的是在一段任务内部,切分点落在哪里。任务越长、越不均匀,这个问题越尖锐。一次抓取并放置,前半段是手臂从远处自由移动到杯子附近(几百毫秒到几秒的自由空间运动),中间是接触瞬间到夹爪稳定(几十毫秒内状态剧变),后半段是端着杯子走到水槽(又回到自由空间运动),最后是放下(再次接触)。如果整段用关节级细粒度,自由移动段的绝大部分前向计算都花在”预测一条几乎直线的轨迹”上;如果整段用任务级粗粒度,接触瞬间的碰撞、滑移会被抹平,粗层不但预测不准,还可能给出一个物理上根本不存在的”顺利抓稳”。两种整段策略都错,因为任务本身在不同段上有不同的误差敏感度。
所以切分点不是调参,而是对任务动力学结构的测量。这一篇会给出三个可测的信号——接触密度、动力学稳定性、任务结构——把它们合成为一个逐段决策的调度器,再用经典的数值优化方法把”在算力预算下最小化复合误差”变成一个可求解的问题,最后落到三类真实系统(分层世界模型、自回归视频生成、模型基规划)里看这些选择长什么样。
一、切分点为什么是问题本身
1.1 从”整段选一层”到”逐段选择”
先把上一篇第九节的 0-1 规划重写一遍,这次把时间轴切开。
设任务物理时长为 ,切成 段,第 段跨度为 ,长度 。每段允许选的粒度层 ,第 层的时间步长 、单步抽象误差 、单次前向代价 。第 段在第 层上需要的预测步数是 。
决策变量是 ,表示第 段用第 层。
和上一篇的区别只有两点,但两点都改变问题的性质。
第一,误差约束变成了逐段的 ,而不再是一个全局门限 。这就是切分点的来源:任务不同段的容错不一样。抓取接触段末端位置容错可能是 2mm,自由移动段可以是 5cm,这两段的 差了一个数量级。
第二,每一段的误差 不再是独立计算的,而是以上一段终点状态为初始条件的复合误差:
这里 是第 段在第 层上 rollout 的雅可比传递算子范数(单步扰动在该段内被放大的倍数,对应上一篇的 形式), 是跨段映射的误差传递比——上一段的终点误差以什么比例进入这一段的初始条件。因为相邻两段用的粒度可能不同, 实际上是一个”粗层终点误差 细层初始误差”或反向的换算系数。
这个递推式子就是整篇的技术骨架:切分点决定了误差在段与段之间怎么接力,而接力比决定了总误差是不是等于各段之和。
1.2 切分点处的两类误差
上一段结尾的误差进入下一段,有两类截然不同的处理方式,这是切分点设计里最容易被忽略的地方。
第一类:状态交接。 上一段的预测终点 作为下一段的初始条件。如果两段同粒度,这个交接是零开销的。如果粒度不同,就需要把状态从一个粒度映射到另一个粒度:从物体层(几个物体的位姿)下到关节层(关节角与角速度),需要一个逆运动学式的映射,映射本身就有误差;从关节层上到物体层,需要聚合,聚合有投影误差(上一篇的三项分解里第一个)。
第二类:预测交接。 更隐蔽的一类。上一段的 rollout 在 时刻终止,但真实系统在 时刻的状态并不是”上一段预测终点”,而是”上一段起点状态 + 上一段的真实执行结果”。如果系统是闭环的(执行器真的动了),那么下一段应该以观测到的状态为起点重新初始化,而不是以预测终点为起点。这就是规划里的 receding horizon(滚动时域)思想:每走一步就用新观测重规划。
这两类处理的结果差别巨大:
- 状态交接、不做重初始化(开环):误差沿 累积。切分点越多,每一段都要重新”接”一次上一段的误差,切分本身会引入额外的累积。
- 预测交接、每段开头重初始化(闭环):误差在切分点被观测截断。 的递推里 这一项被清掉,只剩段内复合。
这给出了第一个反直觉结论:切分本身是有代价的。 切得越细,开环情形下误差累积路径越细碎、跨段映射误差越多。闭环情形下切得越细反而越好,因为每次切分都是一次用真实观测纠错的机会。这直接决定了后面调度器必须知道系统是闭环还是开环——这是任务结构信号的一个维度,第四节会展开。
1.3 粒度切换的非单调性:一个必须先破的直觉
在讲三个信号之前,要先把一个错误的直觉拆掉:“更细的粒度在切分点附近总是更好”。
上一篇第九节的数值例已经证明粒度选择不是查表。这里再补一个切分点特有的非单调现象。考虑接触段的最优化问题:接触段的容错很小( 小),直觉说必须用细粒度。但如果接触段的动力学是指数不稳定的(,比如刚体碰撞、摩擦锥边界),细粒度意味着这一段的 很大( 小),复合误差里的 因子把误差指数级放大。上一篇的情形 C 就是这么算的:、 时细层复合误差是 量级,而粗层()只有 。
所以接触段的正确做法可能不是”细粒度”,而是”能保留不稳定型态、且时间步长不超过不稳定时间尺度的粒度”。这里有一个明确的判据:不稳定时间尺度。扰动增长率是 ,误差翻倍需要的时间是 个步长。粗层的时间步长必须小于这个翻倍时间,否则粗层在一步之内就”跨过”了不稳定模式,把它平均掉了。对 、ms 的系统,翻倍时间约 步、ms;ms 的粗层勉强在边界,s 的粗层明显越界。
这就给出切分点附近的粒度不连续性:容错要求细,稳定性要求步长不越界,两者交集往往是一个中间层,而不是最细层。第五节合成调度器时,这个交集会变成一个硬约束。
二、信号一:接触密度
2.1 接触为什么是分段的第一信号
接触是机器人动力学里唯一一类离散事件:两个物体要么接触、要么不接触,没有中间态。接触状态的改变会让运动方程的形式变掉,力从零跳到有限值,速度可能瞬间改变。用控制论的话说,这是一套混合系统(hybrid system):连续演化(自由运动)与离散跳变(碰撞、黏滞、滑动切换)交替出现。Henzinger 1996 年的《The Theory of Hybrid Automata》把这类系统形式化为”状态空间 + 一组模式 + 模式之间的守卫条件与重置映射”,这也是描述接触最标准的框架。
形式地写,一个混合系统是六元组 :
- :连续状态空间(位置、速度、关节角);
- :离散模式集合。对抓取任务,;
- :每个模式内的连续流(vector field),例如自由模式下 ,夹持模式下加上夹爪约束;
- :守卫集合。模式 在什么条件下切换到 。接触的守卫是”距离函数为零且法向相对速度小于零”,即 ;
- :重置映射。切换瞬间状态怎么跳。碰撞模式下速度按恢复系数改变,, 是恢复系数;
- :初始模式与初始状态。
关键在 。 重置映射是不连续的: 和 之间没有过渡,是一步跳变。任何时间步长 大于这个跳变的”持续时间的状态描述”,都会把这个跳变平均掉。世界模型——不管多大规模——在离散时间上做预测,都只能学到一个”经过 后状态变成了什么”。如果 足够小,跳变在一步内可见,模型可以学到 (或者更一般地,学到碰撞前后的映射);如果 太大,模型学到的是”这段时间里速度变了”,但无法区分”因为接触力改变了速度”和”因为碰撞瞬间改变了速度”,也学不到恢复系数对结果的影响。
这就是接触密度成为切分第一信号的根本原因:它衡量的是在单位时间里,不连续事件出现了多少次。 不连续事件越多,这个时间段对时间步长越敏感,越需要细粒度——或者更准确地说,越需要”步长跨不过事件”的粒度。
2.2 接触的物理时间尺度:一个可算的数
“步长必须小于事件尺度”这句话要变成可操作的设计规则,需要知道接触事件的典型持续时间。
用最常见的罚函数接触模型(penalty contact)估算。设物体质量 ,接触刚度 ,从高度 自由落下。接触期间的运动可近似为质量-弹簧系统,振荡角频率
最大穿透深度由能量守恒给出:,于是
取 kg、N/m、cm(落地高度),算得 mm、N、rad/s、ms。接触持续时间只有四分之一个周期左右,也就是 5ms。
这个数非常关键:它意味着一个 ms 的控制步长整个跨过了接触过程,模型看到的是碰撞前的位置和碰撞后的位置,中间那 5ms 里的力峰值、穿透深度、恢复过程全部不可见。ms 的抓取原语层更是把整个接触过程压缩成一步。这就是为什么接触段的粗细不能按”任务时间”分,必须按”事件尺度”分。
表格对比更直观:
| 粒度层 | 步长 | 与接触事件尺度(5ms)的关系 | 能学到什么 |
|---|---|---|---|
| 关节控制 | 20ms | 跨越 4 个事件时长 | 碰撞前后的平均速度变化,恢复系数不可辨 |
| 抓取原语 | 200ms | 跨越 40 个事件时长 | 只有”接触发生了”这一事实 |
| 子任务 | 1s | 跨越 200 个事件时长 | 只有”抓取成功/失败” |
从表里能看出一条更实际的判据:如果关心接触后的精确状态(速度、姿态、是否滑移),步长必须小于 ;如果只关心接触是否发生,步长可以大到原语级,但必须有独立的接触检测把”发生”这件事显式记下来。 后者就是很多工程系统在做的:世界模型用粗粒度预测,接触状态由一个显式的、快速的接触检测器(触觉传感器、指尖力传感器、关节电流突变检测)单独提供,作为粗层模型的条件输入。这相当于把混合系统的离散部分 交给一个高频的轻量模块,连续部分 交给低频的粗层模型。
2.3 接触密度的定义与测量
把上面的想法量化。在时间窗 内定义接触密度
其中事件 是接触模式的切换(进入、离开、黏滞↔滑动、冲击), 是事件权重。权重取法有三种,分别对应不同的量纲:
- 计数型:,得到”每秒切换次数”。最简单,对冲击和滑动一视同仁。
- 冲量型:,即第 次事件传递的法向冲量,。这个权重把”轻轻放下”和”砸在桌面上”区分开。冲量可以用力传感积分得到,也可以由速度跳变估计 。
- 能量型:,即碰撞损失的能量。它直接对应”这次接触在多大程度上改变了系统状态”,与误差敏感度的相关性最强。
工程上更实用的是接触密度谱,而不是单一标量。做法是把窗内的接触事件按冲量大小分档计数,得到一个直方图。这样做的原因是:接触密度的作用不是决定”这一段粗还是细”,而是决定”这一段需要多细”。一个每秒 20 次轻触( 很小)的段和一个每秒 2 次重击( 很大)的段,计数型密度前者大十倍,但后者才是真正需要细粒度的段。直方图同时保留”频率”和”强度”两个维度,调度器可以据此同时约束步长(看频率)和误差预算(看强度)。
测量层面有两条路径,一条来自传感器,一条来自观测:
- 传感器路径:指尖六维力传感器给出 ;触觉阵列给出接触面积与压力分布;关节电流给出等效力矩。三者都能在 1kHz 量级采样,远快于任何世界模型的推理频率。这条路径的接触检测延迟通常在几毫秒,足以在接触发生后的一个控制周期内被上层感知。
- 观测路径:从视觉或点云里估计接触。做法是计算末端执行器与目标物体表面的有符号距离,距离小于阈值即判为接触;或者用视觉语言模型对一段视频做”接触/非接触”分类。这条路径延迟大(至少一帧,通常几十毫秒),精度差,但不需要额外传感器。它的主要用途是为没有力传感的已有数据打标签,而不是在线检测。
两条路径的误差性质不同:传感器路径有延迟但准确,观测路径准确率低但无延迟约束。调度器要的是”事件发生时刻”,所以在线用传感器、离线训练用观测标签是最合理的分工。这也解释了为什么很多接触密集的机器人世界模型论文都假设有无力传感——有这个信号,接触段的分段问题会简单一个数量级。
2.4 接触段不是”整段都要细”
最后一个容易犯的错误:把”接触密集”等同于”整段细粒度”。
真实接触段内部也是不均匀的。以一次抓取为例,从指尖碰到杯子到夹爪力稳定,时间线上有四个阶段:
- 接近(pre-contact):距离从几厘米到零,无接触,动力学平滑。这一段可以用粗粒度,唯一的要求是不要”跳过”接触瞬间——步长必须小于最后一个接近步。
- 冲击(impact):几毫秒,速度跳变,恢复系数决定反弹。必须细粒度或显式重置映射。
- 稳定(settling):几十到几百毫秒,摩擦锥内的微滑、力从峰值衰减到稳态。这一段动力学是连续但刚性的(stiff):接触刚度大,微小位移产生大力,显式积分容易振荡。粗粒度在这里的误差主要表现为”低估了稳定时间”。
- 保持(holding):秒级,状态几乎不变,只有抓取力维持。粗粒度完全可以。
所以接触段的正确粒度分配是 “两头粗、中间细”,而不是”整段细”。这与数值计算里处理刚性方程的做法完全一致:刚性区间用隐式小步长,平滑区间用大步长。第六节会把这条对应关系讲透。
把四个阶段与粒度对应起来,可以得到一张接触段内部的分段表:
| 阶段 | 典型时长 | 动力学性质 | 推荐粒度 | 理由 |
|---|---|---|---|---|
| 接近 | 100–500ms | 平滑、可控 | 粗 | 无事件,误差线性累积但可预算 |
| 冲击 | 2–10ms | 不连续跳变 | 最细或显式重置 | 步长跨过事件就丢失恢复系数 |
| 稳定 | 50–300ms | 连续但刚性 | 中 | 需要小步长抑制振荡,但不需要事件级 |
| 保持 | 0.5–5s | 近似静止 | 粗 | 状态几乎不变,粗层误差可忽略 |
这张表本身就说明:切分点的最小单位不是”接触段”,而是”接触阶段”。 一个 2 秒的抓取动作可能要切成七八段,其中真正需要细粒度的只有冲击与稳定两段,总时长不到 300ms。如果按”整段细粒度”处理,90% 的算力花在不需要的地方。
三、信号二:动力学稳定性
3.1 谱半径、Lyapunov 指数与”稳定性”到底指什么
接触密度回答的是”事件多不多”,稳定性回答的是”没有事件的平滑段里,误差会不会自己爆炸”。这两件事是正交的:一段自由空间运动可以有很低的接触密度,但如果对象是倒立摆或高速飞行,动力学照样不稳定;一段接触保持可以很平稳。
形式上,一条参考轨迹 的线性化动力学是
对离散时间世界模型, 换成一步的雅可比 。稳定性由Lyapunov 指数刻画:
表示相邻轨迹指数收缩,扰动被吃掉; 表示指数发散,扰动被放大。上一篇用的 就是这个量。这里要多说一句上一篇没细讲的:世界里几乎没有真正”中性稳定”的系统(,)。 只在两种情形出现:一是线性系统恰好停在稳定边界,二是段很短、误差还没来得及显现。后一种才是工程里最常见的——因为段短,误差放大的倍率还没积累起来,所以看起来”似乎无关”。这也解释了为什么上一篇情形 A 里三层复合误差”恰好相近”:那是段短到指数项来不及发力的临界区。
3.2 分段稳定性:一个段一个谱半径
切分点的核心事实是:谱半径是分段的,不是全局的。 一条机械臂轨迹,前 2 秒接近段 ,接触后 50ms 稳定段 ,保持段 。用一个全局 做粒度选择,会在这三段里做出三个都错的判断。
因此调度器需要的不是全局谱半径,而是分段谱半径序列 。它可以通过三种方式获得:
- 从世界模型上直接测:在训练好的潜空间模型上做有限差分,取一段参考轨迹上随机扰动 ,算一步转移后的放大比 。重复多次取均值,得到该段的经验谱半径。这个方法不依赖真实系统,但依赖世界模型本身的准确度——如果模型本身漏了不稳定模式,测出来的 偏小。
- 从真实轨迹上估计:用真实执行数据拟合局部线性模型(一段轨迹上的 least-squares 线性回归),取其特征值模长的最大值。这个方法更准,但需要足够的数据覆盖该段的状态空间。
- 从先验知识给出:接触段、倒立类任务、高速旋转物——这些段的 有经验区间,可以直接设为保守值(例如 )。
串联式潜空间预测的典型结构,可以在第四节给出的分层世界模型示意图里看到:状态 的箭头逐级相接,每一步都以上一步的输出为输入。这正是开环误差累积的来源——第 步误差要经过第 步的雅可比才能到更大的尺度。如果把它改成分段、每段用真实观测重新初始化,箭头就会在每个切分点断开,误差累积路径随之被截断。在这个意义上,一张层次规划图同时也是分段谱半径的测量载体:每一段的状态转换都是一个可测的 。
3.3 稳定段与不稳定段的粒度反转
把第二节的接触时间和这节的谱半径放在一起,能得出一个粒度反转规则,它和直觉正好相反:
- 稳定段()里,误差被收缩,粗粒度的大单步误差不会被放大。所以稳定段可以放心用粗粒度——真正的约束来自 本身和段长,而不是放大。
- 不稳定段()里,粗粒度反而常常更稳,因为 小意味着指数放大的次数少。但前提是不稳定模式没有被粗化合并掉。如果粗层把碰撞抹平, 是虚假的收缩,实际执行时细层的不稳定照样发生。
所以不稳定段的选择规则要写成三段:
- 粗层的谱半径 必须和细层一致地反映不稳定性(即粗化保留了不稳定模式)。检查方法:在粗层和细层上分别测 ,如果两者都 且量级相近,说明模式被保留;如果细层 、粗层 ,说明不稳定模式被合并掉了,禁止在该粗层做决策。
- 粗层步长 必须小于不稳定模式的时间尺度(1.3 节的翻倍时间)。
- 满足前两条后,选复合误差最小的层——通常是不稳定段里”最粗但合规”的那一层。
这条规则把”稳定/不稳定”从定性描述变成了可执行的硬约束。它也解释了一个工程现象:为什么很多分层世界模型在自由空间导航上效果很好,一到精细操作就退化——因为自由空间是稳定段,粗层误差被收缩,怎么粗都行;精细操作是不稳定段,粗层一旦合并了接触模式,谱半径就失真了。
3.4 刚度:稳定性的另一面
还有一个与谱半径相关但不同的量:刚度(stiffness)。刚性接触的动力学写成 ,其中 的特征值量级很大( 量级)。它的后果不是误差放大(特征值可能是纯虚的,),而是显式积分的不稳定性:对一个线性刚性方程 ,显式 Euler 步长 要求 ,即 。 时步长必须小于 ms,这比任何世界模型的粒度都细。
这意味着刚性段不能靠”选更细的粒度”解决,必须改预测方式。两种可行做法:
- 隐式或半隐式更新:世界模型在潜空间里用隐式格式(如多层隐式层的残差)更新,或者干脆在潜空间里加一层”刚性分离”——粗层把快速动态从慢速状态里剥离,只预测慢速状态的演化(这正好与上一节”接触段两头粗中间细”的观察对应)。
- 把刚性段作为一个黑箱原语:即用一个小的时间步长做”稳定段内的快速循环”,外层只是调用它,不对外层预测它的内部状态。这正是分层规划里 option 的做法:上层不需要知道 option 内部的细节,只关心它结束后的状态。
刚度这件事在第二节已经以”稳定阶段”的形式出现过。两个信号在这里交汇:接触密度给出”事件多不多”,刚度和谱半径共同给出”平滑段里步长能不能大”。二者合起来,就是调度器第二个信号的完整内容。
四、信号三:任务结构
4.1 任务结构比动力学更”软”,但同样可测
前两个信号是动力学的:接触事件和谱半径,都可以从动力学方程或系统模型上测。第三个信号任务结构不同——它不由动力学决定,而由任务目标决定:任务要达成什么状态、什么是成功、失败代价多大、动作空间有多丰富。
为什么任务结构也要作为切分信号?因为它决定了误差约束 和算力预算的方向。同样是 5cm 的位置误差,在”把杯子放到水槽里”的接近段无害,在”把胶囊插入药瓶”的插孔段致命。动力学完全一样,任务要求不同,切分点就不同。这本质上是一个任务对误差的敏感度问题,与第三章讨论的”粗层对干预的充分性”是同一个精神:一个粒度对一个任务是否够用,取决于在这个任务关心的所有量上,粗化是否忠实。
任务结构的可测形式,本文采用四个量:
- 子目标序列:任务在什么状态算是完成了一个子目标、进入下一个。
- 成功判据的容差:最终结果的容差是多少。
- 约束的硬软程度:不满足某个约束是”扣分”还是”直接失败”(碰撞禁碰区、力矩上限等)。
- 闭环与否:规划是每步重规划,还是整段开环执行一次。这一项直接决定误差在哪被截断(1.2 节)。
4.2 子目标与 option:任务结构的最小单元
“子目标”就是任务结构里最小、也最经典的单元。Sutton、Precup 与 Singh 在 1999 年的《Between MDPs and semi-MDPs: A Framework for Temporal Abstraction in Reinforcement Learning》里引入了 option:一个 option 是三元组 ,启动集 、内部策略 、终止条件 。执行一个 option 就是执行 直到 触发。一个 option 的典型时长 就是它的天然切分长度。
上一篇已经讲过 option 作为时间抽象,也讲过 Rodriguez-Sanchez 与 Konidaris 在 2024 年给出的动力学保持抽象——那条路线回答的是”给定 option 集合,能不能学出一个压缩映射让粗层轨迹与细层一致”,本质上是为本文的任务结构信号提供理论支撑。这里要加的新内容是:option 的边界就是切分点的候选,但候选不等于必选。 一个 option 内部的动力学如果前半段平滑、后半段接触,那么 option 自然边界切出来的一段仍然需要在内部切一刀。反过来,两个相邻 option 如果动力学连续、只是任务目标换了个名字,那在它们之间切开是多余的——只会增加跨段映射误差(1.2 节)却没有增加任何误差控制能力。
所以任务结构信号的作用不是”直接给出切分点”,而是:
- 给出候选切分点集合(option 边界、子目标达成时刻、约束激活时刻);
- 给出每个候选点的价值:在这个点切开的收益有多大(误差截断、容错变化)。
4.3 分叉点:任务结构里最贵的切分
上一节的 option 视角漏了一类最重要的切分:分叉点。所谓分叉点,是任务在某个状态下有多个可行后续(多条子目标路径、多个策略分支)的时间点。分叉点的特殊之处在于它同时满足:
- 分叉的判定依赖精确的状态(位置差 1cm 可能走向完全不同的分支);
- 分叉后的误差代价不是线性的:走错分支不是”终点偏一点”,而是”任务失败”。
上一篇第九节把分叉点列为需要”能保留所有分叉的粒度,并在分叉后用细粒度重放一段”。这里把它形式化为一个额外约束:在分叉点前,调度器要求该段的分支判别准确率大于某个阈值:
其中 是第 段可能出现的分支集合, 是粗层根据 推断的分支。 取 0.99 量级——分叉点必须是”要么几乎一定对,要么干脆用细粒度”的二元判断,不能接受 0.9 量级的中等准确率,因为 10% 的走错分支会带来完全失败。这个阈值是任务结构信号在调度器里的具体体现。
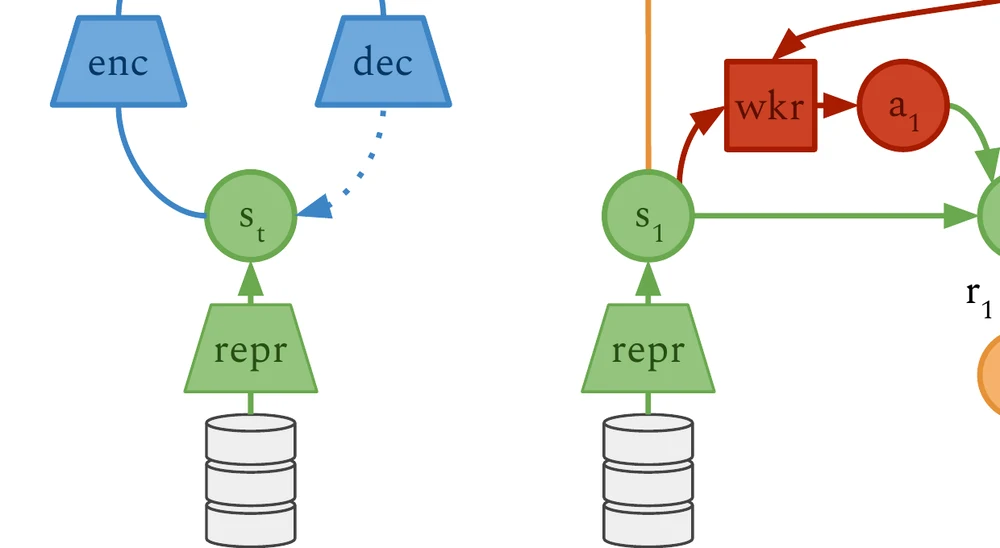
上图来自 《Deep Hierarchical Planning from Pixels》(Hafner 等,2022)的 Figure 2,由论文 PDF 第 2 页栅格化后裁切。右侧的 manager 每隔 步从离散目标空间 里选一个抽象动作,再由 goal decoder 解出发特征空间的目标 ,worker 以 为输入选基本动作。这张图给了”任务结构”一个具体的实现形态: 就是切分长度, 就是子目标的离散编码,而目标解码器就是把子目标从粗粒度映射回细粒度动作的接口。
值得专门看的一处是 goal autoencoder 把特征压成”离散码”。这个离散码正是第三节说的”任务结构信号”的最小形式:粗层只需要回答”第几档子目标”,不需要回答”到毫米级的位姿”。代价是——如果两个子目标在离散码里落到了同一档,粗层就无法分辨它们,这正是分叉点问题在离散目标空间里的形式。
五、把三个信号合成一个调度器
三个信号各自给出一个约束,但调度器要输出的是一个逐段的粒度序列。这一节把它写成一个可以真正求解的问题。
5.1 先离散化候选切分点
调度器不直接在连续时间上搜索切分点,而是先构造一个候选边界集合。做法是把任务时间轴按最细粒度离散成基本格子(比如 ms),然后标记哪些格子边界是”允许切开”的位置。允许切开的位置来自三类:
- 动力学边界:接触事件的时刻(来自第二节的接触检测),以及谱半径发生显著变化的时刻( 的滑动窗估计跳变超过阈值)。
- 任务边界:option 的终止时刻、子目标达成时刻、分叉点(第四节)。
- 规则边界:每段的最短时长(避免过碎切分)与最长时长(避免单段误差预算过大)。
得到候选集合 之后,段就是相邻候选点之间的区间。注意这里的 不是事先固定的——它是候选点个数,由信号决定。这一点很重要:切分点数量本身是调度器的输出,不是输入。 很多实现把段数写死(比如固定 4 段),等于事先假设了任务的复杂度,对不均匀任务必然次优。
5.2 动态规划:误差是状态,算力是代价
有了段和层,问题就是一个带误差状态的最短路。关键观察是:误差递推 是马尔可夫的——第 段的误差只依赖第 段的误差和本段选的层。所以可以用动态规划。
定义 为”从第 段开始、进入误差为 时,剩余各段的最小算力代价”。Bellman 递推:
边界条件 当 ,否则 (违反末段容差即不可行)。最终答案 给出一条最优的 序列。
三个实现细节决定了这个 DP 能不能真用:
- 误差要离散化。 是连续量,实际实现里把它分桶(对数分桶,比如每 3dB 一档),记 。桶数 取 足够,因为误差约束本来就是量级判断。
- 切换开销 必须显式建模。切换层意味着状态重投影、潜变量重编码、可能还有注意力 KV 的失效重算。 通常取”0.1 到 0.5 个最细层前向代价”,量级不大但足以抑制无意义的抖动切换。
- 最短驻留。除了 ,还要加一条硬约束:任何一层一旦被选中,至少停留 段。否则 DP 会在两个误差相近的层之间来回跳,产生”抖动切分”(chattering),而在真实系统里每次切换都要付重初始化的代价。
复杂度是 , 几十、层数三五、桶数几十,单次求解在微秒到毫秒量级——比一次世界模型前向便宜得多。这意味着调度器可以在每次重规划时重新求解,不需要离线一次性算好。
5.3 一个完整的数值例
把上一篇的三层参数搬过来,加一条真实任务的时间轴:
- 第 0 层(关节):ms,cm,;
- 第 1 层(原语):ms,cm,;
- 第 2 层(子任务):s,cm,。
任务总长 s,按信号切成四段:
| 段 | 区间 | 长度 | 容差 | 谱半径 | 说明 |
|---|---|---|---|---|---|
| 接近 | 0–0.5s | 0.5s | 5cm | 0.98 | 自由空间运动 |
| 抓取 | 0.5–0.6s | 0.1s | 0.5cm | 1.06 | 冲击 + 稳定 |
| 搬运 | 0.6–2.9s | 2.3s | 15cm | 0.99 | 端着杯子走 |
| 放置 | 2.9–3.0s | 0.1s | 0.5cm | 1.05 | 再次接触 |
逐段算复合误差 ():
- 接近段:第 0 层 ,误差 cm,算力 ;第 1 层 ,误差 cm,算力 。两层都满足 5cm,选第 1 层。
- 抓取段:第 0 层 ,误差 cm——超过 0.5cm 容差。这就是 1.3 节说的非单调性:最细层的误差反而最大,因为 大、。第 1 层 ,误差 cm,同样超差;第 2 层 ,误差 cm,也超差。三层全部不可行——这个结果说明当前模型的精度不足以支撑该任务,必须换更准的接触模型或放宽容差,而不是”再选一次层”。这正是调度器的一个诊断价值:它会把”参数不合适”暴露成”无可行解”,而不是硬选一个并悄悄超差。
- 搬运段:第 2 层 ,误差 cm,满足 15cm,算力 ;第 1 层误差约 cm,算力 。选第 2 层。
- 放置段:与抓取段同构,同样暴露不可行。
把抓取/放置段的容差放宽到 1cm(更现实:允许抓取后有一次微调),则第 0 层 cm 可行、第 2 层 cm 也”看起来”可行——但第 2 层的 0.5cm 是虚假精度:它来自 、即整段压缩成一步预测,而不稳定性被一步跨过。这就是 3.3 节说的”粗层虚假稳定”。调度器在这里需要额外的硬约束:不稳定段的 必须小于翻倍时间。抓取段 、ms 时翻倍时间约 步、ms,所以第 2 层的 s 步长越界,被这条约束排除;第 1 层的 ms 勉强在界内。最终选择变成”第 0 层或第 1 层”,由误差预算决定选第 0 层。
这个例子给出的总量:接近段用第 1 层,抓取段用第 0 层,搬运段用第 2 层,放置段用第 0 层,总代价约 ;全程用第 0 层是 ,节省约 倍。而全程用第 2 层的代价只有 ,但它在两个接触段上都超差或虚假稳定——这正是”省算力”和”守误差”之间的真实张力,而混合粒度调度的全部意义就是把这两者分开处理。
5.4 伪代码
把上面的 DP 写成可以直接落地的形式:
# segments: 由三个信号给出的段列表,每段含 (L_k, e_k, rho_k, unstable_flag)# layers: 每层含 (dt_l, eps_l, c_l)# h_sw: 切换开销;d_min: 最短驻留段数
def plan(segments, layers, h_sw=0.2, d_min=1, B=48): K, L = len(segments), len(layers) INF = float("inf") # V[k][b] = 从第 k 段起、进入误差在桶 b 时的最小代价 V = [[INF] * B for _ in range(K + 1)] choice = [[None] * B for _ in range(K + 1)] V[K][:] = [0.0 if bucket_value(b) <= segments[-1].e else INF for b in range(B)]
for k in range(K - 1, -1, -1): seg = segments[k] for l, layer in enumerate(layers): H = seg.L / layer.dt # 硬约束 1:不稳定段的步长不得超过翻倍时间 if seg.unstable and layer.dt > doubling_time(seg.rho): continue # 硬约束 2:容差不可行 for b in range(B): e_in = bucket_value(b) e_out = transfer(seg, layer, e_in) # ||J||*eps + ||M||*e_in if e_out > seg.e: continue nb = bucket_index(e_out) for l_prev in range(L): cost = H * layer.c + (h_sw if l != l_prev else 0.0) + V[k + 1][nb] if cost < V[k][b]: V[k][b], choice[k][b] = cost, (l, l_prev) return backtrack(choice) # 返回 [(段, 层), ...]这段代码里有两个容易被删掉、但删掉就失去意义的部分。第一是 seg.unstable 那条硬约束——没有它,DP 会系统性地偏向粗层,因为粗层的 小、 小,复合误差公式天然偏爱它,而”粗层把不稳定模式抹掉”这件事在公式里是看不见的。第二是 h_sw——没有它,DP 会在误差预算刚好卡线的地方反复横跳。
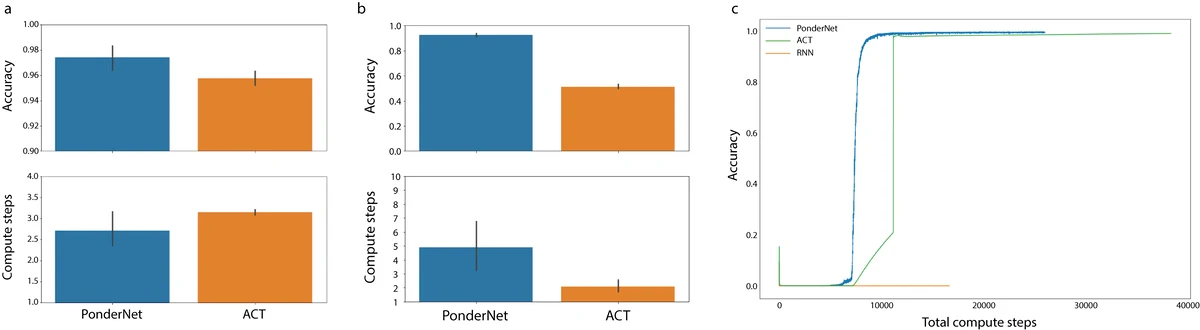
上图是 PonderNet 的示意图(来源:论文 arXiv HTML 版 Figure 1)。它要说明的是另一种”逐段决策”:模型在每一步决定”继续想”还是”停止”,停止概率 由当前状态算出,整体计算量由这个停止决策序列决定。把它与本节 DP 对照,可以看清两种调度的分工——PonderNet 是在线、无预算、由模型自己学出来的停止规则,本节 DP 是离线/重规划时、有明确误差预算、由外部求解器算出来的段选择。真实系统往往两者都用:DP 给出结构化的段边界,PonderNet 式的轻量判据在段内部决定”这一步要不要多算一点”。
六、经典数值方法给出的答案
混合粒度调度看起来像一个新问题,但去掉世界模型的包装之后,它在数值计算里有一个几乎一一对应的祖先:多尺度时间积分与自适应步长控制。这一节把对应关系讲清楚,因为它的价值不只是”类比”——经典方法里那些成熟的分析工具和失败模式,可以直接搬到调度器上。
6.1 多尺度时间推进与时间积分器
多尺度模型(multiscale modeling)的基本想法是:同一个系统里有多个时间尺度(化学反应是纳秒、流体流动是秒),如果都用最细的步长,算力浪费在”慢变量几乎没变”上。标准做法是算子分裂:把系统方程拆成”慢变量方程 + 快变量方程”,慢变量用大步长推进,快变量在小步长内做局部求解。这与混合粒度调度器完全同构:段 = 快/慢划分的区域,层 = 步长,切分点 = 尺度切换的位置。
同一个思想在世界模型里有一个更早的实例:Clockwork RNN(Koutník 等,2014)。它把隐藏层拆成若干块,每块有自己的时钟周期——第 块每 步更新一次,其余时刻保持输出。于是同一层网络里同时存在快模块(每步更新)和慢模块(每 16 步更新),慢模块天然对应”粗粒度的时间抽象”。这个结构的意义不在于它当年效果多好,而在于它证明了多档时间粒度可以在一个网络里共存、且不需要为每档单独训练一个模型。本文的调度器和它的区别是:Clockwork 的时钟周期是固定超参,调度器让每一档的驻留时长随信号变化。
更直接的对应来自自适应步长积分器。经典控制律是 Johnson(1988 年的 MIT 博士论文给出了完整推导)与 Hairer 等人在教科书里系统整理的一步误差估计:用两种不同阶数的公式各算一步,取两者之差作为局部截断误差估计 ,然后按
调整步长, 是高阶公式的阶数。这条公式和第五节 DP 的关系是:如果容忍度 tol 取每段的容差 、误差估计 取复合误差,那么自适应步长积分器给出的”步长如何变”就是”粒度如何变”。
两者的差别也正是本文要补的那一层:经典积分器只处理”一个连续系统内部”的步长变化,而混合粒度调度还要处理离散事件(接触)和模型切换(换粒度意味着换模型,不只是换步长)。这就是为什么第二节要单独讲混合系统:经典积分器遇到重置映射时,也要把事件时刻切成两个积分区间、事件前用 、事件后施加 、继续用 。世界模型的混合粒度调度本质上是在做同一件事,只是模型是学出来的而不是方程写出来的。
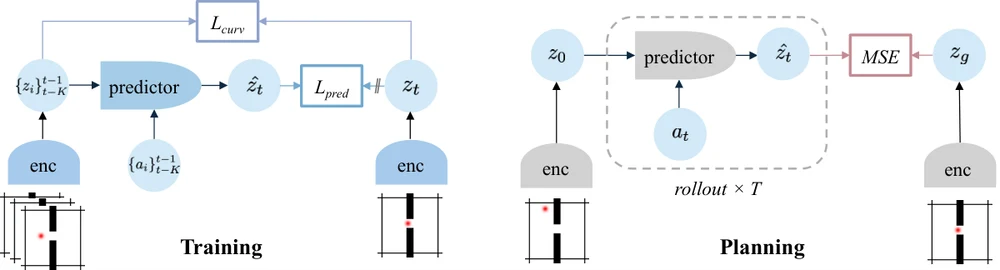
上图是时间直线化(Temporal Straightening,2026)的架构,来源为论文 arXiv HTML 版 Figure 3。它属于 JEPA 式世界模型:编码器与预测器联合训练,预测损失作用于预测嵌入与目标嵌入之差,并叠加作用于目标嵌入的曲率正则,鼓励潜轨迹局部变直。它把”潜空间轨迹弯曲”这件事显式当作训练目标:预测损失只作用于预测嵌入与目标嵌入之差,并让目标嵌入被时间直线化约束。这条线索与本节的主题直接相关——一个轨迹越”直”,一个粗步长跨越它时引入的误差越小。在潜空间里做粗粒度 rollout 的前提,就是潜空间里的轨迹在时间轴上线性。反过来,轨迹弯曲严重的段落就是用粗粒度最容易出错的段落,它们应当被切得更细。
6.2 事件定位与状态重置:为什么需要”恰好在事件时刻切开”
数值计算里处理不连续系统的标准做法叫事件定位(event location):积分器在检测到事件函数过零时,先二分或牛顿迭代找到精确的过零时刻 ,把积分停在这里,施加重置,再从 继续。这样做的好处是不把不连续点”混”进积分步里。
对应到调度器:接触事件必须作为强制切分点,而不是”最近的一个候选点”。 如果候选点网格太粗,接触事件落在两步之间,粗层就会把冲击平均掉——这正是第二节说的 5ms 事件被 20ms 步长跨过的问题。所以调度器的候选集合里,动力学边界(接触时刻)必须精确到事件本身,不能被网格吸并。工程上的做法是:接触检测器给出过零区间 ,调度器把边界放在区间中点,并在该点两侧各留一个最短驻留段。
6.3 刚性方程:隐式大步长,而不是显式小步长
3.4 节提到了刚性。数值计算对刚性方程的标准解法不是”缩小步长”,而是换成隐式格式:对 、,隐式 Euler 的放大因子是 ,对任意 都小于 1,稳定。A 稳定的格式(隐式 Euler、梯形法、BDF)允许在刚性段用大步长。
这个结论对世界模型很有启发:如果一个粗层模型在潜空间里做的是隐式或半隐式更新(例如把潜状态更新写成 的定点迭代形式,而不是 的显式形式),那么它在刚性段(接触稳定段)可以用比”显式模型允许的步长”大得多的步长。这就是为什么有些分层世界模型在接触稳定段的效果反而比关节级模型好:不是因为它更准,而是因为它用了隐式结构,避开了显式格式在刚性段的振荡。
这条对应给出一个具体的工程建议:接触稳定段首选”步长合规 + 隐式更新”的层,而不是”步长很小 + 显式更新”的层。 前者既省算力,又不易振荡。很多世界模型的接触段失败案例,失败原因不是预测精度不够,而是显式更新在刚性段产生了虚假的高频振荡,再被读回成”物体在抖动”。
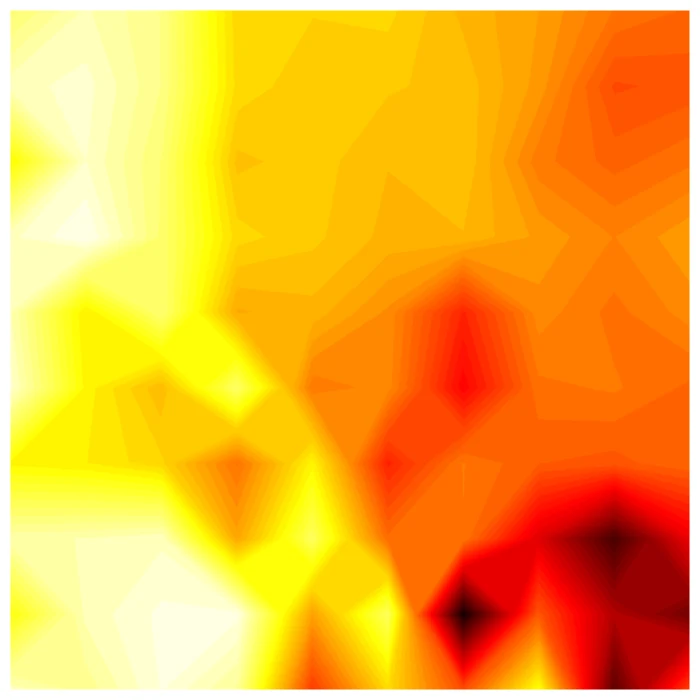
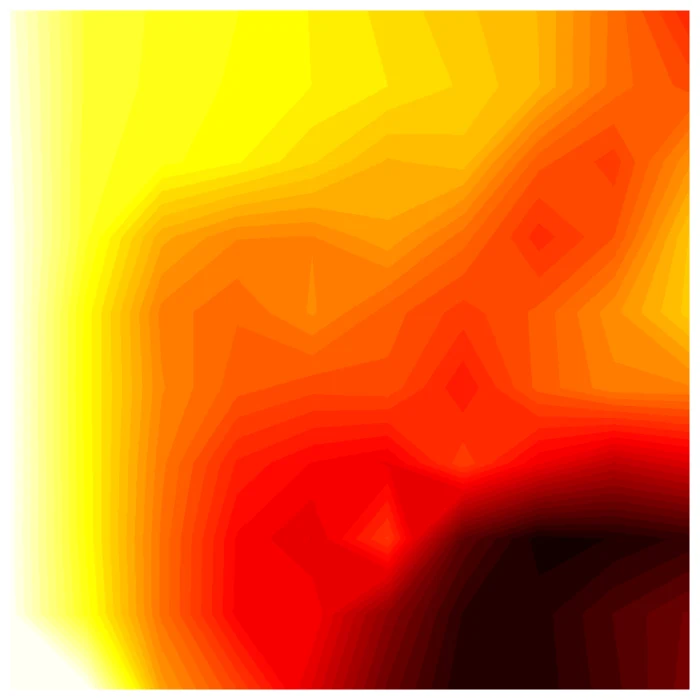
上图与下图来自时间直线化的对比实验(来源:论文 arXiv HTML 版 Figure 4),同一批轨迹在基线编码器(DINOv2)与直线化编码器下的潜空间曲率。左图是基线,潜轨迹是弯曲的;右图经过时间直线化后,轨迹在时间轴上接近直线。曲率越高,粗步长跨越它的误差越大;曲率越低,粗粒度越安全。这给调度器提供了一个纯数据侧的分段信号:不需要测动力学,只测潜轨迹的曲率,就能知道哪些段”粗得起”。
七、真实系统里这些选择长什么样
前三节的调度器是抽象的。这一节看两个具体的系统:一个是在潜空间里做分层的,一个是自回归生成视频的。它们解决的问题不同,但都必须在”这一步的粒度”上做出选择,而且各自的选择方式和上一节的框架能对上。
7.1 分层世界模型:管理者与执行者的两档粒度
Director(《Deep Hierarchical Planning from Pixels》,Hafner 等,2022)给出的是最干净的两档粒度结构:manager 在紧凑的离散目标空间里、每 步选一次子目标;worker 在原始动作空间里、每一步选一次基本动作。
这里的两档对应本文的哪两层?manager 对应”子任务层”,worker 对应”关节层”。 就是第一类切分长度。论文的设计中有几处可以直接用本文的语言重新解释:
- 目标空间是离散的,这对应第四节说的”任务结构的最小形式”。离散化本身就是一种粗化,它把”到毫米级的位姿”变成了”第几档子目标”。好处是粗层的搜索空间极小,代价是分叉点处的分辨率损失——两个不同的目标落在同一个码字上,manager 就分辨不出。
- 探索奖励基于重建误差,这对应上一篇三项分解里的”读回误差”。manager 拿到的奖励是”探索了新状态”,而新状态是通过”重建误差大”识别的-这等价于把读回误差当作一个可观测的奖励信号。这个设计与本文的误差账本是一致的:把误差当作一等公民,而不是藏起来。
- 是一个固定值,这直接暴露了本文要补的这一层。固定 意味着切分长度是超参,而不是由信号决定。在任务前半段(接近) 可能过长——8 个基本步可能跨过了接触事件;在任务后半段(保持) 可能过短——8 步只走了几厘米。本文的调度器本质上就是把固定 换成”由接触密度、谱半径和任务结构共同决定的 ”。
这个改进不是没有代价。 变化后,manager 的动作空间就变成了变长 option,策略训练会变难(每个 option 的时长不同,信用分配不同)。这也是为什么大多数分层世界模型选择固定 :它是训练稳定性的折中,而不是最优设计。这一点在第八节会作为”实现代价”专门讲。
另一个相关的实例是时间直线化(2026)。它不改变粒度,而是改变潜空间的几何:让潜轨迹沿时间轴变直。这个改动从调度器角度看非常划算——它让粗粒度层的单步误差 变小(因为”跨越一段直线”比”跨越一段弯曲线”准),于是粗层在第 段上的可行性变大,调度器会更多地选粗层。换句话说,时间直线化不是一种”预测模型改进”,它是在不动调度器的前提下,把调度器的最优解向粗侧移动。 这两条路线是可以叠加的:直线化降低 ,调度器据此重新分配粒度,两者共同压缩算力。
7.2 自回归视频生成:块内细、块间粗
第二个实例来自 Magi-1(《MAGI-1: Autoregressive Video Generation at Scale》,Sand.ai,2025)。它把视频生成做成”分块自回归”:视频被切成 24 帧一块,一块一块地生成,每块只 attend 到已经去噪完成的历史块。
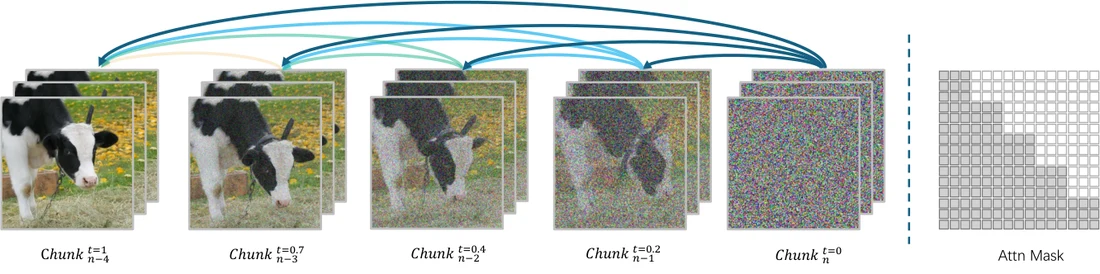
上图是 Magi-1 的块自回归去噪示意(来源:论文 arXiv HTML 版 Figure 1)。左侧是去噪过程:每块先被完整去噪,然后作为干净历史供下一块使用;当一块的去噪程度达到某个阈值,下一块的生成就可以开始,形成流水线。右侧是块因果注意力掩码:每块内部全连接,块之间是下三角,当前块可以看到所有已去噪历史块的 KV,但看不到未来块。
这个结构里同时出现了三种粒度:
- 块内(24 帧):所有帧在块内是一次联合去噪,注意力是全连接。这相当于”块内一个细粒度的、联合的动力学模型”。
- 块间(块与块):当前块只能以历史块为条件,不能回看未来。这是”块间一个粗粒度的、自回归的”接口。
- 去噪步(块内的迭代次数):控制”每块花多少计算去细化”。
用本文的框架看,Magi-1 的选择是:段 = 块,层 = 块内联合 vs 块间条件,切分点 = 块边界。它没有根据信号决定块长,而是固定 24 帧。这是一个典型的”用固定切分换工程简单”的取舍。但值得注意的是,它的固定块长是有意配合生成任务的:视频的叙事结构、镜头切换、动作节奏大体上以秒为单位,24 帧在常见帧率下约 1 秒,正好落在”人类可感知的动作单元”的时间尺度上。
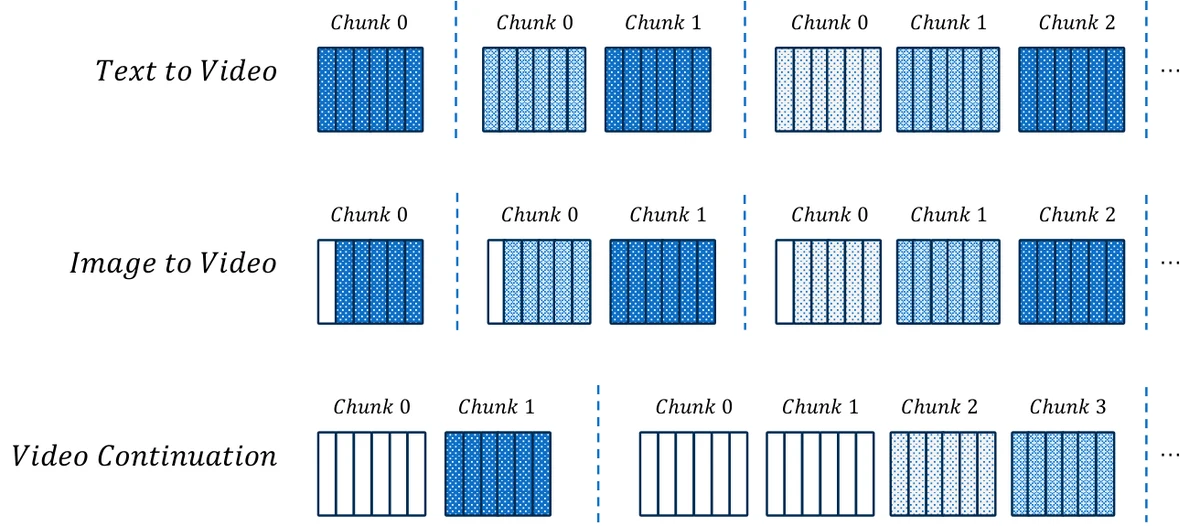
上图(Figure 4,来源:论文 arXiv HTML 版)展示了 Magi-1 如何用”干净块的比例”统一不同任务:每个竖直条代表块内的一个潜帧,颜色越深噪声越大。纯文生视频从全噪声开始;图生视频把第一块部分固定;视频续写把前面的块全部固定。这就是任务结构信号在生成模型里的直接体现——任务的”给定条件”决定了哪些段可以被当作粗上下文(只读的 KV),哪些段必须细粒度生成。
更关键的一点在它的自回归模型的因果结构里:
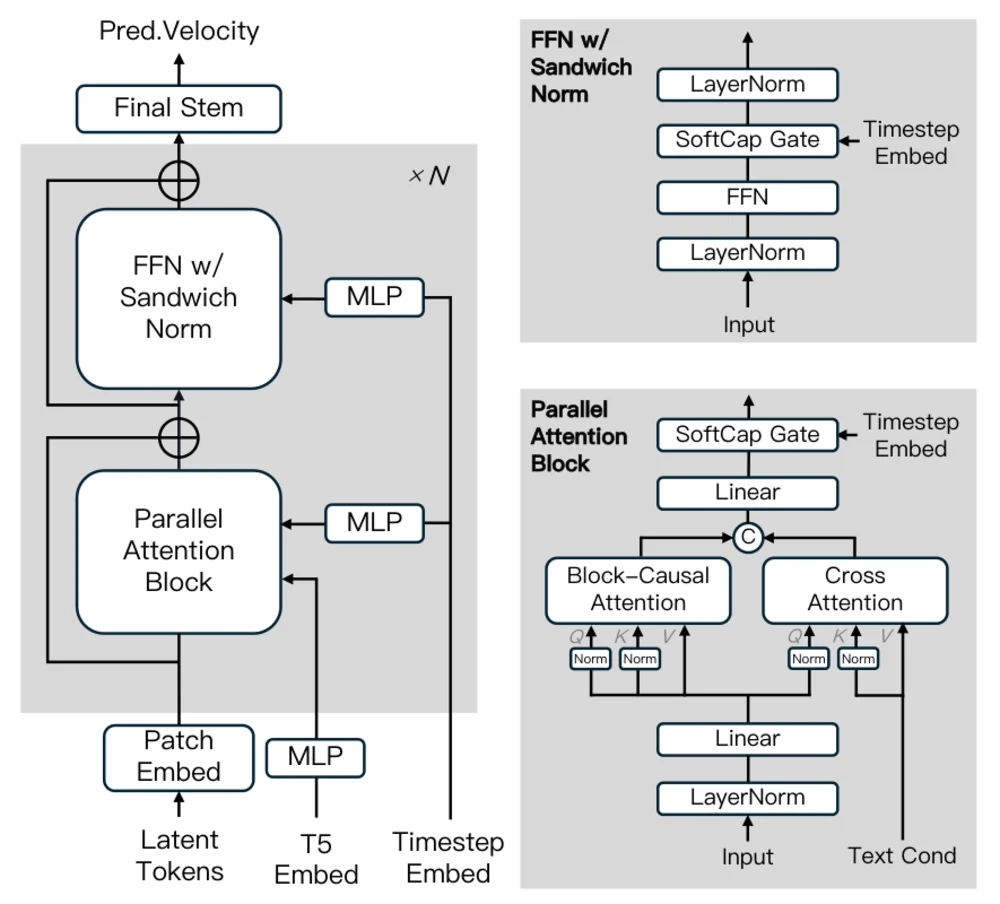
上图是自回归去噪模型的结构(来源:论文 arXiv HTML 版 Figure 3)。它与普通自回归语言模型的区别在于:每个块内部是全注意力,块之间是因果注意力。这个”两级因果”正是混合粒度在注意力层面的实现——块内的细粒度可以建模帧间交互,块间的粗粒度只传递”上一块的摘要”(通过 KV 缓存)。
这个结构有一个直接的、与本文第二信号相关的后果:块间接口的误差会沿块累积。第 块的生成用了第 块的 KV;如果第 块的某个细节错了,它作为”历史”进入第 块,可能在第 块被放大。这与 1.2 节说的开环误差累积完全同构。所以 Magi-1 在长视频生成里遇到的问题是长程漂移——颜色、身份、布局在几十秒后逐渐偏离。这不是”块内模型不准”,而是”块间接口累积了块内误差”。
它采取的两个缓解手段,恰好对应本文的两种切分点误差处理:
- 重叠(block overlap / 前一帧引导):块之间保留一小段重叠区域,用重叠区的已知内容约束新块的起点。这相当于在切分点做”状态交接”,并且用真实的前一块内容代替预测——是”预测交接”的一个软版本。
- 上下文 KV 窗口:不是无条件地看所有历史块,而是只保留一部分历史 KV(对应图中”KV Range”的概念)。这相当于限制误差传递的路径长度——不让所有历史误差都接力到当前块,而是每块只接最近一段的误差。
这两个手段把”块间开环累积”变成了”块间部分闭环 + 有限记忆”。第二节里说的”接触事件需要显式检测并切断误差累积”,在这里的对应物是”镜头切换 / 场景切换需要显式检测并重置 KV”——Magi-1 的镜头切换控制(通过调制不同去噪阶段的 KV 范围)就是这个思想。
八、运行时的实现
前面的讨论都假设调度器能”完美地”知道切分点和每段的参数。真实系统里这些量都是估计出来的,而且系统必须在线运行。这一节讲三个实现层面的问题:怎么在运行时判定切分点、怎么处理层切换的代价、怎么让整个系统保持在延迟预算之内。
8.1 在线切分:从”离线标注”到”在线判定”
切分点信号有两个来源:离线(对已有轨迹打标签)和在线(在运行时从传感器和模型里读取)。两者在调度中的用法完全不同。
- 离线信号用于训练期:训练一个分段器(segmenter)网络,输入是一段观测序列,输出是”每个时刻是否应该切分”。分段器的训练标签来自第二节和第三节的离线测量:接触事件由力传感标注, 的跳变由局部线性拟合标注,分叉点由策略的多模态性标注。这个分段器可以直接复用世界模型的编码器,只加一个轻量的头。
- 在线信号用于运行时:分段器给出一个”切分概率” ,调度器在概率超过阈值、且满足最短驻留约束时才真正切换粒度。
在线判定必须考虑滞后(hysteresis):如果只用瞬时概率,分段器会在边界附近反复给出接近阈值的输出,导致抖动。标准做法是双阈值 + 滞回:
这与控制里的滞后比较器是同一套机制,也和自适应积分器在”缩小步长”与”放大步长”之间设不同阈值是同一种谨慎。两个阈值之间的间距越大,切换越少、响应越钝。 间距本身就是调度器的”响应速度”旋钮。
8.2 切换代价:切换一次不只是换个步长
切换到另一个粒度,在实现上至少涉及四件事:
- 潜状态重映射:细层的潜状态不能直接喂给粗层模型,因为粗层的输入维度和语义都不同。需要一个小型适配器(可以是线性层或一个小网络)。这个适配器是固定的,不随任务变,但它的误差是切换代价的一部分。
- 注意力缓存失效:对基于 Transformer 的世界模型或视频模型,切换粒度意味着”未来时刻的 KV 要以什么粒度生成”。细层的历史 KV 和粗层的历史 KV 维度不同,粗层需要重新编码一段简短历史。这一块的代价最容易低估——KV 重编码有时等于一次完整的前向。
- 策略/规划器的重新初始化:如果粗层和细层对应的动作空间不同(子任务 vs 关节),规划器要在新动作空间里重新采样或重新规划。
- 动作块的丢弃:如果切分点恰好落在某个已执行的动作块中间,块里剩余的动作要么执行完(浪费),要么丢弃(造成空隙)。
把四项加起来,切换代价 在视频/大模型场景里往往是”一次前向的量级”,而不是”常数”。这解释了为什么第五节 DP 里 不能设成 0:如果把它设成 0,DP 会给出一个”每段都选最省力的层”的解,理论上很优,但实际每次切换的额外一次前向会让总代价翻倍甚至更多。
工程上的应对是预算切换:给每个任务设一个”最多切换次数”上限 ,DP 里加一个维度或者用拉格朗日松弛(把切换次数作为约束、加一个乘子 ),得到”给定切换次数上限下的最优粒度序列”。 一般取 3 到 6——再多的切换,收益远小于代价。
8.3 延迟预算
调度器还有一条不能违反的约束:总延迟必须在控制周期之内。这个约束与误差约束是并列的,并且会改变 DP 的写法。
设控制周期 (例如 50ms),一次规划要消耗的时间是
其中 是第 层单次前向的墙钟时间, 是每次切换的墙钟开销, 是 DP 本身的求解时间。要求 。
这带来一个结构性后果:精度最高、最细的粒度往往最慢,如果某一段必须用最细层,它可能挤占其它段的延迟预算。所以调度不只是”按段选层”,而是跨段的时间分配。这与多尺度时间积分把总时长按尺度分配是同一个问题。一个实用的做法是:在 DP 之前先做一次粗分配(每段至少得到一个”最低可行层”),再在剩余预算里做 DP 细化。这实际上是两阶段优化,比精确 DP 快得多,且解的质量损失在工程可接受范围内。
九、失效边界
调度器不是万能的。这一节列出它会在什么情况下给出错误的切分,以及每种错误的识别方法。这些失效不是”实现 bug”,而是”框架本身的假设被破坏”。
9.1 分段器的切分点错位
分段器是在训练数据上学的,它的统计规律不一定在所有情况下成立。典型错位有两种:
- 漏切:接触事件被分段器漏掉(例如接触非常轻、力低于阈值),导致冲击被并进平滑段,粗层把它平均掉。识别方法:用独立的接触检测作为旁路校验,在调度器输出后检查”是否有未解释的力突变”。如果有,强制在该点插一个切分。
- 过切:分段器把平滑段切得很碎(例如把一段稳定的自由运动切成十几段),导致切换代价堆积。识别方法:检查相邻段的层是否相同——如果相同,这些切分是纯浪费,应该合并。
两种错位有一个共同的对策:调度器应该把切分点当作”候选”,而不是”命令”。 分段器给出候选,DP 有权不切(把相邻候选合并成一段)。这就是第五节把 设置为候选点个数、而不是直接固定段数的原因。
9.2 谱半径估计错误
第二信号的核心是分段谱半径。它的估计有三类错误:
- 估计偏小:如果世界模型本身漏掉了不稳定模式,测出的 会比真实小,调度器会误以为”这一段稳定,可以用粗层”。识别方法:把世界模型的 与真实执行数据上的 做对比,两者差异超过 20% 就应触发告警。
- 段内非均匀:一整段用一个 ,段内前一半稳定、后一半不稳定时,平均值会掩盖不稳定部分。识别方法:把段缩短到 的滑动窗稳定为止(即段长不超过谱半径自相关时间)。
- 粗层虚假稳定:粗层因为合并了不稳定模式,测出 。这是最危险的,因为它会恰好给出”粗层可用”的错误信号。识别方法只有一个:在细层上测同一个量,两层不一致就说明粗化破坏了模式(3.3 节第 1 条规则)。
9.3 跨段映射的误差
1.1 节的递推里, 是跨段映射的误差传递比。它在三种情形下被低估:
- 两段粒度不同,但映射是被训练过的适配器而非解析映射。适配器在训练分布之外的行为未知, 可能远大于 1。
- 粗层到细层的读回(上一篇的读回误差)不是单值的——一个粗状态可能对应多个细实现,选错了就带来额外误差。
- 任务状态切换(例如从”搬运”到”放置”)改变了变量的语义,同一个数值在两种语义下含义不同。
对策是把 按”最坏情况”估计,而不是用平均值;并且在粒度切换处强制做一次闭环重初始化(用真实观测代替预测状态)——代价是切断误差累积,收益是把 从”未知”变成”1”。
9.4 分叉点的判别失败
分叉点是任务结构信号里最脆弱的环节。4.3 节要求分支判别准确率大于 0.99,但粗层的能力并不是为”看分叉”而设计的。粗层的潜空间可能恰好把两个不同分支映射得很近(例如两条路径在物体位姿上只差几毫米),于是判别准确率低于阈值,任务走错分支。
这个问题没有好的”事后补救”——走错分支后,模型给出的后续轨迹看起来完全合理,只是目标是错的。只能在调度器层面防御:在分叉点前的那一段,强制使用”能分辨所有分支”的最粗粒度,并在分叉点后立刻用细粒度重规划一段。这与第四节的规则是同一个,只是这里要强调:它是一条硬性安全规则,优先级高于算力约束。
9.5 任务结构本身就是错的
最后一种失效不在调度器的计算里,而在它的输入里:如果任务的成功判据被错误地设定(例如把”杯子稳定放置”写成”杯子位置误差小于 2cm”,而没有考虑是否倾斜、是否漏水),那么容差 从一开始就是错的,调度器会精确地优化一个错误的目标。
这提醒一件事:调度器只优化被告诉它的指标。它的价值不在于它总能做出正确决策,而在于它让”决策依据”变得显式、可审计。 当结果不理想时,可以逐项检查三个信号在哪一环估错了,而不是笼统地说”世界模型不够好”。
十、小结
这一篇要把一个很具体的问题讲清楚:一段任务内部,切分点应该落在哪里。
- 信号一:接触密度。 接触是混合系统里的离散事件,重置映射不连续。一次典型碰撞的接触事件只有 5ms 量级,20ms 的控制步长整个跨过它,所以接触段的粒度必须按事件尺度分,而不是按任务时间分。接触密度(按冲量或能量加权)给出每段需要多细;接触段内部又分接近、冲击、稳定、保持四阶段,粒度是”两头粗、中间细”。
- 信号二:动力学稳定性。 谱半径是分段的。稳定段()可以用粗粒度;不稳定段()的正确选择往往是中间层而不是最细层,因为最细层的步数多、指数放大次数多。前提是粗层没有把不稳定模式合并掉——细层和粗层的 必须一致地反映不稳定性。刚度则是另一个维度,它要求隐式更新而不是更小的步长。
- 信号三:任务结构。 option 边界、子目标达成时刻、分叉点构成候选切分点。分叉点要求判别准确率极高,是优先级最高的硬规则。任务结构还决定了误差容差 和闭环/开环,后者决定误差在切分点是否被截断。
- 调度器: 把三个信号变成候选切分点集合,用带误差状态的动态规划求解”在算力预算下最小化复合误差”,其中必须显式建模切换开销和最短驻留,并且对不稳定段加”步长不越界”的硬约束。
- 经典方法: 多尺度时间推进、自适应步长、事件定位、刚性方程的隐式格式,都在同一套框架里有对应。最直接的类比是:自适应步长控制回答了”步长如何变”,混合粒度调度补充的是”模型如何变”和”离散事件如何处理”。
- 真实系统: Director 用固定的 做两档粒度,把切分长度变成了超参;Magi-1 用固定的 24 帧块做”块内细、块间粗”,并靠重叠与 KV 窗口抑制块间误差累积。两者都验证了框架,也都暴露了”固定切分”的代价。
一个贯穿全篇的事实是:切分点的选择本质上是误差账本的分配问题。 上一篇给出了误差怎么拆成三项、怎么在 rollout 里传播;这一篇给出的是”把误差预算分给哪些段、分多少、用哪种粒度去花”。下一篇会沿这个账本再往下走一层:当世界模型本身会随时间更新(在线学习、持续校正)时,误差账本怎么跟着变——已经花掉的预算能不能被新数据”返还”,以及调度器如何避免把算力花在被更新推翻的段上。
参考资料
- The Theory of Hybrid Automata(Henzinger, 1996)
- Between MDPs and semi-MDPs: A Framework for Temporal Abstraction in Reinforcement Learning(Sutton, Precup, Singh, 1999)
- Deep Hierarchical Planning from Pixels(Hafner et al., 2022)
- MAGI-1: Autoregressive Video Generation at Scale(Sand.ai, 2025)
- Temporal Straightening for Latent Planning(Wang et al., 2026)
- A Clockwork RNN(Koutník et al., 2014)
- PonderNet: Learning to Ponder(Banino et al., 2021)
- Equivalence notions and model minimization in Markov decision processes(Givan, Dean, Greig, 2003)
- Learning Abstract World Model for Value-preserving Planning with Options(Rodriguez-Sanchez, Konidaris, 2024)
- Approximate Causal Abstraction(Beckers, Eberhardt, Halpern, 2019)
- Hairer, Nørsett & Wanner, Solving Ordinary Differential Equations I: Nonstiff Problems(1993)
- Johnson, “The control of dynamically interacting systems”, MIT Ph.D. thesis(1988)
本站延伸阅读:多粒度的形式条件与抽象误差账本见 世界模型从零讲起(三十三);闭环误差的递推与重规划时域见 世界模型从零讲起(十九);世界模型推理的延迟预算见 世界模型从零讲起(九);预算与规划杠杆的汇总见 世界模型从零讲起(十五)。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



