


MoEQuant 完全拆解:MoE 模型 PTQ 为何掉点——专家均衡自采样与亲和度引导量化
以 Mixtral-8x7B 为例,它在每个 MoE 层里从 8 个专家中选 2 个,单次前向的算力大致相当于一个 13B 稠密模型,但部署时 8 个专家全部要常驻显存,权重总量接近 47B 稠密模型的量级。Qwen-MoE-A2.7B-14B 更极端:生成阶段每个 token 只激活约 2.7B 参数,显存里却必须放下 14B 参数。这就是 MoE 推理最核心的账:算力按激活参数计,显存和带宽按总参数计。论文给出的比例是,MoE 层在 Transformer 块中约占 80% 的激活参数,若把全部专家算上则高达 97%。压缩 MoE 模型,重点就在于压缩 MoE 层。
把这笔账换成字节更直观。Qwen-MoE-A2.7B-14B 的 14.3B 参数按 bf16 每参数 2 字节算约 28.6 GB,与论文实测的 27.88 GB 吻合;DeepSeek-MoE-16B 的 16.4B 参数约 32.8 GB,实测 32.23 GB;Mixtral-8x7B 的 46.7B 参数约 93.4 GB,实测 89.64 GB。压到 4 bit 后,纯权重理论上是原来的四分之一,实测分别为 8.51 GB、9.87 GB、23.97 GB——比四分之一略高,多出来的是每通道 scale、未量化的部分(如 norm、embedding、门控)与运行时开销。这几组数字说明:MoE 的显存瓶颈几乎完全由专家权重构成,而算力只需要激活其中一小部分,这正是「压缩权重、保持激活稀疏」这一路线在 MoE 上格外划算的原因。
训练后量化(PTQ)是压缩权重最省事的工具:AWQ、GPTQ 这类方法在稠密模型上能把权重压到 4 bit 而几乎不掉点。可一旦直接套到 MoE 模型上,结果往往惨不忍睹,尤其是泛化能力——代码和数学推理任务上动辄掉十几个百分点。MoEQuant 这篇 2025 年 5 月的论文(arXiv:2505.03804,来自后摩智能 Houmo AI)正是冲着这个问题去的:它没有发明一个新的量化算法,而是指出现有 PTQ 在 MoE 上失效的两个结构性原因,并在校准集和量化误差这两个环节上各打了一个补丁。这两个补丁即插即用,能与 AWQ、GPTQ 等任意 PTQ 主算法组合。
本文按「问题—机制—公式—证据」的顺序把它拆开:先把 MoE 路由带来的两重失衡讲清楚,再把 Expert-Balanced Self-Sampling(EBSS)与 Affinity-Guided Quantization(AGQ)的每一步推导补齐,最后落到具体实验数字和它在工程上的边界。
MoE 推理为什么对量化更挑剔
一次 MoE 前向的结构
一个 MoE 层由若干路由专家(routing expert)、若干共享专家(shared expert)和一个门控网络(gating network,也常叫 router)组成。对每个 token 的隐状态 ,门控网络给每个路由专家打一个分数 ,只保留分数最高的 个专家,再按分数加权求和:
其中 是第 个共享专家的 FFN(共 个,全部激活), 是第 个路由专家, 是选中的专家下标集合:
注意 既决定「选谁」,又决定「每个专家的输出贡献多少」。这一条在传统稠密 Transformer 里根本不存在——稠密模型的 FFN 对所有 token 一视同仁,而 MoE 里同一个专家对不同 token 的「影响力」相差可以很大。后面 AGQ 的全部动机就来自这里。
站点上对 DeepSeekMoE 的细粒度切分与共享专家机制有详细拆解,可参考 DeepSeekMoE 完全拆解:细粒度专家切分与共享专家隔离。
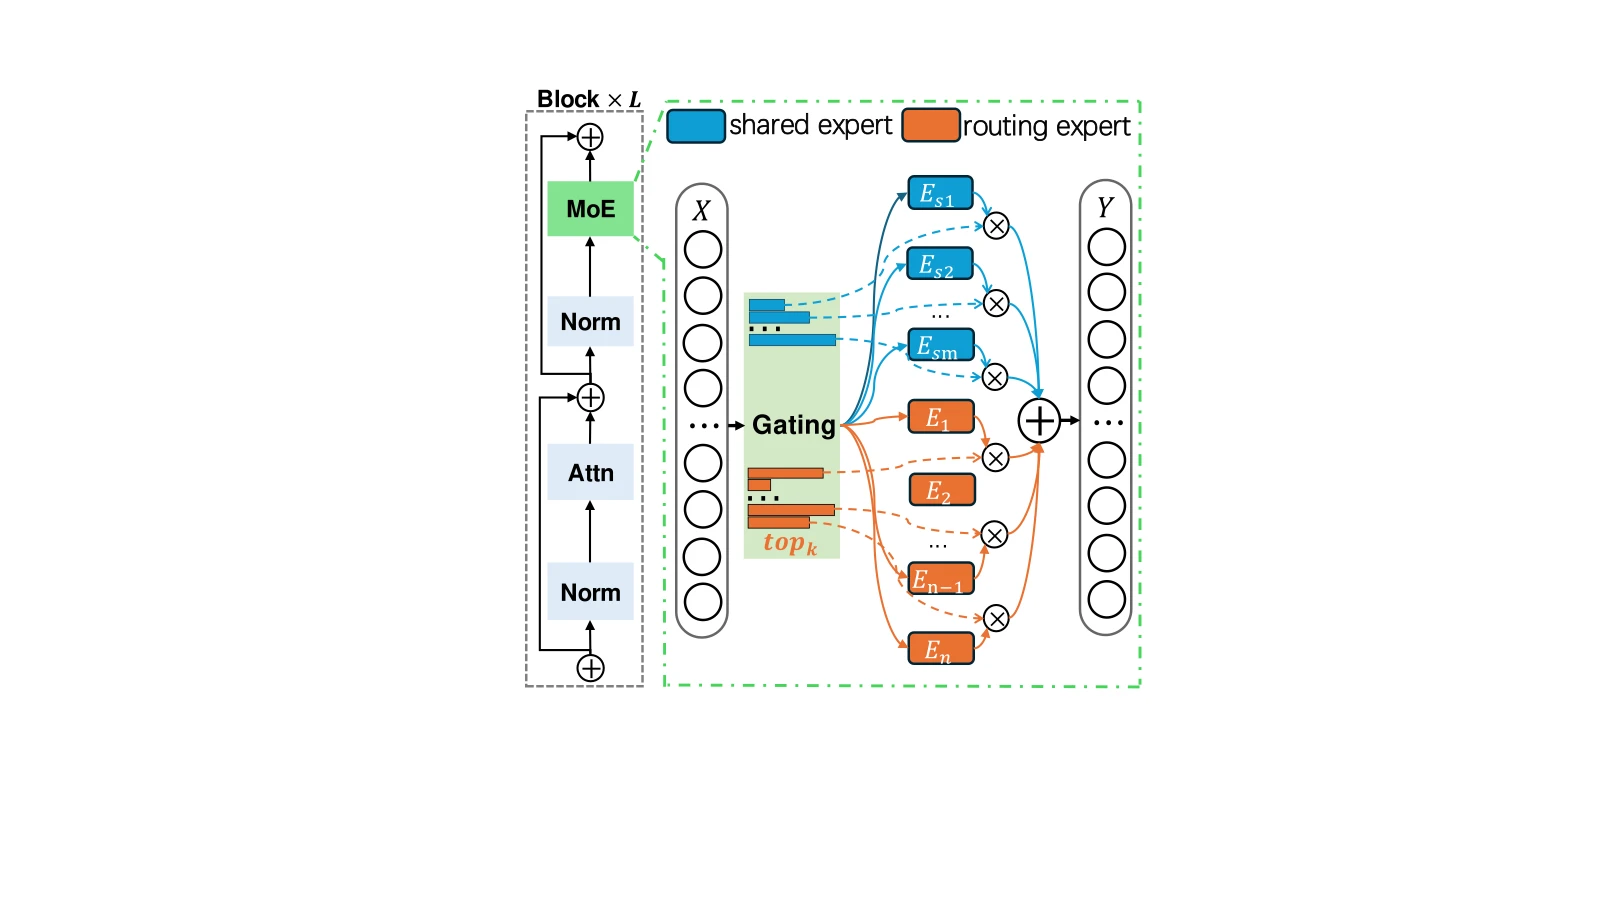
上图是论文中的 MoE 层结构示意(来源:MoEQuant 论文 Figure 3)。每个 token 先经过归一化和门控网络,门控输出每个专家的分数,结构上只保留 top- 的路由专家,所有共享专家无条件参与;最后各专家的输出按门控分数加权合并。图中左侧的 Attn 与 Norm 属于 Transformer 块的公共部分,右侧分叉出的专家塔只有被选中的才真正参与计算。读这张图时要抓住一个细节:没有被选中的专家在这次前向里不计算、不读权重,但它们仍在显存里占着位置。
量化误差在 MoE 里怎么放大
先回顾 PTQ 的基本形式。以逐通道对称均匀量化为例:
其中 是权重矩阵( 个输出通道、 个输入通道), 是每个输出通道一个的量化步长(scale), 表示就近取整, 是整数格点的上下界(4 bit 时通常是 与 )。反量化得到 。
对一个线性层,量化带来的损失写成输出差异的 Frobenius 范数:
是该层在校准数据上的输入激活, 是校准样本数。AWQ 用这个损失挑平滑系数和要保护的通道;GPTQ 从 OBQ 出发,用这个损失的二阶近似来补偿误差,其 Hessian 正是
到这里,所有方法都默认了一个前提:校准集里的每个样本对每个权重单元同等重要。在稠密模型里这基本成立,因为无论什么 token 都会经过同一个 FFN。但在 MoE 模型里,这条前提被路由机制拆得七零八落。
第一,样本落到哪个专家是不均匀的。一个校准集如果主题单一(WikiText2 是维基百科文本,C4 是网页文本),某些专家会被反复命中,另一些专家几乎收不到数据。收不到数据的专家,它的权重从来没有被任何校准样本检验过——量化误差在它身上无从估计,量出来什么样就是什么样。论文把这种跨专家的分布不均称为专家间失衡(inter-expert imbalance)。
第二,即便样本落到了某个专家,它对这位专家的影响力也不同。MoE 的输出是 ,对专家 而言,一个门控分数 0.9 的 token 比门控分数 0.1 的 token 影响大得多。但 GPTQ 的 Hessian 完全不区分这种差异:只要 token 被路由到该专家,它就在 里贡献一份权重相同的项。论文把这种「同一专家收到的样本与专家相关性不同」称为专家内失衡(intra-expert imbalance),并在下面把它形式化为「亲和度」。
两重失衡分别对应论文的两个模块:EBSS 解决校准集怎么造,AGQ 解决量化误差怎么算。下面逐一拆开。
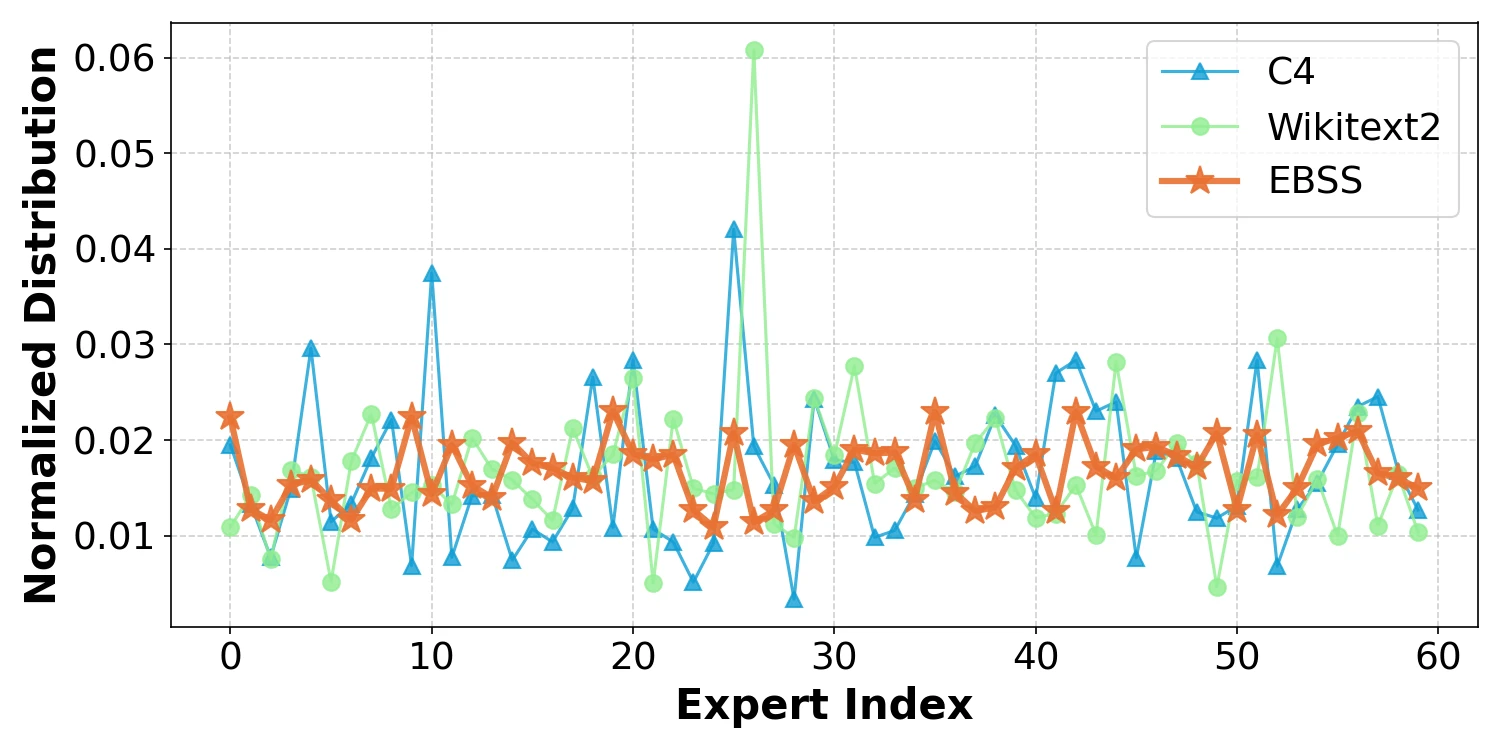
这张图直观展示了第一重失衡(来源:MoEQuant 论文 Figure 2)。横轴是专家编号,纵轴是该层上专家被命中的频率。C4 和 WikiText2 各自 128 段、每段 512 个 token 的常规校准集,在专家维度上都是明显的长尾:少数专家被反复调用,曲线右侧一截几乎贴近零。EBSS 生成的校准集则把曲线压平,各专家的使用频率大致持平。长尾尾部的那些专家,就是 PTQ 方法「没怎么见过、也就没怎么校准过」的专家。
校准集的问题:从领域平衡到专家平衡
直觉方案为什么不够
既然问题是校准集主题单一,最直接的修补是「多领域混合」。论文否定了这条路,理由有二:
- 领域数量近乎无限,真正意义上的领域平衡既复杂又不现实;
- 更关键的是,即便拿到高质量的多领域数据,它们与模型自身的分布仍可能对不上。论文 Figure 4 在 DeepSeek-MoE-16B 上对比了几种数据集的困惑度(PPL),HumanEval、GSM8k、CEval、MMLU 这些「高质量」数据集上的 PPL 明显高于 WikiText2。PPL 高说明模型在这些数据上「不适应」,用它做校准,量化误差的估计自然会偏。
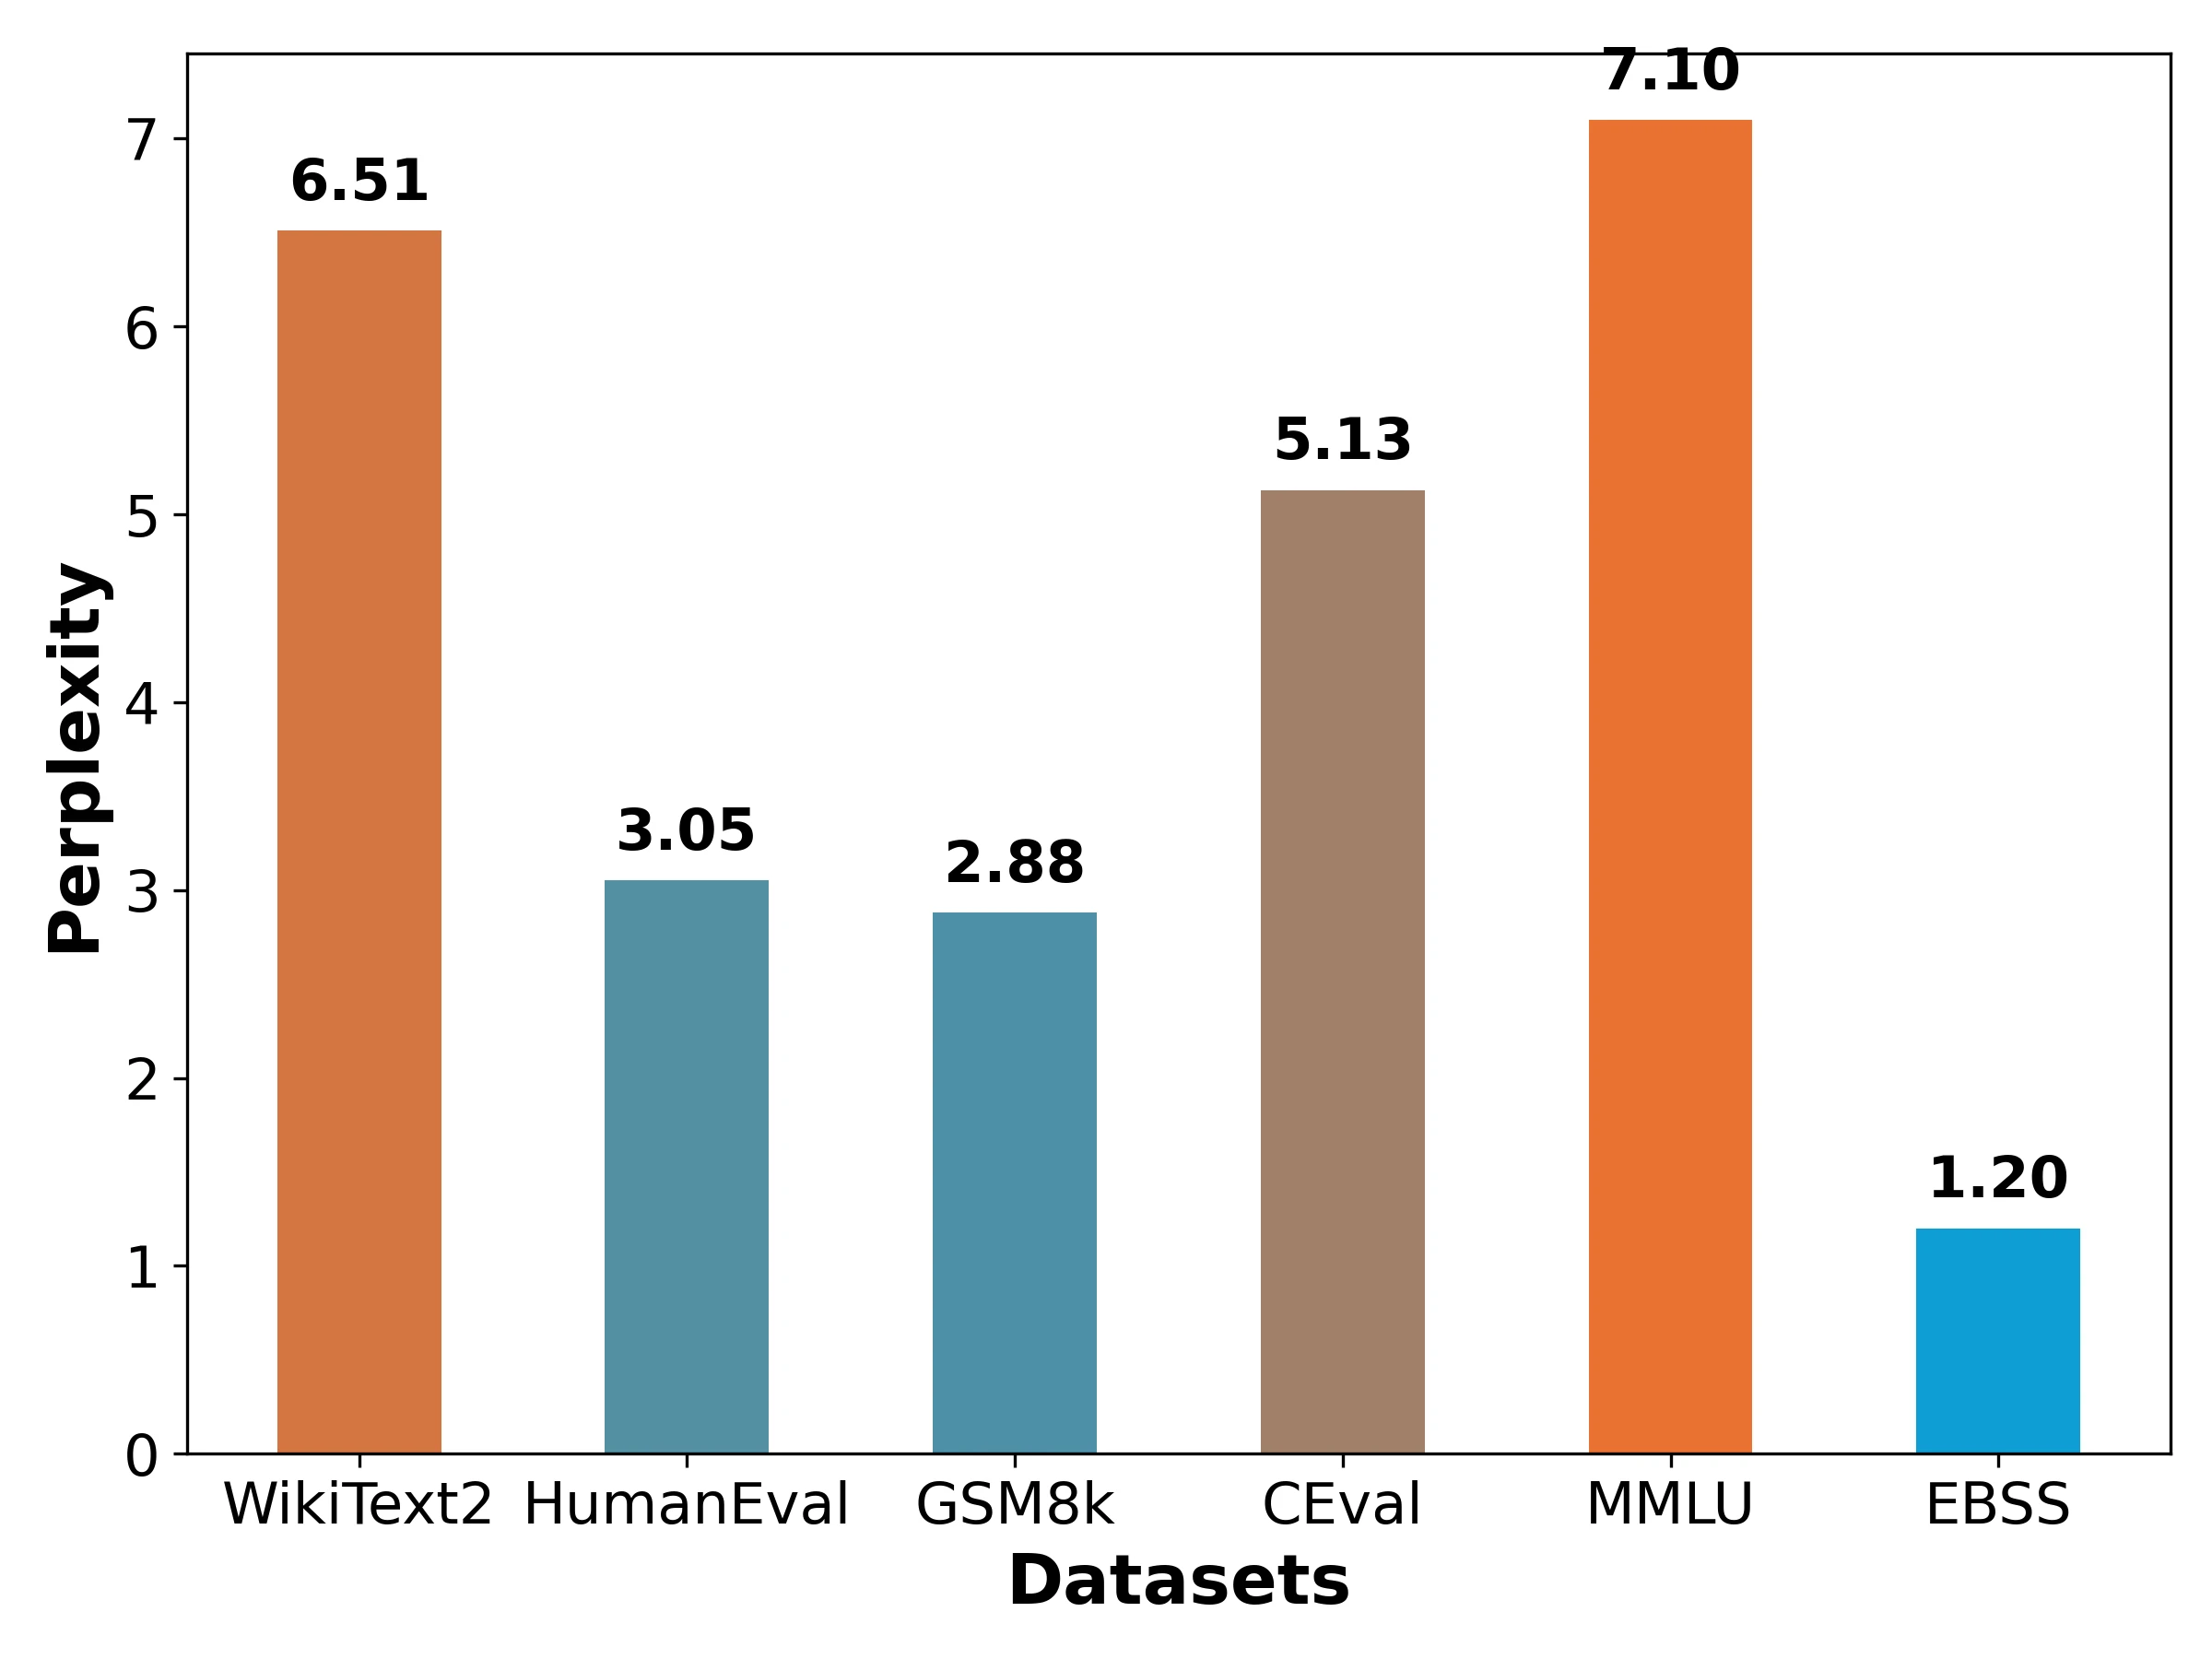
上图即论文 Figure 4(来源:MoEQuant 论文)。柱状对比 WikiText2、HumanEval、GSM8k、CEval、MMLU 与 EBSS 六种数据来源,前五种外来数据集的 PPL 都高于 WikiText2,而 EBSS 自身采样的 PPL 最低。结论是:用外部数据凑校准集,会在「分布贴合」这一项上先输一截。
把目标写成优化问题
于是目标变成:找到一个校准集 ,同时满足两个条件——低困惑度(贴合模型自身分布)与专家均衡(各专家被均匀覆盖)。论文把它写成一个联合最小化:
其中 是被量化的 MoE 模型, 是校准集 在模型上诱导出的专家使用频率标准差, 是控制专家均衡项权重的温度超参数。 是归一化失衡的倒数:频率越平, 越小,这一项越接近 1;越失衡,越大,起惩罚作用。
这里 的定义在论文式 (3)(4) 中给出:先算每层的专家使用频率标准差,再对层取平均:
是 MoE 层数, 是每层专家数, 是第 层第 个专家的使用频率, 是该层的平均频率。取各层标准差的平均,而不是全局合并,是因为不同层的专家分工不同,逐层衡量更能反映「哪一层的某些专家没被喂到」。分母用 是样本标准差的无偏形式。
困惑度的定义是常规的:
是序列长度, 是第 个 token, 是模型给出的条件概率。
直接解这个联合优化不可行:困惑度那一项对应「最优子集选择」,专家均衡那一项对应「负载均衡」,两者都是 NP 难的。论文因此做了两个改写:(1) 用概率的连乘表达 PPL,把问题变成在一个 维词表空间里的最短路/路径搜索;(2) 在搜索中只保留有限的候选分支,把复杂度从「全词表笛卡尔积」压到「 条分支」级别。
自采样:让模型自己写校准集
论文选择无数据自采样(self-sampling):完全不依赖外部语料,只从模型的词表出发,让模型自己按当前概率生成候选 token。好处有三:数据天然贴合模型分布;不需要额外语料;采样过程中还能顺便缓存历史概率与专家分布,避免重复计算。这做法与 Self-Instruct 一脉相承——用模型生成的数据校准模型自己。
定义一条候选序列 的历史累计对数概率:
那么把候选 token 接到 后面后,这条新序列的困惑度可以用缓存直接算:
是 的当前长度, 是模型在 之后给出 token 的对数概率(论文记号里把对数概率记作 ,与前面的概率记号略有不一致)。因为 已经算好,每扩展一个 token 只需要一次 log 概率查询,不必从头重算整条序列——这是自采样在计算上可行的关键。
概率引导的分支剪枝
自采样最大的问题在搜索空间:如果每一步都从整个词表展开,序列长度为 时样本空间是 ,穷举不现实;纯贪心又容易陷在局部最优(一条低质量序列走到黑)。论文的做法是保留有限条分支:
- 维护 条候选序列 ;
- 每一步,每条序列 与词表中每个 组合,得到 个候选;
- 对每个候选打分,只保留最好的 条:
也就是说,从 个扩展里选出 条,分数沿用与总目标一致的「负平均对数概率 + 专家均衡惩罚」结构。论文指出,这样的搜索把复杂度从 降到每次只需要 条分支的扩展,并且因为保留多条分支,能有效缓解贪心陷入局部最优的问题。
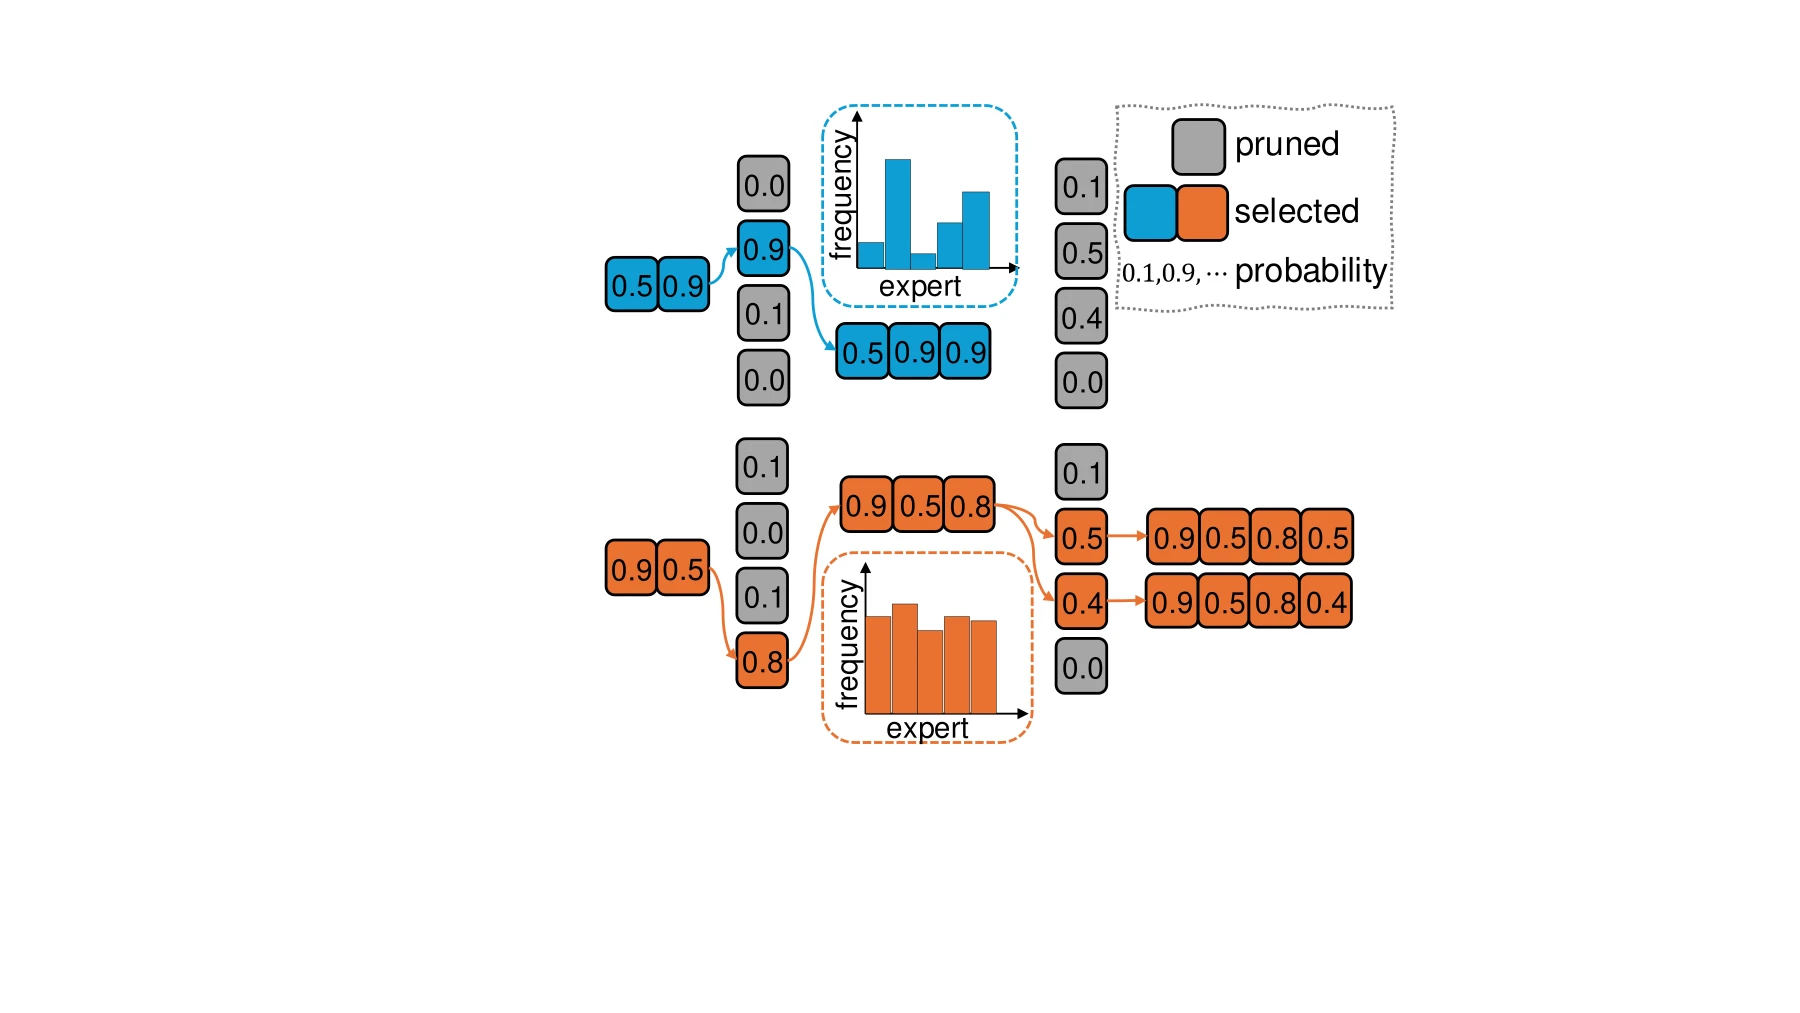
上图是 EBSS 的机制示意(来源:MoEQuant 论文 Figure 5)。树形结构上每一层是一个候选 token,节点旁边标着累计概率(如 0.1、0.9);高亮的是被选中沿用的分支,中间被打叉或被截断的路径是概率过低被剪掉的候选。可以看到搜索并不是一条单线,而是同时保留多条平行分支;每条分支的评分同时受到概率和专家分布两项引导。
一个分支打分的算例
为了把式 (13) 的取舍看清楚,构造一个两位小数的例子。假设某一步有两个候选扩展:A 的父序列累计概率较高,交叉熵项为 2.10(越小越好);B 的父序列更早分叉、概率略低,交叉熵项为 2.25。两个父分支的专家失衡惩罚不同:A 走过的路径集中在少数专家,;B 恰好覆盖了冷门专家,。则 A 的评分为 2.45,B 的评分为 2.35。B 虽然语言模型概率稍差,但因为专家覆盖更均衡而被优先保留。
这个例子说明 EBSS 的偏好:它并不追求「生成最像人话的文本」,而是「生成既像人话、又能把专家喂全的文本」。两个目标冲突时, 决定让步幅度。 很大时失衡惩罚压过概率项,会生成刻意触发冷门专家的残缺句子,损害校准质量; 很小则退化为纯似然搜索,又回到长尾。1.2 的取值正是两者的折中。
顺带指出一处实现时容易踩的记号问题:式 (13) 的 score 是「损失」形式(负平均对数概率加惩罚,越小越好),但式 (14) 写的是 arg top-k。按目标函数的方向,实现时应保留 score 最小的 条,而不是最大的 条。论文正文没有展开这一点,复现时以式 (9) 的联合最小化为准即可。
搜索开销到底花在哪
朴素地在词表上穷举时,长度 的序列有 种组合, 是 5 万级词表,完全不可行。EBSS 把开销压到两个可控的部分:
- 每条分支每步只需一次前向,就能拿到该分支上下一个 token 的完整分布 ,对所有候选 的对数概率查表即可; 意味着每步 4 次前向(共享前缀的可以合批),总开销与序列长度线性相关。
- 专家分布不必对每个候选 token 重算,只在分支粒度统计一次,所以路由统计的额外开销同样与 和步数线性相关。
真正昂贵的是「逐候选 token 更新专家统计」——那需要把词表里每个 token 都真正过一遍路由。延后计算把这部分整个去掉,这是 EBSS 能在单机离线阶段跑完的根本原因。换句话说,EBSS 省掉的不是语言模型前向,而是「为词表中每个候选 token 单独跑一次 MoE 路由」这笔更大的账。
为什么专家均衡项「延后计算」
式 (14) 的打分里有一个容易看漏的细节: 只依赖当前序列 ,并没有计算候选 token 本身对专家分布的影响。这看似不完整,论文给了三条理由:
- 代价:困惑度直接从模型输出的概率分布就能算,但要知道「加入某个 token 后专家分布怎么变」,需要把词表里每个候选 token 真跑一遍路由,开销巨大。而当前序列的专家分布已经算好,延后计算几乎不再额外花费。
- 语义:剪枝本质上是「预测下一个 token」,应当由语言模型的概率分布主导。把专家分布项放进逐 token 的剪枝里,会让选择偏离语义连贯性。
- 效果:即使延后,均衡项仍然作用在「分支层」——同一父节点下所有候选共享同一份专家分布得分,于是剪枝倾向于留下能覆盖到未充分利用专家的分支。论文据此认为,这样能在保持困惑度前提下生成专家均衡的校准集。
这一段是全篇最值得细想的设计取舍。严格来说,式 (14) 是一个近似:它用「父序列的专家分布」代理「扩展后序列的专家分布」。在 条分支的粒度上,这个近似足够把不同分支区分开,但若某个 token 恰好单独触发了一个冷门专家,它在剪枝阶段不会被记录下来。作者的判断是:这个精度损失远小于逐候选计算路由的代价。
两个超参数的实测偏好
附录给出了 EBSS 超参数消融(DeepSeek-MoE-16B,7 个任务平均分):
| 1.0 | 1.1 | 1.2 | 1.3 | 1.4 | 1.5 | |
|---|---|---|---|---|---|---|
| 平均分 | 39.82 | 39.89 | 40.01 | 39.98 | 39.69 | 39.71 |
| 分支数 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 20 | 30 | 40 | 50 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 平均分 | 39.77 | 39.80 | 40.01 | 39.98 | 40.01 | 40.00 | 40.00 | 40.01 | 40.00 | 40.10 | 40.07 | 40.08 | 40.11 |
控制专家均衡项在句子选择中的分量:太低,均衡项几乎不起作用;较高时平均分先升后降,1.2 处最高。 决定生成序列的多样性:增大 提升多样性,但也更费时。从表里看, 从 2 增到 50,平均分只从 39.77 涨到 40.11——收益边际非常明显。论文因此取 、 作为默认,用很小的分支数换大部分收益。这一组数字也说明了另一个事实:EBSS 的收益对搜索宽度不敏感,它的主要作用来自「自采样 + 均衡剪枝」本身,而不是把搜索开得很宽。
亲和度:把门控系数带进量化误差
亲和度如何穿过 FFN 每一层
回到 MoE 层的输出。专家 收到一组 token 集合 ,对应门控系数 ,第 个 token 经该专家后的输出是
这就是论文定义的亲和度:门控系数 刻画了样本 与专家 的相关程度。
把专家展开为一个门控线性层 + 激活 + 下投影的 FFN:
这里 、、 分别是上投影、门控投影、下投影矩阵, 是 SiLU 一类激活。利用「FFN 主体是线性、 近似分段线性/齐次」的性质, 可以从最外层推进到内部:
这两步推导给出了关键结论:门控系数 会传播到专家网络的每一层,最终相当于给该 token 在这个专家内的每一次线性计算乘上一个缩放因子。所以在任何单个线性层上,都可以直接把 乘进这个 token 的输入——不同 token 对同一专家的线性层权重施加的是门控感知(gate-aware)的影响。
需要诚实指出这里有一处近似:把 推进到 内部依赖激活函数的齐次性(),SiLU 只是一定范围内的近似。论文的目标不是严格等价,而是说明「门控系数是主导量级的缩放因子」,用它来重排量化的权重。
重写量化损失
有了这一步,传统只把 token 当等权样本的层内损失 变成门控加权:
是第 个 token 在该层的输入向量, 是它的门控系数。含义很直接:门控系数高的 token 产生的量化误差在总损失里权重更高。对这些 token 来说,它的输出会以更大的系数进入最终结果,量化误差当然应该被更认真对待。AWQ 这类以量化误差直接做选择的方法,把式 (18) 代进去后就会自动把「平滑系数」和「保护通道」的挑选偏向高亲和度的 token。
门控感知的 Hessian
对 GPTQ 这类基于二阶信息的方法,关键量是 Hessian。原式 (8) 的 隐含了每个 token 等权。门控加权后,把 按 逐行缩放:
注意中间式与右边式:若把 的第 行乘以 ,则 ——也就是 的第 元素再按 加权求和。右边那个写法 用逐行乘 然后与 相乘,得到的是 ,与中间式一致,但省去了逐行开方。工程上可以直接把门控系数当作逐行权重拼进 Hessian 统计,不用对每个元素开根号。
对 GPTQ 来说,这一步的意义在于敏感度排序变了:Hessian 里高亲和度 token 的贡献被放大,反过来影响 OBQ/GPTQ 的列序选择与误差补偿量。原来所有 token 一视同仁的「重要性」评估被修正,权重更新会更贴合 MoE 实际运行时的算子动态。
对比站内已拆过的 GPTQ 与 AWQ 机制,可以看到 AGQ 并不是要替换它们:AWQ 的按通道平滑选系数、GPTQ 的二阶误差补偿都照旧,AGQ 只改动了「喂给这两套算法的那份样本统计」,可参考 AWQ 完全拆解:只保护 1% 的显著权重,4-bit 量化如何接近无损 与 GPTQ 完全拆解:二阶信息驱动的权重量化,如何把 175B 模型塞进一张 A100。
在 GPTQ 的逐列更新里,亲和度改了什么
GPTQ 的量化是逐列进行的:第 列被量化后,用它的量化误差 去修正尚未量化的列。标准更新量为
是当前列的量化误差, 是 Hessian 逆。这个式子来自 OBQ 的误差补偿:把当前列的量化误差按「各列与当前列在 Hessian 度量下的相关性」摊到后续列上,从而让已量化列的误差在剩余权重上被抵消一部分。
AGQ 把 换成门控加权的 后, 的元素随之变化,补偿方向被重新加权。直观地说,若某个方向上的方差主要由高亲和度 token 贡献,那么该方向在 Hessian 中的占比更大,量化误差会更倾向于沿这些方向被抵消——也就是优先保住高亲和度 token 的输出;反过来,低亲和度 token 主导的方向会被牺牲一些。这与 MoE 的运行语义一致:门控分数接近零的 token,本来就在聚合时被大幅缩小,量化误差落在它们身上的实际影响也小。
同理,若把 AWQ 的式 (7) 换成式 (18),它的平滑系数搜索会变成按亲和度加权的激活统计。AWQ 原本用逐通道激活幅值判断哪些通道要保护;加权后,判断依据从「全体 token 的平均幅值」变成「高亲和度 token 的加权幅值」。论文没有单独列出 AWQ 统计量的公式,但这条替换是式 (18) 的直接推论,也是 能工作的原因。
工程上有两点需要注意。其一,加权 Hessian 的数值条件可能变差:如果某个专家的校准样本几乎全是低亲和度 token,加权后矩阵接近奇异,GPTQ 的 Cholesky 分解需要更大的阻尼(damping)。其二,常见的 top-k 归一化门控会让同一个 token 对不同专家的 之和为 1;直接把这些 当权重不会改变每个专家的样本数,只改变样本在 Hessian 中的相对分量。GPTQ 逐列补偿与 Cholesky 的具体实现,可参考站内 GPTQ 完全拆解:二阶信息驱动的权重量化,如何把 175B 模型塞进一张 A100。
两种组合的命名
论文里用两种标记区分组合方式: 表示以 AWQ 为主算法的版本, 表示以 GPTQ 为主算法(并沿用 QuaRot 式的等价 Hadamard 旋转来处理权重离群值,不做在线变换)。两个词尾分别对应「AWQ + 均衡校准集 + 亲和度」和「GPTQ + 均衡校准集 + 亲和度」。这个命名很重要:MoEQuant 本身是校准层与误差层的外挂框架,效果要按主算法分别看。
复现路径:一条 MoE 量化流水线
论文承诺开源代码但正文没有附实现,这里按公式给出等价的流程骨架,用来把每一步落在具体张量上。整条流水线分五段。
第一段:统计路由。 在未量化的模型上跑一遍校准数据(或直接进入第二段的自采样),用 hook 记录每个 MoE 层每个 token 的 top-k 专家下标与门控系数。专家使用频率用于计算式 (3)(4) 的 ,门控系数用于 AGQ。
第二段:生成均衡校准集。 EBSS 的分支搜索伪代码如下,核心是「一次前向拿整词表分布、只在分支粒度更新专家统计」:
def ebss(model, tau=1.2, width=4, steps=256): branches = [("", 0.0)] # (已生成序列, 累计对数概率 R_S) stats = [Counter() for _ in range(model.num_moe_layers)] for _ in range(steps): candidates = [] for seq, R in branches: logprobs = model.next_token_logprobs(seq) # 一次前向,返回 |V| 个对数概率 sigma = balance_std(stats) # 父分支的专家失衡 for v, lp in logprobs.items(): # 扩展候选 score = -(R + lp) / (len(seq) + 1) + sigma / tau candidates.append((seq + v, R + lp, score)) branches = sorted(candidates, key=lambda x: x[2])[:width] update_expert_stats(stats, branches) # 分支粒度,延后计算 return [seq for seq, _, _ in branches]注意第 12 行的排序取的是 score 最小的 width 条;这一步与论文式 (14) 的 arg top-k 方向需要按目标函数统一。next_token_logprobs 对每条分支调用一次,可以批处理;返回整词表分布后,扩展与打分的代价只是排序,不涉及额外前向。
第三段:按专家收集激活。 用第二步得到的校准集再做一次前向,把每个路由线性层(up/gate/down)的输入激活按专家分组缓存,同时记录对应 token 的门控系数。共享专家没有门控,其系数按 1 处理。这一步的内存开销是校准集大小 × 层数 × 隐藏维,通常远小于模型本身。
第四段:加权 Hessian + 主算法量化。 每个专家、每个线性层独立计算加权 Hessian,再交给 GPTQ 或 AWQ:
def weighted_hessian(X, c): # X: [b, c_in] 路由到该专家的校准激活;c: [b] 门控系数 Xw = X * c.sqrt().unsqueeze(1) return Xw.transpose(0, 1) @ Xw # H = (X·sqrt(c))(X·sqrt(c))^T
for name, module in moe_linear_layers(model): X, c = calibration_cache[name] # 按专家分组后的激活与亲和度 H = weighted_hessian(X, c) gptq_quantize(module.weight, H, bits=4)第五段:导出与推理。 每个专家产出自己的量化权重与逐输出通道 scale,按推理框架期望的布局打包。MoE 量化后的权重加载路径与普通 Linear 并无本质区别,站内对 SGLang 源码完全拆解(十九):量化方法的注册与层分派 和 llama.cpp 源码完全拆解(十五):量化 GEMM 的矩阵编队 的拆解可以作为落地时的参照:真正需要在框架侧确认的是「per-expert 的 scale 怎么随专家权重一起装载」以及「分组 GEMM 是否按专家取到正确的 scale」。
这条流水线里没有任何一步需要修改量化主算法;所有改动都发生在「喂给主算法的数据」上。这也是论文反复强调「即插即用」的实际含义。
实验结果怎么读
实验设置:逐通道对称权重量化,在 NVIDIA A6000 上完成;模型为 Qwen-MoE-14B、DeepSeek-MoE-16B、Mixtral-8x7B 及其指令微调版本;基线的校准集均为 WikiText2 的 128 段(这正是论文批评的「单一领域校准」)。评测除了 WikiText2 与 C4 上的困惑度,还有 MMLU、HumanEval、GSM8k、BoolQ、HellaSwag、OpenbookQA、MathQA 七项任务。
基础模型 4-bit
以 DeepSeek-MoE-16B 为例(4 bit 权重,九项任务):
| 方法 | Wiki PPL | C4 PPL | MMLU | HumanEval | GSM8k | 七项平均 |
|---|---|---|---|---|---|---|
| FP | 6.51 | 9.04 | 44.60 | 26.83 | 20.16 | 40.86 |
| AWQ | 6.80 | 9.50 | 40.57 | 17.06 | 25.00 | 39.23 |
| 6.94 | 9.32 | 41.20 | 18.90 | 25.00 | 39.68 | |
| GPTQ | 6.66 | 9.39 | 40.60 | 19.18 | 22.56 | 39.01 |
| 6.78 | 9.22 | 42.20 | 25.00 | 19.18 | 40.01 |
读这张表要把握三点。第一,C4 困惑度比 WikiText2 困惑度更能说明问题:所有基线都用 WikiText2 校准,在 WikiText2 上的 PPL 天然「被过拟合」,GPTQ 的 6.66 甚至比 MoEQuant 组合的 6.78 还低;但换到 C4, 的 9.22 追平了 FP 的 9.04 量级,优于 GPTQ 的 9.39。第二,HumanEval 是最能体现收益的指标:GPTQ 从 FP 的 26.83 掉到 19.18, 拉回 25.00;Qwen-MoE-14B 上 GPTQ 为 28.05, 为 29.87,Mixtral-8x7B 上 GPTQ 为 27.60, 为 32.15——几乎回到 FP 的 32.93。第三,七项平均分在三个模型上都比原方法高约 1 个点,并且逼近 FP。
三个模型在 HumanEval 上的横向对比更能说明问题:
| 模型 | FP | GPTQ | GPTQ 保留率 | MoEQuant 保留率 | |
|---|---|---|---|---|---|
| Qwen-MoE-14B | 32.32 | 28.05 | 29.87 | 86.8% | 92.4% |
| DeepSeek-MoE-16B | 26.83 | 19.18 | 25.00 | 71.5% | 93.2% |
| Mixtral-8x7B | 32.93 | 27.60 | 32.15 | 83.8% | 97.6% |
保留率按「量化后分数 / FP 分数」计算。GPTQ 在 DeepSeek-MoE-16B 上只剩七成代码能力,MoEQuant 把差距收窄到约七个点;Mixtral 上几乎追平。代码生成任务对量化的敏感度远高于选择题类任务,原因是它要求长程、精确的符号操作,任何一处分布偏移都可能让整段程序编不过;因此 HumanEval 上的保留率可以当作「量化是否伤到模型推理能力」的试金石。
指令微调模型更明显
指令微调模型的量化通常更难,论文单独测试了 Qwen-MoE-14B-Chat 与 DeepSeek-MoE-16B-Chat(3 项任务)。以 Qwen-MoE-14B-Chat 的 HumanEval 为例:FP 为 21.34,GPTQ 仅 15.24(对应论文所说的「GPTQ 在该模型 HumanEval 上掉 29%」), 为 21.95,已略高于 FP。GSM8k 上 GPTQ 为 26.08, 为 29.11。论文总结 Qwen-MoE-14B-Chat 上 稳定保住 94% 以上的全精度表现。
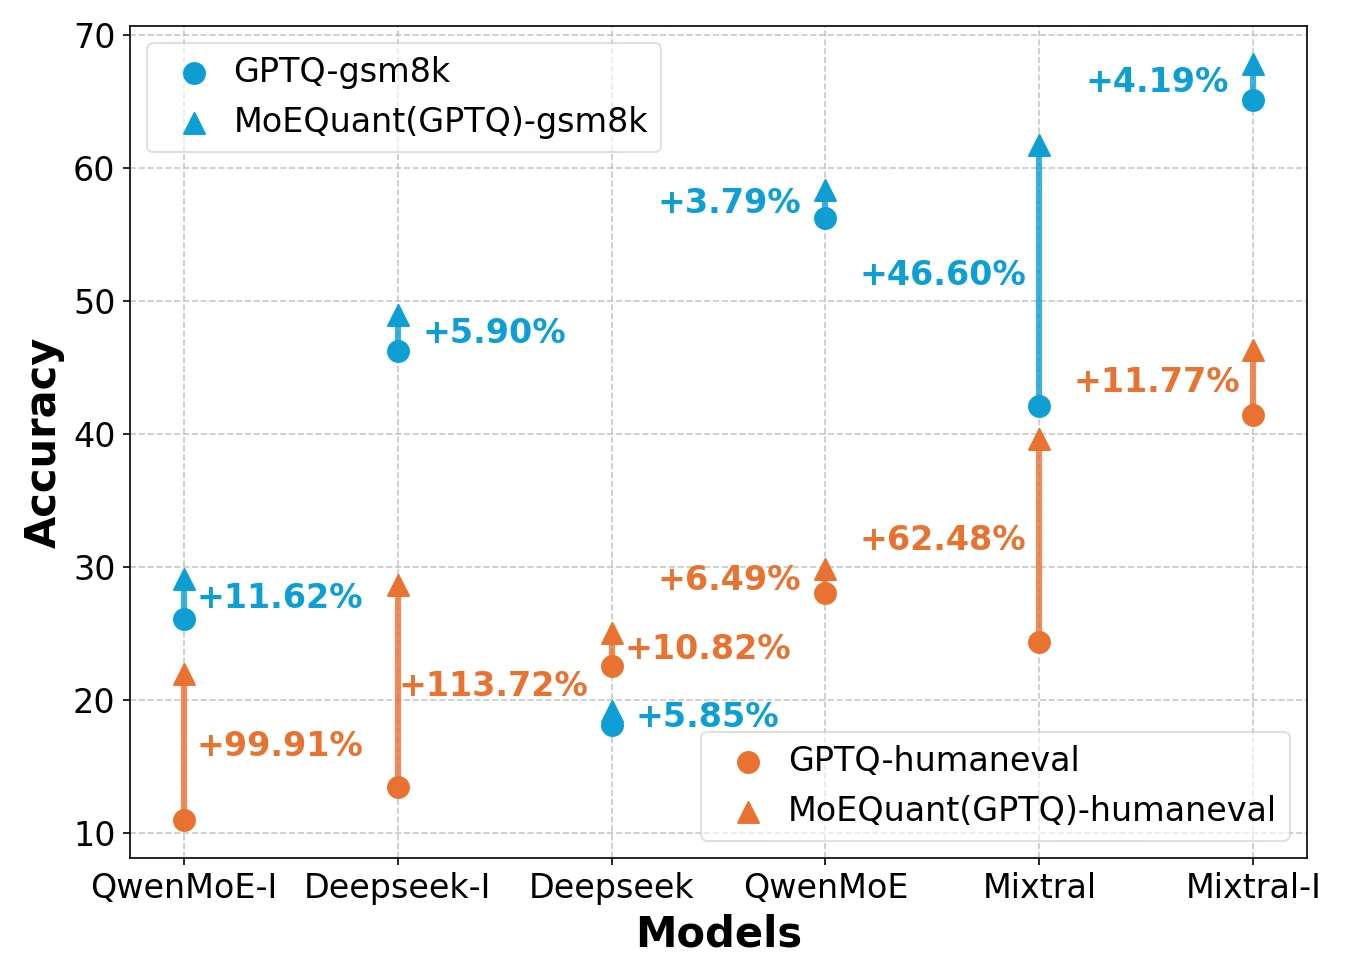
这张图把改进幅度直接标在柱子上(来源:MoEQuant 论文 Figure 1)。灰色柱是 GPTQ 在 GSM8k 上的成绩,斜线柱是 MoEQuant(GPTQ) 版本的成绩,上方标注相对提升比例;HumanEval 用另一组颜色。可以看到各模型的提升都为正,其中指令微调版本(后缀 I)在代码生成任务上的相对提升尤其突出。相对提升之所以看起来很大,是因为基线 GPTQ 在这些任务上掉得极深——从 FP 跌到 GPTQ 只有六成左右,因此补回来哪怕几个绝对点,相对值也会成倍上涨。读这类图时要同时看绝对分数表,避免被相对百分比带偏。
更低比特:收益反而更大
论文在 DeepSeek-MoE-16B 与 Mixtral-8x7B 上试了 3-bit(七项平均):
| 模型 | FP | RTN | AWQ | GPTQ | ||
|---|---|---|---|---|---|---|
| DeepSeek-MoE-16B | 40.86 | 20.17 | 22.20 | 26.65 | 35.85 | 36.47 |
| Mixtral-8x7B | 56.80 | 18.64 | 36.05 | 39.30 | 45.03 | 49.75 |
DeepSeek-MoE-16B 上 3-bit RTN 与 AWQ 出现灾难性退化:RTN 在 WikiText2 上的 PPL 高达 26352,AWQ 也有 4622,基本等于模型崩了;加上 EBSS + AGQ 后 仍只有 26.65,但比 AWQ 的 22.20 好出一截。GPTQ 路线相对稳, 则把 Mixtral-8x7B 的 3-bit 从 45.03 推到 49.75,对 FP 的 56.80 补了约五个点。
这一现象的解读是:比特越低,量化误差越依赖「校准得好不好」。4-bit 时误差补偿的余量还大,校准集偏一点也能被 GPTQ 的二阶补偿吸收部分;到了 3-bit,误差补偿的能力吃紧,校准集的均衡性与样本权重就直接决定成败。这也解释了为什么越激进的量化目标越值得用这类「校准集 + 亲和度」的框架。
消融:两块各自贡献多少
附录的消融以 GPTQ 为基线(九项任务的七项平均),摘录:
| 模型 | GPTQ | +EBSS | +AGQ | +EBSS+AGQ |
|---|---|---|---|---|
| Qwen-MoE-14B | 49.00 | 49.02 | 49.21 | 49.59 |
| DeepSeek-MoE-16B | 39.01 | 39.50 | 39.87 | 40.01 |
| Mixtral-8x7B | 53.42 | 54.24 | 55.15 | 55.58 |
DeepSeek-MoE-16B 上 EBSS 单独贡献约 +0.5,AGQ 单独约 +0.9,两者叠加 +1.0;组合效果最好但并非严格相加。三个模型上 AGQ 单独的增益都大于 EBSS 单独的增益,Mixtral-8x7B 上尤其明显(+1.73 对 +0.82)。论文同时指出,Mixtral 上单独使用 AGQ 时结果「并不优于常规 GPTQ」,组合起来仍是最优的——结合表中数据可以理解为:Mixtral 这一档 AGQ 的单独增益有限而 EBSS 与 AGQ 互补性强,组合才把整体推上去。这提醒读者:消融要按模型看,EBSS 与 AGQ 在不同模型上的相对贡献不同,不能一概而论。
推理效率
论文在 A6000 上对比 4-bit 实现与 FP16:
| 模型 | 解码速度 FP(tok/s) | 量化后(tok/s) | 加速 | 显存 FP(GB) | 量化后(GB) | 节省 |
|---|---|---|---|---|---|---|
| Qwen-MoE-14B | 8.35 | 10.60 | 1.27× | 27.88 | 8.51 | 3.28× |
| DeepSeek-MoE-16B | 20.81 | 24.45 | 1.17× | 32.23 | 9.87 | 3.27× |
| Mixtral-8x7B | 10.24 | 21.25 | 2.08× | 89.64 | 23.97 | 3.74× |
显存节省都超过 3.2×,符合 4-bit 权重的理论预期;加速幅度则差别很大。Mixtral-8x7B 拿到 2.08×,而 Qwen-MoE-14B 与 DeepSeek-MoE-16B 只有 1.17× 到 1.27×。原因需要从 MoE 推理的瓶颈结构去理解:Mixtral 是纯路由专家,每层激活 2 个 7B 量级的专家,单步解码要读的权重多、带宽吃紧,4-bit 直接砍掉 3/4 的读取量,收益立竿见影;Qwen-MoE 与 DeepSeek-MoE 激活参数少(2.7B / 2.8B 量级),单步解码的权重读取本来就少,瓶颈更多落在注意力、调度与 kernel 启动开销上,权重带宽的收益被其他开销摊薄。这也解释了为什么论文宣称能让 MoE 部署到 RTX 4090 一类消费级卡上——驱动因素主要是显存容量,而不是解码速度。
速度收益为什么不均匀:一笔解码账
前面提到 Mixtral 拿到 2.08× 而 Qwen-MoE 与 DeepSeek-MoE 只有约 1.2×,这里把账拆开算一算,理解它为什么必然如此。
单请求、大批量较小的解码阶段(batch 较小时),GPU 几乎跑不满算力,瓶颈在从显存读权重到 SM 的时间。设每步需要读的权重字节数为 ,显存带宽为 ,则单步中「读权重」的理论下限是 。量化到 4 bit 把 降到约四分之一,理论上这一部分时间也降到四分之一;但单步总时间还包含注意力(读 KV Cache)、调度、kernel 启动、采样等固定开销 。于是加速比为
这个式子的含义很直接:只有当 在单步里占比足够大时,压缩权重的收益才会显著体现。Mixtral 每步要读两个 7B 量级专家的权重, 很大,加速比才能到 2×;Qwen-MoE 每步只读 2.7B 激活参数里的专家部分, 与固定开销相当,分母里 占比大,加速比就被压到 1.2× 左右。
这也解释了论文「平均 1.2× 加速」与「3.2× 显存节省」两个数字为什么不对称:压缩权重对显存容量的收益是确定性的(权重总量除以 4),对解码速度的收益取决于该模型的单步时间有多少由权重读取贡献。对激活参数更小的 MoE(如 DeepSeek-MoE 16B 激活约 2.8B),4-bit 的主要价值是「能塞进更小的卡」,而非「跑得更快」。若想进一步提升吞吐,就需要看批量增大后注意力与 kernel 是否成为新瓶颈——批量越大,权重读取被摊薄,收益反而会缩小。
它在量化方法地图里的位置
把 MoEQuant 放进已有的量化方法谱系,可以更清楚它解决了什么、没解决什么。
它不负责主算法。GPTQ 的二阶误差补偿、AWQ 的按通道平滑、QuaRot 的旋转消除离群值,这些都在 MoEQuant 之外照常工作。MoEQuant 改的是两样辅助输入:喂给主算法的校准数据(EBSS)和喂给主算法的样本权重(AGQ)。这也是它能与多种主算法组合、得到 / 两种形态的原因。
它与「MoE 结构感知」的其他尝试互补。站内已拆的 XFP 用码本量化给大 MoE 模型做自适应位宽,可参考 XFP:质量地板驱动的自适应码本量化——3.4 位在双卡工作站跑通 397B MoE;Nemotron 3.5 Bolt 用结构压缩加 IQ2_XXS 做 2 比特级方案,可参考 Nemotron 3.5 Bolt 完全拆解:从 120B 到 74B,Star Elastic 结构压缩与 2.0625-bit 量化如何把大模型塞进 24GB。这些方案关注「位宽怎么排、码本怎么设计」;MoEQuant 关注「在校准这一侧如何公平地对待每个专家」。两条线可以在同一套量化流水线里叠加。
它对专家内部的离群值处理依赖主算法。AGQ 重新加权了样本,但没有触及权重与激活自身的离群值。论文在 GPTQ 路线上沿用 QuaRot 的等价 Hadamard 旋转(离线做、不在线做)来先把离群值压平,再算加权 Hessian;若换成不做旋转的朴素 GPTQ,AGQ 的增益可能被离群值抵消。这说明 MoEQuant 的「亲和度」与「离群值治理」是两个正交问题:前者决定样本怎么分配权重,后者决定权重分布是否适合均匀格点。要放到更低的比特(如 3-bit、2-bit),后者往往更关键,站内对 QuaRot 方法的拆解可参考 QuaRot 完全拆解:旋转坐标系根除激活离群值,LLM 端到端 W4A4KV4 推理的数学魔法。
它的评估依赖特定基准组合。论文主要使用 MMLU、HumanEval、GSM8k、BoolQ、HellaSwag、OpenbookQA、MathQA 七项,其中 HumanEval 与 GSM8k 对量化退化最敏感,也是收益最显眼的指标。若换成长上下文、多轮对话或非英语任务,路由分布会更复杂,EBSS 的均衡校准与 AGQ 的亲和度加权是否同样有效,论文没有给出直接证据。工程上建议在目标业务分布上另做一次评估,而不是只看这组通用基准。
它假设了静态路由。EBSS 与 AGQ 都依赖「路由分布可由校准数据代表」。这对负载相对平稳、单机部署的 MoE 成立;但在大规模专家并行场景下,同一个逻辑专家在不同 rank 上的物理副本、在线负载变化导致的路由漂移(例如 EPLB 动态重排专家),会让校准阶段的专家分布与运行时偏差加大。这时 EBSS 追求「每个专家均衡」反而可能偏离真正需要保护的热专家。论文没有讨论这一点,工程落地时值得按实际流量对齐一次校准数据。
它的开销主要在离线端。EBSS 要在模型上做自采样与分支剪枝, 时的搜索量可以承受;AGQ 只是在校准统计里多带一份逐 token 门控系数,对 GPTQ 的 Hessian 累加几乎不加成本。推理端则完全是主算法本身的收益——这也意味着 MoEQuant 不改动推理内核,4-bit 的 kernel 支持(如 Marlin 一类的 W4A16 内核,参见 Marlin 完全拆解:4-bit 权重如何喂满 GPU Tensor Core)依旧是部署链条上的必要条件。
设计空间与未解的问题
MoEQuant 给出了一个干净的两段式框架,但它把若干设计选择固定了下来,这些选择在某些场景下会成为新的偏差来源。
「专家均衡」本身是一个有偏的目标。 均衡假设每个专家同等重要,可真实流量里热专家承担了更多 token,它们的量化误差对整体输出的影响更大。EBSS 用 惩罚长尾,可能把宝贵的校准预算过多分给冷门专家,反而让热专家的校准密度下降。 是唯一调节旋钮,论文没有提供按专家流量加权的失衡度量。一个自然的改进是用门控质量(每个专家收到的 总和)给 加权,让「均衡」变成「按重要性加权的均衡」;但这会重新引入热专家过拟合的老问题,如何在两者间取平衡需要实验。
自采样会继承模型自身的缺陷。 模型自己生成的数据天然贴合自身分布,PPL 也低;但低 PPL 不等于覆盖长尾知识。一个在某些领域很弱的模型,自采样出的校准集同样不会覆盖那些领域,冷门专家的「均衡」可能只是形式上的:频率被喂平了,语义分布仍然单一。加入温度扰动、随机前缀或多模型混合采样可以缓解,论文未做这类消融。
亲和度只作用在权重量化上。 论文的全部实验是 W4A16(权重 4 bit、激活 16 bit),AGQ 的加权对象是校准激活和 Hessian。若进一步做 W4A4 或 KV Cache 量化,门控系数的类比对象会变成注意力权重或路由分数,作用机制需要重新推导。站内对 KV Cache 量化的多种方案(如 KIVI 的 per-channel Key、per-token Value)已有拆解,可参考 KIVI 完全拆解:非对称 2-bit KV Cache 量化,为什么 Key 按通道、Value 按 token。
与动态专家并行存在时间差。 校准发生在离线、模型结构固定的时刻;上线后若使用 EPLB 动态重排、冗余专家复制或弹性扩缩,逻辑专家到物理专家的映射会变化,但校准统计是按逻辑专家收集的,这一点通常没问题。真正的时间差来自流量分布漂移:上线初期的请求主题与校准集不同,热专家集合会变。论文没有评估这种漂移下的退化速度,工程上应把「周期性重校准」纳入运维流程,而不是量化一次用到底。
与结构化压缩的组合顺序未验证。 若先做结构压缩(如 Star Elastic 一类的嵌套子模型裁剪,参见站内对 Nemotron 3.5 Bolt 的拆解),模型分布已经改变,再用量化前的统计就失效了。理论上应在裁剪后的模型上重新跑 EBSS,但两步的交互、以及裁剪后专家数变化对 的影响,论文都没有覆盖。
这些未解问题并不削弱论文的核心贡献:它第一次把「MoE 的两重失衡」明确命名、量化,并给出可组合的修补方案。它们只是说明,MoE 量化远未到「一个框架包打天下」的阶段。
小结
MoE 推理的显存账由全部专家决定,因此权重压缩是 MoE 落地的第一道门槛;而现有 PTQ 方法在 MoE 上掉点的根因是它们把每个 token、每个专家都当等权处理。MoEQuant 把这个问题拆成两重失衡:
- 专家间失衡:单一领域校准集在路由上呈长尾,冷门专家几乎没被校准过。EBSS 用模型自采样构造校准集,把「负平均对数概率 + 专家均衡惩罚」写成搜索目标,用概率引导的分支剪枝把搜索复杂度压到可执行范围;专家均衡项延后到分支级计算,换来极低的额外开销。
- 专家内失衡:门控系数决定了同一专家内不同 token 的影响力,传统量化误差与 Hessian 却忽略了它。AGQ 从「门控系数传播到 FFN 每一层」的推导出发,把 作为逐样本权重写进量化损失与 Hessian,使权重更新更贴合 MoE 的算子动态。
在 Qwen-MoE-14B、DeepSeek-MoE-16B、Mixtral-8x7B 与两个指令微调模型上,这套框架在 4-bit 下让七项平均分逼近全精度,HumanEval 上三个模型都明显补回,GSM8k 上 Qwen 与 Mixtral 超过原方法、DeepSeek 略有回退——这是主表里少数没有全面占优的格子,值得如实记下。3-bit 下它显著缓和了 AWQ 的灾难性退化,并把 GPTQ 路线的平均分再推高(Mixtral 上从 45.03 到 49.75),显存节省超过 3.2×。它的边界同样清楚:只改校准侧、不改主算法与内核;依赖静态路由假设;在激活参数小、带宽不是瓶颈的 MoE 上,压缩带来的是显存容量收益而非解码速度收益。
参考资料
- MoEQuant: Enhancing Quantization for Mixture-of-Experts Large Language Models via Expert-Balanced Sampling and Affinity Guidance(arXiv:2505.03804)
- MoEQuant HTML 全文(arXiv HTML 版)
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers(arXiv:2210.17323)
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration(arXiv:2306.00978)
- QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs(arXiv:2404.00456)
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models(arXiv:2401.06066)
- Mixtral of Experts(arXiv:2401.04088)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



