


多智能体系统全链路拆解:协作范式、通信与记忆、KV Cache 服务优化,以及面向硬件的基准
一条被忽视的栈:多智能体系统横跨算法、系统与硬件
多智能体系统(Multi-Agent System, MAS)这几年被讨论得很多,却经常被放在两个互不相通的语境里。做算法的人关心的是协作范式:多个模型怎么分工、怎么交换答案、怎么投票聚合;做系统的人关心的是推理服务:请求什么时候到达、KV Cache 怎么分配、批处理怎么调度;做硬件的人关心的是负载画像:这些请求到底在算什么、访存压力有多大、哪一种加速器更合适。三者之间的连接点,恰恰是 MAS 最容易被忽略的部分——协作语义会直接改变服务行为的形状,而服务行为的形状又决定了硬件需要什么。
如果把一个 MAS 任务拆成时间线,它大致是这样的:一个用户请求进入系统,被编排器拆成若干子任务;每个子任务对应一次或多次 LLM 调用,中间穿插工具调用;不同 agent 之间通过共享上下文、结构化文档、消息或隐状态交换信息;某些阶段需要同步屏障,某些阶段可以完全并行;工具调用的等待会让 KV Cache 在显存里闲置,而跨 agent 的重复上下文会让相同的 prefill 被反复计算。最终用户看到的只是端到端时延和一个答案,但系统内部发生的是一次带有依赖图、同步点与不规则请求突发的推理工作负载。
本文沿着这条栈自下而上走一遍:先看推理型 MAS 的三种基本协作范式及其动态化改造,再看 agentic MAS 如何用 SOP 与编排器把任务分工固定下来;随后进入通信与记忆这两层“系统语义”,解释它们为什么等价于带宽、一致性与缓存层次问题;最后落到服务侧的 KV Cache 生命周期管理与面向加速器的基准设计。整条线索可以用一句话概括:MAS 的性能瓶颈很少在单个 agent 的提示词里,而在 agent 之间传递信息的结构与时机里。
阅读地图
| 层次 | 关注对象 | 本文对应章节 |
|---|---|---|
| 协作算法层 | MoA、RouteMoA、Multi-Agent Debate、MetaGPT、Magentic-One、MAS scaling | 第 2–10 节 |
| 通信与记忆层 | 拓扑、信息表示、交换方式、记忆作用域与放置 | 第 11–13 节 |
| 推理服务层 | 工作流依赖、工具停顿、KV Cache 生命周期、跨 agent 复用 | 第 14–16 节 |
| 硬件评测层 | 协作模板、分层语义 trace、计算/访存归因 | 第 17 节 |
把这张表记住,后面每一节都可以放回它所在的层来看。
推理型协作的出发点:单模型的两种系统性缺陷
任何一套多智能体方案,都必须先回答“为什么一个模型不够用”。在推理任务上,这个问题有两个明确的答案。
第一个是单一路径错误。自回归模型在推理时沿着一条采样路径往下写,前面某个中间结论写错了,后续推理与最终答案往往会被错误地带偏。自反思(self-reflection)能部分缓解这一点,但它依赖的是同一份上下文、同一组参数与同一种偏见重新审视自己,很难跳出来发现根本性的前提错误。
第二个是知识局限与视角单一。对开放性问题,单个模型的知识边界就是它训练数据与参数的边界,换一个视角、换一条推理路线,往往能看到别的东西。
基于这两点,推理型多智能体(reasoning-based multi-agent)的核心思路是:让多个模型从不同角度独立生成候选答案,再通过信息交换、相互验证与结果聚合提升最终质量。常见写法有三种:
- 独立聚合(Independent Aggregation):多个 agent 独立生成,最终只聚合答案,典型实现是多数投票或评分选优。
- 多智能体辩论(Multi-Agent Debate):多轮交换推理过程,agent 之间互相批评并据此修正答案。
- 分层混合(Mixture-of-Agents, MoA):按层组织生成与聚合,下一层的模型读取上一层全部输出,逐步整合多个模型的输出。
这三类方案有一个共同特征:它们面向的几乎都是静态任务——数学推理、知识问答、代码生成等“一次性问、一次性答”的问题;交互以文本为主,通常不涉及外部工具调用,也不依赖环境反馈。这一点很关键,因为后面会看到,一旦把工具与环境引入进来,问题就从“怎么聚合答案”变成了“怎么组织依赖与调度资源”。在此之前,先逐个拆解这三种范式。
Mixture-of-Agents:为什么看别人的答案会写得更好
一个被反复验证的现象
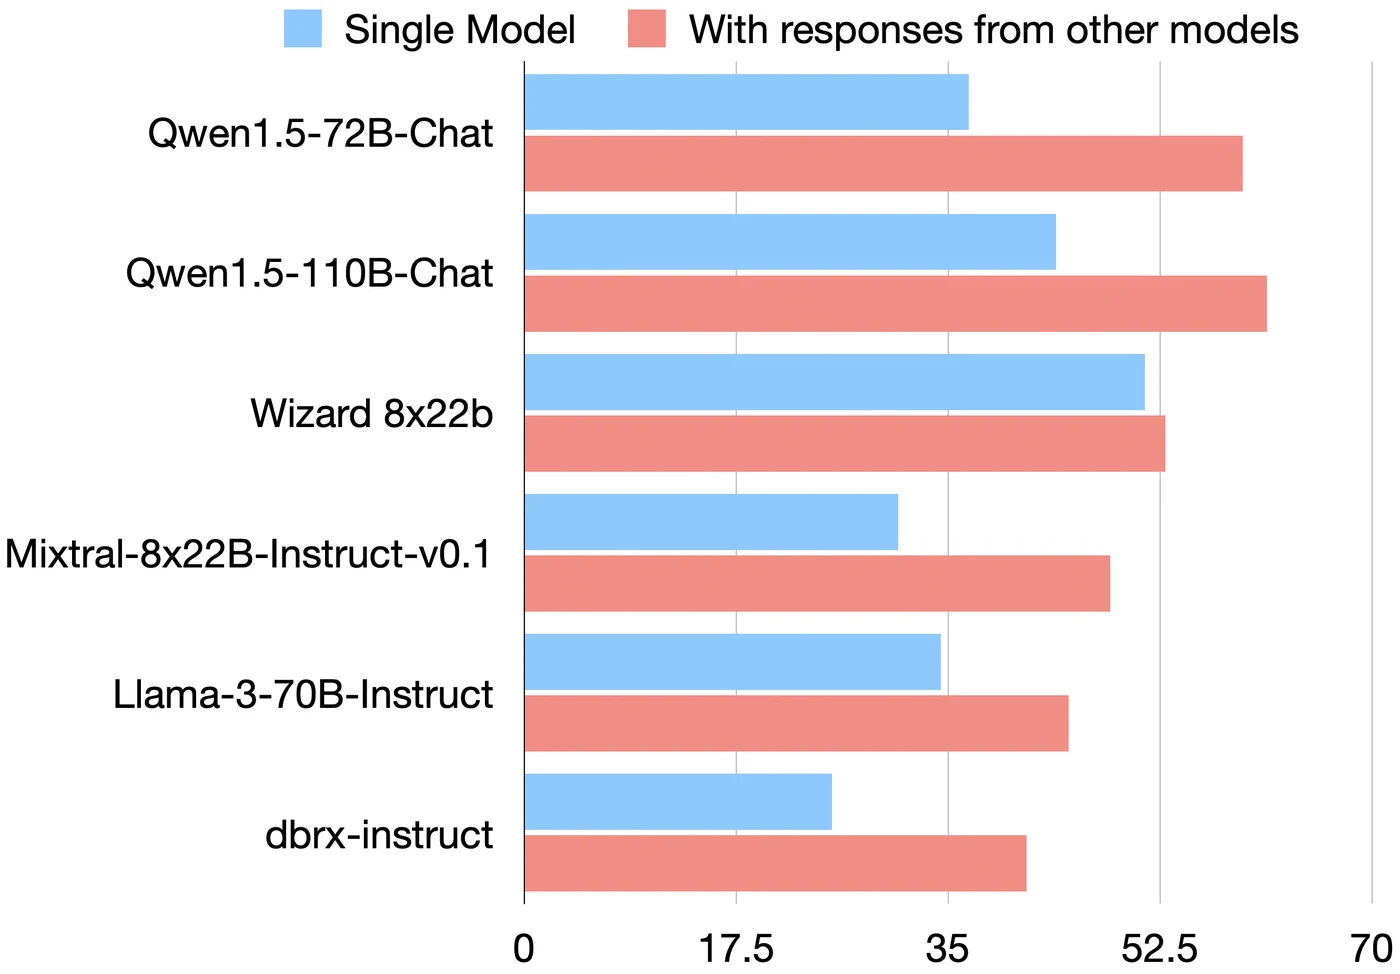
2024 年 6 月,Together AI 团队发表了 Mixture-of-Agents(MoA)1,并在 ICLR 2025 上以 Spotlight 形式出现。这篇工作最核心的观察并不是某个新模型或新训练技巧,而是一个在实验中反复出现的现象:当一个语言模型在生成回答时能看到其他模型的回答,它往往能写出更好的答案,即使那些参考答案本身质量并不高。
这个现象有点反直觉。直觉上,“看别人的答案”会引入噪声,尤其是那些参考答案本身可能有错。但实际发生的是:多层级的协作会把“参考答案”当作一类廉价的、多样化的提示信号——它提供不同视角、不同措辞、不同推理切入点,而聚合模型的任务是从这些信号中挑选并重组出更好的答案。
结构:proposer 与 aggregator 两种角色
MoA 的结构可以拆成两种角色和一层层叠起来的“轮次”。
- proposer(提议者):在一个新的层的开始,每个 proposer 模型都会收到上一层的全部输出(也包括“问题”本身)。它的任务是基于问题与这些参考答案,生成自己的新回答。
- aggregator(聚合者):在层的最后,聚合模型读取上一层所有输出,并把它们整合出一个最终回答。聚合者的质量决定了这一整层的“信息提炼”效果,它是 MoA 的收口。
在实现上,MoA 的结构可以看作一个分层结构:第 1 层由若干 proposer 独立生成;第 2 层中的每个 proposer 读取第 1 层全部输出;这个过程重复若干层;最后一层的输出交给 aggregator。原文中常见的一种配置是 3 层、每层相同的 6 个 proposer,最后一层用一个更强模型(例如 Qwen1.5-110B-Chat)作为 aggregator。
把它写成一个可复用的流程更直观:
输入:问题 q,proposer 集合 P,层数 L,聚合模型 A第 1 层:对每个 p ∈ P,a1_p = p(q)第 k ∈ [2, L] 层: 对每个 p ∈ P,ak_p = p( (q, a(k-1)_p1, a(k-1)_p2, ..., a(k-1)_pn ) )输出:y = A( (q, aL_p1, ..., aL_pn ) )这个流程有一个隐含的结构特性值得注意:每一层的每个 proposer 之间没有依赖,同一层内是完全并行的;层与层之间存在强依赖,必须等上一层全部完成才能进入下一层。换句话说,MoA 天然形成了“同步屏障 + 宽并行”的执行形状。后面讨论服务系统时,这种形状会反复出现。
变体与评测口径
原文还给出两个常见简化版本:
- MoA w/ GPT-4o:最后一层直接使用 GPT-4o 作为 aggregator,其余结构与标准 MoA 一致。
- MoA-Lite:把层数压到 2 层,最后一层使用 Qwen1.5-72B-Chat。它强调的是“更少的推理开销换取尽量大的收益”,是成本敏感场景下的一种典型降配。
评测方面,AlpacaEval 2.0 与 MT-Bench 这两类榜单一律由 GPT-4 充当 judge。这一点对理解 MoA 的适用边界非常重要:这两个基准衡量的主要是“回答是否讨 judge 喜欢”——即是否流畅、是否满足指令、是否信息全面,而并不严格衡量推理任务的正确与否。
这也解释了另一个关键观察:在 SLM-MUX 等工作对推理任务的评测中,MoA 的表现反而可能低于单模型。理由并不神秘:当参考答案里混入了大量错误推理,聚合模型若被要求“综合所有参考答案”,很容易保留错误的中间结论,而多模型一致性投票的纠错能力又依赖于“足够多的正确答案压过错误答案”。在这个意义上,MoA 是一个对强聚合模型依赖很重的方案,它更适合“回答质量”型任务,而不是“答案为对错”型任务。
MoA 的结构性问题与后续改进空间
从系统角度再看一次 MoA,会看到三个结构层面的问题:
- 冗余计算。N 个 agent 对所有问题都执行一次生成,对有些问题(尤其是简单的)是浪费。这就是后续 RouteMoA 要处理的入口。
- 同步屏障。每一层必须等所有 proposer 完成,层数越深尾延迟越长;由于同一个批次里最慢的那个决定了整个屏障,异步性天然很难引入。
- 聚合权重不区分质量。普通 MoA 的聚合者会把参考答案一视同仁地读进去,质量差的答案被当作噪声被“吞掉”。原文中的 aggregator 之所以要选强模型,部分原因就是靠强模型来承担“过滤”这件事。
前两个问题在后文的动态路由和动态编排里都能找到回应;第三个问题本质上是一个“评审(judge)角色”的问题,后面会在 RouteMoA 与 Magentic-One 里以不同形式再次出现。
Multi-Agent Debate:把批评写入下一轮的上下文
来源与定位
多智能体辩论(Multi-Agent Debate)由 Du 等人在 2023 年 5 月提出2,发表于 ICML 2024。如果 MoA 的核心问题是“怎么把多个候选答案聚合成一个好的”,辩论解决的是另一个问题:怎么让多个推理过程互相纠正。
原文对单智能体推理能力的归纳是“容易产生错误的推理步骤和事实幻觉”;他们把已有解决方案分为两类,并指出两类方案各自的不足:
- 自我反思(Self-Reflection):只依赖自身推理,缺乏独立的验证视角。模型很难跳出自洽的推断路径,去质疑自己的前提。
- 独立投票(Independent Voting):只聚合最终答案,无法利用不同模型之间的推理信息。它只能知道“多数答几”,却无法知道“为什么错”。
注意 Independent Voting 的这个短板:在数学推理上,最终答案错误的模型往往在推理路径上就出了偏差,但只有最终答案可用于聚合时,不同模型之间的推理信息不能被互相利用。而辩论把信息粒度从“答案”提升到“推理过程”,这看起来只是一步“多放点上下文”,实际上改变了整个聚合空间:可比较的东西从“答案”变成了“推理链上的中间结论”。
多轮辩论的框架
原文的多轮辩论框架可以拆成四个环节:
- 独立生成(Independent Generation):多个 agent 针对同一问题独立生成答案与推理过程。
- 信息交换(Information Exchange):每一轮,把其他 agent 的回答拼接到当前 agent 的 prompt 中。
- 批评与修正(Critique & Revision):agent 根据其他 agent 的推理信息,重新评估并修正自身答案。
- 迭代辩论(Iterative Debate):重复多轮交互,尝试形成一致的最终答案。
一个很关键的实现细节:辩论可以在完全相同的 LLM 的多个实例之间进行,不需要额外训练,也不需要访问模型内部状态或梯度。这使它在工程上几乎没有门槛——启动多个推理实例、拼接多段上下文即可——但也正是这种“无训练”的特性,使它的瓶颈几乎全部转移到了推理系统上:多个实例、多轮依赖、每轮都要把其他 agent 的输出重新拼接成新的上下文。
主要的实验配置是 3 个 agent + 2 轮辩论。在这个配置下,每轮中每个 agent 的输入包含:原始问题 + 自己上一轮的答案 + 其他两个 agent 上一轮的答案。第 k 轮中输入长度约为 |q| + k * n * |a|,其中 |a| 是一条回答(含推理过程)的 token 数。这个关系是后面 TokenDance 讨论“跨位置缓存”的起点之一。
实验设置与结论
原文的评测任务包括算术题(Arithmetic)、GSM8K、国际象棋推理(Chess Reasoning)、MMLU、人物传记(Biographies)等;对比基线包括单 agent、自我反思、独立多数投票(Independent Majority Voting)。在此配置下,辩论类方法在所测任务上相较独立投票与单模型反思取得了更好的效果。
同时原文也指出,更多的 agent 与更多轮辩论可能进一步提升性能,但推理开销会同步上涨。这个结论听上去温和,但在系统层面的含义其实很硬:这是第一次把“讨论质量”与“推理成本”之间的矛盾摆到台面上——辩论轮数的每次增加,都会叠加一轮“每个 agent 读完整其他人输出”的 prefill 开销。这正好引出下一节更系统的讨论。
三种范式和它们对应的执行形状
把 MoA、辩论、独立投票放在一起看,它们的结构可以整理为下面的对照:
| 维度 | 独立聚合 | Multi-Agent Debate | Mixture-of-Agents |
|---|---|---|---|
| 交换的信息 | 最终答案 | 答案 + 推理过程 | 答案 + 推理过程 |
| 依赖方向 | 无(完全并行) | 轮内并行、轮间同步 | 层内并行、层间同步 |
| 同步次数 | 1 次(聚合点) | 每轮 1 个屏障 | 每层 1 个屏障 + 末尾聚合 |
| 冗余来源 | 所有 agent 都对所有问题作答 | 每轮重复读取完整历史 | 每层重复把全部回答拼进每个 proposer |
| 主要收益来源 | 多样性与投票纠错 | 推理链的交叉批评 | 参考答案对聚合模型的提示作用 |
| 主要适用场景 | 答案可投票的任务 | 推理可分解、可批评的任务 | 回答质量导向的任务 |
这张表的“同步次数”与“冗余来源”两行尤其值得记住。它们是系统侧所有问题的源头:同步屏障决定了请求何时可以进入下一个阶段,冗余决定了每个阶段到底要算多少东西。
从固定拓扑走向动态路由:RouteMoA
固定的代价
前面三种范式都有一个共同假设:拓扑固定——所有 agent 在所有问题上都得作答,层数、agent 数量、聚合方式都是预先写死的。这在评测上省事,在工程上却很不友好:一个简单问题也要跑 6 个 agent、多层聚合;一个难问题却可能因为聚合模型不够强而被“平均掉”关键错误。
2026 年 1 月,RouteMoA3 在 arXiv 上提出了一条更激进但也更现实的路线:为每个问题挑选合适的 agent,而不是让所有 agent 都回答。在这条路线上,MoA 的“层”结构被保留,但每一层里的“谁上场”变成了运行时决策。
这件事的意义远不止“省钱”。一旦每层的参与者取决于“问题本身”和“前一层的表现”,整个 MoA 的执行形状就从一个静态的规则网格变成了一个依赖运行时反馈的流程图:每一层的并行度、每个 agent 的调用次数、总层数都不再是编译期决定的。这就是后文所说的“动态工作流”的雏形。
SLM-based Scorer:把“谁适合这题”学出来
动态路由的第一层问题是:怎么判断某个 agent 适不适合当前问题?RouteMoA 的答案是让一个小的语言模型(SLM)给每个 agent 打一个“适合度分数”,并按分数筛选高潜力模型。
具体做法大致分三步:
- 为每个 agent 构建 embedding 向量:这个向量表征该 agent 在不同类型数据集上的表现。其中的“表现”并不是单一指标,而是两类信号混合的结果——一部分看是否答对(硬指标),一部分看 reward model 的评分(软指标)。这实际上把“准确率”和“输出质量”两类能力都编进了同一个向量里。
- 训练一个 mDeBERTaV3-base 编码器:在问题样本上微调该编码器,使它能把每个问题编码成一个与 agent 表现向量处于同一空间中的表示。
- 用相似度预测表现:计算问题表示与各 agent 表现向量之间的相似度,作为该 agent 在这个问题上的预期得分;让“适合这个问题”的模型得分更高。
这套设计的精神和推荐系统里的“user–item 匹配”几乎一样:agent 是物品,问题是用户,表现向量是物品画像。它并不需要事先运行所有 agent 来判断好坏,属于“先选再跑”,因此在入口处就省掉了大量冗余推理。
一个工程上的附带收益是:Scorer 的推理成本远小于真正的 MoA 执行成本(一个小编码器 vs 多个大模型的多次生成),所以这个“路由判断”可以在预处理阶段独立完成,不参与主流程的同步屏障。
Mixture of Judges:让路由在层间也动态
仅靠“入口打分”只能决定第一层选谁。RouteMoA 把这个思路向下延伸:第一层直接按 scorer 的分数选模型;后续层结合分数与前一层模型的实际表现选模型。这就把“静态偏好”和“即时表现”合并成一个新的评判。
这个“实际表现”来自两种评估:
- self-assessment:每个模型给自己的回答打分。它衡量的是“这个模型对自己的产出有多确信”以及“它对任务的把握感”。
- cross-assessment:由上一层的 top-1 模型对不同模型的回答打分。它相当于一个“评审长”视角,提供了独立于各 agent 自身判断的评价。
两者结合,就把“模型能力先验(scorer)”与“本次运行表现(judge)”组合在一起。原文的描述是“综合模型能力和具体表现,引入了动态性”。从系统的角度看,这种动态性的代价很具体:每层多了一次或多次“评分”型的推理调用,而这些评分调用与主流程是串行依赖的(必须先有答案才能评分),于是每层内部又多出一个细小的同步点。
Model Ranking 与 Early Stopping
在“谁上场”之后,RouteMoA 还决策了“什么时候停”。它把候选模型按三件事排一个综合名次:性能(分数)、token cost 与 latency。这是一个典型的多目标排序——不只是“谁答得好”,还要看“答得好值不值这个成本”。
在此基础上引入 Early Stopping:如果某一层有模型的分数特别高(显著高于其他模型),就不再进入下一层,直接做最终 aggregation。
Early Stopping 是一个在系统层面对 MoA 结构的深刻改动:它让层数成为运行时变量。以前 MoA 的所有执行路径都是“层数 L 固定”,现在同一批请求里,有的请求在第 1 层就结束,有的要走满 L 层。执行图的深度取决于数据,这对推理服务来说是一个不利因素——批处理里混入长短不一的任务会降低 GPU 利用率,而调度器又很难预测每个请求会走多深。这一点会在后面 MAS 服务的部分被反复提及。
实验口径
原文在实验里用了一个重要的对比参照:SMoA——每一层用一个 judge 模型选出该层最高质量的回答,往下传。SMoA 本质上是“固定拓扑 + 每层评审”,是一个把评审规则显式化的基线。RouteMoA 相对它的差别主要在于“选谁上场”与“什么条件下提前结束”这两项动态决策。
需要说明的是,RouteMoA 作为 2026 年 1 月的预印本,其结论仍需要在更多基准上反复验证;但它的思路已经清晰地指向了一个普遍趋势——协作结构正在从固定拓扑向动态路由与自适应执行演化。这一节之后的三节(MetaGPT、Magentic-One)会把这种趋势推得更远。
从这些推理方案里能学到什么
把三条路线并排看,会得到三个相当实用的观察。
第一个观察:多模型协作利用的是不同推理路径的互补性,但并不是 agent 越多越好。MoA 中每个额外 proposer 都带来一次完整生成与一次“被所有后续层阅读”的上下文成本;辩论中每增加一个 agent,其他每个 agent 的上下文都要多拼一份输出。收益是递减的,成本是近似线性甚至超线性的,这个剪刀差是所有后续优化要处理的对象。
第二个观察:协作结构正在从固定拓扑向动态路由与自适应执行演化。固定拓扑(MoA、独立投票)的优点是实现简单、并行度高,缺点是“对简单问题过度计算、对难问题又不够灵活”。动态路由(RouteMoA)把“选谁”和“何时停”交给运行时,代价是引入了额外的评分调用与更复杂的调度形状。到 MetaGPT 与 Magentic-One 时,这种动态性会走得更远:不仅选谁,还要决定“下一步做什么”。
第三个观察:三种范式对应三类不同的执行依赖。独立聚合是“纯并行 + 一次聚合”;MoA 是“层内并行 + 层间屏障”;辩论是“轮内并行 + 轮间屏障 + 多轮累积上下文”。这三类依赖分别对应推理系统里的三种典型压力:宽并行对批处理友好;层间屏障造成尾延迟放大;多轮累积上下文造成每轮都要重新 prefill。换句话说,算法层的拓扑选择实际上在预先决定服务层的瓶颈类型。
最后要认清这些方案的局限,它们同时也是后面 agentic MAS 要解决的问题:
- 效率:重复推理、多轮交互与上下文传递引入额外的 token 成本与延迟。这些成本并不体现在单个 agent 的生成速度上,而是体现在“请求数量 × 上下文长度 × 轮次”的乘积上。
- 泛化:主要面向静态推理任务,缺少工具调用、环境反馈与复杂任务依赖。一旦任务需要“查资料—写代码—运行—读报错—再改”,这些范式里没有“执行”的位置。
- 协作目标:它们的目标始终是“提高一次回答的质量”,而不是“共同完成一个复杂任务”。
从这个意义上说,推理型 MAS 是 MAS 的“前传”。它证明了“多模型协作有收益”,也暴露了“固定拓扑的成本结构不可持续”。接下来要看的,是从“答案协作”走向“任务分工、工具执行与动态工作流”的那一步。
从推理任务到 Agentic 任务:协作对象变了
推理型 MAS 围绕静态问题,通过多模型推理、讨论与聚合生成最终答案。Agentic MAS 面向的是复杂的多步骤任务,引入了工具调用、环境交互与持续反馈。协作目标从“提升单次回答质量”扩展到“共同完成复杂任务”。
这不是同一条曲线上的延伸,而是问题结构的变化。静态推理任务的输入、输出、判定都可以在开始时确定;agentic 任务则是在执行过程中逐步展开的:
- 任务分解(Task Decomposition):把复杂目标拆成多个子任务,交给不同 agent 分工执行。分解粒度与依赖关系直接决定了后续所有调度。
- 动态工作流(Dynamic Workflow):根据执行结果与环境反馈动态调整任务分配和执行路径。任务是“跑起来才知道下一步”的,而不是编译期就固定好的流程图。
- Agent 间通信(Inter-Agent Communication):交换中间结果、工具反馈与共享状态,协调后续执行。这里的通信不只是“读别人的答案”,还包括传递工具输出、错误信息、文件路径、页面状态等结构化与非结构化信息。
由此引出三个核心研究问题,它们正好对应本文后面三层的主题:
- 协作拓扑(Collaboration Topology):agent 应如何组织与协作?是平级全连接、中心编排,还是分层混合?
- 通信机制(Communication Mechanism):agent 之间应该共享哪些信息,又该如何高效传递?共享完整轨迹、压缩摘要、结构化产物,还是隐空间状态?
- 系统效率(System Efficiency):复杂的任务依赖与通信会引入哪些额外开销?这些开销落在上下文长度、token 数量、同步等待,还是 KV Cache 的容量与带宽上?
这三个问题分别对应“结构”、“数据”、“资源”。把它们当作三条正交的轴,后面的所有工作都可以在其中定位。
MetaGPT:把软件团队的 SOP 写进多智能体
动机:自由对话为什么在复杂任务上失灵
早期 MAS 主要依赖自由形式的多轮对话协作。角色之间随便聊、随便问,听起来很灵活,但在复杂任务上会暴露一串结构性问题:
- 信息歧义:自然语言的中间结论没有固定格式,下游 agent 对同一句话的理解可能不同。
- 逻辑不一致:不同 agent 各自维护一份局部上下文,容易产生互相矛盾的假设,且没有人负责“统一口径”。
- 级联幻觉:一个 agent 的错误结论被另一个 agent 当作事实继续推导,错误被放大而非被纠正。
- 缺乏明确角色职责与规范化的中间结果交付:没人知道“这一步应该产出什么”,也没有可检查的交付物。
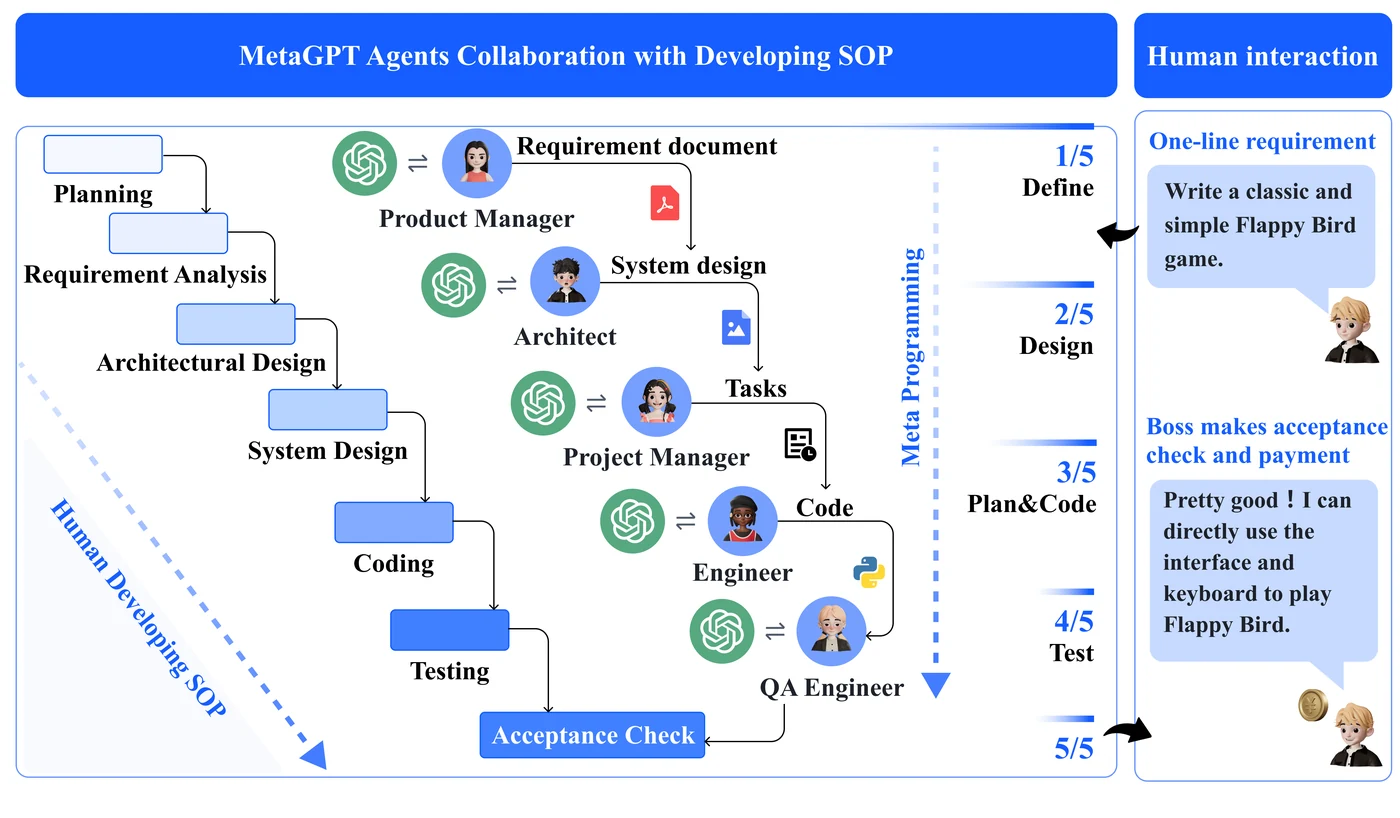
MetaGPT4 的思路很直接:借鉴真实软件开发团队的标准作业程序(Standard Operating Procedures, SOP),把复杂任务拆成由不同专业 agent 完成的子任务,并通过标准化协作流程和结构化输出提升可靠性。这篇工作发表于 ICLR 2024,是“用流程约束语言模型”的代表作之一。
角色分工与工作流
MetaGPT 把一个小型软件公司的角色搬进了 agent 系统:
- Product Manager:需求分析,生成 Product Requirements Document(PRD)。
- Architect:系统设计,生成数据结构、接口和设计文档。
- Project Manager:任务拆解,制定开发计划。
- Engineer / QA Engineer:代码实现、测试与质量检查。
每个角色接收的不是“聊天记录”,而是上游角色的结构化产物:PRD、设计文档、接口定义、任务列表。这个设计的意义在于把“协作”从“自然语言协商”变成了“接口化交付”。下游 agent 的输入不再是模糊的一段话,而是有明确字段与格式的文档。
结构化通信的两条腿
MetaGPT 的通信机制可以拆成三件事:
- Structured Outputs:使用 PRD、设计文档、代码等规范化产物传递信息。产物的格式是预先定义的,因此可以直接被解析、校验、存档,也可以被后续 agent 稳定读取。
- Publish-Subscribe:通过 Shared Message Pool 发布和订阅相关信息。每个 agent 把产物“发布”到共享池,其他角色按需“订阅”。这避免了“全连接广播”带来的上下文爆炸——agent 只读自己订阅的频道。
- Executable Feedback:根据代码执行和测试结果进行迭代修复。这一条把“环境反馈”正式引入了协作闭环:代码能否运行、测试是否通过,成为可验证的信号,而不是另一个模型的主观评价。
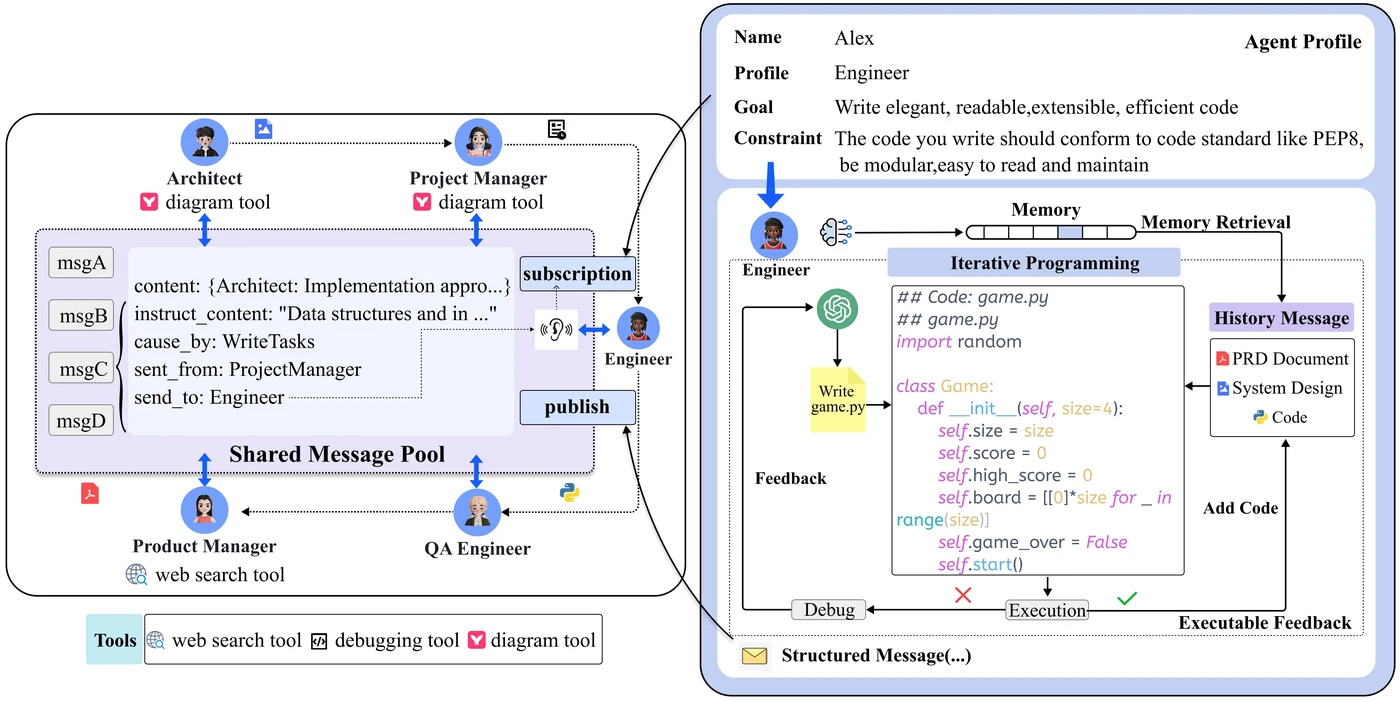
从系统角度看,publish-subscribe 的价值远不止“省 token”。它把一个全连接拓扑改造成了由订阅关系定义的稀疏拓扑。在推理系统里,这等价于把“每个 agent 的上下文都包含全部历史”变成了“每个 agent 的上下文只包含它订阅的片段”。后面在 TokenDance 的分析里会看到,全连接广播会造成“每个 agent 都持有一份几乎相同的共享上下文”,而稀疏订阅天然降低了这种重复存储。
评测与架构意义
MetaGPT 的实验集中在软件开发类任务上,用可执行性、测试通过率与产物完整性等指标来评估。它对后续工作的影响更多在“结构”层面而非“分数”层面:它证明了把流程规范与结构化产物引入 MAS,可以显著提高复杂任务的可执行性。
但它也留下了几个明显的工程问题:
- 流程是固定的。角色与交付物预先定义,遇到流程之外的任务(比如网页操作、跨应用操作)就无法复用。
- 每次交付都要把产物序列化进上下文。结构化产物可以很大,于是“读文档”本身变成了一个昂贵的 prefill。
- 没有真正的动态编排。谁先谁后是 SOP 决定的,而不是运行时反馈决定的。
这三条恰好是 Magentic-One 要回答的问题。
Magentic-One:编排器、双循环与动态工作流
开放式任务带来的新挑战
Magentic-One5 于 2024 年 11 月发布,目标很明确:构建能够处理不同类型开放式任务的通用 MAS(generalist MAS),用具有专门能力的 agent 分工完成复杂任务,并引入一个 Orchestrator 动态规划、监控进展并处理执行失败。
它面对的是三类在真实任务中普遍、但在静态推理基准里不存在的困难:
- 真实任务需要跨越多个步骤,涉及网页、文件、代码等不同工具。每一步的工具不同,执行时间、失败模式、返回数据格式都不同。
- 执行过程中可能产生未知结果、运行错误或任务停滞。
- 预定义的固定执行流程难以适应动态变化的任务状态。
换句话说,问题不再是“多个模型怎么讨论”,而是“一个会跑偏、会卡住、会出错的执行过程怎么被管理”。
Orchestrator–Worker 架构
Magentic-One 的结构是一个很典型的“中心编排 + 专家工人”:
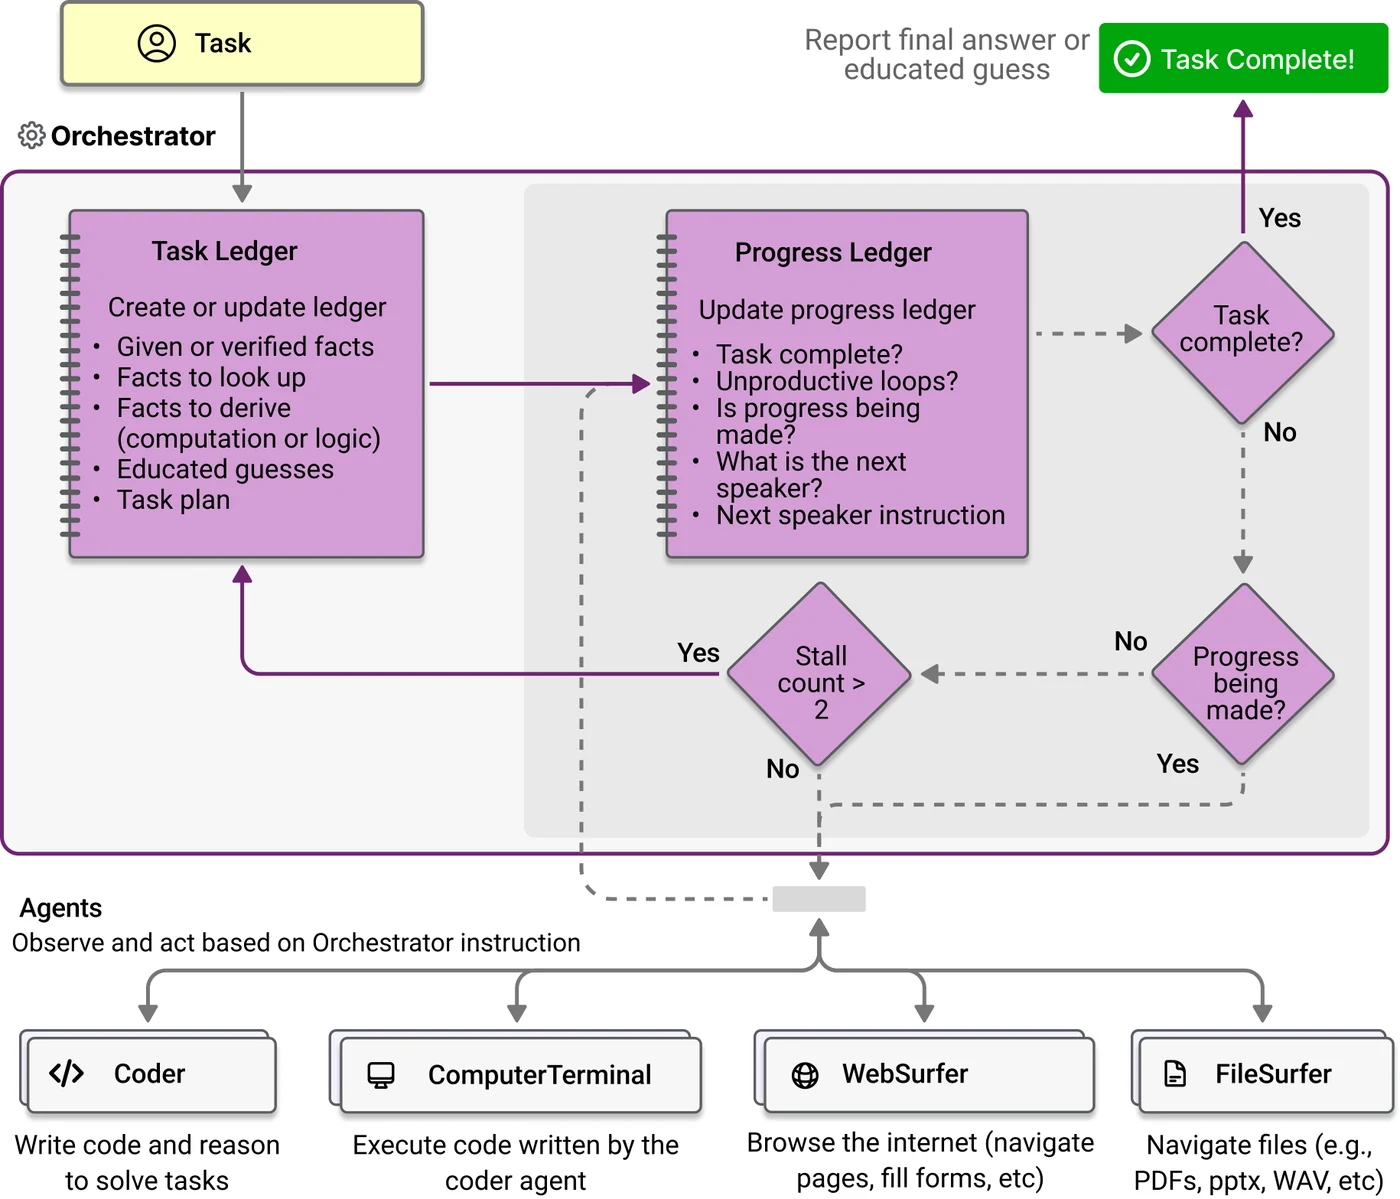
- Orchestrator:负责 Task Planning、Agent Selection 与 Progress Monitoring。它不直接操作工具,而是决定下一步派谁去做。
- WebSurfer:网页浏览、搜索与页面交互。
- FileSurfer:本地文件读取与内容提取。
- Coder:代码生成、数据处理与 Debugging。
- ComputerTerminal:执行代码及 Shell Commands。
协作机制的关键在于执行控制的归属性:Orchestrator 根据当前任务状态选择下一步执行的 agent;专家 agent 通过工具执行子任务并返回观察结果;执行控制集中在 Orchestrator,而不是让所有 agent 自由讨论。
这与 MetaGPT 形成鲜明对比。MetaGPT 的控制流写在 SOP 里,角色按固定顺序接力;Magentic-One 的控制流写在 Orchestrator 的推理里,每一步都由运行时状态决定。前者更像“流水线”,后者更像“项目经理带着团队做项目”。
双循环编排:Task Ledger 与 Progress Ledger
Magentic-One 最值得细看的设计是它的双循环机制。
Outer Loop —— Task Planning。Orchestrator 维护一份 Task Ledger,其中包含已知事实、待查询信息、推测与任务计划。随着执行推进,新的信息会被写入 Task Ledger,计划随之更新。当执行持续停滞时,触发重新规划并重启 Inner Loop。Task Ledger 的功能更像“项目计划书 + 事实清单”,它是跨步骤的、相对持久的。
Inner Loop —— Progress Monitoring。Orchestrator 维护一份 Progress Ledger,评估任务完成情况与当前执行进展,动态选择下一位 agent 并生成具体执行指令,同时识别无效循环与连续停滞,决定是继续执行还是触发 Replanning。Progress Ledger 是短周期的、面向“这一步做得怎么样”的。
这两个 ledger 的分工很像操作系统里的“长期调度”与“短期调度”:Task Ledger 回答“我们要去哪”,Progress Ledger 回答“现在到哪了、下一步干什么”。一个关键的性质是:agent 的调用顺序和调用次数由运行时反馈决定,这就是前文反复提到的动态工作流。
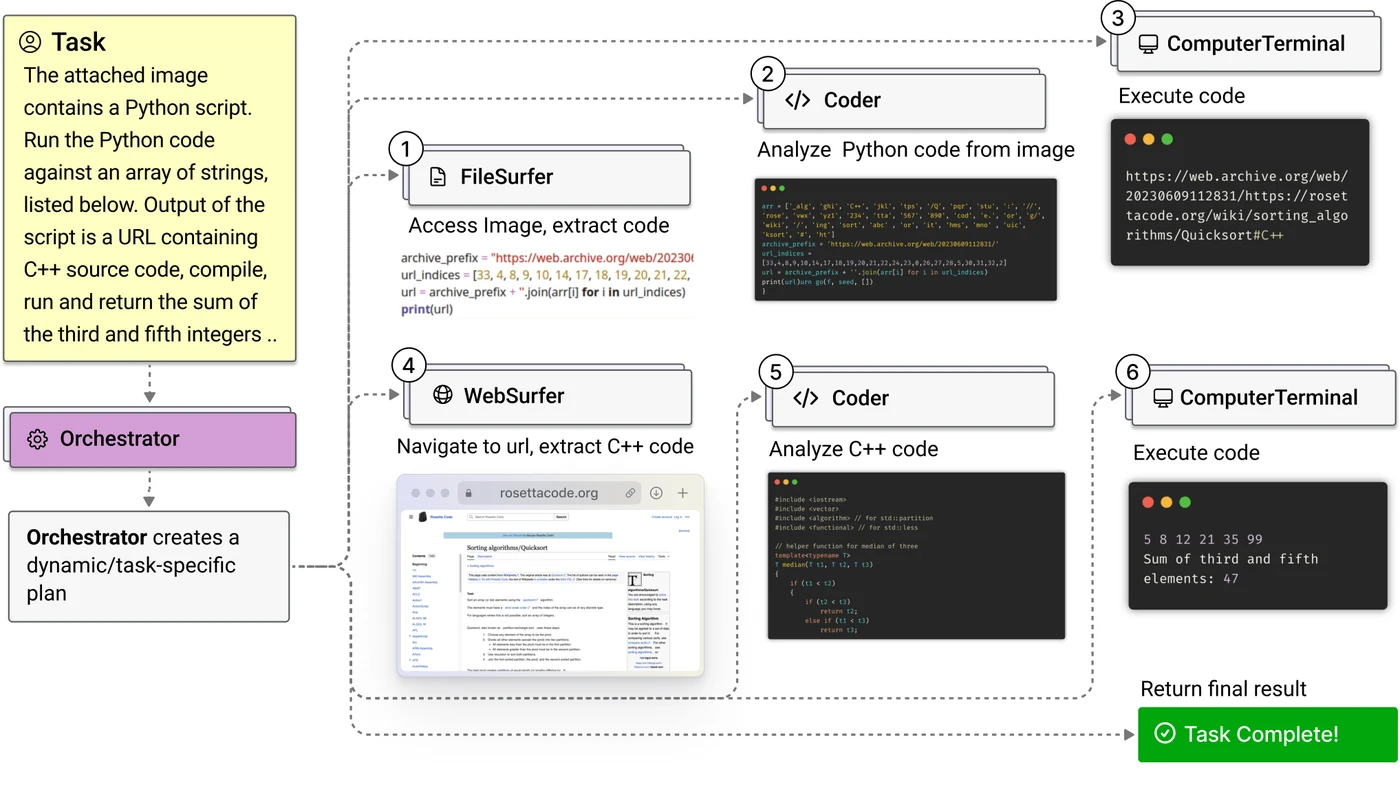
这个设计对服务系统有一层直接含义:请求的到达模式不再是“用户请求到达时产生一批固定请求”,而是“执行过程中按需产生新请求”。Orchestrator 每做一次决策,就产生一次 LLM 调用;每派一个 agent,就产生一次 LLM 调用加若干次工具调用。请求的数量、时间、依赖关系都依赖于运行时的判断结果。这一点会在后文关于 MAS 工作负载特征的一节里展开。
评测设置
Magentic-One 的实验使用 GAIA、AssistantBench、WebArena 三类基准,模型配置为 GPT-4o 或 GPT-4o + o1-preview,基线包括单模型 GPT-4 与各基准上的代表性 agent 系统。这三个基准共同的特点是:任务需要多步操作外部环境,答案必须通过实际操作获得,而不是靠记忆或推理直接给出。正是这种“必须动手”的任务,才能暴露编排与失败恢复的价值。
把 MAS 当作科学问题:架构、任务与缩放的匹配
一个被忽视的评测错位
2025 年 12 月的一篇工作把问题往前推了一步:MAS 应该如何科学地 scaling?它的第一个观察就很尖锐——多 agent 系统经常在不需要 agent 的任务上被测试,例如 GSM8K、MMLU、HumanEval。这些任务本质上是“单步问答”或“单函数生成”,根本不需要任务分解、工具调用或环境交互,用 MAS 去跑只是在给一个静态推理问题叠加冗余调用。
这篇工作把任务重新划了一条线:
- Agentic task:持续的多步环境交互、从环境中获取信息、根据反馈调整策略,例如 web browsing、financial trading、software engineering、planning tasks 等。
- Non-agentic task:上面那些一次性问答/生成类任务。
只有在前者上,MAS 的结构优势(分工、反馈、动态调整)才有发挥空间;在后者上,MAS 往往只是在放大成本。这个区分看似简单,却解释了大量“MAS 在某些榜单上不如单模型”的实验结果。
四种 agent 系统架构
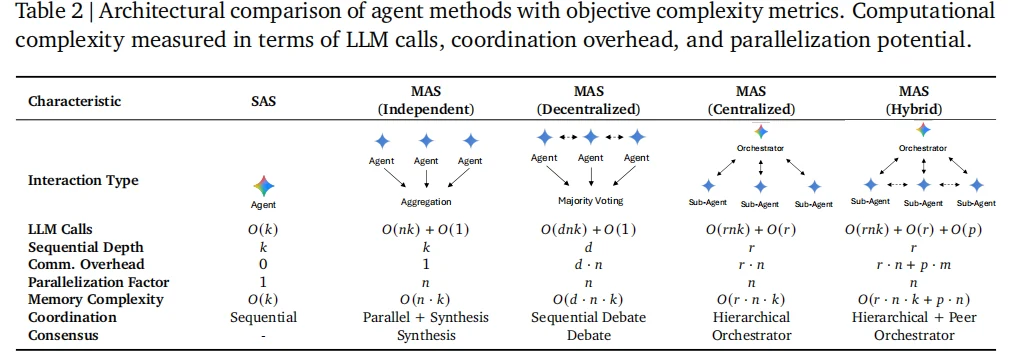
这篇工作把 agent 系统架构整理成一个谱系:
| 架构 | 结构 | 通信 | 典型优势 | 典型代价 |
|---|---|---|---|---|
| Single-Agent System (SAS) | 单 agent 串行执行 | 无 | 开销最低、路径最短 | 无分工、无交叉验证 |
| Independent MAS | 多个 agent 并行探索 + 答案聚合 | 仅在聚合点 | 并行度高、实现简单 | 无中间协同、聚合易丢信息 |
| Centralized MAS | orchestrator 统一调度 | 星型(经 orchestrator) | 控制集中、可监控、易恢复 | orchestrator 成为瓶颈与单点 |
| Decentralized MAS | 所有 agent 彼此 all-to-all 通信(如 MAD) | 全连接 | 信息流通充分、纠错机会多 | 上下文爆炸、同步成本高 |
| Hybrid MAS | 既有 orchestrator,也允许 agent 互相通信 | 混合 | 兼顾控制与灵活性 | 结构复杂、调度与缓存都更难 |
没有万能的架构
这篇工作最值得记住的结论是:不同任务的最优架构不同。它给出的三个典型例子很有代表性:
- Finance:任务可以分解为几个具体的子任务并行探索,Centralized MAS 表现更好。原因是子任务边界清晰、需要统一口径,orchestrator 的集中调度能避免重复探索与结论冲突。
- Web:状态不断变化、搜索空间巨大,Decentralized MAS 表现更好。原因是环境反馈频繁且不确定,平级 agent 之间的即时信息交换比“层层上报”更能适应变化。
- Planning:按步骤进行的任务,SAS 反而更好。原因是任务本身是线性的,引入多 agent 只会增加协调成本,而没有多少可并行的探索空间。
在此之上,这篇工作训练了一个 mixed-effects scaling model 来预测“给定任务特征下哪种架构最优”。这个模型的意义不在于精确预测,而在于提出一种方法论:把“架构选择”当成一个可以用统计模型回答的问题,而不是靠经验拍脑袋。
把这三条结论和前面的技术串起来,会得到一个很重要的判断:MAS 的收益来自“任务结构与协作结构的匹配”,而不是来自“agent 数量”。MoA 在回答质量任务上有效、辩论在可批评的推理任务上有效、Centralized 在可分解任务上有效、Decentralized 在动态环境任务上有效——它们各自的有效域都很清楚,超出有效域就会变成纯粹的开销。
推理型与 Agentic 型 MAS 的关键差别
把前面几节的工作放进同一张表,会看得更清楚。推理型 MAS 与 agentic MAS 的差别不只是“有没有工具”,而是整个系统的约束来源变了:
| 维度 | 推理型 MAS(MoA / Debate / 独立投票) | Agentic MAS(MetaGPT / Magentic-One) |
|---|---|---|
| 任务形态 | 静态问题,一次性输入输出 | 多步任务,输入输出在执行中逐步确定 |
| 拓扑 | 固定(层数、agent 数、聚合方式预先定义) | 固定流程或动态编排,运行时决定下一步 |
| 同步点 | 层 / 轮屏障,数量可预知 | 阶段屏障 + 工具返回 + 条件分支,数量不可预知 |
| 上下文来源 | 主要是其他 agent 的输出 | 其他 agent 输出 + 工具返回 + 环境状态 |
| 主要冗余 | 同一答案被多次生成、同一上下文被多次读取 | 同一上下文被多次读取 + 同一工具被重复调用 + 同一记忆被重复检索 |
| 主要成本项 | 生成 token 数 × agent 数 × 层数 | 请求数 × 上下文长度 × 依赖深度 + 工具等待时间 |
| 失败模式 | 聚合偏向错误答案、讨论陷入自我强化 | 停滞、级联错误、无效循环 |
| 适合的服务优化 | 跨 agent 的 KV 复用、批处理 | KV 生命周期管理、工作流感知调度 |
从这个表里可以提炼出一个对工程很有用的判断:推理型 MAS 的优化重点是“去重”,agentic MAS 的优化重点是“管理生命周期”。前者面对的是“同一份数据被 N 个 agent 同时读”,后者面对的是“同一份数据在不同时间被同一个 agent 反复读写”。TokenDance 属于前者,TokenCake 属于后者,这正是它们互为补充的原因。
通信:MAS 的“总线”与它的三个设计维度
为什么通信是第一个系统性问题
MAS 通过交换中间结果、执行轨迹和共享状态实现 agent 间协作。不同的通信机制决定信息如何传递、复用,以及后续 agent 能够访问哪些上下文。这句话看起来像常识,但它把一个纯算法问题翻译成了系统问题:通信一旦落到具体实现,就会变成上下文长度、token 开销、同步点与数据复用这四个可测量的量。
因此,讨论通信机制时,最有效的拆法不是按“框架”分类,而是按三个设计维度分类。
维度一:通信拓扑——谁和谁通信?
- Direct Peer-to-Peer:agent 之间直接互发消息,没有中心节点。辩论是典型例子,每个 agent 每轮都能读到其他 agent 的输出。
- Manager-Mediated:所有消息经过一个管理者转发与汇总。Magentic-One 的 orchestrator 属于这一类。
- Shared Blackboard:agent 读写一块共享区域,彼此不直接寻址。MetaGPT 的 Shared Message Pool 与各类共享记忆库都属于这一类。
维度二:信息表示——共享什么?
- Full Trajectory:共享完整轨迹(所有轮次、所有工具调用与返回)。信息最全,上下文最长。
- Summarized Context:共享压缩摘要。上下文可控,但有信息损失,且摘要本身要花推理成本。
- Structured Artifacts:共享结构化产物(PRD、接口定义、JSON、文件)。可解析、可校验,但需要预先定义 schema。
- Latent Representations:共享 embedding、hidden state 或 KV Cache。带宽与 token 开销最低,但兼容性与可解释性最差。
维度三:交换方式——怎么访问?
- Message Passing:消息作为独立的上下文片段被显式传递。语义清晰、易于审计,但每次传递都要在下一轮重新 prefill。
- Shared Memory Read & Write:通过共享内存读写。复用性强,但需要处理一致性与生命周期。
这三个维度不是独立的:拓扑决定了消息的扇出与扇入,表示决定了每条消息的长度,交换方式决定了消息是否会被重复计算。它们共同作用于四个系统指标:
| 系统指标 | 被谁放大 | 具体表现 |
|---|---|---|
| Context Length | 信息表示(full trajectory) + 拓扑(全连接) | 每个 agent 的 prompt 随轮次线性或超线性增长 |
| Token Overhead | 表示(未压缩)+ 交换方式(消息重传) | 相同内容被反复编码、反复计费 |
| Synchronization | 拓扑(屏障型) | 最慢 agent 决定整层/整轮的完成时刻 |
| Data Reuse | 交换方式(shared memory)+ 前缀结构 | 相同前缀能否命中缓存,决定 prefill 是否重复 |
文本通信的四种代表实现
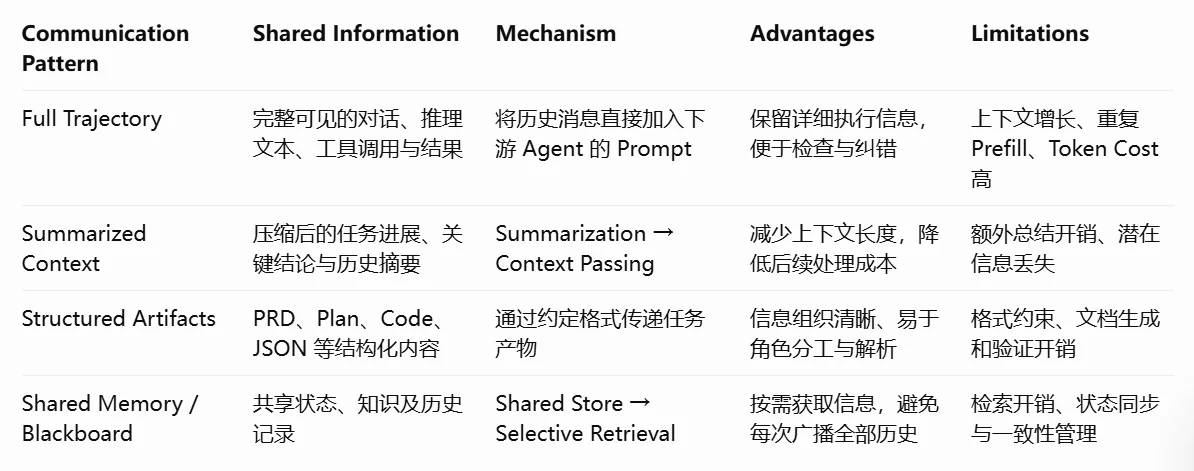
把“信息表示”这一维展开,可以看到四种代表性做法,它们在保真度、token 开销与上下文复用之间做了不同的取舍:
- Full Trajectory:AutoGen、Multi-Agent Debate 这一类。每个 agent 读到完整的对话与推理轨迹。优点是信息不丢失、批评有据可依;缺点是上下文随轮次增长,且大量内容在下一轮会被重复 prefill。
- Summarized Context:MiTa、Memory Summarization 这一类。把历史压缩成摘要再传递。优点是上下文可控;缺点是摘要过程本身要一次 LLM 调用,且摘要可能丢掉关键细节(尤其是错误信息与边界条件)。
- Structured Artifacts:MetaGPT 这一类。用 PRD、设计文档、代码等规范化产物传递。优点是下游可解析、可校验、可执行;缺点是 schema 设计成本高,跨任务复用性差。
- Shared Memory:Memory Sharing for LLM Agents 这一类。把可复用知识放进共享存储,按需检索。优点是复用性强;缺点是一致性、过期与检索质量问题。
这四种做法并不是互斥的,真实系统往往是组合:结构化产物放在共享池里,轨迹用于审计,摘要用于压缩历史,检索用于补充长期知识。
一个容易被忽略的量化:重复 prefill 的比例
考虑一个 all-gather 式的共享上下文结构:每一轮,所有 N 个 agent 都收到一段一模一样的共享上下文(前一轮所有人的输出汇总)。如果共享块长度为 S,私有历史长度为 P_i,那么在理想情况下,这一轮需要计算的 token 总量是:
其中只有 (S) 是重复的。若 (P_i) 相对 (S) 很小(例如每个 agent 只保留一两句私有状态),则重复比例接近:
当 (N) 较大且 (\bar{P} \ll S) 时,这个比例会非常高——系统花了 N 倍的算力去处理同一段内容。这不是一个“可以靠更快的 GPU 解决”的问题,而是一个结构性的冗余。TokenDance 的全部设计,本质上就是在消除这个 (N \times S) 的重复项。
隐空间通信:当文本成为瓶颈
文本通信的三重成本
文本通信之所以成为瓶颈,原因可以拆成三条,而且它们互相叠加:
- 上游必须逐 token 生成消息:即使只是想把一段内部表示“告诉”下游,也必须把它解码成自然语言。解码是自回归的,速度受限于逐 token 采样,而不是矩阵乘法吞吐。
- 下游必须重新 prefill:收到消息后,下游要把它重新编码回内部表示(计算 KV),这段计算与上游已经算过的内容在语义上高度重复,但在数值上无法直接复用。
- 离散化损失:把连续表示离散成 token,会丢失一部分连续空间中的信息。模型内部可能包含“不确定但有方向”的状态,而文本只能表达确定的内容。
这三条合起来,使“通信”成为 MAS 中一个非常特殊的开销项:它既不是纯计算,也不是纯存储,而是“算了两遍、还丢了一点”的过程。
LatentMAS 与共享隐空间工作记忆
隐空间通信(latent communication)的思路是:直接交换 embeddings、hidden states 或 KV Cache,跳过“解码成文本、再编码回表示”的往返。
其中两个代表性设计是:
- LatentMAS:agent 在 hidden state 空间中执行 latent reasoning,避免显式生成中间文本。它把“思考”与“表达”解耦——内部可以连续地推理,只在需要对外输出时才解码。
- Shared Latent Working Memory:通过 layer-wise KV Cache Transfer,把上游 agent 的内部状态传递给下游 agent。这里的关键是“逐层”:不是传递最终输出,而是把每一层的 KV 都交给下游对应层使用。
这两种做法在系统上对应的收益非常直接:省略上游解码与下游 prefill。如果一段共享上下文长 (S) token,文本通信的成本约为“上游生成 (S) 个 token + 下游 prefill (S) 个 token”,而隐空间通信的成本约为“一次 KV 传输”。在带宽足够的前提下,后者的成本可以低一个数量级。
三个必须正视的挑战
隐空间通信不是免费的,它带来三个硬约束:
- 兼容性:不同模型的表示空间、网络结构和层间状态可能不兼容。层数不同、hidden size 不同、RoPE 基频不同,都会让 KV 无法直接对齐。即使是同一个模型的不同实例,如果上下文位置不同,KV 中的位置编码也不一致,必须做重编码。
- 可解释性:隐空间信息难以直接阅读和调试。文本通信的一个巨大优势是“人能看懂、能审计、能写进日志”,而隐空间通信把这一层能力拿掉了。对需要合规与可追溯的系统,这是一个实质性障碍。
- 一致性:共享隐状态意味着多个 agent 共享同一份“内部事实”。一旦上游状态有误,下游没有文本层面的机会去质疑它(因为没有可读的证据),错误会以更隐蔽的方式传播。
这也是为什么隐空间通信在工程上更像是“同一模型族、同一部署、同一上下文结构”内部的一种优化,而不是一个通用的跨模型协议。它更适合做“同一任务的多个 agent 之间共享前缀”这类场景,而不是“不同厂商模型之间的互操作”。
记忆:谁拥有历史,以及历史放在哪
为什么记忆在 MAS 里变成结构问题
多 agent 协作会产生大量中间结果、交互历史与可复用经验。最朴素的做法是“把所有历史都保留在上下文里”,但这会同时造成两个问题:上下文增长与信息冗余。于是记忆管理要回答的核心问题变成了:
谁拥有这份记忆,以及它应该如何跨 agent 共享?
按作用域,可以分成三层:
| 作用域 | 内容 | 生命周期 | 典型风险 |
|---|---|---|---|
| Agent-Local Memory | 单个 agent 的工作状态与专属知识 | 单次任务或单角色 | 视角固化、与其他 agent 不一致 |
| Collaboration Memory | 同一工作流内共享的证据、计划与历史 | 单个工作流 | 并发写冲突、过期信息 |
| Long-Term Memory | 跨任务、跨 session 积累的知识与经验 | 长期 | 陈旧、冲突、检索噪声 |
这三层的边界很重要:越靠近“本地”,记忆越精确但越孤立;越靠近“长期”,记忆越通用但越容易失真。设计记忆系统时,真正的决策是“哪类信息放在哪一层”,而不是“用哪个向量库”。
五种记忆组织方式
把已有的做法按“记忆归属”排列,会得到一条很清晰的谱系。
(1)History-as-Memory:不维护独立存储,直接把历史消息当上下文。
每轮把新的 agent 输出与工具反馈追加到 conversation history;当超过 context window 时,用截断或滑动窗口保留近期信息。它的优点是实现极简、无需 memory manager;缺点是上下文随执行轮数增长,且截断可能丢掉早期的关键决策与中间状态。
从系统角度看,这种方式等价于“把记忆完全放在 KV Cache 里”。它的隐性成本是:每一轮都要为“未被缓存命中的历史”重新 prefill,且当历史被截断时,前面算过的 KV 也被丢弃,形成“算了又扔”的循环。
(2)Agent-Local / Self-Managed Memory:每个 agent 独立维护与自身角色相关的记忆。
不同 agent 保留不同的知识、历史状态与专业视角。Intrinsic Memory Agents 是典型实现,它包含三件事:
- Role-Specific Template:每个 agent 维护角色相关的结构化记忆(例如“我负责验证,我关心哪些检查项”)。
- Local Memory Update:根据自身最新输出与已有记忆更新记忆。
- Context Construction:使用共享的 conversation history 与 agent-local memory 共同构造输入。
它的核心取舍是“记忆跟着 agent 走,从而保留专业视角”。代价是每个 agent 的记忆都要单独维护与更新,且跨 agent 的一致性没有保证。
(3)Shared Memory / Blackboard:记忆属于团队,而不是某个 agent。
不同 agent 把可复用的知识与历史经验存入共享 Memory Pool,后续 agent 根据当前任务检索其他 agent 积累的信息。INMS(Interactive Memory Sharing)是一个完整的实现范式,它包含四个环节:
- Memory Generation:把 agent 交互组织为 prompt–answer pairs。
- Memory Filtering:用 LLM scorer 评估内容质量,筛选值得保留的记忆。
- Shared Memory Pool:高质量记忆进入统一存储,供所有 agent 访问。
- Memory Retrieval:根据当前 query 检索相关记忆,增强后续生成。
这里的“LLM scorer 过滤”值得单独说一句:它实际上是给记忆系统加了一道“写入前的质量控制”。没有这道过滤,共享池会迅速被低质量、重复、互相矛盾的条目淹没,检索质量下降,最终让“共享”变成负资产。
(4)Manager-Controlled Memory:记忆由中心管理者统一维护,并直接参与任务分配。
MiTa(Memory-integrated Task Allocation)是代表:manager–member 分层,manager 负责协调,members 负责局部任务执行;Allocation Module 整合各 agent 的观察与行动建议,统一分配任务;Summary Module 将近期协作历史与任务进展压缩为 episodic memory;Memory-guided Planning 用全局记忆指导后续任务分配,减少协作冲突。
这条路线把“记忆”与“调度”合在了一起:记忆不只是被检索的资料,而是调度决策的输入。优点是不会出现“多个 agent 各自基于不同历史做决策”的混乱;缺点是 manager 成为单点,且压缩摘要会损失局部细节。
(5)Memory Placement:记忆放在哪一层,是一个显式设计决策。
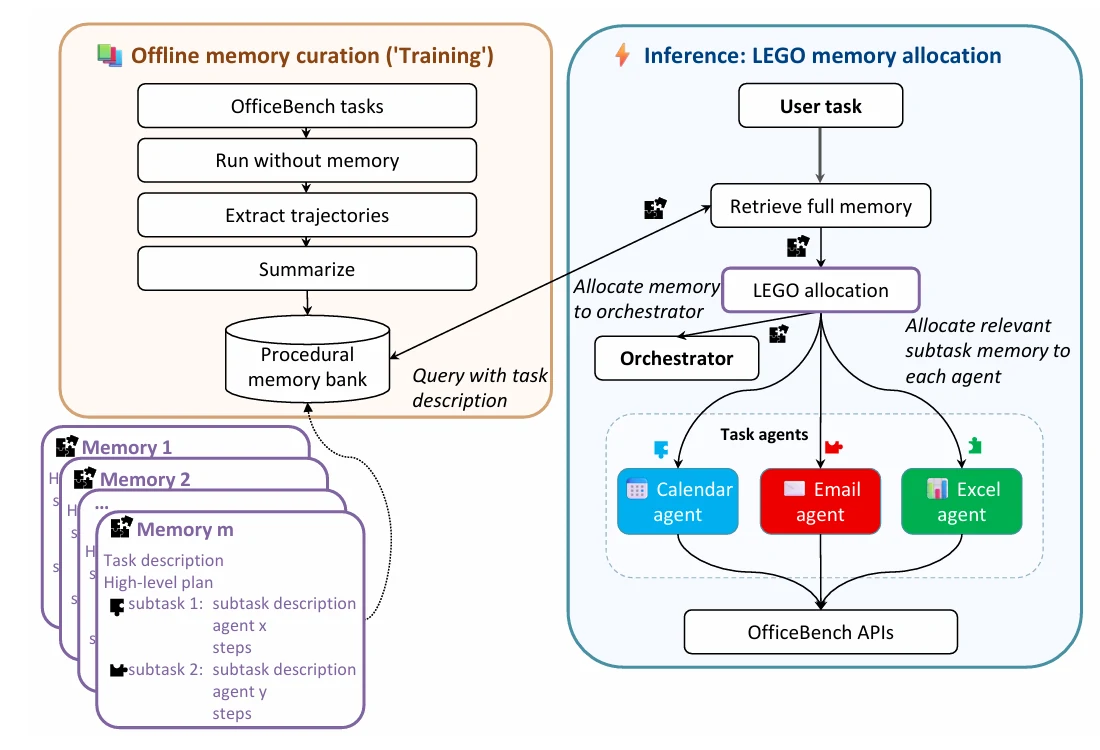
LEGOMem 提出了模块化的程序性记忆(modular procedural memory):
- Memory Extraction:从历史执行轨迹提取可复用的 procedural memory(“这类任务通常怎么做的步骤”)。
- Memory Allocation:将不同粒度的记忆分配给 Orchestrator 或 Task Agents。
- Memory Retrieval:根据完整任务或具体子任务检索相关执行经验。
- Role-aware Reuse:通过不同位置的记忆支持高层规划与局部执行。
这一步的意义在于:它承认了“不同角色需要不同粒度的记忆”。Orchestrator 需要“任务如何拆解、哪些坑要避开”的高层经验;Task Agent 需要“这个工具怎么调、这个 API 返回什么格式”的局部经验。把两者混在一份记忆里,检索时必然互相干扰。
分层与分布式记忆
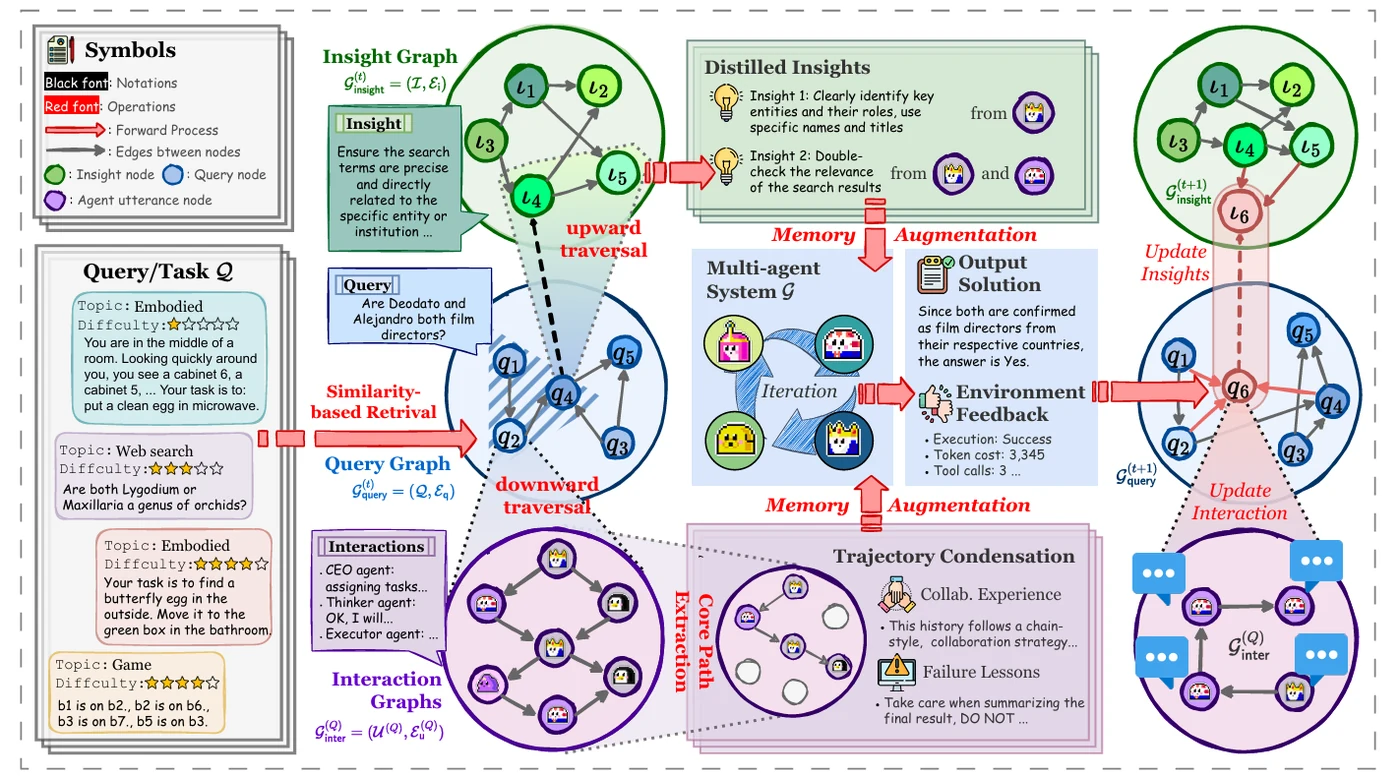
单层记忆难以同时保存细粒度交互与跨任务的高层经验,于是出现了分层结构。G-Memory 是一个有代表性的设计:
- Interaction Graph:记录 agent 之间的细粒度交互与依赖关系。
- Query Graph:组织历史任务及其关联的执行轨迹。
- Insight Graph:从历史任务中抽取可迁移的高层协作经验。
- Hierarchical Retrieval:向上检索 insights,向下获取相关的 interaction trajectories。
- Memory Evolution:根据新任务执行结果更新整个 memory hierarchy。
三层图结构对应三种粒度:interaction 是“谁在什么时候对谁说了什么”,query 是“这个任务当时是怎么解的”,insight 是“这类任务的通用经验”。检索时先向上找经验、再向下找证据,这实际上是一种“先粗后细”的检索策略,能显著降低无关上下文进入 prompt 的概率。
把这条记忆谱系和站内已有的体系结构视角放在一起看,会更清楚:记忆的“作用域”对应缓存层次,“一致性”对应多处理器共享内存的相干性问题,“放置”对应数据在存储层次中的位置选择。这条线索在 Multi-Agent Memory 完全拆解:把 Agent 记忆当成计算机体系结构问题 里有更系统的展开,这里不重复,只强调一个结论:记忆设计的目标不是在“记住更多”,而是在“让正确的信息在正确的时刻出现在正确的 agent 的上下文里”。
MAS 为什么改变了推理服务的负载画像
到这里为止的讨论都还停留在“应用层”:谁和谁协作、共享什么、记住什么。接下来的问题是,这些选择落到推理服务上会变成什么样。答案是:它们会系统性地改变负载的四个基本特征。
特征一:工作流依赖
Agent 请求之间存在数据依赖、同步屏障与动态执行路径。这与传统在线推理有三个本质差别:
- 数据依赖:一个请求的输入里,可能包含另一个请求的输出。调度器不能再把“请求”当作独立单元,而必须处理“请求图”。
- 同步屏障:MoA 的层、辩论的轮、MetaGPT 的阶段,都在天然位置产生屏障。屏障之前的请求必须全部完成,屏障之后的请求才能开始。
- 动态执行路径:Magentic-One 的双循环、RouteMoA 的 early stopping,都让路径长度取决于运行时结果。
这三者叠加,意味着单请求延迟优化不再等价于端到端工作流延迟优化。一个调度器如果把每个请求都当作独立请求来做延迟最优(例如优先调度最长的请求),反而可能让屏障处的等待变长,拉高整个工作流的关键路径。
特征二:工具交互
频繁的工具调用会打断 LLM 推理,形成不规则的执行间歇与请求突发。具体表现为:
- 执行间歇:一个 agent 发起网页搜索,可能等 2 秒到 10 秒不等;发起 shell 命令,可能毫秒级完成,也可能卡在编译上。这段等待期里,该 agent 的 KV Cache 仍然占着显存,但 GPU 上没有对应的计算。
- 请求突发:一个工具返回后,多个下游 agent 可能同时被触发(典型的是 fork–join 中的 join 之后同时启动多个分支),形成一阵请求涌入。
这两点合起来,使 GPU 利用率呈现出“计算段—空洞—突发”的锯齿形,而不是传统在线服务的平稳曲线。传统推理服务里“请求到达服从泊松分布”的假设在 MAS 中不成立——请求到达是由执行进度驱动的,而不是由用户点击驱动的。
特征三:上下文共享
多个 agent 反复交换和读取共享信息,产生大量重复的 context processing。这是本文反复提到的 (N \times S) 冗余在服务层的直接映射:
- 同一段共享上下文,在 N 个 agent 各自的前缀里各出现一次。
- 若前缀缓存命中,重复部分可以被“跳过计算”,但仍需 N 份 KV Cache 存储。
- 若不命中(例如因为位置偏移,后面会展开),则不仅存 N 份,还要算 N 遍。
特征四:负载异构
不同 agent 的调用频率、输入输出长度和 KV Cache 需求差异显著。一个 orchestrator 可能频繁做短调用(“下一步派谁”),一个 researcher 可能长输入长输出,一个 coder 可能长输入短输出,一个 judge 可能短输入短输出。这种异构性让“用同一套批处理策略处理所有请求”变得低效——短请求被长请求拖尾,长请求被短请求打断。
这些特征对应的三个挑战
把四个特征落到系统设计上,就得到 MAS 服务需要回答的三个问题:
-
Workflow-aware Scheduling:单请求延迟优化不一定能最小化端到端 workflow latency。调度需要感知“请求图”和“关键路径”。
-
KV Cache Management:工具等待造成 KV 空闲占用;跨 agent 共享上下文造成缓存冗余。需要一种生命周期管理,把“暂时不用”和“长期重复”区分开。
-
Resource Efficiency:动态依赖和异构负载增加显存管理与资源调度的难度。需要更细粒度的资源隔离与回收。
前两条各自对应一个具体的工程难点,值得展开。
关键路径怎么算。 在一个有 DAG 的工作流里,端到端延迟等于关键路径上各节点耗时之和。假设某个 join 节点 j 需要等待 k 个前驱,那么 j 的开始时刻是:
其中 (t_{\text{queue}}(j)) 是 j 在引擎中排队等待被调度的时长。传统推理服务优化的是所有请求的平均 (t_{\text{queue}}),而 MAS 需要优化的是关键路径上节点的 (t_{\text{queue}})——这两个目标在批处理里经常冲突:把 GPU 让给非关键路径上的长请求,可能抬高关键路径节点的等待,从而拉长整个工作流。
KV 的“空闲占用”与“重算成本”怎么权衡。 一个在工具等待中的 agent,其 KV 有以下几种去处:
| 处置方式 | 显存占用 | 恢复成本 | 适用条件 |
|---|---|---|---|
| 保留在显存 | 高 | 0 | 等待很短,或显存充裕 |
| 卸载到 CPU 内存 | 低 | 一次 PCIe 传输 + RoPE 重编码 | 等待较长,PCIe 带宽充足 |
| 卸载到 SSD / 远端 | 更低 | 更高(多级传输) | 等待很长,显存极度紧张 |
| 直接丢弃 | 0 | 完整重新 prefill | 等待极长,或该上下文可以被廉价重建 |
这四种处置的边界并不是固定的,它取决于“等待时长”与“恢复成本”的比值。TokenCake 的 Scheduling Benefit > Transfer Overhead 判断,本质上就是在做这个权衡,只不过它把“恢复成本”限定在了“传输开销”上,而没把“重编码 / 重新 prefill”算进去。在更完整的模型里,恢复成本应该写成:
其中 (\alpha) 表示“是否保留了位置无关的缓存”。有 PIC 缓存的块只需重编码;没有的块只能重新 prefill。这个公式解释了为什么“位置无关缓存”对 MAS 服务的价值远大于对普通在线服务的价值——在 MAS 里,同一个块会被反复卸载与恢复,重编码成本会被摊薄成很多次。
后文讨论的两个代表性系统分别针对这三个方向:TokenCake 主要回答“KV 什么时候该让位、什么时候该回来”,TokenDance 主要回答“同一段共享上下文怎么只算一次、只存一份”。它们不是竞争关系,而是互补的:前者处理“时间”,后者处理“空间与计算”。
| 系统 | 主要针对 | 核心机制 | 工作流形态 |
|---|---|---|---|
| TokenCake | 时间维度的 KV 生命周期 | 事件驱动的卸载/预取 + 关键路径预留池 | 工具调用频繁、依赖图复杂 |
| TokenDance | 空间与计算维度的跨 agent 复用 | Round-aware 定界符 + collective 复用 + Diff-aware 存储 | all-gather 式共享上下文 |
TokenCake:当工具调用让 KV Cache 闲置
两个典型问题
TokenCake6(2025 年 10 月 arXiv)讨论的是 MAS 系统里 KV Cache 在显存中出现的问题。它把问题归纳为两类,这两类问题都很容易被“只看平均利用率”的监控所掩盖。
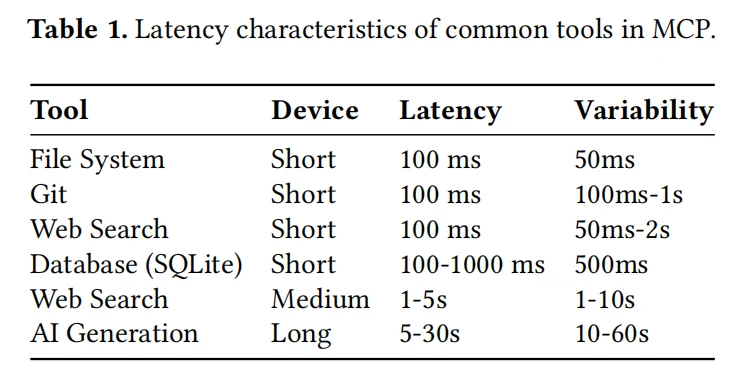
问题一:Time Underutilization(时间维度上的闲置)。工具调用阶段,KV 仍然占据 GPU 显存,但这一段 KV 在这段时间内并不参与计算。一个 agent 在等待网页返回、等待编译完成、等待 API 响应时,它的上下文和 KV 都完整地挂在显存里,但 GPU 上没有为它服务。如果系统里这种等待占了很大比例,显存的有效利用率就会大幅下降。
问题二:Space Contention(空间维度的争用)。显存总量固定,当等待中的 KV 占据了大量块时,正在运行的请求就分不到显存;而显存分配策略又常常导致一个更危险的现象——critical inversion:不重要的 KV 把重要的 KV 驱逐出去。所谓“重要”,指的是处于关键路径上的 KV:它的持有者一返回,立刻就要继续往下推理,而如果它的 KV 已经被换出(或被驱逐),就必须重新 prefill,造成一次昂贵的重算。
这两类问题在传统推理服务里也存在,但 MAS 把它们放大了:工具等待的时间尺度远大于 decode 的一个 token;关键路径的识别需要知道工作流图的结构,而不只是知道“哪个请求先到”。
Time Scheduler:事件驱动的卸载与预测性预取
TokenCake 的第一个核心组件是 Time Scheduler,它处理“哪些 KV 该在工具调用期间让位”。
它的基本判断是 Event-Driven Offload and Predictive Upload:每一次 tool calling,都判断显存上的 KV 是否值得 offload。这里的“值不值得”不是一个直觉判断,而是一个明确的比较:
其中:
- Scheduling Benefit:把这块显存空出来之后,能额外支持 waiting queue 中多少请求继续运行,从而带来多少收益。它本质上是一个“机会成本”的量。
- Transfer Overhead:把暂时用不上的 KV 卸载出去(或之后加载回来)所产生的传输开销。它依赖于块大小、PCIe/P2P 带宽和传输的重叠程度。
这个比较有一个隐含前提:需要预测 tool calling 的耗时。因为如果工具很快就返回,卸载出去再加载回来的开销就是纯亏损;如果工具会等很久,卸载的收益才显著。预测工具耗时是一件比预测 token 生成难得多的事,但它在 MAS 中是可做的——很多工具(检索、编译、文件读取)的历史耗时分布是比较稳定的,可以用统计估计。
从调度理论的角度看,这是一种“基于预期收益的主动让位”策略。它和传统的 LRU 驱逐有本质差别:LRU 是“被动地、等到空间不够时才驱逐最久未用的块”,而这里是在等待发生之前,主动评估“当前持有者何时会再需要这些块”,并把它们挪到更便宜的存储层。前者是无知驱逐,后者是先验驱逐。
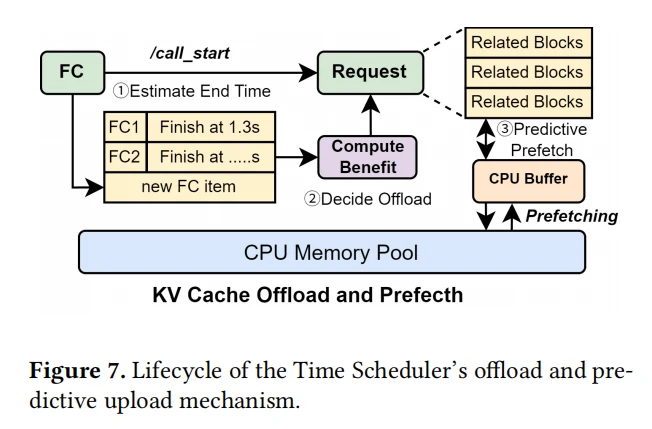
处理传输开销:CPU Block Buffering 与 Gradual GPU Block Reservation
卸载/预取本身会带来新的开销,而 TokenCake 对这部分开销的处理方式很有代表性,因为它揭示了 GPU 与 CPU 两侧的分配行为不对称。
GPU 侧是 Non-bursty 的:随着 token 一个个生成,显存块平稳分配,分配器面对的是稳定的、细粒度的请求流。 CPU 侧是 Bursty 的:KV Cache 一次性被卸载到 CPU,需要一次性分配大量内存,System Memory Allocators 的调度开销很大。
针对 CPU 侧的突发性,TokenCake 采用 CPU Block Buffering:在 GPU 加载 KV 时,CPU 对应内存先不释放,而是用一个 buffer 缓存,防止反复的分配—释放循环。
针对 GPU 侧的容量问题,TokenCake 采用 Gradual GPU Block Reservation:在工具调用快结束时,提前把对应的显存空间分配好,防止加载回 KV 时发现显存不足。
这两条设计在工程上的含义很清楚:“卸载”不是一个单点操作,而是一条跨越 CPU 与 GPU 两侧分配器的流水线。任何一侧的分配器出现抖动(CPU 侧的 burst、GPU 侧的碎片),都会让整条流水线的收益被吃掉。很多“理论上很好”的卸载方案在实践中失败,原因往往就在这里——理论计算只算了带宽,没算分配器。
Space Scheduler:把显存划给关键路径
TokenCake 的第二个核心组件是 Space Scheduler,它解决的是“非关键路径上的 KV 占据大量空间,导致关键路径上的请求等待”的问题。
它的做法是 Dynamic Memory Partitioning:把显存单独划出一个 Reserved Pool,专门供关键路径上的 KV 存储;并根据系统显存压力动态调整 Reserved Pool 的总量。
这个设计的关键不在“预留”,而在“识别关键路径”。要识别关键路径,就必须知道 workflow DAG 中节点的延迟预测——哪个节点的输出会被立即消费,哪个节点处于长链的末端。这与 Time Scheduler 中对工具耗时的预测是同一个能力:MAS 服务需要一张“工作流图 + 时序模型”的预判机制。
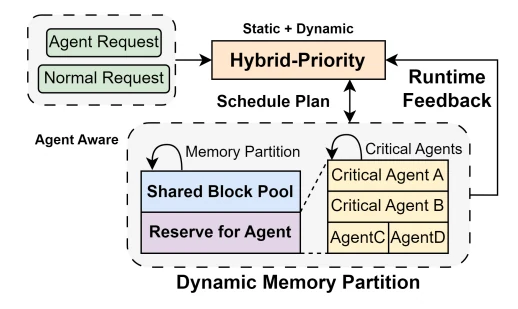
把两类调度放在一起看,TokenCake 的核心思想可以概括成一句话:KV Cache 的价值不等于它的年龄,而等于“它离下一次被需要有多近,以及它在关键路径上的位置”。传统推理引擎里的 LRU 只看年龄;MAS 服务必须看“位置”。
实现与评测
TokenCake 的实现有一个值得注意的细节:它基于 vLLM 框架,并且自行编写 Triton kernel 用于异步数据传输。这说明“卸载”这件事不是靠把数据丢给某个通用 API 就能做好的——它需要与控制路径异步、与计算重叠,这正是自定义 kernel 的用武之地。
另一个实现细节是 API 层的扩展:它扩展了 OpenAI 的 Chat Completion API,使得模型调用能够看到上下文,无需手动管理上下文状态。这一点对 MAS 非常重要:在标准 API 里,客户端每次都要把完整历史重新发送,服务端只能靠前缀匹配去命中缓存;而一段“服务端知道谁是谁”的会话,才有可能把跨轮次的上下文与 KV 关联起来。
评测配置如下:
- 模型与硬件:Qwen2.5-14B on NVIDIA A100(80GB)、Qwen2.5-32B on NVIDIA H200(140GB)。
- 工作流:Code-Writer 与 Deep Research 两类。
- 工作负载:基于 ShareGPT 与 AgentCode 合成用户请求;使用泊松分布生成请求到达时间,模拟动态用户环境,并通过调整每秒请求数(RPS)测试不同负载下的表现。
- 工具调用:采用仿真评估的方式。这一选择有明确理由——工具调用受网速影响很大,真实调用无法确保评估的公平性,因此用可控的仿真延迟替代。
其中“泊松分布生成请求到达时间”这一点值得留意:它模拟的是“用户请求”的到达过程,而不是“agent 请求”的到达过程。后者由前者的执行进度决定,本身就是一个复杂的、由工作流结构塑造的过程。这也正是后续 MAServeBench 要提供一个可控工作负载的原因。
TokenDance:all-gather 结构下的跨智能体 KV 复用
all-gather 式通信的三个缺陷
TokenDance 讨论的是另一类 MAS 通信结构:现有的多智能体框架中,通信经常依赖 all-gather 形式的广播——每一轮,所有 agent 都会接收一段一模一样的共享上下文(前一轮所有人的输出汇总)。
这种结构在实现上最简单(一轮所有 agent 读同一个池),但它对现代推理引擎造成三个致命问题:
(1)前缀缓存(vLLM Prefix Caching)失效。因为每个 agent 的私有历史长度不同,共享输出在后面拼接时所在的绝对位置就不同了。前缀缓存的哈希是按“从序列开头开始的连续前缀”计算的,一旦共享块前面的前缀不同,后面的共享块就无法命中。
这里的机制值得细写。前缀缓存的基本原理是:对一个请求的 token 序列,按块(通常 16 个 token 一块)计算哈希,哈希值连同块内 token 内容一起构成 key,只要某个块之前的全部内容完全一致,这个块的 KV 就可以直接复用。问题出在“之前的全部内容完全一致”这个条件上:如果 agent A 的私有历史是 100 token,agent B 的私有历史是 130 token,那么它们后面那段共享块(内容完全相同)的哈希前缀就不同,A 的块和 B 的块计算出的哈希值不同,于是共享块无法互相复用。
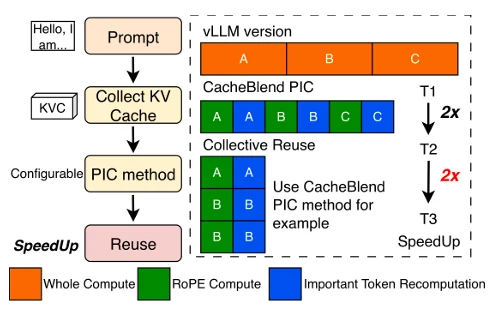
(2)跨位置缓存(CacheBlend 等 PIC 方法)能解决位置偏移,但它们是按单个请求处理的。如果有 10 个 agent,系统要对完全相同的上下文做 10 遍 RoPE 位置重编码,做 10 遍 Diff 比对。也就是说,“位置问题被解决了,但重复计算被放大了 10 倍”。
这里的“PIC”指的是位置无关缓存(Position-Independent Caching)类方法。其思路是:把缓存的 KV 存成“去位置编码”的形式,复用时按当前请求的实际位置重新施加 RoPE。这在单请求场景下是好的——一次重编码换来的是一次完整的 prefill 跳过。但在 N 个 agent 共享同一块的场景下,同一段块被重编码 N 次,重编码成本虽然低于完整 prefill,仍然与 N 成正比。
(3)存储爆炸。虽然 90% 的内容一样,但系统在显存里存了 N 份完整的 KV Cache。即使计算被省掉了,存储也不会被省掉:每个 agent 的私有前缀不同,KV 不能简单地共享指针;共享块在各自请求中的位置不同,KV 数值也不同。
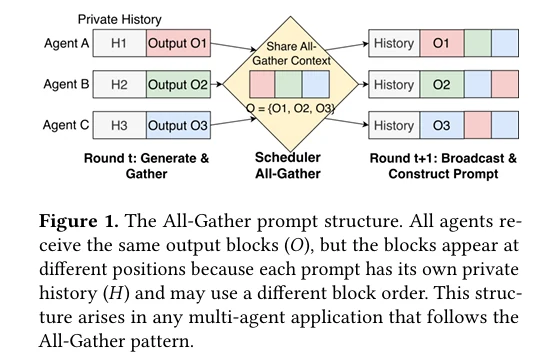
把三个缺陷放在一起看,会发现它们有一个共同根源:前缀缓存把“序列”当作唯一的结构单元,而 MAS 的上下文实际上是“块拼起来的”。一段共享块在语义上是独立的,但在前缀缓存看来,它只是“某个长序列中间的一段”。结构信息丢失了,于是所有优化只能退回到“按整条序列处理”。
Round-Aware Prompt Interface:把结构信息还给缓存系统
TokenDance 的第一个设计是 Round-Aware Prompt Interface:在组装 prompt 时,在私有历史与共享块之间插入特殊定界符 <TTSEP>,并把哈希表从“基于前缀的绝对位置”改为“基于 segment 的独立哈希”,使得系统能看懂哪些块是共享的。
这一步的改动看似微小,但它把“序列”拆成了“段”:每段有自己的哈希,段与段之间的拼接关系被显式记录。于是:
- 同一段共享块,无论被拼在哪个位置,其哈希都相同,可以被识别为“同一段”。
- 不同 agent 前缀长度的差异不再破坏段级匹配——系统不需要“从头开始前缀完全一致”才能命中,只需要“这一段本身相同”。
- 定界符同时给推理引擎与上游框架提供了一个明确的边界,两边可以对齐“段的语义”。
从接口设计的角度看,这其实是把一个“隐含在自然语言里的结构”显式化了。MAS 框架本来就知道“这段是共享的、那段是私有的”,但它组装成字符串之后,这个信息就消失了;推理引擎只能看到一个扁平的 token 序列。<TTSEP> 的作用就是把这个信息从框架传给引擎。
Collective KV Cache Reuse:只重编码一次
有了段级结构,第二个设计就顺理成章:Collective KV Cache Reuse。调度器将同一个回合内的 N 个 agent 组成一个 batch,提取它们的共享块,只执行一次 Batched RoPE,只执行一次 Batched Diff 比对。
这一步把前面提到的“N 遍重编码、N 遍 Diff”压缩成了“1 遍”。从成本模型上看,重编码成本从 (N \cdot C_{\text{rope}}) 降到 (C_{\text{rope}});Diff 比对成本从 (N \cdot C_{\text{diff}}) 降到 (C_{\text{diff}})。在 N 较大的场景下,这是一次数量级的下降。
“Batched”这个词也很关键:它不是把 N 个请求串行处理,而是把它们的共享块合并成一个 batch 做一次 kernel 调用。这既利用了 GPU 的宽并行,也避免了 N 个小 kernel 的启动开销。
Diff-Aware Storage:Master–Mirror 架构
第三个设计解决存储爆炸:Diff-Aware Storage 采用 Master–Mirror(主从)架构。
- 对于极度相似的 N 个 Cache,选出一个偏差最小的作为 Master(全量密集存储)。
- 剩下的 N−1 个请求作为 Mirror,只存一个指向 Master 的指针和极小的 Diff 数据块。
这里的“偏差最小”是一个具体的选择准则:既然共享块在语义上相同,但经过 RoPE 后在不同位置上的数值不同,那么各 agent 的 KV 与“去位置”后的基准值的差异大小不同。选差异最小的作为 Master,可以让其余 Mirror 的 diff 尽量小,从而让后续恢复的修正量最小。
这个设计在存储上的收益非常直接:从 N 份完整缓存变成 1 份完整缓存 + (N−1) 份小 diff,存储占用从 (N \cdot S) 降到 (S + \sum_i d_i)((d_i) 为第 i 个 mirror 的 diff 大小)。
Fused Diff Restore:把修正融进传输管线
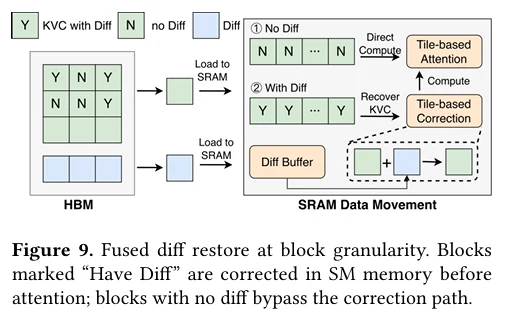
有 Master 与 diff,第四个问题就是“怎么还原”。TokenDance 的 Fused Diff Restore 在 KV Cache 的分层传输过程中,通过 CUDA kernel 对存在 diff 的块进行原地修正:
- 无差异的 Block 跳过修正,同时完成 RoPE Recovery 与 Paged KV 写回。
- 将 Diff Correction 融合到 KV Transfer Pipeline,避免额外构造完整的 Dense Mirror。
这条设计的工程含义有三层:
- “跳过”本身是收益。如果共享块大部分相同,那么大部分块不需要修正,kernel 可以直接写回。这与稀疏更新 kernel 的思路一致:只处理非零元素。
- “融合”避免了额外的拷贝。如果先构造一个完整的镜像 KV 再写回,就要多一次全量内存读写;融合之后,diff 修正直接发生在从存储层到显存的传输过程中。
- 它与 RoPE Recovery 共享同一条管线。位置恢复与 diff 修正在语义上是两件事,但都需要在“块进入显存前”完成,融合在一起能省一次访存。
评测口径
TokenDance 的对比基线是 vLLM(前缀缓存) 与 CacheBlend(目前最强的单请求跨位置复用系统)。这个对照很有说明性:它同时验证了“结构感知比纯前缀匹配好”和“批量集体处理比逐请求处理好”。
测试集选了两类具有代表性的 MAS 工作负载:
- GenerativeAgents(斯坦福小镇类社会模拟):私有历史较短。这类负载里共享块占比高,集体复用的收益明显。
- AgentSociety(清华社会模拟):私有历史极长。这类负载里私有前缀占据了大部分上下文,共享块的绝对占比下降,但绝对长度仍然很大,存储爆炸与重复 prefill 的绝对成本更高。
两个数据集的对比实际上覆盖了 MAS 共享上下文的两种极端形态:一种是“共享为主、私有为辅”,另一种是“私有为主、但共享块本身巨大”。TokenDance 的设计对这两种都适用,因为它们共同的痛点都是“重复”。
TokenCake 与 TokenDance 的组合视角
把两个系统放在一起,会发现它们解决的是同一组资源的两个维度:
| TokenCake | TokenDance | |
|---|---|---|
| 解决的问题 | KV 在时间上的闲置与关键路径争用 | KV 在空间与计算上的重复 |
| 资源视角 | 显存作为“时间资源” | 显存作为“存储资源” |
| 核心假设 | 工作流 DAG 已知或可预测 | all-gather 共享结构 |
| 关键机制 | 卸载/预取 + 关键路径预留 | 段级哈希 + 集体复用 + diff 存储 |
| 若两者合并 | 关键路径上的块可以同时被“去重”与“保位” | 需要统一的块级元数据 |
实际上,这两个机制如果要同时生效,就需要一个统一的块级元数据层:一个块既要能被识别为“与某段共享块等价”(TokenDance 需要),又要带有“最近需要 / 是否关键路径”的标签(TokenCake 需要)。这种统一元数据层的必要性,正是后面硬件基准工作的出发点之一——只有把“块的语义、位置与生命周期”都显式化,才能做跨层的资源决策。
MAServeBench:为加速器研究重建 MAS 负载
为什么现有评测不够用
前面讨论的两个系统都在优化“某一个具体机制”。但做硬件的人会问一个更基本的问题:这些 MAS 负载到底对硬件提出了什么要求? 现有的评测方式回答不了这个问题,原因有三条:
- Application-specific Workloads:现有负载都绑定在具体应用上(某个编码 agent、某个社会模拟),不同系统的结果无法隔离“协作机制”这一变量。你无法判断性能差异是来自“用了 decentralized 拓扑”还是“用了更长的 prompt”。
- Request-level Metrics:请求数量、token 长度、端到端延迟这类指标,难以反映完整的依赖结构。两个工作流可以有相同的请求数和 token 总数,但一个有大量同步屏障、另一个几乎全并行,硬件压力截然不同。
- Limited Hardware Attribution:任务延迟无法直接解释底层计算、存储与资源瓶颈。延迟高了 20%,是因为 GEMM 效率低、访存带宽不够,还是因为调度导致 GPU 空转?从任务层看不到。
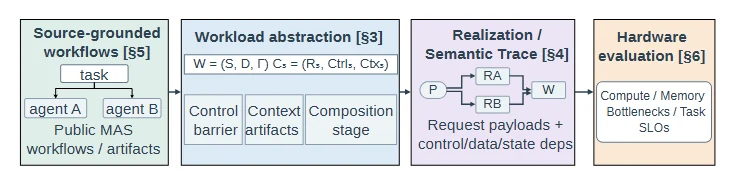
MAServeBench 的动机正是:用可控的 MAS 工作负载,把“协作语义”与“硬件资源需求”连接起来。它的定位不是“再做一个 agent 评测榜”,而是“面向 AI 加速器研究的 MAS serving benchmark”。
四条设计需求
MAServeBench 提出了四条设计需求,它们实际上定义了一个“可做硬件归因的负载生成器”的规格:
- Representative Workloads:协作行为必须来源于已有 MAS 框架与真实应用,而不是凭空构造的合成流程。否则测出来的数字没有代表性。
- Controllable Variables:要能显式控制参与者、执行依赖和上下文构造方式。只有控制住这些变量,才能做消融、才能把性能差异归因到具体机制。
- Reproducible Execution:记录实际模型工作与依赖,支持跨系统对比。同一份 trace 在不同硬件、不同推理引擎上重放,得到的结果才可比。
- Hardware Attribution:通过执行形状与设备指标定位性能代价。需要把请求映射到具体的 batch、kernel shape、内存访问模式上。
可复用的协作模板
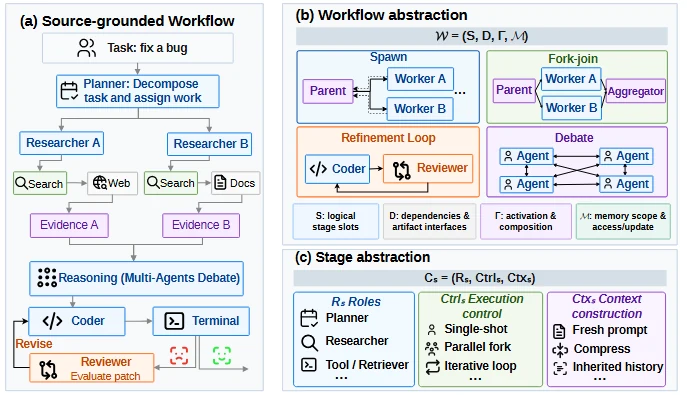
MAServeBench 的核心抽象是“协作模板”。它从真实 MAS 工作流中提炼出四种反复出现的协作行为:
- Spawn:父 agent 按需激活子 agent,并接收执行结果。它的形状是“一个请求在运行中派生出一个新请求”,依赖是父子关系。
- Fork–Join:多个分支并行执行,在同步点聚合结果。它的形状是“宽并行 + 屏障”,是 MoA 层、辩论轮、并行搜索的共同结构。
- Refinement Loop:根据评估反馈重复修改中间结果。它的形状是“串行迭代 + 条件退出”,对应代码修复、写作润色这类任务。
- Debate:多个 agent 多轮交换观点并更新回答。它的形状是“轮内并行 + 轮间屏障 + 上下文累积”。
这四种模板之所以重要,是因为它们把“协作语义”变成了“执行图的基本构件”。任何复杂 MAS 工作流都可以由这四种模板组合而成,就像任何程序都可以由顺序、分支、循环、并行组合而成一样。
在此基础上,MAServeBench 定义了一个统一的 Stage Abstraction,每个 stage 由三部分组成:
- Participants:哪些 agent 参与执行。
- Execution Control:并行、同步、迭代和终止规则。
- Context Construction:继承历史、共享结果及信息压缩方式。
并通过 Hierarchical Composition 把基础模板组合为复杂的端到端 MAS workflows。这个三层结构(模板 → stage → workflow)是它能够同时做到“可控”与“代表性”的关键:模板保证代表性,stage 参数保证可控性,组合保证覆盖度。
分层语义 trace
仅有模板还不够,因为“同一个模板在不同上下文构造方式下,硬件压力完全不同”。因此 MAServeBench 设计了一套分层语义 trace,按 Task → Stage → Session → Operation 记录完整工作流的执行层级:
- Task:用户级任务,对应一个端到端目标。
- Stage:协作阶段,对应一个模板实例(一次 fork–join、一次 refinement 循环)。
- Session:一次 agent 会话,对应一段连续的上下文。
- Operation:一次具体的 LLM 调用或工具调用。
每一层都记录实际 LLM / Tool Operations、输入输出、Token Work 和外部等待,并保留三类依赖:
- Control Dependencies:谁必须在谁之前完成(屏障、条件分支)。
- Data Dependencies:谁的输出是谁的输入。
- State Dependencies:谁读写了同一份共享状态(记忆、文件、工作区)。
这三类依赖的区分很实用:control 决定调度顺序,data 决定上下文构造,state 决定缓存与一致性。硬件归因需要三者结合,才能解释“为什么这个 stage 的 GPU 利用率低”。
可复现执行:两种模式
MAServeBench 提供两种执行模式,对应两类不同的研究问题:
- Native Execution:保留真实协作产生的动态执行和实际工作量。它适合回答“这个真实工作流在硬件上表现如何”。
- Fixed-work Replay:固定请求输入、输出工作量与依赖,隔离特定机制。它适合回答“如果把拓扑从 centralized 换成 decentralized,硬件压力会怎么变”——因为其他变量被固定住了。
在两种模式下,Serving Backend 自主决定 Admission、Batching、Scheduling 和 KV Management。这一点很重要:benchmark 不应该替推理引擎做调度决策,否则测出来的就是 benchmark 的调度器,而不是被测系统的能力。
最后是 Hardware Measurement:将请求执行与实际 Batch、Kernel Shape、Memory Activity 和 Task SLO 关联。只有把“请求”映射到“kernel 与访存”,才能做真正的硬件归因。
负载覆盖与执行验证
在覆盖度上,MAServeBench 从软件开发、科研、金融分析等领域的 12 个已有 MAS workflows 中提取协作行为,验证 Spawn、Fork–Join、Refinement、Debate 等模板的代表性,并用模板组合覆盖不同的执行控制与上下文传递方式。同时,它会对比“组合复现出来的表示形式”与“原始 workload 在相同 task 上的任务完成率”,以确认复现没有改变任务语义。
执行验证分两层:
- 检查实际 LLM Inputs / Outputs 与记录的 Trace 是否一致,验证 Control Dependencies 和请求释放顺序。
- 将任务功能一致性与执行语义一致性分开评估。前者问“任务是否还能完成”,后者问“执行路径是否还和记录的一样”。
这个区分抓住了 benchmark 复现的一个常见陷阱:一个复现可能“任务还能做对”,但执行路径已经完全不同(比如多做了几次重试),此时用它来比较硬件性能就会得出错误结论。
六组评测问题
MAServeBench 的评测计划可以整理成六组问题,它们构成了一条从“负载形状”到“架构启示”的完整链路:
6.1 Experimental Setup:统一 MAS 工作流、用户到达、硬件平台与 Profiling 协议,建立跨工作流、跨架构的可复现评测基础。
6.2 Collaboration Reshapes Serving Workloads:对比不同用户并发下 MAS 与普通 serving 的动态算术强度、活跃模型状态及执行波动。目标是揭示 MAS 协作产生的独特计算与存储需求,以及高并发能否平滑这些差异。这一组问题直接对应本文第 14 节的分析:MAS 的请求到达不是泊松的,算术强度会随 stage 剧烈波动。
6.3 Compute Demands & Architecture Sensitivity:分析实际 Batch、GEMM、Attention、Recurrent、Vector/Auxiliary 算子组成与执行效率;对比 A800 → Pro5000 的计算路径及效率变化,以及 910C → 950DT 上 SIMD/SIMT 对不规则辅助计算的影响。目标是定位计算侧的主要性能限制,分析新架构是否缓解或转移了这些限制。
6.4 Memory Demands & Architecture Sensitivity:分析 Context/State 容量、Attention 访问、HBM/L2 流量及状态生命周期;对比 A800 → Pro5000 的存储层次与访问效率,以及 910C → 950DT 的访问粒度、带宽和状态容量影响。目标是区分“容量不够”“数据供给不够”“访存效率不够”这三类不同性质的限制,并提出 Memory Hierarchy 设计启示。
6.5 Stage-Level Resource Interference:让七种 MAS 工作流独立运行,再让它们混跑(MIX7),比较各 Stage 时延、实际 Batch、计算/访存活动与任务 SLO。目标是识别哪些协作阶段受到干扰,并把损失关联到真实硬件执行或调度资源。
6.6 Hardware Architecture Implications:综合 Compute、Memory、Interference 的跨平台发现,总结面向 MAS Serving 的计算灵活性、存储层次和资源协同设计需求。
这六组问题合起来,实际上是在回答一个此前很少被系统回答的问题:MAS 的协作结构,应该怎样映射到加速器的设计参数上? 例如,如果 6.5 发现 Debate 阶段的屏障会让 GPU 频繁空转,那么加速器可能需要更强的细粒度调度与更快的上下文切换;如果 6.4 发现 Actor 类负载的 state 容量是主要限制,那么 HBM 容量与层次结构就比峰值算力更重要。
回到整条栈:五个可以带走的设计原则
把十三节的内容压缩,可以得到五条在跨层设计时反复出现的判断。
第一,MAS 的收益来自结构匹配,而不是数量堆叠。 MoA 的有效域是“回答质量型任务”,辩论的有效域是“可批评的推理任务”,Centralized 的有效域是“可分解任务”,Decentralized 的有效域是“动态环境任务”。超出有效域,更多 agent 只是更多开销。
第二,通信结构决定了系统瓶颈的类型。 all-gather 带来存储与重复 prefill 的爆炸,manager-mediated 带来中心节点的串行压力,blackboard 带来一致性与检索质量问题。选择通信结构,实际上是在选择“你愿意为哪种瓶颈付出代价”。
第三,记忆设计的关键是“放置”,而不是“容量”。 同样的信息放在 agent-local、collaboration 还是 long-term 层,带来的一致性、检索精度与上下文成本完全不同。LEGOMem 的角色感知放置与 G-Memory 的分层检索,都是把“放置”显式化的尝试。
第四,MAS 服务的核心矛盾是“KV 的价值随位置与时间变化”。 TokenCake 用关键路径识别与预测性卸载处理时间维度,TokenDance 用段级哈希与 diff 存储处理空间与计算维度。两者共同指向一个结论:传统推理引擎的 LRU + 前缀缓存假设,在 MAS 负载下都不再成立。
第五,硬件评测必须从“请求级指标”下沉到“执行形状”。 只有把 stage、session、operation 与 batch、kernel shape、访存活动关联起来,才能解释 MAS 为什么在某些加速器上表现不同。MAServeBench 的价值不在于给出一个分数,而在于提供一套能把协作语义翻译成硬件需求的实验方法。
从更长的时间尺度看,这五条原则指向同一个方向:多智能体系统正在从“提示词工程”变成“系统设计”。当协作范式稳定下来之后,真正决定产品体验的将是通信协议、记忆层次、KV 生命周期与调度策略——也就是本文反复拆解的那些“看不见的部分”。
参考资料
- Together AI, Mixture-of-Agents Enhances Large Language Model Capabilities, arXiv:2406.04692, 2024. https://arxiv.org/abs/2406.04692
- Yilun Du, Shuang Li, Antonio Torralba, Joshua Tenenbaum, Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, arXiv:2305.14325, ICML 2024. https://arxiv.org/abs/2305.14325
- Sirui Hong et al., MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework, arXiv:2308.00352, ICLR 2024. https://arxiv.org/abs/2308.00352
- Adam Fourney et al., Magentic-One: A Generalist Multi-Agent System for Solving Complex Tasks, arXiv:2411.04468, 2024. https://arxiv.org/abs/2411.04468
- Jiayi Yao et al., CacheBlend: Fast Large Language Model Serving for RAG with Cached Knowledge Fusion, arXiv:2405.16444, 2024. https://arxiv.org/abs/2405.16444
- vLLM 文档,Automatic Prefix Caching. https://docs.vllm.ai/en/latest/features/automatic_prefix_caching.html
- 站内延伸:Multi-Agent Memory 完全拆解:把 Agent 记忆当成计算机体系结构问题、PagedAttention 完全拆解、Continuous Batching:从请求级调度到迭代级调度、跨模型 KV Cache 传输
- RouteMoA(arXiv,2026 年 1 月)、TokenCake(arXiv,2025 年 10 月)、TokenDance、Towards a Science of Scaling Agent Systems(arXiv,2025 年 12 月)、MAServeBench 等为本文讨论的会议报告与预印本工作,具体条目以其公开版本为准。
Footnotes
-
Together AI, Mixture-of-Agents Enhances Large Language Model Capabilities, arXiv:2406.04692,2024 年 6 月。https://arxiv.org/abs/2406.04692 ↩
-
Yilun Du, Shuang Li, Antonio Torralba, Joshua Tenenbaum, Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, arXiv:2305.14325,2023 年 5 月。https://arxiv.org/abs/2305.14325 ↩
-
RouteMoA,面向多智能体推理的动态路由方案,arXiv,2026 年 1 月 26 日(预印本)。原文链接以 arXiv 检索为准。 ↩
-
Sirui Hong et al., MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework, arXiv:2308.00352,2023 年 8 月;ICLR 2024。https://arxiv.org/abs/2308.00352 ↩
-
Adam Fourney et al., Magentic-One: A Generalist Multi-Agent System for Solving Complex Tasks, arXiv:2411.04468,2024 年 11 月。https://arxiv.org/abs/2411.04468 ↩
-
TokenCake,面向多智能体工作流的 KV Cache 感知推理服务框架,arXiv,2025 年 10 月(预印本)。 ↩
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



