


SageAttention 系列完全拆解:低精度注意力如何做到不掉点——离群值平滑、逐线程 INT4 与 FP22 累加器
背景:为什么注意力成了低精度化的最后一块硬骨头
Transformer 推理的算力开销主要压在两类矩阵乘上:线性层里的 ,与注意力里的 和 。线性层的量化早已成熟,W4A16、W8A8、FP8 都有工业级实现,原因是线性层的权重在推理时是固定不变的,可以离线算好每一列的 scale;激活虽然逐 token 变化,但一条通道上的统计分布相对稳定,离群值可以用 SmoothQuant 一类的手段迁移掉。
注意力没有这些便利。它的两个矩阵乘都发生在「刚算出来的中间量」上: 和 是上一层投影的输出, 是 softmax 的即时结果,三者都依赖当前输入,逐 token 变化,无法离线预处理。更麻烦的是,注意力对数值误差的容忍度远低于线性层:线性层的输出还会经过残差叠加和归一化,误差被平滑掉;而 的误差会先被指数函数转换成概率的相对误差——,打分上的绝对误差 直接变成权重的相对误差——再经 softmax 归一化决定整行输出的权重分配。一个 token 的打分错一点点,它的权重就可能从一个量级跳到另一个量级。
正因为如此,早期的注意力量化大多采取保守做法:要么只量化线性层、把注意力整段留在高精度,端到端虽能加速,但注意力仍是显式开销;要么只优化两个矩阵乘中的一个,把 留在 FP16,等于只改了一半的循环。只要有一半矩阵乘还跑在高精度通道上,整个 kernel 的吞吐就被那一半定死。
从算子耗时上看得更清楚。当序列长度 远大于头维度 ( 通常为 64 或 128)时,注意力的两次矩阵乘都是 的;softmax 的逐元素非线性只有 次标量运算,比矩阵乘少一个 的因子,显存访问在 FlashAttention 分块后也被压到与 同阶。这意味着一旦两个矩阵乘都换到更快的 Tensor Core 通道上,注意力 kernel 的理论耗时就能成倍下降;反之,只要有一段仍跑在 FP16 的高精度通道上,整个 kernel 就被这一段的吞吐定死。这是把 也压到低精度的根本动因。
接下来的内容围绕一个核心问题展开:注意力的两个矩阵乘各自该怎么量化、量化误差又该怎么从结构上抵消掉。下文以 SageAttention 系列为主线:第一代由 Zhang 等人在 2024 年 10 月公开,次年发表于 ICLR 2025;第二代于 2024 年 11 月公开,发表于 ICML 2025;第三代于 2025 年 5 月公开。三代给出的答案不是简单的「换成 INT8」或「换成 FP4」,而是针对注意力的数据分布专门设计了几组预处理与补偿手段。理解这些手段背后的分布假设,比记住「它比 FlashAttention2 快 2 倍」更有价值。
前置:低精度矩阵乘、量化粒度与 FlashAttention 的循环
要读懂后面每个设计,需要先把三块背景放到位:Tensor Core 的低精度通道、量化粒度的含义,以及 FlashAttention 的分块循环。
Tensor Core 的精度通道与各自的吞吐
GPU 上的 Tensor Core 按操作数格式分成若干条独立通道。以论文讨论的 RTX 3090(Ampere 消费级)与 RTX 4090(Ada 消费级)为例,FP16 乘加是基准吞吐,INT8 是其 4 倍,INT4 又是 INT8 的 2 倍。数据中心卡在配置上更保守:A100、L20、L40、H100 上 INT8 相对 FP16 是 2 倍;而 Hopper(H100、H20)没有原生 INT4 通道。FP8 是 Ada 才引入的通道,Ampere 两代都不支持。累加器的差异同样按卡分开:把 FP32 累加降到 FP16 只在 RTX 3090、4090 上翻倍,在 L20、L40、H100 上不变。
| GPU 类别 | INT8 相对 FP16 | INT4 | FP8 相对 FP16 | FP16 累加相对 FP32 |
|---|---|---|---|---|
| RTX 3090(Ampere 消费级) | 4 倍 | INT8 的 2 倍 | 不支持 | 2 倍 |
| RTX 4090(Ada 消费级) | 4 倍 | INT8 的 2 倍 | 2 倍 | 2 倍 |
| L20 / L40(Ada 数据中心) | 2 倍 | INT8 的 2 倍 | 2 倍 | 1 倍 |
| A100(Ampere 数据中心) | 2 倍 | 有硬件通道,未走该路径 | 不支持 | 1 倍 |
| H100 / H20(Hopper) | 2 倍 | 无原生通道 | 2 倍 | 1 倍 |
这张差异表是 SageAttention 一、二两代选用不同位宽的直接原因,后文会反复用到。Blackwell 代(RTX 5090、B200、B300)新增了 FP4 Tensor Core,微缩放 FP4 矩阵乘的理论吞吐达到 FP16 的 8 倍,这是第三代 SageAttention 的硬件前提。
量化粒度:谁共享一个 scale
量化一个矩阵,核心选择是「多少个元素共享一个 scale 因子」,也就是粒度(granularity)。对 这种外积型矩阵乘,粒度的可用维度受一条硬约束:scale 只能加在矩阵乘的外轴上。原因很简单,矩阵乘的结果元素 是内轴 上的求和,如果按 分块给了不同 scale,反量化时就必须在求和结果里逐块乘回不同的系数,这要求结果矩阵逐块可见,破坏了 Tensor Core「一次算完一整块」的执行模型。
由此得到注意力的可用粒度:
- 的外轴是 token 维度,因此 、 只能按 token 做逐 token(per-token)、逐块(per-block,连续若干 token 一组)或逐张量(per-tensor)量化;
- 的外轴是 的行(token)与 的列(通道),因此 可以逐 token 或逐块, 可以逐通道(per-channel)。
逐通道量化通常是最精确的粒度(离群值集中在某几条通道上时,逐通道 scale 能把它单独隔离),但它对 和 恰好不可用;反过来,逐 token 量化对 精度最好,代价是反量化时每个线程要拿着不同的 scale 去乘,开销高。这套约束正是后面两代设计不断在「粒度精度」与「反量化开销」之间权衡的出发点。
FlashAttention 的分块循环
把注意力写成三段:,,。朴素的注意力要显式写出 的 与 ,当 达到数万时显存读写远超计算本身,属于典型的 IO 瓶颈。FlashAttention 的做法是把 token 维切块:外层循环遍历 的块 ,内层循环遍历 、 的块 、,每读入一对 ,在片上算出一个局部的 ,用在线 softmax 更新行最大值 、行和 与输出累加器 :
其中 、 是 的向量,分别初始化为 与 ; 的形状是 。外层循环结束后再除以 得到最终输出。关键在于:内层循环里每处理一块 ,都要做一次 与一次 ,这两次矩阵乘各占注意力计算的一半,所以「把两个矩阵乘都压到低精度」是唯一能成倍提速的路线。SageAttention 的修改完全嵌在这个循环里,不改变算法结构,只替换矩阵乘的精度与输入表示。
FlashAttention 的 IO 感知分块与在线 softmax 推导,可参考站内 FlashAttention 完全拆解(一):IO 感知与分块注意力算法。
核心思想:只量化矩阵乘的输入,不量化概率本身
读三代论文时容易忽略的一点是:它们从头到尾都没有量化 softmax 的输出概率 本身(即除以行和之后的那一份),也没有让 softmax 在低精度下运行。在线 softmax 的指数、行最大值、行和计算始终在 FP32/FP16 上完成,被量化的只有流入两个矩阵乘的操作数:、、、。
这个边界的选择不是随意定的。softmax 是对每个元素做一次 ,计算量只有 次标量运算,相比 的矩阵乘可以忽略;但它决定了整行的权重分配,是数值上最敏感的一步。把敏感的非线性留在高精度,把昂贵的线性运算压到低精度,这就是整套方法的基本分工。
在此基础上,三代工作各自解决一个位宽台阶上的新问题:
- INT8 台阶: 用 INT8, 保留 FP16 操作数但把累加器换成 FP16。核心难点是 存在强烈的通道离群值,做法是「平滑 K」。
- INT4 台阶: 降到 INT4, 改用 FP8。INT4 的数值范围只有 ,必须同时平滑 与 ,并引入与原矩阵乘指令布局对齐的逐线程量化;同时发现 FP8 矩阵乘的累加器实际只有 22 位有效精度,需要两级累加补偿。
- FP4 台阶: 与 双双换到 Blackwell 的微缩放 FP4。难点转移到了 的指数型分布和 FP8 scale 的表示范围上,做法是「对 两级缩放」。
贯穿始终的是一种设计哲学:量化误差不能靠提高位宽去压,而要靠抵消掉误差里的结构成分。三条平滑技巧都利用了注意力张量「所有 token 共享一个大偏置」的结构;逐线程量化利用的是 Tensor Core 指令的固定的寄存器布局;两级累加利用的是块内误差远小于全局误差的事实。每一处都在「去掉误差中可由结构预知的那部分」,剩下的才是无法避免的舍入噪声。
原理详解:QK^T 的 INT8 量化与 K 的离群值平滑
量化注意力的一般形式
把量化器记作 :给定高精度矩阵 ,它返回低精度表示 与 scale ,满足 ,其中反量化 就是逐元素乘以 scale。矩阵乘 的量化版本为 ,再乘回 。把这个框架套进 FlashAttention 的块循环,SageAttention 第一代的公式是:
两处值得注意的细节。其一, 被并进了 的量化:在片上先把 乘上 再量化,如此 的缩放系数只剩 ,省掉了矩阵乘后的一次行缩放,也避免了 与 INT8 结果的混合精度处理。其二, 不是单纯的量化器,它先做一步变换再量化——这正是下面要讲的平滑 K。
为什么直接量化 Q、K 会崩
论文给出了直接的实验证据:在文本生图(Unidiffuser)与文本生视频(CogVideoX)任务上,把 、 直接逐块量化到 INT8,输出会变成完全模糊的图或视频。表 1 中「不做平滑」的几行很能说明问题:CogVideoX 的 FScore 从满精度的 3.768 掉到 1.9 至 2.0,Unidiffuser 的 FID 从 163 涨到 221 至 267。而 Llama2 的 WikiText 困惑度(5.823 到 5.826)几乎不动——语言模型的注意力对这一点误差更耐受,生成模型则不然。
根因在 的数据分布上。下图是 CogVideoX 与 Unidiffuser 两个模型中随机抽样的一组 、、 热力图,横轴是通道维,纵轴是 token 维:
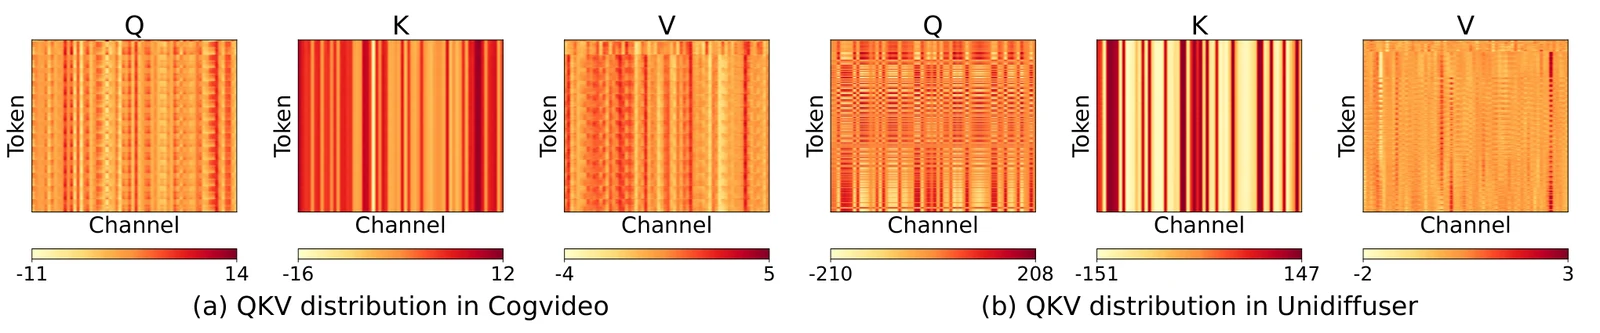
(图源:SageAttention 论文 Figure 4)
观察 的那几栏可以看出,它呈现出沿着通道维的稳定条纹:某些通道在整个 token 维上颜色很深,另一些很浅。这意味着每个 token 的 key 向量里,那几条通道上都带有一个几乎相同的、很大的值。注意这个现象和常见的线性层离群值不太一样:它不是少数 token 上突然冒出一个尖峰,而是全体 token 共享的同一个通道偏置。token 之间的键实际上可以拆成「一个所有 token 共享的大偏置」加「一个很小的 token 特有信号」。
这一结构直接毁掉了逐块量化的精度。逐块量化按块内元素的最大绝对值定 scale,如果块里某条通道的偏置值远大于其余通道,scale 就会被这个偏置撑大,其余通道的有效信号被压缩到 INT8 的少数几个码点上,小信号一律被舍入成零。结果是所有 token 的 key 在量化后都「长得一样」,注意力打分失去了区分度。
平滑 K:减掉均值,不改变 softmax
既然偏置是共享的,就把它整体减掉:
是一个 的行向量,沿 token 维求均值,再广播到每个 token 上减去。减完之后,每个通道上的共享分量消失,剩余的 token 特有信号幅度小得多,逐块量化时 scale 由这个小信号决定,码点的利用率大幅提高。最终的量化器写成复合形式 :先减均值、再量化。
关键一步是证明这个变换不改变注意力结果。对任意查询向量 :
推导只用了一个事实:softmax 对输入每一行加上任意常数不变,因为 。而 是一个对所有列都相同的标量(与 无关),恰好构成这一行的常数平移。于是「减均值」是数学上完全无损的预处理,误差只来自之后量化那一小步。
为什么不能直接用线性层的平滑思路(SmoothQuant 按通道把激活的离群值迁移到权重)?SmoothQuant 的形状是「每一列乘一个因子、对应的行除同一个因子」,它之所以成立,是因为被迁移的量乘在同一个矩阵乘的对应位置上,可以整体约掉。对注意力的 要这么做得把缩放加在内轴(通道)上,那正是粒度规则不允许的位置:通道 scale 无法在反量化时对外积求和结果逐通道乘回;而若想靠 、 沿通道互乘互除来平衡,又会同时改变 的尺度结构,使得下游所有层的输出尺度都得跟着重标定。减均值要简单得多,它消掉的不是「离群值」这一现象本身,而是离群值里那个全体 token 共享的加性分量——这部分分量对注意力的贡献本来就是一个可忽略的常数平移,所以可以无损地剥掉。
误差如何从打分传到输出
平滑和量化最终都要回答一个问题: 上的一点点误差,到了 上会被放大成什么样。设量化后的打分为 ,记 ,归一化后 。当 很小时,一阶展开给出
也就是说,权重的相对误差约等于该列的打分误差减去整行的加权平均误差。如果一整行的误差相同(常数平移),两者相消,权重完全不受影响——这正是减均值无损的另一种表述方式;真正有害的是「行内不一致」的误差。再看输出:
取绝对值并放缩,得到
这个界说明两件事。其一,输出误差与打分误差同阶,并没有被指数函数指数级放大——指数函数做的是把绝对误差变成相对误差,指数本身在 softmax 里被归一化约掉了。其二,真正危险的是 很小时的情形:权重本身只有 量级,量化网格稍一粗糙,这个 token 就从「有一点贡献」变成「完全没有贡献」;对单个输出元素来说这只是一点小误差,但对依赖长尾聚合的生成模型,这类丢失会累积成结构性的偏差。这也解释了为什么后续设计都在拼命保住小权重的分辨率,而不是只盯最大值的精度。
上面的界还给出了一个工程上的判据:要评估某种量化方案,看「行内打分误差的极差」比看「全局最大误差」更有意义。逐块 scale 之所以优于逐张量,正是因为它把 的误差限制在同一行的一块内,减少了 在行内的起伏。
平滑 K 的效果在表 1 里体现得很直接:
| 量化方式 | 平滑 K | Llama WikiText ↓ | CogVideo FScore ↑ | Unidiffuser FID ↓ | UltraPixel FID ↓ | TIMM ImageNet ↑ |
|---|---|---|---|---|---|---|
| 满精度(FP16) | — | 5.823 | 3.768 | 163.33 | 179.78 | 84.79% |
| 逐 token INT8 | 否 | 5.824 | 1.924 | 221.18 | 193.36 | 84.21% |
| 逐 token INT8 | 是 | 5.824 | 3.734 | 166.52 | 179.79 | 84.74% |
| 逐块 INT8 | 否 | 5.825 | 2.014 | 229.08 | 195.67 | 84.18% |
| 逐块 INT8 | 是 | 5.824 | 3.718 | 166.93 | 179.98 | 84.76% |
| 逐张量 INT8 | 否 | 5.826 | 1.902 | 267.06 | 196.26 | 84.12% |
| 逐张量 INT8 | 是 | 5.824 | 3.640 | 167.65 | 180.21 | 84.69% |
| FlashAttention3(自带量化) | — | 5.850 | 3.394 | 394.13 | 383.61 | 84.70% |
平滑之后,三种粒度的生成质量全部回到满精度附近(Unidiffuser FID 从 221 至 267 收回到 166 至 168,UltraPixel 从 193 至 196 收回到 179 至 180),而开销在表 10 中被测为小于 0.2% 的注意力耗时。相比之下,表内 FlashAttention3 的量化版本在 Unidiffuser 上 FID 高达 394,说明单纯「把矩阵乘换成低精度指令」并不足以保住生成质量。该表来自第一代论文的对比,使用作者当时可获得的实现,结论应理解为「注意力量化需要针对其数据分布做预处理」,不宜当作对另一实现整体能力的判断。
为什么 Q、K 选 INT8 而不是 FP8
第一代选 INT8 的决定性理由是吞吐,而不是纸面上的精度优势。在 RTX 4090 上 INT8 矩阵乘比 FP8 快一倍(相对 FP16 是 4 倍对 2 倍),RTX 3090 则根本没有 FP8 通道;这两张卡是论文的主要实验平台。精度方面,论文自己的层内统计其实显示 E4M3 做 的平均余弦相似度略高于 INT8(99.94% 对 99.70%),所以不能简单说 INT8 更准。真正成立的说法是:INT8 的 127 个均匀码点在「已经平滑过」的数据上足够用,而它换来的 2 倍吞吐差距远大于两者的精度差;FP8 的 E4M3 与 E5M2 只给尾数留了 3 位与 2 位,在 block 内已经按最大值定 scale 的前提下,动态范围优势体现不出来,反倒损失了尾数分辨率。
PV 的量化:INT8 不够,退回 FP16 操作数 + FP16 累加器
的量化走了另一条路。按逐块量化 、逐通道量化 的 INT8 方案,平均精度看起来还行,但看最差层就露馅了:在 Llama2 与 Unidiffuser 所有层上, 取 INT8 时最差层的余弦相似度只有 56.40%,相对 L1 误差高达 0.79。少数层被毁掉,端到端就会出现可见的退化。
作者改用「操作数保持 FP16,累加器换成 FP16」的方案。这条路的收益完全建立在硬件上:在 RTX 3090 与 4090 上,FP16 操作数配 FP16 累加器的矩阵乘比配 FP32 累加器快一倍。在 A100、L20、L40、H100 等数据中心卡上则没有这一加速,所以这个技巧只对消费级卡有效,这是第一代论文在 2025 年后显得「过时」的原因之一。
精度方面,FP16 累加器和 FP32 累加器的结果在表 4、表 5 中完全一致(平均余弦相似度都是 99.98%,最差层都是 99.84%),即在这一场景下降低累加精度没有带来可测的误差。论文没有给出严格的误差界,一个直观解释是: 每行最大值为 1(因为 且 是该行最大值), 的元素幅度也不大,而块内只有 64 到 128 个 token 参与一次累加,求和结果落在 FP16 尾数能稳定表示的量级内;再往外还有跨块输出累加器兜底。这个结论仍应按「论文在所列模型上的实测」理解,换模型或换块大小时值得重新验证。
量化粒度的取舍与自适应选择
第一代实现了四种内核,按 的粒度(逐 token / 逐块)和 的方案(INT8 / FP16 累加)组合:
| 内核 | ||
|---|---|---|
| SAGEAttn-T | 逐 token INT8 | FP16 操作数,FP16 累加器 |
| SAGEAttn-B | 逐块 INT8 | FP16 操作数,FP16 累加器 |
| SAGEAttn-vT | 逐 token INT8 | 逐块 INT8 + 逐通道 INT8 |
| SAGEAttn-vB | 逐块 INT8 | 逐块 INT8 + 逐通道 INT8 |
逐 token 比逐块精度略好但内核稍慢;带 v 的 INT8 版本在多数层速度再快约 4%,但在少数层精度不够。于是作者做了一个逐层自适应选择:用若干输入测试每一层在 SAGEAttn-vB 下的余弦相似度,只有超过 99.8%(即 SAGEAttn-B 的最差相似度)的层才启用 vB,其余层退回 B。论文报告这一策略在不损失精度的前提下把 OPS 再提高约 12%。这个思路在工程上很有代表性:量化方案不必全局统一,按层的敏感度做混搭往往比单一方案性价比更高。
第一代主内核在 RTX 4090、头维度 64 与 128 两种配置下达到 340 TOPS 左右的峰值,约为 INT8 理论峰值的 52%;相对 FlashAttention2 约 2.1 倍,相对 xformers 约 2.7 倍。下图并排展示 SAGEAttn-vT 与 SAGEAttn-B 两条执行流。以 B 为例,在一个 SM 内, 的 INT8 块与 scale 驻留片上, 块逐个读入, 走 INT8 通道并反量化, 保持 FP16, 走「FP16 操作数 + FP16 累加器」通道:
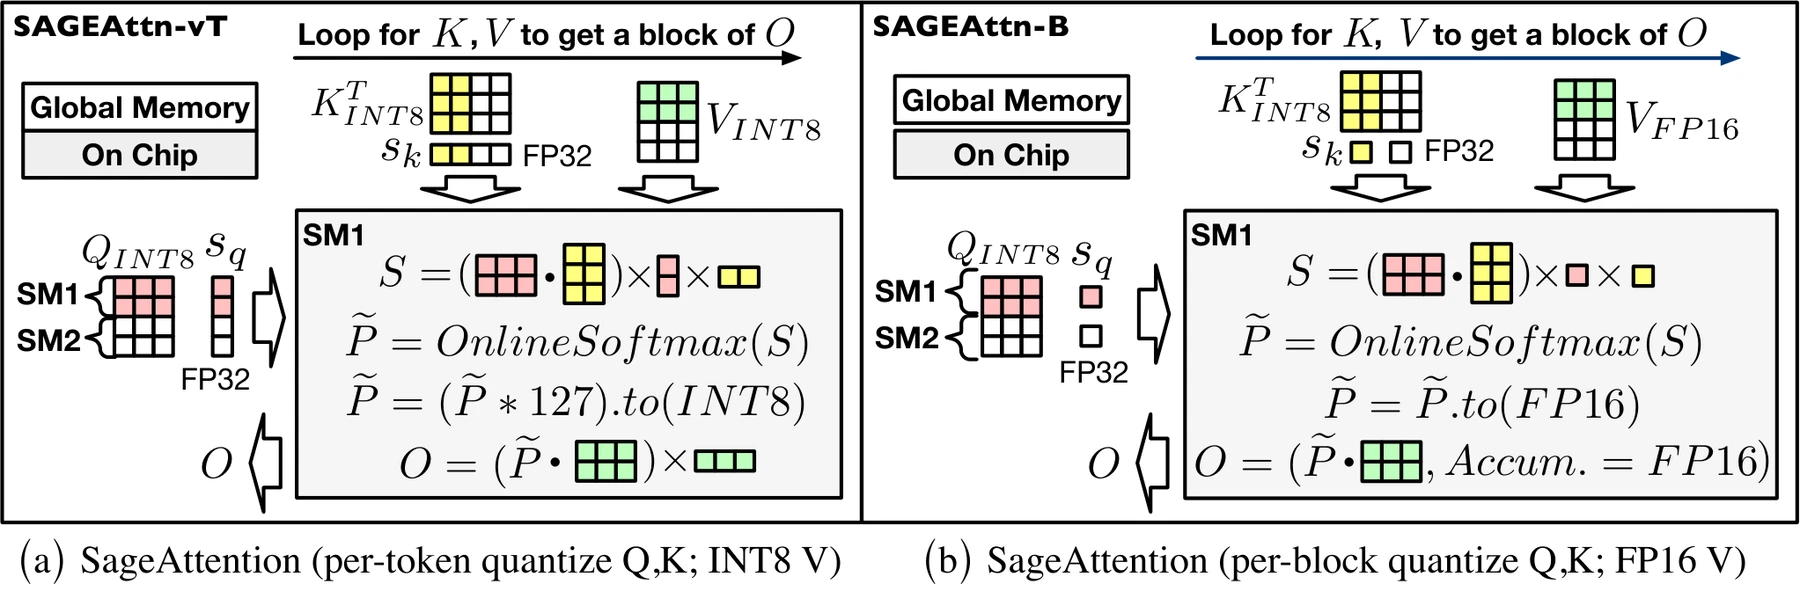
图中两条并排的流程对应两个内核:左侧 vT 把 乘 127 后转成 INT8、 按通道量化,走 INT8 的 通道;右侧 B 把 保留为 FP16 并注明累加器为 FP16。两者的共同点是 、 都是 INT8 且在片上反量化,OnlineSoftmax 始终以 FP32 计算。这个对比正好体现了前面讲的粒度取舍——vT 更快但更脆,B 稍慢但稳健(图源:SageAttention 论文 Figure 5)。
SageAttention 2:逐线程量化、平滑 Q 与 FP8 的 PV
第一代解决了 INT8 台阶,留下两个弱点:INT8 矩阵乘的速度只有 INT4 的一半(W1);FP16 累加器只在 RTX 4090、3090 上有加速,在 L20、H100 上没有(W2)。第二代的目标是把 推到 INT4、把 推到 FP8,让加速在更广的 GPU 上成立。
平滑 Q:把偏置拆出去,用一次 GEMV 补回来
INT8 的 127 个码点已经很宽裕,减掉 K 的均值就够用。INT4 只有 共 15 个码点,量化的动态范围规则变得非常苛刻:如果块内有一个元素比其余元素大 14 倍以上(0.5 对 7),其余元素就全部被舍入成 0。一个共享偏置就足以把一块里的其余通道全部清零。
第一代只平滑了 ,第二代发现 也有同样的通道偏置,于是两边都平滑。 的均值沿整个 token 维算一次, 的均值则按 块算:
是 的行向量,在块内广播; 是 的全局均值。把 按这两个分量拆开:
是对 每一行的常数平移( 是标量, 的每一列相同),softmax 会把它消掉,所以完全不用算。 则不能忽略:它是一个 的向量,对 的每一行作相同的加性修正,含义是「平滑后丢掉的交叉项」。它只需要用一次矩阵向量乘(GEMV)计算 与 的乘积,代价远小于 本身。
这个拆解带来一个重要的工程结构。论文的做法是:预处理阶段把平滑、量化与 GEMV 合并在一次遍历里完成,、 只从显存读一次,就产出量化后的 、 与对应的 、;注意力内核里只做 INT4 矩阵乘、片上反量化、加回 三件事。反量化与向量加法的开销相对昂贵的 MMA 指令可以忽略。这里的「一次遍历」是关键词:如果平滑、量化、GEMV 各自读一遍显存,光是搬运就会吃掉低精度矩阵乘省下来的时间。
论文通过消融给出了平滑顺序的结论:平滑 Q + K 优于只平滑 Q,优于只平滑 K,优于其他做法。只平滑 时, 的大偏置仍会把乘积整体抬离零点, 侧被平滑出来的小残差信号在这种整体抬升下依旧分不清;两边同时平滑,才让 这个「残差矩阵」的幅度真正变小,INT4 的范围被均匀地用满。需要注意 SmoothQuant 那种「两边互相迁移」的做法在这里失效:两侧都有离群值,挪来挪去只是换了谁崩;真正有效的是把共享偏置整体移到矩阵乘之外,用 GEMV 精确补回。
逐线程量化:让每个线程只拿一个 scale
平滑只减小了幅度,没有改变「块内存在异常值」这个事实。要让误差再小一档,就得把粒度做细。逐 token 量化最细,但反量化开销大:每个线程负责的输出元素来自不同的 token 行,手里会有好几个不同的 ,反量化时要逐个与各自的 相乘,本质上是每个线程多做一次向量点积。
逐块量化的反量化很便宜(每块一个 scale),但 INT4 下太粗。SageAttention 2 的突破在于:粒度可以细到「线程级」,而且不用付出任何额外反量化开销。这个粒度不是凭空定的,而是从 Tensor Core 指令的寄存器布局反推出来的。
具体来说,一个 块在一个 SM 内被拆成 段,由 个 warp 并行处理,每一段记为 ; 被所有 warp 共享。每个 warp 用 32 个线程执行 mma.m16n8k64 指令完成 。按这条指令的操作数布局可以推出: 这一组元素可以共享一个 scale,而 与 可以共享一个 scale。因为布局是按线程划分的,每个线程在反量化时恰好只需访问一个 和一个 , 退化为标量乘法。
下图展示了这个映射:左边是每个 warp 内的 token 与 scale 的对应关系,右边是 mma.m16n8k64 指令里 token 与线程编号的对应关系,底部注明每个线程只对应一个 scale:
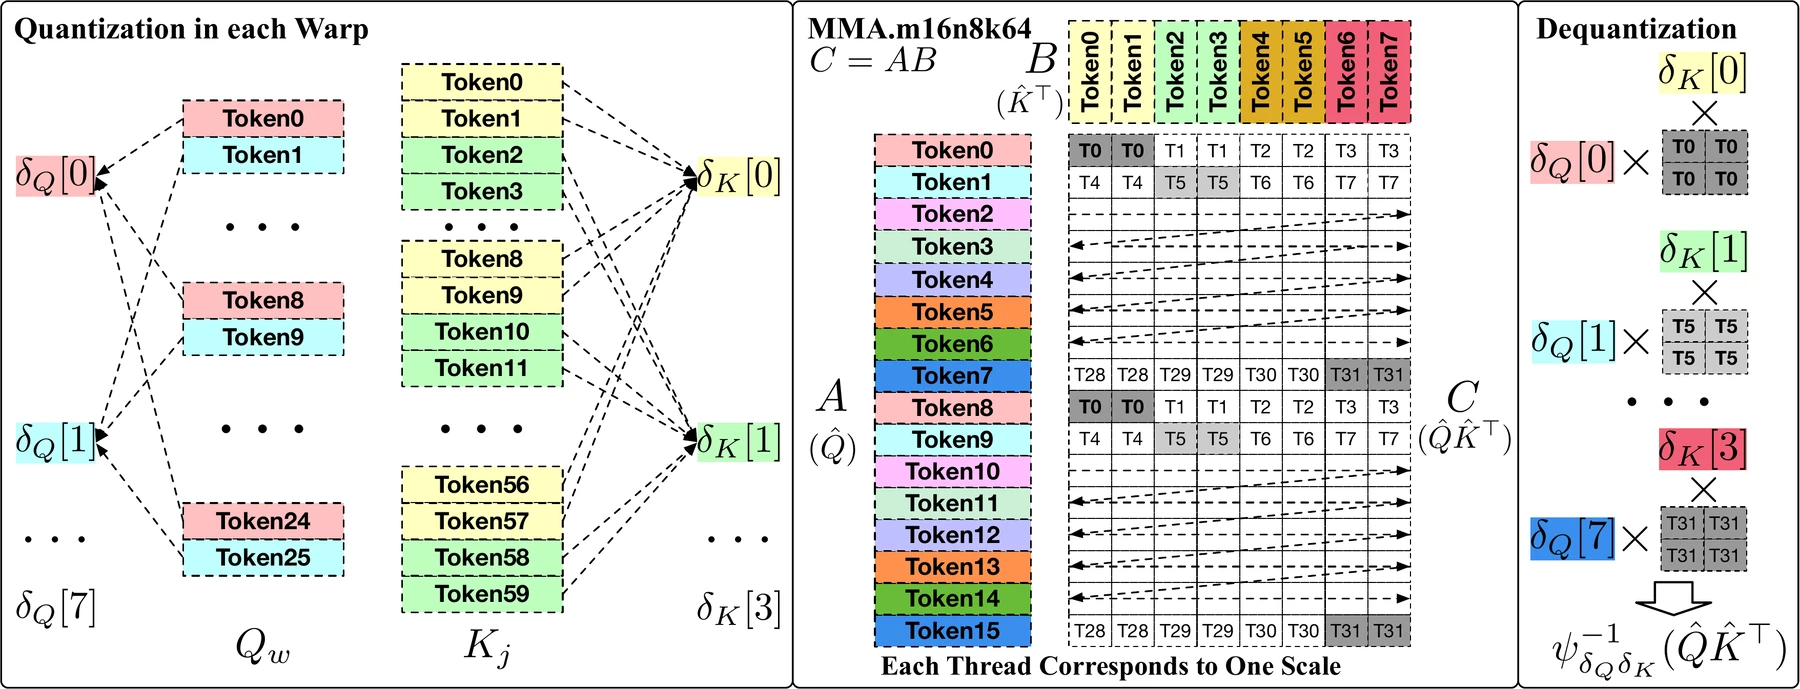
看右侧矩阵图,同一行的 64 个元素(k 维)被分散到 T0 到 T31 各线程的寄存器里;逐线程量化把「同一个线程持有、同属一个 token 的 8 个元素」划为一组,正好与指令的读入方式对齐。这就解释了为什么它在精度上接近逐 token、在速度上接近逐块(图源:SageAttention2 论文 Figure 4)。
代价实测非常小。在 L20 上,同一条 INT4+FP8 内核:基线 284 TOPS,加逐线程量化后 283 TOPS,加两级累加仍是 283 TOPS,再加平滑 Q 降到 273 TOPS。而逐 token 量化本身就把内核压到 268 TOPS。可以说逐线程量化是「拿逐块的代价,换逐 token 的精度」。
FP8 的 PV 与 22 位累加器
第二代把 换到 FP8(E4M3,可表示范围 ),因为 FP8 矩阵乘在几乎所有现代 GPU 上都是 FP16 的两倍速,解决了第一代 FP16 累加器只对消费级卡有效的弱点(W2)。
的分布决定了量化方式。它不是线性层的激活:,行最大值为 1;多数元素很小(比如 5000 个 量级的元素),但它们的和不可忽略。定点整数量化会把均匀码点铺在这个区间上,对大量小元素的表示很差。FP8 的浮点特性更适合:相对精度只由尾数位数决定, 与 的元素都能得到量级一致的相对误差,不会因为数值小而丢掉全部有效位。作者对 用静态 scale (因为元素本来就在 ),对 用逐通道量化来处理其通道离群值。
真正意外的是累加器。FP8 的 MMA 指令在论文中记作 mma(f32f8f8f32),名字里写着 FP32 累加,但作者按位实验后发现:在 Ada 与 Hopper 架构上,这个累加器实际只有 1 位符号、8 位指数、13 位尾数,即 22 位有效精度。实验方法是把 置零、只用 输入初值:当 恰好是 1+8+13 位格式时输出与 完全一致;当 尾数多于 13 位时,输出的最低 10 位尾数被清掉(截断)。这说明指令内部把结果折进了 22 位的中间表示。
直接后果是: 的块内累加如果用这个 22 位累加器承载整行 个 token 的求和,误差会随 累积。第二代的对策是两级累加:
这里维护两套寄存器: 用 FP8 的 MMA 指令算出,只有 22 位精度,但它只累加一个块内的 个 token(如 64 个),误差被限制在块尺度; 是跨块的累加器,用 FP32 承载,每个块结束后把 加进去。误差不再随全局 增长,而是被锁在单块的 个 token 内。作者也指出,同样的两级累加在 CUTLASS 与 DeepGEMM 中已被用于线性层的权重-激活乘积;据论文所述,把它用于注意力是首次。
把两种累加方式写成伪代码,差别一目了然:
# 方案 A:整行都压在 FP8 的 MMA 累加器里(误差随 N 增长)O_ij = 0 # FP22 累加器for j in 1..T_n: O_ij = diag(e^{m_{j-1}-m_j}) * O_ij + P_ij · V_j # 每一步都落回 FP22
# 方案 B:两级累加(SageAttention2 实际采用)O_i = 0 # FP32 跨块累加器,常驻寄存器for j in 1..T_n: R_ij = P_ij · V_j # FP22 块内结果,只累加 b_kv 个 token O_i = diag(e^{m_{j-1}-m_j}) * O_i + R_ij # 以 FP32 精度并入方案 A 里 FP22 累加器反复承接上一块的结果,误差按块数线性叠加;方案 B 只让 FP22 承载单块的乘积,误差被限制在块内,跨块的合并在 FP32 上完成。这也是为什么它可以在不改变块大小与指令的前提下,仅多一个 FP32 寄存器组就换回精度。
下图以 的一行与 的一列为例,展示 FP22 累加器在一块内如何表示这个点积,以及块与块之间如何交给 FP32:
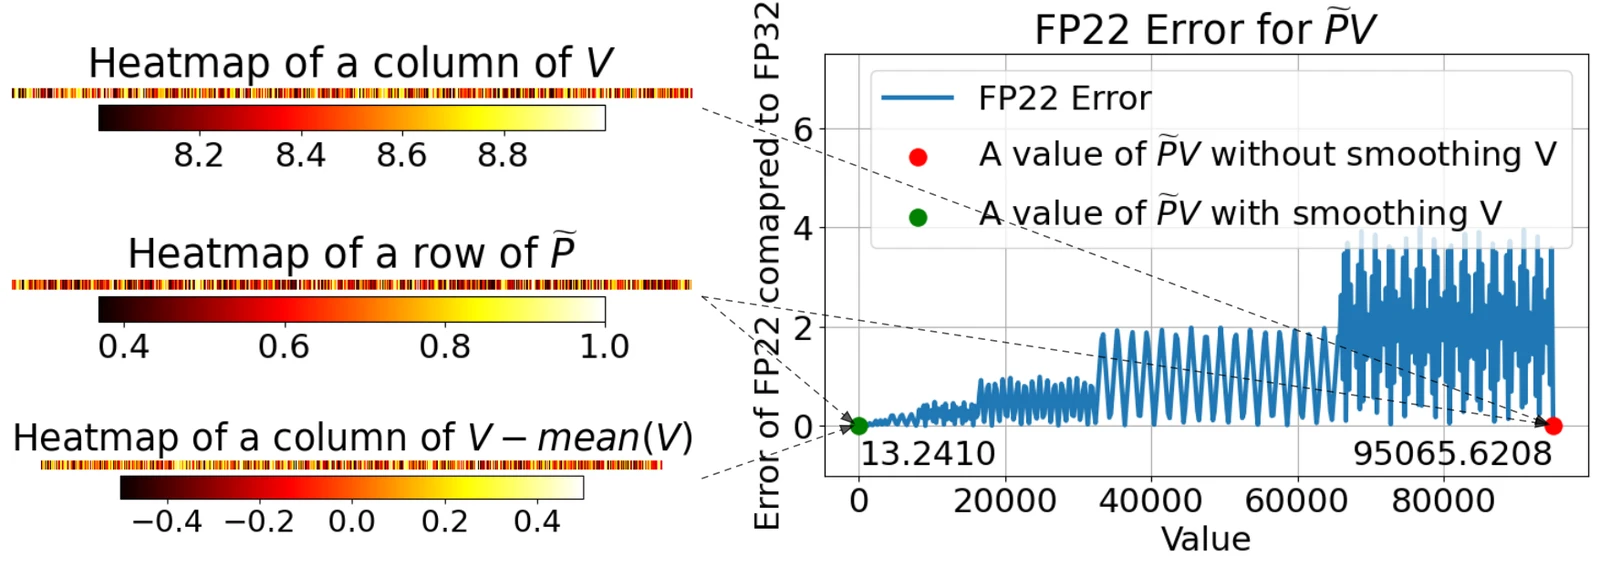
图中一行 与一列 的乘加结果只保留到 FP22 的 22 位有效精度,出块时再由一次 FP32 加法并入总累加器;这正是「块内低精度、块间高精度」在寄存器层面的样子(图源:SageAttention2 论文 Figure 17)。
还有一个可选技巧是平滑 V:若 的通道维存在偏置,减去 ,最后把 加回输出。正确性来自 每行之和为 1,因此 直接叠加即可。作者在实际模型里观察到,这一技巧只对 V 有明显通道偏置的模型有效;在 Llama3.1 上 没有明显偏置,不启用。
第二代整体流程
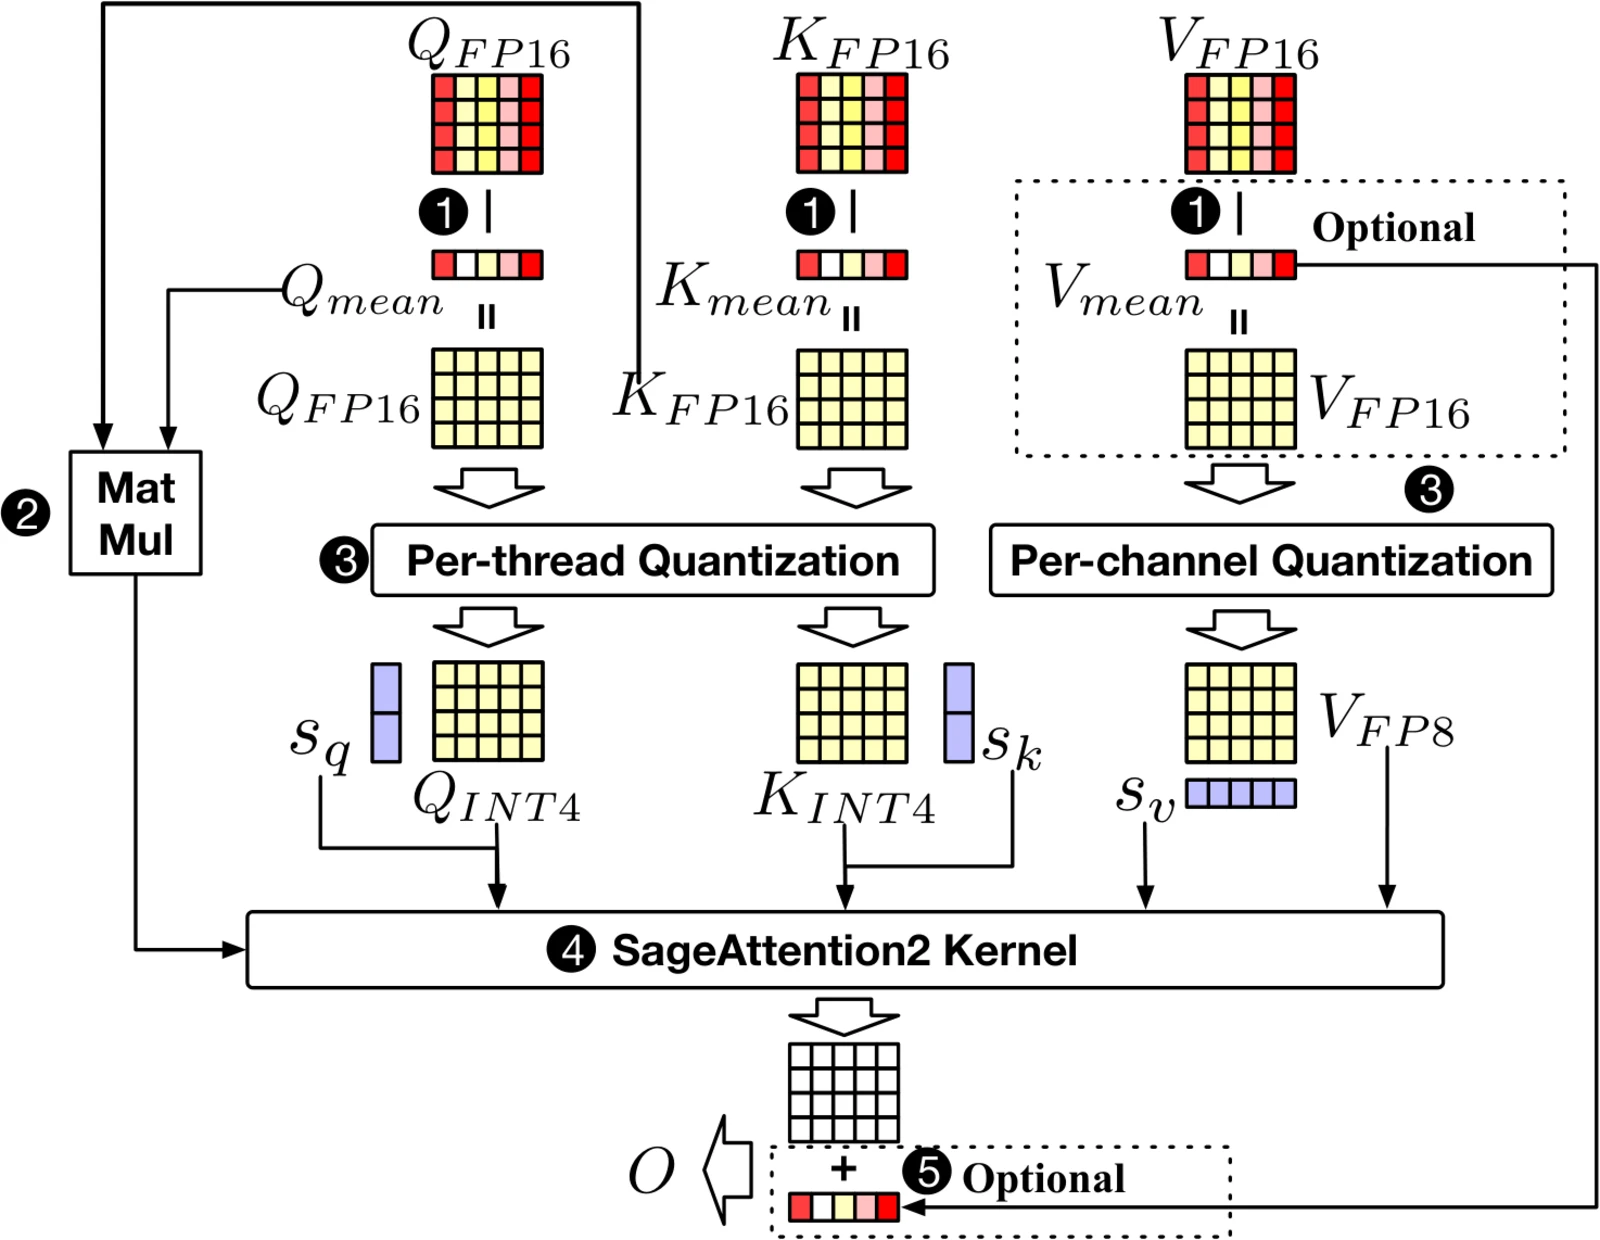
流程按图上编号:① 对 、、 做平滑;② 一次 GEMV 得到 ;③ 对 、 逐线程量化、对 逐通道量化;④ 执行 SageAttention2 内核( INT4 + FP8);⑤ 把 与可选的 V 平滑项补回输出。整个流程里只有第 ④ 步在低精度下,其余都是轻量的预处理和校正,且都能与相邻算子融合(图源:SageAttention2 论文 Figure 3)。
Hopper 上的退化:SageAttn2-8b
Hopper 架构没有原生 INT4 Tensor Core。为了在 H100、H20 等卡上可用,作者提供了 取 INT8 的变体(SageAttn2-8b),其余设计不变。在表 9 的相对加速中可以看到这层差异(均相对 FlashAttention2):
| 方法 | RTX 3090 | RTX 4090 | A100 | L40 | L20 | H100 | H20 |
|---|---|---|---|---|---|---|---|
| FlashAttention2 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 |
| FlashAttention3 | — | — | — | — | — | 1.37 | 1.57 |
| FlashAttention3(FP8) | — | — | — | — | — | 2.63 | 3.06 |
| SageAttention(第一代) | 1.97 | 1.96 | 1.37 | 1.45 | 1.24 | 1.53 | 1.52 |
| SageAttention2 | — | 2.93 | — | 2.60 | 2.46 | 2.61 | 3.12 |
注意第一代在 A100 上只有 1.37 倍——这正是前面说的 W2 问题:FP16 累加器加速在数据中心卡上不存在。第二代在 L20 上达到 2.46 倍,正是因为 换到了 FP8。在 H100 上 2.61 倍与 FlashAttention3 的 FP8 版本 2.63 倍基本持平;在 H20 上 3.12 倍则超过了后者的 3.06 倍,同时精度更高。RTX 4090 上峰值 481 TOPS,约为第一代 340 TOPS 的 1.4 倍;这一代在 4090 上相对 FlashAttention2 的内核加速也从第一代的约 2 倍提到 2.93 倍。
SageAttention 3:FP4 注意力与微缩放格式
Blackwell 引入的 FP4 Tensor Core 把注意力推到了 4 位。E2M1 格式的 FP4 一共 16 个码点,去掉正负零后只剩 14 个非零值,单看元素精度远不如 INT8,因此它必须借助「微缩放」(microscaling):把矩阵切成很小的块(每 16 或 32 个元素一块),每块配一个 FP8 的 scale,反量化时逐块乘以 scale。这种格式里,精度的来源从「元素本身的码点」转移到了「块内共享的 scale 是否精确」。
NVFP4 与 MXFP4
两种主流的 FP4 微缩放格式:
| 格式 | 元素格式 | 缩放块大小 | scale 格式 |
|---|---|---|---|
| NVFP4 | E2M1(1 符号 + 2 指数 + 1 尾数) | 每个 元素一块 | E4M3(4 指数 + 3 尾数) |
| MXFP4(OCP 标准) | E2M1 | 每个 元素一块 | E8M0(只有 8 位指数,无尾数) |
论文选择了 NVFP4:块更小(16 对 32),scale 带尾数(E4M3 对 E8M0)。在 CogVideoX 所有层的真实张量上,NVFP4 做注意力时的余弦相似度是 99.52%,MXFP4 是 98.37%;L1 误差 0.077 对 0.294,RMSE 0.201 对 0.994。差距主要来自两点:块更小意味着离群值只影响 16 个元素而不是 32 个;E8M0 的 scale 只有 2 的幂,无法表示「块内最大值 / 6」这类非 2 的幂的比值,量化点被粗糙地错开。
微缩放矩阵乘如何工作
给定 ,用 量化:把 按行切成 的小块 ,每块算一个 ,然后
反量化 。除以 6 是因为 E2M1 的最大可表示值是 6。
微缩放矩阵乘指令 FP4MM 接收四个输入 与一个 FP32 累加器,内部等于对反量化后的 、 做矩阵乘。在 RTX 5090 上,FP16 矩阵乘约 200 TOPS,微缩放 FP4 约 1600 TOPS,8 倍差距。注意一个容易被忽略的事实:FP4MM 内部做的是逐块的微缩放反量化再乘,scale 在硬件里随块乘回,软件不需要为它开额外循环。FP4 的位宽只有 FP16 的四分之一,但吞吐是 FP16 的 8 倍——这个倍率不是「位宽越窄越快」自然得来的,而是 scale 反量化被做进了指令流水的结果;如果 scale 要软件逐块乘回,这个倍率就拿不到。
注意力的两个矩阵乘都改用 FP4MM:
、 沿用第二代的平滑 Q + K 与 GEMV 补 ,这部分不变。
两级缩放: 的难题
在 FP4 下出了新问题。它的元素在 ,微缩放的 scale 是 ,于是 scale 落在 。NVFP4 要求 scale 用 E4M3 表示,问题不在于 E4M3 的相对精度随数值大小变化,而在于它在这个窄区间里根本没有几个可取值:附录给出的计数是,E4M3 在 内只有 35 个不同取值,而在 内有 127 个。每个 scale 再配 8 个 FP4 码点,直接量化时反量化后的输出总共只能落到约 个不同电平上;两级缩放把 scale 推到全量程后可落 127 个取值,电平数增加到约 个。可表示的电平稀疏,才是 直接量化误差大的根源。
论文的解法是对 做两级缩放:先把每一行整体缩放到 ,再用标准 :
第一级 scale 全程用 FP32 计算、不进入 E4M3,只作为最后输出的一次行缩放;缩放后 的最大值贴近 ,第二级 scale 因此落在 E4M3 的全量程上,可取值从 35 个增加到 127 个,块内量化才是准的。也就是把「scale 的动态范围」和「scale 的精度」拆成两级来兼顾:粗一级吃下大动态范围,细一级在窄范围内保精度。消融数据:直接量化时 CosSim 93.32%、L1 0.193;两级缩放后 CosSim 99.52%、L1 0.077,几乎回到 NVFP4 本身的水平(99.52%、0.077)。
下图是 SageAttention3 的整体工作流:左边 FP16 的 经过平滑 Q 和 FP4 微缩放量化为 FP4 与 FP8 scale; 经过平滑 K 后量化为 FP4; 经 OnlineSoftmax 后对 做两级缩放;右侧 逐块量化后与 一起进入第二个 FP4MM:
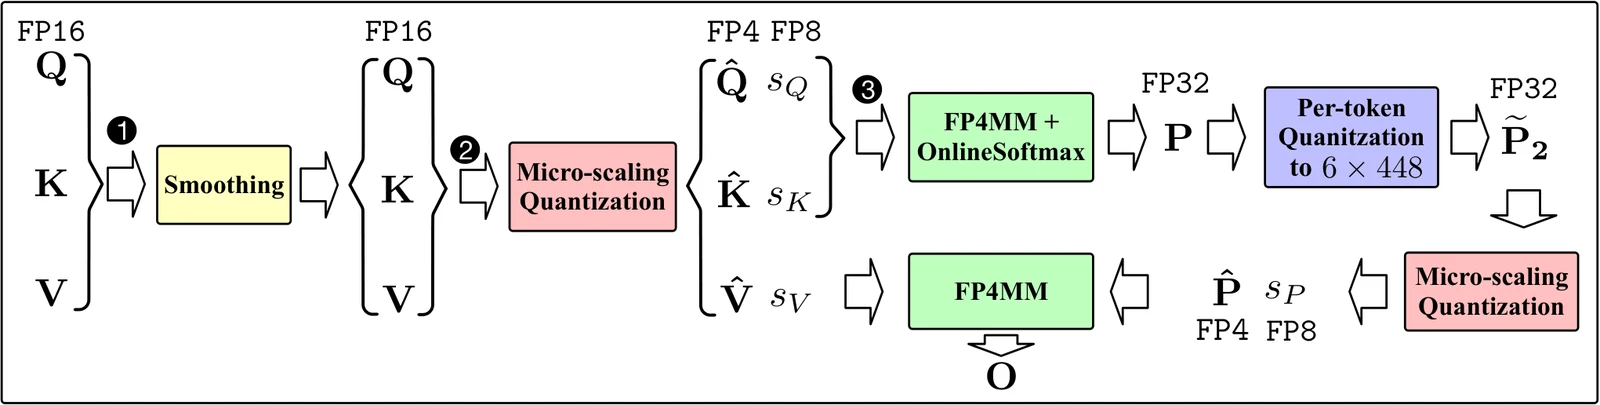
图里可以清楚看到两条流水:上方 、 的 FP16→FP4(配 FP8 scale)与下方 、 的同样路径,中间夹着 FP32 的 softmax。两个 FP4MM 的输出由 FP32 累加器承载,与第二代的「块内低精度、跨块 FP32」是同一套思路的延续(图源:SageAttention3 论文 Figure 2)。
内核层面的适配
FP4 累加器在 Blackwell 上的寄存器布局与操作数 A 的寄存器布局不同,若用线程 shuffle 把累加器对齐到 A 的布局会显著拖慢内核。作者的处理是置换:改变 块内列的排列方式,让累加器布局变成一套经置换的 FP32 布局,同时把 的列对应地重排以保持矩阵乘结果正确,这个重排可以融合进量化 kernel,不引入额外一次遍历。
第二处优化是复用 shuffle。块内量化要求找 16 个连续元素的最大值,而这 16 个元素分布在 4 个线程上,需要线程内归约再跨线程 shuffle。作者把微缩放量化与在线 softmax 融合:softmax 本来就要算行最大值,量化要找的是 16 元素最大值,二者可以复用一次。这减少了约 50% 的 shuffle 与求最大值操作,整个内核提速约 10%。
第三处是 producer warp 的 epilogue。常规 warp 特化内核让 consumer warp 同时做矩阵乘与写回,producer 只负责加载;但 FP4 注意力受寄存器约束,这种分工跑不开。作者改成 producer warp 之间乒乓调度:一个 producer 为下一个矩阵乘加载输入,另一个同时把上一个结果写回全局显存,consumer 只负责把矩阵乘结果从寄存器搬到共享内存。通过把「矩阵乘」与「全局写回」都放进 producer 一侧,在寄存器预算内实现了重叠。
数据概览
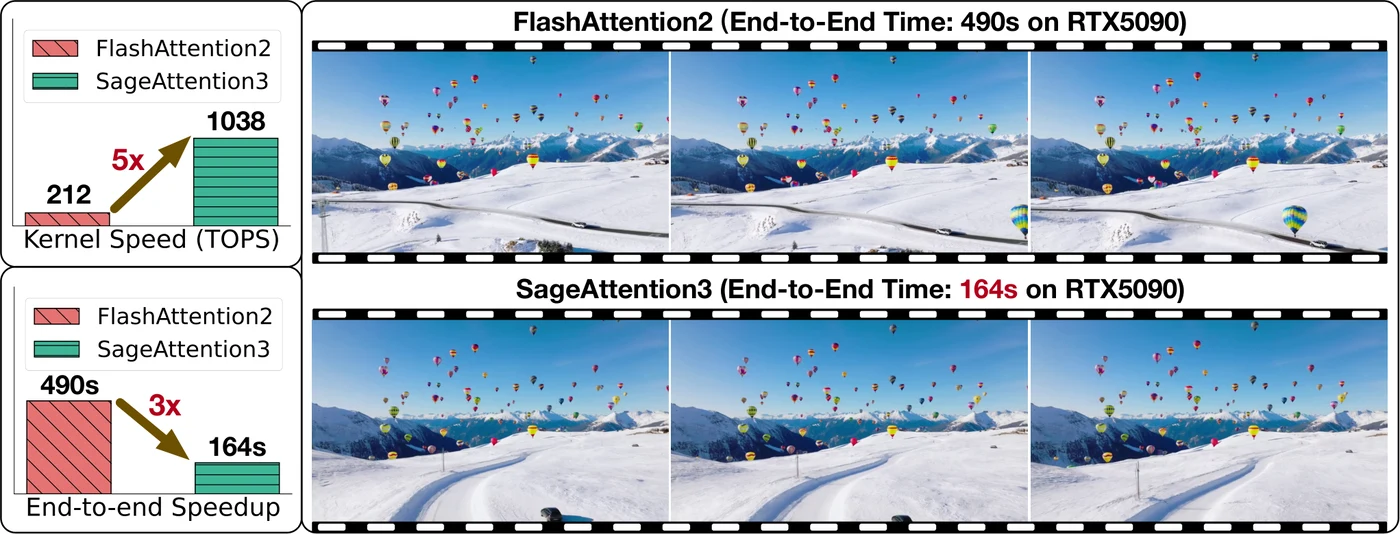
第三代在 RTX 5090 上达到 1038 TOPS,约为最快 FlashAttention 实现(FlashAttention2)的 5 倍,是 xformers 的 8 至 11 倍。端到端上,HunyuanVideo 在 RTX 5090 上约 3 倍、CogVideoX 约 2.4 倍。下图是论文首页的端到端对比:FlashAttention2 在 RTX 5090 上生成同一视频耗时 490 秒,SageAttention3 明显更短(图源:SageAttention3 论文 Figure 1):
在精度上,CogVideoX 的 FScore 从满精度 4.780 到 FP4 的 4.035,CLIPSIM 与 CLIP-T 基本持平(0.1865→0.1881、0.9968→0.9969);HunyuanVideo 的 CLIPSIM 甚至略有提升(0.1838→0.1866),但 FScore 从 1.4793 降到 1.232。FScore 衡量的是时序一致性,它掉得最明显,正是三代之中最需要正视的精度损失所在:FP4 下个别帧的权重错配更可能出现,表现为画面在时间上的轻微抖动,而单帧的清晰度与文本对齐(CLIPSIM、CLIP-T)仍然完好。
论文同时给出了 Blackwell 各型号的理论吞吐对比(按 Tensor Core 峰值估算):
| 方法 | B300(TOPS) | B200(TOPS) | RTX 5090(TOPS) |
|---|---|---|---|
| FlashAttention3(16 位) | 2500 | 2500 | 209.5 |
| FlashAttention3(FP8) | 5000 | 5000 | 419 |
| SageAttention3(FP4) | 15000 | 10000 | 1676 |
这些是理论上限而非常测值,实际内核只能用到其中一部分;但它们说明了位宽台阶带来的天花板如何逐级抬升。
需要说明的是,第三代后半篇还探索了 8 位注意力在训练/微调(SageBwd)上的可行性,结论是微调可以无损、预训练收敛变慢。训练不在本文范围内,这里只用一句交代:它的意义在于说明低精度注意力的适用边界目前主要停在推理侧。
Kernel 实现:量化、矩阵乘与反量化如何在一趟里完成
三代的 kernel 都建立在同一套「融合」原则上:把尽量多的预处理与校正塞进相邻算子,避免为量化单独开一次显存往返。原因很朴素:量化本身是一次逐元素的乘与舍入,算力很小;但它若单独读一次 、 再写回一次量化结果,显存流量就翻倍。在注意力 kernel 中显存带宽往往比算力更紧,这部分 IO 就成了主开销。
第一代的做法是把 的量化融合进 RoPE(旋转位置编码):在 RoPE 结果从共享内存写回全局显存之前,就把 算好并一起写出,于是注意力层直接拿到量化好的 ,省掉一次独立的量化 pass。 也是在这一步并进去的。
第二代的融合点更多。平滑、量化、GEMV 三者合并在同一个预处理遍历里,、 与 (用于逐通道量化)的高精度值只从显存读一次;注意力内核内部按块做反量化、加 、反量化 、两级累加,这些都在片上完成。 只需要一次 GEMV,因为它线性依赖于 ,而后者正是本块从显存读入的高精度 ,无需回写中间结果。
第三代把两级缩放、平滑、量化全部放进同一流程,并把 的块最大值寻找与 softmax 的行最大值合并。
一个实际工程上很容易踩坑的点是:反量化的 scale 必须以寄存器可直接使用的形式到达每个线程。逐块与逐线程量化之所以能零开销,正是因为 scale 的选取与线程布局对齐;如果为了追求精度改用逐 token 量化,scale 在反量化时就变成需要跨线程聚合的向量,这才是逐 token 被压到 268 TOPS 的真正原因,而不是算术多了。读任何量化 attention kernel 时先问一句「scale 如何到达线程」就能定位绝大部分开销。
精度与性能:论文给出的数据怎么读
把三代的端到端数据放在一起看,可以得到一个「位宽台阶 ↔ 可感知质量损失」的经验图景。下表只摘录论文主表中的代表性行:
| 方法 | 数据格式 | CogVideoX FScore ↑ | Unidiffuser FID ↓ | Llama3.1 WikiText ↓ |
|---|---|---|---|---|
| 满精度 | FP16 | 3.768(第一代实验)/ 4.780(第三代实验) | 163.33 | 6.013 |
| SageAttention | INT8 QK + FP16 PV | 3.834 | 166.49 | 未测(Llama2 为 5.824 对 5.823) |
| SageAttn2-8b | INT8 QK + FP8 PV | 2.487 | 未测 | 6.019 |
| SageAttn2-4b | INT4 QK + FP8 PV | 2.884 | 未测 | 6.256 |
| SageAttention3 | FP4 QK + FP4 PV | 4.035 | 未测 | 未测 |
注:SageAttn2 两行来自第二代论文,其 CogVideoX 满精度基线为 2.507,与第一、三代的 3.768 / 4.780 不可跨列比较。
读这张表要注意几点。第一,不同代论文的 CogVideoX 配置与指标口径并不完全一致(满精度基线分别是 3.768 与 4.780),跨行直接比较数值大小是不可靠的,更可靠的是同一次实验内的相对差:第一代 FScore 甚至略高于自己的基线(3.834 对 3.768),属于指标噪声量级;第三代相对自己的基线 4.780 掉到 4.035。第二代的数字更能说明「单一指标会骗人」:8 位版本 2.487 略低于基线 2.507,4 位版本反而升到 2.884,但同一次实验里 4 位的 VQA-a 只有 57.7(基线 70.2)——FScore 只看时序一致性,画面结构已经劣化时它未必下降,必须结合 CLIPSIM、VQA 一起读。第三,语言模型(Llama 系列)对注意力量化异常耐受:困惑度从 6.013 变到 6.019、MMLU 0.635 对 0.634(SageAttn2-8b),几乎无损;INT4 版本困惑度升到 6.256、MMLU 降到 0.607,开始可感知。第四,生成模型(视频、图像)最敏感,是整个系列把主要验证精力放在生成模型上的原因。第二代的 4 位版本在 CogVideoX 上的 VQA 下滑,就是论文自身说明「4 位在部分生成模型上质量会下探、8 位变体更稳妥」的来源。
从工程选型的角度看,三代的性能与适用硬件可以归纳为:
| 代系 | QK 格式 | PV 格式 | 主要得益硬件 | 相对 FlashAttention2 内核加速 | 部署约束 |
|---|---|---|---|---|---|
| SageAttention | INT8 | FP16 操作数 + FP16 累加 | RTX 3090/4090 | 约 2 倍 | 消费级卡首选;数据中心卡收益小 |
| SageAttention2-4b | INT4 | FP8 | RTX 4090、L20、L40、H20 | 2.5 到 3 倍 | 需要原生 INT4 通道 |
| SageAttention2-8b | INT8 | FP8 | H100 等 Hopper | 约 2.6 倍 | Hopper 无 INT4 时的替代 |
| SageAttention3 | NVFP4 | NVFP4 | RTX 5090、B200、B300 | 4 到 5 倍 | 需要 Blackwell 的 FP4 通道 |
此外,第二代还报告了超长上下文与音频任务的验证:在 Llama-3-262k 上做 262k token 长度的 Needle-in-a-Haystack,SageAttn2-8b 与 FlashAttention3(FP8)同处 8 位口径,前者保持性能而后者出现明显的端到端退化;Qwen2-Audio 7B 在 LibriSpeech 上的词错误率与满精度持平(如 test-clean 1.72 对 1.74)。这两组实验的价值在于把验证从「扩散模型」扩展到「长序列语言模型」与「语音模型」,说明这套方法并不是只在图像/视频生成上成立。长上下文场景本身的系统问题(KV 缓存布局、分页、并行)可参考站内 SGLang 源码完全拆解(八):Attention Backend 与 FlashInfer 完全拆解,那里讲的是 attention kernel 如何被组织成服务级组件;SageAttention 则是往这个组件里填一个更快的实现。
关于精度上的一个常见误解:把 SageAttention 的误差理解为「注意力结果偏了一点点」并不准确。误差真正的形态是部分 token 的权重被错配:某几行 因为量化码点稀疏,多个不同的 score 被舍入成同一个值,softmax 之后这些列拿到相同权重。在语言模型里这往往是可容忍的(上下文局部冗余度高,错配的列常是不重要的长尾);在生成模型里,权重错配意味着某个空间区域的特征不再被正确聚合,后果就是局部模糊或结构错乱。平滑、逐线程量化、两级累加做的都是让更多 score 落到不同码点上。
另一个容易被低估的点是离群值的「共享性」这一前提本身会变。整个平滑链条依赖「所有 token 共享同一个通道偏置」。如果换一种模型或训练方式,键向量的离群值不再共享而变成逐 token 的随机尖峰,减均值就收不到预期效果——论文并未在各代上穷举这一点,这是把它们迁移到新模型前应该先做小规模层内相似度验证的原因,也是第一代「逐层自适应选择内核」的思路至今仍然有用的原因。
接下来是工程接入与边界。
工程集成与适用边界
接入方式与关键接口
SageAttention 系列的三代实现都在同一个代码仓库(清华团队维护)中提供,第一代与第二代以 Triton 实现覆盖 RTX 4090 与 3090,第二代另有针对 RTX 4090、L20 的 CUDA 实现以及一个面向 Hopper 的 8 位变体(SageAttn2-8b),第三代给出面向 RTX 5090 的 FP4 实现。作为「即插即用」的推理加速,接入的关键不是修改模型权重,而只是替换注意力模块里的那一层:原先调用 scaled_dot_product_attention 或 FlashAttention 的地方,改调对应的 SageAttention 内核,量化与平滑都在内核内部完成。
替换在接口上要交代清楚三件事,这也是读它的源码入口时需要对照的:
- 输入 保持 FP16/BF16,形状按「批、头、序列、头维度」的四维布局给出;分组查询注意力(GQA)时 、 的头数少于 ,内核按分组映射头,不需要在模型侧提前把 复制展开。具体参数命名以仓库接口为准,不在正文臆造。
- 因果掩码与否必须显式告知:非因果时内层循环遍历全部 块;因果时只遍历「对角块及其之前」的块,对角块内部还要逐 token 掩码,这一分支决定了实际计算量。
- 不同代内核的适用硬件不同,调用前要按显卡选择对应实现(例如 Hopper 上要用 8 位变体,Ada 消费级可用 INT4 版本),选错会出现无对应指令而回退或报错。
有几个接入细节需要留意。第一,RoPE 融合只出现在第一代的某些实现中,第二、三代不保证实现同样的融合;若不做融合,每层会多一次只针对 的读写,对端到端的影响是百分之一量级。第二,平滑 K 需要沿 token 维的全局均值。这在「一次算完整个序列」的 prefill 里很直接,但在分页 KV 缓存、分块追加 K 的服务场景里,均值不能一次算清,必须用增量均值(来一个 token 更新一次)维护,否则平滑的前提就不成立。低精度注意力与分页 KV 缓存结合时要额外改造的原因正在这里——站内 vLLM 源码完全拆解(七):PagedAttention Kernel 讲的是分页访问本身的结构,而任何「沿 token 维求统计量」的预处理在分页结构里都需重新设计。
何时收益大、何时收益小
收益大小取决于注意力的耗时占比与硬件是否支持相应位宽通道。可以用一个简单的粗略估计:端到端加速比约为 ,其中 是注意力在原始模型中的耗时占比、 是注意力内核加速倍数。比如注意力在前向中占六成、内核 3 倍速,端到端约 1.67 倍;注意力只占一成、内核 3 倍速,端到端约 1.07 倍——注意力占比越高,低精度内核的杠杆越长。
由此可以判断这一系列在哪些场景收益突出:
- 高分辨率图像、长视频生成:注意力呈二次增长,占比高。第一代在 CogVideoX、UltraPixel、Unidiffuser 上测得注意力层加速 2.01、2.14、2.34 倍,五个模型平均 2.83 倍(表 7;其中 TIMM 因原始 torch attention 极慢而达到 5.89 倍,拉高了均值),正是这类场景。
- 长上下文语言模型的首 token 生成(prefill):注意力占比随序列长度上升。SageAttn2-8b 在 100K token 的 Llama3.1 上把时间降到 25.4 秒(原 39.9 秒)。
- 解码阶段:单 token 解码的注意力是访存受限的,收益主要来自批量很大时 的算力;批量小时更依赖 KV 访问优化,那是另一类问题。更关键的是平滑 K 的均值随上下文增长而漂移,早先按旧均值量化好的 K 缓存不能直接复用;要么缓存高精度 K 并按新均值重算(每步多一次 带宽),要么接受滞后均值带来的精度损失。这决定了该系列的主战场是 prefill 与扩散模型的全注意力,而非逐 token 解码的 KV 复用。
收益小的场景包括注意力占比低的模型(如小型图像分类网络层数短、 小)、以及只跑在不受益硬件上的情形(例如第一代在 A100 上只有 1.37 倍)。
精度敏感的层与对策
论文反复出现的一个事实是「平均精度尚可、最差层很差」。这意味着端到端指标的漂亮数字可能掩盖了个别层已经崩掉。工程上更稳妥的做法是保留第一代提出的逐层混合策略:先在全模型上跑一组真实输入,统计每层在低精度与满精度下的输出余弦相似度,把低于阈值的层退回高精度实现,其余层用低精度。三代的内核都接受这种「按层替换」的接入,代价只是多维护两套调用。
还没解决的问题
这套方法留下了几个明确的空白,读论文时容易被亮眼的加速数字盖过去。
统计量的在线维护。平滑依赖沿 token 维的均值,而这个均值在自回归生成中随上下文变化。现有实现主要面向「一次拿到整段序列」的 prefill 与扩散模型的全注意力;若要用于逐 token 解码,要么每步重算均值并重新量化整个 KV 缓存(带宽代价与注意力本身同阶),要么接受陈旧均值。论文没有给出后者的误差分析,这是把方法推进到 decode 路径前必须补的一课。
4 位精度的模型依赖性。8 位版本在论文覆盖的模型上基本无损,4 位版本则已经在 CogVideoX 的 VQA 指标上出现明显下滑(VQA-a 57.7 对 70.2),不同模型、不同层的敏感度差别很大。所谓「即插即用」在 4 位下应理解为「接口即插即用」,精度仍需逐层验证,不能把 8 位的结论直接外推到 4 位或 FP4。
硬件碎片化。三代内核分别绑定不同的指令集:第一代依赖 Ada 的 INT8 与 FP16 累加加速,第二代 4 位路径要求原生 INT4,Hopper 只能退回 8 位变体,第三代要求 Blackwell 的 FP4。部署时要按卡选实现,同一套服务在混合机型上会同时维护多条内核路径,这部分工程成本不会被计入论文的加速比。
评测覆盖。主要实验集中在扩散类生成模型,语言模型侧以困惑度、MMLU 与一组 262k 长上下文检索为主,缺少对解码吞吐、连续批处理、P/D 分离等真实服务指标的测量。加速比是在单算子层面测的,端到端收益仍取决于注意力在具体模型中的占比。
后续的 SageAttention2++(2025 年 5 月)主要是在实现层面继续压缩 SageAttention2 的开销,思路仍是同一套量化框架,可视为工程优化而非新的位宽台阶。
小结
SageAttention 系列的主线可以用三句话概括。
第一,它从结构上回答了「注意力为什么难量化」:、 的离群值不是逐 token 的随机尖峰,而是全体 token 共享的通道偏置。这一共享性可以让平滑变成一次数学无损的均值相减,再通过一次 GEMV 或一个常数平移把丢掉的交叉项补回,从而在不提高位宽的前提下换回绝大部分精度。
第二,位宽每降一级,需要补的误差结构就换一次:INT8 阶段的主要误差来自 的通道偏置(平滑 K);INT4 阶段 、 两侧都要平滑,并且粒度要细化到与 Tensor Core 指令布局对齐的线程级,才能既精确又不增加反量化开销;FP8 阶段暴露出累加器只有 22 位有效精度,靠块内低精度、跨块 FP32 的两级累加把误差锁在块尺度;FP4 阶段问题转移到 的指数型分布与 FP8 scale 的表示范围,两级缩放把粗动态范围与细精度分开。
第三,性能提升来自硬件位宽通道本身,而保住精度靠的是预处理与结构补偿。读这类工作时应先看硬件口径(哪一代卡、哪种位宽通道),再看误差补偿设计;只记住速度倍数容易误导——同一个内核换到不支持相应通道的卡上,收益可能缩水到不足一倍半。
可以把三档位宽的「注意力量化账」简化为一个对照:
| 位宽台阶 | 代表方法 | 核心补偿手段 | 典型误差形态 |
|---|---|---|---|
| INT8 | SageAttention | 平滑 K | 块内小信号被压成零 |
| INT4 + FP8 | SageAttention2 | 平滑 Q + K、逐线程量化、两级累加 | 码点稀疏致部分 score 撞码 |
| FP4 | SageAttention3 | 两级缩放 、NVFP4、布局置换 | FP8 scale 可取值过少致量化电平稀疏 |
对关心推理系统的人而言,这个系列的另一个启示是:量化策略的选择不是精度与速度的二选一,而是对数据分布做正确建模。线性层量化受益于权重固定、激活稳定;注意力量化受益于 token 间的强共享结构。哪种方法在一个新模型上有效,往往不取决于位宽,而取决于这种共享结构是否还成立。这也解释了为什么三代论文都在用真实张量做逐层的相似度统计,而不是只报端到端指标。
参考资料
- SageAttention: Accurate 8-Bit Attention for Plug-and-play Inference Acceleration(ICLR 2025)
- SageAttention2: Efficient Attention with Thorough Outlier Smoothing and Per-thread INT4 Quantization(ICML 2025)
- SageAttention3: Microscaling FP4 Attention for Inference and An Exploration of 8-bit Training
- SageAttention 官方代码仓库 thu-ml/SageAttention
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
- SageAttention2++: A More Efficient Implementation of SageAttention2
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models
- OCP Microscaling Formats (MX) Specification
- NVIDIA PTX ISA: Matrix Multiply-Accumulate Instructions
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



