


HybridAgent 完全拆解:HybridLink、连续工作记忆与文本-隐空间混合推理
背景与问题定义
文本是 Agent 唯一的通用语
当前几乎所有 LLM Agent 都建立在同一个前提上:模型与外部世界的一切沟通都通过文本 token 完成。要解一道难题,Agent 必须把中间推导逐步生成出来——每一步推理、每一次自我检查、每一个”接下来该调用什么工具”的念头,都要先被解码成可读的 token 序列,拼回上下文,才能继续往下走。
这个设计带来了极好的透明性与可控性:人能读、能审计、能在出错的位置插入修复。但代价写在了每一台推理服务器的账单上:
- 解码开销:每个中间 token 都要走一次完整的前向传播(prefill 阶段还要算注意力),而一段几千 token 的思维链,绝大多数内容对最终答案的贡献是间接的;
- 上下文膨胀:长思维链会把上下文迅速撑满,KV Cache 线性增长,解码阶段的注意力读取量随之上升,这直接决定了单请求的显存占用与峰值吞吐;
- 深度受限:文本 token 是离散的、低频的,一段推理被压缩到几十个 token 里,信息密度天然受限于词汇表与解码步数。
换句话说,Agent 的思考速度被”必须把想法说出来”这条规则锁死了。
隐空间推理:另一条路线及其代价
另一条路线放弃了”说出来”这个前提。以 Coconut(Chain of Continuous Thought)为代表的隐空间推理工作提出:与其把最后一步的语义解码成一个 token 再重新嵌入,不如让最后层隐状态直接作为下一步的输入,在连续空间递归展开计算。模型因此可以在自己的表示空间里进行内部推理,不必为每一步付出一次完整解码与再嵌入的成本。
隐空间推理把推理的”带宽”从词汇表的规模提高到了隐藏维度的规模——一次前向传播可以携带的信息量,远大于一个离散 token。但它也带来了两个致命缺口,正是这两个缺口让隐空间推理长期无法成为真正的 Agent:
- 没有原生的工具调用通路。工具调用本质上是一个离散的、结构化的动作:生成一段符合 schema 的 JSON、匹配到某个函数名、把返回结果拼回上下文。隐向量既不能被外部工具解释,也无法在多轮 agentic 循环中承载”调用—观察—修正”的离散协议。
- 语义不可读。连续向量不像解码出的文本那样天然暴露人可读的语义,这带来双重后果:训练时难以监督(不知道该在哪个位置施加什么监督信号),推理时难以审计与调试(出现了错误结论,无法定位到哪一步思考出了问题)。
于是两条路线形成了各缺一半的僵局:文本路线可解释、可调用工具,但开销大、深度浅;隐空间路线高效、表达力强,但封闭在模型边界内、无法与外部世界交互。此前的工作要么在文本侧继续堆叠推理脚手架,要么在隐空间侧继续优化单模型的推理质量,很少有人真正把两者放进同一条生成过程里。
HybridAgent 想解决的问题
Stanford、UIUC 与 Together AI 的研究者在 2026 年 10 月发表的论文《Hybrid Reasoning Agents》(arXiv:2610.18861)给出了这一路线的第一个完整答案。它的目标可以概括成一句话:让模型想得比文本更深,但仍然通过文本行动。
用论文自己的表述,HybridAgent 要在单一生成过程中动态地在两种模式之间切换:
- 文本模式:与标准 LLM 完全一致,逐 token 采样,负责工具调用、环境交互与最终答案输出,保持透明可控;
- 隐模式:最后层隐状态经一个轻量模块 HybridLink 回注输入端,直接在连续空间递归推演,不经过解码与再嵌入。
两种模式共享同一套输入接口、同一份 KV Cache、同一条生成轨迹。这一点比”把两个模型拼起来”关键得多,因为只有共享输入空间与工作记忆,多轮 agentic 循环中的工具观察与隐式思考才能无损地拼接在同一个上下文流里。
核心思想
一句话概括
把”下一步输入”这个位置变成一个可插拔的接口:文本模式的下一步输入是词嵌入层产出的向量,隐模式的下一步输入由 HybridLink 从最后层隐状态实时生成,两种向量落在同一个嵌入空间里,Transformer 对它一视同仁。
与已有方案的本质区别
与标准文本 Agent 的区别在于解码路径。文本 Agent 每推进一步都要:解码 token → 把 token 拼回序列 → 重新嵌入 → 前向传播。HybridAgent 在隐模式下每推进一步只需要:前向传播 → HybridLink 映射 → 直接作为下一步输入。省掉的是采样、词表投影(LM head)与再嵌入这三步,而这三步在长思维链场景中恰好是重复成千上万次的。
与 Coconut 类隐空间推理的区别在于是否保留文本通路,以及回注方式。Coconut 把 原样当作 ,这在纯隐空间推理里可行(整条轨迹都在隐空间里,不存在切换),但一旦混合生成就出问题: 是隐表示空间中的向量,而模型前向传播时看到的其他位置都是嵌入空间中的向量,两者分布不同。当轨迹在两种模式间反复切换时,这种错配会让模型难以从连续状态切回离散 token。HybridLink 用一个带残差的轻量适配器把这一步补上(3.1 节会给出公式与参数量),这也是整篇论文中”架构上唯一必须新增的东西”。
与”外挂式”混合方案的区别在于上下文如何跨轮传递。把隐空间推理模块作为子过程调用,然后把它产出的文本摘要塞回主上下文,是最容易想到的工程做法,但那样每轮都要在 token 空间里重建一次上下文,既损失信息又重复计算。HybridAgent 的做法是让 KV Cache 本身成为工作记忆:文本 token、隐思想、工具返回结果三者的 KV 条目按位置顺序累积在同一个缓存里,下一轮直接从这份缓存继续生成。
设计空间里的关键取舍
把”下一步输入”做成接口后,作者面临三个必须回答的设计问题,后续各节会逐一展开:
| 设计问题 | 可选方案 | 论文的选择与理由 |
|---|---|---|
| 回注到输入空间的映射形式 | 直接复用 ;独立线性层;带残差的小 MLP | 带残差的小 MLP(HybridLink),只需对齐分布差异,约 参数 |
| 何时进入/退出隐模式 | 预设固定比例;按位置强制切换;由模型自己决定 | 由模型自己决定,用特殊 token 作为进入锚点、用余弦相似度条件作为退出判据 |
| 混合轨迹如何跨轮携带 | 每轮把隐思想还原成文本再拼回上下文;保留 KV 条目 | 保留 KV 条目作为连续工作记忆,无损且免重算 |
下面几节按”架构 → 工作记忆 → 逐 token 推理流程 → 后训练 → 实验”的顺序拆解。
HybridLink 架构详解
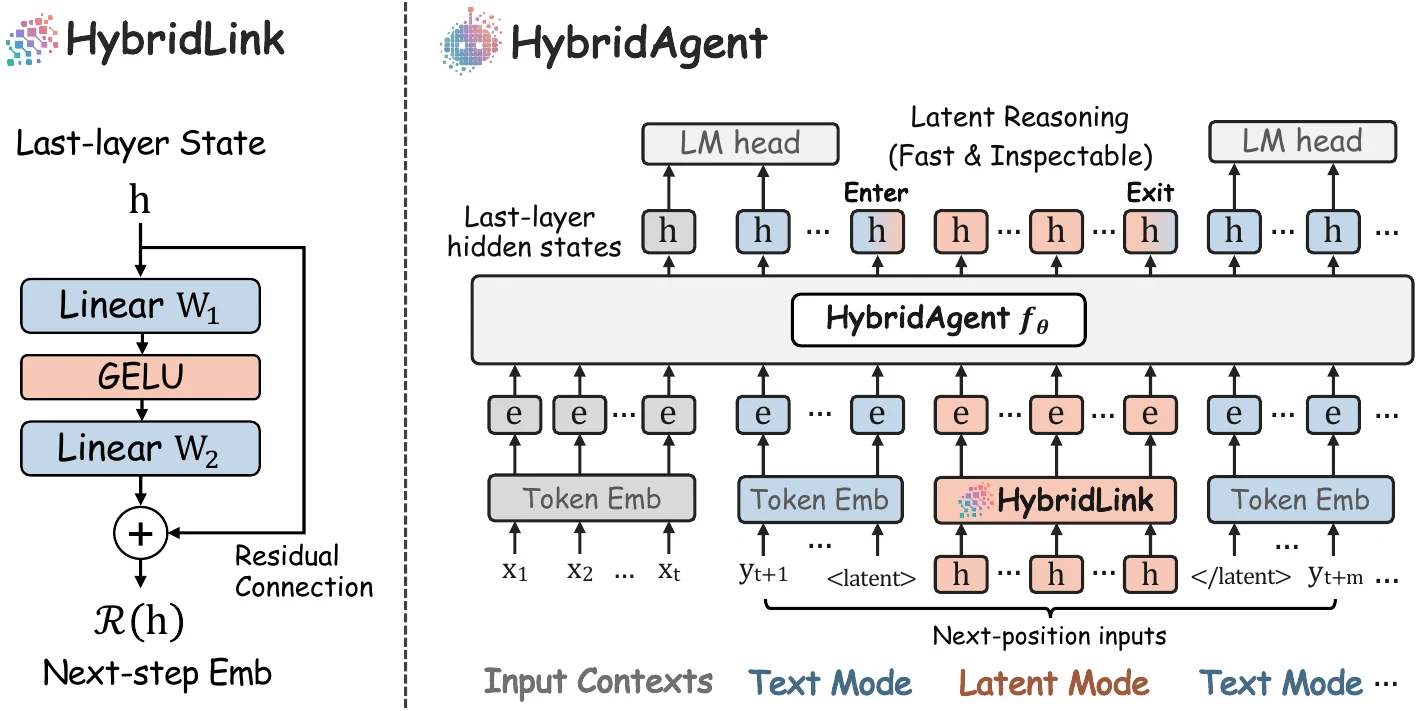
图源:论文 Figure 1(arXiv:2610.18861),经官方仓库 togethercomputer/HybridAgent 素材重绘。
为什么不能直接把隐状态当输入
先看清问题的物理形态。一个标准 Transformer 的每一步前向传播,输入端拿到的是一串向量:每个位置的输入向量 = 对应 token 的嵌入向量 + 位置编码。生成阶段,模型把最后层隐状态 送进 LM head(词表投影矩阵),得到词表上的 logits,softmax 采样出一个 token,再把这个 token 的嵌入向量放回输入端,开始下一步。
隐空间推理把中间几步的”解码—再嵌入”环节掐掉,直接用 当 。在纯隐空间推理里这没问题,因为整条轨迹都在隐空间里自洽。但一旦要混合生成就出问题了: 生活在隐表示空间,而模型在文本模式下看到的所有输入向量都生活在嵌入空间。两个空间的分布不同,量纲不同,各向异性结构不同。
后果是多轮切换时模型会”失忆”:它刚刚还在隐空间里推理,突然要求它切回文本,此时输入向量里混进了来自另一分布的向量,模型的注意力模式和前馈网络激活都会被打乱。作者在论文里明确把这称为 representation mismatch——不是精度问题,而是分布对齐问题。
HybridLink 的公式与设计动机
HybridLink 的形式很简单:
逐项解释:
- :第 步最后层的隐状态向量, 是隐藏维度;
- :升维投影,把隐状态先映射到中间维度 ;
- :逐元素激活函数,论文用的是 GELU;
- :降维投影,把中间维度的结果压回 ;
- 最后的 :残差连接。
这个结构就是一个两层 MLP 加残差,也就是常说的小型 adapter。关键在于残差项 的作用:它让输出天然地保留了 的原始语义,只让 MLP 去学习”从隐表示空间到嵌入空间还差多少”的那个偏移量。如果去掉残差,HybridLink 就得从零学一个完整的跨空间映射,参数量和训练难度都会大幅上升。
参数量估算: 和 加起来约 。当 取常规的 时,参数量是 量级;论文给出的实际口径是约 ——也就是说中间维度取得比 小得多,是个刻意压薄的瓶颈结构。对 4B 模型而言,这个模块大约 10M 参数,相对主干可以忽略。
这个设计选择回答了一个自然的问题:为什么不做成更强的映射器(比如多层 Transformer adapter、或者直接微调嵌入层)?作者的取舍逻辑是——要学的东西本来就很少。因为残差已经保留了原语义,剩下的只是分布对齐,用一个带瓶颈的两层 MLP 足够,多一点参数都是浪费,而且更大的映射器更容易过拟合到训练时见过的隐状态分布上,反而损害泛化。
模式切换的两个判据
HybridLink 解决了”怎么映射”的问题,接下来是”何时切换”。这里的设计有两个不对称的判据,一个用于进入,一个用于退出。
进入隐模式:生成 <latent> 特殊 token。 文本模式下 HybridAgent 与标准 LLM 完全一样,逐 token 采样。当它采样出特殊 token <latent> 时,这个 token 就成为隐模式的入口锚点(entry anchor)。从下一次前向传播开始,模型不再走 LM head,而是走 HybridLink。
退出隐模式:余弦相似度条件。
即:把当前隐状态经 HybridLink 映射得到的向量 ,在词表中找嵌入向量最接近它的那个 token ;如果这个最近邻恰好是 <latent>(闭合标签),隐模式就结束,模型回到文本模式。
这两个判据的不对称是刻意的:
- 进入用离散采样,因为进入是一个需要模型主动做的决策——它必须”决定”什么时候值得停止说话、开始内部推演。用采样得到
<latent>,意味着这个决策进入了模型的输出分布,可以被 SFT 与 RL 直接训练。 - 退出用连续相似度判据,因为它不该依赖一次可能在错误时机发生的采样。在隐空间里,模型每步都在产生连续的隐状态,用”这个状态的语义是否已经收敛到’该说完了‘“作为退出信号,比逐 token 采样一个离散标签更稳健,也不会因为一次采样噪声就提前或延后退出。
为什么长度与频率是涌现的
论文特别强调:每个 step,模型自适应地决定留在当前模式还是切换;文本段和隐段的长度与频率是动态涌现的,不遵循预设配置。
这一点值得展开。最容易想到的替代方案是硬编码一个比例,比如”每生成 200 个文本 token 就插入 50 步隐推理”,或者”前 30% 的推理在隐空间完成”。这类固定配比的问题在于:真实推理过程中,“哪一段值得深挖、哪一段只是走个形式”是随问题而变的,固定比例会把算力浪费在不需要深推的位置上,又在需要深推的位置上过早截断。
HybridAgent 把这个问题交给训练去解:SFT 阶段通过自条件训练让模型学会在合适位置进出隐模式,RL 阶段则直接把这一决策纳入策略优化(“何时在隐空间思考、何时通过文本行动”)。用论文的表述,HybridRL 训练的就是这个平衡能力。5.3 节会看到训练动力学上的直接证据——随着训练推进,模型把越来越多的生成从文本模式迁移到隐模式。
连续工作记忆
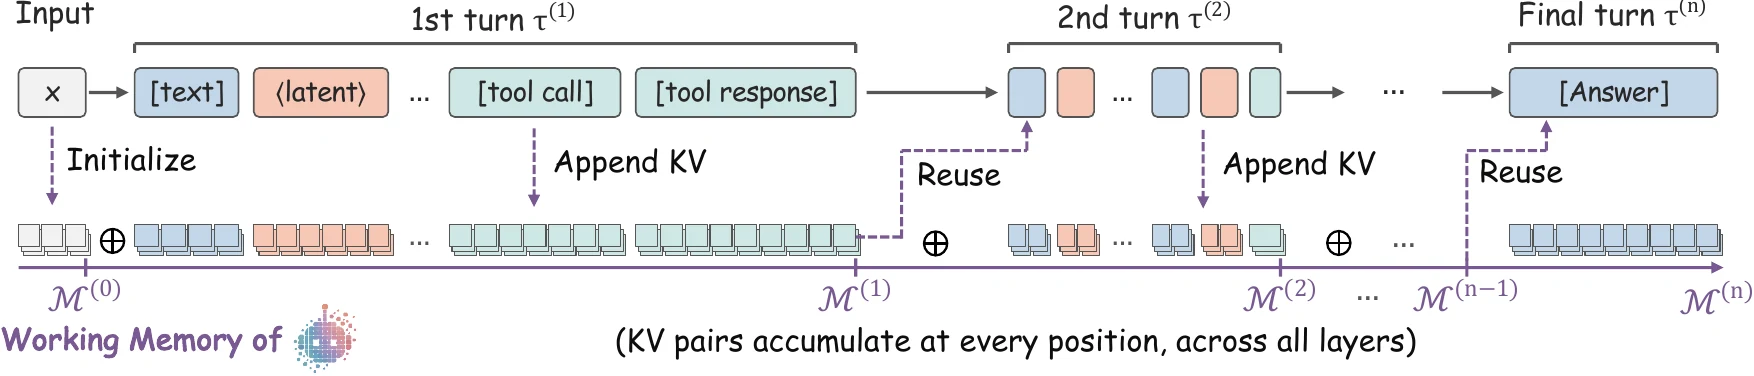
图源:论文 Figure 3(arXiv:2610.18861)。
常规 Agent 的多轮上下文为什么要重建
标准 LLM Agent 一轮结束时做的是:把这一轮生成的全部文本、加上工具返回的结果,拼到输入序列尾部;下一轮开始时,把整个新序列重新送进模型做一次 prefill。这个流程隐含了一个前提——上下文可以只用 token 表达。
混合轨迹打破了这个前提。一条混合轨迹 里同时包含三类内容:模型生成的文本、隐思想(连续向量)、外部工具返回结果(文本)。隐思想那一部分根本无法用常规 tokenizer 重建:它不是任何 token 的嵌入,而是 HybridLink 从 生成的连续向量。如果每轮都要把上下文”还原成 token 再拼回去”,隐思想携带的信息就在这一步丢失了。
一种偷懒的工程做法是把隐思想解码成最近邻伪文本(下一节会讲这个机制),再把伪文本拼回上下文。这样做可行,但代价是:每轮都要重新 prefill 一遍完整历史,信息也有损(伪文本只是最近邻 token,不是原向量)。
用 KV Cache 本身当工作记忆
HybridAgent 的做法是让上下文留在 KV Cache 里,不再做 token 空间重建。
论文给的形式化描述很简单。先定义工作记忆 为按位置顺序累积的 KV 条目:
符号含义: 是输入的初始上下文, 与 是初始上下文在所有 Transformer 层上的 key/value 条目; 表示按位置顺序追加; 是第一轮的完整轨迹, 是它的长度。
关键在于”所有层”和”按位置顺序”这两点: 保存了第一轮完整混合上下文在各层上的 KV,位置编码保持连续,因此后续轮次的注意力可以直接在这些条目上做正常的因果注意力,不需要知道”这一段原来是隐思想、那一段原来是文本”。
这个设计的成立前提是 3.1 节的输入空间统一:文本 token 经嵌入层进输入空间,隐思想经 HybridLink 进输入空间,工具返回结果经嵌入层进输入空间。三者在同一空间里参与前向传播,产生的 KV 条目形式完全一致,所以能毫无障碍地拼在同一份缓存里。这也是”共享输入接口”这个架构决策最大的一处收益——它让混合上下文在存储层面退化为普通上下文。
论文在附录 A 给出了这个续接过程的正式论证(multi-turn continuation over working memory),核心结论是:连续工作记忆无损地保留了完整的混合上下文,不需要中间做过一次 token 空间重建。这里的”无损”是与”解码成伪文本再拼回”的方案对比而言的。
工程上的含义
这个机制对推理系统有直接的工程意义,值得单独点出来:
- 省掉重复 prefill。多轮 agentic 循环中,每轮都把全部历史重算一遍注意力,是实际部署中最贵的一笔开销(历史越长越贵,且随轮数呈平方级累积)。工作记忆把历史保留为 KV,下一轮直接在其上续算,等价于把”多轮 agent”变成”一条长序列的连续生成”。
- 缓存条目布局不再是”纯 token 序列”。KV Cache 里会混有非 token 来源的条目,这对显存管理、持久化(把对话历史存到 CPU/SSD 或远端)以及前缀复用(prefix caching)都提出了新问题:这些条目不能靠 token id 重新生成,一旦被淘汰就只能从轨迹重放得到。存储层面的取舍可参考本站 KV Cache Offloading 完全拆解 中对分层放置与异步流水的讨论。
- 多轮记忆的角色变化。在纯文本 Agent 里,工作记忆基本等同于”上下文窗口 + 摘要策略”;在 HybridAgent 里,它变成了有明确物理载体(KV 条目集合)的状态对象,这一点与 Multi-Agent Memory 完全拆解 里把记忆当作体系结构问题来处理是同一个视角,只是 HybridAgent 的记忆是单模型内、按层展开的。
推理过程逐 token 展开
前面几节讲的是架构与数据流,这一节把一次完整的混合生成拆成逐 step 的执行序列,这是理解”隐模式到底省了什么”最直接的方式。
文本模式的 step
与标准 LLM 完全一致:
- 输入序列(嵌入向量 + 位置编码)进入各层 Transformer;
- 取出最后层隐状态 ;
- 经 LM head 得到词表 logits,采样得到 token ;
- 的嵌入向量 成为下一步的输入, 对应的 K/V 条目追加进工作记忆。
如果采样到的 是 <latent>,则它作为进入锚点,下一步切到隐模式。
隐模式的 step
- 输入序列进入各层 Transformer(这一步与文本模式完全相同,因为输入向量已经统一在嵌入空间);
- 取出最后层隐状态 ;
- 经 HybridLink 得到 ,不经过 LM head、不采样、不查词表;
- 直接成为下一步的输入, 的 K/V 条目同样追加进工作记忆;
- 检查退出条件: 是否为
</latent>;若是,则回到文本模式。
省掉的是什么,以及为什么这很重要
对比两段流程,隐模式的每一步省掉的是三件事:词表投影(LM head)、softmax 采样、嵌入层查询。
LM head 的计算量是 。Qwen3 一类的模型词表规模在 15 万量级,隐藏维度 4096 上下,这个矩阵乘在每一步生成中都要做一次,在长思维链里累积起来是一笔可观的成本——它的规模甚至可能超过注意力部分。而隐模式把这三步合成为一次 HybridLink 映射:两次矩阵乘,瓶颈维度远小于词表规模。
更本质的收益在深度上:一次前向传播携带的信息量,从”一个离散 token 的嵌入”变成了”一个 维连续向量”。文本模式下,模型的每一步推理被压缩进一个 token,表达力受限于词汇表与采样;隐模式下每一步都在完整维度上传递语义,同样的参数预算可以做更多轮”无损耗的思考”。论文把这一点概括为 sequence-wise recurrent computation over continuous representations——在连续表示上做逐序列的递归计算,从而扩展 Agent 的有效推理深度。
需要强调:省掉的这三件事不改变注意力和前馈网络的计算,因此隐模式不是免费的——每一步仍然是一次完整前向传播。它省的是解码与再嵌入的开销,以及用更少步数表达同等推理深度的机会成本。这也是为什么后续实验结果里的加速倍数是 1.8–2.6 倍,而不是数量级。
隐思想的可读化
论文报告了一个在设计时并未专门追求、但极具实用价值的性质:隐模式保持免解码的同时,依然可以直接被解读。
解读方法是复用退出判据里的那一步:对隐模式中的每一个 step,把 映射到词表上最近的 token 嵌入,取那个最近邻 token。把整段隐推理的每一步最近邻 token 串起来,就得到一段可读的伪文本(pseudo-text),它承载了这段隐思想的大致语义。
这个性质的价值在于它同时补上了隐空间推理路线长期的两个缺口:
- 训练时可监督。伪文本让研究者能检查模型在隐空间里”想”了什么,判断训练信号是否落在了正确的位置上。
- 推理时可审计。出现错误结论时,可以把对应的潜思想还原出来看是哪一步偏离了方向;监管场景下也能对内部思考做实质性检查,而不是只能看到一个黑箱。
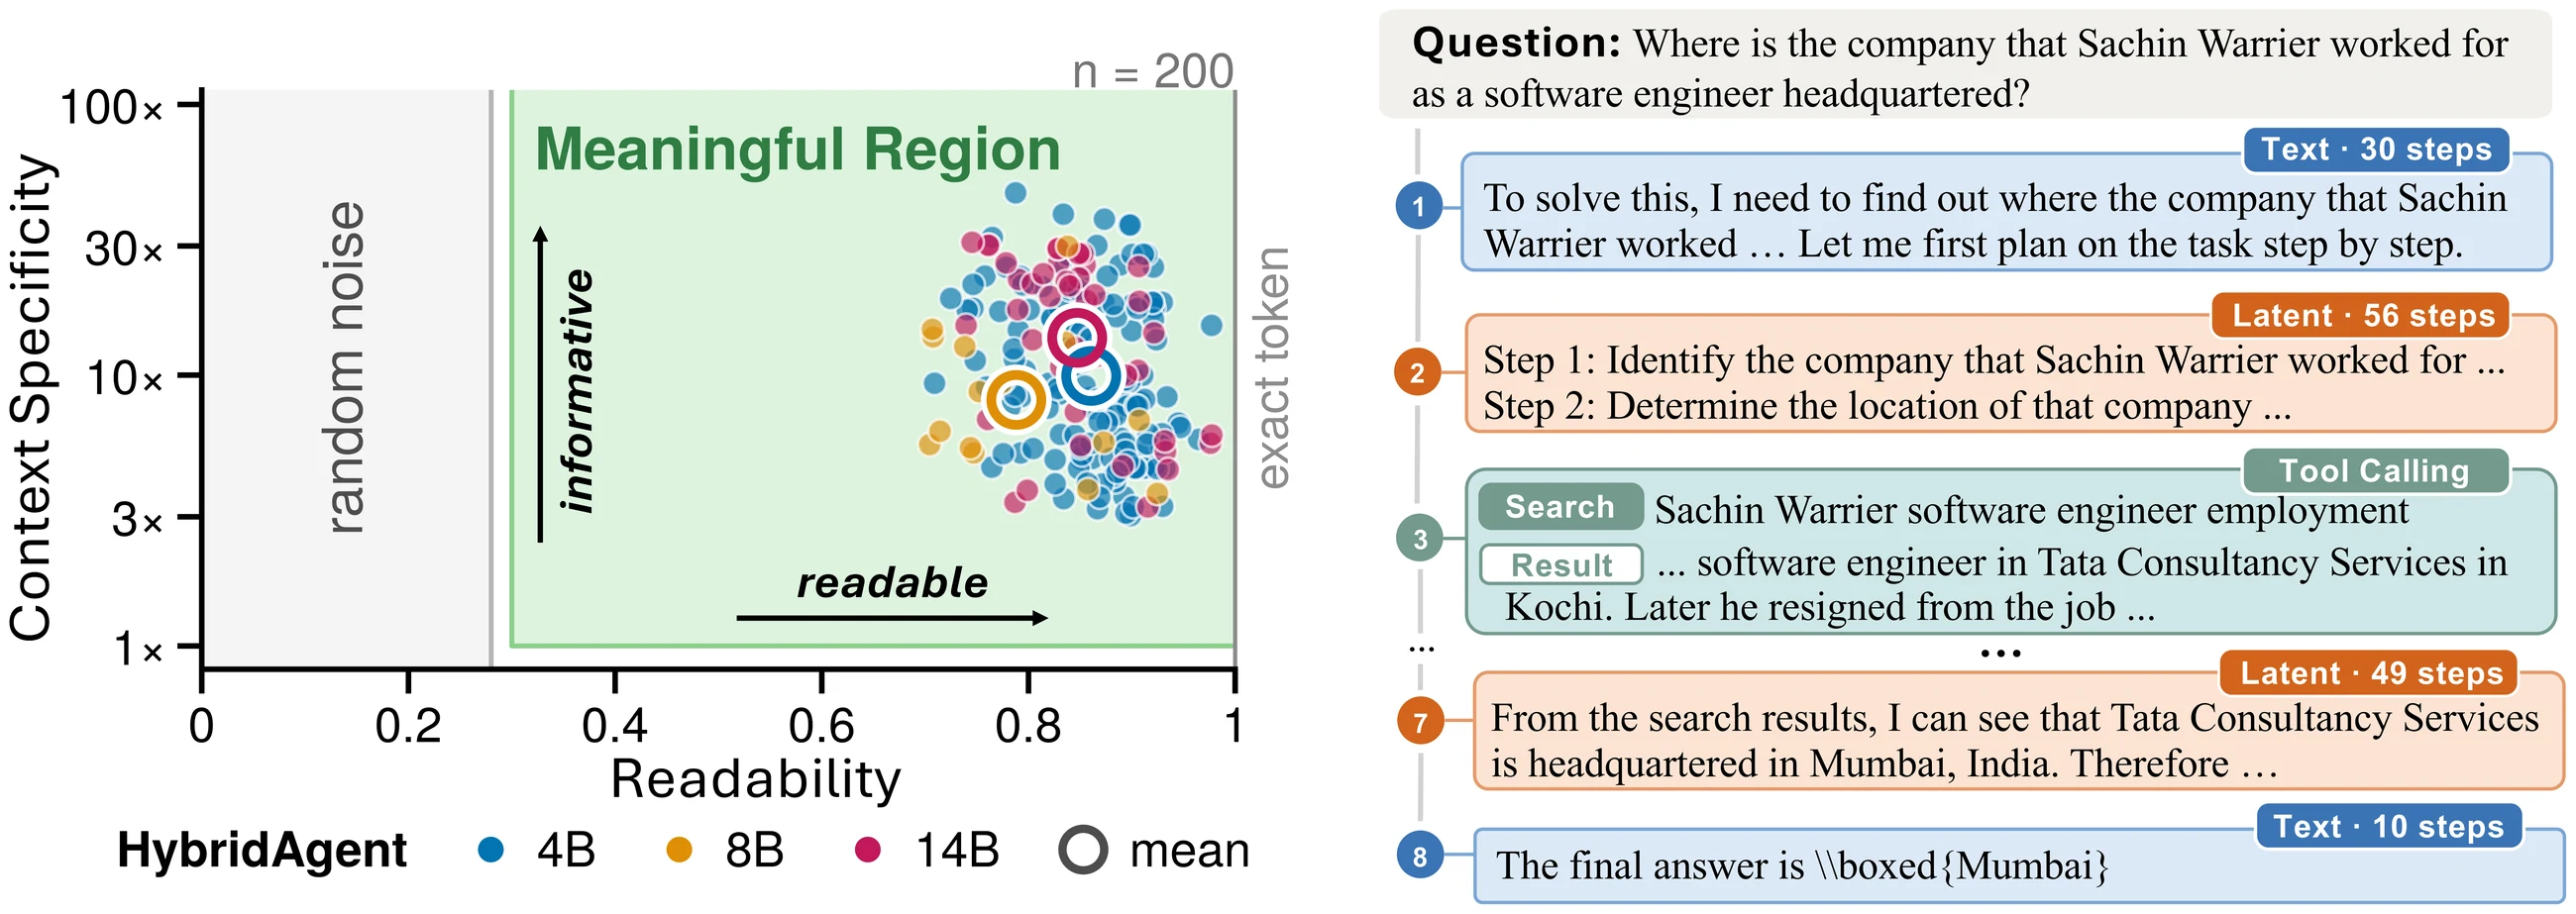
图源:论文 Figure 2(arXiv:2610.18861)。
从图中可以读出两条信息。左图的统计口径是:隐思想的语义是否高度可读、且是否与当前上下文强相关——如果最近邻 token 落在高频虚词上,说明隐状态没有承载有效语义;如果最近邻 token 与周围文本和工具调用语义一致,说明这段隐思想确实在做与任务相关的推理。右图给出的是定性对照:把一段混合轨迹里的隐伪文本抽出来,与它前后的文本推理、工具调用放在一起,可以看到语义是连贯的——隐模式不是在”另起一段无关的思考”,而是在延续同一条推理链。
混合推理的后训练机制
HybridAgent 不改主干架构,因此不需要从头预训练;它把标准 agentic 后训练管线(SFT + RL)适配到混合设定上。两个阶段分工明确:SFT 教模型与 HybridLink 协同、并把工具调用行为稳定下来;RL 进一步训练”何时隐空间思考、何时文本行动”的平衡能力。
HybridSFT:自条件训练如何消除训练-推理错配
第一个要解决的问题是 train-inference mismatch,论文把它归因为 exposure bias。
具体机制是这样的:
- 训练时(teacher forcing):模型在第二步以后的输入,用的是真实标注的隐嵌入 ——也就是从数据里拿到的、正确的隐思想对应的向量。
- 推理时(free-running):模型必须消费自己 HybridLink 产生的隐状态 。
训练时见到的向量与推理时实际拿到的向量分布不同,模型在训练中学到的”如何解读输入隐向量”的能力,在推理时会失准。这就是 exposure bias 在混合设定下的具体形态——不是经典的”预测下一 token 时用了真值 token”,而是”预测下一隐步时用了真值隐向量”。作者在附录 B 的第 B.1 节专门论证了为什么必须自条件训练。
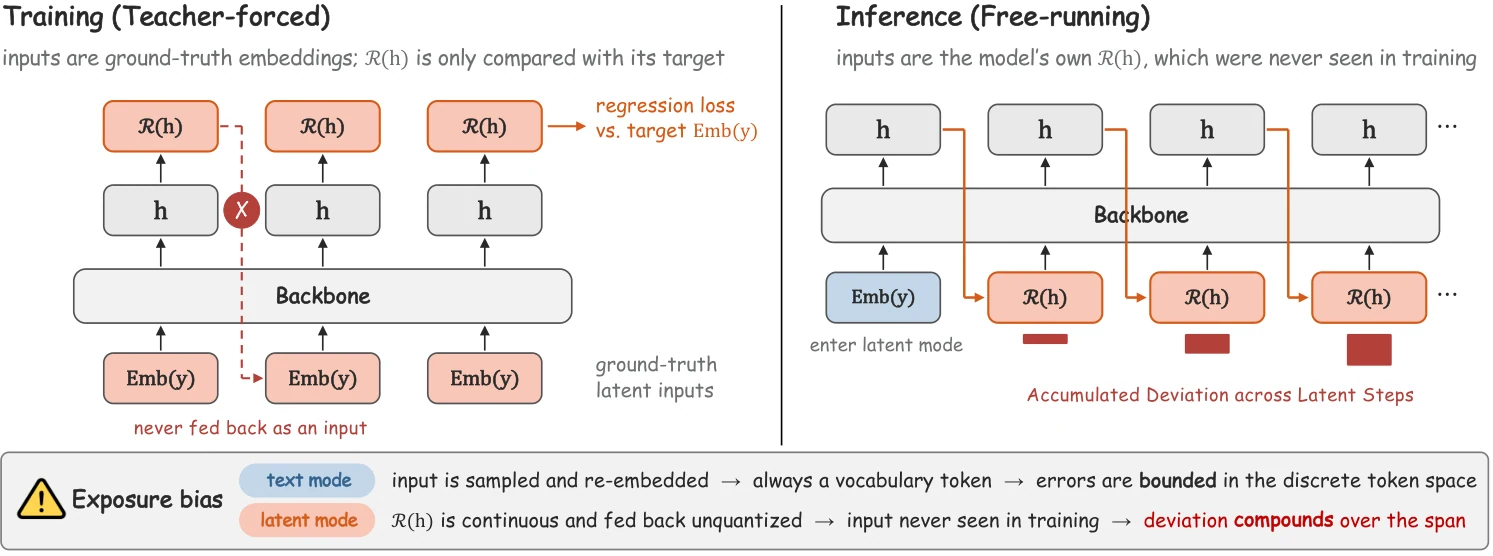
图源:论文 Figure 11(arXiv:2610.18861 附录)。图中左侧是训练阶段的激活路径,右侧是自由运行时的路径,两者在隐步输入来源上的差异就是错配的来源。
两阶段自条件训练。 论文给出的解法是 Self-Conditioned HybridSFT,用两遍前向传播完成一次训练步:
- 第一遍(teacher-forced):用标注数据跑一次前向,沿途通过 HybridLink 产生每一步的潜在输入预测。这一遍的作用是造出自产的隐输入,而不是直接拿标注隐嵌入;
- 第二遍(自条件):把第一遍产生的预测 替换掉标注隐嵌入 作为第二遍的输入,在这一遍上计算损失并更新。
这样做的效果是:主干在训练中看到的隐输入,分布与推理时会遇到的一致,错配被消掉。代价是每次训练步要多跑一遍前向(第一遍只为生成输入),这是纯工程上的开销。
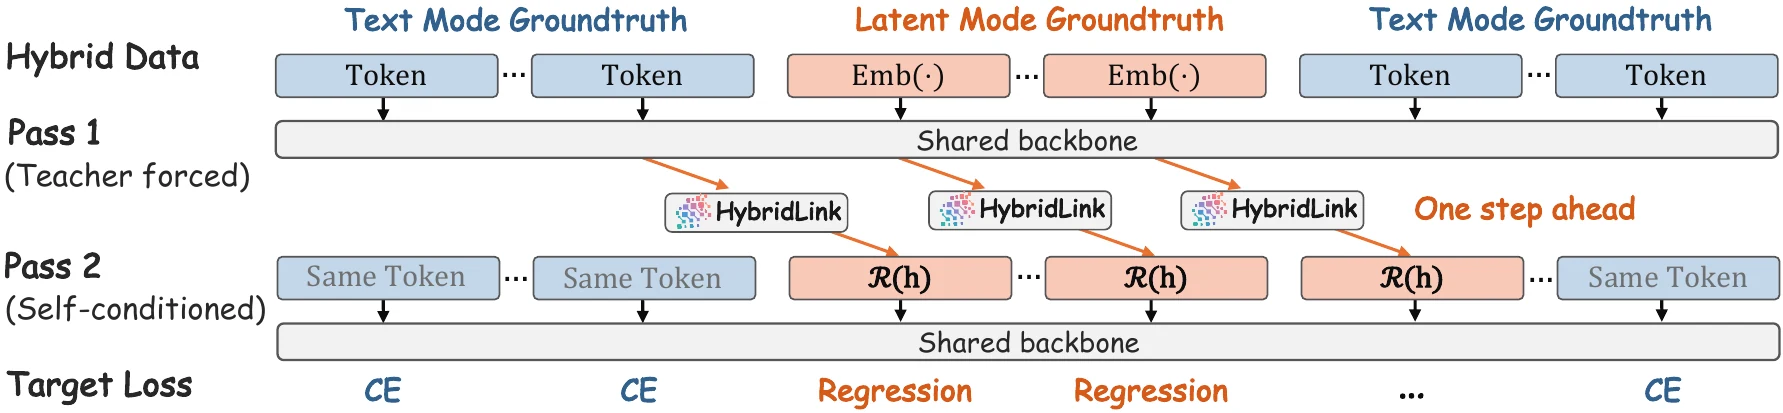
图源:论文 Figure 4(arXiv:2610.18861),经官方仓库素材重绘。
数据从哪来。 HybridSFT 需要混合轨迹作为监督数据——54K 条自动标注的混合轨迹。这些轨迹不是人工编写的,而是由一个数据策划管线从纯文本示范转换而来:用 LLM 判断与模型熵两路互补信号,给每一段推理分配模式(该段走文本还是走隐空间),再据此构造出多轮混合轨迹。
用模型熵作为分配信号是一个有意思的取舍。熵高意味着模型在该处不确定、有多种可能的延续,这类位置适合放在隐空间里做内部推演(不需要把每种可能都摊成文本);熵低意味着延续几乎是确定的,放在文本里解码开销小、也便于审计。LLM 判断则补上熵信号看不出的语义层面的判断(比如”这里是不是需要调用外部工具”)。
效果量级。 论文报告 HybridSFT 的分阶段效果:在 MATH500 上从 47.0 提升到 84.2。表中把连续的 HybridSFT 阶段与同规模(Qwen3-14B-Base 主干)的纯隐空间、纯文本训练基线做了对照,说明提升来自混合训练本身,而不仅是训练步数增加。
HybridRL:把策略似然分解到文本位置
SFT 能让混合生成稳定并可用工具,但它不能回答”何时该隐、何时该显”这个平衡问题——因为 SFT 只是在模仿数据里的模式分配,没有对”这样分配好不好”做优化。HybridRL 补的就是这一步。
分解策略似然。 在混合轨迹上做策略优化有两个技术障碍:
第一,轨迹里的隐思想不是离散动作,常规的 token 级策略梯度无从下手。论文的解法是 hybrid policy factorization——把混合策略的似然完全分解到文本位置上。也就是说,策略梯度的更新只从文本 token 的似然上取,隐思想作为上下文的一部分被”边缘化”掉。这样既保持了优化目标的良定义性,又不需要为连续动作定义概率密度。附录 C 给出了这个分解的完整形式化(C.1 Hybrid Policy Factorization 与 C.2 Hybrid Policy Optimization)。
第二,策略更新通常要为 rollout 重建一份可微的计算图。在混合设定下,重建时不仅要重算文本 token 的似然,还必须让这些似然以 rollout 时完全相同的隐思想为条件——因为隐思想是主干在前向中产生的,重建过程如果重新跑一遍 HybridLink,得到的隐向量会与 rollout 时不同,导致似然口径不一致。
精确 rollout 重放(exact rollout replay)就是为此设计的:rollout 阶段把隐思想连同采样出的文本 token、工具观察一起记录下来;策略更新阶段在嵌入空间里做一次单一可微前向,把完整混合轨迹重放一遍,其中记录的隐输入保持不变(不重算),只重算采样位置的似然。这样既满足了可微性要求,又保证了训练数据与推断过程的一致。
奖励设计。 论文对 HybridRL 的奖励做了消融(Table 4)。奖励需要同时覆盖两个方向:任务完成的质量,以及模式分配的效率(隐模式用得是否恰当、工具调用是否有效)。消融的目的正是确认这两类信号各自是否必要——去掉效率侧的信号,模型会倾向用更多文本 token 完成任务,效率收益消失;去掉质量侧信号,压缩率上去了但准确率掉下来。
训练动力学上的证据
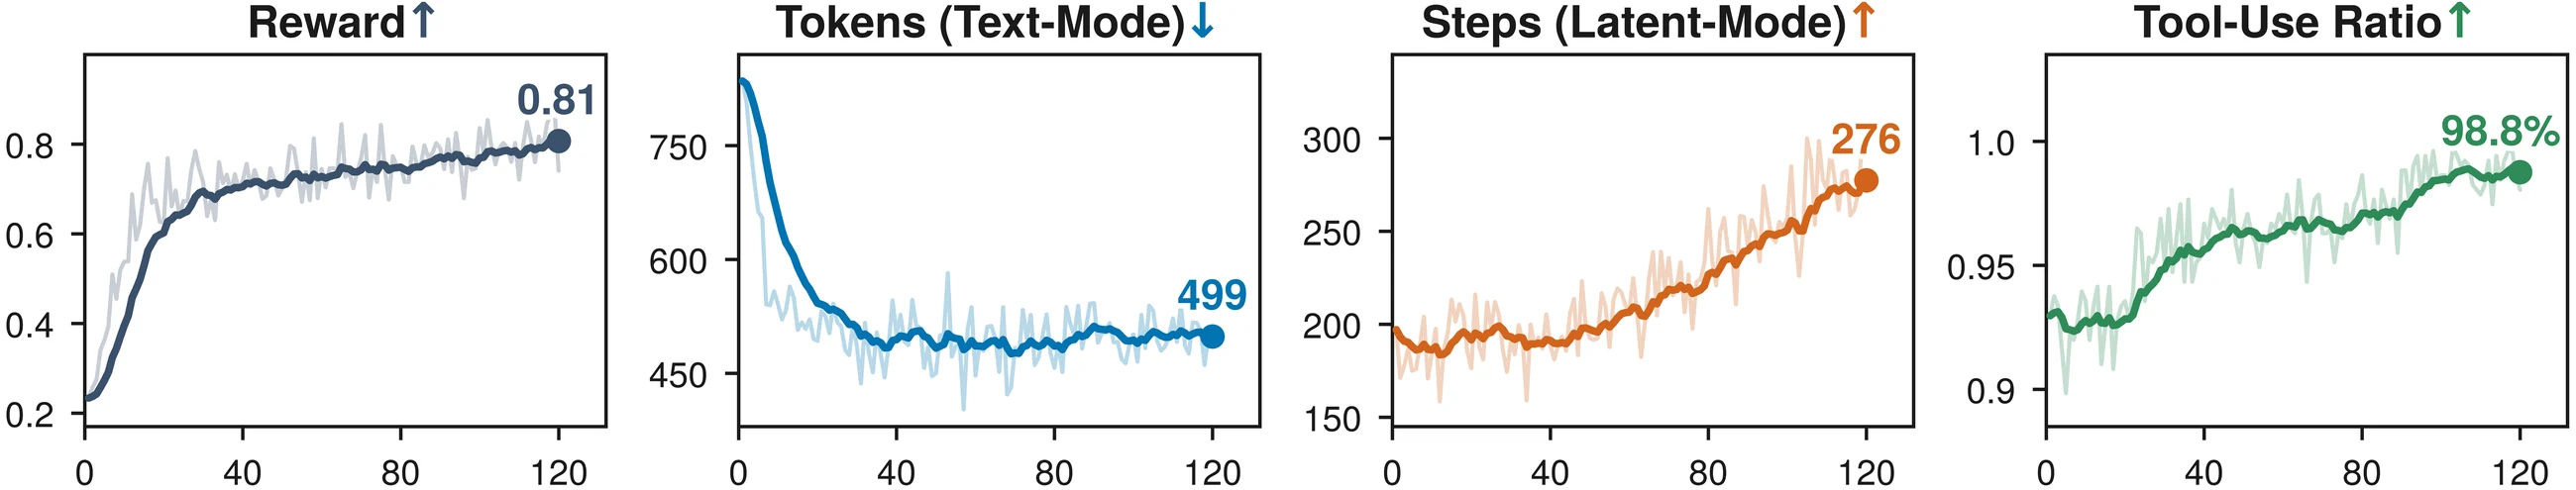
图源:论文 Figure 9(arXiv:2610.18861)。
图中三条曲线的同步变化值得逐条读:随着训练步数增加,从文本模式迁移到隐模式的生成比例上升(模型学会了更激进地在内部推演)、奖励上升(模式迁移确实带来了更优的任务表现,而不是单纯压缩 token)、工具使用量上升(模型并没有因为”多想”就”少做”,工具调用行为反而更积极)。这三者同时上升是这篇工作最关键的一个经验证据:高效的内隐推理与可靠的工具调用不是二选一的取舍,训练可以同时把两者推上去。
实验与结果
实验设置
- 主干:Qwen3-Base,三个规模 4B / 8B / 14B;
- 基准:11 项,覆盖数学、科学、医学、知识密集型搜索与 agentic 推理。agentic 侧包括 GAIA、WebWalker、HLE、SealQA、DSQA;数学与知识密集型搜索侧包括 AIME25/AIME26 等,小样本基准(如 AIME)用 avg@16 口径报告准确率;
- 对照:前沿 LLM Agent、agentic 框架,以及同等规模的文本 Agent 与隐空间推理基线(matched text and latent baselines);
- 统计口径:5 次独立运行,HybridAgent 的准确率平均标准差 ±0.014,对应 95% 置信区间 ±0.017。
主要结果
论文的核心汇总数字是:相较前沿 LLM Agent 与覆盖文本、隐空间两条路线的 agentic 框架,平均性能提升 10.4%。在 agentic 推理任务的 8B 与 14B 规模上,HybridAgent 稳定优于先进 LLM Agent、agentic 框架以及同规模文本/隐空间基线。14B 版本在 agentic 推理基准上领先最强基线 17.4%。
规模维度的结论同样重要:三个规模上一致有效,说明这套机制不是只在某个特定容量模型上成立的偶然现象。
效率收益
效率侧的三个数字是本篇最常被引用的部分:
- token 生成减少 35.5%–54.7%:相比同规模文本 Agent,完成同样的任务需要的生成 token 数大幅下降。这部分正是隐模式把中间推理”折叠”进连续向量带来的;
- 推理加速 1.8×–2.6×:反映到端到端延迟上。加速倍数小于 token 削减幅度,说明隐模式的每一步仍要付一次完整前向的代价——省的是解码与再嵌入,不是整个 step;
- 成本节省 2.7×–3.7×:成本倍数高于加速倍数,因为成本还包含了被省掉的注意力与前缀重算(工作记忆避免了重复 prefill),以及更短的上下文带来的显存收益。
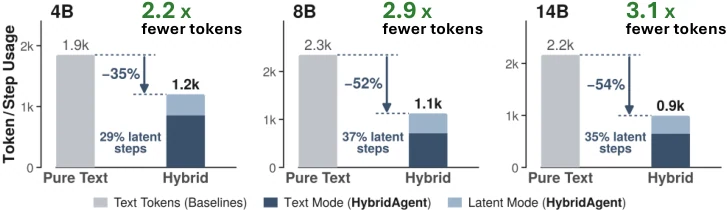
图源:论文 Figure 6(arXiv:2610.18861)。
图里两条曲线(文本 token 用量、总生成步数)在三个规模上都低于对齐的文本基线,且规模越大差距越明显——这与”隐模式的价值随推理深度增长”的预期一致。
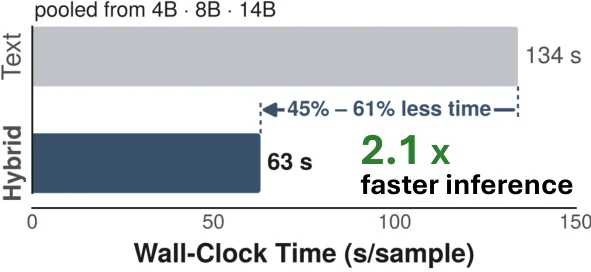
图源:论文 Figure 7(arXiv:2610.18861)。
测试时扩展
混合推理保留了文本模式,因此在推理时依然可以走 pass@k 的扩展路径:采样多次、挑最好的结果。论文在 100 道硬数学与科学题上评了 pass@k(k = 4, 8, 16, 32, 64),并与用 GRPO 训练的文本 Agent 做对照。
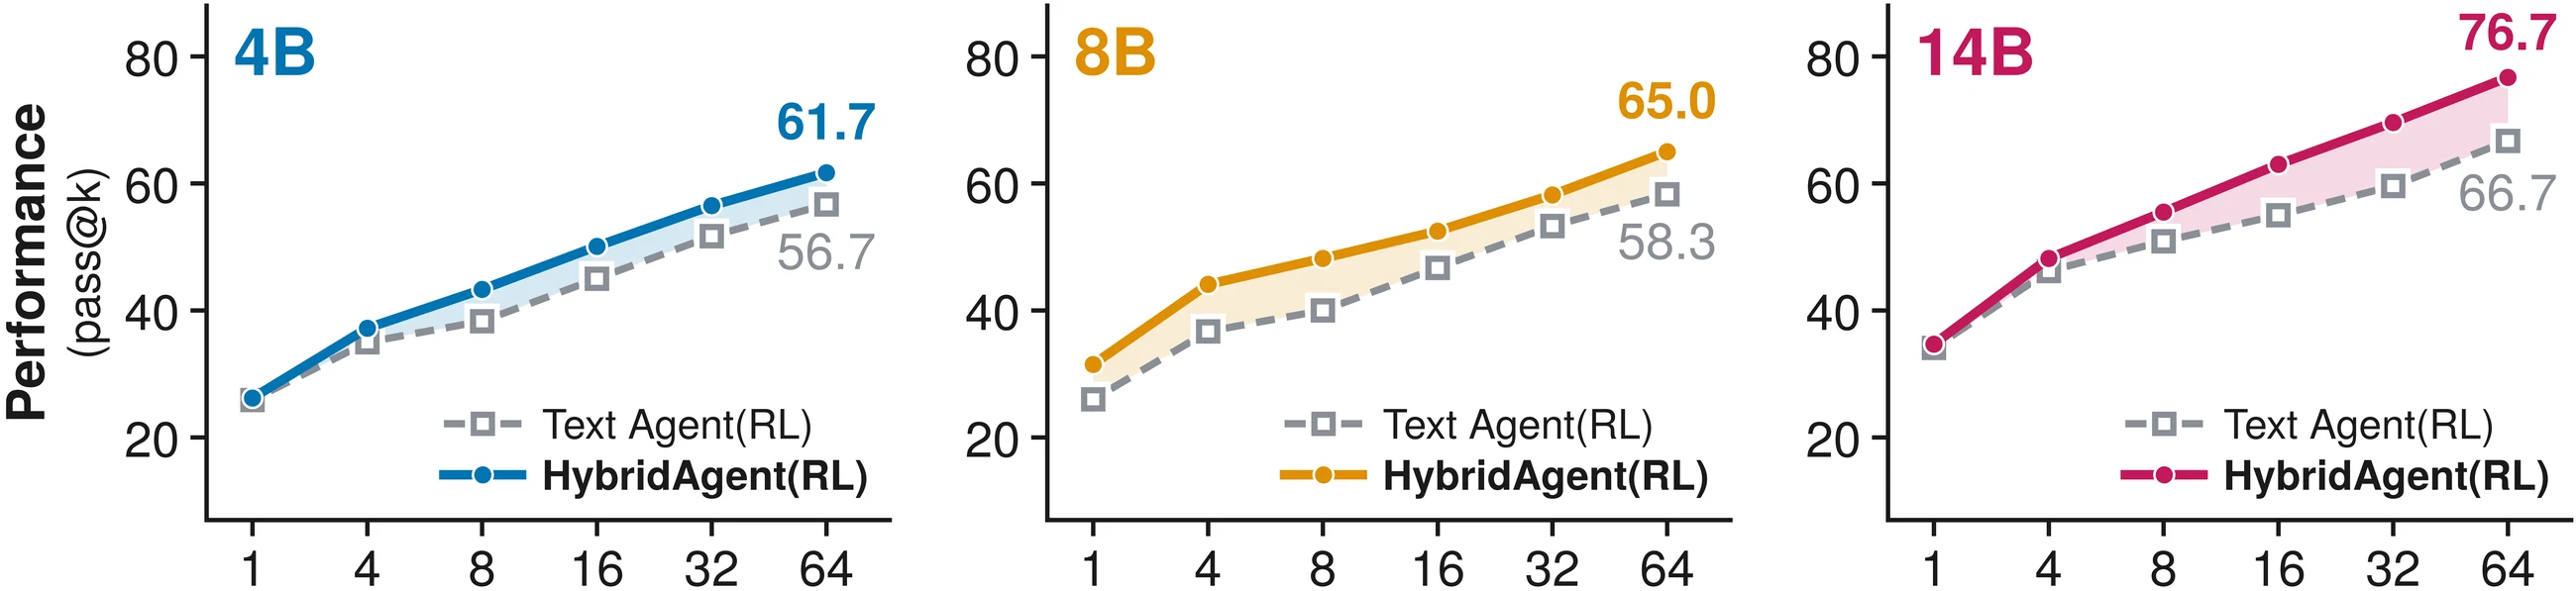
图源:论文 Figure 5(arXiv:2610.18861)。
这张图回答的是”隐模式是不是用牺牲探索能力换效率”这个质疑。如果隐推理压缩了推理的多样性,它应该在高 k 值上被文本 Agent 追上。图中 HybridAgent 在全部 k 值上保持优势,说明隐模式压缩的是冗余的中间表述,而不是答案空间的多样性——这一点对 agentic 场景尤其重要,因为 Agent 需要多次尝试才能找到正确的工具调用路径。
消融与因果分析
论文对几个关键设计分别做了消融,这些结果比主结果更能说明”哪个部件真正在起作用”。
HybridLink 的架构选择(Table 6)。论文把 HybridLink 与若干替代架构设计做了对照。消融的价值在于验证 3.1 节那个”残差 + 薄瓶颈”取舍是否真的必要:如果把残差去掉,或者把映射器换成更强的结构,准确率会发生什么变化。结论支持了原文的设计逻辑——映射器只需要负责分布对齐,把容量堆在映射器上不会换来更好的结果。
隐模式的因果依赖(Table 5)。这是最有说服力的一组实验:对隐模式中产生的隐思想施加不同干预,然后看 MATH500 准确率的变化。干预在两个规模(8B、14B)上分别做,准确率出现大幅下降。这组结果的意义在于把”隐思想确实在承载推理”从解释性主张变成了因果证据——如果隐模式只是装饰性的,干预它不应该显著影响最终答案。(注:具体的干预方式与逐项数值请以论文 Table 5 原文为准,本文不转述未经核对的细粒度数字。)
HybridRL 奖励项的必要性(Table 4)。去掉效率侧奖励,模型会退回更接近文本 Agent 的行为;去掉质量侧奖励,压缩率上升但准确率下降。两项都是必要的,不存在”只要一项就够”的简并情况。
工具使用的可靠性(Figure 10)。论文单独统计了 8B 与 14B 规模上的有效工具调用率,并在有效调用中统计”执行成功”(无错误执行)的比例,同时评估了需要工具才能回答的问题上的最终答案准确率。这组数据回答了”混合推理会不会损害工具调用的结构化能力”这个最直接的担心——从结果看,HybridAgent 的工具调用可靠性保持在可用水平,且随规模提升。
工程与推理服务视角
论文主要在算法层面展开,但 HybridAgent 的几个机制对推理系统有相当直接的工程含义,值得单独整理。
混合输入的调度问题
3.1 节说明了文本与隐模式共享输入空间,但论文也明确点出了混合生成的难度来源:它必须同时处理 dense continuous vectors 与 sparse discrete tokens 这两类本质不同的输入。
从服务系统的角度看,这意味着同一段生成序列里会出现两种”step”:
| 维度 | 文本模式 step | 隐模式 step |
|---|---|---|
| 输入来源 | 嵌入层查表(离散 → 连续) | HybridLink 映射(连续 → 连续) |
| 输出路径 | LM head → 采样 | HybridLink 直接回注 |
| 是否可中断 | 可以(token 边界明确) | 不可以(隐段内无离散边界) |
| 是否可缓存复用 | 可以(按 token 前缀) | 不可(需保留向量或重放) |
中间两行是调度上最需要注意的差异。隐段内部没有可中断点:一段隐推理在语义上是一个整体,中途停下来没有天然的恢复状态(不像文本可以按 token 边界切分并在之后重新 prefill)。这对抢占式调度(preemption)与 chunked prefill 的实现提出了新要求——调度器需要能识别隐段的边界,并把整段当作不可切分单元来处理。
前缀复用也受影响。文本 Agent 的标准做法是把请求前缀做成 KV 缓存复用(prefix caching),靠 token id 匹配即可命中。混合轨迹的前缀里含有无法由 token 重建的隐向量,无法靠 token 序列匹配来复用,必须额外存储向量本身,或者在命中时通过重放重建。这与工作记忆的持久化需求是同一个问题的两面。
计算图与 kernel 层面
- LM head 的缺席。隐模式跳过词表投影,这一步在词表规模大时是生成阶段的主要矩阵乘之一。对自研 kernel 的实现者而言,隐段内的 kernel 序列是”attention + FFN + HybridLink”,文本段内是”attention + FFN + LM head + sampling”,两套序列需要在一个统一的执行循环里切换。
- HybridLink 的 kernel 规模很小。两层 MLP、中间维度刻意压薄,它的计算量相对主干可以忽略,但它是每步都要执行的——在长隐段里它的累计开销不可无视。把它融进主干 FFN 的尾部,或者与下一步的位置编码相加融合成单个 kernel,是自然的工程优化方向。
- 位置编码的连续性。工作记忆要求”按位置顺序”累积 KV 条目,隐步必须占用连续的位置 id。这一点在多轮接力时容易被忽略:如果隐段与文本段的位置 id 处理不一致,工作记忆里的因果结构就会出错。
显存与存储
隐模式带来的显存侧变化是双向的:
- 利好:token 生成量减少 35.5%–54.7%,上下文长度随之下降,KV Cache 的规模压力缓解;
- 新负担:工作记忆里的隐向量条目必须原样保留(或可重放地保留),不能像纯 token 缓存那样靠 token id 再生。对长时间运行的多轮 Agent 而言,这部分的持久化与淘汰策略需要单独设计。
论文在附录 G.2 做了成本分析(Cost Analyses),口径与前面的 2.7×–3.7× 成本节省一致。它的成本模型里同时计入了被省掉的生成与避免掉的重复 prefill,这两个来源的占比会随轮数变化——轮数越多,工作记忆带来的收益越显著。
与其他推理侧优化的关系
HybridAgent 优化的维度与常见的推理侧技术是正交的,这一点值得说清楚:
- 它与 KV Cache 量化、注意力稀疏化(如本站 DoSA 完全拆解 讨论的精确稀疏索引)不冲突——这些都是让单步更便宜,而 HybridAgent 是让步数更少、每步携带信息更多;
- 它与投机解码的关系更微妙:投机解码用小模型草拟、大模型验证来摊薄解码成本,其收益高度依赖”被草拟的 token 大模型会接受”;隐模式则直接取消了这些 token 的产生。两者是否可叠加、叠加后收益如何分配,论文没有涉及,是值得后续探索的方向;
- 它与连续/离散表示的统一这条路线(隐空间推理、连续思维链)是同一条线上的推进,HybridAgent 的贡献是把这条线从”能推理”推进到”能作为 Agent 行动”。
局限与开放问题
论文本身没有单列局限章节,但从机制细节和实验口径里可以读出若干尚未解决的问题,这里列出并标注哪些是论文明确的、哪些是分析性的推断。
明确写在论文里的边界:
- 混合输入的异质性处理是核心难点。论文原文把这列为构建这类 Agent 的主要 hardness——需要同时处理 dense 连续向量与 sparse 离散 token 两类输入。架构上的解法已经给出,但复杂度的根源没有被消除。
- 主干不改,能力上限继承自主干。HybridAgent 不从头预训练,所有效果建立在 Qwen3-Base 的能力之上。这意味着它在主干本身能力不足的语言、领域上没有额外增益来源。
- 自条件训练带来两遍前向的开销。HybridSFT 每步需要跑两遍前向,这是训练侧的确定代价。
分析性的观察(论文未直接讨论):
- 隐段的可中断性缺失会影响服务质量。如前所述,隐段内没有离散边界,长隐段在服务系统里表现为一段不可抢占的执行窗口,对尾延迟(tail latency)的影响需要实测。论文报告的 1.8×–2.6× 加速是平均口径,没有给出延迟分布。
- 伪文本解读的保真度有上限。最近邻 token 是对连续向量的粗粒度投影,它能反映大致语义方向,但无法还原向量承载的全部信息。把它当作审计工具是有效的,把它当作”完整还原模型的思考”则高估了它。
- 模式分配策略的可迁移性未知。数据策划管线依赖 LLM 判断与模型熵两路信号来分配模式。这套信号对训练语料的分布敏感,换到差异较大的领域时是否需要重新校准,论文没有给出跨域实验。
- 评测集中于推理与搜索类任务。11 项基准覆盖数学、科学、医学、知识密集型搜索与 agentic 推理,但不包含需要长程操作(多步代码执行、交互式环境)的任务,隐模式在这类任务上的收益与代价尚不清楚。
小结
把这篇论文的机制收拢成几句话:
架构上只加了一个部件。 HybridLink 是一个带残差的薄瓶颈 MLP,参数量约 (4B 模型约 10M),作用是把最后层隐状态从隐表示空间映射回输入嵌入空间。它的存在使得文本嵌入与隐向量落在同一个输入接口上,Transformer 对两者一视同仁。这个”统一输入接口”是整个设计的支点:它同时让模式切换成为可能、让 KV 条目能在同一份缓存里混合累积。
两个判据控制模式切换,且不对称。 进入靠采样出 <latent> 特殊 token(一个可被训练的离散决策),退出靠 在词表上的最近邻是否为 </latent>(一个稳健的连续判据)。文本段与隐段的长度、频率由模型自己决定,是训练涌现的结果而非预设配置。
上下文留在 KV Cache 里。 工作记忆 是按位置顺序累积的 KV 条目集合,覆盖所有 Transformer 层。文本、隐思想、工具观察三者在同一输入空间里产生形式一致的条目,因此可以无损地拼在同一份缓存中,跨轮直接复用——省掉的是每轮重建上下文的重复 prefill。
后训练分两段解决两个不同的问题。 HybridSFT 用两阶段自条件训练消除训练-推理错配(主干在训练时消费自己 HybridLink 产出的隐输入,而非标注隐嵌入),把工具集成生成稳定下来;HybridRL 用混合策略分解(似然只从文本位置取)+ 精确 rollout 重放(重放时保持记录的隐输入不变)在完整混合轨迹上做策略优化,训练模型在隐空间思考与文本行动之间做平衡。
结果是”两件事同时变好”而非取舍。 三个规模(4B/8B/14B)、11 项基准上平均性能提升 10.4%,同时 token 减少 35.5%–54.7%、推理加速 1.8×–2.6×、成本节省 2.7×–3.7×。训练动力学曲线显示,往隐模式的迁移、奖励上升、工具使用上升是同步发生的——高效内隐推理与可靠工具调用可以统一,而不是二选一。
对推理侧系统的意义:HybridAgent 走的是与”让每一步更便宜”(量化、稀疏注意力、更快的 kernel、投机解码)不同的一条路——让推理的步数更少、每步承载的信息更多。这两条路正交,理论上可以叠加;而它带来的新工程问题(隐段不可中断、隐向量条目不可由 token 重建、前缀复用的匹配方式改变)恰好落在推理服务系统的调度与显存管理这两个核心模块上。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



