


TokenRouter 完全拆解:把 LLM 请求拆成 Token 级动态路由的高效推理服务
从请求级路由到 Token 级路由
模型路由通常发生在请求进入服务端的那一刻:路由器判断问题难度,把整条请求交给小模型或大模型,之后不再改变执行者。这个粒度容易部署,却把一条回复内部的难度变化压成了一个二元决定。数学推导中的关键转折可能只占十几个 token,格式化结尾和普通连接词却占据大量生成步;把整条请求都交给大模型,会为容易片段支付同样昂贵的计算。
Token 级路由把决策点移到每次解码之后。当前模型得到 logits、隐藏状态或采样 token 后,路由策略判断下一步仍由本模型执行,还是把控制权交给另一个模型。小模型可以承担大部分平坦、低不确定性的片段,大模型只处理推理路径容易分叉的位置;也可以让多个专长互补的模型在同一条回复里轮流接管。这里的“路由”不同于 MoE 在单个模型内部选择专家:被选择的是各自拥有完整权重、KV Cache 与调度器的独立模型实例。
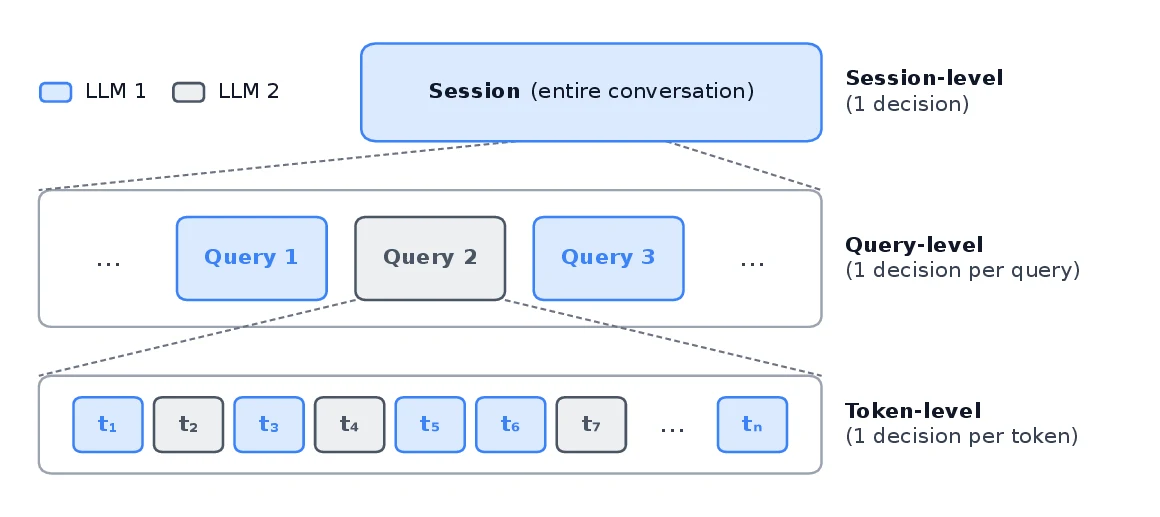
图 1:会话级、请求级与 token 级路由。前两者只在粗粒度边界选择模型,token 级路由可以在生成序列内部反复切换。来源:TokenRouter 论文。
算法层面的收益并不自动转化为服务收益。以 R2R 为例,论文指出它可以在匹配 32B 模型质量的条件下,只把约 5% 的 token 交给 32B 模型;若按整条问题路由,则约需把 40% 的请求交给大模型。理论账本看起来很漂亮,但一次回复可能发生数十到数百次交接。若每次交接都重新发送完整上下文、做前缀匹配、分配 KV 页并等待目标模型当前 batch 结束,系统开销会吞掉节省的模型计算。
TokenRouter 由清华大学团队在 2026 年 10 月公开,并被 NeurIPS 2026 接收。它解决的正是这层“算法已经决定把哪个 token 交给谁,系统怎样高效执行”的问题。它不绑定某一种路由策略,而是提供统一的 route()、send()、receive() 接口,支持 R2R、CITER、Co-LLM、R-Stitch、GlimpRouter 以及多模型路由。其设计原则可以压缩成一句话:请求中心编程,模型中心执行。
这句话划开了两个视角:
- 策略开发者沿着一条请求的时间线思考:解码、判断、发送、接收、继续。
- 运行时按模型组织工作:每个模型拥有自治的子服务器,只批处理当前应该在本模型上运行的请求。
这项分离是全文的主线。TokenRouter 的贡献不是让路由器“更聪明”,而是避免服务系统把聪明的路由策略执行得很笨。
问题建模:真正被路由的是什么
设系统中有 个候选模型,生成序列为 。在第 个位置,路由策略选择模型索引 ,被选模型基于共同前缀生成或修正下一个 token:
其中 是输入提示, 是已提交的输出前缀。路由策略本身可能读取置信度、熵、隐藏状态、额外分类器输出或多个模型的融合权重。TokenRouter 不规定 如何产生,它只要求每次前向后能给出目标模型。
“生成一个 token”不等于“提交一个 token”
这是理解系统状态的第一个关键点。小模型发现当前 token 不可靠时,可能把刚生成的 token 丢掉,让大模型从前一个位置重生成。此时小模型完成了一次前向,却没有向用户提交新 token。反过来,一些协作算法可能保留当前 token,只让同伴从它之后继续。因而一次转移需要同时描述:
- 当前执行模型 ;
- 目标模型 ;
- 发给目标模型的最短 token 后缀;
- 这次转移实际提交的 token 数 ;
- 目标模型已看到前缀的截止位置。
例如 R-Stitch 在小模型输出熵超过阈值时,把控制权交给大模型,并从发送序列中删掉这个高熵 token。大模型收到的是“可信前缀”,负责重生成不确定位置。若不区分生成与提交,服务端可能重复输出、漏掉 token,或者让两边 KV Cache 对应到不同的逻辑位置。
路由传的是逻辑状态,不是复制整份 KV
两个不同参数的模型不能直接共享通常意义上的 KV Cache。即使词表与 tokenizer 相同,它们每层的 Key、Value 都由各自权重计算,形状和语义也可能不同。模型 A 转给模型 B 的核心载荷通常是请求 ID、B 尚未见过的 token 后缀、位置锚点、完成状态以及算法自定义字段。B 用自身权重对新增前缀做 extend/prefill,在自己的 KV 池中补齐状态。
因此,TokenRouter 优化的不是“把 A 的 KV 显存拷到 B”,而是三件更基础的事:只传必要 token;让每个模型保留自己的请求状态;请求返回时从原有 KV 位置恢复,而不是被当成一条全新请求。跨模型 KV 映射是另一类技术,可参考跨模型 KV 缓存转移;TokenRouter 在没有学习映射的前提下工作。
三类系统性浪费
第一类是步骤失同步。小模型单步可能只需数毫秒,大模型单步可能慢数倍。若所有请求在逻辑 token 位置上设置全局屏障,快模型每步都要等慢模型。
第二类是 batch 准入延迟。目标模型刚启动一轮前向后才有新请求到达,这个请求不能中途塞进正在执行的 CUDA kernel,只能等下一轮。token 级切换频繁,等待会反复发生。
第三类是状态重建。把返回请求当作新的 HTTP 调用,会重复触发 tokenizer/dispatcher、前缀树匹配、RadixCache 加锁、KV 页分配和缓存元数据更新。论文附录对标准 SGLang 基线的一次小模型步骤进行剖析:前缀匹配、锁缓存节点、释放锁和更新 RadixCache 分别占 20.94%、17.47%、13.81% 和 32.62%,真正的小模型推理只占 4.20%。瓶颈已经不在模型前向。
TokenRouter 的系统架构
图 2:外部只有一个服务入口,内部每个候选模型对应一个自治子服务器。紫、蓝、黑三条数据流分别对应客户端、解码和跨模型循环。来源:TokenRouter 论文。
外部客户端看到的是一个 OpenAI 兼容接口,不需要知道后端有几个模型。Server Interface 把新请求送到配置指定的入口模型;从这一刻起,请求可能在多个子服务器间迁移,最终仍由统一接口流式返回。
每个子服务器包含四类核心部件:
- 一个模型运行器,负责本模型的前向、CUDA Graph 与本地 KV 池。
- 一个调度器,维护 waiting、running、pending 等请求集合,组装本模型的 batch。
- 一个路由器,在前向后根据算法决定每条请求的下一站。
- sender/receiver,把本地请求转换为点对点消息,并在另一端恢复成可调度状态。
各子服务器的结构相同,所以从两个模型扩展到三个模型不需要重写中央状态机。目标模型名称是路由结果的一部分;双模型场景也兼容布尔式“留在本地/交给唯一同伴”的旧接口。官方实现建立在 SGLang 0.5.1 上,子服务器之间在同机时使用 ZeroMQ IPC,也支持给不同模型配置可达的 TCP peer endpoint,从而跨节点部署。
三循环解耦
普通单模型服务通常已有两个异步循环:客户端循环接收请求、流式发送结果;解码循环选择 batch、执行前向。TokenRouter 增加第三个跨模型循环,专门收发 peer request。三者不设置全局 token 屏障:
- 客户端循环可以持续接纳新请求;
- 每个模型的解码循环以自己的速度前进;
- 跨模型循环在请求抵达时把它放入目标调度器,不阻塞其他模型。
若请求 A 从小模型切到大模型,小模型只暂停 A;同 batch 的 B、C 仍可继续。大模型也不必和小模型对齐“第几个逻辑 token”,它只处理自己当前可运行的请求。所谓模型中心执行,本质上是把全局同步批次拆成多个模型本地的连续批处理域。连续批处理的背景可参考Orca 的迭代级调度;TokenRouter 的新难点是请求会反复离开并返回一个调度域。
请求中心的三个接口
route(batch, result) 在一次前向后执行,为 batch 中每条请求返回目标模型。result 可包含 next-token logits、隐藏状态和采样结果。返回当前模型表示继续本地解码,返回其他名称表示发生 handoff。
send(req, destination) 把本地请求编码成 PeerReq。消息至少包含请求 ID、来源、目标、handoff 序号、活动/结束状态、位置锚点以及对方尚未看到的 token 后缀。位置锚点让对方回来时也只传新增部分,而非每次传完整上下文。
receive(msgs) 做三件事:按目标地址过滤消息;按请求 ID 和 handoff 序号去重,防止陈旧消息覆盖新状态;把已知请求唤醒,或为第一次到达本模型的请求建立本地状态。默认语义是接受对方返回的全部 token;需要重生成、丢弃或附带额外状态的算法可以重载它。
下面的伪代码展示 R-Stitch 小模型侧为何只需表达策略,而不必操纵 batch:
def route(batch, result): probs = softmax(result.next_token_logits) entropy = -(probs * log(probs)).sum(-1) / log(vocab_size) return where(entropy > threshold, "large", "small")
def send(req, destination): # 当前高熵 token 不提交,由大模型重生成 trusted_prefix = req.prompt_ids + req.output_ids[:-1] return make_peer_req( rid=req.rid, destination=destination, unseen_suffix=trusted_prefix[req.peer_anchor[destination]:], loc=len(trusted_prefix), handoff_seq=req.handoff_seq, )接口很小,但它封装的是正确性边界:由谁拥有输出位置、对方缺哪段上下文、哪一个 handoff 才是最新事件。若这些字段散落在外部 dispatcher 与多个推理服务器之间,路由算法稍有变化就可能破坏缓存一致性。
路由算法:收益、迁移成本与负载约束
TokenRouter 支持的策略可以按“何时切换”分为三类。
| 策略 | 模型数 | 从模型 切出的信号 | 模型 何时返回 |
|---|---|---|---|
| CITER | 2 | 低置信 token | 生成一个 token 后 |
| R2R | 2 | 预测到推理轨迹可能分叉 | 生成一个 token 后 |
| Co-LLM | 2 | 高 defer score | 生成一个 token 后 |
| R-Stitch | 2 | 高熵 token | 熵重新降低时 |
| ME | 至少 2 | 每个 token 按集成权重选模型 | 每步重新选择 |
这些算法的目标函数不同。R2R 更关心小模型是否即将偏离大模型推理路径,CITER 同时考虑当前决策对未来 token 的影响,R-Stitch 用归一化熵作为无需训练的局部难度信号,ME 则允许三个以上模型逐步协作。共同点是每次前向之后都能产出目标模型,因此可投影到 route-send-receive 生命周期。
不要把路由阈值和系统 batching 阈值混为一谈。前者决定质量—计算量折中,例如熵超过多少才调用大模型;后者决定队列里积累多少条请求才启动一次大模型前向。即使路由序列完全相同,改变 batching 阈值也会显著改变吞吐和单请求速度。TokenRouter 的实验重点是固定算法语义,优化如何执行这条路由序列。
一个更完整的成本账本
若只计算模型 FLOPs,token 级路由的平均每 token 成本可近似写成:
其中 是提交过程中落到模型 的执行比例, 是该模型单步成本。但真实延迟还包含:
forward 是模型计算;queue 是等待凑 batch 与等待前一轮完成;extend 是目标模型为新增后缀补算 KV;route 是逐 token 路由器;comm 是跨进程或跨节点消息。粗糙实现往往只降低第一项,却让后四项膨胀。TokenRouter 的异步执行主要压低同步空泡,handoff-resume 压低状态重建,延迟批处理压低碎片 batch,进程内路由与 CUDA Graph 则压低逐 token 固定开销。
状态迁移:KV Cache 如何追上计算
token 级路由最容易被误解成“请求去了另一台服务器,回来再继续”。对无状态 RPC,这句话足够;对自回归推理,它遗漏了最昂贵的状态:两边各自的 KV Cache、逻辑输出前缀和调度位置。
pending 不是 finished
单模型调度器通常把请求分成 waiting、running、finished。TokenRouter 在运行与结束之间加入 pending 状态。请求交给同伴时,本地副本不释放 KV 槽,也不继续参加解码,只从活动 batch 移到侧边集合。这样同时满足两个条件:
- 对调度器而言,它暂时不消耗本模型计算;
- 对缓存管理器而言,它仍是活请求,本模型已经计算的前缀不会被回收。
同伴返回后,receiver 根据返回状态把它切回 running 或 finished,并把新 token 追加到逻辑序列。如果只接受 0 到 1 个 token,可直接回到 decode 路径;若同伴返回多个 token,本模型需要走 extend 路径,为这段新后缀补算本地 KV。这里的 extend 不是从头 prefill,输入长度只等于本模型尚未看过的后缀。
假设提示长度为 ,模型 A 已处理到输出位置 ,随后请求在 B 上生成 个 token 又返回。朴素重建要让 A 再处理 个 token;保留状态后,A 只需 extend 新增的 个 token。一次返回节省的输入工作量近似为:
随着回复变长,朴素方案的重建代价随 增长,因而长输出越跑越慢;保留本地 KV 后,每次交接成本主要由新增后缀长度决定。这解释了论文中 8,192-token 高强度推理场景的差距为何远大于短回复。
每个模型有自己的“已见位置”
仅有一个全局 token 长度不够。若 A 和 B 多次来回切换,二者看到的最后位置不同。TokenRouter 为每个请求保存按模型索引的位置锚点,可抽象为:
从 A 发往 B 时,需要发送的 token 后缀是全局可信前缀从 开始的部分;B 返回时同理使用 。于是通信量与“上次离开后新增多少 token”有关,而不是与完整上下文长度有关。
位置锚点还承担协议校验。发送方附带 handoff sequence,接收方只接受比当前记录更新的消息。请求已经结束后,迟到的旧 peer message 不能把它复活;同一个 handoff 的重复消息也不能导致 token 追加两次。官方实现为 new、need、finished 等控制状态维护幂等处理,并将全局活跃请求数通过 peer channel 顺带广播,避免再引入中央协调器。
为什么仍然需要两份 KV
保留各自状态的代价是,同一请求可能在多个模型的 KV 池里占空间。若两个模型共享 GPU,这些缓存还会与两份模型权重争抢显存。TokenRouter 根据各模型权重占用、每 token KV 单元大小和可配置的共享显存预算,联合计算可分配容量,避免每个子服务器都按“独占 GPU”假设预留最大 KV 池。
设模型 的权重与固定开销为 ,每个缓存 token 占用 字节,共享预算为 。若所有模型按共同容量 预留,一个简化约束是:
实际实现还要保留激活、CUDA Graph 与临时 workspace,但这个式子揭示了为什么不能让各 SGLang 实例独立估算“剩余显存”:它们会重复计算同一块物理预算。分页 KV 的底层思想可参考PagedAttention 完全拆解;TokenRouter 在其上增加的是跨子服务器的联合容量规划和请求生命周期协调。
一次请求如何穿过系统
以小模型 S 和大模型 L 组成的 R2R 风格系统为例,一条请求经历如下闭环。
- 客户端把 prompt 发给统一入口,接口将它登记为新活跃请求并送入 S。
- S 完成 prefill,随后执行一次 decode。路由器读取当前结果,判断是否出现可能分叉的位置。
- 若继续由 S 处理,请求留在本地 running batch;若需要 L,S 将它标成 pending,保留 S 侧 KV,并构造只含 L 未见后缀的
PeerReq。 - L 的跨模型循环接收消息。若这是请求第一次到 L,它建立本地请求并对所需前缀做 extend;若请求以前来过,就从 L 自己保存的位置续算。
- L 生成算法规定的 token。对 R2R、CITER 和 Co-LLM,通常生成一个 token 后就把控制权交回;R-Stitch 则可能连续留在 L,直到输出熵降回阈值以下。
- S 收到返回消息,核对 handoff 序号,把新增 token 补入本地状态,再把请求放回可运行集合。
- 任一模型产生终止 token 或达到长度上限后,结束状态沿 peer channel 传播,各子服务器释放本地 KV,统一入口向客户端完成响应。
整个闭环中没有“所有请求必须同时完成第 步”的规则。逻辑序列仍然严格自回归,但物理执行时间线是异步的。顺序正确性由单请求的 handoff 序号和前缀位置保证,而不是由全局 barrier 保证。
交接语义决定正确性
下面三个问题必须由路由算法明确,而不能由运行时猜测:
- 当前模型刚采样的 token 是否可信?若不可信,
send必须排除它,让目标模型重生成。 - 目标模型生成的 token 是否全部提交?若算法要做融合或回退,
receive必须实现相应语义。 - 请求完成由哪一侧宣布?结束消息必须传播到所有保存了本地状态的模型。
因此 route-send-receive 并非三个随意拆开的回调。它们分别定义控制流、传输边界与提交语义,合在一起才构成一次可验证的状态转移。
为什么它能提高服务效率
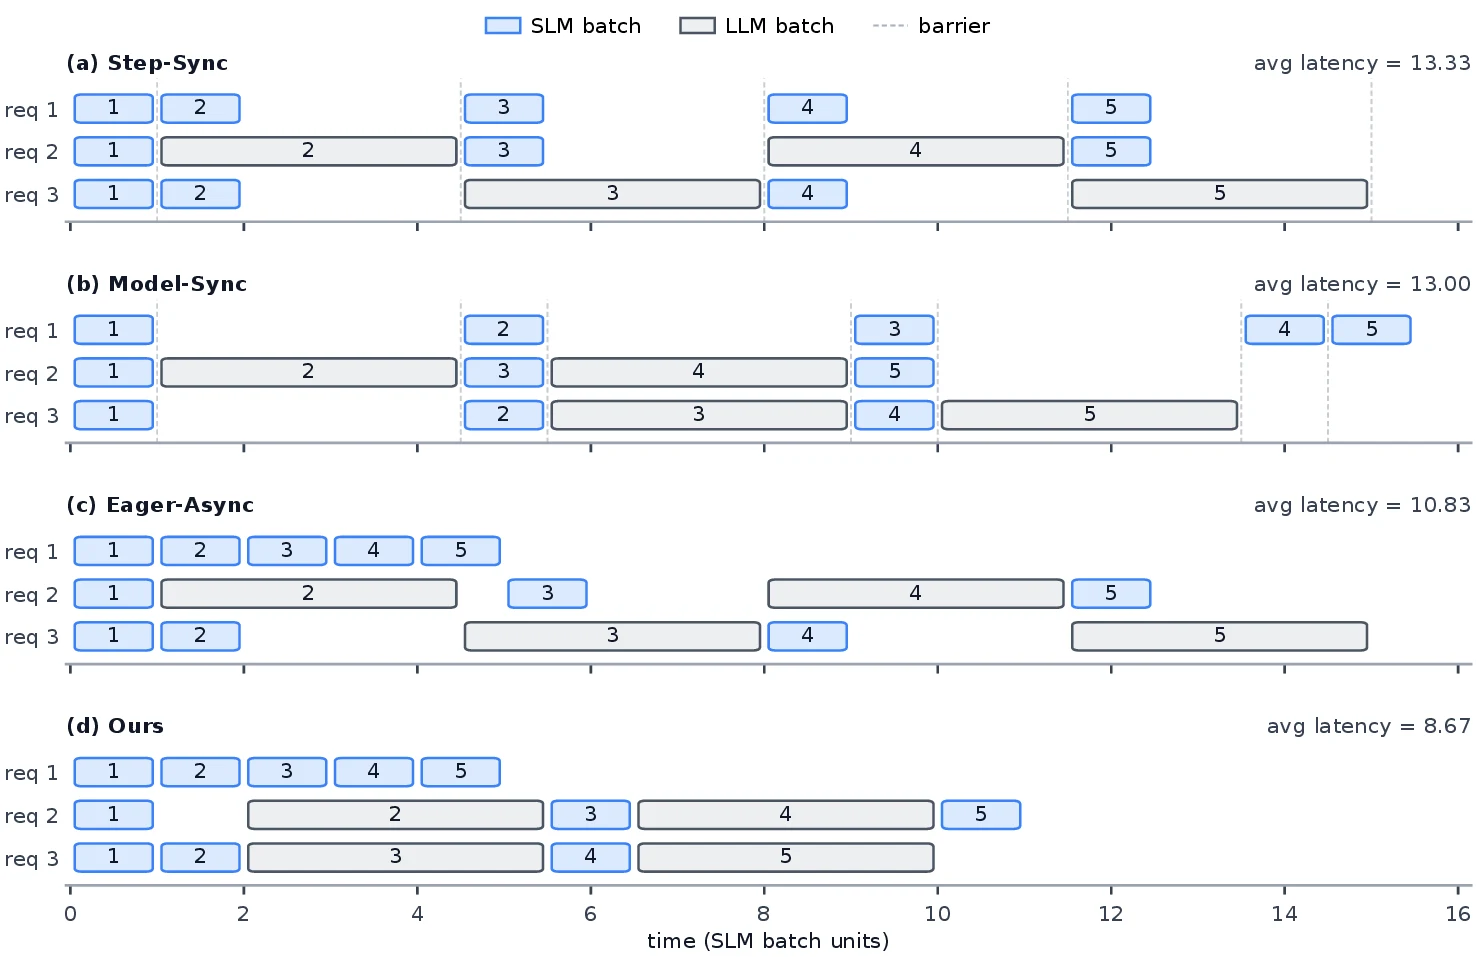
图 3:Step-Sync、Model-Sync、Eager-Async 与 TokenRouter 延迟批处理。来源:TokenRouter 论文。
图 3 把性能问题画得很清楚。
Step-Sync 在每个逻辑步骤设置屏障,小模型完成后等待大模型,硬件空闲时间最大。Model-Sync 一次只推进一个模型,适合草稿—验证这种周期固定的耦合,却不适合数据依赖、随机切换的 token 路由。Eager-Async 取消屏障,但目标模型一看到单条请求就立刻开工;随后到达的请求只能错过当前 batch,形成大量小 batch 和准入等待。
TokenRouter 保留异步执行,却故意不让昂贵模型对第一条到达请求立即响应。它把到达请求暂存到队列,达到阈值 后才在模型 上发车。早到请求多等一小段时间,换来更多请求共同摊薄一次前向的固定成本;晚到请求反而不用等一个刚启动的长步骤结束。目标不是让每条请求最早开工,而是减少全体请求的平均空泡。
延迟批处理不是普通静态 batch
它有三个区别。第一,阈值按模型设置,小模型可以 持续推进,大模型用 聚合稀疏调用。第二,阈值可以按系统活跃并发数选取;官方实现允许配置阈值列表,并用全局活请求数选择当前值。第三,它仍建立在连续批处理上,已运行 batch 完成一次迭代后可以与新到请求重组,并非等待固定的一组请求全部结束。
阈值过小会碎片化,阈值过大则会饿死。假设系统只有 条闭环请求,其中太多请求分别卡在不同模型的 waiting queue,任何队列都凑不够自己的门槛,系统会进入静止状态。论文给出无死锁的充分约束:
直觉是模型 最多可以有 条“差一条才发车”的请求。若所有模型这种滞留上限之和仍小于总请求数,至少还有一条请求能让某个模型达到阈值并继续流动。
用 Markov 链选择阈值
TokenRouter 没有把 当作凭经验拍出的常数。它将系统观察点放在任一模型完成 batch 的时刻,并定义状态:
其中 是模型 的等待请求数, 是正在执行的 batch 大小, 是该 batch 的剩余执行时间。系统总共有 条闭环请求,因此满足:
设一次模型 前向结束后,请求转往模型 的概率为 ,这次转移提交 个 token。对于完成 batch 的模型,目的地计数服从多项分布。把各模型单步时延离散为共同时间粒度 的整数倍后,可枚举有限可达状态,建立转移矩阵 ,求稳态分布 :
在状态 中,下一个事件的保持时间是所有运行 batch 剩余时间的最小值:
长期吞吐等于每次状态跳转平均提交 token 数除以平均经过时间:
表示在下一事件中完成 batch 的模型集合。分子统计稳态下每个事件提交多少 token,分母统计事件间隔。最后在满足无死锁约束的有限阈值空间中搜索:
模型假设路由概率在考察时间窗口内近似平稳、不同请求的路由决定相互独立、单步时延可由离线 profiling 给出。它不是对所有非平稳 workload 的精确预言,但比单凭“batch 越大越好”多考虑了闭环请求会在模型间循环和相互饥饿的事实。
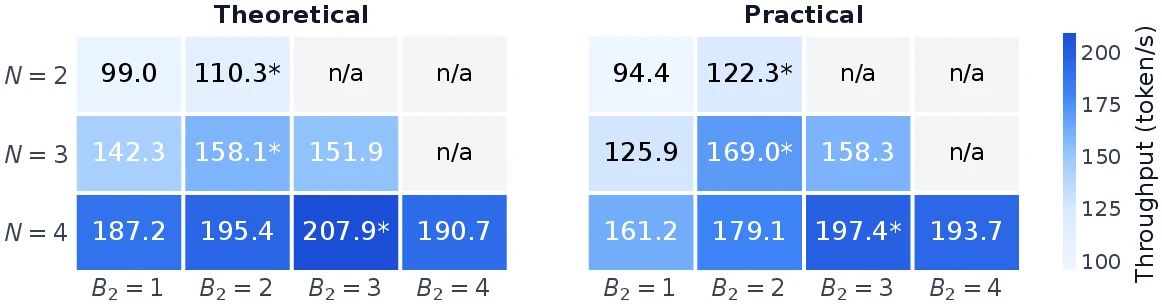
图 4:固定小模型阈值 ,改变大模型阈值 时,Markov 模型预测与硬件实测的吞吐曲线。星号表示各并发度下的最优点。来源:TokenRouter 论文。
论文用 R2R 验证这个模型:小模型到大模型的概率取 ,测得单步时延分别为 6.0 ms 与 27.9 ms,时间粒度取 0.1 ms。不同并发度下,模型预测的最优阈值都与实测最优点一致。重要的不是每一个吞吐数字都完全重合,而是它能可靠选中“该等几条再发车”。
实现细节与工程边界
extend 路径也必须 CUDA Graph 化
单模型服务中的常见形状是 batch 内每条请求各解码一个 token,因此 CUDA Graph 通常重点覆盖 decode。token 路由改变了热路径:请求从同伴返回时,本地模型必须 extend 对方刚生成的一个或多个 token;对本地调度器而言,这不是普通 decode 请求。
如果 extend 每次都走 eager kernel launch,频繁 handoff 会把 CPU 调度和 kernel 启动开销放大到每个 token。TokenRouter 因此为一组 extend batch size 与 token length 捕获 CUDA Graph,落在捕获范围内的常见交接直接 replay,超过范围的长 extend 才回退到普通执行。这与只给 decode 捕图相比,是由 workload 形态决定的优化,不是简单地“多开一个 CUDA Graph”。CUDA Graph 的捕获、实例化与重放机制可参考CUDA Graph 完全拆解。
路由器必须在进程内
请求级路由一条请求只调用一次,独立路由微服务的 RPC 成本通常可以接受。token 级路由在每次前向后、对 batch 中每条请求调用;若把 logits 送到另一个进程再等决定,等于给每个 token 串联一次 IPC 往返。
TokenRouter 把 router 与 scheduler 放在同一进程,并让路由决策成为 GPU 上的 tensor 操作。以熵路由为例,softmax、逐元素乘法、归约和阈值比较都可留在设备侧;只有最终目标索引参与调度。路由模型若本身较大,仍需要计入资源与时延,但系统至少不再强制加入跨进程边界。
同 GPU 重叠与独立 GPU 部署
论文主实验为了在相同 GPU 数量下比较,让 Qwen3-0.6B 用一张 GPU、Qwen3-32B 用两路张量并行,并通过 CUDA MPS 让小模型与大模型共享两张物理 GPU。MPS 允许来自不同进程的 kernel 更好地并发,但也带来权重、KV 和执行资源竞争。
如果资源允许,把两个模型放到互不重叠的 GPU,吞吐平均再提高 6.43%。这说明异步架构不仅是软件抽象,也会把硬件放置变成一等配置:
- 流量稀疏的小模型未必值得增加 TP;
- 大模型单步延迟决定多数交接等待,额外 GPU 更适合优先给大模型;
- 共卡节省设备数,但要依赖 MPS 并联合规划显存;
- 分卡减少争用,却需要更多 GPU,跨节点时还要考虑网络。
论文的并行策略消融印证了第一、二点。在两 GPU 相关配置中,将大模型 TP 从 1 提到 2,使 和 的吞吐分别提高 40.6% 与 22.8%;大模型已经 TP=2 后,再把小模型 TP 从 1 提到 2,只增加 0.8% 与 0.4%。瓶颈资源应该给慢而关键的服务站,而不是平均分配。
跨节点为何没有被 token 通信压垮
论文还在 3.7 GB/s RoCE 链路上把 Qwen3-0.6B 与 Qwen3-32B 部署到一个或两个节点。并发 4 时,R2R 从单节点 228.94 token/s 降到跨节点 202.43 token/s,CITER 从 308.36 降到 277.56 token/s;有损失,但没有数量级崩塌。
原因不是网络免费,而是消息主要携带增量 token 和控制元数据,没有逐步搬运整份多层 KV。若实现改成传完整前缀或跨模型 KV tensor,这个结论就不再成立。跨节点部署还要求 tokenizer、词表与逻辑 token 序列在模型间兼容,否则“发送 token ID”不能代表相同文本语义。
代码结构里的抽象边界
官方仓库把入口协议放在 entrypoints/,把调度、交接、分词与反分词放在 managers/,算法特有逻辑放在 algorithms/,模型执行与 CUDA Graph 放在 model_executor/。新增路由策略通常为每个协作模型实现一个 BaseTokenRoutingScheduler 子类,再注册到 scheduler registry。
这个边界有两个工程好处。第一,路由算法可以复用 SGLang 的分页缓存、连续批处理和模型执行器,不必 fork 一整套 serving stack。第二,性能优化集中在公共运行时:一次修复 extend CUDA Graph、消息去重或 KV 生命周期,所有策略受益。代价是算法必须能表达为逐步的 route-send-receive;需要联合访问多个模型完整 logits、做同步融合或回滚长片段的算法,可能要扩展消息与提交协议。
如何读实验结果
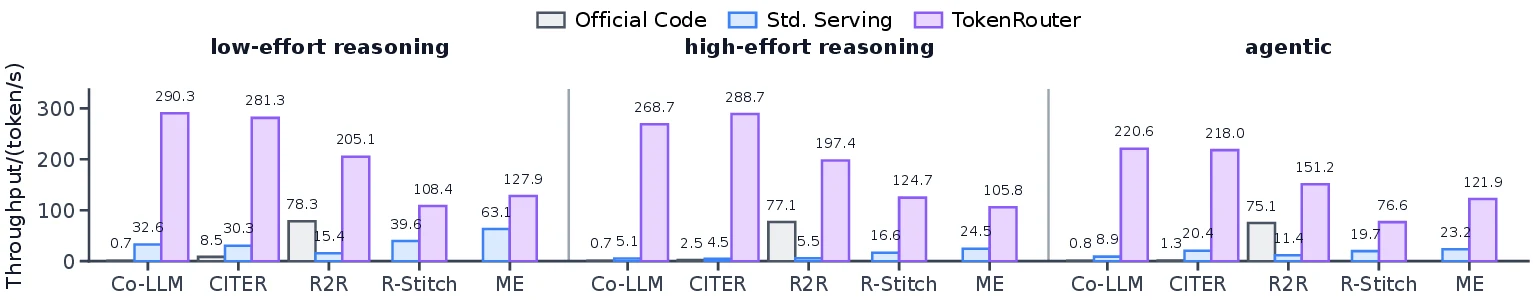
图 5:并发度 4 时,五种路由算法在三类 workload 上的输出吞吐。灰色是算法官方实现,蓝色是每模型一个标准 SGLang 服务加外部逐 token dispatcher,紫色是 TokenRouter。来源:TokenRouter 论文。
实验设置先于加速比
主实验硬件是 8 张 A100 80GB。双模型算法使用 Qwen3-0.6B 与 Qwen3-32B,多模型 ME 使用 Qwen3-0.6B、8B 与 32B。三类 workload 分别是:
- 低强度推理:AIME2024,输入约 100 token,最大输出 2,048 token;
- 高强度推理:AIME2024,筛选 32B 解答超过 8,192 token 的题,最大输出 8,192 token;
- Agent 轨迹:SWE-Smith,多轮输入约 8,192 token,最大输出 1,024 token。
吞吐定义为总输出 token 数除以墙钟时间。服务系统用 个 worker 维持 条在途请求,一个请求完成后立即补下一条。这是闭环并发,不等同于固定 arrival rate 的开放排队系统。读者不应把图中 token/s 直接当成任意线上流量分布的容量。
基线也要分清。Official Code 是各算法原仓库的实现,成熟度不同:Co-LLM 使用每模型一个 vLLM 服务并有连续批处理,CITER 与 R2R 的官方实现则不是完整连续批处理服务。Std. Serving 是作者统一构建的 SGLang 基线,每个模型一个标准服务,外部 dispatcher 每次只路由一个 token。论文报告的增益取两种基线中更强者,因此没有专挑最慢官方代码作分母,但某些算法的通用基线仍然受到反复前缀匹配与缓存维护影响。
主要结论与其边界
在 15 个“算法 × workload”组合上,TokenRouter 相对更强基线的吞吐提升为 2.01–64.15 倍,并把 Std. Serving 的端到端延迟降低 2.03–63.64 倍。长输出从 2,048 增到 8,192 上限时,TokenRouter 吞吐保持稳定,而 Std. Serving 损失 58.1%–85.2%。这与前面的复杂度分析一致:标准基线每次返回都按新 extend 请求做前缀树和 KV 元数据工作,其交接成本会随已生成前缀增长。
但 64.15 倍不能被概括成“任何 LLM 推理都快 64 倍”。它来自特定的 CITER、高强度推理、并发与基线组合,展示的是为 token 路由定制运行时相对把单模型服务硬拼起来的差距。对最成熟的 R2R 官方实现,不同模型对上的吞吐提升是 1.99–3.21 倍,仍然显著,但更接近可迁移的系统收益区间。
论文还在各算法原始设置下报告并发 4 的对照。例如 R2R 的官方实现吞吐为 89.62 token/s,TokenRouter 为 244.56 token/s,端到端延迟从 751.15 秒降到 270.19 秒;Co-LLM 从 3.46 提升到 76.02 token/s,延迟从 247.61 秒降到 11.46 秒。这些数字反映系统执行差距,并不意味着 TokenRouter 改善了相同路由轨迹的答案质量。
消融告诉我们收益来自哪里
在 R2R、并发度 8 的消融中,官方实现为 134.89 token/s。只逐步加入小模型 CUDA Graph、大模型 CUDA Graph、路由器 CUDA Graph 后,基础实现从约 132.78 提升到 230.79 token/s;再加入异步执行达到 296.86 token/s;最后加入延迟批处理达到 372.48 token/s,即相对官方实现 2.76 倍。
这组数字给出两个判断:
- 约一半收益来自常规但必须适配新热路径的工程优化,不能把全部提升归因于新调度算法。
- 异步执行和延迟批处理不是互相替代。前者消除跨模型 barrier,后者修复异步到达造成的小 batch;只做前者会落入 Eager-Async 的碎片化。
吞吐不是唯一目标
延迟批处理主动让早到请求等待,因此必须同时看每用户生成速度。论文把并发从 1 提到 16 时,TokenRouter 总吞吐提高 8.61 倍,并保留单用户速度的 51.7%;官方 R2R 总吞吐提高 5.14 倍,只保留 31.3%。在并发 16 下,TokenRouter 的吞吐仍是官方 R2R 单并发的 18.58 倍,同时单用户速度高 1.13 倍。
这说明选 的目标虽是稳态 token throughput,却没有必然把交互速度压垮。不过若生产 SLO 直接约束 P99 TPOT 或单请求 deadline,优化目标需要加入尾延迟,而不能只最大化平均提交 token 率。
与相邻系统的关系
与请求级路由
RouteLLM 一类系统在请求入口选择模型,后端仍是标准单模型服务。它们交接次数少、状态简单,最适合模型差异主要发生在整题难度的 workload。TokenRouter 针对的是同一回复内部难度高度不均匀,或多个模型需要逐 token 协作的情况。细粒度能得到更多质量—成本工作点,但会支付路由、extend、缓存复本和调度复杂度。
与投机解码
两者都使用快慢模型,却有不同协议。投机解码让草稿模型先提出固定或动态长度候选,目标模型用一次前向并行验证;交互模式大致是“草稿若干步—验证一次”,并有严格的无损接受规则。token 路由让某个模型直接拥有下一步生成,切换由数据依赖策略决定,可能在任意位置来回,也未必保持与单一目标模型完全相同的分布。
因此,投机解码运行时可围绕周期性 draft/verify 做紧耦合流水线;TokenRouter 必须处理随机模型访问、不同 token 提交语义与多模型扩展。有关树验证和接受规则,可参考EAGLE 完全拆解或Medusa 完全拆解。
与 P/D 分离
DistServe 把 prefill 和 decode 放到不同 GPU 池,迁移发生在阶段边界,通常每条请求一次;TokenRouter 的迁移发生在 decode 内部,可能每几个 token 一次。两者都把逻辑请求从固定 worker 所有权中解耦,但 TokenRouter 的状态切换频率更高,发送增量更小,对消息与缓存生命周期更敏感。P/D 分离的 goodput 与放置问题可参考DistServe 完全拆解。
与通用 SGLang/vLLM
SGLang 的 RadixAttention 和 vLLM 的 PagedAttention 解决单模型内请求如何共享前缀、分页管理 KV,并通过连续批处理提高利用率。TokenRouter 没有替代这些机制,而是让每个模型子服务器继续使用它们,同时修复“请求会离开又回来”打破的单模型假设。
这也是为何把多个现成 server 放在外部路由器后面并不等价:外部 dispatcher 看不到内部 KV 槽和 pending 生命周期,只能把返回 token 当成新请求。TokenRouter 把路由协议下沉到调度器附近,让缓存状态与跨模型控制流处在同一个一致性域。
局限与适用条件
第一,系统加速不能挽救错误的路由策略。若路由器频繁把关键 token 留给能力不足的模型,答案质量会下降;若过于保守地调用大模型,计算节省消失。TokenRouter 保持既定算法语义并加速执行,不提供通用质量保证。部署评测必须同时固定采样设置,报告质量、实际模型调用比例、吞吐、TTFT、TPOT 与尾延迟。
第二,多模型缓存会换来容量压力。交接频繁而请求上下文很长时,每个参与模型都可能保留一份本地 KV。系统减少了重算,却可能降低可承载并发数。模型数越多、KV 单 token 越大,这个矛盾越突出。若路由模式呈现长时间单向迁移,可以考虑主动释放长期不会返回模型的缓存;但这需要概率预测或超时机制,一旦判断错误就要重新 extend。
第三,延迟批处理模型采用稳态近似。真实 Agent workload 会经历工具调用、长短回合交替和路由概率突变; 与模型步时延还会随序列长度、batch shape、缓存命中和 GPU 争用变化。离线得到的 可能随时间失效。生产系统更合适的方向是在线估计转移概率与服务时间,在吞吐和 P99 SLO 约束下周期性调阈值。
第四,tokenizer 与协议兼容性是隐含前提。Qwen3 同族模型共享词表,传 token ID 很自然;跨模型族协作若词表不同,就需要发送文本后重分词,位置可能不再一一对应,甚至一个模型的单 token 会变成另一个模型的多个 token。此时位置锚点、提交边界与停止条件都要重新定义。
第五,跨节点结论来自两节点、3.7 GB/s RoCE 和增量 token 消息。更多模型、更高切换率或跨地域网络会放大排队抖动、消息乱序与故障恢复问题。请求状态分散在多个子服务器后,一个节点失效不仅丢失当前计算,还可能丢失该模型独有的 KV;论文没有建立持久化或副本恢复协议。
第六,当前开源实现仍有功能组合边界。代码对多模型加数据并行的某些路径明确保留限制;CUDA Graph 只能覆盖预先捕获的形状范围;结构化输出、投机解码、LoRA、多模态与分布式缓存等特性若同时启用,都需要验证其状态能否随 handoff 正确传播。一个单模型功能“可以运行”,不代表在反复跨模型迁移时仍保持同样语义。
适合 TokenRouter 的场景具有几个共同特征:至少两个模型在同一序列内有明确互补性;路由算法只需交换小型逻辑状态;输出较长,避免状态重建的收益能覆盖系统复杂度;服务有足够并发,可把稀疏的大模型调用聚成 batch。若请求很短、并发接近 1、两个模型速度相近或几乎每步都调用大模型,请求级路由或直接服务大模型可能更简单。
小结
TokenRouter 把 token 级路由从算法伪代码变成了一个完整服务问题。它识别出的核心矛盾不是模型选择本身,而是单模型 serving stack 默认“请求永远属于一个模型、活动请求同步向前”这两个假设,在逐 token 切换下同时失效。
系统的解法由四层机制咬合而成:route-send-receive 把算法语义压缩成可组合接口;每模型一个自治子服务器消除全局步骤屏障;pending 与位置锚点保留各模型的 KV 生命周期;基于 Markov 吞吐模型的延迟批处理把异步稀疏到达重新聚成高效 batch。extend CUDA Graph、进程内路由、联合显存规划和幂等 peer message 则补齐了热路径上的工程细节。
最重要的系统结论是:异步并不天然高效。取消屏障后,如果目标模型见一条就跑一条,碎片 batch 和准入延迟仍会吞掉收益;短暂、受约束、可建模的等待,反而能同时提高总体吞吐和请求完成速度。TokenRouter 提供的不是一个固定阈值答案,而是一套把路由概率、模型时延、并发度、KV 状态和 SLO 放到同一张性能账本里的方法。
参考资料
- TokenRouter: Efficient Serving System for Token-Level LLM Routing
- TokenRouter 官方代码仓库
- TokenRouter 官方项目页
- R2R: Efficiently Navigating Divergent Reasoning Paths with Small-Large Model Token Routing
- CITER: Collaborative Inference for Efficient Large Language Model Decoding with Token-Level Routing
- R-Stitch: Dynamic Trajectory Stitching for Efficient Reasoning
- Learning to Decode Collaboratively with Multiple Language Models
- SGLang: Efficient Execution of Structured Language Model Programs
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- Orca: A Distributed Serving System for Transformer-Based Generative Models
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



